Change the Product, Keep the Parameters:结合代数 Transformer 层精读
论文:Change the Product, Keep the Parameters: Associative Algebra Layers for Transformers
作者:Ilya Koziev、Ivan Oseledets
版本:arXiv:2609.32814v1,提交于 2026-09-26;本次研读于 2026-10-19。
文件:原文 PDF · 英文汇报 PDF · 可编辑 Beamer
论文总览
这篇论文把线性层的“乘法规则”本身当作架构设计变量:保留全部可学习权重块,却只计算固定规则允许的部分激活—权重交互。作者选择满足结合律、具有单位元的代数,使受限线性映射仍能在复合时保持同一结构,并用双线性秩给出所选乘法的精确成本下界。
最容易混淆的三层结果是:
| 层次 | 研究对象 | 得到的结论 |
|---|---|---|
| 数学构造 | 直接图代数 $\mathcal Q_q$ | 标量双线性秩恰为 $2q^2-q$;固定物理块大小、随矩阵规模增加组数时,新乘法的计算量为二次阶 |
| GPU 内核 | 合成 BF16 张量,采用公开 Transformer 的层尺寸 | 许多形状能加速;最优组数依赖尺寸;部分小专家层在前向加反向时变慢 |
| 语言模型 | 两个 110.6M 模型,仅 FFN 使用不同乘法 | 递归代数 $\mathcal Q_2^{\otimes2}$ 带来 6.2%–7.8% 生成吞吐提升,同时三项下游指标下降 |
论文的主要价值是给出一种可严格计数、可实现、可训练的稀疏交互架构。实验展示了速度与质量的取舍,尚未建立等质量下的效率优势。尤其要区分:大组数直接代数的内核加速,与小模型递归代数的语言能力结果,来自两套不同实验。(Secs. 3、5、7、9,PDF pp. 3–9)
结构地图
下文页码均为从 1 开始的 PDF 页码;本篇与正文印刷页码一致。
| 原文章节 | 作用 | PDF 页码与关键定位 |
|---|---|---|
| 1 Introduction | 用两组特征说明为什么改变乘法 | pp. 1–2,Eqs. (1)–(4) |
| 2 Products as Architectural Choices | 乘法表、双线性秩及 Alder–Strassen 下界 | p. 3,Eqs. (5)–(8) |
| 3 Graph Products with Exact Cost | 图代数及精确秩 | pp. 3–4,Theorem 3.2 |
| 4 Transformer Projections | 位置类型、矩形投影、参数覆盖 | pp. 4–5,Eqs. (16)–(21) |
| 5 Scaling and Practical Implementation | 二次计算量、有限形状约束、内核调度 | pp. 5–6,Eqs. (22)–(26) |
| 6 Training and Inference | 反向、因果性及 KV 缓存 | pp. 6–7,Algorithm 1、Eq. (29) |
| 7 Experiments | 内核测试与小规模预训练 | pp. 7–8;Tables 1–2 在 p. 8,Table 3 在 p. 9 |
| 8 Related Work;9 Discussion and Limitations;10 Conclusion | 方法定位、证据边界与结论 | p. 9 |
| A Direct Associativity Check;B Vector–Jacobian Products;C The Tensor-Square Candidate | 结合律、梯度与递归构造 | pp. 12–13 |
| D Experimental Details | 模型配置、损失曲线、吞吐与评测 | pp. 13–15,Fig. 1、Tables 4–8 |
| E Kernel Benchmark Details;F Larger Pure Products | 完整 FFN、反向、大尺寸实验 | pp. 15–18,Tables 9–13 |
| G Attention Extension and Detailed Cost Accounting | 尚未纳入小模型实验的注意力扩展 | pp. 17–21,Tables 14–15 |
| H Graph-Algebra and Scaling Proofs;I Training Data Sources | 理论证明、数据清单与去污染 | pp. 21–24 |
一:动机——权重容量与每次使用的计算量能否分开?
普通线性层 $Y=XW$ 同时固定了两件事:权重有多少可学习数值,以及输入组与权重组怎样相乘。传统快速矩阵乘法主要改变计算同一结果的算法。例如,Strassen 将普通 $2\times2$ 块乘法的八个常规乘积降为七个。
作者提出:隐藏表示和相邻层本来就要联合学习,是否可以选择一个更便宜的乘法,再从头训练模型适应它?由此得到的输出一般不同于 $XW$,因此它应理解为一个新线性层族。参数数量可以保持不变,但每个位置允许的信息流会改变。
相较于通过低秩分解、Tensor Train 等方式压缩权重存储,本文把限制放在固定交互表上;相较于内容驱动的专家路由,本文按位置决定使用哪些块。这也解释了为何“保留参数”与“保留原模型功能”是两个不同命题。(Secs. 1、2、8,PDF pp. 1–3、9)
二:方法——从六个乘积到因果 Transformer
2.1 最小例子:删除交互,保留权重块
把输入和权重写成兼容的块矩阵:
新乘法定义为
普通乘法还包含左上角的 $UW_v$ 和右下角的 $VW_u$;新规则直接省掉这两个 GEMM。因此块乘积从八个变为六个。$W_u,W_v$ 仍在其他项中出现,四个权重块都独立学习。
这里的两行展示两种位置类型,并非把两个 token 混起来计算:第一类 token 提供 $(A,U)$,只产生第一行;第二类提供 $(V,D)$,只产生第二行。特征混合发生在单个 token 内。(Sec. 1,PDF pp. 1–2,Eqs. (1)–(3))
2.2 为什么要结合律和单位元?
一般乘法表可以写成
$c_{ij}^{k}$ 是架构固定的系数,决定交互的存在及其输出位置;$w$ 才是学习的权重。定义 $\Phi_w(x)=\mu_{\mathcal A}(x,w)$,结合律给出
因此,兼容的纯线性映射复合后仍属于同一族。单位元 $1_{\mathcal A}$ 则满足 $\Phi_{1_{\mathcal A}}(x)=x$ 和 $\Phi_w(1_{\mathcal A})=w$,保证完整代数表示中的权重没有永远不起作用的槽位。到了 Transformer,要把不同位置类型联合起来,才能覆盖完整权重库。
这两个性质提供结构保证。包含门控、激活和注意力的整个网络,不能用上述线性复合公式直接折叠为一层。(Sec. 2.1,PDF p. 3,Eqs. (5)–(6))
2.3 图代数:只允许端点与边的乘法
给无自环有向图 $G=(V,E)$ 的每个顶点一个基元 $e_i$,每条边一个基元 $a_{ij}$。仅以下基元乘法非零:
任意边乘边都为零。对应的坐标公式是
直觉是:一条非对角交互可由起点的输入作用于边权,也可由边输入作用于终点权重,但不能串联两条边。边空间 $J$ 因而满足 $J^2=0$;去掉边后剩下独立的顶点乘法,$\mathcal Q_G/J\cong\mathbb F^{|V|}$。
结合律的证明可按三个因子的边数分类:含至少两条边时,两种括号都为零;恰一条边时,只有其相邻顶点匹配端点才能保留;没有边时只需三个顶点一致。双线性把基元结论扩展到整个空间。(Sec. 3.1,PDF pp. 3–4;App. H.1,pp. 21–22)
2.4 “秩最优”具体最优在哪里?
双线性秩 $R(\mathcal A)$ 计数精确双线性算法所需的最少标量乘法。Alder–Strassen 下界是
其中 $t$ 是极大双边理想的个数。图代数的维数为 $|V|+|E|$,且 $t=|V|$,故
显式公式恰好用每个顶点一次、每条边两次乘法,所以上下界相等。完全有向图有 $q(q-1)$ 条边,得到
这是给定新乘法的精确秩。$R(\mathcal Q_2)=6$ 与普通 $2\times2$ 矩阵乘法的秩 7 比较时,目标函数已经不同。把标量槽位提升为矩阵块后,六项对应六个块 GEMM;下界也不直接等于 GPU 延迟下界。(Sec. 2.2、Theorem 3.2,PDF pp. 3–4;App. H.1,p. 22)
2.5 矩形投影与位置类型
对 $X\in\mathbb F^{M\times K}$、$W\in\mathbb F^{K\times N}$,将输入分成宽度 $s_j$ 的 $q$ 组,输出分成宽度 $r_j$ 的 $q$ 组。于是 $W_{jk}\in\mathbb F^{s_j\times r_k}$。
位置 $p$ 选择固定类型 $i=\tau(p)$,计算
类型 $i$ 使用全部对角块和第 $i$ 行非对角块;不同类型共同覆盖全部 $KN$ 个参数。单个 token 的权重梯度也只到达这些活跃块。
教学解释:满秩与稠密表达能力不同。 对 $q=2$、类型 1,有效权重矩阵为
当两个对角块可逆时,$T_1$ 可以满秩,却仍禁止 $x_2$ 对 $y_1$ 的直接影响。由此可见,本文的低双线性秩既不是低秩权重分解,也不能保证与任意稠密线性映射具有同样的函数类。(Sec. 4,PDF pp. 4–5)
2.6 直接四组与递归四组必须分开
实验训练用的是 $\mathcal Q_2^{\otimes2}$。类型及特征组由两位二进制串表示;对输入类型 $\alpha$、输出组 $\delta$,允许的中间组为
若两端 Hamming 距离为 $h$,有 $2^h$ 个中间组。例如 $\alpha=00,\delta=11$ 时,递归规则允许 $00,01,10,11$ 四个组;直接 $\mathcal Q_4$ 只允许两个端点组。递归构造保留了部分两步交互,因此它与直接四组不是同一个代数。
| 乘法 | 槽位数 | 所展示算法的全表块乘积数 | 等宽投影 MAC 比例 | 精确秩信息 |
|---|---|---|---|---|
| $\mathcal Q_2$ | 4 | 6 | $3/4$ | 6 |
| $\mathcal Q_4$ | 16 | 28 | $7/16$ | 28 |
| $\mathcal Q_2^{\otimes2}$ | 16 | 36 | $9/16$ | 仅知在 $[28,36]$ 内 |
递归 $L$ 层的显式算法用 $6^L$ 次乘积,等宽投影比例为 $(3/4)^L$。因此,小模型实际 FFN 的 MAC 节省为 $1-9/16=43.75\%$,不能套用直接四组的 $56.25\%$ 节省。(Sec. 3.2,p. 4;App. C,pp. 12–13)
2.7 前向、反向与二次缩放
定义 $D_{\rm diag}=\sum_j s_jr_j$。类型 $i$ 的一行需要
次乘加(MAC)。第一项来自全部对角映射,第二项来自源组 $i$ 到其他输出组的交互。若 $M_i$ 行具有类型 $i$,则
等宽分组时,每行均有相同比例
反向的 $dX,dW$ 各重复前向的乘积支撑,因此三次矩阵乘法计算合计为 $3C_{\rm proj}^{\rm fwd}$。这只计算投影乘加,不包含优化器、归一化、激活和数据搬运。三个投影组成的 SwiGLU 在 $B$ 个 token 上,前向加反向从 $9BDF$ 降为 $9\rho BDF$。(Sec. 4、6.2,pp. 4、6;App. B,p. 12)
平方矩阵边长为 $n=qb$、叶块为 $b\times b$ 时,直接图代数的成本是
只有固定 $b$、令 $q=n/b$ 随 $n$ 增大,才得到
若固定 $q$,成本仍为三次阶。这个二次结论针对随规模改变的乘法族;同时,权重存储仍为 $n^2$,每个位置能直接使用的交互比例会下降。块值代数还满足 $R(\mathcal Q_q\otimes M_b)\ge2n^2-q$,给出同阶下界,而非普通矩阵乘法的二次算法。(Sec. 5.1,p. 5;App. H.2,p. 22)
2.8 为什么少做乘法也可能更慢?
类型专属的叶 GEMM 大约具有 $(M/q,K/q,N/q)$ 的形状。分组越细,算术量越低,但小矩阵利用率、启动开销和补齐 tile 的成本越突出。若高效叶块的最低轴长为 $(m_0,k_0,n_0)$,作者给出筛选条件
这只是初始筛选;真实核函数可以在较小叶块上取得更优结果,仍需测量。设代数核与稠密核的有效算力比为 $\eta_q$,额外开销与稠密耗时之比为 $\delta_q$,计算主导近似下加速要求
实现包括一次累加两个端点乘积的融合核、先算全部对角映射再算类型专属映射的两阶段核,以及单 token 的向量归约核。每个部署模型的 $q$ 必须在训练、prefill 和 decode 中固定;可随负载改变的是 tile 和调度。(Secs. 5.2–5.3,PDF pp. 5–6)
2.9 因果性和 KV 缓存
投影只访问当前 token,$\tau(p)$ 由绝对位置确定,再配合普通三角注意力掩码,就能保持自回归因果性。训练将各类型的 token 分组批处理;解码只计算新 token 所属的类型。分块 prefill 或续写时必须保持同一绝对位置类型。
小模型仍使用稠密注意力,缓存为 $K,V\in\mathbb R^{N\times n_{kv}\times d_h}$,共 $2NH_{kv}$ 个标量。设 $D$ 为模型宽度、$F$ 为 FFN 宽度,$H_q=n_qd_h$、$H_{kv}=n_{kv}d_h$,门控 FFN 的 $g=2$,则每层单 token 的相关 MAC 为
前两项是 Q/K/V/O 投影,第三项是 FFN,最后一项是注意力分数和 value 汇聚。实验中 $H_q=H_{kv}=D,F=2D,\rho=9/16$,仅考虑该层全部投影时,代数模型成本为稠密模型的 $59/80=73.75\%$;FFN 节省 43.75% 经其他投影稀释后变成 26.25%。(Sec. 6,pp. 6–7,Eq. (29))
2.10 附录中的注意力扩展
附录 G 还定义了结构化 $QK^\top$,但小模型实验没有使用它。把单头维度分成 $q$ 个宽度 $m$ 的组,类型为 $i,j$ 的 query–key 对只取 $F(i,j)=\{i,j\}$ 中的组;相同类型时集合只有一项:
归一化由初始化时选中坐标独立、中心化、单位方差的假设推导。随后仍做 masked softmax 与稠密 $PV$。对 $M$ 个允许的 query–key 对,其中 $M_=$ 对端点类型相同,分数计算比例为
类型平衡的长序列趋近 $\rho_q$。由于 $PV$ 保留,注意力乘加的前向加速上限为 $2/(1+\rho_{\rm score})$;按反向重算分数的口径,训练上限为 $7/(3+4\rho_{\rm score})$。直接四组分别约为 $1.391\times,1.474\times$,递归四组为 $1.280\times,1.333\times$。
未来 query 的类型可能访问同一 key 的不同组,所以必须缓存完整 key;value 也完整保留。该扩展仍有线性增长的 KV 存储和逐 token 注意力成本。(App. G,PDF pp. 18–21,Eqs. (38)–(61)、Tables 14–15)
三:实验——分清算子、模型与比较预算
3.1 内核测试协议
算子测试使用一张 H200 NVL、合成 BF16 张量及 FP32 累加。稠密基线在校准阶段选择更快的 cuBLAS/cuBLASLt 路径;代数核校准 tile 与调度。两边都使用 CUDA Graph、预分配输出,并在独立的 12 次试验中交替执行顺序。
warm 测量重复回放相同图;cache-flushed 测量在计时之外访问 512 MiB 缓冲区后做一次回放。两者同时具有不同缓存复用和持续运行状态,不宜把差别完全归因于某一个硬件瓶颈。
初始形状覆盖五种公开 FFN 尺寸,$M\in\{1,32,512,2048\}$,$q\in\{4,8,16,32,64\}$。MoE 的 $M$ 是已经路由到某个专家的 token 数,测试不含派发、通信。扩展实验用 Qwen3-32B 的 $(K,N)=(5120,25600)$ 及其反向投影,增大 $M,q$;这些测试没有加载 Qwen/DeepSeek 的模型权重。(Sec. 7.1,p. 7;Apps. E–F,pp. 15–16)
3.2 小模型训练与数据
两个模型均为 110,631,168 个可训练参数,各训练一次。配置是 12 层 pre-norm decoder、$D=768$、32 个注意力头、$F=1536$ 的无偏置 SwiGLU、1536 上下文、GPT-2 BPE 词表 50,257 和可学习位置嵌入。只替换 FFN 的三个投影,注意力、embedding 和 LM head 保持稠密。
每个模型使用两张 H100,每卡 batch 40、100,000 步,合计 $100000\times2\times40\times1536=12.288$B token 槽位。使用 AdamW,峰值学习率 $3\times10^{-4}$,500 步 warmup,余弦降至峰值的 10%,weight decay 0.1,$\beta=(0.9,0.95)$,梯度范数裁剪 1.0。前后向 BF16 autocast,参数 FP32 存储。(Table 4、App. D.1,p. 13)
数据是公开指令数据混合,将 prompt 和 response 拼接后从头训练。来源包括 ReFusion、UltraData-SFT-2605、LaMini、代码、数学、俄语与指令遵循数据。清单统计的是导入记录数,不能直接当作最终 token 采样比例。作者按精确 query–response 对去重,再通过 3 字符 shingles 的 Jaccard 相似度、MinHash/LSH 候选和精确复查去除基准近重复,阈值为 0.80;代码样本还将回答片段与 MBPP 参考解比较。(App. I,pp. 23–24)
实际类型安排也与理论示例不同:训练实现对零起点位置使用
即每连续 192 个位置属于同一类型,四种类型周期为 768。内核微基准采用循环类型。递归等宽投影的 $9/16$ 乘加比例与类型频率无关,但位置依赖和各块的使用频率仍会影响训练行为。(App. D.5,p. 15)
3.3 吞吐与下游评测分别如何测量?
吞吐覆盖 Code、Math、QA、WMT 俄英翻译,每域 100 个独立 prompt;temperature 0.8、top-p 0.95、top-k 50、最多生成 256 tokens。每模型每域运行四次,剔除首次 warmup,对剩余三次取均值并以 Student t 分布给出 95% 置信区间。吞吐包括分词与采样。
下游评测则使用 lm-eval-harness 0.4.9.1,batch 1、BF16、最多生成 512 tokens;GSM8K 为 5-shot,MBPP 与 IFEval 为 zero-shot。GSM8K 衡量答案 exact match;MBPP pass@1 衡量单个生成程序通过测试的比例;IFEval 衡量可验证指令的满足情况,其层级标注问题见下节。下游结果越高越好。(Sec. 7.2,p. 8;Apps. D.2–D.4,p. 14)
四:结果——算术收益何时变成实际收益?
4.1 纯投影:形状越大,通常越能利用细分
下表为主文 Table 1 的选定组数结果。$q_*$ 是测试网格中 warm 延迟最低的候选,速度比为“稠密耗时 / 代数耗时”。
| 形状 | $M$ | $q_*$ | 稠密 / 代数,μs | warm / flushed 加速 |
|---|---|---|---|---|
| Qwen3-1.7B | 2048 | 32 | 75.7 / 24.9 | 3.04× / 2.84× |
| Qwen3-4B | 2048 | 32 | 160.6 / 51.1 | 3.14× / 2.94× |
| Qwen3-8B | 2048 | 32 | 320.7 / 63.6 | 5.04× / 4.52× |
| Qwen3-30B-A3B 单专家 | 2048 | 16 | 13.2 / 8.4 | 1.57× / 1.30× |
| DeepSeek-V3 单专家 | 2048 | 16 | 82.3 / 28.3 | 2.91× / 2.47× |
| Qwen3-32B | 2048 | 32 | 849.2 / 167.8 | 5.06× / 4.86× |
| Qwen3-32B | 8192 | 128 | 3337.4 / 400.7 | 8.33× / 8.60× |
| Qwen3-32B | 32768 | 256 | 13458.6 / 1169.4 | 11.51× / 11.70× |
最后一行的 $q=256$ 是网格上界;不能由此确定更大 $q$ 的表现。它们是不同乘法的纯投影耗时,不能解读为把现有 Qwen3-32B 无损替换后整体加速 11.51 倍。(Table 1,PDF p. 8)
扩展网格直接显示“组数更多”未必更快。以下是 $5120\to25600$ 投影的代数核 warm 耗时,单位 ms:
| $q$ | $M=2048$ | $M=8192$ | $M=32768$ |
|---|---|---|---|
| 32 | 0.168 | 0.583 | 2.335 |
| 64 | 0.232 | 0.523 | 2.055 |
| 128 | 0.248 | 0.401 | 1.558 |
| 256 | 0.266 | 0.414 | 1.169 |
反向形状 $25600\to5120$ 在三个 $M$ 上均以 $q=64$ 最快,分别为 0.147、0.396、1.519 ms。投影方向也影响最佳细分。选择一个具体模型架构时,不能把这些按负载分别选出的 $q$ 同时当作其运行时收益。(Table 12,p. 17)
4.2 完整 SwiGLU 与反向:一个重要失败案例
固定 $q=32$ 时,双方合并 gate/up 并使用同样的激活核。完整 SwiGLU 前向的 warm 加速与单个投影的训练加速如下:
| 形状 | 完整 FFN 前向,$M=1$ | 完整 FFN 前向,$M=2048$ | 投影前向+$dX$+$dW$,up / down,$M=2048$ |
|---|---|---|---|
| Qwen3-1.7B | 3.45× | 2.55× | 1.27× / 1.76× |
| Qwen3-4B | 4.74× | 2.78× | 1.33× / 1.66× |
| Qwen3-8B | 6.64× | 4.17× | 1.96× / 2.56× |
| Qwen3-30B-A3B 单专家 | 1.71× | 1.74× | 0.65× / 0.57× |
| DeepSeek-V3 单专家 | 3.94× | 3.74× | 1.79× / 1.35× |
小型 Qwen 专家的 up 从 40.0 μs 增至 61.4 μs,down 从 38.5 μs 增至 67.6 μs。尽管理论上前向和两个梯度都节省乘加,实际 backward 实现仍可能抵消收益。此处梯度核使用固定 tile,仅前向做了调优。$M=1$ 的 warm 回放还重复同一类型,其完整序列行为需要实际解码测量。(Tables 9–10,p. 16;App. E,p. 15)
固定 $q=32$ 的纯扩展投影另在 Table 11(p. 17)报告。例如 Qwen3-8B 的 $M=1$ 为 7.07× / 4.14×(warm / flushed);这进一步显示缓存复用会显著改变小批量收益。
4.3 固定叶块:二次算术具有有限尺寸的计时证据
| $n$ | $q=n/128$ | 稠密 ms($b=128$ 对照) | 代数 ms,$b=128$ | 代数 ms,$b=256$ | $b=128$ warm 加速 |
|---|---|---|---|---|---|
| 4096 | 32 | 0.210 | 0.044 | 0.058 | 4.81× |
| 8192 | 64 | 1.773 | 0.166 | 0.225 | 10.69× |
| 16384 | 128 | 13.881 | 0.689 | 0.991 | 20.15× |
| 32768 | 256 | 114.265 | 2.868 | 5.344 | 39.85× |
速度比保留原表报告值;表中延迟已四舍五入,直接相除可能略有不同。$b=256$ 的稠密对照在原表中独立测量,不能用本表的 $b=128$ 对照重新计算它的速度比。
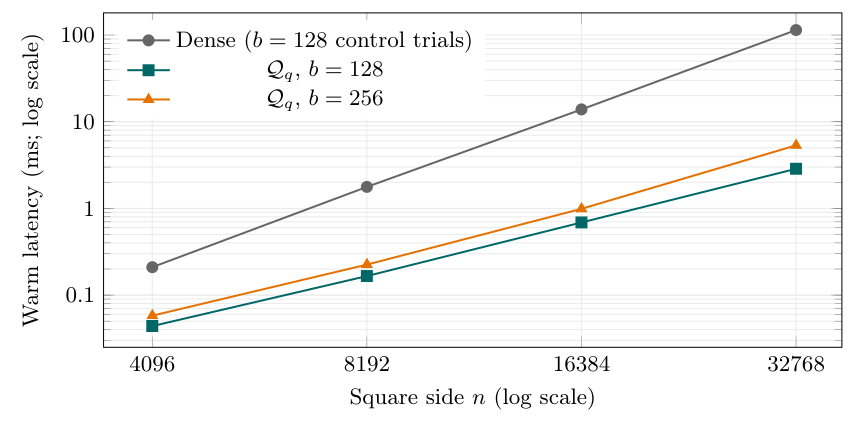
根据原文 Table 13(PDF p. 18)重绘。横纵轴均采用对数刻度;灰线是 $b=128$ 试验对应的稠密对照,绿线、橙线分别是叶块为 128、256 的代数乘法。曲线斜率展示随尺寸增长的耗时趋势。
在这四个尺寸上,$b=128$ 代数耗时的端点 log–log 斜率约为 2.01,符合二次增长趋势。这是合成平方乘法的有限尺寸证据;由于 $q$ 随 $n$ 增大,不能推出语言模型保持质量时也具有同样缩放。(App. F,pp. 16–18,Table 13)
4.4 语言模型损失:可收敛,但损失差距持续存在
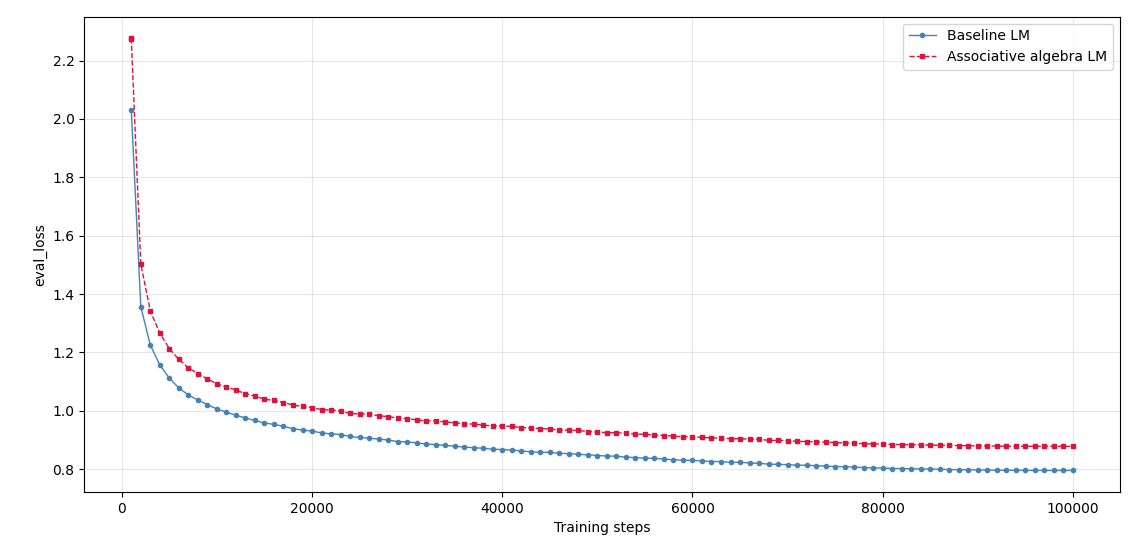
来源:原文 Fig. 1,PDF p. 13,使用作者原始图件。横轴为训练步数,纵轴为 evaluation loss;蓝实线是稠密基线,红虚线是代数模型。
两条曲线均持续下降,说明递归层能按该配方训练;代数模型在图示过程中一直具有更高损失。末端从图上约读为 0.80 与 0.88,属于视觉近似值,论文没有在表中提供相应精确终值。该差距与下游任务退化的方向一致。
4.5 端到端生成吞吐:约 7%,且输出长度不同
| 领域 | 稠密 tok/s,均值±95% CI 半宽 | 代数 tok/s,均值±95% CI 半宽 | 相对增益 |
|---|---|---|---|
| Code | 987.8 ± 1.0 | 1054.5 ± 2.2 | 6.8% |
| Math | 991.4 ± 5.0 | 1060.6 ± 3.8 | 7.0% |
| QA | 958.6 ± 11.0 | 1033.1 ± 3.5 | 7.8% |
| WMT ru–en | 985.9 ± 5.2 | 1047.1 ± 2.6 | 6.2% |
原文报告四域吞吐比的非加权均值为 1.070;按表中吞吐均值复算约为 1.0693,即平均提升约 6.93%。这里存在轻微数字差异,两者均支持“约 7%”的表述。置信区间来自每个已训练模型的三次计时,不是独立训练模型之间的变化范围。(Table 2,p. 8;Tables 5–7,pp. 14–15)
两个模型并未生成相同长度:Code 平均 195.5→182.4 tokens,Math 223.8→227.8,QA 92.6→110.8,翻译 190.0→204.9。因而表格描述真实生成负载的结果。若要单独估计层替换造成的延迟变化,需要固定长度、重复整模型计时。
FFN 算术节省 43.75%,整层投影只节省 26.25%,再加上注意力、LM head、访存、分词和采样,约 7% 的最终吞吐增益与这些额外成本相容;不能把 43.75% 直接当作整模型加速幅度。(Sec. 6.3、9,pp. 7、9)
4.6 下游质量:三项均下降,IFEval 名称存在冲突
下表以百分数表示,$\pm$ 为任务评测标准误(SE),不是 95% 置信区间。差值为“代数−稠密”,单位是百分点。
| 任务及指标 | 稠密 | 代数 | 差值 |
|---|---|---|---|
| GSM8K,flexible-extract EM | 3.18 ± 0.48 | 2.20 ± 0.40 | −0.98 |
| MBPP,pass@1 | 6.60 ± 1.11 | 3.80 ± 0.86 | −2.80 |
| IFEval,loose accuracy,按附录数值 | 34.53 | 31.06 | −3.47 |
来源:Table 8,PDF p. 15。附录给出的未舍入 IFEval 输出为 0.345324 和 0.310552,差约 −3.4772 个百分点;主文 Table 3(p. 9)把得分舍入为 34.5 与 31.1,文字据此写差 3.4 个百分点。
v1 的指标名称不一致:主文 Table 3 写 “Instance, loose”,附录 Table 8 写 “Instruction-level loose accuracy”。实例级与指令级的统计单位不同,不能将二者等同。本笔记保留附录数值及其标签,同时标出这一歧义;仅凭论文无法确认实际评测键。两处数值都支持代数模型较低这一方向结论。
模型仅各训练一次,任务标准误不能衡量训练随机性的波动。这一小规模结果最直接支持“可训练且生成更快,但质量有代价”,不支持等质量或等训练时间下更优。(Secs. 7.2、9,pp. 8–9;App. D.4,pp. 14–15)
五:结论与研究启发
本文将“参数库存”与“单次计算的交互密度”分开,并把这种选择纳入可证明的代数结构。直接图代数有精确秩和清楚的缩放公式;位置类型把完整代数落到逐 token 的矩形投影上,解决了因果性与缓存的一致性问题;内核实验则展示算术优势如何受形状和反向实现制约。
最值得保留的机制理解是:省计算来自改变每个位置可以使用的特征交互,参数数目保持不变并不能抵消这一限制。 递归构造保留更多交互,却比直接四组贵;大组数虽然能大幅降低计算,但非对角块被某类位置使用的频率也更低。现有模型证据显示了这一设计的成本,而不是绕过了成本。
以下是本次分析提出的后续实验,尚不是论文结果:
- 在相同模型、数据和训练预算下直接比较 $\mathcal Q_4$ 与 $\mathcal Q_2^{\otimes2}$,衡量额外八个全表块乘积换回了多少质量。
- 固定生成长度,并同时报告全模型延迟、训练吞吐与任务分数,建立等质量下的成本曲线;重点检查小型专家层的反向瓶颈。
- 比较循环类型、192-token 分段类型及跨层类型安排,判断位置相关的权重使用模式对优化和泛化的影响。
若用于组会讨论,核心问题是:在某个实际任务的质量要求下,怎样选择交互表与组数,才能让减少的计算量超过恢复质量所需的额外训练成本?