DepthBench:残差连接如何把网络层数转化为有效计算深度
论文:DepthBench: Measuring How Residual Connections Enable More Computational Depth
作者:Keyu Wang、Yangyi Huang、Jiale Kang、David González-Martínez、Weiyang Liu、Shiwei Liu。前两位为共同第一作者。
版本:arXiv:2609.32534v1,2026-09-26 提交;本次获取与研读日期:2026-10-19。
原文:arXiv v1 · 本地 PDF
配套成品:英文汇报 PDF · 可编辑 Beamer 源码
作者提供的资源入口:代码 · 模型检查点。
论文总览
DepthBench 研究的是一个容量分配问题:参数预算相近时,把模型做得更深、更窄,什么样的残差结构能让增加的层真正有用? 作者将十种架构放在共同的 LLaMA 类骨干与预训练配方下,扫描宽深比,并结合表示距离、跳层干预、换层顺序、删层和 LogitLens 分析深度利用。
400M 主实验中,从 16 层、宽度 1216 改为 32 层、宽度 896,Pre-LN 的验证损失从 2.759 升到 2.782;Full AttnRes 从 2.751 降到 2.718,HC 从 2.729 降到 2.699。后两者的优势伴随更强的跨层依赖与顺序敏感性。其共同特点是让早期计算结果保持可区分、可重新组合:Full AttnRes 直接读取历史子层输出,HC 通过多个残差流递归传播和重组信息。[Sec. 3–4.2,PDF pp. 5–11]
结论需要连同具体曲线理解。HC 在 1.6B 上没有延续清晰的深度收益;固定骨干参数的曲线并非一路单调改善;更深的模型还增加 prefill 计算、KV 缓存和运行时间。论文最有价值的贡献,是将残差结构、宽深分配、优化条件和系统成本放进同一个比较框架,而不是给出一个通用的最佳层数。
结构地图
以下页码均为从 1 开始的 PDF 页码,与本文印刷页码一致。
| 原文章节 | 作用 | PDF 位置 |
|---|---|---|
| 1. Introduction | 区分可训练性与有效计算深度 | pp. 2–3 |
| 2. Preliminaries & Setup | 架构分类、宽深比控制和训练设置 | pp. 3–5;Tables 1–4 |
| 3. Main Results | 主规模、固定骨干、跨规模、领域 NLL | pp. 5–7;Figs. 2–4 |
| 4.1. Evaluating Depth Utilization Across Architectures | 表示角距离、因果分数、换层分数 | pp. 7–10;Figs. 5–6;Eqs. (2)–(8) |
| 4.2. Characterizing Depth Processing in Full AttnRes and HC | 显式残差路径、删层、LogitLens | pp. 10–11;Figs. 7–8 |
| 4.3. Potential Hidden Cost for mHC and Block AttnRes | 块混合的早期低利用区、多流传播的秩下降 | pp. 11–13;Figs. 9–10 |
| 4.4. No Free Lunch: The Accuracy–Efficiency Trade-off of Depth Scaling | prefill、缓存、显存和运行成本 | pp. 13–14;Fig. 11 |
| 5. Related Work;6. Conclusion | 与深度训练、模型形状和残差研究的关系 | pp. 14–15 |
| Appendix A. Architecture-specific Settings | 各架构实现、初始化、额外参数 | pp. 19–20;Tables 5–6 |
| Appendix B. Complete Model Configurations | 固定骨干、200M–500M、1.6B 配置 | pp. 21–22;Tables 7–9 |
| Appendix C. Learning Rates & Their Impact | 学习率选择及其对表示诊断的影响 | pp. 22–23;Figs. 12–13 |
| Appendix D. FLOP Accounting | 前向 FLOPs 计数口径 | pp. 23–24 |
| Appendix E. Complete Results of Causal Score, Permutation Score and Angular Distance | 16、24、32 层的完整诊断热图 | pp. 24–27;Figs. 14–16 |
一:动机——模型能够训练,不代表新增层带来了有用计算
标准 Pre-LN 的子层更新为
其中 $F_\ell$ 是注意力或前馈变换,本文多数架构中的 LN 实际使用 RMSNorm。恒等残差路径改善梯度传播,使较深网络可以训练;但它没有单独要求后层执行新的、不可替代的计算。[Eq. (1),PDF p. 3]
可以把连续残差累加理解为:历史更新都进入同一个状态,新层只能从这个总和中获取信息。如果后期更新相对已有状态很小,或不同层都在做类似修正,那么增加层数与增加有效顺序计算之间就会脱节。论文所说的“深度诅咒”指向这种弱化、冗余与同质化,而不只是梯度爆炸或训练失败。
已有方法改善归一化、缩放或残差传播,但不同论文往往使用不同模型规模、数据和训练配方。单看“某方法损失更低”,无法判断收益来自更好的优化、更多参数,还是确实更会利用深度。因此本论文同时考察两件事:一是固定参数时该架构偏好什么形状,二是其后层是否表现出更有区别的功能。
需要抓住实验设计的含义:在固定宽度下增加层数,是同时增加容量;DepthBench 则主要研究用宽度换深度。其结果对应宽深分配的联合变化,并没有独立固定宽度、head dimension 等所有因素。它是一项受控的架构实证研究,核心产物是评测框架和机制证据。[Sec. 1–2.2,PDF pp. 2–5]
二:方法——改变形状,再检查层之间怎样协作
2.1 宽深比与两个参数预算
令
$r$ 越小,模型通常越深越窄。对本文 sub-1B 的 MHA 骨干,忽略少量归一化和路由参数,参数数目近似为
$12Ld^2$ 来自注意力投影与 SwiGLU 前馈矩阵;$2Vd$ 来自不共享权重的输入 embedding 与输出 LM head。该近似用于解释小模型的预算关系;1.6B 使用 GQA 和不同 FFN 比例,不能原样套用同一系数。[Sec. 2.2,PDF pp. 4–5]
这里有一个关键混杂:固定总参数时,缩小 $d$ 会减少 embedding/head 参数,从而把更多预算留给 Transformer 骨干。Table 3 中,16 层模型的骨干约为 284M,70 层模型约为 345M。作者因此增加固定约 300M 骨干的实验,让 embedding/head 随宽度自然变化。这能检验收益是否仅仅来自骨干变大。
主规模的七个形状如下;数值按 Table 3 抄录。
| $L$ | $d$ | $d/L$ | 骨干参数 | 总参数 |
|---|---|---|---|---|
| 16 | 1216 | 76.00 | 284M | 407M |
| 20 | 1120 | 56.00 | 301M | 414M |
| 24 | 1024 | 42.67 | 302M | 405M |
| 28 | 960 | 34.29 | 310M | 406M |
| 32 | 896 | 28.00 | 309M | 399M |
| 42 | 800 | 19.05 | 324M | 404M |
| 70 | 640 | 9.14 | 345M | 409M |
这是近似匹配,存在离散宽度和额外模块带来的偏差。十架构的完整主对照展示在 16–32 层五个形状上;更深形状与固定骨干实验主要展示 Pre-LN、Full AttnRes 和 HC,不能把实验概述理解为每种架构都展示了全部七点。[Table 3,PDF p. 5;Fig. 2,PDF p. 6]
2.2 十种架构究竟改了什么
| 类别 | 架构 | 相对基线的主要变化 |
|---|---|---|
| 基线 | Pre-LN | 单个残差流,固定加法累积 |
| 归一化 | Sandwich-LN | 分支输入、输出都归一化 |
| 归一化 | LNS | 第 $\ell$ 个 block 的两个分支输入都乘 $1/\sqrt{\ell}$ |
| 归一化 | DeepNorm | Post-LN、放大残差、配套深度相关初始化 |
| 归一化 | KEEL | pre/post norm 与较大的残差增益结合 |
| 多流残差 | HC | 多个残差流,动态读、写、流间混合 |
| 多流残差 | mHC | 在 HC 上加入非负读写和近似双随机传播约束 |
| 跨层访问 | Full AttnRes | 对所有历史子层原始输出做深度注意力 |
| 跨层访问 | Block AttnRes | 对历史块内累加结果及当前运行和做深度注意力 |
| 跨层访问 | MoDA | 注意力同时访问序列 KV 和早期层同 token 的深度 KV |
来源:Table 1,PDF p. 4;Appendix A,PDF pp. 19–20。
归一化组仍主要从一个递归状态读取信息。举例说,LNS 把分支更新改成 $F_\ell(\ell^{-1/2}\mathrm{LN}(h_{\ell-1}))$;DeepNorm 使用 $\mathrm{LN}(\alpha h_{\ell-1}+F_\ell(h_{\ell-1}))$,其中 $\alpha=(2L)^{1/4}$;KEEL 把分支 pre-norm 与外层 post-norm 结合,残差增益按子层数设定,并对首个 block 特殊处理。它们主要改变尺度、梯度与优化条件。
MoDA 的跨层访问发生在注意力 KV 路径,仍保留加法残差。本文采用 Pre-LN MoDA:在共同配方下,24 层的 Pre-LN 版本最佳验证损失为 2.764,Post-LN 版本最佳测试结果为 2.912。因此这里比较的并非原 MoDA 论文偏好的 Post-LN 配方。[Table 5,PDF p. 20]
2.3 Full AttnRes:给过去的计算保留独立入口
对一个 token,设 $v_0$ 为 embedding,$v_i$ 为第 $i$ 个历史子层的原始分支输出。按 Appendix A 的实现描述,可以将一次读取写成
这里用 $z_\ell$ 区分混合后的输入,用 $f_\ell$ 表示新分支输出,是对实现的整理表达。$w_\ell\in\mathbb R^d$ 是每个子层学习的 query,key 是归一化后的历史来源;分数不除以 $\sqrt d$,softmax 温度为 1。query 初始化为零,因而初始时对来源均匀平均。首个注意力子层直接读 embedding;最终 LM head 也有独立混合读取。[Appendix A,PDF p. 19]
关键是保存的来源为各子层分支输出,而非一串已经累计了所有前驱的残差状态。后层可以重新选取某次早期计算,不必只依赖其多次被相加后的痕迹。权重由 token 的来源表示决定,因此即使 query 是学习参数,最终混合仍是输入相关的。权重非负且归一化。
代价也随之明确:来源数随深度增加,所有层的来源评分和混合总量约按 $L^2$ 增长,显式保存历史输出也增加激活存储压力。
2.4 HC:把“历史的不同成分”沿多个流传下去
在单 token 的列流记法下,令 $H_\ell\in\mathbb R^{d\times m}$,本文 $m=4$。更新为
$A_\ell\in\mathbb R^{m\times m}$ 混合已有流;$\alpha_\ell\in\mathbb R^m$ 读取流,得到 $d$ 维分支输入;$\beta_\ell\in\mathbb R^m$ 将新的 $d$ 维输出写回多个流。本文用静态系数加输入相关的 tanh 修正实现路由,初始传播矩阵为单位阵。embedding 复制到四个流,最终对四流求和,再过 RMSNorm 与 LM head。[Table 1,PDF p. 4;Appendix A,PDF p. 20]
沿给定前向过程展开显式残差路径,早期分支 $f_i$ 对后来分支输入的系数为
它依次经过“写入—中间流混合—读取”。与 Full AttnRes 的直接历史检索不同,HC 靠递归传播组合历史信息;系数也没有被要求成为 softmax 概率。由于路由本身依赖状态,这个路径系数描述实际前向中的显式线性传播通路,并不等于模型的完整输入输出 Jacobian。[Sec. 4.2,PDF pp. 10–11]
2.5 Block AttnRes 与 mHC 的设计取舍
Block AttnRes 将每组子层输出相加成一个保存来源。本文固定约 8 个块,块长按子层计为 $b=2L/8$;例如 32 个 Transformer block 对应 64 个子层,每块 8 个子层。每次读取结合 embedding、已冻结的块和当前未完成块的运行和。不同子层在同一块内被合并后,后层的独立选择粒度随之变粗。[Appendix A,PDF p. 19]
mHC 则保留四流结构,但读取权重取 sigmoid、写入权重取两倍 sigmoid,$A_\ell$ 经 20 次 Sinkhorn–Knopp 迭代成为近似双随机矩阵。读写非负,传播更受约束。本文采用接近单位传播的 GAP-8 初始化,并对部分路由运算使用 FP32;这说明比较对象是具体实现,不能只看“HC/mHC”名称。[Appendix A,PDF p. 20]
2.6 怎样测量“层在做什么”
论文没有用单个分数把层数换算成“有效层数”,而是组合多个诊断。
表示角距离:
值域为 $[0,1]$,越小表示方向越接近。它对整体正缩放不敏感,适合观察表示是否在深层趋同。HC/mHC 拼接四流作为探针状态,AttnRes 使用深度混合后的状态。热图横轴为起始层 $\ell$,纵轴为距离 $n$,并非直接把终点层编号作为纵轴。[Eq. (2),PDF p. 8]
因果分数:跳过层 $s$ 后,比较后层 $\ell$ 的更新变化:
带横线的状态来自跳层运行。分子测更新向量的扰动,分母按原更新量归一化。分数大意味着后层计算依赖被跳过层;它衡量的是内部更新的相对变化,不是任务准确率损失。[Eq. (3),PDF p. 9]
换层分数:交换两层顺序后,度量语言建模损失的相对变化:
分数大表示两层不易互换。原文将其解释为性能退化,但公式带绝对值,严格含义是变化幅度;损失改善也会被计为非零。两种干预分别考察依赖性与顺序特殊性。[Eq. (4),PDF p. 9]
为避免普遍重要的前几层主导统计,作者只统计后 $3/4$ 网络中的层对:
$R_{\mathrm{perm}}$ 对满足同样后段约束的 $\ell_1<\ell_2$ 层对,统计 $P>0.15$ 的比例。这里统计的是超过指定阈值的层对比例,既不是有效层数占比,也不是相对于基线的性能提升百分比。[Eqs. (5)–(8),PDF pp. 9–10]
三:实验——控制了哪些条件,测量了哪些结果
3.1 四组互补实验
| 实验 | 参数口径与形状 | 主要检验问题 |
|---|---|---|
| 400M 主实验 | 约 400M 总参数;十架构的主要对照为 16–32 层,并向更深形状扩展 | 架构是否改变宽深偏好 |
| 固定骨干 | 约 300M 骨干;$L=16,24,32,42,70,84$ 的配置池 | 改善是否只来自骨干参数增加 |
| 跨规模 | 200M、300M、400M、500M;宽深比约 28、43、76 | 趋势是否依赖单一规模 |
| 更大规模 | 约 1.6B;$(L,d)=(28,2048),(40,1728),(54,1504)$ | 趋势是否延续到更大模型 |
来源:Table 2,PDF p. 4;Tables 7–9,PDF pp. 21–22。配置表给出可用形状,并不意味着每条结果曲线都有所有点。
sub-1B 使用 16 头 MHA、RoPE、RMSNorm、SwiGLU;FFN 中间宽度为向上取整到 16 倍数的 $8d/3$。1.6B 改用 16 query heads、8 KV heads 的 GQA,$d_{\mathrm{ff}}=3d$。因此跨规模实验同时跨越了注意力配置,不能只把它看作同一计算图的等比放大。[Sec. 2.2,PDF pp. 4–5]
3.2 预训练与学习率
从头在 FineWeb-Edu 上训练,另留不重叠验证集。训练 token 预算按约 20 tokens/parameter 设定:200M–500M 分别使用 4B、6B、8B、10B tokens,1.6B 使用 32B。上下文长度为 2048,全局 batch 为 512 序列,即每步约 1M tokens。
AdamW 使用 $(\beta_1,\beta_2)=(0.9,0.95)$、$\epsilon=10^{-8}$、weight decay 0.1、梯度裁剪 1.0;学习率先用 10% 步数 warmup,再 cosine 衰减到峰值的 10%。各架构必要的初始化差异在 Appendix A 单独给出。
400M 实验扫描架构相关学习率:多数方法最佳为 $2\times10^{-3}$,DeepNorm 为 $10^{-3}$,LNS 为 $10^{-2}$。固定骨干与 200M–500M 实验复用这些选择,1.6B 统一使用 $5\times10^{-4}$。[Sec. 2.3,PDF p. 5;Table 4]
主结果不是简单地把所有方法塞进同一学习率。但“每个方法都充分独立调参”仍需具体看实现:Block AttnRes 复用 Full AttnRes 的最佳学习率;mHC 扫描用的是较早的近均匀初始化,主结果用 GAP-8。它们直接影响优化条件解释。[Fig. 12 图注,PDF p. 22]
3.3 指标分别回答什么
| 指标或实验 | 数据/对象 | 方向与含义 |
|---|---|---|
| 验证损失 | held-out FineWeb-Edu | 越低越好,衡量语言建模预测 |
| 领域 NLL | coding:MBPP、HumanEval;STEM:SciQ、GPQA;math:GSM8K、MATH-500 | teacher-forced NLL 越低越好;每个类别平均两项任务 |
| 角距离 | 不同深度的探针表示 | 距离及结构描述表示变化,本身没有越大必然越好的结论 |
| 跳层/换层 | 模型层对 | 依赖和顺序敏感性 |
| 单层剪除 | ARC-Easy | 准确率下降反映该层的任务重要性 |
| LogitLens | 中间预测与最终预测 | $D_{\mathrm{KL}}(p_{\mathrm{final}}\Vert p_{\mathrm{probe}})$ 描述输出分布的演变 |
| 系统成本 | 400M、prefill 4096、BF16、A100-SXM4-40GB | FLOPs、KV/峰值显存、每 1B prefill tokens 的 GPU-hours |
领域评测在给定参考序列前缀下计算似然,没有报告相应生成任务的 pass@1 或答对率。ARC-Easy 的准确率实验则是另一个删层诊断,不能与领域 NLL 混成同一种性能证据。[Figs. 4、8、11,PDF pp. 7、11、13]
四:结果——深度偏好、计算机制与成本
4.1 主结果:残差设计改变了用宽度换深度的效果
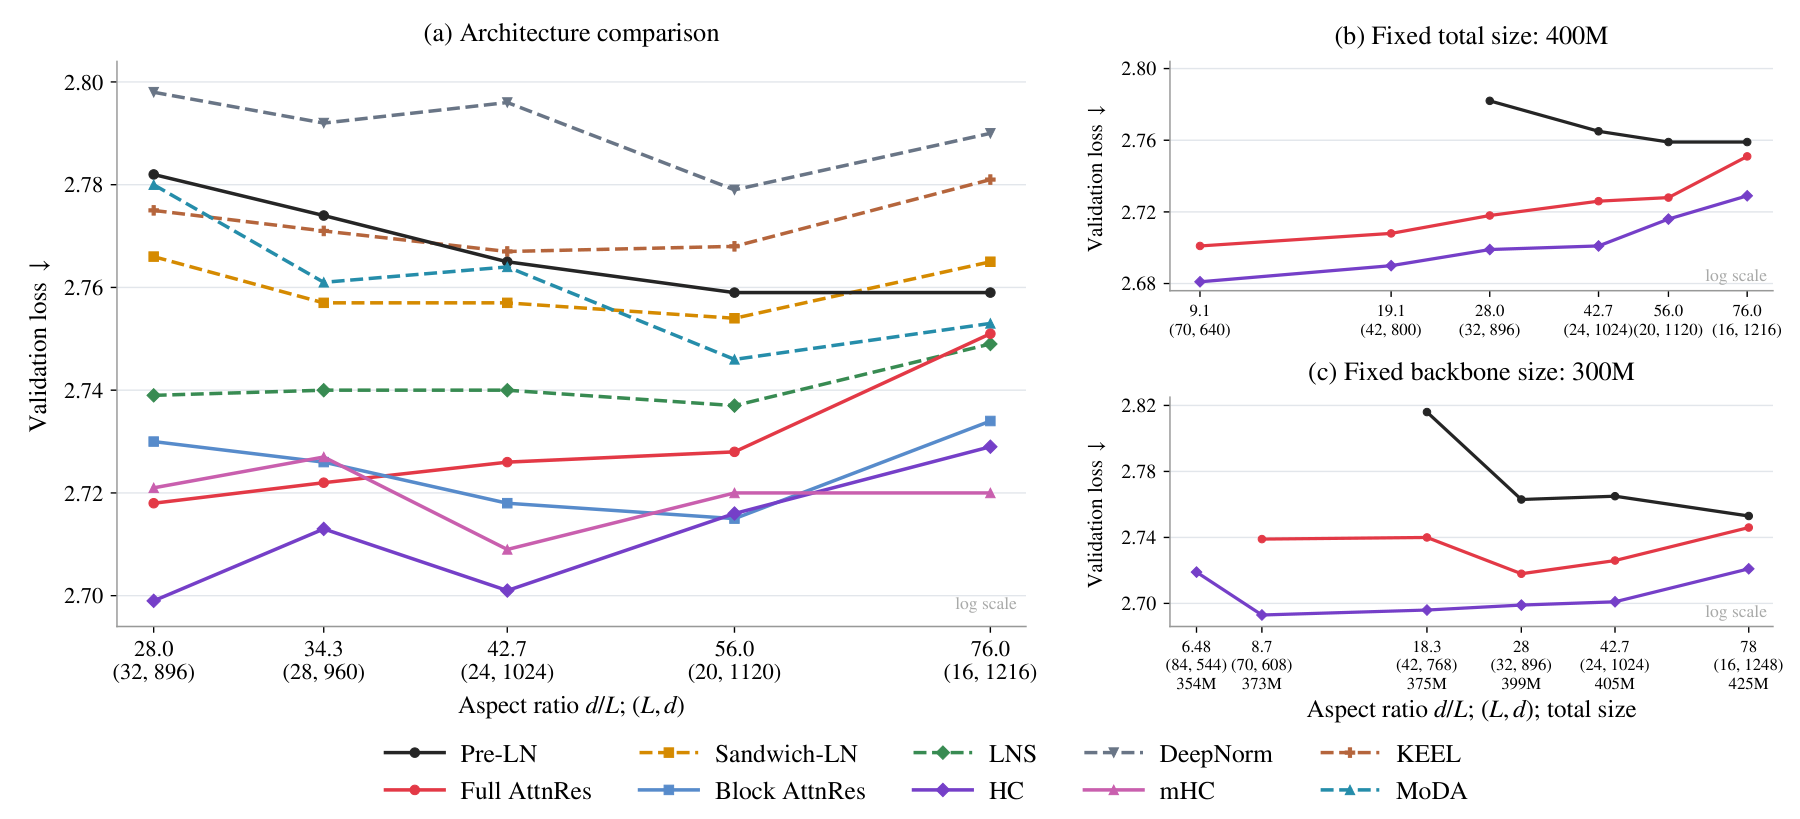
来源:原文 Fig. 2,PDF p. 6。纵轴为验证损失,越低越好;横轴宽深比由左到右增加,所以往左才是更深更窄。左图比较十架构,右上固定总参数,右下固定骨干参数;右下同时标出实际总参数。
| 架构 | $L=16$ 验证损失 | $L=32$ 验证损失 | 后者减前者 |
|---|---|---|---|
| Pre-LN | 2.759 | 2.782 | +0.023 |
| Full AttnRes | 2.751 | 2.718 | −0.033 |
| HC | 2.729 | 2.699 | −0.030 |
这些是原文正文报告的数值及其差值,不是百分点。32 层时,Full AttnRes 与 HC 相比同形状 Pre-LN 分别低 0.064、0.083。Block AttnRes 在 $L=20$ 达到 2.715,随后到 $L=32$ 变为 2.730;mHC 最佳点位于 $L=24$。这显示“某个形状表现好”与“随着加深持续获益”是两种不同性质。[Sec. 3,PDF pp. 5–6]
Sandwich-LN、LNS、DeepNorm、KEEL 和 MoDA 的形状曲线多为较弱或非单调趋势。LNS 在更高学习率下整体表现改善,但没有出现 Full AttnRes 那种清晰的深度偏好。因此,仅改善归一化和优化并不自动带来更好的容量分配。
需要修正正文的“持续改善”措辞。 Fig. 2(a) 中 HC 的中间点有反弹,并非每增加几层都改善。Fig. 2(b) 在固定总参数的更深范围内支持 HC 与 Full AttnRes 的继续获益;但 Fig. 2(c) 的固定骨干实验呈现明显最优点:Full AttnRes 在约 32 层后没有继续改善,HC 从 70 层到 84 层也变差。固定骨干对照支持“部分深形状的优势不能只用骨干增大解释”,却不能支持“相同骨干下无限加深会一直更好”。
4.2 跨规模和领域评测:Full AttnRes 更稳定,HC 有明确失败情形
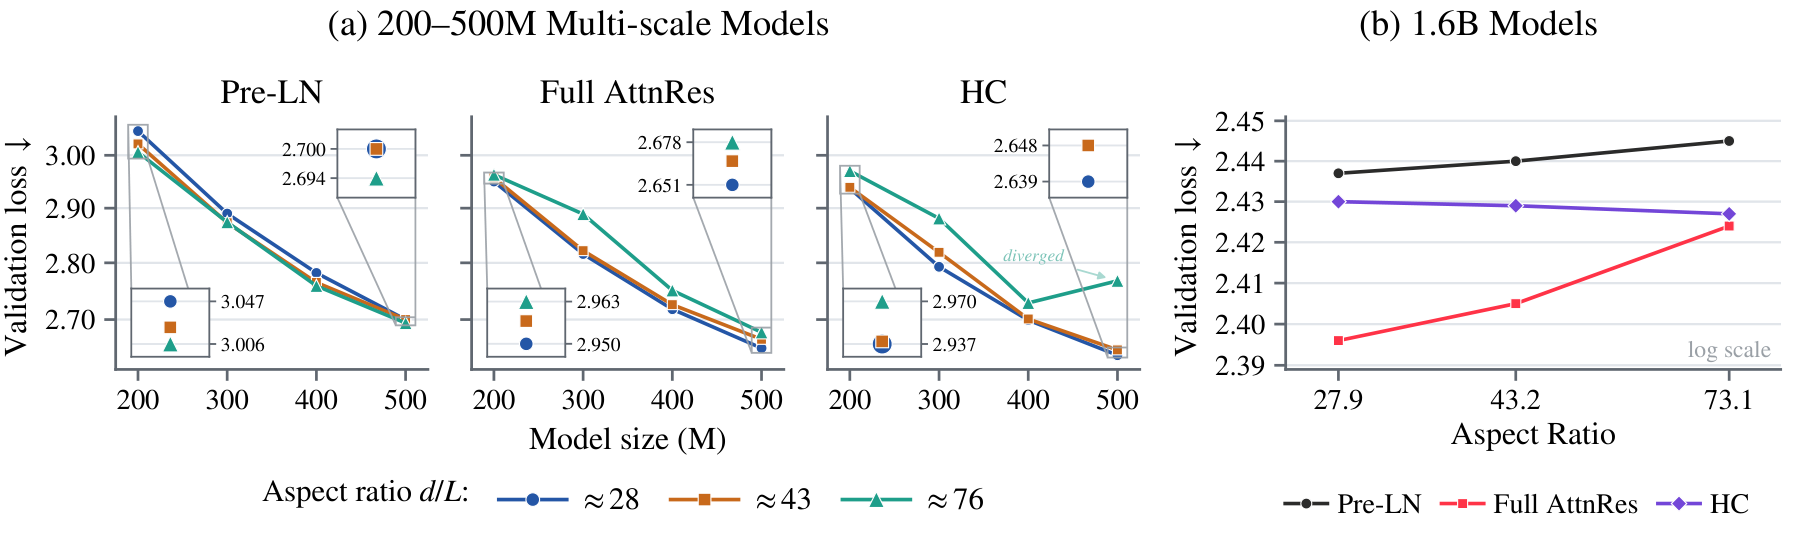
来源:原文 Fig. 3,PDF p. 7。左侧各面板横轴为模型规模,三条线对应约 28、43、76 的宽深比;右侧固定约 1.6B,横轴直接为宽深比。
Full AttnRes 的更深形状优势在 200M–500M 与 1.6B 上延续。HC 的情况更复杂:500M 最大宽深比运行出现梯度爆炸;1.6B 上其深形状没有清晰收益。作者认为这可能来自 HC 的优化敏感性,需要更细学习率选择;这里的敏感性解释与图中失败结果应分别看待,本文没有通过重新调参后的匹配实验彻底消除它。[Sec. 3,PDF p. 6]
还有一个容易忽略的细节:1.6B 的 Pre-LN 曲线本身也出现轻微的深形状改善。因此“Pre-LN 加深一定变差”同样不是跨规模结论。Full AttnRes 在该面板中体现的是更强的收益幅度和更低的验证损失。
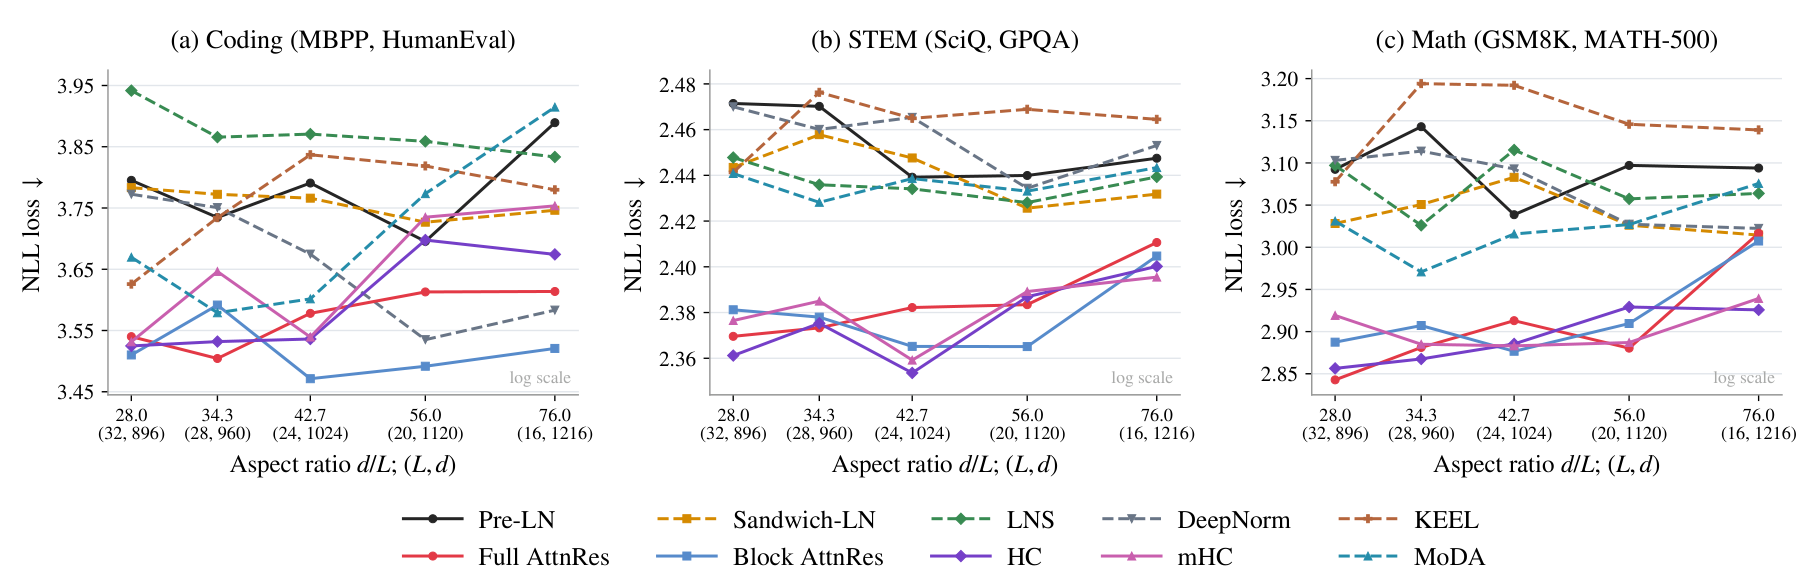
来源:原文 Fig. 4,PDF p. 7。三个面板分别对该领域的两项任务平均 NLL,所有纵轴都是越低越好。
更深的 HC 和 Full AttnRes 整体上有更好的领域预测能力,STEM 和数学的端点对比尤其明显。不过,具体中间点存在反弹,coding 也不是统一单调曲线;Block AttnRes 在一些 coding 形状上相当有竞争力。可靠的解读是:主验证集上的收益能够延伸到这些参考答案的预测似然,而不是所有方法在所有领域有同一排序。
4.3 层级诊断:不仅变化更多,还更依赖特定前驱与顺序
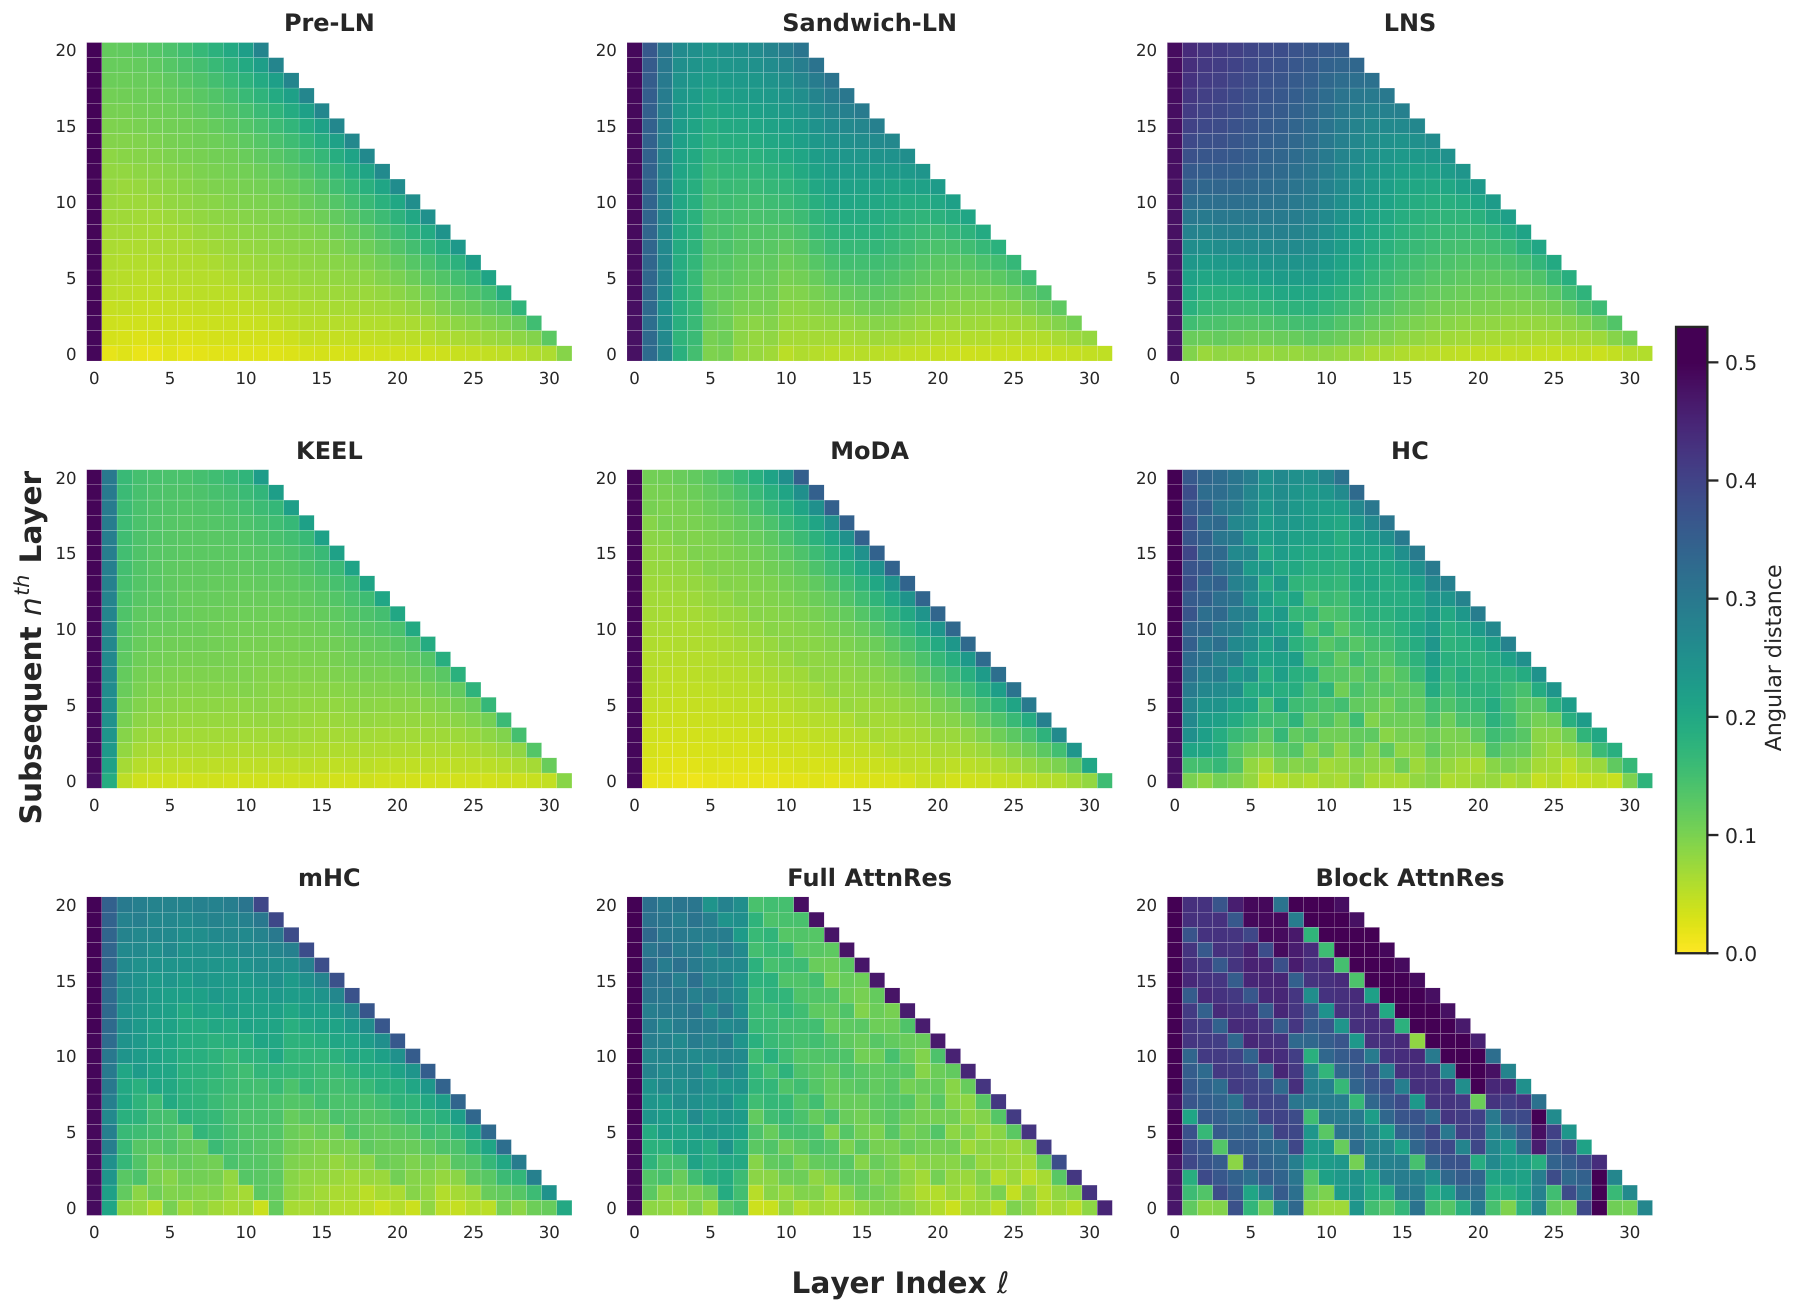
来源:原文 Fig. 5,PDF p. 8。黄色表示方向接近,蓝紫色表示更远;横轴为起始层,纵轴为向后的层数间隔。
Pre-LN 的后层表示趋于平滑、接近。HC 与 Full AttnRes 保留更多局部非平滑结构,Block AttnRes 则呈现明显的块边界纹理。作者强调的不只是距离绝对值更大,而是不同层具有更不均匀、更有特性的变换。
这张图统一使用 $2\times10^{-3}$ 学习率,LNS 并非在自身最优学习率下展示;DeepNorm 在此学习率发生爆炸,因此从主图排除。Appendix C 的 Fig. 13 显示,学习率会显著改变角距离图案。所以角距离图适合提供表示结构的线索,不能单独用来决定哪个架构更会计算。[PDF pp. 8、22–23]
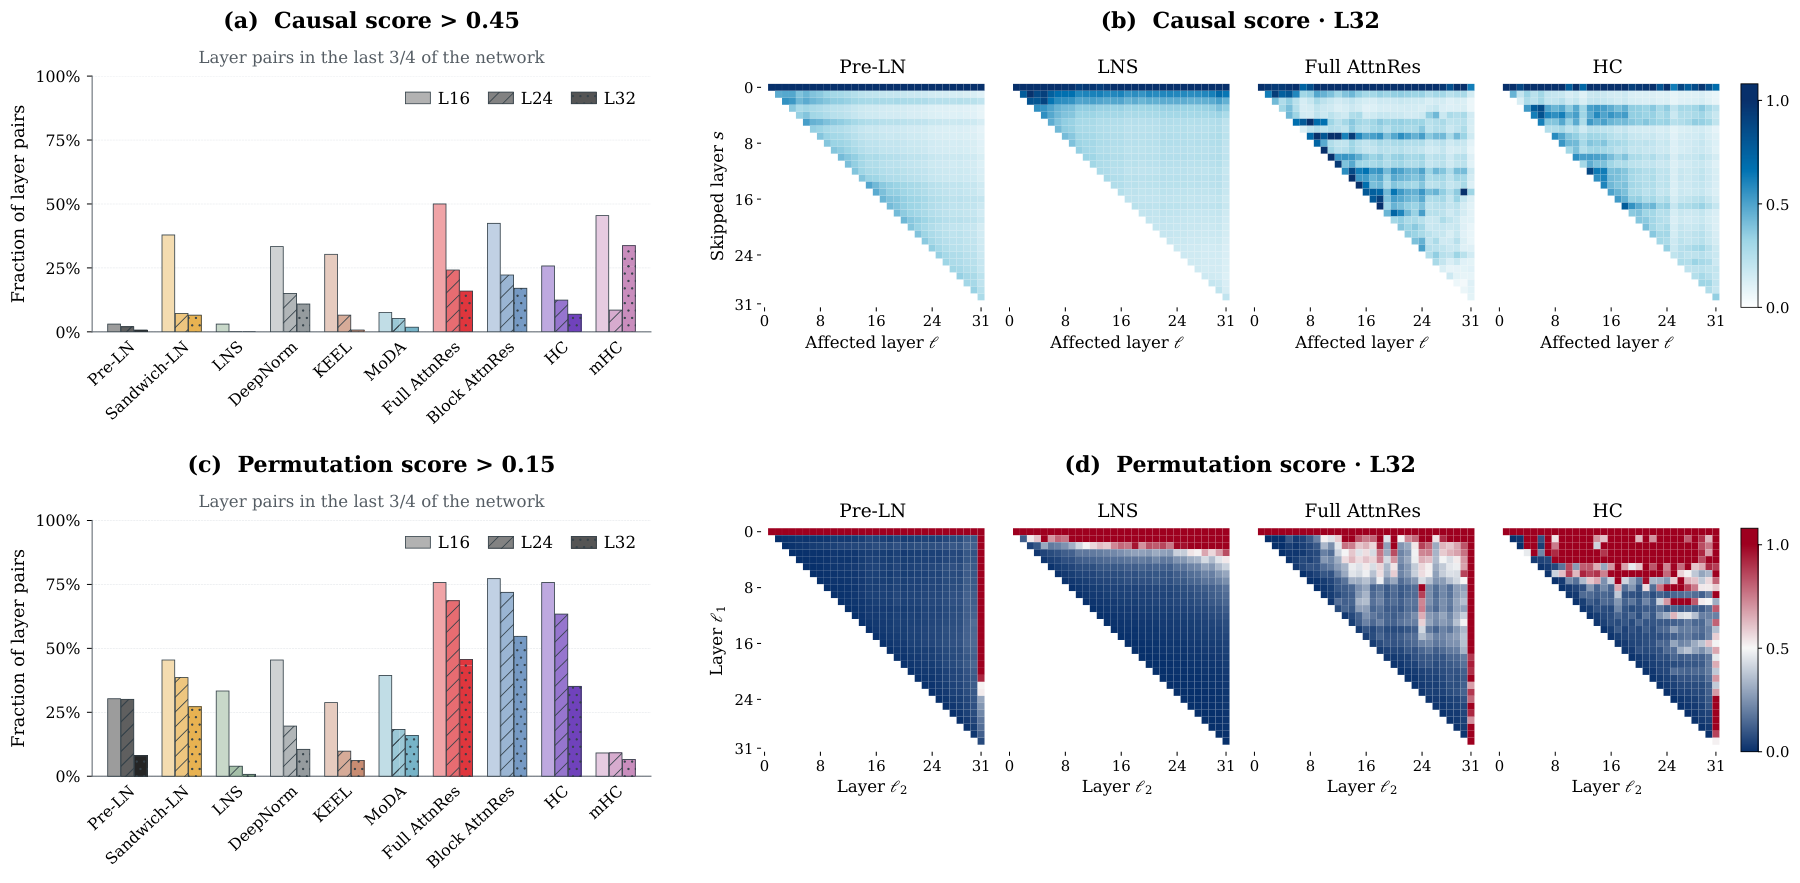
来源:原文 Fig. 6,PDF p. 9。左侧是超过阈值的层对比例,右侧展示 32 层模型的完整层对关系;因果热图越深表示更新依赖越强,换层热图越红表示顺序影响越大。
| 32 层模型 | 后段层对中 $C>0.45$ 的比例 | 后段层对中 $P>0.15$ 的比例 |
|---|---|---|
| Pre-LN | 约 1% | 约 8% |
| Full AttnRes | 约 16% | 约 46% |
| HC | 约 7% | 约 35% |
来源:Sec. 4.1,PDF p. 10;这些是作者在正文中的近似读数。
Full AttnRes 与 HC 的后段层具有更强的相互依赖和更低的可互换性,支持新增深度被用于差异化计算。但这组诊断并不与形状收益一一对应:mHC 的因果分数可以较强而换层敏感性明显偏低;Block AttnRes 也有较强干预反应,却没有同样的深度扩展收益。因此依赖强、表示变化大、最佳深度更大,需要结合证据讨论。
Appendix E 的 16、24、32 层完整热图还显示,许多架构的强响应集中在前部;剔除前 $1/4$ 是为了突出后段差异。阈值是一个汇总选择,比较时应保留 0.45、0.15 和后段层对的口径,避免把柱高解释为普适的有效深度度量。[Figs. 14–16,PDF pp. 25–27]
4.4 两种深度处理:显式检索与递归多流传播
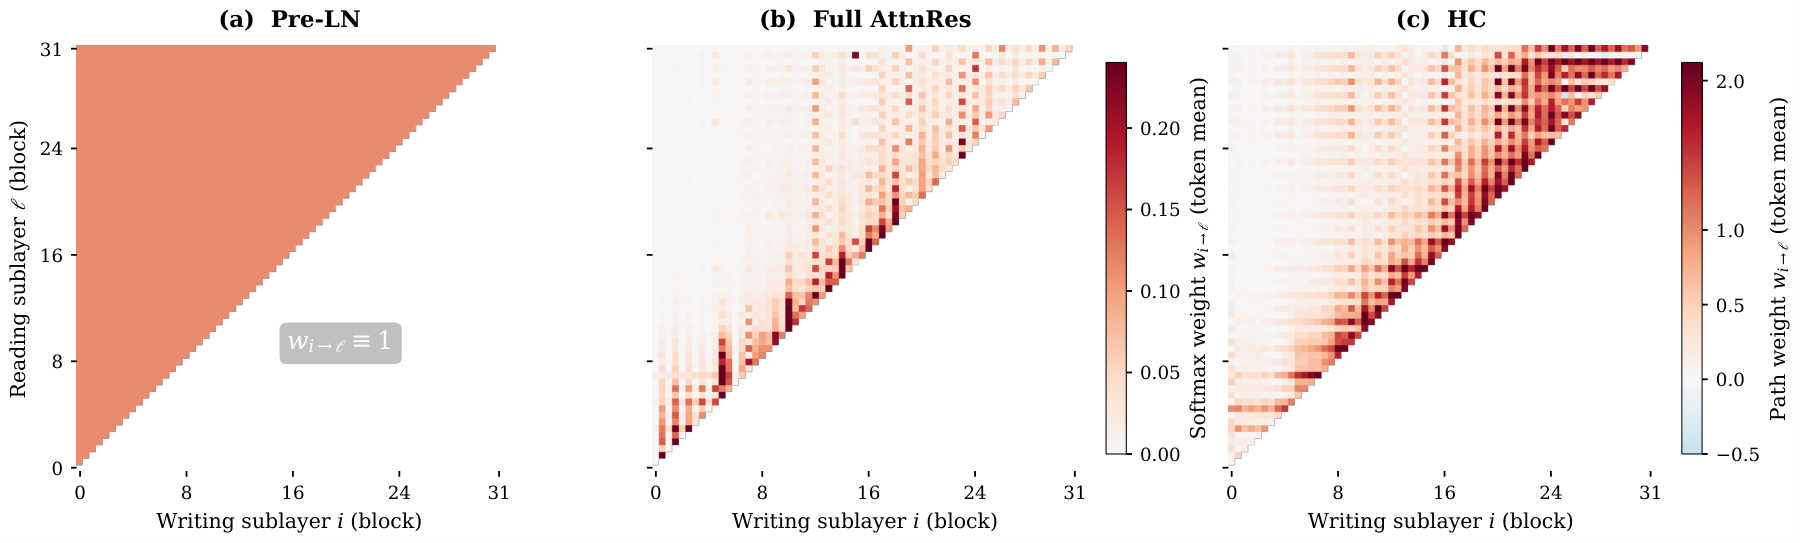
来源:原文 Fig. 7,PDF p. 11。横轴是写入来源,纵轴是后来的读取位置。Pre-LN 的显式加法系数恒为 1;Full AttnRes 是 softmax 权重;HC 是读写与中间流映射的乘积。
Pre-LN 图中的全 1 只说明显式残差通道对旧更新做恒等累加,不说明所有历史更新对输出同样重要。Full AttnRes 可选择特定历史来源;HC 的近距离路径较强,也保留跨越较多层的传播。两个模型都能避免将后层限制在同一种平滑精修中,但实现方式不同。
不同面板的色标也不同:AttnRes 权重是非负归一化值,HC 的有效路径系数可以为负或大于 1。因此不能仅凭两图颜色深浅比较“重要性大小”。
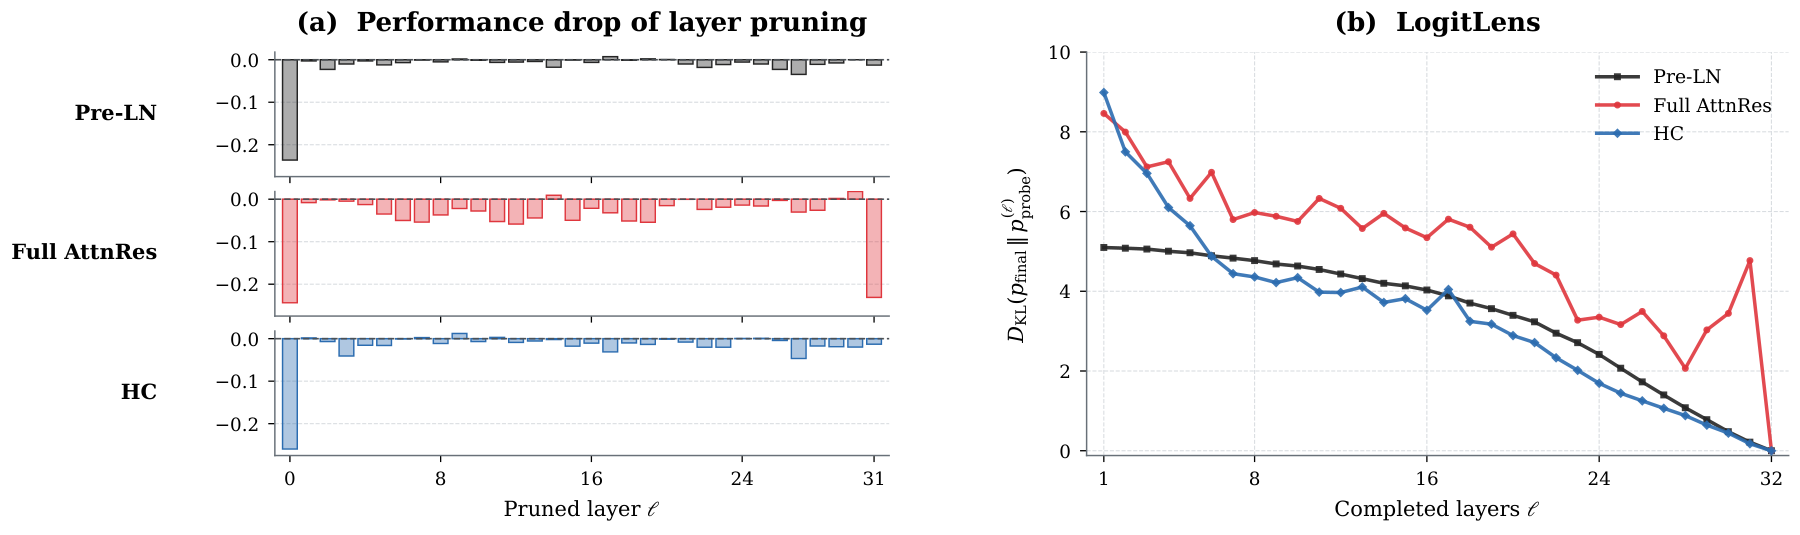
来源:原文 Fig. 8,PDF p. 11。左侧逐层删去一个层后看 ARC-Easy 准确率变化;右侧看完成不同层数后,中间预测到最终预测的 KL 距离。
剪层结果并没有证明 HC 的每个后层都不可替代。HC 与 Pre-LN 都特别依赖第一层,删除大多数后层的影响相对有限;Full AttnRes 的敏感性分布更广,并明显依赖最终层。这把“跨层合作更强”与“每层单独不可缺少”区分开了。
LogitLens 使用
Pre-LN 读当前残差状态,HC 读四流之和,Full AttnRes 读下一层深度 query 得到的混合状态。Pre-LN 与 HC 的轨迹整体较平滑;Full AttnRes 有明显非单调波动,符合持续检索历史来源并在后部整合的解释。KL 的参考是最终模型自身的预测,不是真实答案,因此其下降表示与最终输出更一致,而不是直接表示推理更正确。[Sec. 4.2,PDF pp. 10–11]
4.5 Block AttnRes:固定块数可能消耗新增的顺序计算机会
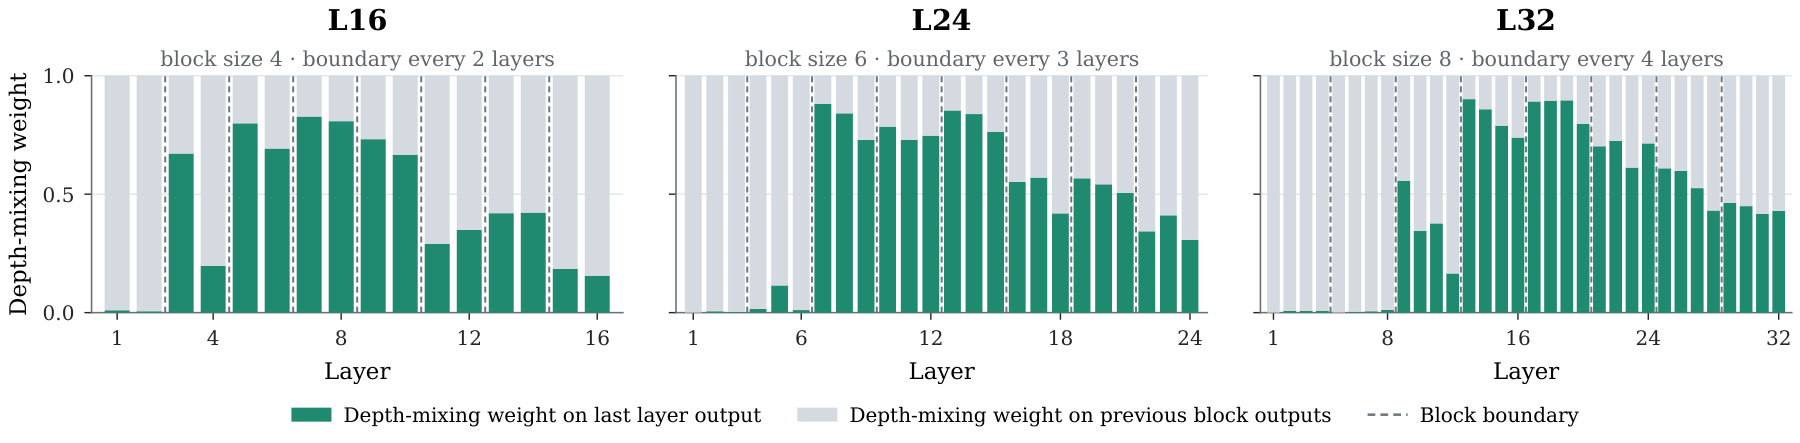
来源:原文 Fig. 9,PDF p. 12。绿色是对当前块运行和的权重,灰色表示其余来源权重,竖虚线为块边界。原图把绿色简称为 last layer output,但其对象是当前块累积和,而不总是最后一个子层的独立输出。
作者观察到,前部若干层对运行和赋予近零权重,反复从 embedding 等已有来源读取,刚完成的计算较难进入后续分支。此类早期低利用段在 $L=16,24,32$ 时分别约为 2、5、8 层,随深度增加;32 层时达到四分之一网络。[Sec. 4.3,PDF pp. 11–12]
它解释了为什么更长的块可能损害“逐层接力”:新分支虽然被算出并写入运行和,下一个分支却未必真正读取它。后续保存或读取块和仍可能利用这些结果,因此把它理解为一段链式依赖不足,比断言这些层的输出完全被永久丢弃更准确。
正文把这一现象与首个保存块出现前的阶段联系起来,但图中的低利用段也可延伸到首个边界之后,例如 $L=32$ 每 4 层一个边界,而描述的低利用段约 8 层。现有证据支持“固定 8 块调度下观察到早期低读取”的机制线索;它没有单独比较固定块长、更高块数或其他初始化来确认原因。
4.6 mHC:传播更稳定,历史流方向可能更难区分
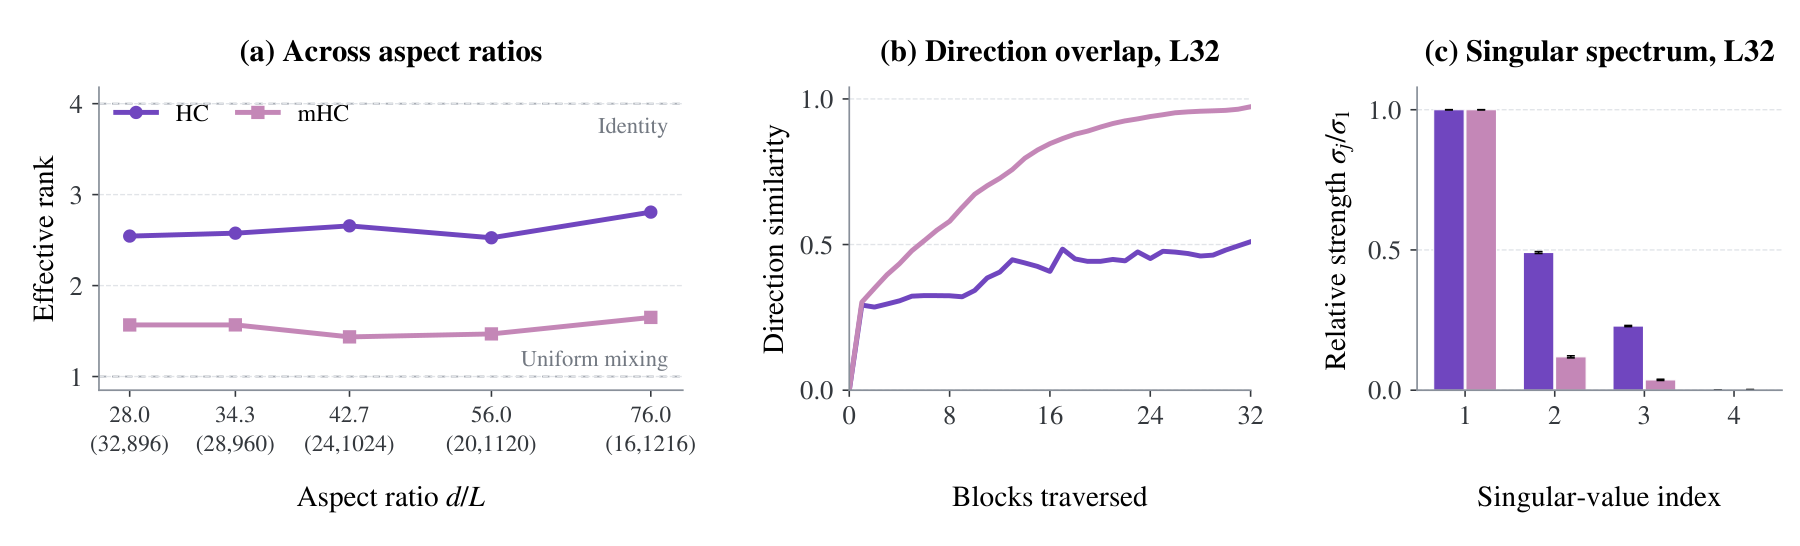
来源:原文 Fig. 10,PDF p. 12。左图比较全部残差映射乘积的有效秩,中图看传播后流方向的平均绝对余弦相似度,右图看以最大奇异值归一化的奇异谱。
有效秩按归一化奇异值的熵指数定义。若传播乘积的奇异值为 $\sigma_j$,则
四流情况下,四个相等奇异值对应有效秩 4,一个奇异值占主导则接近 1。论文测得 HC 为 2.53–2.81,mHC 为 1.44–1.65;32 层 mHC 的传播方向接近共线,非首位奇异值也明显衰减。图中的 95% 区间来自文档 bootstrap,反映抽样文档上的统计变化。[Fig. 10,PDF p. 12]
作者用双随机矩阵的平均固定点解释这一现象:
在其他方向被持续收缩的条件下,多次传播逐渐接近 $U$,不同流变得越来越类似,早期写入的不同成分更难保持区分。[Eq. (10),PDF p. 13]
一个教学例子能说明条件:取 $A=(1-\varepsilon)I+\varepsilon U$,$0<\varepsilon<1$,则
平均方向被保留,流差异按几何速度衰减。这里的推导是辅助理解;双随机性本身并不强制所有矩阵连乘都收敛到 $U$,单位阵或置换阵就是反例。原文也使用“当其余方向收缩时”的条件。
这项分析关注显式残差传播乘积,而非整个非线性网络的表示秩;后续分支仍在写入新信息。结合 mHC 较低的换层敏感性,结果支持“稳定传播与长程路由多样性之间存在取舍”的解释。由于 HC/mHC 同时改变非负约束、路由参数化和初始化,该实验尚未把全部差异归因到 Sinkhorn 约束这一项。
4.7 系统成本:固定参数不等于固定 FLOPs 或固定延迟
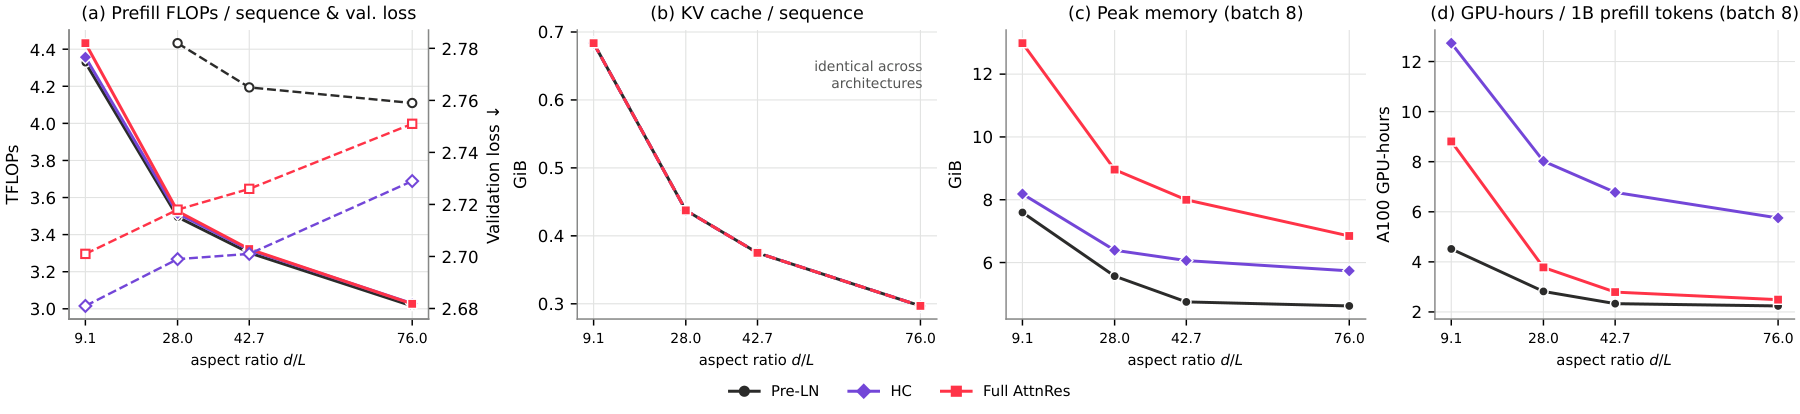
来源:原文 Fig. 11,PDF p. 13。400M、BF16、A100-SXM4-40GB;FLOPs/KV 为每序列,峰值显存与 GPU-hours 使用 batch 8;最后一图的单位是每 1B prefill tokens 的 A100 GPU-hours。图 (a) 实线是 FLOPs,虚线及右轴是验证损失。
固定骨干近似意味着 $Ld^2$ 固定,但 $Ld$ 随深度增加。因此,密集投影成本相对稳定时,注意力序列交互的 $O(T^2Ld)$ 与 KV 存储的 $O(TLd)$ 都会增加。若以固定骨干作教学近似,$d\propto L^{-1/2}$,则 $Ld\propto\sqrt L$。
在因果注意力只计算约一半 query–key 对的计数约定下,基线每次前向的主要 FLOPs 为
全位置输出 logits 时 $F_{\mathrm{head}}=2TdV$;仅最后位置输出时为 $2dV$。一次乘加计为两次 FLOPs,归一化与逐元素运算被省略。若实现显式计算完整注意力矩阵,注意力项相应为约 $4T^2d$。[Appendix D,PDF p. 23]
几种残差机制的额外 FLOPs 为
Block AttnRes 固定八块时,读取来源数被限制在较小范围,计数为
这些公式不计 softmax、RMSNorm、Sinkhorn 等操作,mHC 在此口径下的额外 FLOPs 主要来自路由投影,不应据此断言其实际时间由同一项完全决定。[Appendix D,PDF pp. 23–24]
实验中从宽深比 76.0 降到 9.1,prefill FLOPs 约从 3.0 增至 4.4 TFLOPs/序列,KV 缓存增加超过两倍。对本文 MHA 形状,可从 $Ld$ 直接得到约 $70\times640/(16\times1216)=2.30$ 倍的 KV 增长;这个比值是按配置计算的解释值。不同残差架构的 KV 曲线相同,因为此项取决于共同注意力配置。
Full AttnRes 的峰值显存最大;HC 虽然名义 FLOPs 只增加较少,测得 GPU-hours 却最高,反映串行层数、矩阵形状、路由实现和硬件利用率的影响。这些是指定环境的前向 prefill 结果,不能直接当成完整训练时长或单 token 解码延迟。
五:结论——把可访问的历史计算视为深度设计的一部分
这篇论文最扎实的发现是:在共同小模型预训练框架中,残差机制会实质改变宽深分配的收益。 Full AttnRes 和 HC 在 400M 上比标准 Pre-LN 更能利用深形状;Full AttnRes 的跨规模证据更连贯。路径分析和干预结果进一步支持,可区分的历史来源与顺序相关的层间合作,是有效深度的重要线索。
对于架构设计,本文给出的启发是考虑三件相连的事:如何保存早期计算、如何让后层选择这些计算、如何防止传播与压缩把不同来源混成同一方向。Full AttnRes、HC、Block AttnRes 和 mHC 分别展示了访问粒度、状态传播、稳定性和系统成本的不同取舍。
对主要结论影响最大的实验边界有三点:
- 预算是近似等参数与既定数据配方,并非严格等计算量。 固定骨干对照缓解 embedding/head 分配的混杂,但深度本身仍增加注意力、缓存和串行成本。实际选择应看质量与硬件预算的共同前沿。
- 架构间的额外参数并不都可忽略。 24 层时,Pre-LN 为 405.41M,Full/Block AttnRes 为 405.51M,HC 为 405.70M,mHC 为 410.13M,而 MoDA 为 453.64M,约比 Pre-LN 多 11.9%。主导结论中的 Pre-LN/Full AttnRes/HC 参数匹配较紧,但十方法整体并非严格等参数。[Table 6,PDF p. 20]
- 机制图景比一个统一“有效深度分数”更可靠。 学习率影响表示热图,跳层、换层、剪层与 LogitLens 测量不同功能;mHC 与 Block AttnRes 的诊断还提示,某项内部敏感性增强并不保证加深时损失持续下降。
进一步最值得做的实验,是给深形状同样充分的优化机会,并对候选机制进行局部干预:固定 Block AttnRes 的块长而增加块数;分别放松 mHC 的非负读写与双随机约束;在匹配训练 FLOPs 或 GPU-hours 下重新比较形状。这样才能把当前的机制解释推进到更直接的设计因果证据。