ELF-REG:将全连续扩散语言模型扩展到推理任务
论文:ELF-REG: Scaling Continuous Diffusion Language Models to Reasoning Tasks
作者:Zeyu Michael Li、William Xingxu Chen、Bingshuo Qian、Jiayin Liu、Xiang Cheng(Duke University / Tsinghua University)
版本:arXiv:2609.29102v3,2026-10-08 修订;获取与研读日期:2026-10-14。
原文:arXiv v3 · 本地 PDF · 英文汇报 PDF · 可编辑 Beamer 源码。以下页码均为从 1 开始的 PDF 页码,与本版本印刷页码一致。
论文总览
ELF-REG 的核心是:在连续表示空间中并行生成整段回答,训练时借助冻结自回归教师的局部与全局表示,使中间去噪预测更有用;推理时直接解码这些中间预测,从而节省后续去噪计算。
方法建立在 Embedded Language Flows(ELF)上,增加两个训练信号:表示对齐(REPA)把学生中间层对齐到教师的逐词元表示;表示联合去噪(REG)把教师的全局表示作为一个额外状态,与整段回答一起去噪。推理时不调用教师,REG 从噪声生成。前缀早停(prefix early-stop)则沿较长时间网格只执行前缀,把最后一次“干净状态预测”交给并行解码器。
主实验中,ELF-REG-L 在 GSM8K 上以 64 次网络评估(NFE)达到 55.96% pass@1,在 MATH-500 和 HumanEval 上以 128 NFE 分别达到 13.39% 和 22.56%。相对于同系列 ELF-L,分别增加 4.11、2.84、2.90 个百分点。更有启发性的是 ELF-REG-B 的 GSM8K 配对分析:早停输出与完整轨迹输出仅有 8.61% 完全相同,但数值答案一致率已达 87.11%,继续生成对准确率的净收益仅为 0.64 个百分点。(表 1–2、11,pp. 7–8、29)
这项工作支持“小规模、任务专用的全连续生成模型可以更有效地学习推理与代码”。阅读其效率与排名结论时,需同时考虑冻结编码器的成本、代码评测后处理和输出长度差异。论文另有重新加噪采样器实验,收益明显,但其 4 种子协议与上述 16 种子主结果不同。
结构地图
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 推理任务与低 NFE 的研究动机 | p. 2;图 1 在 p. 1 |
| 2 Related Works | 全连续、掩码/混合扩散、表示监督与早停的关系 | pp. 3–4 |
| 3 Methodology | ELF、REPA+REG、前缀早停 | p. 4,式 (1)–(2) |
| 4.1 Early-stop decoding and the remaining flow map | 端点误差、解码一致性、分布距离 | p. 5,命题 1–2、推论 1 |
| 4.2 Endpoint error and decoder stability along the sampling trajectory | 同一轨迹上的误差、稳定性与准确率 | pp. 6–7,图 2 |
| 5 Experiments | 数学、代码、多样本能力与学习曲线 | pp. 7–9,图 3、表 1–3 |
| 5.1 Clean-prediction re-noising | 不改权重,改变采样更新 | p. 9,表 4 |
| 5.2 Ablations and additional analyses | 训练组件、早停与其他分析 | pp. 9–10,表 5–6 |
| 6 Conclusion and Discussion | 贡献与通用模型方向 | p. 10 |
| A Method details | 教师层、损失归一化、自条件引导 | pp. 18–19,式 (7)–(9) |
| B Experimental settings and comparison protocols | 数据、规模、预算、评测和比较条件 | pp. 19–26,表 7–10 |
| C Early-stop proofs and the discrete sampler | 证明、真实离散采样器和诊断协议 | pp. 26–30,算法 1、表 11–13 |
| D Additional results and analyses | NFE/样本数扫描、采样器、表示与训练消融 | pp. 30–43,表 14–38、图 4–10 |
| E Comparison with related work | 各方法生成状态和监督位置的区别 | pp. 44–46,表 39 |
| F Limitations / G Qualitative Examples | 任务专用与画布限制;正确和错误例子 | pp. 46–50 |
一:动机
1.1 并行生成的能力瓶颈
自回归(autoregressive, AR)模型依次产生离散词元;全连续扩散语言模型在每次网络调用中同时更新所有回答位置的连续向量,最后才一次性解码成词元。后者可以把“输出词元数”与“串行网络调用数”分开,但数学推导和程序生成要求跨位置保持一致,减少去噪步数会暴露中间表示质量不足的问题。
ELF 已提供上下文化表示、双向去噪网络和共享解码器。本文的增量是把这一框架训练到数学与代码任务,并通过教师监督提高学习效率和中间预测质量。REPA、REG、早停本身都有先前工作;本文的贡献应理解为它们在全连续语言推理中的组合、实证扩展,以及对早停行为的分析。(§1–2,pp. 2–4;附录 E,pp. 44–46)
1.2 两个互补的问题
训练问题是:仅靠最终词元监督和速度回归,能否高效学到有用的中间表示?作者加入逐位置表示对齐和全局状态重建,向学生提供更丰富的训练目标。
推理问题是:输出达到任务所需质量时,是否还必须完成整个连续轨迹?作者区分“保持整段输出不变”与“保持正确答案”,发现后者可以更早出现。因此,同一个训练好的模型可以使用更短的采样前缀,不必为每个 NFE 预算另训少步模型。
二:方法
2.1 数据流:编码器、教师、学生各做什么
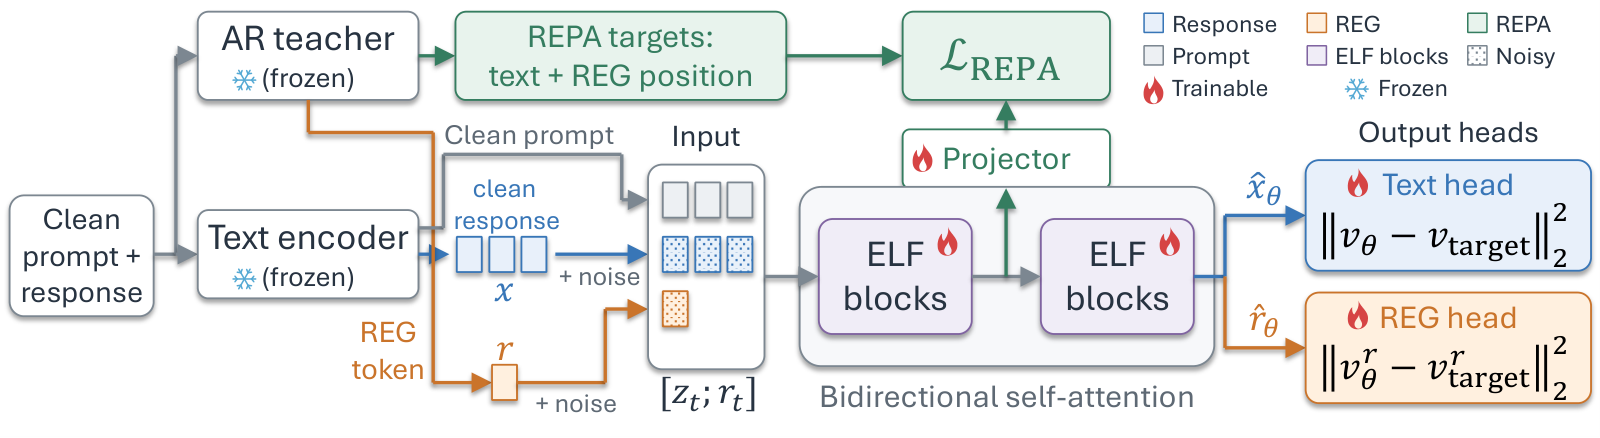
来源:原图 1(a),PDF p. 1。蓝色路径提供文本去噪目标;绿色路径通过投影器监督学生中间层;橙色路径产生额外的全局 REG 目标。学生各位置通过双向注意力交换信息。
| 组件/符号 | 含义与维度 | 训练、推理中的角色 |
|---|---|---|
| 冻结文本编码器 | Qwen3-0.6B-Base,第 20 层 | 训练时编码干净文本;推理时仍编码 prompt |
| $x,z_t,\hat x_\theta$ | 干净、带噪、预测干净的文本状态;每位置 $d=1024$ | 回答状态被生成,prompt 保持固定 |
| 冻结 AR 教师 | Qwen3-1.7B-Base,表示宽度 2048 | 只在训练时提供 REPA 与 REG 目标 |
| $u_i^{(\ell)},h_i$ | 学生第 $\ell$ 个块的状态、教师同位置状态 | REPA 默认使用教师第 20 层 |
| $p_\phi$ | 3 层位置独立 MLP,隐藏宽度 2048 | 映射学生状态到教师维度;仅训练使用 |
| $r,r_t,\hat r_\theta$ | 全局 REG 状态;$d_r=2048$ | 额外 token 与文本联合去噪,供解码器参考 |
| $q_j$ | 上一步的干净状态预测 | 自条件(self-conditioning),初值为 0 |
| $\mathcal D$ | 共享 Transformer 的解码模式与词表头 | 在解码时间 1,一次产生全部回答词元 |
ELF-B 有 12 层、宽度 768,ELF-L 有 32 层、宽度 1280。REPA 分别监督第 4、8 个块。REG 的干净重建目标来自教师第 24 层的最后一个非特殊内容词元;REG 位置的 REPA 目标仍来自 REPA 教师层,即第 20 层。不要把两种目标混作同一个层输出。(§3.1–3.2,p. 4;附录 A.1、表 7,pp. 18–20)
2.2 ELF 的连续去噪与共享解码器
训练将干净回答表示与高斯噪声线性混合:
这里 $t=0$ 为纯噪声端,$t=1$ 为干净端,默认 $\sigma=2$。文本状态先按每个向量的特征均值与方差标准化。去噪网络预测干净状态 $\hat x_\theta$,理想连续表达中的速度为
因此,模型虽然输出“干净状态”,训练可用速度回归,推理可用 Euler 更新。前一步的干净预测作为下一步的自条件输入,避免每次完全重新估计。(式 (1),p. 4)
同一个 Transformer 也训练解码模式:以 0.2 的概率选择解码训练样本,用词元交叉熵监督。解码器的时间输入设为 1,自条件设为 0,但训练输入有独立噪声扰动。这使解码器能够处理不完全落在理想干净数据上的连续表示。推理最后一次调用解码模式,再经过词表投影和逐位置 argmax,得到完整回答;首个 EOS 决定输出结束位置。(附录 A.3–A.4,pp. 18–19)
2.3 REPA:对齐干净教师的中间表示
REPA 的逐位置损失为
教师看到干净的 prompt 和回答,学生在去噪样本中看到干净 prompt 和带噪回答。默认对齐同一位置,文本损失只计算回答内容词元,排除特殊词元和 padding;prompt 与 response 权重分别为 0 和 1。REG 位置另外加入有效位置平均,解码样本也施加 REPA。
从机制上看,这为噪声输入下的学生中间层提供语义结构目标,比只约束末端重建更直接。教师采用因果注意力,学生仍采用双向注意力;对齐教师表示没有把学生的生成顺序改成自回归。(§3.2,p. 4;附录 A.2,p. 18)
2.4 REG:把全局表示变成生成状态的一部分
取教师最后一个非特殊内容词元的状态,按特征标准化得到 $r$。因果教师的这个位置已能汇集前面的 prompt 和回答信息。训练把它独立加噪:
投影后的 REG 作为额外 token 加入学生,通过双向注意力与文本交换信息,并用单独输出头预测 $\hat r_\theta$。它有自己的速度回归损失,也接受 REPA 监督。
训练有干净全局目标,推理只有全局噪声初值。 因此,REG 是模型要联合生成的辅助状态,而不是推理时由教师提供的答案摘要。最后解码时 REG 留作上下文,但不输出成文本。
教学上可把 REPA 理解为“指导中间层如何组织表示”,把 REG 理解为“增加一个需要共同重建的全局变量”。这解释了两者的不同作用,但“全局规划”仍是机制直觉,实验并未把 REG 解码成可检查的计划。(§3.2,p. 4)
2.5 联合损失、自条件引导与归一化
论文主目标是
实现使用 $c_t=\max(1-t,0.05)$ 代替可能过小的分母。设 $b\in\{0,1\}$ 表示是否启用自条件,$w>0$ 为引导尺度,$\operatorname{sg}$ 表示停止梯度,则文本速度目标为
$v_{\mathrm{no\text{-}sc}}$ 来自零自条件的辅助预测,$v_{\mathrm{sc}}$ 来自把其干净预测作为条件的第二次辅助预测;二者在相同带噪状态和时间计算。REG 使用相同形式的目标。自条件概率为 0.5,训练引导尺度在 $[0.5,5.0]$ 采样。(式 (7)–(8),p. 18)
定义 $x_t^\star=\operatorname{sg}(z_t+c_t v_{\mathrm{target}})$,则
这一等价式说明:写成干净状态回归时需要时间权重 $\omega(t)=c_t^{-2}$;直接写成速度回归时,不应再多乘一次该权重。文本与 REG 平方误差分别除以特征维度 $d,d_r$。文本交叉熵/速度损失按受监督回答位置归一化,包含 EOS padding;REPA 排除特殊词元与 padding;REG 速度损失只对去噪样本计算。三项的平均集合并不相同。(式 (9),p. 19)
推理时,引导已通过目标学习进网络,每次去噪只需一次网络评估。文中普通 CFG 固定为 1,GSM8K 的自条件引导 SCCFG 为 3,代码与 MATH 为 2。它们是不同设置,不能把“CFG=1”读成“完全没有引导”。
2.6 前缀早停:少跑轨迹,并解码干净预测
对实际预算 $N$,设 master budget 为 $M=\rho N$,默认 $\rho=8$。先生成含 0、1 的 $M$ 个时间点,其中 $M-2$ 个内部点来自排序后的 logit-normal 分布,logit 均值/标准差为 $-1.5/0.8$。完整 master 轨迹应有 $M-1$ 次去噪更新;早停只执行前 $N-1$ 次。
用联合文本与 REG 状态 $y_j$、上一预测 $q_j$ 表示更新:
最后解码 $\mathcal D(d_{N-2})$。这与 full-span 有两处区别:后者把 $N-1$ 次更新铺满 $[0,1]$,并解码最终更新后的状态 $y_{N-1}$。两者均有 $N-1$ 次去噪和 1 次解码,所以实际开销都是 $N$ NFE;早停没有先跑完 $M$ 次。(§3.3,p. 4;算法 1、式 (12),p. 27)
以 $N=64,\rho=8$ 为例,构造的是 512 点网格,只调用 63 次去噪器和 1 次解码器。最后干净预测产生于索引 62 的时间,而不是更新后索引 63 的时间。4 个诊断种子的预测时间均值为 $t=0.0825$,范围 0.0755–0.0858。因此,$\rho=8$ 不是“走到连续时间的八分之一”。
对应训练插值的名义信噪比为
平均约 $2.03\times10^{-3}$。这是训练腐蚀分布的描述;实际生成 ODE 状态不必沿着某个真实样本与噪声的线性插值移动。(表 12、附录 C.4,pp. 28–29)
2.7 理论:用当前干净预测近似剩余流映射
固定 prompt 和引导,令 $F_{s,t}$ 是连续速度场 $v$ 的流映射,$y_t$ 包含全部生成状态。完整生成继续到 $y_1=F_{t,1}(y_t)$;早停返回 $D_t(y_t)=y_t+(1-t)v(y_t,t)$。二者差异为
其中 $\bar v_{t:1}$ 是剩余轨迹上的平均速度。直觉是:早停相当于用当前速度跨越整个剩余区间;当前速度接近剩余平均速度时,端点近似就好。
命题 1 假设速度场连续可微、流存在且唯一。若沿轨迹加速度
满足 $\|a_s\|\le A$,则
推导只需把速度差写成加速度积分,再交换积分次序并使用三角不等式。对于很早的退出,$(1-t)$ 并不小,必须有较平缓的剩余速度变化,界才有解释力;flow matching 的训练目标本身不保证这种平缓性。(命题 1、式 (4),p. 5;附录 C.1,p. 26)
连续状态有误差,也可能解码成同一段文字。设 $m>0$ 是完整端点中获胜词元相对任意竞争词元的最小 logit margin,覆盖有效回答及首个 EOS;$L$ 是两端点连线上的成对 logit 差的 Lipschitz 常数。若
则所有这些位置的获胜词元保持不变,$\mathcal D(\hat y_t)=\mathcal D(y_1)$。这里的 $L$ 已针对成对 logit 差定义,条件无需额外乘 2。此结论保持的是完整端点输出,即使该输出本身错误。(命题 2、式 (5),p. 5)
把相同初始噪声产生的两端点耦合,论文进一步得到
其中 $P$ 是连续状态分布,$Q$ 是解码输出分布。对任意 $\eta>0$,右边还可上界为
前项对应小间隔/高敏感度输出,后项对应大的端点误差。这个推导不要求 $m$ 与 $L$ 独立;要求有限二阶矩和相应 margin/Lipschitz 条件。(推论 1、式 (6),p. 5;附录 C.2,pp. 26–27)
真实采样器还保存自条件 $q_j$,并使用分母截断。它的精确离散端点差为
第一项是截断分母修正,第二项是实际离散轨迹上的速度变化。只在 $y_j$ 上定义 Markov 状态会遗漏 $q_j$。实验测到的有限差分加速度可支持上述机制解释,但不能直接代入连续命题充当已认证误差界。(式 (13)–(14),p. 28)
三:实验设置与比较口径
3.1 按任务训练,不是一个通用模型
GSM8K、代码、MATH、MMLU 各有独立 checkpoint;代码模型共用于四个代码基准。GSM8K、代码、MMLU 的学生从头训练;MATH 从对应模型的 GSM8K 第 7.5 epoch 权重继续训练 8 epoch。冻结编码器和教师已有预训练知识。(附录 B.2,pp. 20–22)
| 任务 | 学生训练数据 | 筛选后样本数 | ELF-REG 训练 token 总量 |
|---|---|---|---|
| GSM8K | OpenMathInstruct-2 的 GSM8K 部分 + MetaMathQA | 2,404,028 | 6.696B,12 epoch |
| MATH | OpenMathInstruct-2 的 MATH 部分 | 3,572,583 | 17.810B,含 4.185B GSM8K 初始化 |
| 代码 | OpenCodeInstruct 的 Python 问答 | 2,740,479 | 14.958B,12 epoch |
| MMLU | 辅助训练集及 Qwen3-30B-A3B-Instruct-2507 生成的正确 rationale | 96,112 | 1.259B,30 epoch |
数学数据按相关问题分组,并过滤与测试集匹配的组;代码过滤采用规范化 prompt 匹配、词级 8-gram Jaccard 相似度和解答 AST 精确匹配等。这里的 token 预算统计 prompt 与 response,包含 EOS、排除 padding,按 epoch 估算;不包含冻结模型的基础预训练。
参数表中 ELF-B baseline 为 90M 非解码器 + 156M 解码器,ELF-REG-B 为 104M + 156M;L 规模分别为 637M + 157M、652M + 157M。REG 模型的统计包含训练专用投影器,冻结的 0.6B 编码器与 1.7B 教师另计。因此,104M 或 652M 都不能被当成整个部署系统的全部参数。(表 7,pp. 19–20;附录 B.4,p. 23)
3.2 任务、指标与随机性
| 评测 | 检验能力及评分方式 | 主结果设置 |
|---|---|---|
| GSM8K,1,319 题 | 从推理文本提取最终数值 | 64 NFE,零样本,早停 |
| MATH-500,500 题 | 数学答案符号等价,math-verify 0.9.0 | 128 NFE,零样本,早停 |
| HumanEval / HumanEval+,164 题 | 同一批程序运行原测试/扩展测试 | 128 NFE,零样本,早停 |
| MBPP-500 / MBPP-378 | 原始 500 题 / EvalPlus 保留的 378 题;均用 base tests | 128 NFE,零样本,早停 |
| MMLU,14,042 题 | 从 rationale 提取选项字母 | 附录结果,full-span |
主表每题生成 16 个样本。pass@1 是单样本正确率,再对问题与生成种子平均;括号为生成种子之间的标准差。同一 checkpoint 的生成种子没有覆盖重新训练带来的波动。设某题 16 个样本中有 $c$ 个正确,则
这是 $k$ 个候选中至少一个正确的估计,不能解释成模型单次输出就能识别并选出正确答案。(附录 B.3,p. 22)
3.3 NFE、输出长度和代码后处理
ELF 的 NFE 计入一次最终解码,但不计冻结 prompt 编码器的前向。PlaidQ 的 $K$ 次去噪加解码为 $K+1$ NFE,开启 CFG 时为 $2K+1$。因此,PlaidQ+CFG 的 257 NFE 对应 128 次去噪更新,每次两次网络评估,再加解码。不同网络每次调用的 FLOPs、词表头和缓存方式不同,NFE 比值不能直接换成实测延迟加速比。(附录 B.4,p. 23)
ELF 数学和代码的总画布均为 1024 token,prompt 上限分别为 256、512;回答可使用实际 prompt 之外的所有位置。PlaidQ 的代码 completion 上限为 128 token,prompt 模板和后处理也不同。普通 AR/大规模 dLM 行主要提供背景参考,混有不同 demonstrations、训练量与思考模式。(附录 B.3、B.5,pp. 22–25)
代码主表使用 EvalPlus sanitizer,并在“期待的函数名不存在、提取代码恰有一个顶层函数”时给该函数增加别名。这不会修改函数算法,却会改变接口匹配是否通过。作者还在 MBPP 和 HumanEval 基准上调过 SCCFG(均选 2);这与只使用独立验证集调参的数学实验不同。这些条件对跨论文小幅领先的解释尤其重要。(附录 B.3,pp. 22–23)
四:结果与解释
4.1 轨迹分析:答案先有用,整段文字后稳定
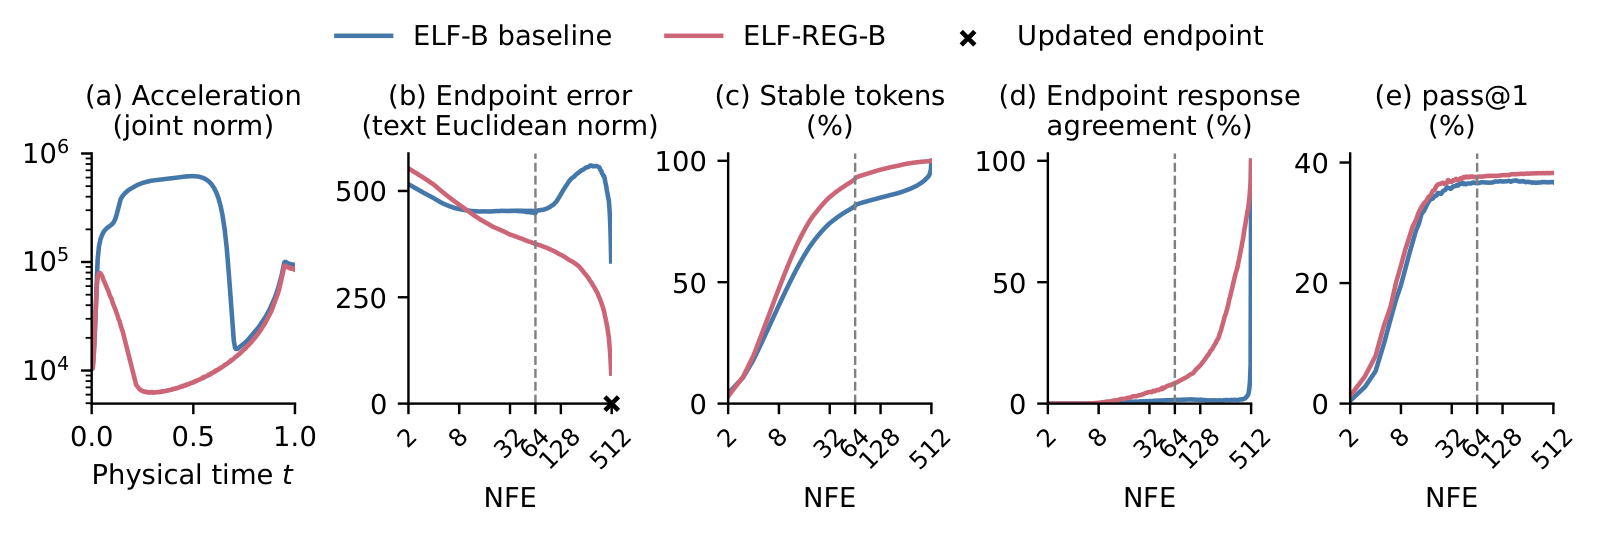
来源:原图 2,PDF p. 6。蓝线为 ELF-B,红线为 ELF-REG-B。(a) 的横轴是连续时间,纵轴为联合状态加速度的对数刻度;(b)–(e) 横轴为 NFE,分别画文本端点误差、稳定词元比例、完整回答一致率与 pass@1,虚线标出 64 NFE。加速度用均匀网格,其他面板用 logit-normal 网格,不能把各横坐标直接视作同一个时间表。
同一条 master-512 轨迹,在 64 NFE 提前读出,与继续到 512 NFE 比较:
| 指标 | ELF-B | ELF-REG-B |
|---|---|---|
| 数值答案与端点一致 | 80.27% | 87.11% |
| 整段回答与端点完全一致 | 1.46% | 8.61% |
| 继续生成:错变对 | 79/5,276 | 70/5,276 |
| 继续生成:对变错 | 78/5,276 | 36/5,276 |
| pass@1,64 NFE | 36.71% | 37.64% |
| pass@1,512 NFE | 36.73% | 38.29% |
| 准确率净变化 | +0.02 个百分点 | +0.64 个百分点 |
来源:表 11,p. 29;均为 1,319 题 × 4 生成种子的配对结果。ELF-REG 的净提升由 $(70-36)/5276$ 计算,显示值四舍五入后是 0.64 个百分点;不要仅用表内已四舍五入的 38.29−37.64 代替计数。
“稳定词元”要求当前以及所有后续已保存观测都等于终点词元;“完整回答一致”只比较当前与终点,但要求词元序列、EOS 状态、长度全部相同。数值答案一致则不要求推理文本相同。三者衡量的是不同层次的稳定性。
ELF-REG-B 的 64 NFE 文本端点误差比 baseline 低 16.1%。均匀网格的独立诊断在 $t=5/64$ 观察到:剩余最大联合加速度的中位数从 $6.215\times10^5$ 降为 $0.946\times10^5$,约下降 84.8%;联合端点误差从 530.78 降为 490.80,约下降 7.5%。(表 13,p. 30)
这些结果支持“REPA+REG 改善中间预测和轨迹平缓性”的解释。图 2 在 512 NFE 的零误差、100% 一致性来自用更新后的端点作参照,本身是构造结果。论文的连续理论讨论整段输出保持条件,而任务准确率接近终点并不要求所有词元固定。
4.2 主实验:数学、代码与多候选能力
数学。 同系列主结果最清楚地显示训练目标的收益:
| 数据集 / 学生规模 | NFE | ELF baseline | ELF-REG | 提升 |
|---|---|---|---|---|
| GSM8K / B | 64 | 37.71 ± 0.95 | 38.11 ± 1.07 | +0.40 个百分点 |
| GSM8K / L | 64 | 51.85 ± 0.88 | 55.96 ± 0.94 | +4.11 个百分点 |
| MATH-500 / L | 128 | 10.55 ± 0.90 | 13.39 ± 1.03 | +2.84 个百分点 |
数值均为 pass@1 (%);来源:表 2,p. 8。B 的最终准确率差距较小,其优势更多体现在更早达到相近性能;L 的质量差距更明显。两种 GSM8K baseline 还分别多训练了 6、3 个 epoch。
低 NFE 扫描中,ELF-REG-B 在 16 NFE 达到 34.42%,已高于 FMLM+ (Init) 在 64 NFE 的 33.60%。ELF-REG-L 的 16、32、64 NFE 分别为 52.89%、55.04%、55.96%;MATH-500 的 64→128 NFE 则从 13.31% 到 13.39%,默认采样器在这一范围内接近饱和。(表 14、19,pp. 30、32)
代码。 下表是作者主评测协议下的 pass@1 (%):
| 模型 | NFE | MBPP-500 | MBPP-378 | HumanEval | HumanEval+ |
|---|---|---|---|---|---|
| Open-dCoder | 128 | 16.70 | 23.90 | 20.80 | 17.60 |
| oDLM | 128 | 15.70 | 22.99 | 17.87 | 16.40 |
| PlaidQ+CFG | 257 | 15.53 | 24.58 | 22.04 | 19.70 |
| ELF-L | 128 | 17.19 | 26.75 | 19.66 | 18.75 |
| ELF-REG-L | 128 | 19.10 | 28.92 | 22.56 | 21.46 |
来源:表 1,p. 7。ELF-REG 相对 ELF-L 的收益在四列都存在;相对外部方法的排名还受上一节的协议差异影响。HumanEval 相比 PlaidQ+CFG 的均值差仅 0.52 个百分点,不宜读成已证明有显著优势。
去除函数名别名规则,仅重新评分同一批生成结果后:
| ELF-REG-L 评测 | MBPP-500 | MBPP-378 | HumanEval | HumanEval+ |
|---|---|---|---|---|
| 主表:sanitizer + 别名 | 19.10 | 28.92 | 22.56 | 21.46 |
| 仅 sanitizer | 15.95 | 24.21 | 22.26 | 21.15 |
| 别名规则带来的百分点差 | 3.15 | 4.71 | 0.30 | 0.31 |
来源:表 15,p. 31。此时 MBPP-500 的最高报告均值变成 Open-dCoder 的 16.70%,MBPP-378 变成 PlaidQ+CFG 的 24.58%;HumanEval 两列仍由 ELF-REG-L 领先。ELF-REG-L 相对 ELF-L 的收益在没有别名时仍保留。这区分了模型内部改进与跨论文排名对协议的敏感度。
多候选。 ELF-REG-L 不为少步生成另行训练,在 8 NFE 的 MBPP-378 pass@10 为 46.39%,高于专门少步训练的 PlaidQ-D16 在 17 NFE 的 40.49%;16 NFE 的 HumanEval pass@10 为 41.21%,高于 PlaidQ+CFG 在 257 NFE 的 39.87%。(表 17,p. 32)
| 基准、固定 NFE | ELF-L pass@10 | ELF-REG-L pass@10 |
|---|---|---|
| MBPP-500,128 | 40.50 | 39.92 |
| MBPP-378,128 | 52.90 | 55.05 |
| HumanEval,128 | 45.93 | 48.87 |
| HumanEval+,128 | 42.84 | 46.69 |
| MATH-500,64 | 36.73 | 44.04 |
来源:表 18、20,pp. 32–33。MBPP-500 是重要例外:pass@1 提高,但 pass@10、pass@16 的覆盖率略低。准确率提高并不自动意味着更多候选下覆盖的题目集合也变大。MATH-500 在 64 NFE 的 pass@16 则从 44.00% 提高到 52.20%。(表 3,p. 8)
4.3 训练效率:更少 epoch,仍须支付教师计算
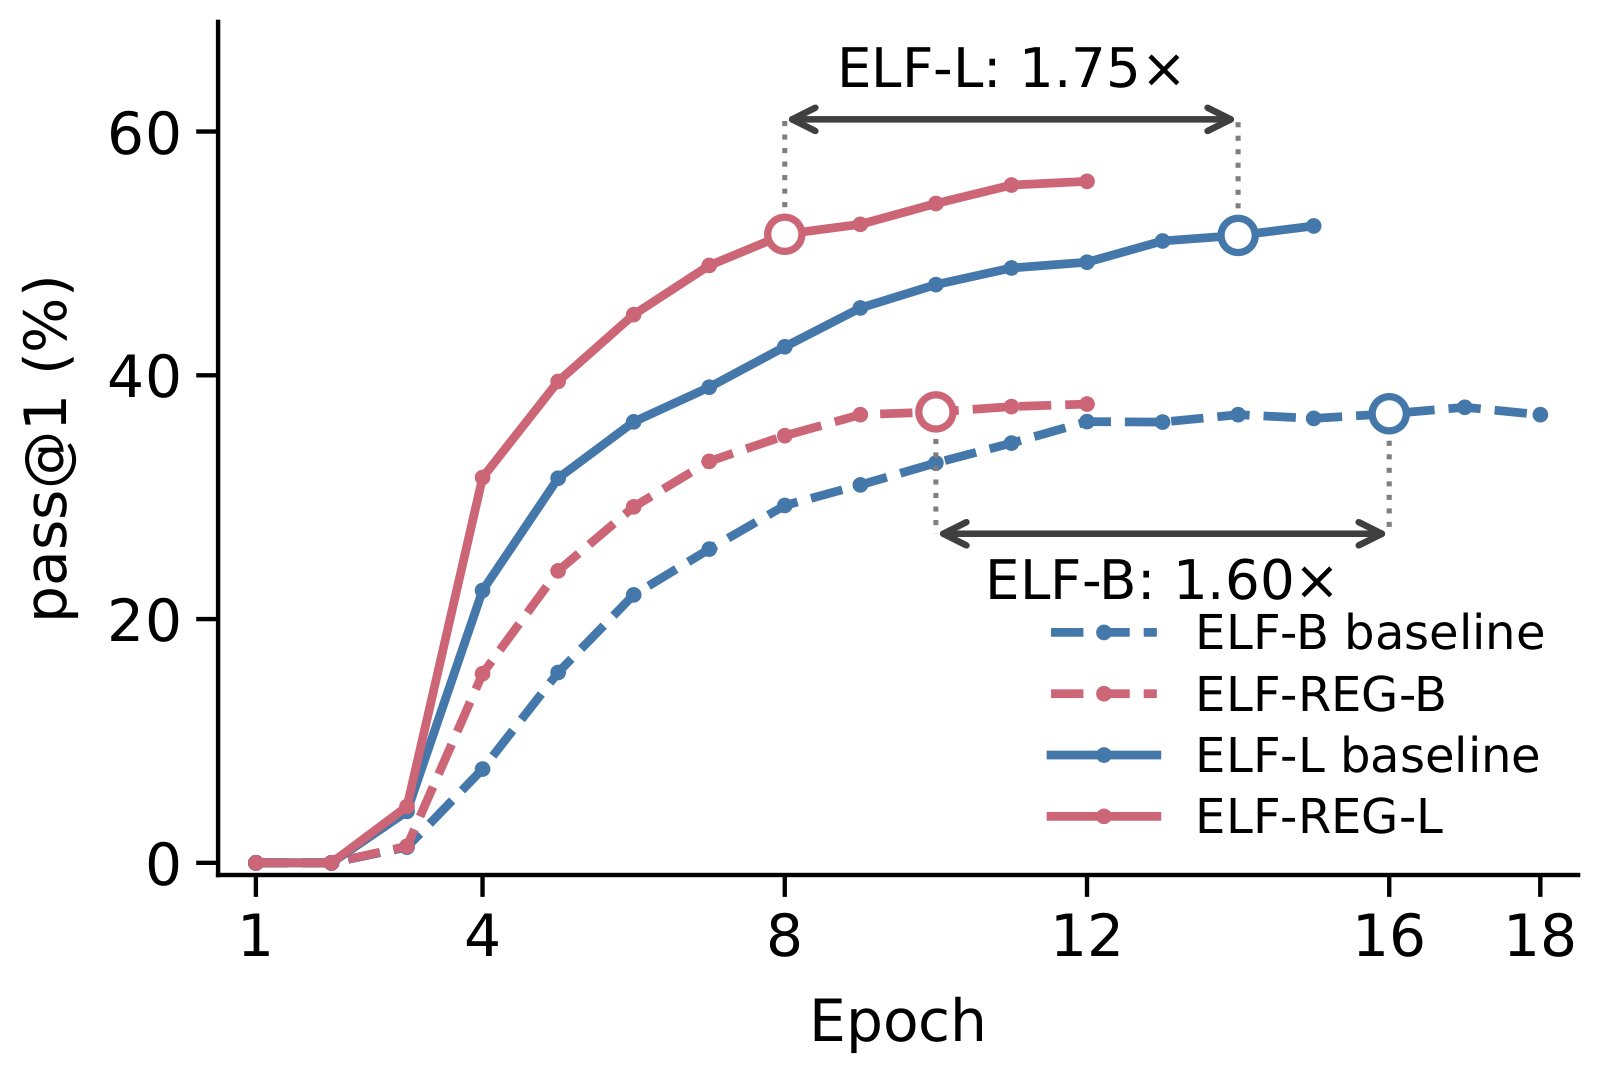
来源:原图 3,PDF p. 7。横轴 epoch,纵轴 64 NFE 早停下的 pass@1;虚线为 B,实线为 L,红色为 ELF-REG。箭头比较首次达到同一准确率阈值所需的训练进度。
ELF-L 达到 51.48% 阈值需要 14 epoch,ELF-REG-L 需要 8 epoch,减少约 43%。计算成本下降小于 epoch 下降,因为每个 REG 训练步更贵:
| 规模 | 相同准确率阈值 | baseline H200 GPU-hours | REG H200 GPU-hours | 降低 |
|---|---|---|---|---|
| B | 36.85% | 151.8 | 130.4 | 14.1% |
| L | 51.48% | 324.7 | 222.6 | 31.4% |
来源:表 9,p. 21。固定训练预算时成本也可能增加:代码两者都训 12 epoch,分别为 317.3 与 407.9 GPU-hours;MATH 含初始化分别为 449.6 与 563.1 GPU-hours。(表 8,p. 21)
图 1 的任务 token 比较更适合说明数据使用量:代码 14.958B 对比 PlaidQ 的 327.900B,GSM8K 的 6.696B 对比估算的 FMLM+ 49.664B。冻结模型预训练不在这些数值里,其他方法的数据、分词与训练过程也不同,故不能把 token 比值当成端到端训练成本比。(表 33,p. 37;附录 B.5,pp. 23–24)
4.4 §5.1:重新加噪进一步改善采样
作者在同一 checkpoint、相同 NFE、相同最后预测时间 $t_\star$ 下,改变两件事。第一,用幂函数安排去噪评估时间:
它相对均匀时间安排把更多评估放在接近出口处。第二,不再 Euler 推进带噪状态,而用干净预测和新鲜噪声构造下一输入:
上一干净预测仍作自条件;REG 也独立重新加噪;prompt 固定;最后一次直接解码干净预测。(附录 D.1.1,pp. 33–34)
| ELF-REG 任务 / 规模 | NFE | 默认采样器 pass@1 | 重新加噪 pass@1 |
|---|---|---|---|
| GSM8K / B | 64 | 37.64 | 42.97 |
| GSM8K / L | 64 | 55.91 | 60.37 |
| MATH-500 / L | 128 | 13.15 | 20.15 |
| MBPP-500 / L | 128 | 18.05 | 25.60 |
| MBPP-378 / L | 128 | 27.84 | 38.76 |
| HumanEval / L | 128 | 23.93 | 33.08 |
| HumanEval+ / L | 128 | 22.56 | 31.40 |
来源:表 4,p. 9;都是相同的 4 个生成种子,不可把表中的 33.08% 与 16 种子主表的 22.56% 直接相减来估计采样收益。ELF-REG 在所有已测任务的 NFE≥16 时 pass@1 都提高,在 NFE=4 时则都下降。
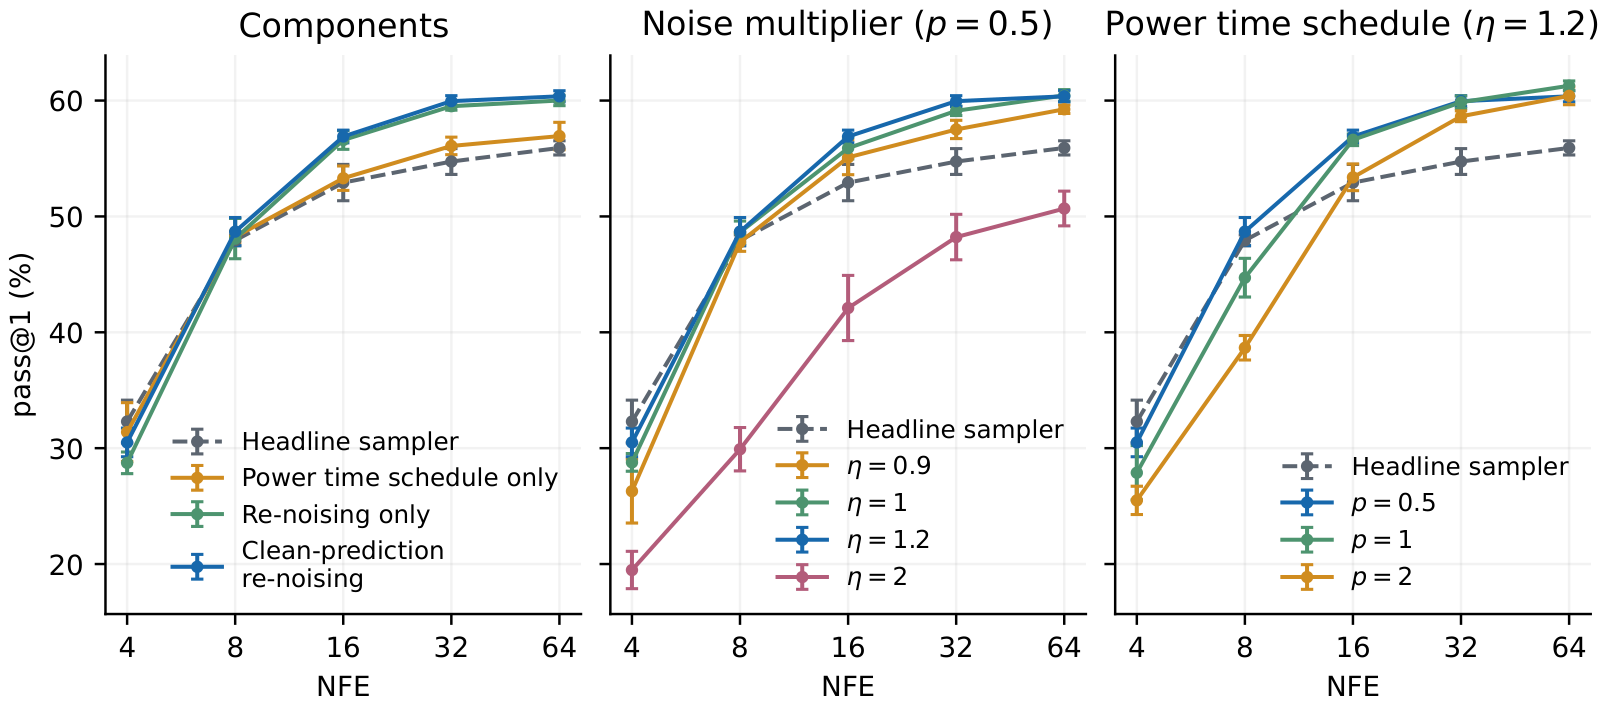
来源:原图 5,PDF p. 37;数值在表 30,p. 36。横轴 NFE,纵轴 GSM8K pass@1。左图把时间安排和重新加噪分别加入,再组合;中图改变噪声倍率;右图改变时间幂次。
64 NFE 时,仅改时间安排为 56.94%,仅重新加噪为 60.01%,组合为 60.37%,默认为 55.91%,说明此处主要收益来自重新加噪。$\eta=2$ 会明显降低准确率;$p=1$ 在 64 NFE 达到 61.28%,所以默认 $p=0.5$ 不是每个预算下的最优值。
还存在准确率与候选覆盖率的取舍:ELF-REG-L 在 GSM8K、64 NFE 的 pass@1 提高,但 pass@4 从 72.48% 降至 71.11%。(表 24,p. 34)这一观察支持关注采样分布的变化,而非只优化平均单次正确率。重新加噪改变了更新方程,前文基于 Euler 的离散端点误差恒等式不适用于这个采样器。
4.5 §5.2:训练收益主要来自监督,而非额外 token 容量
GSM8K 的 B 模型统一比较第 6 epoch、64 NFE 早停、16 个生成种子:
| 配置 | pass@1 (%) |
|---|---|
| ELF baseline | 21.74 |
| 仅 REPA | 24.56 |
| REPA+REG | 28.92 |
| REPA+REG 训练后,推理移除 REG | 28.66 |
| REPA + 一个可学习 token(OLT) | 25.60 |
来源:表 5,p. 10。REPA 有收益,REG 再增加 4.36 个百分点;移除 REG 后只损失 0.26 个百分点。OLT 并未复现联合去噪目标的收益。这支持 REG 主要通过训练塑造共享网络,而不是单纯靠推理时多一个 token 的容量。
默认的前缀早停也优于相同 NFE 的 full-span:
| ELF-REG-B,第 12 epoch | 4 NFE | 8 NFE | 16 NFE | 32 NFE | 64 NFE |
|---|---|---|---|---|---|
| Full-span | 7.25 | 15.75 | 25.27 | 30.95 | 34.19 |
| 前缀早停,$\rho=8$ | 11.82 | 26.20 | 34.42 | 37.15 | 38.11 |
来源:表 6,p. 10。这个对照同时改变时间网格覆盖与最后送入解码器的状态,不能把全部收益只归给“提前停止”这一单独因素。比例扫描中,$\rho=16$ 在 16–64 NFE 略优,但 4、8 NFE 略差;$\rho=8$ 是跨预算折中。(表 37,p. 42)
早停也依赖采样算法。附录把 FMLM+ 的 master-64 轨迹截断,在 16 NFE 从其本地 full-span 的 25.38% 降到 16.83%;作者解释为提前截断了渐进词元提交过程。这个结果说明,ELF 中有效的“读出完整干净预测”不能原样搬到依赖 token commitment 的混合采样器。(表 22,p. 33)
4.6 其他表示、训练和采样分析
编码器质量。 Qwen3-0.6B-Base 相比 t5-small 支持更好的 GSM8K/MMLU 学习曲线。向已提供的 gold answer 表示加噪后,Qwen 编码器系统也更容易恢复正确答案,尤其是 MMLU。该实验横轴是 noise/signal RMS ratio,纵轴是 gold-answer recovery;它测的是有金标准输入的编码—去噪—解码能力,而不是从 prompt 独立解题。编码器比较同时伴随 tokenizer 和预处理差异。(图 6,p. 38)
教师目标的位置偏移。 默认 shift-0 对齐学生位置 $i$ 与教师位置 $i$;shift-1 改为教师位置 $i-1$。作者把一道题中间的单个数字对应 latent 替换,控制其他输入,再比较扰动向前后位置传播的强弱。在监督块 4,shift-1 在 $t=0.05,0.2,0.7$ 都有更强的“后侧−前侧”影响;到最终块 12,$t=0.2,0.7$ 的排序反转。它改变局部表示的方向性,但没有建立全网络稳定的因果解码顺序。(图 7–8、表 34,pp. 39–40)
词元何时固定。 以最后一次观测到 token 改变的更新步数衡量 settling,默认 shift-0 在所有回答位置分箱都更早固定。曲线没有从前到后的单调顺序;这与并行、双向的生成机制相符。(图 9,p. 42)
训练配置。 在较早 checkpoint 的单种子验证消融中,B 模型默认 REPA+REG 达到 32.32% validation pass@1,高于 REG-only 的 25.39%、全局目标均值池化的 27.05%、同时监督 prompt 的 27.93%;L 的默认对齐块 8 比块 6、10、11 更好。这组用 full-span 64 更新加 1 次解码(65 NFE),且有输出截断,不能与表 5 的 16 种子早停分数混用。(表 35–36,p. 41)
粗网格误差具有方向性。 将 16 NFE 粗轨迹与 64 NFE 参考轨迹的文本状态及自条件误差,注入后者后继续生成;随机误差和跨模型误差按每位置的联合范数归一化。相同幅度下,随机误差损害明显更小。REG 模型更能承受自己的粗网格误差,但换误差来源时模型排序会改变。图 10 的 retention 只在两个模型都答对的 1,219 个题目—种子对上计算,REG 本身未受注入。(pp. 42–43)
full-span 预算缩小时,另一个条件保留率实验也观察到 REG 优势:16 NFE 为 71.34% 对 65.93%,32 NFE 为 85.06% 对 81.95%。分母是两个模型在 full-span 64 NFE 都解决的 4,693 个题目—种子对,不是全部测试样本。(表 38,p. 43)
MMLU。 附录的独立 B 模型在 full-span 64 NFE 从 45.34% 提升到 46.71%,并在 4–64 NFE 全部预算下提高。(表 21,p. 33)
五:结论与研究启发
论文最扎实的三条结论是:REPA+REG 改善同系列全连续模型的学习;同一 checkpoint 的干净预测可以在少量网络评估后提供有用答案;整体回答稳定与任务答案稳定应分开衡量。推理移除 REG 后收益大部分保留,也把关注点引向训练目标对共享表示的塑造。
理论给出的是“中间预测接近自身轨迹终点、并保持解码输出”的条件。实验更强的实践启发是:为了完成任务,未必需要把轨迹推进到文本完全定型。 如果后续研究能根据答案质量而不是逐词元一致性选择退出,可能比固定 $\rho$ 更节省计算;这是本次分析提出的研究方向,本文实现仍是预设预算的前缀退出。
具体取舍主要有三点:
- 能力范围。 每个任务单独训练,代码只含 Python,固定回答画布改变长度还需微调;本文尚未交付覆盖所有任务的通用模型。(附录 F,p. 46)
- 成本口径。 教师只用于训练,但冻结编码器仍用于推理;NFE 和任务 token 数分别不能替代部署延迟、端到端训练算力。匹配 GSM8K 准确率的 GPU-hours 是更直接的训练效率证据。
- 质量与评测。 MBPP 排名依赖函数名后处理,单次准确率与多候选覆盖率有时相反;所报标准差主要反映生成随机性,作者未重复多训练种子。
定性例子进一步说明剩余错误类型:模型能写出连贯推导却把 $352/8$ 算成 43;生成的程序也会把三角形面积写成 $a h^2$。流畅的并行输出并没有消除算术和语义错误。(附录 G,pp. 47–50)
可供后续验证的方向包括:统一长度和后处理的跨模型代码评测;报告包含编码器在内的真实延迟与内存;比较“仅更改退出状态”“仅更改时间网格”的独立收益;同时优化 pass@1 与候选覆盖率。这些实验能进一步判断,收益主要来自表示学习、时间安排还是输出分布的变化。