On the Importance of Gating:中文精读笔记
完整题名: On the Importance of Gating: Memorization vs. In-Context Learning in State Space Models
作者: William L. Tong、Aryo Lotfi、Emmanuel Abbe、Kostas Vaggelakos、Vishnu Banna、Etai Littwin、Josh Susskind、Cengiz Pehlevan、Eran Malach(Apple / Harvard University)。
版本: arXiv:2609.16540v1,提交于 2026-09-15;获取与研读日期:2026-09-28。PDF 首页另有由排版生成的 2026-09-16 日期,本文以 arXiv 版本标识为准。
来源: 版本页面 · 在线 PDF · 本地原文 · 作者主 TeX · 英文幻灯片
材料与覆盖范围: 已阅读同版本作者 main.tex、其引用的 apple_preamble.tex 与相关数学宏定义,并结合 25 页 PDF 核验正文第 1–6 节、附录 A–D、图 1–5、表 1 和关键证明。作者源码获取成功;未编译或执行作者源码。图件来自作者原始 PDF 图,与论文最终排版核对一致,出处记录在 图件清单。本笔记是分析与教学解释,不是全文翻译,也没有复现实验训练。下文页码均指从 1 开始的 PDF 页码,本论文与印刷页码一致。SSM-Gating 是归档用主题简称,并非作者提出的新方法名。
论文总览
论文追问:状态空间模型(State Space Model,SSM)检索失败时,问题一定在于固定状态装不下上下文吗?作者构造了一个有正确检索解、也有容易学习的参数记忆捷径的任务,发现门控衰减会改变优化先学到哪一种解。较强门控压低上下文传来的信号,模型先记住训练中稳定的输入—标签关联;较弱门控则更容易学会依据本次上下文作答。
这一结果不能简化为“去掉门控更好”。长上下文中,非正交 key 的干扰会累积;适当衰减能限制噪声,却也使远处的目标更难保留。因此论文同时讨论两个不同问题:
- 训练动力学: 已经存在检索解时,多久才能学到它?
- 长度外推: 学会检索后,面对更多干扰,相关信息还能否被读出?
最可靠的贡献是把这两种作用放进同一套可分析模型,并用多 token 检索、逻辑规则选择和预训练模型工具调用依次验证。它提供了机制解释,没有给出普适最优的门控配置或一种新架构。工具调用实验也仅覆盖改造后的 BFCL python simple 子集,不能代表完整智能体能力。
结构地图
| 原文章节 | 在论证中的作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 区分容量限制与优化偏好;提出门控的双重作用 | pp. 1–2 |
| 2.1 Task;2.2 Model | 可扰动标签任务、简化 SSM | pp. 2–3 |
| 2.3 Short context retrieval | 初始学习偏好、记忆平台与逃逸时间 | pp. 3–4;命题 1、4 |
| 2.4 Long context generalization | 干扰累积、无衰减极限、检索局部性 | pp. 4–5;图 1;命题 8、9 |
| 3 Multi-Token Retrieval | 在完整 Mamba-2 中检验初始化和距离效应 | pp. 6–7;图 2 |
| 4 Logical Rules Retrieval | 用规则名称变化区分记忆与检索 | pp. 7–9;图 3 在 p. 8 |
| 5 Tool-Calling SSMs with Tool-Retrieval | 将机制带到预训练模型与自然语言工具调用 | pp. 9–10;图 4 |
| 6 Discussion | 概括机制,提出更丰富状态转移的后续方向 | pp. 10–11 |
| A Related Work | ICL、复制、门控和长度泛化的相关研究 | p. 14 |
| B.1 Short context retrieval – extended version | 梯度流、初始速率、约化动力学与逃逸时间证明 | pp. 15–18;式 (B.1)–(B.4) |
| B.2 Long context generalization – extended version | 旋转对称性、条件高斯分布、局部性证明 | pp. 18–21;式 (B.5)、引理 6–7、命题 8–9 |
| B.3 How representative is a static gate? | 用训练前后门控漂移检验固定门控近似 | p. 21;表 1 |
| C Weak Tool Retrieval | 外部检索不完美时,大工具池的收益与代价 | pp. 21–22;图 5 |
| D Additional Experimental Details | 各实验架构、数据生成、优化与统计口径 | pp. 23–25 |
参考文献位于 pp. 11–13;本文未逐篇研读所引外部论文。
一:动机——为什么“有容量”仍然学不会检索?
固定大小的递归状态确实限制任意长序列上的精确回忆,但“当前测试准确率低”并不能独自证明状态容量不够。训练数据往往同时提供两条降损失的路径:记住训练中反复出现的映射,或者学会匹配当前上下文。只要前者更早产生稳定梯度,模型就可能长时间停留在这个次优解附近。
本文关注的门控是历史状态的衰减。它与输出门、MoE 路由门等其他“gating”概念应区别理解。在作者简化模型中,门控越强,旧信息到达查询位置时越弱;但直接根据查询向量读取参数记忆的路径仍然存在。这形成不对称的优化竞争。
这里的“记忆”指训练权重中的稳定关联,即参数记忆(in-weights memorization);“检索”指利用当前输入里可能已改变的标签,即上下文学习(in-context learning,ICL)。二者都可能在普通测试数据上答对,必须设计能让它们给出不同答案的评估。(Sec. 1–2,pp. 1–3)
二:方法——把记忆与检索分解成两个 margin
2.1 任务如何暴露捷径
先固定 $P$ 个向量 $x_i\in\mathbb R^d$,采自 $\mathcal N(0,I/d)$,并为每个向量固定一个标签 $y(x_i)\in\{-1,+1\}$。每次训练样本提供长度为 $\ell$ 的上下文,再附上查询 $x_q$;查询向量已经在上下文出现。
每次出现时独立扰动标签:
输入 token 将向量和本次标签拼接,查询的标签坐标设成零:
目标是本次上下文中的 $\widetilde y(x_q)$。 扰动不是应该被模型“纠正”的错误标注。若 $\epsilon=0.1$,背下固定标签可以得到 90% 的单标签准确率,但无法应对剩余 10% 的翻转;读取当前上下文才有机会全对。
教学例子: 训练中某个 key 通常对应 $+1$,这一次上下文却明确标成 $-1$。输出 $+1$ 暴露了参数捷径,输出 $-1$ 才是在遵循当前示例。该例仅用于解释任务,不是额外实验。(Sec. 2.1,pp. 2–3)
2.2 简化模型与符号
模型以 logistic loss $\log(1+\exp(-\widetilde y f))$ 训练。分类预测应理解为 $\operatorname{sign}(f)$。作者将其联系到一个固定恒等 Q/K/V 投影的单头 Mamba-2 S6 简化层;实际可训练参数仅为 $\lambda$ 和读出向量 $w$,不能视为完整 Mamba-2 的精确理论。
| 符号 | 含义与方向 |
|---|---|
| $d$、$P$、$\ell$ | key 向量维度、固定 key 数量、上下文项数 |
| $\epsilon$ | 每次标签翻转概率;短上下文分析取 $(0,1/2)$ |
| $\Delta=\ell-i+1$ | 匹配 token 到查询的距离 |
| $\lambda$ | 对数衰减率;越大,历史衰减越强 |
| $\alpha_\Delta=\exp(-\Delta e^\lambda)$ | 距离 $\Delta$ 上的保留权重;越大,门控越弱 |
| $\tau=e^{-\lambda}$ | 简化模型中的衰减时间尺度;$\alpha_\Delta=e^{-\Delta/\tau}$ |
| $w=(w_x,v)$ | $w_x\in\mathbb R^d$ 读取 key 身份,$v\in\mathbb R$ 读取标签坐标 |
| $u=y(x_i)(w_x^\top x_i)$ | 对固定标签的参数记忆强度 |
| $\delta_m=(1+\alpha)u$、$\delta_r=\alpha v$ | 记忆 margin、检索 margin,均为无量纲量 |
训练初始化是 $w=0$、$\lambda=\lambda_0$。门控强弱与 $\alpha$ 大小方向相反,阅读图时最容易混淆。
在短上下文理论中,作者进一步把输入看成精确正交;高维且 $P\ll d$ 的高斯向量只是这一近似的动机。固定查询位置后:
不翻转时 margin 是 $\delta_m+\delta_r$;翻转时是 $-\delta_m+\delta_r$。于是 $\delta_r>\delta_m$ 恰好表示检索强到足以纠正参数记忆在翻转样本上的错误。$w_x=0,v>0$ 已经给出正交任务上的正确分类解,表明这里存在可行检索解。(Sec. 2.2–2.3,p. 3;App. B.1,p. 15)
2.3 初始学习速率为什么偏向记忆
命题 1 给出初始 margin 增长率之比:
其来源很直接。零读出初始化使 $\dot\alpha(0)=0$,并有
$u$ 是单个 key 特有的参数方向,其梯度摊到 $P$ 个 key 上;共享的 $v$ 接收各个 key 的共同检索信号。再乘上输出端的保留权重,就得到检索 margin 的 $\alpha^2$ 抑制。
因此,较大的 $P$ 减少单个映射的重复收益,较大的 $\epsilon$ 削弱稳定标签捷径,而较小的 $\alpha$ 强烈压制检索。作者据此给出小 $\alpha$ 下的临界尺度:
分析补充: 这是初始速率的近似阈值,不是任意训练阶段的严格相变。若令 $s=\sqrt{(1-2\epsilon)/P}$,从原式解出速率相等得到 $\alpha=s/(1-s)$,还需落在可行区间 $(0,1]$。图 1a 使用 $P=32,\epsilon=0.1$,标注的 0.158 是近似值;精确初始速率交点约为 0.188,而图中 margin 是训练 25 步后测量的。三者不能当成同一个量。(命题 1,pp. 3、15;图 1a,p. 5;App. D.1,p. 23)
2.4 记忆平台与逃逸时间
固定 $\alpha$ 且让检索读出 $v=0$ 时,期望 logistic loss 在
处唯一最小,因此平台上的记忆 margin 是 $\delta_m=\kappa$。这不是 100% 的任务准确率,而是纯记忆模型在存在翻转时的最优置信度。$\epsilon=0.1$ 时 $\kappa=\log 9$。
作者把轨迹近似限制在该平台,并忽略门控方程中的较高阶项,得到
其中
在 $0\le r\le\kappa$ 上有正的常数上下界。命题 4 证明,在这组约化动力学中,初始 $v(0)=0$、$\alpha(0)=\alpha_0\to0$ 时,到 $\alpha v=\kappa$ 的首次时间满足
证明的关键不是硬解三维系统,而是用 $v$ 当作时钟。令 $b=\log(1/\alpha)$,两条微分方程相除:
从而
作者证明 $v_T=\Theta(1)$,积分主要由平台早期贡献。直觉是:最初检索信号极弱,$v$ 很难增长;一旦它增长,门控也逐步减弱,检索改善形成正反馈。
代入 $\alpha_0=e^{-\Delta e^{\lambda_0}}$,这个渐近式对应
这解释距离上的指数困难,以及对数衰减率上的双指数敏感性。但它不等于对完整 Mamba、有限学习率、AdamW 或 Muon 的收敛定理。完整梯度流接近平台的误差控制与最终达到任意精度,不能仅由此命题自动获得;正文的“最终可以逃离”应连同约化假设阅读。(App. B.1,pp. 16–18)
2.5 长上下文:保留信号也保留了干扰
接下来作者更换分布以排除参数记忆:key 是新采样的高斯向量,标签独立均匀为 $\pm1$,相当于 $P\to\infty$、$\epsilon=1/2$。这不是继续使用前面的有限固定字典。命题 5 利用旋转对称性证明:期望损失的梯度流从零初始化出发保持 $w_x(t)=0$,且 $v(t)>0$。因此分类边界可用 $v=1$ 分析。该命题证明正性,不单独证明正文提到的 $v=\mathcal O(1)$ 收敛界。
标签坐标成为
令 $S_2(\ell,\lambda)=\sum_{j=1}^{\ell}\alpha_j^2$。条件于查询及标签,
这一步利用独立高斯干扰的精确分布,而不只是中心极限定理近似。引理 6 给出基于这个标量统计量的最优判别为 $\operatorname{sign}(g)$,条件错误率为
$\Phi$ 为标准正态分布函数。这里的“Bayes error”只针对标签坐标 $g$ 中的信息,不是给任意能访问全部输入的算法设定的错误率下界。(App. B.2,pp. 18–19)
2.6 两个极限,以及局部性的必要限定
无衰减极限。 固定 $\ell\ge2$,令 $\tau\to\infty$,则所有权重趋近 1,干扰项数变成 $\ell-1$:
高维时 $\|x_q\|\approx1$。只有进一步让 $(\ell-1)/d\to\infty$,错误率才趋于 $1/2$。不能把“无衰减”本身说成在任何长度都随机猜测。图 1c 的 $d=128,\ell=1024$ 给出无衰减准确率约 0.638,与图中水平线一致。(命题 8,p. 20;图 1c,p. 5)
有衰减时的有效干扰量。
这将干扰从随总长度 $\ell$ 增加,变成主要由 $\tau$ 决定。然而目标保留权重仍以 $e^{-\Delta/\tau}$ 衰减,所以近似信噪比具有
的结构。对固定容许错误率 $\delta\in(0,1/2)$,命题 9 在 $1\le\tau=o(d)$、$\ell/\tau\to\infty$、$\|x_q\|=\Theta(1)$ 下给出距离尺度
因此长序列中的近处检索与长序列任意位置的检索是不同能力。相关 token 保持靠近查询时,增加远处干扰可以不致破坏性能;如果目标随上下文增大不断远离,强门控也会忘掉它。有限序列中实际可谈的距离不超过 $\ell$;本笔记把该量解释为衰减限定的可检索尺度,而不把渐近式外推到不存在的位置。上述渐近条件也不能覆盖任意极端门控值。(引理 7、命题 9,pp. 19–21)
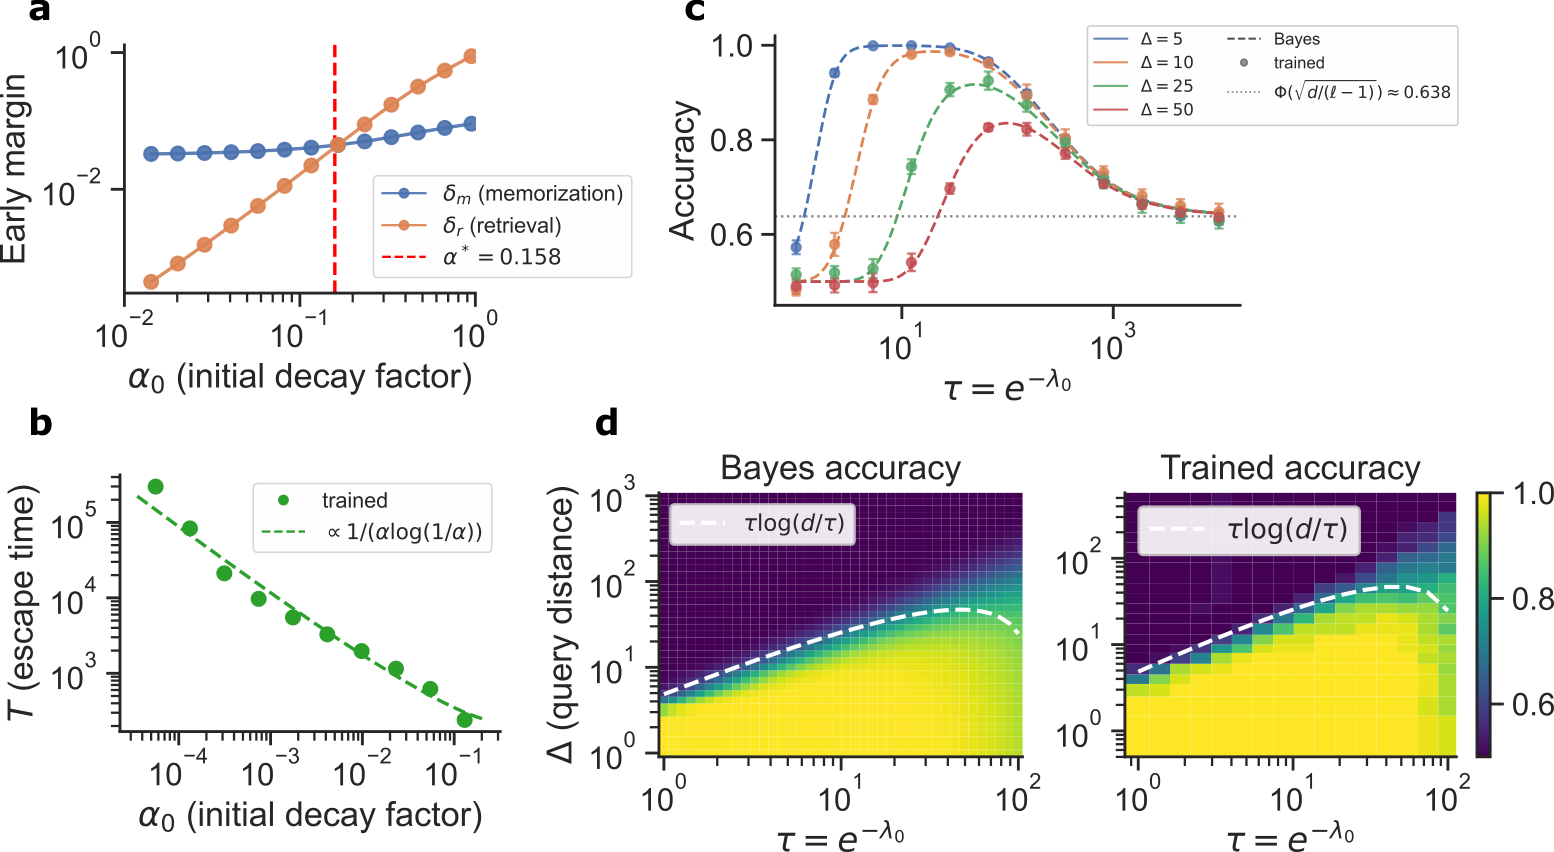
图 1,PDF p. 5,作者原图。a 的横轴为初始保留权重 $\alpha_0$,纵轴为早期 margin;b 为 $\alpha_0$ 对逃逸时间,均采用对数坐标。c 横轴为时间尺度 $\tau$,颜色区分查询距离,显示过强与过弱衰减都可能降低准确率。d 比较标签坐标 Bayes 准确率与训练结果,横轴为 $\tau$、纵轴为距离 $\Delta$,色彩越亮准确率越高,虚线表示理论距离尺度。这些图支持简化理论的趋势,不能证明所有 SSM 都服从同一条数值曲线。
三:实验——每组实验到底在控制什么?
3.1 简化理论验证:四个面板采用不同配置
作者使用简化 SSM 与 SGD,基础学习率 0.1,batch size 128。(App. D.1,p. 23)
| 图 1 面板 | 配置 | 测量对象 |
|---|---|---|
| a | $d=512,P=32,\ell=8,\Delta=4,\epsilon=0.1$ | 25 次梯度更新后的两个 margin |
| b | $d=512,P=32,\ell=4,\Delta=1,\epsilon=0.1$;学习率改为 0.3 | 记忆平台逃逸时间 |
| c | $d=128,\ell=1024$;训练 10,000 步 | 随 $\tau$ 与查询距离变化的准确率 |
| d | $d=128,\ell=512$;训练 10,000 步 | $\tau$—距离平面上的准确率热图 |
这些设置没有与后面的多层模型混用。图 1 的重复次数、误差条统计定义未在上述实验说明中交代,不能套用图 2 的五种子口径。
3.2 多 token 检索:把捷径放进完整 Mamba-2
每个 key 和 value 均长 8 tokens,词表大小 64;静态字典有 10,000 对。训练样本含 $n\sim\mathrm{Unif}\{1,\dots,512\}$ 个 KV 对,每个 value token 以 0.1 概率扰动,查询比例为 $q=0.1$。只背静态 value 的作者基线是
它对应完整 8-token value 的准确率,而不是 90% 的逐 token 准确率。论文称指标为 sequence accuracy,但没有进一步明确多查询如何聚合;不能把 0.4305 写成“一次包含多个 query 的所有答案同时正确”的概率。
实验分为两种任务布局:
| 布局 | 查询对象 | 主要考验 |
|---|---|---|
| best-first | 上下文最前面的 $qn$ 个 key | 较远的信息能否参与学习,是否卡在记忆解 |
| best-last | 最后面的 $qn$ 个 key | 相对更近的目标面对更大干扰池时能否泛化 |
best-last 并不意味着所有目标到查询的 token 距离严格固定,因为 $qn$ 也随 $n$ 增大。它是偏近处的实验布局,而不是命题 9“固定局部距离、总长度无限增大”的完全等价实现。
Mamba-2 使用 24 层、$d_{\rm model}=768$、扩展因子 2、24 个 head、head 维度 64、状态维度 128;Transformer 对照是 12 层 GPT-NeoX,宽度 768、12 heads、FFN 3072、全 RoPE、FlashAttention 2、无 dropout。两者输入输出 embedding 均绑定。这里的 Transformer 用于比较检索学习与长度外推,论文没有报告这一组精确参数量或等 FLOPs 匹配。
Mamba 每个 head 默认 $\lambda\sim\log(\mathrm{Uniform}(1,16))$,实验统一平移 $\lambda\leftarrow\lambda+\Delta\lambda_0$。负偏移弱化衰减,0 为默认值。优化使用 AdamW:峰值学习率 $3\times10^{-4}$,$\beta=(0.9,0.95)$,weight decay 0.1,5% 线性 warmup 后 cosine decay 到峰值的 10%,梯度裁剪 1.0,batch size 128,bfloat16,最多 100,000 步,sequence accuracy 到 99% 提前停止。(Sec. 3,p. 6;App. D.2,pp. 23–24)
3.3 逻辑规则:学会规则语义与记住规则名称不是一回事
任务采用只有一个输入和一个输出命题的 Horn clause,形如 $A\to B$。实际配置为三个命题集合 $M=3$,每个集合含 128 个命题,相邻集合之间各有 $K=128$ 条规则,需要两轮选择到达目标。模型每轮输出所选规则的四位数字名称,规则本身固定,名称可以重采样。主文示意图 3a 是概念图,实际配置应以附录 D.3.3 为准。
这里要区分两件事:模型可以在权重中学到固定图上的“哪个后继能到目标”,但仍需要检索本次上下文中该条规则使用的新名称。因此该实验不是证明模型从零学会任意陌生逻辑系统。
检索学习实验中训练池大小至多 32,正确规则被随机注入;最前 10% 规则的名称按样本重采样。两个诊断评估如下:
- No oracle: 正文将此评估描述为不额外注入正确规则,仍能输出相应旧名称体现参数记忆倾向。考虑到任务允许多条通向目标的路径,应把它视为诊断指标,而非精确分离后的参数记忆概率。
- Random oracle name: 在与训练一致的前部区域注入正确规则并重采样其名称,检验模型是否读取当前名称。
主要指标为首轮准确率:选择一条可让目标继续可达的规则即算正确,并允许不止一条正确路径;它不等于两轮完整轨迹成功率。
长度实验另行训练:所有名称每次都重采样,池大小训练至多 8,测试至多 128;更相关规则放在靠近查询的一端。不能把它与训练上限 32、部分名称固定的诊断实验混为一组。
Mamba-2 为 4 层、16 heads,head 与 state 维度均为 256;Llama 风格 Transformer 为 4 层、8 heads,每头维度 128。使用 Muon,峰值学习率 $10^{-3}$,10% warmup 后 cosine decay,batch size 128。作者说明 AdamW 在扫参后仍训练不稳定,故选 Muon;优化器可能影响平台的具体持续时间。(Sec. 4,pp. 7–9;App. D.3,pp. 24–25)
3.4 工具调用:预训练之后、SFT 之前干预门控
评估对象是 BFCL 的 python simple 子集,原始单候选工具配置被改成多工具池。所有工具汇入共享池,用 BM25 按与用户查询的相关性排序,取前 $k$ 个;如果未取到正确工具,则将其随机注入。工具按 best-first 顺序呈现,最相关候选在前,对查询距离较远。
模型配置如下:
| 条目 | Mamba | Transformer |
|---|---|---|
| 架构 | Mamba-2,32 层,宽度 2048 | Llama 风格,28 层,宽度 2048 |
| 参数量(含 embedding) | 1.5B | 2B |
| 预训练 | 同为 Nemotron-CC-HQ 的 300B tokens | 同左 |
| 预训练配置 | 序列长度 4K、batch 256、AdamW、峰值 lr 0.0003、weight decay 0.1、cosine decay | 同左 |
| SFT 数据 | Nemotron Agentic 工具调用 split | 同左 |
| 工具池 | 训练上限 24;图 4 测试到 72 | 同左 |
门控干预为在 SFT 前把衰减率乘以 $s$:
图 4 使用 $s\in\{0.06,0.12,0.25,1,4,8,16\}$。$s=1$ 保留预训练门控,$s<1$ 弱化门控;不是将 $\lambda$ 直接乘以 $s$,也不是在推理时临时改动。
准确率越高越好: 按 BFCL 确定性 checker 检查完整调用,函数和参数均需正确。
幻觉率越低越好: 输出调用在语法上有效,但函数名不在本次候选工具池中。它不是全部错误率,不衡量事实幻觉,也不能与准确率互补相加为 1。
作者交代了 SFT 使用 AdamW,但未完整报告该阶段的步数、学习率、数据量、随机种子与置信区间。模型参数量不同,故更有说服力的门控证据是同一个 Mamba 系列内部的 scale 干预,而不是从架构间差异推出门控是唯一原因。(Sec. 5,pp. 9–10;App. D.4,p. 25)
四:结果——按照原文的论证顺序读图
4.1 图 1:理论与简化模型训练相符,但对应的是有限适用域
图 1a 显示随着初始 $\alpha_0$ 增大,检索 margin 更快增长;b 的逃逸时间随 $\alpha_0$ 变小显著延长,与约化方程的渐近尺度相近。c 尤其重要:固定查询距离时,准确率随 $\tau$ 并不单调,过强衰减丢目标,过弱衰减积累噪声。d 显示理论局部性轮廓与训练热图大体一致。
这里最有价值的证据不是某个“最佳门控数值”,而是两条机制被分开检验:门控抑制检索的学习梯度;门控也抑制推理中的干扰方差。 这两种作用来自不同分布假设,不能合并为一个已经证明的全局最优训练方案。
4.2 图 2:默认初始化可以长期停在 43% 左右
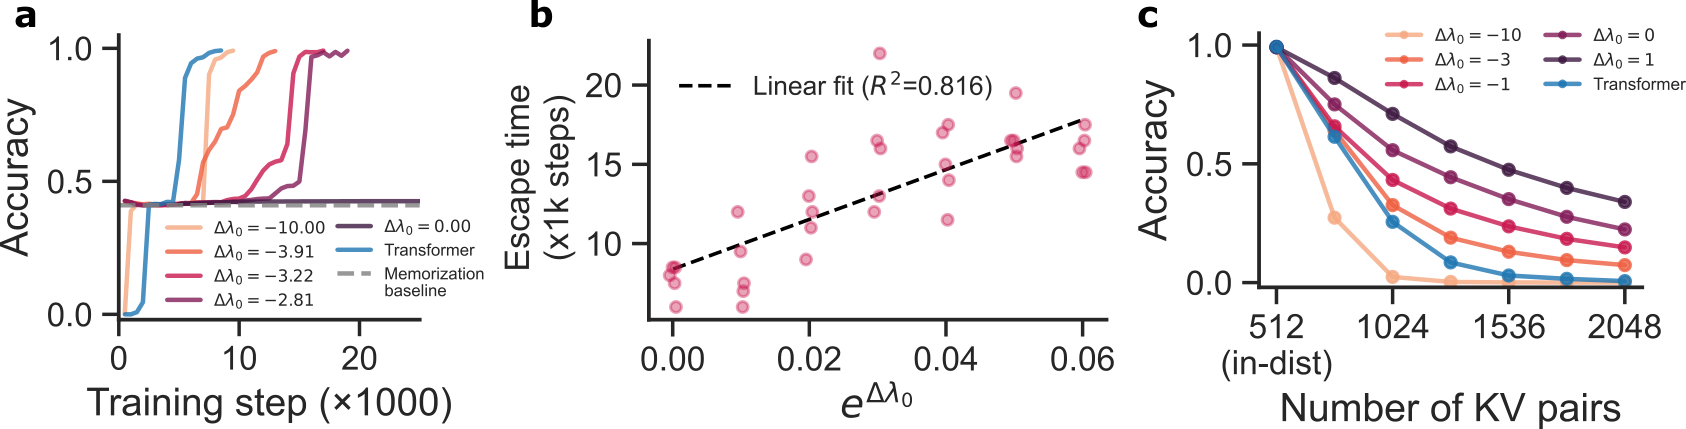
图 2,PDF p. 7。a 横轴为训练步数,纵轴为 sequence accuracy;颜色表示门控偏移,虚线为记忆基线。b 横轴为 $e^{\Delta\lambda_0}$,纵轴为首次超过 0.95 准确率的训练步数。c 横轴为 KV 对数量,纵轴为准确率,训练长度上限为 512 对。
- best-first 学习: 更负的偏移更快离开约 0.43 的平台。默认初始化在 100,000 步内未逃离;这是附录报告的训练上限,图 a 本身只展示较早一段时间。不能据此声称默认模型“永远无法检索”。
- 统计口径: 图 a 展示五个种子中逃逸时间居中的一条训练曲线,不是均值;图 b 展示全部五种子的点,线性拟合 $R^2=0.816$。逃逸阈值是准确率大于 0.95,与理论的 $\delta_r=\delta_m$ 定义不同。
- best-last 外推: 测试 $n\in\{512,768,1024,1280,1536,1792,2048\}$,平均值来自五种子,附录说明阴影为 95% 置信区间。较强门控退化更慢;在 2048 对处,偏移 $+1$ 的准确率约 0.35,最弱门控与 Transformer 接近 0。这里 0.35 是读图约值,不是作者另有精确表格;结果说明相对更好,并非长长度上保持完美。
参数化核验: Sec. 3.2 用“$\alpha\propto e^{-\mathrm{offset}}$”连接理论与线性拟合。但按照本文实际定义,对固定单头与距离应是
故不能从约化理论严格推出 $T\propto e^\delta$。完整模型还有多 head、输入相关时间步及多层交互。图 2b 的线性关系应当视为有限扫描区间内的经验拟合,不是已验证的理论指数律。(Sec. 3.2,p. 6;App. D.2,pp. 23–24)
4.3 图 3:名称重采样揭开记忆捷径,局部排序帮助长度外推
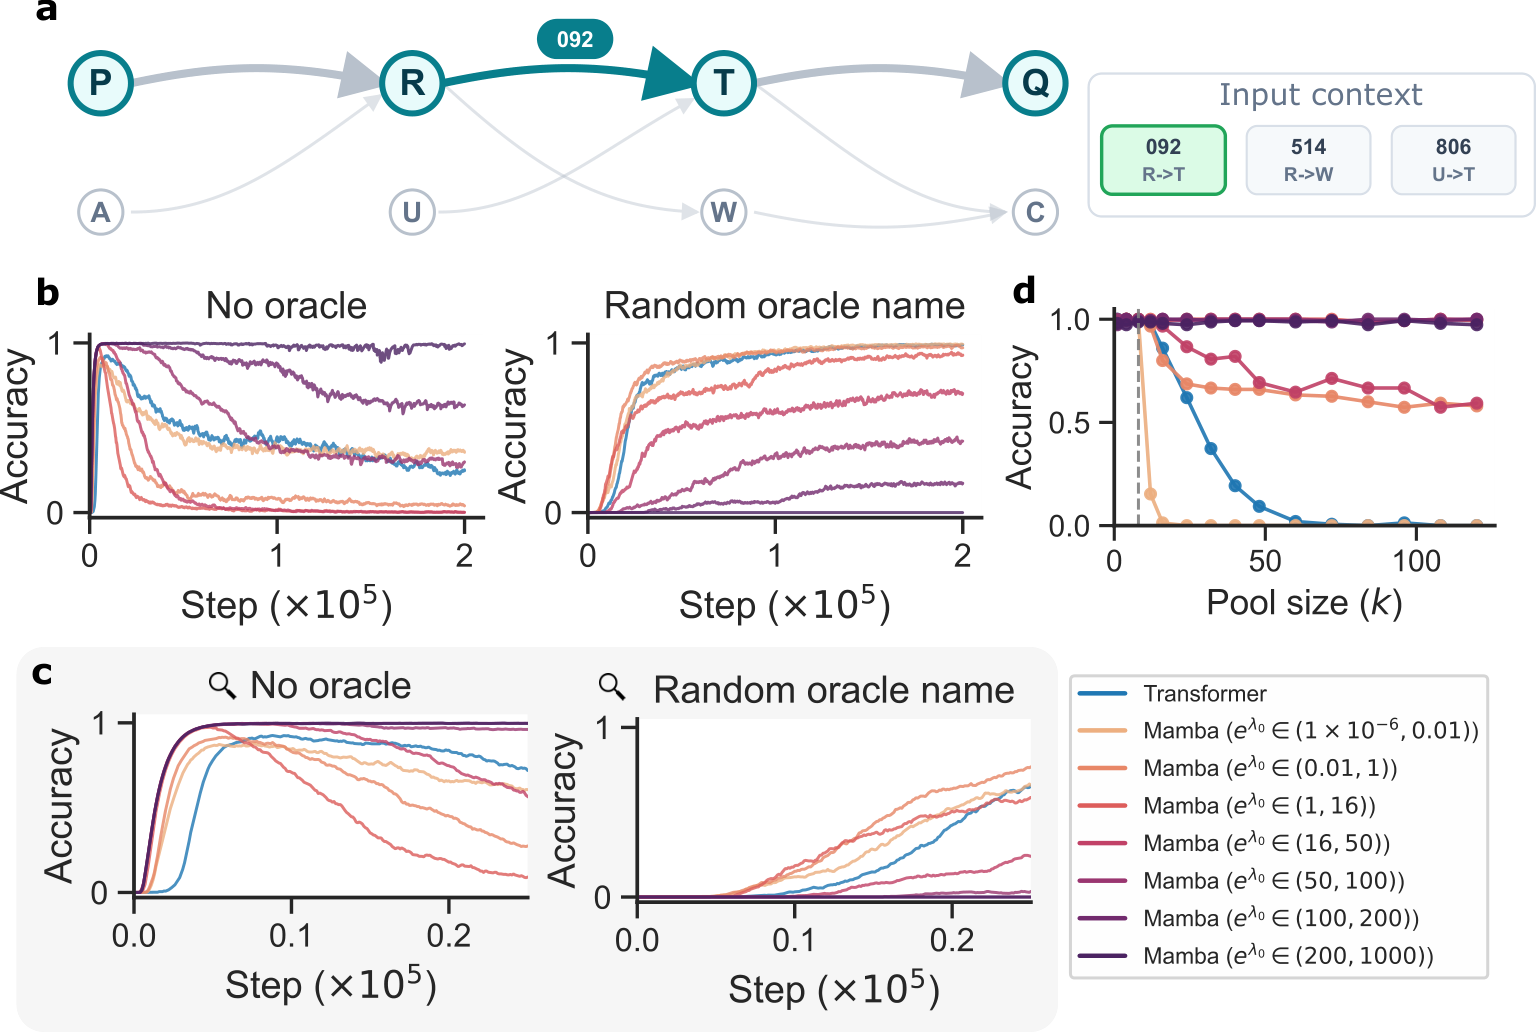
图 3,PDF p. 8。a 为规则选择示意;b 左图是不注入 oracle 时的准确率,右图是 oracle 名称改变时的准确率;c 放大训练初期,横轴单位 $10^5$ 步;d 横轴为工具池大小,虚线为训练上限 8。图例给出不同的初始衰减率区间 $e^{\lambda_0}$,越深的紫色代表越强衰减。
记忆与检索相互印证。 强门控长期维持较高 no-oracle 准确率,同时对改名 oracle 表现很差;弱门控较快提高改名准确率。部分模型早期先升高 no-oracle 准确率,随后下降,正是“先背旧名称、后依赖当前名称”的轨迹。no-oracle 分数降低在此不必解释为能力退化,它可能意味着模型更遵循提供的工具列表。
长度泛化的前提改变了。 图 d 在全部名称随机化、相关规则靠近查询的设置下,强门控曲线到 128 个候选仍接近满分;Transformer 与最弱门控快速下降。这支持局部检索下抑制干扰的作用,不能转述为“强门控能准确读取任意远处的规则”。
报告限制。 原文对逻辑实验没有给出像图 2 那样清晰的多种子与置信区间说明;曲线差异可以描述,但不能补造显著性检验。
4.4 图 4:弱化预训练门控改善工具调用,收益幅度与外推结论要分开
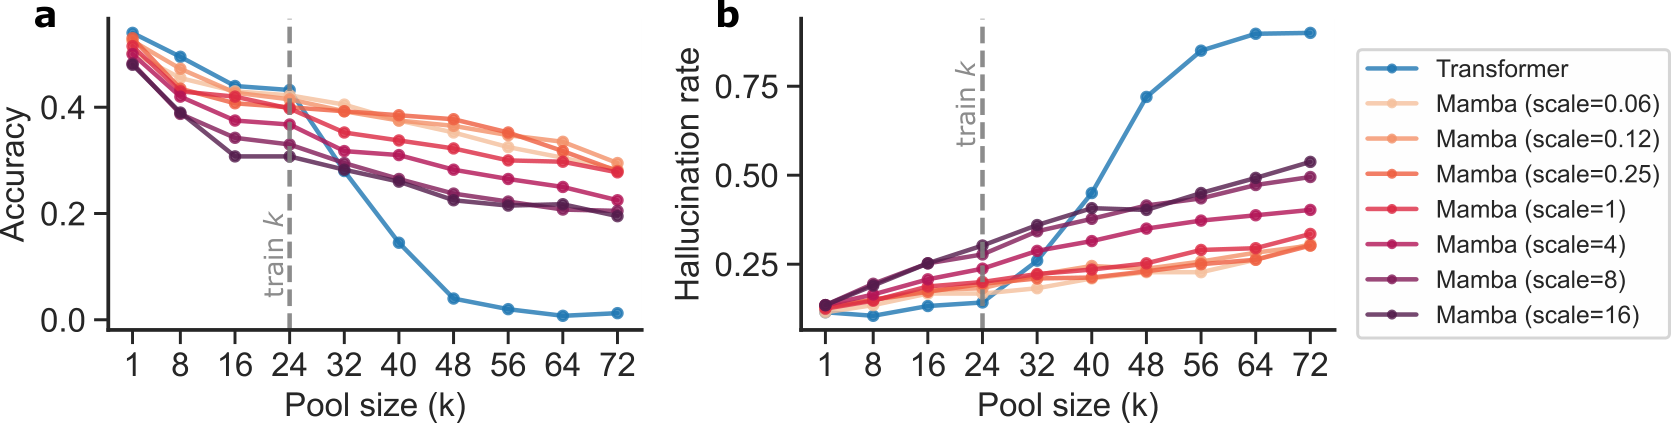
图 4,PDF p. 10。a 为完整调用准确率,b 为池外函数幻觉率,横轴均为工具池大小,竖虚线在训练上限 $k=24$。颜色区分 Mamba scale,蓝色为 Transformer。
同一 Mamba 系列中,较弱门控总体准确率较高、幻觉较少;最强的 $s=8,16$ 明显更容易输出列表中不存在的工具。少数弱化配置还优于未经缩放的 $s=1$,说明预训练学到的门控不一定最适合后续工具调用任务。不同弱化值之间并非严格单调,未报告置信区间,不能把小差异称为统计显著提升。
为便于把握量级,$k=72$ 处读图得到:
| 模型组 | 完整调用准确率,约值 | 池外函数幻觉率,约值 |
|---|---|---|
| Transformer | 0.01–0.02 | 0.90 |
| 弱门控 Mamba,$s=0.06,0.12,0.25$ | 0.28–0.30 | 0.30–0.32 |
| 强门控 Mamba,$s=8,16$ | 0.20–0.21 | 0.50–0.54 |
这些是曲线视觉估读的范围,不是原始评测日志或精确百分点差。论文未给出对应数值表。
需要保留的原文限定: Sec. 5.2 明确表示,在此次探测范围内门控强弱没有显示出明显不同的长度泛化趋势,各个 Mamba 都比该 Transformer 基线更能外推。不能用前面合成任务的结论,改写为“BFCL 已证明更强门控带来更好的长度泛化”。此外,主实验补入漏掉的正确工具,主要考验模型读取与调用能力,并没有同时测量 BM25 漏召回造成的端到端失败。
4.5 表 1:固定门控近似有经验依据,门控并非没有变化
附录 B.3 在图 3d 对应实验中统计训练 200,000 步前后各 head 的有效长度中位数:
| 初始中位数 $\tau$(tokens) | 训练后中位数 $\tau$ | 报告的 $\lvert\Delta\alpha\rvert$ |
|---|---|---|
| $2.1\times10^4$ | $1.2\times10^4$ | $4\times10^{-5}$ |
| 297 | 315 | 0.001 |
| 17 | 14 | 0.024 |
| 2.8 | 3.0 | 0.083 |
| 1.4 | 1.4 | 0.067 |
| 0.8 | 0.7 | 0.053 |
| 0.2 | 0.2 | 0.007 |
来源:表 1,PDF p. 21。初始跨约五个数量级的排序仍被保留,所以初始化可作为训练后门控区间的代理。然而第一行 $\tau$ 也发生了明显相对变化;“相对整个扫描范围变化不大”不能等同于每个 head 恒定不变。这里以单步保留率解释 $\tau=-1/\log\alpha$,应与前文距离 $\Delta$ 上的 $\alpha_\Delta$ 区分。
4.6 图 5:外部检索器不完美时,不能只优化单次读取能力
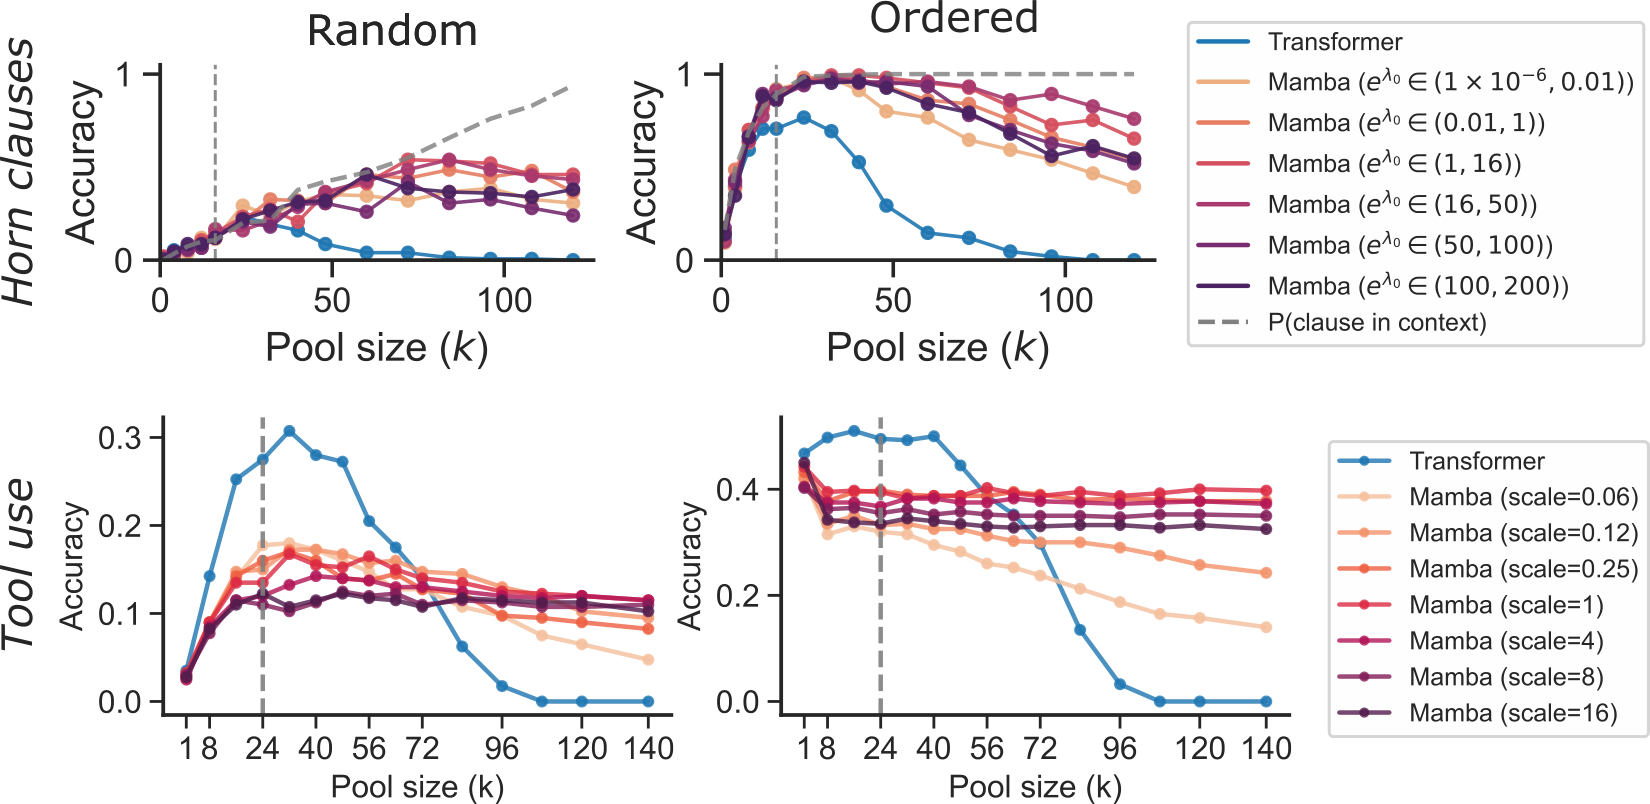
图 5,PDF p. 22。上排为 Horn clauses,下排为工具调用;左列是接近随机的检索,右列是有噪声但有序的检索。灰色虚线曲线在规则任务中表示正确规则进入上下文的概率,竖虚线表示训练池大小上限。
附录 C 取消主实验中“正确候选必在池中”的保证,以 Plackett–Luce 排序噪声控制候选质量。$\beta=0$ 为随机,$\beta\to\infty$ 趋向确定性排序;在本文参数化里,$\beta$ 越大检索器越强,即使作者将其称为 temperature,也应按这个方向理解。两类任务的 $\beta$ 数值不可直接比较:规则任务使用 0 与 1,工具调用使用 0.05 与 10。
更大池有两个相反作用:提高候选召回率,也加重模型选择负担。若成功要求正确工具在池中,可用如下教学分解帮助理解:
这是解释框架,不是作者拟合的模型;若评估允许正确的池外调用,需额外保留“工具不在池中仍答对”的项,不能无条件套用。
图 5 中适度门控通常能较好利用增大的池,弱门控在较大池时更容易失去条件成功率。尤其下排有序工具池中,$s=1$ 等中间配置保持较稳定表现,而 $s=0.06$ 随池增大显著下降。这说明主实验“弱门控较好”的排序会随检索器和布局变化。左下随机工具池曲线也并非全部单调上升,不能笼统声称“工具越多越好”。
五:结论、边界与值得继续检验的问题
5.1 最值得记住的贡献
论文把 SSM 的检索困难拆成了解存在、解能否及时学到、解在更多干扰下能否保持有效三个层次。短上下文理论明确给出一个可检索的模型,却因门控而优先走参数记忆捷径;长上下文理论则显示,仅增加保留长度会引入噪声。这解释了弱门控改善某些复制与 ICL 任务、强门控改善某些长度外推任务为何可以同时成立。
这项工作的实用启发是:评估门控时应同时控制目标距离、干扰规模、稳定映射重复程度、候选排序与外部召回率。单一平均准确率容易把不同能力混在一起。它没有证明一套统一初始化能解决全部问题;更高维或非线性状态转移是作者提出的后续研究方向,尚未在本文验证。(Sec. 6,pp. 10–11)
5.2 原文核验中发现的差异
| 位置 | 原文差异或推导边界 | 本笔记的处理 |
|---|---|---|
| Sec. 2.4,p. 4;App. B.2,p. 20 | 正文命题 8 显示 $\Phi(-\sqrt{d/\ell-1})$,附录正式结果是 $\Phi(-\lVert x_q\rVert\sqrt{d/(\ell-1)})$ | 使用附录公式;分母应为干扰项数 $\ell-1$。正文表达在 $\ell>d$ 时甚至会出现负根号,判断为排版或代数笔误 |
| Sec. 3.2,p. 6;App. D.2,p. 23 | 以 $\alpha\propto e^{-\mathrm{offset}}$ 解释逃逸时间线性拟合,不符合 $\lambda$ 的实际偏移定义 | 保留图 2b 的经验结果与 $R^2$,不声称严格推导成立 |
| Sec. 2.3,p. 4;App. B.1,pp. 16–18 | 对最终逃逸的概括,强于命题 4 对约化动力学的严格覆盖范围 | 明确区分完整训练、平台近似与该近似内的渐近定理 |
| Sec. 2.4,p. 4;命题 5,pp. 18–19 | 正文提到 $v=\mathcal O(1)$,命题 5 实际证明的是 $w_x=0,v>0$ | 分类讨论只依赖正号,不把它引为幅度收敛定理 |
这些问题不抹去经验趋势,但影响该如何准确转述理论。
5.3 证据的适用范围
- 简化理论限制。 短上下文采用正交 key、固定位置、全局标量门控和期望梯度流;长上下文采用独立高斯 key、随机标签与固定门控。全模型的多层、输入相关选择与优化器都超出这一证明。
- 局部性限制。 强门控带来的长上下文收益依赖相关候选位置;保持近处信号不等于解决任意位置的长程检索。
- 实验范围限制。 主要实验为受控合成任务,真实任务只测改造的 BFCL 子集。逻辑任务的语义图固定,不是一般复杂规划的证明。
- 比较与统计限制。 BFCL 的 1.5B 与 2B 不是等参数比较;除多 token 实验外,多种子与区间报告不充分,不能给小差异添加未报告的显著性。
- 工程结论限制。 没有报告门控干预后的普遍语言建模质量、广泛下游退化、端到端时延或吞吐量收益。不能据此承诺减少幻觉而无其他代价。
- 复现材料限制。 本次获取的作者源码主要是论文、图件与参考文献,未包含实验训练实现与逐点评测数据;部分 SFT 超参数缺失。本文训练总算力报告为低于 28,288 H100 GPU 小时,属于作者估计,本次未复核算力账目。(App. D.5,p. 25)
5.4 本次分析提出的后续实验
以下是读者建议,均不是本文已经取得的结果。
- 在完全相同的任务和参数预算下,联合扫描“目标距离 $\Delta$ × 干扰项数 × 门控强度”,避免仅凭 best-first 与 best-last 的不同数据分布推断一个全局最优。
- 同时记录每层每 head 的有效保留权重、参数记忆诊断与检索 margin,检查最终模型是否通过其他层补偿了某些 head 的强衰减。
- 先以弱门控学会检索、再增强部分遗忘,能否绕开平台并保留外推能力?需要直接做训练日程干预,不能由本文自动推出。
- 在工具调用中同时报告检索器 recall、给定正确工具在池中的调用成功率和池外函数率,并交换候选排列顺序,识别改善来自召回、读取还是参数记忆。
- 对预训练后修改门控,补测通用语言能力与多种 BFCL 子集,确认任务收益是否带来其他能力损失。
适合组会讨论的问题是:如果目标是学习“何时保留、何时遗忘”,单个衰减标量是否足够,还是需要能区分目标与干扰方向的状态更新? 本文建立了这个问题的动机,答案仍需新的理论与实验。