SpectralShift:通过谱重参数化扩展 Gated DeltaNet 上下文
- 原题:SpectralShift: Effective Context Window Extension of Gated DeltaNet via Spectral Reparameterization
- 作者:Zian Liu、Yiwen Hu、Zican Dong、Tian Xie、Wayne Xin Zhao、Yucheng Ding、Ran Tao、Bryan Dai。
- 版本:arXiv:2609.14320v1;提交于 2026-09-13;获取及研读日期:2026-09-18。
- 原始材料:arXiv · 本地 PDF · 作者 TeX · 源码清单。已读取主 TeX 的正文、全部实质性附录 A–I,并用同版本 28 页 PDF 核对图表、公式及页码。参考文献用于确认文内来源,未逐篇阅读被引论文。
- 配套成品:英文组会幻灯片 · 可编辑 TeX。作者在论文中给出的代码地址为 GDN-SpectralShift;本次未运行作者训练代码或复现实验。
论文总览
核心问题是:模型能接受更长输入,并不意味着递归状态能把有用信息保留到查询位置。 对混合注意力模型,只调整全注意力层的位置编码并继续预训练,可能没有解决 Gated DeltaNet(GDN)层原先学到的遗忘速度与新依赖长度之间的失配。
SpectralShift 把这个问题写成有限时间状态转移矩阵的奇异值问题:长程信息需要足够多的“慢衰减方向”,写入信息也需要进入这些方向;与此同时,模型还要保留可快速清空旧状态的分量。方法只在扩展训练开始时围绕全局均值收缩 α 投影权重,并在训练中缩小该投影的学习率,两者都使用 $s=\sqrt{L_{\rm ref}/L_{\rm tar}}$。
最明确的主实验结果是:在 1.5B 总参数、0.6B 激活参数的混合 GDN-MoE 上,8K→32K→128K、10B+10B token 的训练设置下,五个评测长度的 RULER 分数均值从 52.38 升至 55.18,即 +2.80 分,约 +5.35% 相对提升。但 128K 评测点本身是 43.1→44.6(+1.5 分),不能把跨长度平均提升写成该点提升。也不能将结果概括为每个任务、每个长度都上升。(Sec. 5.2,Table 3,PDF p. 6)
结构地图
以下均为从 1 开始的 PDF 页码;本文件不替未编号的原文公式编造编号。
| 原文章节 | 作用 | 页码与关键证据 |
|---|---|---|
| 1 Introduction | 线性递归层扩窗失配与方法概览 | pp. 1–2,Fig. 1 |
| 2 Preliminary | GDN 更新、有限时间衰减、慢谱带 | pp. 2–3 |
| 3 Analysis: Understanding Long-Context Retrieval through Spectral Dynamics | 慢模态数量与写入对齐诊断 | pp. 3–4,Tables 1–2 |
| 4 Method: SpectralShift for Long-Context Continual Pretraining | 初始化、学习率、联合谱变化 | pp. 4–6,Algorithm 1,Lemma 1,Theorems 1–2 |
| 5 Experiments | 主结果与三类消融 | pp. 6–8,Tables 3–6 |
| 6 Related Work;7 Conclusion | 相关工作定位及总结 | p. 8 |
| Limitations;Ethics Statement | 小模型验证范围与作者声明 | p. 9 |
| A Analysis Details | 门控参数化与精确谱分解 | pp. 12–13 |
| B NIAH Spectral Analysis Details | 针位置、SVD 计算、快头计数 | pp. 13–14,Tables 7–8 |
| C Derivation of the Square-Root Length-Scaling Exponent | 条件性的平方根规则推导 | pp. 14–15 |
| D Proofs for alpha-Centered Spectral Initialization | 单调性及固定轨迹边界 | pp. 15–17 |
| E One-Step State Response During Length-Scaled CPT | 模块微扰、状态响应、共享衰减界 | pp. 17–20 |
| F Positive Spectral Displacement and Slow-Band Expansion | 正初始化裕量、扰动预算、快头保持条件 | pp. 20–25 |
| G Pre-Training Experiment Details | 架构、训练、数据配比 | p. 25 |
| H Evaluation Results;I RULER Evaluation Variance | 分任务结果及方差 | pp. 25–28,Tables 9–11 |
一:动机——需要多少条能活到终点的信息通道?
全注意力直接访问历史 token,计算成本随序列长度平方增长;GDN 用固定大小的矩阵状态压缩历史,GDN 层的递归计算可随长度线性增长。压缩的代价是,旧信息需要经过连续状态转移才能到达未来查询。如果只增加输入窗口,原来的遗忘速度可能让早期信息在到达查询前就消失。(Sec. 1,pp. 1–2)
只追求“最长记忆时间”也不够:即使有一个方向衰减很慢,其他信息仍可能没有空间保存。作者因此同时看慢谱带的宽度与写入对齐。反过来,把所有方向都变慢也不是目标:状态清理与上下文切换需要快衰减分量。快谱与具体功能的联系是作者的机制解释;论文的快头计数并不是直接的上下文切换行为测试。
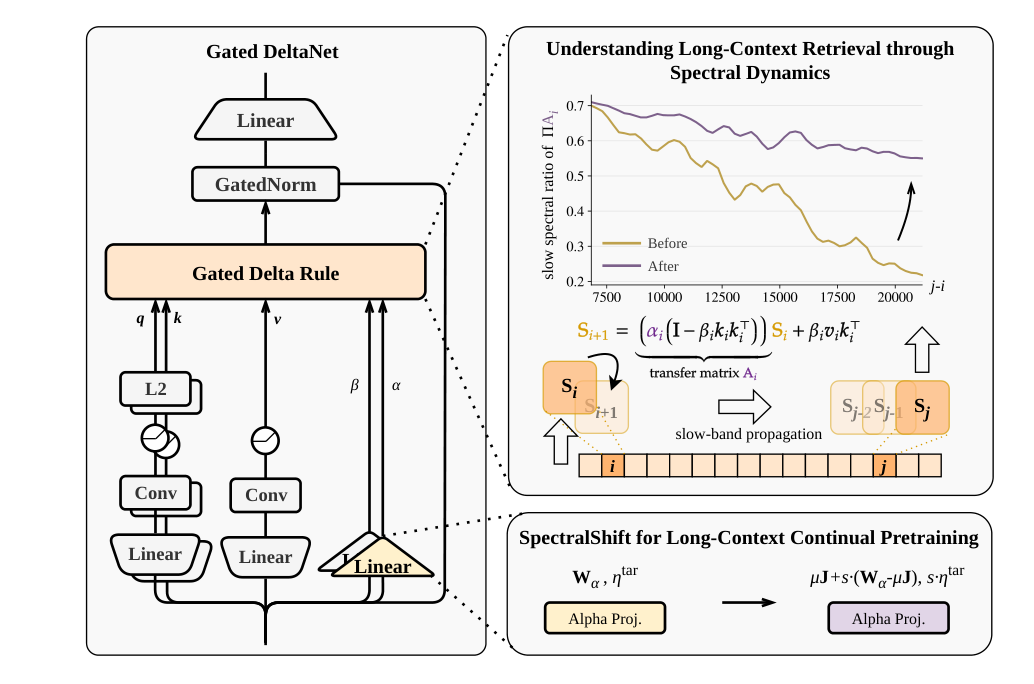
原图:Fig. 1,PDF p. 2,复用作者矢量图并转为 PNG。左侧定位 α 投影在 GDN 中的位置;右下展示权重及学习率修改;右上横轴为传播距离、纵轴为慢谱比例,After 曲线展示更慢的容量流失。该概览图没有误差带,定量结论应以 Tables 1–6 及附录协议为准。
二:方法——改共享衰减,同时让其他分支继续学习
2.1 GDN 的状态与符号
| 符号 | 含义与维度 |
|---|---|
| $\mathbf h_t$ | 当前层输入,$\mathbb R^{d_{\rm model}}$ |
| $\mathbf k_t,\mathbf q_t$ | key 与 query,$\mathbb R^{d_k}$;推导假设 $\|\mathbf k_t\|_2=1$ |
| $\mathbf v_t$ | value,$\mathbb R^{d_v}$ |
| $\mathbf S_t$ | 每个头的状态,$\mathbb R^{d_k\times d_v}$ |
| $\alpha_t$ | 标量保留门,$(0,1]$ |
| $\beta_t$ | 标量更新门,$(0,1)$ |
| $\ell=j-i$ | 该任务实际依赖距离,以 token 计,不一定等于总窗口长度 |
| $\gamma_r$ | 第 $r$ 个奇异方向的衰减率,量纲为每 token |
采用附录 E.4(PDF pp. 18–19)与状态维度一致的写法:
原文符号问题:Sec. 2(p. 2)把加性项写为 $\beta_t\mathbf v_t\mathbf k_t^\top$;附录 E.4 写成 $\beta_t\mathbf k_t\mathbf v_t^\top$,后者也与 Sec. 3.2 的残差写入和上述状态约定一致。虽然作者令 $d_k=d_v$,方阵尺寸相同仍不消除 key/value 轴含义的差异。本笔记和幻灯片统一使用附录 E.4 的形式,并明确这一选择。
归一化 key 时,$\mathbf A_t$ 在 key 方向的特征值为 $\alpha_t(1-\beta_t)$,其余方向为 $\alpha_t$。因此 α 控制整个头的共享衰减,β 和 key 控制方向性擦除。但多步矩阵通常不交换,不能直接把逐步特征值相乘当成长期记忆谱。(App. A.2,pp. 12–13)
2.2 有限时间转移与慢谱带
令 $\sigma_r(\boldsymbol\Phi)$ 按降序排列:
这里的“谱”主要指有限时间乘积的奇异值谱,不是单步特征值谱。α 的乘积对同一头所有奇异值做相同缩放,在衰减率上表现为共同平移。
慢谱带保留的是“经过当前任务距离后,振幅至少剩 $e^{-1}\approx0.368$”的方向。这是诊断阈值,不是检索正确的充分条件,也不是原始 token 存储容量的精确计数。(Sec. 2,p. 3)
教学例子,非实验数据:假设每步在某方向保留 0.9999,8,000 步后约剩 $e^{-0.8}=0.449$,32,000 步后约剩 $e^{-3.2}=0.041$;它可以满足较短任务的阈值,却无法满足较长任务。这个例子只解释累计衰减,不包含真实模型的方向变换。
2.3 有慢通道,还必须写进去
将针位置的更新重排为
在固定实现轨迹的分析里,该残差写入经后续转移得到 $\boldsymbol\Phi_{i\to j}\mathbf k_i\Delta\mathbf v_i^\top$。若 $\boldsymbol\Phi=\mathbf U\boldsymbol\Sigma\mathbf V^\top$,进入慢输入子空间的比例为
$E_{\rm write}\in[0,1]$,只衡量 key 的方向对齐;它不包含残差 value 的大小、未来 query 的读出对齐或多次写入干扰。因此它能支持机制解释,但单独不能预测检索准确率。(Sec. 3.2,p. 4;App. B.1,p. 13)
2.4 初始化:围绕全局均值缩放
对每个待处理的 α 投影矩阵,计算其所有元素的全局均值 $\mu_\alpha^{\rm ref}$;$\mathbf J$ 为同形状全 1 矩阵。
这保留权重均值、收缩权重偏差,不是直接把 α 门值乘以 $s_1$,也不是逐行中心化。固定输入时,投影可写成 $\mathbf a_t(s_1)=\mathbf c_t+s_1\boldsymbol\xi_t$,其中 $\mathbf c_t=\mu\mathbf J\mathbf h_t$。
门控参数化为
附录 A.1(p. 12)说明 $A_{\log},b_{dt}$ 在这些实验中固定于预选值。减小 $s_1$ 时:$\xi_t>0$ 则 α 增大、遗忘变慢;$\xi_t<0$ 则 α 减小、遗忘变快。Lemma 1 是逐 token 单调性结论,既不保证每个头都变慢,也不保证一定同时出现变慢和变快的头。(Sec. 4.1,pp. 4–5;App. D,pp. 15–17)
固定隐藏轨迹、β 和 key 后,同一头所有有限衰减率有共同位移;真实多层网络修改上游 α 会改变后续隐藏状态,所以不能把这一精确的局部结论当作全网恒等关系。
2.5 为什么是平方根?
附录 C(pp. 14–15)以 $s=0$ 的中心化响应作分析基准,定义长度 $L$ 上累计 log-retention 偏移 $\Delta_L(s)$,以及其跨输入方差 $\mathcal D_L(s)$。假设中心化的逐 token 响应累积方差为 $\Theta(L)$,且在所考虑的数据和缩放范围内一致成立,则
令 $\rho=L_{\rm ref}/L_{\rm tar}$,在幂律族 $s_k=\rho^k$ 中,目标与参考方差之比为 $\Theta(\rho^{2k-1})$。使扩展比例变大时该量级不爆炸也不消失,要求 $k=1/2$。
“最优”因此是给定幂律族、累计方差增长假设和尺度匹配目标下的指数选择,不是直接对检索损失求全局最优。权重元素中心化也不自动意味着激活 $\xi_t$ 的加权时间均值为零。作为本次分析:若长期相关性让累计方差偏离线性增长,上述推导就需要重新检验。
2.6 训练:只降低 α 投影学习率
其余可训练参数按原学习率继续目标长度持续预训练(continual pretraining,CPT)。固定单层输入、有界更新方向与局部敏感性时,Theorem 1 / App. E.7 给出
这个界限制整个头的共享谱移动速度,保留其他分支调整方向性转移和写入的能力。正文余项写作较松的 $O(s_2^2\eta)$;附录在 $0<\eta\le1$ 下解释了它与二次余项的关系,不能简单认定二者冲突。(p. 5;pp. 17–20)
附录 E 进一步把一次训练更新引起的状态变化分成 α、β、key、value 四类驱动力,经原轨迹的 $\boldsymbol\Phi$ 向后传播。α 学习率缩放同时影响均值分量 $\Delta c$ 和偏差分量 $\Delta\xi$;训练时并不冻结均值。长度一致的高阶余项界还需累计二阶敏感性有界。
教学用流程:8K→32K 时 $s=0.5$;8K→128K 时 $s=0.25$;32K→128K 时 $s=0.5$。每次扩展从该阶段的参考 checkpoint 重新计算均值和长度比。先改权重,再设置独立优化器参数组,再进行 CPT。推理使用训练后的普通 GDN,无需在线做 SVD。论文实现拆分融合的 in_proj 并用自定义 kernel 融合前后向;没有给出量化吞吐或耗时收益。(Algorithm 1,p. 4;App. G.2,p. 25)
2.7 联合保证:哪些条件才能让慢谱带真的变宽?
Theorem 2 定义 $D_r=\gamma_r^{\rm ref}-\gamma_r^{\rm after}$,于是 $D_r\ge\gamma_r^{\rm ref}-1/\ell$ 即可进入慢谱带。单看正文,这是阈值条件;实质性的充分条件在附录 F(pp. 20–25):
- 正初始化裕量:令 $b_t=c_t+b_{dt}$,$\kappa_t$ 为 softplus 在相关线段上的最小二阶导数,$M=\sum_t\sigma(b_t)\xi_t$、$V=\sum_t\kappa_t\xi_t^2$。若 $V>0$ 且 $M\ge-(1+s)V/4$,累计标量衰减减少量满足 $g\ge G=e^{A_{\log}}(1-s^2)V/4>0$。证明使用凸性积分,不依赖截断 Taylor 展开。
- 全网扰动预算:选择 $G\ge g_\star>0$,对已实现的训练轨迹要求 $|P^{(u)}-\widetilde P|\le g_\star/4$,且 $\|\mathbf R^{(u)}-\mathbf R^{\rm ref}\|_2\le a(1-e^{-g_\star/4})$。$P$ 是累计标量衰减,$\widetilde P$ 是参考轨迹上初始化后的量,$a$ 是参考方向乘积的奇异值下界。
- 正位移与计数:对 $\sigma_r(\mathbf R^{\rm ref})\ge a$ 的排序奇异值,可得 $D_r^{(u)}\ge g_\star/(2\ell)$。取 $a=e^{-(1+d)}$、$0
- 预算如何维持:初始扰动须有正剩余裕量;局部可微、key 归一化前非零,硬 MoE 路由需处于固定路由区域;全参数累计更新范数须不超过给定半径。仅把 α 学习率乘 $s$ 并不自动控制上游层及其他参数的全部变化。
- 快分量另行保证:慢带扩张的下界不自动给出快头保持。一个简单充分条件是 $\widetilde P-b_\alpha>1/\tau_0$;当 $\tau_0=0.1$ 时右侧为 10。只对通过条件认证的参考快头成立。
附录 F.7 给出非空构造:$g_\star=0.05,d=0.02,s=1/4$,参考近边界模态 $\ell\gamma_r\approx1.016455$ 在保证至少 0.025 的位移后进入慢带,同时另一个 $P=11$ 的快头仍保持快。这证明充分条件可以同时成立,不是对实际 10B/20B 训练运行逐步验证这些条件。排序奇异值的索引也不等于跨 checkpoint 跟踪同一个奇异向量。
三:实验——区分诊断模型、主模型与纯 GDN
3.1 谱诊断协议
按附录 B.2–B.3(pp. 13–14):从 4K checkpoint 分别扩展到 8K 与 32K;配对的 Low/High 组训练数据、随机种子、学习率相同,High 增加 α 初始化重参数化。分析混合模型的 12 个 GDN 层×8 个 key 头,共 96 个层头。针位于 0.2/0.4/0.6/0.8,查询在结尾;8K 的依赖距离为 6535/4896/3258/1619,32K 为 26195/19642/13088/6535。前向 BF16,转移乘积及 SVD 用 FP64。
$H_\ell^{\rm slow}$ 计至少有一个慢模态的层头数,$M_\ell^{\rm slow}$ 计全部慢方向数;二者在最长针—查询距离报告。$E_{\rm write}$ 在全部 96 个层头和四个针位置上平均,无慢模态的头记为 0。NIAH-3 Avg. 为 Single-1/2/3 平均,越大越好。
协议歧义:Table 1 图注(p. 3)称 Low 为原始“pure GDN model”,附录 B.2 则明确写 hybrid、96 个层头及 CPT 对照。本笔记采用更具体的附录协议介绍,但不替作者消除这处矛盾,也不把该组结果与 Table 6 的纯 GDN 实验混用。
3.2 主实验设置
| 项目 | 原文报告 |
|---|---|
| 模型 | 1.5B-A0.6B GDN-MoE,16 层,隐藏维 1024 |
| 混合架构 | 每四层一层全注意力,GDN:全注意力=3:1 |
| GDN 配置 | 卷积核 4,key/value 维度 128,8 key 头、16 value 头 |
| MoE | 160 专家,top-8,专家隐藏维 128,SwiGLU |
| 基础预训练 | Dolma3,500B token,8192 窗口;global batch size 1024 |
| 优化器 | Muon,Nesterov,基础学习率 $8.6\times10^{-4}$;weight decay 0.1,梯度裁剪 1.0 |
| 扩窗 | 32K:10B;64K/128K:直接 20B 或经 32K 的 10B+10B |
| 扩窗批量 | 原文写固定 8M tokens,恒定学习率调度 |
| 位置编码 | 默认全注意力用 ABF 调 RoPE;GDN 用 NoPE |
| RoPE base | 基础 10,000;32K 为 1,000,000;64K 为 10,000,000;128K 未明确列出 |
数据方面,32K CPT 从 Longmino 采样,32–64K 长序列约占 25%,8–32K 占 8%;64K/128K 设置中 64–128K 占 30%,8–64K 占 4%,其余为 mid-training 数据。作者说明超过 128K 的长序列不足,主要以 64K 为实验重点。(Sec. 5.1,p. 6;App. G,p. 25)
Baseline 为同类扩窗 CPT、不采用 SpectralShift 的对照;混合模型默认仍有位置编码调整。General Avg. 汇总 MMLU、LAMBADA、ARC-Easy、WinoGrande、PIQA;RULER 衡量合成长上下文能力,另报告 DROP、RACE。表中分数均以更高为好。论文未完整说明 RULER 总分与 Table 10 九个显示类别之间的聚合权重,不应直接取九列平均替代原总分。DROP/RACE 的评测模板和详细评分实现也未在文中展开。
四:结果——支持什么,不能推出什么
4.1 慢容量与写入对齐同步改善
| 窗口 | $H^{slow}$ Low→High | $M^{slow}$ Low→High | $E_{write}$ Low→High | NIAH-3 Avg. Low→High |
|---|---|---|---|---|
| 8K | 18→22 | 1036→1308 | 0.1006→0.1503 | 8.60→32.93 |
| 32K | 15→19 | 984→1109 | 0.0964→0.1819 | 10.07→30.47 |
来源:Tables 1–2,pp. 3–4。两种窗口均出现更宽的慢带和更大写入重叠。该配对实验与提出的机制一致,但没有独立固定容量并干预对齐,因此不能拆出两个因素各自贡献多少。
快头用 $\tau_1=-1/\log\sigma_1(\Phi)<0.1$ 定义,即该头最慢方向也足够快。8K 快头数 4→5,32K 为 5→5。(Table 8,p. 14)这支持“仍保留极快分量”,不能证明所有快模态数量和功能完全不变,也不能证明原有每个快头身份都保持。
4.2 主结果:目标长度均有收益,幅度取决于训练路径
| 目标长度 / CPT 预算 | 目标点 RULER Baseline | SpectralShift | 差值(分) | General Avg. Baseline→方法 |
|---|---|---|---|---|
| 32K / 10B | 40.6 | 45.8 | +5.2 | 54.3→53.1 |
| 64K / 10B+10B | 41.6 | 45.4 | +3.8 | 55.0→55.6 |
| 64K / 20B | 46.4 | 48.4 | +2.0 | 54.8→55.0 |
| 128K / 10B+10B | 43.1 | 44.6 | +1.5 | 53.7→54.8 |
| 128K / 20B | 41.9 | 42.2 | +0.3 | 52.9→54.0 |
来源:Table 3,p. 6。所有这些目标点均提升,但不能据此保证任意窗口内都提升:64K / 20B 在 16K 评测时方法为 59.7,baseline 为 60.5。32K 训练的 General Avg. 还下降 1.2 分,DROP 从 22.3 降到 21.5。
128K 两阶段的完整 RULER 序列(8/16/32/64/128K)为:方法 64.6/60.1/56.7/49.9/44.6,对照 64.3/57.2/51.9/45.4/43.1;均值分别 55.18 和 52.38。这里 +5.35% 是 $(55.18-52.38)/52.38$,不是 +5.35 个百分点。
路径也重要:128K 方法的两阶段结果明显优于直接 20B;但 64K 的目标点直接 20B 更高(48.4 vs 45.4),所以不能说分阶段总是更优。
4.3 消融:初始化和学习率配合更可靠
Table 4(p. 7)单独报告 8K→128K 消融。为避免原文把长度比也叫 $s$ 的符号冲突,下表用 $\rho=L_{ref}/L_{tar}$。
| 配置 | General | R-8K | R-32K | R-64K | R-128K |
|---|---|---|---|---|---|
| 不重参数化、不缩学习率 | 54.0 | 57.6 | 47.4 | 43.6 | 42.8 |
| 仅初始化,$\rho^{0.25}$ | 55.1 | 60.0 | 49.1 | 41.2 | 38.4 |
| 初始化+LR,$\rho^{0.25}$ | 54.9 | 61.8 | 50.0 | 42.1 | 40.7 |
| 仅初始化,$\rho^{0.5}$ | 54.1 | 61.4 | 50.6 | 43.5 | 39.8 |
| 初始化+LR,$\rho^{0.5}$ | 54.3 | 63.8 | 52.5 | 48.5 | 42.9 |
| 初始化+LR,$\rho$ | 52.2 | 61.3 | 51.4 | 43.5 | 40.1 |
平方根组合在各 RULER 长度列中最高;相对仅平方根初始化,R-64K 提高 5.0 分、R-128K 提高 3.1 分。可是相对无方法的消融 baseline,R-128K 只有 +0.1,不能概括为 128K 大幅提升。更强收缩伤及一般能力。缺少“只降学习率、不改初始化”的独立行,所以表格支持组合优于只初始化,但未完整隔离两种模块各自的必要性。该表 baseline 与 Table 3 不同,不能把两表行拼接成同一次对照。
4.4 位置编码兼容性
Table 5(p. 7)在最大评测长度报告的方法与 baseline 差值:
| 扩窗 | DroPE | YaRN | ABF |
|---|---|---|---|
| 8K→32K,评测 32K | +1.0 | +0.2 | +5.2 |
| 32K→64K,评测 64K | +1.1 | +1.0 | +6.3 |
这是“可以和不同全注意力位置编码策略结合”的证据,但并非各长度都改善:8K→32K 的 YaRN 在 8K 是 54.3 vs 57.1,在 16K 是 47.1 vs 47.4;32K→64K 的 DroPE 在 8/16/32K 也略低。
跨表冲突须保留:Table 5 的 32K ABF DROP 写 25.1/25.9,而 Table 3 对应行是 21.5/22.3;Table 5 的 64K ABF RULER 列为 59.7/52.7/45.4/38.5(方法),而 Table 3 两阶段行为 64.0/59.7/52.7/45.4。前者部分数字呈错一列的对应关系,但原文未解释,不能自行纠正或断言只是排版错误。主结果采用 Table 3;兼容性按 Table 5 的表内比较陈述。
4.5 纯 GDN:有方向性证据,但绝对成绩仍低
| 扩窗 | Baseline | SpectralShift | 差值 |
|---|---|---|---|
| 4K→8K | 11.11 | 11.96 | +0.85 |
| 4K→16K | 8.00 | 11.25 | +3.25 |
| 4K→32K | 6.43 | 10.63 | +4.20 |
来源:Table 6,p. 8,指标为 RULER Single-1,不是完整 RULER 总分。32K 相对提升约 65.3%,但从很低的 baseline 出发,不代表已实现高可靠检索。正文把纯 GDN 配置指向附录 G,附录主要给出混合架构,独立纯 GDN 的完整训练配置并不清楚。
4.6 分任务与一般能力:平均数掩盖了什么?
Table 9(p. 26)显示 32K 方法的 LAMBADA 43.4 vs 46.7,WinoGrande 51.3 vs 53.5;不能把一般能力写成“无损”。128K 两阶段的五项平均为 54.78 vs 53.68,与主表四舍五入一致,但 MMLU 仍是 37.8 vs 38.0。
Table 10(p. 27)的 64K 直接 20B 在目标点,多 key 任务 48.1 vs 31.9、变量追踪 24.6 vs 11.3 有收益,而多 query 为 35.4 vs 55.4、多 value 为 37.5 vs 61.2,出现显著任务间取舍。128K 直接 20B 的变量追踪在 32/64/128K 都为 0.0,对照为 18.1/19.5/19.2。128K 两阶段在目标点多 query 和多 value 上升,但变量追踪从 22.5 降到 10.5。这些结果限制了“所有检索能力都改善”的说法。
附录 I(pp. 26、28;Table 11)报告所谓 RULER evaluation variance,例如 128K 两阶段在 128K 为 0.0702 vs 0.0636。文中未明确运行次数、方差统计单位、是否跨训练种子及置信区间计算方法;不把它换算为标准误或用来断言 0.1/0.3 分差异显著。
五:结论——最值得带走的认识与复现重点
论文最有用的贡献,是把 GDN 扩窗从单纯的训练长度问题推进到有限时间谱的容量、写入对齐及优化保持问题,并给出工程改动较小的训练方案。其主表支持若干扩窗路径下的目标点改善;条件性理论解释了为什么可以扩张慢带,同时保留部分快头。
边界同样明确:验证主要在 1.5B MoE 上;没有大规模模型或百万上下文验证;谱诊断样本有限且有模型描述冲突;理论预算没有在实际长训练中逐步认证;缺少只改学习率的消融;一般能力与分任务结果存在下降;“高效”没有配套的吞吐、显存或训练耗时对照。混合模型仍有全注意力层,也不能将整个模型都称为纯线性复杂度。
如果要复现,优先确认四件事:第一,分开 4K 谱诊断与 8K 主模型设置;第二,核对 α 分块、均值计算和 Muon 参数组在拆分后的更新尺度;第三,在同训练预算、同位置编码下补齐只调 LR 的对照;第四,同时记录任务点 RULER、各子任务、一般能力及慢/快谱指标,避免只追平均分。128K RoPE base、纯 GDN 配置、评测统计口径与上述跨表差异需要作者代码或进一步说明才能消除。
可用于组会讨论的问题:平方根规则在强相关长文档上是否仍满足方差假设?$E_{write}$ 改善是否只是子空间变宽的自然结果?若采用读出对齐与多写干扰指标,能否解释 multi-query/multi-value 的下降?这些是本次阅读提出的后续问题,不是论文已经验证的结论。