SAS:用端到端上下文排序训练稀疏注意力选择器
原题:SAS: Simple Attention Sparsification via End-to-End Optimization of Context Ranking
作者:Zhiwei Li, Lei Zhu, Hao Gu, Xiang Hu, Yan Wang, Haitao Mi, Sirui Han, Leowei Liang, Zhijiang Guo(依 PDF;arXiv 摘要页将 Leowei Liang 列作 Leo Liang)。
版本:arXiv:2609.13141v1;提交日期 2026-09-11;获取与研读日期 2026-09-18。PDF 首页另印有 September 14, 2026,不将它当作 arXiv 提交日期。
材料:版本化论文页面 · 本地原文 PDF · 作者主 TeX · 作者代码链接(本次未运行)
阅读范围:同版本 PDF 全文 26 页,作者 paper.tex → body.tex → sec/1_intro.tex … sec/7_conclusion.tex,以及 appendix.tex → sec/Z_appendix.tex 中附录 A–E;核对实际引用的原图、公式、表格及参考文献条目。本笔记为分析,不是全文翻译,也不包含独立实验复现。下文页码均为从 1 开始的 PDF 页码,与正文印刷页码一致。
论文总览
这篇论文研究一个很具体的问题:已有稠密 LLM 每步只能读取少量历史 KV 块时,选择器应该学着复现原模型的注意力分布,还是直接学习哪些块有助于最终预测?
SAS 选择后者。它保留 Top-K,但在训练时把选择器输出的连续门控以对数形式加入注意力 logits,使语言模型损失可以经门控回传到选择器。默认冻结主模型,只训练与 SeerAttention-R 相同的 AttnGate。推理时移除连续门控,仅用学到的排序选块,执行普通稀疏注意力。
最有力的证据来自紧预算推理:1024-token 预算下,Qwen3-4B/8B/14B 的 GPQA-Diamond 相对 SeerAttention-R 提升 10.57 / 13.74 / 15.50 个百分点。这并不意味着所有任务都胜出、也不意味着保留了完整长上下文检索能力。附录中 Qwen3-14B、4096 预算、128K RULER,SAS 只有 29.95,完整注意力为 82.23。
结构地图
| 原文章节 | 作用 | PDF 页码与证据 |
|---|---|---|
| 1 Introduction | 稠密注意力蒸馏与预测目标不一致 | 1–3;图 1 |
| 2 Related Work | 区分免训练选择与可训练稀疏路由 | 3–4 |
| 3 Preliminaries | 稠密、稀疏注意力及 Top-K 定义 | 4;式 (1)–(3) |
| 4.1 From Sparse Selection to Context Ranking | 门控与四个设计维度 | 4–5;图 2、式 (4) |
| 4.2 Learning Reliable Block Ranking | 控制实验、梯度解释 | 6–8;表 1、图 3–4、式 (5)–(8) |
| 4.3 Instantiating Simple Attention Sparsification | 最终算法与训练内核 | 8–9;式 (9)、算法 1–2 |
| 5.1 Experimental Setup | 模型、训练、评测和服务后端 | 9–10 |
| 5.2 Post-Training Results | 推理、LongBench、agent 任务 | 10–11;表 2–5 |
| 5.3 Extension to Continued Pretraining | 联合训练主模型和选择器 | 11–12;表 6–7 |
| 6.1 Analyzing the Learned Block Selection | 层内覆盖与跨层召回 | 13–14;图 5、式 (10)–(11) |
| 6.2 Analyzing the Generation Behavior | 输出长度与截断 | 14;图 6 |
| 6.3 End-to-End Decode Efficiency | 稳态 decode 耗时与瓶颈 | 14–15;图 7 |
| 7 Conclusion | 作者总结 | 15 |
| A Training Dynamics | loss 与梯度范数 | 20;图 8 |
| B Limitation | RULER 长上下文退化 | 21;表 8 |
| C Final Performance of Sparse vs. Full Training Scope | 两种训练范围的最终结果 | 21;表 9 |
| D Gradient Derivation | 门位置、STE、训练范围推导 | 21–24 |
| E Kernel Implementation | 前向与反向伪代码 | 24–26;算法 3–4 |
一:动机
1.1 为什么“注意力质量”不等于“预测价值”
传统可训练方法先用轻量选择器给块打分,再取 Top-K。离散索引在分数的小幅扰动下不变,因此语言模型损失无法通过索引操作为排序提供有用梯度。SeerAttention-R 等方法转而蒸馏每一层的稠密注意力分布。
作者认为这种代理监督存在两种错位:一是忽略跨层互补,一个块不必在每层重复读取;二是注意力权重没有完整表达 value 向量及其后续计算对预测的作用。因而,“尽量覆盖该层最高注意力质量”不一定等价于“预算固定时最有助于回答”。这是动机,并非论文已经给出了全局最优排序的证明。(Sec. 1,pp. 1–3)
1.2 SAS 的贡献边界
SAS 的主要贡献是训练信号与门控设计,并非新发明块稀疏结构或 AttnGate。它在已有 block-sparse 框架中引入可微路径,以 LM loss 替代逐层注意力蒸馏。这里的 post-training 是相对于稠密预训练而言,仍然需要训练选择器,不是“无需训练”。
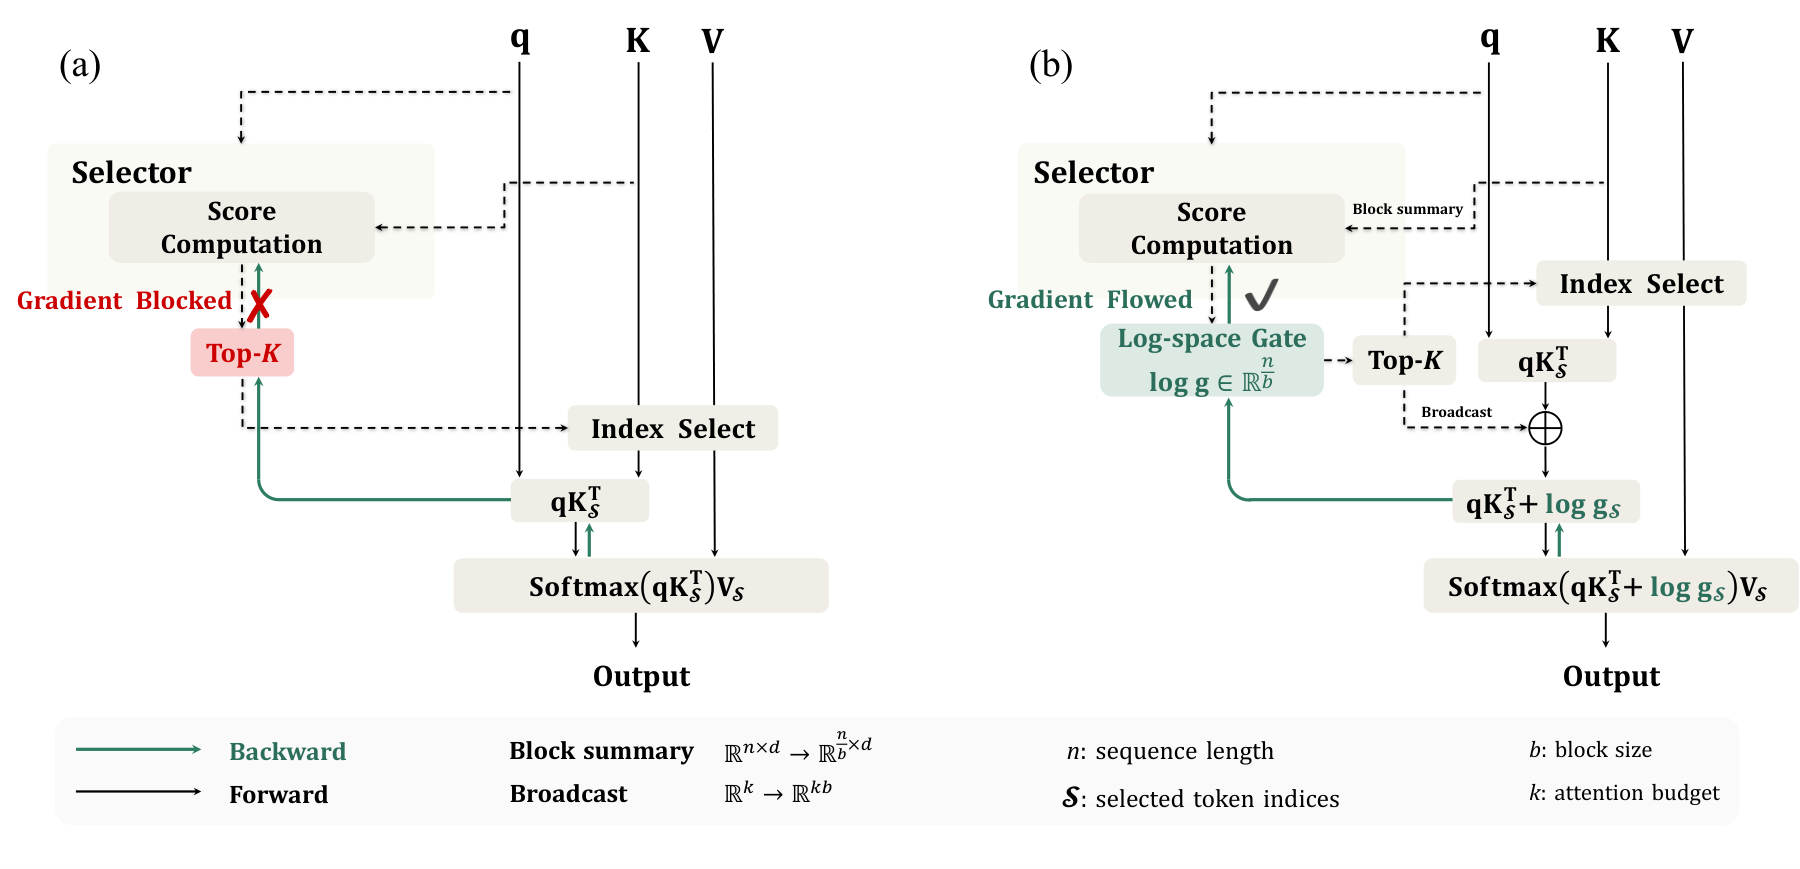
原图 1,PDF p. 2。左侧只有离散 Top-K 路径;右侧增加连续 log-gate 进入 attention logits 的路径。图中的绿色反向路径说明:Top-K 本身仍不具备普通可微梯度,新增门控承载学习信号。
二:方法
2.1 符号与输入输出
| 符号 | 含义与维度 |
|---|---|
| $\mathbf q\in\mathbb R^d$ | 当前 query;为简洁省略 head/batch 维 |
| $\mathbf K,\mathbf V\in\mathbb R^{n\times d}$ | 历史 key/value;原文简化两者维度相同 |
| $B_0$ | 始终保留的当前块,块内采用因果 mask |
| $B_1,\ldots,B_C$ | 候选历史块;最终方法中的 $C$ 不包含当前块 |
| $b=64$ | 每块 token 数 |
| $\mathcal R_\theta,\mathbf s\in\mathbb R^C$ | 选择器及历史块打分 |
| $\mathbf g\in\mathbb R_+^C$ | 历史块 softmax 门控;另设 $g_0=1$ |
| $K,\mathcal I,\mathcal S$ | 所选历史块数、块索引集合、实际注意的 token 集合 |
| $z_i,\mathbf o$ | token 注意力 logit、attention 输出 |
原文式 (1)–(9) 为简洁省略 $1/\sqrt d$;实际内核保留 sm_scale。$K$ 是数量,$\mathbf K$ 是矩阵,不能混淆。论文常用 $Kb$ 标记 token 预算;按算法当前块另行保留,因此不应把“2048 预算”解释为所有时刻实际只访问且恰好访问 2048 个 token。
2.2 训练计算:硬选块与软门控同时存在
首先给全部候选历史块打分并归一化:
再选取历史 Top-K,并并入当前块:
将块门控广播到相应 token,计算(原文式 (9),p. 9):
在默认设置中,最终 next-token LM loss 沿整网反向传播,但优化器只更新选择器 $\theta$。冻结 backbone 参数不等于可以完全跳过其反向链路。梯度经 $\log\mathbf g$ 回传,离散集合选择仍作为当前前向的固定索引处理。所谓“端到端”是最终预测损失能训练选择器,并不等价于对 Top-K 集合求精确导数。
2.3 推理计算:门控移除
算法 2(p. 9)直接从 $\mathbf s$ 取 Top-K,不再计算门控偏置:
softmax 保序,因此用 $\mathbf s$ 或 $\mathbf g$ 选择的集合一致。训练和推理的 attention 数值权重并不一致:训练门控承担排序学习,推理仅使用排序。论文验证这种替代训练方式有效,但没有证明训练目标与最终离散推理目标完全等价。
服务实现中 prefill 用稠密注意力,decode 才用稀疏注意力。SAS 与 SeerAttention-R 使用相同 SGLang/FlashInfer 后端,只加载不同选择器权重。完整 KV 仍可供之后动态选取;该方法不等于永久驱逐未选中的 KV。(Sec. 5.1,p. 10)
2.4 为什么门控要放在 softmax 内部
对 token $i$,设其所在块为 $b(i)$,则
加 $\log g$ 相当于在归一化前乘 $g$,会重新分配注意力质量。相比之下,外部门控 $\operatorname{softmax}(\mathbf q\mathbf K^\top)(\mathbf g\odot\mathbf V)$ 只缩放 value 贡献,没有重新归一化。
原文式 (5)(p. 7,推导 pp. 21–23)给出:
其中 $d\mathbf o=\partial\mathcal L/\partial\mathbf o$。内部梯度比较该 token 的 value 与当前聚合输出,即“把质量重新分配到这里会如何改变输出”。这为相对排序提供了更直接的信号。
2.5 为什么历史块必须做竞争性归一化
原文式 (6)(p. 7):
容易误判的地方是:“softmax 对平移不敏感,减去 LSE 应该没作用。”只有对所有参与 attention 的 token施加同一常数,它才抵消。当前块始终偏置为 0,因此历史块共享的负偏置会改变历史与当前块之间的总质量平衡。同时,历史分数整体加常数不会改变 $\mathbf g$,避免通过整体抬高历史分数绕过排序学习。
教学例子(并非论文实验):两个历史块和一个当前块,各只含一个 token,且 $z_i=0$。历史分数都是 0 时,softmax 门控为 $(1/2,1/2)$,最终三者 attention 为 $(1/4,1/4,1/2)$;若直接注入原始分数,则为 $(1/3,1/3,1/3)$。这也说明“历史门控之和为 1”不意味着历史 attention 必然占一半:一般还取决于各块 token logits 与有效 token 数。
图 3(p. 7)的行对应 L5/L15/L25,列对应 step 50/500/1000/1 epoch,横轴是选择器 logit、纵轴为分布密度。sigmoid 分数走向正饱和,使门接近 1;原始 logit 走向 0,也趋近无偏置 attention。它们可以获得低训练 loss,却没有学出适合离散推理的有效排序。
2.6 为什么保留连续分数,不用二值 STE
比较中,STE 前向将门变成 0/1,但反向以连续门近似。对于被丢弃 token,其代理梯度中可能出现
分母没有自己的 $e^{z_i}$,故该比值可任意大。它不是该 token 实际前向的注意力概率;实际前向权重为 0。作者以此解释早期随机路由遗漏高-logit 块时的巨大梯度范数。(式 (7),p. 8;附录 D.2,p. 23)
软门控前向的实际概率始终不超过 1,但这本身不能推出所有参数梯度都有统一上界:门梯度还含 $1/g_m$、value 和上游梯度。论文给出的强项是具体梯度结构与实测稳定性,而非对任意网络训练稳定性的完整定理。
2.7 为什么默认只在选中块上做 attention
full scope 让全部历史块参与门控 attention;sparse scope 仅在选中块与当前块上计算。归一化 $\mathbf g$ 仍基于全部候选历史分数,不能改成仅在 Top-K 内归一化。
记 $dg_m=\partial\mathcal L/\partial g_m$,$ds_m=\partial\mathcal L/\partial s_m$。对未选块,原文式 (8)(p. 8)为:
sparse scope 中未选块的直接 gate 梯度为零,score 梯度未必为零,它会经 softmax 分母被间接更新,但信号没有评估该块自身内容。图 4(p. 8)对 Top-K=3 的若干 query 作散点图:横轴为 $-g_m$、纵轴为 $ds_m$;上排 sparse、下排 full;未选块在 sparse 下共享同一系数,更新高度相关。它展示早期学习信息不足,不是证明最终一定收敛到同一解。
2.8 训练内核到底做了什么
Sec. 4.3(p. 9)与附录 E(pp. 24–26)给出 FlashAttention 风格 Triton 内核:
- 按 KV tile 流式读取,计算缩放后的 $QK^\top$。
- 对历史块加入对应 log-gate;按 query 阈值 $\tau$ 判定是否入选,未选位置设为 $-\infty$;整个 tile 无 query 选中时跳过。
- 当前块不加偏置,保留因果 mask;用 online softmax 更新输出和 log-sum-exp。
- 反向重算概率,使用 $dS=P\odot(dOV^\top-\Delta)$,其中 $\Delta=\sum_d O_d\,dO_d$,并把每块 token 的 $dS$ 累加成 $d\log G$。
核心节省是避免显式存储完整 $n\times n$ attention 矩阵。阈值表示没有消除寻找阈值/候选排名的所有代价;伪代码的并列分数处理也未展开。论文没有给出完整训练显存和训练吞吐对照表,因此不能把推理速度数字当作训练加速。
三:实验
3.1 四组配置不能混用
| 实验 | 主模型与训练对象 | 数据与关键设置 |
|---|---|---|
| 门控消融 | Qwen3-4B;冻结 backbone | OpenR1-Math-220k 中 93.7K 样本;块 64、Top-K=32;训练与生成上限 32768;GPQA avg@16 |
| 主要后训练 | Qwen3-4B/8B/14B;仅 AttnGate | OpenR1-MATH-220K,1 epoch;AdamW,LR $10^{-3}$,cosine,global batch 32,训练长度 32768;VeOmni/FSDP |
| 继续预训练 | OLMo3-7B stage-1;主模型与新选择器一起训练 | OLMo3 语料约 50B tokens;8192 长度,13000 steps,batch 512;LR 从 $2\times10^{-4}$ cosine 至 $2\times10^{-5}$;块 64、Top-K=32 |
| RULER 限制实验 | Qwen3 系列;训练选择器 | Dolma3 longmino mix 抽样 0.5B tokens;64K packing;non-thinking、YaRN 扩至 128K |
主要后训练用同一训练好的选择器跨推理、长文本和 agent 任务评测,支持一定跨任务迁移。LongBench 使用 non-thinking;agent 评测用 YaRN 扩至 65536。继续预训练改用从 attention 投影初始化的专用 retrieval Q/K 投影,组内 query heads 共享选块,不能说所有实验都用相同 AttnGate。(Sec. 4.2.1、5.1、5.3,附录 B)
3.2 Baseline 的比较角色
- Full Attention:质量参照,读取全部可见上下文;它不是理论性能上界,小样本随机评测允许稀疏模型偶尔更高。
- SeerAttention-R:最重要对照;同 backbone、同 AttnGate 架构,以逐层 attention 蒸馏训练。主要检验训练目标的变化。
- Sliding Window / StreamingLLM:固定局部结构以及 sink+局部结构的免训练选择对照。
- Quest:query-aware 的免训练 KV 选择;1024 预算带星号的结果来自对 SeerAttention-R 图 5 的 WebPlotDigitizer 读数,不是本论文全部重新测得。
- OLMo3-512SWA / HiLS-Attn-RoPE:继续预训练对照。前者窗口设置与 SAS 历史预算并非同一个参数,不能由平均得分单独推断同算力下谁最优。
表 2 的 SeerAttn-R 与 SeerAttn-R# 必须区分:带 # 是本论文复现,只有 4096 组单列。不能把所有预算行都描述为同一次重跑。
3.3 指标和统计口径
推理指标为答题准确率(%),越高越好;控制消融明确为 16 次评测平均,表 2 对若干方法给标准差,但正文对主推理协议主要引用 SeerAttention-R,没有在本文逐项重述温度等采样参数。avg@16 不等于 16 次中任意一次正确的 pass@16。
LongBench 是多任务基准分数,按输入长度或任务类别分组,越高越好,不应全部称为“分类准确率”;本文未完整展开每任务打分及聚合权重。BFCL 表中是 multi-turn 评测分数,越高越好,本文没有逐项展开 evaluator 定义。
VitaBench 报告 Avg@4、Pass@4、Pass^4;通常分别用于平均成功、四次中至少一次成功、四次均成功的不同要求,但 SAS 本文没有重述完整估计公式,本笔记保持原指标名称,不据此推导独立采样概率关系。表中括号按正文宏和表述记作标准差,不冒充置信区间。
平均生成 token 数与达到 32768 上限的截断率越低越好,但必须与答案质量一起判断。decode latency 单位 ms/token,越低越好;speedup 是 dense latency / sparse latency,越高越好。论文没有报告完整显著性检验,不将微小分差断言为统计显著。
四:结果
4.1 门控消融:可反传还不够,排序信号必须有用
Qwen3-4B,2048 token 预算,GPQA-Diamond,1 epoch。数据摘自表 1(p. 6)。除“sparse”一行及噪声近似外,其余门控比较使用 full scope。
| 设计 | 准确率 % ↑ | 平均生成 token ↓ |
|---|---|---|
| Full Attention 参照 | 56.1 | 8547 |
| 内部 + softmax + 连续 + full | 54.4 | 7109 |
| 外部 + softmax + 连续 + full | 41.6 | 13807 |
| 内部 + sigmoid + 连续 + full | 17.0 | 28444 |
| 内部 + raw logits + 连续 + full | 18.8 | 26401 |
| 内部 + softmax + STE + full | 46.0 | 7289 |
| 内部 + softmax + 连续 + sparse(SAS) | 54.8 | 7410 |
| 加噪近似 full scope | 52.2 | 7552 |
内部相对外部提高 12.8 个百分点;连续相对 STE 提高 8.4 个百分点。sparse 在 10 steps 为 24.8、full 为 30.8,但 1000 steps 已为 53.6 vs 53.7,最终为 54.8 vs 54.4。这支持采用更省计算的 sparse,而不是说明 sparse 在任何训练长度都最好。
附录 C 表 9(p. 21)显示多数模型/预算最终接近,但仍有差异,如 8B、1024 GPQA 的 full 为 55.62、sparse 为 53.17。结果支持“接近”,不支持严格等价或已经证明同一最优解。
附录 A 图 8(p. 20)进一步表明:sigmoid/raw logits 的 loss 可低于 softmax,却在稀疏推理失败;STE 也能较快降低 loss,但梯度范数更高。本任务的低训练 loss 不能单独代表高质量离散排序,需同时评估无门控稀疏推理。
4.2 推理:收益主要集中在紧预算和较难任务
表 2(p. 10),1024-token 预算。括号为 SAS 原表标准差;差值均为本次直接相减的百分点。
| 任务 / backbone | SeerAttention-R | SAS | 差值 |
|---|---|---|---|
| MATH500 / 4B | 84.67 | 90.65 (1.1) | +5.98 |
| MATH500 / 8B | 83.57 | 91.27 (1.1) | +7.70 |
| MATH500 / 14B | 86.12 | 92.93 (1.0) | +6.81 |
| GPQA / 4B | 39.84 | 50.41 (2.8) | +10.57 |
| GPQA / 8B | 39.43 | 53.17 (2.9) | +13.74 |
| GPQA / 14B | 45.64 | 61.14 (2.9) | +15.50 |
例如 4B GPQA 的 +10.57 个百分点,约等于相对 Seer 的 +26.5%,两种单位不能混写。完整注意力的 GPQA 为 56.19 / 60.54 / 65.25,因此 SAS 在 1024 仍有 5.78 / 7.37 / 4.11 个百分点缺口。
2048 预算的 AIME 更突出:
| 任务 / backbone | SeerAttention-R | SAS | 差值 |
|---|---|---|---|
| AIME24 / 4B | 55.83 | 68.85 (6.6) | +13.02 |
| AIME24 / 8B | 58.23 | 70.73 (6.7) | +12.50 |
| AIME24 / 14B | 63.65 | 77.76 (6.6) | +14.11 |
| AIME25 / 4B | 45.16 | 56.38 (7.3) | +11.22 |
| AIME25 / 8B | 43.30 | 58.41 (7.2) | +15.11 |
| AIME25 / 14B | 48.70 | 64.19 (7.1) | +15.49 |
1024 的 AIME 没有结果,不能补成 0。Quest 在 2048 的 4B AIME24/25 为 0,但 8B/14B 不为 0,不能泛化成 Quest 在所有模型都完全失败。
4096 时差距缩小,且存在反例:4B MATH500,SAS 93.67,原报告 Seer 94.10;8B GPQA,SAS 60.42,Seer 60.48。SAS 的 4B AIME24 为 71.72 (6.8),full 为 71.25,仅 +0.47,不能凭此宣称显著超越稠密模型。4B AIME25 仍为 59.97 vs full 66.41,未完全恢复。
4.3 LongBench:数学数据训练的选择器可以迁移
表 3(p. 10);以下是各长度桶汇总后的 Avg.,保持原表口径。
| 预算 / 方法 | 4B | 8B | 14B |
|---|---|---|---|
| Full Attention | 52.2 | 54.4 | 56.6 |
| 2048 / Seer | 51.2 | 52.6 | 54.9 |
| 2048 / SAS | 51.5 | 53.4 | 55.8 |
| 4096 / Seer | 51.9 | 53.8 | 55.7 |
| 4096 / SAS | 52.0 | 53.9 | 56.2 |
2048 预算、8K+ 桶中,4B 是 48.4→48.8(+0.4),8B 是 47.6→49.3(+1.7),14B 是 51.5→53.9(+2.4)。改善总体存在,但某些短输入桶持平或略降,且主推理长链和 non-thinking 长文本不是同一种能力。
原文矛盾:引言 p. 3 声称 4B、2048、8K+ 提升 +3.2;最终 PDF 表 3 与作者 TeX 均给出 48.8−48.4=+0.4。本笔记与幻灯片采用表 3,不传播 +3.2。Sec. 5.2 中 14B 的 +2.4 则与表一致。
4.4 Agent 任务:BFCL 全组改善,VitaBench 有明确例外
表 4(p. 11),BFCL Multi-Turn:
| 预算 / 方法 | 4B | 8B | 14B |
|---|---|---|---|
| Full | 35.75 | 42.75 | 44.50 |
| 2048 / Seer | 29.00 | 34.38 | 38.88 |
| 2048 / SAS | 32.50 | 36.75 | 39.50 |
| 4096 / Seer | 33.38 | 39.25 | 43.88 |
| 4096 / SAS | 34.38 | 41.25 | 44.00 |
在这些组合中 SAS 均更高,最大增幅为 4B、2048 的 +3.50;14B、4096 距 full 仍低 0.50。
表 5(p. 11),VitaBench Qwen3-14B 的 Avg@4:
| 预算 / 方法 | Delivery | Instore | OTA |
|---|---|---|---|
| Full | 29.0 (3.3) | 27.2 (2.9) | 12.5 (2.1) |
| 2048 / Seer | 32.2 (3.0) | 19.0 (2.5) | 4.2 (1.4) |
| 2048 / SAS | 30.0 (3.3) | 19.2 (2.5) | 10.2 (1.8) |
| 4096 / Seer | 32.5 (3.1) | 26.7 (2.8) | 11.7 (2.2) |
| 4096 / SAS | 34.2 (3.0) | 28.7 (3.0) | 12.3 (2.3) |
2048 时 Delivery 的 SAS Avg@4 和 Pass@4 均低于 Seer(30.0 vs 32.2;61.0 vs 67.0),但 Pass^4 更高(9.0 vs 4.0)。4096 时 OTA Pass@4 为 27.0,低于 Seer 29.0、full 37.0;Delivery Pass^4 为 4.0,低于 full 8.0。因而“接近完整注意力”需要限定具体指标,不能把平均、至少一次成功与稳定成功混为一谈。
4.5 继续预训练:可行性证据强于全面领先证据
表 6–7(p. 12):
| 模型 | 11 项通用任务平均 ↑ | LongBench 平均 ↑ |
|---|---|---|
| OLMo3-Base | 43.88 | 29.0 |
| OLMo3-512SWA | 43.24 | 28.0 |
| HiLS-Attn-RoPE | 41.68 | 30.0 |
| SAS-RoPE | 43.28 | 30.0 |
SAS 通用平均比 HiLS 高 1.60,和 SWA 只差 0.04,仍低于原始稠密模型 0.60。LongBench 与 HiLS 持平,优于 dense base 1.0。具体任务并非一致:HellaSwag 50.63、Race 74.05 较好;CRUX 仅 19.25,低于 base 24.62 和 HiLS 25.62。GPQA 26.77 也低于 base 29.29 与 SWA 31.31。因此更合理的结论是该训练机制可用于联合继续预训练,不能宣称所有知识、数学和代码能力都恢复。
4.6 选择器到底学到了什么
Sec. 6.1,图 5(p. 13)、式 (10)–(11)(pp. 13–14)。
层内质量覆盖定义为
第一种测 attention 质量,第二种额外考虑 value 范数,但仍不是 value 方向和后续网络作用的完整因果度量。
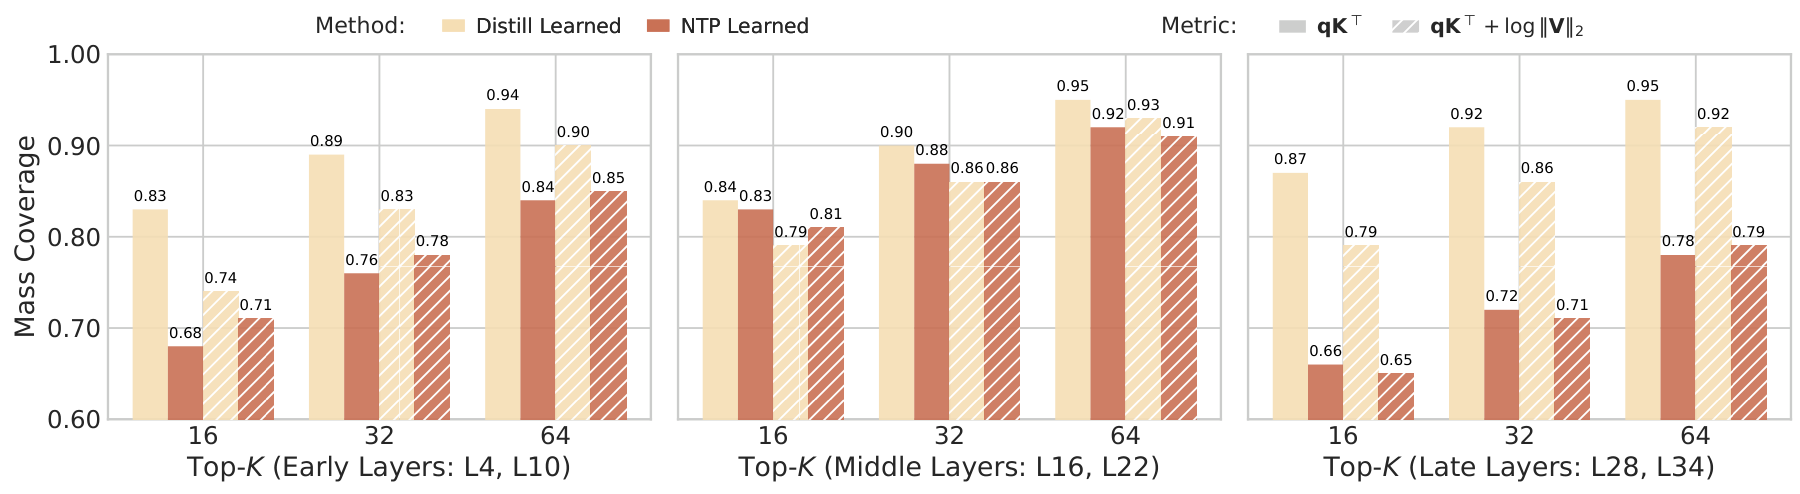
原图 5(a),p. 13。横轴是 Top-K 块数,三个面板分别为早、中、晚层;纵轴是覆盖率;颜色区分 Distill 与 NTP(SAS),纹理区分两种权重。SAS 在绝大多数设置的覆盖率更低,这直接提醒我们:高层内覆盖不是下游质量的充分条件。
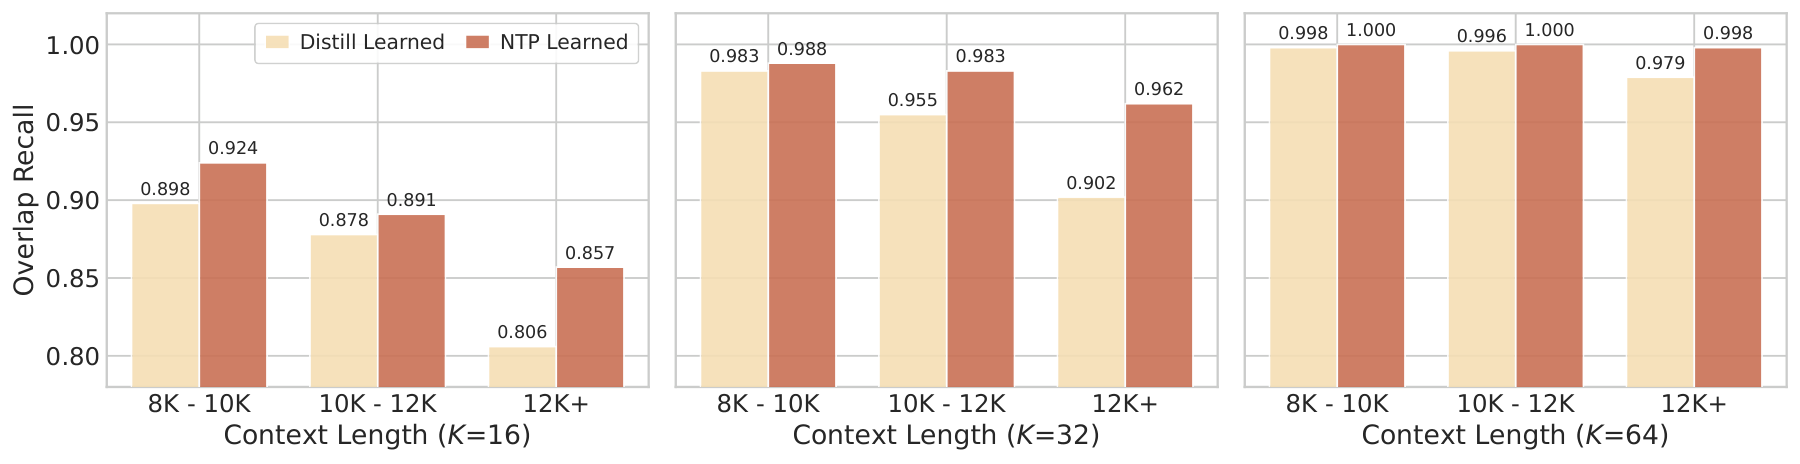
原图 5(b),p. 13。每面板固定 K=16/32/64,横轴为输入长度桶,纵轴为跨层并集 overlap recall。对 full attention,在 GQA 组内对各 head 的 Top-K 以多数票形成组级集合,再跨层取并集 $\mathcal I^\star_{\rm all}$;模型自己的集合用相同流程生成:
例如 K=16、12K+,Seer 0.806,SAS 0.857;K=32、12K+ 为 0.902→0.962。作者将它解释为跨层更互补。本次分析认为结果与该解释相容,但 recall 未惩罚并集变大,也没有通过干预逐层路由证明因果关系;oracle 还是根据稠密注意力构造,而不是人工标注“真正有用”的块。测试来自 >8K 的训练序列,不是独立下游检索测试。
4.7 生成行为:准确率之外,长推理更少撞上限
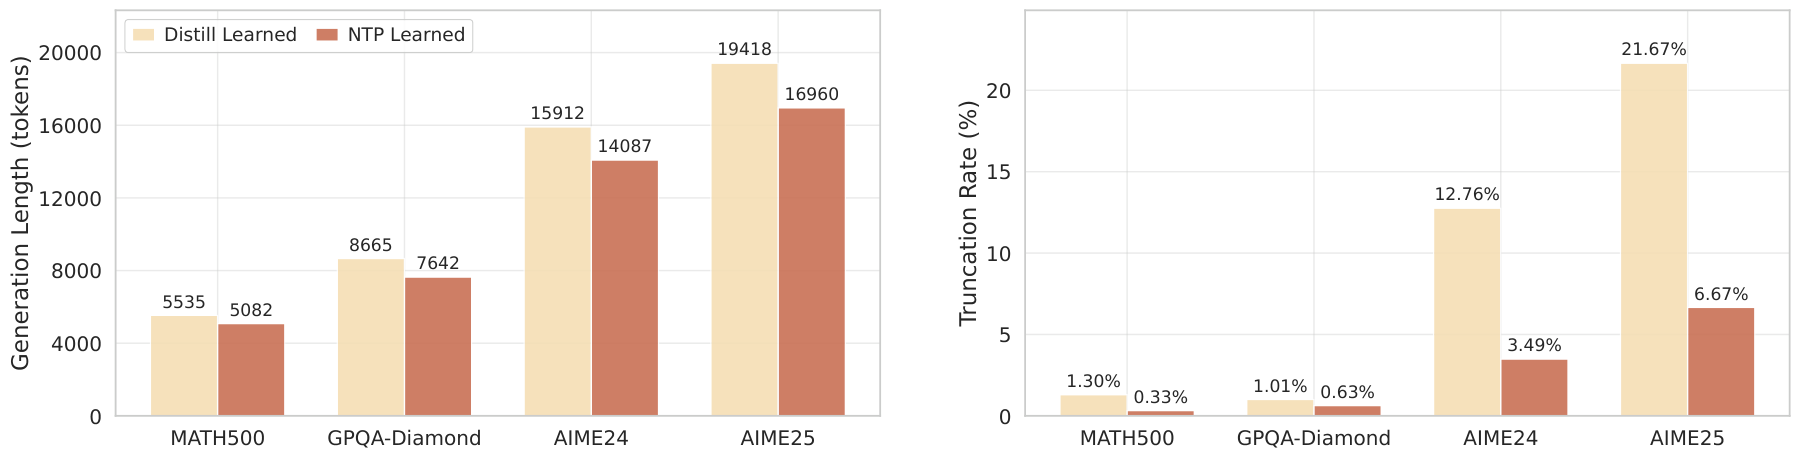
原图 6(p. 14),Qwen3-4B、4096 预算。左图横轴为四项推理任务、纵轴为平均输出 tokens;右图纵轴为 32768 上限下截断率。Distill 是 Seer,NTP 是 SAS。
| 任务 | 平均 tokens:Seer→SAS | 截断率:Seer→SAS |
|---|---|---|
| MATH500 | 5535→5082 | 1.30%→0.33% |
| GPQA-Diamond | 8665→7642 | 1.01%→0.63% |
| AIME24 | 15912→14087 | 12.76%→3.49% |
| AIME25 | 19418→16960 | 21.67%→6.67% |
AIME25 少生成 2458 tokens,截断率下降 15.00 个百分点。这是与选择质量改善相符的观察,不是证明所有缩短都来自更好推理;还需联合准确率、终止策略和样本分布解释。
4.8 效率:decode 更快,但路由随上下文增长
测量对象为 Qwen3-4B、SGLang、单 GPU/TP=1、CUDA graphs、chunked prefill;先完成 prefill,再计时 512 个生成 token 的稳态 decode。论文正文和图注没有给出 GPU 型号,故不补造。(Sec. 6.3,pp. 14–15)
| 条件 | 原文报告相对完整 attention 的 decode 加速 |
|---|---|
| batch=1,64K | 2.4× |
| batch=1,256K | 4.6× |
| batch=1,512K | 5.6× |
| batch=8,64K | 约 13× |
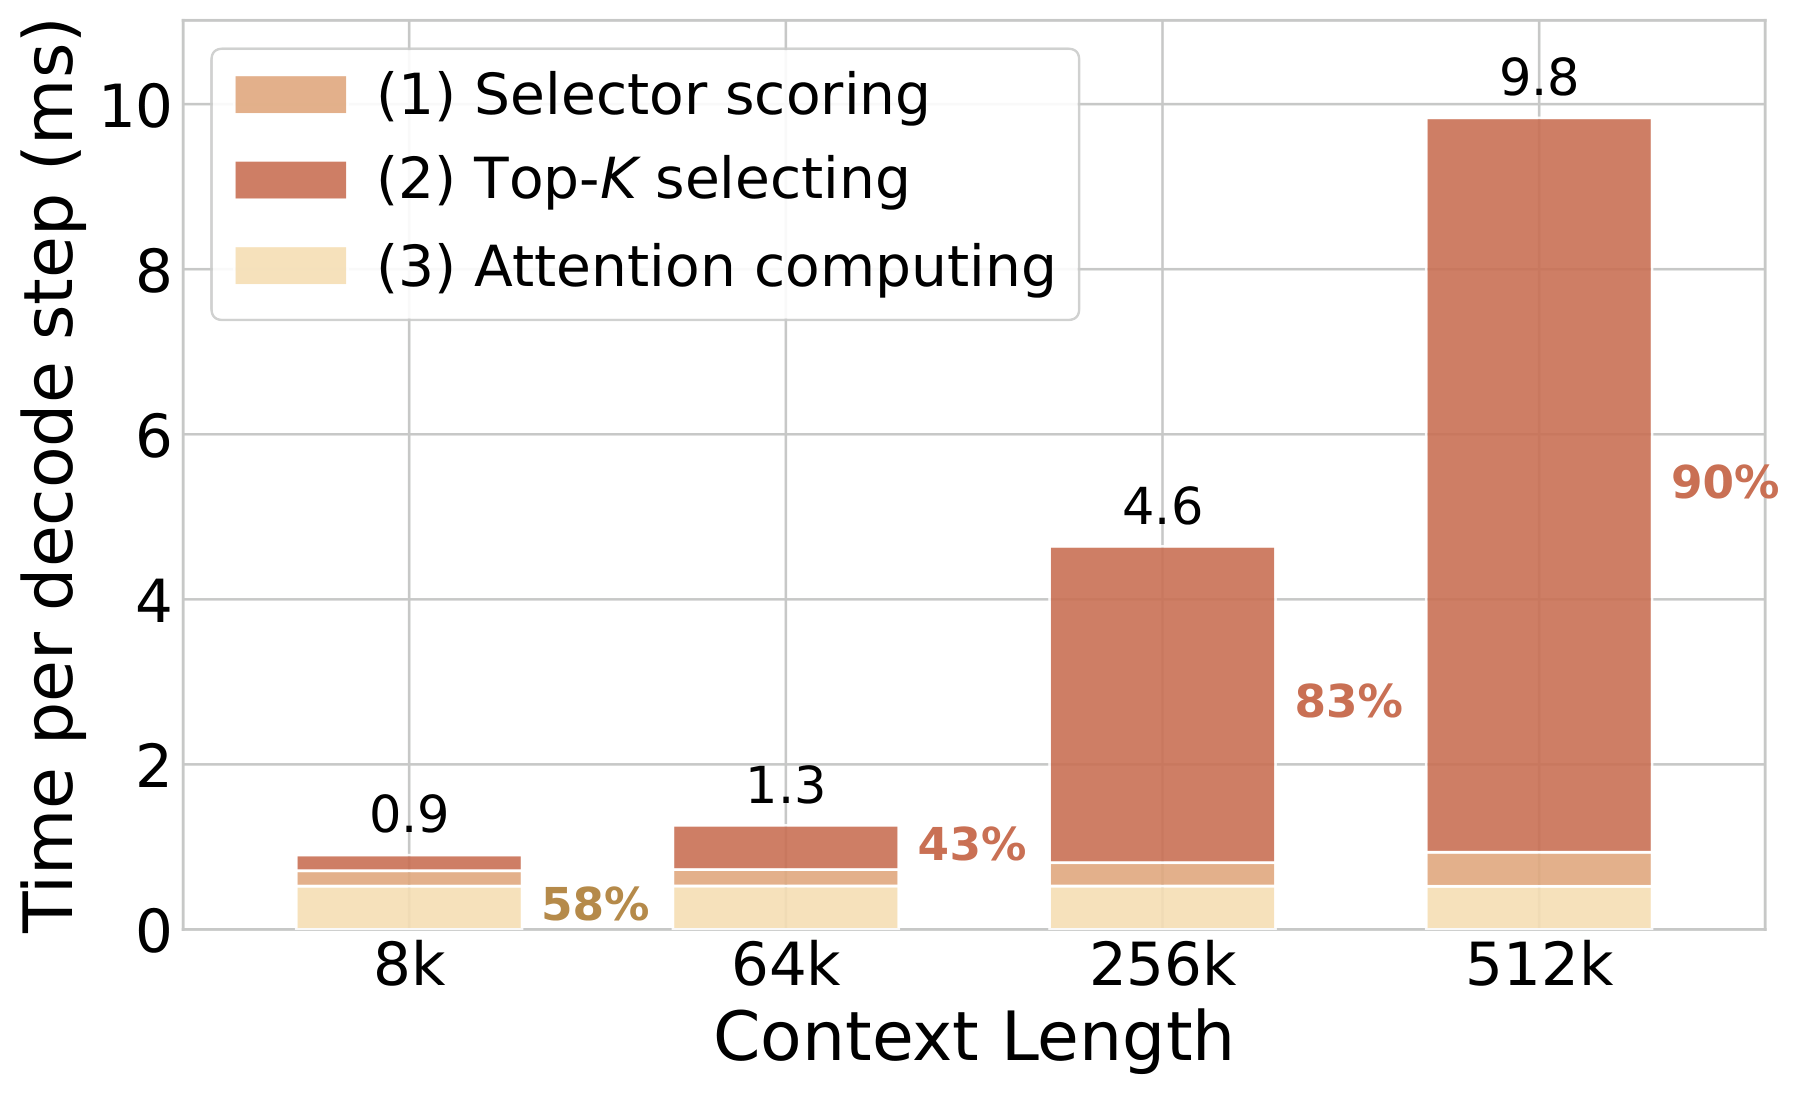
原图 7(c),p. 15。横轴 context length,纵轴为一个 sparse attention decode step 的耗时组成;堆叠为 selector scoring、Top-K、attention compute。Top-K 占比由 8K 的 21% 增至 512K 的 90%,图中总耗时也从约 0.9 ms 增至 9.8 ms。这里是注意力/选择阶段的分解,不应与整个模型每 token latency 直接混用。
固定预算时,所选 KV 的 attention compute 可以近似与长度无关,但给全部块打分和 Top-K 仍随 $C\approx n/b$ 增长。因此 Sec. 5.1 的“复杂度与 $n$ 无关”应限定为选块后的 attention 计算,不能推广到完整 decoder。对极长上下文,路由会成为主要瓶颈。速度实验到 512K,并不能证明答案质量在 512K 仍然可靠;质量评测的协议和长度不同。
五:结论
5.1 可以可靠带走的结论
SAS 证明了一个实用方向:在已有稠密 LLM 上,通过设计训练期连续门控,让最终 LM loss 学习适用于离散稀疏推理的块排序,可以优于逐层拟合稠密 attention。四个关键选择是 softmax 内 log-gate、历史块 softmax 归一化、保留连续排序信息、默认 sparse scope。最有说服力的收益出现在较紧预算的困难推理任务。
5.2 最大能力边界:RULER 长检索仍明显掉分
附录 B、表 8(p. 21)采用不同的 64K 长文本训练协议。以下为 Qwen3-14B、4096 预算:
| RULER 输入长度 | Full | Seer | SAS |
|---|---|---|---|
| 4K | 95.28 | 95.28 | 95.28 |
| 8K | 92.71 | 91.62 | 91.52 |
| 16K | 92.91 | 76.77 | 83.35 |
| 32K | 92.15 | 64.96 | 66.82 |
| 64K | 92.19 | 42.34 | 45.92 |
| 128K | 82.23 | 22.36 | 29.95 |
128K 时比 Seer 高 7.59,但距 full 仍低 52.28。作者猜测 pooling block summary 容易丢失针状细节;这是合理解释,本文没有把 summary 表达能力与其他因素完全分离验证。8K 也有 SAS 小幅落后 Seer 的例子。
5.3 讨论时应该保留的限定
- 训练与推理 attention 权重不同;可微门控是有效代理,并非精确优化离散集合的理论保证。
- 数学数据上的任务迁移值得肯定,但不能替代超长检索能力验证。
- 速度数字是特定配置下的稳态 decode,不是包含 prefill 的端到端请求时间,也不是相对 Seer 的额外速度优势。
- 论文没有完整训练成本表、硬件型号和全部评测超参数;本次未运行作者代码或重新测量性能。
- 小于标准差尺度的领先、以及缺少误差的平均分,不宜直接写成统计显著。
- 一处重要文字/表格冲突已在上文记录:引言 LongBench +3.2 与表 3 +0.4 不一致。
5.4 后续最值得验证的问题(本次分析)
- 在同预算和固定并集大小下,跨层互补仍能否解释质量提升?可以做固定其他层选择、只替换某层路由的干预。
- 用更能保留局部细节的 block summary,是否能改善 64K/128K RULER,同时控制 selector 和 Top-K 成本?
- 是否可以缩小训练软门控与推理无门控之间的差异,并避免 sigmoid/raw logits 的退化捷径?
- 在明确硬件、相同数据与 GPU-hours 下,LM 训练相对注意力蒸馏的真实成本/质量收益如何?
成品与复核记录
本笔记与英文幻灯片 PDF、可编辑 TeX共用同版本证据。原始图件复制自作者 TeX,来源映射见 figures/provenance.json。本地幻灯片构建命令:python3 build_slides.py slides.en.tex,使用 pdfLaTeX。具体交付检查结果见 quality-check.md。