Breaking the Token Ceiling:中文精读笔记
论文:Breaking the Token Ceiling: Distilling Smaller, Stronger Byte Models
作者:Kalyani Marathe、Artidoro Pagnoni、Tomasz Limisiewicz、Margaret Li、Mike Lewis、Luke Zettlemoyer、Srinivasan Iyer
版本:arXiv:2609.12303v1,2026-09-11 提交;2026-10-23 获取与研读
原文:本地 PDF · arXiv 页面
论文总览
核心问题:如果教师模型使用 BPE token,而小学生模型直接预测 UTF-8 字节,如何从教师的 token 概率构造字节级蒸馏目标?在较长训练和不同计算预算下,字节学生与 token 学生的表现又如何变化?
论文提出两种单次教师前向的转换方法。Marginalize-It 按字节前缀汇总 token 概率,但遇到“一个候选 token 已结束、另一个仍未结束”时会丢失概率质量;End-Of-Token(EOT) 在每个教师 token 后插入 <eot>,将结束事件变成可预测符号,从而精确分解教师在该 token 位置的完整分布。作者用三种表示(token、byte、byte+<eot>)乘以两种目标(交叉熵、蒸馏)构成六组约 1B 层参数的实验。低训练 FLOPs 时 token 模型领先;字节模型随训练增加改善更快。以验证集每字节比特数(BPB)和六项任务平均错误率的两段缩放律外推,EOT 蒸馏的渐近平均准确率为 52.4%,token 蒸馏为 48.4%,差 4.0 个百分点。这是外推值;附录报告的最大已训练检查点分别为 44.6% 和 44.4%。[Sec. 2–8,PDF pp. 4–19;附录 C,PDF p. 37]
结构地图
| 原文章节 | 内容与作用 | PDF 页码、关键证据 |
|---|---|---|
| 1 Introduction | 提出跨 tokenizer 蒸馏与过度训练的问题 | pp. 1–4,图 1 |
| 2 Logit Conversion Methods | Marginalize-It 与 EOT 的概率转换 | pp. 4–5,图 2 |
| 3 Scaling Study Design | 六组对照、模型、数据和任务 | p. 6,表 1 |
| 4 Scaling Trends I | BPB 随训练 FLOPs 变化 | pp. 7–8,图 3、表 2–3 |
| 5 Scaling Trends II | 选择题、生成和翻译任务随 FLOPs 变化 | pp. 8–11,图 4–6 |
| 6 Scaling Trends III | 任务表现与 BPB 的关系及渐近预测 | pp. 11–16,图 7–10、表 4–5 |
| 7 The Case for End-Of-Token Logits | 等 FLOPs 轨迹、交点、数据和存储估算 | pp. 16–19,图 11、表 6–7 |
| 8–10 | 公开模型比较、相关工作、讨论 | pp. 19–21,表 8 |
| 附录 A–G | 架构与存储、其他学习率、实际检查点、敏感性、第二验证集、转换伪代码、BPB 反例 | pp. 24–50,表 9–24、图 21–30 |
一:动机——为什么 token 教师难教 byte 学生
常见预训练蒸馏直接让学生拟合教师的下一个 token 分布;这要求两者共享词表。字节学生词表很小,离线保存完整分布的成本较低,但一个教师 token 通常含多个字节。仅把教师对 isu 的概率交给学生预测首字节 i,不能直接得到随后 s、u 各步的完整条件分布。已有精确跨 token 边界方案可能需要在不同候选续写上多次运行教师;本文要在教师已有的一次前向结果中完成转换。[Sec. 1–2,PDF pp. 1–5]
研究的第二个问题是优化资源的分配:token 序列短、输出词表大;byte 序列长、输出词表小。即便层内参数相同,两类模型的总参数、每段文本消耗的 FLOPs、可见文本量和推理成本都不同。因此论文比较的是有意设计的训练轨迹,而非严格相同总参数或相同推理成本的架构竞赛。[Sec. 3、10,PDF pp. 6、20–21;表 9,PDF p. 24]
二:方法——从 token 分布构造字节目标
2.1 共同的前缀汇总
设教师在一个 token 边界给出完整分布 $q(t\mid h)$,$t\in V$,$h$ 是此前的教师 token 上下文。令 $b(t)$ 为 token 解码后的字节串。首字节 $a$ 的概率为
之后在真实字节前缀 $u$ 下,只保留与 $u$ 匹配的候选,再汇总下一字节。这个做法的难点是:某个候选 token 可以恰好在 $u$ 结束;它的后续文本要靠教师在下一个 token 边界的新预测决定。若直接丢弃该候选并对剩余概率重新归一,得到的是近似条件分布。[Sec. 2.1,PDF p. 4;图 2,PDF p. 5]
2.2 Marginalize-It:便宜的近似
图 2 的 Tiramisu 例子中,真实 token 为 isu,但同一前缀下还有 is 和 isk。预测前缀 is 后的第三个字节时,Marginalize-It 丢掉已结束的 is(教师给它 $0.125$),只在 isu($0.5$)和 isk($0.125$)间归一:
它对首字节精确,对后续字节只在没有会影响下一步的跨边界候选时精确。优势是只需教师已有的 token logits,作为实验中的近似蒸馏对照。[Sec. 2.1,PDF p. 4;附录 F,PDF pp. 46–49]
2.3 EOT:把“当前 token 已结束”变成显式事件
EOT 把每个候选表示为 $\tilde b(t)=b(t)\Vert\langle\mathrm{eot}\rangle$。令
其中 $a$ 可以是普通字节,也可以是 <eot>。由于每个 token 的结束都有独立符号,各下一符号分支穷尽 $M(u)$,可从同一次教师输出准确分解带 token 边界的教师分布。上述例子在 is 后变为
训练语料也必须在每个教师 BPE token 后插入 <eot>,例如 T | iram | isu 变成 T <eot> i r a m <eot> i s u <eot>。这里“精确”指目标分布转换;学生经过训练后能否拟合该分布仍由模型和优化决定。平均每 4.5 个文本字节增加一个标记,按表 3 的每段原文本 FLOPs 计算,EOT 相比普通 byte 模型多约 30.94%,同时也改变了训练轨迹。[Sec. 2.2,PDF pp. 4–5;表 3,PDF p. 8]
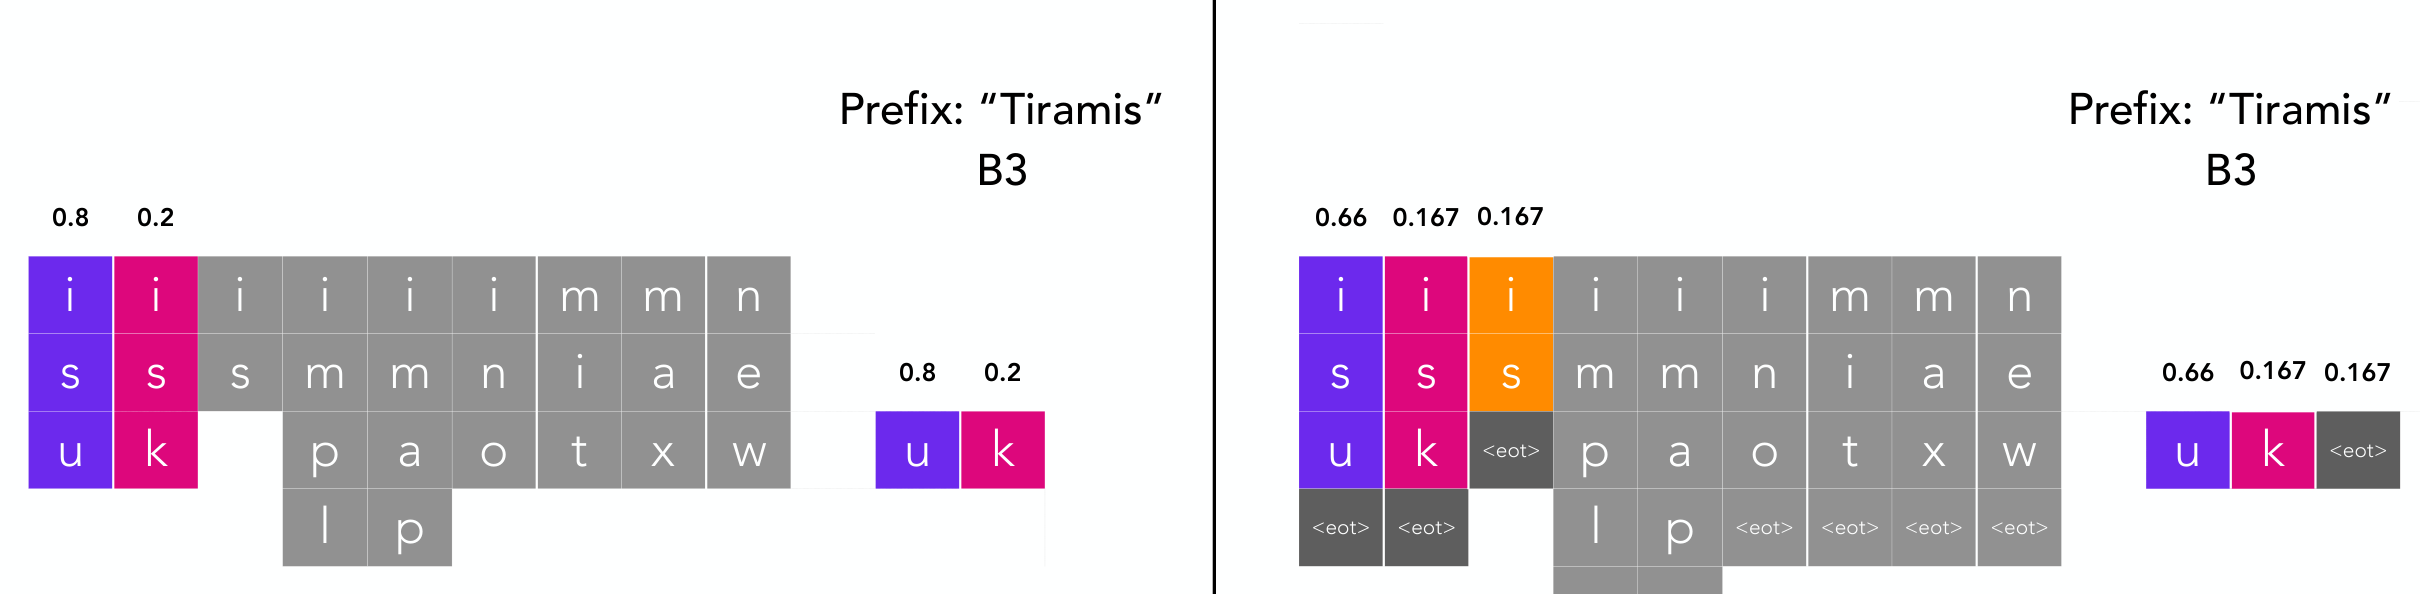
原图 2 的 B3 面板,PDF p. 5;裁切保留了两列候选、概率和 <eot> 分支。
三:实验——比较对象与指标
三种学生都是 25 层、隐藏维度 2048、FFN 维度 5632、16 个注意力头的稠密 decoder-only Transformer,层参数均约 1.2846B。因 embedding/输出词表不同,总参数为 token 1.81B、byte 1.28B、byte+EOT 1.28B;词表分别是 128,256 / 260 / 261。教师为 Llama 3-8B,训练文本来自 Llama-2 预训练混合语料。token 蒸馏保存 top-$k$(约 600)教师 logits;两种 byte 蒸馏保存完整小词表分布。[Sec. 3,PDF p. 6,表 1;附录 A,PDF pp. 24–26,表 9–10]
| 学生表示 | 监督(CE) | 蒸馏(教师 KL) | 每单位训练 FLOPs | 序列长度 |
|---|---|---|---|---|
| BPE token | Token Supervised | Token Distilled | $8.18\times10^9$/token | 2,048 |
| UTF-8 byte | Bytes Supervised | Marginalize-It Distilled | $8.81\times10^9$/byte | 9,216 |
byte + <eot> | Bytes w/ <eot> Supervised | End-Of-Token Distilled | $9.44\times10^9$/单位 | 11,264 |
蒸馏损失为 $L=\alpha L_{\rm KL}+(1-\alpha)L_{\rm CE}$;六组比较使用监督与蒸馏两种目标。作者扫描 $10^{-3}$、$4\times10^{-3}$、$8\times10^{-3}$ 三档峰值学习率,正文重点展示 $4\times10^{-3}$。每次训练使用 64 张 H200;byte 训练加入 QK norm 以缓解早期损失尖峰。相同 FLOPs 下 byte 模型处理的原文本字节量较少,EOT 又增加序列单位;比较时应同时看计算量和数据量。[Sec. 3,PDF p. 6;附录 A,PDF pp. 24–25]
作者用两种尺度衡量模型:验证集 BPB 为语料总交叉熵(nats)乘 $\log_2 e$ 后除以 UTF-8 字节数,越低越好;下游任务包括 ARC-Easy、ARC-Challenge、HellaSwag、PIQA 四项选择题,MBPP、Natural Questions 两项生成,以及 FLORES 英德、德英两项翻译。前六项汇总为平均 top-1 错误率/准确率;翻译单独看 BLEU,越高越好,没有进入“52.4%”的六任务平均。[Sec. 3.3、6.4,PDF pp. 6、14–15;附录 A.5,PDF p. 25]
四:结果——先看实测,再看外推
4.1 Sec. 4:BPB 的 FLOPs 缩放
作者拟合 $y(x)=b x^a+c$,其中 $x$ 为训练 FLOPs,$y$ 为验证 BPB,$c$ 是拟合的无限计算渐近值。$4\times10^{-3}$ 学习率下,token 蒸馏的 $c=0.9407$,Marginalize-It 为 $0.9016$,EOT 蒸馏为 $0.8983$。图 3 显示 token 初期 BPB 更低,但字节曲线下降更快;表 2 给出该验证集上很高的拟合 $R^2$。这些 $c$ 是从有限检查点拟合出来的,不是实际训练到无限计算所得。[Sec. 4,PDF pp. 7–8,图 3、表 2–3]
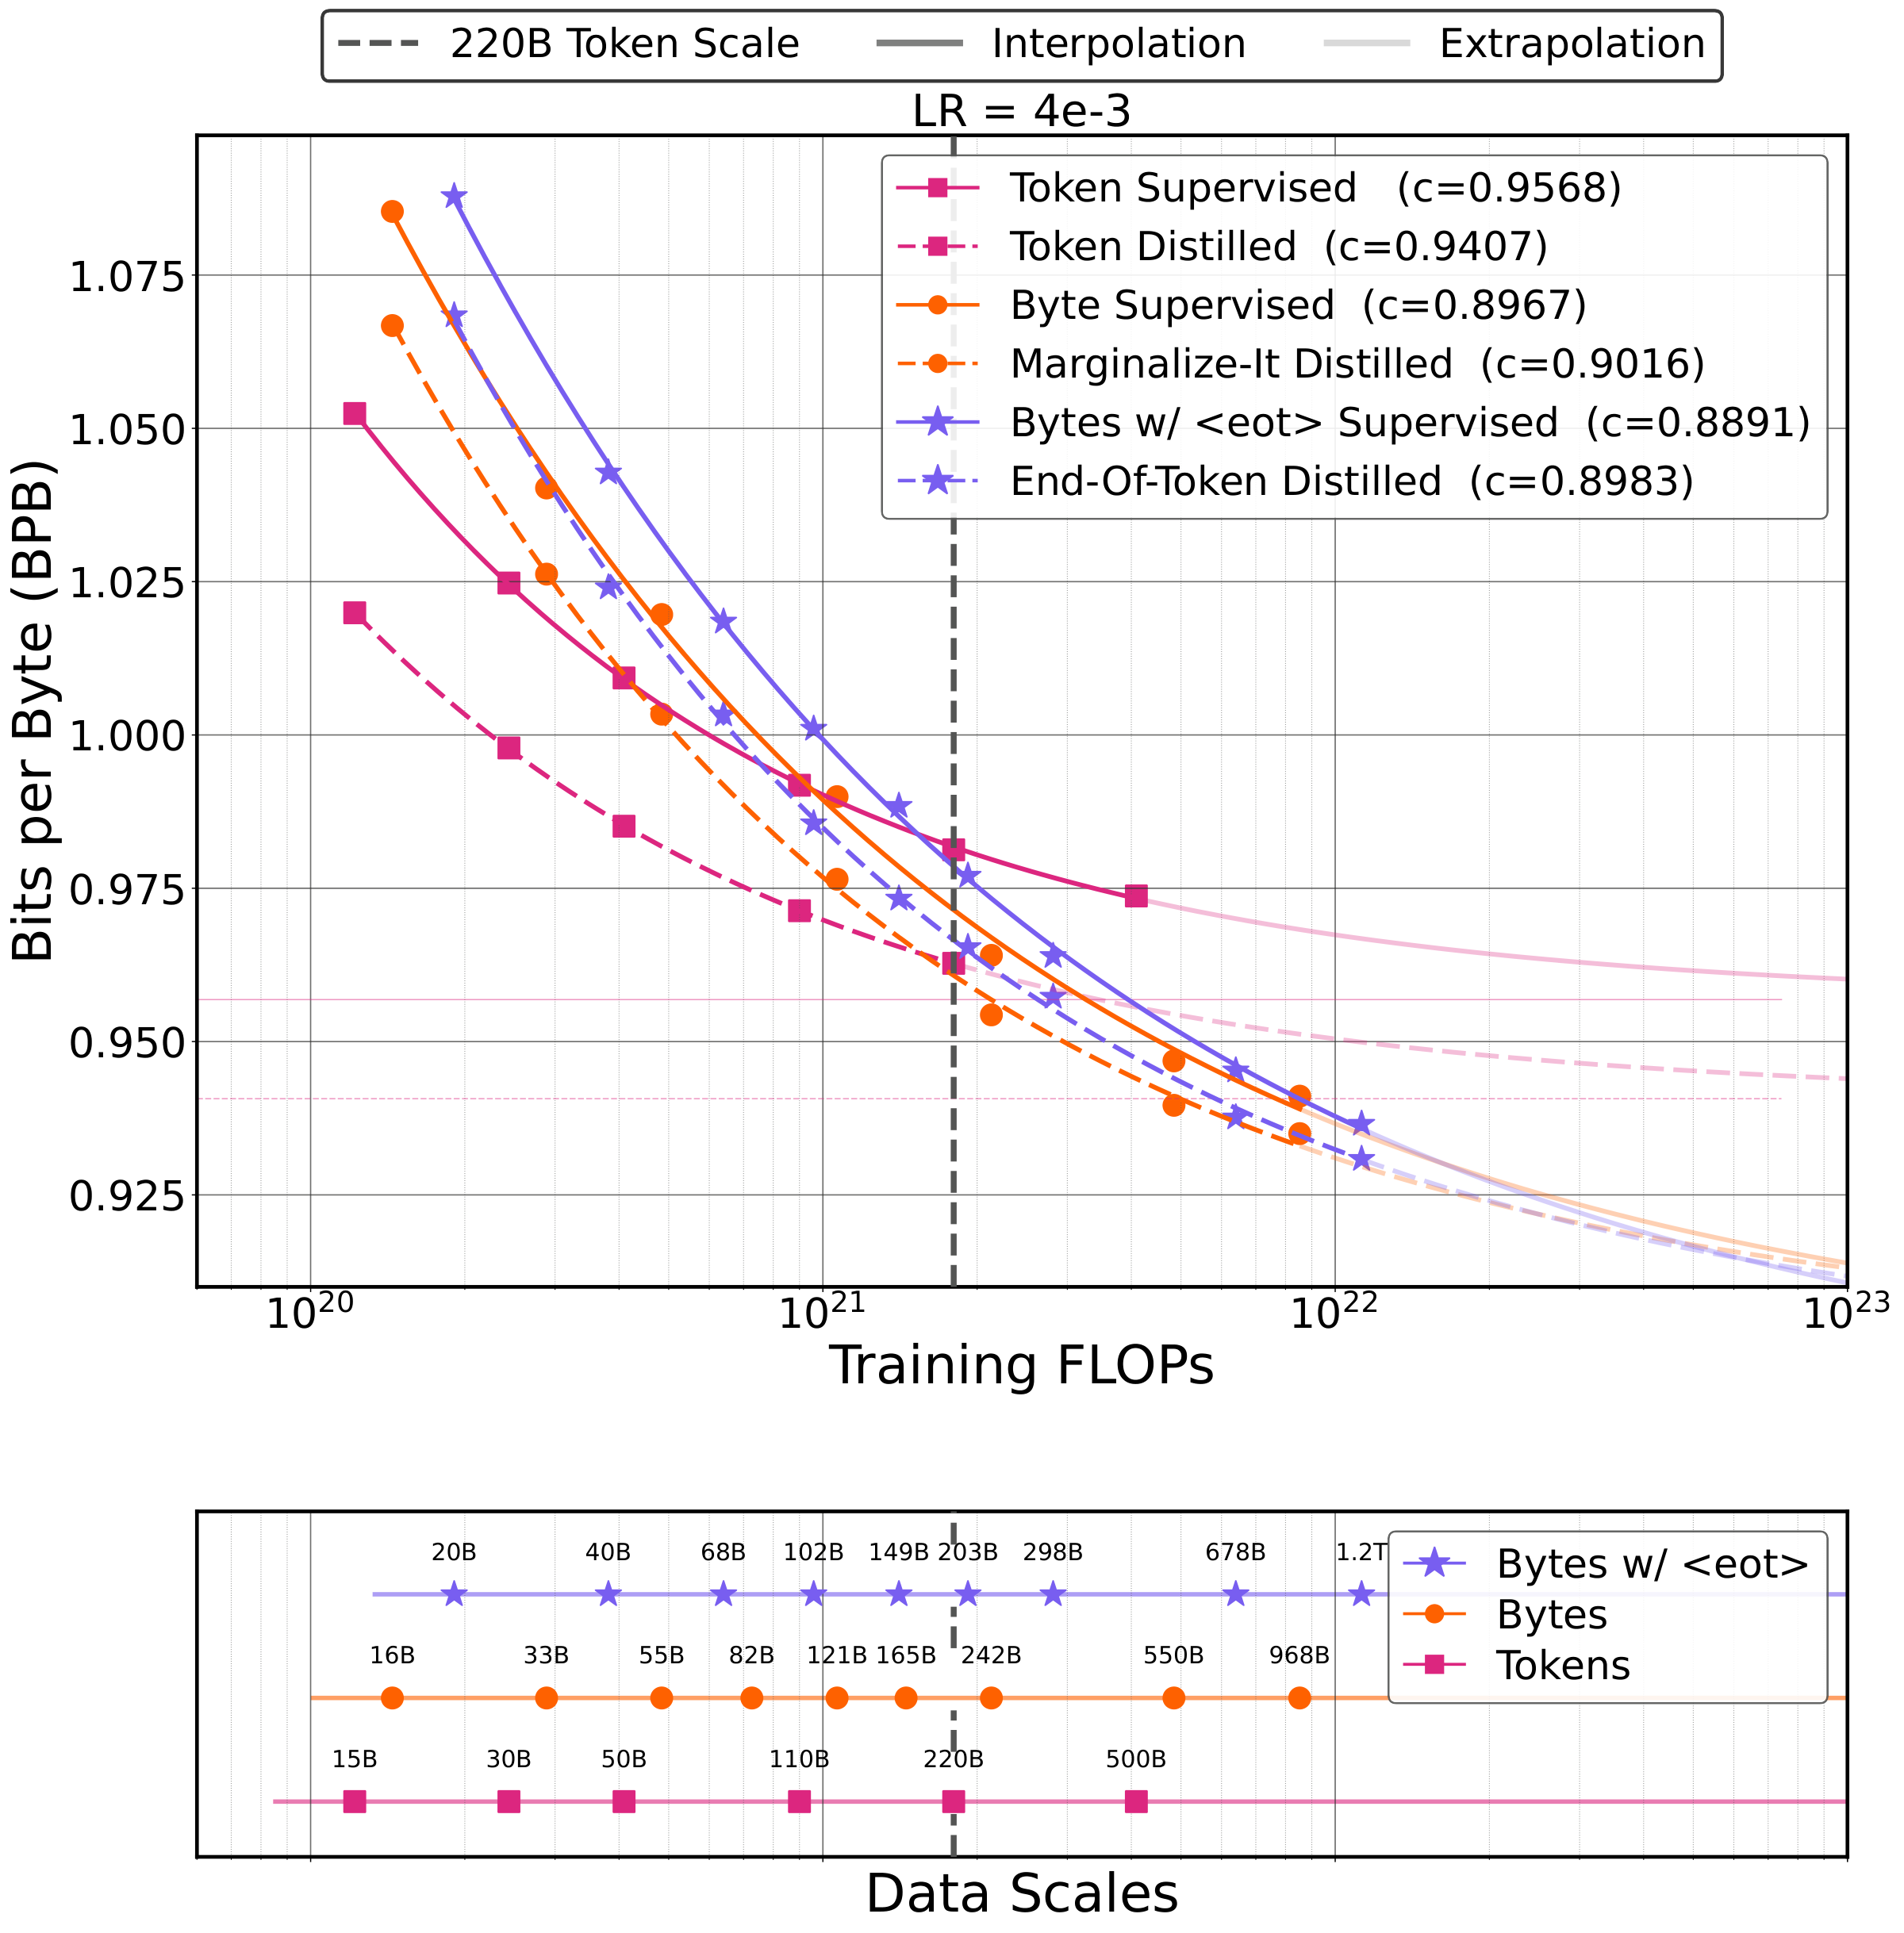
原图 3,PDF p. 7;上半图横轴为训练 FLOPs,下半图标出不同表示在各预算下对应的训练单位数。
4.2 Sec. 5:实际下游曲线不能仅由 BPB 排序
四项选择题平均准确率中,token 模型在低计算预算领先;byte 与 EOT 曲线起点较低,随后上升更快(图 4)。MBPP/NQ 的图 5 也显示相近趋势,但 token 曲线的饱和感较弱。FLORES 两个翻译方向以 BLEU 作图(图 6):byte 模型低预算尤其弱,后期上升较快。论文在约 $1.8\times10^{21}$ FLOPs 的比较点发现:尽管四组 byte 模型在验证集 1上的 BPB 已低于 Token Supervised,它们的下游表现仍较差。这是后续按模型分别拟合“BPB→任务错误率”的直接动机。[Sec. 5,PDF pp. 8–11,图 4–6]
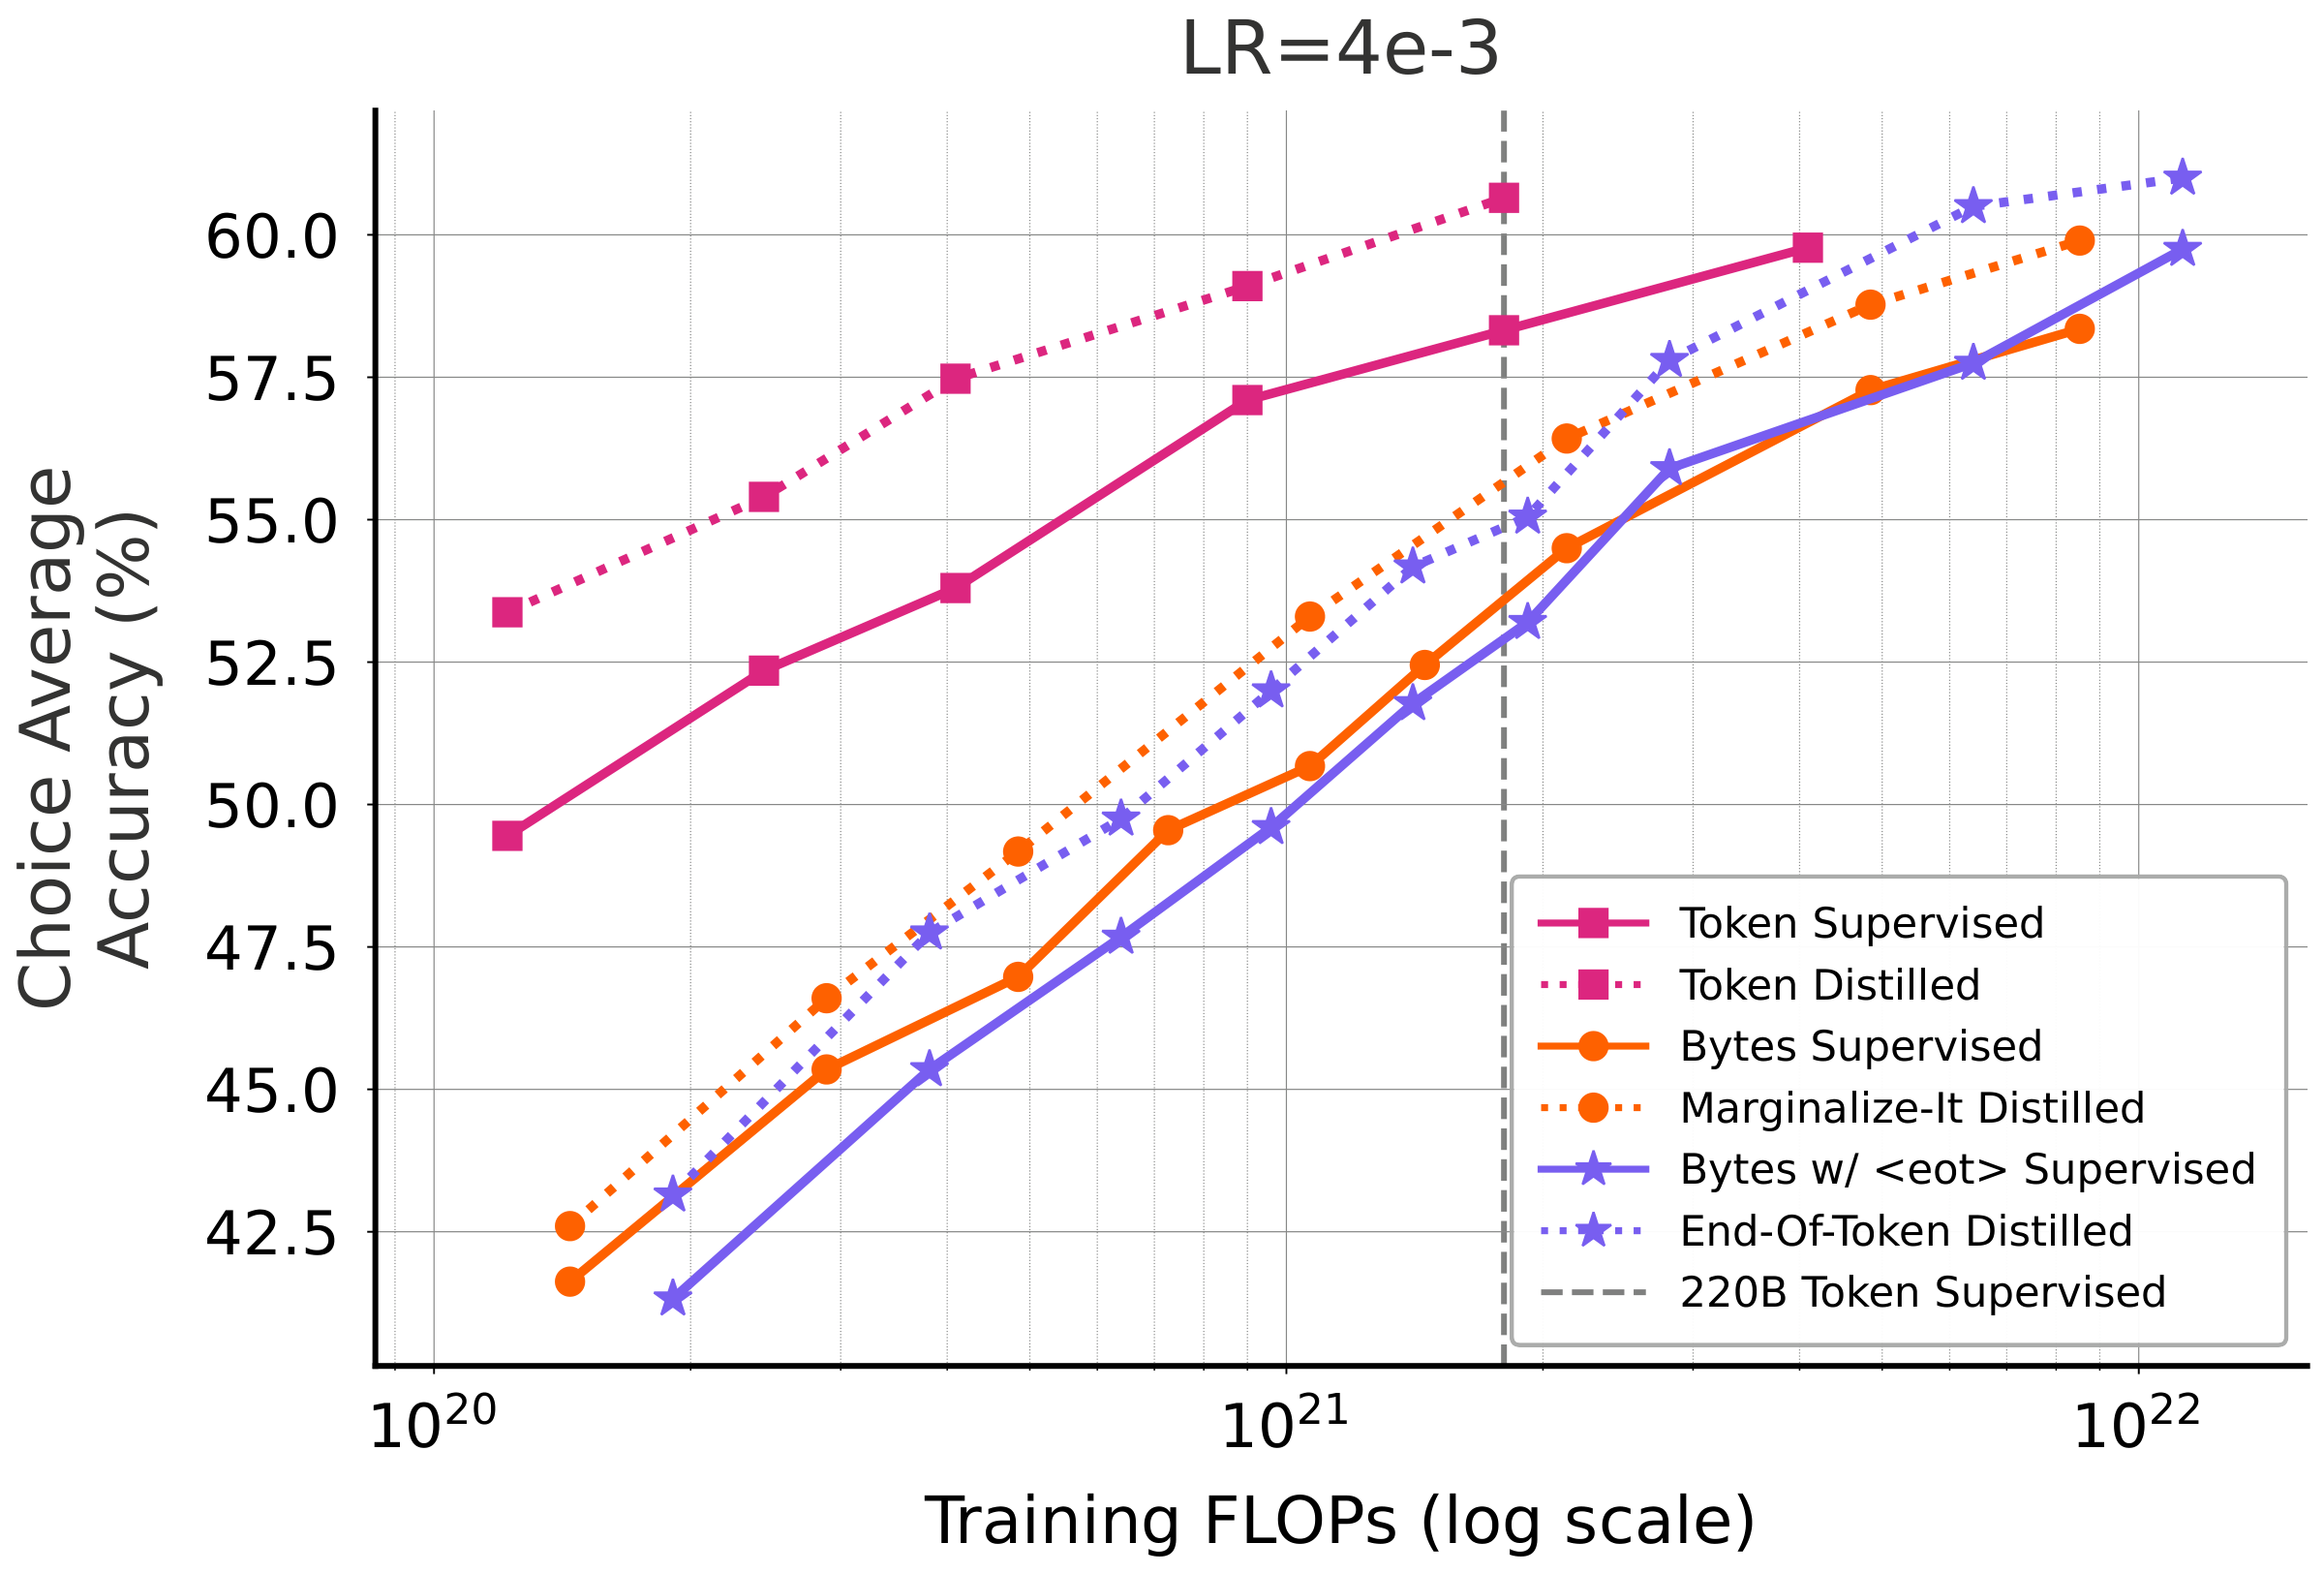
原图 4,PDF p. 9;实线为监督、虚线为蒸馏;横向比较时需注意各系列实际训练预算覆盖范围不同。
4.3 Sec. 6:由 BPB 推任务表现,得到渐近预测
作者对每一组单独拟合
其中 $y$ 为 BPB,$z$ 为六任务平均错误率。先由训练 FLOPs 预测 BPB,再由 BPB 预测下游错误率。不能用同一个 BPB 数值跨表示直接给模型排名:不同模型的 $z(y)$ 曲线不同;甚至在同一 byte+EOT 架构下,监督模型的渐近 BPB $0.8891$ 低于蒸馏模型的 $0.8983$,后者的预测下游准确率仍更高。[Sec. 6,PDF pp. 11–16,图 7–10、表 4–5]
| 方法,LR=$4\times10^{-3}$ | 拟合渐近 BPB $c$ ↓ | 预测六任务平均准确率 $a^*$ ↑ |
|---|---|---|
| Token Supervised | 0.9568 | 46.0% |
| Token Distilled | 0.9407 | 48.4% |
| Bytes Supervised | 0.8967 | 51.2% |
| Marginalize-It Distilled | 0.9016 | 50.5% |
Bytes w/ <eot> Supervised | 0.8891 | 51.6% |
| End-Of-Token Distilled | 0.8983 | 52.4% |
原表 5,PDF p. 16。EOT 蒸馏比 token 蒸馏高 4.0 个百分点,比 Marginalize-It 蒸馏高 1.9 个百分点。但 Marginalize-It 蒸馏的渐近预测比普通 byte 监督低 0.7 个百分点,因此“蒸馏总会更好”不适用于所有外推比较。
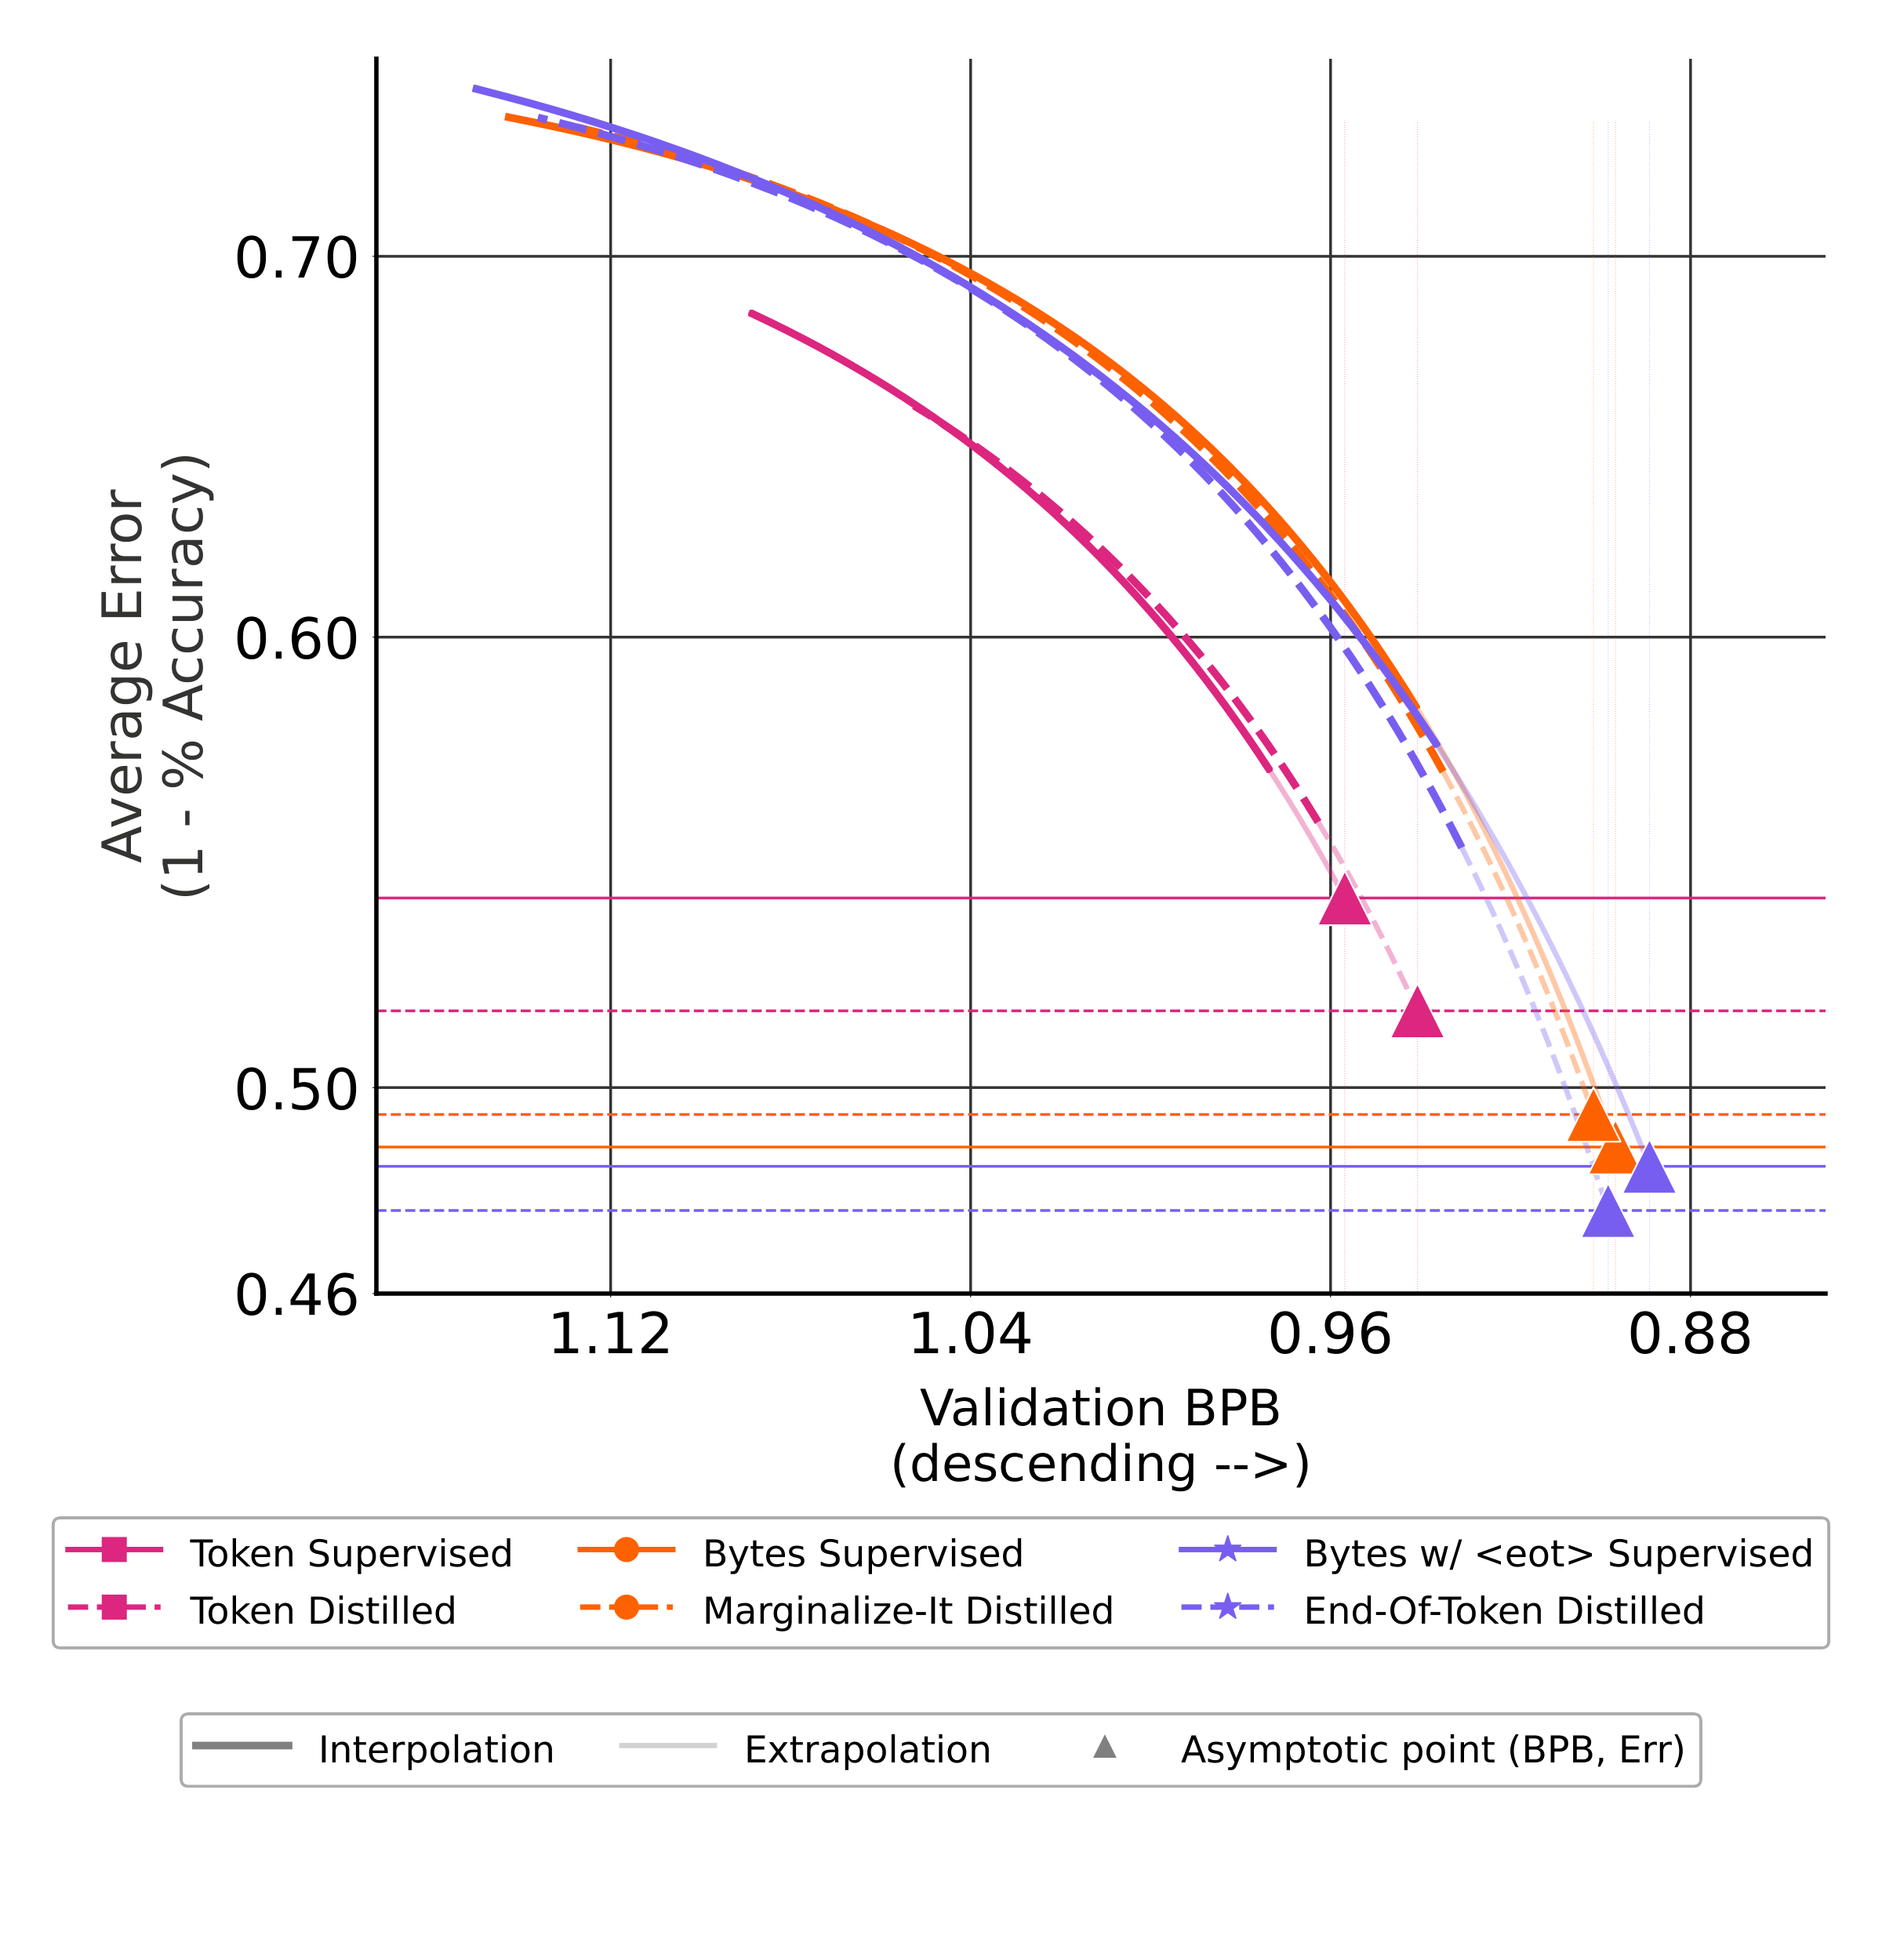
原图 10,PDF p. 15;横轴向右表示 BPB 降低,浅色部分是外推,三角形是拟合渐近点。
4.4 Sec. 7:交点、数据量和存储量的计算口径
“Feather Plot”把相同训练 FLOPs对应的各方法点连起来:先用 $y(x)$ 求 BPB,再用各自的 $z(y)$ 求错误率。低预算 token 蒸馏仍领先,作者估算 EOT 蒸馏达到 Token Distilled 的渐近 48.4% 所需约 $6.33\times10^{22}$ FLOPs;Marginalize-It 需要 $2.04\times10^{23}$ FLOPs。两者均来自拟合曲线的反解,超出主图已训练检查点的预算。[Sec. 7,PDF pp. 16–18,图 11、表 6]
在 EOT 的这个预算点,表 7 算得 $6.70\times10^{12}$ 个序列单位,其中按每 4.5 个文本字节一个 <eot> 折算为 $5.48\times10^{12}$ 个文本字节。同 FLOPs 的 token 流水线按 4.5 字节/token 折算为 $3.48\times10^{13}$ 字节,比例 6.35 倍,即摘要的“约六分之一训练数据”。这是按处理的文本字节量与拟合交点推导的比值;论文也说明部分大规模训练会重复语料,不应把它读成已验证的独立语料需求。存储 5.19 倍 的估算还依赖表 10 的编码设定:token 每步保存约 600 个 top-$k$ 值及索引,byte 每步保存完整小词表 float32 logits。[Sec. 7,PDF p. 18,表 7;附录 A.6,PDF p. 26,表 10;Sec. 10,PDF p. 21]
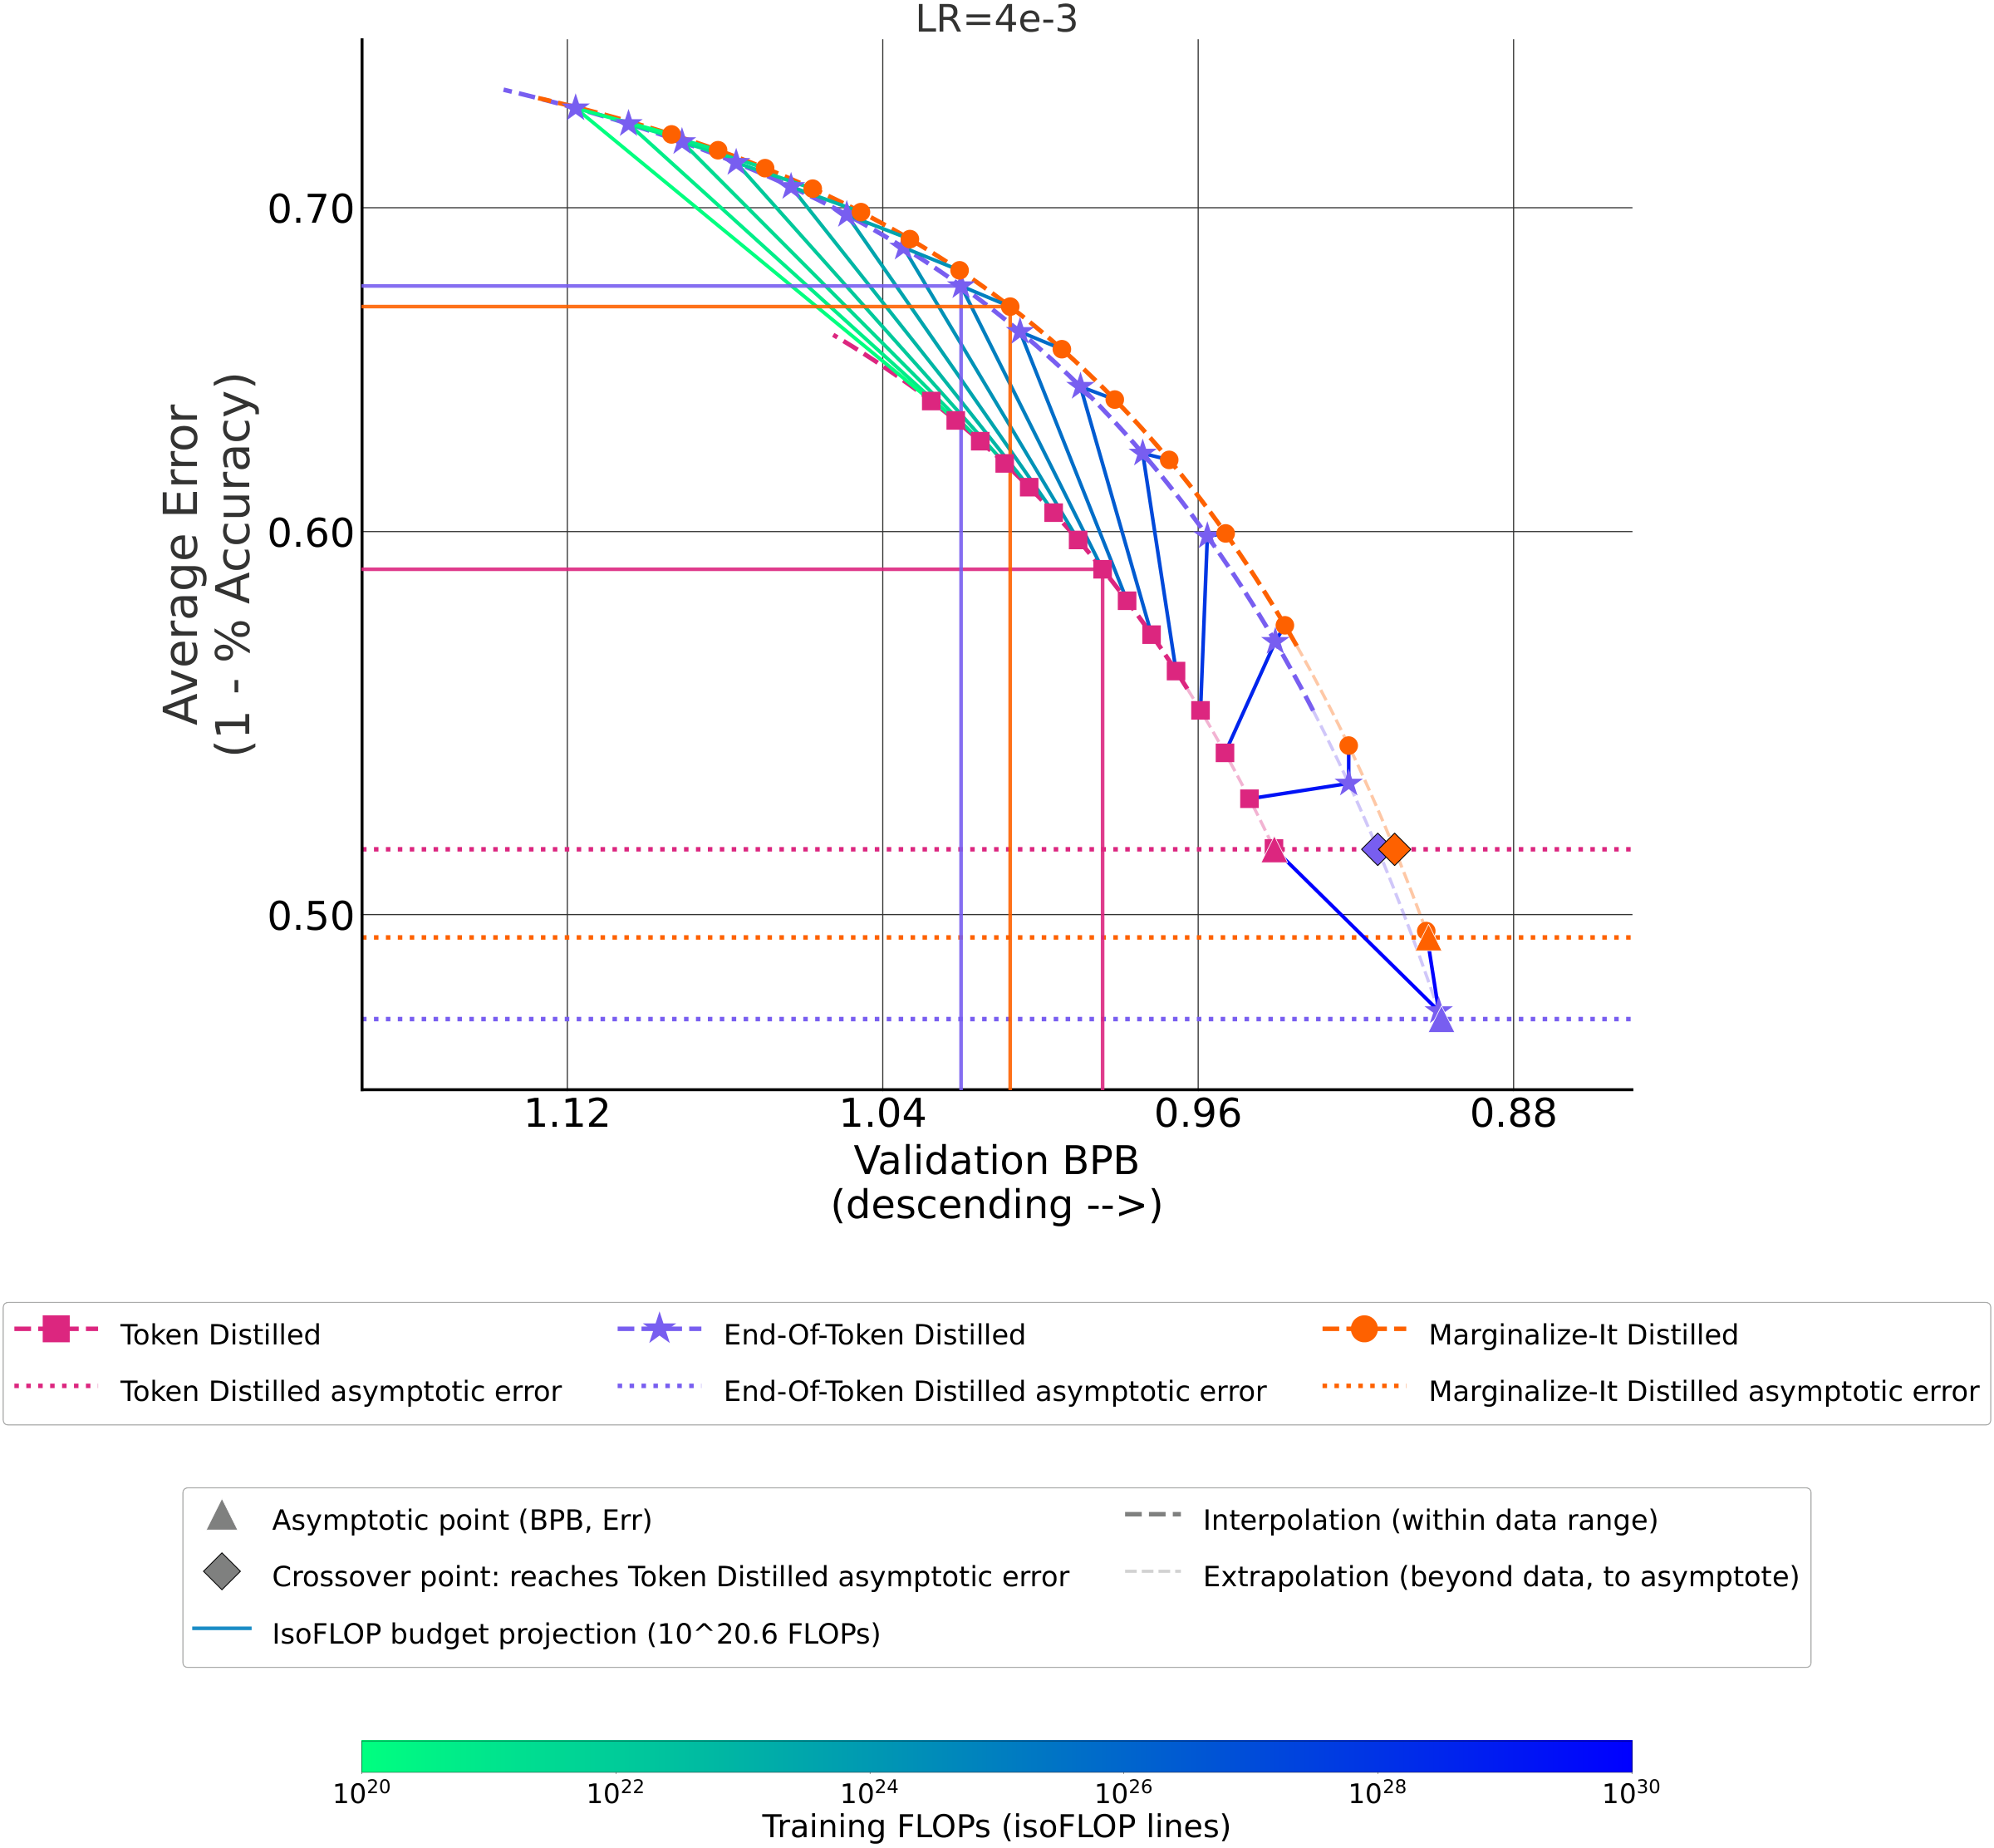
原图 11,PDF p. 17;彩色连接线代表同一计算预算,菱形为拟合的交点,三角形为拟合的渐近点。
4.5 Sec. 8 与附录 C:公开模型比较是“预测对实测”
| 模型 | 六任务平均准确率 | 性质 |
|---|---|---|
| End-Of-Token Distilled | 52.4% | 缩放律渐近预测,正文表 8 |
| Token Distilled | 48.4% | 缩放律渐近预测,正文表 8 |
| End-Of-Token Distilled 最大已训练检查点 | 44.6% | 附录 C 表 18 的实测 |
| Token Distilled 最大已训练检查点 | 44.4% | 附录 C 表 18 的实测 |
| Llama 3.2-1B | 45.9% | 公开模型实测,正文表 8 |
| Gemma-3-1B-pt | 44.3% | 公开模型实测,正文表 8 |
| Gemma 2B | 50.3% | 公开模型实测,正文表 8 |
因而摘要中的 EOT 相对 Llama 3.2-1B、Gemma-3-1B-pt、Gemma 2B 的 6.5、8.1、2.1 应读作预测渐近准确率与公开模型实测准确率的百分点差($52.4-45.9$ 等),而不是现有检查点已获得的优势。最大的 EOT 检查点 44.6% 仍低于 Llama 3.2-1B 与 Gemma 2B;它仅比表中 Gemma-3-1B-pt 高 0.3 个百分点。公开模型还使用不同训练数据规模,故这张表主要提供成绩参照。[Sec. 8,PDF p. 19,表 8;附录 C,PDF p. 37,表 18]
五:结论与判断
本文最扎实的方法贡献是:用 <eot> 使教师 token 的候选字节串带有显式终止事件,从而一次教师前向即可形成精确的增强字节目标;Marginalize-It 则给出更轻的近似对照。实测曲线支持 token 模型低预算领先、byte 模型后续改善更快,也清楚展示 BPB 与下游准确率的排序可能不一致。主要的“4.0 个百分点”和公开模型领先幅度是对固定约 1B 层参数模型、给定数据和六项任务的渐近外推。[Sec. 2、5–8,PDF pp. 4–19]
最影响应用判断的限制有三项。第一,附录换用验证集 2后,在 $4\times10^{-3}$ 下 EOT 与 token 蒸馏的渐近预测变为 50.5% 对 48.7%,差距从 4.0 缩至 1.8 个百分点;EOT 达到 token 渐近成绩的计算预测从 $6.33\times10^{22}$ 增至 $1.69\times10^{23}$ FLOPs。第二,留一法图 21 显示 byte 曲线的渐近 BPB 拟合通常比 token 更敏感,外推点应随拟合选择一起看。第三,byte 序列更长,作者明确指出其推理成本较高;本文没有做等推理成本的最终质量比较。这些条件决定了“更强”目前主要是所设缩放律下的预测,而非普遍的部署结论。[附录 D–E,PDF pp. 38–45,图 21、23、表 21–22;Sec. 10,PDF pp. 20–21]