NCP-ArchPreview:在万亿 token 预训练中联合预测 token 与概念
论文:NCP-ArchPreview Technical Report: Moving towards Latent Space Language Models through Next Concept Prediction
作者:The Intern-NCP Team;Shanghai AI Lab、上海交通大学 LUMIA Lab。完整作者名单见文末。
版本:arXiv:2609.10715v1;arXiv 提交日期 2026-09-09;获取及研读日期 2026-09-28。PDF 首页另印 2026-09-11,本文以 arXiv 版本号标识材料。
材料:arXiv 摘要页 · 原文 PDF · 作者主 TeX · 源码清单 · 英文汇报 PDF · 可编辑幻灯片
阅读范围:已阅读主 TeX 实际引用的全部正文、表格、附录 A–E,并对照 43 页 PDF 核验关键公式、原图、实验数值及定位。参考文献用于确认文中脉络,没有逐篇阅读所有被引论文;未运行作者训练或推理代码,也未复现实验。以下页码均为 PDF 页码,从 1 开始,与本版本印刷页码一致。图件来自同版本作者源码,没有生成式替代图;来源记录见 图件清单。
论文总览
核心问题是:语言模型内部已经形成了跨 token 的表征,能否让这些表征也成为显式预测目标,使大规模预训练更有效?
NCP-ArchPreview 保留逐 token 自回归输出,在中间加入一个以四个 token 为单位运行的概念模块。编码器隐状态经过平均池化形成连续概念,乘积量化码本提供有限的参考向量;概念模块预测码本分布,再把其加权向量反馈给 token 解码器。模型联合优化下一 token 预测(NTP)、下一概念预测(NCP)和码本拟合(VQ),并使用模块内部及模块之间的动态残差连接。
最有力的贡献是把 ConceptLM 的思路扩展到 8.94B 参数、从预训练开始启用 NCP、5.73T token 的规模,并给出多个层次的对照实验。这里的“概念”是模型学习的固定长度隐状态片段,并非人工定义的语义类别,也未证明码本中的每个条目都有可解释含义。
| 核心结果 | 原文数值 | 应如何理解 |
|---|---|---|
| Stage-1 达到 OLMo-3-7B 最终训练损失 | 用其 51.3% 的训练 token;最终损失低 0.091 | 1.95× 是按 token 数计算的收敛比,不是测得的墙钟加速 |
| Stage-1 下游 Overall AVG | 46.59 → 49.04,+2.45 个百分点 | 26 个指定任务结果的等权平均 |
| Stage-2 下游 Overall AVG | 56.98 → 57.57,+0.59 个百分点 | 优势减小,代码与 MC-STEM 组均值下降 |
| 与参数匹配 Transformer 比较 | 约 85% 理论计算量,训练损失接近 | 来自前 200B token 消融,不是完整训练后的等性能证明 |
| Scaling 实验 | 作者报告约 1.74× 计算效率 | 固定计算预算搜索及验证损失拟合结果 |
| 轻量领域适配 | 更新约 17M 参数 | 包含码本和概念预测头,不只是码本向量 |
| 概念增强投机草稿 | MAL 5.933 → 6.180,作者报告 +4.17% | 每轮提交 token 数增加,未直接报告端到端延迟增益 |
来源:Fig. 1(p. 2),Table 1(p. 11),Sec. 4.3、Table 2(p. 13),Fig. 4(p. 15),Sec. 5.1(pp. 16–19),Table 9(p. 21)。细小的末位差异可能来自显示值舍入;下文区分作者报告与本次计算。
结构地图
| 原文章节 | 论证作用 | PDF 页码与主要证据 |
|---|---|---|
| 1. Introduction | 为什么需要显式潜在目标;大规模训练概览 | pp. 1–3;Fig. 1 在 p. 2 |
| 2. Model Architecture | 池化、PQ 码本、概念预测、因果注入、IRC/CRC | pp. 4–8;Fig. 2 在 p. 5;Eqs. 1–20 |
| 3. Training | 三类损失、梯度路径、Muon 优化 | pp. 8–9;Eqs. 21–25 |
| 4.1–4.2 Experimental Setup / Main Results | 8.94B 模型、两阶段训练和下游评测 | pp. 10–12;Table 1 |
| 4.3 Ablation Studies | 参数、计算量及组件贡献 | pp. 13–14;Fig. 3 在 p. 12;Table 2 |
| 4.4 Hierarchical Residual Connection Comparison | 1B 模型比较不同残差结构 | pp. 14–15;Table 3 |
| 4.5 Scaling Law | 计算最优的模型与数据分配 | pp. 14–15;Fig. 4 |
| 4.6 Model Analysis | Muon 与 Q/K 归一化的稳定性 | pp. 16–17;Figs. 5–6 |
| 5.1 VQ Training | 代码、数学、知识适配及效率 | pp. 16–19;Tables 4–7、Fig. 7 |
| 5.2 Multi-Token Prediction on NCP-ArchPreview | 3B 控制实验中的 NCP/MTP 互补性 | pp. 19–20;Fig. 8、Table 8 |
| 5.3 Predicted Concept Improves Block-Parallel Speculative Drafting | 向草稿模型注入概念信号 | pp. 20–21;Table 9、Eqs. 26–27 |
| 6. Related Work | 与 ConceptLM、层次模型、动态残差的关系 | pp. 21–22 |
| 7. Limitations / 8. Conclusion | 适用范围及尚未完成的训练阶段 | p. 23 |
| A. Author List | 作者与贡献 | p. 33 |
| B. Additional Architecture Details | 完整配置、训练前向伪代码 | pp. 33–35;Table 10、Algorithm 1 |
| C. Analysis of OLMo-3 Mid-Training Data with Proxy Metrics | 按能力筛选中期训练配方 | pp. 33–38;Table 11、Fig. 9 |
| D. Scaling Experiments | FLOPs 定义、搜索方法与实验点 | pp. 38–40;Fig. 10、Table 12 |
| E. Evaluation Details | 提示、采样、指标汇总、训练轨迹 | pp. 38–43;Tables 13–14 |
附录之间有浮动图表交错,不能仅依赖 PDF 书签页码定位。
一:动机与贡献边界
1.1 为什么 NTP 之外还要预测概念
标准 NTP 的监督位于离散 token 层面。跨词、跨片段结构必须作为完成这个目标的中间能力自行出现。作者希望增加一个显式约束:过去的概念表示应能够预测未来一段文本的表示,从而使编码器保留对跨 token 依赖有用的信息。
这个设计同时改变两个因素:计算粒度变粗,使一部分参数在较短序列上运行;训练目标增加 NCP,使这部分计算被直接监督。仅有“压缩序列”不能说明 NCP 有效,只有增加预测损失也不能解释层次计算带来的容量收益,所以论文分别做组件、计算匹配和参数匹配对照。
1.2 不是首次提出 NCP
论文明确把 ConceptLM 视为直接前作:它已有联合学习 PQ 码本、下一概念预测和概念辅助 token 生成。本文新增的主要证据是,从预训练起启用这一机制,并扩大到 8.9B/万亿 token,配合层次残差、适配与草稿实验。不能把 NCP 或乘积量化本身都归为本报告首次提出的创新。(Sec. 6.2,p. 22)
作者将 JEPA 作为动机背景;但本模型仍依赖 NTP,不是纯粹的潜在空间预测系统。固定四 token 切块也不同于按句子、语义边界或动态字节片段划分概念的模型。后文实验没有直接检验“语义概念变得更可解释”这一命题。
二:方法
2.1 从输入到输出的数据流
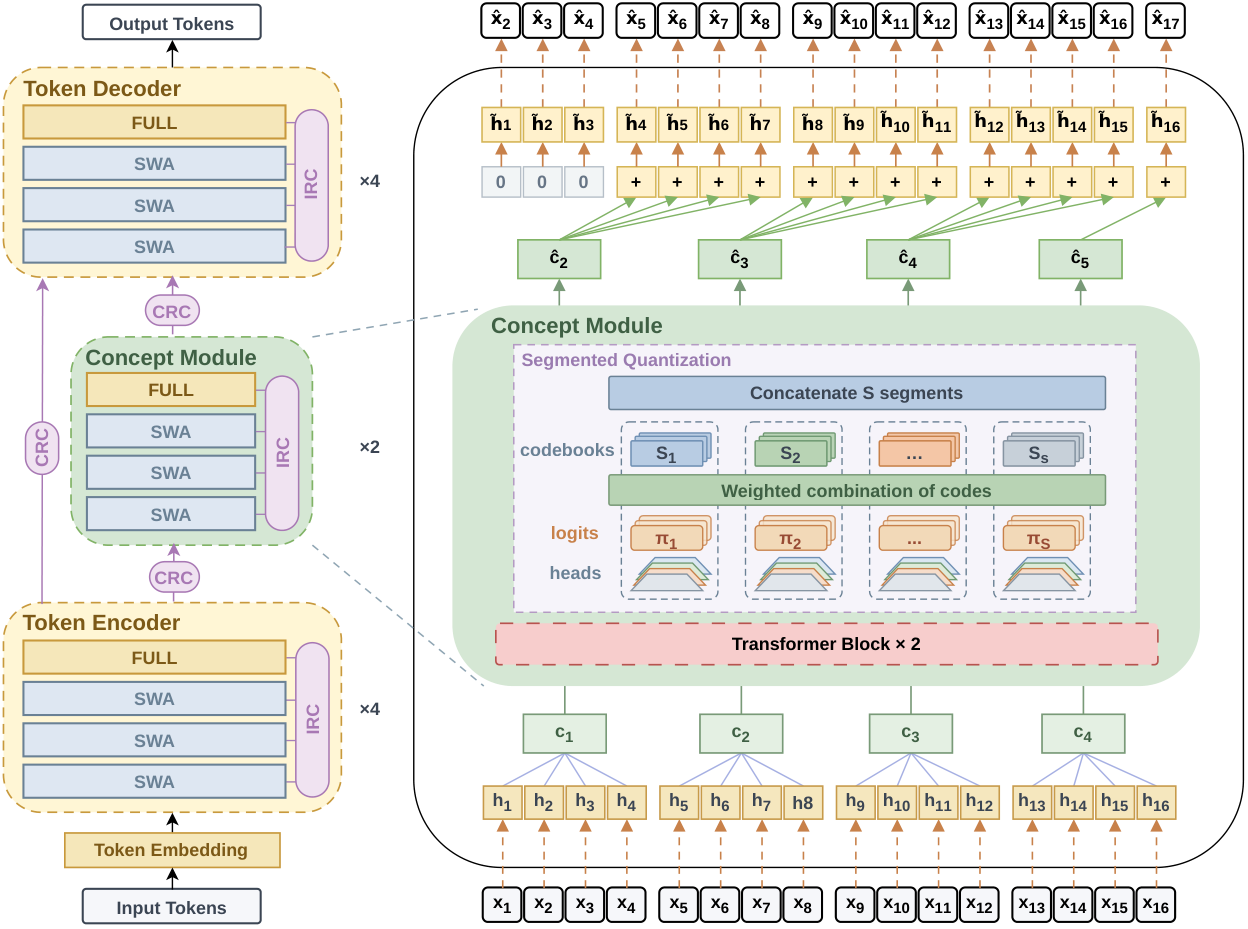
原图 2,PDF p. 5。先读左边的三模块,再读右边的池化—预测—反馈路径。左图中的 SWA 为滑动窗口注意力,FULL 为全注意力;右图顶部的前三个零对应概念信息尚不可用的前缀。
模型配置为:
| 项目 | 配置 |
|---|---|
| Token Encoder / Concept Module / Token Decoder | 16 / 8 / 16 层因果 Transformer |
| 隐藏维度 / FFN 维度 | 4096 / 11008 |
| 注意力头数 / KV 组数 / 单头维度 | 32 / 32 / 128 |
| token 词表 / 最大训练上下文 | 100278 / 8192 |
| token 级局部注意力窗口 | 4096;每第四层使用全注意力 |
| 位置编码 / 激活 / 归一化 | RoPE base 500000;SwiGLU;RMSNorm,$\epsilon=10^{-6}$ |
| 主实验 Q/K 归一化 | layer-wise QK RMSNorm |
| 概念压缩因子 / PQ 分段 / 每段码字 | $k=4$ / $S=32$ / $N=128$ |
| 参数量 / 参数精度 / dropout | 8.94B / BF16 / 0 |
来源:Sec. 4.1(p. 10)及 Table 10(p. 34)。图 2 的右侧是机制展开图;实际概念模块深度以配置表的 8 层为准。
输入 token 先产生全长隐状态;概念路径使用缩短四倍的序列;随后两条路径在解码器汇合。因此,只有概念模块按压缩后的长度计算,模型的 32 个 token 级层仍按 token 粒度运行。
2.2 符号与概念构造
| 符号 | 含义及维度 |
|---|---|
| $x_{1:T}$ | 长度为 $T$ 的输入 token 序列 |
| $\mathbf h_t$ | 编码器输出,$\mathbb R^d$,$d=4096$ |
| $k,M$ | 每概念 token 数及概念数;正文 $M=\lfloor T/k\rfloor$ |
| $\mathbf c_m$ | 第 $m$ 块的连续概念,$\mathbb R^d$ |
| $S,N$ | PQ 分段数、每段码字数 |
| $\mathbf c_m^s,\mathbf e_n^s,\mathbf d_m^s$ | 连续分段、码字、最近码字,均为 $\mathbb R^{d/S}$ |
| $\boldsymbol\pi_m^s$ | 第 $s$ 段码本上的预测概率,$\mathbb R^N$ |
| $\hat{\mathbf c}_m,\mathbf b_t$ | 预测概念、对齐到 token 的概念信号,均为 $\mathbb R^d$ |
| $\operatorname{sg}$ | stop-gradient:前向保留数值,反向不传播梯度 |
编码器和平均池化为:
对应 Eqs. 1–2,p. 4。每个 $\mathbf h_t$ 已包含其因果前缀的信息,所以池化的是具有上下文的隐状态,不是四个孤立 token 的静态词向量。固定分块并不保证恰好覆盖一个词、一个推理步骤或一个自然语义单元。
2.3 乘积量化:用小码本提供很大的组合空间
先按特征维度将 $\mathbf c_m$ 划成 $S=32$ 段,每段 128 维;每段独立找最近码字:
各段拼接得到 $\mathbf d_m$。这些是 Eqs. 3–6,p. 5。组合数为 $N^S=128^{32}$,但并没有存储这么多个完整向量;实际码本参数量为
这是根据配置的本次计算。巨大组合数只是表示容量,不等于已经学到同样数量的语义概念,更不保证所有组合都被使用。
2.4 下一概念预测:离散码本上的软组合
概念模块在训练时读入连续历史 $\mathbf c_{ 对应 Eqs. 7–10,p. 6。关键是不取 argmax、不采样单一码字,而是取加权期望,因此 token 损失可以经过这条路径反向传播。 “离散概念预测”容易被误解成“分类到一个离散概念 ID”。本文实际训练目标是连续向量 MSE;离散性来自有限的码本基底。更严格地说,由于 softmax 权重非负且和为 1,每个预测分段处在该段码字的凸包内。这是由公式得到的分析,比一般的“线性组合”约束更强。 本次教学例子:若一个分段对两个码字给出 0.8/0.2 概率,反馈向量就是 $0.8\mathbf e_1+0.2\mathbf e_2$,没有把模型的选择硬性压到其中一个码字。例子仅解释公式,不是论文实验。 在 Eq. 11(p. 6)中,$\Delta=k$: 然后 对应 Eqs. 12–13,p. 6。注意 $t$ 是用于预测下一个 token 的输入位置,不是待预测 token 的位置。 以下为按公式展开的教学例子,$k=4$: 这样,预测 $x_5$ 时使用的是由 $x_{1:4}$ 推断出的 $\hat{\mathbf c}_2$,而不是由真实 $x_{5:8}$ 算出的 $\mathbf c_2$。Concept Module→Decoder 的跨模块残差也需要同样对齐,否则旁路仍可能泄漏未来信息。 **训练与推理的区别及未充分说明之处:**训练可用真实序列并行构造概念监督;Sec. 2.3 另称推理时将先前预测概念自回归反馈。论文只提供训练前向 Algorithm 1,没有完整说明增量推理中预测概念、已生成 token 重编码概念及跨模块缓存怎样更新。因此不能仅凭这段文字补写出一套声称与发布实现完全一致的推理算法。对非整块长度,正文使用 floor,而 Table 10 又注明 padding/masking 后 $M=T/k$;末块处理也需查实现。(pp. 4、6、34–35) 模块内残差(Intra-Module Residual Connections, IRC)为当前层生成一组深度混合系数: 对应 Eqs. 14–18,p. 7;此处 $s$ 指模块,与上面的 PQ 分段下标是不同用法。IRC 权重不经过 softmax,允许负权重;初始化为只选择最近的残差更新状态,使初始行为退化为标准残差。 跨模块残差(Cross-Module Residual Connections, CRC)先对齐序列粒度,再按目标状态选择源模块的不同深度: 对应 Eqs. 19–20,pp. 7–8。CRC 使用 softmax 归一化和可学习逐维缩放 $\mathbf D\in\mathbb R^d$,后者小值初始化。三条连接为 Encoder→Concept、Encoder→Decoder、Concept→Decoder。 两者都能按当前表示选择深度信息,但权重约束不同。论文的 FLOPs 统计不完整计入历史状态物化、内存读写、归约和小 kernel 调度,不能把很小的理论 FLOPs 开销直接等同为几乎免费的运行时开销。 码本拟合损失(Eq. 21,p. 8): 它让被选中的码字靠近编码器分布;目标端停止梯度,因此该损失不直接推动 Encoder 去追逐码字。 正文 NCP 损失(Eq. 22,p. 9): 目标为连续概念 $\mathbf c_m$,不是最近码字 $\mathbf d_m$,也不是概念 ID 的交叉熵。目标端不回传,但预测分支通过历史 $\mathbf c_{ NTP 损失及总目标(Eqs. 23–24,p. 9): NTP 通过融合后的 token 路径与软概念路径共同更新模型。这也解释了为什么概念模块不是训练时加上、推理时即可随意删除的辅助头。 **实现核验点:正文与伪代码归一化不同。**Algorithm 1 第 21 行(p. 35)写成 按论文的拼接定义和普通欧氏范数,算法式是正文式的 $1/S=1/32$。差异可通过调整 $\alpha$ 吸收,但两式不应直接当作相同的实现;正文和附录也未给出明确的 $\alpha,\beta$ 数值。本笔记及幻灯片主讲公式统一采用正文 Eq. 22,并保留这一复现问题。 矩阵参数使用 Moonlight Muon,其正交化更新按 $\sqrt{\max(d_{\rm in},d_{\rm out})}$ 缩放;嵌入、偏置等非 Muon 参数使用 AdamW。默认学习率 $6\times10^{-5}$,采用与 OLMo-3-7B 相同的 cosine 调度。(Sec. 3.6,Eq. 25,p. 9) 主实验保留 OLMo 的 layer-wise Q/K 归一化。后文 per-head Q/K 归一化虽然更稳定,但只用于稳定性消融,不能把它当作主成绩使用的设置。 各行不能合并成一套“统一 8.9B 实验”。例如,MTP 的结论来自 3B 控制模型,而主模型的 5.73T 下游成绩并未使用该额外 MTP 层。 Stage-1 使用 Dolma 3 Mix,Stage-2 使用 Dolma 3 Dolmino;作者称与 OLMo 使用相同数据,并通过 OLMo-Core 的协议评测。主结果的 Vanilla 指公开的相应阶段 OLMo 模型;同配方重新训练的匹配基线属于另一个消融组。(Sec. 4.1,p. 10;Table 1,p. 11) Overall AVG 的定义尤其重要:对 26 项 higher-is-better 结果等权平均,即 MMLU 四领域加 MMLU-Pro(5)、数学(4)、代码(6)、MC-STEM(2)、MC-Non-STEM(3)、GenQA(6)。不重复计入汇总 MMLU 行,不平均六个领域的 AVG,也不加入 BPB。MMLU 总分本身则是 57 个学科等权平均。(Appendix E,pp. 39–42) “每题 32 个 completion”不等于报告 Pass@32。BPB 的十任务平均单列;MT-MBPP Gold 先在 17 个语言子集内取均值,随后只占十任务中的一个权重。全局随机种子为 42。论文表 13 未列全套 temperature/top-p 等解码参数,不能自行按惯例补齐。 领域适配 Tables 5–7 的 General AVG 实际包含 MMLU、ARC-E、HellaSwag、NQ Open、SciQ MC 五项;Appendix E 的文字列举漏提了 SciQ。应以对应表格列和五项均值解释这组数据,不与主表 Overall AVG 混用。 原图 1a,PDF p. 2。横轴是训练 token 数,纵轴是 token 级训练损失;橙线为 OLMo,青线为 NCP。插图放大末段,下方曲线为两者差值。图中的 1.95× 箭头比较达到同一损失所需 token 数,不是运行时间。 作者报告 Stage-1 用 51.3% token 达到基线末端损失,约为 $5.73\times0.513=2.94$T token(本次按报告比例计算);最后损失差为 0.091。Stage-2 对应比例为 66.2%,末端损失低 0.027。阶段训练分布不同,所以不能把两个阶段的绝对 loss 直接视为同一难度标尺。(Sec. 4.2.2,p. 10) 来源:Table 1,p. 11。MC-STEM 显示均值之差为 2.46,原表差值为 2.47;保留作者值并注明舍入层面的差别,其他一些差值也存在末位类似现象。 Stage-1 所称数学提升“18%”是组均值 $3.75/20.79\approx18.0\%$ 的相对变化,不是 18 个百分点。GSM8K 的 +5.99 则是百分点。主表中 Stage-2 HumanEval 从 49.31 降到 45.62(−3.69 个百分点),不能把正的平均增益解释成所有任务均受益。 作者认为 Stage-2 仅约 10% 是代码数据,数据配比可能解释代码弱化;这是解释性假设,论文没有用单独改变代码比例的因果对照直接证实。(Sec. 4.2.3,p. 12) BPB AVG 从 Stage-1 的 0.824 降到 0.811,Stage-2 从 0.793 降到 0.763。局部任务可与生成成绩不同向,例如 Stage-2 GSM8K Gold BPB 0.356→0.381 变差,但 GSM8K Pass@1 提升。因此“参考答案似然”和“生成正确率”不能互相替代。 来源:Table 2,p. 13。这里省略小型码本与残差组件,概念层计算也只是近似;不是逐 kernel 精确成本。 原图 3,PDF p. 12。横轴训练 step,纵轴训练 loss;三条灰线是标准、计算匹配、参数匹配基线,蓝/绿/红分别逐步加入 CM、Residual、NCP。右上角插图放大最后 8k steps,适合读细小差异。 完整模型好于计算匹配基线,并接近参数匹配基线;CM、Residual、NCP 在这个添加顺序下各带来进一步改善。由 $34/40=85\%$ 得到同参数设置下的理论计算比例。反过来,以 NCP 为分母,40 层基线多 $40/34-1\approx17.65\%$;Fig. 3 图例的“+15% computation”使用的表述不宜与“比 NCP 多 15%”混同,15% 正好是以 40 层为分母的节省比例。 这组证据支持体系结构和 NCP 都有作用,但消融只覆盖 200B token,且是逐步添加而非完整因子设计,没有证明三项收益在任意设置下独立可加,也没有报告全程 5.73T 的参数匹配下游对照。 来源:Sec. 4.4、Table 3,pp. 14–15。完整方案相对无层次残差低 0.0323,优于本文配置的 Block AttnRes。不能据此概括为 IRC 在所有规模和实现上都优于 AttnRes;也不能把 +0.051% 当成实测吞吐或显存增幅。 原图 4,PDF p. 15。横轴为 FLOPs,纵轴为验证 loss,标记是搜索所得最优点,虚线是拟合;同一损失处的横向差距对应作者报告的约 1.74× 计算效率。 附录用 $C=F_{\rm tok}D$ 统计总训练 FLOPs,排除嵌入参数相关估算,而不是直接对全部非嵌入参数套 $6N_{\rm param}D$。原因是概念层每个块才运行一次,参数数与每 token 激活计算不再成固定比例。 来源:Appendix D、Table 12,pp. 38–40;以上为本次从每预算所有已列实验点中取最小值。Fig. 10 展示同一预算下改变模型/数据分配的曲线。有限预算与搜索范围内的优势值得关注,但 1.74× 既不是主模型的实测训练加速,也不是任意更大规模上的已验证常数。 原图 6,PDF p. 17。横轴训练步数;左图是最大注意力 logit,右图是最大 Q/K 范数。Muon 基线曲线上升,per-head 归一化的对应值保持较低。 Fig. 5(p. 16)另展示部分头的范数异常、注意力 logit 放大与梯度尖峰共同出现。作者解释是:全矩阵 Muon 更新耦合了多个头,而 layer-wise 归一化仅约束整体尺度,无法充分约束单个头的尺度和 QK 对齐。匹配 AdamW/Muon 及 per-head 干预支持这个诊断,但不构成覆盖所有优化器/模型的稳定性定理。 **主成绩仍来自 layer-wise Q/K 归一化。**这一节给出潜在改进方案,没有把其效果计入主表。 从各自 Stage-1 检查点分别在 Magicoder、Orca-Math、TriviaQA-RC 上训练,比较 Full、LoRA 和 VQ。VQ 冻结其余模型参数,更新既有码本及预测头;LoRA 同样更新 17M 参数,但新增权重。码本本身只有约 0.524M;17M 的说法必须包含预测头。(Sec. 5.1、Table 4,pp. 16–17) 以下均是 NCP 模型内部对比,目标分数的变化为相对该实验 Stage-1 基线的百分点差: 来源:Tables 5–7,pp. 18–19。General 初值均为 68.68,按五项通用任务汇总;这里的 GSM8K 起点为 46.78,与主表 45.26 不同。论文另行报告这些辅助实验,不能把不同表的起点拼成一条训练轨迹。 代码适配中,Full 的 HumanEval 提升较大,但 MBPP+ 从 29.63 降到 7.14;VQ 则是唯一同时提升四项代码任务的设置。数学中 VQ 同时优于等训练参数的 LoRA 的目标均值和通用均值,但目标增益仍低于 Full。知识中 VQ 保留通用能力较好,却明显落后于 Full/LoRA 的 TriviaQA 收益。即使骨干冻结,VQ 也不是“完全不遗忘”:代码适配的 General AVG 下降 0.42,且这项保持程度不及该组 LoRA。 作者将知识增益较小解释为固定骨干 MLP 无法直接改写其中的事实关联。这与参数冻结的机制相容,但不是本文通过事实定位或神经元干预验证的因果结论。 原图 7,PDF p. 19。左图为 8 GPU、micro-batch size(MBS)1 的每 GPU token/s;中图是同配置显存容量占比;右图改为单 GPU、MBS 2,因此不能跨面板当成仅方法不同的对照。 8 GPU、MBS 1 时,Full/LoRA/VQ 分别为 7739/10400/15632 token/s/GPU;VQ 分别约为 Full 的 2.02×、LoRA 的 1.50×。显存容量占比分别为 90.3%/49.0%/32.4%。单 GPU、MBS 2 时 VQ 为 51.6%,LoRA 为 87.9%,Full OOM。论文未明确报告该测量的 GPU 型号和容量,不能换算成确定的 GB,也不应把这些倍数推广为预训练加速。 NCP 控制模型使用 Encoder/Concept/Decoder = 8/4/7;标准 OLMo-3-3B 被分为 8/1/7 并在相应深度增加相同层次残差。各自再增加一个预测后第二个 token 的 MTP 层,损失权重为 0.3。四者均训练 150B token。(Sec. 5.2,pp. 19–20) 来源:Table 8,p. 20。指标排除辅助损失,且是整个训练区间平均,不同于 Table 3 的最后 200 步均值。NCP 无 MTP 已优于普通残差模型加 MTP;NCP 再加 MTP 仍改善。Fig. 8 中交叉约在 2285 次更新,末段排序一致。 这支持两种信号互补,但本节只报告训练 loss,不能直接推出 8.94B 的下游分数或最终推理速度改善了多少。 基线结合 DFlash2 的两 tap 动态卷积、每位置 top-16 路径选择,以及 DFlare 的逐层混合五个 Target 隐状态。增加概念的版本保持其他设置相同,取已验证前缀中最后完整块的概念信号,通过零初始化门注入每个草稿位置: 对应 Eq. 26,p. 21。论文在这条公式使用 $c$,而正文其他地方 $c$ 表示池化概念、$\hat c$ 表示预测概念;标题与文字又称 Concept Module 的概念状态。这里沿用该节的记号,不擅自认定具体实现抽取的是哪一个张量。 草稿器 1.1B 参数,注入增加 0.04M;作者称不额外执行 Target 计算。训练采用同数据顺序、随机种子及预算:序列长 8192,每序列 512 anchors,全局 batch 512,固定 5B token 子集重复 10 epoch。验证使用 16 token proposal horizon。 来源:Table 9,p. 21;按已舍入的显示值重算相对变化会有约 0.01 个百分点量级的差异。 Eq. 27 定义 $\mathrm{MAL}=R^{-1}\sum_r c_r$,其中 $c_r$ 是一轮验证真正提交的 token 数,包含存在时的 Target correction 或 bonus token,不只是接受的草稿 token 数。四任务方向一致,HumanEval 改善最大,说明概念信号可辅助草稿。但没有端到端延迟、吞吐及置信区间,不能直接说用户可感知速度提升 4.17%。 作者构造固定的 177202 条专家轨迹,覆盖 63 个来源、6 个领域,约 100M teacher suffix token,来自一个冻结的 Qwen3.7-Plus teacher。候选检查点在相同 prompt、suffix、来源及能力标签下评分。 自由生成类任务对专家后缀做 teacher forcing,计算平均 token NLL(Eq. 28,p. 35),再先按来源平均、后在能力类别内平均,避免大数据源仅凭样本数占据主导。代码、竞赛数学、学术 STEM、逻辑推理保留为能力向量。HellaSwag 则使用正确选项与最强干扰项的字符归一化 log-likelihood margin。 来源:Table 11,p. 36。四种自由生成能力的 NLL 排序与相关下游任务一致;正文称 V1→V3 的训练损失更低,但这些能力反而更弱。它支持使用贴近能力的 held-out 评估,而非只选择训练混合损失最低的模型。 Fig. 9(p. 37)横轴是 $-\mathrm{NLL}$、纵轴是下游百分分数;主图拟合只有三个同协议 Stage-2 点,插图才加入 Stage-1。HumanEval 的 $R^2=0.999$ 不能被当作对未知配方/模型家族的预测保证。HellaSwag 的 V2/V3 仅差 0.05 个百分点,作者在筛选时视为同一领先档,而不声称代理能确定两者的精确排名。这里没有证明某一个混合数据源造成了能力增益。 Table 14(p. 43)中的 Overall AVG 从 100K step 的 39.64 提高到最终 49.04;但 1.0M→1.1M step 为 48.05→48.00,单任务波动更多。BPB AVG 也会反弹。因此正文“持续提高”的表述应读成整体趋势,不是每个检查点、每个任务的单调保证。该表只有 NCP 轨迹,没有同样完整的匹配基线轨迹。 我的判断:这篇论文更强的证据是显式概念预测作为工程架构在大规模预训练中可行且有益。它没有直接证明隐空间里存在稳定、可解释的符号概念,也没有证明模型已学会类似人类的抽象规划。 这些问题不直接推翻报告结果,但会影响严格复现。论文没有给出的关键细项包括明确 $\alpha,\beta$、完整领域适配超参数(例如 LoRA rank/目标层、学习率、步数)、上述适配效率测量硬件,以及全部生成采样参数。不要把经验默认值当作作者设置。 可优先做三件事:在完整训练预算下比较同参数/同 FLOPs 的下游性能;测量层次残差及概念缓存对真实吞吐、显存、时延的成本;直接分析码本利用率、语义稳定性及跨领域概念结构。若目标是应用,则应分别验证 17M 接口能否覆盖所需领域,以及 MAL 增益在目标部署硬件上能转化成多少实际速度。 主阅读链路为作者 main.tex → sections/01_introduction.tex、02_architecture.tex、03_training.tex、04_evaluation.tex、05_related_work.tex、07_limitations.tex、08_conclusion.tex → appendix.tex 及其引用的全部七份表格文件;notations.tex 用于宏解释。已核验 PDF 的图 1–10、表 1–14 与核心公式。原文参考文献没有逐项外部核查,报告不代表独立实验复现。 作者在首页列出的资源:模型集合、LMDeploy、评测代码。这些链接按原文记录,本次未审计仓库实现。 完整作者(Appendix A,p. 33):Jiaqi Cao;Chiyu Chen;Shuang Cheng;Xu Cheng;Beiya Dai;Yufan Feng;Kewen Ge;Ruijun Ge;Jiayi Huang;Yang Jiao;Dahua Lin;Zhouhan Lin;Yifan Liu;Yuliang Liu;Biqing Qi;Mowen Ruan;Junzhe Shen;Yunchong Song;Hao Sun;Zhongbo Tian;Yixuan Wang;Rubin Wei;Jiaxin Xiong;Kangyu Yang;Qian Yao;Qi Zhang;Bowen Zhou。 英文幻灯片为本次独立编写的研读汇报,原图仍归原作者;本目录附本地 pdfLaTeX 编译工具。它是 Beamer PDF,不是 PowerPoint 文件。2.5 因果对齐:为什么要在完整块之后注入
当前输入位置 $t$ 已能构造的概念历史 加到当前状态的信号 监督的输出 1–3 第一个块未完整 0 $x_2$–$x_4$ 4–7 用 $\mathbf c_1$ 预测下一块 $\hat{\mathbf c}_2$ $x_5$–$x_8$ 8–11 用 $\mathbf c_{1:2}$ 预测下一块 $\hat{\mathbf c}_3$ $x_9$–$x_{12}$ 12–15 用 $\mathbf c_{1:3}$ 预测下一块 $\hat{\mathbf c}_4$ $x_{13}$–$x_{16}$ 2.6 IRC 与 CRC:分别解决模块内和模块间的信息复用
2.7 三类损失与梯度到底流向哪里
2.8 优化与稳定性设置
三:实验设计与指标
3.1 各实验回答的问题不同
实验 对象及预算 对照与主要问题 主训练 8.94B;Stage-1 5.73T,Stage-2 100B token 对比相应阶段公开 OLMo-3-7B;规模训练是否有效 组件/匹配消融 前 200B token,同训练配方 32/34/40 层普通模型及逐步加 CM、Residual、NCP;收益是否仅来自更多计算或参数 残差比较 1B,150B token 无层次残差、IRC、CRC、输入级跨接、Block AttnRes Scaling ladder 五档 $10^{19}$ 到 $10^{20}$ FLOPs 搜索模型大小、训练数据量、学习率和 batch size;比较每预算最优验证损失 VQ 适配 从 Stage-1 出发,三个独立领域训练 Full、17M LoRA、17M VQ;目标能力与通用能力如何权衡 MTP 互补性 3B,150B token 残差对齐的 OLMo 与 NCP,各有/无一层 MTP 草稿增强 1.1B drafter;固定 5B 子集重复 10 epoch 基线与仅增加概念注入的版本;比较精确验证下的 MAL 配方代理评测 三个等预算 Stage-2 配方,加 Stage-1 参考 固定能力数据的似然能否辅助筛选配方 3.2 主训练与下游协议
代表任务 提示/采样 指标及方向 MMLU、MMLU-Pro 5-shot 多选准确率,越高越好 GSM8K 8-shot,每题 1 个 completion Pass@1,越高越好 MATH-500 4-shot,每题 32 个 completion Pass@1,越高越好 HumanEval、MBPP 3-shot,每题 32 个 completion 测试执行 Pass@1,越高越好 HellaSwag 5-shot,按字符长度归一化选项似然 选项准确率,越高越好 LAMBADA 两版本 0-shot,贪心补全 token 补全准确率,越高越好 Gold completion 等十项 任务分别配置 0/3/5/8-shot 每 UTF-8 byte 的负 log2 似然 BPB,越低越好 四:结果与证据
4.1 主结果:收敛优势明确,下游优势依赖训练阶段
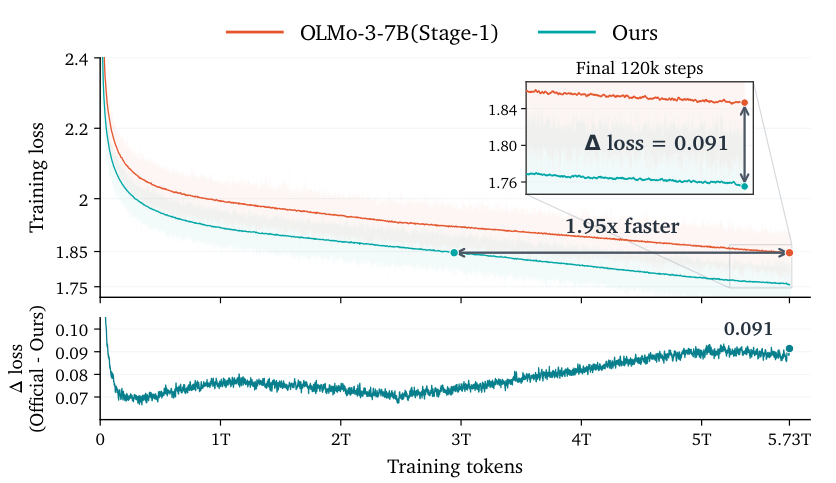
指标 Stage-1 OLMo → NCP 变化,百分点 Stage-2 OLMo → NCP 变化,百分点 Overall AVG 46.59 → 49.04 +2.45 56.98 → 57.57 +0.59 MMLU 汇总 62.22 → 64.80 +2.58 66.66 → 68.48 +1.82 GSM8K 39.27 → 45.26 +5.99 79.68 → 83.02 +3.34 MATH 组 AVG 20.79 → 24.54 +3.75 55.63 → 57.39 +1.76 Code 组 AVG 25.15 → 27.79 +2.64 39.42 → 38.77 −0.65 MC-STEM AVG 84.47 → 86.93 原表 +2.47 89.65 → 88.67 −0.98 MC-Non-STEM AVG 70.08 → 74.71 +4.63 76.85 → 77.76 +0.91 GenQA AVG 54.29 → 54.76 +0.47 53.49 → 54.04 +0.55 4.2 参数与计算匹配:收益不只来自多加八层
配置 参数量的 block 近似 每 token 计算的 block 近似 Vanilla $32P_{\rm blk}$ $32F_{\rm blk}$ Vanilla computation-aligned $34P_{\rm blk}$ $34F_{\rm blk}$ Vanilla size-aligned $40P_{\rm blk}$ $40F_{\rm blk}$ NCP-ArchPreview $(16+8+16)P_{\rm blk}$ $(16+8/4+16)F_{\rm blk}=34F_{\rm blk}$ 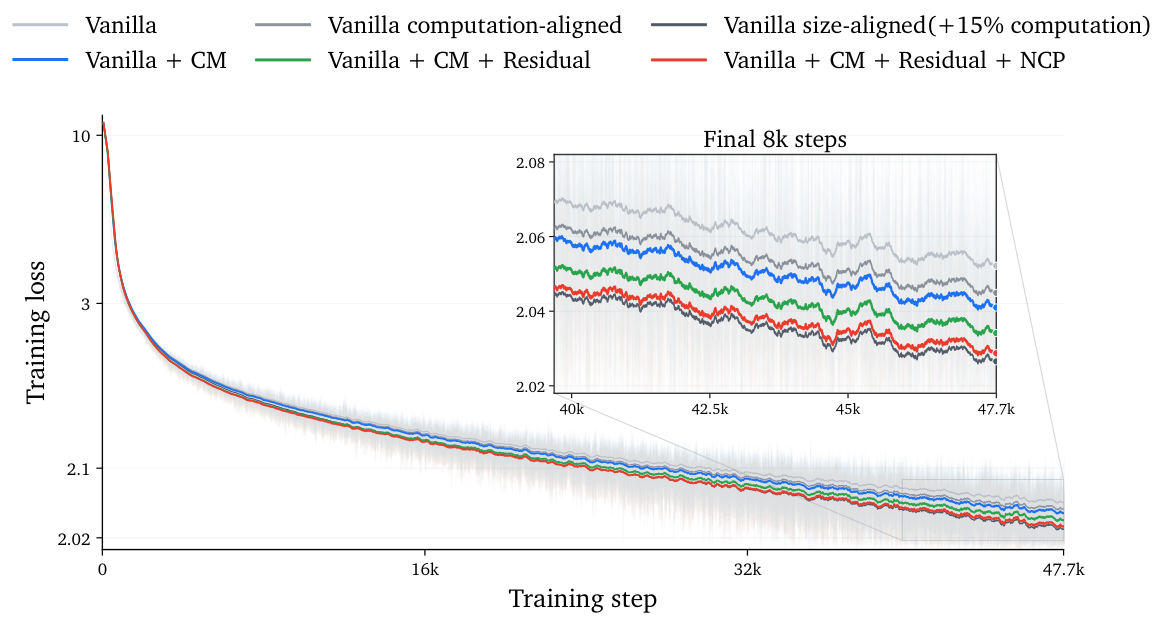
4.3 残差设计:完整 IRC+CRC 最优,实际成本仍待测
1B / 150B token 配置 最后 200 记录步平均 LM loss ↓ 额外理论 FLOPs 无层次残差 2.2588 0 IRC+CRC 2.2265 +0.051% 仅 IRC 2.2315 +0.024% IRC+输入级跨接 2.2292 +0.024% IRC+各阶段 softmax 2.2295 +0.024% Block AttnRes,块大小 4,含跨模块连接 2.2409 +0.026% 4.4 Scaling:比较固定预算下的最佳验证损失
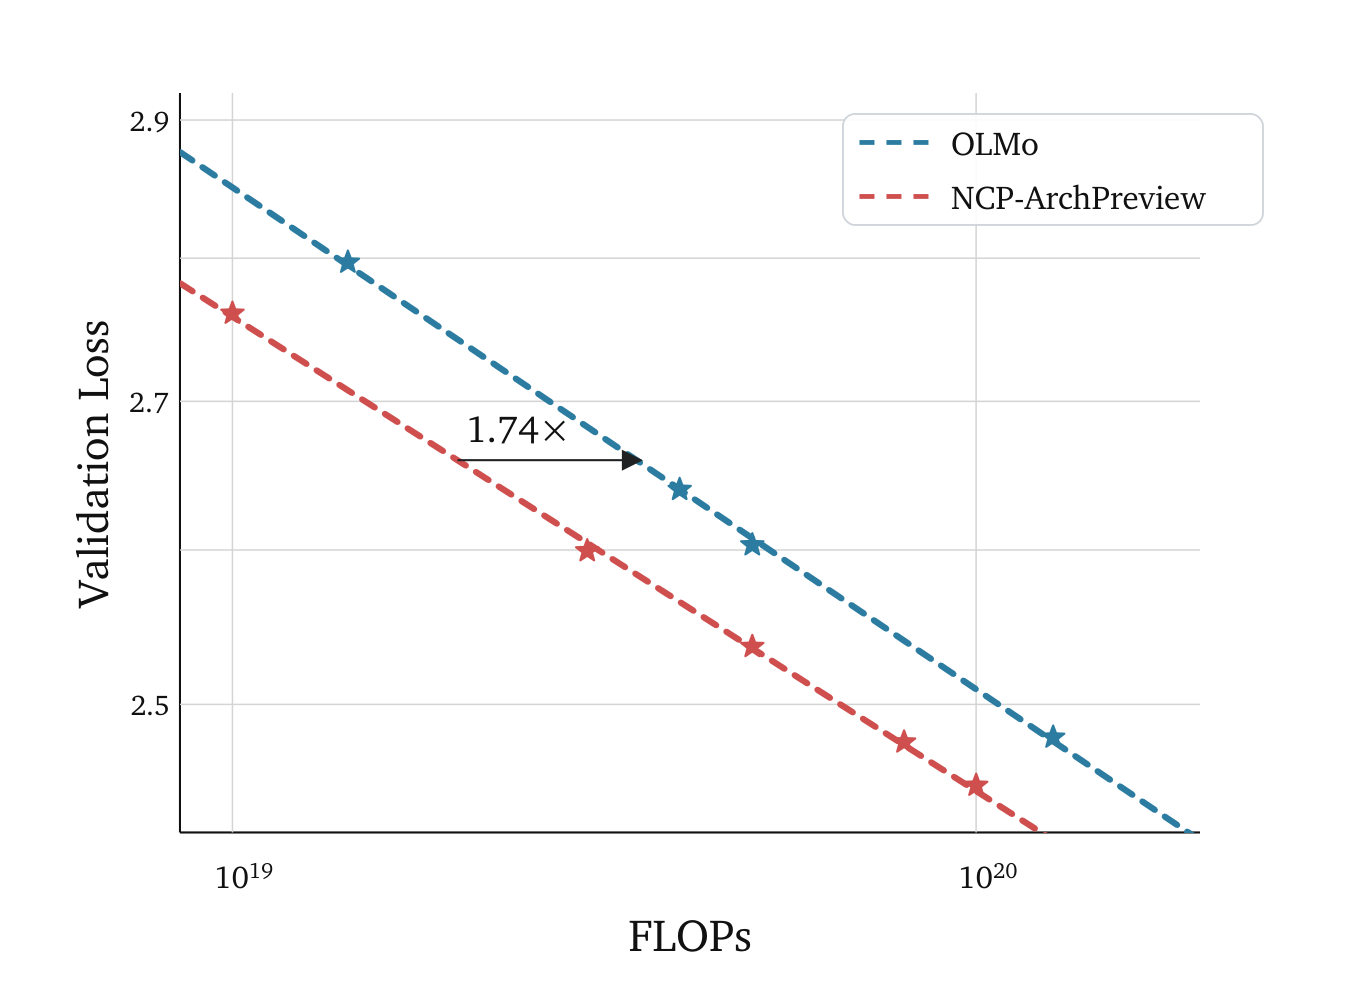
FLOPs 预算 Table 12 中 NCP 最佳验证 loss 对应 Encoder/Concept/Decoder 层数 $10^{19}$ 2.759 4/4/4 $3\times10^{19}$ 2.599 8/4/8 $5\times10^{19}$ 2.537 8/8/8 $8\times10^{19}$ 2.476 8/4/8 $10^{20}$ 2.449 8/8/8 4.5 稳定性:Muon 与跨头归一化存在交互
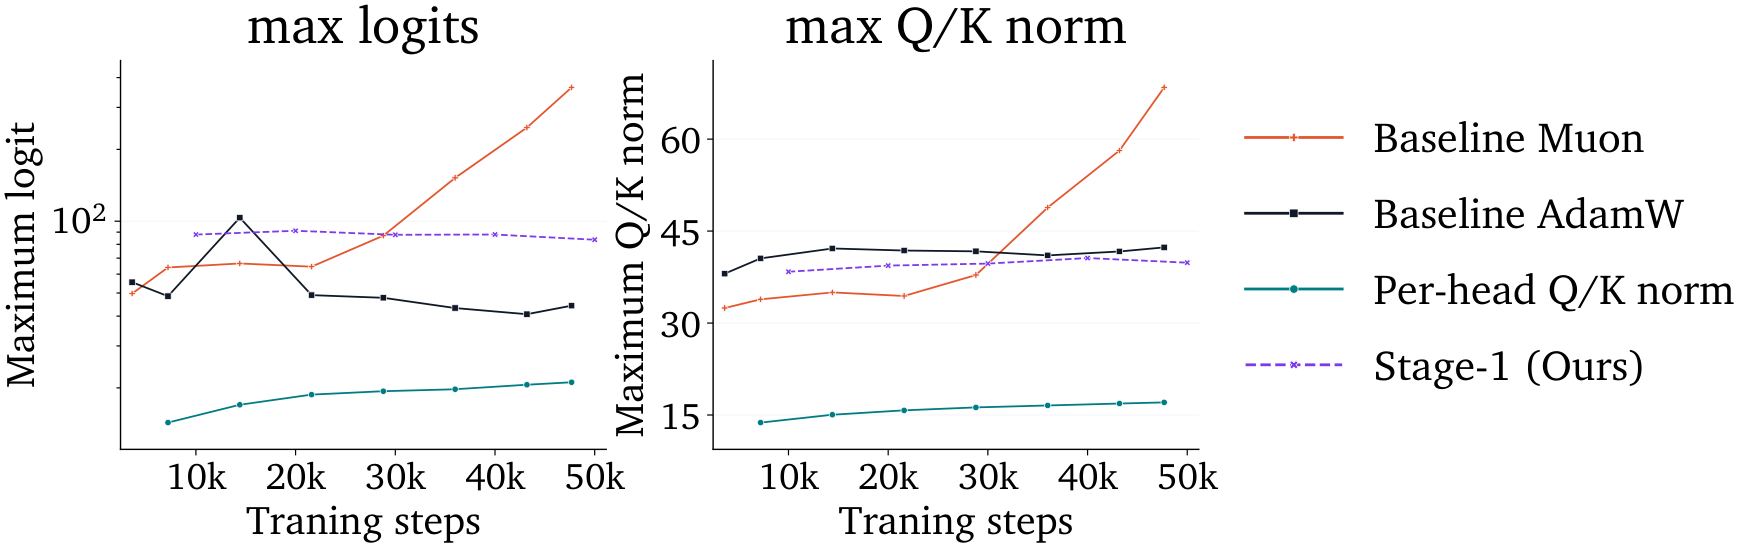
4.6 VQ 领域适配:小接口有用,但存在能力取舍
领域 / 初始目标分数 Full:目标分数(变化) LoRA:目标分数(变化) VQ:目标分数(变化) Code 四任务均值 / 30.04 28.43(−1.61) 31.38(+1.34) 32.69(+2.65) Math 两任务均值 / 30.56 36.72(+6.16) 33.71(+3.15) 34.83(+4.27) TriviaQA EM / 40.28 58.28(+18.00) 57.76(+17.48) 49.47(+9.19) 适配领域 Full 的 General AVG 变化 LoRA 的变化 VQ 的变化 Code −0.48 −0.11 −0.42 Math −0.97 −0.42 +0.39 Knowledge −0.29 −0.14 +0.03 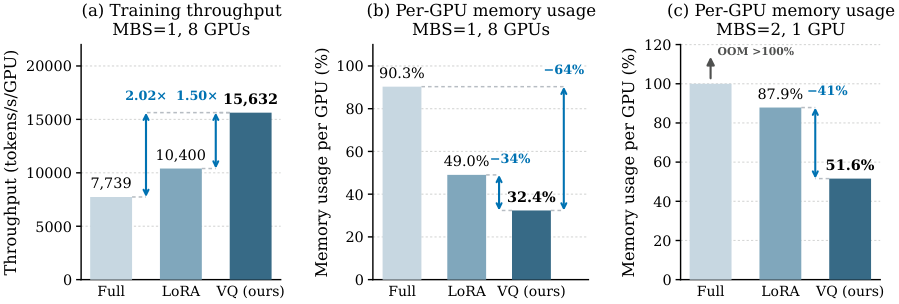
4.7 MTP:概念目标与多 token 目标可以互补
配置 全部前 150B token 平均 LM loss ↓ 训练 FLOPs OLMo-3-3B + Residual 2.3805 $3.245\times10^{21}$ 上者 + MTP 2.3739 $3.750\times10^{21}$ NCP-ArchPreview 2.3707 $3.227\times10^{21}$ NCP-ArchPreview + MTP 2.3664 $3.731\times10^{21}$ 4.8 草稿模型:接受长度增加,但不是已测得的等比例加速
任务 基线 MAL +Concept MAL 作者报告的相对变化 GSM8K 6.351 6.537 +2.93% MATH 6.105 6.240 +2.22% HumanEval 5.432 5.845 +7.59% MBPP 5.844 6.099 +4.37% Macro average 5.933 6.180 +4.17% 4.9 附录 C:用能力代理指标筛选 Stage-2 配方
指标 Stage-2 V1 V2 V3 Function-generation NLL ↓ 0.7330 0.7501 0.7598 Competition-math NLL ↓ 0.5742 0.5949 0.6075 Academic-STEM NLL ↓ 0.8909 0.9007 0.9058 Logical-reasoning NLL ↓ 0.8148 0.8314 0.8355 HumanEval ↑ 45.60 42.19 39.96 MATH-500 ↑ 43.74 41.66 37.21 HellaSwag margin ↑ 0.09678 0.09932 0.10083 HellaSwag accuracy ↑ 66.40 67.30 67.25 4.10 附录 E:预训练进展总体改善,并非严格单调
五:结论、限制与复现要点
5.1 论文可靠地建立了什么
5.2 阅读时应保留的限制
5.3 对照原文发现的具体说明问题
项目 两处原文/现象 对复现或解读的影响 NCP 归一化 Eq. 22,p. 9;Algorithm 1 第 21 行,p. 35 差一个 $1/S$;需结合实现确认 $\alpha$ 与 reduction 概念时间下标 正文 Eq. 7 用预测目标下标 $\mathbf u_m$;算法用 $\mathbf u_{m-1}$ 预测第 $m$ 块 可用输出位置/目标位置重编号解释,不能机械照搬造成一块偏移 推理与末块 Sec. 2.3 描述预测概念回馈;Algorithm 1 仅描述训练;Table 10 写 padding/masking 增量缓存、概念刷新和末块 mask 需实现级核验 草稿概念状态 Sec. 5.3/标题与 Eq. 26 的 $c$ 记号不够明确 不据此认定是池化向量、预测向量还是模块中间层 15% 与 85% Fig. 3 图例;Table 2 的 34/40 节省率和额外开销的分母不同 通用能力任务列表 Tables 5–7 含 SciQ;Appendix E 文字未列 SciQ General AVG 按表内五项解释 5.4 值得继续验证的问题
原始材料与复用说明