Continual Learning Mechanisms Compose for Long-Horizon Memorization:中文精读笔记
- 作者:Zheyuan Zhang、Alvin Zhang、Daniel Khashabi、Tianmin Shu(Johns Hopkins University);前两位共同一作,后两位共同指导。
- 原文:arXiv:2609.06986v1,提交于 2026-09-07;本次获取与研读日期:2026-09-16。
- 本地原文 PDF · 英文汇报 PDF · 可编辑 TeX。目录名 CL-Composition 是本次归档的主题简称,不是作者提出的方法名。
- 材料与范围:已读取同版本
main.tex实际引用的全部正文章节和 Appendix A–E,并用 47 页 PDF 核对章节、主要公式、图表与结果。参考文献用于辨认比较对象,没有逐篇阅读被引论文;没有运行作者实验。页码均指 PDF 的 1 起始页码。
论文总览
论文问的是:语言模型能否把陆续到来的信息写入参数,并在之后 100 个任务的连续更新中记住它们?作者把保存旧知识的机制分成数据、函数、权重三个“锚”,再与低秩更新的保存方式组合。最有力的实验证据是生成式回放与 merged LoRA 的互补性;单独使用的增益较小,一起使用则大幅提升训练问答的最终保持率。
全锚组合(SI + SD + Replay + merged LoRA)在主实验 16 种组合中,三个数据集分别排第 2、1、3,平均 Final 为 34.9%。这不是每个数据集都最优,也不是跨全部 21 个方法均前 3。它延缓遗忘,但没有解决长期遗忘或通用能力损失。本文衡量的是训练问题的记忆,不能据此认定模型能回答改写问题或迁移到新任务。
结构地图
| 原文章节 | 论证作用 | PDF 页码与证据 |
|---|---|---|
| 1 Introduction | 参数记忆问题、组合假设 | pp.1–3;Fig.1 在 p.2 |
| 2 Related Work | 与持续学习、回放、LoRA、模型编辑的关系 | pp.3–4 |
| 3 Composing Continual Learning Mechanisms | 三类锚及两类主要分配规则 | pp.4–6;Eqs.(1)–(6) |
| 4 Evaluation Setup | 4.1 指标、4.2 数据、4.3 TSH 搜索 | pp.6–8;Eqs.(7)–(10),Fig.2 |
| 5 Experiments and Results | 5.1 组合,5.2 半衰期,5.3 因子效应 | pp.8–11;Fig.3、Table 1 |
| 6 Conclusion | 贡献与记忆/泛化、能力保持边界 | p.11 |
| A Extended Related Work | 相关方法的详细定位 | pp.17–18 |
| B Detailed Method Implementations | 实际损失、任务边界、坐标风险、超参数 | pp.18–32;Table 3 |
| C Data Construction | 三套数据的构造和新颖性限制 | pp.33–35 |
| D Search Procedure Details | 搜索预算、续训、排序迁移 | pp.35–38;Table 6 |
| E Additional Results | 完整配置、统计、额外分配规则、通用能力及控制 | pp.38–47;Tables 7–14,Figs.4–6 |
一:动机
1. 为什么要单独研究 long-horizon memorization?
上下文提示和检索让模型在推理时接触外部知识;这里研究的是知识写入参数后还能否保留。每个任务给出一组问答,学习器只可用当前训练集与上一任务留下的状态,不保存过去的原始训练样本。推理时不给 task ID,因此不能凭任务编号选取专用模型。
很多持续学习基准同时考察迁移或异构任务性能,很难单独判断旧关联是否被覆盖。本文用同一批问题的长期复测隔离“学会后是否记得”。这是一种明确的实验设计,而不是用训练集准确率宣称泛化。
2. 贡献是受控的组合研究
生成式回放、自蒸馏、SI/EWC 和合并低秩更新都已有先例。本文的贡献主要在问题设定、三套 100 任务数据、机制分类、任务级 successive halving,以及全因子实验对互补性进行检验。理解重点应是“哪些机制搭配有效、条件是什么”,而不是把每个模块当作新算法。
二:方法
1. 输入、状态与任务循环
任务 $t$ 的输入是当前数据 $\mathcal D_t=\{(x,y)\}$、上一任务的模型 $\Theta_{t-1}$,以及已启用方法的状态。输出是新模型 $\Theta_t$ 和供下一任务使用的状态。
完整组合的任务循环可以按以下顺序理解(教学整理,源于 Appendix B.7, pp.31–32):
- 在更新前冻结上一模型作为教师;若启用回放,由教师生成当前任务期间使用的临时伪数据。
- 按当前数据和回放数据联合训练;函数锚约束当前序列上的输出,权重锚约束被追踪的 LoRA 参数。
- 在坐标重置前汇总 SI 重要度,或估计 online EWC Fisher;OSRM 则另收集特征。
- 将本任务 LoRA 更新合并进稠密权重,重建新 LoRA 和优化器;释放临时教师及回放样本。
所有第一任务的旧知识锚都关闭。教师每任务更新,并不是一直固定最初的预训练模型。
2. 总目标:正文概念式与附录实现式要区分
正文 Eq.(2) 将目标概括为当前 SFT 加三种保持项。实际主组合在启用回放时优化的是(Appendix B.2, pp.20–21):
关闭回放时,拟合项恢复为 $\mathcal L_{\mathrm{SFT}}^t$,不能仍把它乘以 $1-w$。不同配置还可选 online EWC,O-LoRA 另有正交惩罚;主 $2^4$ 因子实验的权重锚固定为 SI。
$w$ 是损失混合权重,不是旧任务样本占全历史数据的比例。SFT 对完整问题—答案序列计算 token 平均负对数似然,问题 token 不屏蔽;padding 和 replay seed 不作为有效目标。
3. 数据锚:教师生成伪序列,并提供软目标
所有回放训练序列前加同一个 <|replay_token|>,其新增 embedding 用原词表均值初始化并冻结。每个 $t>1$ 的任务开始时,从这个单 token 提示尝试生成 300 条完整问答序列,丢弃空输出。不提供旧问题或任务编号;“无条件”指不以具体旧样本或 task ID 为条件。
生成使用 $\tau_G=1.5$、top-$p=0.9$、最多 384 个新 token。每个当前 minibatch 配一个回放 minibatch;回放迭代器耗尽后重新打乱循环。任务结束后不把这些样本带入后续训练。
回放不是将采样 token 一律当作正确答案,而是对同一生成前缀比较教师和学生的全词表分布:
$m$ 为序列、$\ell$ 为预测位置,$a$ 屏蔽 seed 和 padding,$h,\bar h$ 是学生/教师 logits,$\tau_D=2$。生成温度 $\tau_G$ 与蒸馏温度 $\tau_D$ 作用不同:前者决定采样覆盖,后者决定输出分布平滑度。(Appendix B.3, pp.21–23。)
直觉上,教师生成的旧知识“练习题”使学生更新时仍接触旧分布。但教师遗忘的内容未必能再生成;这种机制不能提供永久保存的保证。
4. 函数锚:在当前数据上保持旧函数
函数锚 SD(self-distillation)同样使用上一模型的前向 KL,但输入是当前任务的完整序列,温度 $\tau_F=5$,权重 $\lambda_F=1$。它与回放的区别主要是约束在哪种输入分布上施加,而不是“一个用 KL、另一个不用”。二者可共享教师。(Appendix B.4, p.24。)
教学解释:学习新实体时,SD 让模型在当前语言环境中不过度偏离旧输出;Replay 则主动提供更接近旧任务的输入。SD 也可能牵制新学习,因此其收益应由实验判断。
5. 权重锚:保护重要坐标,必须留意坐标是否仍有同样含义
SI 追踪的是可训练 LoRA 因子的标量坐标 $\vartheta_i$,并非直接估计全部稠密模型参数的重要度:
$g$ 是拟合损失梯度,$\Delta$ 是该任务的净位移,$\xi=0.1$。SI 大致问“这个坐标沿优化路径帮损失下降了多少”,并将负贡献截为零。参考点取最新任务结束值,重要度累积,因此状态量不随任务数增长。O-LoRA 的 SI 实现例外地只记录加权当前数据损失梯度,其他规则用含回放的拟合损失。(Appendix B.5, pp.24–27。)
online EWC 用逐样本损失梯度平方估计对角 Fisher,先按第一任务的均值尺度归一化,再以 $\gamma=1$ 累积。它需额外反向计算,权重为 1000;它参与搜索和额外基线,但不进入主因子实验的二元 SI 因子。
坐标风险:merged LoRA 会重建 $A,B$,然而 SI/EWC 将旧重要度与旧参考值按同名同位置直接赋给新坐标,没有执行使函数含义一致的变换。若有坐标映射 $f$,局部二次型一般需 $H_{\rm new}=J^\top H_{\rm old}J$,且往往不再对角。本文实现没有这样的映射。(Appendix B.5.4, pp.27–28。)因此 Symbol-QA 中 SI×Merge 的负交互与该风险相符,但不能仅凭这点证明它就是唯一原因。
6. 更新保存在哪里:shared 与 merged LoRA
设 $W_0\in\mathbb R^{d_{out}\times d_{in}}$,$A_t\in\mathbb R^{r\times d_{in}}$、$B_t\in\mathbb R^{d_{out}\times r}$,$\rho=\alpha/r$:
shared 始终优化同一组因子,相对基座的累计更新秩最多为 $r$。merged 每任务结束后把更新写入稠密矩阵,再以 Kaiming 初始化 $A$、$B=0$ 新建工作空间;新适配器最初不改变模型函数。累计更新秩最多可到 $\min(tr,d_{in},d_{out})$,这是容量上的区别,不是不同任务一定正交或互不干扰的保证。两者每任务都重启优化器,因此该比较不只是“是否重启 Adam”。(Sec.3.3;Appendix B.6, pp.28–31。)
O-LoRA 冻结并保留过去各任务因子,对新旧 $A$ 的重叠施加逐元素 $\ell_1$ 惩罚;状态为 $O(T)$。sequential OSRM 保存过去各任务的层输入均值,用最小右奇异方向初始化新 $A$ 后继续合并,状态也随任务数增长;它是对原 OSRM 的顺序化改编,不能将结果概括为原始 OSRM 一般无效。
三:实验
1. 数据与新颖性控制
| 数据集 | 任务×每任务样本 | 构造 | 解释边界 |
|---|---|---|---|
| Symbol-QA | 100×100 | 62 字符表中随机 6 字符键、4 字符值;键全局唯一 | 几乎无法从键推导值,检验任意关联记忆 |
| LLM-QA | 100×100 | Qwen3-4B-Instruct-2507 生成 100 个虚构主题;实体、问题去重;答案≤8词 | 没有外部验证全部虚构,也未证明基座全部未知 |
| Real-QA | 100×50 | 10 个公开 QA 来源各选500条,过滤基座五次采样中答对的项,再混洗分任务 | 五次未答对不等于预训练从未包含;每任务是混合样本,不保证来源数严格均衡 |
Real-QA 来源:TriviaQA、NQ-Open、PopQA、SQuAD、WebQuestions、OpenBookQA、SciQ、ARC-Easy、ARC-Challenge、MedMCQA。选择题移除选项,要求生成答案文本;存在别名时接受多个答案。合成数据显式做全局唯一性检查,Real-QA 的跨源重复检查在构造描述中没有同等清楚交代。(Sec.4.2;Appendix C, pp.33–35。)
2. 训练与比较条件
基座是 Qwen3-4B-Base,不是生成 LLM-QA 用的 Instruct 版本。每任务 10 epochs,batch 8,梯度累积 1,最大序列长384;AdamW 学习率 $5\times10^{-4}$,weight decay 0.01,梯度范数裁剪1,任务内前5%步 warmup 后恒定学习率。LoRA rank32、alpha64、dropout0.05,作用于 q/k/v/o 和 gate/up/down 七类投影。回放权重依 Symbol/LLM/Real 顺序为 0.75/0.5/0.75。(Table 3, p.32。)
最终每数据集评估21种方法,每种3个训练种子。16种主组合是 SI、SD、Replay、Merge 四因子的全开关;Merge 关闭意味着 shared LoRA。其余包括 online EWC、O-LoRA、sequential OSRM 及匹配的组合替换。naive baseline 是没有锚的 shared LoRA 顺序微调,不能把它描述为全参数 SFT。
3. 指标:当前学会与日后记住分别测量
令 $M_{i,j}$ 为完成任务 $i$ 后,在任务 $j\le i$ 的训练问答上答对的比例。每次只给问题,不给答案;评估集与训练集的样本相同,答案匹配遵循数据集规则。
Final、Diag 越高越好;Forget 越低越好。Forget 对比的是任务曾达到的最高值,并排除最后一项,不能直接以 $100-\mathrm{Final}$ 代替。附录 $W(k)$ 是最后 checkpoint 在最近 $k$ 个任务上的平均准确率,不能把它当作全历史表现。(Eqs.(7)–(8), pp.6–7。)
4. 搜索:给有前景的组合更多任务预算
TSH 候选数为 $3\times3\times5\times2=90$:权重锚空/EWC/SI;函数锚空或两种权重;回放空或四种温度—权重组合;shared/merged 两种分配方式。按3种训练种子的平均 Final 排名,依次在10/20/50/100任务运行90/45/23/10个配置,晋级后从 checkpoint 续训。
每种子每数据集训练量 $90(10)+45(10)+23(30)+10(50)=2540$ 个“配置×任务”,相对穷举9000减少71.8%。这是训练任务数预算,不是实测 GPU 时间节省,不同机制每任务成本不相同,亦未计入完整的生成和评估开销。(Appendix D.1, p.36。)
搜索顺序用 seed1234 的排列,报告时用独立的默认顺序从基座重训。最初10任务排名与最终100任务排名的 Spearman 为0.93/0.95/0.90,但只覆盖17种可比较组成,并取搜索中该组成最好的超参变体。早淘汰仍可能错过晚期优胜者;后三阶段候选池变化,不能把 Fig.2 的百分位变化理解为准确率增长。
四:结果
1. Sec.5.1:组合显著优于主比较中的单模块
| 方法 | Symbol-QA Final % | LLM-QA Final % | Real-QA Final % |
|---|---|---|---|
| Naive(shared,无锚) | 1.0±0.1 | 1.4±0.0 | 1.3±0.2 |
| Replay | 4.2±0.9 | 7.5±2.7 | 12.5±1.4 |
| Merge | 1.7±0.1 | 3.0±0.3 | 4.0±0.4 |
| Replay + Merge | 16.6±5.8 | 32.4±8.9 | 48.2±2.8 |
| SI + Replay + Merge | 15.7±3.3 | 41.2±9.5 | 54.8±10.4 |
| SD + Replay + Merge | 23.2±4.2 | 33.0±1.8 | 39.0±1.9 |
| 全锚 + Merge | 18.5±2.8 | 41.8±1.4 | 44.3±8.7 |
数值为三个训练种子的均值±标准差,不是置信区间。来源:Fig.3, p.9;Tables 8–10, pp.40–41。粗体是主16组合内每数据集最高均值,不代表逐对显著胜出。
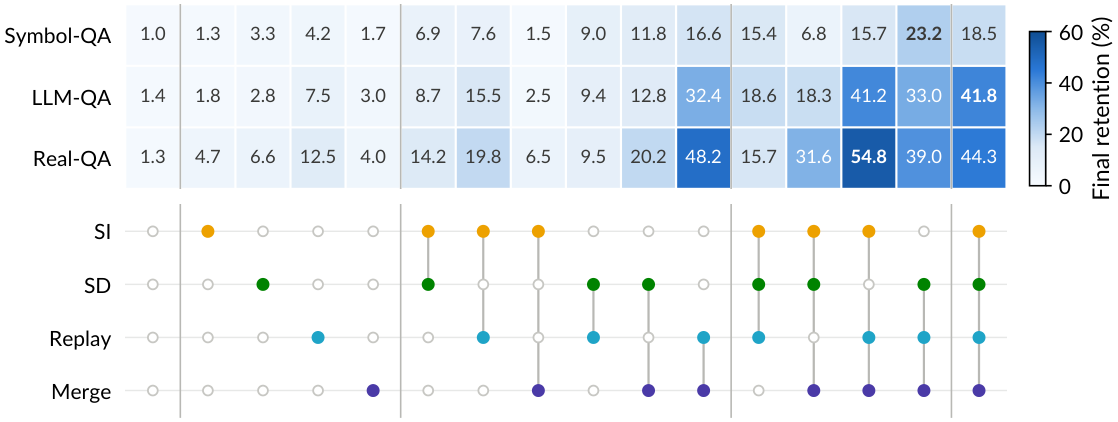
原图 Fig.3, p.9:上方每行一个数据集,每列一种组合,颜色越深 Final 越高;下方实心标记说明启用哪个因子。读列时先辨认机制,再比较同一数据集内的数值。它显示加入所有模块并非总能继续提高结果。
全锚组合均值 $(18.5+41.8+44.3)/3\approx34.9\%$,主比较最佳单模块 Replay 平均约8.1%。作者报告相对 naive 约28倍。按表中逐数据集的一位小数计算约28.3倍,而直接用摘要舍入的 $34.9/1.2$ 会得到29.1;这是舍入精度问题。更直观的差异是约33.6个百分点。另一个重要边界:Real-QA 的独立 O-LoRA 为13.9%,超过Replay的12.5%;正文“最强单机制12.5%”应限定在主因子/固定状态比较。
全锚组合在主16组合的名次为2/1/3;把额外 O-LoRA 组合纳入后,Real-QA 全锚会排到第4。作者的“best method”主要强调跨数据集最差名次这一稳健口径,也不等于最高跨数据集平均分:SI+Replay+Merge 从表中可算出约37.2%,高于34.9%。
2. Sec.5.2:记忆半衰期延长,老记忆仍持续衰减
记忆年龄 $a=i-j$ 为学完该任务后又学习了多少任务。$R(a)$ 平均所有满足该年龄的 $M_{i,j}$;半衰期是首次低于 $R(0)/2$ 的年龄。它按任务数计,不是训练小时。
| 方法范围 | Symbol | LLM | Real |
|---|---|---|---|
| Naive | 1 | 1 | 2 |
| 主比较最佳单模块 | 4 | 6 | 11 |
| 全锚 + Merge | 19 | 32 | 32 |
| 每数据集最佳组合 | 19 | 32 | 44 |
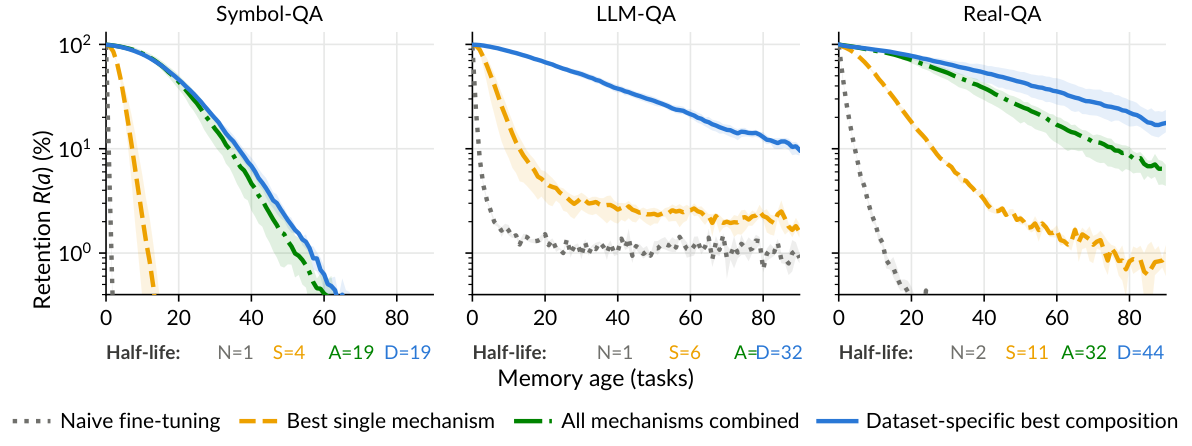
原图 Fig.1, p.2;解释见Sec.5.2, p.10。横轴为年龄,纵轴保持率采用对数刻度;灰/黄/绿/蓝分别为naive、最佳单机制、全组合、数据集特定组合。实线为3种子均值,阴影是min–max而非95%置信区间。半衰期相同不表示整条曲线或最终保持率相同。大年龄只包含更少的任务—checkpoint配对,本次分析认为这也应影响对曲线末端稳定性的判断。
3. Sec.5.3:Replay × Merge 的协同是核心证据
| 效应(百分点) | Symbol | LLM | Real |
|---|---|---|---|
| Replay 主效应 | +9.5 | +18.5 | +19.3 |
| Merge 主效应 | +5.9 | +14.9 | +20.5 |
| SI 主效应 | +0.3 | +5.8 | +6.3 |
| SD 主效应 | +5.7 | +5.0 | +3.7 |
| Replay×Merge | +3.6 | +9.4 | +11.7 |
| SD×Replay | −0.2 | −3.5 | −10.3 |
| SI×Merge | −3.0 | −0.1 | +0.2 |
来源Table 1, p.10;完整统计Tables 11–13, pp.42–43。Replay×Merge三项均 $p<10^{-4}$。每数据集16格×3种子,共48次观测;残差自由度32。主效应是对其余因子取平均后的开关差值,并非从naive单独增加模块的收益。
直接固定 SI=SD=off 更易看懂协同:Symbol 中 Replay 单独提高3.2点,Merge提高0.7点,两者单独收益之和3.9点;组合却提高15.6点。LLM 对应7.7对31.0点,Real对应13.9对46.9点。这些条件切片的超加性差值不同于表中的全因子交互效应,不应把两种数值混用。
SD虽然平均主效应为正,但在已有Replay时,对自然语言数据的平均帮助变小;Real中加在SI+Replay+Merge之上反而从54.8降到44.3。Symbol的SI×Merge为显著负值,符合坐标重置风险;该机制解释未通过专门修复坐标的干预实验证实。显著性基于3个训练种子,不能代替多任务顺序、多模型的外部验证。
4. 附录诊断:时间矩阵、状态增长和通用能力
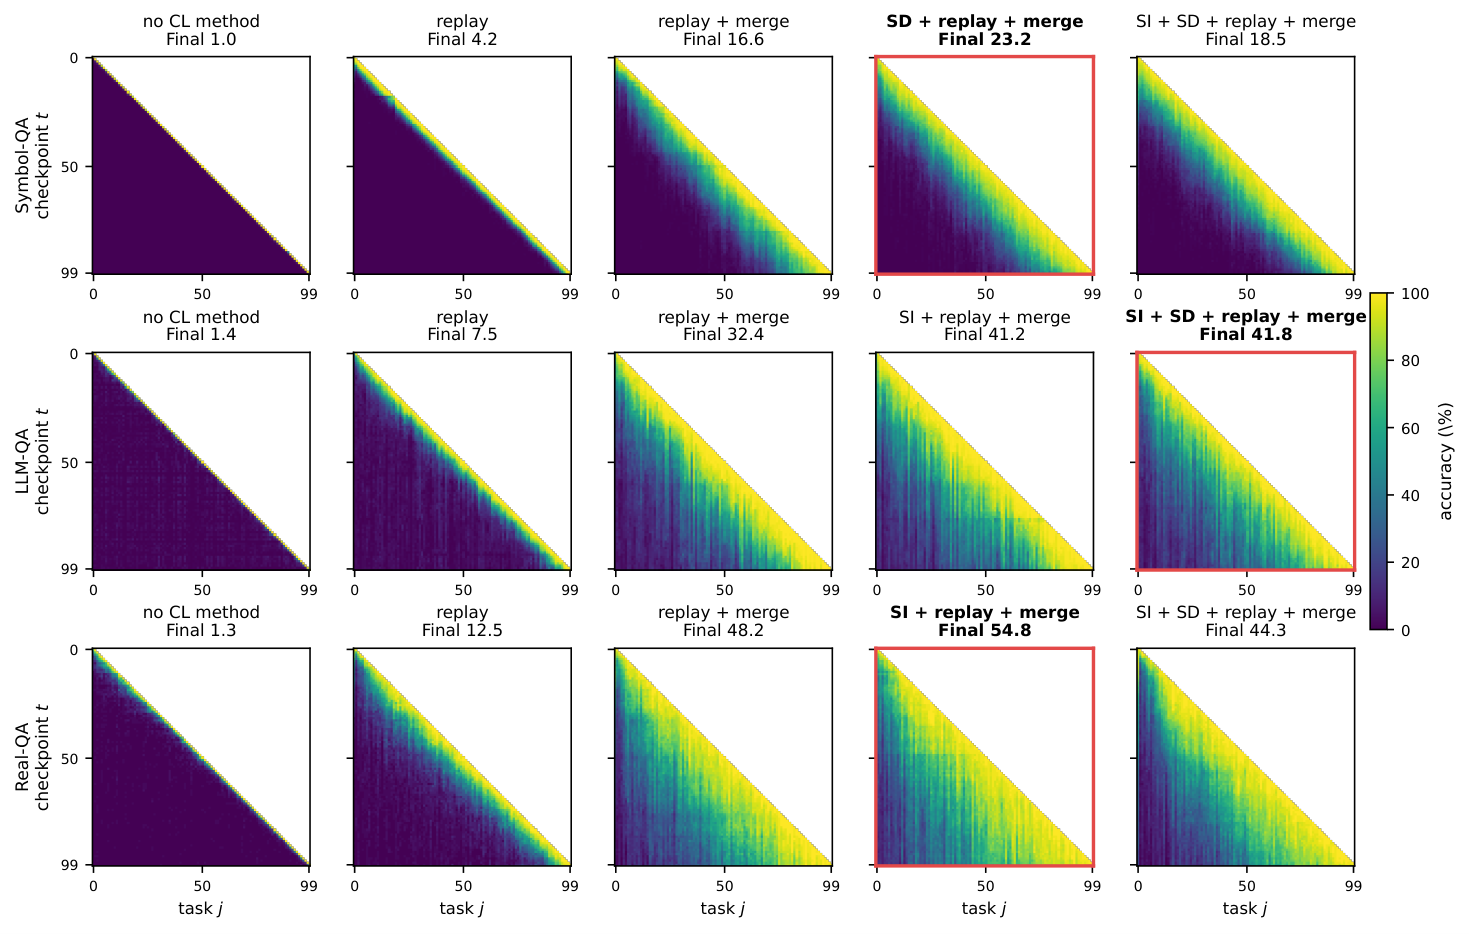
原图 Fig.5, p.44。横轴是被评估任务 $j$,纵轴是训练checkpoint $i$;只显示下三角。亮对角说明当前任务能学会,往下仍亮才说明旧任务保持好。组合把亮带拓宽,但没有让整个下三角都保持高亮。图中展示三个种子的中位种子,不是最优seed;每列是独立训练的组合,不能理解为一条训练轨迹中途加模块。Fig.4的贪心构造路径也只是独立配置的比较摘要。
替换分配规则时固定TSH所选锚:Symbol用全锚,LLM/Real用SI+Replay。相对匹配的merged组合,O-LoRA的Final变化为−3.3/+1.0/+1.6点,sequential OSRM为−0.8/−11.5/−11.6点。O-LoRA在自然语言任务上最高均值为42.2/56.4%,比主16组合最佳仅高0.4/1.6点,差异处于seed波动范围。任务增长状态未提供一致的记忆优势。(Table 14, p.45。)
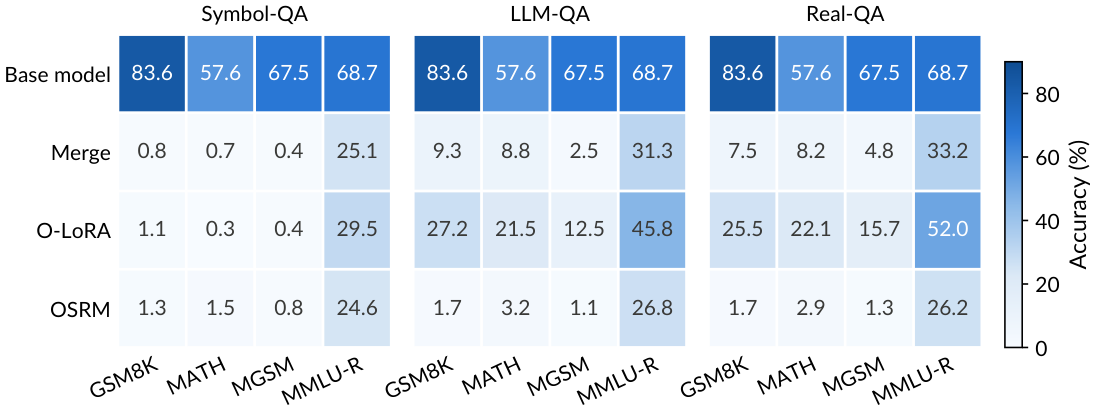
原图 Fig.6, p.46;解释pp.46–47。每个数据块的列为GSM8K、MATH、MGSM、MMLU-Redux,行是原始基座与三种带匹配锚的分配规则。基座四基准平均69.4%;在LLM-QA/Real-QA训练后,merged组合降为13.0/13.4%,O-LoRA为26.8/28.8%,OSRM为8.2/8.0%。O-LoRA较好,却仍损失超过40个百分点。这里的自然语言组合不含SD,不能把数字直接当作“全锚组合的通用能力”。
MMLU-Redux用答案字母的next-token概率打分,不依赖模型能否生成合法字母;因此整体能力下降不能全归咎于输出格式错误。O-LoRA摘掉全部适配器可恢复原模型,但也去掉了新学知识;这与“新记忆激活时仍保持原能力”是两个目标。
5. 较弱证据与原文不一致之处
- 学习失败段落:E.7(p.45)将
si_sd_merge和online_ewc都称为与fold组合的权重锚失败,但方法定义的独立online EWC使用shared LoRA,并非merged。该段还称其他配置Diag都在96–100%,而Table 9(p.41)的LLM online EWC是89.2±0.2、SI是95.3±0.1。因此应以逐配置表为准,不把该段机制归因当作已确认事实。 - 温度对照:E.8(pp.45–46)报告温度0.7为21.2±7.9、1.5为20.8±2.1,但此段未明确命名所测组合与数据集,也没有提供均值差检验细节。3种子下可描述均值接近、样本标准差不同;不能由此证明温度只影响方差而不影响期望,或由一次跨版本复现证明整个训练系统普遍确定。
- 搜索赢家变化:Symbol的全锚组合搜索/报告为23.4/18.5,而SD+Replay+Merge为22.4/23.2(E.10, p.47)。这是选择噪声的合理例子,但随机任务可交换不等于有限样本任务顺序没有作用;仅两个顺序不能分离所有噪声来源。“无偏估计”也需限定为既定配置与报告协议下的结果。
- 控制实验:E.11(p.47)报告Symbol前向迁移0.0±0.0,其他不足3.1点,且记忆任务的boxed格式输出率100%。后者适用于所测记忆评估,不能推广到通用能力benchmark,原文另报告其数学回答有训练格式重复。
五:结论
这篇论文最扎实的结论是:在Qwen3-4B-Base、固定预算、100任务、无原样本长期回放和无推理task ID的记忆协议中,生成式回放与merged LoRA组合比单独机制强很多。SI和SD是条件性增益,不能简单理解为模块越多越好。全因子设计比只报告一个最佳组合更有解释力。
证据边界包括:单一基座与规模;主要报告一种最终任务顺序的三个训练种子;评估复用训练问题;回放固定300条可能难覆盖长期增长的旧知识;状态不随任务数增长不等于显存/计算便宜;通用能力仍大幅退化。原文未给出足以精确比较各组合实际GPU成本的完整墙钟数据。
本次分析认为值得后续验证的方向是:在相同生成与训练计算预算下比较回放覆盖策略;在稠密更新空间或经过校准的坐标上施加重要度约束;同时用原问、改写问和通用能力形成多目标评估;跨多个任务顺序与基座复验Replay×Merge。上述是研究建议,未被本论文实验验证。
组会可用一句话收束:组合改变了遗忘的时间尺度,但尚未建立可靠、可泛化且不损伤原能力的长期参数记忆。