Trace as State:将推理轨迹作为条件状态的中文精读笔记
论文:Trace as State: Reasoning Traces as Conditional States for Long-Context Transformers
作者:Xu Zou(Z.ai)、Jie Tang(Tsinghua University)
版本:arXiv:2609.02702v1,提交于 2026-09-02;本次获取与研读日期:2026-09-30。
材料:arXiv 摘要页 · 原文 PDF · 作者主 TeX · 英文汇报 PDF · 可编辑幻灯片。
本次阅读以同版本作者 TeX 为正文、公式和表格依据,以 21 页 PDF 核验题名、最终内容、图表和页码。已阅读主文件实际引用的全部正文章节与附录 A–F,包括证明、评分细节、提示模板、难度分层、置信区间和 token 用量;查看了图 1–6。未运行作者实验,也未独立核验其引用论文或在线模型服务。以下页码均为从 1 开始的 PDF 页码,与本版印刷页码一致。图件复用作者原始矢量图,PNG 为其渲染版,出处记录在 图件清单。
论文总览
一句话要点:在新一轮推理中,把前一轮得到的推理轨迹放到长上下文之前,能让这些线索参与上下文的重新编码;在所测长上下文任务中,这通常比把同一份轨迹放到上下文之后更有效。
论文把三个层次连接起来:
- 理论动机:对于确定性、精确、单遍的条件状态更新任务,先知道初始条件,只需追踪一条实际状态路径;最后才知道条件,最坏情况下要保留整个“初始条件到最终结果”的函数。两者的持久状态位数可相差指数级。
- 推理方法:冻结模型,收集其先前生成的推理轨迹,序列化成文本状态代理 $T$,再输入 $[T,x,q]$。$x$ 是长上下文,$q$ 是末尾问题。不更新模型参数,不改变单次前向的因果掩码。
- 实证检验:核心对照 Trace Append 使用同一个模型、同一个 $x$、同一份 $T$,但输入 $[x,T,q]$。论文报告 27 个模型—任务—指标组合中,Trace as State 的均值有 26 个更高;其中 GraphWalks 与 MRCR 的 24 个配对比较中,20 个未校正 95% 区间完全高于零。
最醒目的结果是 DeepSeek V4 Pro Preview 在 GraphWalks Parents 上,EM 从首轮 29.2%、轨迹后置 43.0%,提升到轨迹前置 81.8%。这里相对后置是 +38.8 个百分点,相对首轮是 +52.6 个百分点。这支持“反馈出现的位置很重要”,但不等于证明真实 Transformer 节省了指数级显存,也不代表所有任务都获得显著提升。(Sec. 3–4;Table 2, p. 7;Table 5, p. 18。)
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与证据 |
|---|---|---|
| Abstract;1 Introduction | 输入顺序与推理顺序不一致的问题 | pp. 1–2;Fig. 1 在 p. 3 |
| 2 Related Work | 长上下文、因果顺序、架构循环、文本反馈的相关工作 | pp. 2–3 |
| 3.1 Causal State Updates and Order-Dependent Memory | 定义状态更新与最坏情况内存分离 | pp. 3–4;Eq. (1)–(2) |
| 3.2 Reasoning Traces as a Textual State Proxy | 区分真实状态与文本代理,定义轨迹序列化 | p. 4;Eq. (3)–(4) |
| 3.3 Trace as state. | 同一轨迹的前置与后置对照 | p. 5;Eq. (5) |
| 4.1 Setup | 模型、预算、数据、重复与评分规则 | pp. 5–6;Tables 1-1、1-2 |
| 4.2 Main Results | 三模型、三类任务的主结果 | p. 6;Table 2 在 p. 7 |
| 4.3 Context Order Ablations | 问题、答案、随机轨迹、重复上下文等控制 | pp. 6–7;Table 3 在 p. 8 |
| 4.4 Trace Count Ablation | 复用 1–5 条轨迹的收益 | pp. 7–8;Fig. 2 在 p. 8 |
| 5 Conclusion;Limitations | 跨轮状态反馈的意义与适用边界 | pp. 8–9 |
| A Attaining the Worst-Case Residual-Map Count | 残余映射计数、可达构造、精确下界的条件 | pp. 12–13 |
| B Scoring and Run Qualifications | 解析失败、截断、过滤、模型裁判 | p. 13 |
| C Prompt and State Templates | 序列化、版本及实际插入位置 | pp. 13–14;Table 4 在 p. 14 |
| D GraphWalks Difficulty Profiles | 事后难度分层,描述收益异质性 | pp. 14–18;Eq. (6)、Figs. 3–4 |
| E Confidence Intervals | 配对差值与按题 bootstrap | pp. 18–20;Table 5、Figs. 5–6 |
| F Token Usage | provider 返回的输入、缓存与输出 token | pp. 20–21;Table 6 |
参考文献位于 pp. 10–11;本笔记保留原文不规则的表号,如 Table 1-1 和 Table 1-2。
一:动机
1.1 可以看到全部上下文,不等于此前表示能受后来信息影响
因果 Transformer 在编码前面的 token 时不能使用后面的内容。后来产生的推理仍可以读取此前缓存,并影响后续输出;受限的是已经形成的上下文表示不能在同一遍中被后来的线索反向更新。
在长图遍历中,重要状态可能是当前搜索前沿;在多轮对话检索中,是最终请求实际指向的那次对话;在小说阅读中,是后来才解析清楚的指代或关系。任务相关状态有时是在阅读及推理之后才变得明确。此时,把状态移到下一遍开头,可以改变重新阅读时的信息处理条件。(Sec. 1,pp. 1–2;Sec. 3.2,p. 4。)
1.2 论文真正要隔离的是反馈时机
仅比较“首轮回答”与“多轮回答”,无法判断收益来自更多计算、更多线索,还是线索在输入中的位置。Trace Append 因此很关键:它同样获得原始上下文、五条首轮轨迹和新一轮推理,只把轨迹放在后面。
这个控制支持对整体位置干预的判断。它仍不能单独证明收益完全由某一种内部状态机制产生,因为位置变化也会改变上下文化、注意力分配和输入距离等因素。作者将理论作为定性动机,而不是把真实任务等同于其最坏情况构造。(Sec. 3.2–3.3,pp. 4–5。)
1.3 与既有思路的关系
按论文 Sec. 2 的讨论,重复输入、文本反馈、循环网络深度和扩散式重构都能帮助模型重新处理信息。这里的区别在于:通过现有文本接口,将先前生成的任务相关信息移到上下文之前,在每一遍仍保持因果处理。本文没有训练新的循环模块,也没有报告对内部隐状态的直接干预。下文对 Re2 的解释以本文 Table 3 实际使用的 $[x,q,x,q]$ 为准;不把该实验配置推广成对原始 Re2 方法的完整定义。
二:方法与理论
2.1 符号与输入输出
| 符号 | 含义 |
|---|---|
| $C=(c_1,\ldots,c_n)$ | 理论中的有序信息单元序列 |
| $\mathcal S$、$s_i$ | 有限任务状态空间、处理第 $i$ 个单元后的状态 |
| $U$、$z=s_0$ | 固定更新规则、由任务条件指定的初始状态 |
| $b=\log_2\lvert\mathcal S\rvert$ | 状态空间大小的对数,单位为 bit;不是模型隐藏维度 |
| $\phi_C$、$\mathcal K$ | 序列诱导的残余映射、不同残余映射的个数 |
| $x,q,\mathcal M$ | 实验中的长上下文、末尾问题、冻结的模型 |
| $r_j,a_j,n_{\mathrm{tr}}$ | 第 $j$ 次源运行的推理轨迹、独立返回的可见答案、轨迹条数 |
| $\pi,T$ | 固定序列化器、序列化后的轨迹块 |
注意:理论中的 $z$ 与文本块 $T$ 不是同一个数学对象。$T$ 可能不完整、有损或错误;论文不把它当作模型内部状态的忠实读出。(Table 1, p. 4;App. A, p. 12。)
2.2 条件先到:只跟踪实际发生的一条路径
原文 Eq. (1) 定义
若输入顺序为 $[z,C]$,处理器在读 $C$ 前就知道初态。假设已知 $U$,每一步只需保留当前 $s_i$,所以一个 $\mathcal S$ 值寄存器足够,即 $\lceil b\rceil$ bit。这里统计的是持久的、依赖输入的工作状态,而不是固定转移规则本身的描述长度。
2.3 条件后到:需要区分所有可能的响应函数
对于给定序列 $C$,定义
$\phi_C$ 表示“如果初态是 $z$,读完整个 $C$ 会得到什么”。当输入为 $[C,z]$ 且不能重读 $C$ 时,读完 $C$ 的处理器必须保留足够信息,以便稍后回答任意 $z$。
证明关键是可区分性:若两条序列对应不同的函数 $f,g$,却在读完后进入同一个内部配置,总存在某个 $z$ 使 $f(z)\ne g(z)$。之后读取相同 $z$,确定性处理器只能给出相同结果,与对全部输入精确求解矛盾。因此一般下界是 $\lceil\log_2\mathcal K\rceil$ bit。
设 $m=|\mathcal S|$。所有自映射共有 $m^m$ 个。附录 A 构造 $n=1$、输入字母表 $\mathcal C=\{c_f:f\in\mathcal S^{\mathcal S}\}$,并令 $U(s,c_f)=f(s)$,使每个自映射都可由一个输入单元实现。于是原文 Eq. (2) 的最坏情况达到
与条件先到的 $\lceil b\rceil$ bit 相比,关于 $b$ 呈指数级分离。原文给出的检查例子是 $m=4$:有 $4^4=256$ 个函数,条件后到需要 8 bit,先到只需 2 bit。(Sec. 3.1,pp. 3–4;App. A,p. 12。)
2.4 理论的适用边界
这是一项存在性、最坏情况结果,条件包括确定性、所有输入上精确、只读一遍,以及把辅助可写存储全部计入配置。构造允许一个信息单元表示任意状态自映射,固定更新表也不计入输入依赖的工作状态。受限更新族可使 $\mathcal K$ 远小于 $m^m$;允许误差、随机化或重读也不直接受此证明约束。
有限上下文、有限精度的因果 Transformer,可以把位置、各层 KV cache 和其他持久缓冲一起视为有限工作状态。但“属于该抽象”并不能推出实际图任务实现了全部残余映射,更不能推出前置轨迹会把实际 GPU 显存从指数级降到线性。论文没有测量这种内存节省。(App. A,pp. 12–13;本段最后两句为本次分析。)
2.5 从抽象状态到实际文本反馈
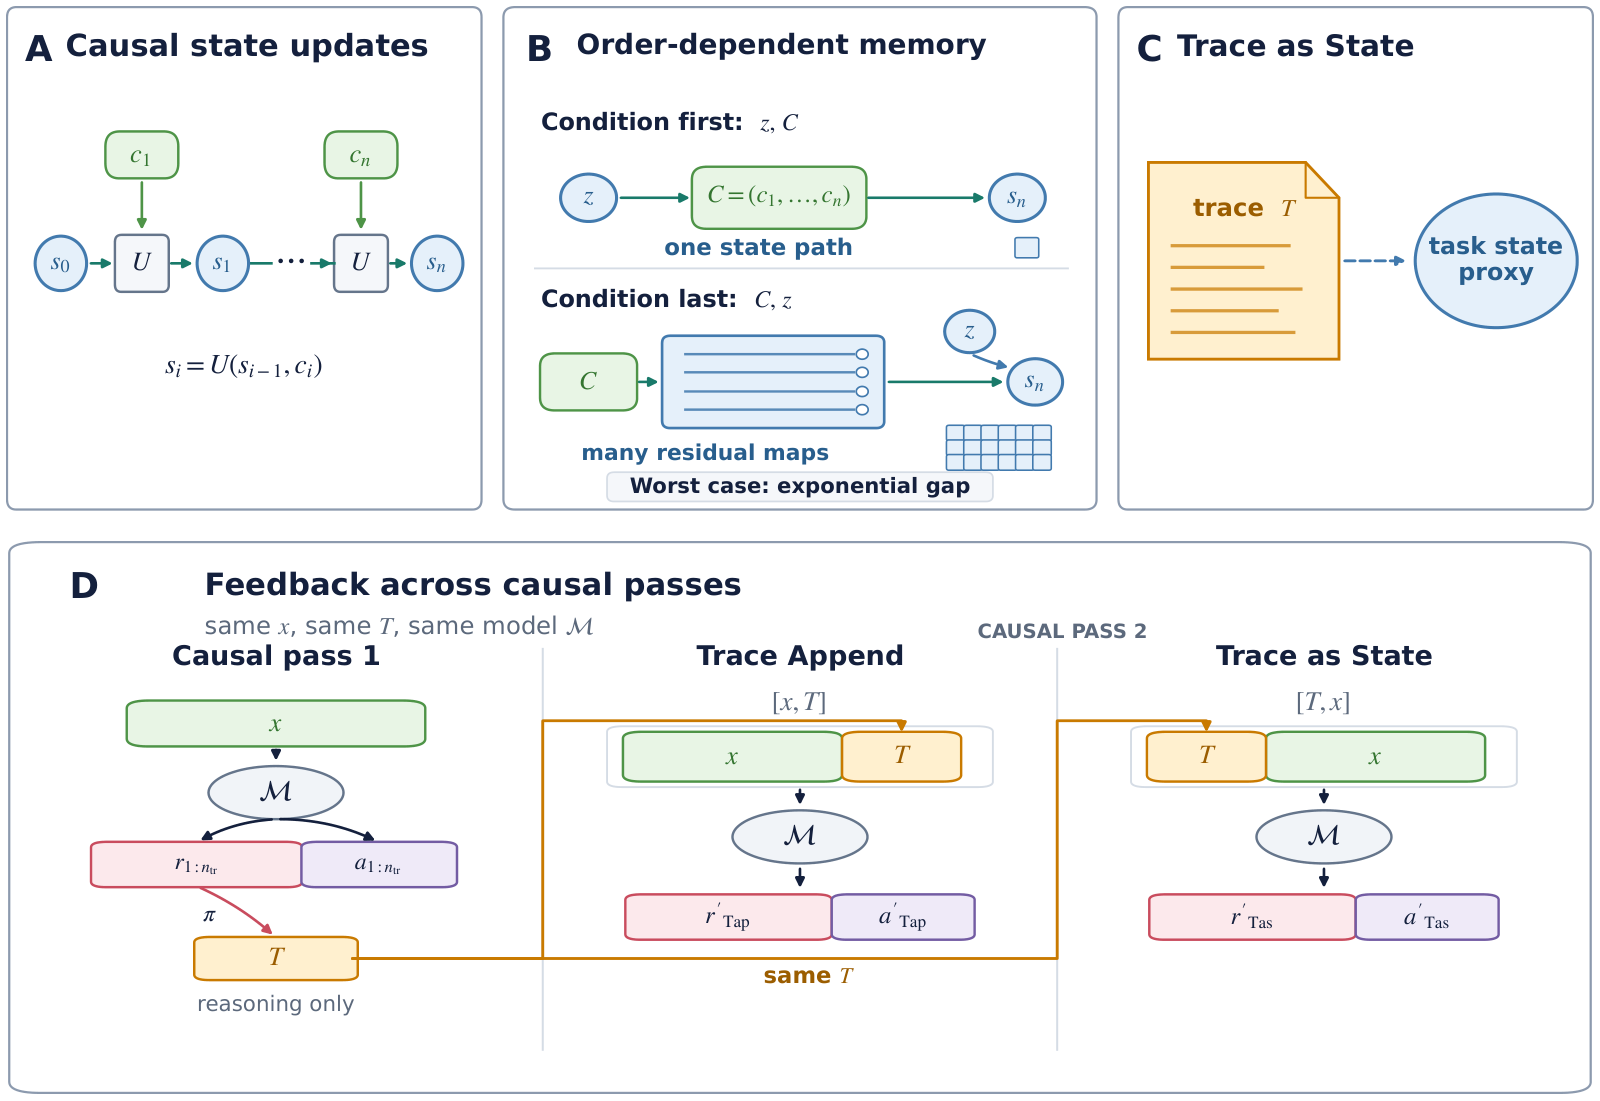
来源:原文 Fig. 1,p. 3,作者原始图。按 A→B→C→D 阅读:A 是单条状态递推;B 比较初态先到与后到;C 明确轨迹只是状态代理;D 用同一份 $T$ 比较前置和后置。图中为简写 $[T,x]$ 与 $[x,T]$,实验还保留末尾问题 $q$。
原文 Eq. (3)–(5) 的流程如下;这里展开实验中的 $q$:
输出是新一轮答案 $a'$。模型没有继续使用先前的会话隐状态,而是发起新的推理调用,用文本显式传递信息。前置 $T$ 时,重新处理 $x$ 的表示可以受 $T$ 影响;后置时,$T$ 仍可影响后续推理与答案,但不能改写本轮先前已编码的 $x$。(Sec. 3.3,p. 5;Sec. 4.1,pp. 5–6。)
2.6 序列化与实际输入边界
主实验使用五次独立首轮运行的推理字段,按 repeat-index 顺序放入 $T$,添加任务说明、错误提示、编号和固定边界。单条轨迹若超过 50,000 个字符,保留其前 50,000 字符并添加省略号;不是 50,000 token,也不是取最后一段。独立返回的答案字段 $a_j$ 不放入 $T$,但推理轨迹自身仍可能包含答案相关信息,不能据此宣称 $T$ 不含任何答案线索。
GraphWalks 前置条件把完整 $T$ 放在发布的任务提示之前;后置条件在最后一个 Operation: 块之前插入同一 $T$。最终操作与答案格式要求始终在末尾。固定提示要求模型将轨迹当作可能有错的草稿,并回到原图核验。原文 GraphWalks 提示措辞提到 “trace tail windows”,但具体实现说明明确采用前缀截断;本笔记按实现说明解释。(App. C,pp. 13–14。)
以下是教学伪代码,不是已执行的复现代码:
source = [fresh_call(model, context=x, question=q) for j in 1..5]
traces = [truncate_to_first_50000_characters(run.reasoning) for run in source]
T = fixed_serializer(traces)

for placement in [before_context, after_context]:
    prompt = [T, x, q] if placement == before_context else [x, T, q]
    evaluate(five_fresh_calls(model, prompt), with_invalid_outputs_scored_zero)
2.7 一个直观例子
教学解释,非原文实验样例:一长串有向边里,需要找目标节点 $v$ 的父节点。首轮轨迹指出“可能遗漏了指向 $v$ 的某条边”。把这条线索放在第二遍开头,会让模型在扫描边列表时就关注 $v$ 及遗漏候选。若轨迹在边列表之后,模型仍能利用缓存推理,但边列表在这一遍中的原始表示形成时没有这条线索。这个例子说明可能的功能,不证明模型内部确实执行了显式扫描器。
三:实验设计与评分
3.1 模型与预算
下表均为论文所报告的实验配置,不是对当前 API 的查询结果。(Tables 1-1、1-2,p. 6;App. C.2,pp. 13–14。)
| 模型 | 论文描述的架构 | 输入预算(token) | 输出预算(token) | 推理设置 |
|---|---|---|---|---|
| DeepSeek V4 Pro Preview | CSA + HCA + mHC | 1,048,576 | 131,072 | max |
| Qwen 3.7 Max | Gated DeltaNet + Gated Attention | 983,616 | 65,536 | 固定 xhigh 提示文本 |
| GLM-5.2 | DSA + IndexCache | 1,048,576 | 65,536 | max |
DeepSeek 使用作者注明的 2026-04-24 版本,不是同名的 2026-08-13 版本。Qwen 的 xhigh 不是 API 的 reasoning_effort 参数:MRCR 将该指令放在 system message,GraphWalks 和 NUB 放在单条 user message 开头。
必须区分“表中列出的输出预算”和“实际请求参数”:作者明确说没有传入自定义最大输出值,所以运行记录并不能确定当时真正生效的 provider 默认上限。不能把 65,536 / 131,072 写成已核实的逐次调用硬上限。
3.2 数据、样本和重复
| 任务 | 问题性质 | 评估范围与题数 | 指标,均为越高越好 |
|---|---|---|---|
| GraphWalks | 长边列表上的 BFS 和父节点集合问题 | 256K 档;BFS 100 题、Parents 100 题 | 集合 EM、集合 F1 |
| MRCRv2 8-needle | 将末尾请求绑定到正确的历史请求—回答实例 | 256K 100 题、512K 100 题 | 字符串 EM、SequenceMatcher ratio |
| NUB-1M | 长篇小说的细节理解 | Season 2,一部约 400–700K token 小说,20 题 | 模型裁判准确率 |
GraphWalks/MRCR 的每格 100 题由 Table 5 的配对统计说明核实;Table 1-2 则分别列出每个任务族总计 200 题。论文没有在这两个任务上评测 1M 档,原因是不同 tokenizer 可能超长且需为轨迹留出空间。“模型支持约 1M”不是“本文所有任务输入都为 1M”。
主实验首轮每题 5 次;五条源轨迹共同形成一个 $T$,再用于前置和后置的第二轮评估,每个条件也取 5 次均值。论文平均分反映的是重复采样后的期望表现,不是每题 best-of-5。若部署时复用五条轨迹并只要一个最终答案,流程需要 5 次源调用 + 1 次反馈调用;不能把“二阶段”误解为总共两次模型调用。(Sec. 4.1,pp. 5–6;Sec. 4.4,p. 7;App. E,p. 18。)
3.3 指标和失败如何进入分母
GraphWalks:从最终 Final Answer: [...] 行解析节点集合,与 gold set 比较。EM 要求集合完全一致;集合 F1 衡量交集相对于预测与参考的覆盖。作为指标解释,在非退化情形可写为 $2|P\cap G|/(|P|+|G|)$。两者都空时 EM=F1=1;仅一个为空时均为 0。缺失、格式错误或答案不是终止位置等情况计 0。
MRCR:预测必须以题目指定的随机前缀开始;验证并去除前缀后,计算字符串完全匹配和 Python difflib.SequenceMatcher 的 ratio。它不是 GraphWalks F1。前缀无效、回答缺失或内容过滤都记 0,保留在分母。
NUB:由 DeepSeek V4 Pro 将模型答案与人工维护的参考答案比较,返回布尔正确性。裁判提示不含 solver 身份和前后置标签;作者报告人工复核未发现错误。该结果仍是 20 道题上的模型裁判准确率,不能等同于大规模独立人工盲评。
超长、阻断、缺失、非正常终止及过滤输出均作为失败,这意味着分数同时反映推理能力与接口/格式完成率。(App. B,p. 13。)
四:结果与解释
4.1 主结果:GraphWalks Parents 的位置收益最大
下表每个数对均为 EM / F1(%),来自 Table 2,p. 7。
| 模型 | 子任务 | First Pass | Trace Append | Trace as State |
|---|---|---|---|---|
| DeepSeek | BFS | 31.6 / 36.4 | 41.8 / 48.3 | 58.8 / 65.9 |
| DeepSeek | Parents | 29.2 / 46.5 | 43.0 / 65.3 | 81.8 / 91.3 |
| Qwen | BFS | 60.0 / 68.1 | 60.4 / 70.4 | 63.8 / 71.7 |
| Qwen | Parents | 60.8 / 87.2 | 71.0 / 91.7 | 96.4 / 99.1 |
| GLM | BFS | 55.8 / 70.7 | 60.0 / 75.8 | 63.4 / 75.0 |
| GLM | Parents | 66.4 / 88.5 | 83.2 / 92.7 | 100.0 / 100.0 |
Parents 的前置减后置 EM 分别为 +38.8、+25.4、+16.8 个百分点。作者解释是该任务尤其依赖在解释图时维持父节点相关状态。实验支持位置干预的收益,但未直接观察或测量模型内部的父节点状态。
BFS 的收益更不均匀:Qwen 与 GLM 的 EM 都仅增加 3.4 个百分点;GLM 的 F1 反而下降 0.8 个百分点(由表中舍入值相减)。EM 更高、F1 略低并不矛盾:完全正确的题数与其他题的部分集合重合可以朝不同方向变化。
GLM Parents 的 100% 是该模型在这批 100 题、5 次重复记录上的结果,不是对任意图输入或更长上下文的保证。
4.2 MRCR 也受益,但最长档的部分比较不确定
下表每个数对为 EM / Seq.(%)。(Table 2,p. 7。)
| 模型 | 长度档 | First Pass | Trace Append | Trace as State |
|---|---|---|---|---|
| DeepSeek | 256K | 53.8 / 78.5 | 66.6 / 79.6 | 76.8 / 88.7 |
| DeepSeek | 512K | 45.4 / 63.6 | 49.4 / 66.9 | 52.6 / 73.3 |
| Qwen | 256K | 79.8 / 83.1 | 84.0 / 87.1 | 88.4 / 91.3 |
| Qwen | 512K | 36.2 / 43.7 | 40.4 / 47.4 | 46.8 / 52.5 |
| GLM | 256K | 40.2 / 48.2 | 40.0 / 58.3 | 61.2 / 71.9 |
| GLM | 512K | 42.6 / 52.0 | 44.6 / 59.9 | 55.4 / 70.1 |
前置在这里的全部均值上高于后置。GLM 256K 的 EM 增加 21.2 个百分点,说明轨迹后置甚至略低于首轮,并不妨碍前置产生较大收益。DeepSeek 512K 的 EM 只增加 3.2 个百分点,其配对区间跨零,因此应保留不确定性。
各档不是同一批题的受控长度扩展,不能把 256K 与 512K 分数的差直接当作“把上下文加长一倍”造成的纯因果影响。
4.3 NUB:文本反馈有帮助,额外前置收益较小
| 模型 | First Pass Acc. | Trace Append Acc. | Trace as State Acc. | 前置减后置 |
|---|---|---|---|---|
| DeepSeek | 60.0% | 71.0% | 73.0% | +2.0 pp |
| Qwen | 37.0% | 49.0% | 51.0% | +2.0 pp |
| GLM | 43.0% | 65.0% | 66.0% | +1.0 pp |
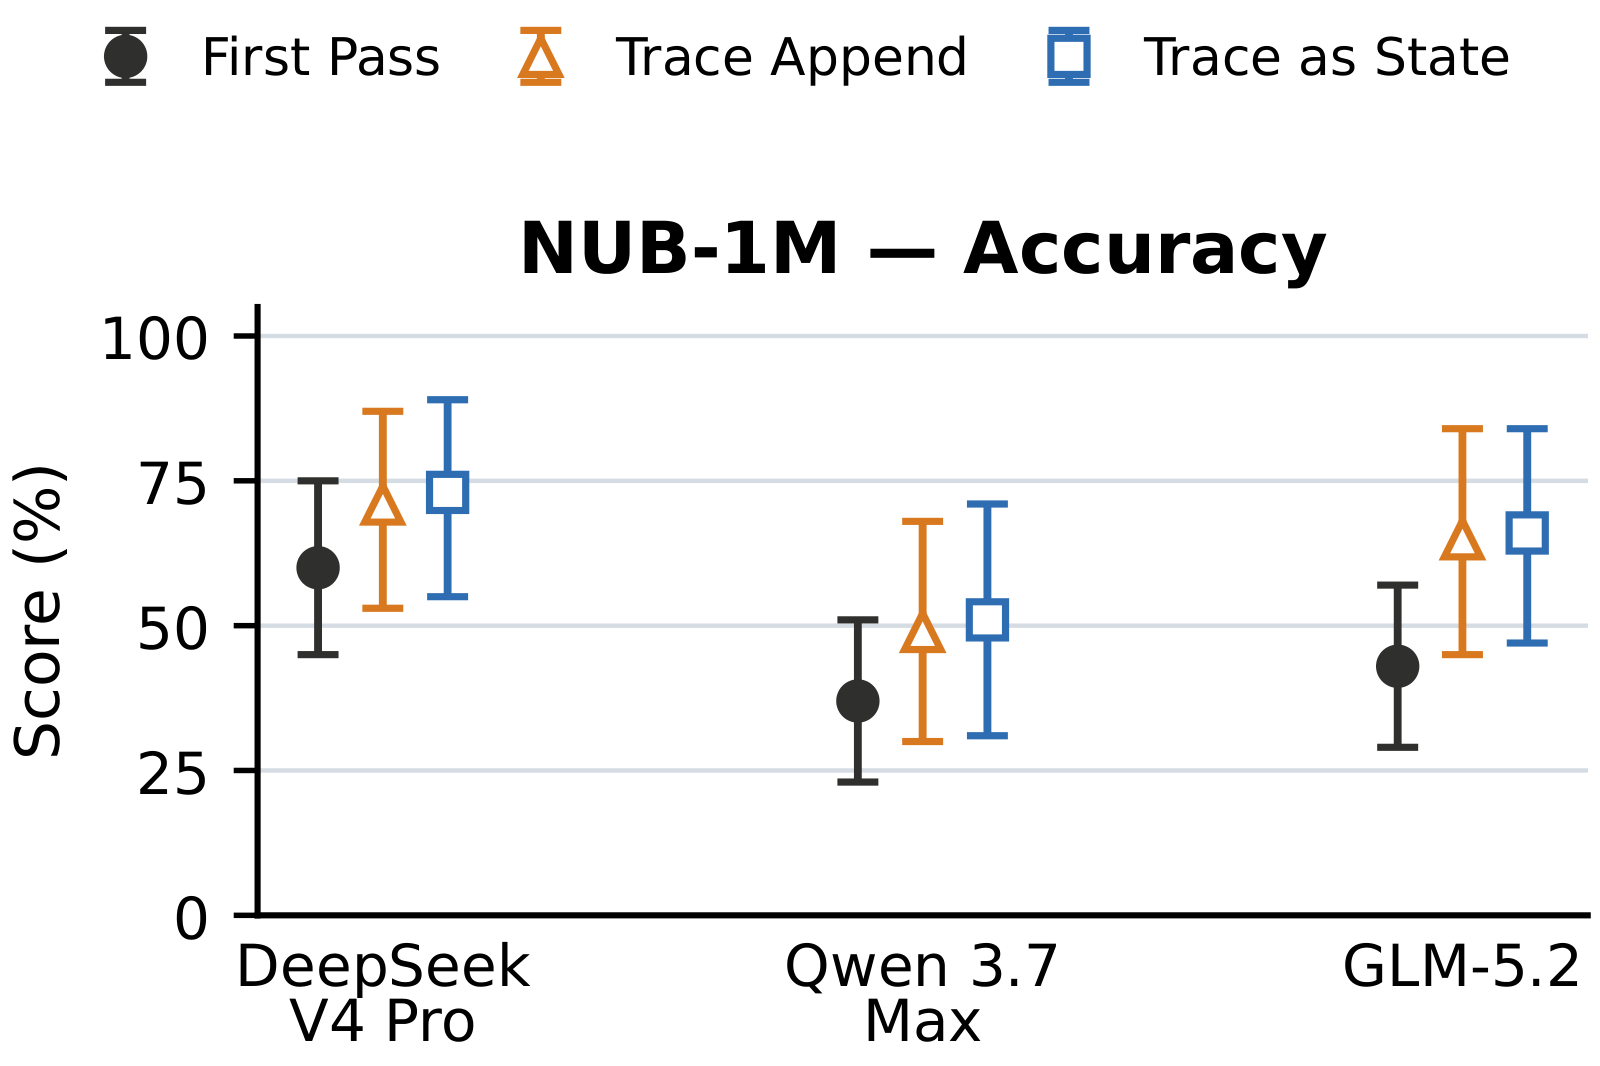
来源:Fig. 5,p. 19,NUB 原始面板。横轴是模型,纵轴为准确率;黑点为首轮、橙色为后置、蓝色为前置,误差棒是按题重采样的 95% 区间。相比首轮,反馈整体有明显均值提升;前置相对后置只多 1–2 个百分点。只有 20 题,区间较宽;Table 5 没有给出 NUB 的配对差值区间。因此它提供方向一致的补充证据,不能据此声称三个模型的小说阅读收益都统计显著。(Sec. 4.2;App. E。)
4.4 26/27 是均值胜出计数,20/24 是另一种统计描述
27 来自三个模型各九项指标:GraphWalks 四项、MRCR 四项、NUB 一项。除了 GLM BFS F1,前置均值均高于后置;前置对首轮则为 27/27 更高。这些指标彼此相关,不能视为 27 次独立重复实验。
Table 5 对 GraphWalks/MRCR 的 24 格进行同题配对:每题先平均 5 次重复,再对 100 道题进行 20,000 次 cluster bootstrap(seed 0),计算 Trace as State − Trace Append 的百分位 95% 区间。这样避免把同一题的五次生成当作独立题目。区间未做多重比较校正。
| 配对比较 | 差值(pp) | 未校正 95% 区间(pp) |
|---|---|---|
| DeepSeek Parents EM | +38.80 | [31.60, 46.20] |
| Qwen Parents EM | +25.40 | [17.60, 33.60] |
| GLM Parents EM | +16.80 | [10.40, 23.80] |
| GLM MRCR 256K EM | +21.20 | [14.40, 28.20] |
| DeepSeek MRCR 512K EM | +3.20 | [−2.60, 9.40] |
| Qwen BFS F1 | +1.29 | [−0.56, 3.90] |
| GLM BFS EM | +3.40 | [−1.00, 7.80] |
| GLM BFS F1 | −0.83 | [−3.94, 1.62] |
后四项是全部跨零比较,其余 20 格区间完全高于零。F1 差值采用 Table 5 的未舍入均值计算值,因此 +1.29、−0.83 不必等于 Table 2 保留一位小数后的 +1.3、−0.8。Fig. 5 的各单元均值区间不能替代 Table 5 的配对差值区间。(App. E,p. 18。)
4.5 上下文顺序消融:哪些替代解释被削弱了
全部在 DeepSeek V4 Pro Preview、GraphWalks 256K 上进行;分数为百分比。(Table 3,p. 8;Fig. 6,p. 20。)
| 条件 | 输入/选择方式 | BFS EM | BFS F1 | Parents EM | Parents F1 |
|---|---|---|---|---|---|
| First Pass | $[x,q]$ | 31.6 | 36.4 | 29.2 | 46.5 |
| Majority@5 | 五次答案的逐节点多数票 | 35.0 | 39.6 | 31.0 | 47.8 |
| Oracle@5 | 每题、每指标回顾性取五次最高分 | 50.0 | 55.5 | 50.0 | 75.0 |
| Question First | $[q,x,q]$ | 33.4 | 36.8 | 53.0 | 64.6 |
| Re2,本文实现 | $[x,q,x,q]$ | 49.0 | 52.9 | 50.0 | 68.9 |
| Answer Feedback | $[a,x,q]$ | 35.4 | 39.4 | 45.4 | 58.0 |
| Random Trace | $[T_{\mathrm{rand}},x,q]$ | 22.4 | 35.9 | 14.2 | 31.3 |
| Trace Only | $[T,q]$ | 46.2 | 52.7 | 43.8 | 67.3 |
| Trace Append | $[x,T,q]$ | 41.8 | 48.3 | 43.0 | 65.3 |
| Trace as State | $[T,x,q]$ | 58.8 | 65.9 | 81.8 | 91.3 |
问题前置:Parents 提升很大,说明任务目标本身已有价值;但 BFS 接近基线。需同时看到评分细节:Question First 有 181 个输出被按长度限制处理(121 个终止标记为空、60 个原生长度终止),另有 1 个缺少正确末行,共 182 个计零。BFS 占其中 161 个、Parents 21 个。其较差结果不能完全归因于推理状态本身。(App. B,p. 13。)
重复上下文:Re2 明显优于首轮,但低于前置轨迹,尤其 Parents EM 的 50.0% 对 81.8%。这与“任务相关线索比单纯重读更有用”一致;这些控制没有报告统一的端到端成本匹配,不能据此下结论说前置在每美元预算下最佳。
只反馈答案:Parents EM 45.4%,明显低于前置轨迹 81.8%,支持过程文本携带了答案字段之外的有用内容。由于文本长度等也不同,不能隔离究竟是哪类轨迹内容发挥了作用。
随机轨迹:从同子任务其他问题取轨迹,成绩低于首轮。单纯“长得像推理”的格式不够;问题相关性是重要条件。该实验并未分离随机轨迹的具体错误程度、长度和干扰类型,不能宣称排除了所有位置效应。
仅轨迹:无需原图也能超过首轮部分指标,说明轨迹中有大量答案相关信息;但重新提供 $x$ 后,TaS 明显更好,表明上下文核验/补充仍有价值。
多数票与 Oracle:Majority@5 按每个节点是否出现在至少 3 次预测集合中投票,并非选择出现次数最多的完整答案。Oracle@5 按 evaluator 分数事后取最大值,需参考答案,属于分析上界而非部署方法。TaS 在此表超过 Oracle@5,说明反馈阶段不只是从五个已有答案中挑选;它也消耗额外计算,不能称作免费超越同预算上界。
4.6 轨迹条数:一条已有收益,更多总体更好
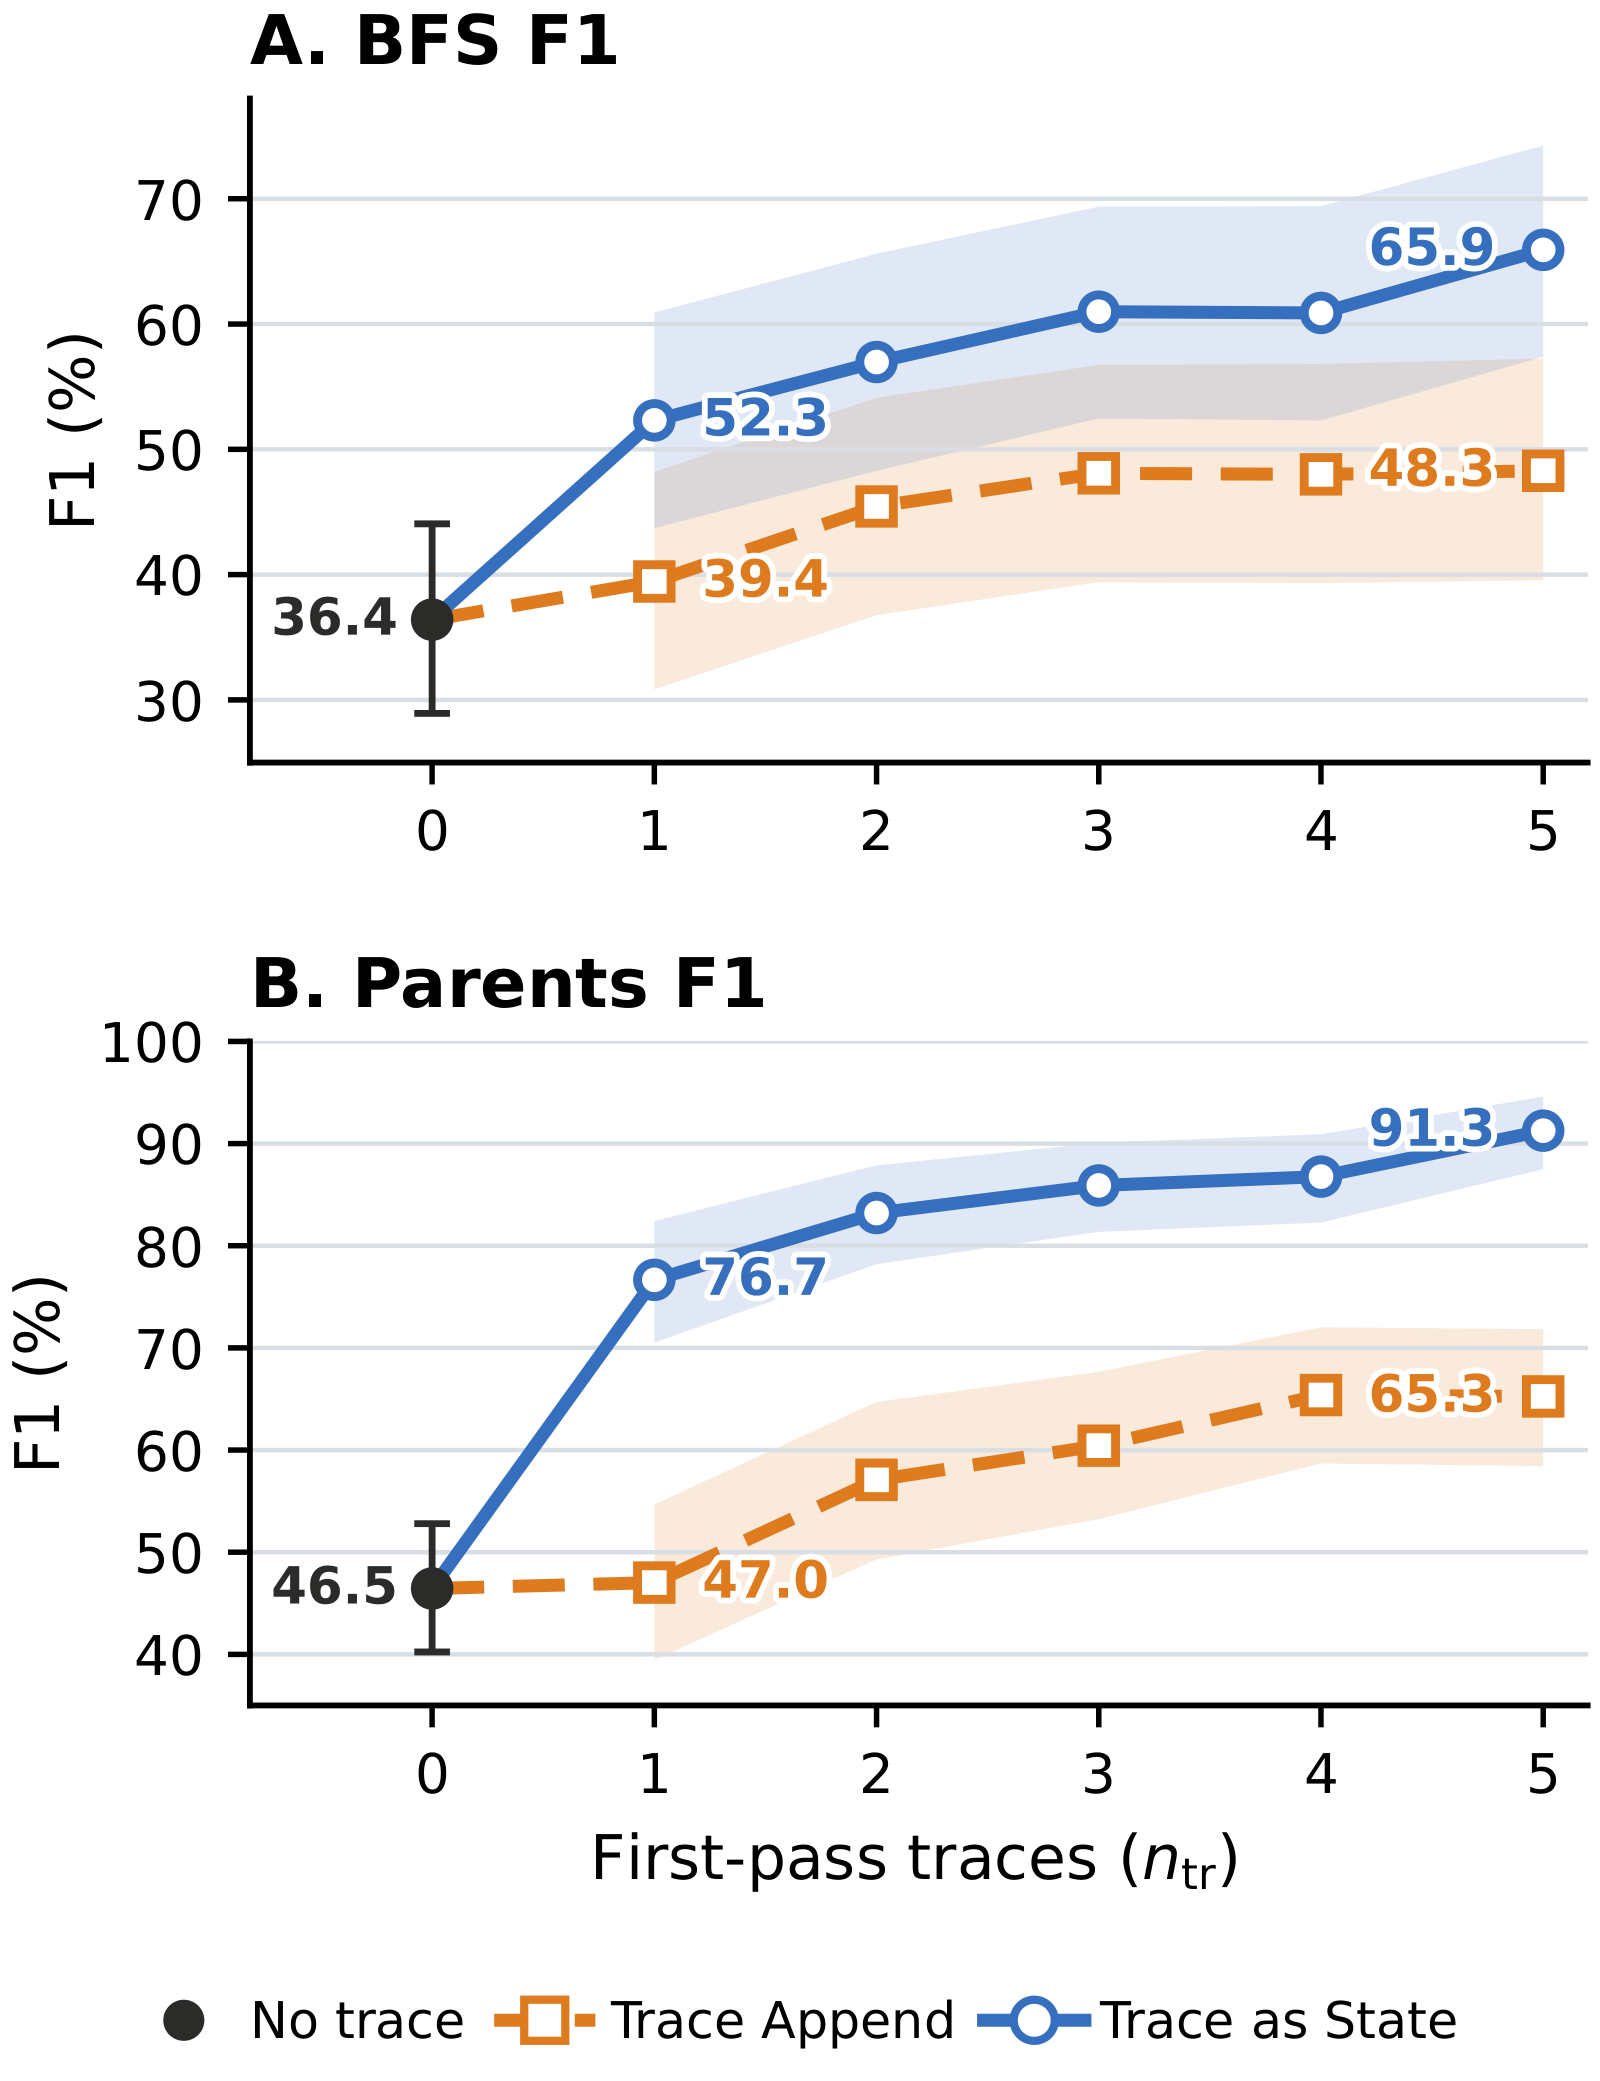
来源:Fig. 2,p. 8。横轴是复用首轮轨迹数 $n_{\mathrm{tr}}$;纵轴是 F1(%)。A 为 BFS,B 为 Parents;蓝色实线为前置,橙色虚线为后置;阴影为按题 bootstrap 的 95% 区间。$n_{\mathrm{tr}}=0$ 是共同首轮均值。
在 $1\ldots5$ 的每个设置中,双方使用相同 $T$,且取 repeat 顺序中的前 $n_{\mathrm{tr}}$ 条合格轨迹,形成嵌套集合;每个条件另做五次第二轮生成。图上标注的精确端点为:
| 子任务 | 首轮 F1 | 1 条:后置 / 前置 | 5 条:后置 / 前置 |
|---|---|---|---|
| BFS | 36.4 | 39.4 / 52.3 | 48.3 / 65.9 |
| Parents | 46.5 | 47.0 / 76.7 | 65.3 / 91.3 |
一条轨迹就能产生明显的位置差;多条总体继续改善,但曲线不是“每增加一条都严格提升”,也没有在这里证明收益与 token 数成固定比例。增加条数同时增加源调用成本、文本量及潜在信息多样性,此消融没有将这些因素分别固定。结果仅覆盖一个模型、一个任务族及最多五条轨迹。(Sec. 4.4,pp. 7–8。)
4.7 难度分层:描述异质性,尚不能证实容量阈值
附录 D 将 BFS 深度分为 1–2、3–4、5–6、7–8、9–10,题数分别为 17、25、21、15、22;将 gold 父节点数分为 0、1、2、3、4–5、≥6,题数为 13、17、25、20、13、12。图的纵轴是相对共同首轮的得分增量,不是绝对准确率,也不是前置直接减后置:
此式为原文 Eq. (6),其中 $p$ 指前/后置,$b$ 在该附录表示分箱,和理论部分 $b=\log_2|\mathcal S|$ 的用法不同。
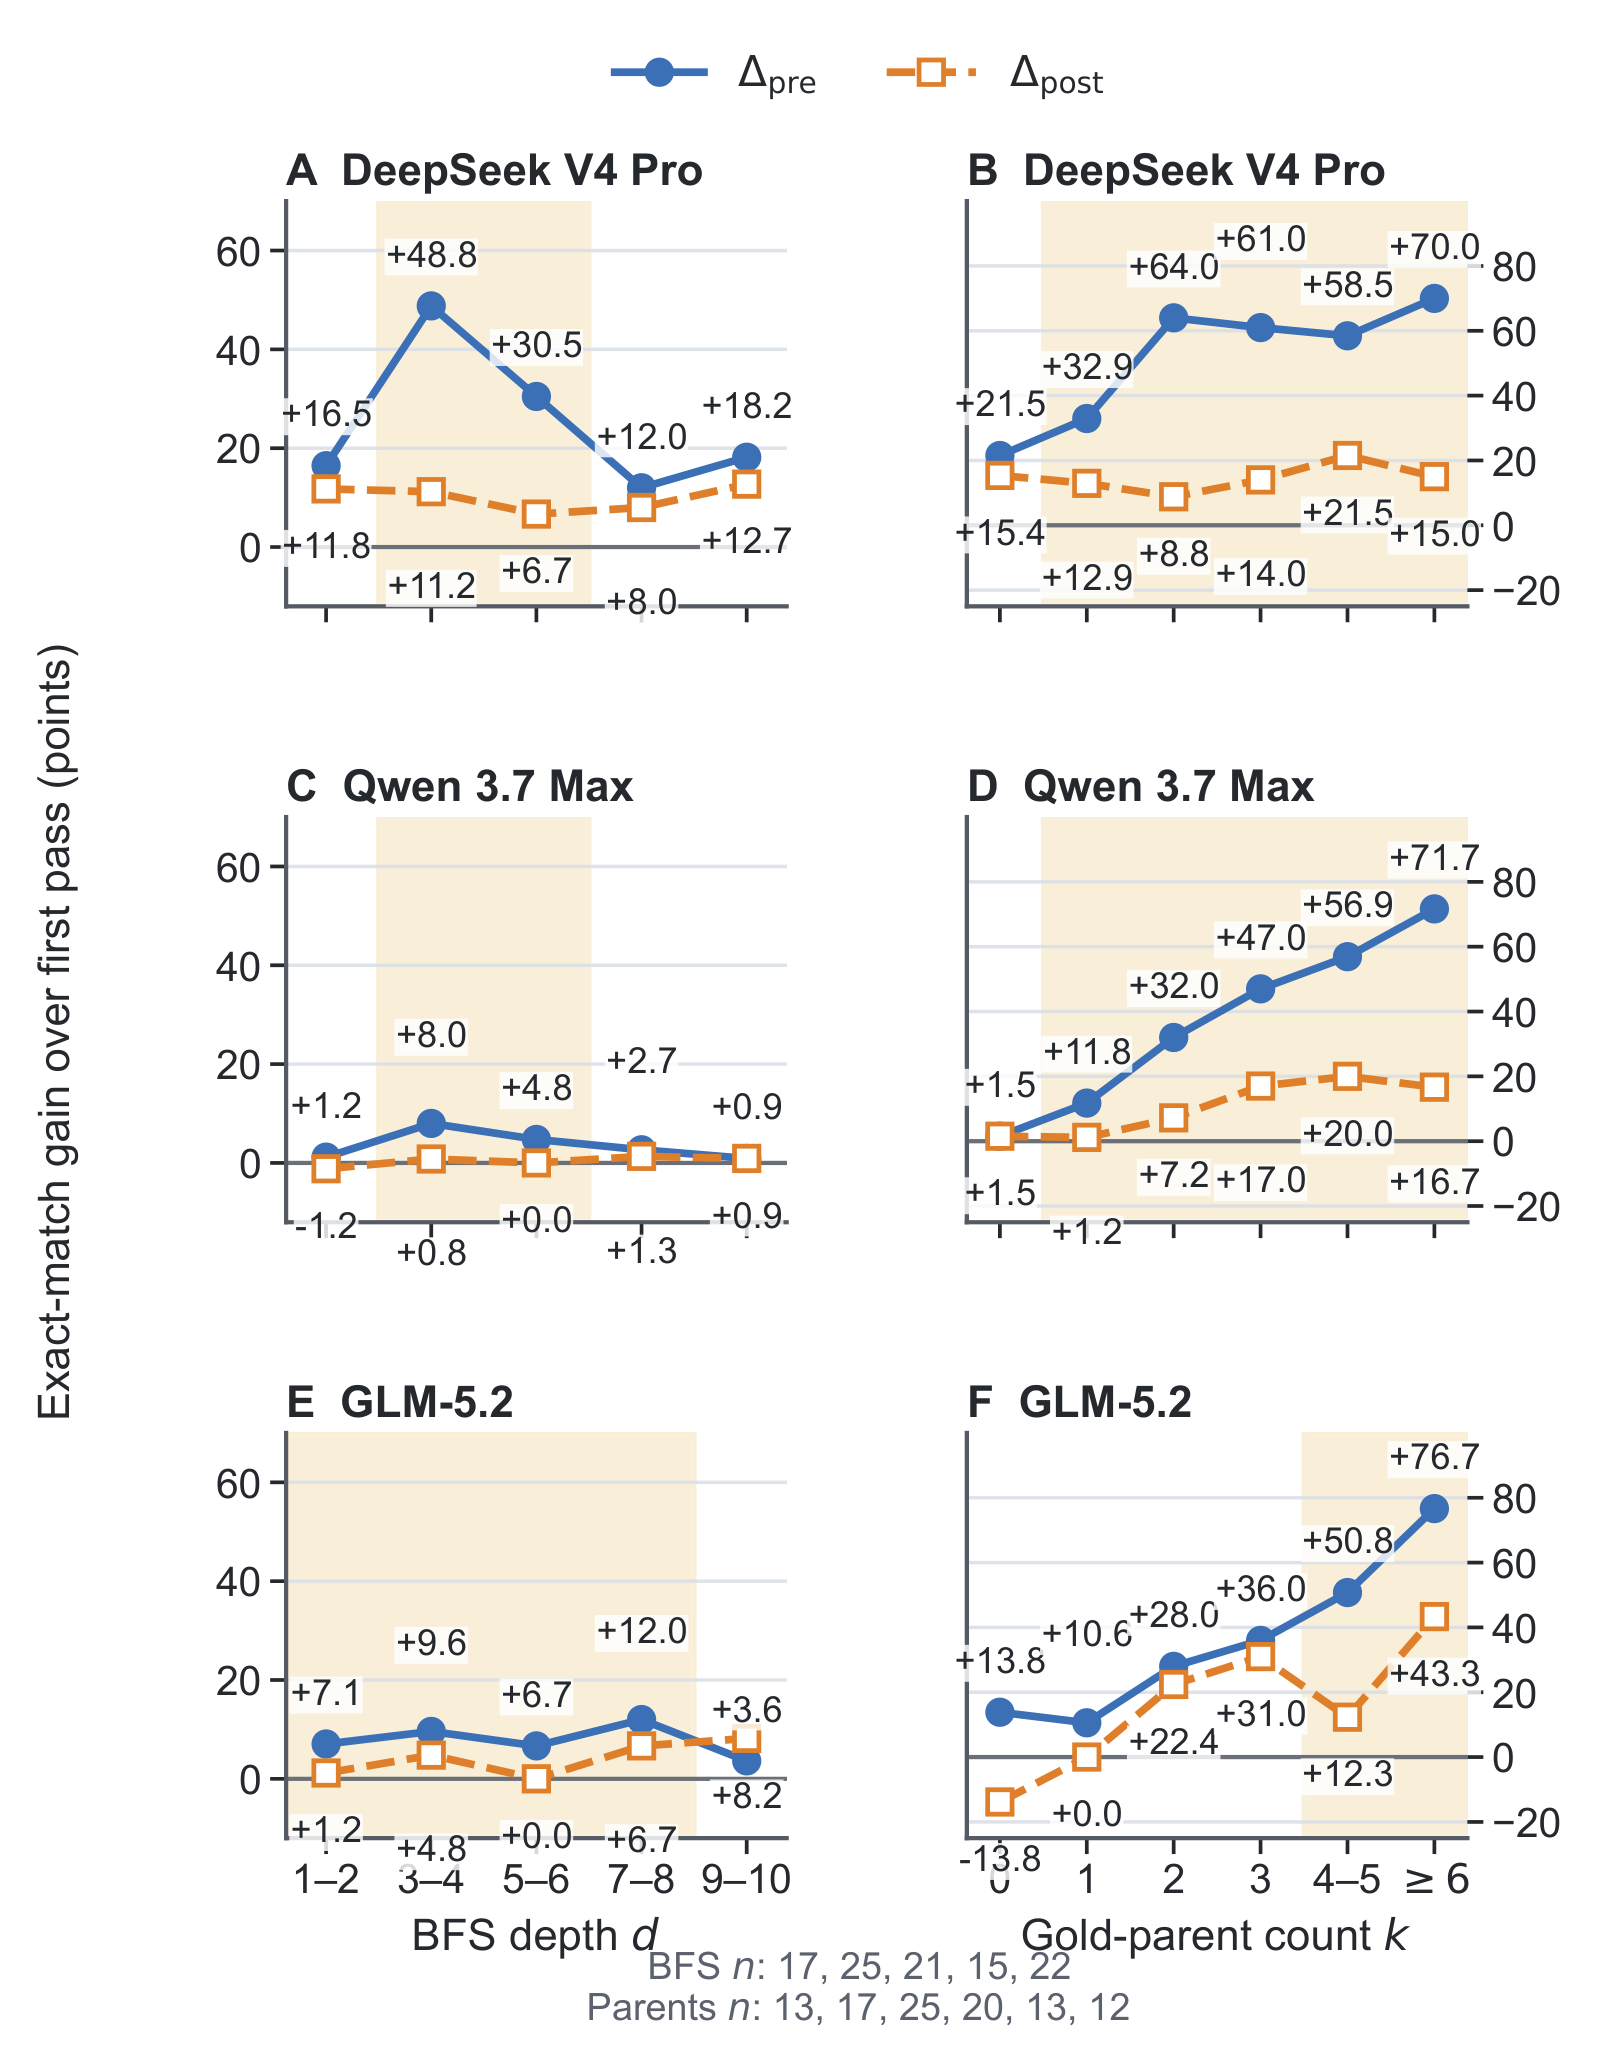
来源:Fig. 3,p. 16。每行一个模型,左列 BFS、右列 Parents;蓝/橙分别为前/后置相对首轮的增量。DeepSeek 的 BFS 最大位置差集中在深度 3–6;GLM 在最后的 9–10 档出现反转。Parents 的已绘制 EM 分箱中前置都不低于后置,Qwen 在 $k=0$ 打平,其他模型的差距不是单调增加。
Fig. 4(p. 17)的集合 F1 分层保持 DeepSeek BFS 的明显优势;Qwen、GLM 更局部化,Parents 大体有利于前置。黄色范围是在看过结果后选出的,各模型/任务/指标的边界还不同。作者明确称其为探索性描述,不能解释为预注册的交互检验、容量阈值或机制证明。后续应事先确定分箱或连续变量对比,再用留出题目验证。
4.8 Token 成本:重读有效,但不是无成本
Table 6(p. 21)记录 provider 返回的累计 token,单位为百万(M)。Tokens 是该行对应阶段;Total tokens 给前/后置阶段加上共享 First Pass 的各类 token。输出包含推理 token;missed input = total input − cached input。只覆盖保留响应中有 usage 的记录,不是逐题延迟或货币成本。
以下摘录两个能说明取舍的例子,列出含源运行的总量:
| DeepSeek 任务 | 条件 | Cached input (M) | Missed input (M) | Output (M) |
|---|---|---|---|---|
| GraphWalks 256K | First Pass 本身 | 206.766 | 51.092 | 62.507 |
| GraphWalks 256K | Trace Append 总计 | 477.783 | 119.646 | 97.738 |
| GraphWalks 256K | Trace as State 总计 | 483.840 | 113.593 | 90.482 |
| NUB Season 2 | First Pass 本身 | 31.651 | 8.418 | 0.817 |
| NUB Season 2 | Trace Append 总计 | 71.240 | 12.878 | 1.001 |
| NUB Season 2 | Trace as State 总计 | 59.069 | 25.055 | 1.215 |
在 GraphWalks 上,TaS 相对 Append 的第二轮输出更少(27.975M 对 35.231M),但含源运行的总成本仍明显高于首轮。NUB 则显示前置的总未缓存输入高于后置:25.055M 对 12.878M。这符合前缀变动可能妨碍缓存复用的限制,但 API 统计不能单独确定全部缓存差异的原因。
不同模型、任务的输出长度和缓存命中模式不同,不能把“同一 $T$”等同于“端到端开销完全一致”,也不能从 token 表推出统一加速倍数。论文未报告统一预算下的成本—质量曲线、逐题延迟或价格核算。(Limitations,p. 9;App. F,pp. 20–21。)
五:结论、边界与进一步阅读问题
5.1 最可靠的贡献
论文提供了一种简单、可操作的推理流程,并用同内容不同位置的核心对照证明:先前推理得到的信息,在重新编码长上下文之前提供,通常更有价值。这在 Parents 上最强,在 MRCR 多数条件上也有支持;NUB 的增量较弱,应作为补充证据。
理论的价值是解释一种可能的顺序瓶颈:不知道初始条件时,处理器可能要保留更丰富的响应结构。实践贡献则是无需改训练或注意力掩码,使用文本让任务信息跨轮反馈。两者相互启发,但理论下界尚未直接解释各模型、各题型的具体收益幅度。
5.2 读者需要保留的限制
- 接口:当前实现需要模型暴露可记录的推理字段;只返回答案的 API 不能直接复现同一流程。换用摘要或其他状态接口是扩展思路,本文未验证其等价性。
- 成本:多条源轨迹和新一遍长上下文增加计算、延迟与 token;前置还可能降低原上下文的缓存复用。
- 代理质量:轨迹可能错误、有损、包含答案线索;错误前缀可能产生干扰。随机轨迹实验已显示这种方法不是对任意文本都有效。
- 范围:仅三个模型、三个任务族;没有多轮 agent、更多反馈轮数、各种长文本长度和等成本策略的系统研究。
- 统计:27 个指标相关;四个配对区间跨零;NUB 只有 20 题;难度分层是事后探索。
- 复现细节:论文报告了主要模板和输入顺序,但附录 C.3 没有给出 NUB 的完整专用模板;实际 provider 默认输出上限不确定。采样温度等设置在所读正文与附录中未明确报告,不能用常见默认值补齐。
这些限制中,接口、成本和任务覆盖由作者明确指出;对预算匹配、统计解释和模板完整性的辨析为本次阅读分析。
5.3 值得进一步做的实验
以下为本次分析提出的后续问题,并非论文已验证的结果:
- 在固定总输入/输出预算下比较前置轨迹、增加首轮采样、重复上下文和精炼状态摘要,确定收益来自何种预算分配。
- 对同一轨迹有控制地删除中间线索、答案信息或错误片段,分离“状态内容”与“文本长度”的作用。
- 比较前 50,000 字符、后段窗口、结构化状态和压缩摘要,检验当前截断方式的损失。
- 预先定义难度维度并在新题上检验,避免用事后高收益区间解释机制。
- 在多轮任务中同时测准确率、缓存命中和实际延迟,研究跨轮收益能否覆盖重读代价。
5.4 组会讲解主线
先解释因果表示为何受输入顺序约束,再用四状态例子讲清残余映射计数;随后展示同一份 $T$ 的前后置设计、Parents 主结果、配对区间和替代解释消融。最后讨论 token 成本与理论到实际模型之间的距离。英文幻灯片按这一顺序组织,数值均与上述表格一致。
本次阅读最应记住的设计原则是:把后来才得到的任务线索带回下一遍开头,能改变下一遍读取原始材料的方式;其收益与成本需要分别测量。