Tail-Replay:混合 LLM 前缀缓存的短尾重放机制
论文:Tail-Replay: Escaping the Curse of Linear Attention in Prefix Caching for Hybrid LLMs
作者:Yirui Liu、Ruoling Qi、Xuaner Wu、Penghang Liu、Jian Chen
版本:arXiv:2608.30310v2,2026-10-15 修订;获取与研读日期:2026-10-16。
原文:arXiv v2 · 本地 PDF · 英文汇报幻灯片
论文总览
混合大语言模型把全注意力(Full Attention,FA)和线性注意力(Linear Attention,LA)交替排列。FA 的键值缓存可以按 token 截取;LA 把整个历史压入一个不断覆盖的循环状态。于是,新请求即使与旧请求共享前 $m$ 个 token,也未必能取得恰好位于 $m$ 的 LA 状态。
Tail-Replay 把这个状态恢复问题改成短序列重放:保存每个 FA 层的完整前缀 KV 和逐 token 输出隐藏向量;命中后,从零状态重放匹配前缀末尾的 5% 或 10%,近似恢复各组 LA 状态。 每组都从自己对应的精确 FA 隐藏向量出发,因此重放误差不会沿重放路径跨组继续累积。这里“精确”指原先完整预填充得到的缓存;LA 重建状态仍然是近似值。
作者在三个 Gated DeltaNet 混合模型上报告:LongBench 与 RULER 的基准平均分保留率为 92.8%–99.9%;在约 32K 匹配前缀、5% 重放、传输重叠和末端 FFN 跳过同时开启时,首 token 延迟(TTFT)相对完整预填充加速 9.12–14.32 倍。逐任务表现并不均匀;此外,Qwen3.6-27B 的 RULER 汇总表与附录数据存在实质不一致,具体见结果部分。
这篇论文最值得关注的是:用精确的跨层入口和可衰减的组内循环状态,换取不依赖循环检查点位置的前缀复用。 代价包括近似误差、额外隐藏向量存储,以及随重放长度增加的计算量。
结构地图
| 原文章节 | 作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 解释混合架构与前缀缓存的状态粒度冲突 | pp. 1–2 |
| 2 Preliminary and Related Work | GDN 递推、检查点方法与相关缓存方案 | p. 2,式 (1) |
| 3 Method | 缓存内容、独立组重放、两项执行优化 | p. 3,图 1、式 (2) |
| 4 Experiment | 质量与 TTFT 两类实验 | p. 4,表 1、表 2 |
| 5 Conclusion | 总结贡献 | p. 4 |
| A Complete Quality Results | 所有质量任务与长度单元格 | p. 5,表 3 |
| References | 相关工作的原始出处 | pp. 5–7 |
以下页码均指从 1 开始的 PDF 页码。
一:动机——共享 token 不一定意味着存在可复用状态
1.1 两类缓存的寻址方式不同
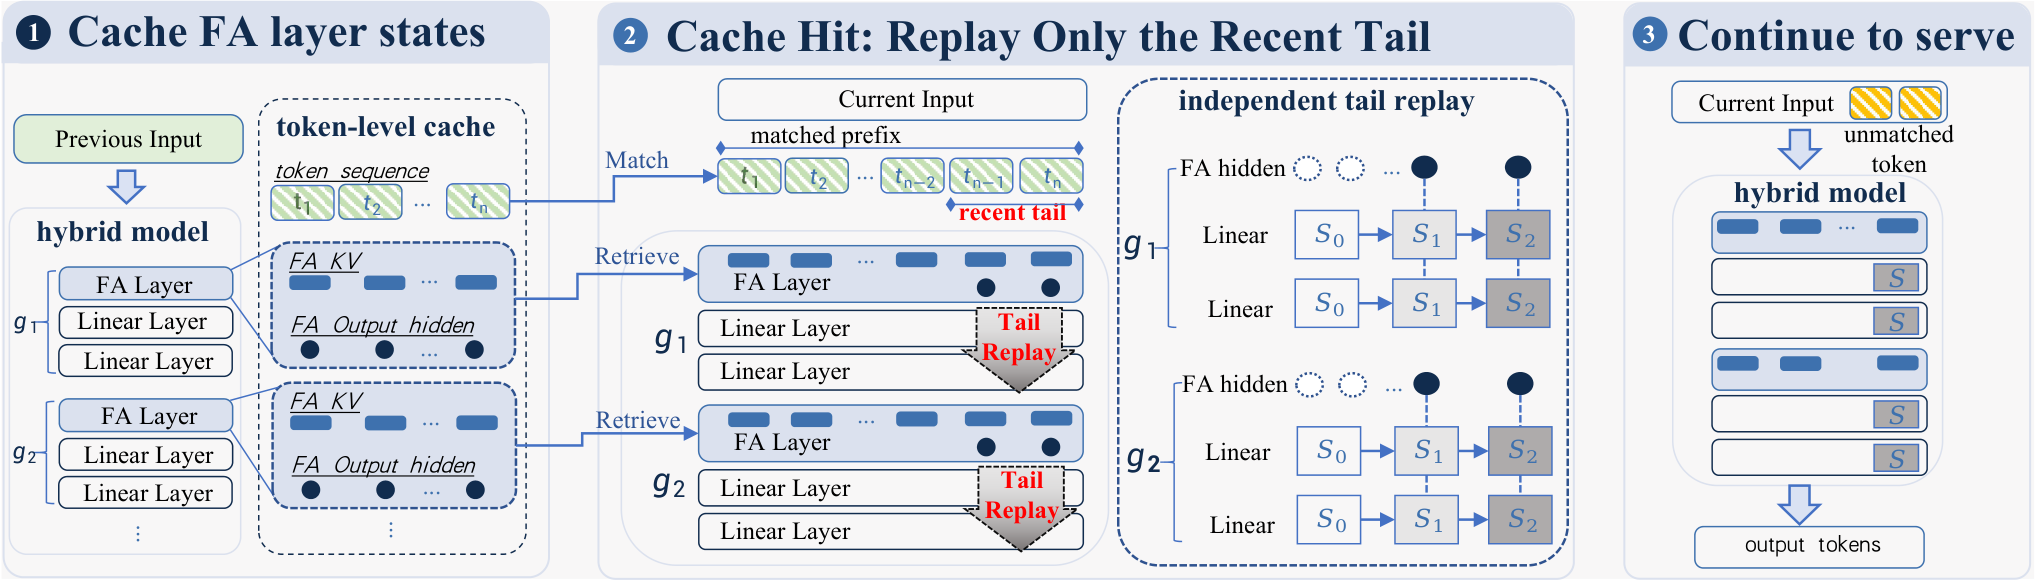
假设旧请求是 $P=(t_1,\ldots,t_n)$,新请求只共享前 $m 检查点方法在若干位置显式保存 $S_c$。当命中点 $m$ 不在这些位置时,可以从更早的有效检查点重新计算到 $m$,但复用收益依赖检查点的分布。论文所谓解除限制,针对的是这种恢复边界受检查点约束的问题,而非声称任意命中都能无损、零计算地恢复。 这张表概括原文 Sec. 1–2 的定位;论文实验没有直接比较 Marconi 或 Sparse Prefix Caching,因此后面的加速倍数都是相对 full prefill 的倍数。 原图 1,PDF p. 3;直接使用作者矢量图转换的 PNG。按从左到右的顺序阅读:左侧记录旧请求的 FA KV 与 FA 输出隐藏向量;中部对匹配前缀的近期尾部进行分组重放;右侧使用恢复后的状态处理未命中的后缀。中部的 $g_1,g_2$ 表示不同组,每组包含一个 FA 层及其后连续的 LA 层。 对每个 FA 层,缓存是: 其中 $h_i$ 是该 FA 层对第 $i$ 个 token 的输出隐藏向量。不能把这项方法概括成“只保存 KV”:隐藏向量是分组独立重放成立的关键额外缓存。 为了支持不同的匹配终点,缓存覆盖原前缀的逐 token 输出;命中后仅取所需尾部作为重放输入。 教学例子:若命中 $m=10{,}000$ 个 token,$r=5\%$,则重放第 9,501–10,000 个位置。假设另一方案最近的检查点在 8,192,则从该点精确恢复需要覆盖之后的 1,808 个位置。这个例子只说明恢复区间的差别;两条路径的每 token 成本和恢复精度并不相同。 原文式 (1) 写成: $\alpha_i\in(0,1]$ 控制旧信息的衰减;秩一项改变与键方向有关的状态分量,新外积项写入当前信息。作者的直觉是:若较早历史对当前状态的贡献已被后续更新衰减,从零状态读入近期尾部,就可能接近完整状态。(Sec. 2,PDF p. 2,式 (1)。) 原文没有指定键、值和状态的具体轴布局。上式保留论文记法;若实现采用 $S\in\mathbb R^{d_v\times d_k}$、$v_i\in\mathbb R^{d_v}$、$k_i\in\mathbb R^{d_k}$,则键空间算子应右乘状态,不能直接把原文的左乘式当成矩形张量代码。下文只把 $T_i$ 理解成作用于状态的线性算子,不据此补造模型维度。 以下为本次分析的条件性推导,用于解释机制,并非原文给出的定理。先假设完整计算与重放使用完全相同的转移 $T_i$ 和写入 $b_i=\beta_i v_i k_i^\top$,令 $a=m-k$,则: 空乘积取单位算子。因此,短尾重放丢掉的正是尾部开始前的状态经过后续转移后的剩余贡献。如果存在 $\|T_i\|_2\le\rho<1$,就有: 对原文形式,一个充分的非扩张条件是键经过单位范数归一化且 $\beta_i\in[0,2]$,此时 $\|I-\beta_i k_i k_i^\top\|_2\le1$;再有统一的 $\alpha_i\le\rho<1$ 才能得到上面的指数界。这些是推导的附加条件,论文只明确给出 $\alpha_i\in(0,1]$,没有估计整模型的收缩率。特别是 $\alpha_i=1$ 且某方向未被键更新影响时,旧信息可以持续存在。 更进一步,组内后面的 LA 层接收的是前面 LA 层近似计算后的输出,转移和写入本身也可能改变。一般误差递推会增加两项: 这解释了两个设计选择:增加尾长可以消除更多初始状态误差;缓存每个 FA 出口则为下一组提供精确输入,阻止上一组重放误差继续影响下一组的恢复入口。论文的端到端实验检验的是这两种机制共同作用后的任务质量。 如果只从很早的一层开始重放,近似 LA 状态会改变其输出,再影响下游层的输入。Tail-Replay 在每个 FA 出口重新读取完整预填充时的 $h_i$,于是下一组不需要接收上一组近似生成的隐藏向量。 可以把这些 FA 出口理解为深度方向的精确恢复入口。每组第一层的输入隐藏向量是精确的,组内所有输出和所有循环状态并不会因此自动精确。 后续新后缀仍使用近似恢复的 LA 状态,因此生成质量需要实验验证。(Sec. 3,PDF p. 3。) 还要注意,重放输入是完整预填充得到的 FA 隐藏向量,其本身已经经过对更早上下文的计算;后续请求又保留了全部匹配前缀的 FA KV。因此,远端信息仍有这两条保留路径。5% 的重放效果应理解为这种混合缓存设计的结果,不能据此推断模型只需要最近 5% 的原始上下文。 末端 FFN 跳过。 一组最后一个 LA 层完成注意力/循环状态更新后,它的 FFN 输出不再被本次恢复使用:下一组直接读取自己的 FA 输出缓存。因此可以跳过该组最后一层的 FFN。组内中间 FFN 仍用于生成下一 LA 层的输入;新后缀的正常推理也仍需要执行相应网络计算。 传输与重放重叠。 恢复 LA 状态依赖尾部隐藏向量,不依赖完整的 FA KV。在尾部输入可用时,可以让 FA KV 的主机到设备传输与重放在不同流上推进,到处理新后缀前才同步。 下面是本次分析的理想化延迟模型,忽略资源争用并把共同开销记入 $T_{\mathrm{other}}$: 当重放时间超过 KV 传输时间,继续加大 $r$ 就更容易直接推高 TTFT。尾部隐藏向量自身也必须准备好;这个重叠关系不能理解为所有数据搬运都免费。(Sec. 3,PDF p. 3。) 取消 LA 检查点同时引入逐 token FA 隐藏向量。用 $L_{\mathrm{FA}}$ 表示 FA 层数,$d_h$ 表示隐藏宽度,$d_K,d_V$ 表示每层每 token 的总 KV 宽度,$b$ 表示每元素字节数;在这些宽度各层相同的简化情形下,本次分析得到: 其中隐藏向量的额外部分为 $nL_{\mathrm{FA}}bd_h$。具体数值需要各模型布局和精度;论文未报告等存储预算下与检查点策略的容量、命中率比较。因此,“不存循环检查点”不能直接换算成“总缓存更小”。 作者使用 OLMo-Hybrid-7B、Qwen3.5-4B、Qwen3.6-27B,均为 Gated DeltaNet 混合模型;硬件为 NVIDIA H100,软件为 PyTorch 2.9.1。(Sec. 4,PDF p. 4。) 表 2 没有分别列出“仅重叠”和“仅 FFN 跳过”,因而只能量化组合收益,不能从中拆分两项优化的单独贡献。 LongBench 采用 narrativeqa、hotpotqa、qasper、musique、qmsum,指标为 token-F1 或 ROUGE-L,分数越高越好。附录中 narrativeqa 占多个长度单元格,其他四项均为 16K:Qwen3.5 是 16K/32K/64K,OLMo 是 16K/31K,Qwen3.6 是 16K/64K。因此三模型的 LongBench 平均值不是在完全相同的长度集合上求得,不宜用这一列直接给模型排位。 RULER 列出 cwe、qa1、niah、vt 四个任务,在 8K 和 16K 上各测一次,共八个任务—长度单元格,指标为平均 recall,越高越好。论文采用的是这些已评测子集,不应把结果写成覆盖完整基准的全部任务。(表 1,PDF p. 4;附录 A、表 3,PDF p. 5。) “质量保留率”的含义是同模型、同基准聚合后的分数比例: 它不等于生成文本相同比例,也不等于逐样本正确率。表 1 的保留率和三位小数分数应按作者原报分别读取,不能把三位小数相除后的微小差异当成确定的计算错误。 质量实验未明确交代每个样本的匹配前缀与未命中后缀如何划分,也未给出样本数和解码设置。这限制了实验协议的复现;尤其不能把“重放匹配前缀的 5%”解释成“整个评测输入只处理 5%”。 效率实验使用共享的 narrativeqa 前缀,名义长度为 8K、16K、32K。实际匹配长度略有差别,完整数据见下表。每个延迟是 20 次计时重复的均值;这 20 次属于延迟测量,不是质量实验的样本数。 TTFT 从开始缓存传输或重放计时,直到生成首个 token,计入这一命中恢复路径的传输成本。论文没有将这张表定义为从请求到达、经过排队和缓存查找后的完整在线服务时延,也没有报告并发吞吐。因此加速结论对应的是这里测量的命中路径。 下表逐项沿用原表 1;括号是作者报告的相对 Full 保留率。 来源:Sec. 4,表 1,PDF p. 4。 Zero-only 显著劣于 Full,说明仅有精确 FA KV 不足以替代循环状态。5% 的尾部重放就能补回大部分差距。提高到 10% 后,Qwen3.6 和 OLMo 的平均分上升,但 Qwen3.5 从 0.369 降到 0.367;端到端任务分数不呈严格的尾长单调性。 来源:表 1,PDF p. 4;此表保留作者原报数值。 Qwen3.5 的 5% 重放平均分已经很接近 Full;OLMo 则从 5% 的 0.756 增加到 10% 的 0.785,额外预算带来的改善更明显。附录中 Qwen 两模型在 niah、vt 上,重放后的所列单元格均达到 1.000,而 OLMo 仍有残余损失。(表 3,PDF p. 5。) † Qwen3.6-27B 的数值需要单独处理。 表 1 说明 RULER 是八个任务—长度单元格的平均值;按表 3 实际列出的八行做等权平均,得到: 例如 Full 是 $(1+1+0.895+0.875+1+1+1+1)/8=0.97125$。按附录计算的 5%/10% 保留率分别约为 99.87%/100.00%,也与表 1 不完全相同。两表差距超过末位舍入能解释的范围,原文未说明另一套汇总口径。可以保留“这一模型在所列 RULER 单元格上恢复充分”的判断,但不应把两套数值混用或擅自选一套作为已经修正的结果。 来源:附录 A,表 3,PDF p. 5。保留率为根据所列分数计算。 这里最有决策意义的是 OLMo 的 Qasper:5% 重放比 Full 少 0.086 个分数单位;若把分数乘 100 展示,就是 8.6 分,相对损失约 21.8%。因此,摘要中的 92.8% 下界是基准平均值的下界,并不是所有任务的保留率下界。另一方面,个别单元格略高于 Full,也不足以据此把近似恢复解释成稳定的质量改进方法。 以下为表 2 的关键列。所有延迟单位为 ms;两种重放预算均采用 H2D-OVL+skip。 来源:Sec. 4,表 2,PDF p. 4。加速倍数沿用作者报告,分母为同一行的 Full。 根据原表 2(PDF p. 4)重绘。横轴为名义匹配前缀长度,纵轴为相对同一行完整预填充的 TTFT 加速倍数;三条线分别表示三个模型。实际 token 数以上表为准。 完整预填充成本随前缀变长而明显增加,短尾恢复的增长较慢,所以 5% 的相对加速从 8K 的 2.55–5.70 倍升到约 32K 的 9.12–14.32 倍。尤其是 Qwen3.6,在 31,847 个匹配 token 下从 3605.2 ms 降至 251.8 ms。 当预算从 5% 增至 10%,同一 Qwen3.6 32K 行的延迟从 251.8 增至 371.3 ms,增加约 47.5%;Qwen3.5 从 86.2 增至 108.1 ms,增加约 25.4%;OLMo 只从 108.8 增至 112.5 ms,增加约 3.4%。预算代价与模型执行瓶颈有关,不能只凭“多重放一倍”预测最终延迟。 约 32K 时,H2D-SER 与 H2D-OVL+skip 的比较如下。下降比例由原表 2 的均值计算。 这些数值说明,除了少算前缀本身,减少重放末端的无用 FFN 和隐藏传输时间也能降低恢复成本。它们量化的是组合优化相对串行 Tail-Replay 的收益,与前一节相对 Full 的加速具有不同分母。 Tail-Replay 的贡献是把混合模型的前缀复用边界与循环检查点位置分开:FA 侧保存逐 token 的精确历史和恢复入口,LA 侧用较短尾部近似重建状态。这个设计把模型本身的遗忘特性转化为推理阶段的复用机会,并用分组入口限制深度方向的误差传播。 实验最有力地支持两点:零状态直接继续通常损失很大,短尾重放确实有价值;对于所测 H100 上的长匹配前缀,恢复路径能显著减少 TTFT。能否替代实际服务中的检查点策略,还取决于相同内存预算下的命中分布、检查点距离、额外隐藏向量容量和任务容忍度;论文没有提供这些路线的直接效率比较。 后续最有价值的方向是让重放长度适应组和请求:在收缩快、任务不敏感的组用较短尾部,在恢复困难的组增加预算或退回精确检查点。同时需要在相同存储预算下比较命中率和恢复成本。这里的自适应机制是本次分析提出的延伸,并非论文已经实现的能力。 对于组会讨论,可以围绕三个具体问题展开:为什么精确的 FA 出口足以切断跨组重放误差;什么样的状态分量会在短尾之后仍未衰减;在 Qasper 这类任务上,如何用可观测信号决定需要更长重放或精确恢复。1.2 与已有方法的关系
路线 论文中的代表 状态恢复依据 与 Tail-Replay 的差别 FA 前缀复用 RadixAttention 等 按 token 保存的 KV 天然可以截取前缀,但未解决 LA 状态 循环检查点管理 Marconi、Sparse Prefix Caching 保留下来的精确循环状态 重点在保留哪些状态、在何处放置检查点 局部状态初始化 LinearKV 缓存的局部线性状态 仍保存循环状态作为初始化依据 短尾重放 Tail-Replay 精确 FA 隐藏向量与零初始化重放 不存 LA 检查点,以重算换取边界灵活性 二:方法——精确入口、局部近似和独立恢复
2.1 缓存里实际保存什么
符号 含义 $n$ 旧请求的 token 数 $m$ 当前请求与旧请求匹配的前缀长度 $r$ 重放比例,实验取 0.05 或 0.10 $k=\lceil rm\rceil$ 实际重放 token 数;不要与键向量 $k_i$ 混淆 $S_i,\hat S_i$ 完整预填充状态、短尾重放状态 $k_i,v_i$ LA 递推使用的键、值向量,由组内计算产生 $\alpha_i,\beta_i$ 遗忘门、写入/纠正强度 $T_i$ 作用于旧状态的转移算子 2.2 一次命中的执行流程
2.3 为什么尾部可能足以恢复状态
2.4 为什么每个 FA 出口都要缓存
2.5 两项执行优化
2.6 储存成本转移到了哪里
三:实验——质量恢复与命中路径延迟分别评估
3.1 模型、硬件和对照
对照/变体 做什么 回答的问题 Full 完整预填充 质量参照和 TTFT 加速分母 Zero-only 复用匹配 FA KV,LA 状态清零,无重放 精确 FA KV 本身是否足够 Tail-Replay 5% / 10% 从零状态重放匹配前缀近期尾部 恢复收益与预算的关系 H2D-SER KV 传输与重放串行执行 未启用组合优化时的命中成本 H2D-OVL+skip 传输重叠,同时跳过组末 FFN 两项优化合用后的延迟 3.2 质量任务、长度与指标
3.3 TTFT 的测量口径
四:结果——重放有效,但收益随模型、任务和预算变化
4.1 LongBench:平均恢复明显,10% 并不处处优于 5%
模型 Full Zero-only 5% 重放 10% 重放 Qwen3.6-27B 0.426 0.313 0.410(96.2%) 0.417(97.8%) Qwen3.5-4B 0.374 0.271 0.369(98.9%) 0.367(98.1%) OLMo-Hybrid-7B 0.317 0.159 0.294(92.8%) 0.297(93.9%) 4.2 RULER:检索收益较强,Qwen3.6 的汇总存在冲突
模型 Full Zero-only 5% 重放 10% 重放 Qwen3.6-27B † 0.987 0.299 0.985(99.8%) 0.986(99.9%) Qwen3.5-4B 0.960 0.415 0.959(99.9%) 0.958(99.7%) OLMo-Hybrid-7B 0.812 0.215 0.756(93.1%) 0.785(96.7%) 数据依据 Full Zero-only 5% 重放 10% 重放 表 1 原报 0.987 0.299 0.985 0.986 表 3 八行均值,本次计算 0.97125 0.34800 0.97000 0.97125 4.3 逐任务结果揭示了平均值掩盖的代价
模型与单元格 Full Zero-only 5% 10% 说明 OLMo,qasper@16K 0.394 0.129 0.308 0.318 5%/10% 仅保留约 78.2%/80.7% OLMo,musique@16K 0.305 0.107 0.282 0.273 加长尾部后分数下降 Qwen3.5,qasper@16K 0.487 0.355 0.482 0.461 10% 比 5% 更低 Qwen3.6,qa1@8K 0.895 0.405 0.880 0.885 召回改善明显,仍略低于 Full Qwen3.5,vt@16K 1.000 0.244 1.000 1.000 短尾重放充分恢复此单元格 4.4 TTFT:长匹配前缀带来更大的计算节省
模型 匹配 token 数 Full 5% 重放 5% 加速 10% 重放 10% 加速 OLMo-Hybrid-7B 8,225 264.3 82.9 3.19× 82.7 3.20× OLMo-Hybrid-7B 16,417 533.7 83.5 6.39× 85.6 6.24× OLMo-Hybrid-7B 31,366 1068.3 108.8 9.82× 112.5 9.50× Qwen3.5-4B 8,226 191.6 75.2 2.55× 75.9 2.53× Qwen3.5-4B 16,418 387.7 75.0 5.17× 76.0 5.10× Qwen3.5-4B 31,847 786.4 86.2 9.12× 108.1 7.27× Qwen3.6-27B 8,226 879.6 154.3 5.70× 154.7 5.69× Qwen3.6-27B 16,418 1797.2 161.6 11.12× 218.1 8.24× Qwen3.6-27B 31,847 3605.2 251.8 14.32× 371.3 9.71× 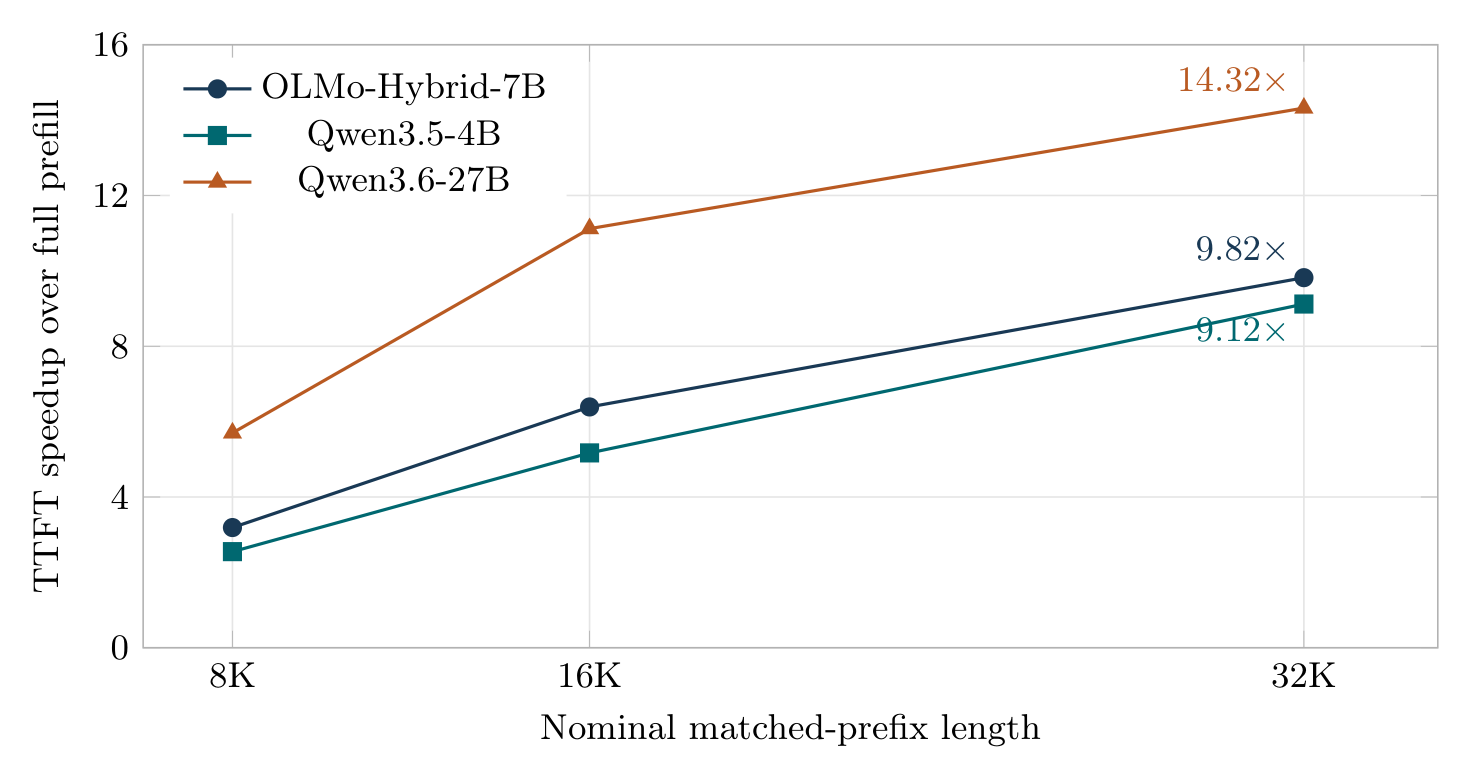
4.5 两项优化的组合收益
模型 5%:串行 → 组合优化 TTFT 下降 10%:串行 → 组合优化 TTFT 下降 OLMo-Hybrid-7B 158.8 → 108.8 ms 31.5% 191.7 → 112.5 ms 41.3% Qwen3.5-4B 105.8 → 86.2 ms 18.5% 133.9 → 108.1 ms 19.3% Qwen3.6-27B 311.9 → 251.8 ms 19.3% 453.9 → 371.3 ms 18.2% 五:结论——值得保留的设计思想与实际取舍