DAMP:衰减感知的混合精度循环状态量化
论文:DAMP: Decay-Aware Mixed-Precision Recurrent-State Quantization
作者:Tao Zhang、Jianchao Tan、Pingwei Sun、Yanqi Yu、Zunhai Su、Zixu Jiang、Yuchen Xie、Xunliang Cai、Ziqian Zeng
版本:arXiv:2608.27513v2,2026-09-30 修订;首次提交于 2026-08-27。研读日期:2026-10-13。
材料:本地原论文 PDF · 英文汇报 PDF · 可编辑 TeX
论文总览
DAMP 解决混合注意力模型中一个具体的推理瓶颈:Gated DeltaNet(GDN)和 Kimi Delta Attention(KDA)的循环状态虽然不随序列长度线性增长,却通常以 FP32 保存,而且每生成一个 token 都要读取、更新和写回。直接降低状态存储精度会反复引入量化误差,损害数学推理和代码生成。
作者的核心判断是:高精度应优先分给“本次量化误差大,而且误差容易在未来保留下来”的 key 通道。 DAMP 先沿 value 维做缩放与重排(scaling and reordering,SR),再通过离线校准为每个 key 通道计算衰减加权的误差风险。每个头固定保留 16 个通道为 FP16,其他通道采用分组 INT8;静态排列与融合 CUDA 内核把这种分配转化为实际的访存节省。
主要结果有三个不同层次:有效状态存储约 9.9 bits/value,较 FP32 减少 69.1%;循环更新内核最高 2.59× 加速;整模型每输出 token 的耗时(TPOT)最高下降 19.0%。准确率在所测任务上接近 FP32,其中 Qwen3.6 的 AIME 2026 从 INT8+SR 的 63.98% 恢复到 83.82%,FP32 为 85.46%。这些数字分别对应状态存储、内核和整模型,不能互换。三模型的测试覆盖也不完全相同:前两个模型测试六个基准,Kimi-K3 的准确率结果只有 AIME 和 HMMT。(§6,PDF pp.7–9)
结构地图
以下页码均为从 1 开始的 PDF 页码,与正文印刷页码一致。
| 原文章节 | 论证作用 | 页码与关键证据 |
|---|---|---|
| 1 Introduction | 状态存储和更新成本;均匀量化的失败 | pp.1–3;Fig.1 位于 p.1 |
| 2 Related Work | 与权重、KV cache、Mamba 状态量化区分 | p.3 |
| 3 Recurrent-State Quantization in GDN and KDA | 状态递推、存储量化、误差传播 | pp.3–4;Eqs.(1)–(13) |
| 4 Structure in Quantization Error and Decay | 误差集中与衰减排序稳定性 | pp.4–6;Fig.2 |
| 5 DAMP: Decay-Aware Mixed-Precision State Quantization | 风险评分、预算分配、静态布局 | pp.6–7;Fig.3,Eqs.(14)–(15) |
| 6 Experiments | 准确率、效率、选择器与精度预算消融 | pp.7–9;Tables 1–4,Figs.4–5 |
| 7 Conclusion | 贡献与结果归纳 | p.10 |
| A Additional Method Details | 量化格式、校准、等价变换、实现、生成参数 | pp.15–17;Algorithm 1,Eqs.(16)–(18),Table 5 |
| B Long-Context Evaluation | 4K–128K RULER | p.17;Table 6 |
| C Stability of Offline Signals | 校准集一致性、GDN 头级衰减 | p.18;Table 7,Fig.6 |
| D Additional GDN Ablations | GDN 下的选择器结果 | pp.18–19;Table 8 |
| E Multi-Turn Serving on Kimi-K3 | 多轮负载及缓存复用设置 | p.19 |
| F Limitations | 架构与系统覆盖、4-bit 的不足 | p.19 |
一:动机——固定大小的状态仍然昂贵
混合架构把 GDN/KDA 层与 full attention 或 MLA 层交错放置。循环层把历史压缩为固定大小的矩阵,但服务系统同时维护多请求的活动状态,以及前缀缓存所需的状态检查点。论文估计,Qwen3.6-35B 在 SGLang、batch size 256 下,包含这些状态的 FP32 存储约为 80 GB。这是该服务配置的容量估计,不能当作单条序列的状态大小。(§1,PDF p.2)
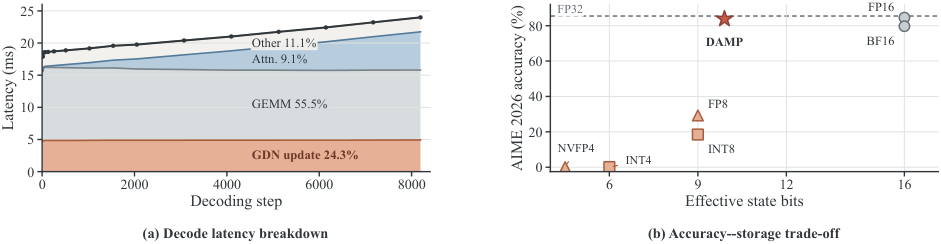
原文 Fig.1,PDF p.1。左图横轴为解码步数,纵轴为延迟,堆叠部分给出各类操作;该配置下 GDN 更新占解码延迟的 24.3%。右图横轴为有效状态位数,纵轴为 AIME 2026 准确率。低位数的均匀量化节省存储,却迅速损害推理准确率。
这种状态与只写入一次、以后读取的普通缓存有一个关键区别:它每一步都参与新的递推,并再次被量化。今天的误差会改变明天更新的起点。因此,仅控制单步量化误差未必足够,还要考虑误差经过后续动态后的寿命。
相关工作中,权重/激活量化主要处理数值范围和表示精度,KV cache 量化处理注意力缓存,Quamba2 和 Q-Mamba 等处理 Mamba 系列的状态。作者将新贡献定位于 GDN/KDA 的训练后状态量化,以及结合局部量化误差与衰减保留程度的静态精度分配。(§2,PDF p.3)
二:方法——从完整误差递推到可部署的近似评分
2.1 状态里存什么,GDN 与 KDA 有何区别
对一个层、一个头:
| 符号 | 含义与维度 |
|---|---|
| $S_t\in\mathbb R^{d_k\times d_v}$ | 第 $t$ 步的循环状态;行对应 key 通道,列对应 value 维 |
| $q_t,k_t\in\mathbb R^{d_k}$ | query、key;头内做 $\ell_2$ 归一化 |
| $v_t\in\mathbb R^{d_v}$ | 当前 value |
| $\beta_t\in(0,1)$ | delta-rule 写入/擦除强度 |
| $\Lambda_t=\operatorname{diag}(a_{t,u})$ | 对旧状态施加的学习衰减 |
| $A_t=(I-\beta_t k_tk_t^\top)\Lambda_t$ | 旧状态经历的完整线性转移 |
状态更新与读出为:
先衰减旧状态,再部分擦除当前 key 方向已有的关联,最后沿该方向写入新 value。GDN 在同一头的所有 key 通道共享衰减,即 $\Lambda_t=\alpha_t I$;KDA 使用通道级衰减 $\Lambda_t=\operatorname{diag}(\exp(g_t))$。这一区别决定了后面如何理解“衰减感知”。(§3.1,PDF p.3,Eqs.(1)–(4))
2.2 量化的是存储,更新算术仍然使用 FP32
每次解码,内核读取压缩状态,反量化后用 FP32 完成递推与读出,再把新状态压缩写回。预填充(prefill)也在每个 chunk 内使用 FP32 算术,chunk 结束时写入同样的压缩缓存,后续 chunk 读取该状态。因此,压缩不局限于解码阶段,但也不等于把矩阵更新算术都变成 INT8。(附录 A.4,PDF pp.16–17)
对 INT8 的一个 value 分组 $x$:
实际实现每个 key 通道独立处理,并沿 value 维每 32 个数一组;每组保存一个 FP32 scale,无 zero point。分组 scale 每次写状态时重新计算。它与离线固定的 SR 缩放系数是两种不同参数。(§3.2,Eqs.(5)–(6);附录 A.1,PDF p.15)
2.3 完整误差递推为什么不能只看当前误差
用 $S_t^q$ 表示压缩后重建的状态,定义累计误差 $\Delta S_t=S_t^q-S_t$,以及这次写回新引入的误差:
在使用同一组 $A_t,k_t,v_t,\beta_t$ 的递推比较中,有:
从 $\Delta S_0=0$ 展开:
这是原文的误差传播恒等式:旧误差要经过所有后续转移,当前误差只是其中一项。$A_t$ 同时含衰减和依赖 key 的 delta-rule 因子,后者还会改变误差方向、混合 key 行。(§3.3,PDF p.4,Eqs.(7)–(13))
分析上的区别:这条固定输入轨迹下的状态递推,和整模型自由生成时的输出误差不是同一对象;后者的上游激活和生成 token 也可能改变。DAMP 后面的评分进一步只保留衰减对误差能量的影响,因此是校准代理指标,并非上述矩阵乘积的精确计算或最终准确率的误差上界。
2.4 两个观测让静态分配变得可行
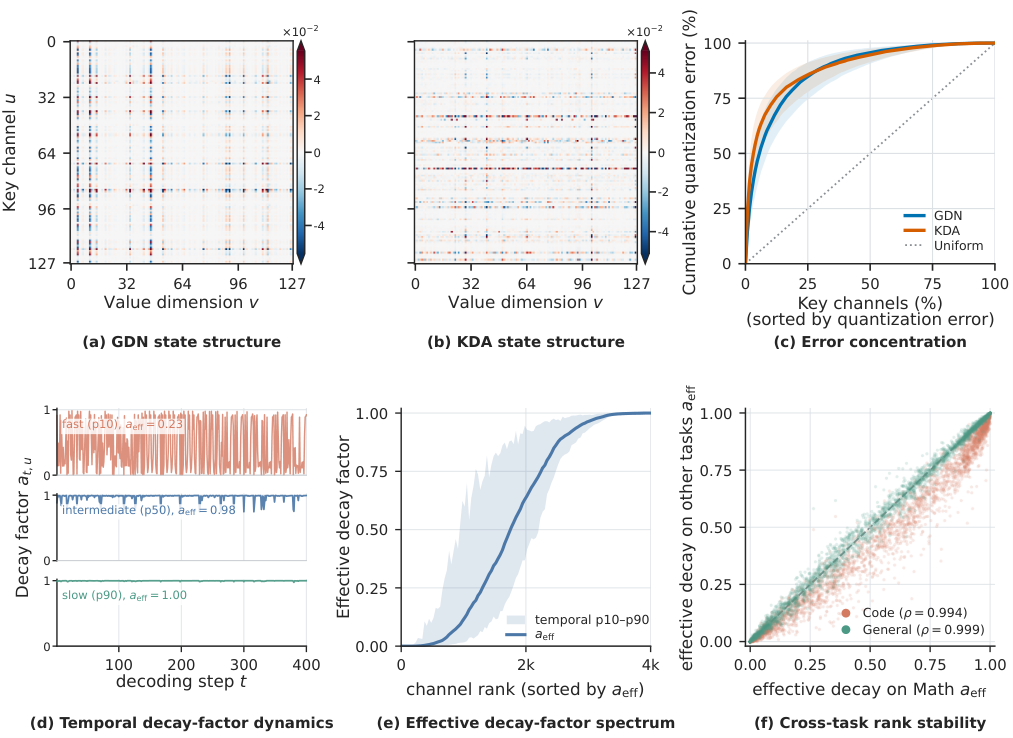
原文 Fig.2,PDF p.5。上排 (a–b) 的横轴是 value 维,纵轴是 key 通道,颜色表示状态数值,异常大值集中在部分行、列。(c) 将 key 通道按量化误差排序,横轴为累计通道比例,纵轴为累计平方误差比例:即使经过 SR,误差最高的 12.5% 通道仍贡献约 69% 的 GDN 误差、76% 的 KDA 误差。
SR 首先对 value 维做离线缩放,以缩小维间幅值差异,然后按缩放后的 RMS 幅值重排,把量级相近的值放进同一量化组。它已经很有效:Qwen 的 AIME 从 INT8 的 18.48% 提升至 INT8+SR 的 63.98%;但剩余误差仍明显集中,需要继续保护少量 key 行。(§4.1,PDF pp.4–5)
下排 (d) 展示三个 KDA 通道的逐步衰减,(e) 给出有效衰减的排序谱及时间分位范围,(f) 比较不同任务上的排序。有效衰减定义为几何均值:
数值接近 1 表示衰减弱、状态及其误差保留得久。KDA 在 Math 与 Code、General 间的 Spearman 排序相关分别为 0.994、0.999。这支持从离线样本估计“哪些通道经常保留误差”;它不要求所有时间步的衰减数值恒定。(§4.2,PDF pp.5–6)
2.5 DAMP 如何计算风险并挑选通道
在 FP32 参考轨迹的采样状态上,模拟低精度量化,恢复到原状态坐标后,测量第 $u$ 行的局部平方误差:
这里测的是参考状态上的量化误差;它与前节沿量化轨迹定义的 $R_t$ 有区别。对每个采样点再读取同一轨迹未来 $H=256$ 步的衰减,定义:
$e$ 的单位是状态数值的平方,$W$ 无量纲;$C$ 是对单次误差在当前及后续有限窗口中累计保留能量的估计。平方来自误差能量,开头的 1 对应当前状态。计算时先逐样本相乘,再平均,不能替换为 $\mathbb E[e]\mathbb E[W]$。(§5.1,PDF p.6,Eqs.(14)–(15))
教学例子:若某通道未来每步衰减固定为 $a$,则
$H=256$ 时,$a=0.5$ 的 $W\approx1.33$,$a=0.99$ 的 $W\approx49.96$。局部误差相同的两个通道,后者的评分约高 37.5 倍。这解释了为什么只按当下误差排序会漏掉“误差不最大,却长期不消失”的通道;实际方法使用观测到的逐步衰减,而非固定 $a$。
对每个层 $\ell$、头 $h$ 独立取分数最高的 $K_{\mathrm{hi}}=16$ 个 key 通道:
相同的高精度通道数有利于统一内存布局,但各头选择的通道身份不同,且推理时不再变化。这个 top-$K$ 在固定每头数量的条件下,最小化“留在低精度部分的 $C_u$ 之和”;它没有跨头重新优化高精度预算,也没有最小化包含完整递推动力学的真实输出误差。
GDN 的细节:同一头内所有通道共享 $W_t$,所以 retention-only 无法在头内排序。但 DAMP 使用 $\mathbb E_t[W_t e_{t,u}]$;若各通道误差出现的时间不同,时间变化的共同权重仍能改变排序。只有在权重恒定,或其与误差的关系满足额外条件时,才会退化到 error-only 的排序。(附录 D,PDF p.18)
2.6 校准不仅是算一次 top-$K$
每个模型使用 36 个训练集提示:MATH、APPS、ARC-Challenge 各 12 个;划为互不重叠的 fitting、parameter-selection、validation 三份,每份每领域 4 个提示。每条输入 1,024 tokens,FP32 状态下固定生成 4,096 tokens,抑制提前终止。
在解码位置 0、2,048 开始的两个窗口中,各记录 1,024 次更新;每窗在第 256、512、768 次更新后取 anchor,并保留其后 256 次衰减。因此每条序列 6 个 anchor,每份数据 72 个。(附录 A.2,PDF p.15)
对每个 SR 候选配置 $c$:
- 用 fitting 集的 RMS 统计构造缩放和 value 排列,在该集合上计算 $C^{(c)}$ 并选出保护集合 $\mathcal H_c$。
- 冻结集合,在 parameter-selection 集评价完整混合精度配置:
- 选 $J(c)$ 最小的候选;保留其 fitting 阶段选出的集合和排列,再用独立 validation 集评价冻结配置。
两个精度的误差都在原始状态坐标中测量,因此不会让单纯缩小数值的变换获得虚假的误差优势。校准对 anchor、窗口、序列和领域做分层等权平均。作者报告校准约需 Qwen 7 分钟、Kimi-Linear 9 分钟、Kimi-K3 78.75 分钟。(Eq.(16),Algorithm 1,PDF pp.15–16)
2.7 静态变换和融合内核如何兑现收益
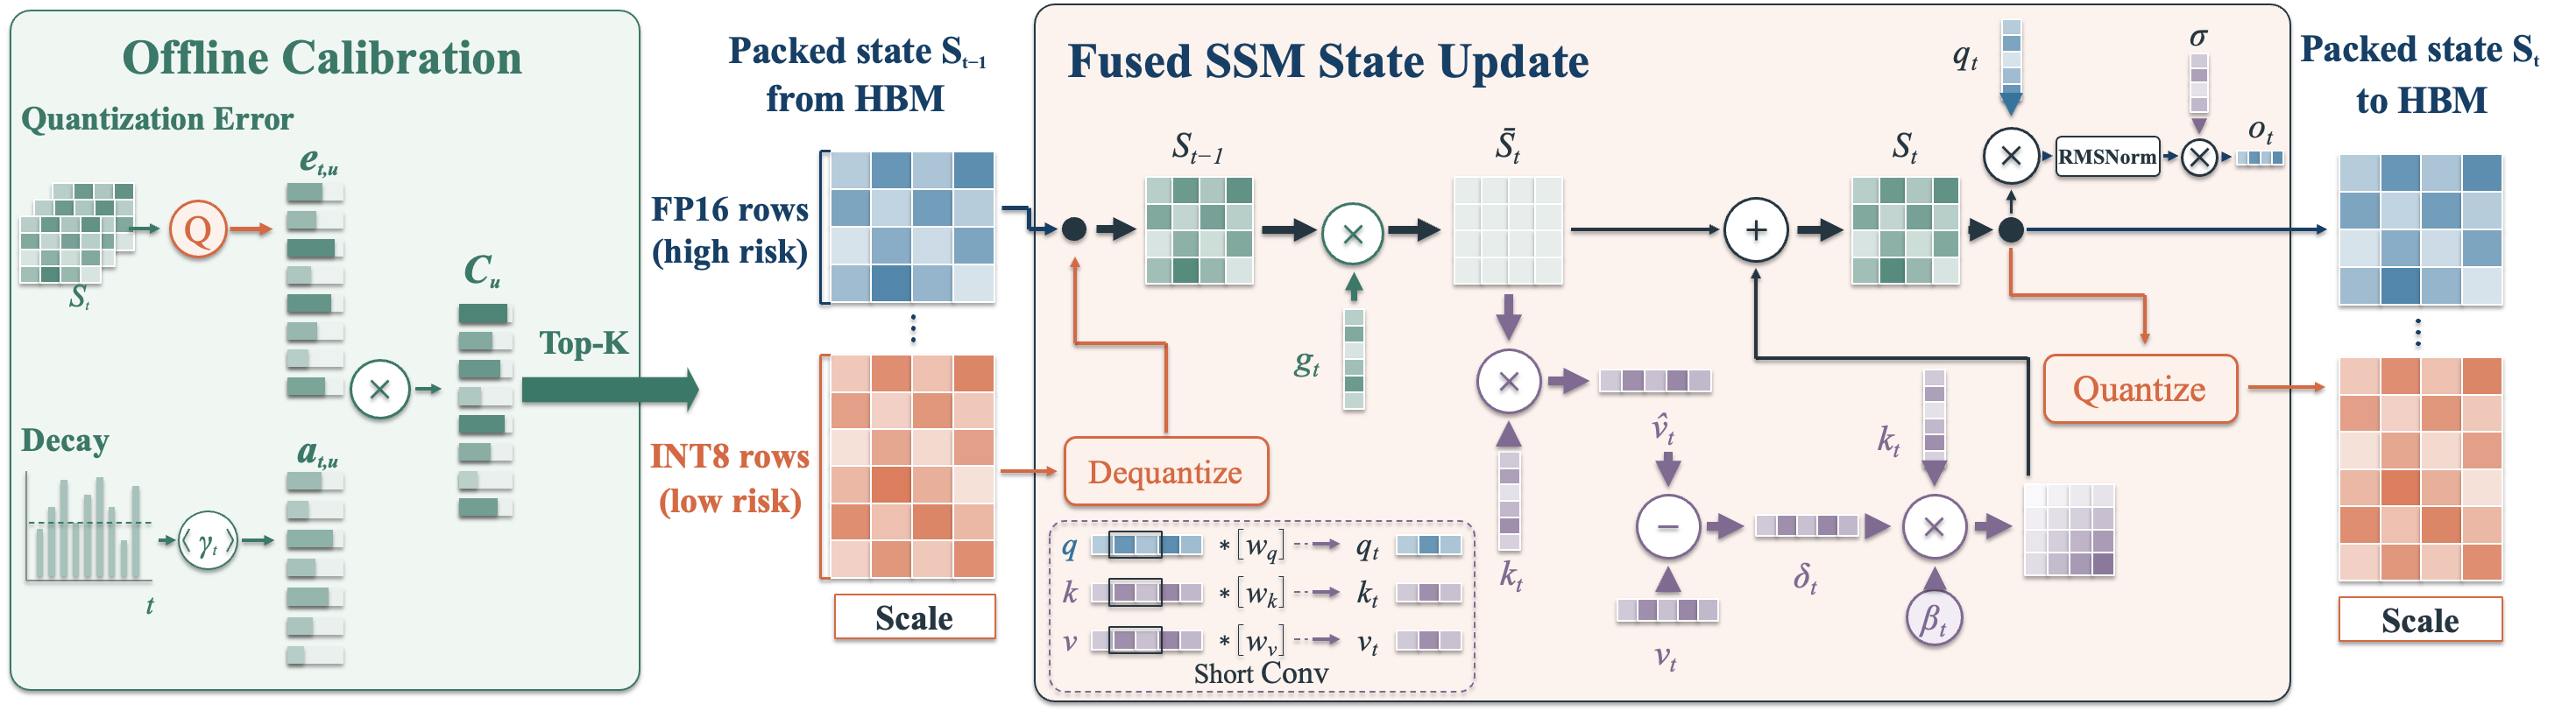
原文 Fig.3,PDF p.6。左侧离线选高风险行,中间从显存读取连续的 FP16 区和 INT8 区,融合执行重建、递推、读出与重新量化,右侧写回压缩状态。图中的两类存储区域对应该头的固定通道划分。
记 key、value 的置换矩阵分别为 $P_K,P_V$,value 缩放矩阵为 $D_c=\operatorname{diag}(c_1,\ldots,c_{d_v})$,$c_v>0$。缓存保存变换后的状态:
在这个坐标中:
读出时恢复 value 数值尺度,再让归一化与门控使用相同的排列;输出投影改为 $W'_O=W_OP_V^\top$,吸收逆排列。配套变换初始状态后,不考虑量化时与原模块功能等价。query/key/value 投影以及相关卷积、门控、归一化参数在推理前调整,避免每一步显式搬动整块状态。value 缩放与恢复融合进更新和读出。(附录 A.3,PDF p.16,Eqs.(17)–(18))
实际内核在寄存器中复用状态 tile,连续读取 FP16 和 INT8 区,低精度区连同每组 FP32 scale 一起写回。选择 FP16 作为保护格式的依据是其在相同 16-bit 存储下平均优于 BF16;论文据此认为这类状态更受益于更细的数值分辨率。(§5.2,PDF p.7;附录 A.4)
2.8 9.9 bits 是怎样算出来的
有效位数必须包括分组参数,不能只看格式名字:
| 存储方案 | 每组参数 | 论文报告的有效 bits/value |
|---|---|---|
| FP32 / FP16 / BF16 | 无分组参数 | 32 / 16 / 16 |
| INT8,32 值/组 | 一个 FP32 scale | $8+32/32=9$ |
| FP8 E4M3,32 值/组 | 一个 FP32 scale;不使用 SR | 9 |
| INT4,32 值/组 | FP32 scale 和 FP32 zero point | $4+64/32=6$ |
| NVFP4,16 值/块 | 一个 E4M3 block scale,另有 FP32 global scale | 约 4.5 |
| DAMP INT8 | 高精度行 FP16,其余为上述 INT8+SR | 约 9.9 |
按原文配置展开的存储计算:16/128,即 12.5% 的 key 行采用 FP16,其他行的有效位数为 9,则
相对 INT8+SR 只多 0.875 bits/value,相对 FP16 仍节省约 38.3% 的状态空间。这里计算的是循环状态表示及其分组 scale,不包括模型权重、其他注意力层 KV cache 或所有服务系统开销。(Table 1,PDF p.7;附录 A.1、A.4)
三:实验——准确率、内核与服务收益分别怎么测
3.1 模型和对照的角色
| 模型 | 架构组成 | 准确率测试 |
|---|---|---|
| Qwen3.6-35B-A3B | 30 GDN + 10 full-attention 层,约 3B 激活参数 | 六个基准 |
| Kimi-Linear-48B-A3B-Instruct | 20 KDA + 7 MLA 层,约 3B 激活参数 | 六个基准 |
| Kimi-K3 | 2.8T 总参数、104B 激活参数;69 KDA + 24 gated MLA 层 | AIME、HMMT |
所有状态方案在 SGLang 中实现,以默认 FP32 状态为参考。FP16/BF16 检查单纯减半存储是否足够;FP8/INT8 检查均匀低精度;INT8+SR 分离预处理的贡献;INT4/NVFP4 检查更激进压缩;同为 9.9 bits 的选择器消融再分离“选哪些通道”的贡献。(§6.1,PDF pp.7–8)
准确率指标均越高越好。AIME 2026 I/II、HMMT February 2026、IMO-AnswerBench 测数学;GPQA-Diamond、MMLU-Pro 测一般推理;LiveCodeBench-v6(LCB)测代码。每题多次随机生成,不能把“每题生成 128 次”解读为 pass@128。主表报告准确率百分比,但没有明确展开跨题/生成样本的聚合公式。(附录 A.5,PDF p.17)
| 基准 | Qwen / Kimi-Linear 每题生成数 | Kimi-K3 每题生成数 |
|---|---|---|
| AIME 2026 | 128 | 16 |
| HMMT | 64 | 8 |
| IMO-AnswerBench | 16 | — |
| GPQA-Diamond | 32 | — |
| MMLU-Pro | 16 | — |
| LCB-v6 | 8 | — |
Qwen 和 Kimi-Linear 使用 thinking mode。Qwen 的 temperature/top-p/top-k 为 0.6/0.95/20,最大输出 65,536 tokens;Kimi-Linear 为 1.0/1.0/不截断 top-k,最大输出 262,144 tokens;K3 为 temperature 1.0、top-p 0.95、presence/frequency penalty 均为 0,最大输出 262,144 tokens。这里是任务准确率设置,不能与后面的 64-token 性能负载混用。(Table 5,附录 A.5)
3.2 两类性能实验
解码实验:ShareGPT-V3 请求,输入固定 256 tokens、输出 64 tokens,batch size 从 16 到 256。Qwen、Kimi-Linear 使用 TP1/DP8,K3 使用 TP8/DP1。内核延迟按微秒/层衡量,包含状态加载、反量化、量化和写回;整模型指标为 TPOT,相对 FP32 的降幅越大越好。(§6.3,PDF p.9)
多轮服务实验:K3 处理 WildChat-1M 的 256 个四轮对话,共 1,024 个请求;每轮输出长度对齐数据集响应,上限 1,024 tokens,生成结果进入下一轮输入。启用 SGLang prefix caching,在循环状态与 KV cache 的固定总内存预算下比较首次 token 延迟(TTFT)的均值、P95,以及按 token 计算、跨四轮的平均缓存命中率。(Table 3,PDF p.9;附录 E,p.19)
长上下文补充实验使用 RULER 的 4K–128K 输入,报告 macro accuracy,各格式贯穿 prefill 和 decode。它与长链数学生成考察的负载不同。(附录 B,PDF p.17)
四:结果——恢复了多少准确率,收益来自哪里
4.1 Qwen:SR 必要,但保护少量通道才补回主要差距
以下为原文 Table 1 的 Qwen3.6-35B-A3B 分组,PDF p.7;准确率单位均为 %,越高越好。“IMO”为 IMO-AnswerBench,“GPQA”为 GPQA-Diamond。
| 状态格式 | bits | AIME | HMMT | IMO | GPQA | MMLU-Pro | LCB |
|---|---|---|---|---|---|---|---|
| FP32 | 32 | 85.46 | 57.57 | 50.29 | 81.97 | 84.66 | 86.95 |
| FP16 | 16 | 84.58 | 55.82 | 49.42 | 82.13 | 84.61 | 86.80 |
| BF16 | 16 | 79.71 | 54.97 | 43.71 | 81.66 | 84.65 | 84.10 |
| FP8 | 9.0 | 29.27 | 14.06 | 10.23 | 76.26 | 77.66 | 15.02 |
| INT8 | 9.0 | 18.48 | 20.12 | 16.38 | 79.48 | 83.88 | 32.23 |
| INT8+SR | 9.0 | 63.98 | 50.09 | 39.31 | 81.89 | 84.59 | 64.51 |
| NVFP4 | 4.5 | 0.03 | 0.05 | 0.98 | 16.57 | 9.31 | 1.02 |
| INT4 | 6.0 | 0.07 | 0.14 | 1.03 | 28.69 | 32.19 | 0.85 |
| INT4+SR | 6.0 | 0.03 | 0.09 | 1.02 | 24.59 | 13.28 | 0.02 |
| DAMP INT8 | 9.9 | 83.82 | 55.11 | 48.89 | 82.05 | 84.57 | 85.67 |
AIME 的恢复链最直观:18.48 → 63.98 → 83.82,依次对应 INT8、INT8+SR、DAMP。DAMP 相对 INT8+SR 增加 19.84 个百分点,仍低于 FP32 1.64 个百分点。LCB 相对 INT8+SR 增加 21.16 个百分点,与 FP32 相差 1.28 个百分点;HMMT 的差距为 2.46 个百分点。
任务间敏感度差异很大:INT8+SR 在 GPQA/MMLU-Pro 分别只比 FP32 低 0.08/0.07 个百分点,但在 AIME/LCB 低 21.48/22.44 个百分点。因此只看通用问答分数,会严重低估循环状态量化对复杂生成任务的影响。4-bit 的失败也应具体理解为数学、代码结果接近崩溃,而非所有基准都变为零。
4.2 Kimi-Linear 与 K3:接近 FP32,但覆盖范围不同
原文 Table 1 的 Kimi-Linear-48B-A3B-Instruct 分组:
| 状态格式 | bits | AIME | HMMT | IMO | GPQA | MMLU-Pro | LCB |
|---|---|---|---|---|---|---|---|
| FP32 | 32 | 62.34 | 38.02 | 28.04 | 64.17 | 68.48 | 61.17 |
| FP16 | 16 | 63.07 | 37.83 | 28.10 | 64.74 | 68.42 | 60.58 |
| BF16 | 16 | 58.56 | 32.77 | 25.37 | 63.48 | 68.51 | 60.79 |
| FP8 | 9.0 | 29.47 | 13.16 | 11.20 | 54.26 | 56.90 | 22.16 |
| INT8 | 9.0 | 49.90 | 27.08 | 22.21 | 63.22 | 68.37 | 57.97 |
| INT8+SR | 9.0 | 58.07 | 32.05 | 24.67 | 62.61 | 68.47 | 59.49 |
| NVFP4 | 4.5 | 3.38 | 1.47 | 3.31 | 46.75 | 58.47 | 6.04 |
| INT4 | 6.0 | 7.50 | 2.46 | 6.53 | 46.65 | 61.00 | 0.79 |
| INT4+SR | 6.0 | 0.52 | 0.47 | 2.42 | 40.02 | 55.68 | 2.49 |
| DAMP INT8 | 9.9 | 62.94 | 38.54 | 27.75 | 64.56 | 68.64 | 61.02 |
DAMP 相对 INT8+SR 的 AIME/HMMT 分别提高 4.87/6.49 个百分点;相对 FP32,六个基准的差异介于 −0.29 与 +0.60 个百分点。表中的小幅正差值适合解释为接近 FP32,而不是量化稳定提升模型能力;正文表没有给出置信区间。
Kimi-K3 的结果如下,来自 Table 2,PDF p.8:
| 状态格式 | bits | AIME 2026 | HMMT |
|---|---|---|---|
| FP32 | 32 | 96.88 | 97.92 |
| BF16 | 16 | 97.29 | 96.78 |
| FP8 | 9.0 | 59.83 | 40.91 |
| INT8 | 9.0 | 89.17 | 82.58 |
| INT8+SR | 9.0 | 93.96 | 91.67 |
| INT4 | 6.0 | 4.38 | 7.58 |
| DAMP INT8 | 9.9 | 97.50 | 97.35 |
这支持向更大 KDA 混合模型扩展的可行性。K3 的 BF16 本身也接近 FP32;作者推测 BF16 状态的量化感知训练可能有所帮助,但没有在本文中验证这一因果解释。(§6.2,PDF pp.8–9)
4.3 内核加速明显,整模型收益受其他成本限制
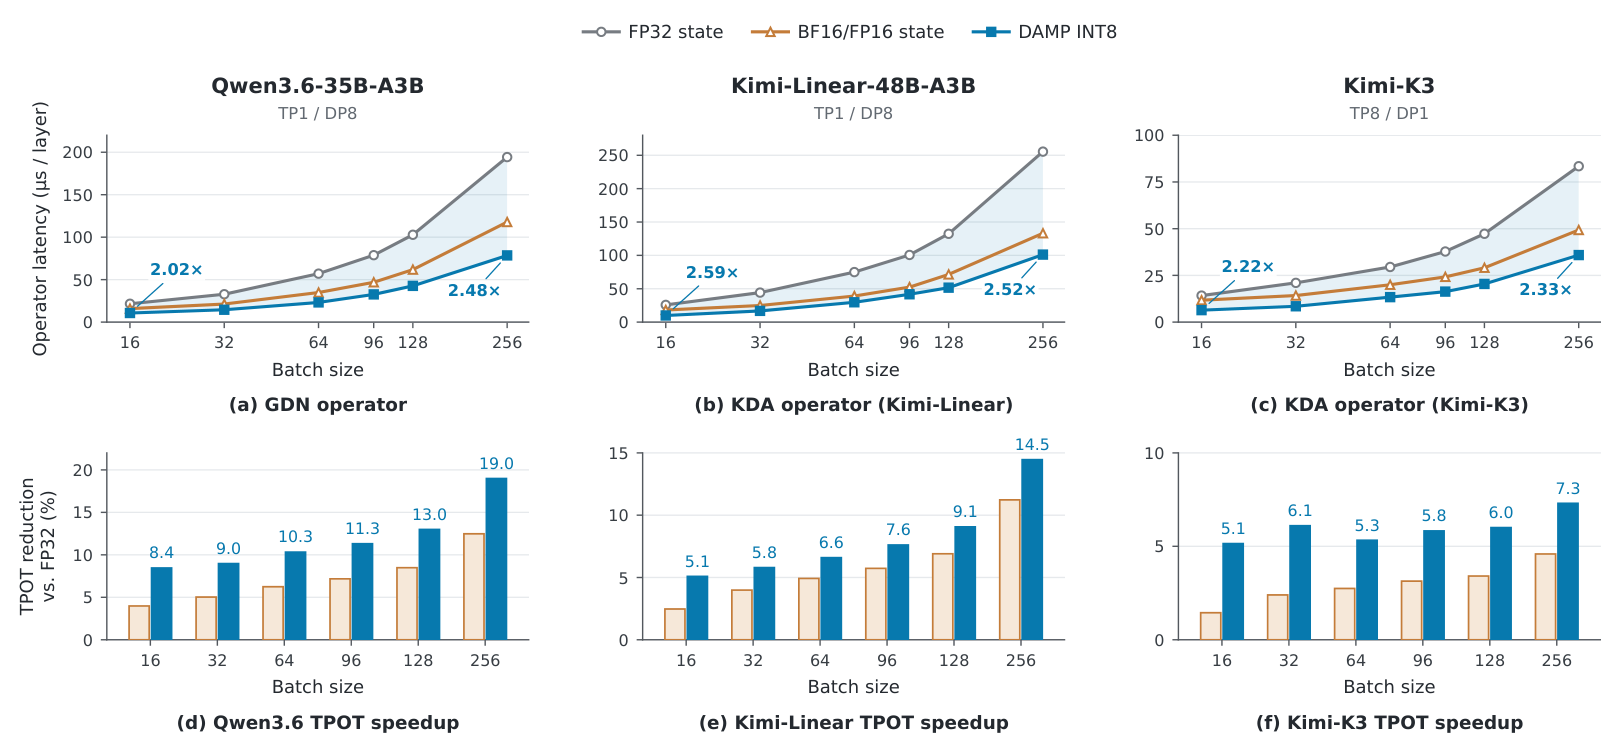
原文 Fig.4,PDF p.8。三列依次为 Qwen、Kimi-Linear、K3;上排纵轴是微秒/层,越低越好,下排为相对 FP32 的 TPOT 降幅,越高越好;横轴均为 batch size。灰线为 FP32,橙色为 16-bit,蓝色为 DAMP。图中 2.59× 出现在 Kimi-Linear、batch 16 的内核比较,不能与 batch 256 的最大整模型收益混为一个实验点。
| 模型 | batch 256 的内核加速比,相对 FP32 | batch 256 的整模型 TPOT 降幅 |
|---|---|---|
| Qwen3.6 | 2.48× | 19.0% |
| Kimi-Linear | 2.52× | 14.5% |
| Kimi-K3 | 2.33× | 7.3% |
循环更新之外还有 GEMM、其他注意力及通信,因此加快一个内核不会按同一倍数加快全模型。作者认为 K3 的 TP8 通信开销可能部分解释较小的 TPOT 降幅。19.0% 的耗时下降对应约 $1/0.81=1.235$ 倍的倒数吞吐关系,但论文直接报告的是耗时降幅,不是“整模型 2.59×”。(§6.3,PDF p.9)
4.4 多轮服务:状态压缩还能换取更多缓存复用
固定状态与 KV cache 的总内存预算,K3 的多轮结果如下:
| 状态格式 | 平均 TTFT / 秒 ↓ | P95 TTFT / 秒 ↓ | 平均 token 缓存命中率 / % ↑ |
|---|---|---|---|
| FP32 | 38.427 | 72.471 | 47.20 |
| BF16 | 35.646 | 69.500 | 56.96 |
| DAMP | 30.464 | 61.559 | 65.29 |
相对 FP32,平均 TTFT 下降 20.7%,命中率增加 18.09 个百分点;相对 BF16,平均 TTFT 下降 14.5%。这说明固定显存下的收益不只有更快读写:更小的状态还能与更多前缀缓存共存,减少后续轮次的重复计算。(Table 3,PDF p.9;附录 E)
4.5 选择器消融:衰减信息带来额外收益
固定 INT8+SR 量化器和 9.9-bit 预算,Kimi-Linear 的比较为:
| 高精度通道选择依据 | AIME | GPQA-D | LCB-v6 |
|---|---|---|---|
| 随机 | 59.06 | 62.12 | 58.68 |
| 状态能量 | 60.36 | 63.38 | 59.67 |
| 局部误差 error-only | 61.40 | 63.85 | 60.34 |
| 保留权重 retention-only | 61.22 | 63.69 | 60.69 |
| DAMP:$\mathbb E[eW]$ | 62.94 | 64.56 | 61.02 |
DAMP 相对 error-only 分别提高 1.54、0.71、0.68 个百分点;比随机保护通道更明显。这组同预算实验直接支持结合误差与保留程度的选择方法。(Table 4,PDF p.9)
GDN 补充结果只报告随机、状态能量、DAMP 三种选择器:AIME 为 66.59/82.19/83.82,GPQA 为 80.98/81.37/82.05,LCB 为 66.88/85.17/85.67。GDN 下 DAMP 相对状态能量有额外改善,但该表没有 error-only 行,因此不能把 KDA 的 error-only 对比幅度套到 GDN。(Table 8,PDF p.19)
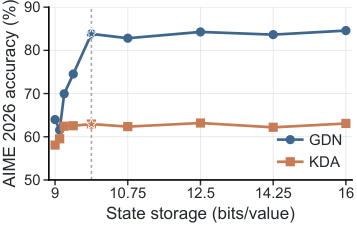
原文 Fig.5,PDF p.9。横轴为有效状态位数,随 FP16 通道数量增加而上升;纵轴为 AIME 准确率;蓝线 GDN、橙线 KDA。增加高精度预算总体有效,但超过 $K_{\mathrm{hi}}=16$ 后收益有限,曲线也并非严格单调。主配置据此采用 16 个通道,而非把全部状态改为 FP16。
4.6 长上下文与校准稳定性补充了什么
RULER 的完整结果来自 Table 6,PDF p.17,单位为 macro accuracy %:
| 模型 / 状态格式 | 4K | 8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|
| Qwen FP32 | 96.96 | 96.94 | 96.65 | 96.56 | 96.32 | 96.13 |
| Qwen FP16 | 96.98 | 96.94 | 96.65 | 96.56 | 96.32 | 96.11 |
| Qwen INT8+SR | 96.93 | 96.89 | 96.60 | 96.43 | 96.28 | 96.07 |
| Qwen DAMP | 97.00 | 96.94 | 96.65 | 96.56 | 96.32 | 96.10 |
| Kimi-Linear FP32 | 95.27 | 94.44 | 93.53 | 92.37 | 91.44 | 88.02 |
| Kimi-Linear FP16 | 95.27 | 94.44 | 93.53 | 92.37 | 91.44 | 88.03 |
| Kimi-Linear INT8+SR | 95.27 | 94.35 | 93.41 | 92.24 | 91.36 | 87.87 |
| Kimi-Linear DAMP | 95.27 | 94.42 | 93.53 | 92.36 | 91.44 | 88.02 |
DAMP 与 FP32 的最大绝对差为 Qwen 0.04、Kimi-Linear 0.02 个百分点;INT8+SR 则为 0.13、0.15。这里连均匀 INT8+SR 都很稳,说明“能处理长输入”与“在复杂长生成中维持准确率”应分别评估,而不能只用上下文长度解释量化敏感度。
将校准语料分为两个不重叠、领域平衡的子集,分别选通道后:
| 架构 | 平均共同 top-16 通道数 | 保护集合重合率 | 完整排名 Spearman |
|---|---|---|---|
| KDA | 14.72 | 92.0% | 0.990 |
| GDN | 14.91 | 93.2% | 0.986 |
| 随机选择期望 | 2.00 | 12.5% | — |
这比单看衰减跨任务排序更接近实际部署问题:最终被保护的集合对校准样本划分也较稳定。(Table 7,PDF p.18)
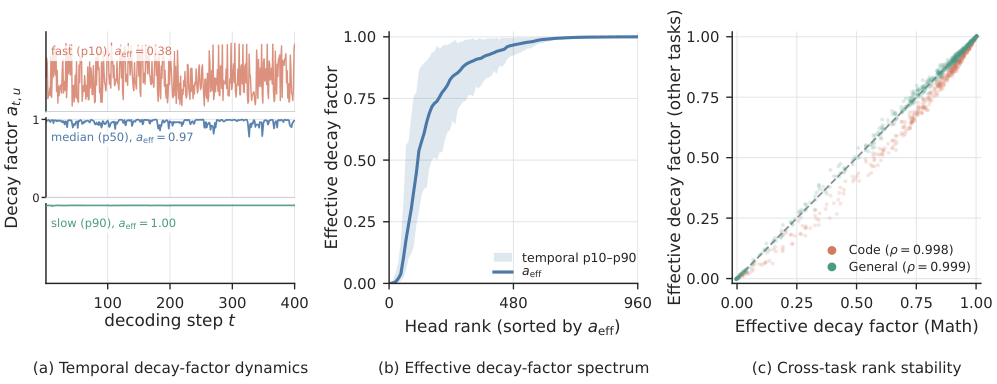
原文 Fig.6,PDF p.18。共统计 Qwen 的 30 层、960 个 GDN 头;横轴从逐步时间、头排序到跨任务比较,纵轴为衰减或有效衰减。有效衰减的第 10/50/90 百分位为 0.376/0.967/0.9996,头间差异很大;Code、General 相对 Math 的头排序相关为 0.998、0.999。这里的稳定对象是“头”,与 KDA 的“头内 key 通道”不同。
五:结论——贡献、取舍与后续问题
DAMP 最有价值的思路是把循环状态量化当成一个动态误差问题:不仅问一个数现在被压缩得多差,还问这次误差在后续计算中会保留多久。论文将这一思路做成小样本离线校准、固定每头预算、静态布局和 FP32 融合更新,在三种 GDN/KDA 模型上给出准确率与系统证据。
实际取舍也很清楚:相对 FP32,状态容量减少约 69.1%;相对已经很准的 FP16,还能减少约 38.3%,代价是量化和静态布局的实现复杂度。若只观察一般问答或 RULER,均匀 INT8 方案容易显得已经足够;数学和代码任务揭示了保护高风险通道的价值。
会影响进一步使用的几个问题是:
- 评分忽略了部分递推动力学。 完整 $A_t$ 中的 key 相关擦除和通道混合没有进入 $C_u$,$H=256$ 也是固定有限窗口。将这些因素纳入评分,或比较更长预测窗口,是方法上的直接延伸。
- 统一每头 16 行是实现与分配自由度的折中。 GDN 头间的衰减差别很大,但所有头仍分到相同数量的 FP16 行。若在相同总字节数下跨头分配预算,是否值得承担更不规则的内存布局,本文尚未回答。
- 4-bit 压缩仍不成熟。 均匀 INT4/NVFP4 的任务退化严重;附录 F 也明确表示以这些格式作为低精度部分的 DAMP 变体尚未恢复 FP32 准确率。
- 绝对性能复现还缺少关键配置。 正文和附录给出了 batch、TP/DP 与负载,但没有明确 GPU 型号,以及多轮实验总内存预算的具体数值;SR 候选缩放因子的构造也只描述到 RMS 统计层面。因此适合先把论文给出的配置内相对收益作为证据,再在目标硬件和服务预算上测量部署效果。(§6.3;附录 A.2、E、F)
最适合在组会追问的是:在同样的约 9.9-bit 预算下,加入 key 方向信息、跨头预算分配、或更细粒度的误差目标,哪一种能以最小实现成本进一步缩小 Qwen 数学任务上的剩余差距?