Puro-2B:低成本从零预训练的系统、优化与数据配方
论文:Puro-2B: Poor Lab’s Qwen2-1.5B Trained on RTX 5090 within $5090
作者:Kairong Luo、Jiarui Cui、Yaorui Yin、Shengqi Chen、Yiming Yang、Linxiang Gao、Yanmohan Wang、Chengxia Li、Mingzhe Zhang、Kaifeng Lyu、Wenguang Chen(清华大学、鹏城实验室)。
版本:arXiv:2608.27370v2,2026-09-03 修订;研读日期:2026-10-14。
来源:arXiv v2 · 本地原文 PDF · 英文汇报 PDF · 可编辑 TeX。下文页码均为从 1 开始的 PDF 页码。
论文总览
Puro-2B 研究的是:能否把十亿参数、万亿 token 级别的从零预训练,做成小型研究组能重复运行的开放实验平台? 作者将消费级 RTX 5090 集群、分块 FP8、MuonH、学习率调度、数据筛选和课程模型平均(Curriculum Model Averaging,CMA)组织成一套配方。模型采用 Qwen3-1.7B 的架构配置,但取消输入嵌入与输出头的权重共享,参数量约 2B;训练从随机初始化开始。标题里的 Qwen2-1.5B 是性能参照。
两个应分开理解的结果如下。成本指训练数据已准备好以后,重跑一次定稿预训练流程的 GPU 折算成本;性能是作者协议下 15 项基准的等权平均。
| 模型端点 | 总训练 token | GPU-hours | 折算成本 | Avg15 ↑ | 对照 |
|---|---|---|---|---|---|
| Puro-2B UD,Phase 2 半预算 | 918.83B | 14,262 | $4.37K,约 $4.4K | 55.54 | Qwen2-1.5B 为 55.14 |
| Puro-2B CMA,正式发布端点 | 约 1.40T | 22,514 | $6.89K,约 $6.9K | 57.81 | Qwen2.5-1.5B 为 60.73 |
来源:Table 1,p.6;Tables 4–5,pp.21–22;Tables 18–19,p.53。Qwen 的 Avg15 由表中 15 个分数取均值。因此,“低于 $5,090”有一个实际训练端点支持;“最佳模型接近 Qwen2.5”对应更高的 $6.9K 预算,并仍有约 2.91 个百分点的综合差距。
论文最有启发的机制证据有两条:普通 Muon 在对齐有效学习率后,几乎复现了 MuonH 的末端损失;而课程学习的收益需要连同末段学习率和 checkpoint 平均一起分析,单独平均权重并非总能改善结果。研究贡献主要是配方整合、可追踪的成本与训练证据,以及由此支持的预训练—后训练对照实验;FP8、Hyperball 与 CMA 的基本思想均有前作来源。
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码及关键证据 |
|---|---|---|
| 1 Introduction;2 Overview | 定义低成本开放预训练目标、完整流程、成本边界 | pp.4–8;Figs.2–3,Table 1 |
| 3.1 Training Infrastructure | 5090 拓扑、通信与并行策略 | pp.8–11;Table 2 |
| 3.2 FP8 Mixed-Precision Training | 数值格式、量化粒度与精度保留 | p.11;Fig.14,p.43 |
| 3.3 Hyperball Optimization | 有效学习率、对齐诊断、生产调度 | pp.11–15;Eqs.(1)–(5),Figs.4–6 |
| 3.4 Curriculum Model Averaging | 源内排序、恒定学习率续训、模型平均 | pp.15–16;Fig.7 |
| 3.5 Post-Training Recipe;3.6 Data Recipe | SFT 对照设计、代理数据实验与静态分片 | pp.16–19;Figs.8–9 |
| 4.1 Evaluation Setup;4.2 Resulting Performance | 统一基准协议与基座能力 | pp.20–22;Tables 4–5 |
| 4.3 Cost Estimation;4.4 Post-Training | 成本因子、成本曲线和 SFT 后效果 | pp.22–25;Figs.10–11 |
| 5 Related Works;6 Conclusion and Future Direction | 开放配方定位与后续方向 | pp.25–27 |
| A Limitations;B Cost Assumptions | 污染、适用规模、价格与跨模型核算 | pp.38–40;Tables 6–7 |
| C Training Details;D Scaling Ladder | 生产参数、五规模实验与拟合 | pp.40–45;Tables 8–11,Figs.12–15 |
| E Post-Training Details;F LR Schedule Analysis | SFT 重复实验、MPL、WSD 调度诊断 | pp.45–52;Tables 12–17,Figs.16–19 |
| G Scaling Checkpoint Ledger;H Curriculum and CMA;I Data Recipe | 各端点台账、课程实现、数据与代理结果 | pp.52–63;Tables 18–24,Fig.20 |
一:动机——让开放配方能够被重跑
开源权重让研究者部署和微调模型,开放配方进一步提供数据、配置、训练代码和中间状态。但如果重跑训练依然需要很高预算,预训练方法研究仍然难以进行。Puro-2B 希望提供一个足够有能力、又能承担重复实验成本的基座,从而研究数据顺序、优化器和后训练之间的关系。(Secs.1、5,pp.4–6、25–26。)
作者同时优化三个量:获得目标能力需要多少训练工作、硬件执行这些工作有多快,以及每 GPU-hour 的价格。本文的解释性拆分可以写成:
这不是论文额外拟合的公式,而是理解配方的教学拆分。数据和优化影响分子,FP8 与系统调优影响吞吐,5090 的本地成本假设影响时间价格。各项存在交互,例如较小矩阵会限制 FP8 的实际加速,低通信带宽又决定了并行策略。
二:方法——完整训练链条怎样工作
2.1 模型与两阶段训练
生产模型是约 2B 参数的稠密 decoder-only Transformer,采用 Qwen3-1.7B 架构并解除 embedding/LM head 共享。两个阶段都使用 4,096 长度、全局 batch 1,536 条序列、micro-batch 2,因此每个完整优化步处理:
| 配置 | Phase 1 | Phase 2,全预算 |
|---|---|---|
| 训练 token | 438.84B | 959.99B |
| GPU 数量 | 24 | 96 |
| TP / PP / DP | 1 / 2 / 12 | 1 / 4 / 24 |
| pipeline 层数分配 | 18 / 10 | 9 / 9 / 9 / 1 |
| 每 GPU 中位吞吐 | 238 TFLOP/s | 192 TFLOP/s |
| 基础学习率主轨迹 | $5\times10^{-3}\to1.04\times10^{-3}$,power | $1.04\times10^{-3}\to10^{-5}$,linear |
| 活跃训练时间折算 | 10.43 天 | 7.16 天 |
来源:Table 1,p.6;Sec.3.1.3,pp.10–11;Table 8,p.40。TP、PP、DP 分别为张量并行、流水线并行、数据并行。末段 CMA 会替换 Phase 2 主轨迹的最后一部分学习率,见 2.7。扩展到 96 卡后单卡吞吐下降,反映更高的梯度同步占比;更多 GPU 主要缩短这一阶段的用时。
2.2 消费级 GPU 的通信和内存限制决定了系统设计
RTX 5090 每卡 32 GB 显存,无 NVLink。作者的系统有两层适配。(Sec.3.1,pp.8–11。)
首先是硬件通信路径。在所用机器上,开启 P2P 后单向点对点带宽从 31.5 提升到 56 GB/s,双向从 32 提升到 111 GB/s,延迟从 14.3 降到 0.4 微秒。8 卡 AllReduce 的 busbw 从 14.75 增至 27.34 GB/s。节点间使用 400 Gbps InfiniBand;启用 GDR 后,24 卡 AllReduce 的 busbw 从约 8.87 增至 19.93 GB/s。
这些数字对应作者特定拓扑和驱动修改。GDR 修改细节因作者所述 EULA 限制未公开;标准驱动能运行同一训练配方,但通信性能较低。因此,报告中的训练吞吐需要连同这项部署依赖一起理解。
其次是软件并行和内存安排:只用 DP+PP,避免每层频繁通信的 TP;将 PP 组放到拓扑更近的 GPU;把较少的 Transformer 层分给包含大型 LM head 的 pipeline stage。优化器状态也做按显存占用的分配,优先保持 Muon 矩阵完整,再填入 Adam 参数,从而适配 32 GB 显存。micro-batch 则根据 kernel 的实际形状和吞吐拐点选择。
论文报告约 73% 的 MFU 使用精度加权峰值:
72% 与 28% 是 FP8/BF16 理论 Tensor Core 工作占比;这里按执行时间加权,得到调和形式的峰值。73% 对应 Phase 1 的混合精度口径,不能当作 96 卡上的 BF16-only MFU。(Sec.3.1.3,p.11。)
2.3 FP8 的边界:计算与保存激活用低精度,关键状态留在高精度
从随机初始化起,主要 Transformer 线性层就采用 FP8,无 BF16 预热后再切换的阶段。QKV、attention output、MLP 投影的前向、输入梯度和权重梯度 GEMM 都走 FP8 路径;core attention、残差流和模型 checkpoint 仍有 BF16 表示,master weights、优化器状态以及梯度累加等使用高精度。(Sec.3.2,p.11;Fig.14,p.43。)
| 对象 | 量化或精度安排 | 目的 |
|---|---|---|
| GEMM 输入激活及激活梯度 | E4M3,沿 reduction 维每 128 个值一组 | 限制异常值对整张量 scale 的影响 |
| GEMM 权重 | E4M3,每 $128\times128$ block 一个 scale | 局部动态范围适配 |
| block scale | 2 的幂,具有 E8M0 式指数表达能力 | 在 Blackwell 的原生 MXFP8 路径执行 |
| 周边输出、通信张量、发布前训练权重 | BF16 | 与混合精度训练其余路径衔接 |
| softmax、梯度/优化器状态累加等 | FP32 | 保持数值稳定性 |
分块 scale 使普通值不必与少数 outlier 共用一个过大的量化间隔。低精度保存线性层输入还减少反向所需的激活显存。这里约 72% 的计算走 FP8;模型整体并不是始终以 FP8 保存。精度和加速的实验证据见 4.2。
2.4 数据代理实验:用能力向量选择来源,再人工确定混合比例
作者没有给所有来源建立统一的“质量分数”。他们先用共同的 Qwen3-0.6B 架构 checkpoint 做 continuation proxy:该 checkpoint 已在基础混合上训练 86B tokens,每个候选切片再续训 2,000 步,长度 4,096、全局 batch 1,024,约 8.4B tokens。候选数据比例按下式从 0 增至 80%,其余为基础混合 replay:
大于 50B tokens 且有质量标签的来源取四个分位附近的局部切片;5B–50B 或更大但无可用标签的来源随机取约 4B tokens;更小来源不进入该代理比较。共 39 个切片,以 Math、Code、Chinese、General 四维能力画像辅助筛选。(Sec.3.6,pp.17–19;App.I,pp.60–63。)
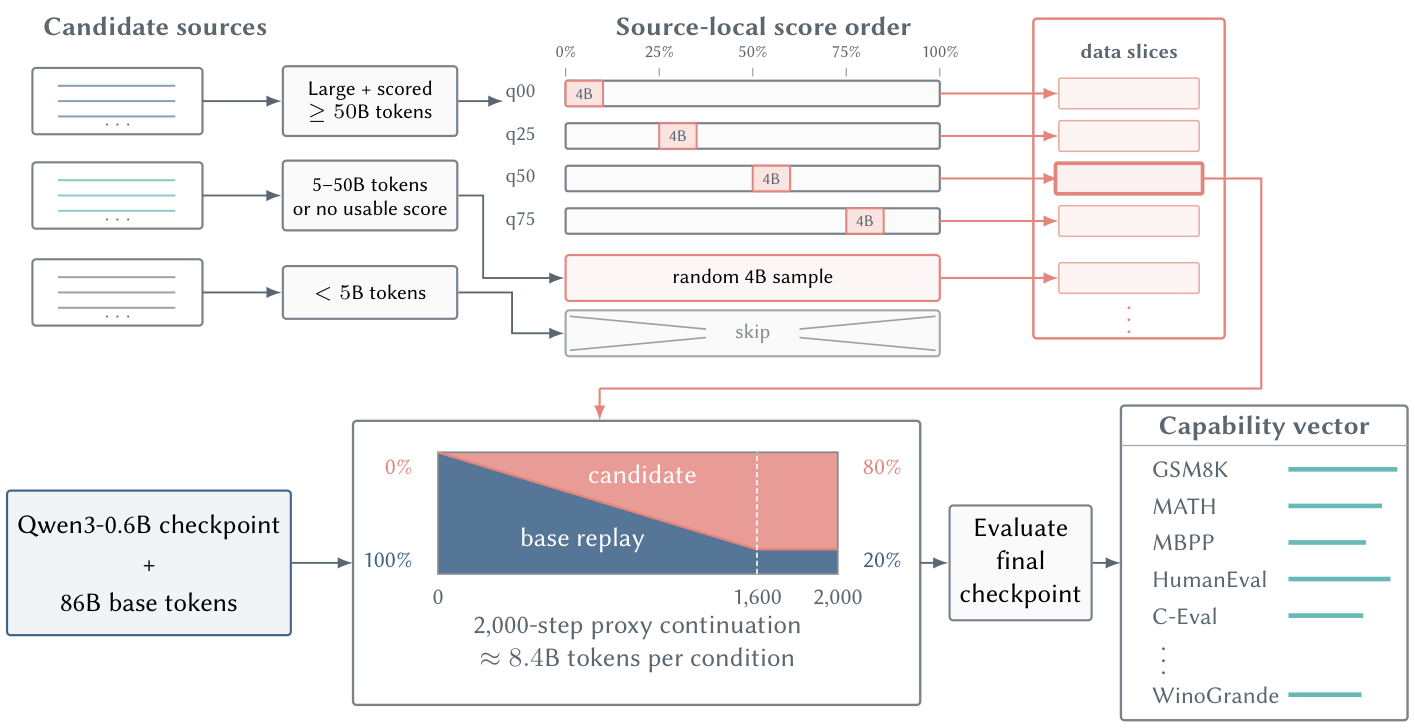
原文 Fig.9,p.18。沿上半部看切片生成,再沿下半部看比例渐变、固定起点续训与末端评估。四维能力分别由 2、2、2、9 个任务组成。这套 15 项 proxy 包含 C-Eval/CMMLU,与最终基座评估的 15 项并非同一集合;最终评估用 MMLU-Pro/BBH 替代这两项。
数据决策的例子是:DCLM-Dedup 的 q00 切片综合排名第三,q25 第十一,于是 Phase 2 保留约 34B tokens 的高评分区域,约为该来源前 5%。MegaMath-Code 的代码信号最强,MegaMath-Web-Pro 在数学及通用维度表现较好;中文来源用于保持基础中文覆盖。具体 mixture weight 仍由人工决定。
作者对各任务先做 z-score,聚合为四维后再次标准化并做 PCA。前两主成分解释 34.5% 与 28.1% 方差;PC1 主要呈现 General 与 Code 的对比,PC2 主要呈现 Math 与 Chinese 的对比。它描述这批代理实验的共变,不能直接推出增加某类数据必然损伤另一能力。(Fig.20,p.60;App.I,pp.60–61。)
最终用 Kaiyuan-Spark 固化来源 revision、筛选规则、比例和随机种子,训练读取预生成静态 shards。主要做源内去重,作者没有做跨来源去重;数据组件也含合成文本、数学和代码。两阶段语义领域组成如下:
| 数据领域 | Phase 1 token / 占比 | Phase 2 数据池 token / 占比 |
|---|---|---|
| English | 321.31B / 73.2% | 557.52B / 59.4% |
| Math | 31.56B / 7.2% | 171.29B / 18.3% |
| Chinese | 51.34B / 11.7% | 88.48B / 9.4% |
| Code | 34.62B / 7.9% | 108.11B / 11.5% |
| SFT / instruction | 0 | 12.66B / 1.3% |
| 合计 | 438.84B | 938.06B |
来源:Fig.8 内嵌 Table 3,p.18。Phase 2 数据池的 938.06B 与训练阶段的 959.99B 不矛盾:阶段开始有约 43.87B 的线性混合过渡,包含 Phase 1 replay 21.93B 和已计入 Phase 2 池的早期数据 21.93B。于是:
早期 Phase 2 片段不能再重复相加。上表按语义把 MegaMath-Code 计入 Code;底层 scheduler manifest 将其放在 Mathematics,故附录 Table 21 的分组比例不能直接与此表混用。(Table 20,p.55;App.H.2,pp.55–56。)
2.5 MuonH:控制矩阵的相对更新量
设选定权重矩阵为 $W_t\in\mathbb R^{m\times n}$,Muon 产生同形状更新 $u_t$。普通 Muon 加权重衰减的形式是:
$\eta_t$ 是标量学习率,$\lambda$ 是 weight decay 系数,$\rho_t$ 是忽略径向衰减后、相对于当前权重尺度的更新幅度,即有效学习率(ELR)。即使 $\eta_t$ 固定,权重范数增长或更新范数变化也会改变 ELR。对于近似满足 $\mathcal L(cW)\approx\mathcal L(W)$ 的矩阵,方向变化比绝对尺度更值得关注。(Eqs.(2)–(4),p.12。)
MuonH(Muon with Hyperball)为每个矩阵固定初始半径 $R=\|W_0\|_F$,先归一化 Muon 更新,再把权重投影回球面:
对应原文 Eq.(1),p.12;此处加上上标 $H$,与基础学习率区分。投影前位移长度为 $\eta_t^H R$,当前权重范数为 $R$,所以指定的相对更新幅度就是 $\rho_t=\eta_t^H$。这一定义描述投影前位移,并非声称投影后转角严格等于学习率。
生产训练在选定 attention/MLP 矩阵上使用 MuonH、weight decay 0,并设 $\eta_t^H=10\eta_t^{\rm base}$;embedding、归一化层、LM head 等用 AdamW、weight decay 0.1 和基础学习率。实现上优化的核心是把有效步幅变成一个可以直接设计的时间序列。(Sec.3.3,pp.12–13;Table 9,p.40。)
2.6 学习率:先保留继续训练空间,再做长线性衰减
Phase 1 的基础学习率为:
先 warmup 1,000 步,再按幂律衰减;$5\times10^{-4}$ 是渐近下限,438.8B 处实际基础学习率约 $1.04\times10^{-3}$。Phase 2 从这一值接续,局部样本计数 $s$ 从零重新计:
$S_j$ 是该分支的衰减样本预算。UD 五档预算是五条各自衰减到末端的训练轨迹,不是从一条全预算轨迹提前截取五个 checkpoint。(Eqs.(10)–(11),pp.40–41;Fig.13a,p.42。)
0.6B 的 WSD(warmup–stable–decay,预热—恒定—衰减)扫描支持较高 ELR 峰值和较长训练倾向于需要更长衰减。作者关注“距最佳验证损失 0.01 内的区域”而非把每个网格最优点都当成规律。例如 TPP=20、峰值从 0.008 增到 0.024 时,该区域的最低衰减占比从 0.4 移至 0.8。这些观察支持长衰减设计;Phase 1 幂指数 1/2 本身并未由该扫描优化得出。(Fig.6,p.14;App.F.2,pp.51–52。)
2.7 CMA:源内质量进度对齐,末段保持更新并平均参数
课程首先在各数据组件内部排序:有可用评分的按其来源自身的偏好方向从低到高排列;无评分的使用固定随机顺序。每条样本按其在组件内的累计 token 比例获得位置 $p(x)\in[0,1)$,再分到:
同一个 bucket 汇集每个组件大约 $1/376$ 的 tokens,因此每桶约 2.5B tokens,混合比例近似保持不变,而有评分组件逐渐进入更偏好的区域。这里无需比较不同来源的评分尺度;随机排序的组件也不会被赋予不存在的质量顺序。(Sec.3.4,pp.15–16;App.H.1,pp.54–55。)
实现中为避免全量文档排序的 Spark 开销,有评分组件使用最多 256 个近似分位区间,每区间再分 64 个确定性 hash 子分片;无评分组件用 4,096 个确定性随机分片。内部 bin 先按 token 数累计,再映射到 376 个生产桶。token 分位比文档计数更符合训练曝光量:长短文档不再各算一票。
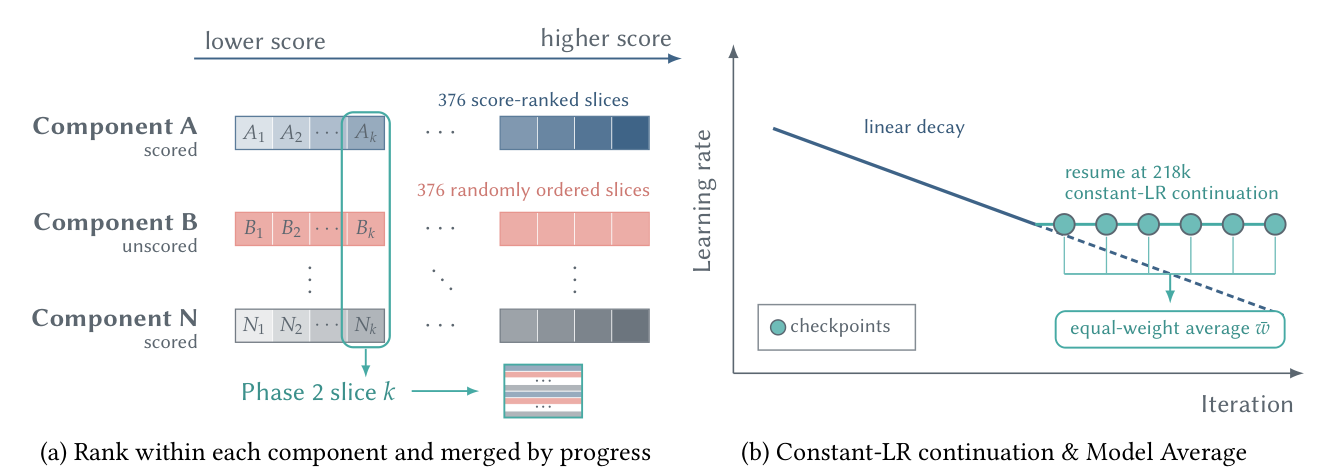
原文 Fig.7,p.16,按最终 PDF 裁切。左图从各来源相同的归一化进度取片段;右图展示从衰减轨迹分出恒定学习率续训,再平均后期 checkpoint。动机是:若最优数据出现在学习率接近零时,其参数更新影响也会变小。
| 分支 | Phase 2 数据顺序 | 末段学习率 | 输出参数 |
|---|---|---|---|
| UD | 全局打乱 | 线性衰减 | 最终 checkpoint |
| CD | 源内课程 | 线性衰减 | 最终 checkpoint |
| CDC | 源内课程 | 衰减后恒定 | 最终 checkpoint |
| CMA | 源内课程 | 衰减后恒定 | 六个后期 checkpoint 等权平均 |
正式 CMA 从全局 step 218,000 续训,固定基础学习率 $4.08\times10^{-5}$,MuonH ELR 则为 $4.08\times10^{-4}$。最后约 29B tokens 走恒定学习率路径;平均选用 step 222,100、222,200、222,300、222,400、222,500、222,569 的模型参数:
平均窗口覆盖 469 步,约 2.95B tokens。这里只平均模型参数,优化器状态不平均;推理仍是单个模型。六点平均窗口与约 29B 的整个续训区间也需区分。(App.H.3,p.56。)
三:实验——每组比较回答什么问题
3.1 基座评估的对象、协议和指标
基座对比都使用 pretrained/base 版本。open-weight 组包括 Qwen、Gemma、Llama、LFM、Falcon;open-recipe 组包括 Instella、OLMoE、Yulan-Mini、SmolLM3、MiniCPM5 和 MobileLLM-R1。参数规模以 1B–3B 为主,但 OLMoE 的 A1B/7B 表示约 1B 激活参数、7B 总参数,因此它与稠密模型的容量并不相同。(Secs.4.1–4.2,pp.20–22。)
| 基准组 | 任务 | 实际评估 |
|---|---|---|
| 数学 | GSM8K、原版 MATH | 4-shot 生成,解析最终答案 |
| 代码 | sanitized-MBPP、HumanEval | 3-shot 生成,按程序测试结果计分 |
| 复杂推理 | MMLU-Pro、BBH | 5-shot CoT / 4-shot 生成 |
| 其余知识与常识 | MMLU、ARC-C/E、BoolQ、CSQA、HellaSwag、PIQA、SIQA、WinoGrande | 5-shot,以候选答案 log-likelihood 排名 |
OpenCompass 固定模型/tokenizer revision、数据快照、prompt、示例与答案提取器,生成任务用 greedy decoding。可同时采用完形填空格式 CF 与选择题格式 MCF 的任务,为每个模型分别选择得分较高的格式后进入汇总。所有结果均为百分数,越高越好。
数学代码均分为 4 项平均,知识推理均分为 11 项平均;总分为:
因此总分的 11/15 权重来自后一个分组,各任务也不按测试样本量加权。这是理解 $4.4K 模型“达到 Qwen2 水平”的必要口径。(Sec.4.1.3,p.21;App.B,p.39。)
3.2 优化与数值精度的受控实验
论文采用三种不同尺度的证据:170M BF16 诊断比较原始 Muon、MuonH 和 ELR 对齐 Muon;0.6B BF16 扫描 WSD;0.17B–1.7B 的五档 ladder 用于计算等价拟合。五档均训练 20 tokens per parameter,长度 4,096、GBS 512,使用相同数据分布和 Nemotron-CC 子集验证集。生产模型则约 700 TPP。(Sec.3.3;App.D,pp.42–45;App.F,pp.49–52。)
ladder 的优化器比较固定 FP8,但 MuonH 与 Muon 的学习率和 weight decay 各按配方设置,因此比较的是完整优化配方。Muon 的 0.17B 和 0.33B 超参数有 LR/WD 搜索支撑,更大尺寸使用按规模外推的设置。精度比较则固定 MuonH 超参数,只改变 BF16/FP8。MuonH 的 ladder multiplier 为 2,WSD 扫描为 3,生产和 170M 对齐诊断使用 10,不能混用这些倍率。
3.3 后训练是否保留预训练差异
每个 SFT 设置内部,UD 与 CMA 初始化使用相同样本、顺序、tokenizer、优化器、学习率和训练预算;唯一改变的是预训练端点。这里 UD 使用全预算端点。三次重复改变的是 SFT 数据顺序,并非三次独立从零预训练。(App.E.1,pp.45–46。)
| SFT 设置 | assistant-supervised tokens | 端点 step | 检验重点 |
|---|---|---|---|
| GSM8K-based | 41.42M | 172 | 不含预训练 replay,检验针对性数学适配后差异 |
| Math & Code with replay | 530.86M | 2,431 | 更长、更多样的 SFT 后差异;replay 占监督 tokens 2.46% |
| Tulu-3 mixed-domain | 82.25M | 449 | 泛化能力与指令遵循 |
共同格式为 ChatML、4,096 context、assistant-only loss、文档隔离 packing,90%/10% 训练验证划分、两轮训练。基础 LR 从 $10^{-5}$ cosine 衰减到 $10^{-7}$,MuonH 倍率 10。SFT 数据做去重,并剔除与测试题共享 13-gram 的训练样本。数学评估使用 GSM8K 全部 1,319 道测试题、零样本 ChatML 和确定性答案提取,所以其分数不能直接与基座 4-shot 分数作训练前后因果比较。(Sec.3.5,p.17;App.E,pp.45–49。)
四:结果——逐层理解能力与成本
4.1 基座能力:综合超过 Qwen2,但能力分布不均匀
| 模型 | 数学+代码 Avg4 ↑ | 推理+知识 Avg11 ↑ | Avg15 ↑ |
|---|---|---|---|
| Qwen2-1.5B | 40.29 | 60.54 | 55.14 |
| Qwen2.5-1.5B | 47.52 | 65.53 | 60.73 |
| Qwen3-1.7B-Base | 58.48 | 67.75 | 65.27 |
| Instella-3B | 33.41 | 63.13 | 55.20 |
| Yulan-Mini-2.4B | 52.11 | 61.24 | 58.80 |
| SmolLM3-3B-Base | 58.99 | 68.35 | 65.85 |
| MobileLLM-R1-950M-base | 47.36 | 56.73 | 54.23 |
| Puro-2B UD,$4.4K | 38.61 | 61.70 | 55.54 |
| Puro-2B CMA,$6.9K | 43.50 | 63.02 | 57.81 |
来源:Tables 4–5,pp.21–22。Avg15 根据 15 项已列分数计算,避免对四舍五入后的两个组均值再简单平均。
最佳 CMA 相对 Qwen2 的数学代码均分高 3.21 点,知识推理高 2.48 点,综合高约 2.68 点;对 Qwen2.5 则两组分别低 4.02、2.51 点。它的主要价值是所报告成本下的能力,而不是小模型绝对排名领先。
数学代码细项揭示了不同预算的差异:
| 模型 | GSM8K | MATH | sanitized-MBPP | HumanEval |
|---|---|---|---|---|
| Qwen2-1.5B | 59.82 | 23.70 | 50.19 | 27.44 |
| Qwen2.5-1.5B | 67.70 | 32.28 | 58.37 | 31.71 |
| Puro UD,$4.4K | 56.03 | 27.86 | 49.81 | 20.73 |
| Puro CMA,$6.9K | 59.67 | 30.30 | 52.92 | 31.10 |
来源:Table 4,p.21,单位 %。$4.4K 端点在数学代码组低于 Qwen2,知识推理组较高,从而使 Avg15 略胜约 0.40 点。最佳模型接近 Qwen2.5 的 HumanEval,但 GSM8K 和 MATH 仍有差距。
4.2 MuonH 与 FP8:一个减少等质量工作量,一个加快执行
ELR 对齐诊断。 在 170M BF16 的同架构、batch、数据种子和评估条件下,普通 Muon 最终验证损失约 3.073,MuonH 为 3.029。若普通 Muon 在线设置:
使它的 ELR 跟随 MuonH 目标,而不做固定半径投影,则最终损失约 3.030。(Eq.(5),p.13;Fig.5,p.14。)
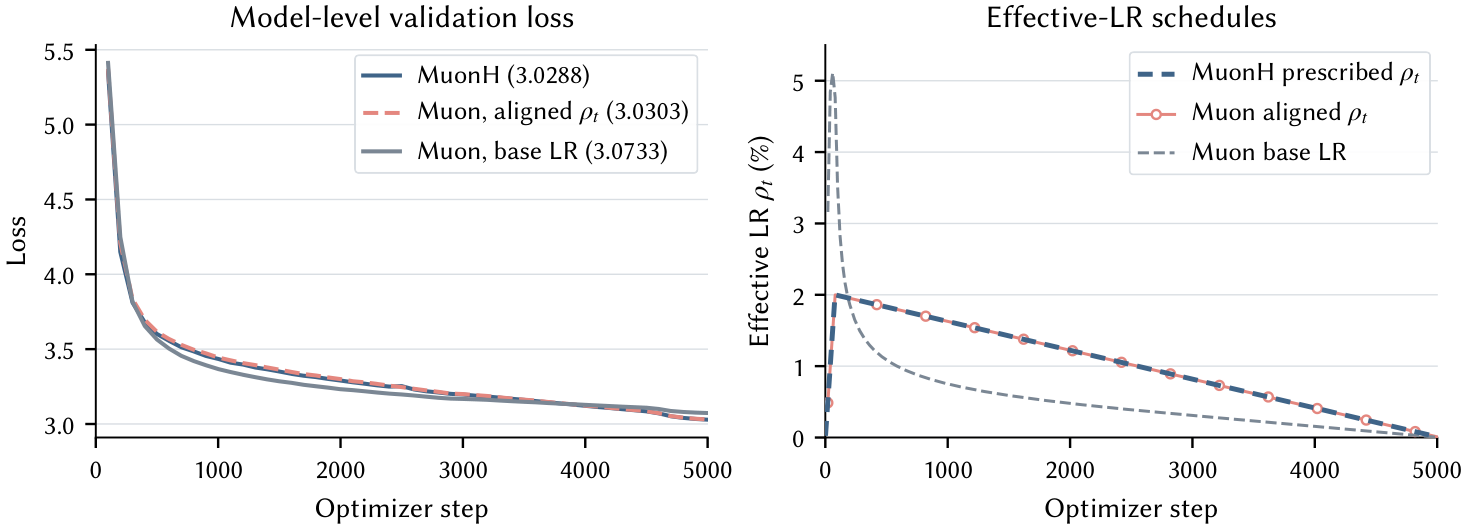
原文 Fig.5,p.14。左边纵轴是验证损失,右边是选定 MLP down-projection 的 ELR;横轴为优化步。普通 Muon 的 ELR 早期下降更快,早期损失较低,但末期被另两条曲线超过。这个对照将重要解释落在 ELR 轨迹,而非单纯归因于球面投影。
等质量计算量拟合。 五档 ladder 令 $C=6ND$,联合拟合:
$N$ 为 ladder 的 scaling parameter count,$D$ 为 tokens;$C_0$ 是参考计算量,$L_\infty$、$\alpha$ 共享,组间只有幅度 $A_g$ 不同。因此变体用 $C/\kappa$ 达到 baseline 在 $C$ 处的拟合损失。MuonH 完整配方的 $\kappa\approx1.19$,约节约 16.1% 理论计算;逐个留出模型尺寸时为 1.17–1.28。留一范围衡量端点敏感性,不包含函数形式选择的不确定性。(Eqs.(12)–(14),p.42;App.D,pp.42–44。)
FP8 精度与吞吐。 在固定 MuonH 的五档比较里,FP8 验证损失比 BF16 高 0.0031–0.0039。共享形状拟合得到 BF16 等价计算保留率:
匹配质量需要约 2% 更多名义计算;而 1.7B 处实测吞吐增益约 1.36 倍。作者结合两项后报告约 1.34 倍质量调整加速、约 25.2% GPU-hours 节约。按展示的 1.36 与 0.980 相乘约为 1.33;这一小差异可能来自舍入,这里保留原文报告的近似值。(Fig.10,p.23。)
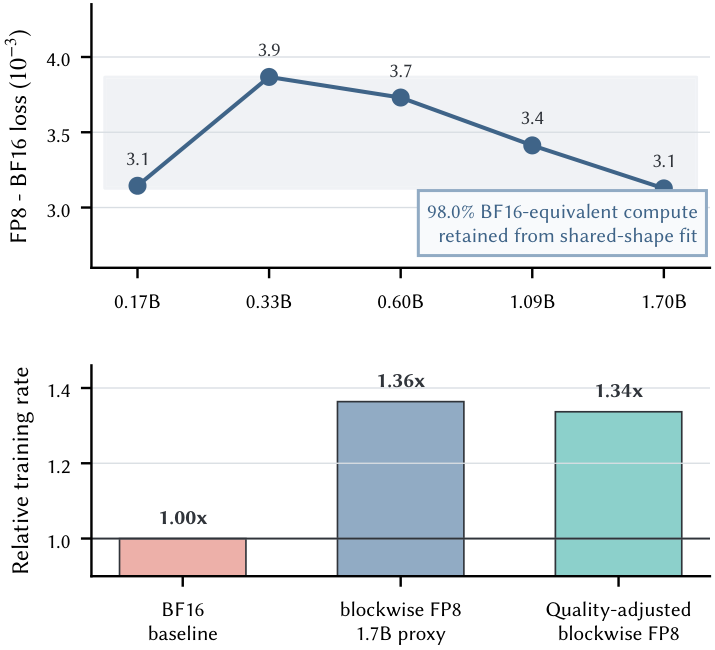
原文 Fig.10b,p.23。上图纵轴为 FP8 减 BF16 的损失差,标度 $10^{-3}$;下图把 1.7B 的原始吞吐收益和质量调整收益并列。计算等价因子来自 TPP=20,生产模型约 TPP=700,把因子迁移到生产预算属于估计。正文的 22,654 FP8 GPU-hours 是这种估算中的数值;生产成本台账实际使用 22,514.41,二者口径不同。
4.3 学习率诊断:衰减的时机影响末端损失
0.6B WSD 扫描中,ELR 峰值为 0.008、0.012、0.016、0.020、0.024,衰减占比取 0.2–1.0。距最佳损失 0.01 内的区域下缘依次为 0.4、0.4、0.6、0.6、0.8;峰值 0.012 时从 TPP20 到 TPP50/100,下缘从 0.4 移到 0.6。长衰减区域往往较平,所以单个网格最小值不是严格单调的。(Sec.3.3.2,pp.14–15;Fig.18,p.52。)
作者用多幂律模型(Multi-Power Law,MPL)解释两种作用:累计学习率曝光量推进优化;学习率下降还有随后逐步兑现的损失改善。设 $q_t$ 选原始 LR 或 ELR,$S_q(t)$ 为 warmup 后的梯形积分曝光,$S_w$ 为 warmup 曝光,则:
求和仅包括 warmup 后至 $t$ 的变化;$\Delta q_k=q_k-q_{k-1}$。衰减时该项为负,$G$ 则表示该次下降影响已兑现的比例。这里 $C$ 是响应缩放系数,与上文 FLOPs 计算量同字母但含义不同。若教学性地令 $G=1$,修正项简化为 $B(q_t-q_{\rm warm})$,只保留总衰减量,失去响应时延。(App.F.1,pp.49–50。)
在两条 170M Muon 曲线、末 20% 验证点留出的诊断上,用 ELR 替代原始 LR 后平均 RMSE 从 0.0265 降至 0.0210;简化的 $G=1$ 模型为 0.0207,说明这些数据并不强烈区分完整与简化响应模型。WSD 的两锚点拟合仅使用衰减比 0.2、1.0,对其余 15 条未见调度的曲线 RMSE 0.0157,端点 MAE 0.0067,预测的最优占比随峰值从 0.33 增到 0.85。其用途是筛选下一批调度实验,而非证明精确最优。(Figs.16–18,pp.50–52。)
附录另构造了普通 Muon 的“山形标量 LR”:为了在权重范数增长时保持 ELR 约 0.02,标量 LR 需要先升,随后末段下降;5,000 步损失为 3.0678。它再次说明只看原始 LR 曲线会误判实际更新幅度。(App.F.3、Fig.19,p.52。)
4.4 CMA 消融:有效的是组合,并非平均本身
| 完整 Phase 2 分支 | Avg15 ↑ | 解释 |
|---|---|---|
| UD,最终参数 | 56.00 | 统一数据顺序对照 |
| UD,衰减轨迹参数平均 | 55.57 | 单做平均反而下降 |
| CD,最终参数 | 57.17 | 排序带来约 1.17 点收益 |
| CD,衰减轨迹参数平均 | 57.18 | 平均几乎无变化 |
| CDC,215k 续训末端 | 55.64 | 恒定 LR 的入口选择影响很大 |
| CMA,215k 续训平均 | 56.80 | 平均改善该分支 |
| CDC,218k 续训末端 | 57.12 | 恒定 LR 单独未超过 CD |
| CMA,218k 续训平均 | 57.81 | 正式选择的组合 |
来源:Table 19,p.53。Sec.3.4 与 Fig.13b 将 UD 写作 55.99,对应“CD +1.18”;Table 19 写作 56.00。这里采用表中端点,比较时用约 1.17–1.18 点,不赋予 0.01 点差异额外意义。
最有信息量的对照是:CD 已获得大部分改善;218k 的恒定 LR 末端本身没有超过 CD,但在该分支上平均六个 checkpoint 后增加约 0.69 点。215k 平均后的分支也弱于 218k。因此作者选择 CMA 的证据支持顺序、续训和平均的联合设计。两个续训入口不是严格匹配的系统搜索,218k 是已测试配置中的选择。(Sec.3.4,p.16;App.H.3,p.56。)
4.5 成本曲线:实际预算点与拟合等价预算分开看
UD 的五档 Phase 2 从共同 Phase 1 checkpoint 出发,各自调整衰减时长:
| Phase 2 tokens | 总成本 | Avg15 ↑ |
|---|---|---|
| 60B | $2.16K | 51.98 |
| 120B | $2.47K | 53.24 |
| 240B | $3.10K | 54.01 |
| 480B | $4.37K | 55.54 |
| 959.99B | $6.89K | 56.00 |
来源:Tables 18–19,p.53。拟合形式为:
此处 $C$ 是货币成本,不再是 FLOPs;采用一致货币单位,单位变化由截距吸收。$b$ 描述 Phase 2 增量成本翻倍对应的分数增长。固定 Phase 1 成本后做 shifted log fit,训练样本内 RMSE 从不平移的 0.452 降为 0.209。(Sec.4.3.1,pp.23–24。)
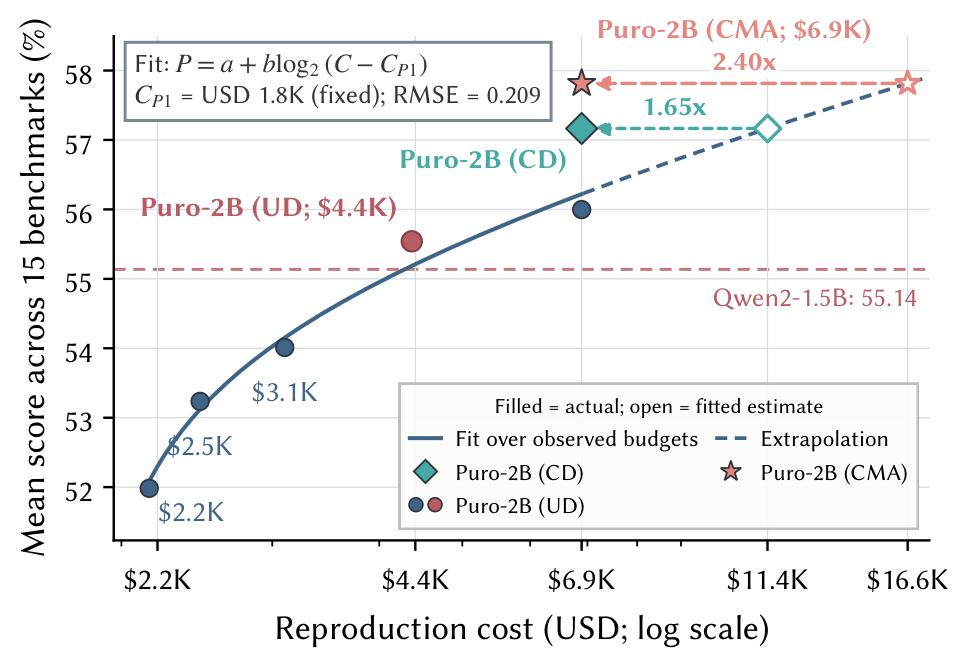
原文 Fig.2b,p.5。横轴为对数显示的美元成本,纵轴为 Avg15;实心点表示实际预算,空心点表示沿 UD 拟合曲线反解的等价成本。CD 57.17 反解为约 $11.36K,CMA 57.81 反解为约 $16.55K,分别约为实际 $6.89K 的 1.65 与 2.40 倍。
这两个等价预算均超出 UD 实测最高 $6.89K,属于外推;2.40 倍是达到 CMA 分数的拟合 UD 成本比,不能表述成实测端到端训练加速 2.40 倍。反过来,约 $4.4K 超过 Qwen2 的结论有实际 UD 点支持,不只依赖曲线插值。
4.6 金额如何算出,跨模型对比如何定位
作者使用本地 8 卡节点每月 12,000 CNY 的归一化假设,按 30 天计:
用论文固定汇率 6.8067 CNY/USD,等于约 $0.3061/GPU-hour;表格四舍五入写 $0.31。生产 GPU 时间为 Phase 1 的 6,009.46 加 Phase 2 的 16,504.95,于是:
这些价格和汇率是论文的核算输入,不是当前公开租赁报价。5090 价格基于作者将硬件和电力在五年内摊销的估计;并非普遍可获得的公开云租赁渠道。(Table 2,p.9;Table 6,p.38;App.B,p.40。)
边界从材料化训练 shards 之后开始,只算定稿 Phase 1/2 活跃训练 GPU 时间。数据处理、proxy 实验、消融、失败尝试、SFT、评估、平均 checkpoint 的操作、研究人力及额外 CPU/存储/网络等不计入。因此 $6.9K 是复跑最终预训练路径的边际加速器成本,不能用来代表项目从零开发的全部费用。(Sec.2.2,p.8。)
跨模型图优先使用已披露金额或 GPU-hours;只有 token 预算时才用 $6ND$,缺省以 H100 989.5 TFLOP/s、70% MFU 折算。Puro 的坐标来自其生产 GPU 时间,其他模型则混有实际披露与理论估计。由此得出的 Pareto 优势以这些核算假设为条件。(Sec.4.3.2,p.24;Table 7,p.39。)
四项经常被并列展示的效率数字其实回答不同问题:
| 因子 | 报告值 | 证据含义 |
|---|---|---|
| RTX 5090 对 H200 | 2.77×,BF16 | 峰值计算量/价格代理;FP8 口径约 2.74× |
| FP8 | 1.34× | 五档质量拟合+1.7B 吞吐,固定 MuonH |
| MuonH | 1.19× | 固定 FP8 的完整优化配方等质量计算量拟合 |
| CMA | 2.40× | 固定 2B 的 UD 成本曲线外推 |
来源:Fig.2a,p.5;Secs.4.3.1–4.3.2,pp.22–24。它们没有构成同一个逐项开启的全因子实验,直接相乘不能得到实测总收益。
4.7 后训练:差异保留,但不是每项任务都变好
| 后训练设置与指标 | UD 初始化 | CMA 初始化 | CMA−UD |
|---|---|---|---|
| GSM8K-based SFT:GSM8K | 66.89 | 68.66 | +1.77 pp |
| Math & Code + replay:GSM8K | 74.10 | 76.12 | +2.02 pp |
| Tulu-3:15-task macro-average | 53.96 | 55.13 | +1.17 pp |
| Tulu-3:IFEval,单独统计 | 41.71 | 43.07 | +1.36 pp |
来源:Fig.11,p.25;Tables 13、15、17,pp.47–49。均为三次匹配 SFT 数据顺序的平均;pp 表示百分点。
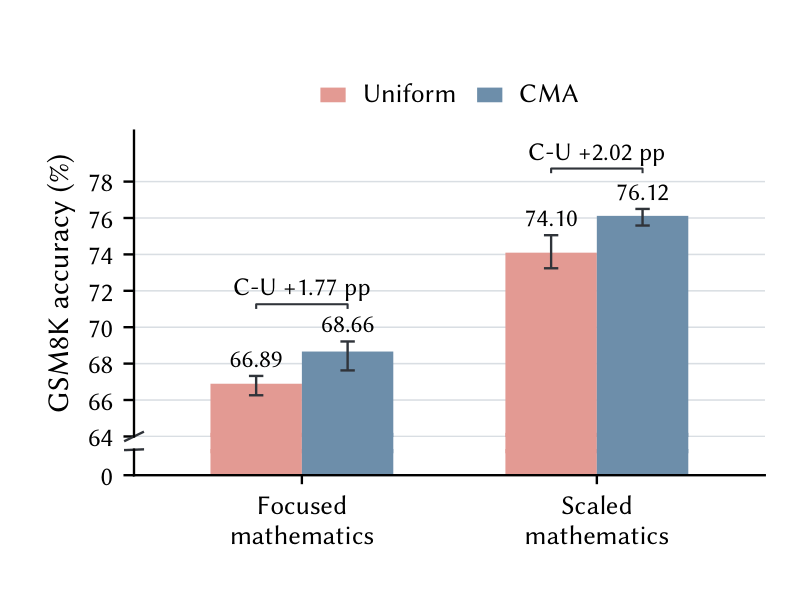
原文 Fig.11a,p.25。两组分别是较短的 GSM8K-based SFT 与较长的 Math & Code SFT,误差条表示三次结果的最小值到最大值,并非标准误或置信区间。应比较每组内的 UD/CMA 差值,不能用两组绝对分数隔离“训练更久”的因果作用,因为数据组成也变了。
GSM8K-based 的三次 CMA 增益为 1.82、2.12、1.36 pp;Math & Code 为 3.26、1.21、1.59 pp。灵活答案提取以及只认显式答案的敏感性检查仍保留增益,且每次 CMA 独自答对的问题数都更多,支持差异涉及数学解题能力而不只是格式。(App.E.2–E.3,pp.46–48。)
Tulu-3 后 15 项中 10 项改善,但分布很不均匀:HellaSwag +7.25、ARC-C +3.95、MATH +3.79;BoolQ −4.61、HumanEval −1.63、BBH −1.06。IFEval 单列,不进入 Avg15。(Table 17,p.49。)
这支持“完整预训练配方造成的差异可以在共同 SFT 后保留”。由于 CMA 同时改变顺序、末段 LR 和权重平均,这些 SFT 实验不能把贡献全部归给数据排序。SFT 的 13-gram 清洗也没有清除已经进入预训练权重的任何基准重叠。
五:结论——最值得带走的设计原则与边界
Puro-2B 的价值在于把一条能够完成万亿 token 训练、达到实用基座能力的路径具体化。选择与模型规模匹配的硬件,把 FP8 实际吞吐、优化效率、数据顺序和成本台账连在一起,比单独汇报 FLOPs 或参数量更能解释“低成本”。
对方法研究,两个方向尤其值得继续:第一,把矩阵的有效学习率作为可观测量,而不是只记录标量 LR;第二,在数据分布随训练进度改变时,同时设计学习率和参数平均。本文最好的诊断分别是 ELR 对齐普通 Muon,以及 CD/CDC/CMA 的端点拆分。
决定如何使用这些结果的边界有四个:
- 性能与污染。 作者未做覆盖所有预训练数据及所有代理/最终基准的严格 exact/near-duplicate 审计。若高评分数据末段更集中地含基准重叠,课程效果可能被影响;SFT 后增益保留不能排除这种解释。(App.A,p.38。)
- 训练规模。 2B、约 700 TPP 是为得到低推理成本模型而选择的 overtrained 区域。20-TPP ladder 的因子向这里迁移需要假设;固定 2B 的 cost scale-down 曲线也不提供更大模型的 scale-up 规律。(App.A、D,pp.38、42–44。)
- 复跑成本与部署。 需要已经准备好的数据、24/96 卡集群、相应网络与系统适配。$4.4K/$6.9K 只覆盖定稿路径的加速器时间;驱动与通信依赖会改变其他实验室的实际吞吐和成本。
- 开放材料的粒度。 作者发布配方、权重和代码,数据组件沿用各自上游条款;部分来源禁止原始数据再分发或条款仍待核实。附录提供来源家族账目,不能把整个数据集一概视作 Apache 2.0,也不能仅凭家族表重建所有细节。中文仅为基本覆盖,headline 评估不含中文任务。(App.A、I,pp.38、57–60。)
若要基于这篇论文设计后续实验,本次分析优先建议:在同一无基准重叠的数据池上做排序×末段 LR×平均的匹配组合;在接近 700 TPP 的设置复核 FP8/MuonH 的等质量因子;把公开可复现的通信配置和数据材料化成本纳入总预算。这几项分别缩小当前最关键的归因、尺度迁移和可达成本的不确定性。
论文给出的主要项目入口:模型集合、训练代码 Puro-Megatron、数据处理 Kaiyuan-Spark、数据入口。