Recirculation:中文精读
论文:Michael C. Mozer、Shoaib Ahmed Siddiqui、Danny Sawyer、Sunny Sanyal、Rosanne Liu,Recirculation,arXiv:2608.17981v3(2026-09-28 修订)。本次获取:2026-10-23。arXiv 页面 · 本地原文 PDF
论文总览
Recirculation 在不改变现成 Transformer 权重的条件下,把某个 token 在深层形成的表示,少量反馈到该 token 的浅层第二次处理。 第二次处理与下一 token 的首次处理流水并行,使修正后的表示可进入后续上下文。作者希望借此让浅层持续使用深层已推断出的状态,例如在“河岸”语境中保持 bank 的含义;普通 feedforward Transformer 对每个 token 的状态更新次数受层数限制。(§1–2,PDF 第 1–5 页)
论文需要分成两个结论来读。固定系数 Recirculation 只在推理时改变计算图、完全不训练:Gemma3 4B 预训练模型在十个正常带 BOS 的语料上困惑度均降低,但幅度仅为 0.09%–0.62%;八项单 token 基准平均准确率提高约 0.23 个百分点。Adaptive Recirculation 冻结原模型,却用反向传播训练一个根据 token 表示输出反馈系数的 MLP:在特定 1B 语言建模设置下九语料平均困惑度降低 23.0%;针对 GSM8k 训练后,4B 模型的 pass@1 从 29.3% 到 35.5%,即约 +6.2 个百分点、相对准确率 +21%。后一个结果不能归入“零训练”收益。(表 1–2、图 12–13,PDF 第 8、14–15 页)
这种方法有明确的计算取舍:生成时作者认为两套计算栈可以并行,额外延迟很小;但预填充需要按 token 顺序更新,长上下文会明显增加等待时间。论文没有给出生成延迟或预填充吞吐的实测基准。(§2、§5,PDF 第 4–5、16–18 页)
结构地图
| 原文章节 | 核心内容 | PDF 页码与证据 |
|---|---|---|
| §1 State tracking | 多义词状态追踪问题、浅层和深层的时间差 | 第 1–4 页,图 1–2 |
| §2 Proposed method: Recirculation | 双栈流水、反馈混合公式、与 looping 的区别 | 第 4–6 页,图 3–4,式 (1)–(2) |
| §3 Related research | Looped Transformer、显式递归、思维链和激活干预 | 第 6–7 页 |
| §4.1–4.3 Experiments | 层位/系数搜索、困惑度、归一化与 ramping | 第 7–10 页,图 5–6、表 1 |
| §4.4 Analysis of recirculation | 跨模型、温度控制、looping 对照、token 位置与词性 | 第 10–12 页,图 7–9 |
| §4.5 Generative tasks | 指令遵循、语境理解、单 token 任务、GSM8k/HumanEval | 第 12–15 页,图 10–12、表 2 |
| §4.6 Adaptive recirculation | 系数学习及消融、下游任务适配 | 第 15–16 页,图 13 |
| §5 Discussion;附录 A–D | 成本与适用条件、两次反馈示意、评估和训练细节 | 第 16–18、25–38 页 |
一:动机——深层已经理解,浅层却仍在重猜
论文的 bank 对话展示一个具体错误:模型先在钓鱼语境中把 bank 解释成“河岸”,随后面对 ATM 问题又像在谈“银行”。作者的机制解释是:多义 token 的浅层表示仍含两种含义,深层才完成语境消歧;后续输入重新从浅层进入时,已经算出的深层解释并未直接成为浅层的状态。图 2 左侧画出了这种“深层先理解、浅层再处理”的错位。(§1,PDF 第 2–3 页)
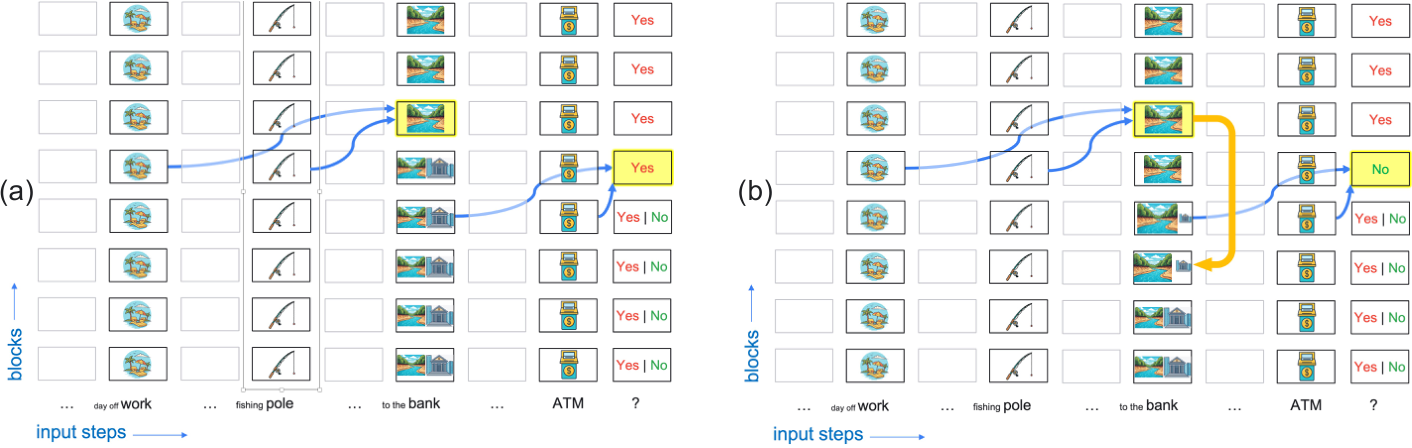
图 2(PDF 第 3 页)是机制示意。文中引用的既有激活替换实验,在预先识别关键 token 后把深层激活复制到浅层,使相关语境化错误减少 60%;那是动机证据,不是本文 Recirculation 的量化结果。本文改为向每个 token 注入小幅反馈,以免大幅替换让现成模型偏离其熟悉的激活分布。(§1,PDF 第 3–4 页)
作者依赖 Transformer 残差流在层间保有一定特征对齐:若深层的某个方向已经代表“河岸”相关语义,浅层通过少量同维向量混合便可能利用它,无须先训练完整适配器。这是设计假设;是否真的带来有效状态追踪,需要由后续干预、对照和任务结果来检验。(§1,PDF 第 4 页)
二:方法——同一 token 的第二次处理如何影响未来
2.1 时间、层与两套流水栈
设第一个下标为展开/计算步 $i$,第二个为输入 token 位置 $j$,第三个为层 $l$,$z_{i,j,l}$ 表示该层的残差流输出。在输入步 $t$,当前 token 首次经过整套层,并在深层 $s$ 形成 $z_{t,t,s}$;下一计算步令同一个 token $t$ 从较浅的层 $d
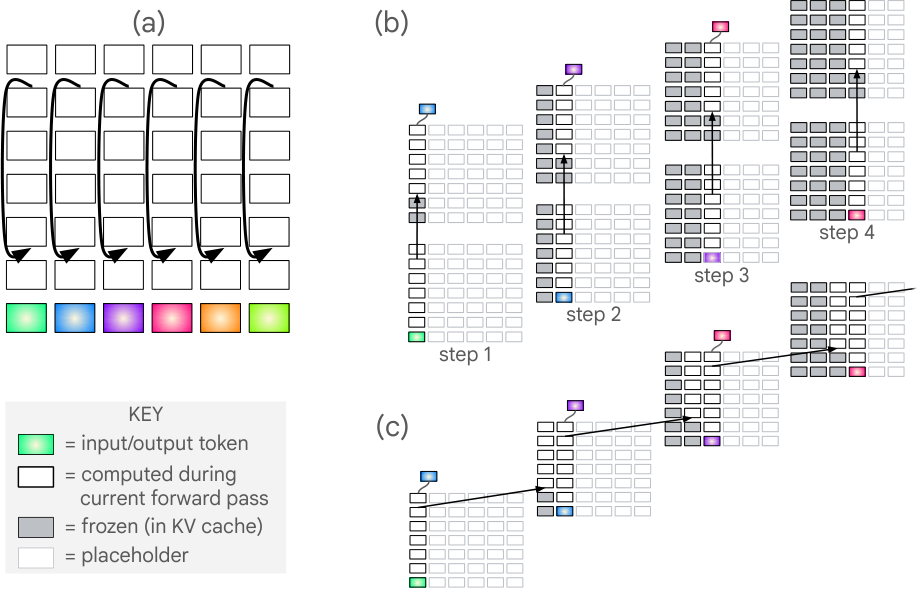
图 3(PDF 第 5 页):(b) 普通 looping 把某层块复制到同一 token 的更深路径;(c) Recirculation 将前一 token 的额外遍历与当前 token 的首次遍历错开并行。灰色格子是已有状态或 KV cache,空心格子是当前计算。图 4(PDF 第 5 页)进一步显示:普通 looping 的颜色状态随 token 向更深层爬升,而 Recirculation 可在各步的同一层高度延续。这是“能够表达递归状态更新”的架构论证,并非论文已证明现成模型一定学会任意状态机。
2.2 反馈公式与归一化
论文式 (1) 把反馈点写为
固定系数实验通常取 $\beta=1$;这时浅层原表示完整保留,再加入系数为 $\alpha$ 的深层信号,不是权重之和为 1 的凸组合。由于深层残差范数通常更大,默认 $f$ 先把源向量缩放到目标向量的 $L_2$ 范数:
例如 Gemma3 4B 预训练模型在标准困惑度搜索中选 $s=15,d=8,\alpha=0.09$;4B 指令模型另选 $s=33,d=28,\alpha=0.15$。1B、12B 的最佳层位也不同,所以“把所有模型都在同一层回流”不是本文实验协议。1B 在开头 token 上还采用 $\alpha_t=\min(t/10,1)\alpha$ 的 ramping。归一化消融主要提高搜索区域的稳健性,未显著改变最大收益。(§2、§4.1–4.3,PDF 第 5、7–10 页;附录 B,PDF 第 26–32 页)
原文有一处超参数记录不一致:4B PT 省略 BOS 的设置在主文表 1(PDF 第 8 页)给出 $s=18,d=9,\alpha=0.15$,附录表 B.2(PDF 第 27 页)给出的前两项相同,但 $\alpha=0.10$。论文没有解释差异;复现实验时应明确记录所采用的版本。
2.3 与 looping、思维链的区别及成本
Looping 在同一 token 内重复一段层,主要增加深度;Recirculation 让先前 token 的表示在下一计算步回到浅层,使状态有一条沿 token 序列延续的路径。普通思维链也靠顺序生成传递状态,但要用额外 token 表示中间计算。图 8 的同层位搜索中,Gemma3 家族的朴素、免训练 looping 没有出现 Recirculation 那样稳定的有利区域;这个对照不能概括所有经过训练或精细调参的 looping。(§2–3、§4.4,PDF 第 4–6、10–11 页)
每个已处理 token 需要一次额外遍历,生成时可与下一个 token 的首次遍历并行,因此作者认为延迟接近普通生成;但计算资源并未免费获得。预填充的历史 token 也必须按顺序完成反馈,无法像普通预填充那样一次并行处理整段输入。论文未给出实际毫秒延迟、吞吐或额外 FLOPs 的对照数值;评估的是准确率与困惑度收益,并提出块级反馈作为未来降低预填充成本的方向。(§2、§5,PDF 第 5、16–18 页)
三:实验设计与指标
固定系数实验先在 arXiv、C4、PG-19 的训练分割、1024-token 窗口上搜索 $\alpha$ 与源层 $s$、目标层 $d$;再用独立评估分割计算 Gemma3 1B/4B/12B 的困惑度。Gemma3 4B 主表另测试指令调优版(IT)与刻意省略 BOS token 的预训练版(PT)。后者移除了模型原本依赖的注意力 sink,是人为增加困难的条件;不能把它的较大收益当作正常带 BOS 输入的典型收益。普通困惑度是所有被计分 token 的指数平均负对数似然;LongPPL 加重关键长上下文 token 的作用,二者的基准值和百分比不能混用。(§4.1–4.2,PDF 第 7–9 页;附录 B.1–B.2,PDF 第 26–28 页)
下游评估覆盖:800 个水果/动物双变体指令遵循问题;三类带干扰句的语境化是/否问题;八项零样本单 token 基准;以及用 zero-shot 思维链或代码生成评估的 GSM8k、HumanEval。后两者同时报告 pass@1(单次正确率)与 pass@128(128 次采样至少一次正确的比例)。固定系数版本的层位可能来自语言建模搜索,也可能来自 MMLU 开发集搜索;Adaptive 版则另外训练反馈系数。(§4.5–4.6,PDF 第 12–16 页;附录 D,PDF 第 35–38 页)
四:结果与证据强度
4.1 层位搜索找到局部有利区域,而非任意反馈都有效
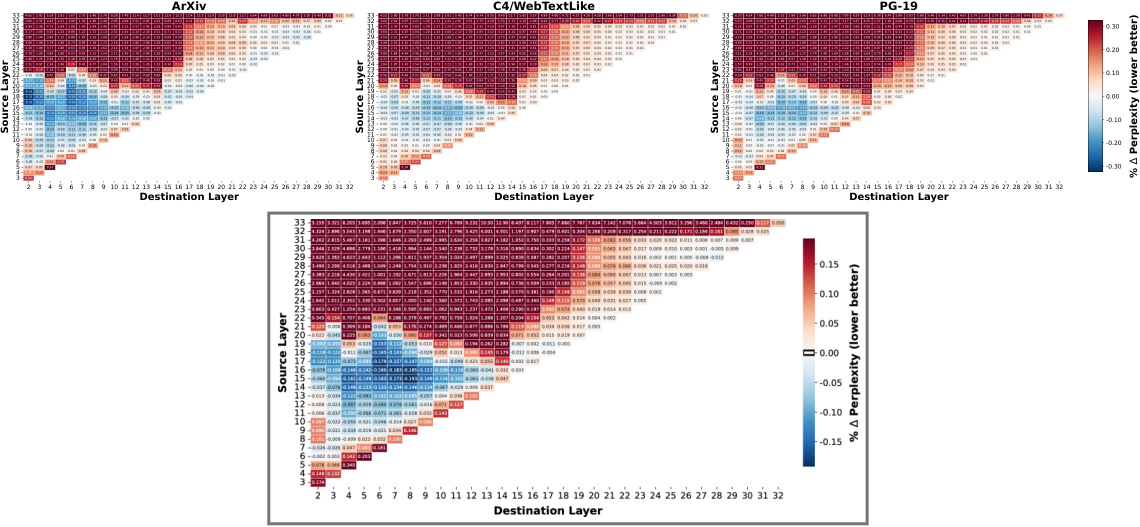
图 6(PDF 第 8 页)的横轴是目标层、纵轴是源层;蓝色为困惑度下降,红色为上升。arXiv、C4、PG-19 都有大致相似的蓝色区域,支持选取中部层位;但另一些层位显著有害,正文举例 $s=33,d=14$ 可让困惑度升高约 15%。图 7(PDF 第 10 页)把搜索扩至 Phi2、Ministral3、Qwen3、Pythia,也见到有利区域;这只是 arXiv 子集上的层位扫描,不能代替这些家族的完整下游评估。(§4.1、§4.4,PDF 第 7–10 页)
4.2 困惑度:正常输入收益小,IT 与缺 BOS 设置大得多
下表从原表 1(PDF 第 8 页)摘取三行,数字均为相对困惑度下降百分比;列之间使用不同模型配置或输入条件,不能当作同一模型上的独立加成。
| 数据集 | 4B PT,带 BOS | 4B PT,LongPPL | 4B IT | 4B PT,缺 BOS |
|---|---|---|---|---|
| arXiv | 0.25% | 0.72% | 9.22% | 11.26% |
| PG-19 | 0.20% | 1.18% | 10.76% | 15.72% |
| BillSum | 0.09% | 0.26% | 18.09% | 4.46% |
4B PT 的标准困惑度在十个数据集上都下降,范围 0.09%–0.62%;正文报告逐 token 配对检验均 $p<0.0001$,但效应量 Cohen’s $d<0.10$。LongPPL 的相对下降通常更大,支持“少数关键 token 受益较多”的解释。IT 模型或去掉 BOS 后的基准困惑度本来较高,回流可能同时起到校准与分布修复作用。附录表 B.3(PDF 第 28 页)显示缺 BOS 时 1B、12B 在 LAMBADA 上反而变差(困惑度变化分别为 $-0.72\%$、$-2.81\%$ 的“下降”),所以跨模型也并非逐数据集全胜。
温度对照尤其影响 IT 结果的解读:在 PG-19 上,单独调 softmax 温度对 4B IT 的困惑度最多可降低约 19.5%;温度加 Recirculation 达 20.2%,额外收益约 0.7 个百分点。正常带 BOS 的 4B PT,温度匹配后的额外收益约 0.18 个百分点;缺 BOS 条件约额外 12 个百分点。故回流效果不能完全等同于温度调整,但 IT 大幅困惑度收益的一部分与输出校准重合。(§4.4,PDF 第 10–11 页;附录 C,PDF 第 33–34 页)
4.3 哪些 token 贡献了收益
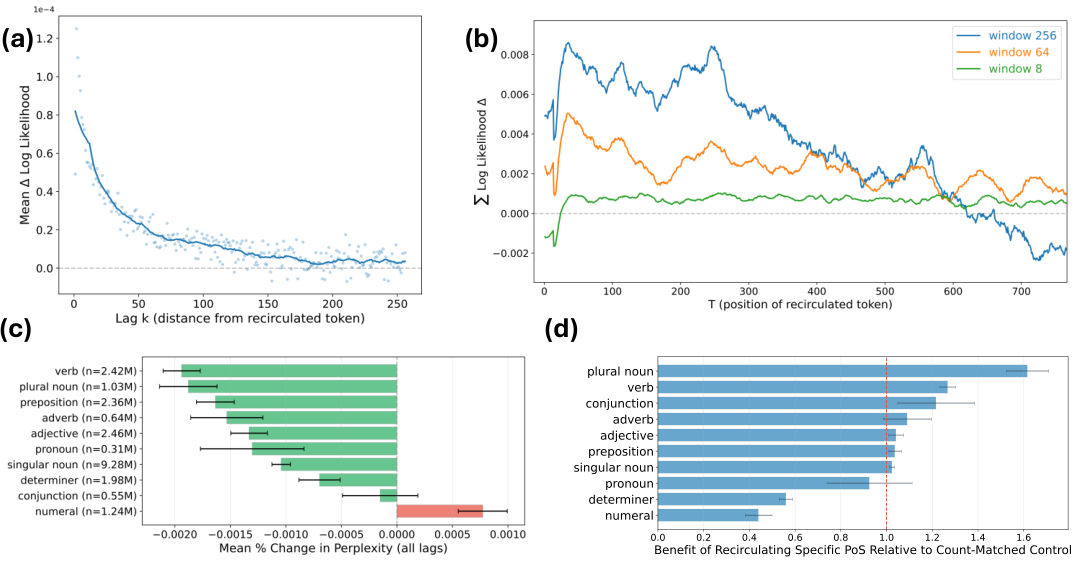
图 9(PDF 第 11 页)单独让窗口第 $t$ 个 token 回流后,观察后续 token 的对数似然变化。(a) 改善随距离衰减,但有长尾;(b) 对较远目标,前部 token 的回流有更持久的影响;(c)(d) 动词、复数名词等通常比数字、限定词贡献大,数字 token 的单点平均效果甚至有害。词性和贡献之间的关系来自这一套 Gemma3 4B/arXiv 设置,不是语言普遍定律。它支持作者“选择性传播有用状态”的机制解释,也提示对每个 token 用同样强度可能浪费计算。(§4.4,PDF 第 11–12 页;附录 C,PDF 第 34–35 页)
4.4 生成任务:收益因任务与调参方式而异
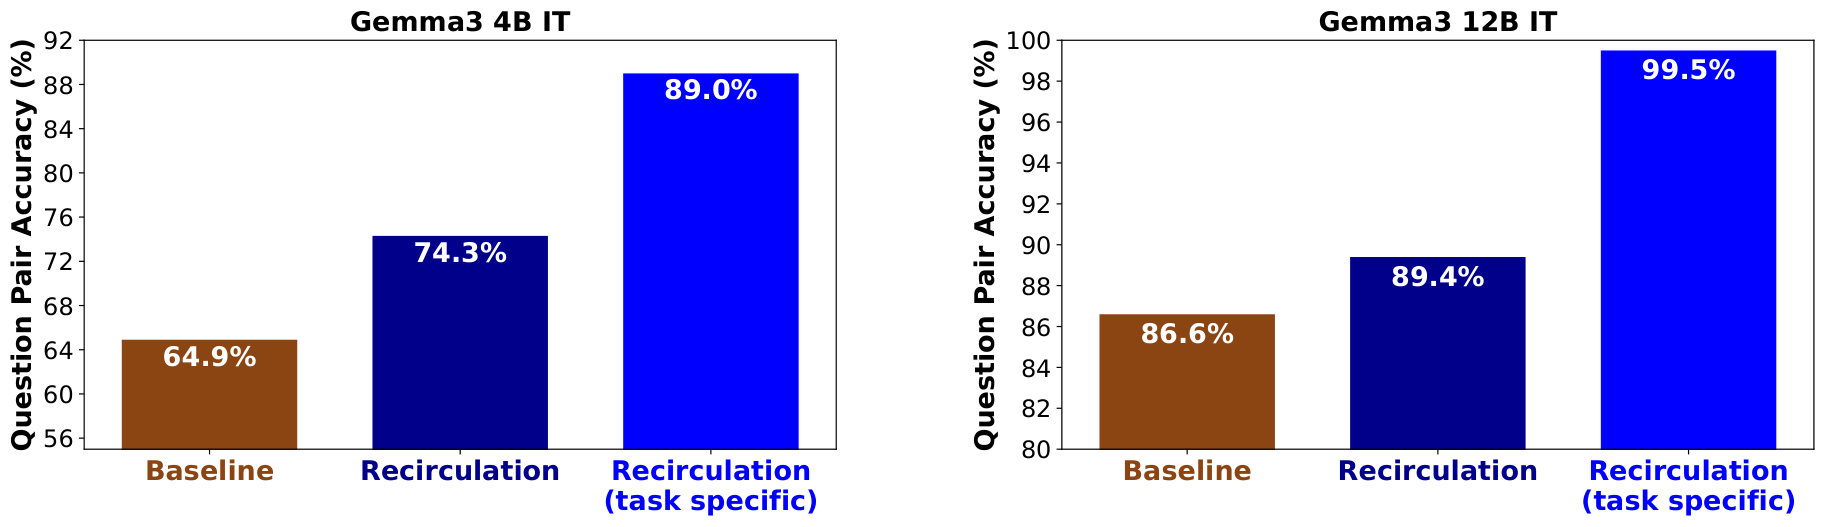
图 10(PDF 第 12 页)的预先选定层位结果:Gemma3 4B IT 从 64.9% 到 74.3%,12B IT 从 86.6% 到 89.4%;按错误率计,相对减少分别约 26.8%、20.9%。图中的任务专用搜索还达到 89.0% 和 99.5%,但作者明确把这视为在同一任务上调参所得的上限,不能与预先选定的跨任务设置等同。语境化图 11(PDF 第 13 页)在多数条件下也有提升;12B 的 factual/gender 问题接近天花板,而多义词问题随干扰句增加仍明显下滑,例如五句干扰时错误率只从 38.47% 降到 36.25%(附录表 D.1,PDF 第 36 页)。
八项零样本单 token 基准(表 2,PDF 第 14 页)的固定系数结果为 6 项上升、2 项下降,平均提高约 0.23 个百分点。例如 MMLU 从 57.90% 到 58.28%,HellaSwag 从 75.89% 到 75.86%;这些平均收益远小于上述指令任务的变化。实验用 MMLU 开发集寻找层位与系数,与评估问题不同;附录另换四组层位,40 个任务×配置配对中有 7 个下降。(§4.5,PDF 第 14 页;附录 D,PDF 第 37 页)
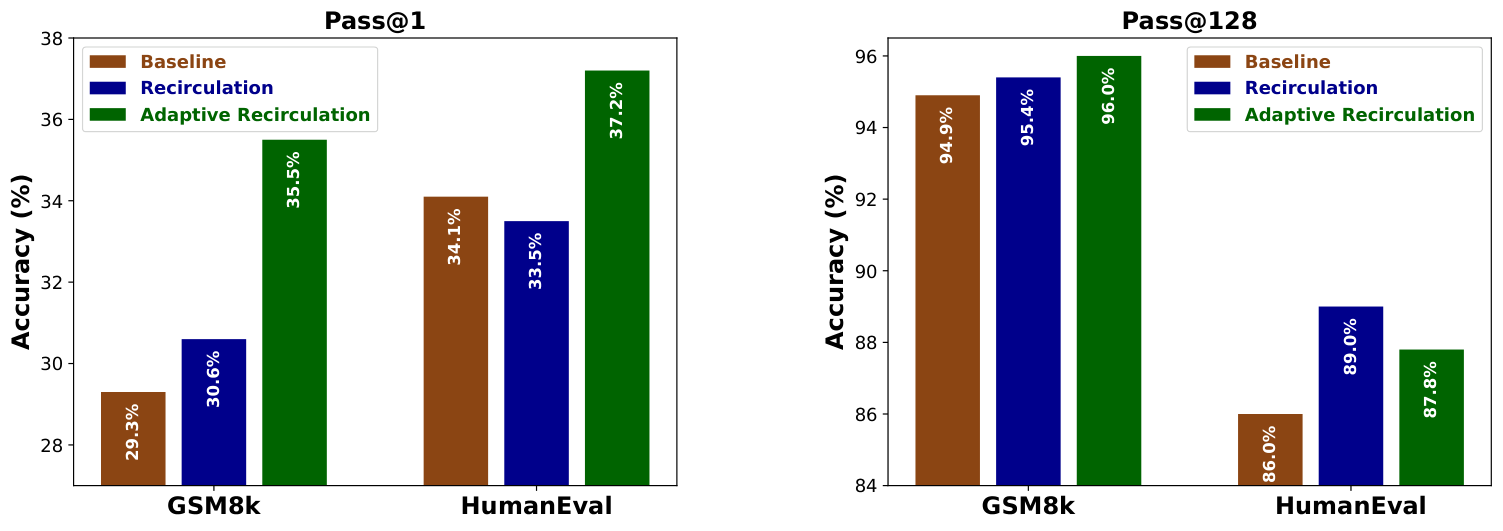
图 12(PDF 第 15 页)区分固定与自适应版本。固定回流让 GSM8k pass@1 29.3→30.6%,却让 HumanEval pass@1 34.1→33.5%;pass@128 则分别 94.9→95.4%、86.0→89.0%。Adaptive 在训练了任务相关的系数 MLP 后,pass@1 升至 GSM8k 35.5%、HumanEval 37.2%。摘要的 GSM8k“相对准确率 +21%”是 $(35.5-29.3)/29.3$,不是 +21 个百分点;它同时相当于错误率相对下降约 8.8%。Adaptive 的 HumanEval pass@128 为 87.8%,低于固定回流的 89.0%,所以自适应并非每一指标都更好。HumanEval 的适配训练来自另一个代码数据集 BigCodeBench。(§4.5–4.6,PDF 第 15–16 页;附录 D,PDF 第 38 页)
4.5 Adaptive:训练反馈通路,冻结原模型
Adaptive 版把当前 token 的源层与目标层向量拼接,输入一个两隐层 GELU MLP,输出按维度的 $\boldsymbol\alpha,\boldsymbol\beta\in[0,1]^{d}$,从而写成 $z'=\boldsymbol\alpha\odot f(s)+\boldsymbol\beta\odot d$。原 Gemma3 权重冻结,但系数 MLP 经 BPTT 训练;论文的语言建模消融使用 1B PT,在 arXiv/C4/PG-19 共各 250 篇训练文档的 1024-token 窗口上训练 100 步,并让许多非首窗口省略 BOS 来放大方法差异。(§4.6,PDF 第 15–16 页;附录 D.5,PDF 第 38 页)
| 1B PT,九语料平均相对困惑度下降 | 结果 |
|---|---|
| 固定系数回流 | 8.5% |
| 学习常数标量 | 8.4% |
| 学习 token 条件标量 | 11.7% |
| 学习常数向量 | 20.6% |
| 学习 token 条件向量(Adaptive) | 23.0% |
| 解冻原模型完整微调 | 21.6% |
图 13(PDF 第 15 页)支持两个设计判断:按维度调节比仅调标量更有效,依 token 决定系数又比常数更有效。23.0% 是这个含缺 BOS 窗口、特定训练/验证语料组合的九数据集均值,不能与主表 1 正常带 BOS 的 0.09%–0.62% 直接比作唯一由 MLP 带来的净改善。
自适应在单 token 任务的泛化尤其依赖训练集。表 2 中在 MMLU 测试集的一部分(约 3600/14000 题)训练 MLP,随后又在整个测试集评估 MMLU,得到 59.83%;这列的 MMLU 数值含训练样本,不能当作独立测试提升。改用 MMLU 辅助训练集时为 58.63%,改用 ARC Easy/Challenge 训练则使 MMLU 降至 56.05%/55.02%,多个其他任务也下降。跨任务适配的训练集选择是结果的关键条件。(§4.6、表 2,PDF 第 14–16 页)
五:结论与使用时的判断
论文最有价值的想法是把现成模型的深层语境状态回送给较浅层,并把第二次遍历与下一个 token 的首次遍历流水化。图 3–4 给出与单 token 深度 looping 不同的状态路径;层位搜索、token 干预与部分下游任务结果支持其有效性。固定系数版本可作为无需改权重的诊断式架构改造;自适应版本进一步展示“只训练反馈通路”的潜力。
实际采用时,三个条件会改变结论:预填充的顺序成本尚无实测吞吐,长上下文可能很贵;反馈层位、幅度和归一化随模型与任务变化,错误层位能显著损伤困惑度;自适应收益包含系数网络训练,且某些下游列存在任务数据重叠。论文因此更像一个可实验的架构方向,而不是已经具备通用部署配置和延迟保证的即插即用方案。(§5,PDF 第 16–18 页)