DeltaLog:延迟物化递归状态以加速线性注意力解码
论文:DeltaLog: Deferred Materialization of Recurrent States for Linear Attention Decoding
作者:Junqing Lin、Jingwei Sun、Guangzhong Sun,中国科学技术大学
版本:arXiv:2608.15533v1,提交于 2026-08-16;本次研读与获取日期:2026-10-10
链接:arXiv · 原文 PDF · 英文汇报 PDF · 可编辑 TeX
论文总览
线性注意力把不断增长的 token 级 KV 缓存换成固定大小的矩阵状态,但大批量解码仍需在每个 token 后读写这些矩阵。DeltaLog 抓住一个结构上的机会:单步新增信息能够用两个向量表示,长期历史却必须保存在一个稠密矩阵中;两者不必在每一步都合并并写回显存。
作者将状态表示为“稠密基底+近期紧凑更新日志”。通常只追加 key/value 更新因子及衰减信息,每隔 $M$ 步才把日志合并进基底。查询和 Delta-rule 纠正通过基底与日志共同计算,因此推迟的是物理写回,而逻辑状态仍随每个 token 更新。每步仍然读取稠密基底,性能收益主要来自减少写流量。
本文的贡献有三层:给出保持递推语义的状态表示及不变量;把它实现为有明确写入归属的 GPU 分块内核;将追加与合并两种执行路径接入基于 vLLM 的服务原型。权重和预填充计算保持原样。论文没有通过重新训练模型获得质量或速度收益。
| 证据层次 | 关键结果 | 对象与条件 |
|---|---|---|
| 内核延迟 | 相对 FLA 最高加速 1.86× | RTX 4090,GDN,图 7 的 $B=128$ |
| 写流量 | 原文报告减少 7.83× | H200,GDN,$B=128,M=8$,Nsight Compute 计数 |
| 总 DRAM 流量 | 减少 1.64× | 与上行同一配置;保留了基底读取成本 |
| 整模型解码 | 加速 1.05–1.20× | H200,两种模型、三个批量,共六组配置 |
| 数值行为 | 所测输出最大相对误差为 0.00303–0.00450 | 128-token 内核 rollout,所选合并间隔 |
这些数字分别衡量内核速度、写流量、总流量和整模型速度,不能相互替代。来源:Sec. 5.2–5.6,PDF pp. 9–12,Figs. 6–8、12,Table 4。
结构地图
下文页码均为从 1 开始的 PDF 页码,与本文印刷页码一致。
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 提出每 token 稠密写回造成的 state-update tax | pp. 1–2,Fig. 1 |
| 2.1 Recurrent Form of Linear Attention | 对角衰减+外积更新的统一接口 | pp. 2–3,Eqs. (1)–(3),Table 1 |
| 2.2 Recurrent State in Autoregressive Decoding | 区分 prefill 与 decode | p. 3 |
| 2.3 The State-Update Tax in Serving | 状态维护成本随并发增加 | p. 3,Fig. 2 |
| 2.4 Why the State-Update Tax Is Memory-Bound | 流量规模与算术强度分析 | pp. 3–4,Fig. 3 |
| 3.1 Append–Merge Decode Cycle | 状态布局、追加和合并流程 | pp. 4–5,Fig. 4,Algorithm 1,Eqs. (4)–(6) |
| 3.2 State Invariant and Traffic Model | 等价性与流量收益条件 | pp. 5–6,Eqs. (7)–(11) |
| 3.3 Tiled Kernel Decomposition | value 维切片、重放复用和单写者 | pp. 6–7,Fig. 5 |
| 3.4 Operator Instantiations | GDN、KDA、RWKV6 的差异 | p. 7 |
| 4 End-to-End System Implementation | 双 CUDA Graph、状态槽和分阶段队列 | p. 8 |
| 5.1 Experimental Setup | 平台、精度与基线 | pp. 8–9,Tables 2–3 |
| 5.2 Kernel Decode Performance | 两种 GPU 上的内核收益 | pp. 9–10,Figs. 6–7 |
| 5.3 Where the Speedup Comes From | 流量剖析与 split replay 消融 | pp. 10–11,Figs. 8–9 |
| 5.4 Sensitivity to Merge Interval and State Size | 合并间隔与状态规模的取舍 | pp. 10–11,Figs. 10–11 |
| 5.5 Numerical Behavior | 有限精度下的输出和状态误差 | p. 11,Fig. 12 |
| 5.6 End-to-End Serving Impact | 整模型解码 TPOT | p. 12;Table 4 位于 p. 11 |
| 6 Discussion and Limitations | 有利工作区间与系统收益上限 | p. 12 |
| 7 Related Work | 定位于保留模型语义的 IO 优化 | p. 12 |
| 8 Conclusion | 总结状态物化策略的系统价值 | pp. 12–13 |
一:动机——固定大小的状态仍可能很昂贵
1.1 更新很小,立即物化却很大
对一个注意力头,递归状态 $S_t\in\mathbb{R}^{d_k\times d_v}$ 保存已经处理的历史。原文采用如下系统分析接口:
其中 $\lambda_t$ 是对数衰减,$a_t\in\mathbb{R}^{d_k}$、$b_t\in\mathbb{R}^{d_v}$ 是本 token 的更新因子。普通线性注意力对应无衰减的加法;GDN、KDA 增加 Delta-rule 纠正。对于以更新后状态读出的情形,输出为 $o_t=\phi(q_t)^\top S_t$。具体算子需要保留自己规定的更新前后读出顺序。来源:Sec. 2.1,PDF p. 2,Eqs. (2)–(3)、Table 1。
新增因子的大小是 $O(d_k+d_v)$,而立即读写整个状态的成本是 $O(d_kd_v)$。加上批量 $B$ 和头数 $H$,状态形状是 $[B,H,d_k,d_v]$。作者把每步过早展开、提交稠密状态所造成的维护成本称为状态更新税(state-update tax)。
以原文的 $B=512,H=32,d_k=d_v=128$、FP32 状态为例,单层状态共 1 GiB;一次完整读取加写回约 2 GiB。状态大小不随上下文增长,并不妨碍它随并发增长而成为带宽瓶颈。来源:Sec. 2.4,PDF p. 4。
1.2 这一成本在整模型中可见
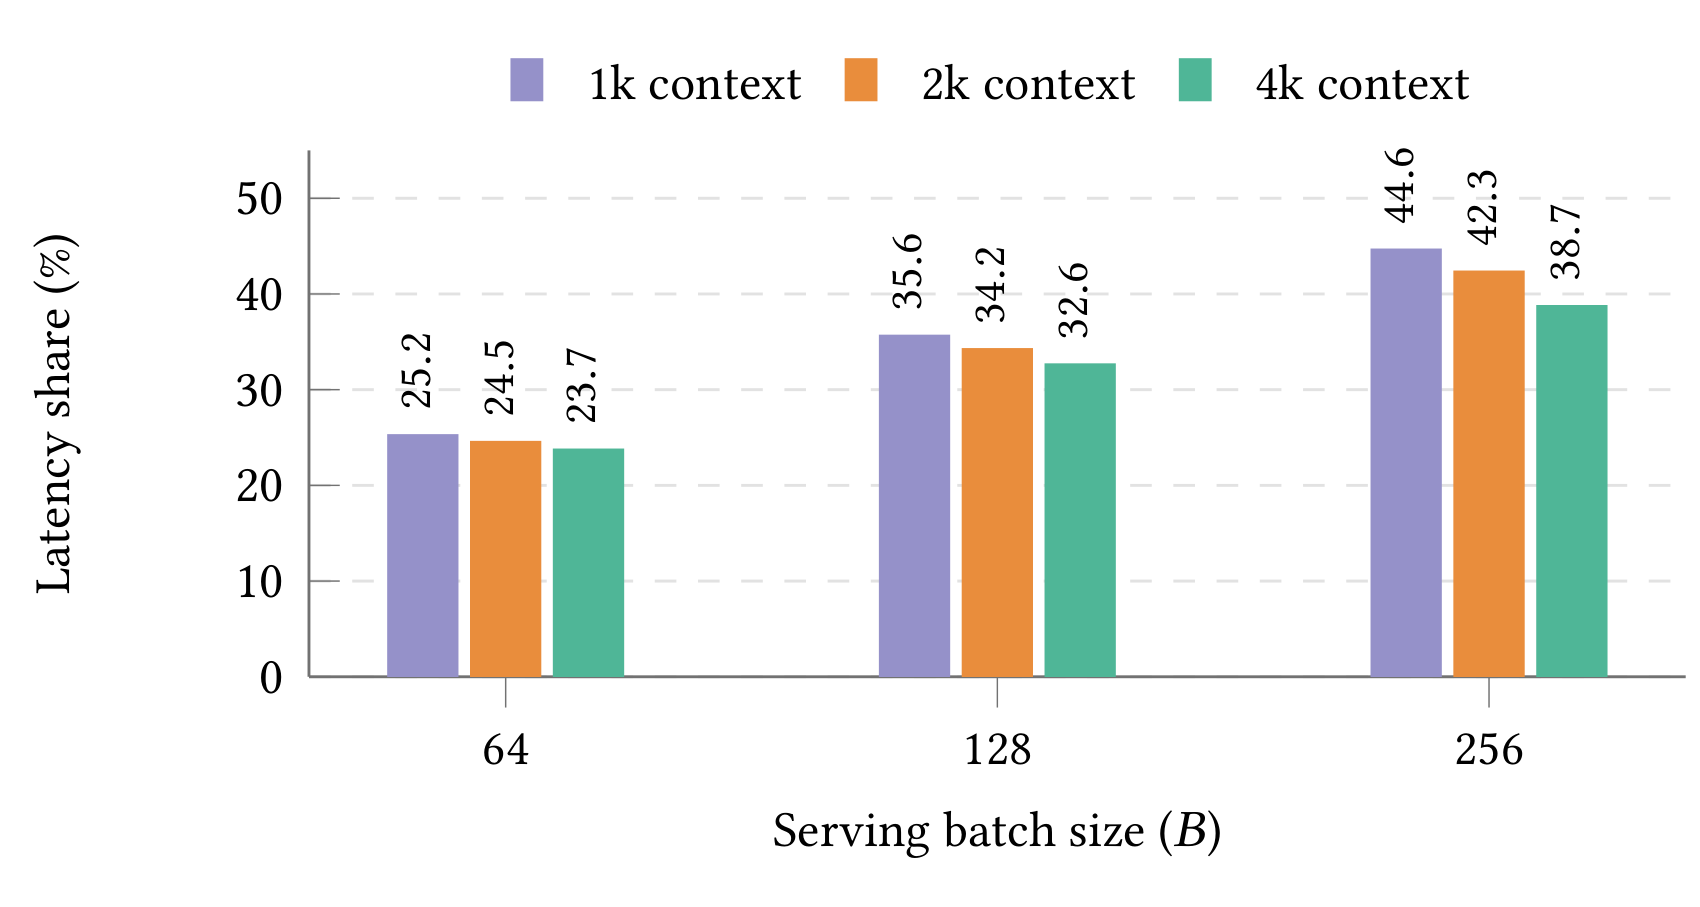
原文 Fig. 2,PDF p. 3;从原页裁切。横轴是服务批量,纵轴是延迟占比;三种颜色对应 1k、2k、4k 上下文。在 Qwen3.6-35B-A3B 的 1k 上下文测量中,占比从 $B=64$ 的 25.2% 升至 $B=256$ 的 44.6%。2k、4k 下也呈相同并发趋势。这里测的是状态物化路径在整模型中的占比,不能直接解读为“44.6% 都能够被消除”。
原文按每个状态元素约 4 FLOPs、一次 FP32 读取和写入估算算术强度:
这个估计只保留主要状态流量,省略向量、元数据和算子额外计算。它解释了作者为什么优先优化数据移动,而不只减少乘加。来源:Sec. 2.4,PDF pp. 3–4,Fig. 3。
二:方法——把状态更新与稠密写回分开
2.1 物理表示及符号
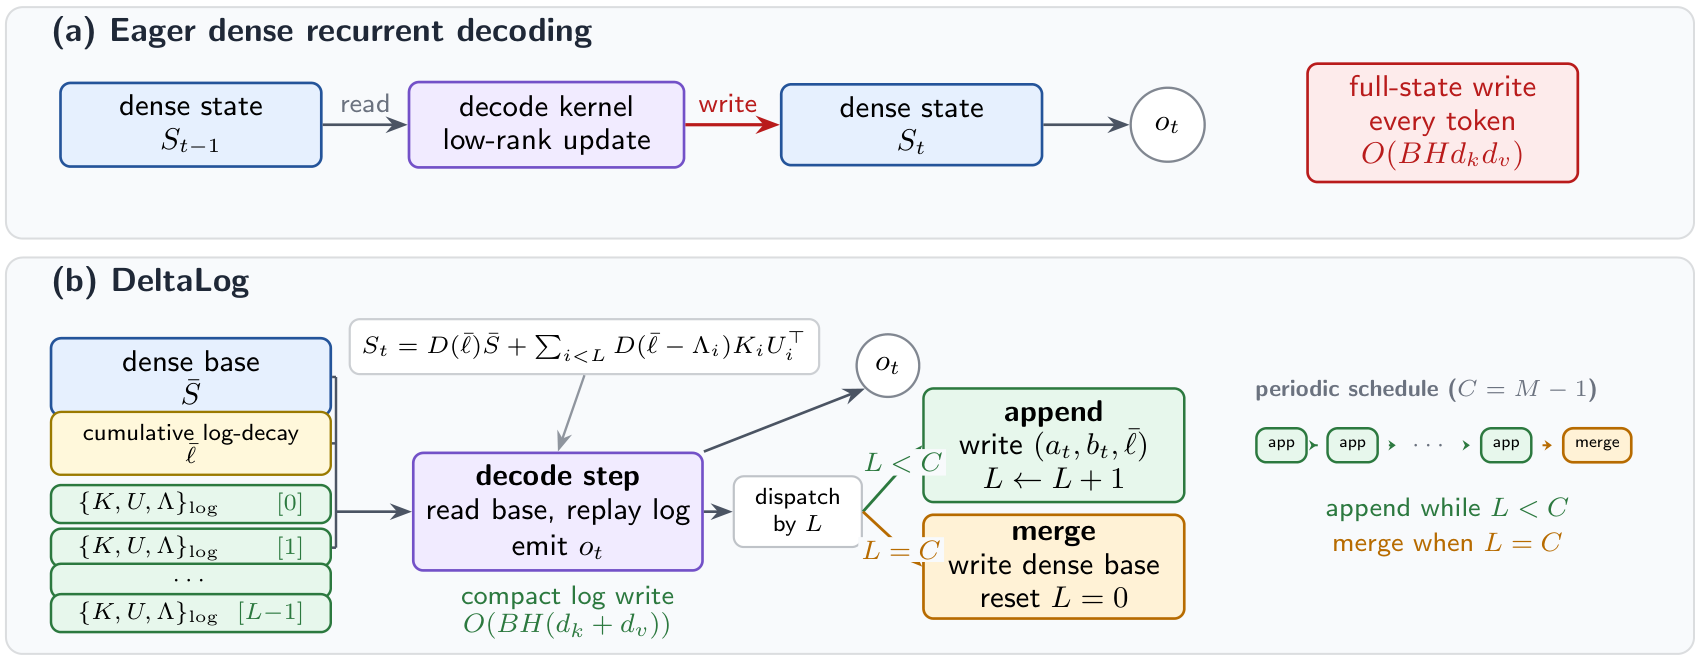
原文 Fig. 4,PDF p. 5,复用作者图件。上半部分每步生成并写回完整状态;下半部分通过基底与日志计算输出,再由日志长度决定追加或合并。图中的两条分支改变提交目标,模型每步仍观察到完整逻辑历史。
| 符号 | 含义与形状 |
|---|---|
| $\bar S$ | 上一次合并后的 FP32 稠密基底,$[B,H,d_k,d_v]$ |
| $\bar\ell$ | 自上次合并以来的累计对数衰减;每头一个标量,或每个 key 坐标一个值 |
| $K_{\log}$ | 保存更新因子 $a_i$,$[B,H,C,d_k]$ |
| $U_{\log}$ | 保存更新因子 $b_i$,$[B,H,C,d_v]$ |
| $\Lambda_{\log}$ | 每条日志插入时的累计对数衰减快照,宽度与 $\bar\ell$ 相同 |
| $M$、$C$、$L$ | 合并周期、日志容量 $C=M-1$、当前日志条数 $0\le L\le C$ |
这里的 $U_{\log}$ 不总是原始 value:对 Delta-rule 算子,它保存经过旧状态纠正的更新向量。这一点决定了如何重放以及为什么要保留 FP32 精度。来源:Sec. 3.1、3.4,PDF pp. 4–5、7。
2.2 状态不变量:每条更新只承受插入后的衰减
DeltaLog 的核心不变量是原文 Eq. (7):
基底代表较早历史,所以承受合并后累积的全部衰减。日志第 $i$ 条在更晚时刻插入,应该只承受插入后的衰减;两个累计对数值相减正好给出这一段区间。于是,物理存储中的基底可以暂时不变,逻辑状态仍然是最新的。来源:Sec. 3.2,PDF p. 6。
追加闭包依赖一个简单恒等式:
旧项全部增加当前衰减,新项的快照等于新的累计衰减,因此新项刚插入时权重为 $D(0)=I$。这一证明适用于文中使用的标量或对角衰减及可记录的紧凑外积更新。若状态变换不能保持这种紧凑形式,就不能直接套用同一日志设计。
2.3 追加与合并:顺序是正确性的一部分
一个周期包含 $M-1$ 次追加和一次合并。按 Algorithm 1,可把每步理解为以下过程:
- 从当前基底和日志计算算子所需的更新前读出。Delta-rule 的旧状态纠正必须取到正确时刻的状态。
- 令 $\bar\ell\leftarrow\bar\ell+\lambda_t$,形成本 token 的 $a_t,b_t$,并计算算子规定的更新后输出。
- 若进入该步时 $L
- 若进入该步时 $L=C$,将旧日志与当前更新一起物化进基底,清空日志并重置累计衰减。
合并使用原文 Eq. (6):
此处的 $\bar\ell$ 已包括当前 token 的衰减。当前更新直接加入合并结果,无需先占用一个额外日志槽。随后设 $\bar\ell=0,L=0$,不变量就退化为 $S_t=\bar S$。因此追加和合并两条路径都保持同一个递推状态。来源:Sec. 3.1–3.2,PDF pp. 5–6,Algorithm 1、Eqs. (4)–(7)。
教学例子。 将矩阵简化为一个标量,设 $S_0=10$,每步衰减为 $1/2$,连续三步的新增量为 $2,3,4$,并取 $M=3$。
| 步数 | 立即更新得到的逻辑状态 | DeltaLog 的基底 | DeltaLog 的表示 |
|---|---|---|---|
| 1 | $7$ | $10$ | $10/2+2$,记录第一条更新 |
| 2 | $6.5$ | $10$ | $10/4+2/2+3$,记录第二条更新 |
| 3 | $7.25$ | $7.25$ | 合并 $10/8+2/4+3/2+4$,日志清空 |
这个例子展示“基底暂时没有更新”与“逻辑状态没有更新”的区别;它不是原文实验。
2.4 直接从基底和日志计算读出
以下是从 Eq. (7) 展开的教学推导。令 $x\in\mathbb R^{d_k}$ 为一次状态查询,则
第一项读取稠密基底。第二项先在 key 维计算一个标量,再乘 value 向量。由此可直接得到输出,或得到 Delta-rule 所需的旧状态查询,无需先将所有日志外积写成一个完整显存矩阵。
按 Table 1 的更新抽象,Delta-rule 取 $a_t=k_t$,并以 $\hat v_t=S_{t-1}^\top k_t$ 构造 $b_t=\beta_t(v_t-\hat v_t)$。这里将向量统一写成列向量以保持维度一致。更新依赖旧状态,并不破坏日志表示:先算出正确的 $\hat v_t$,再把得到的 $b_t$ 记录下来即可。实际算子的完整前向仍应保持其衰减、纠正与读出的原始顺序;论文也在 Algorithm 1 单独保留了更新前读出。来源:Table 1,PDF p. 2;Algorithm 1,p. 5;Sec. 3.3,pp. 6–7。
2.5 流量模型:节省写回,付出重放
设 $p_S,p_K,p_U$ 分别为状态、key 日志、value 日志每个元素的字节数,$d_\lambda=1$ 表示每头标量衰减,$d_\lambda=d_k$ 表示逐 key 衰减。单层的主要存储量为:
这里的 $C_{\mathrm{entry}}$ 是整批、所有头的一条日志位置所需字节;不要与日志容量 $C=M-1$ 混淆。FP32 衰减元数据带来式中的系数 4。
稠密实现的每步流量约为
一个周期中,写入 $M-1$ 条日志,重放次数合计为 $0+1+\cdots+(M-1)=M(M-1)/2$。假设每次重放只读每条日志一次,则
这五项依次是公共输入、每步基底读取、摊销基底写回、日志读写和累计衰减读写。模型省略临时 scratch、索引及实际分块造成的额外访问。其收益条件是
所以 $M$ 增大时,写回频率下降,日志重放却近似线性增加。来源:Sec. 3.2,PDF p. 6,Eqs. (8)–(11)。
进一步解读。 忽略日志和公共开销,只比较状态读写,流量改善上限为 $2/(1+1/M)$:$M=8$ 时约 1.78×,即使继续增大 $M$ 也只趋近 2×,因为基底每步仍须读取。这是简化流量模型的结论,不是所有 GPU 实现的严格速度上限。
日志还会增加驻留显存。按 Table 3 的内核形状与精度,$B=128$ 时稠密基底为 256 MiB;由上式推导出的辅助驻留量如下,未计长度索引、对齐和 scratch:
| 算子 | $M$ | $(M-1)C_{\mathrm{entry}}+C_{\mathrm{decay}}$ | 相对基底增加 |
|---|---|---|---|
| GDN | 8 | 21.125 MiB | 8.25% |
| KDA | 4 | 17 MiB | 6.64% |
| RWKV6 | 4 | 14 MiB | 5.47% |
这是本次根据原文布局计算的容量代价,不是作者测得的峰值显存。DeltaLog 用有限的额外存储换取较少的数据移动。
2.6 GPU 实现:复用 key 侧工作,分片写 value
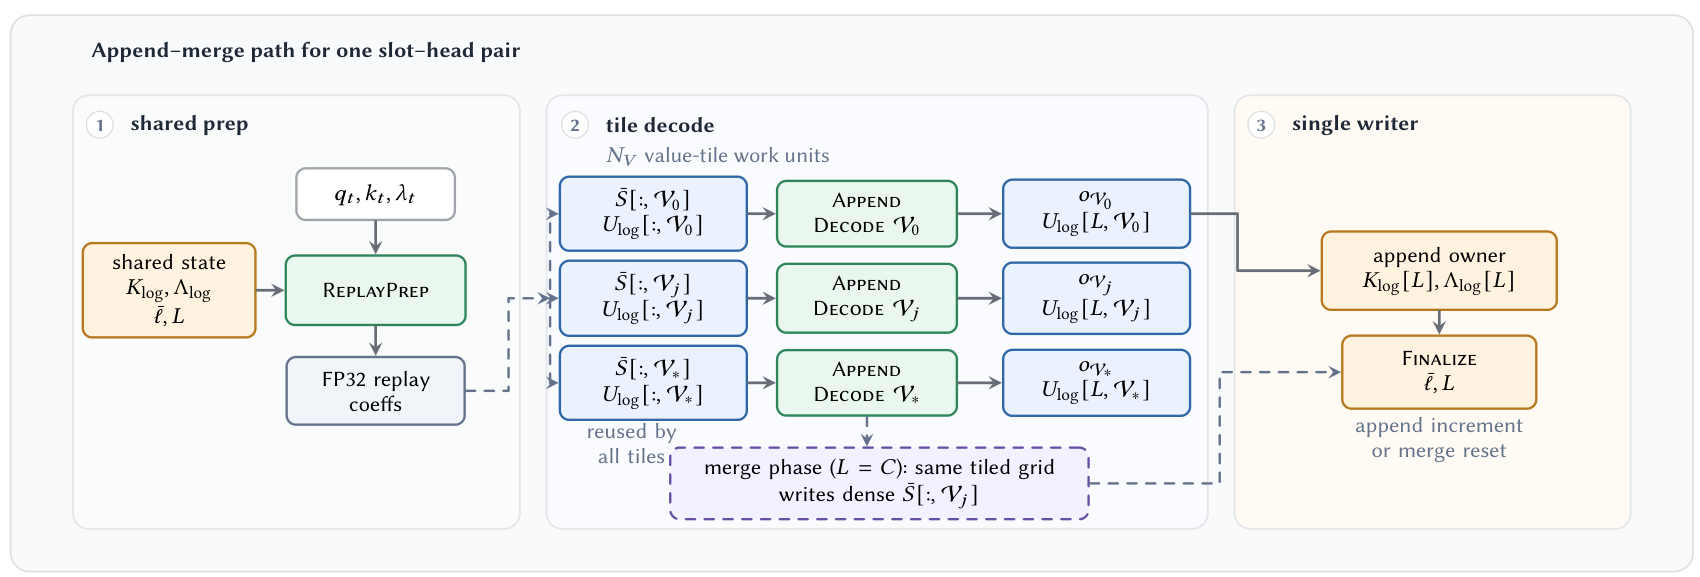
原文 Fig. 5,PDF p. 7;从原页裁切。先读左侧共享准备,再读中间 value 切片,最后看右侧单写者。状态沿 value 维切成 $d_k\times B_V$ 的块,块数为 $N_V=\lceil d_v/B_V\rceil$。
各 value 块独占自己的 $\bar S[:,\mathcal V_j]$、$U_{\log}[:,\mathcal V_j]$ 和输出片段;key 日志、衰减快照、累计衰减和 $L$ 则由同一 slot–head 下的所有块共享。
作者据此安排三阶段:
- ReplayPrep:在值得复用时,每个 slot–head 只计算一次 key 侧重放投影,存入临时 FP32 scratch。
- AppendDecode:并行读取各自基底块和值日志,复用投影系数,计算输出及新 value 日志分片。
- 共享提交与 Finalize:指定写者写一次新 key 和衰减快照,再一次性更新累计衰减和日志长度。合并阶段沿用分块网格,但写回的是完整基底块,最后清空元数据。
单写者保证共享状态只提交一次。如果每个 value 块都递增 $L$ 或提交共享 key,就会产生重复写入甚至状态错误。ReplayPrep 的使用则取决于成本:额外启动和 scratch 访问必须由节省的重复计算抵消,这一点在消融实验中有直接证据。来源:Sec. 3.3,PDF pp. 6–7。
2.7 三种算子的关键差异
| 算子 | 衰减粒度 | value 更新 | 日志 K/U 精度 | 主要成本 |
|---|---|---|---|---|
| GDN | 每头标量 | Delta-rule 纠正 | BF16 / FP32 | 有旧状态查询,但衰减元数据很小 |
| KDA | 逐 key 坐标 | Delta-rule 纠正 | BF16 / FP32 | 保留纠正,同时增加逐坐标衰减和日志元数据 |
| RWKV6 | 逐 key 坐标 | 原始 value | BF16 / BF16 | 元数据较多,但省去 Delta-rule 纠正路径 |
三者的基底和衰减元数据都用 FP32。GDN/KDA 的 value 日志使用 FP32,是为了减轻纠正中相减造成的数值损失;RWKV6 的原始 value 更新允许两侧日志都使用 BF16。来源:Sec. 3.4,PDF p. 7;Table 3,p. 9。
2.8 接入服务系统:必须管理执行阶段
服务原型为每种统一 decode-batch 描述分别捕获 append 和 merge 两种 CUDA Graph,将阶段纳入 graph cache key。请求通常进入追加队列,到达合并边界后转入合并队列,合并完成再返回。新请求的 prefill 输出初始化基底,辅助日志为空;状态槽复用时重置其辅助缓冲和元数据。
因此集成工作包括:状态分配器扩展、阶段感知的图选择,以及与连续批处理相容的请求迁移。论文的性能评估采用 batch-synchronous graph-mode 原型;它展示了整模型解码收益,但没有给出混合到达率下的队列等待时间或尾延迟曲线。来源:Sec. 4、5.1、5.6,PDF pp. 8–9、12。
三:实验——分别检验速度、机制和数值行为
3.1 平台与共同配置
内核实验在 H200 NVL 和 RTX 4090 上进行;整模型服务实验仅在 H200 上进行。独立 Triton 内核统一采用 $H=32,d_k=d_v=128$,激活 BF16、基底 FP32,合并间隔分别选 GDN 8、KDA 4、RWKV6 4。不能把这些独立内核的固定头数和维度直接套到整模型的全部层上。来源:Sec. 5.1,PDF pp. 8–9,Tables 2–3。
| 比较对象 | 在实验中的角色 |
|---|---|
| PyTorch Compile | 经 torch.compile 优化的稠密参考实现 |
| Fast Linear Attention(FLA) | 三种算子都有的优化 Triton 稠密基线,主要速度比的分母 |
| vLLM dense kernel | 当前集成中 GDN/KDA 的稠密内核;未提供 RWKV6 路径 |
| 同一 vLLM 服务原型 | 整模型实验只替换递归 decode 路径,其他模型与运行条件匹配 |
主要指标是每输出 token 时间(TPOT,越低越好)、基线延迟除以 DeltaLog 延迟的加速比(越高越好)、DRAM 读写 GiB(越低越好),以及相对稠密参考的输出和状态误差。合并开销必须算入周期平均值;只计追加阶段会高估收益。
3.2 六组实质性问题
| 原文实验 | 检验问题 | 协议与证据 |
|---|---|---|
| 5.2 内核性能 | 三种算子、两种 GPU 是否均获益? | $B\in\{64,128,256,512\}$,Figs. 6–7 |
| 5.3 流量剖析 | 改善是否来自减少稠密写回? | H200 GDN,$B=128,M=8$,Fig. 8 |
| 5.3 拆分重放消融 | ReplayPrep 是否值得额外开销? | H200,完整周期 CUDA Graph,$M=4,8$,Fig. 9 |
| 5.4 敏感性 | 多久合并、什么规模适合? | $B=128$ 扫描间隔;固定算子维度、改变批量扫描状态总量 |
| 5.5 数值行为 | 重排累积顺序是否产生可接受误差? | 128-token rollout,$B=64,128,256$,Fig. 12 |
| 5.6 服务效果 | 内核收益能保留多少? | 两个模型、三个批量,每次生成 128 token,Table 4 |
四:结果——优势来自减少写回,收益受重放和系统占比约束
4.1 内核性能:跨算子获益,但幅度不同
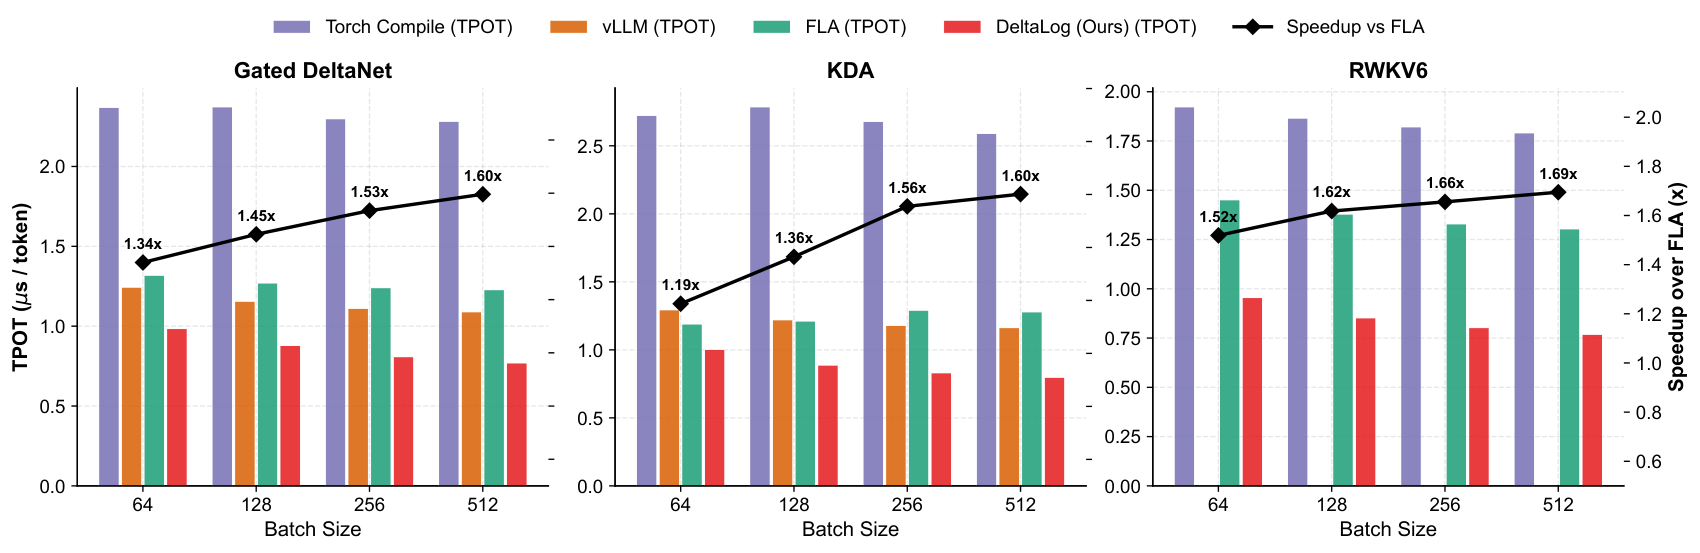
原文 Fig. 6,PDF p. 9。三个面板依次为 GDN、KDA、RWKV6;柱形对应左轴 TPOT,黑色折线对应右轴相对 FLA 的加速。应先在同一面板、同一批量下比较,再跨算子观察趋势。
下表直接保留图中折线标注的加速比,避免混用左轴 TPOT 与其他图的周期平均毫秒数。
| GPU / 算子 | $B=64$ | $B=128$ | $B=256$ | $B=512$ |
|---|---|---|---|---|
| H200 / GDN | 1.34× | 1.45× | 1.53× | 1.60× |
| H200 / KDA | 1.19× | 1.36× | 1.56× | 1.60× |
| H200 / RWKV6 | 1.52× | 1.62× | 1.66× | 1.69× |
| RTX 4090 / GDN | 1.84× | 1.86× | 1.74× | 1.69× |
| RTX 4090 / KDA | 1.30× | 1.35× | 1.48× | 1.55× |
| RTX 4090 / RWKV6 | 1.63× | 1.41× | 1.53× | 1.61× |
来源:Figs. 6–7,PDF p. 9;Sec. 5.2,pp. 9–10。相对 H200 上可用的 vLLM 稠密内核,GDN 加速 1.26–1.42×,KDA 为 1.29–1.46×。
GDN 的标量衰减使日志较轻;KDA 增加逐 key 衰减,部分配置收益较低;RWKV6 虽然同样有逐 key 元数据,却省去旧状态纠正。三者对比说明,日志成本取决于算子结构,不能只看稠密状态大小。
4.2 流量剖析:写入大幅下降,读取略有上升
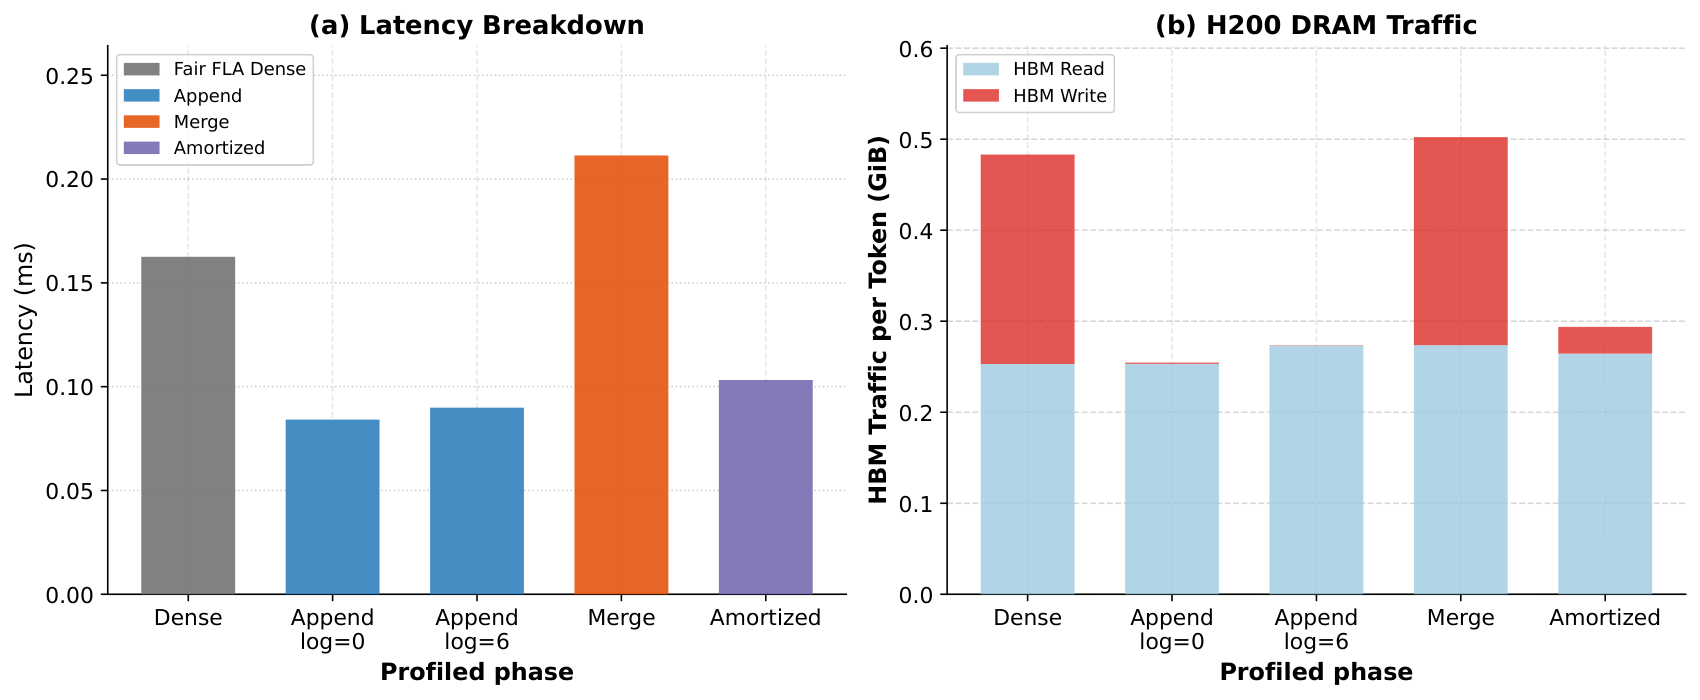
原文 Fig. 8,PDF p. 10。左面板依次是稠密基线、日志长度为 0 和 6 的追加、带 7 条日志的合并、周期摊销结果;右面板用堆叠柱分别显示读取与写入。配置为 H200、GDN、$B=128,M=8$。
| 阶段 | DRAM 读取 | DRAM 写入 | 含义 |
|---|---|---|---|
| Dense | 0.253 GiB | 0.230 GiB | 每步读写完整状态 |
| Append,$L=0$ | 0.253 GiB | 很小,正文未给精确数 | 保留基底读取,只提交紧凑更新 |
| Append,$L=6$ | 0.273 GiB | 很小,正文未给精确数 | 日志重放使读取增加 |
| Merge,$L=7$ | 0.274 GiB | 0.229 GiB | 恢复一次完整写回 |
| 周期平均 | 正文未单列 | 0.0294 GiB | 写回被八步摊销 |
Dense 总流量为 0.483 GiB;作者报告写流量减少 7.83×、总流量减少 1.64×。用正文已舍入的 $0.230/0.0294$ 计算约为 7.82,和作者报告仅有舍入差异。写流量下降很大而总流量改善较小,正对应“每步仍读基底”的设计。追加延迟随 $L$ 略增,合并比追加昂贵,所以必须以完整周期衡量收益。来源:Sec. 5.3,PDF p. 10。
4.3 拆分重放:额外内核有时会拖慢
作者比较融合追加内核与先计算重放点积的 split 路径;两者都保留相同的 metadata-finalization 阶段,并将整个合并周期捕获进 CUDA Graph。下表速度比为 fused 延迟 / split 延迟。
| 算子 | $M=4$ | $M=8$ | 对实现选择的含义 |
|---|---|---|---|
| GDN | 1.02–1.07× | 1.05–1.11× | 复用投影可稳定抵消准备阶段开销 |
| KDA | 0.998–1.003× | 1.03–1.04× | 所选 $M=4$ 几乎持平,长日志下才较明显 |
| RWKV6 | 0.979–0.980× | 1.00–1.02× | $M=4$ 下反而慢约 2% |
来源:Sec. 5.3,PDF p. 10;Fig. 9,p. 11;$B\in\{128,256,512\}$。这项消融直接限定了 Fig. 5 中共享准备阶段的适用性:GDN 更值得拆分,而 RWKV6 的融合路径本来就较轻。
4.4 合并间隔与状态规模:存在甜点区间
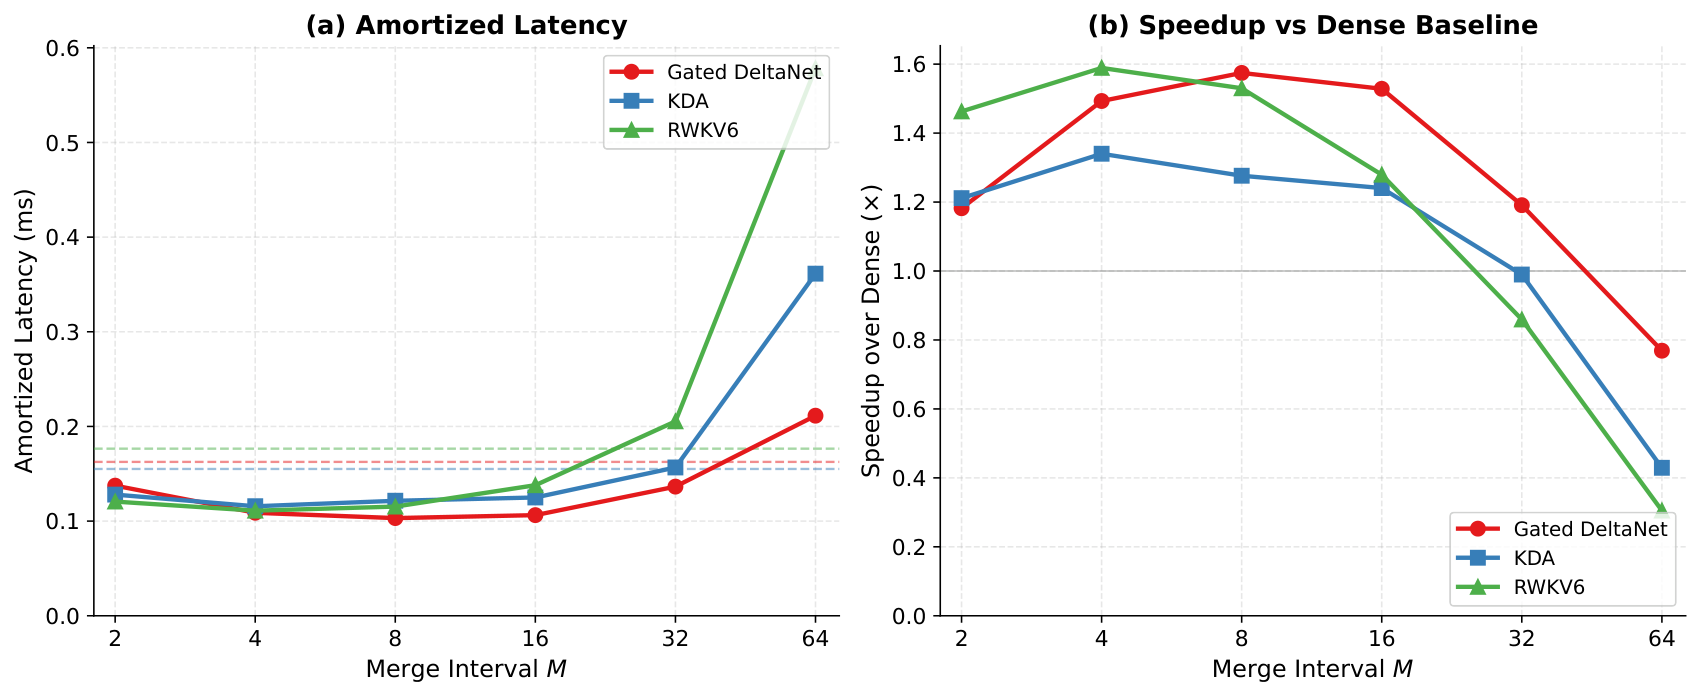
原文 Fig. 10,PDF p. 11。横轴是 $M$;左图是摊销延迟,右图是相对稠密基线的速度比,越过 1× 表示收益转为负值。H200、$B=128$ 的主扫描包含 $M\in\{2,4,8,16,32,64\}$。大间隔使日志重放变贵,尤其在逐 key 衰减的两种算子上。
| 算子 | 该扫描选出的 $M$ | 摊销延迟 | 相对 FLA 加速 |
|---|---|---|---|
| GDN | 8 | 0.103 ms | 1.57× |
| KDA | 4 | 0.116 ms | 1.34× |
| RWKV6 | 4 | 0.110 ms | 1.60× |
来源:Sec. 5.4,PDF p. 11。三种曲线体现相同的取舍,但最优间隔不同;这些是所测配置的经验选择。
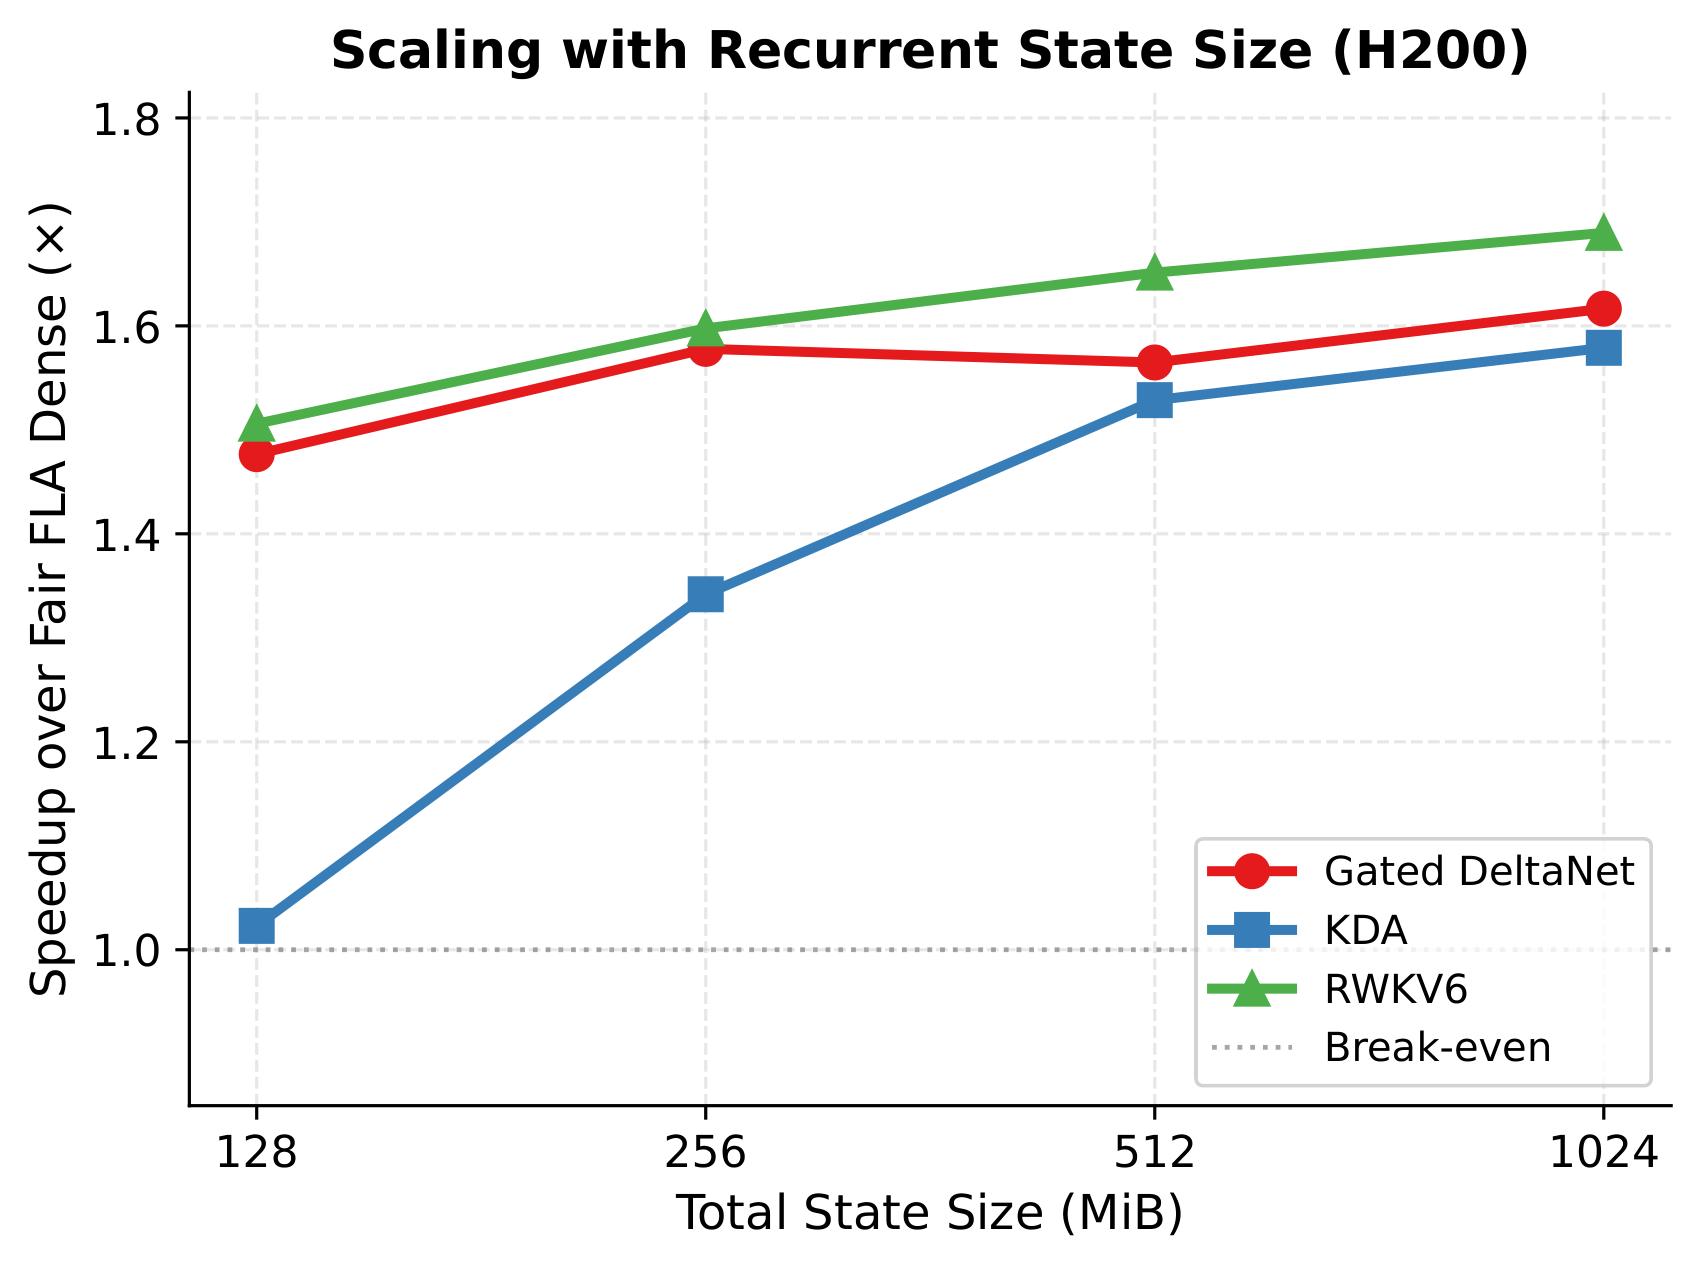
原文 Fig. 11,PDF p. 11。横轴是整批状态的 MiB,纵轴是相对 FLA 的加速。作者固定算子维度、通过改变批量让总状态从 128 MiB 增至 1024 MiB。GDN 从 1.48× 增至 1.62×;KDA 从 1.02× 增至 1.58×;RWKV6 从 1.51× 增至 1.69×。因此这一扫描同时改变了并发,不是单独扩大每个 head 的矩阵维度。
原文测量的一处未对齐。 图 6 与图 11 的部分名义对应点并不相同:按 Table 3 的形状,$B=64$ 对应 128 MiB,但 KDA 在图 6 标为 1.19×,图 11 / Sec. 5.4 报告 1.02×。原文未说明这两轮测量的配置或计时差异。这里将两个实验分别呈现;趋势支持“大状态更有利”,逐点数值不宜合并为一条统一曲线。
4.5 数值行为:代数等价与浮点结果需要分开
精确算术下,不变量证明给出与原递推相同的逻辑状态。实际实现改变累加顺序,并使用混合精度日志,因此作者另测 128-token rollout,批量为 64、128、256,采用各算子选定的 $M$。
| 算子 | 输出最大相对误差 | 物化状态最大相对误差 |
|---|---|---|
| GDN | 0.00303 | $7.92\times10^{-7}$ |
| KDA | 0.00450 | $4.61\times10^{-4}$ |
| RWKV6 | 0.00376 | $2.86\times10^{-7}$ |
来源:Sec. 5.5,PDF p. 11,Fig. 12。作者报告三者均通过仓库容差及考虑 BF16 的基准容差;图中还画出了 $10^{-2}$ 的参考线。正文没有给出相对误差的归一化方式与分母稳定项等完整定义,也没有逐项列出上述两套容差。
较合适的结论是:所测 128 步内核 rollout 在容差内与稠密参考一致。长生成中的误差演化,以及输出 token 是否发生变化,需要不同于这组内核数值测试的验证。KDA 的状态误差明显高于另两种算子,是后续长程测试值得优先关注的对象。
4.6 整模型解码:最高 1.20×,收益受路径占比限制
两个模型分别是 Qwen3.6-35B-A3B(GDN)和 Kimi-Linear-48B-A3B-Instruct(KDA)。下表为 H200 NVL 上的完整模型 decode TPOT,单位 ms/token,越低越好;每轮生成 128 token,基线使用相同模型、批量、精度和 CUDA Graph 配置。原文没有评测 prefill,因此这里的整模型收益不包含提示词处理阶段。
| 模型 / $M$ | 批量 | Dense | DeltaLog | 原文加速比 |
|---|---|---|---|---|
| Qwen / 8 | 64 | 8.36 | 7.75 | 1.08× |
| Qwen / 8 | 128 | 10.30 | 9.01 | 1.14× |
| Qwen / 8 | 256 | 16.07 | 13.40 | 1.20× |
| Kimi / 4 | 64 | 7.66 | 7.33 | 1.05× |
| Kimi / 4 | 128 | 8.92 | 8.13 | 1.10× |
| Kimi / 4 | 256 | 13.98 | 12.54 | 1.12× |
来源:Table 4,PDF p. 11;Sec. 5.6,p. 12。速度比沿用原文舍入值。比如 Qwen $B=256$ 的 TPOT 从 16.07 降到 13.40,延迟减少约 16.6%;“1.20× 加速”不应写成“延迟下降 20%”。
可用 Amdahl 定律解释内核与整模型收益的差距。以下是教学表达:设可优化路径占原延迟的 $f$,该路径加速 $s$,则
MLP、归一化、调度、内存管理和其他模型计算仍然消耗时间,故总收益自然小于递归内核收益。该公式帮助理解论文的系统结果,不用于把来自不同实验的 $f$ 与 $s$ 拼接成某组精确预测。
五:结论——物理状态表示是独立的优化空间
DeltaLog 最有价值的观察是:模型需要每步得到正确的逻辑状态,并不要求每步都把这一状态以完整稠密矩阵重新提交到显存。 只要更新具有可重放的紧凑结构,就能把频繁更新和偶尔物化分开。状态不变量回答“为什么正确”,流量模型回答“何时有利”,GPU 分工和服务阶段管理回答“怎样把收益保留下来”。
对实现者,三个取舍最直接:
- 合并频率决定写入与重放的平衡。 $M$ 应按算子和实际负载调优;逐 key 衰减不能直接沿用标量衰减的选择。
- 节省流量伴随额外状态。 基底仍然每步读取,日志增加有限驻留显存,并引入周期性合并成本;小状态可能缺少足够可节省的写流量。
- 服务收益要看完整路径。 论文支持大批量、图模式下的整模型 decode 改善;动态混合队列的尾延迟、长生成数值行为和服务容量仍是进一步部署评估中有具体意义的问题。
与架构级线性注意力工作相比,DeltaLog 保留已训练模型;与主要优化并行训练、prefill 或 token 级 KV 管理的方法相比,它把优化目标落在单 token 递归解码的稠密状态提交时机。原文的结果支持这一方向,最有说服力的组合证据是:不变量证明、DRAM 写流量剖析、合并间隔的性能曲线,以及两个模型上的 decode TPOT 改善。来源:Secs. 6–8,PDF pp. 12–13。