MemPrism:面向长程智能体的任务条件关系记忆视图
论文:MemPrism: Task-Conditioned Relational Memory Views for Long-Horizon Agents
作者:Zhisheng Chen、Bingfan Zeng、Bangde Cao、Zhengwei Xie、Yuxuan Li、Jinhan Li、Zheng Lu、Xiangchen Guan、Zikai Xiao、Rui Qian、Jingwei Song。前三位为共同第一作者。
版本:arXiv:2608.06745v1,arXiv 提交日期 2026-08-07。PDF 首页另印有 2026-08-10;本次身份与版本以 arXiv 元数据为准。
获取与研读日期:2026-09-27。研读修订:r1。
材料:本地原文 PDF · 作者主 TeX · 源码清单 · 英文汇报 PDF · 英文 TeX。
本笔记依据同版本 PDF 与作者 TeX 完成。已阅读 main.tex 实际引用的 Introduction、Related Work、Method、Experiments 和完整 appendix_body,覆盖正文、附录 A–E;关键公式、表格、图 1–5、案例图 B.1–B.2 均与 PDF 核对。没有执行作者代码、重跑实验或核验外部实验运行档案。下文页码均为从 1 开始的 PDF 页码,与本文件可见页码一致。论文正文不显示章节编号,因此使用真实标题定位,不自行补成“第 3 节”等编号。
论文总览
这篇论文把智能体记忆中的一个问题单独拿出来研究:信息被保存和找到之后,是否被组织成当前决策容易使用的形式? 作者称这种“有证据却用不好”的情况为表示失配(representation mismatch)。
MemPrism 保留原始交互和结构化事件,在每一步决策前,让一个小型 Router 选择“关系类型、时间范围、结果筛选、显示粒度”四项设置。确定性的 Composer 与 Render 据此生成临时记忆图像,交给冻结的视觉语言模型(VLM)执行任务;用完即丢弃视图,历史只追加真实发生的交互。训练主要改变记忆接口中的视图选择策略。
最直接的结果来自 ALFWorld:最终成功率 40.71%,Full History 为 31.43%,最强外部记忆对照 LangMem 为 38.27%。因此优势分别为 9.28 和 2.44 个百分点,不能混为同一个“相对最强基线提升”。默认配置下平均 prompt tokens 从 1,201 减至 797,约减少 33.6%。这些是论文报告值,未在本次研读中独立复现。(表 2,p.9;图 4,p.11)
更有研究价值的是消融:相同配置规则下,改变关系视图或显示介质会改变结果;动态文字视图本身也有效。这支持“决策时组织历史”值得学习,但不证明光学介质是唯一可行方案,也不证明所有单步决策都只因关系表示而改变。(图 3,p.10;附录 C.1,p.20)
结构地图
| 原文章节或小节 | 在论证中的作用 | PDF 页码与证据 |
|---|---|---|
| Introduction | 定义表示失配;区分持久事件与临时工作记忆 | pp.1–3,图 1 |
| Related Work | 对比结构化记忆、可学习记忆控制、光学记忆 | pp.3–4 |
| Method / Overview、Recorder | 推理流程与事件模式 | pp.4–5,图 2,式 (1)–(4) |
| Method / Router、Composer | 144 种联合动作与四类关系构建 | pp.5–6,表 1,式 (5)–(11) |
| Method / Render、Adapter | 图像接口、软标签初始化、GRPO | pp.7–8,式 (12)–(18) |
| Experiments / Experiment Setup | 基准、模型、训练及评测条件 | p.8 |
| Experiments / Main Results | 三个基准的主结果 | p.9,表 2–3 |
| Experiments / Where Does the Gain Come From? | 四组机制消融 | pp.10–11,图 3 |
| Experiments / Long-Horizon Behavior | 累积步数阈值下的成功率和 token | p.11,图 4 |
| Experiments / Cross-Model Transfer and Prompt Compression | 固定 Router 跨任务 VLM 迁移 | p.12,图 5 |
| Conclusion | 将读时组织作为记忆接口设计原则 | p.12 |
| References | 引用文献表 | pp.13–14 |
| A. Reproducibility Statement | Router 输入结构、训练阶段和超参数 | pp.15–17,表 A.1 |
| B. EB-ALFRED Case Studies | 两个可视记忆与执行案例 | pp.17–19,图 B.1–B.2 |
| C. Evaluation Protocols, Baseline Alignment, and Extra Results | 比较口径、光学对照、分辨率、选择分布 | pp.20–23,表 C.1–C.3 |
| D. Additional Method and Implementation Details | 事件校验、证据恢复、复杂度 | pp.22–25,图 D.1、式 (D.3) |
| E. Prompts, Schemas, and Action Definitions | Phi、教师和任务模型提示,以及动作解析规则 | pp.26–41 |
一:动机——记住、找回和用好是不同环节
1.1 作者具体想解决什么
长期交互中,同一批历史可能服务不同决策。例如,重复失败时需要对齐“同一个动作的多次尝试与结果”;判断手里是否已有物体时,需要聚合实体状态;定位当前失败的上下文时,需要连接相隔较远但共享实体的事件。单一时间线即使包含这些事实,也未必最适合所有问题。
作者区分三种失败:
| 失败环节 | 发生了什么 | MemPrism 的主要切入点 |
|---|---|---|
| 存储失败 | 必要事实没有留下 | 原始事件与结构化事件并存有助于追溯,但不能保证抽取无误 |
| 检索失败 | 事实存在,却没有送到读取端 | 范围选择和任务相关事件恢复会影响这一环节 |
| 表示失配 | 证据已在可用历史中,但关系不突出 | 选择任务相关的关系组织和显示粒度 |
这是一种分析上的区分,不表示实现中三个环节完全独立:Router 同时选择窗口和筛选条件,Composer 还会恢复任务相关事件。因此完整方法的增益包含证据选择、组织和呈现的共同作用。(Introduction,pp.1–3;Composer,p.6)
1.2 与相关工作的关系
按论文的归纳,结构化记忆在写入时维护摘要、笔记或图;可学习记忆控制决定写入、删除和检索;光学记忆把历史渲染成图像以控制输入体积。MemPrism 将“当前怎样看历史”设成一个单独的学习问题,并将持久记录与临时视图分离。这里是作者的定位,不宜扩大为“所有先前方法都无法动态组织记忆”。(Related Work,pp.3–4)
Full History 只是所测文本输入策略,不能当作理论性能上界。保留更多历史可能引入干扰,本文结果本身也说明完整文本历史并不总是最好。
二:方法——稳定事件流与按需生成的工作记忆
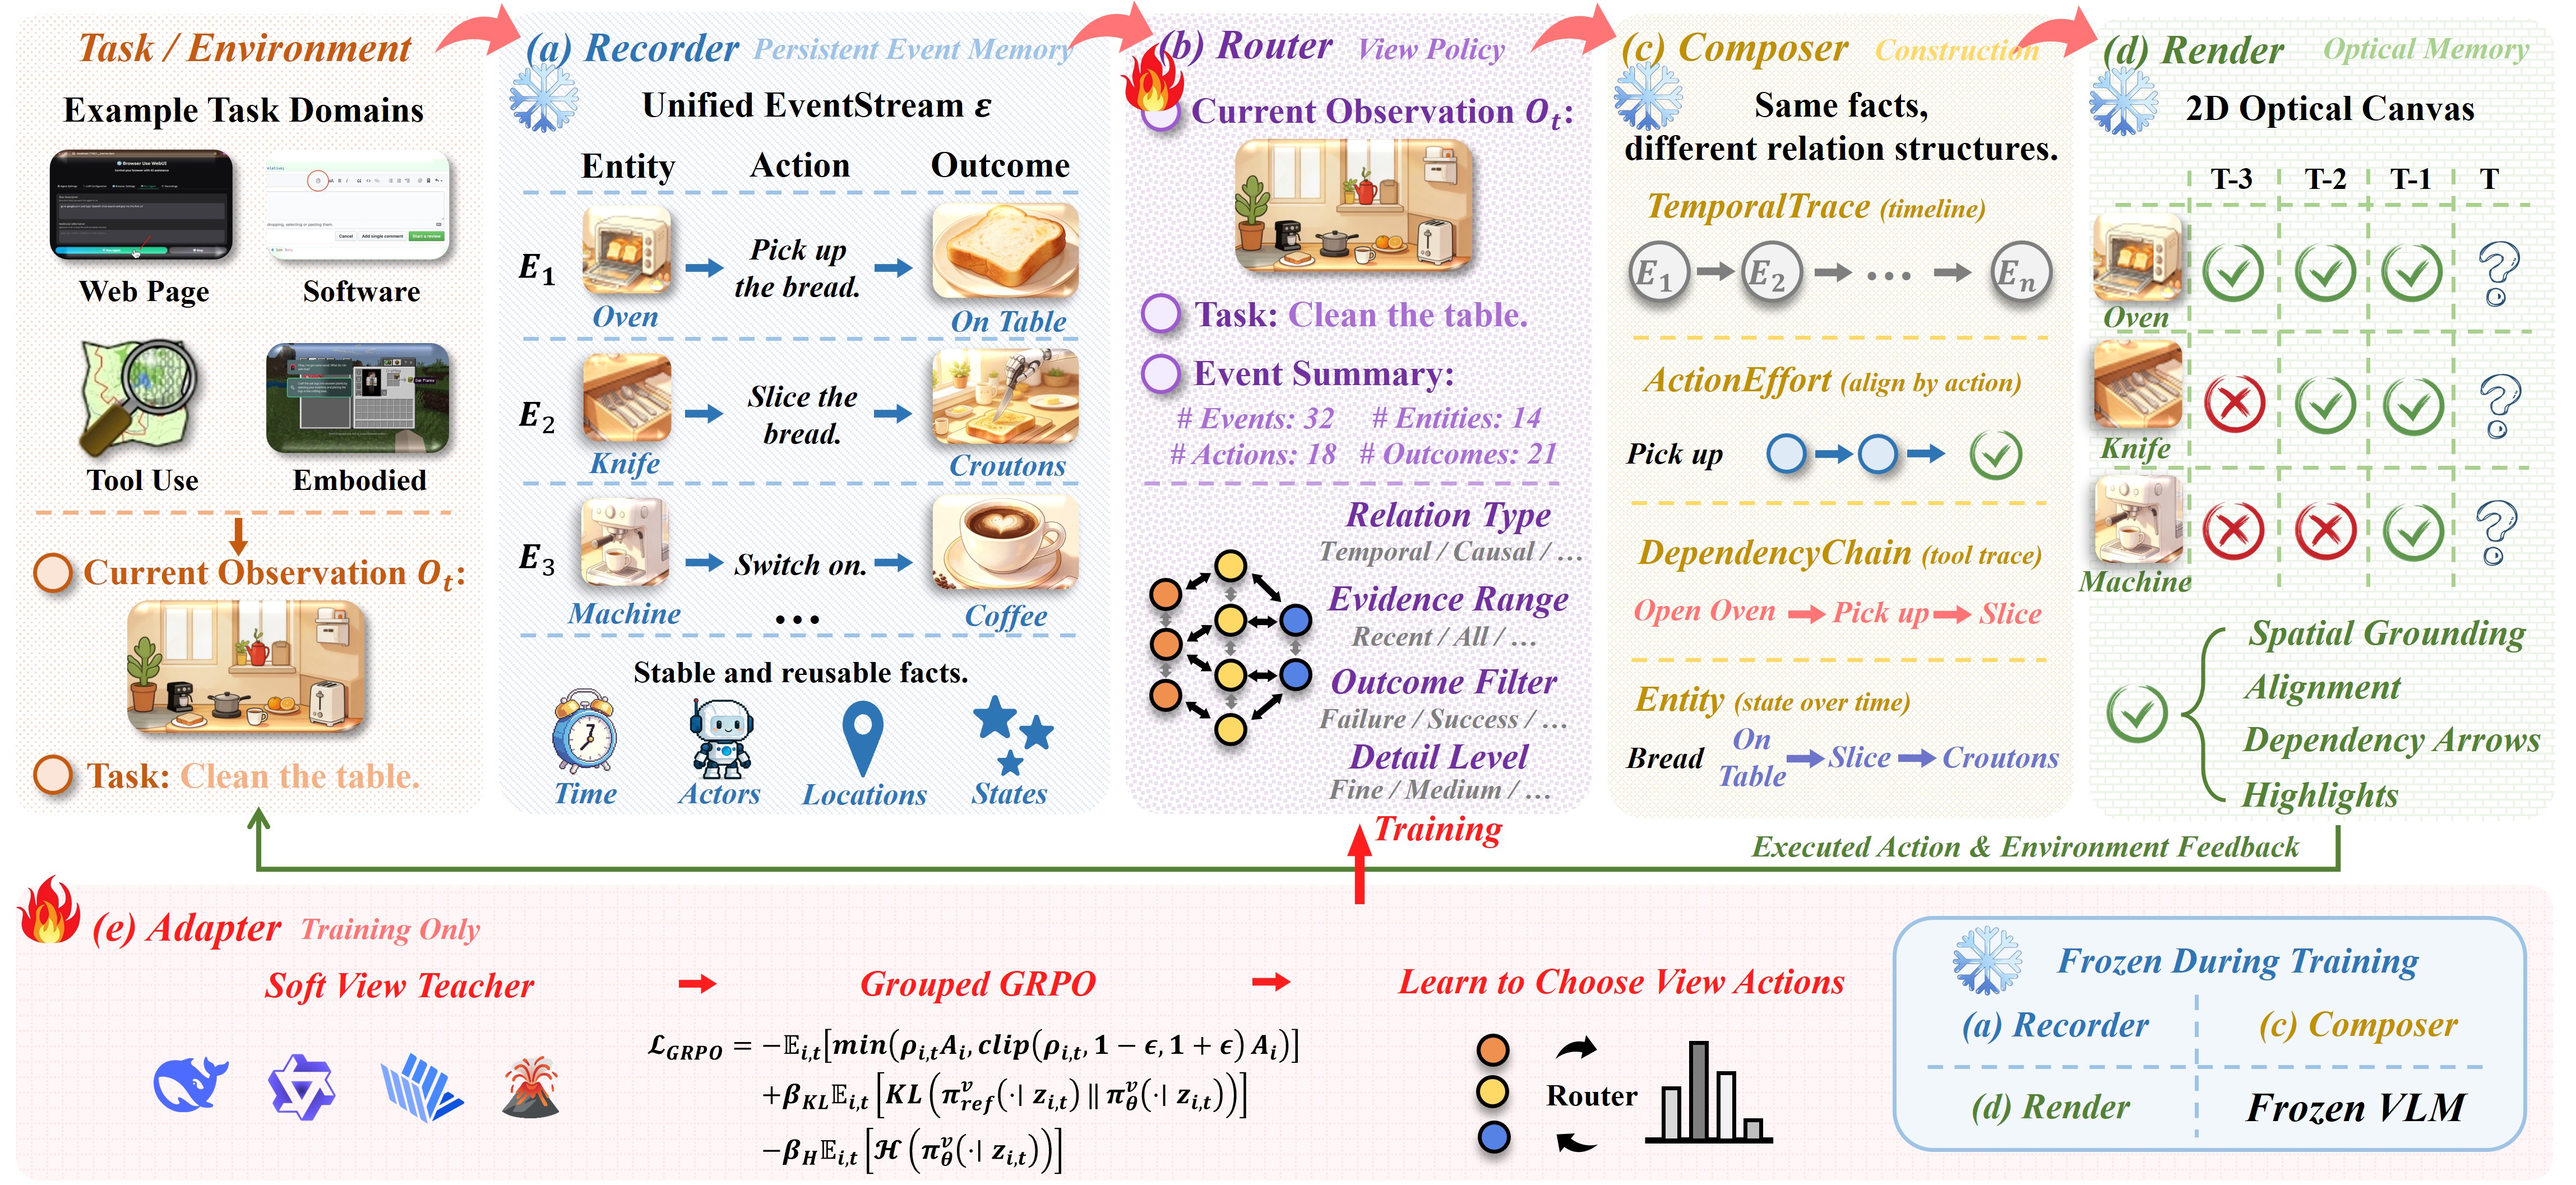
来源:原图 2,PDF p.5,直接复用作者图件。阅读顺序是 Recorder → Router → Composer → Render → 冻结任务模型;下方 Adapter 只在训练中使用。图中的软件与工具使用属于概念性任务示例,实际评测基准见第三部分。
2.1 输入、输出和一次决策循环
| 符号 | 含义 |
|---|---|
| $g,o_t,X_t$ | 任务目标、当前观测、提交给任务模型的当前环境输入 |
| $u_t$ | 环境动作;不要与视图选择动作混淆 |
$\mathcal E_{| 当前步之前的事件流 | |
| $a_t^v=(\tau_t,w_t,c_t,\gamma_t)$ | 关系类型、时间范围、结果筛选、粒度的联合动作 |
| $S_t,V_t$ | 构建出的关系结构及其图像视图 |
| $H_t^{\mathrm{short}}$ | 各对照共享规则的短期文本上下文 |
| $\pi_\theta^v,\pi_{\mathrm{task}}$ | 可学习视图策略与冻结任务策略 |
以下为根据原文整理的教学伪代码,不是作者程序:
读取当前观测、目标和事件摘要
Router 选择一个联合视图动作
Composer 筛选事件、恢复任务相关证据、构建关系结构
Render 生成临时图像 V_t
任务模型读取:当前环境输入 + 目标 + 短期文本 + V_t
在线环境执行预测动作;Mind2Web 仅评分,按专家动作推进
保存实际转移的原始记录,抽取并校验结构化事件,追加一次
丢弃 V_t,进入下一步关键不变量是:生成的视图不能覆盖或成为新的历史事实。这避免重复摘要逐层改写记录,但不意味着每次临时显示都无损。(图 D.1,p.24)
2.2 Recorder:保存原始转移,再抽取可组织的事件
原始交互为
分别记录动作前观测、实际动作、执行反馈、奖励或标签、环境元数据。抽取器 $\Phi$ 与规则校验得到
$e^{\mathrm{ent}}$ 是主实体,$e^{\mathrm{act}}$ 是归一化动作,$e^{\mathrm{out}}$ 是异常、状态更新、未观察到变化三者之一。$\Delta s_t$ 是 (key, new_value) 形式的稀疏更新;$\xi_t$ 可保存图像、框和裁切区域。抽取器只需提供有证据的新值,旧值由事件流维护,无需反向猜测。(式 (2)–(4),pp.4–5;附录 D.1,pp.22–23)
三种环境的适配不同:ALFWorld 从文字转移抽取;EB-ALFRED 先确定事件语义,再在动作后同步图像中定位最多三个候选实体,明确失败时清空状态更新;Mind2Web 从前后 HTML 及专家动作构造事件,状态键限制为页面、浮层、字段、选项、结果、流程六类。Mind2Web 即使没有抽出语义键,也可能保留 state_update 标签,因为推进依据是有效专家轨迹。(附录 D.2,pp.23–24;E.1,pp.26–31)
边界:确定性校验可排除空键、未知值、重复项和部分不合法框,但不能把所有 LLM 语义错误变为正确事实。保留原始转移提供的是追溯基础。
2.3 Router:学习选择“怎么看”,而非下一步做什么
联合动作空间为
| 因子 | 选项 | 控制对象 |
|---|---|---|
| 关系 $\tau$ | TemporalTrace、ActionEffect、EntityState、DependencyChain | 历史的组织方式 |
| 范围 $w$ | 最近 6 条、最近 10 条、全部 | 基础证据时间范围 |
| 筛选 $c$ | 全部、异常、状态更新、无观察变化 | 基础结果类型范围 |
| 粒度 $\gamma$ | coarse、medium、fine | 显示条目和细节量 |
模型对 144 种组合输出一个联合 softmax,不是四个独立分类器;训练时采样,评测时取 argmax。因此可以学习例如“较长窗口与较粗显示”的组合偏好。(表 1、式 (6)–(9),pp.5–6)
附录给出了实际输入结构:
| 输入 | 维度与来源 |
|---|---|
| 当前观测、目标 | 冻结 MiniLM 各输出 384 维;每段文字最多 256 tokens |
| 近期统计 | 最近 8 个事件,128 维,包含动作频率、结果比例、实体和连续失败等;部分坐标补零 |
| 全局统计 | 最近至多 64 个事件,8 维 |
| 融合方式 | 四路各投影至 512 维,加 [CLS],构成 5 个 token |
| 编码器与输出 | 4 层 Transformer、8 个注意力头、FFN 1024;3 个残差 MLP 块后输出 144 维 logits |
Router 的当前路径不使用可选 CLIP 图像嵌入;原始环境图像和记忆图像由后续任务 VLM 读取。“全局”统计也只看最近至多 64 步,并非整段历史的完整语义编码。注意区分 6/10 步视图窗口、8 步输入统计、64 步全局统计。(附录 A.2,p.15;D.4,pp.24–25)
2.4 Composer:四种关系视图与证据恢复
基础选择并非硬删除。实现先按 $w,c$ 筛选,再恢复与任务目标词项直接匹配的事件;DependencyChain 还保留定义当前锚点所需的近期上下文:
因此选择“最近 6 条”或“仅异常”不保证最终图像严格只含这部分事件。然后构建 $S_t=\mathcal C_{\tau_t,\gamma_t}(\widehat{\mathcal E}_t)$。(式 (10)–(11),p.6;式 (D.3),p.24)
| 视图 | 组织键与阅读方式 | 适合的问题 |
|---|---|---|
| TemporalTrace | 按步骤串起动作、结果、状态更新 | 刚才做过什么,当前进展到哪一步? |
| ActionEffect | 按动作—实体分组,对齐重复尝试及结果 | 对这个对象重复做该动作是否有效? |
| EntityState | 按实体与状态键串联观测到的新值 | 对象现在在哪里、处于什么状态? |
| DependencyChain | 以最近事件为锚点,连接共享实体、状态键或近邻事件 | 当前事件与哪些较早事件有关? |
DependencyChain 是启发式局部依赖追踪,不是经验证的因果图。其 coarse/medium/fine 最多展示 6/8/10 个链事件;其他视图通过保留端点、异常、结果转折或全部条目调节粒度。粒度改变临时显示,不改变持久事件流。(附录 E.2,pp.31–37)
教学例子:历史包含“打开柜子失败 → 拿起杯子 → 再打开柜子成功 → 放入杯子”。问“杯子在哪里”,EntityState 可以聚合位置与持有状态;问“打开柜子的重试是否奏效”,ActionEffect 会更直接。这是解释设计直觉的自造例子,并非论文实验。
2.5 Render:二维布局是关系接口
空间邻近表达分组,行列对齐支持比较,箭头表达状态转移或局部关联,高亮提示失败与任务相关信息。给定相同事件、动作、目标和渲染设置,输出图像相同。冻结 VLM 同时使用当前观测、短期文本和图像,并非只靠一张记忆图行动。(式 (12)–(13),p.7;D.3,p.24)
“光学记忆”在这里是图像编码的记忆输入,不是专用光学硬件。其代价依赖图像尺寸及各 VLM 的视觉 token 化方式。
2.6 Adapter:先模仿教师,再用任务反馈优化
阶段 D1:决策条件软标签。 教师看到观测、目标、历史和参考下一步动作 $u_t^{\mathrm{ref}}$,给出视图分布 $q_T$。学生 Router 的运行输入不包含参考答案。教师提示要求先确保辨别下一步所需证据清楚,再在等效候选间考虑成本。(式 (14),p.7;E.2,pp.31–37)
第一项匹配教师分布,第二项惩罚不必要的大范围或精细视图;$\widehat C_t(a)$ 是结构成本,不能直接当作测量过的毫秒或 GPU 成本。PDF 没有给出它的完整数值定义,也没有明确列出教师模型 ID 和实际软标签记录总量。(式 (15),p.7)
阶段 D2:组相对策略优化(GRPO)。 同一任务采样 $G=16$ 条轨迹,以组内回报均值和标准差标准化:
同一在线轨迹内的所有视图选择共享 $A_i$。若一组回报完全相同,例如二值回报下全成功或全失败,该组的策略优势项为零;KL 和熵项仍可影响优化。EB-ALFRED 还含进度奖励,不能仅凭全部失败就判断回报相同。损失为
上式 KL 和熵中的分布都条件于 $z_{i,t}$;$\pi_{\mathrm{ref}}^v$ 是 D1 后冻结的参考策略,$\pi_{\mathrm{old}}^v$ 是收集本批数据的策略。$\epsilon$ 是更新裁剪幅度,$\varepsilon$ 是标准差稳定项,两者用途不同。(式 (16)–(18),p.7)
正文概括为“只训练 Router”;附录更精确地区分:D1 训练融合编码器与 Planner,MiniLM 始终冻结;D2 连融合编码器也冻结,只更新三块残差 Planner 及 144 类输出头。 任务 VLM、Phi、Composer、Render 在两阶段均冻结。Mind2Web 的 D2 来自离线回放和动作是否正确的二值信号,不是在线网页探索。(A.3,p.16;D.4,p.25)
三:实验——先分清评测单位与训练边界
3.1 数据、交互协议与指标
| 基准 | 规模与环境 | 论文实际评测指标 |
|---|---|---|
| ALFWorld | 3,827 个训练实例;评测 140 个有序 episodes;最多 50 步 | 完整任务成功率 SR,越高越好 |
| EB-ALFRED | EmbodiedBench 包装的视觉具身环境;6 个子集各 50 项,共 300 项;最多 30 步 | 子集与平均 SR,越高越好 |
| Mind2Web | 1,009 个训练任务、137 网站、31 域;测试 Cross-Task 252、Cross-Website 177、Cross-Domain 912 项 | 表 2 报告逐步动作准确率,越高越好 |
ALFWorld 的 140 项是评测 episode 单位,不一定对应 140 个独立源游戏;唯一游戏数和重复规则被放在作者运行记录中,PDF 没有列出。(Experiment Setup,p.8;C.1,p.20)
Mind2Web 使用教师强制回放(teacher-forced replay):模型预测 CLICK/TYPE/SELECT 并评分,但下一步状态由人类轨迹决定,记忆也追加专家实际动作及其转移。因此 12.87% 不是自主完成网页任务的成功率。设置文字提到 exact episode success,但表 2 没有提供其数值,不能用动作准确率替代。(p.8;图 D.1,p.24;E.5,pp.40–41)
EB-ALFRED 结果属于 EmbodiedBench 协议,不能与官方 ALFRED leaderboard 直接比较。(p.8)
3.2 对照方法分别回答什么
| 对照 | 比较角色 | 阅读时要保留的条件 |
|---|---|---|
| No Memory / Full History | 无历史或完整文本历史输入 | 并非理论下界、上界;主表覆盖不完全相同 |
| LangMem | 搜索与维护记忆集合 | 在 ALFWorld 和 Mind2Web 主表出现 |
| A-Mem | 原子笔记、语义属性及动态链接 | 是外部记忆接口对照 |
| Mem0 / Mem0ᵍ | 事实提取检索;后者加入图记忆 | 使用冻结的共享任务读取模型 |
| CFG-SFT | 外部细粒度动作数据上的任务模型微调 | 改变任务 VLM 参数,不能归入相同读取器的记忆消融 |
| 固定关系视图、动态文本/图像、频率匹配随机 Router | 内部机制对照 | 用于拆解贡献,不是外部系统 |
| AgentOCR (w/o RL) | 引用的冻结任务模型光学历史设定 | token 统计范围不一致,不是严格等预算比较 |
主记忆比较使用 Qwen2.5-VL-7B-Instruct 作为冻结任务模型,文字事件抽取使用 Qwen3.5-2B。附录说明共享初始任务、接口、短期上下文规则、解码与动作解析;在线动作一旦不同,后续观测和历史自然分叉,不是每一步都在完全相同事实集合上的反事实比较。各外部系统的 writer、检索深度和版本固定信息由作者称保存在 run manifest,本文 PDF 没逐一展开。(C.1–C.2,pp.20–21)
3.3 训练配置和资源
| 设置 | ALFWorld | ALFRED 训练路径 | Mind2Web |
|---|---|---|---|
| D1 epochs | 50 | 20 | 50 |
| D1 $\lambda_C$ | 0.02 | 0 | 0.02 |
| D2 学习率 | $3\times10^{-6}$ | $3\times10^{-6}$ | $10^{-6}$ |
| D2 迭代/步数 | 100 iterations | 100 iterations | 150 training steps |
| 每次分组 | 8 组 × 16 轨迹 | 8 组 × 16 轨迹 | 8 组 × 16 回放轨迹 |
| 回报 | 终局成功 | 成功 + 0.2 × 目标条件进度 | 动作匹配正确与否 |
| 裁剪 / KL 系数 | 0.2 / 0.2 | 0.2 / 0.2 | $\epsilon_{\mathrm{low}}=0.1,\epsilon_{\mathrm{high}}=0.15$ / 0.01 |
| 熵系数 | 0.003 | 0 | 此表未报告 |
D1 公共设置为 AdamW、学习率 $10^{-4}$、batch 256、weight decay 0.01、seed 7。ALFRED 使用官方训练标注训练,保留 EB-ALFRED episodes 评估。作者报告最终运行使用 8 张 H200;训练时间分别为 24/48/24 小时,单卡峰值内存分别为 127.0/77.6/127.0 GB。这说明“轻量 Router”不意味着包含环境 rollout 和冻结大模型推理的整个训练流程很便宜。(表 A.1 与 A.3–A.4,pp.16–17)
四:结果——收益、解释与边界
以下百分数除特别注明外均为论文报告值;“百分点”是两个百分率直接相减,不是相对百分比。
4.1 Main Results:三个基准都改善,但改善幅度不同
ALFWorld 与 Mind2Web 总体结果(表 2,p.9):
| 方法 | ALFWorld SR ↑ (%) | Mind2Web 总体动作准确率 ↑ (%) |
|---|---|---|
| Full History | 31.43 | 8.79 |
| LangMem | 38.27 | 9.45 |
| A-Mem | 34.68 | 8.35 |
| Mem0 | 37.49 | 8.12 |
| Mem0ᵍ | 35.34 | 7.92 |
| MemPrism SFT | 34.29 | 10.81 |
| MemPrism SFT+GRPO | 40.71 | 12.87 |
ALFWorld 最终方法比 Full History 高 9.28 个百分点,按表中舍入值计算相对增长约 29.5%;比最强外部对照 LangMem 高 2.44 个百分点,相对增长约 6.4%。SFT 本身低于 LangMem、Mem0 和 Mem0ᵍ;GRPO 相比 SFT 增加 6.42 个百分点,是这项基准最终领先的重要环节。
Mind2Web 最终方法比 Full History 高 4.08 个百分点,比 LangMem 高 3.42 个百分点。原文把四种对话型记忆方法概括为“没有额外收益”,但 LangMem 的 9.45% 实际略高于 Full History 的 8.79%;更准确的说法是这些外部接口没有表现出一致收益,且在该表中都低于最终 MemPrism。
Mind2Web 三个测试分布(同表):
| 方法 | Cross-Task (%) | Cross-Website (%) | Cross-Domain (%) |
|---|---|---|---|
| Full History | 12.57 | 7.95 | 7.91 |
| LangMem | 13.20 | 8.85 | 8.42 |
| A-Mem | 10.85 | 7.62 | 8.08 |
| Mem0 | 11.42 | 7.35 | 7.28 |
| Mem0ᵍ | 11.08 | 7.12 | 7.05 |
| MemPrism SFT | 12.95 | 10.05 | 10.85 |
| MemPrism SFT+GRPO | 14.23 | 11.13 | 12.83 |
相对 Full History,最终方法在三个 split 的差值为 1.66、3.18、4.92 个百分点。总体准确率不能用三列做简单算术平均;论文未在该表给出逐 split 的动作数分母,任务数也不能直接替代动作数。
EB-ALFRED(表 3,p.9):
| 方法 | Base | Common | Complex | Visual | Spatial | Long | Avg. SR (%) |
|---|---|---|---|---|---|---|---|
| No Memory | 10.0 | 8.0 | 6.0 | 2.0 | 0.0 | 2.0 | 4.7 |
| Full History | 16.0 | 10.0 | 14.0 | 0.0 | 10.0 | 12.0 | 10.3 |
| CFG-SFT | 16.0 | 16.0 | 8.0 | 8.0 | 4.0 | 6.0 | 9.7 |
| A-Mem | 8.0 | 10.0 | 12.0 | 0.0 | 6.0 | 6.0 | 7.0 |
| Mem0 | 16.0 | 16.0 | 14.0 | 0.0 | 10.0 | 12.0 | 11.7 |
| Mem0ᵍ | 14.0 | 16.0 | 16.0 | 0.0 | 8.0 | 12.0 | 11.0 |
| MemPrism SFT | 20.0 | 20.0 | 22.0 | 0.0 | 16.0 | 16.0 | 15.7 |
| MemPrism SFT+GRPO | 24.0 | 22.0 | 26.0 | 0.0 | 16.0 | 18.0 | 17.7 |
相对 Full History 的总体增益为 7.4 个百分点,相对最强记忆对照 Mem0 为 6.0 个百分点。SFT 已有较大收益,GRPO 再增加 2.0 个百分点。然而 Visual 子集最终仍为 0%,低于 CFG-SFT 的 8%;记忆组织没有解决所有视觉理解与行动问题。300 项中每个子集仅 50 项,单个成功/失败就对应该子集 2 个百分点,需要结合不确定性理解小差值。
4.2 Where Does the Gain Come From?:四组消融
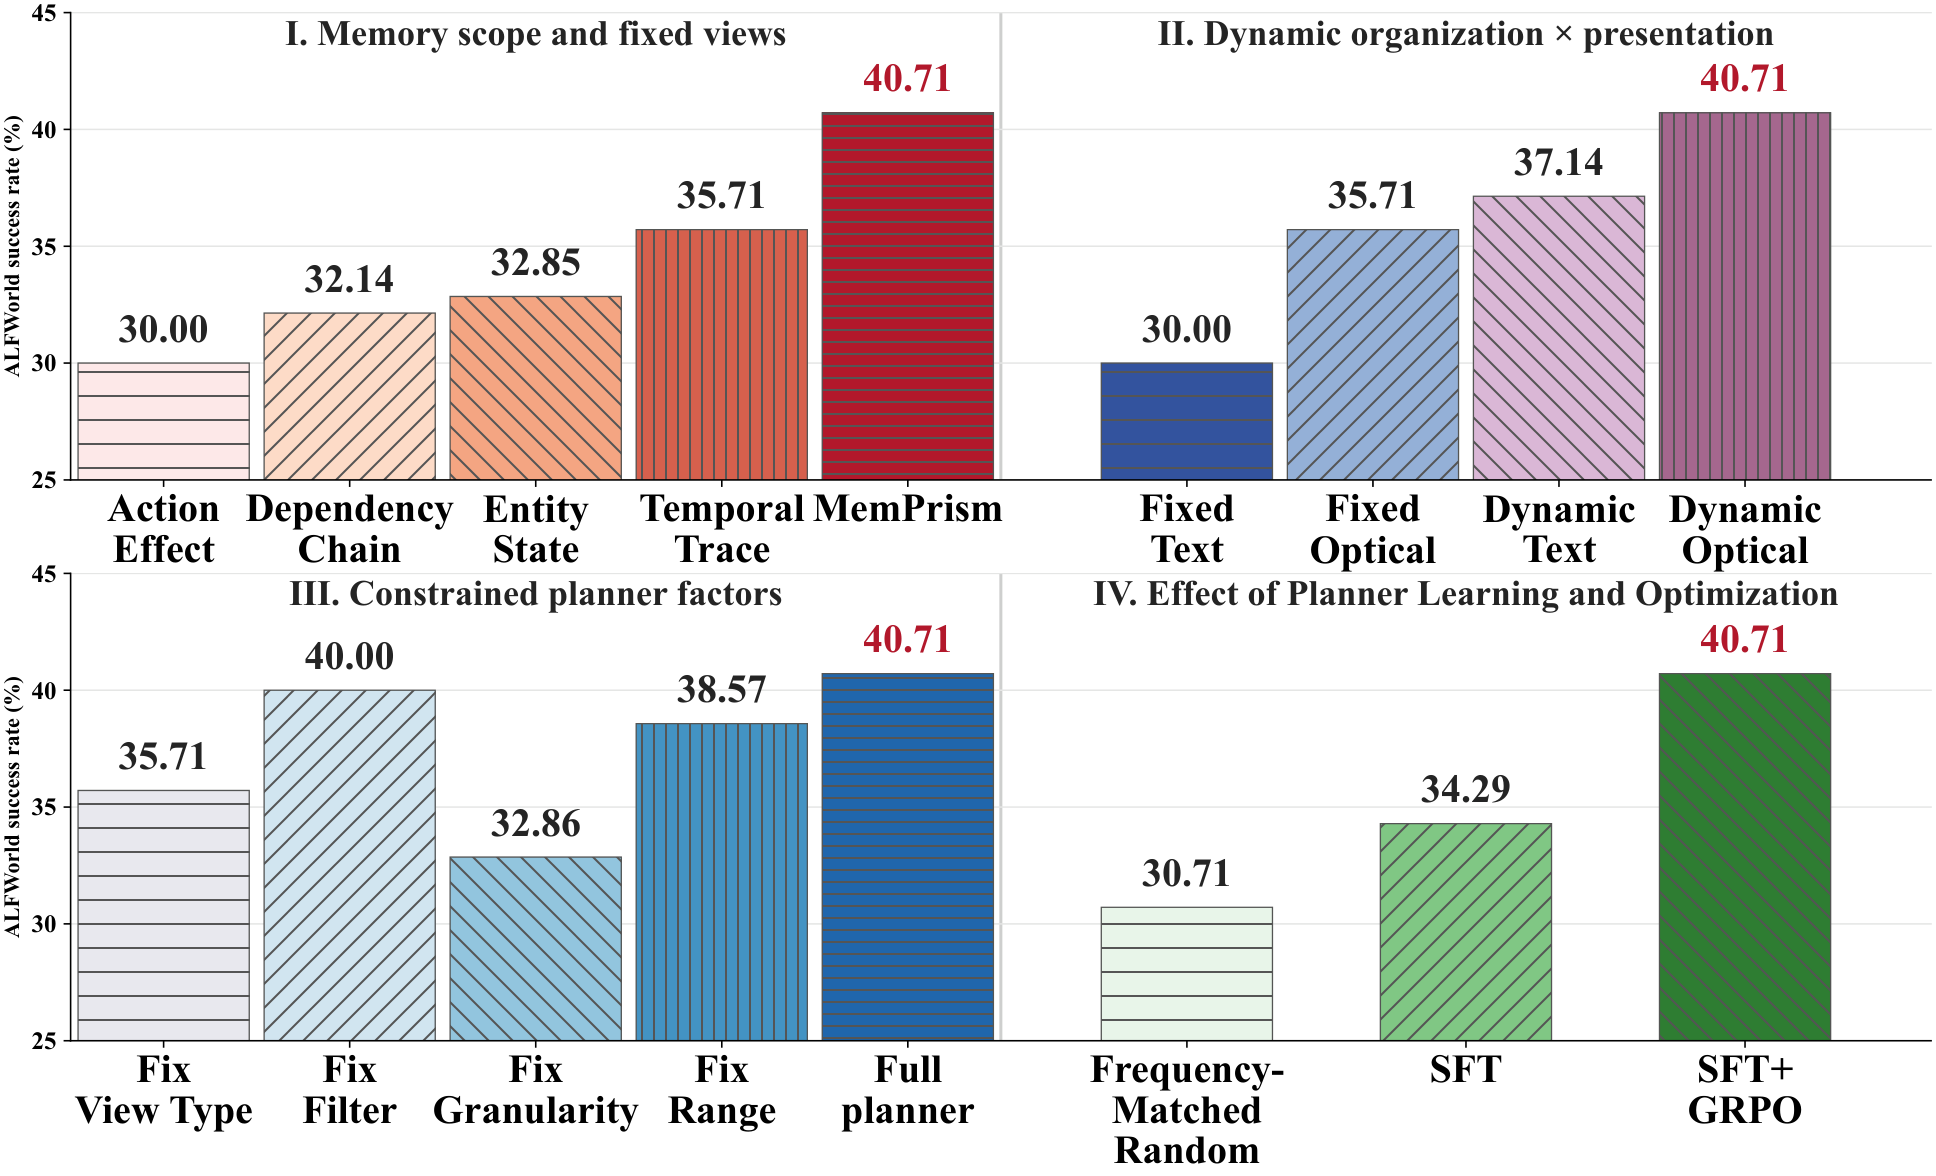
来源:原图 3,PDF p.10。四个面板共用成功率百分比含义;图的纵轴从 25% 起,柱高视觉差异会被放大,应读数值。左上比较关系类型,右上拆分动态组织与介质,左下固定单个动作因子,右下比较学习方式。
① 固定关系结构。 均采用 recent-long(10 条)、medium、all,ActionEffect / DependencyChain / EntityState / TemporalTrace 的 SR 分别为 30.00 / 32.14 / 32.85 / 35.71%;动态方法为 40.71%。固定关系中最大差值 5.71 个百分点,说明统一窗口与粒度并不能消除关系组织带来的性能差异。
作者将此解释为对表示失配的直接验证。本次分析认为更稳妥的结论是:在共享初始任务和接口的在线评测中,不同关系组织导致不同整体行为。附录 C.1 明确允许后续轨迹分叉,不能把它说成逐步固定全部事实、只改变图片排列的严格因果实验。
② 动态组织 × 显示介质。 固定配置为 TemporalTrace + recent-long + medium + all:
| 组织方式 | 文本呈现 SR (%) | 图像呈现 SR (%) | 改为图像的差值 |
|---|---|---|---|
| 固定 | 30.00 | 35.71 | +5.71 个百分点 |
| 动态 | 37.14 | 40.71 | +3.57 个百分点 |
| 改为动态的差值 | +7.14 个百分点 | +5.00 个百分点 | — |
两种介质中动态组织都有效,两种组织方式中图像呈现都有效;最佳结果来自动态图像视图。但四个差值有条件依赖。不能把 +5.00 和 +3.57 当作从固定文本出发、可独立相加的两项贡献。从固定文本到动态图像的总提升是 10.71 个百分点。以这个 2×2 表计算的差中之差为 −2.14 个百分点,不能把“共同有效”进一步称为已验证的正向统计交互。
③ 固定单个 Planner 因子。 下表以实际图 3 的 full planner = 40.71% 为基准计算差值:
| 被固定的因子及值 | SR (%) | 相对完整模型变化(百分点) |
|---|---|---|
| 关系类型 = TemporalTrace | 35.71 | −5.00 |
| 结果筛选 = all | 40.00 | −0.71 |
| 粒度 = fine | 32.86 | −7.85 |
| 时间范围 = recent-long | 38.57 | −2.14 |
| 全部可选 | 40.71 | 0 |
最明显的下降来自始终使用 fine。它提示“保留最多细节”会有代价,自适应压缩可能帮助控制噪声;这是对所选固定值的观察,不能推成所有粒度或所有任务上都成立的普遍排名。原文同页段落将完整模型写成 40.70%,并按该数计算 −7.84 等差值;与图上 40.71% 差 0.01,本笔记保留差异并统一按图计算。
④ 学习与任务条件化。 按已学策略总体配置频率抽样、但不看当前决策状态的 Frequency-Matched Random 为 30.71%;SFT 为 34.29%;SFT+GRPO 为 40.71%。在这个对照下,光是偏爱若干常用配置不足以解释最终效果;状态条件化与任务反馈优化均有价值。(图 3,pp.10–11)
4.3 Long-Horizon Behavior:后段预算收益与有限时域
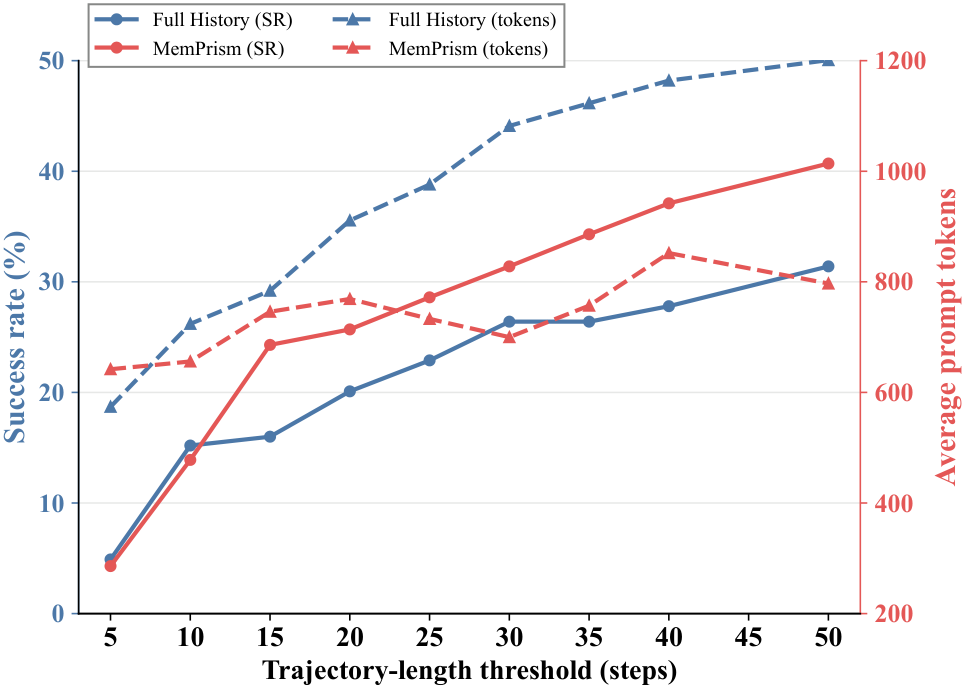
来源:原图 4,PDF p.11。横轴是累积轨迹长度阈值,不是互斥的长度分桶;实线圆点读左轴 SR,虚线三角读右轴平均 prompt tokens;蓝色为 Full History,红色为 MemPrism。
前两个短阈值(≤5、≤10)Full History 小幅领先。到 ≤15 时,正文报告 MemPrism 24.3%、Full History 16.0%;到 ≤50 的终点分别约为 40.7% 和 31.4%。正文报告 Full History 平均 token 从 574 增至 1,201,MemPrism 在这些阈值下为 642–852,终点为 797。
以报告的终点整数计算:
正文其他位置报告 33.65%,图中保留一位小数为 33.6%;本笔记使用约 33.6%,不从已舍入数字推断额外精度。
这支持在所测至多 50 步范围内,紧凑视图能控制任务模型的输入长度,同时保留较好的成功率。它不证明无限长轨迹上成本恒定,也不能把累积阈值曲线读成“所有长任务子群都提高同一幅度”。逐阈值 token 分母与平均权重未在图注详细给出,不额外推断。
4.4 Cross-Model Transfer and Prompt Compression:跨读取模型可迁移
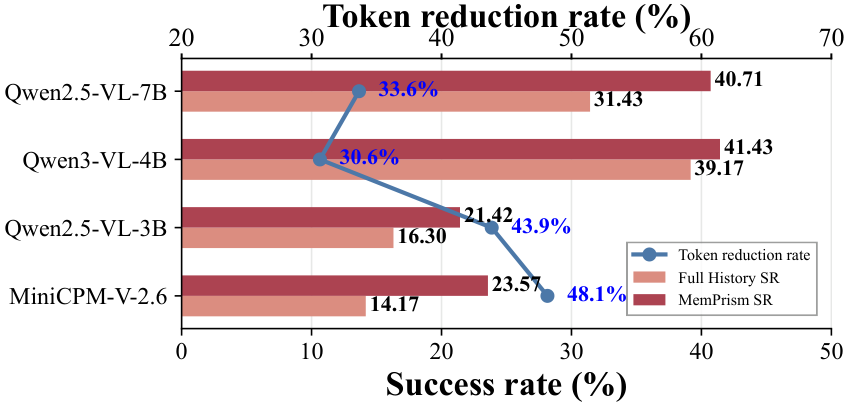
来源:原图 5,PDF p.12。横向条形读底部 SR 轴,蓝线读顶部 token 减少百分比轴,两个轴量纲不同。Qwen2.5-VL-7B 是训练时任务 VLM,其余三种模型使用相同 Router checkpoint,没有针对新 VLM 重新适配。
| 任务 VLM | Full History SR (%) | MemPrism SR (%) | 增益(百分点) | 模型内 token 减少 |
|---|---|---|---|---|
| Qwen2.5-VL-7B | 31.43 | 40.71 | +9.28 | 约 33.6% |
| Qwen3-VL-4B | 39.17 | 41.43 | +2.26 | 30.64% |
| Qwen2.5-VL-3B | 16.30 | 21.42 | +5.12 | 图示约 43.9% |
| MiniCPM-V-2.6 | 14.17 | 23.57 | +9.40 | 48.15% |
三个未用于 Router 训练的读取模型均改善,这是本文有说服力的接口复用证据。它验证的是这些模型上的迁移,不能扩大为任意 VLM 或跨环境零样本迁移。图注要求 token 仅在同一个模型内比较,不宜据此排名不同模型的绝对效率。作者把 MiniCPM 的收益与视觉 token 密度和 OCR 能力联系起来,但没有单独控制这两项因素;该解释应作为假设而非机制定论。
4.5 附录补充:光学对照、分辨率与选择分布
AgentOCR 对照。 表 C.1(p.22)列出 AgentOCR (w/o RL) SR 25.30%、MemPrism 40.71%,相差 15.41 个百分点。前者 0.47k 是 memory-context tokens,后者 797 是完整平均 prompt tokens;不能据此得出 MemPrism 比 AgentOCR 更省 token,也不能当作严格相同预算的控制实验。作者排除会训练任务策略的 AgentOCR 完整 RL 设置,并解释了未纳入 MemOCR 与 OCR-Memory 的原因。(C.3–C.4,pp.21–22)
分辨率敏感性。 固定 checkpoint 与其他配置,只改图像最长边上限;轨迹仍可自然分叉。(表 C.2,p.22)
| 最长边上限 (px) | SR ↑ (%) | 平均 prompt tokens ↓ | 非法动作比例 ↓ (%) |
|---|---|---|---|
| 448 | 38.57 | 703 | 0.043 |
| 672(默认) | 40.71 | 797 | 0.064 |
| 896 | 40.00 | 917 | 0.097 |
在这三点上,672 像素兼顾成功率与输入量;更大图像并不自动更好。非法动作列本身已经是百分比,0.064% 不能误读为 6.4%。这些结果没有随表给出区间,不能判定 672 与 896 的 0.71 个百分点差异具有统计显著性。
选择分布。 表 C.3(p.23)的关系类型边际如下:
| 类型 | ALFWorld (%) | EB-ALFRED (%) | Mind2Web (%) |
|---|---|---|---|
| TemporalTrace | 55.15 | 42.28 | 42.26 |
| ActionEffect | 31.24 | 21.98 | 7.62 |
| EntityState | 13.61 | 20.86 | 18.48 |
| DependencyChain | 0.00 | 14.88 | 31.64 |
ALFWorld 的粒度选择为 coarse 38.56%、medium 0%、fine 61.44%;EB-ALFRED 为 26.81/35.39/37.80%,Mind2Web 为 22.76/56.85/20.39%。按原表相加,最近 6 条的窗口边际约为 75.65/52.93/52.97%;最近 10 条约为 0.16/21.71/34.74%;全部历史约为 24.19/25.38/12.29%,舍入可能使总和略离 100%。
这表明策略没有均匀使用动作空间。ALFWorld 中 DependencyChain 在教师分布约占 3% 概率,最终贪心选择为零;作者解释为训练后集中到回报更稳定的配置。该动作仍在空间中,不能说模块被删除;也不能说 ALFWorld 收益证明四种关系都必不可少。边际频率只描述行为,不独立证明每类视图的因果作用。(C.6,pp.22–23)
4.6 案例:图像究竟给了模型什么
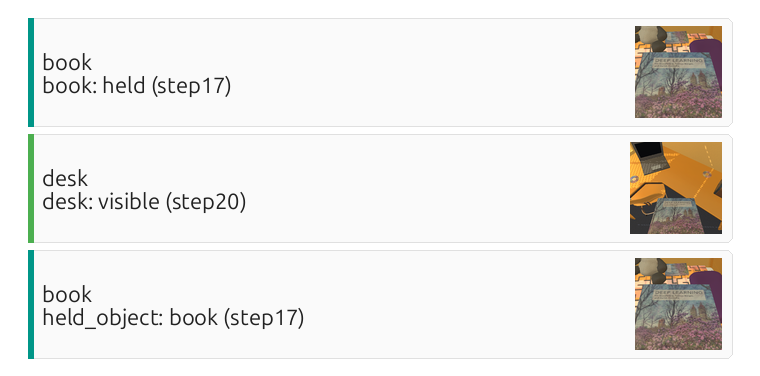
来源:原图 B.2 的记忆面板,PDF p.19,直接复用作者 PNG。三条卡片把“书被拿着”“桌子可见”“手中对象为书”集中显示,并带来源步骤与视觉裁切。模型随后选择放下手中对象,记录进度从 0 到 1/2。
案例 1(图 B.1,p.18)用 TemporalTrace 展示重复放置失败、重新拾起平底锅等历史,最后成功执行放下动作,进度从 0 到 1/3。模型输出中把“水龙头打开”解释成“锅已清洁”,但展示的进度不是完整任务成功,不能据此确认清洁目标已达成。
两个例子说明接口的实际外观和一步执行效果,没有提供移除记忆的配对反事实,也未展示完整任务完成过程;它们是解释案例,不是额外统计证明。
五:结论——可借鉴的设计原则与尚未解决的问题
5.1 可靠贡献
第一,作者把“读到证据之后怎样组织”变成显式策略变量,形成可实验拆解的记忆接口。第二,稳定事件存储与临时工作记忆分离,为不同任务状态复用同一历史提供了清楚的工程边界。第三,固定任务读取模型的消融、动态文本对照和三种新 VLM 的迁移结果,共同支持关系视图选择确实有实用价值。
最值得迁移的思想是:长期保存可追溯事实,决策时生成适合当前问题的表示。 具体是否使用图像,应由读取模型能力、成本口径和任务特点决定;本文证明了图像路径在这些设置下有效,而非所有系统都应转成光学记忆。
5.2 证据强度与原文不一致
| 核验点 | 原文证据 | 本次处理 |
|---|---|---|
| ALFWorld 完整 Planner 数字 | 图 3 为 40.71%;p.10 段落为 40.70% | 采用图值,明确差 0.01,并重新计算消融差值 |
| 统计区间 | C.1 说归档含 Wilson 与配对 bootstrap 区间;PDF 图表没有展示具体区间 | 不宣称 2.44 个百分点优势“显著”;未核验外部 run artifacts |
| 140 episodes 与成功率精度 | 38.27% 等基线不能直接还原为单次 140 项中的整数成功数 | 不擅自补造成功计数或重复平均方式,需运行档案解释聚合口径 |
| 任务模型冻结 | 正文 p.8 泛称冻结;C.2 明确 CFG-SFT 微调任务 VLM | 把 CFG-SFT 视为不同训练条件,排除出相同读取器的机制归因 |
| Mind2Web episode success | 设置说报告此指标,表 2 只给动作准确率 | 不补写未出现的 episode 数值 |
| 训练模块 | 正文泛称只训练 Router;A.3 进一步区分 D1 与 D2 | 以附录的分阶段冻结范围解释 |
这些差异不自动推翻结果,但会限制可以从论文 PDF 独立验证到什么程度。
5.3 方法与效率边界
- 语义抽取和读取能力仍是瓶颈。 错误实体、缺失状态或 VLM 看不清图像都可能让视图无效;EB-ALFRED Visual 子集 0% 是直接的性能边界。
- 视图语言和输入摘要有限。 只有四类关系、144 个组合;Router 当前观测文字截断至 256 tokens,统计仅覆盖近期窗口,复杂远程依赖可能需要更丰富的状态表示。
- 长程不等于常数成本。 令 $N_t$ 为历史事件数、$D_t$ 为范围内接受的状态更新数、$P_t$ 为渲染像素数。附录 D.5(p.25)中范围筛选、任务词项恢复和关系构建通常为 $O(N_t)$;EntityState 为 $O(N_t+D_t)$,渲染为 $O(P_t)$。语义存储为 $O(N_t+D_t)$,另加图像。只有在固定大小摘要构建之后,Router 推理才与总历史长度无关。
- prompt token 减少不等于总系统省同样比例。 Phi 调用、图像编码、渲染、任务 VLM 推理与存储都贡献开销。附录说这些分别记录于运行档案,但 PDF 的主要效率图展示的是 prompt tokens,没有给出完整端到端延迟和总费用对照。
- 泛化范围有限。 训练是各基准相应训练分区,跨 VLM 结果也不等于跨新任务环境零样本泛化;在线具身与离线网页结果应分开解读。
5.4 后续值得验证的问题(本次分析)
- 在固定单步事件集合、等 token 或等延迟预算下,关系结构和图像介质分别带来多少提升?
- 在保留任务相关事件的条件下,Phi 错误如何传播,直接读取原始事件能否成为可靠回退?
- 加入真正在线的网页交互、显著超过 50 步的任务后,Router 摘要窗口和线性扫描是否成为瓶颈?
- 若用成本可比的文本结构化表或更强读取模型,动态关系组织还保留多少收益?
以上是根据证据边界提出的研究问题,不是论文已经完成的实验。
复查与复用说明
原文与作者图件集中保存在同版本 source/,本次成品为 r1/。图件出处、PDF 页码和哈希见 figures/provenance.json。所有图都来自原文,未用生成式图像替换实验结果。
幻灯片以约 25 分钟组会为目标,正文讲清动机、数据流、训练、主结果和机制,备份页补充配置与证据限定。重新构建命令为:
python3 build_slides.py slides.en.tex需要本地 pdflatex 与 Beamer。分享可编辑幻灯片时,应连同 figures/ 和 build_slides.py 一起复制;分享 PDF 则可独立使用。所有分析均以 arXiv v1 为范围,没有把其他论文的成绩或后续版本混入。