BinaryPC:用二值主成分实现免训练的哈希稀疏注意力
论文:Training-Free Hashing-Based Attention via Binary Principal Components
作者:Daohai Yu、Zhanpeng Zeng、Keyu Chen、Wenhao Li、Zhifeng Shen、Luxi Lin、Ruizhi Qiao、Xing Sun、Rongrong Ji。
版本:arXiv:2608.04405v1,提交于 2026-08-05;获取与研读日期:2026-10-16。
来源:arXiv · 本地原文 PDF · 作者代码链接。下文页码均为从 1 开始的 PDF 页码。
配套:英文汇报 PDF · 可编辑 TeX。
论文总览
BinaryPC 解决的是长上下文 decode 阶段反复读取大量 KV 的成本。它为每个 key 构造 64 位二值编码,先用很小的编码扫描所有历史位置,挑出候选,再读取这些位置的原始 KV 做注意力。其核心目标是重构 key 矩阵 $\mathbf K\approx\mathbf H\mathbf P$:$\mathbf H$ 为二值系数,$\mathbf P$ 为数据相关的实值基。由此,原始分数 $\mathbf q\mathbf k^\top$ 可近似为 $(\mathbf q\mathbf P^\top)\mathbf h^\top$。
这带来三个相互配合的设计:通过逐次二值秩一分解构造编码;key 的每个编码系数用 1 bit,query 投影的每个系数用多 bit;另外保留一小组重构误差较大的 token,防止罕见但关键的信息被哈希漏掉。投影可以在当前输入上在线构建,也可以提前用校准数据得到,后者称为离线投影校准(Offline Projection Calibration,OPC)。这些过程均不需要梯度训练。
结果需要区分任务与预算。Llama-3.1-8B-Instruct 在 LongBench 上,2% 预算的 BinaryPC 得分为 49.50,全注意力为 49.64;在 128K RULER 上则为 73.23 对 76.49,仍有 3.26 分差距。速度实验中,OPC 版本在八张数据中心 GPU、2M 上下文、batch size 2 时达到 3.56 倍解码吞吐,但该超长上下文实验扩展了位置编码且不评价生成质量。它保留完整 KV 缓存,减少的是每步访问与注意力计算量。(表 3,p. 6;表 4,p. 7;§4.2、图 5,pp. 7–8;附录 B.4、B.6,pp. 17–18)
结构地图
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| 1. Introduction | 解码瓶颈与现有哈希方法的不足 | pp. 1–2,图 1–2 |
| 2. Related Works;2.1 Sparse Attention;2.2 Hashing-Based Sparse Attention | 静态裁剪、动态筛选、随机及学习型哈希的区别 | pp. 2–3 |
| 3.1 Hashing-Based Retrieval | 用压缩表示近似 query–key 分数 | p. 3,式 (1) |
| 3.2 BinaryPC | 重构目标、二值分解、OPC、位运算检索、EAS | pp. 3–5,式 (2)–(9),算法 1–3,图 3 |
| 4.1 Accuracy Evaluation | 短、中、长上下文和长度扩展 | pp. 5–7,表 1–4,图 4 |
| 4.2 Efficiency Evaluation | 内核开销与整模型解码吞吐 | pp. 7–8,图 5–6 |
| 4.3 Ablation Study | EAS 配额、码长、校准领域 | pp. 8–9,表 5–7 |
| 5. Conclusion | 贡献归纳 | p. 9 |
| A.1–A.4 Implementation Details | baseline、数据、算法示意、CUDA 位平面实现 | pp. 13–15;图 8 排在 p. 16 |
| B.1–B.3 Additional Experiment Results | 输出近似误差、消费级 GPU、Qwen 长文结果 | pp. 16–17;表 8、10 分别在 pp. 14、15 |
| B.4–B.6 | 70B 扩展、MagicPIG 与更多稀疏方法的效率比较 | pp. 17–18,表 11–13 |
| B.7–B.9 | LongBench、NIAH、RULER 细分结果 | pp. 18–21;表 9 在 p. 15,图 9–10、表 14–18 在 pp. 19–21 |
一:动机——挑出重要 token 本身也需要成本
1.1 为什么重点放在解码
预填充(prefill)可以并行处理输入,解码则逐 token 生成。对单个 query,完整注意力要遍历长度为 $N$ 的历史 KV;每一步的注意力计算随 $N$ 线性增长,并伴随大量显存读取。即使最终只想对少数 token 做注意力,如果先算完所有精确分数再取 top-k,筛选阶段依然要读取全部 key。
BinaryPC 希望把这次全量扫描改为读取极小的哈希编码,然后仅为候选位置读取原始 KV。论文的“稀疏”主要发生在 decode;prefill 仍计算完整输入注意力。(§1,p. 1;§4.2,p. 8;附录 B.2,p. 16)
1.2 比较对象分别暴露什么问题
| 比较对象 | 选择依据 | 与本文相关的取舍 |
|---|---|---|
| PyramidKV、CAKE、CompressKV | prefill 时估计重要性并分配预算 | 裁剪后难以找回未来 query 才需要的信息 |
| Quest | 当前 query 与分块 key 统计 | query-aware,但按块选取可能携带不相关 token |
| MagicPIG | 随机投影的局部敏感哈希(LSH) | 数据无关,本文采用的默认配置含 10 bit × 150 张表 |
| Spotlight | 训练得到的非线性哈希映射 | 数据相关,但需要模型对应的训练;本文只测已发布权重的 Llama-3-8B |
| TOPK oracle | 所有 key 的精确分数 | 用于观察筛选近似的损失,仍承担全量精确打分成本 |
作者的切入点是:数据相关的编码不一定要通过梯度学习得到,也可以从实际 key 的重构问题出发直接计算。(§2,pp. 2–3;附录 A.1,p. 13)
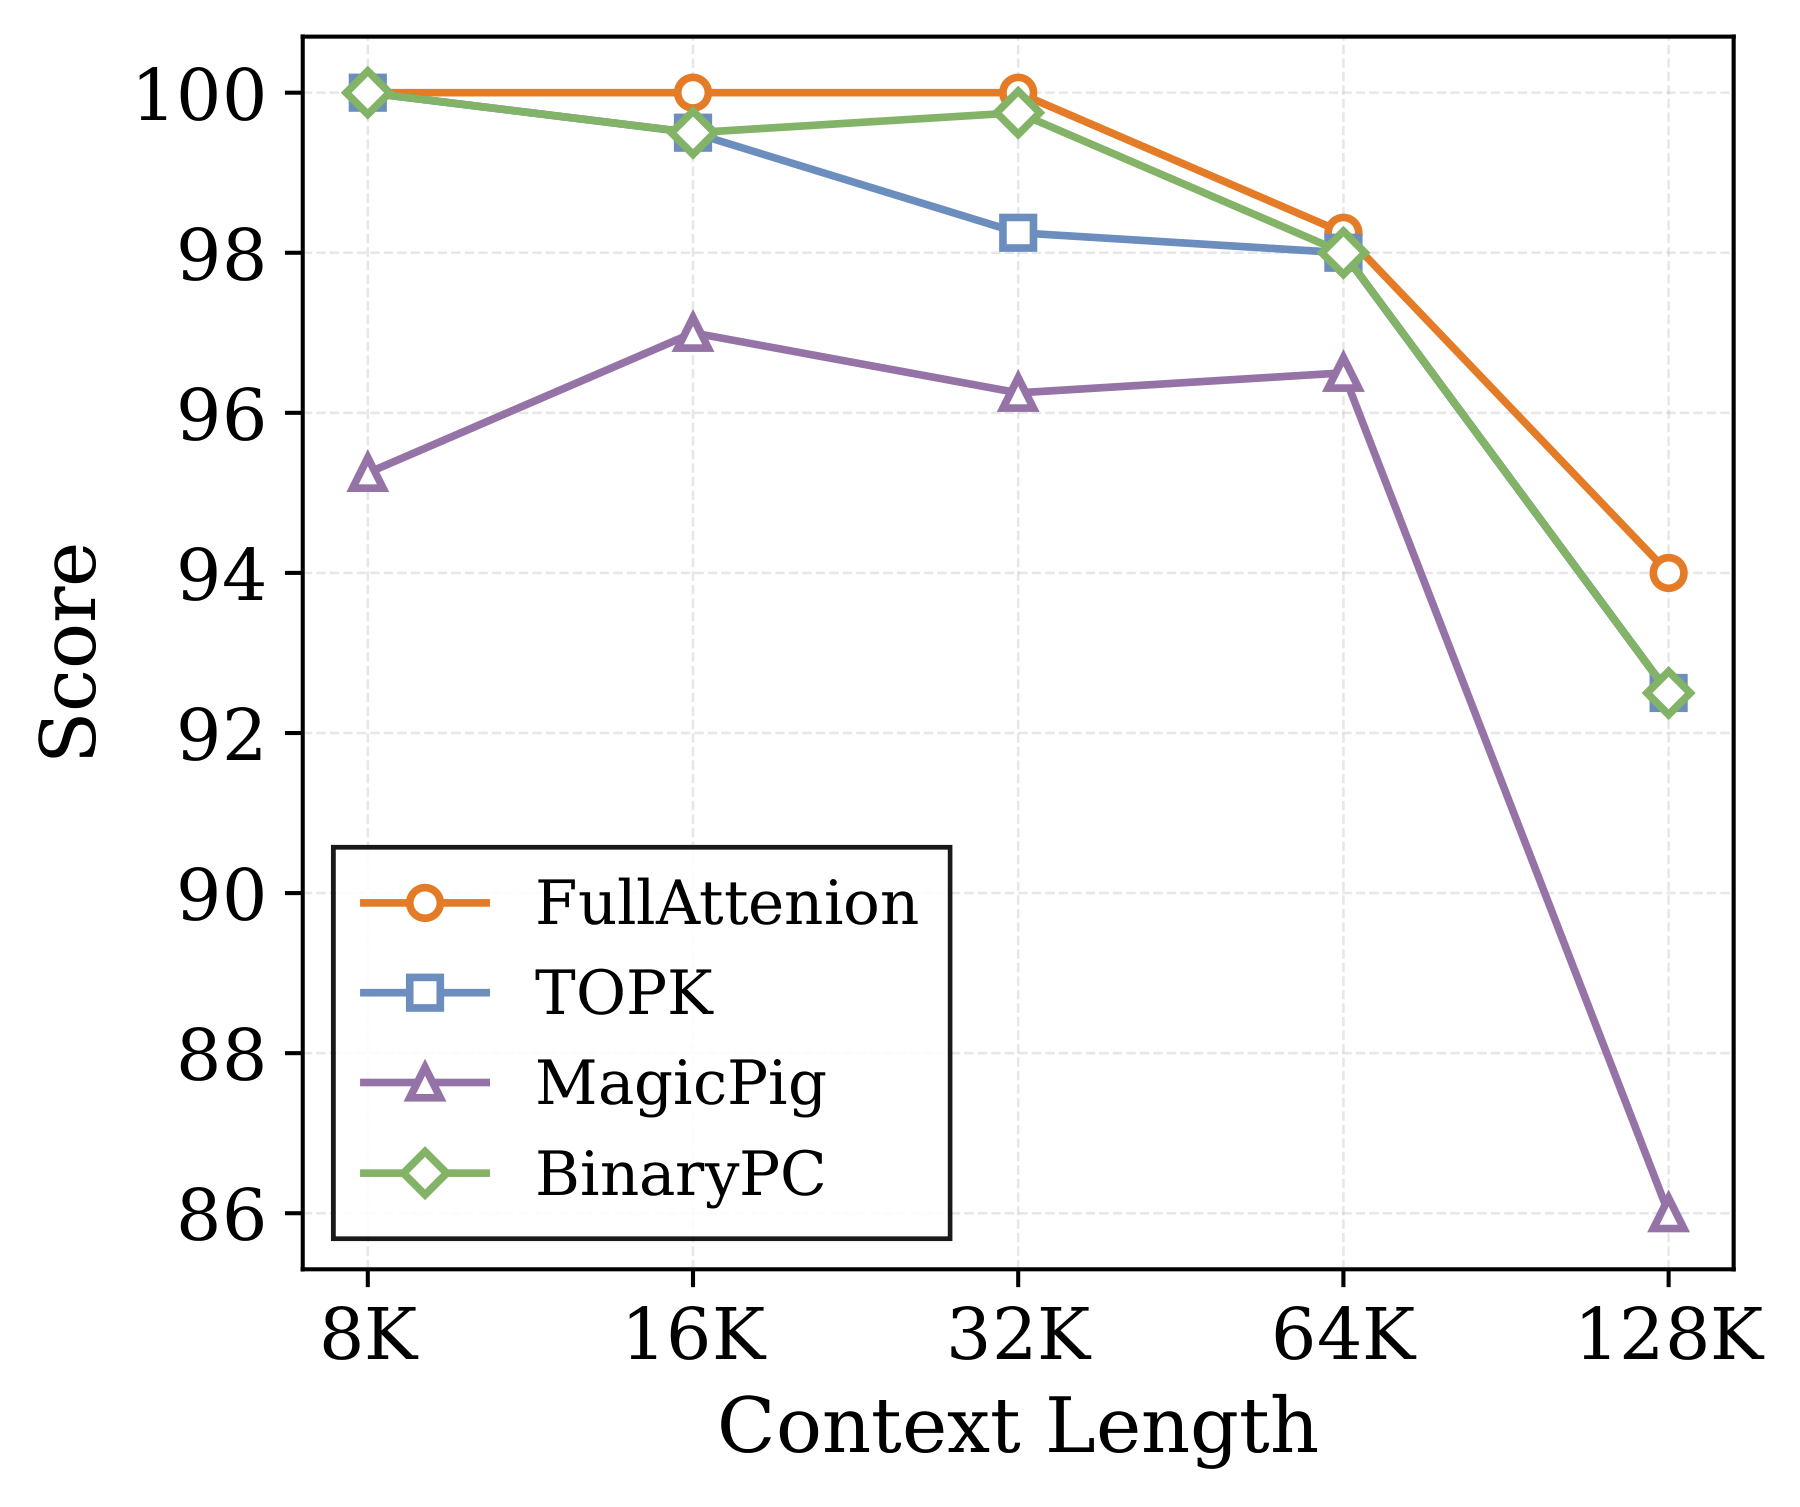
原文图 1,p. 1。横轴为上下文长度,纵轴为 NIAH multi-value 子任务分数,TOPK 使用 2% 预算。128K 时 TOPK 和 BinaryPC 均为 92.50,MagicPIG 为 86.00,全注意力为 94.00(细分数值见表 18,p. 21)。这说明该任务存在有效稀疏子集,而哈希质量会决定能否找到它;图中这一结论对应多值检索,其他 RULER 子任务的稀疏化损失还需单独看。
二:方法——先重构 key,再近似检索分数
2.1 符号与整体流程
以下按一个注意力头说明,省略 batch、layer 和 head 下标。
| 符号 | 维度/含义 |
|---|---|
| $N,D$ | 历史 token 数、key/query 维度;CUDA 实现使用 $D=128$ |
| $H$ | 哈希码长,默认 64 |
| $\mathbf K$ | $N\times D$,完整 key 矩阵 |
| $\mathbf H$ | $N\times H$,每个元素为 $-1$ 或 $+1$ |
| $\mathbf P$ | $H\times D$,每一行是一个实值重构分量 |
| $\mathbf q,\mathbf k$ | $1\times D$ 行向量 |
| $\mathbf h$ | $1\times H$,一个 key 的二值编码 |
| $B,k,m$ | 总选取预算、哈希候选数、误差保护数;本文用 $B$ 帮助区分预算口径 |
数据流为:
- 在线从输入 key 构造 $\mathbf P$,或者加载离线校准的 $\mathbf P$。
- 构造每个 key 的 64 位编码,保存完整 KV,并确定高误差 token 集。
- 对当前 query 计算 $\mathbf q\mathbf P^\top$,量化后扫描所有 key 编码。
- 将哈希 top-k 与误差保护集合合并,读取所选原始 KV,在该子集上计算注意力。
因此,哈希分数用于选位置;最终注意力仍使用所选原始 key/value,而不是用二值编码直接替代 value 聚合。
2.2 重构目标为什么能服务于内积检索
原文式 (2) 的目标为:
若一行满足 $\mathbf k\approx\mathbf h\mathbf P$,则有原文式 (3):
这里的非对称性很重要:key 只有 $H$ 个二值系数,query 的 $H$ 个系数仍带幅值。二值化没有要求 key 的所有方向和长度信息都等价,因为实值基 $\mathbf P$ 仍携带尺度。通常注意力的 $1/\sqrt D$ 缩放对同一个 query 的排序不产生影响,最终子集注意力仍应按模型原有定义计算。(§3.2,pp. 3–4)
下面是帮助理解 EAS 的本次推导。令 $\mathbf e=\mathbf k-\mathbf h\mathbf P$,则
它将 key 重构误差与打分误差联系起来,但这个界尚未包含 query 的量化误差。两个候选的精确分数间隔如果大于各自误差上界之和,排序才由这个界得到保证。小的平均重构误差并不能自动保护少数高误差 token。
2.3 算法 1:逐 bit 做二值秩一分解
为统一维度,下面将 $\mathbf u$ 写成 $N\times1$ 列向量,$\mathbf v$ 写成 $1\times D$ 行向量;这与原算法的计算等价。
初始化 $\mathbf R=\mathbf K$,对每个 bit 重复:
把 $\mathbf u$ 放到 $\mathbf H$ 的下一列,把 $\mathbf v$ 放到 $\mathbf P$ 的下一行。每一轮用一个共同向量的正负两个版本近似所有 residual,再处理剩下的信号。(算法 1、式 (5)–(6),p. 4)
为什么 $\mathbf v$ 有这个闭式解? 固定 $\mathbf u$ 后,求解 $\min_{\mathbf v}\|\mathbf R-\mathbf u\mathbf v\|_F^2$。因为 $\mathbf u^\top\mathbf u=N$,最小二乘解正好是上式。由此还能得到以下本次推导:
所以对构造投影的这批数据,每一步总残差都不增加。不过,$\mathbf u$ 是从一次随机方向投影取符号获得的;原文最终算法没有内层交替优化,也没有求精确奇异向量。“Binary Principal Components”描述其从残差逐次提取分量的思想,具体实现是贪心近似。这里也未要求 $\mathbf K$ 中心化或 $\mathbf P$ 的各行正交,不能直接套用标准 PCA 的最优性结论。
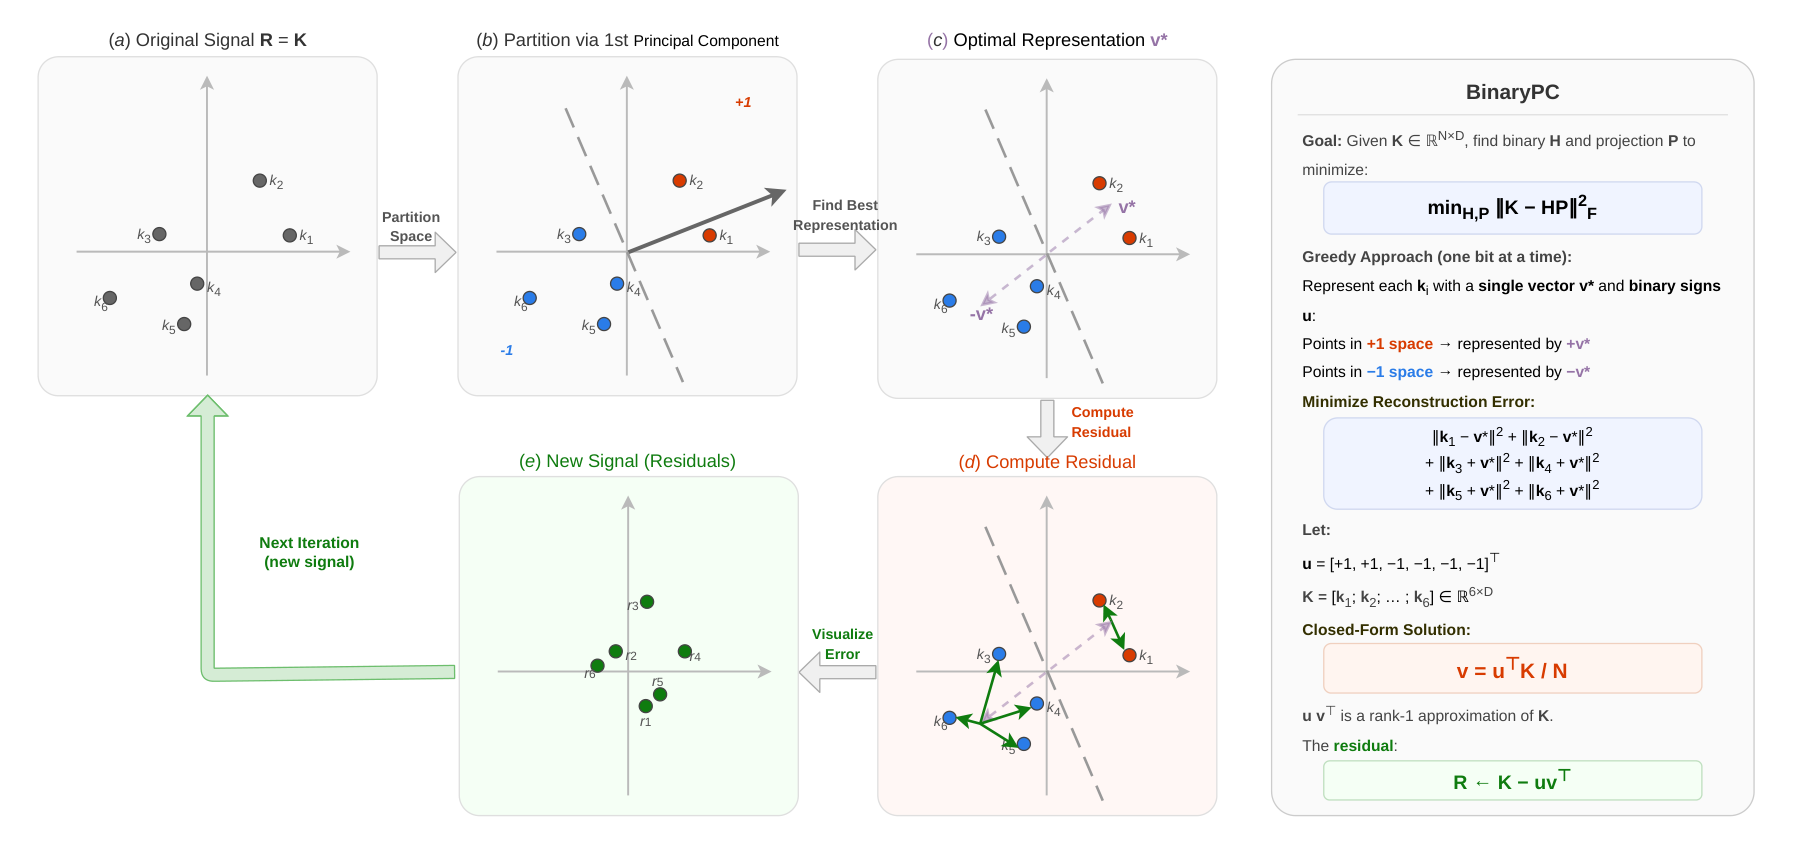
原文图 8,p. 16。上排依次展示当前信号、二值分区、共享重构向量;右下计算残差,左下把残差作为下一轮输入。阅读时应将“主方向”示意与算法 1 的随机投影近似结合理解。
2.4 算法 2:给定基时,新 key 要按残差顺序编码
当 $\mathbf P$ 已知时,不能简单把所有 bit 同时写成 $\operatorname{sign}(\mathbf k\mathbf P^\top)$。因为基不正交,后一个分量应编码前面分量没有解释的部分:
这适用于离线投影作用于新输入,以及固定投影下编码新增 key。(算法 2,p. 4)
以下是教学例子:设 $\mathbf P_{1,:}=(2,0)$、$\mathbf P_{2,:}=(1,1)$、$\mathbf k=(1,-1)$。第一步取 $h_1=+1$,剩余 $\mathbf r_1=(-1,-1)$;第二步取 $h_2=-1$,重构为 $(2,0)-(1,1)=(1,-1)$。若第二步还使用原始 key,内积为 0,无法表达这个顺序消残差的逻辑。
算法 2 与算法 1 的性质也有区别。固定 $\mathbf v$ 时,选择符号后的范数变化为
这个量可以为正,因此新 key 的每一步残差下降依赖数据;原文图 3 展示的是所测数据上的下降趋势。该区别解释了为什么仍需要显式保护难以编码的 key。
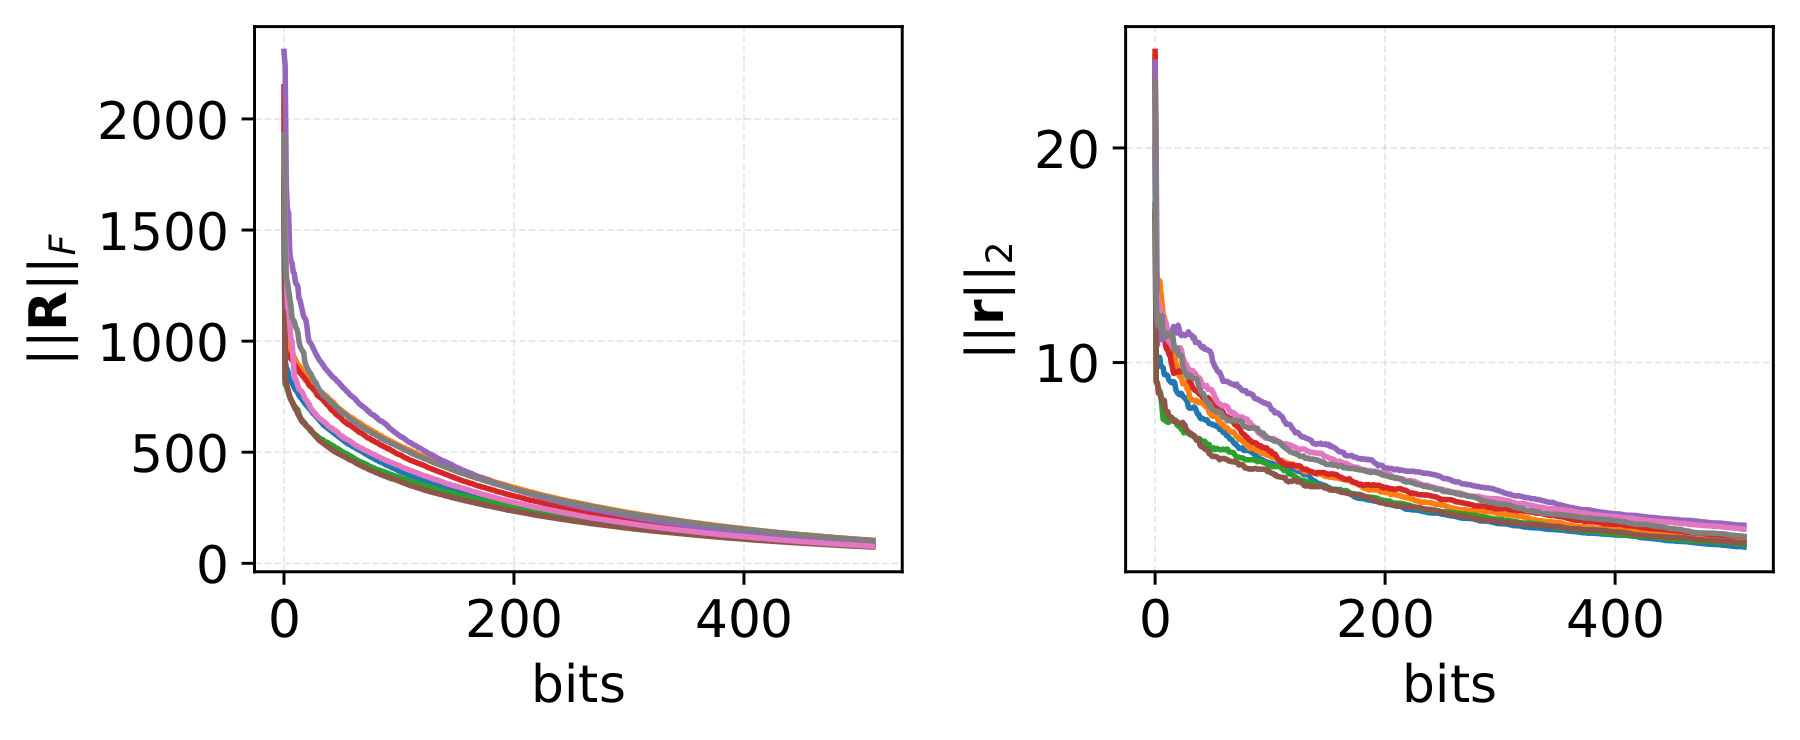
原文图 3,p. 4。横轴均为编码 bit 数;左侧为算法 1 的 Frobenius 残差,右侧为算法 2 的单向量 L2 残差,不同曲线对应不同数据。图展示了逐步增加分量带来的重构改善,最终 64 bit 的取舍还要结合表 6 的任务结果。
2.5 OPC:把投影构造移到部署之前
在线版本从当前上下文的 key 计算投影。OPC 则从 PG19、ProofPile、CodeParrot 各取 60 个样本,共 180 个样本,通过模型前向收集各层 key,再用算法 1 生成投影。推理时使用已有投影和算法 2 编码。(§3.2,p. 4)
这里“免训练”指不使用反向传播或梯度更新,不代表没有数据处理成本。OPC 仍需要运行目标模型、保存与其激活分布相适应的投影。它节省线上构造投影的时间,但实际输入仍需计算 key 编码;图 7 中 OPC 的 prefill 时间与全注意力接近,并非整个预处理过程消失。
2.6 算法 3:query 用 8 个字,key 用 1 个字
令 $\mathbf p=\mathbf q\mathbf P^\top\in\mathbb R^{64}$。原文将其量化到 $[-127,127]$ 的整数,每个元素保存一个符号位和七个幅值位,然后按位平面打包:
- key 的 64 个符号打包为一个
int64,共 8 字节。 - query 的 64 个符号打包为一个
int64,同一幅值位的 64 个 bit 各打包为一个int64,合计 8 个字、64 字节。 - 用 XOR 判断符号关系,AND 筛出该位有效的位置,popcount 统计正负贡献,再按位权加总。
为何允许 query 更大?每步只有少量 query,而要扫描许多 key;增加 query 精度的代价可以被复用,key 编码的每个额外字节却会乘以历史长度。(算法 3,p. 5;附录 A.4,pp. 14–15)
为避免符号位约定产生歧义,下面给出一个明确编码约定下的等价推导。设 $\hat p_i=s_i\sum_{j=0}^{6}2^j M_{j,i}$,且 $+1\mapsto0$、$-1\mapsto1$。令 $W$ 为 query 与 key 符号字的 XOR,则 $W$ 的 1 表示异号,因此
原文式 (10)–(12) 把七个位写为 $j=1,\ldots,7$ 并使用 $2^j$,与普通七位幅值的 $0,\ldots,127$ 表示相差一位;若全部分数仅多一个正的常数倍,top-k 不变。式 (13) 的正负顺序还依赖符号 bit 的具体约定。实现时应明确这两项,不能将论文中的抽象 $\{-1,+1\}$ 直接当作机器 bit。上述公式固定了约定;原文没有明确给出 query 量化的缩放与取整规则。
2.7 EAS:给高重构误差 token 留一条通道
误差感知保护(Error-Aware Safeguard,EAS)在 prefill 时计算
将最大的 $m$ 项组成 $\mathcal S_{\mathrm{err}}$。解码时再与哈希候选合并:
高重构误差不等于当前 query 的高注意力权重;它表示这个位置的哈希分数更不可信。EAS 的作用是把这类位置交给原始 KV 注意力处理,尤其照顾上下文中的离群信息。(式 (8)–(9),p. 5)
默认 10% 指总注意力预算中的占比。例如总输入 100,000 token、总预算 2% 时,$B=2,000$,约 200 个位置用于 EAS、1,800 个用于哈希候选;并不是额外保留输入的 10%。两集合有重叠时,并集大小不超过配额之和;原文未说明去重后是否补齐。
2.8 时间与内存到底省在哪里
按原算法,构建 $H$ 个分量约需 $O(NDH)$ 计算;固定投影后,一个新 key 的顺序编码和一个 query 的投影都约为 $O(DH)$。对 $H=64$,每个 query 要扫描所有 $N$ 个 64 位 key 码,经过七个幅值位平面计算近似分数,再调用 torch.topk、torch.gather,最后在约 $B$ 个位置上做原始注意力。
因此,检索仍随上下文长度增长,优势来自更小的扫描表示和更便宜的运算,并没有把候选搜索变成与 $N$ 无关的常数时间。
以 $D=128$、BF16 K/V 为例,一个 KV head 的每个 token 原始缓存为 $2\times128\times2=512$ 字节,新增哈希码为 8 字节,相对 KV 缓存增加 1/64≈1.56%。投影在长序列下较小。完整 KV 仍保留供候选回读,故 2% 注意力预算不对应 98% 的 KV 显存节省。(§4.2,p. 8;附录 B.4,p. 17)
三:实验——先分清任务、指标与预算
3.1 质量评测如何组织
主实验覆盖 Llama-3-8B、Llama-3.1-8B-Instruct、Mistral-7B-Instruct-v0.3、Qwen2.5-7B-Instruct-1M,附录补充 Llama-3-70B-Instruct。不同基准并未都在每个模型上完整交叉测试。
| 评测组 | 检验问题与统计口径 | 主要预算 |
|---|---|---|
| 短上下文 LM-Eval-Harness | GSM8K-CoT、MMLU 的 accuracy,CoQA 的 F1;取三项平均,越高越好;附录称每个子任务抽取 1,000 实例 | BinaryPC 5%;Quest 64 token;MagicPIG 实测约 5–7% |
| LongBench | 16 个数据集,覆盖六类任务;使用各任务基准分数,越高越好 | BinaryPC 2%,另有 1K;其他若干方法 1K |
| InfiniteBench | 七类任务的基准分数及其平均;包含摘要、问答、选择、说话人识别、整数与 passkey 检索 | BinaryPC 2% 或 2K;常见对照 2K |
| LongBench v2 | 多选题准确率;Easy/Hard 与 Short/Medium/Long 是两套分组,Avg. 是整体结果 | 与上项相同 |
| RULER | 13 个任务,涵盖检索、追踪、聚合、QA;分别在 8K–128K 评测 | BinaryPC 2% 或 2K;oracle 2%;常见对照 2K |
| NIAH | 将相关内容放在不同深度,观察检索分数随长度和深度变化 | BinaryPC 2%;Quest 等 2K |
LongBench 表 3 的六个任务类别列是类别内平均,但右侧 Avg. 对应表 9 的 16 个数据集平均,不是六个类别均值再等权平均。RULER 表 4 的 Avg. 则是五个长度设置的平均。不同基准的 Avg. 不能直接混为一个“平均准确率”。(§4.1,pp. 5–7;附录 A.2,pp. 13–14;表 9,p. 15)
3.2 预算和 baseline 的实现条件
固定百分比与固定 token 数会随长度产生不同关系:按 8,192 token 计,2% 约为 164 个位置,而 2,048 个位置占 25%;到 131,072 token 时,2% 约为 2,621,而 2K 约为 1.56%。因此,2K RULER 在较短输入上的改善伴随明显更大的预算。
MagicPIG 的默认检索结果数量随数据变化,作者估计除短任务外约为 2–3%,不是严格 2%。若干 baseline 保留前两层密集注意力,MagicPIG 保留首层和中间层;这些实现差异应与 token 预算一起理解。Spotlight 的短任务表实际采用 5%,LongBench 为 2%;附录概述中的 2% 不能覆盖表 2 的特例。(表 2–4;附录 A.1,p. 13)
3.3 效率协议与质量协议分开
主速度实验使用 Llama-3.1-8B-Instruct 的 OPC 版本、八张数据中心 GPU、HuggingFace Transformers、流水线并行和预分配 Static KV Cache。先 warm-up 32 步,再连续生成 64 token,每点平均三次运行。比较对象的图例为 FlashAttention 2.7.1;预算为 2%。
速度曲线扩展到 2M token,作者明确为此扩展位置编码并忽略输出质量,所以 2M 的数据回答吞吐问题。论文公开正文只称“data-center GPUs”或“consumer-grade GPUs”,没有明确列出主实验 GPU 型号;不能用源码注释或图件文件名补成已公开配置。(§4.2,pp. 7–8)
四:结果——质量、检索、速度与消融分别说明什么
4.1 短上下文:OPC 的收益明显,在线版本仍会损失推理表现
| 方法 | 预算 | Llama-3-8B 三项平均 ↑ | Llama-3.1-8B 三项平均 ↑ |
|---|---|---|---|
| 全注意力 | Full | 64.92 | 72.74 |
| Quest | 64 token | 35.55 | 36.53 |
| MagicPIG | Default | 56.46 | 64.23 |
| Spotlight | 5% | 58.97 | — |
| BinaryPC | 5% | 59.31 | 70.81 |
| BinaryPC + OPC | 5% | 63.82 | 71.16 |
来源:表 2,p. 6。三项包含两项 accuracy 与一项 F1,因此表内写“平均分”。
在线 BinaryPC 在 Llama-3-8B 上比全注意力低 5.61 分,不能将这一组概括为完全无损。差距主要来自 GSM8K:54.50 降至 42.60,而 OPC 恢复到 52.00。OPC 使三项平均达到 63.82,距离完整基线 1.10 分。Llama-3.1-8B 上在线与 OPC 分别低 1.93、1.58 分,明显优于本表中的其他稀疏对照。
这组实验支持“无需梯度训练也能得到较好的哈希映射”,同时说明投影来源会影响短任务质量,特别是需要较长生成链条的任务。
4.2 中等上下文:LongBench 平均分接近,但不等于逐任务无损
| 模型 | 全注意力 | BinaryPC 2% | OPC 2% |
|---|---|---|---|
| Llama-3-8B | 30.63 | 30.18 | 30.35 |
| Llama-3.1-8B-Instruct | 49.64 | 49.50 | 49.50 |
| Mistral-7B-Instruct-v0.3 | 47.31 | 47.07 | 47.24 |
| Qwen2.5-7B-Instruct-1M | 47.03 | 46.48 | 46.30 |
来源:表 3,p. 6;表 9,p. 15。均为 16 数据集平均分,越高越好。
Llama-3.1 的 2% 结果只低 0.14 分;换为 1K 预算,在线与 OPC 达到 49.66、49.67。Mistral 的 1K 结果为 47.38、47.42,略高于全注意力的 47.31。这些小幅正负差别宜解读为表现接近,论文没有给出质量评测的多次重复误差条。
类别和任务结果能补充平均值的解释。例如 Llama-3.1 的 GovReport,BinaryPC 2% 为 34.92、全注意力为 34.45,而 PyramidKV 1K 为 26.69,表明动态读取对该摘要任务较有利。Qwen 的代码任务则仍有损失:Lcc 从 46.19 降到在线版 42.01,OPC 为 39.94;不能只凭平均分概括所有任务。(表 9,p. 15)
4.3 超长上下文:Llama 接近完整基线,Qwen 的差距更明显
| 模型/方法 | 预算 | InfiniteBench 平均 ↑ | LongBench v2 整体准确率 ↑ |
|---|---|---|---|
| Llama-3.1 全注意力 | Full | 43.30 | 29.4 |
| Llama-3.1 MagicPIG | Default | 43.18 | 27.6 |
| Llama-3.1 BinaryPC | 2% | 43.21 | 29.8 |
| Llama-3.1 OPC | 2% | 43.09 | 29.4 |
| Qwen2.5 全注意力 | Full | 31.15 | 30.4 |
| Qwen2.5 MagicPIG | Default | 24.57 | 28.4 |
| Qwen2.5 BinaryPC | 2% | 29.83 | 31.2 |
| Qwen2.5 OPC | 2% | 29.31 | 30.4 |
来源:表 1,p. 5;表 8,p. 14。
Llama 的在线版本在 InfiniteBench 低 0.09 分、在 LongBench v2 高 0.4 个百分点。LongBench v2 的 29.8 与 CAKE 2K 并列,因此这里也不是独占最优。Qwen 的 InfiniteBench 则分别低 1.32、1.84 分,不过明显好于 MagicPIG。
任务难度与模型底座仍起主导作用:Qwen 全注意力在 InfiniteBench 的 R.PK 仅为 34.58,在线 BinaryPC 也是 34.58;另一套 NIAH 上两者达到 100。它们是不同检索测试,不能将一个基准的满分迁移到另一个基准。(表 8;图 9,p. 19)
4.4 RULER:接近精确稀疏 TOPK,仍受预算和任务影响
| 上下文 | 全注意力 | TOPK 2% | BinaryPC 2% | BinaryPC 2K | MagicPIG Default |
|---|---|---|---|---|---|
| 8K | 94.32 | 91.53 | 91.67 | 94.47 | 91.28 |
| 16K | 93.96 | 91.37 | 90.86 | 93.98 | 90.82 |
| 32K | 87.10 | 88.80 | 87.73 | 88.86 | 85.26 |
| 64K | 85.19 | 83.39 | 84.36 | 85.09 | 83.96 |
| 128K | 76.49 | 73.62 | 73.23 | 72.89 | 72.07 |
| 五个长度平均 | 87.41 | 85.74 | 85.57 | 87.06 | 84.68 |
来源:表 4,p. 7;模型为 Llama-3.1-8B-Instruct,各项越高越好。
2% BinaryPC 的五长度平均只比精确 TOPK 低 0.17 分,但比全注意力低 1.84 分。128K 的 73.23 与 oracle 的 73.62 很接近,却低于全注意力 3.26 分。由此更合适的解释是:哈希筛选的额外损失较小,但稀疏子集本身仍有信息损失。 这里 TOPK 是基于精确分数的参照,并非所有生成任务分数的数学上界;部分长度的稀疏结果可以超过完整基线。
子任务揭示了平均分背后的差异。8K 的常见词提取(CWE),全注意力为 96.30,精确 TOPK 2% 为 75.40,BinaryPC 2% 为 75.30;即使精确知道所有分数,少量 token 也难保留聚合所需的信息。128K 的 N-MK3 则为全注意力 70.00、TOPK 59.00、BinaryPC 45.00,仍存在明显的哈希选取损失;同一长度的 N-MV 为 94.00、92.50、92.50。(表 14,p. 19;表 18,p. 21)
原文一处影响对照数值的差异:表 4 的 Quest 128K 是 65.39,表 18 则是 63.59,后者与其列出的 13 项均值一致。因此不宜据其中一个数计算精确的相对提升;BinaryPC、TOPK 与完整基线的上述比较不受该差异影响。
4.5 NIAH 与注意力输出相似度:更直接地看筛选质量
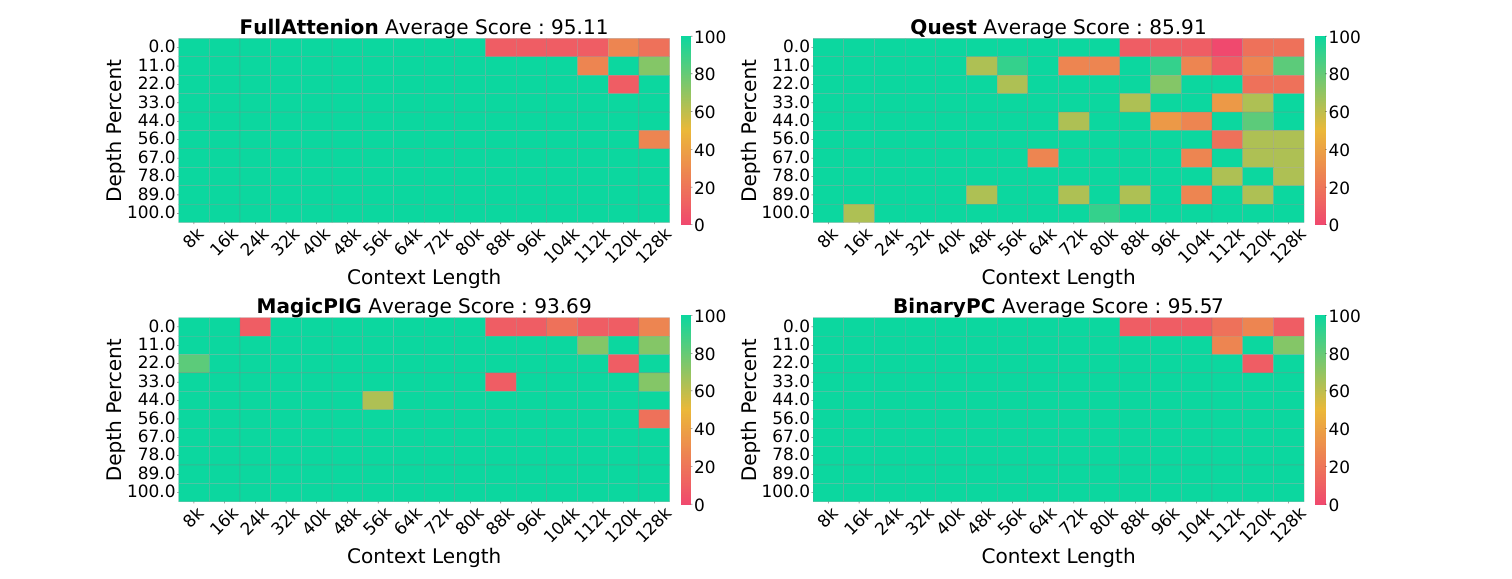
原文图 4,p. 7;裁切保留全部四个面板。横轴为 8K–128K 上下文长度,纵轴为插入信息的相对深度,颜色从低分到高分对应红色到绿色。
Llama-3.1 上,全注意力、Quest、MagicPIG、BinaryPC 的图示平均依次为 95.11、85.91、93.69、95.57;附录 OPC 为 95.85。BinaryPC 的高分区域与全注意力接近,但长上下文顶部位置仍有低分格子,不能把“近乎完美”读成所有位置都满分。Qwen 的图 9 中,全注意力、在线及 OPC 都为 100.00,MagicPIG 为 98.92。(图 4,p. 7;图 9–10,pp. 19–20)
表 10 进一步比较 Llama-3.1 第一个解码步的稀疏与完整注意力输出余弦相似度:
| 方法 | 8K | 16K | 32K | 64K |
|---|---|---|---|---|
| BinaryPC,2.0% | 0.9835 | 0.9811 | 0.9870 | 0.9895 |
| MagicPIG,2.2% | 0.9388 | 0.9651 | 0.9595 | 0.9725 |
来源:表 10,p. 15;越接近 1 越好。这个观察支持 BinaryPC 选择的子集更好地近似完整注意力输出;测量对象是首个解码步,不是整段生成过程中每一步的误差轨迹。
4.6 单层加速:回读的成本下降,搜索开销仍要算入
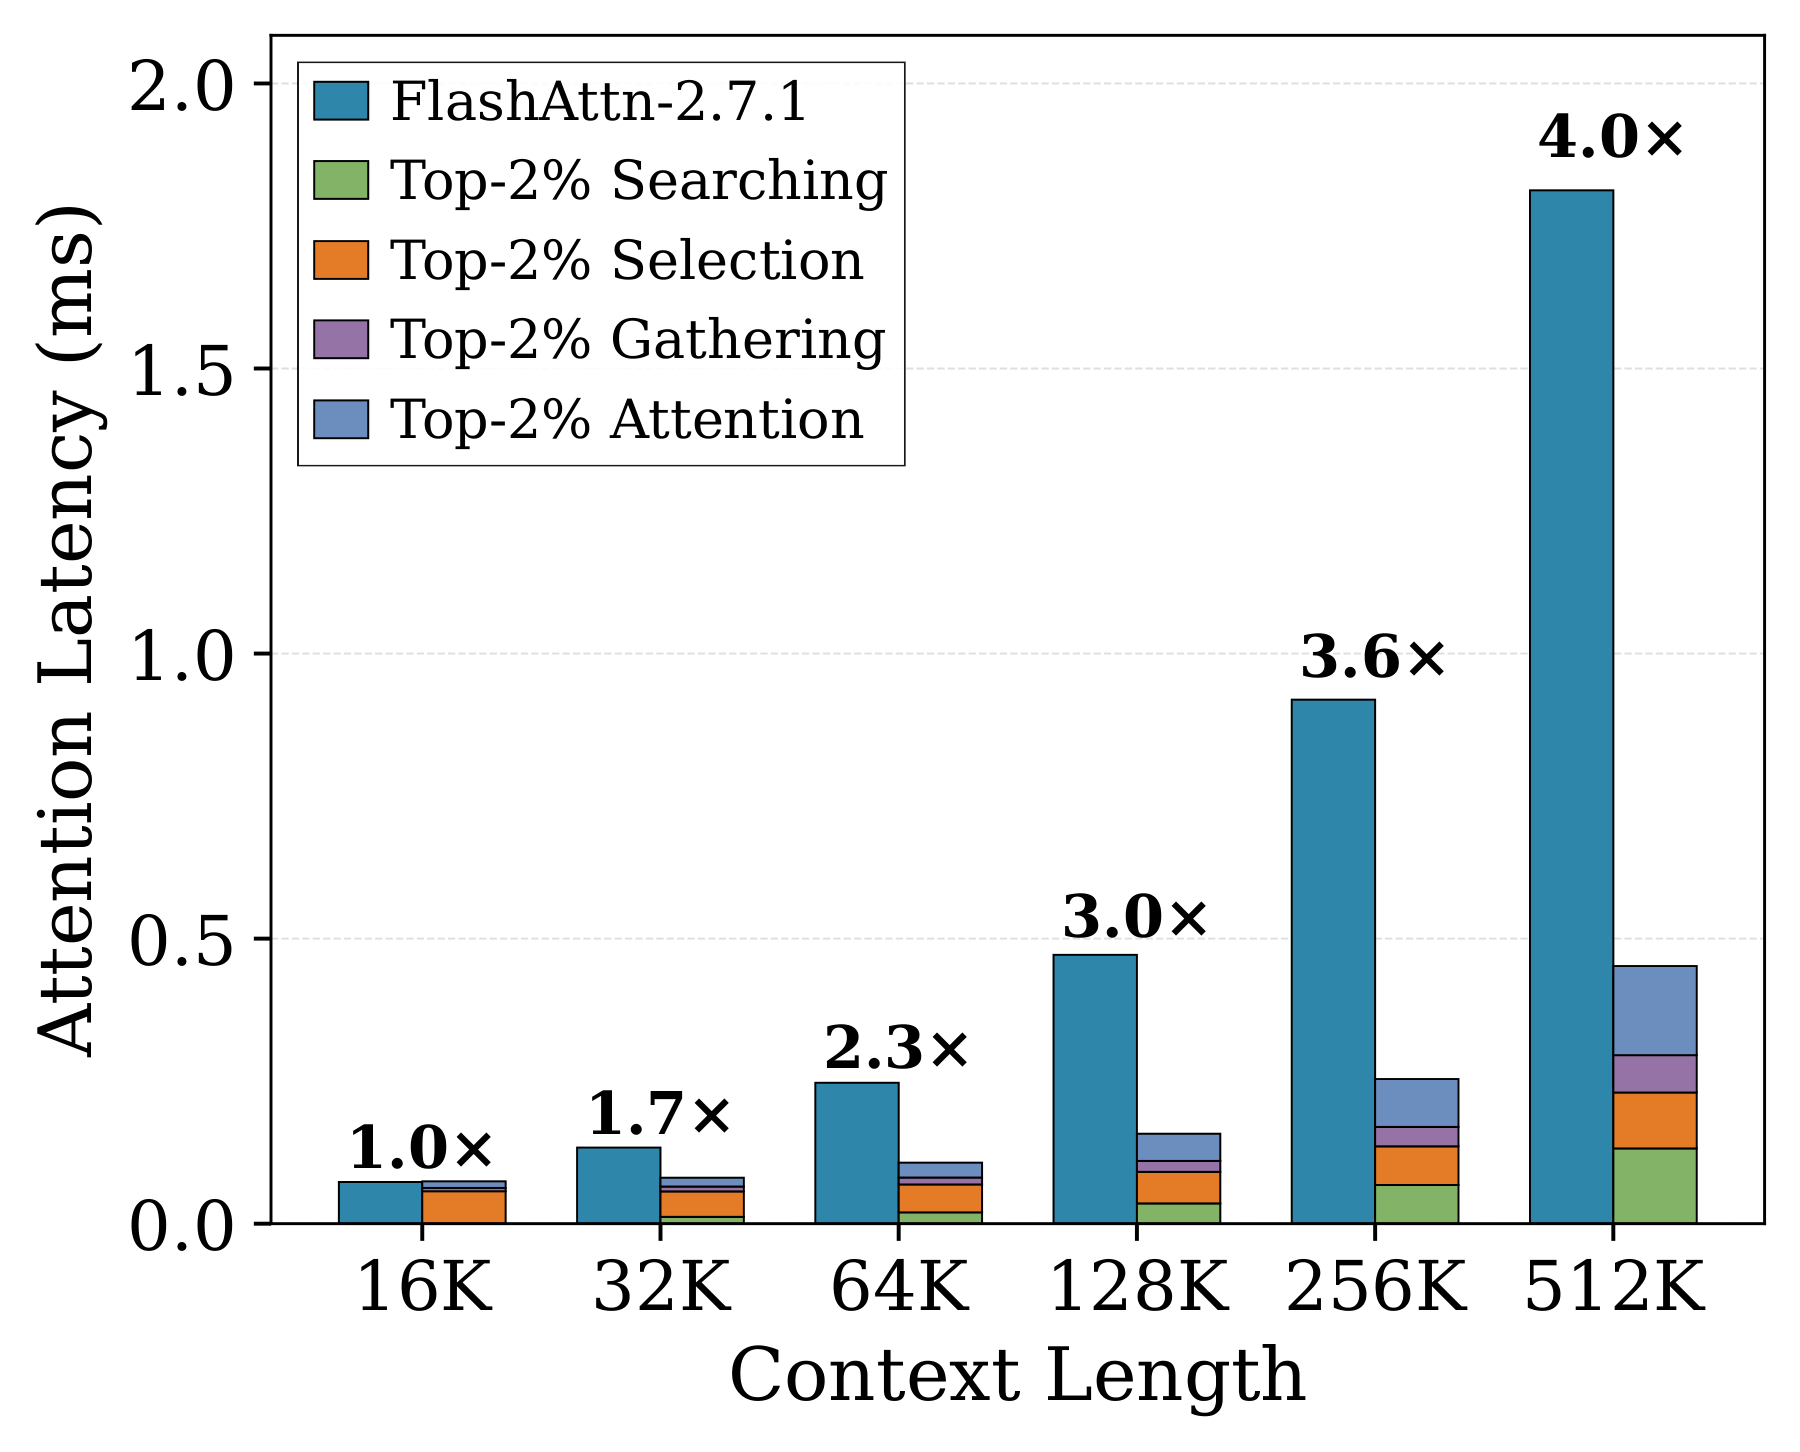
原文图 6,p. 8。横轴为上下文长度,纵轴为单层注意力延迟(ms);蓝色为全注意力,堆叠柱区分 searching、selection、gathering 与子集 attention。图注中的旧名称 BinVortex 对应本文 BinaryPC。
512K 设置下,作者报告全注意力内核为 1.814 ms,BinaryPC 的子集注意力为 0.163 ms,搜索、top-k、gather 合计 0.295 ms。因此应比较
即论文取整的 4.0 倍单层加速。仅用 $1.814/0.163$ 会忽略实际检索流水线。这里 2% token 预算并未转化为 50 倍加速,因为全量哈希扫描、选择、数据回读与小输入内核效率都占时间。(§4.2,p. 8)
4.7 整模型吞吐:收益随长度增大,也受到内核切换影响
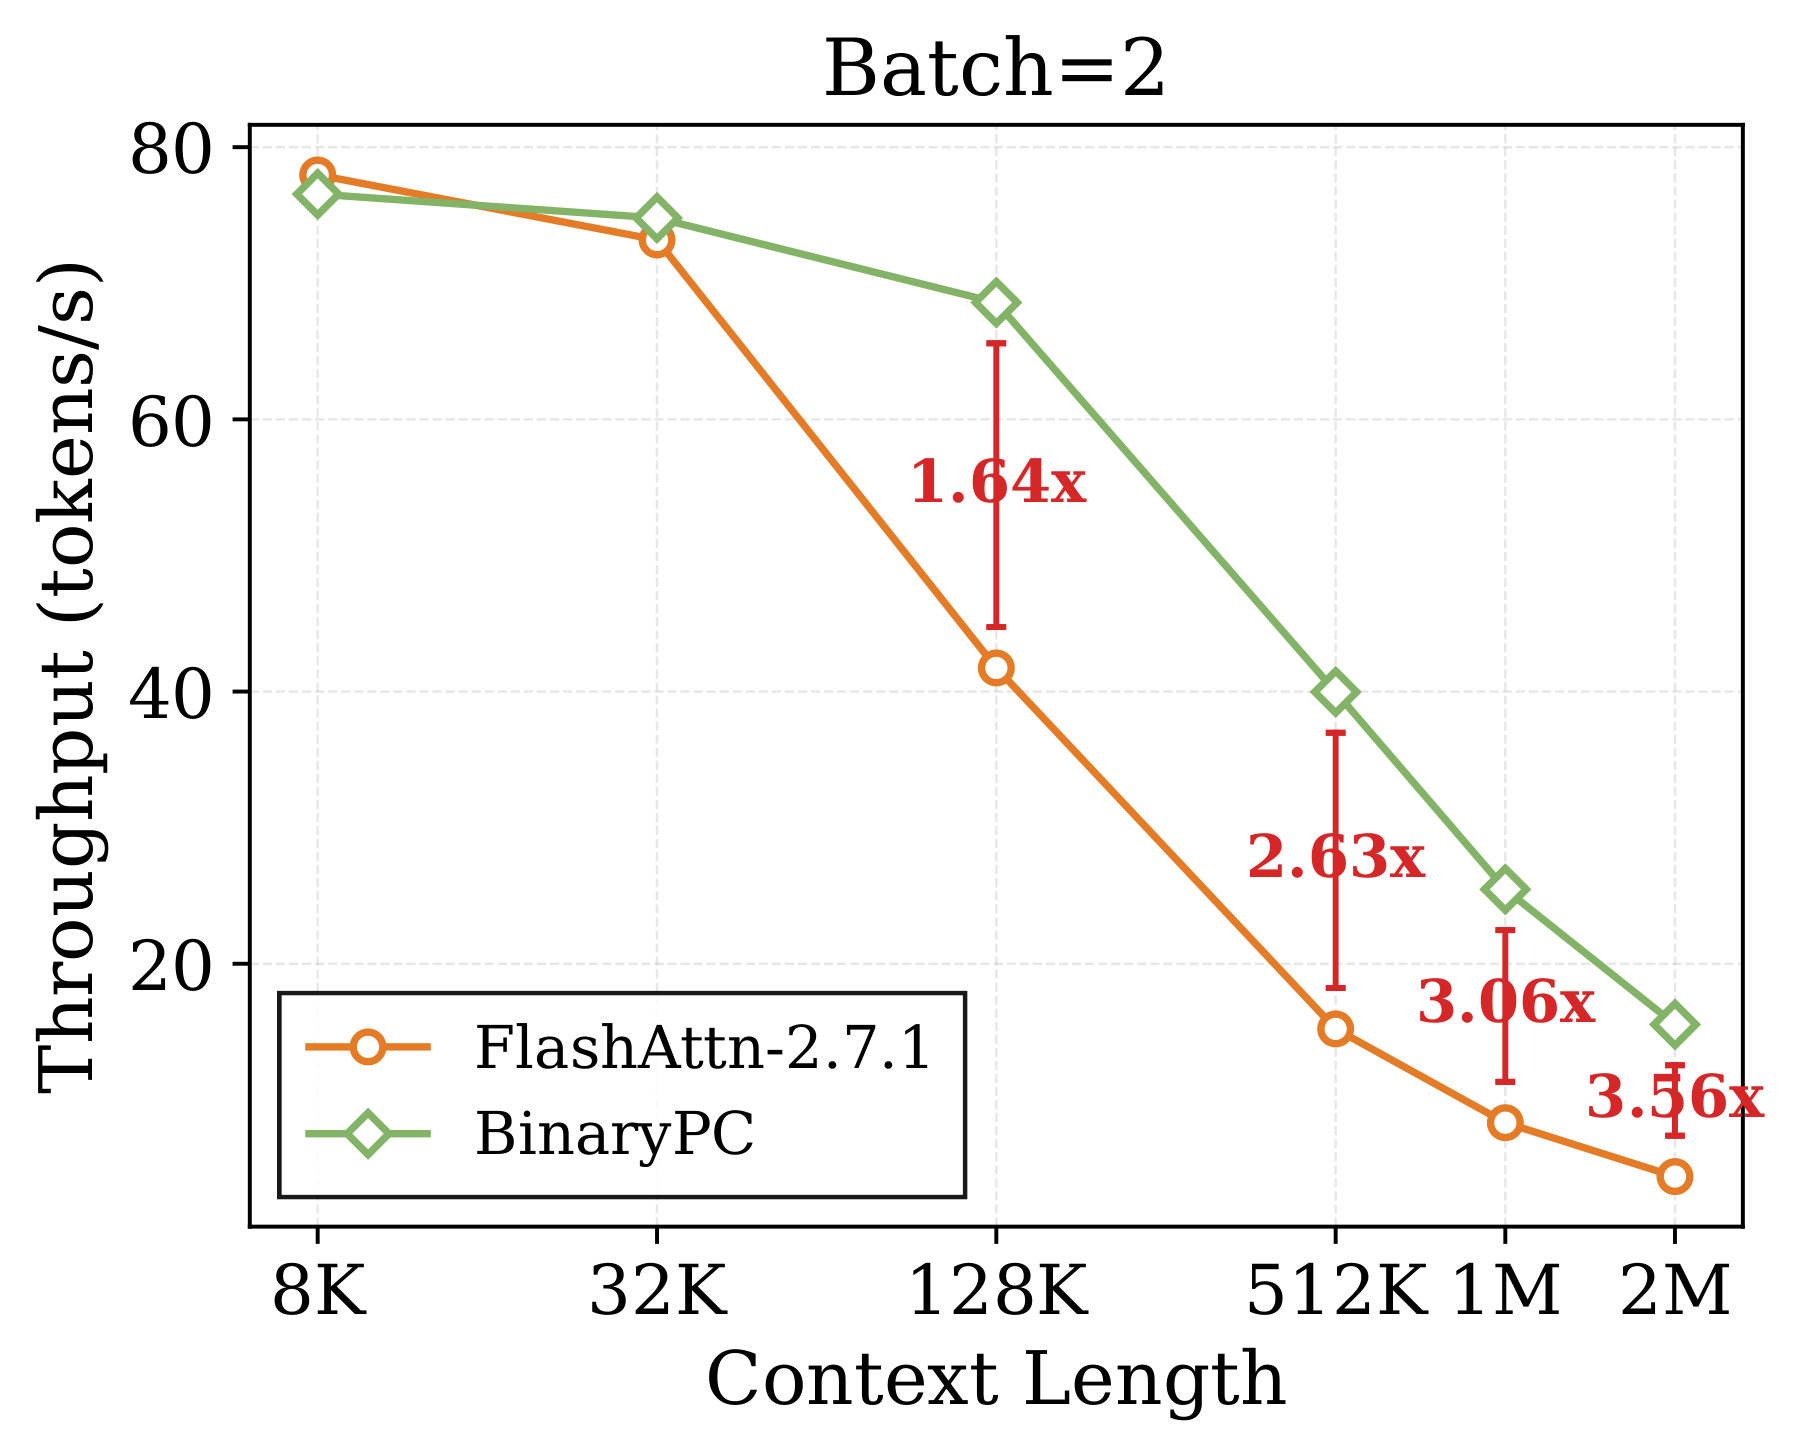
原文图 5 第二面板,p. 8。横轴为上下文长度,纵轴为整个模型的解码 tokens/s;绿色为 BinaryPC,橙色为 FlashAttention 2.7.1。短输入较接近,随着历史 KV 增长,减少访存的收益变大。
| 设置 | 作者报告的 BinaryPC / FlashAttention 吞吐比 |
|---|---|
| 八张数据中心 GPU,2M,batch 1 | 3.17× |
| 八张数据中心 GPU,2M,batch 2 | 3.56× |
| 同类硬件,64K,batch 16 | 4.25× |
| 同类硬件,128K,batch 16 | 5.04× |
| 八张消费级 GPU,512K,batch 1 | 2.40× |
| 消费级硬件,32K,batch 16/20 | 2.19×/3.42× |
来源:图 5、§4.2,p. 8;图 7、附录 B.2,pp. 14、16。
数据中心 GPU 上 batch 大于 15 时,FlashAttention 的内部启发式会从 Split-K 切到标准内核,完整注意力吞吐出现明显下降;BinaryPC 的子集更小,受影响较轻。因此 5.04× 反映了稀疏读取与具体内核切换共同作用。它与 2M、batch 2 的 3.56× 是两种不同设置,不应合成一个“常规加速范围”。
OPC 预填充开销接近全注意力,在线版还需构造投影,图 7 显示额外一次性耗时。生成足够长时可摊销,但这里“end-to-end decoding throughput”衡量的是整个模型的解码阶段,不能直接当作包含 prefill 的整次请求加速。
4.8 附录的效率对照限定了“最快”的含义
在单张数据中心 GPU 的同机比较中,64K、batch 4 时 FlashAttention、MagicPIG、BinaryPC 吞吐分别为 87.62、42.05、148.46 tokens/s。BinaryPC 是全注意力的 1.69 倍、MagicPIG 的约 3.53 倍。作者将 MagicPIG 的成本归因于 GPU–CPU 协作与通信;该结果对应其采用的实现和平台。(表 12,p. 18)
但 BinaryPC 并非所有稀疏方法中速度最高:八张消费级 GPU、128K、2,048 token 预算下,CompressKV 为 29.01 tokens/s,PyramidKV 为 28.14,BinaryPC 为 27.66,完整注意力为 21.31。各方法使用其官方实现,缓存设置也存在差别;此表支持其吞吐有竞争力,而非全面领先。(表 13,p. 18)
70B 的 LongBench 六类分数与完整注意力接近,例如代码类为 55.22 对 54.24、摘要为 26.98 对 27.31。效率部分报告的是单层延迟,并使用固定 2,048 预算:32K 时 BinaryPC-70B 为 0.243 ms,比完整注意力 0.181 ms 更慢;128K 时为 0.243 对 0.654 ms,256K 时为 0.245 对 1.289 ms。头维度和 KV head 数相同使单层成本近似,但从 32 层增加至 80 层后,总注意力工作量仍会增加。(表 11、附录 B.4,p. 17)
4.9 消融一:EAS 是在线版本的重要组成
该实验在 InfiniteBench 的每个子任务取 100 个样本,因此完整基线为 47.92,与主实验表 1 的 43.30 不属于同一统计样本。
| EAS 占总预算比例 | 在线版 R.PK ↑ | 在线版平均 ↑ | OPC 的 R.PK ↑ | OPC 平均 ↑ |
|---|---|---|---|---|
| 0% | 64.00 | 41.30 | 99.00 | 46.93 |
| 2% | 99.00 | 47.42 | 99.00 | 47.34 |
| 5% | 99.00 | 47.63 | 99.00 | 47.57 |
| 10% | 99.00 | 47.41 | 99.00 | 47.51 |
| 15% | 99.00 | 47.51 | 99.00 | 47.41 |
来源:表 5,p. 9;Llama-3.1-8B-Instruct。
在线版只分配总预算中的 2% 给 EAS,就把 passkey 得分从 64 恢复到 99,增加 35 个百分点。作者解释为 passkey 与背景上下文差异很大,在当前输入构造的二值表示下容易成为难编码离群点。2–15% 区间的平均分相近,默认选 10% 提供余量,而不是因为 10% 在表中最优。OPC 在没有 EAS 时 R.PK 已达 99,EAS 的收益转移到其他任务,例如 En.Dia 从 15 增到 18。(§4.3,pp. 8–9)
4.10 消融二:64 bit 是表示质量与机器字宽的折中
| 码长 | 104K NIAH 得分 ↑ | 88K–120K 五长度平均 ↑ |
|---|---|---|
| 32 bit | 71.82 | 86.37 |
| 64 bit | 92.73 | 90.18 |
| 128 bit | 90.91 | 90.00 |
来源:表 6,p. 9。
32 bit 在 104K 出现明显退化;64 与 128 bit 的整体结果接近,而 64 bit 正好装进一个机器字。这个消融支持使用 64 bit 的工程取舍,并不意味着更长编码一定降低性能。表中 120K 的三种结果都在 84 左右,也说明增加编码长度不能消除底座和任务的所有误差。
4.11 消融三:PG19 单领域校准在该设置下足够
表 7 的 LongBench 平均分为:全注意力 30.57、混合领域 OPC 30.39、仅 PG19 的 OPC 30.43。PG19-only 的代码类为 67.06,混合校准为 66.66,完整基线为 67.77。该观察支持投影并不一定依赖内容领域的严格匹配,至少在这组覆盖问答、代码和合成任务的测试中如此。(表 7,p. 9)
这是一组独立消融,表题未明确标出模型,也与表 3 的完整基线数值略有差别,因此保留其自身比较口径,不将 30.43 拼接进主实验表格。
五:结论——贡献与实际取舍
BinaryPC 最值得借鉴的是把重构目标、低成本检索与误差保护连在一起。重构形式让压缩表示可以近似原始内积,也给出了可直接使用的误差信号;query/key 的非对称量化又把存储分配到数量差异最大的两端。它展示了一条无需反向传播即可适应激活分布的路径。
决定实际使用价值的条件有三项。第一,必须容纳完整 KV;这是访问加速方案。第二,上下文越长,低带宽扫描的收益越可能超过编码、top-k 和 gather 的成本,短上下文可以更慢。第三,质量取决于任务、预算与投影来源:在线短任务、聚合任务和部分复杂检索仍存在明显损失,EAS 与 OPC 需要作为完整设计的一部分理解。
从后续研究看,一个自然问题是:重构目标对所有 key 误差等权,能否更直接照顾 query 相关的排序间隔或注意力输出误差,同时保留无梯度构造的优点?另一个问题是生成很长时,静态投影和 prefill 阶段确定的误差保护集合如何随新 token 更新。它们是由本文机制引出的研究方向,不是本论文已经验证的成果。