同一字符串,换一种 token 切分后模型还认识吗?——多语言非规范分词鲁棒性精读
原题:Language Models are not Equally Robust to Non-Canonical Tokenization across Languages
作者:Poulami Ghosh、Preethi Jyothi,IIT Bombay。
版本:arXiv:2607.26831v1,2026-07-29 提交;获取与研读日期:2026-11-13。
材料:本地论文 PDF · 作者 TeX · 英文汇报 PDF · Beamer 源文件。下文使用从 1 开始的 PDF 页码,与原文印刷页码一致。
- 发表:未查到正式发表或明确录用信息(截至 2026-11-13);目前可核实的是上述 arXiv 预印本。
- 代码:未查到公开代码(截至 2026-11-13)。
论文总览
这篇论文把分词器视为模型输入接口中的一个潜在脆弱点:保持解码后的字符串完全相同,只改变送入模型的合法 token 序列,任务表现会不会改变? 研究对象是非规范分词(non-canonical tokenization),即不同于默认分词器输出、但仍能还原同一文本的词表内切分。这里既不修改文本含义,也不新增词表项。
作者在三个模型家族、总计 27 种主要研究语言和六项生成式下游评测上比较默认切分、随机合法切分和字符级切分。Table 1 的平均随机相对退化为 Llama 23.772%、Qwen 11.391%、Gemma 9.937%;字符级则为 40.960%、16.091%、20.928%。英语中较强的稳定性没有普遍扩展到其他语言,模型排名也随扰动类型而变。(Sec. 5.1,Table 1,PDF pp. 5–6。)
论文还把合法切分空间用于数据增强:只在英语 Multilingual-ARC 上做 LoRA 微调,以重复规范切分、随机多切分或按长度比分桶的多切分训练,再跨语言测试。最好的表内配置将规范/随机/字符级平均准确率从 78.3/71.8/66.0 提升到 81.8/74.8/69.2。不过,随机分词相对规范分词的平均退化并未低于未微调基线;更准确的结论是,增强提高了绝对表现,并比同倍数重复规范数据更好地保留鲁棒性。(Secs. 6–7,Table 3,PDF pp. 9–11。)
结构地图
| 原文章节 | 要回答的问题 | PDF 页码与证据 |
|---|---|---|
| 1 Introduction | 英语中的分词鲁棒性是否具有跨语言普遍性? | pp. 1–2;Fig. 1 |
| 2 Related Work | 与英语鲁棒性、分词边际化、随机分词训练有什么关系? | p. 3 |
| 3 Methodology | 如何定义同文不同切分,并在合法空间中采样? | pp. 3–4;Fig. 2 在 p. 5 |
| 4 Experimental Setup | 模型、语言、碎片率、任务与扰动范围 | pp. 4–5;Fig. 3 在 p. 7 |
| 5.1 Impact of non-canonical tokenization | 主评测退化与碎片率关联 | pp. 5–6;Table 1 |
| 5.2 Impact of granularity | 更细切分与更长序列各自意味着什么? | pp. 6–8;Fig. 4、Table 6 |
| 5.3 Impact of scale | 扩大模型能否改善鲁棒性? | pp. 8–9;Table 2 |
| 5.4 Cross-lingual experiments | 不生成答案时,句向量检索是否仍受影响? | pp. 8–9;Figs. 5–7 |
| 6 Non-Canonical Tokenization as a Source of Data Augmentation | 多切分训练如何构造? | pp. 9–10;Table 3 |
| 7 Analysis;8 Conclusion;Limitations | 如何解释训练增益,哪些因素尚未分离? | pp. 10–11 |
| Appendices A–D | 硬件、排除语言与微调配置 | pp. 13–15;Tables 4–10 |
| 附录结果图 | Qwen/Gemma 检索、MGSM 粒度曲线、语言级微调增益 | pp. 16–19;Figs. 6–9 |
一:动机——模型理解的是文本,还是熟悉的 token 接口?
1.1 文本相同,不代表模型内部计算相同
一个字符串可能既能表示成一个完整词 token,也能拆成若干子词、字符或词表允许的更小片段。这些序列解码后相同,却会改变 embedding 查表、序列位置、注意力计算和读入文本的局部组合方式。语言模型通常主要接触规范切分,因此其他合法切分形成一种输入分布变化。
此前英语研究观察到,现代指令模型对这种变化可以相当稳定。本文追问:这种稳定性是否也存在于词表覆盖、文字系统和语言资源条件不同的语言?英语结果不应自动代表多语言系统。本文的贡献是建立跨语言诊断,并测试一种训练缓解方案,而不是提出新的基础 tokenizer。(Secs. 1–2,pp. 1–3。)
1.2 这种扰动为什么有实际意义
词表裁剪、tokenizer 替换、跨语言词表适配,都可能让已有文本换一种 token 序列进入模型。研究这些变化有助于判断模型与原分词器的耦合程度。本文固定原词表、使用已有合法 token,因而能把“换切分”的影响与“新 token 的 embedding 尚未学好”区分开来。
二:方法——定义可控的合法扰动,再测行为变化
2.1 规范切分、合法空间与不变性
设 $\Sigma$ 为字符表,$V$ 为 tokenizer 词表。规范分词器是确定性映射:
解码函数 $\mathrm{decode}:V^*\to\Sigma^*$ 满足 $\mathrm{decode}(t_c)=x$。同一字符串的合法分词空间为:
所谓非规范切分,是 $t\in\mathcal T(x)$ 且 $t\ne t_c$。对输入 token 序列进行处理的模型 $f:V^*\to\mathbb R^d$,理想的分词不变性写作:
这里的 $f$ 可以表示 logits、隐藏表示或任务预测;论文没有把所有实验统一成某个固定向量距离,而是使用任务分数差、正确率和检索表现衡量敏感性。相同文本是实验约束,近似相同的模型行为是待检验性质。(Sec. 3,pp. 3–4。)
2.2 三种输入条件
| 条件 | 构造 | 作用 |
|---|---|---|
| Canonical | $t_c=T_{\rm canon}(x)$ | 模型熟悉的默认输入,作为参照 |
| Random non-canonical | 从合法空间采样其他切分 | 测试对一般合法表示变化的敏感性 |
| Character | 将文本切成字符级单位 | 测试更强的碎片化输入 |
实验对整个用户侧 prompt 重新切分,包括指令文本、题目和选择题选项;system prompt 和 special tokens 保持原样。输出仍由模型正常生成,本文没有把输出切分也固定成相同的非规范形式。随机评测使用五个采样种子取平均,因此这里的重复反映切分采样变化。(Sec. 4,pp. 4–5。)
字符级条件的形式化写成 $t_{\rm char}=(x_1,\ldots,x_{|x|})\in\mathcal T(x)$,这要求选用的字符单位能够用合法词表表示。对于 Unicode、字节回退和组合文字,实现必须明确“字符”的粒度以及解码一致性检查;本文没有充分展开这些细节。因此应把字符级看作作者实现中的最细切分条件,不直接推广成所有 tokenizer 都有“一个 Unicode 字符对应一个 token”。
2.3 MDD 如何避免枚举指数多个切分
作者使用多值决策图(Multi-valued Decision Diagram,MDD)表示合法空间。节点对应字符串位置;边对应词表中能匹配的片段;从起点到终点的一条路径就是一种合法切分。Fig. 2 给出英语、俄语、泰语、印地语中“time”对应文本的图,说明不同文字和词表会产生不同形状的切分空间。(Sec. 3,p. 4;Fig. 2,p. 5。)
关键是均匀采样路径,不是均匀选每条出边。以下是对原文“按子图中的切分数加权”的教学展开。采用半开区间边 $i\to j$,令 $C(i)$ 为从位置 $i$ 到终点的路径数,终点 $m=|x|$:
一路相乘后,中间路径计数相消,每个完整切分都得到 $1/C(0)$ 的概率。使用动态规划即可计算计数,无须把全部切分真正列出来。
教学例子:设字符串为 abc,词表允许 a,b,c,ab,bc,abc。四条合法路径为 [abc]、[ab,c]、[a,bc]、[a,b,c]。起点选择 a 的后续有两条路径,选择 ab 或 abc 各一条,所以出边概率应为 $1/2,1/4,1/4$。如果三条出边各用 $1/3$,四条完整路径便不均匀。
原文先定义非规范切分必须排除 $t_c$,采样公式随后却写成 $t_n\sim\mathcal U(\mathcal T(x))$。严格的非规范评测应明确是否条件于 $t\ne t_c$,或采样后拒绝规范路径。切分空间非常大时区别可能很小,但只有少数合法切分的语言中这个接口会影响扰动强度。
2.4 碎片率与长度比承担不同角色
作者定义碎片率(fragmentation rate,FR)为平均每词的 token 数:
同一语言、同一文本的两种切分保持 word 数不变,所以 FR 的比值等于 token 序列长度之比。长度比(length ratio,LR)用于控制某一次扰动有多细:
FR 描述一个 tokenizer 对文本本身的碎片化程度,LR 描述相对规范输入的变化幅度。跨文字系统比较 FR 时,word 的划分会影响解释,不能把它直接当作语言资源量的替代指标。规范切分一般较短,但不保证是所有合法切分中最短的;原文脚注明确认可能存在更短的合法序列。(Sec. 4,pp. 4–5。)
2.5 平均相对退化与百分点不能混用
对语言 $\ell$ 的规范分数 $a_{c,\ell}$ 和扰动分数 $a_{r,\ell}$,相对下降的教学写法为:
Tables 1、3 报告跨语言平均相对下降;Table 1 最后一行又对六个任务取平均。相对降幅越小越稳健,负值意味着扰动条件分数反而提高,但要结合输出是否符合评测格式解释。
其中 $L$ 为汇总的语言数,两种聚合一般并不相等。因此不能直接用 Table 3 舍入后的平均准确率反算所有 $\Delta$ 列。例如基线 78.3 和 71.8 的总体比值下降约 8.30%,而表内平均相对下降为 8.542%。表内随机绝对分数未在 Table 1 单独给出,也不应把六任务平均 canonical 分数乘以 $1-\bar\Delta/100$ 当成精确重建值。
三:实验——哪些比较真正可解释
3.1 模型、任务与语言范围
主模型为 Llama-3.1-8B-Instruct、Qwen3-8B、gemma-3-12b-it,另用 Qwen3-4B/14B 测规模效应。采用扩展的 lm-evaluation-harness,直接生成答案;选择题通过 system prompt 要求只输出选项字母,而非对选项做条件似然打分。(Sec. 4,pp. 4–5;Table 8,p. 15。)
| 任务 | 检验内容 | 答案形式 | Table 8 所列样本数 |
|---|---|---|---|
| MGSM | 多语言数学问题求解 | 短答案 | 250 |
| MLQA | 根据给定上下文抽取答案 | 短答案 | 1000 |
| Multi-ARC | 科学知识与推理 | 选择题字母 | 1000 |
| Multi-HellaSwag | 常识情境续接 | 选择题字母 | 1000 |
| Global-MMLU-Lite | 跨学科知识与理解 | 选择题字母 | 400 |
| Belebele | 多语言阅读理解 | 选择题字母 | 900 |
表内主结果是各任务的生成式评测分数,分数越高越好;Table 3 明确为 accuracy(%)。对于 MLQA,原文没有清楚说明采用 exact match 还是 F1,解释主表时保留“任务分数”而不擅自确定统计定义。
Table 9 的 27 种语言为:阿拉伯语、加泰罗尼亚语、丹麦语、德语、英语、巴斯克语、法语、印地语、克罗地亚语、匈牙利语、印尼语、意大利语、日语、韩语、荷兰语、葡萄牙语、罗马尼亚语、俄语、斯洛伐克语、西班牙语、塞尔维亚语、瑞典语、斯瓦希里语、泰语、乌克兰语、越南语、简体中文。论文没有逐任务完整列出这些语言的覆盖矩阵,不应把“27 语言、6 任务”理解为每个模型都报告了完整的 $27\times6$ 独立结果。
语言筛选同时考虑模型支持和能否形成有意义的非规范扰动;作者用 Qwen 的语言集合代理 Gemma 的支持范围。部分语言在 Qwen 下规范切分已接近字符级,被排除在主分析外并在附录单独研究。这使主结果描述的是所选语言集合,不代表所有低资源语言。(Sec. 4;App. C;Table 9,pp. 5、13–15。)
3.2 三类参照分别控制什么
规范输入是推理扰动的基准;接近规范长度的非规范输入控制“变长”因素;训练中的 Canonical($N\times$) 则控制重复数据和增加训练曝光带来的收益。三者分别回答:换切分会不会退化、是否仅由长度造成、增强是否优于简单多训练。
检索实验进一步去掉生成答案与答案解析的影响:FLORES-200 中给定源语言句子,以目标语言候选的余弦相似度排序,统计正确译文排第一的比例。正文称句向量取最后一个 token 的隐藏状态,图中还扫描不同层的同类表示;它并非专门训练的双塔检索器。(Sec. 5.4,pp. 8–9。)
四:结果——从主退化到机制探针,再到缓解训练
4.1 主结果:模型“更稳健”的排名依赖扰动方式
| 模型 | Canonical 六任务平均分 ↑ | Rand 平均相对下降 ↓ | Char 平均相对下降 ↓ |
|---|---|---|---|
| Llama-3.1-8B-Instruct | 63.918 | 23.772% | 40.960% |
| Qwen3-8B | 64.748 | 11.391% | 16.091% |
| gemma-3-12b-it | 74.375 | 9.937% | 20.928% |
Gemma 的规范分数最高,随机扰动平均下降也最小;Qwen 在字符级条件下最稳健。正文把 Qwen 笼统称为最稳健,需要加上扰动条件,不能忽略 Gemma 的随机降幅更低。Llama 在两种扰动下都最敏感。这里比较的是原表报告的汇总值;文中没有逐任务、逐模型明确列出共同语言面板,不能进一步把这些排名解释为严格等语言覆盖下的模型能力排序。(Sec. 5.1,Table 1,pp. 5–6。)
为保留任务差异,下表列出三种模型各任务的 Rand/Char 相对下降(%):
| 任务 | Llama | Qwen | Gemma |
|---|---|---|---|
| MGSM | 27.522 / 48.661 | 19.948 / 21.856 | 7.890 / 17.609 |
| MLQA | 24.446 / 41.424 | 12.002 / 13.580 | 14.708 / 15.675 |
| Global-MMLU-Lite | 20.371 / 35.046 | 8.957 / 13.721 | 9.766 / 18.702 |
| Multi-ARC | 24.320 / 41.232 | 8.542 / 15.963 | 9.865 / 26.726 |
| Multi-HellaSwag | 25.754 / 43.810 | 12.202 / 21.071 | 10.012 / 27.258 |
| Belebele | 20.221 / 35.586 | 6.692 / 10.353 | 7.382 / 19.597 |
每一行每个模型的 Char 退化都高于 Rand,但“短答案一定比选择题脆弱”并不逐项成立。例如 Gemma 的 MGSM Rand 下降 7.890%,低于其多个选择题任务;Llama 的 HellaSwag Rand 下降又高于 MLQA。更可靠的判断是:敏感性由模型、任务和扰动粒度共同决定,平均表现无法替代逐项结果。
4.2 碎片率关联:控制题目本来会不会做之后仍有负相关
作者对 Multilingual-ARC 的样例拟合逻辑回归。其教学表达为:
$Y_c$、$Y_r$ 分别表示规范/非规范输入下是否答对,$\mathrm{FR}_c$ 为规范输入碎片率。Table 10 的系数为:
| 语言 | 规范答对系数 $\beta_c$ | 规范 FR 系数 $\beta_f$ |
|---|---|---|
| 英语 | 3.416 | −1.114 |
| 巴斯克语 | 2.211 | −0.138 |
| 意大利语 | 2.692 | −0.146 |
| 中文 | 4.718 | −0.967 |
正文对英语给出 $\beta_c\approx3.42$、$p<0.001$;FR 系数约 −1.11、$p=0.021$。这支持“同样考虑规范条件正确性后,较高 FR 的样例更易在非规范条件失败”。其他语言的表格没有给出显著性值,不应把四个负系数一律称为显著关系。FR 与资源量、词表覆盖、题目长度等因素也可能共同变化,该分析没有把它们的独立因果贡献分离出来。(Sec. 5.1,p. 6;Table 10,p. 15。)
4.3 粒度与长度控制:序列变长不是唯一解释
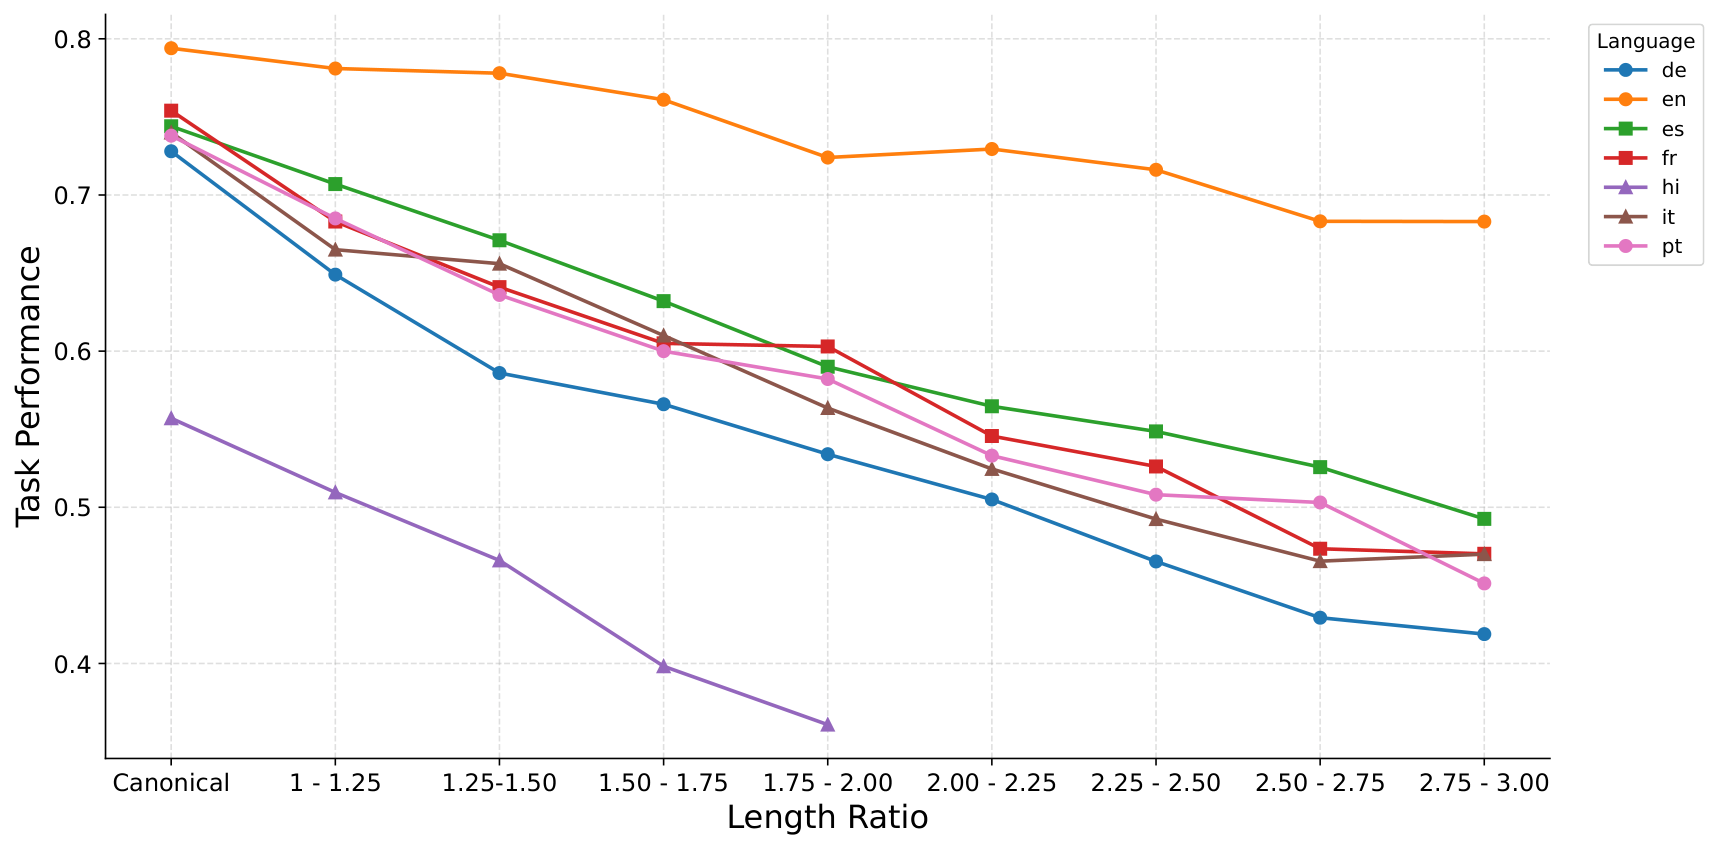
原图 Fig. 4(a),PDF p. 7。横轴为 sampled/canonical token 长度比分桶,纵轴为任务表现;各色线条表示语言,Canonical 是单独的参照点。
Llama 中英语曲线相对稳定,德、法、葡等语言随长度比增加下降明显。Qwen 的许多语言曲线较平滑,英语、法语、俄语等较稳;Gemma 的规范表现较强,但荷兰语、瑞典语、克罗地亚语、巴斯克语等在高粒度区间有较大退化。不能把英文曲线的稳定性外推到同一模型的所有语言。(Sec. 5.2,pp. 6–8;Fig. 4,p. 7。)
附录 Fig. 8 把同样的粒度分析扩展到 MGSM:英语仍较稳,而部分语言如泰语、斯瓦希里语出现明显退化。曲线未延伸到的 bucket 不能当成零分;它可能不是该语言/样例集合可采到的有效范围。(p. 18。)
为了区分“切分变了”与“序列更长”,Table 6 只使用长度比 0.95–1.00、1.00–1.05 的替代切分:
| 语言 | Canonical | LR 0.95–1.00 | LR 1.00–1.05 |
|---|---|---|---|
| 阿拉伯语 | 78.30 | 74.73 | 73.00 |
| 英语 | 88.00 | — | 87.90 |
| 巴斯克语 | 45.60 | 40.75 | 41.10 |
| 印地语 | 66.90 | — | 62.51 |
| 匈牙利语 | 78.90 | 73.33 | 71.10 |
| 法语 | 80.90 | — | 81.30 |
| 中文 | 86.90 | 87.38 | 86.69 |
阿拉伯语在 +5% 内的长度变化下仍低 5.30 个百分点,匈牙利语低 7.80 个百分点,说明仅用序列变长不能解释这些退化;英语和中文则几乎不变,法语在该 bucket 还有小幅提高。Table 6 没有明确标注对应模型,而且出现了不在 Table 9 主语言清单中的尼泊尔语,适合用作长度控制证据,不宜擅自贴上某个模型的确定标签或视作全部语言统一下降。(Sec. 5.2;Table 6,pp. 8、14。)
4.4 规模:部分鲁棒性改善,4B 的格式失败必须单独看
| 任务 | Qwen3-4B:Canon / Rand Δ% | Qwen3-8B:Canon / Rand Δ% | Qwen3-14B:Canon / Rand Δ% |
|---|---|---|---|
| MGSM | 44.267 / 21.085 | 45.911 / 19.948 | 45.289 / 16.208 |
| MLQA | 47.564 / 14.648 | 58.050 / 12.002 | 65.329 / 10.841 |
| Global-MMLU-Lite | 25.933 / −26.882 | 59.883 / 8.957 | 58.050 / 7.518 |
| Multi-ARC | 38.255 / −27.978 | 78.275 / 8.542 | 78.400 / 7.169 |
MLQA 的规范分数随规模提高,随机退化从 14.648% 降至 10.841%;MGSM 规范分数保持在 44–46 左右,但随机退化减少。这支持规模可以改善某些任务上的鲁棒性,而不只是提高原始分数。
Qwen3-4B 的两项选择题负 $\Delta$ 不能简单解释为“非规范切分帮助推理”:作者明确报告该模型未遵循只输出选项的 system instruction,因此受答案格式失败干扰。8B 与 14B 在这些任务上的比较更可解释;14B 的 MMLU 规范分数还略低于 8B,规模收益并非所有任务和指标单调。(Sec. 5.3,Table 2,pp. 8–9。)
4.5 句向量检索:切分差异进入了表示层
设源句与候选目标句表示为 $\mathbf x,\mathbf y$,以
排序并计算 top-1 retrieval accuracy。源侧和目标侧均按相应条件切分;图文件对应 normal/normal、random/random、char/char。
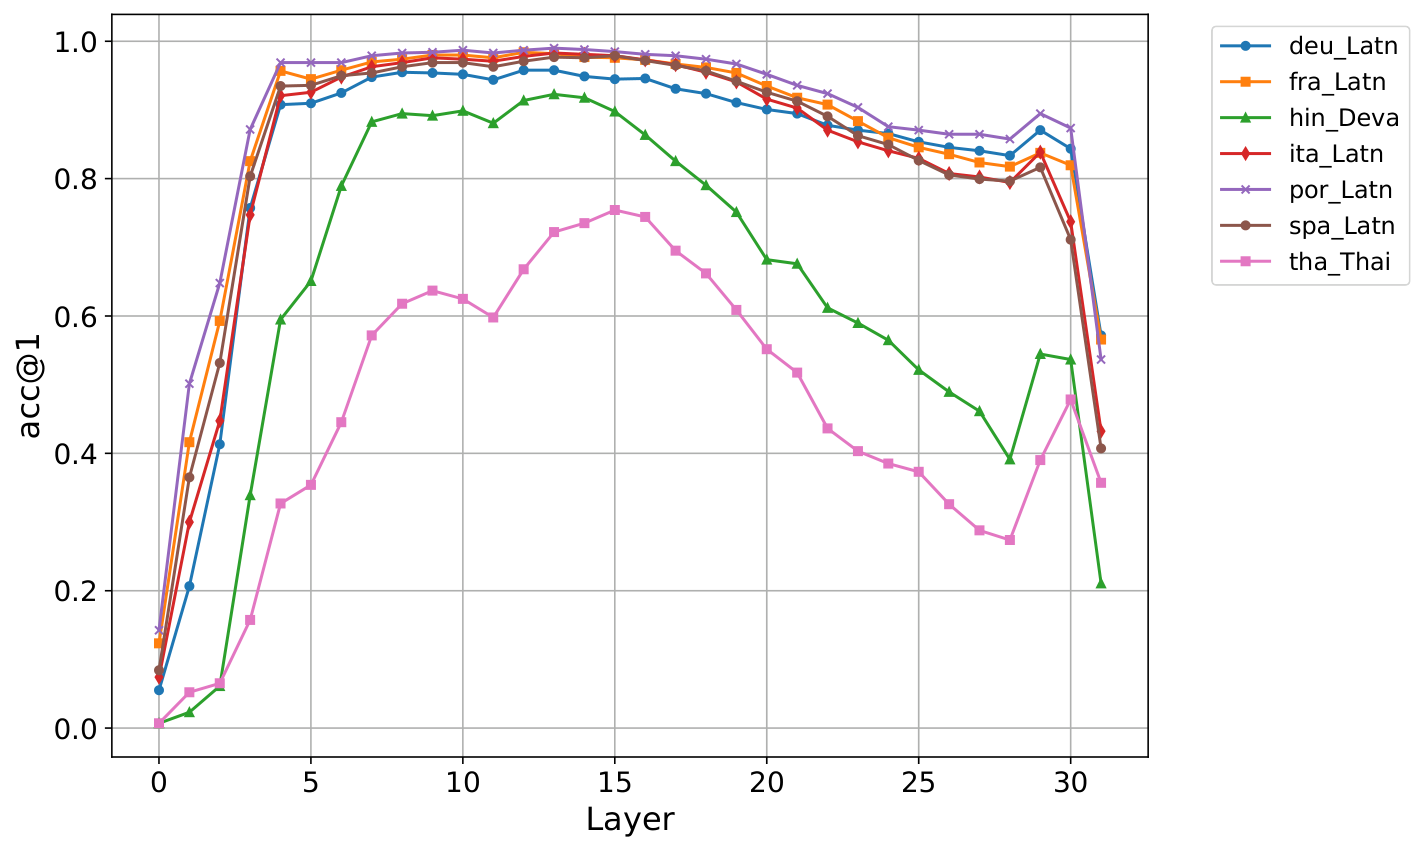
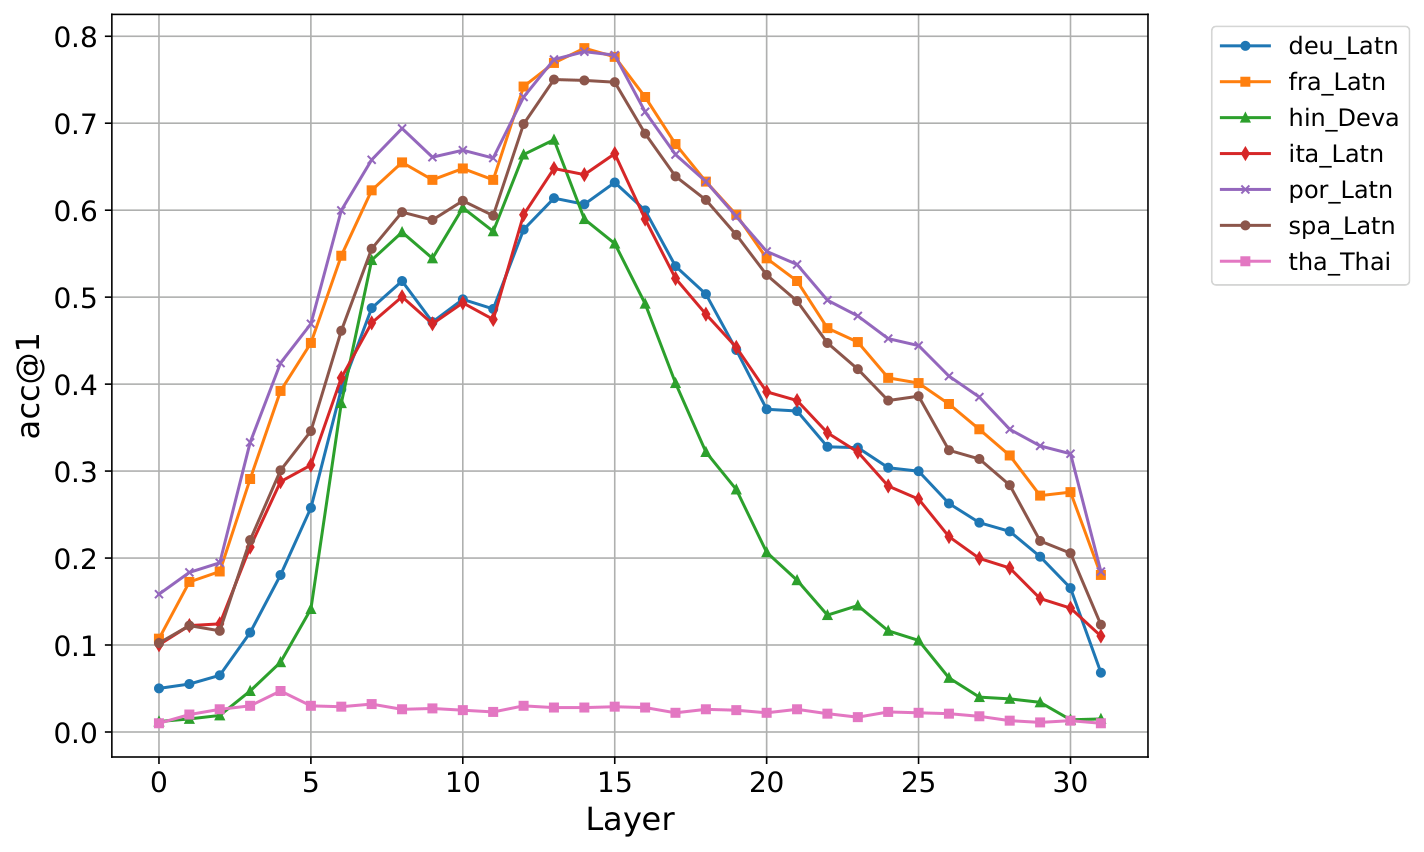
原图 Fig. 5(a)、5(c),PDF p. 8。横轴是 Transformer 层,纵轴为 acc@1;图例是各语言曲线。两个面板的纵轴上限分别为 1.0 和 0.8,比较时应读数值。
Llama 的规范切分在中间层出现较高检索表现,随机和字符级输入使峰值、层间变化和后层表现都改变。字符级条件下泰语曲线尤低。Qwen 的附录 Fig. 6 中仍有多条语言曲线在非规范条件保持较高表现;Gemma 的 Fig. 7 整体更弱、扰动后降低更多。Gemma 在生成式基准中的领先没有自动转化为这个句向量探针的领先。(Sec. 5.4,pp. 8–9;Figs. 6–7,pp. 16–17。)
这些结果把敏感性延伸到表示质量,避免将所有退化归因于生成答案格式。但正文“最后一个 token 的最终隐藏状态”与图中扫描所有层的展示需要区分;源/目标语言配对方向、候选集合大小等也未充分列出。因此这里保留曲线支持的比较,不把某个单点当成已完整定义的统一检索基准成绩。
4.6 被排除语言:低退化有时意味着扰动空间本来就小
Fig. 3 中,Qwen 的孟加拉语 FR 为 6.66→6.68(规范→字符级),古吉拉特语为 9.29→9.29,泰卢固语为 13.55→13.55。相比之下,英语为 1.35→5.16。前几种语言的规范切分本来就非常碎,字符级输入几乎没有进一步改变接口。(Fig. 3(b),p. 7。)
| 语言 | Qwen:Canon / Rand / Char | Gemma:Canon / Rand / Char |
|---|---|---|
| 孟加拉语 bn | 57.70 / 52.64 / 53.00 | 65.61 / 53.80 / 46.96 |
| 古吉拉特语 gu | 54.30 / 52.64 / 52.80 | 60.78 / 56.62 / 50.34 |
| 马拉雅拉姆语 ml | 38.80 / 33.14 / 34.00 | 46.23 / 40.12 / 35.46 |
| 泰卢固语 te | 42.70 / 41.00 / 42.00 | 44.82 / 40.32 / 35.96 |
Table 5 还估计合法分词空间规模,其列为 $\log_{10}$ 切分数:孟加拉语 Qwen 为 3.53、Gemma 为 64.45;古吉拉特语分别为 1.12、59.73。它们不是原始切分条数。原文未明确先取对数再平均,还是先平均再取对数,因此这里不反推精确的平均切分条数。亚美尼亚语的许多句子在 Qwen 下只有一种合法切分,所以没有列入这些表。
这组结果解释了一个重要测量问题:输入变化的幅度不匹配时,较小的性能差距不等于更强的抽象组合能力。 主分析排除若干语言改善可比性,同时也缩小了结论覆盖范围。附录表只展示七种排除语言,而正文讨论的排除清单更长,不宜当成完整清单的所有定量结果。(App. C,Tables 4–5,pp. 13–14。)
4.7 多分词训练:在英语上增加表示多样性
训练只使用英语 Multilingual-ARC:原始 1116 个训练样例、298 个验证样例。统一验证集将每个验证样例表示为 Canonical、Random、Character 三种形式,共 894 条,用于所有方案的模型选择。(Sec. 6.2,p. 10。)
| 方案 | 一个原始样例如何展开 | 控制目的 |
|---|---|---|
| Canonical / Non-Canonical / Character,1× | 只保留对应形式的一份 | 单纯替换一次切分是否够用 |
| Canonical,$N\times$ | 同一规范形式重复 $N$ 份 | 控制重复曝光与更多训练 |
| Mixed,$N\times$ | 每十份含 1 规范、1 字符级、8 随机合法切分 | 加入不固定粒度的多样性 |
| LR-Bucketed,$N\times$ | 每十份含 1 规范、1 字符级、8 个不同 LR 桶各一份 | 系统覆盖不同粒度 |
$N\in\{10,20,30\}$,八个 LR 桶从 $[1.00,1.25)$ 到 $[2.75,3.00]$,步长为 0.25。更大的 $N$ 重复十份的构成模式。与纯随机采样相比,分桶使每组训练数据都有从接近规范到约三倍长度的切分,不让样本集中于某一种常见粒度。(Sec. 6.1,pp. 9–10。)
LoRA 配置为 rank 16、alpha 32、dropout 0.1,作用于 $q_{\rm proj},k_{\rm proj},v_{\rm proj}$;最大长度 2048,学习率 $2.5\times10^{-6}$,5 epochs,单设备 batch 4、梯度累积 16,每 25 steps 评估。硬件为 48GB RTX 6000 Ada。(Tables 7 与 App. A,pp. 13–14。)
Table 3 未在标题中明确指定被微调模型;其基线分数和 $\Delta$ 与主表 Qwen3-8B 的 ARC 对应,因而可推测是该模型,但这是从数值对应作出的判断。不同 $N$ 在相同 epoch 数下还改变总更新量;同一 $N$ 下,不同切分长度也改变处理 token 数,因此“相同份数”不等于严格相同计算预算。
4.8 数据增强结果:绝对表现提高,相对鲁棒性只部分改善
| 训练方案 | Canon accuracy ↑ | Rand accuracy ↑ | Char accuracy ↑ |
|---|---|---|---|
| 未微调 | 78.3 | 71.8 | 66.0 |
| Canonical 1× | 79.2 | 72.3 | 66.3 |
| Non-Canonical 1× | 78.8 | 72.1 | 66.3 |
| Character 1× | 78.8 | 72.0 | 66.2 |
| Canonical 10× | 81.1 | 73.6 | 67.7 |
| Mixed 10× | 81.1 | 73.7 | 67.9 |
| LR-Bucketed 10× | 81.1 | 73.8 | 68.0 |
| Canonical 20× | 81.2 | 73.7 | 67.9 |
| Mixed 20× | 81.5 | 74.6 | 68.7 |
| LR-Bucketed 20× | 81.6 | 74.6 | 68.9 |
| Canonical 30× | 81.2 | 73.7 | 67.9 |
| Mixed 30× | 81.2 | 74.0 | 68.2 |
| LR-Bucketed 30× | 81.8 | 74.8 | 69.2 |
三个 1× 方案差别很小,说明只换一次输入切分不够。Canonical 从 1× 到 10× 已提高 1.9/1.3/1.4 个百分点,说明重复曝光和增加训练本身贡献明显;原文 Sec. 7 将这组比较解释成“多个合法切分更有效”,但 Canonical 10× 实际只重复同一规范切分,这个比较不能单独证明多样性收益。
同倍数比较更有说明力:30× 下 LR-Bucketed 相比 Canonical 提高 0.6/1.1/1.3 个百分点;相比 Mixed 又提高 0.6/0.8/1.0 个百分点。Mixed 从 20× 到 30× 反而下降,而 LR-Bucketed 仍略升,支持系统覆盖粒度比无约束随机堆更多份数更有效。(Table 3,p. 10。)
| 方案 | Rand 平均相对下降 ↓ | Char 平均相对下降 ↓ |
|---|---|---|
| 未微调 | 8.542% | 15.963% |
| Canonical 30× | 9.405% | 16.490% |
| Mixed 30× | 8.987% | 16.141% |
| LR-Bucketed 30× | 8.637% | 15.548% |
从未微调到 LR-Bucketed 30×,三种输入条件的准确率都上升 3.0–3.5 个百分点,但 Rand 平均相对下降由 8.542% 到 8.637%,没有缩小;Char 则改善 0.415 个相对降幅百分点。相比同倍数 Canonical,分桶增强在 Rand、Char 的相对差距上都更好。因此“缓解敏感性”应理解为:提高非规范输入下的实用表现,并相对纯规范微调更好地保留稳健性,而不是已经消除规范与非规范的性能差距。
Fig. 9 的热图将语言放在纵轴、训练方案放在横轴,颜色表示相对未微调基线的绝对增益;红色为正、蓝色为负。多份训练普遍更暖,但部分 1× 方案在丹麦语、荷兰语、越南语等的随机条件下为蓝色。因此英语训练有跨语言迁移的平均收益,不应按正文的强措辞写成“每种方案在每种语言、每种条件上都提高”。(Sec. 7,pp. 10–11;Fig. 9,p. 19。)
五:结论——诊断接口耦合,训练时覆盖合法表示
最有说服力的主线是:相同字符串的合法 token 表示变化,足以引起明显的多语言性能差异;接近等长度的扰动和句向量检索又说明,这种变化既不只是长度开销,也不只是生成答案格式。英语中的稳定表现不能作为其他语言的默认假设。
方法上的启发是,把分词空间当作可控的增强空间:原始样例不必改写内容,就能提供多种合法输入表示。分桶采样进一步把“多样性”落实为对切分粒度的覆盖;其增益应通过同份数重复规范数据和匹配计算量的实验来判断。
当前证据的具体范围也很明确:增强实验只在英语 ARC 训练、跨语言 ARC 测试,尚未展示对其余五项任务的迁移;词表分配、训练资源、文字系统等因素仍未被独立操纵。与此同时,MDD 的规范路径处理、字符单位、各任务语言覆盖、长度控制表的模型身份和训练模型标注还需要更清晰的实现说明。这些细节会影响扰动究竟有多强,以及“更稳健”的比较是否具有相同口径。