Metis: Memory Foundation Model:中文研读笔记
作者:Zeyu Zhang、Ziliang Guo、Yihang Sun、Xichong Zhang、Xixuan Hao、Zehao Lin、Yang Zhang、Xiaoyan Zhao、Tong Shen、Bo Tang、Zhi-Qin John Xu、Junchi Yan、Haofen Wang、Xu Chen、Feiyu Xiong、Zhiyu Li、Tat-Seng Chua。机构包括 MemTensor、中国人民大学、新加坡国立大学、上海交通大学、同济大学。
版本:arXiv:2607.26760v2,2026-08-04 修订;获取与研读日期:2026-10-09。下文页码均为从 1 开始的 PDF 页码,与本版本印刷页码一致。
arXiv 原文 · 本地论文 PDF · 英文汇报 PDF · 可编辑 Beamer 源码。论文给出的项目入口:Metis、模型集合。
论文总览
Metis 研究的问题是:能否让语言模型在不回放历史文本、也不在线反向传播的情况下,跨多轮交互记住、修改、遗忘和组合用户提供的信息? 作者把这个目标称为记忆基础模型(Memory Foundation Model),其核心是同时学习持久化的原生记忆状态(native memory state)和操作这个状态的原生记忆过程(native memory procedure)。
实现上,Metis 在冻结的语言模型中加入记忆分支:把每轮隐藏表示筛选、投影并写入固定大小的矩阵,之后用独立的记忆 query 读取,并与当前轮的原始注意力输出融合。离线中期训练学习“怎样读写”,在线阶段只更新用户状态。其意义是把跨轮次信息管理变成可训练的前向计算。
实验支持这一方向,但也清楚显示当前能力的边界。Metis-27B 在不回放上下文的条件下,MemOps (Gold) 得分为 24.76,LoCoMo (Gold) 为 26.74,均高于所比较的无上下文基线;相同规模的完整上下文模型分别达到 87.90 和 65.03。因此最值得关注的是紧凑状态带来的新能力及其效率—质量取舍。长轨迹容量、外部基准上的遗忘、激活记忆后的指令遵循,仍是明显短板。(§6.2,表 5–6,PDF pp. 19–20)
结构地图
| 原文章节 | 论证中的作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 外部记忆的问题与研究目标 | pp. 1–3,图 1 |
| 2 Memory Foundation Model | 定义原生状态、原生过程,与 TTT/MANN 的定位比较 | pp. 3–6,§2.1–2.5 |
| 3 Metis Architecture | 状态、选择、写入、读取、虚拟前缀解释、误差与效率 | pp. 6–13,图 2,式 (1)–(11) |
| 4 Data Construction | 四类基本记忆操作及复杂场景辅助数据 | pp. 13–16,表 1–4 |
| 5 Model Optimization | 重建、操作、正则化三种训练目标与采样课程 | pp. 16–18,式 (12)–(17) |
| 6.1–6.3 Experimental Settings / Overall Performance / Ablation Studies | 评测协议、主结果、结构和数据消融 | pp. 18–22,表 5–7 |
| 6.4–6.5 Out-of-Distribution Memory Tasks / Source-Exclusion Study | 新基准迁移及训练来源敏感性 | pp. 21–23,表 8–9 |
| 6.6–6.9 Memory Capacity / General Capability / Low-rank Decomposition / Case Studies | 容量、干扰、存储压缩和行为案例 | pp. 23–26,图 3–5,表 10–11 |
| 7 Related Work / 8 Conclusion | 与快权重、递归状态、记忆网络的关系及结论 | pp. 27–28 |
| A Roadmap for Memory Foundation Models | 五级能力路线图,属于展望 | pp. 33–34,图 6 |
| B Extensive Experiment Results | MemOps (Full) 的更完整历史设置 | pp. 34–35,表 12 |
| C Further Analysis of Update Designs | LU/GDU 跨规模比较及 LU 下重复消融 | pp. 35–36,表 13–14 |
| D Transfer Across Backbone Families and Scales | Llama/Gemma 骨干迁移 | pp. 36–37,表 15 |
| E Evaluation Implementation Details / F Prompts | 基线实现、写入与查询提示、裁判与通用能力协议 | pp. 37–40 |
| G Efficiency | 冷启动延迟、长历史扫描、会话存储、多用户服务 | pp. 40–46,表 16,图 7–11 |
一:动机——记忆是对未来用途的预测
1.1 信息出现的时刻与使用的时刻不同
用户今天提供一项偏好,模型可能在数轮之后才需要它。写入时不知道未来具体会问什么,查询时又不一定能重新访问原始材料。作者因此把记忆理解为预测问题:根据当前信息的内容和操作意图,预测哪些表示有助于未来回答。(§1–2,PDF pp. 1–6)
常见外部记忆将历史存为文本,经过检索、重排和拼接后送入模型。这种机制便于查看和跨模型使用,但检索目标与最终回答目标未必一致;离散流程也使直接通过回答损失优化整个读写过程更困难。Metis 尝试把“存什么、怎样用”放进模型计算中,以监督数据共同学习。
这里的“原生”是作者对架构和训练方式的定义。快权重、可微记忆网络和递归状态早已存在;Metis 的具体贡献是把这些思路组织成跨交互持久状态 + 指令驱动的记忆操作 + 记忆专用中期训练,并在现有骨干上验证这一组合。(§2.4、§7,PDF pp. 5–6、27)
1.2 动态状态与训练权重必须分开理解
传统无记忆模型每轮按固定参数 $\theta$ 生成;外部记忆模型额外输入历史文本 $C_t$;Metis 用随交互变化的 $\theta_t$ 表示“静态参数与当前状态的组合”:
其中 $X_t$ 是本轮输入,$Y_t$ 是本轮输出,$\Phi$ 是在线冻结的骨干及记忆读写参数,$\mathbf M_t,\mathbf S_t$ 是跨轮次保存的状态。上式右侧是将作者的动态参数记法展开后的教学表示。
参数化记忆不意味着在线训练骨干。 离线阶段用梯度学习读写函数;在线阶段通过前向计算改变状态。部署时不同用户可以共享 $\Phi$,各自保存一份状态。当前轮内部仍保留原骨干的注意力机制,Metis 增加的是过去交互对当前轮的影响。(§2.1–2.4、§3.2–3.3,PDF pp. 3–9)
二:方法——先选信息,再写入矩阵,再按问题读取
2.1 整体数据流与符号
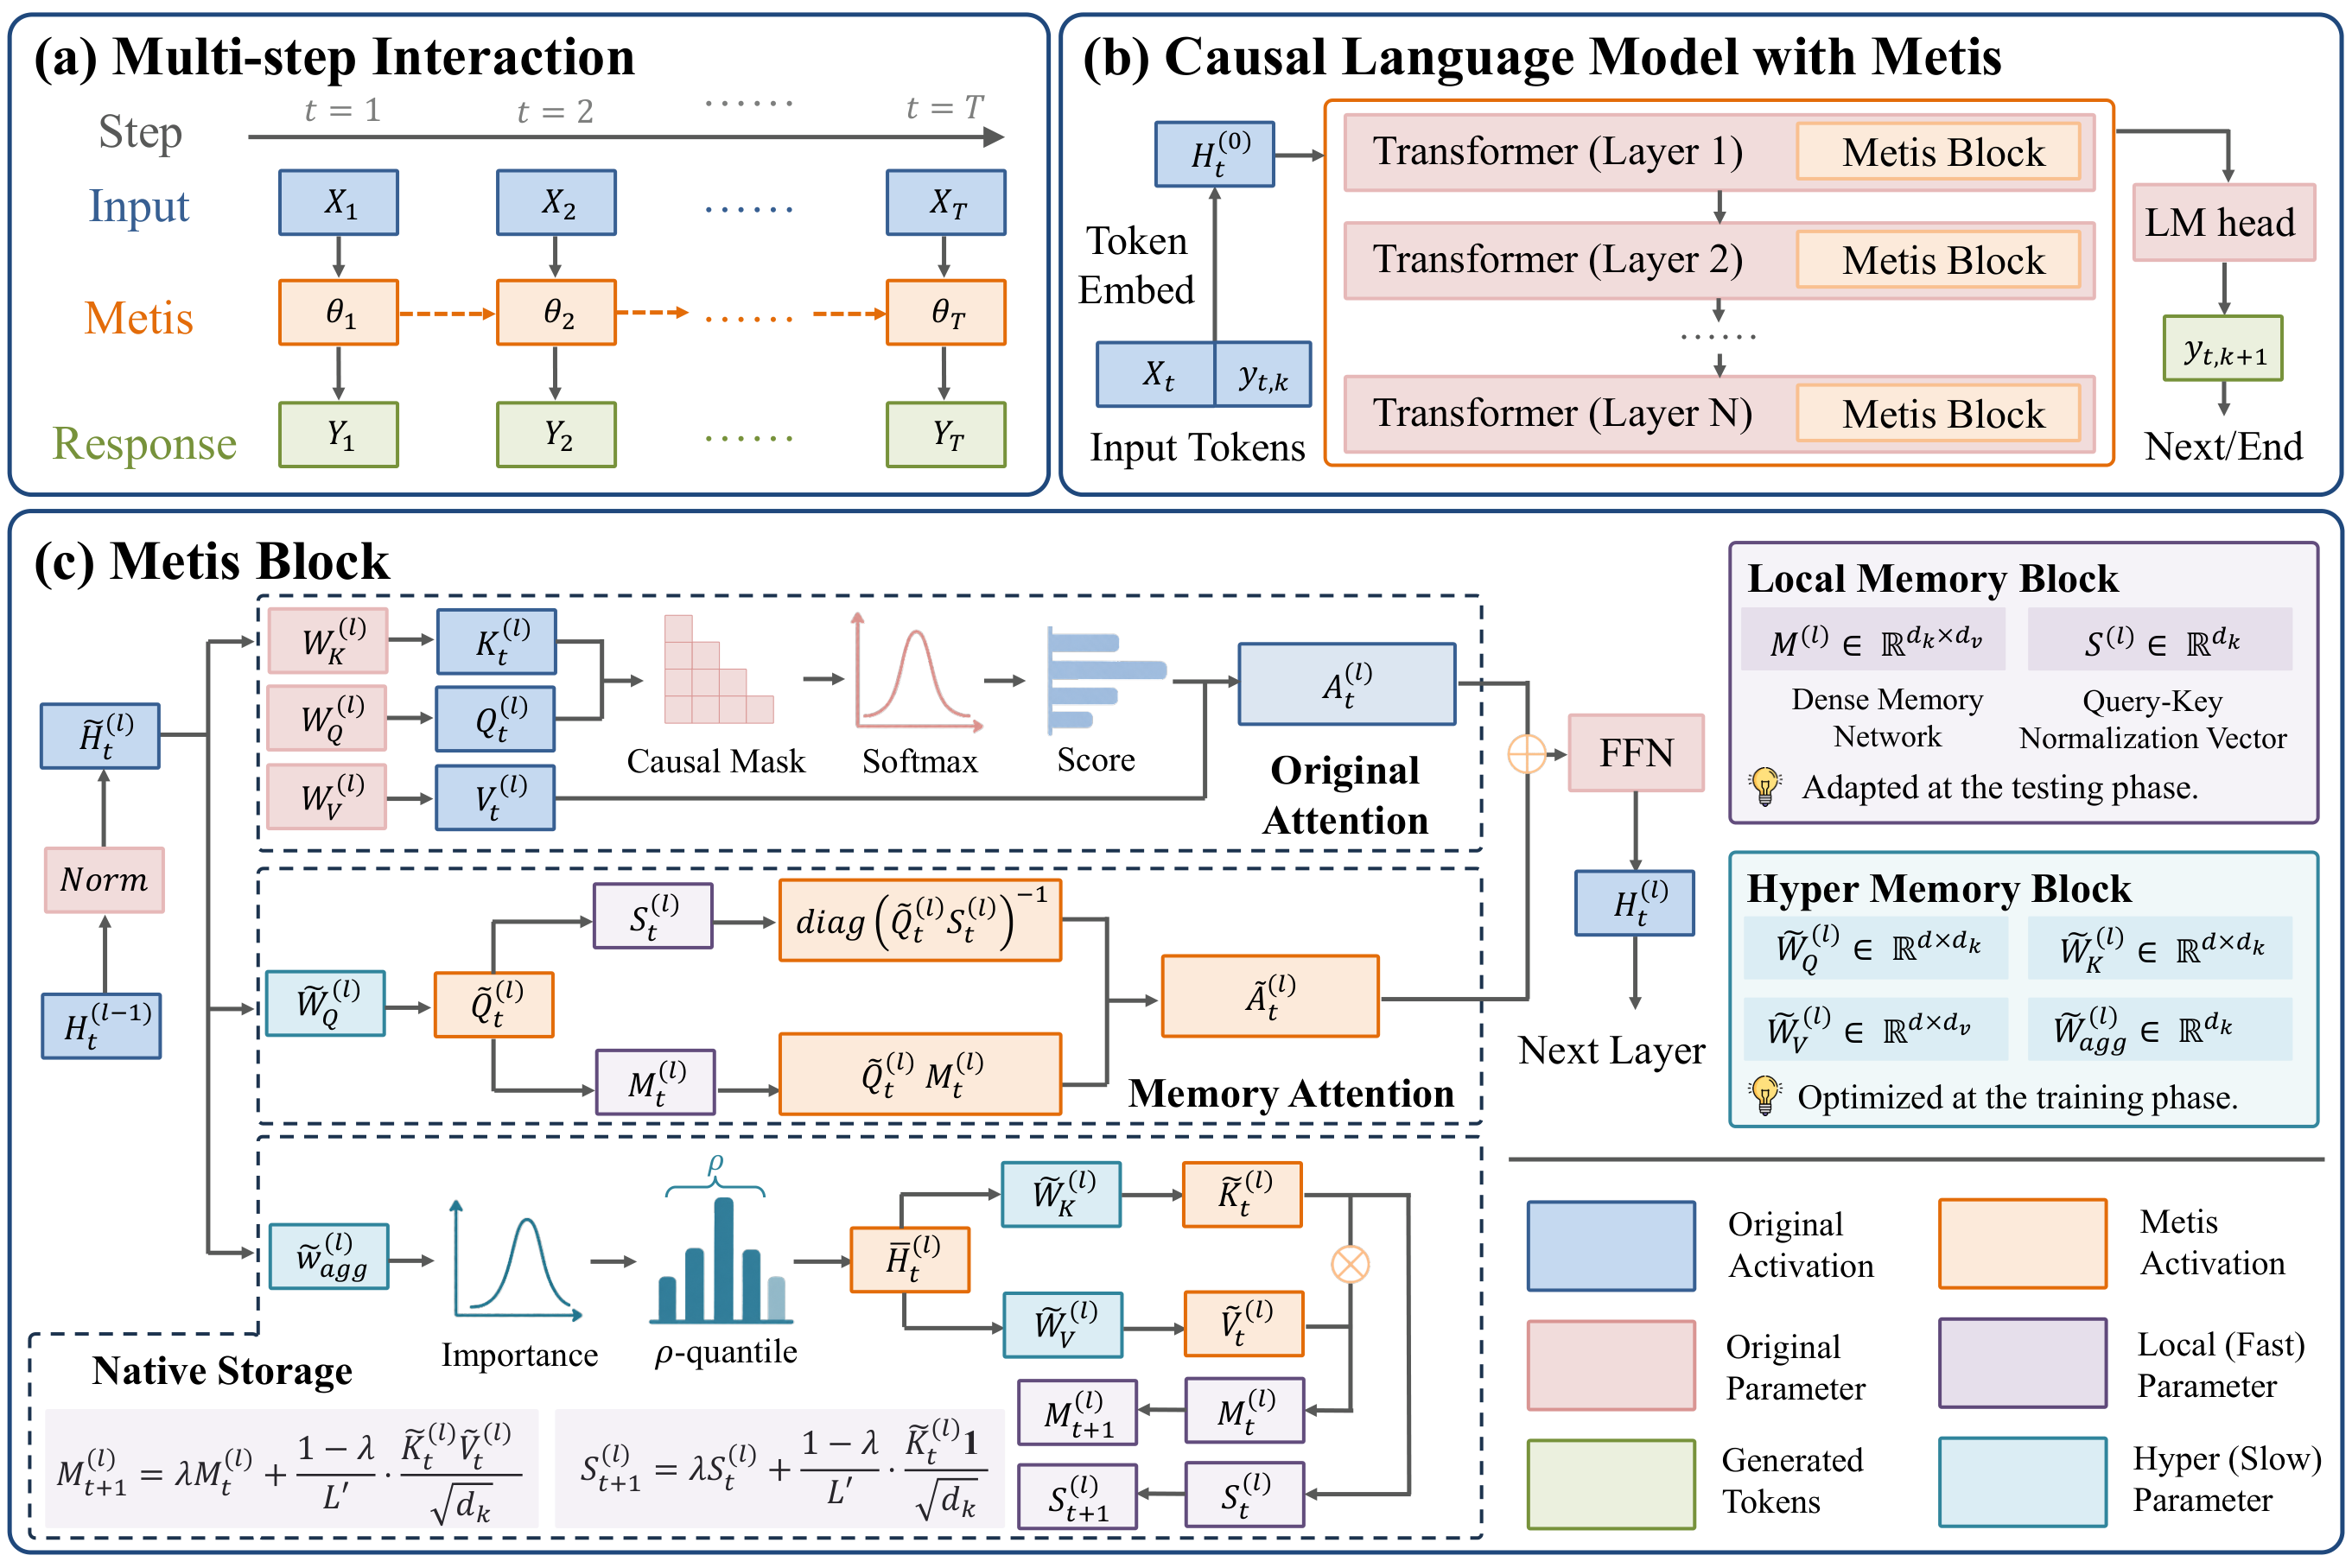
原文图 2,PDF p. 7。先看左上角跨轮次状态传递,再看右上角记忆模块接入骨干,最后看下方的三个计算分支:当前轮注意力、历史状态读取和未来状态写入。图中展示的是线性更新版本,最终主实验采用的 GDU 与这一示意需要区分。
| 符号 | 含义与维度(沿用原文单层记法) |
|---|---|
| $t,l$ | 交互轮次、网络层编号 |
| $L,d$ | 本轮参与处理的 token 数、隐藏维度 |
| $d_k,d_v$ | 记忆 key/query 与 value 的维度 |
| $\tilde{\mathbf H}_t^{(l)}\in\mathbb R^{L\times d}$ | 预归一化后的本层隐藏表示 |
| $L_t',\bar{\mathbf H}_t^{(l)}$ | 选中的 token 数及其 $L_t'\times d$ 表示 |
| $\mathbf M_t^{(l)}\in\mathbb R^{d_k\times d_v}$ | 保存历史 key–value 关联的矩阵 |
| $\mathbf S_t^{(l)}\in\mathbb R^{d_k}$ | 读取时使用的 key 归一化状态 |
| $\tilde{\mathbf w}_{\rm agg}^{(l)},\tilde{\mathbf W}_{Q,K,V}^{(l)}$ | 离线学习、在线冻结的选择与投影参数 |
| $\lambda,\gamma$ | LU 的历史折扣因子、当前注意力与记忆分支的混合权重 |
局部记忆块(local memory block)保存 $\mathbf M,\mathbf S$,默认初始值为零;超记忆块(hyper memory block)保存选择和投影等慢参数,决定如何从新输入生成状态更新。(§3.2,PDF p. 8)
2.2 自适应聚合选择的是累计概率质量
先对每个 token 打分:
$\tau$ 控制打分分布的集中程度。将概率降序排列,选择累计概率达到阈值 $\rho$ 的最短前缀,同时至少保留 $K_{\min}$ 个位置:
$\boldsymbol{\Pi}$ 的每行是一个被选位置的 one-hot 指示向量。top-$\rho$ 是累计概率阈值,不是固定保留 $\rho$ 比例的 token。 分布集中时可选较少位置,分布平坦时会保留更多。这里的“聚合”具体表现为筛选并收集多行隐藏状态,没有把整轮内容压成一个加权平均向量。
离散选择通过直通估计器(straight-through estimator)把梯度路由到稠密概率分布,从而训练打分向量。它是一种梯度估计方法。选中表示再投影为
这样做的动机是:有用事实可能分散在多个位置,只用最后一个 token 的表示可能丢失细节。后面的消融直接支持这一点。(§3.3,PDF pp. 8–9;表 7,PDF p. 22)
2.3 线性更新给出直观解释,最终模型采用 GDU
正文式 (2)–(3) 写成线性更新(Linear Update,LU):
矩阵乘积 $\tilde{\mathbf K}^{\top}\tilde{\mathbf V}$ 是选中 token 的 key–value 外积之和:每个 key 方向关联一个 value。除以 $L_t'$ 控制不同写入长度带来的幅值变化;$\lambda$ 让旧状态随轮次衰减。记忆大小由 $d_k,d_v$ 决定,不随着交互条数增长。
从零状态展开 LU,可得到
这说明历史内容叠加在共享矩阵中,而不是每条事实占有独立可寻址的文本记录。全局衰减也不直接等同于“忘掉指定实体”;语义操作必须依靠隐藏表示、投影和训练目标共同实现。
最终主结果使用 Gated Delta Update(GDU)。 §3.3 明确说实际用 Gated Delta Network 风格的更新替代 LU;附录 C.2 将其解释为按 key 修正已有 value 关联,更适合针对性改写。论文没有展开 Metis 所用 GDU 的完整递推及门控配置,因而式 (2)–(3)、图 2 的写入公式和 §3.5 的展开式应按 LU 理解。复现最终模型时还需对照项目实现,不能直接把这两条公式当作最终 GDU 算法。(PDF p. 9、pp. 35–36)
2.4 用独立 query 读取历史,再与当前轮注意力融合
记忆 query 为
正文式 (4) 的读取为
对一行 query $\tilde q$ 而言,就是将读出的 $\tilde q\mathbf M$ 除以标量 $\tilde q\mathbf S$。正文说明实现会在分母加一个单位向量以改善数值稳定性;展示的式 (4) 本身省略了这一项。$\mathbf S$ 是对记忆 key 贡献的归一化统计,和随后对输出幅值做的 $\operatorname{Norm}$ 是两个不同环节。
式 (5) 将两条分支融合:
第一项负责当前轮内部的信息交互,第二项将历史状态带入本层。之后沿用输出投影、残差连接和 FFN。独立的 $\tilde{\mathbf W}_Q$ 允许历史读取使用专门的匹配空间,降低当前 query 对无关历史 key 的响应。(§3.3,式 (4)–(5),PDF p. 9)
2.5 一轮交互的先后关系
下面是按论文抽象出的教学流程,省略层内张量细节:
初始化该用户的所有层记忆状态 M、S
对每轮输入 X_t:
    用当前状态 M_t、S_t 参与生成 Y_t
    从本轮参与写入的隐藏表示中选取 token,计算记忆 key/value
    通过前向更新得到供下一轮使用的 M_(t+1)、S_(t+1)
    持久化该用户的新状态
一般定义允许输入与输出共同参与更新;主实验采用独立的信息写入阶段,先提交历史段,再用仅含问题的提示查询。附录 F.2 给出了固定且与答案无关的 commit 提示。定性案例则描述为先回答,再将用户输入写入。阅读时应区分这一抽象计算图与各实验具体调用路径。(§5.1、§6.1、§6.9、附录 F.2,PDF pp. 16–19、26、39)
2.6 虚拟前缀解释与干扰误差
作者设想给当前层添加历史虚拟前缀 $\mathbf P_t$。在真正的前缀 softmax attention 中,当前内容和历史前缀各有一个归一化分区,它们的相对权重由每个 query 的分区函数决定。随后做两步近似:用全局 $\gamma$ 替代随 query 变化的分区权重;用点积形式替代指数相似度核,从而把历史项整理成 $\mathbf K^\top\mathbf V$ 和 $\mathbf K^\top\mathbf 1$ 两个状态。(§3.4,PDF pp. 9–11)
这个推导解释了矩阵记忆与前缀信息的联系,但不提供与完整 softmax attention 等价的保证。特别是把 $\exp(z)$ 替成 $z$ 并非保留常数项的 $1+z$ 泰勒近似;正文也没有为这个替换给出统一误差界。其作用是启发架构。
§3.5 进一步分析 LU 中多个历史轮次混合带来的干扰。沿用原文 $\mathbf U_j$ 表示第 $j$ 轮对归一化分母的贡献,$\mathbf R_j$ 表示其对 value 分子的贡献。为便于解释,令
这里 $c$ 是当前问题所需的历史轮次。则
$\epsilon_1$ 来自无关 value 直接混入,$\epsilon_2$ 是无关 key 改变分母后稀释目标,$\epsilon_3$ 是二者的交叉影响。各项都含无关轮次的 query–key 相似度,因此专门训练记忆 query 有助于抑制干扰。
这个一阶展开需要目标分母可逆,且 $D_c^{-1}D_o$ 足够小;仅说某一个目标 key 的相似度较高还不够,因为很多无关项可能累计起来。它讨论的是 LU 的局部干扰机理,没有给出任意长轨迹或最终 GDU 的容量保证。(§3.5,PDF pp. 11–13;以上 $D_c,D_o,R_o$ 为教学简记)
2.7 数据与训练目标如何教会语义操作
主数据来自 27 个公开基准,以结构化事实为种子,经改写、插入干扰轮次、自动质量检查,形成四类操作。质量检查包括状态一致性、干扰信息正交性、无参考时不能回答的捷径检查和语义多样性。(§4.1,表 1–2,PDF pp. 13–15)
| 操作 | 训练序列的含义 | 样本数 | token 数(百万) |
|---|---|---|---|
| Remember | 写入事实,之后询问 | 56,855 | 362.0 |
| Forget | 写入事实,再撤销,之后询问 | 136,271 | 21.7 |
| Update | 写入旧值,再给新值,按新状态回答 | 81,501 | 11.0 |
| Reflect | 写入多个事实,回答它们的组合关系 | 82,510 | 11.4 |
| 合计 | 显式指令、隐式表述和带干扰序列 | 357,137 | 406.1 |
Remember 的样本数不是最多,但因加入长干扰上下文,占据约 89.1% 的主数据 token。不能把“样本数量较均衡”理解成“训练 token 成本相近”。这里的 reflect 是多个已存事实的组合或多跳推理,不是自主反思并持续改进模型的广义能力。
辅助数据共 609,443 条:多实体绑定 76,153 条,选择性遗忘 76,153 条,记忆问答之后接普通对话 357,137 条,以及无需记忆的对话 100,000 条。前两类缓解相似事实混淆和误删,后两类训练模型在不需要历史时抑制记忆污染。(§4.2,表 3–4,PDF pp. 15–16)
三种目标共享同一 token 平均负对数似然,只改变监督样本和答案:
$\mathcal Q_s$ 是有答案监督的查询步,参考和操作步仍参与状态演化,但不直接施加该答案损失。五个数据子集分别是重建、显式/隐式操作、干扰操作、多事实和抗污染数据。
| 目标 | 所需输出 | 解决的学习问题 |
|---|---|---|
| Memory reconstruction | 根据记忆恢复先前原文 | 冷启动时建立可用编码和读取能力 |
| Memory operation | 按记住、更新、忘记、组合后的状态回答 | 将输入语义映射为状态变化 |
| Regularization | 区分相似事实,并正确完成无需记忆的任务 | 限制串事实、误删和无关值泄露 |
重建以尽量无损为训练目标,而任务型记忆需要按未来用途有损压缩,两者存在取舍。作者用随训练 epoch 线性变化的采样权重 $w_\tau(e)$,再归一化为 $\pi_\tau(e)$,逐渐转向较难的长程和正则化数据。采样概率控制期望贡献,每个抽到的样本内部并未再乘一组独立损失系数。“重建目标追求无损”是优化意图,不表示实验已经实现无损存储。(§5,式 (12)–(17),PDF pp. 16–18)
中期训练冻结骨干,只训练原生记忆参数;主实验使用 Qwen3.5 4B/9B/27B、8 张 H100、BF16、AdamW、学习率 $2\times10^{-4}$,200 步 warmup 后恒定学习率,梯度裁剪 1.0。4B 与 27B 都训练 14,000 步,分别约 1 和 0.4 epoch;9B 根据验证集在 8,000 步早停。因此后续规模趋势也包含训练进度不同的影响。(§6.1,PDF p. 19)
三:实验——先明确模型在查询时能看到什么
3.1 三种信息访问条件
| 条件 | 查询时可访问的历史 | 对照意义 |
|---|---|---|
| Full Context | 评测实例提供的全部证据文本 | 测量保留原始证据时的参考表现 |
| Partial Context | DenseRAG 检索的 top-5 句级片段 | 测量检索后保留部分证据的表现 |
| No Context | 只输入问题,历史依赖已经写好的状态/适配器 | Metis、Temp-LoRA、$\delta$-Mem 的主要比较条件;原始骨干作为无记忆对照 |
“No Context”不表示有记忆方法从未看过历史。它们在信息阶段已经读取并写入,只是不把原文回放进查询提示。每个测试实例重新初始化状态,主协议先写信息、后问问题;这与开放式智能体长期连续运行有所不同。(§6.1、附录 E–F,PDF pp. 18–20、37–40)
3.2 数据集与指标
MemOps (Gold) 只提供问题必需的 oracle 轮次;MemOps (Full) 提供三个完整证据片段、共 24 条 utterance。因此,Gold/Full 是证据范围,Full/Partial/No Context 是查询访问方式,两个维度不能混用。Metis Test Set 测试合成分布中的四种操作。
LoCoMo (Gold) 提供相关证据 session,不是全部长期对话历史。NextMem 是上下文生成任务的集合,包含 SQuAD、HotpotQA、LongMemEval 和 LoCoMo;主表不应等同于分别跑四个原始基准的任意官方长历史设置。(§6.1,PDF pp. 18–19)
主实验由 gpt-4.1-mini 对每个回答打分,温度为 0,重复三次后取该样本分数中位数;裁判允许一定部分得分,最终表格按 0–100 展示,越高越好。每个基准内部 Avg. 是按样本的微平均,消融 Overall 则是四个基准分数的等权宏平均;三次裁判重复并非三次独立模型训练。(附录 F.3,PDF p. 40)
3.3 基线的训练和容量并不完全匹配
DenseRAG 仅使用当前实例可见的文本,按句切分,长于 256 个 embedding token 的句子继续分块,余弦相似度检索 top-5。Temp-LoRA 使用对应的 Qwen3.5 骨干,rank 64,对注意力及 FFN 投影做在线适配;每个 1,024-token chunk 更新两次,每个实例重置 LoRA 和优化器。它代表用在线梯度吸收历史的路线。
$\delta$-Mem 使用官方 Qwen3-4B-Instruct-2507 适配器,而非相同 Qwen3.5 骨干;查询前清除文本历史、输入 IDs 和 KV cache,只保留在线状态。它的官方 rank-8 状态也远小于 Metis。因此与它的比较体现整套系统的效果,不能将全部差异归因于某个单独的更新规则。(附录 E、G.3,PDF pp. 37、43)
四:结果——能力已经出现,但容量和可控性决定实用程度
4.1 记忆操作:同分布成绩与外部遗忘能力差别很大
下表选择表 5 的基准内微平均分;所有数字均在 0–100 标度上,越高越好。
| 模型与访问条件 | MemOps (Gold) | Metis Test Set |
|---|---|---|
| Qwen3.5-4B,完整上下文 | 84.56 | 75.18 |
| Qwen3.5-27B,完整上下文 | 87.90 | 78.87 |
| Qwen3.5-4B,RAG top-5 | 30.18 | 64.82 |
| Qwen3.5-27B,RAG top-5 | 28.01 | 65.40 |
| Qwen3.5-4B,无历史 | 1.65 | 16.96 |
| Temp-LoRA-4B,无上下文 | 8.85 | 19.34 |
| Temp-LoRA-9B,无上下文 | 13.51 | 19.51 |
| Temp-LoRA-27B,无上下文 | 9.70 | 23.86 |
| $\delta$-Mem,无上下文 | 4.38 | 15.03 |
| Metis-4B,无上下文 | 17.84 | 56.72 |
| Metis-9B,无上下文 | 19.63 | 57.92 |
| Metis-27B,无上下文 | 24.76 | 73.77 |
来源:§6.2,表 5,PDF p. 19。
在相同 Qwen3.5-4B 骨干、查询不回放文本的条件下,Metis 比 Temp-LoRA 在两个基准分别高 8.99 和 37.38 个分数点。Metis-27B 的合成测试分数接近完整上下文参考,但外部 MemOps 仍差 63.14 分。可见学到操作并不自动意味着对更复杂证据分布也同样可靠。
最能体现这种差别的是遗忘:Metis-27B 在自建测试集 Forget 上为 77.50,在 MemOps (Gold) 上只有 10.91。9B 的外部遗忘分数 11.59 还略高于 27B,规模提升没有单调改善所有操作。4B/9B 在自建 Forget 上只有 31.25/30.42,甚至低于无历史原骨干的 49.58/49.90;由于不知道事实的模型也可能通过“无法回答”获得遗忘类得分,必须把 Forget 与 Remember 和选择性保留能力一起解释。
4.2 记忆问答:内部状态确实传递信息,完整证据仍明显更强
| 模型与访问条件 | LoCoMo (Gold) | NextMem |
|---|---|---|
| Qwen3.5-4B,完整上下文 | 63.52 | 77.15 |
| Qwen3.5-27B,完整上下文 | 65.03 | 78.80 |
| Qwen3.5-4B,RAG top-5 | 23.54 | — |
| Qwen3.5-27B,RAG top-5 | 23.17 | — |
| Qwen3.5-4B,无历史 | 0.18 | 11.86 |
| Temp-LoRA-4B,无上下文 | 9.99 | 24.20 |
| Temp-LoRA-9B,无上下文 | 11.72 | 28.12 |
| Temp-LoRA-27B,无上下文 | 4.24 | 30.97 |
| $\delta$-Mem,无上下文 | 10.79 | 20.42 |
| Metis-4B,无上下文 | 16.31 | 41.69 |
| Metis-9B,无上下文 | 16.81 | 43.39 |
| Metis-27B,无上下文 | 26.74 | 50.82 |
来源:§6.2,表 6,PDF p. 20。破折号表示原文未列该设置。
原始骨干在 LoCoMo 的无历史分数接近零,Metis 的增益说明早期信息确实通过状态影响了后续回答。在 4B 上,相对 Temp-LoRA,LoCoMo 提高 6.32 分,NextMem 提高 17.49 分。
NextMem 的 4B 细分结果尤其值得看:Metis 在 SQuAD 上为 29.62,HotpotQA 为 58.13,LongMemEval 为 39.36,LoCoMo 为 50.48;Temp-LoRA 对应为 26.19、38.62、9.71、11.12。收益集中在部分更需要记忆整合的任务。另一方面,4B Metis 在单独 LoCoMo (Gold) 上仍低于 RAG top-5 的 23.54;不能把“在无上下文组最优”改述为优于一切文本检索方法。
LoCoMo (Gold) 的 Temporal 从 Metis-4B 的 7.03 升至 27B 的 13.83,而 Open 仅从 28.37 升至 28.93。这表明容量扩大会改变某些关系处理能力,但作用依赖任务。上述数据都是不同配置模型的结果,9B 的训练早停也应计入理解。
4.3 消融:信息选择和读取归一化比更换更新规则更关键
| Metis-4B 变体 | 四基准宏平均 | 相对完整模型变化 |
|---|---|---|
| 完整模型 | 33.14 | — |
| 去掉多事实辅助数据 MS | 29.68 | −10.43% |
| 去掉全部辅助数据 MS+MP | 26.74 | −19.31% |
| 用 LU 替代 GDU | 32.95 | −0.58% |
| 去掉自适应选择 SA,改用最后 token | 12.93 | −60.98% |
| 去掉独立记忆 query OQ | 29.09 | −12.23% |
| 去掉 query–key 归一化 QKN | 23.72 | −28.44% |
来源:§6.3,表 7,PDF p. 22。右列沿用原表基于未舍入值的相对变化;它不是百分点差。
最大损失来自把整轮信息压在最后 token 上。共享状态再强,如果写入时已经丢掉关键事实,后续读取也无法恢复。去掉 QKN 与独立 query 的损失,则分别支持幅值控制与历史相关性选择的重要性。辅助数据的收益说明,绑定、局部修改和按需抑制记忆需要针对性训练。
GDU 在 4B 总平均上只比 LU 高 0.19 分,但 LoCoMo 为 16.31 对 11.97;LU 在 Metis Test Set 则为 58.54 对 56.72。因此更新规则的差异主要体现为任务取舍,而不是所有任务同步提升。
4.4 分布外结果:ATM-Bench 迁移明显,MemDaily 不稳定领先
这两项基准没有用于构建训练数据,但评测仍采用 Gold 证据和查询不回放文本的设置。ATM-Bench 对列表、数字、开放问答分别用 Jaccard、后处理精确匹配和 LLM 裁判;MemDaily 使用六类题目的确定性单选准确率。平均值根据官方类别样本数加权。(§6.4,表 8,PDF p. 22)
| 方法 | ATM-Bench (Gold) | MemDaily (Gold) |
|---|---|---|
| $\delta$-Mem | 2.27 | 39.84 |
| Temp-LoRA-4B | 2.57 | 44.92 |
| Temp-LoRA-9B | 2.86 | 51.42 |
| Temp-LoRA-27B | 2.57 | 59.45 |
| Metis-4B | 10.22 | 52.54 |
| Metis-9B | 16.49 | 47.29 |
| Metis-27B | 18.56 | 59.04 |
Metis 在 ATM 的数字问题上达到 14.17/24.72/31.39,而对应 Temp-LoRA 均为 0,这使得迁移收益不只依赖开放问答裁判。ATM 列表召回仍几乎为零:4B 为 1.08,9B 和 27B 为 0。MemDaily 上 9B 落后同规模 Temp-LoRA 4.13 个百分点,27B 也略低 0.41 个百分点,说明泛化收益依赖问题类型与骨干规模。
4.5 排除训练来源:主体能力保留,任务表现重新分配
作者去掉所有由 LoCoMo 和 LongMemEval 生成的训练实例,再按其余相同设置训练。按该实验计数,删除约 2.61% 的实例,但集中在记住、重建、多实体及混合操作部分,因此也改变了任务组成。(§6.5,表 9,PDF pp. 22–23)
| 规模 | 排除后的六基准宏平均 | 相对原模型的分数点变化 | LoCoMo (Gold) 变化 |
|---|---|---|---|
| 4B | 30.90 | −1.66 | −3.13 |
| 9B | 32.83 | −0.76 | −1.09 |
| 27B | 39.59 | −2.69 | −5.59 |
六基准是 LoCoMo、NextMem Avg、Metis Test、MemOps、ATM、MemDaily,不能与表 7 的四基准 Overall 混比。LoCoMo 及 NextMem 内的 LoCoMo 子集在三个规模都下降,说明来源组成确实重要;27B 的 NextMem 平均反而增加 2.49 分,LongMemEval 子集增加 4.50 分,表明变化不是统一退化。
这项结果支持“学到的记忆过程有一定可迁移性”,同时说明训练来源会改变任务偏好。作者关于实体覆盖和监督比例变化的解释是合理假说;该实验同时改变两者,不能单独识别其中一个因素的因果作用。
4.6 容量:单次长写入与多次更新都会丢信息
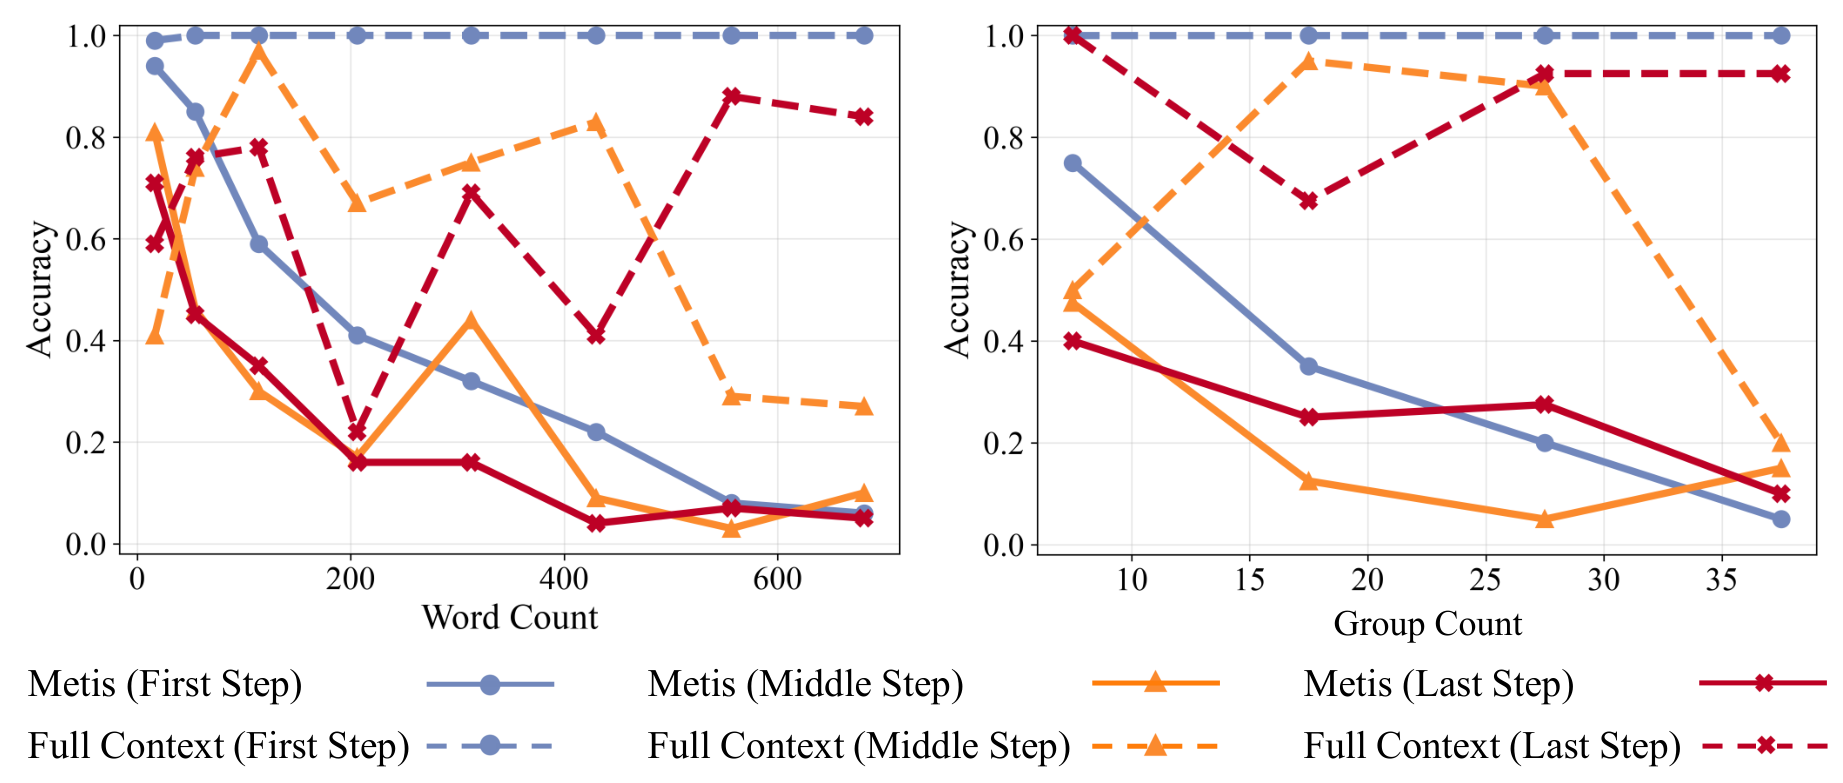
原文图 3,PDF p. 23;协议见 §6.6,PDF pp. 23–24。纵轴都是回答准确率;实线是 Metis,虚线是完整上下文 Qwen3.5-4B;蓝、橙、红分别探测最早、中间和最近的事实。
作者构造 20 位虚构用户,每位有 40 项原子属性。左图每次清空状态,将前 $t$ 条陈述拼起来做一次写入;横轴是 word count。最早事实的召回明显下降,几百词以后三个位置的成绩普遍偏低。这隔离出一次压缩所能容纳的信息量。
右图只在轨迹开始清空状态,之后连续提交分组陈述,考察多次状态更新后的保留。最早事实逐渐减弱,中间和最新事实也不稳定,说明不仅存在旧信息衰减,也存在共享状态中的干扰。
图中有一个影响精确解读的标注问题:正文称 40 条陈述按默认 $g=5$ 分组,应得到 8 次组级更新;右图横轴却标为 Group Count,刻度延伸到接近 40。这里据实保留“更新累积时明显退化”的结论,不从这些横轴点推断精确可支持的更新次数。左图的词数也不换算成未经报告的 token 容量。
4.7 通用能力:空状态接近原骨干,激活记忆后发生干扰
| 基准 | 初始阶段 Qwen / Metis | 初始差值 | 激活阶段 Qwen / Metis | 激活差值 |
|---|---|---|---|---|
| MMLU-Pro | 46.00 / 45.20 | −0.80 | 46.00 / 40.90 | −5.10 |
| IFEval(strict) | 79.30 / 79.85 | +0.55 | 76.71 / 54.53 | −22.18 |
| GSM8K | 83.09 / 82.03 | −1.06 | 84.53 / 78.92 | −5.61 |
| MMMLU | 61.30 / 60.50 | −0.80 | 59.90 / 56.60 | −3.30 |
来源:§6.7,表 10,PDF p. 24;差值为 Metis-4B 减 Qwen3.5-4B,单位为百分点。
初始状态下差异小;激活状态中,Metis 先把无关消息写入记忆,Qwen 则把同一消息放在提示里,再完成相同基准。IFEval 的 −22.18 个百分点 说明记忆分支可能显著干扰严格指令遵循,即使骨干权重完全冻结。
附录 F.4 实际给出的是一条固定的通用评测提示,要求认真遵循后续指令。这个设置检验的是一次这类无关状态激活后的干扰,不能据它量化“历史越多,通用能力下降越多”的函数关系。它也提示训练目标应覆盖对当前任务无帮助时的记忆抑制。(PDF p. 40)
4.8 低秩分解:短期评测状态可压缩,但读写容量问题仍在
作者将状态转成 FP32 做 SVD,保留前 $k$ 个奇异方向:
低秩因子用于保存,读取前重建矩阵。因此实验直接验证的是状态持久化压缩,而非始终在低秩因子上执行更新或降低相同比例的计算量。(§6.8,PDF p. 25)
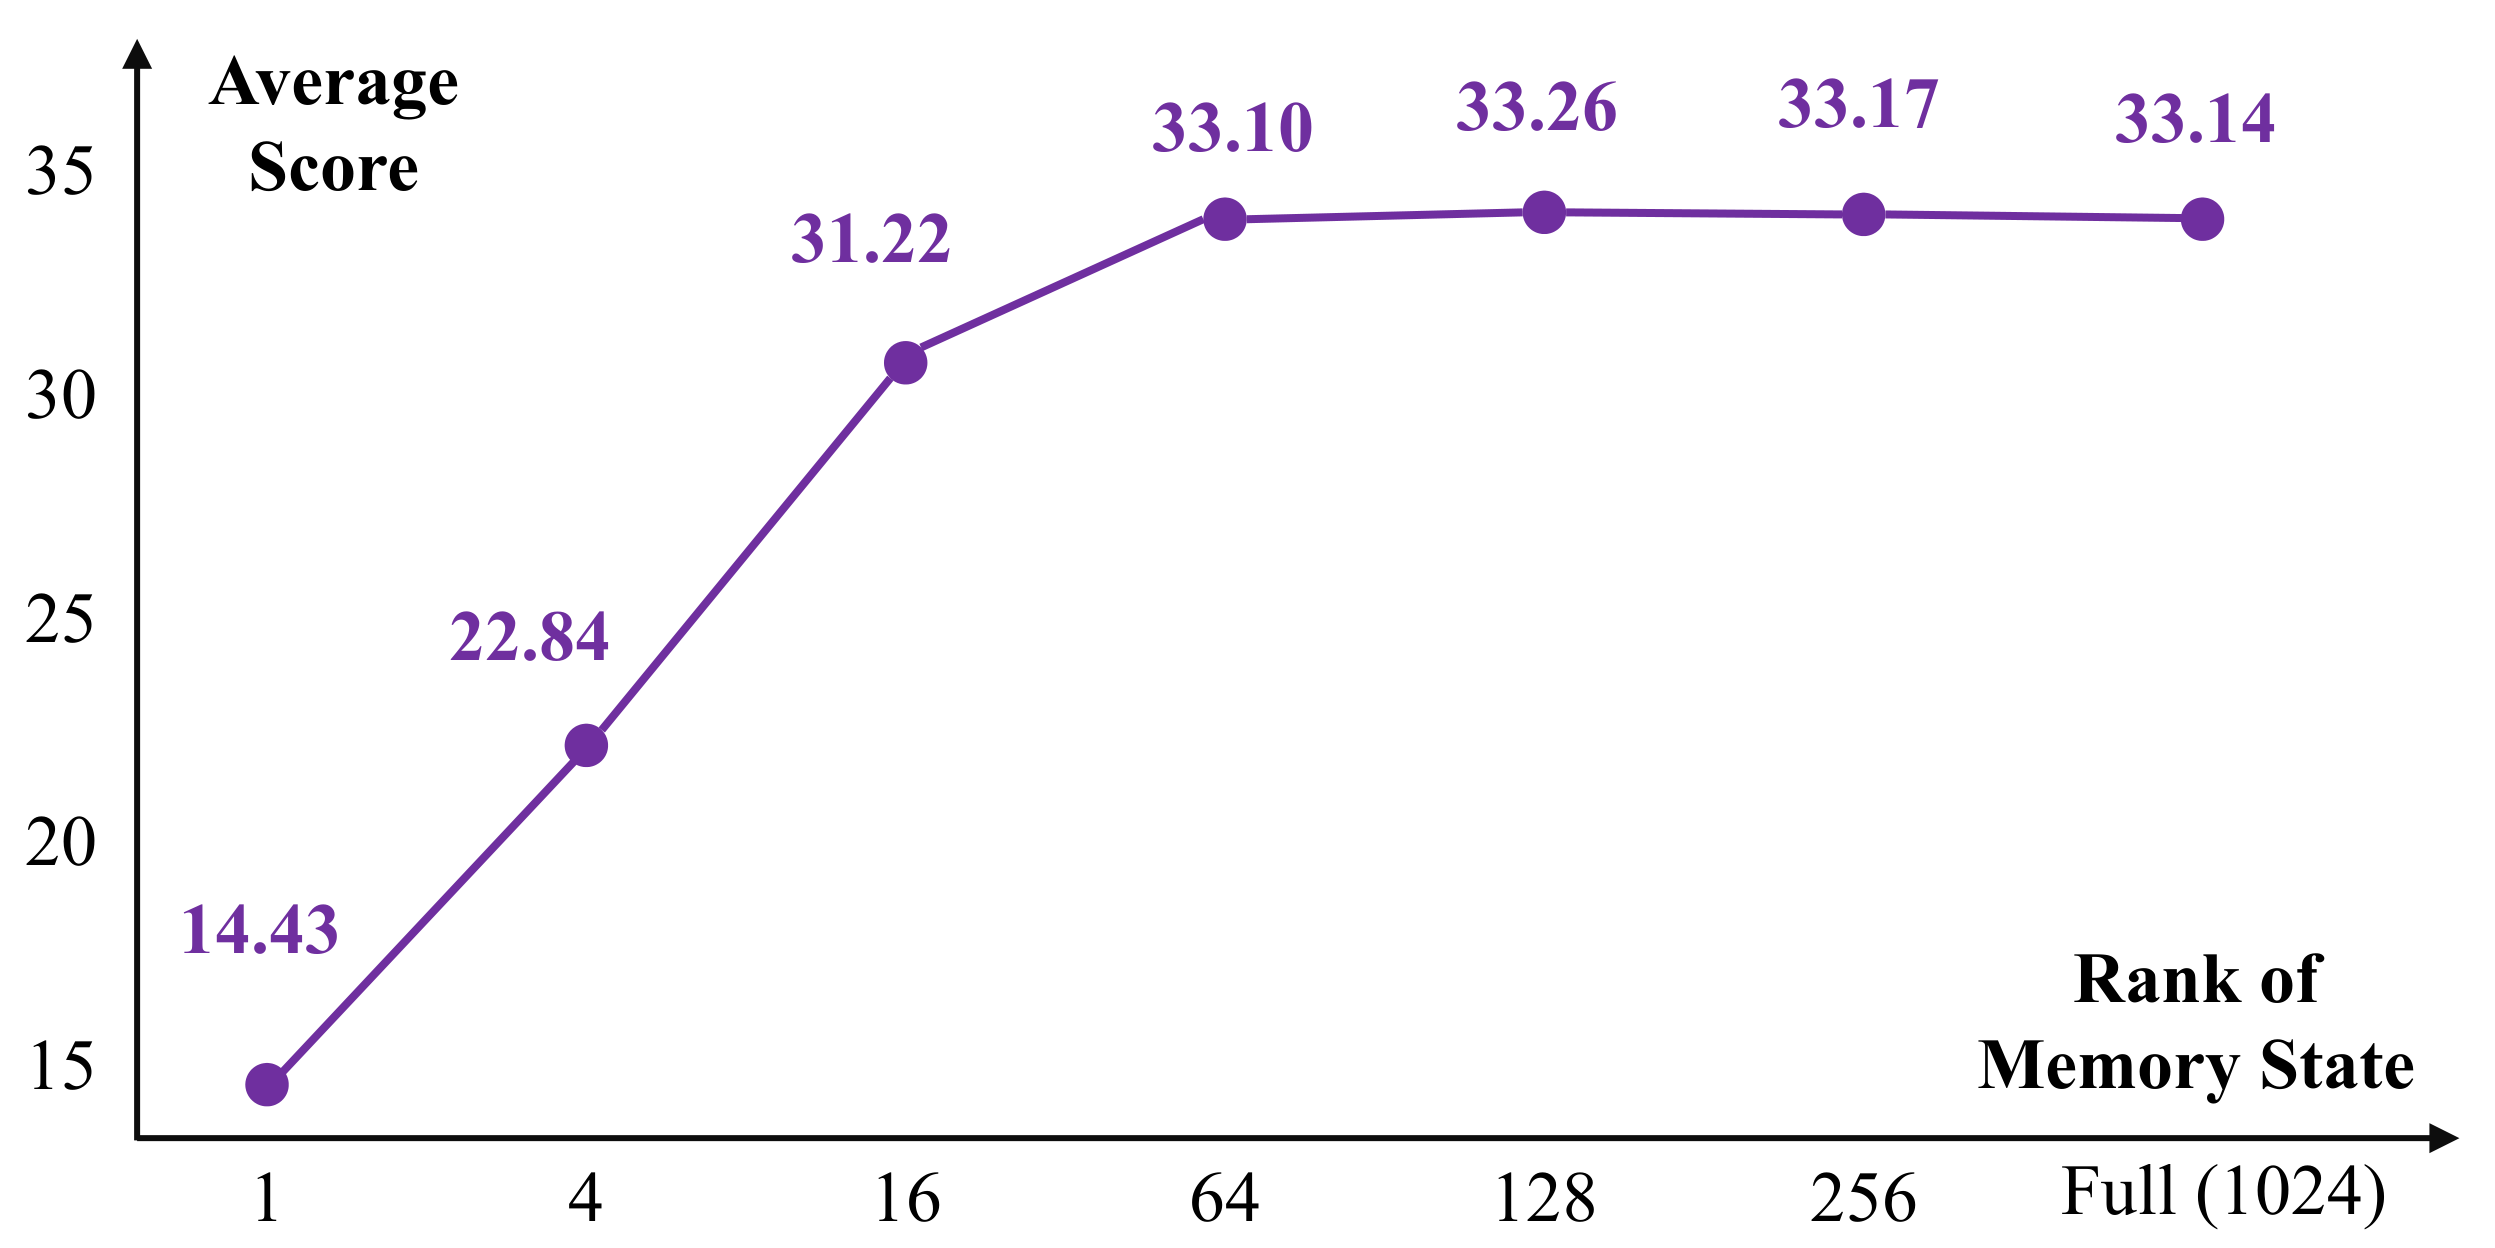
原文图 4、表 11,PDF p. 25。横轴是保留秩,Full 为 1024;纵轴为四基准等权宏平均,图中每个点上方给出精确分数。
| 保留秩 | 1 | 4 | 16 | 64 | 128 | 256 | Full |
|---|---|---|---|---|---|---|---|
| 平均分 | 14.43 | 22.84 | 31.22 | 33.10 | 33.26 | 33.17 | 33.14 |
| 相对完整状态恢复率 | 43.5% | 68.9% | 94.2% | 99.9% | 100.4% | 100.1% | 100.0% |
$k=64$ 已接近完整状态,总存储由 16.79 MB 降至 2.11 MB,约为八分之一。原文将超过 100% 的结果解释为裁判波动,而非压缩必然改善准确率。
两个看似相反的结果可以同时成立:当前评测中形成的状态有低秩冗余,但模型又不擅长保留长历史。低秩冗余只说明已编码状态的有效方向有限,不代表所有被丢掉的信息仍能恢复。瓶颈可能同时存在于选择、编码、更新和读取环节。
4.9 案例:操作完成后的行为与当轮回复需要分别看
图 5 展示了记住偏好、多属性绑定、穿过无关聊天后再召回,以及遗忘案例。遗忘案例最有启发:用户要求忘记 Alice 喜欢牛肉汉堡时,助手当轮仍复述了这条偏好;下一轮询问时才回答没有该信息。作者将其归因于当轮仍过度依赖旧状态。(§6.9,图 5,PDF p. 26)
该案例与“先用旧状态回答,再提交新状态”的时序吻合。最终查询中不再给出旧事实说明输出行为发生了变化;单个案例不能判定潜在信息是否已不可恢复。需要可靠遗忘的应用还必须关注操作当轮的泄露与保留事实是否被连带破坏。
4.10 补充实验:完整证据、更新规则与骨干迁移
MemOps (Full)。 在更完整的 24 条 utterance 证据下,无上下文 Metis-4B/9B/27B 平均为 9.70/11.53/15.35;对应 Temp-LoRA 为 9.98/12.19/10.83。4B 和 9B 的 Metis 没有超过同规模 Temp-LoRA,只有 27B 领先。完整上下文 Qwen3.5-27B 为 87.19。由 Gold 到 Full 的下降进一步说明无关和更长证据的压缩很困难。(附录 B,表 12,PDF pp. 34–35)
LU 与 GDU。
| 规模 | GDU / LU 四基准宏平均 | GDU / LU 的 LoCoMo (Gold) |
|---|---|---|
| 4B | 33.14 / 32.95 | 16.31 / 11.97 |
| 9B | 34.44 / 35.59 | 16.81 / 15.37 |
| 27B | 44.02 / 41.50 | 26.74 / 14.16 |
来源:附录 C.1,表 13,PDF pp. 35–36。所有规模都呈现“GDU 的 LoCoMo 更好,LU 的 Metis Test 更好”。9B 的 LU 训练 14,000 步,GDU 使用 8,000 步早停检查点,不能把两者的平均分差纯粹归结为更新算子。
附录 C.2 从 LU 再做消融:去掉 SA 后平均从 32.95 降到 16.21,去掉 OQ/QKN 分别降至 28.83/28.02,关键结构收益仍在。但去掉 MS 单独一项后反而升到 33.67,和 GDU 下的下降方向不同;辅助数据与更新机制存在相互作用。去掉全部 MS+MP 后为 28.85,辅助数据总体仍有帮助。(表 14,PDF p. 36)
跨骨干迁移。 Llama3.1-8B、Gemma4-12B、Gemma4-31B、Llama3.1-70B 分别在相同中期训练范式、14,000 步检查点上评测;这里是把架构和训练流程迁移后重新训练,不是零训练迁移一份通用记忆模块。
| 骨干 | 无历史宏平均 | 加入 Metis 的宏平均 | 完整上下文宏平均 |
|---|---|---|---|
| Llama3.1-8B | 10.69 | 36.03 | 70.61 |
| Gemma4-12B | 8.36 | 37.68 | 77.30 |
| Gemma4-31B | 5.40 | 33.44 | 78.18 |
| Llama3.1-70B | 12.71 | 39.29 | 75.06 |
来源:附录 D,表 15,PDF pp. 36–37。所有迁移模型都从内部状态受益,但规模不单调:Gemma4-31B 低于 12B。该结果支持框架可移植,最佳训练配方仍可能依赖骨干。
4.11 效率:应分清冷启动、历史摄入、查询与服务阶段
LoCoMo 应用级延迟。 4B 模型、1,527 个 Gold 实例,每个实例冷启动,贪心生成最多 96 token。端到端时间包含写入、检索或在线适配;查询时间从准备完成后计时。各模型自然停止,所以输出长度并不相同。(附录 G.1,表 16,PDF p. 41)
| 方法 | 平均端到端秒数 | P95 端到端秒数 | 平均查询秒数 |
|---|---|---|---|
| 完整上下文 | 0.607 | 3.012 | 0.607 |
| RAG top-5 | 0.268 | 0.456 | 0.223 |
| Temp-LoRA | 1.567 | 3.292 | 0.305 |
| $\delta$-Mem | 0.884 | 1.600 | 0.656 |
| Metis | 0.562 | 0.926 | 0.360 |
Metis 相对完整上下文的平均端到端延迟仅降低约 7.4%,P95 降低 69.3%;RAG 在该冷启动设置最快。Metis 平均生成 8.3 token,完整上下文为 5.7,所以这些数字是应用级成本,不能解释成固定输出长度下纯解码速度。表 16 的 effective throughput 数值与生成 token / 查询时间相符,例如 $8.3/0.360\approx23.1$ token/s;不能用它声称包含摄入时间的端到端吞吐。
受控长历史扫描。 单张 A800,batch=1,历史从 512 到 128K token,固定最终查询内容 512 token,输出 32 或 128 token;Metis 以最多 2K token 的块摄入历史。这项测试只测生成与延迟,不评答案质量。
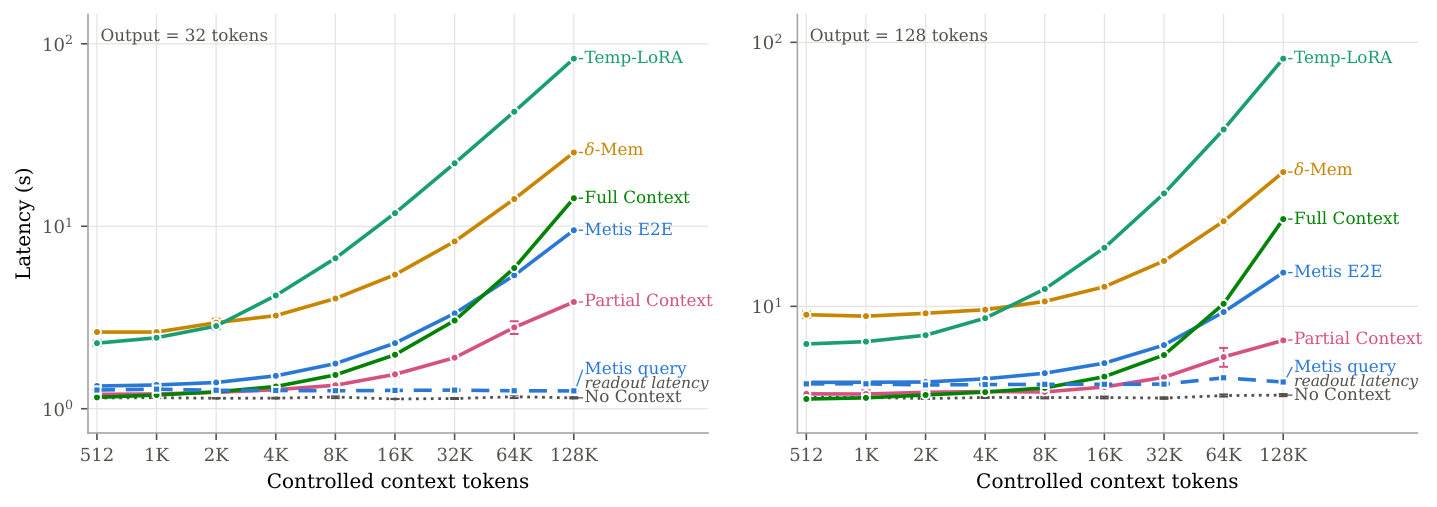
原文图 7,PDF p. 42。左右分别为输出 32/128 token,纵轴为对数秒数;Metis E2E 包含历史摄入,Metis query 不含摄入,不能将两条线混同。
第一次实测 Metis 端到端延迟低于完整上下文是在 64K;到 128K,完整上下文与 Metis 在两种输出长度下分别为 14.254 对 9.521 秒(1.497×)、21.404 对 13.423 秒(1.595×)。完整上下文骨干本身已有 24/32 层线性注意力,这使得交叉点来得较晚。
固定大小状态让读取成本对历史长度不敏感,但摄入历史依然有成本。64K/128K 时纯状态更新约 0.203/0.406 秒,只占 Metis 端到端时间的 2.1%–4.3%;历史编码的骨干前向约为 3.86/7.65 秒,才是摄入的大头。(图 8,PDF pp. 42–43)
§3.6 的并行延迟公式 $\max(T_{\rm orig},T_{\rm util},T_{\rm store})+T_{\rm fuse}$ 描述依赖关系上的可并行性;附录 G.2 明确说最终实现没有开启跨 CUDA stream 的这种重叠,因为调度开销可能抵消收益。不能把理论可并行直接当作实测优化已启用。(PDF pp. 13、43)
每会话持久化存储。
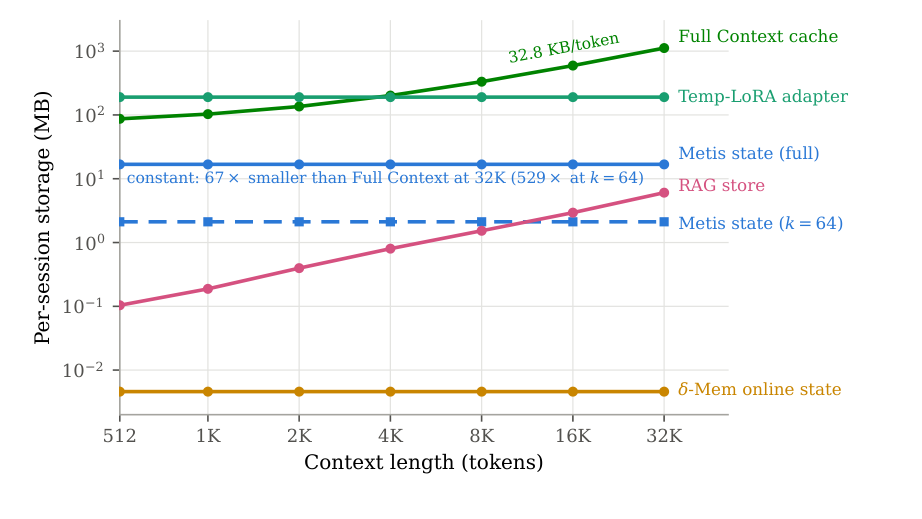
原文图 9,PDF p. 44,协议与数字见 G.3,PDF p. 43。纵轴为对数 MB,横轴为历史 token 数,统计来自实际运行时对象。完整上下文包含继续会话所需 KV cache 和线性层状态,RAG 包含 FP32 embedding 及文本,参数记忆方法只统计各会话独有状态。
32K 历史时,完整上下文占 1,118.86 MB,Metis 完整状态为 16.79 MB,rank-64 为 2.11 MB,约相差 67 倍和 529 倍。RAG 为 6.051 MB,Temp-LoRA 为 190.3 MB,$\delta$-Mem 则仅 4.6 KB。Metis 的优势是固定且较小的存储,并不是所有方法中状态最小。论文的 128K 存储比值是根据线性趋势外推,不是该存储实验的实测点。
多用户服务。 Memory-as-Adapter(MaA)共享冻结骨干与静态记忆参数,按用户交换动态状态。所有用户状态形状一致,可沿 batch 维堆叠后做批量矩阵乘法;每位用户无需独立加载整个模型。(附录 G.4,PDF pp. 44–46)
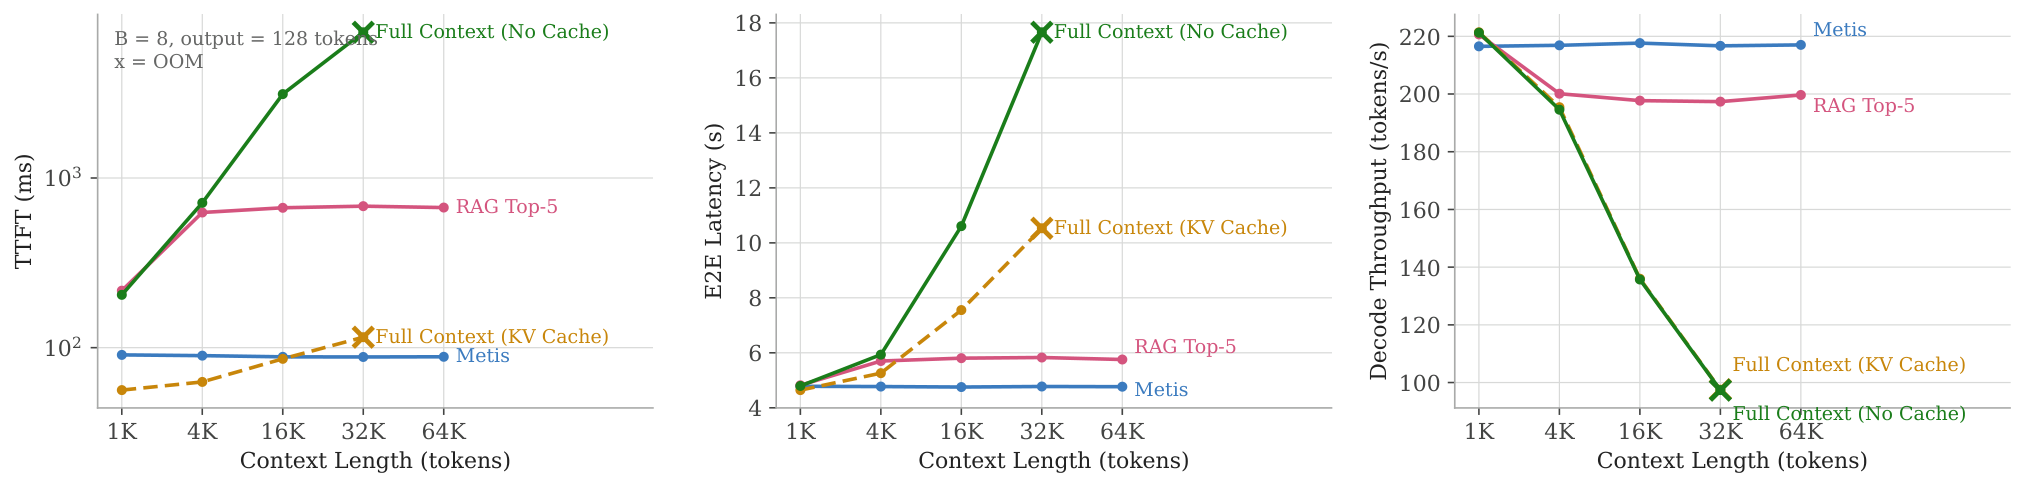
原文图 10,PDF p. 45。三个面板依次为首 token 时间、批请求端到端时间、解码吞吐。服务测试已预建历史状态;Metis 的请求成本包含从 SSD 加载与注入状态,和前面的冷启动全部历史摄入协议不同。
1K–64K 历史下,Metis 的首 token 时间约 88–91 ms、批请求时间约 4.76–4.78 秒,解码吞吐约 216–218 token/s。相对同提示的原始骨干,记忆路径在 $B\le8$ 时增加约 14% 延迟,在 $B=64$ 时约 30%;此时聚合吞吐达到 1,585.6 token/s。这是一台机器、静态 batch、五次测量取中位数的原型测试;状态写入已预先完成,尚未解决连续 batching 下读写交错与一致性调度。(图 11,PDF pp. 45–46)
20 用户、200 次跨用户探测未出现他人事实泄露;单用户一条事实时,不同 batch 大小的自有事实召回均为 100%。这说明 batch 切片的隔离设计在该简单负载下工作正常,不能用于推断长用户历史的召回质量。128K 的速度扫描同样没有回答质量评分,应与图 3 的容量退化一起理解。
五:结论——把记忆做成可训练过程之后,还需要解决什么
Metis 的主要价值在于把“如何从一段交互产生未来可用的状态”设为明确的学习任务。它将快权重式关联状态、专门的历史读取、语义操作数据与抗干扰训练组合起来,在冻结骨干上实现无在线梯度的跨轮次记忆。自适应选择和读取归一化的强消融结果,也说明输入选择与历史利用质量比单纯更换写入递推更加关键。
如果面向实际系统,最直接的取舍是:愿意承受多少信息损失,换取多小的用户状态与多稳定的查询成本。Gold 条件下的成功、固定大小存储和服务吞吐共同说明这条路线值得继续探索;MemOps (Full)、容量曲线和激活状态下 IFEval 的下降,则说明它还不适合承担精确、长期、可审计记忆的全部职责。
由本文机制和结果可以提出三个具体研究方向,以下属于本次分析:
- 根据未来使用风险决定保留方式。 对频繁使用且可容忍语义压缩的信息写入原生状态,对需要精确恢复或追溯的事实保留文本证据。容量实验使这种混合存储有直接动机。
- 把“何时不读记忆”做成更强的训练约束。 空状态表现接近骨干,而激活后 IFEval 明显下降,说明冻结权重不足以隔离记忆干扰;需要针对当前任务的读取抑制与操作时序监督。
- 联合评测写入成本、长期质量和操作可控性。 在同一条持续轨迹中交错写入、更新、选择性遗忘、普通任务与查询,同时报告质量和成本,比将短期质量与长历史速度分别测量更接近部署目标。
附录 A 提出的五级路线是:有状态能力、自主管理、从经验学习、持久认知、自我演化。它为未来方向提供概念框架;本文直接验证的是原生状态和部分语义管理行为,后面几个层级仍属于展望。(PDF pp. 33–34)