Memory for Large Language Models:中文精读笔记
作者:Sining Zhoubian、Dan Zhang、Evgeny Kharlamov、Jie Tang。
版本:arXiv:2607.25380v1,2026-07-28 提交;研读及获取日期:2026-10-04。
原文:arXiv 版本页 · 本地 PDF · 英文汇报 PDF · 可编辑 TeX。下文页码均为 PDF 页码,与本版印刷页码一致。
论文总览
这是一篇以模型架构为中心的记忆综述。它把通常分开讨论的 KV cache、稀疏注意力、线性递归、状态空间模型、测试时学习、查表模块与混合专家放在同一个问题下:历史信息存在哪里,由谁决定写入和读取,经过多长时间还能够影响预测?
作者提出三个主要分类轴:表示形式(隐式/显式)、更新动态(离线/在线)、持续性(短期/长期)。又在“更新动态”之下补充五类写入或管理机制,解释仅知道“推理时会更新”为什么还不够。论文最有用的贡献是把“存储载体”和“更新规则”分开,使不同模型可以在同一组问题下比较。[Sec. II,pp. 2–6,Tables I–III]
全文的主线是:注意力保留细粒度历史,代价随上下文增长;递归状态以压缩换取长序列处理效率,但承受信息碰撞和遗忘;独立记忆模块把写入、寻址与维护变成可设计操作,同时带来漂移、索引和生命周期问题。因此,作者主张通过混合架构分配不同种类的记忆,并用召回、干扰、持续性和成本共同评价它们。[Secs. III–VII,pp. 6–18]
这篇论文提供的是分类框架、机制归纳与研究议程。三张表分别是代表方法分类、更新规则分类、与其他综述的定位比较;四张图均为概念图。它没有建立一个统一训练与预算条件下的性能排行榜,文中关于各方法效果的叙述来自所引研究。
结构地图
| 原文章节 | 解决的问题 | PDF 位置 |
|---|---|---|
| I. Introduction | 为什么把记忆视为独立架构维度 | pp. 1–2;Fig. 1 在 p. 2 |
| II. A Taxonomy of Memory in Large Language Models | 三个分类轴、五类更新规则、综述范围 | pp. 2–6;Fig. 2 在 p. 3;Tables I/II/III 分别在 pp. 4/5/6 |
| III. Implicit Memory via Computation Dynamics | 注意力、稀疏与选择机制、递归状态及其限制 | pp. 6–9;Fig. 3 在 p. 7 |
| IV. Explicit Memory via Addressable and Adaptive Storage | 可写参数、查表存储、MoE、多时间尺度及风险 | pp. 9–14;Fig. 4 在 p. 10;Eq. (1) 在 p. 12 |
| V. Model-Level Memory Architectures: Design, Implementation, and Evaluation | 混合架构、内存管理、如何评测记忆 | pp. 14–17 |
| VI. Open Challenges and Future Directions | 理论、终身学习、可靠更新、动态分配与硬件协同 | pp. 17–18 |
| VII. Conclusion | 将记忆设计理解为多种机制的组合 | p. 18 |
| References | 被综述工作的来源 | pp. 18–20 |
一:动机——“更长上下文”并没有回答所有记忆问题
以“很早之前给出一条事实,之后再问它”为例,模型可以采用几种不同策略:保存那一位置的 KV,在一个递归状态中压缩它,把它写进专门的权重,或者存成一个可以检索的条目。它们都可能答对,却使用不同资源,也有不同失败方式:窗口淘汰、状态干扰、参数覆盖、寻址失败。
仅比较上下文窗口,无法区分这些机制;仅比较模型参数量,也无法衡量模型在推理时吸收新信息的能力。作者因此把“记忆”从规模指标转为结构问题:存什么、如何改、怎样取、能保留多久。[Sec. I,pp. 1–2]
本综述的范围是模型内部或与其推理动态紧密结合的机制。常规的聊天记录管理、用户画像、反思提示以及外部数据库编排,不在其主要范围。kNN-LM 仍被纳入,是因为检索结果直接进入语言模型的预测机制;外部是否存在一个文件或数据库并不是范围判断的充分条件。与 agent 记忆综述相比,本文解释的是模型怎样实现记忆运算,而非应用如何管理经历。[Sec. II-D,pp. 5–6,Table III;Sec. IV-B,pp. 11–12]
二:方法——用分类轴拆解记忆机制
2.1 三个轴要分别回答
| 分类轴 | 关键问题 | 论文的区分 | 使用时的注意点 |
|---|---|---|---|
| 表示形式 | 是否有独立、可控的存取接口? | 隐式:依附前向计算;显式:专门的存储或更新接口 | 是否是张量、参数或 GPU 内存,不能直接决定类别 |
| 更新动态 | 被讨论的记忆何时发生改变? | 离线:训练/构建时改变;在线:推理时也能改变 | 读取不同条目不等于改变条目;在线也不必执行反向传播 |
| 持续性 | 历史信息在多长范围内仍有效? | 短期:窗口/局部工作记忆;长期:延伸到更长上下文,有时跨会话 | 状态物理存在、历史有影响、事实可准确召回,是不同要求 |
来源:Sec. II-A–C,pp. 2–5。
这里最反直觉的一点是:KV cache 被归为隐式记忆。作者承认注意力是内容寻址的,但强调 cache 的产生、追加和读取由注意力计算规定,缺少脱离当前计算轨迹的独立存储语义。这是本文采用的接口判据;不能把“隐式”理解为它没有真实存储,或者不能按内容检索。[Sec. II-A,p. 2;Sec. III-A,p. 6]
“在线”也不等于在线训练:标准 Transformer 的权重可以完全冻结,但 KV 仍逐 token 追加,因此 Table I 将它列为 Online。反过来,MoE 每个 token 都重新路由,专家权重却不必修改,所以被列为 Offline。[Table I,p. 4]
“长期”在此是有效时间跨度,不统一等于跨会话。Mamba 的固定状态可以汇总很长的输入,故归入长期;这并不自动说明结束一次推理后会保存该状态,或能恢复其中任意旧事实。跨会话保留还需要明确的保存、恢复、更新及重置规则。[Sec. II-C,p. 5;Sec. III-D,p. 9]
2.2 代表方法在框架中的位置
下表精选并重组原文 Table I,保留作者的分类;同一模型含多个组件时,应继续分析各组件。
| 代表机制 | 表示 | 更新 | 持续性 | 真正改变的对象 |
|---|---|---|---|---|
| Transformer KV cache、StreamingLLM | 隐式 | 在线 | 短期 | token KV 集合及其保留窗口 |
| Mamba、Gated Delta Networks、RWKV | 隐式 | 在线 | 长期 | 压缩历史的递归状态 |
| MoM | 隐式 | 在线 | 长期 | 被路由到的多个递归状态 |
| Log-Linear Attention | 隐式 | 在线 | 长期 | 随序列增长的分层摘要 |
| Next-Latent Prediction | 隐式 | 离线 | 长期 | 训练目标对隐藏表示施加的约束 |
| TTT-E2E、Titans、In-Place TTT | 显式 | 在线 | 长期 | 专门承担上下文存储的可写参数 |
| MEMORYLLM(2024) | 显式 | 在线 | 长期 | 前向自更新的潜在记忆池 |
| kNN-LM、Engram | 显式 | 离线 | 长期 | 预构建数据存储/训练所得查表槽位 |
| MoE | 显式 | 离线 | 长期 | 推理时读取的专家参数库 |
| MemoryLLM(FFN,2026) | 显式 | 离线 | 长期 | 可预计算的 token 级 FFN 读取结果 |
这里的两篇 MEMORYLLM / MemoryLLM 不是同一机制:前者是在线更新潜在池,后者让 FFN 读取更接近与上下文解耦的查表。[Sec. IV-B(e),p. 12]
Next-Latent Prediction 的 Offline 指新引入的训练目标,而非模型在推理时不再生成隐藏状态。这暴露出表格使用时的重要要求:先说明正在分类的是“训练干预”“运行时状态”还是“完整模型”,否则相同轴上的标签可能比较了不同层次。[Sec. III-C(g–h),p. 9;本次分析]
2.3 五类更新规则:不只问“什么时候更新”
| 更新机制 | 运算含义 | 代表例子 | 关键失败方式 |
|---|---|---|---|
| 基于优化的写入 | 用损失函数优化专用参数或快权重 | TTT-E2E、Titans、In-Place TTT | 代理目标与最终任务不一致、累计漂移 |
| 状态转移 | 递归、delta 修正、投影或滤波 | Mamba、GDN、Kaczmarz/Kalman 类 | 压缩损失、键之间相互干扰 |
| 信号门控写入/路由 | 用惊讶度、熵、误差或效用控制写入或激活路径 | GDWM、AMOR、HAM | 信号失准、阈值敏感、低估延迟价值 |
| 准入、淘汰与巩固 | 决定保留哪些条目、如何压缩或重写 | StreamingLLM、HAM、Bottlenecked Transformers | 信息被不可逆地删除、保留偏差 |
| 目标诱导/结构性改变 | 用训练目标、层替换、结构安排或离线构建改变记忆行为 | Next-Latent Prediction、Priming、Engram、MoE | 刚性、训练目标错配、测试时适应受限 |
来源:Table II,p. 5;Sec. VI-C,p. 17。
这五类可以叠加。例如,Titans 的梯度写入同时受惊讶信号调制;HAM 同时包含递归状态更新与 KV 准入。作者把它们当作更新轴内的细化视角,没有提出一个与前三轴平行的新分类轴。
2.4 隐式记忆之一:保存 token,再选择读取范围
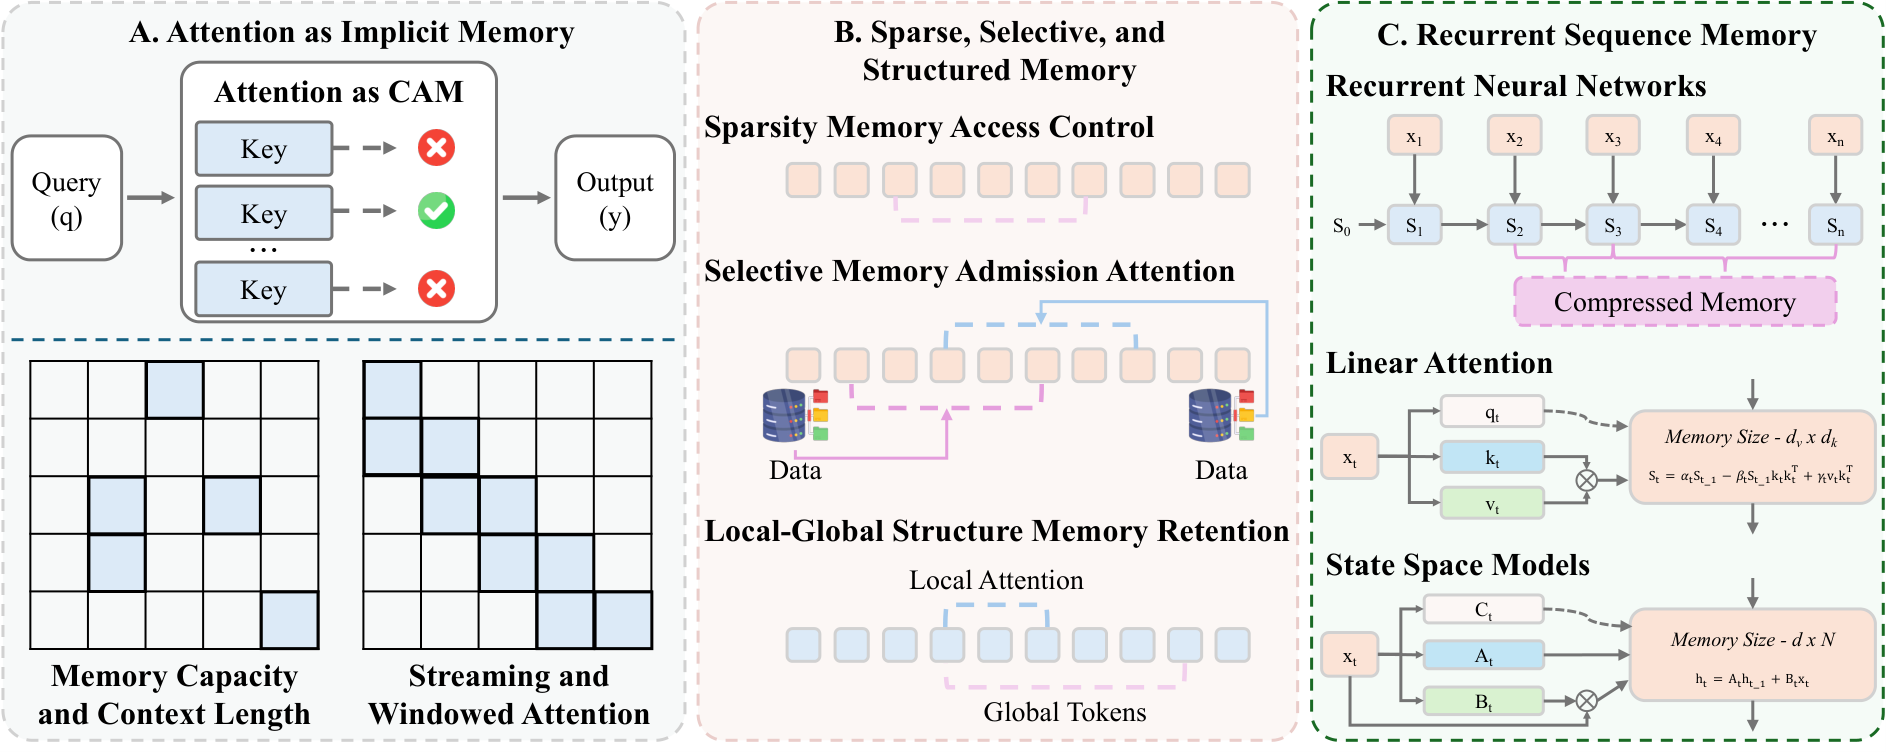
原文 Fig. 3,PDF p. 7。左侧展示注意力、窗口与可访问位置;中间分别对应访问控制、选择性准入和局部/全局保留;右侧展示把历史压入 RNN、线性注意力和 SSM 状态。图中网格表示访问结构,没有实验坐标或性能数值。
为了把图中的动作说清楚,可以用下面的标准注意力表达式作教学说明。它不是本文新增公式:
这里 $q_t,k_i\in\mathbb R^{d_k}$、$v_i,y_t\in\mathbb R^{d_v}$。读取由当前 query 决定,写入则是把新 $k_t,v_t$ 追加到历史。由此可以分清三种优化:
- 压小每条记录:MLA 改变 KV 的存储表示,减少每 token 的存储量。
- 少读一些记录:Sparse Transformer、Longformer、BigBird 用结构化访问;MoBA 按 query 路由到相关 KV 块;NSA 组合压缩摘要、选择块与局部窗口。
- 少保留或重写一些记录:StreamingLLM 保留注意力 sink 与最近窗口;淘汰后的位置不再作为原始 KV 可访问。局部—全局结构则保留少量跨远距离的锚点。
第一种改变记录大小,第二种改变访问集合,第三种改变可用内容。它们可以组合,但“每次少读”本身并不保证“总存储更少”。Selective Attention 的分数调制也要与物理移除 KV 区分;原文 Sec. III-B 主要用它说明信息贡献的选择性。[Secs. III-A–B,pp. 6–8;Sec. V-B,p. 16]
复杂度口径必须分开。 对单层单头、固定维度的普通 KV 表示,存储量是 $\Theta(t(d_k+d_v))$,一步解码扫描历史的注意力工作量随 $t$ 线性增长;处理长度 $T$ 的完整序列时,全注意力的配对运算量是 $\Theta(T^2)$。显式保存注意力分数矩阵时才另有二次规模的矩阵存储。引言把计算与存储一起写成二次增长,Sec. V-B(a) 又明确指出 KV cache 线性增长;阅读和比较时应采用上述拆分。[Sec. I,p. 1;Sec. V-B(a),p. 16;复杂度式为教学展开]
HyperMLP 则提示另一种变化:即便仍把历史放在前向计算中,读取也不必只用概率单纯形上的注意力权重;输入条件化的序列混合可以改变计算几何,而不改变本文所说的隐式存储类别。[Sec. III-A(d),p. 7]
2.5 隐式记忆之二:把历史合并到状态中
用一个从 $M_0=0$ 开始的未归一化线性关联记忆说明压缩过程(教学模型):
展开后,$y_t=\sum_{i\leq t}v_i(k_i^\top q_t)$。相比 KV cache,所有条目的贡献合在同一矩阵里,存储与步数无关;代价是难以再逐条分离。带核特征和归一化分母的线性注意力还需相应统计量,上式只解释最基本的关联写入。
一个碰撞例子。 若同一单位 key $k$ 先写入 $v_1$,再写入 $v_2$,简单叠加会使读取 $Mk$ 得到 $v_1+v_2$。如果目标是保存该 key 的最新关联,delta 更新更直接:
当 $\|k_t\|_2=1$ 时,
$\eta_t=1$ 可在当前 key 方向上替换旧预测;不同 key 若不正交,写入仍可能改变其他关联。这个例子说明为何“更好的写入规则”可以比单纯扩大状态更重要,也解释了原文讨论投影、滤波和通道级门控的动机。它是简化推导,不是某一个 Gated DeltaNet 变体的完整公式。
原文 Sec. III-C(pp. 8–9)的发展脉络可以分成以下几组:
| 改进位置 | 代表工作 | 改变了什么 |
|---|---|---|
| 遗忘与状态动力学 | LSTM、GLA、RWKV-5/6、Mamba/2/3 | 用门控、选择性转移和更丰富状态控制历史如何衰减;Mamba-3 还涉及复数状态与 MIMO |
| 精确编辑当前关联 | GDN、Gated DeltaNet-2、Kaczmarz 类 | delta 修正、分离擦除与写入、按 key 尺度校准投影 |
| 估计质量驱动写入 | Kalman Linear Attention、Gated KalmaNet | 用滤波/在线回归的信息调节状态更新 |
| 更丰富的矩阵变换 | RWKV-7、KDA、DeltaProduct、Comba | 向量门控、对角加低秩转移、多次反射或闭环反馈 |
| 分配更多状态 | MoM、Log-Linear Attention | 多状态路由减轻混写;分层结构让容量随序列长度对数增长 |
| 改变表示训练压力 | Next-Latent Prediction | 用未来潜在状态预测,鼓励保留对未来有用的历史 |
RNN 与 SSM 都是状态记忆,但状态转移的结构约束不同;后者的结构常有利于扫描和并行实现。RetNet 的递归/分块形式以及 Jamba 的注意力—Mamba 交替,则说明状态更新与精细读取可以在同一模型中共存。
固定存储、可处理任意长流、准确记住任意多事实不是同一件事。 例如教学递归 $s_t=\lambda s_{t-1}+u_t$ 中,$u_{t-r}$ 对当前状态的权重为 $\lambda^r$;当 $0<\lambda<1$,它在图上始终有路径,却可能在数值上已很弱。原文据此类压缩问题强调状态容量、保留精度和抗干扰能力的取舍。Log-Linear Attention 和缓存历史状态快照又表明,不能把所有递归记忆都概括成严格常数存储。[Sec. III-C–D,pp. 8–9;Sec. V-B(a),p. 16]
2.6 显式记忆之一:把指定参数或槽位作为可写存储
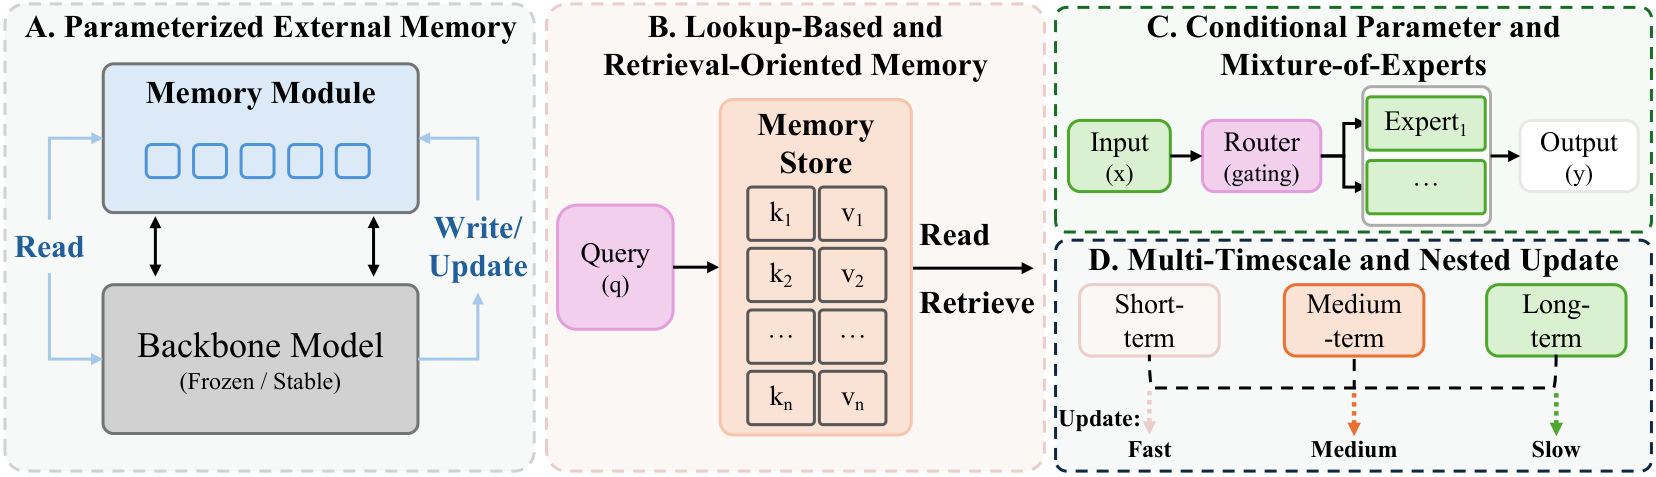
原文 Fig. 4,PDF p. 10。左侧画出 backbone 与专用记忆模块之间的读写;中间是独立 KV 存储;右上为专家路由;右下是不同更新频率。右下的快慢层次是设计示意,具体更新频率与信息寿命仍需分别分析。
快权重的核心不是参数一定要非常多,而是给一部分参数指定特殊角色:慢参数维持一般能力,快参数随当前输入变化,用于存储上下文。早期 fast weights、MANN 和 DNC 为这种分离提供背景,现代工作把它放进大模型与长上下文条件下。[Sec. IV-A,pp. 10–11]
一个通用的教学描述是
$\phi_t$ 是专门的记忆参数,$\mathcal L_{\mathrm{write}}$ 是写入目标,$\eta_t$ 控制更新强度,$r_t$ 是读出的信息。上式不规定先读后写还是先写后读,也省略了动量、门控、遗忘和分块;具体顺序由架构的因果约束决定。
| 模块 | 写入动作 | 架构意义 |
|---|---|---|
| Titans | 惊讶信号驱动记忆参数的梯度更新 | 使写入强度与当前输入的学习信号关联 |
| TTT-E2E | 在整体训练中学习适合推理时更新的机制 | 让部署时的内循环成为训练考虑的一部分 |
| In-Place TTT | 使用现有 FFN 的 down-projection 作为快权重 | 专用记忆接口可以复用原层里的矩阵 |
| GDWM | 按上下文效用门控更新 | 决定哪些片段值得付出写入成本 |
| MEMORYLLM | 前向计算直接刷新潜在记忆池 | 在线写入可以不依赖梯度下降 |
| LM2 | 通过注意力式读取与门控使用专用槽位 | 在层内分出承担记忆角色的工作区 |
来源:Sec. IV-A,pp. 10–11。Table I 将 LM2 的主机制列为 Offline;不能仅凭存在门控,就推断其部署时在优化记忆参数。
TTT 与递归的边界并非由公式外观决定。 对前面的线性记忆取
一次梯度下降恰好给出 delta 更新,因为 $\nabla_M\mathcal L=(Mk_t-v_t)k_t^\top$。在这个条件下,“内循环优化”与“状态转移”描述的是同一计算。原文 Sec. IV-A(c) 也指出,某些带 KV binding 的 TTT 可重写为学习的线性注意力。因此,要说明为什么一个模块被视为显式记忆,还必须说明它有没有独立的写入对象、策略和生命周期;名称里有 TTT 不足以作结论。[p. 11;上述等价式为教学推导]
2.7 显式记忆之二:查条目与调用专家
查表存储把“内容容量”与“每次处理多少内容”分开。 kNN-LM 的 key 是上下文表示,value 是语料中观察到的后续 token;仓库可独立存在,通过近邻检索影响预测。Engram 用结构化哈希访问稀疏槽位,让存储容量可以相对独立于稠密计算规模扩展。PlugLM 让部分 FFN 成为可替换、可更新的 KV 记忆,ExplicitLM 进一步采用可读 token 序列组成的层级记忆库。[Sec. IV-B,pp. 11–12]
这里仍有成本:近邻检索有索引与访存开销,哈希方案有碰撞与地址质量问题,增大的仓库要管理重复、过时条目和增长速度。因此,“一次只查少数条目”并不意味着总存储、带宽与维护成本不随规模变化。
Memorizing Transformers 与 LongMem 被作者放在边界地带:它们确有独立索引和检索,但内容主要来自中间激活。作者认为它们的语义自主性、可编辑性与存储抽象程度,尚不同于专门的记忆库。这也说明本文的隐式/显式区分更像接口连续谱,而不是所有方法都自然落入两个绝不重叠的集合。[Sec. IV-B(b),p. 11]
MoE 存的是可调用变换。 原文唯一的编号公式是
其中 $h\in\mathbb R^d$ 是输入隐藏向量,$\mathcal S(h)\subseteq\{1,\ldots,E\}$ 是 router 选中的专家集合,$g_i(h)$ 是门控权重,各专家输出与 $y$ 具有相同输出维度。与查表读取一个 value 相比,MoE 先选择参数块,再用它计算一个输入相关变换。[Sec. IV-C,pp. 12–13]
原文以 Mixtral 的八专家、每 token 选二为例:总参数容量可以增大,而每 token 只激活其中一部分。这里的“近似保持每 token FLOPs”需要固定激活专家数及专家大小;所有专家的存储、路由通信和负载均衡仍是成本。
将 MoE 归为显式记忆,是作者对“可寻址模块化知识”的解释。它有启发性,但应保留其含义:可路由到一个专家,不自动等于可以定位、编辑或召回一条具体经历。 本文排除普通静态权重、却纳入同样离线学习的专家权重,依赖的正是“是否被分块并条件寻址”这一额外结构判断。[Sec. II-A,pp. 2–3;Sec. IV-C,pp. 12–13;本次分析]
2.8 多时间尺度:控制学习速度,也控制干扰
Nested Learning 将更新频率组织成层次;快部件吸收当前输入,慢部件保留较稳定的知识。与单一“冻结 backbone + 可写记忆”的二分不同,这里可以有多组更新速率。[Sec. IV-D,p. 13]
需要同时规定三个量:多久更新一次、一次更新多强、允许修改多大范围。快更新使模型更容易适应当前输入,也更容易过拟合噪声;慢更新减少覆盖,却可能反应迟缓。固定 backbone 可避免直接改写基础参数,但读取有偏的记忆仍会改变输出,因此不等于消除了记忆自身的漂移。[Secs. IV-D–E,pp. 13–14]
原文还讨论几何受约束的适配,如正交低秩更新与 Muon-OGD:它们帮助理解可写参数如何降低干扰,但主要是更新约束,不因保护旧知识就自动成为一种独立存储架构。类似地,何时重置记忆、如何处理陈旧信息、跨 episode 如何保持一致,都是可写存储需要补上的生命周期规则。[Sec. IV-E,pp. 13–14]
2.9 混合架构:同时决定“放哪里”和“为哪些 token 使用”
原文 Sec. V-A(pp. 14–15)把混合设计推进到资源分配问题。
| 混合方式 | 例子 | 分配决策 |
|---|---|---|
| 固定交替层 | Samba、Jamba、OLMo Hybrid、Kimi Linear | 哪些层使用精细注意力,哪些层压缩状态 |
| 层内混合 | Hymba、Falcon-H1 | 哪些头或通道走不同记忆路径 |
| 从已有模型转换 | LightTransfer、Priming | 选择替换哪些注意力层,并对齐/继续训练 |
| 按不确定性开启计算 | AMOR | 当前输出熵较高时,是否执行注意力细化 |
| 按预测困难保留条目 | HAM | 当前 token 是否进入稀疏 KV cache |
| 隐式计算加显式模块 | Titans、Engram 类架构 | 如何融合工作记忆与可写参数/查表内容 |
| 多部件与跨度扩展 | Hydra、Expansion Span | 组合状态、注意力、专家、工作区或超窗口检索 |
AMOR 与 HAM 特别值得区分:前者门控是否计算注意力细化,后者门控是否存入高保真 KV。省计算和省存储分别发生在不同决策点。一个概念性的混合数据流是“所有 token 更新压缩状态,部分 token 进入精细缓存,当前 query 按需读取”,但具体读写时序仍由对应模型规定。
这种分工也带来新瓶颈:目前的低熵、低误差不保证未来无用。若一个平常的名字稍后成为关键证据,靠局部惊讶度做准入可能提前丢掉它。原文把校准、延迟相关性和不可逆淘汰列为更新规则的核心难点。[Table II,p. 5;Sec. VI-C,p. 17]
2.10 系统优化改变的层次各不相同
| 技术 | 主要改变 | 记忆语义上的含义 |
|---|---|---|
| KV 量化/低秩压缩 | 每条记录的位数或表示维度 | 以表示误差换容量/带宽 |
| PagedAttention | 逻辑 KV 到物理块的分配 | 减少碎片、支持复用,本身不增加事实保留能力 |
| 窗口/稀疏全局连接 | 保留或访问哪些位置 | 改变信息可达性与局部/全局分工 |
| Memory Caching | 保存片段级递归状态快照 | 在单个压缩状态与逐 token KV 之间增加存储层次 |
| Bottlenecked Transformers | 周期性加工或重写 cache | 对工作记忆做巩固;本文仍将它靠近隐式短期记忆 |
来源:Sec. V-B,p. 16。吞吐与批大小的改善可以使更多上下文实际可用,但需要与表示能力的提升分别解释。
三:证据与评测——怎样判断一个模型真的“记住了”
3.1 原文证据的组织方式
论文围绕已有工作建立概念对应,未把各方法放进相同数据、模型规模、训练 token 数和硬件预算下重跑。因而本篇支持的主要结论是“机制如何关联、怎样比较”,不是“哪种记忆总体最好”。例如关于 Samba、kNN-LM 或 Titans 效果的描述,是对对应研究的定性归纳;文中没有提供足以直接计算它们之间相对提升的共同分数表。
3.2 评测任务与它们能观察的行为
| 原文讨论的评测 | 主要观察什么 | 分析时应看什么 |
|---|---|---|
| Needle-in-a-Haystack | 从大量干扰中找回目标事实 | 目标位置、序列长度、检索成功率 |
| RULER | 随上下文长度变化的有效利用能力 | 各任务与长度上的退化曲线,而非标称窗口 |
| LongBench、L-Eval、∞Bench | 长上下文理解与任务表现 | 检索、整合、生成等任务应分别解释 |
| SCROLLS、NarrativeQA 类任务 | 跨远距离证据组织与推理 | 失败来自没有保存、没有找到,还是没有推理出来 |
| 干扰、遗忘与持续学习诊断 | 新信息写入后旧内容是否保持 | 间隔、干扰强度、更新前后表现与跨 episode 一致性 |
| 资源曲线 | 质量与存储/计算的交换关系 | 固定资源下的质量,或固定质量下的资源需求 |
来源:Sec. V-C,pp. 16–17;∞Bench 亦见 Sec. III-A,p. 7 与 Fig. 2。原文未统一规定这些基准的计分细节,因此不能把每个任务的分数当作同单位的“记忆容量”。
困惑度下降与旧事实召回改善不是同一个测量。 困惑度反映平均预测质量,方向越低越好;召回准确率反映所问内容是否恢复,通常越高越好。一个模型可以学到更平滑的分布,却丢掉罕见的精确信息。相反,保留更多 KV 可能改善精确召回,却因存储或带宽而增加服务成本。[结合 Secs. III-D、V-C 的分析]
3.3 将原文建议落成一个可比较协议
下面是本次分析提出的评测设计,不是作者已经执行的实验。
- 写入与读取分开控制。 先给出一组 key–value 事实,在不同间隔后查询;分别增加事实数、相似 key 数和无关干扰。
- 明确更新语义。 区分“回忆所有出现过的值”和“读取最后一次有效修改”。追加、覆盖、纠错对应不同目标。
- 控制生命周期。 在连续流、片段边界、保存后重新加载三种条件下分别测量;记录哪些状态会被重置。
- 按目标选择基线。 全注意力提供细粒度参考,固定状态递归提供压缩基线,混合模型检验资源分工;对显式写入再加入关闭更新或关闭检索的对照。
- 比较资源曲线。 同时记录总存储、峰值显存、prefill/decode 延迟、吞吐与写入成本。TTT 要计入更新计算及必要优化器状态,查表要计入仓库和检索,MoE 要分开总参数与激活参数。
可以用教学记号 $A(\Delta,I,B)$ 表示在查询间隔 $\Delta$、干扰强度 $I$、资源预算 $B$ 下的召回准确率。观察这一曲面,比只报告一个“支持多少 token”的数字更能对应原文提出的容量、保真度、持续性、抗干扰和效率。
四:主要结论及其解释边界
4.1 存储量与有效记忆之间隔着读取和更新
注意力窗口扩大、专家数量增加、查表仓库变大,分别扩大了不同资源,但都要经过读取机制才能影响答案。原文的统一贡献,是让人同时检查存储载体、访问路径与更新政策,而不把资源容量直接当作能力。[Secs. II、V-C]
4.2 写入规则决定了压缩记忆是否有用
递归模型的改进不只在“线性复杂度”,更在于如何擦除、覆盖、校准和分配状态;显式模型也不只在“有一个库”,更在于什么值得写、如何避免漂移、怎样让旧内容持续可用。Table II 把这两条路线接在同一组操作问题上,是全篇最便于迁移到新论文的部分。
4.3 混合设计把问题转为有限资源的分配
细粒度 KV、压缩状态、可写参数和静态库具有不同成本和失真方式,组合它们有结构上的动机。作者进一步从固定层比率走向按 token 的存储与计算决策,AMOR 与 HAM 是这条思路的清晰例子。[Sec. V-A,pp. 14–15]
这是一条由已有设计支持的研究方向;本综述没有给出证明某种组合在所有预算上占优的统一实验。真正需要比较的是同等成本下的召回与干扰表现,以及控制器是否确实节省了端到端资源。
4.4 分类框架仍需要更明确的操作判据
有三点会影响如何使用这份分类:
- 隐式/显式的边界带有接口判断。 KV 也按内容读取,MoE 也通常只做普通前向计算;TTT 还可能等价于递归。应列出具体寻址、更新与维护权限,而不是只贴标签。
- 更新轴有时混合了干预层次。 Next-Latent Prediction 的 Offline 描述训练目标,Mamba 的 Online 描述状态演化。对比时最好把“机制参数如何训练”和“运行状态如何更新”分开记录。
- 长期标签的尺度较粗。 原文 Sec. II-C 用有效历史跨度定义长期,Fig. 2 与部分 Sec. IV 文字又强调跨上下文/会话保留。实际读模型时应继续写明重置边界、保留时长和召回精度,避免把类别名当作能力保证。
这些问题不妨碍用它整理机制,但说明本文是概念框架,而非已经完成形式化证明的互斥分类理论。[Secs. II-A–C、III-C、IV-A–C;本次分析]
五:结论与研究启发
这篇综述最值得带走的习惯是:每遇到一个新的 memory 模块,画出它的存储对象、读路径、写路径和重置边界,再讨论效率与能力。 三轴帮助定位,五类更新规则帮助解释计算,评测曲线帮助判断是否真正解决了任务。
原文 Sec. VI(pp. 17–18)的六个方向可以对应到具体问题:
| 方向 | 尚待解决的问题 |
|---|---|
| 统一理论 | 如何共同度量保真度、干扰与压缩,而非只数 token 或参数? |
| 持续/终身参数记忆 | 怎样积累新知识,同时维持旧能力及稳定更新? |
| 可靠且可解释的写入规则 | 惊讶、熵、误差何时能预测未来价值;错误写入如何诊断或修正? |
| 自适应记忆分配 | 什么信息应留 KV,什么应压缩,什么值得写入长期库? |
| 硬件与算法协同 | 如何把访问频率与 GPU/加速器的存储层次和带宽匹配? |
| 多维度评测 | 如何分别测量保存、找回、抗干扰、持续性以及成本? |
对于线性注意力、TTT 和混合架构研究,一个直接的后续问题是:当压缩状态自认为已经学会一条信息时,我们是否仍该为未来精确查询保留它? 这把状态更新、缓存准入和延迟价值放到同一个可检验的问题中,也连接了本文的机制分类与评测议程。