RIS-Kernel:中文精读笔记
论文:RIS-Kernel: A Model-Agnostic Architecture for Long-Context LLM Inference via Sparse Attention
作者:Anderson R. Santos,Federal University of Uberlândia(UFU)
版本:arXiv:2607.21927v1,2026-07-24 提交;本次获取与研读日期:2026-10-01
材料:arXiv 摘要 · 原文 PDF · 作者主 TeX · 英文汇报 PDF · 可编辑幻灯片
本次阅读覆盖主 TeX 的全部正文、实际引入的 riskernel.bbl、9 幅图、5 张表以及 PDF 第 20 页补充表。已用同版本的 20 页 PDF 核对身份、页码和关键图表。以下页码均为从 1 开始的 PDF 页码,与印刷页码一致。原文以 CC BY 4.0 发布;图件保留作者原图,来源见图注与 图件记录。这是原文分析与数值核查,未重新运行模型实验。
论文总览
RIS-Kernel 中的 RIS 是 Reduced Interaction Sampling(交互缩减采样)。它希望让已有语言模型在 CPU 上处理长文档:运行时替换注意力实现,将局部窗口、开头锚点、多个随机稀疏视图组合起来;生成时把选中的 KV 索引去重合并,再用一次统一 softmax 计算注意力。权重不变,扩窗时另外调整 RoPE。
最有证据支持的结果是:在作者构造的小型科学文档选择题基准上,Qwen2-1.5B 可以通过这套实现完成 32k/64k 上下文推理;若选择合适的稀疏参数和 YaRN,部分配置优于无上下文回答。32k 的 Stochastic 最佳值为 24/32,dense 为 23/32;64k 的 Structural 最佳值为 42/64,无上下文为 33/64。
阅读时必须保留三个限定:其一,seed 集成会扩大实际索引并集,1% 采样密度不等于最终只计算 1% 的注意力;其二,正文承认保留 $O(T^2)$ 的布尔矩阵,现有描述不足以推出完整实现具有 $O(T\log T)$ 时间复杂度;其三,32k 的 Structural 数据在正文/表 5 与图 1–3 之间不一致,64k 的主要显著性结果也仅为作者报告的 $p=0.078$。因此,应把它理解为值得分析的 CPU 推理工程方案和初步实证,而不是已经确立的普适复杂度突破或稳定超越 dense 的结论。
结构地图
原文先写结果,再讨论,最后介绍方法。理解时建议先读第 4 节,再返回第 2 节。
| 原章节与标题 | 作用 | PDF 页码 / 证据 |
|---|---|---|
| 1 Introduction | CPU 长上下文动机与三项工程问题 | 1–2 |
| 2.1 Hardware Profiling and Reproducibility Baseline | 两台 CPU 机器、内存与线程瓶颈 | 2 |
| 2.2 Empirical Evaluation | 四篇科学文档的上下文构造 | 2 |
| 2.2.1 Experiment A: Controlled Precision Comparison (32k Window) | 原生长度下与 dense 比较 | 3;图 1–3 在 3–4;表 5 在 20 |
| 2.2.2 Experiment B: Scalability and Extrapolation (64k Window) | 超过原生长度时的检索 | 4–5;图 4 |
| 2.2.3 Ensemble Coverage Analysis | seed 并集覆盖概率 | 5–6;式 (1)、图 5 |
| 2.3 RoPE Scaling: Linear versus YaRN | 位置编码比较的总述 | 6 |
| 2.4 Linear Interpolation: Positional Dilution and Cognitive Collapse | 线性缩放失败现象 | 6–7 |
| 2.5 YaRN: Preserving Positional Geometry Under Extrapolation | YaRN 结果、TinyLlama 边界 | 7–8;表 1、图 6 |
| 2.6 Stochastic versus Structural Performance Comparison | 两种采样几何的取舍 | 8–9;表 2、图 7 |
| 2.7 Sweet-Spot Analysis: Sub-1% Structural Density at 64k | 0.1%–0.9% 的参数扫描 | 10;表 3 |
| 2.8 Cross-Document Synthesis: Qualitative Validation | 两文档综合生成 | 10–11;表 4 |
| 3.1–3.5 Discussion | dense 对照、参数记忆假说、扩窗、稀疏模式与硬件解释 | 12–14 |
| 4.1 Memory-Bounded Geometry Generation | 流式合并 seed 掩码 | 14;图 8 |
| 4.2 Sampling Modes: Stochastic and Structural | 随机全局采样与局部 clique | 15 |
| 4.3 Hybrid Anchor and Pre-Fusion Unified Softmax (PFUS) | 缓存索引并集与统一归一化 | 15–16;图 9 |
| 4.4 Dynamic RoPE Scaling | 运行时调整 RoPE | 15 |
| 4.4.1 Benchmark Design and Multi-Stage Validation | 选择题评分与配对显著性 | 15–17 |
| 4.4.2 Ensemble Stochastic Projection and Retrieval Coverage | 局部窗口、锚点与多次出现的命中概率 | 17 |
| Declarations / References / Supplementary Information | 数据入口、参考文献和 32k 补充结果 | 17 / 18–19 / 20 |
一:动机——保留文档信息,同时减轻注意力开销
对于长度为 $T$ 的输入,显式计算全部 query–key 交互需要二次数量级的配对。论文关注的使用情景是:研究者有普通 CPU 服务器和大量科学文本,希望直接把资料交给已有小模型,而不重新训练权重。
减少交互会带来三种风险。第一,随机采样可能漏掉远处的关键实体;第二,把局部和随机部分分别归一化后粗略混合,可能改变不同 token 的相对权重;第三,即使选中了正确内容,模型的位置编码也可能无法在训练长度之外正常工作。RIS 分别以多 seed 覆盖、PFUS 和动态 RoPE 缩放应对这些问题。[Sec. 1,PDF pp. 1–2;Sec. 4,pp. 14–17]
“不改权重”是这项工作的明确边界:改变的是推理时允许哪些注意力连接、如何合并这些连接,以及超长输入的位置映射。论文中的“model-agnostic”主要是实现接口层面的目标;实证主体是 Qwen2-1.5B,另有 TinyLlama 的负面结果和 Qwen2.5 的定性生成,尚不能据此保证任意模型、任意任务都保持精度。
作者把 65,536 token 和 dense 的内存失败写得接近普遍硬件边界,但实际证据来自其特定实现与测试机器。该长度不是由二次复杂度单独决定的通用上限;“本次 dense 运行 OOM”也不是“所有 dense 实现都无法运行”的证明。
二:方法——多个稀疏视图先合并,再计算注意力
2.1 符号与整体数据流
原文把 $N$ 同时用于序列长度、seed 数和题数。为避免混淆,下面用 $T$ 表示序列长度、$S$ 表示 seed 数;在介绍原式时给出对应关系。
| 符号 | 含义 |
|---|---|
| $T$ | 输入序列长度,主实验为 32,768 或 65,536 |
| $S$ | 用来生成采样几何的 seed 数;原式 (1) 中写作 $N$ |
| $d$、$q$、$\rho$ | 原文不同位置使用的采样密度记号;需区分单视图预算与并集后的密度 |
| $L$ | 密集局部滑动窗口,原文指定为 1,024 token |
| $B,B_{max}$ | Structural 模式的块大小及其上限 |
| $Q,K,V$ | 每个注意力头的 query、key、value;头维度以下记为 $D_h$ |
| $U$ | 独立随机视图的期望并集覆盖比例 |
| $k$ | 某个目标内容在序列中出现的次数 |
整体流程为:加载已有模型并替换注意力方法 → 根据目标长度选择 RoPE 缩放 → 建立局部窗口和全局锚点 → 流式生成多个 seed 的稀疏几何并合并 → prefill 使用合并后的掩码 → 单 token 生成时缓存随机锚点,合并动态局部窗口,抽取相应 KV,统一计算 softmax。原文没有报告重新训练或微调。[Sec. 4.1–4.4.2,PDF pp. 14–17]
2.2 流式掩码:节约同时驻留的副本
每个 seed 单独生成随机索引,施加因果约束,将结果加入主掩码与生成索引结构,然后释放临时对象。因此不需要同时保存 $S$ 个完整 seed 掩码。
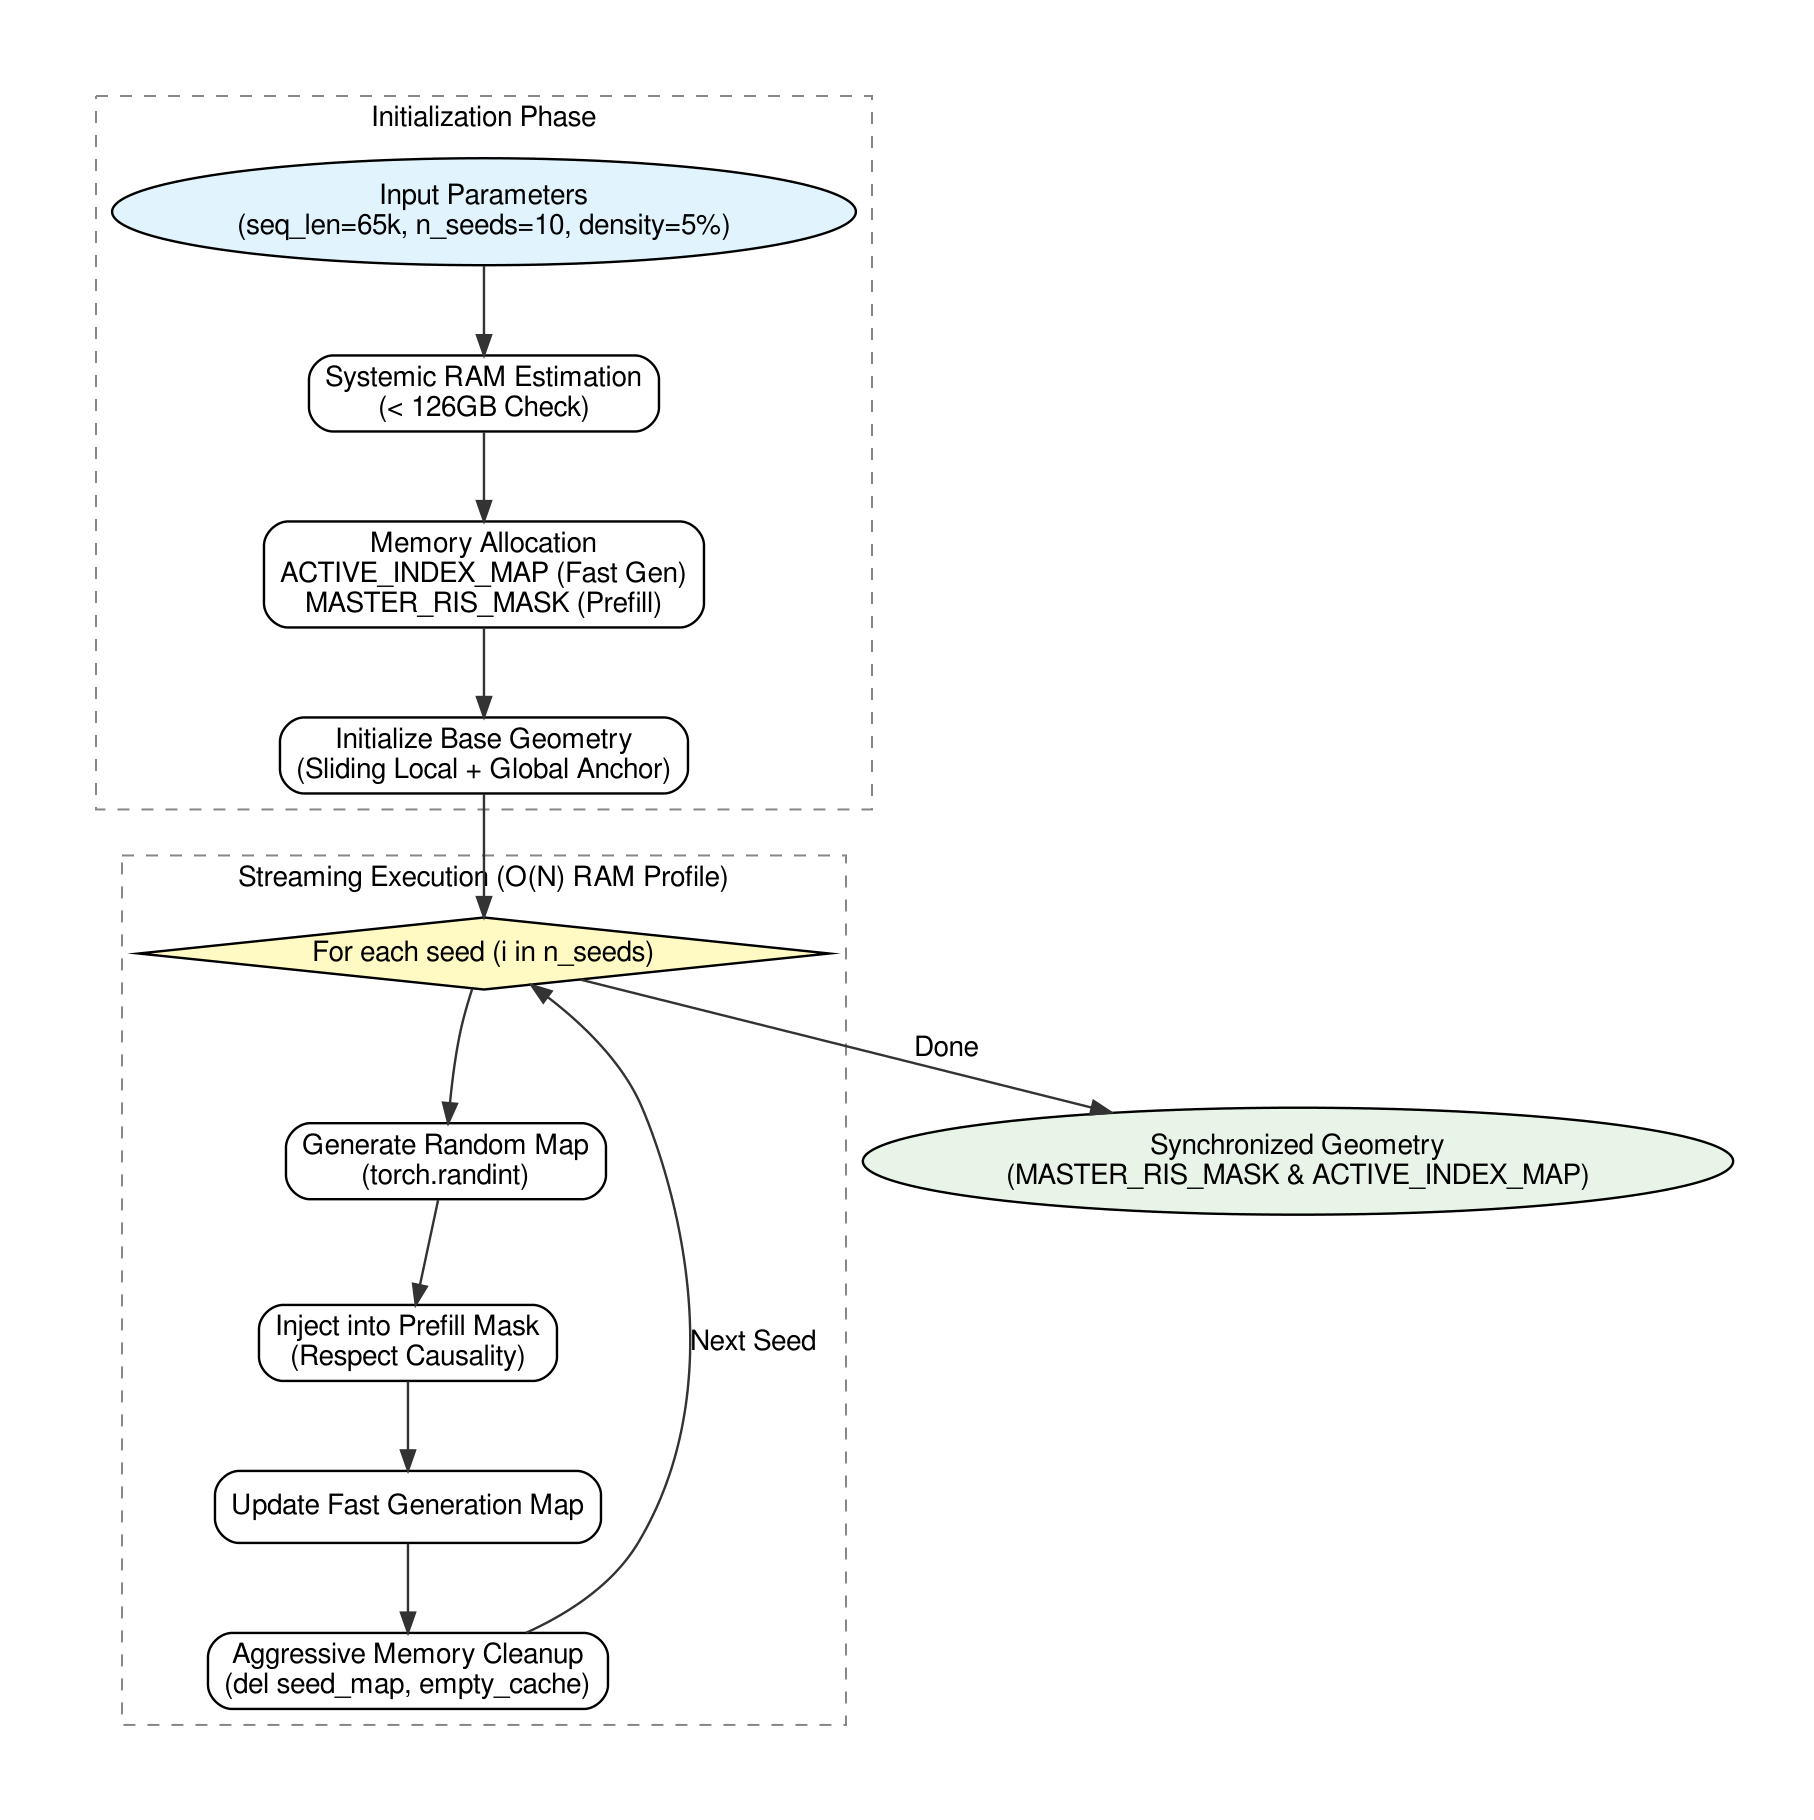
来源:原图 8,PDF p. 14。阅读顺序是初始化主结构、循环生成 seed、注入主掩码、更新生成索引、释放临时内存。图中循环框写有 “O(N) RAM Profile”,但图注和正文明确写峰值包含 $O(N^2)$ 布尔矩阵;不能把框内标签当作整套算法的线性空间保证。
本次推导:若布尔值占 1 字节,$65,536^2$ 个元素就是 4 GiB;10 份这样的矩阵约为 40 GiB。逐 seed 合并能消除临时掩码副本数带来的倍数,却不会消除主矩阵本身的二次规模。Sec. 4.1 所称初始化开销“不随序列长度变化”与其随后承认的二次矩阵并不相容。内存峰值、初始化总时间和最终索引规模也应分别测量。
2.3 Stochastic 与 Structural:相同名义预算,不同连接偏好
Stochastic:为每个 pivot 从全序列均匀抽取全局邻居,用多个 seed 降低漏选概率。因果过滤后只能保留允许访问的位置。
Structural:先把序列划分为局部块,在块内建立 clique,再补充随机全局连接。原文给出
作者声称先从总预算扣除 clique 的成本,再分配全局随机连接,从而与 Stochastic 保持预算一致。直觉是:同一实体附近的解释、限定词和关系往往需要一起保留;块内连接把预算集中在这些局部组合上。[Sec. 4.2,PDF p. 15]
但这种保证只覆盖块内允许的连接:它不保证查询一定能访问任意远处的答案,不保证跨块实体关系完整,也不保证答案必然正确。原文 Sec. 2.6 关于“保证 ground-truth anchor 邻域”的表述应据此收窄。
此外,局部窗口 $L=1024$ 和开头锚点还会带来基础连接。以 64k 最后一个 query 为例,仅最近 1,024 个 token 就约占完整历史的 1.56%。原文对这些基础连接是否全部计入报告的 $d$ 缺少统一说明,所以不能把表中的 0.3% 或 1% 当成整个最终注意力图的实测密度。
2.4 Hybrid Anchor:固定随机部分,滑动局部部分
解码时,如果每生成一个 token 都重新计算所有 seed 的索引并集,CPU 上的索引处理会很贵。作者在第一个生成 token 时计算并缓存随机索引并集,称为 Stochastic Anchor;以后每一步只更新局部窗口。两者通过 unique() 去重后,抽取参与本次注意力的 KV。[Sec. 4.3,PDF pp. 15–16]
这里的“ensemble”应主要理解为稀疏连接的并集。方法和图 9 没有描述先独立运行 $S$ 个完整模型,再平均输出或做答案投票。讨论部分使用的“vote”是直觉性措辞,不能据此把开销直接写成 $S$ 次完整推理。
缓存也存在设计取舍:随机锚点冻结后,新的 query 主要依靠原来的远程连接和动态局部窗口。论文没有单独消融长时间生成中这种固定索引策略的质量影响。
2.5 PFUS:对所有选中 token 做一次 softmax
PFUS 全称 Pre-Fusion Unified Softmax,可理解为先融合索引、再统一归一化。
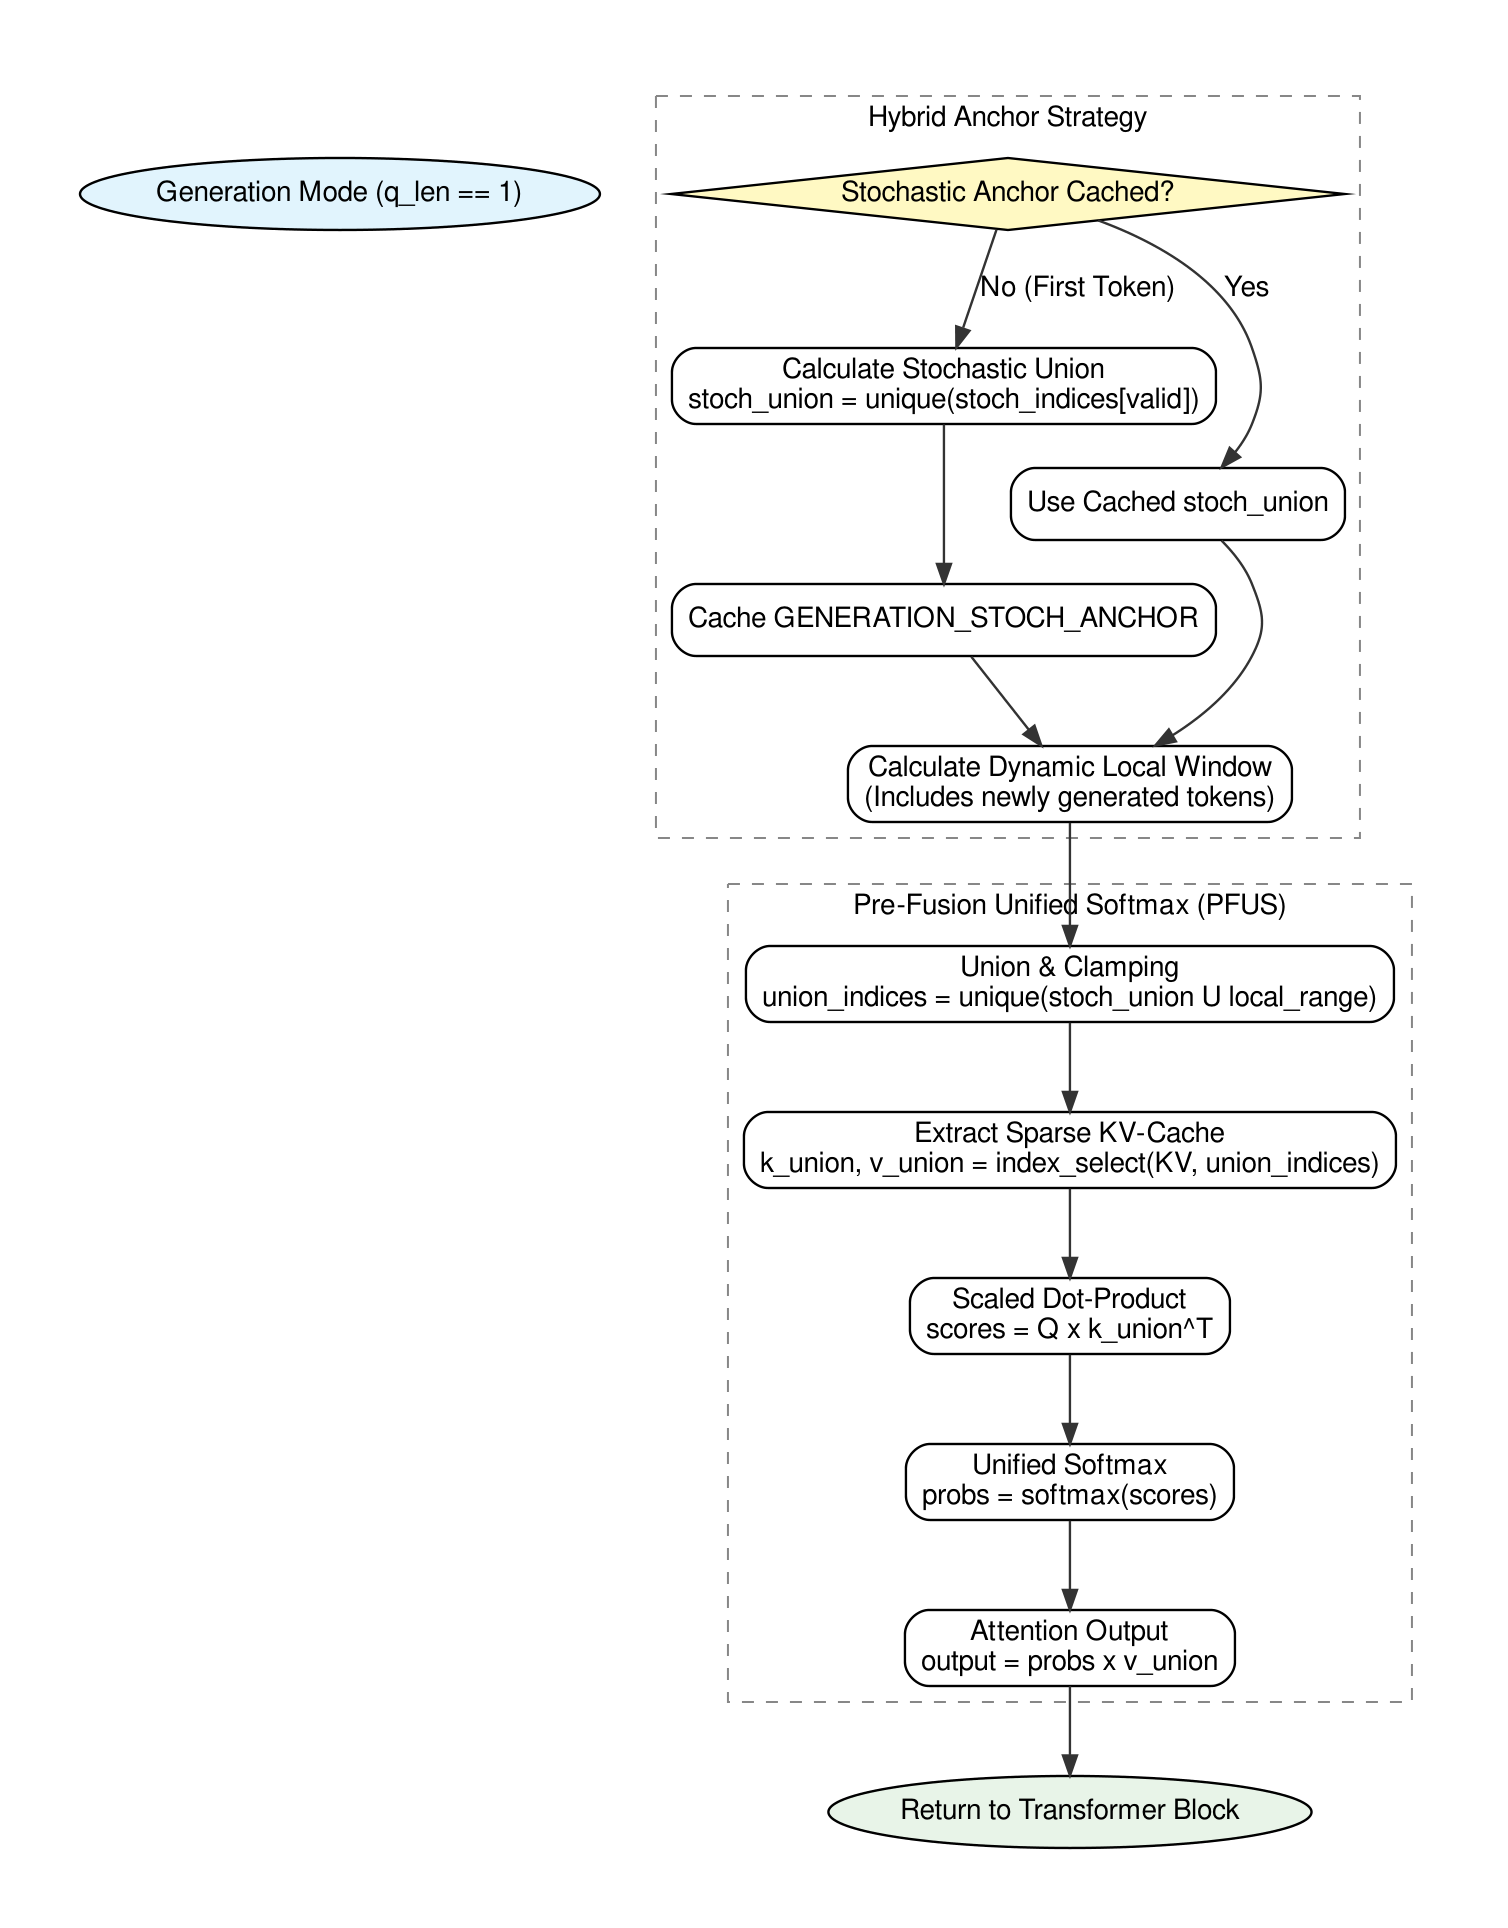
来源:原图 9,PDF p. 16。上半部分决定随机锚点是否已缓存;下半部分取索引并集、抽取 KV、计算分数、统一归一化,最后返回注意力输出。
用本次教学记号表达,令 $\mathcal I_t$ 为该步合并、去重、过滤后的索引集合,则
这是根据 Fig. 9 写出的标准缩放点积注意力表达式,并非原文另一个带编号公式。$q_t,k_j\in\mathbb R^{D_h}$,$v_j$ 为对应 value。参与注意力的集合变小,但各 token 在同一个分母下竞争。
教学例子:假设全局组只有一个 token,分数为 3;局部组两个 token,分数均为 0。统一 softmax 给全局 token 的权重约为 $e^3/(e^3+2)=0.909$。若先分别归一化,再把两组各赋 1/2 权重,它只有 0.5。这说明固定混合权重会改变竞争关系。
不过,“分别归一化”并非必然丢失正确权重:如果同时保存各组的 softmax 分母,并按分母比例精确合并,也可恢复统一结果。PFUS 的优势在于直接采用一个归一化域;论文没有提供移除 PFUS 或采用精确分组归一化的独立消融,不能量化它对最终准确率的单独贡献。
2.6 覆盖概率:回答“选中没有”,不回答“答对没有”
原文式 (1) 为
其中 $N$ 在该式中是 seed 数,本笔记记作 $S$。推导是:每个视图漏掉给定目标的概率为 $1-d$,独立 $S$ 次均漏掉的概率为 $(1-d)^S$,取补集即可。Sec. 4.4.2 又给出一个目标出现 $k$ 次时的命中概率
这一扩展还假定不同出现位置的命中事件可按独立机会处理。共享 clique、因果过滤和去重可能使这种近似偏离真实几何。[Sec. 2.2.3,式 (1),PDF pp. 5–6;Sec. 4.4.2,p. 17]
| 单视图密度 $d$ | seeds $S$ | 按独立假设计算的 $U$ |
|---|---|---|
| 1% | 10 | 9.56% |
| 1% | 70 | 50.52% |
| 1% | 100 | 63.40% |
| 5% | 10 | 40.13% |
| 5% | 40 | 87.15% |
| 5% | 70 | 97.24% |
这些值是根据原式重算的期望覆盖率,不是性能实测或整体 FLOPs 比例。覆盖率随 seed 增加单调上升,边际增益递减;准确率不受这一数学性质保证,因为被加入的 token 可能有用,也可能成为干扰。作者把高密度退化解释成“噪声被重新引入”,与若干现象相容,但没有通过干扰项干预实验建立因果关系。
2.7 复杂度应怎样理解
以下是基于论文所述数据结构的读者分析,不是作者已经证明的定理。
若每个 query 最终保留 $r(T)$ 个 key,理想的稀疏点积与聚合约为 $O(T\,r(T)\,D_h)$。要在固定头维度下得到 $O(T\log T)$,必须约束 $r(T)=O(\log T)$,并确保索引构造和执行内核也不引入更大成本。
若按固定密度采样,并用 $U=1-(1-d)^S$ 描述并集,则预期连接数约为 $T^2U$,因果三角区只改变常数。固定非零 $d$、固定 $S$ 时,$U$ 为常数,仍是二次量级。只有当有效密度随长度缩减到 $O(\log T/T)$ 等适当规模时,才可能得到所称的次二次算术量。
还需要分开考察三个层次:
- 逻辑连接数:掩码有多少允许的 query–key 配对。
- 执行算术量:若仍先做 dense 矩阵乘法再掩码,逻辑稀疏不会自动减少矩阵乘法成本;原文不足以证明 prefill 每一环节都跳过了未选中配对。
- 存储与端到端耗时:主布尔掩码仍为 $O(T^2)$;全模型还包含投影、MLP、KV 缓存和索引合并等成本。
因此,可以确认“流式处理减少 seed 临时副本”和“解码时按索引抽取 KV”的设计;不能由固定 1% 密度或一张流程图确认完整推理的 $O(T\log T)$。原文也没有给出可验证该渐近主张的系统长度—时间/FLOPs 曲线。[Sec. 3.4–3.5,PDF p. 13;Sec. 4.1–4.3,pp. 14–16]
2.8 动态 RoPE:选中的内容还要有可用的位置表示
RIS 根据目标窗口与原生窗口之比配置位置缩放,提供 linear 与 YaRN。线性插值统一压缩位置尺度,YaRN 则按频带处理。它们会改变旋转后的 query/key 所形成的注意力分数,所以“采样机制与位置编码模块分开”不等于“质量与位置编码无关”。64k 对 32k 是 2 倍扩展。[Sec. 4.4,PDF p. 15]
论文的实证支持“本次设置中 YaRN 比 linear 好”,但没有逐项测量所谓位置相干性;“失败完全位于 RIS 上游”仍是作者解释,尚未通过完善的控制实验排除采样、任务和实现因素。
三:实验——两个选择题阶段与一个生成阶段
3.1 数据、模型和硬件
上下文由四篇生物学/生物信息学稿件拼接:ajinshanensis(细菌基因组)、aom(厌氧甲烷氧化)、genppi(蛋白互作网络预测)、meta(蜂幼虫食物宏基因组)。拼接前删去引言之前的元数据、标题页、关键词和摘要。[Sec. 2.2,PDF p. 2]
| 项目 | 32k 控制实验 | 64k 扩窗实验 | 跨文档定性生成 |
|---|---|---|---|
| 模型 | Qwen2-1.5B-Instruct | Qwen2-1.5B-Instruct | Qwen2.5-1.5B-Instruct |
| 输入长度 | 32,768 | 65,536 | 22,800–32,400 |
| 任务 | 32 道 A–E 选择题 | 64 道 A–E 选择题 | 四文档的六种两两配对 |
| 输出评分 | 比较选项 log-probability | 比较选项 log-probability | 自由生成与作者定性检查 |
| 无上下文准确率 | 19/32 = 59.375% | 33/64 = 51.5625% | 未报告可比基线 |
| dense 对照 | 23/32 = 71.875% | 作者报告 OOM,无准确率 | 未报告 |
| 主要机器 | i7-3770,16 GB,4 物理核;部分设置改用大内存机 | 双路 Xeon,128 GB,20 物理核 | 同一 Xeon 机器 |
| 位置编码 | 原生长度,缩放因子为 1 | linear / YaRN,因子 2 | linear |
硬件配置按论文报告记录;作者将两台机器分别称为 bioinfo、ibteci。全部实验使用 CPU、Float32。32k 的部分 5% 高 seed 配置在 16 GB 机器 OOM 后转移到 128 GB 机器,表 5 用星号标识。[Sec. 2.1,PDF p. 2;Table 5,p. 20]
作者称答案选项均衡分布,但 32/64 不能被 5 整除,应理解为近似均衡;论文未给出足以在正文中核对每个选项频数的明细。改变窗口时也改变题集,因而两个阶段不是严格“只改变长度”的受控比较。
3.2 指标、对照角色与统计口径
Accuracy,越高越好:每题选择得分最高的选项,统计正确率。它衡量五选一判断,不直接测量自由文本生成质量、证据引用准确率或开放式回答的幻觉率。选项概率的具体多 token 聚合、长度归一化等实现细节,正文未充分报告。
Context gap recovery,越高代表追回更多净差额:32k 下可写为
分母为 $23/32-19/32=4/32$。因此 RIS 答对 22 题就是 $(22-19)/(23-19)=75\%$;答对 24 题就是 125%。这个量是相对于基线的净准确率差额,不是“恢复了多少比例的原文信息”。它也不保证 RIS 与 dense 答对的是同一批题;一题就会改变 25 个 recovery 百分点。
Zero-context 测模型在没有文档时能做多少;dense 是相同模型在完整连接下的经验对照。作者称 dense 为 ground-truth upper bound,但它不是数学上不可超越的准确率上界。64k 没有 dense 结果,所以只能比较绝对准确率及相对于无上下文的百分点变化,不能计算同定义的 gap recovery。
McNemar 配对检验利用同一批问题上两个方法对错不一致的情况;单独的总准确率不足以重算它。下文保留作者报告的 $p$ 值,并不声称已独立重算。网格中许多设置共享同一题集,不能把这些配置视为独立的新增测试样本。[Sec. 4.4.1,PDF pp. 16–17]
四:结果——按原实验分组解读
4.1 硬件与运行代价:能运行,仍然很慢
Sec. 2.1 报告,65k 某配置中 matmul_qk 约 19 秒,matmul_av 约 350 秒;40-seed prefill 内存约 38 GB,更大的集成可能逼近 128 GB。论文没有在这里充分注明上述算子计时的层数/调用聚合口径,不能把它们直接当作完整请求耗时。
过多线程会造成竞争:作者报告 101 线程使 prefill 慢约 6 倍,最后分别使用 4 和 8 线程。对所测 CPU,Float16 的软件执行路径很慢,因此最终采用 Float32。作者据此解释主要瓶颈是内存移动;其硬件诊断有启发,但缺少完整带宽计数和统一端到端基准,不能简单推广为所有设备上的同一瓶颈。
没有 GPU 对比实验,也没有与优化后的 exact attention、其他训练外稀疏方法进行系统延迟/质量比较。论文声称可直接迁移到 GPU 并降低延迟,属于实现预期,不是本篇 v1 已测结果。[Sec. 2.1,PDF p. 2;Sec. 3.5,p. 13]
4.2 实验 A:32k 有可比 dense,但优势只有一题
以下为正文与表 5 报告的关键配置。带“冲突”的 Structural 行不能直接当作已由所有图表交叉验证的数值。
| 配置 | $d$ / $S$ | 准确率 | 正确题数 / 32 | gap recovery |
|---|---|---|---|---|
| 无上下文 | — | 59.38% | 19 | 0% |
| Dense | 100% / 1 | 71.88% | 23 | 100% |
| Stochastic | 1% / 10 | 62.50% | 20 | 25% |
| Stochastic | 1% / 50 | 68.75% | 22 | 75% |
| Stochastic 最佳 | 1% / 70 或 80 | 75.00% | 24 | 125% |
| Stochastic | 5% / 10 | 71.88% | 23 | 100% |
| Structural,图表冲突 | 1% / 10 | 68.75% | 22 | 75% |
| Structural,图表冲突 | 1% / 40 | 71.88% | 23 | 100% |
来源:Sec. 2.2.1,PDF p. 3;Table 5,p. 20。Stochastic 的最佳配置相对 dense 为 $1/32=3.125$ 个百分点,相对无上下文为 $5/32=15.625$ 个百分点。
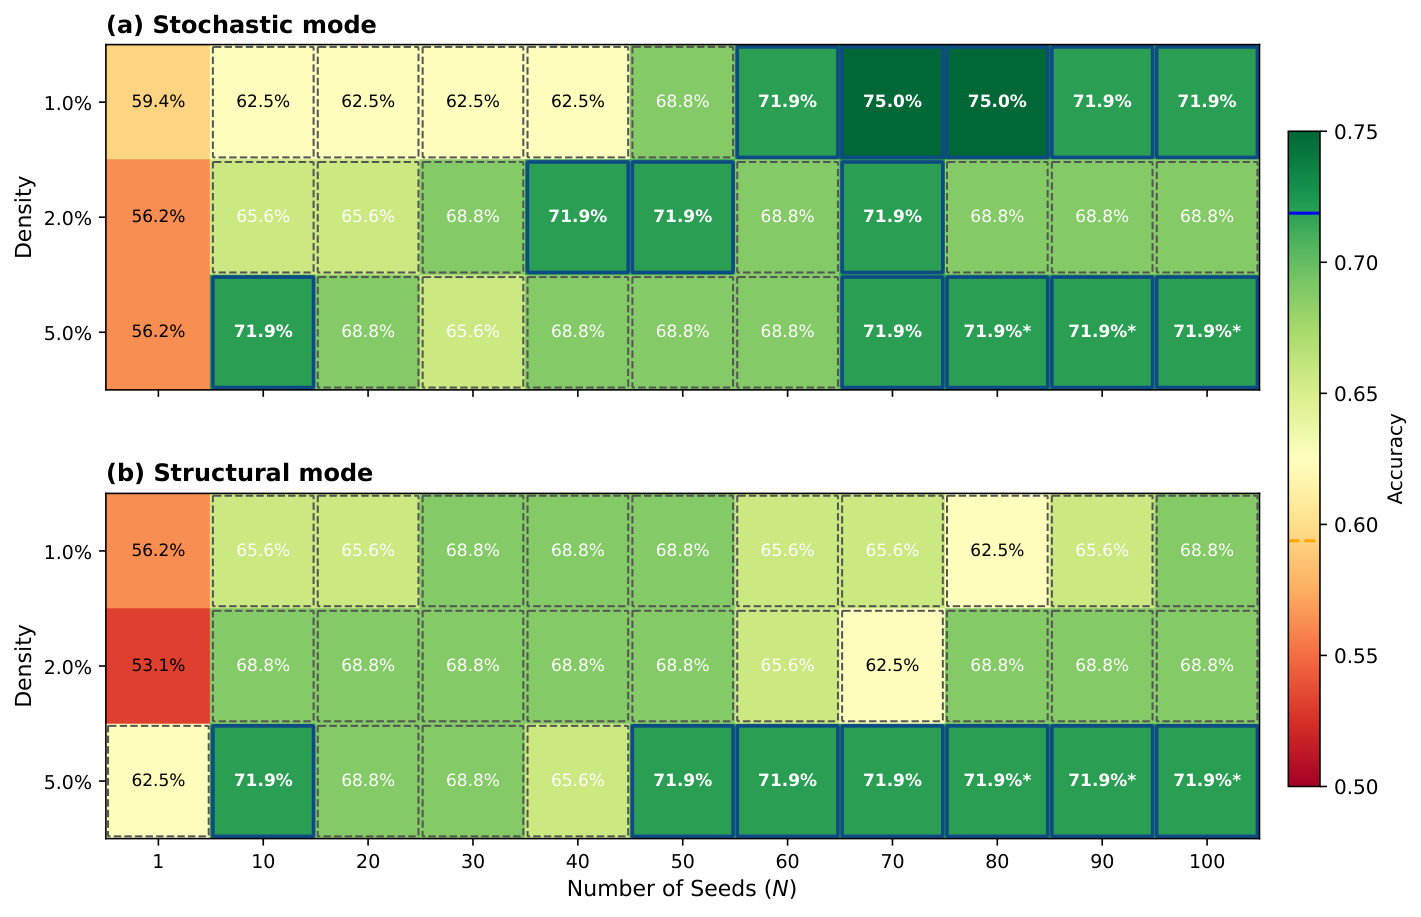
来源:原图 1,PDF p. 3。横轴为 seed 数,纵轴为单视图名义密度,上面是 Stochastic,下面是 Structural,颜色和格内数字表示 accuracy。蓝框标注达到 dense 的设置,星号表示切换到大内存机器。该图用于展示原始证据及其冲突,不能与表 5 无差别混用。
对同一 Structural 1% / 10 seeds,图 1 为约 65.6%,表 5 为 68.75%;1% / 40 seeds,图 1 为约 68.8%,表 5 为 71.88%。图 3 的 1% 和 2% Structural 峰值均为 68.75%,也不支持正文所称在这些密度下达到 71.88%。因此“Structural 只用 10 seeds 就恢复 75% gap”及“40 seeds 达到 dense”必须带上这个未解决的原文冲突。
作者把 75% 的 Stochastic 结果解释为随机稀疏的正则化作用。它是一个合理假说,但小样本、在同一题集上选超参数、缺少对 dense 的直接显著性报告和机制干预,均限制了该解释。原文给出的 $p=0.227$ 比较的是最佳 RIS 与无上下文,并不是 RIS 与 dense;它不支持“统计上显著超越 dense”。
4.3 实验 B:64k 超过无上下文,尚无 dense 质量对照
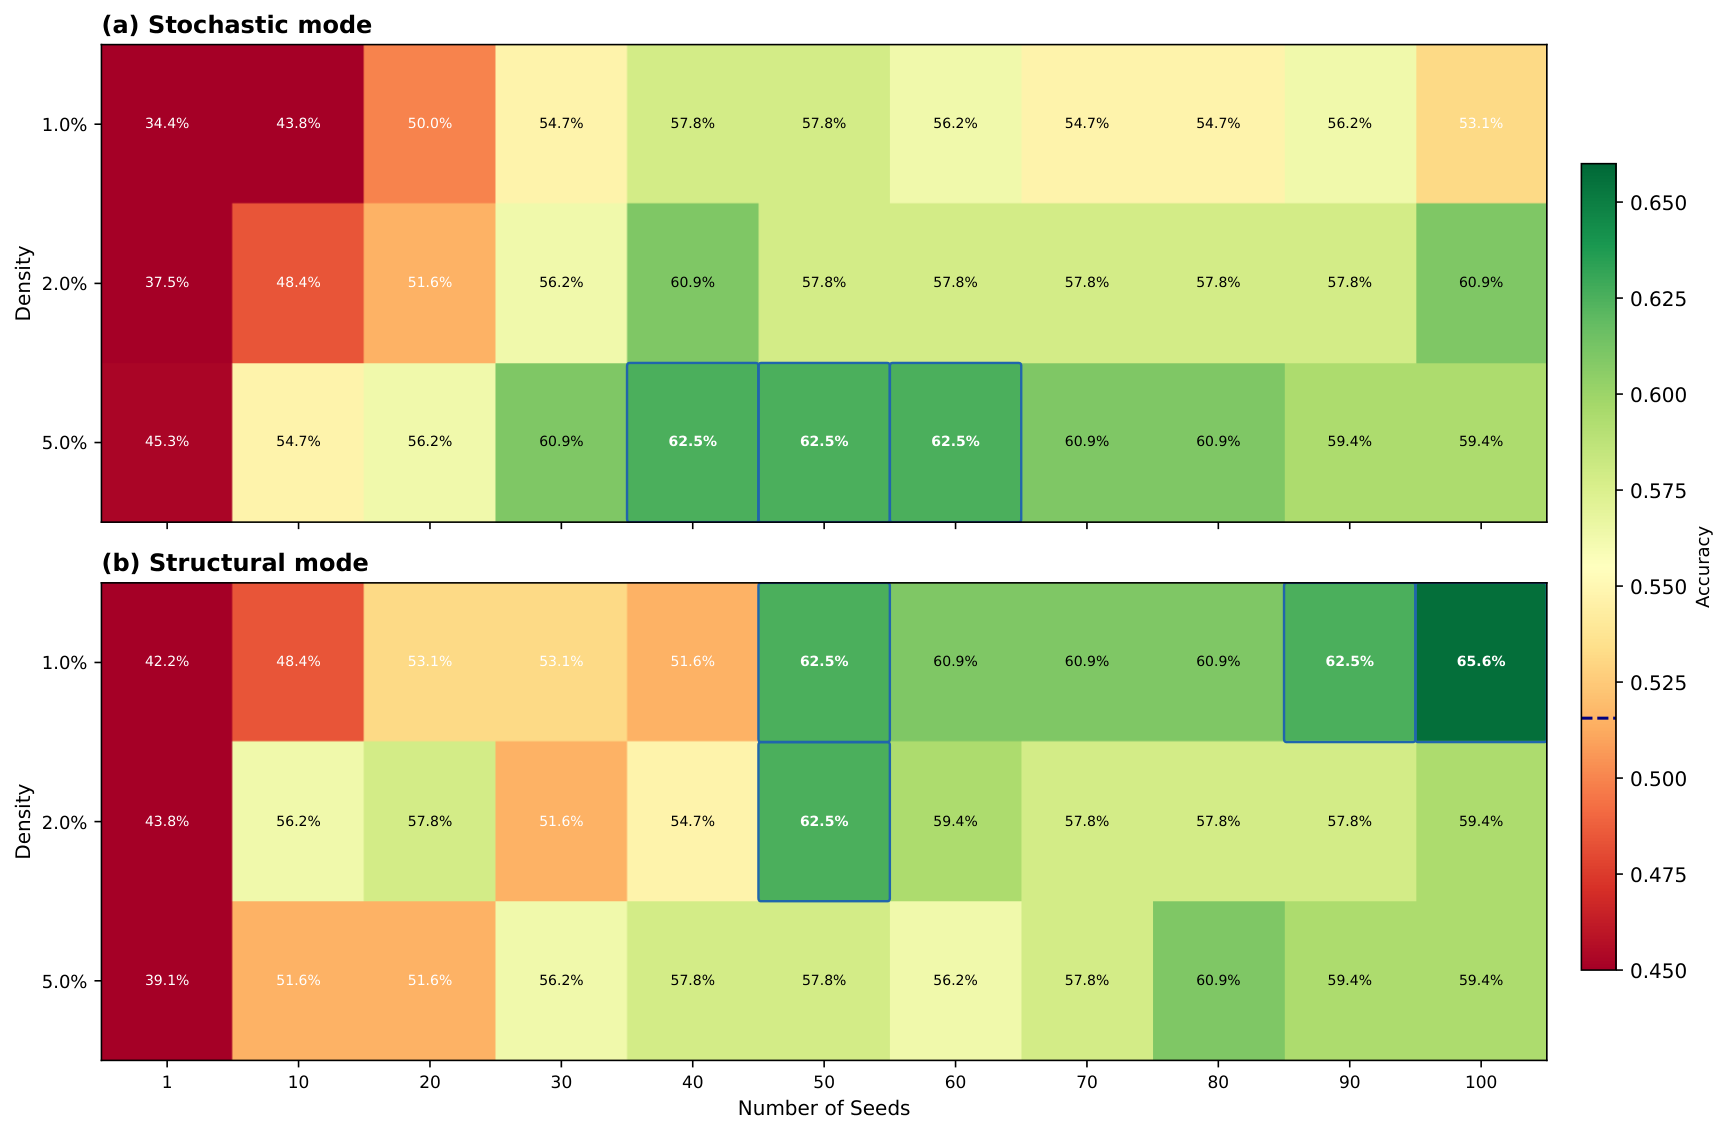
来源:原图 4,PDF p. 5。横轴是 seeds,行分别为 1%、2%、5% 密度;上半是 Stochastic,下半是 Structural。不要只看最高的深绿色格子:低 seed 下不少配置低于 51.56% 无上下文基线,收益依赖预算和采样方式。
| 模式 | 密度 | 跨配置均值 | 中位数 | 峰值 |
|---|---|---|---|---|
| Stochastic | 1% | 52.13% | 54.69% | 57.81% |
| Stochastic | 2% | 54.97% | 57.81% | 60.94% |
| Stochastic | 5% | 58.66% | 60.94% | 62.50% |
| Structural | 1% | 56.53% | 60.94% | 65.62% |
| Structural | 2% | 56.25% | 57.81% | 62.50% |
| Structural | 5% | 55.26% | 57.81% | 60.94% |
来源:Table 2,PDF p. 9。这里的均值和中位数汇总完整的参数配置运行,不是某个固定配置在独立随机重复下的均值与不确定性。
Stochastic 5% 在 40–60 seeds 达到 40/64 = 62.50%,比无上下文多 7 题;Structural 1% 在 100 seeds 达到 42/64 = 65.625%,多 9 题,即 14.0625 个百分点。原文不同位置将 65.625% 写为 65.62% 或 65.63%,这是同一计数的舍入差异。
在固定 1% 名义预算下,Structural 的网格均值比 Stochastic 高 4.40 个百分点;5% 时 Stochastic 的均值反而高 3.40 个百分点。这支持在本基准上考虑“局部结构偏好与全局覆盖”的取舍。它不证明 Structural 在所有紧预算任务中都更优;两模式各自最佳结果之间的配对检验也没有显著差异。[Sec. 2.6,PDF pp. 8–9]
4.4 覆盖率解释与 seed 扩展曲线
Fig. 5(PDF p. 6)在 64k、5% 下画出 accuracy 对 seed 数的变化:Stochastic 从低 seed 上升,在 40–60 附近达到 62.5%,随后略退;Structural 的轨迹有波动,图中 80 seeds 反而高于 40–60 seeds。
这与“更多覆盖有收益,但不保证准确率持续提升”相符。它不足以确立 accuracy 关于 seed 的普遍凹性,也不足以确认高 seed 下降唯一来自噪声。特别是 Structural 共享 clique,不能无条件套用独立随机视图公式来解释整张图的覆盖。
4.5 RoPE 对比:YaRN 的相对优势存在,幅度应按同口径比较
| 密度 | Linear 峰值(seeds) | YaRN 峰值(seeds) |
|---|---|---|
| 1% | 45.3%(50) | 57.8%(40) |
| 2% | 54.7%(50) | 60.9%(40) |
| 5% | 59.4%(40–50) | 62.50%(40–60) |
来源:Table 1,PDF p. 7;该表与 Stochastic 结果对应。每列是各自搜索所得峰值,不是全部严格匹配 seed 数的比较。
单 seed 的 linear 在 1%、2%、5% 下分别为 15.6%、20.3%、23.4%。作者将它们统称“处于或低于 20% 随机水平”不准确,后两个数值略高于 20%。更关键的是,不能把 linear 的单 seed 最差结果与 YaRN 的多 seed 最佳结果相减,称为位置编码的纯收益。
Fig. 6(PDF p. 8)也存在口径问题:图注称每个长度选择最佳配置,但 64k 的 linear 曲线约为 53%,既不同于表 1 的最高 59.4%,也不同于图注重述的单 seed 15.6%–23.4%。本笔记和幻灯片使用表 1 的同类峰值对照,并保留其选择预算不同的限定。
TinyLlama 边界实验:[Sec. 2.5,PDF pp. 7–8]
| 长度 / 相对其 2,048 原生长度 | 题数 | 正确率 | 对应正确题数 |
|---|---|---|---|
| 4,096 / 2 倍 | 4 | 50.00% | 2 |
| 8,192 / 4 倍 | 8 | 12.50% | 1 |
| 16,384 / 8 倍 | 16 | 6.25% | 1 |
| 32,768 / 16 倍 | 32 | 18.75% | 6 |
作者称这些结果对 1–100 seeds、1%–5% 密度均不变,说明增加采样预算在这些设置里没有救回效果。但每个长度的题集不同且很小,又缺少充分匹配的其他对照,所以不能据此建立“所有 2k 小模型超过 4 倍扩窗都会失败”的定律。Qwen2 主实验的 64k / 32k 是 2 倍;p. 8 括号里关于 Qwen2 的 4 倍说法与主设置不一致。
4.6 Sub-1% Structural:绝对准确率保留与净上下文收益保留不同
原文扫描 0.1%–0.9%,每个密度测试 50、100、150、200 seeds。表中 $B_{max}$ 随密度从 66 增至 590。[Sec. 2.7,Table 3,PDF p. 10]
| 密度 / $B_{max}$ | 最佳准确率 | 达到最佳的 seeds | 四配置平均 |
|---|---|---|---|
| 0.1% / 66 | 51.56% | 150、200 | 48.44% |
| 0.2% / 131 | 54.69% | 150 | 51.95% |
| 0.3% / 197 | 59.38% | 150、200 | 55.08% |
| 0.4% / 262 | 59.38% | 150 | 56.25% |
| 0.5% / 328 | 59.38% | 150、200 | 58.20% |
| 0.6% / 393 | 57.81% | 100、150 | 56.64% |
| 0.7% / 459 | 60.94% | 200 | 57.42% |
| 0.8% / 524 | 62.50% | 100 | 60.16% |
| 0.9% / 590 | 57.81% | 200 | 55.47% |
| 1.0% / 655 对照 | 65.63% | 100 | 64.06%(仅 50、100 两配置) |
0.3%–0.5% 的最佳值均为 38/64,低于 1% 的 42/64 四题。0.5% 在四种 seed 预算间波动较小:36/64 到 38/64,共 3.125 个百分点。0.8% 是此轮 sub-1% 搜索的最高点,但并不是全部 64k 设置的能力上限,因为 1% 已达到 42/64。
原文称低于一半的结构注意力成本保留超过 90% 的“contextual retrieval signal”。如果用绝对准确率计算,$38/42=90.48\%$;如果真正扣除 33/64 的无上下文基线,保留的净收益是
因此“90% 的绝对准确率”与“90% 的上下文贡献”不可互换。
从 1% 降到 0.3% 确实使块大小/名义结构预算约下降 70%,但最佳 seed 数由 100 增至 150–200,还有固定窗口、索引合并和并集扩张成本。论文没有给出这些点的匹配端到端耗时/峰值内存,不能宣称整次推理成本下降 70%。另外,正文称 0.7%、0.9% 从 150 增至 200 seeds 不再提高,与表中分别增加 3.13、1.56 个百分点不符。
4.7 跨文档综合:有生成案例,但不是严格的幻觉率评测
这部分改用 Qwen2.5-1.5B,不能与前面的 Qwen2 选择题合并。Phase 1 为 1% / 70 seeds、temperature 0.1、repetition penalty 1.3;Phase 2 为 3% / 30 seeds、temperature 0.2、repetition penalty 1.1。两阶段同时改变四个设置。[Sec. 2.8,PDF pp. 10–11]
| 文档组合 | 长度 | 时间:Ph1 → Ph2 | 字符数:Ph1 → Ph2 | 报告语义错误:Ph1 / Ph2 |
|---|---|---|---|---|
| ajinshanensis–aom | 30,000 | 113 → 43 分钟 | 4,801 → 3,327 | 0 / 0 |
| ajinshanensis–genppi | 29,500 | 110 → 46 分钟 | 2,426 → 3,735 | 0 / 0 |
| ajinshanensis–meta | 22,800 | 108 → 52 分钟 | 4,210 → 5,230 | 1 / 0 |
| aom–genppi | 32,400 | 110 → 16 分钟 | 3,491 → 907 | 0 / 0 |
| aom–meta | 25,600 | 90 → 63 分钟 | 3,403 → 4,158 | 0 / 0 |
| genppi–meta | 25,200 | 96 → 27 分钟 | 3,672 → 2,362 | 0 / 0 |
来源:Table 4,PDF p. 11。时间由原表时:分:秒转换为分钟,字符数不是 token 数。作者报告六个活跃进程合计峰值约 36 GB,每进程约 6 GB。
模型生成了跨文档的概念联系,例如细菌互作网络与 GenPPi 的预测方法、未培养微生物的测序与代谢表征等。Phase 1 有一处把 Bacillus cereus 写成 Bacillus subtilis,并出现格式与尾随符号重复;Phase 2 报告未观察到语义错误,格式也改善。
这说明有可读的跨文档综合案例。但 12 次运行、作者定性判断、未报告独立盲评/详细判分协议/匹配 dense 对照,不足以估计一般意义的幻觉概率。输出长度和生成参数都变了,也不能把时间下降完全归于稀疏结构。按表重算,最快的一对从 110 到 16 分钟,降约 85.5%,超出正文概括的 30%–70%;应优先引用逐项数据。
4.8 统计证据应该怎样措辞
| 比较 | 总正确题数 | 作者报告 McNemar $p$ | 可支持的措辞 |
|---|---|---|---|
| 32k Stochastic 最佳 vs 无上下文 | 24/32 vs 19/32 | 0.227 | 观察到净增加 5 题;未达到常用显著性阈值 |
| 64k Structural 最佳 vs 无上下文 | 42/64 vs 33/64 | 0.078 | 在作者采用的 10% 阈值下边际显著;未达到 5% |
| 64k Stochastic 最佳 vs 无上下文 | 40/64 vs 33/64 | 0.189 | 正向趋势,未达到 10% |
| 64k 两种稀疏模式的最佳配置 | 42/64 vs 40/64 | 0.6875 | 未检出差异;不等于证明二者等效 |
来源:Sec. 4.4.1,PDF pp. 16–17。原文未在这几页给出完整 discordant-pair 计数、所有检验实施细节或网格搜索后的多重比较校正。因此上述 $p$ 值按作者报告引用,不能据它们宣称搜索后最佳配置具有已确认的稳健优势。
五:结论——保留工程思路,谨慎对待强主张
5.1 值得带走的贡献
最可取的设计是把几件具体工程事情组合起来:无需改权重的注意力替换;逐 seed 构图降低临时内存;局部结构与全局随机连接的预算取舍;生成时缓存随机索引、仅更新局部窗口;在索引并集上采用统一 softmax;把位置外推作为独立但影响质量的因素进行比较。
实验证据表明,这套组合在所测小模型、四份科学文档和少量选择题上能够在 CPU 运行,并在部分参数设置中带来净上下文收益。它也提醒我们,单纯增加随机覆盖不能修复所有扩窗失败,密度、seed 数与位置编码必须一起看。
5.2 原文矛盾与主张边界汇总
| 问题 | 原文两侧证据 | 本次处理 |
|---|---|---|
| 32k Structural 1% / 10 | 正文/表 5:68.75%;图 1:约 65.6% | 标注未解决冲突,不默选一个值 |
| 32k Structural 1% / 40 | 表 5:71.88%;图 1:约 68.8%;图 3 的该密度峰值 68.75% | “低 seed 达到 dense”保留争议 |
| 32k Stochastic 5% / 1 | 表 5:57.81%;图 1:约 56.2% | 57.81% 不对应单次 32 题整数正确数,不能据此推断题数 |
| 32k Structural 5% / 10 | 表 5:65.62%;图 1:约 71.9% | 不把两份数据合并成一个结果集 |
| 图 2 右轴 recovery | dense 线在右轴约对齐 125%,按定义应为 100% | recovery 用题数公式重算,不读取右轴 |
| 64k 的 62.50% “能力上限” | Sec. 2.2.2/2.5 如此描述;表 2/3 与统计节给 42/64 | 最高报告值按 42/64,62.5% 只用于相应配置 |
| Figure 6 的 linear 比较 | 图注、曲线与表 1 的峰值不一致 | 用表 1,并注明是各自搜索峰值 |
| 低密度保留 90% 信号 | 绝对值比为 38/42,扣除 floor 后为 5/9 | 同时报告 90.48% 与 55.56% 的不同含义 |
| seed 饱和表述 | Sec. 2.7 称 0.7%/0.9% 后续无收益;表 3 显示仍提高 | 以具体表格记录为准,不声称统一最优 seed 区间 |
| 初始化/推理复杂度 | “开销平坦”“$O(T\log T)$”与显式 $O(T^2)$ 掩码并存 | 区分临时副本、存储、逻辑边与实际算术量 |
上述问题足以改变对 headline 结果的理解,但并不等于整个实现无法工作。更准确的判断是:工程方案可分析,部分结果可定位,若干强结论尚待澄清和独立验证。
5.3 作者的解释与仍未排除的解释
作者把高无上下文分数归于模型的领域参数记忆,并称源文章晚于训练截止时间,从而认为直接污染不太可能。[Sec. 3.2,PDF p. 12] 这可作为假说,但文档发布时间不能单独排除题目可猜性、通用知识、相似内容或选项线索。准确率不是无效指标;它需要与同题无上下文基线、证据依赖程度一起解释。
类似地,“稀疏正则化”“局部块保证事实检索”“位置编码完全解释失败”都是比当前控制实验更强的机制判断。本文没有分别移除 clique、PFUS、初始锚点或局部窗口的完整消融,也没有在固定质量或固定实际 FLOPs 下充分对照其他注意力实现。
5.4 最值得补充的验证
- 固定论文对应代码快照,先对齐正文、图 1–3、表 5 和逐题预测;发布每次运行的真实并集密度与题目正确数。
- 在独立验证集选 $d,S$,再对更大测试集做多随机重复,报告逐题配对检验和不确定性。
- 在匹配设备、精度、输入和输出长度下,分开测构图、prefill、decode、总内存和端到端延迟;用实际参与的配对数验证复杂度。
- 固定总有效连接或总算力,分别消融 PFUS、clique、局部窗口和锚点缓存,检验收益来源。
- 使用固定问题和受控答案位置扩展上下文,比较更强的 dense/稀疏基线及开放式回答,区分“能接入某架构”与“能保持其质量”。
5.5 组会可直接使用的判断
这篇论文展示了一种将随机稀疏连接、局部结构、统一 softmax 和 RoPE 扩窗拼合到已有小模型上的 CPU 推理方案。最可靠的结论是特定任务上的运行可行性与有限检索收益。把它表述为“已证明 $O(T\log T)$、1% 总成本、稳定胜过 dense、普遍保留 90% 上下文信号”,均超出了本篇 v1 的证据。
材料与复核范围
- 原始材料:PDF、主 TeX、参考文献源(本地核验附件)、源码清单与哈希。
- 作者公布的复现入口:GitHub 仓库、Zenodo 归档、Code Ocean,见 PDF p. 17。仅额外查看了 GitHub 项目首页;当前仓库可能已晚于论文 v1,不将后续版本说明并入本文证据,也未审计/执行作者实现或核验两个归档的具体内容。
- 本次独立核查包括:关键图表的 PDF 视觉核对、正确题数与百分点换算、gap recovery、独立覆盖公式、sub-1% 的净收益保留比例、跨文档时间换算。没有原始逐题预测时,不伪称重算了 McNemar 检验。
- 与本笔记配套的英文幻灯片按约 25 分钟组织,保留同样的数值口径和证据限定。