VarRate:无需训练的可变秩 KV 缓存压缩
论文:VarRate: Training-Free Variable-Rate KV Cache Compression for Long-Context LLMs
作者:Shahrzad Esmat、Dhawal Shah、Ali Jannesari(Iowa State University)
版本:arXiv:2607.15498v1,2026-07-16 提交;本次获取与研读:2026-09-24;研读修订:r1。
材料:arXiv v1 · 原文 PDF · 作者主 TeX · 源码清单 · 英文汇报 PDF。
本笔记依据同一 v1 的作者 main.tex、参考文献 main.bbl、原图和最终 20 页 PDF。已阅读正文 §§1–5 与附录 A.1–A.21;关键公式、表格和图号以最终 PDF 核验。下面的页码均是 PDF 从 1 开始的物理页码。未运行作者实验,也未独立验证其原始预测、实现或统计脚本;“报告”均指论文报告。“本次分析”是据原文作出的解释或推导。
论文总览
VarRate 把 KV 压缩看成一个有限预算分配问题:每个 token 都保留一个近似表示,但重要 token 使用更多低秩系数。它沿用 SnapKV 的注意力显著性信号,却把信号用于分配表示精度。这样,即使压缩文档时不知道未来问题,误判 token 的重要性也不会直接删除它的整条 KV。
这项工作的核心证据是 VarRate 对自己的统一秩基线 flat 的比较:在同样约 20% 的单序列缓存预算下,LongBench 16 任务平均分在 Llama 和 Qwen 上分别提高 2.22、17.50 分,配对 bootstrap 的 95% 区间均不包含零。它并非在每种模型、任务和预算下都超过 token selection 或量化;当前准确率实现还会重建完整 K/V,因此压缩表示的存储收益不能直接解释成已实现的端到端 GPU 显存缩减或解码加速。(§4.2,表1,PDF p.6;表15,p.16;§4.4,pp.6–7)
阅读时应把四个层次分开:编码预算、信息保真度、任务得分、真实服务成本。本文对前两个层次的设计和对第三个层次的实验较充分;第四个层次仍受到重建式评测框架和缺少融合内核的限制。
结构地图
| 原文章节 | 论证作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 查询相关删除与统一低秩的两种失败方式 | pp.1–2,图1 |
| 2 Related Work | 区分删除、低秩、量化、查询无关打分与合并 | pp.2–3 |
| 3.1 Preliminaries and Codec Setup | pre-RoPE 联合表示、锚点残差、PCA 基与预算 | p.3,式(1)–(3) |
| 3.2 Salience-Guided Variable-Rate Allocation | 显著性与 water-filling | p.4,式(4)–(5);算法1在p.5 |
| 3.3 Reconstruction and Complexity | 嵌套截断、重建和计算代价 | pp.4–5,式(6);图2在p.4 |
| 4.1 Setup | 模型、数据、实现与统计协议 | p.5 |
| 4.2 Accuracy at a Matched Budget | 主结果与 flat/Palu 对照 | pp.5–6,表1、图3 |
| 4.3 Query-Agnostic Reuse | 文档先压缩,再回答问题 | pp.5–6,表2在p.7 |
| 4.4 Cost | prefill 开销与重建式解码限制 | pp.6–7,表3、图4 |
| 4.5 Ablations | 信号、分配形状、量化和泛化 | pp.7–8,表4 |
| 5 Conclusion | 汇总保留粗表示的价值 | p.8 |
| A Additional Experiments and Analyses | 21 个补充小节,见结果部分逐项解读 | pp.10–20,表5–24、图5–8 |
参考文献在 PDF pp.8–9。源码图片文件名与最终图号并不一致,例如 fig4.pdf 实为图3,fig5.pdf 实为图8;本笔记统一使用最终编号。
一:动机——重要性估计错误后,会丢掉什么?
自回归注意力缓存历史 token 的 key 和 value;其存储随上下文长度线性增加。常见压缩可以沿不同轴进行:
| 压缩轴 | 保留什么 | 主要风险 | 本文中的比较角色 |
|---|---|---|---|
| token selection | 少量 token 的完整 KV | 错删后无法读取该 token 的 KV | SnapKV、PyramidKV、Ada-KV |
| 统一低秩 | 所有 token 的少量投影系数 | 同样预算未必适合不同 token | flat 是最直接消融;Palu 是外部低秩方法 |
| 数值量化 | 全维坐标的低精度值 | 数值误差 | KIVI-2/4;也可与 VarRate 组合 |
| 查询无关评分后选择 | 用其他信号预测未来价值 | 更好的评分可能需要额外计算 | KVzip、Expected Attention |
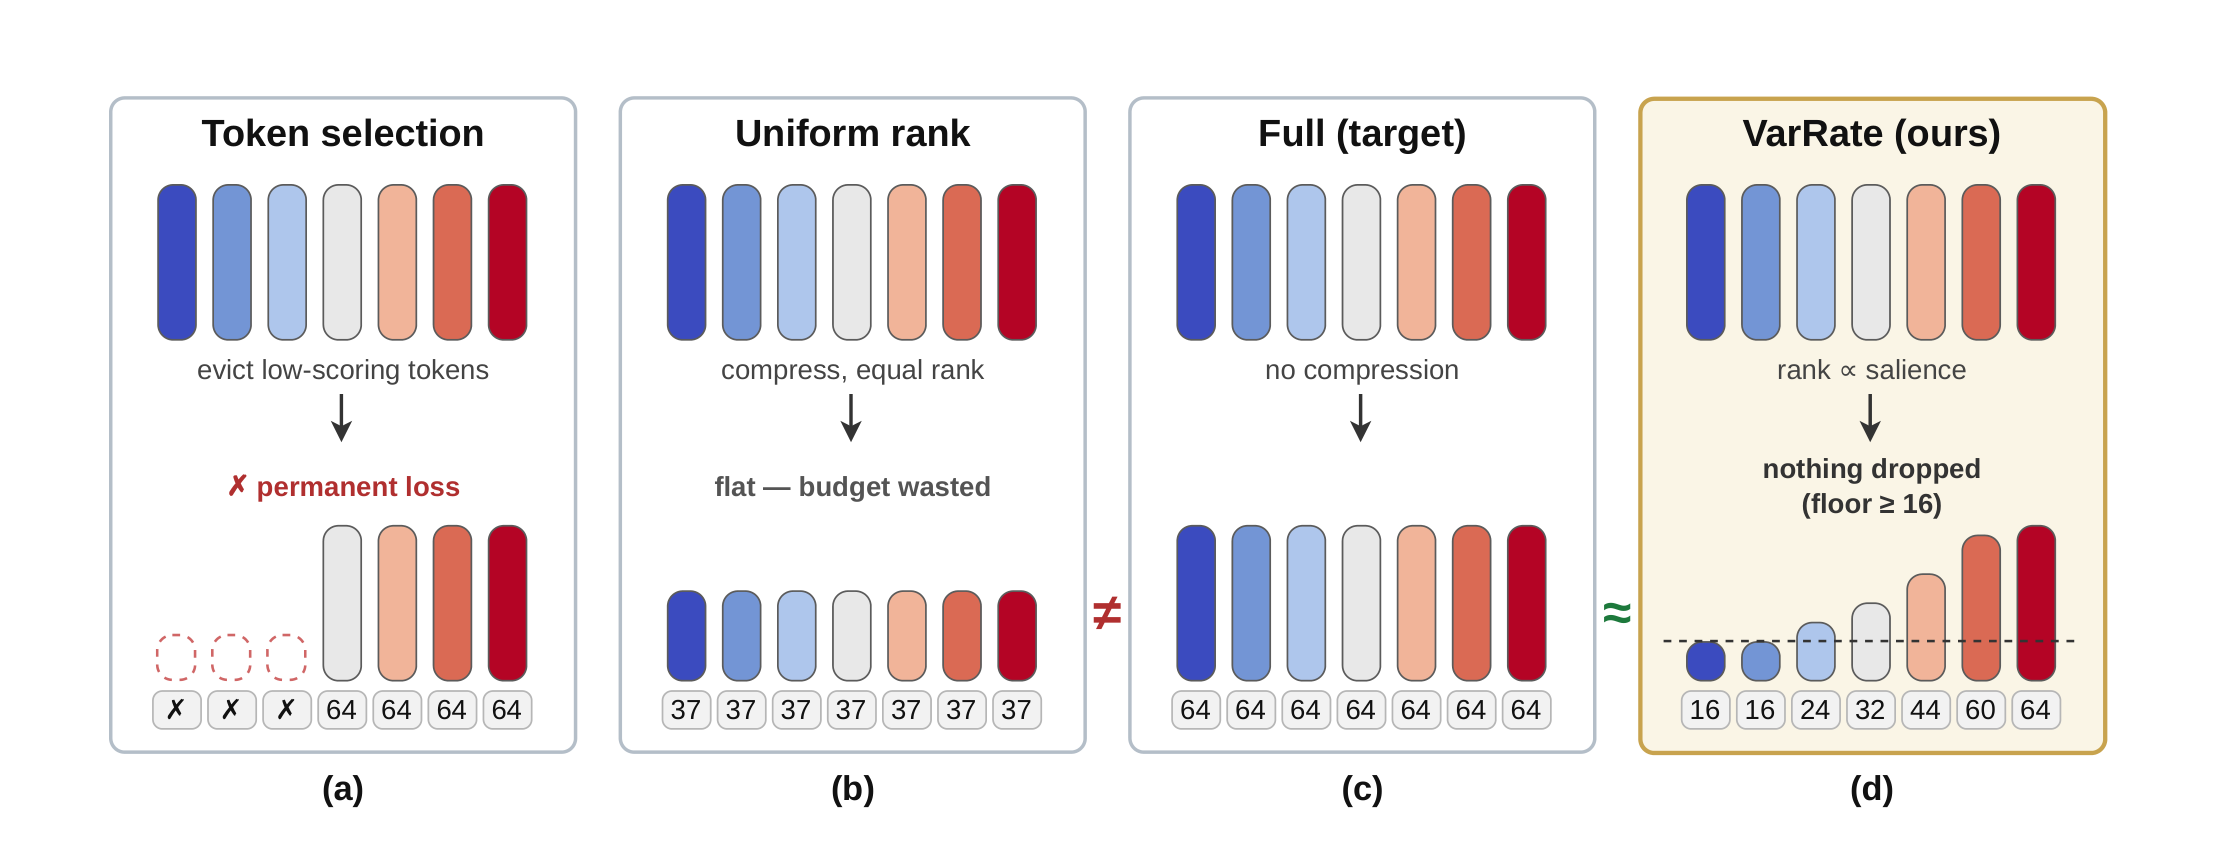
原图1,PDF p.2。柱高表示示意秩;(a)、(b)、(d) 比较相同名义预算,(c) 是未压缩参照。这里的柱高和接近号是方法示意,不能当成实测重建误差。
关键场景是 query-agnostic reuse:先把文档压缩一次,之后多个问题使用这份缓存。此时“文档尾部的注意力”不能像包含问题的 prompt 尾部那样直接反映当前答案需求。作者的思路是承受这种评分误差:低分 token 仍留下部分表示。
需要保留两个限定。第一,KVzip 也执行删除,却在此场景表现强,说明“删除必然失败”不成立;失败取决于信号与决策方式的组合。第二,低秩截断仍然有损:保留 token 不等于保留它的全部信息,丢失的系数不能凭空恢复。因此导言中的“可逆”应理解为较温和的保真度分配,不能理解为无损、可随时找回已丢信息的编码。(§§1–2,pp.1–3;本次分析)
二:方法——先定义残差表示,再分配每个 token 的秩
2.1 输入、输出与符号
每层独立压缩,使用该层自己的离线校准基;同一层内部把所有 KV heads 联合编码。
| 符号 | 含义与维度 |
|---|---|
| $L,H,G,d_h$ | prompt 长度、query head 数、KV head 数、单头维度;$G\le H$ |
| $D=2Gd_h$ | 联合 key/value 向量宽度 |
| $\mathcal A,\mathcal E,\mathcal C$ | 锚点、精确保留集合、待编码集合 |
| $\Delta,c,w,w_{\rm obs}$ | 锚点位置步长、最近锚点个数、精确保留尾窗、打分尾窗 |
| $V\in\mathbb R^{R\times D}$ | 按奇异值排序的正交行基;$R$ 为最大可用秩 |
| $r_t,r_{\min}$ | token $t$ 的系数个数及下限 |
| $\kappa,B$ | 保留的缓存比例、待编码 token 可用的系数总数 |
逻辑压缩表示包括精确锚点/尾窗、token 的锚点索引、变长系数及解码所需秩/边界信息,另加共享的模型侧基。算法1最终写成重建后的 K/V 返回值;这一点与实验使用的完整 K/V 重建模式一致。论文没有给出足以实现紧凑变长运行时的全部存储布局细节。
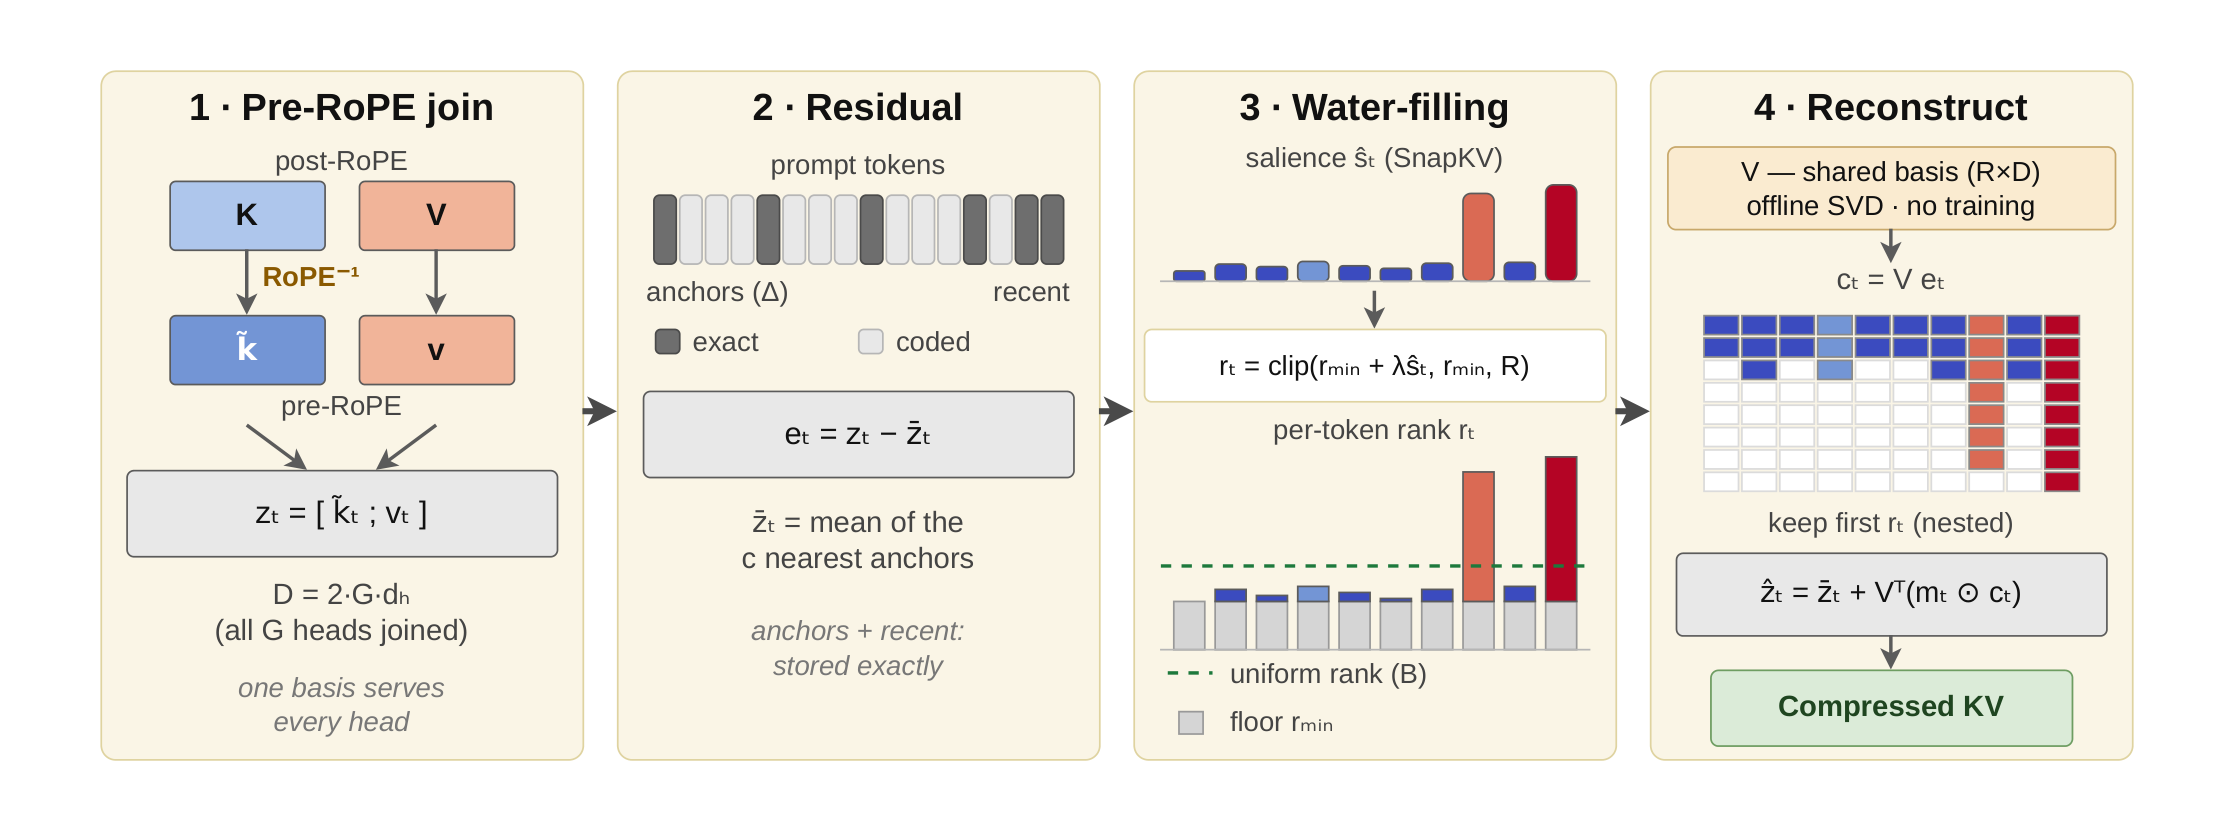
原图2,PDF p.4。由左到右是去旋转并拼接、减去锚点均值、按显著性分配秩、截断并重建;图中的条形分配仍是示意。
2.2 pre-RoPE 联合向量与锚点残差
先逆转 key 上的旋转位置编码(RoPE),再拼接全部 KV heads:
不同位置的旋转会让本来相近的 key 方向分散;在 pre-RoPE 空间压缩更有利于共享子空间。value 没有相应去旋转操作。重建结束后,key 要按原位置重新施加 RoPE。
每隔 $\Delta$ 个 token 留一个精确锚点,同时保留最近 $w$ 个 token。对其他 token,找其在联合向量欧氏距离上最近的 $c$ 个锚点:
这里的“最近”不是文本位置最近。锚点均值先解释公共成分,低秩系数只编码剩余差异;所以 flat 与 Palu 的差别不只是是否自适应分配秩,它们的表示构造本来就不同。(§3.1,p.3;A.6,pp.11–12)
2.3 共享 PCA 基:不训练,但需要校准
作者用六段无标签 LongBench 上下文收集逐层残差,取 SVD 的前 $R$ 个右奇异向量,得到 $V$。这不需要梯度或微调,但需要数据、前向计算和离线分解;“training-free”不等于“data-free”或零预处理成本。
默认 $R=1024$。Llama 的半精度基在所有层合计约 134 MB,作为模型侧一次性共享开销,不计入单序列 KV 预算。部署时仍应计入总显存,尤其是短序列、小 batch 或基不能常驻设备时。附录只检验了有限的换样本/换任务校准,不能推出对任意域都稳定。(§3.1,p.3;§4.1,p.5;A.8,pp.12–13)
2.4 预算是系数总数,而不是每个 token 固定秩
令 $n_{\rm ref}=|\mathcal E|$,精确 token 已占用 $n_{\rm ref}D$ 个标量,剩余预算为
flat 给每个待编码 token 分配 $B/|\mathcal C|$;VarRate 改变各 token 的份额。锚点索引和整数秩取整使实际字节数略偏离此理想公式:原文称锚点索引额外约 0.2%,取整使预算超出不足 0.4%;表3记录的 VarRate footprint 为 20.2%。这些百分数不能简单叠加成统一账本,最终比较应以各实验实际 footprint 为准。(§3.1–3.2,pp.3–4;表3,p.7)
**本次推导:**给定 $\mathcal E$ 与 $R$,至少需要
因此并非任意 $\kappa\in(0,1)$ 都能在不变配置下满足等式。特别是固定精确锚点会形成低预算的硬成本;较宽预算也可能要求调整基秩或精确集合。论文预算扫描没有逐点列出全部内部配置,不应把主实验的默认值自动套到所有扫描点。
2.5 显著性与 water-filling
从最近 $w_{\rm obs}$ 个 query 观察历史 token 的注意力,对 query 和全部 $H$ 个头平均:
随后做长度 5 的移动平均,再在待编码集合上 min–max 归一化得到 $\hat s_t\in[0,1]$。这是从 SnapKV 借用的信号;VarRate 的主要新意在于之后的连续分配,而非发明一个更准确的未来 query 预测器。
从最低秩开始,将剩余预算按显著性比例分配;达到 $R$ 的 token 被封顶,其超出份额继续分给其他 token。$\lambda$ 控制总体预算。实作还要取整。论文未明确给出全部分数相同、min–max 分母为零或剩余活跃权重总和为零时的处理分支;重实现时需要显式处理。
**教学例子,非论文数据:**四个待编码 token,$r_{\min}=2$、$R=8$、$B=20$,归一化显著性为 $(0,1/3,2/3,1)$。取 $\lambda=6$,得到秩 $(2,4,6,8)$,总和仍为20;flat 则是 $(5,5,5,5)$。两者使用相同数量的系数,但第一种把更多方向留给高显著性 token。
原文把这一过程称为 water-filling。它是带上下界的按权重分配规则;论文没有证明该线性打分规则是某个完整 attention 失真目标的全局最优解。每个 token 的真实边际收益还取决于其各阶系数能量,这些不直接出现在式(5)中。(本次分析;§3.2,p.4,算法1,p.5)
2.6 截断、重建及其保证的范围
先计算 $\mathbf c_t=Ve_t\in\mathbb R^R$,仅存前 $r_t$ 个系数,重建为
精确集合直接用原值。由于基正交,固定同一残差时,多保留一个系数不会增大欧氏重建误差;减少的平方误差就是该系数的平方。这是局部表示层面的嵌套性,不是任务准确率随秩严格单调的定理,也不是一次重新分配总预算后所有 token 的误差都会下降。
查询输出误差与 value 误差的注意力加权有关;key 误差还会改变 softmax 分布。用注意力质量分配秩有直觉依据,但作者未给出从式(5)到多层生成误差的严格上界。PCA 基的能量排序也只反映校准分布的总体统计,未保证每个未来 token 都有相同谱形状。
2.7 计算与在线行为
每层锚点搜索量级为 $O(L^2Gd_h/\Delta)$,投影/重建量级为 $O(LDR)$。前者在固定步长下仍随长度二次增长;不能因为系数存储线性就把编码过程也称为线性时间。打分和编码依附已有 prefill,不像 KVzip 那样为评分多次重跑整个模型。
论文称变秩截断不增加同一满秩投影之后的投影算术,但真实实现的打分、分配、数据移动仍有额外成本。默认准确率实验是重建完整 K/V 后继续 attention;文中没有完整交付融合的变长系数 attention 内核、在线追加与重压缩调度。因此算法的 prompt 压缩过程不能自动扩展成已经验证的长期多轮服务方案。(§3.3,pp.4–5;§4.4,pp.6–7)
三:实验——先固定比较口径
3.1 默认配置和指标
主模型是 Llama-3.1-8B-Instruct 与 Qwen2.5-7B-Instruct;Mistral-7B-Instruct-v0.2 仅作第三模型核查,不计入双模型 headline。默认配置为 $\kappa=0.20$、$r_{\min}=16$、$R=1024$、$\Delta=16$、$c=4$、$w=w_{\rm obs}=64$。使用 KVPress 和 greedy decoding;主实验在单 A100 上测准确率。
LongBench 采用 16 个任务的官方指标,覆盖单文档/多文档问答、摘要、few-shot、合成检索、代码补全。AVG-16 是任务得分平均,并非单一“准确率”,也不能用表1六个类别均值再简单平均得到。检索关注命中正确 passage,MuSiQue 关注多跳问答的答案质量,GovReport 关注摘要重合度;各项得分通常越高越好。WikiText-2 的困惑度 PPL 则越低越好。原文没有完整展开每个任务的计分器公式、所有 prompt 和生成上限,本笔记不补造这些配置。
3.2 几组不能混用的协议
| 实验 | 对象与样本口径 | 检验问题 |
|---|---|---|
| 主 LongBench 表1 | 两模型、16任务;§4.1称每任务200样本 | 标准含问题场景的质量/预算比较 |
| 三任务细分消融 | 常用 passage / MuSiQue / GovReport;通常每任务200 | 检索、推理、分布式摘要信息的取舍 |
| 查询无关复用表2 | passage / MuSiQue / Qasper | 去掉压缩时的 question 后是否稳健 |
| KVzip 强统计表18 | 上述三任务按样本配对,每个模型×场景约600对 | 小样本任务级检验是否误导 |
| oracle 对照 | 单独的100样本检索框架 | 默认显著性距离 gold-span 分配多远 |
| RULER 表17 | 16K,$n=40$ | 更广的合成任务交叉核查 |
| NIAH 表24 | Llama、16K–128K、每格75例,跨长度固定 needle 集 | 超过主实验长度的受控检索 |
| 真实延迟表16 | Llama、单A100;$n=18$,另去掉2次warmup | 整次调用的 wall-clock 成本 |
表1比较方法时,对16个任务进行20,000次配对 bootstrap,报告95% CI,并辅以 exact sign test。只有 CI 排除0才支持有方向的差异。CI 包含0表示未检测到显著差异,不构成正式等效性证明;本文的“tie”应按这个含义理解。
公平性还有三个细节:KIVI-2 实测约19.6%,接近20%而非字节完全相同;KIVI-4 约31%,不属于同预算主胜负;KVzip 被赋予与 VarRate 相同的64-token尾部保护,以免把当前问题本身删除。(§4.1–4.3,pp.5–7)
四:结果——什么被支持,什么仍有限定?
4.1 主实验:收益最明确地来自对 flat 的改进
下表摘取表1的 AVG-16(↑),括号中的变化为本次按原表相减;单位为得分点。
| 方法 | 缓存比例口径 | Llama | Qwen |
|---|---|---|---|
| Full | 100% | 46.01 | 48.79 |
| VarRate | 约20% | 45.69(−0.32) | 48.00(−0.79) |
| flat | 约20% | 43.47 | 30.50 |
| SnapKV | 20% | 45.79 | 46.25 |
| PyramidKV | 20% | 46.02 | 44.90 |
| KIVI-2 | 约19% | 44.82 | 46.82 |
来源:表1,PDF p.6。这里“预算20%”是保留20%、约5倍压缩,不是只减少20%。
最直接的因果对照是 VarRate 与 flat:表示、基与预算都尽量保持一致,只改变分配。Llama 差值为 +2.22,95% CI [0.72, 4.05];Qwen 为 +17.50,[10.77, 24.69],分别在13/16、15/16任务上获胜。相比之下,Llama 对 SnapKV 的−0.10和对PyramidKV的−0.33均未显著;Qwen 对两者分别+1.75和+3.10,均显著。KIVI-2在两模型上均未被显著超过。(表15,p.16)
作者将 Qwen 的困难与其四个 KV heads 的结构联系起来,这是解释而非控制其他因素后的因果证明。两模型平均分 VarRate 46.85 是名义最高,不能由此推出跨所有模型最优。Full 也是经验参照,并非数学上不可超过的得分上界。
4.2 查询无关复用:改善鲁棒性,但 KVzip 仍是强对手
问题不放入被压缩文档时,表2的三任务平均如下。注意这里第三个任务是 Qasper,不是 GovReport。
| 方法 | Llama | Qwen |
|---|---|---|
| Full control | 59.91 | 58.21 |
| VarRate | 56.21 | 51.79 |
| SnapKV | 45.75 | 41.35 |
| Ada-KV | 47.48 | 40.28 |
| KVzip,64-token pin | 55.34 | 56.42 |
来源:表2,PDF p.7。VarRate 相对自身 query-aware 协议下降3.53/5.50分,SnapKV下降12.96/14.66分;这些是场景变化的差值,不能与当前行对Full的差值混为一谈。Full自身场景切换仅改变+0.08/+0.55,提供了排除单纯 prompt 改变的对照。(§4.3,pp.5–6)
KVzip 的公平性修正很重要:保护尾部问题后,其分数提升,原先看似属于 VarRate 的领先消失。主文按模型×场景四格的任务均值给出 VarRate 比 KVzip 平均低0.77;仅查询无关两模型均值则低1.88,图4写约1.9。两者统计对象不同。
更有统计能力的附录 A.16 改为约600个样本/格配对,报告:
| VarRate − KVzip | 差值 | 95% CI |
|---|---|---|
| Llama,query-aware | −0.55 | [−2.00, 0.91] |
| Llama,query-agnostic | +0.95 | [−1.48, 3.42] |
| Qwen,query-aware | −0.04 | [−1.67, 1.62] |
| Qwen,query-agnostic | −5.06 | [−7.57, −2.58] |
| 合并四格,约2400样本 | −1.18 | [−2.20, −0.16] |
来源:表18,PDF p.17。后三种“未显著”的单元之外,Qwen复用格和整体合并结果均偏向KVzip。因此摘要的“overall within a point”只适用于其主文特定平均方式,不能覆盖附录按样本合并的−1.18。本文应支持的结论是较低压缩开销下接近 KVzip 的部分表现,而非对其精度优势或严格等效性。
4.3 成本:约8倍指附加开销,不是总延迟
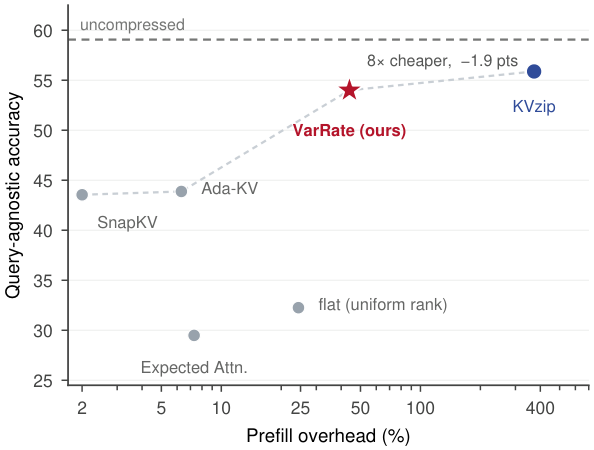
原图4,PDF p.7。横轴是 prefill overhead(对数刻度,越低越好),纵轴是两模型查询无关三任务平均(越高越好)。VarRate位于作者画出的取舍前沿,但这张图将两模型的精度汇总与Llama上的成本测量组合,不能视为同一请求上的完整服务性能画像。
表3报告 Llama、A100、16K 的附加 prefill 开销:SnapKV +2.0%,flat +24.4%,VarRate +44.0%,KVzip +372.2%。据此算出
这比较的是附加部分。若在同一基础prefill时间上比较总量,倍率应是 $(1+3.722)/(1+0.44)\approx3.28$;它仍不代表端到端生成速度。
VarRate解码为37.4 tok/s,Full为37.5,基本相同。原因是准确率路径重建全长、全维K/V。表中某些masker的低解码吞吐被作者标为KVPress模拟删除的框架产物,不能拿来证明这些方法本身慢。压缩表征的约20.2% footprint、模型侧基、重建临时张量、GPU峰值显存是不同账本。(§4.4,pp.6–7;A.6,p.11)
真实整次调用的补充测量更贴近使用场景:短输出检索由1.256秒到1.781秒,+41.8%;长输出GovReport由13.59秒到13.95秒,+2.6%,作者认为处于运行噪声内。两者来自小规模特定任务测试,不能推广为所有长生成场景都“零成本”。(A.14,pp.15–16,表16)
4.4 主消融:正确内容信号与分配形状各自有作用
Llama,20%预算,表4(PDF p.7)给出两条证据链:
- 信号:flat检索87.5,随机信号+water-filling为93.0,真实显著性为99.5。随意变成不均匀分配不能得到全部收益。
- 分配形状:显著性+二元top-K分配同样达到99.5检索,但GovReport仅29.0,低于flat的30.1和渐变分配的30.4。把所有非赢家都压到低秩对分散信息不利。
独立100样本oracle实验中,gold-span分配100.0、注意力99.0、flat93.0。它支持这一检索设置中默认信号接近该oracle,但不能证明对所有任务、所有分配策略全局最优;尤其不能把其中flat93.0与200样本表4的87.5直接相减。(§4.5,p.7)
附录结果逐项解读
A.1–A.4:语言建模、选择方法扫描与量化
A.1 Perplexity at Equal Budget,PDF p.10。 WikiText-2上按实际字节对齐,VarRate PPL 6.95,flat 7.26,改善0.31,约4.3%的相对PPL下降(本次计算)。这是独立于LongBench得分的佐证,但PPL降低不直接证明某个特定KV几何误差度量降低。此小节没有充分列出模型、窗口、样本规模和不确定性,不能自行补齐。
A.2 VarRate Against the Selection Family Across Budgets,p.10,表5。 Llama在15/20/25%预算中,检索和多跳问答与选择方法总体未显著区分;摘要相对最强选择基线的GovReport差值按表计算约为+0.8、+1.6、+2.7,作者报告后两档显著。改善针对这三个任务和模型,不代表主表所有摘要类别、模型都同样获益。
A.3 Quantization: Where It Wins, and Where It Composes,p.10,表6。 KIVI在GovReport明显更强:Llama KIVI-2为35.2,VarRate30.4;Qwen33.3对31.3。保留所有坐标但降低精度,与删除部分投影方向,错误结构不同。量化不是一个已被VarRate击败的轴。
A.4 Composability at Multiple Bit-Widths,pp.10–11,表7。 对低秩系数量化,Llama三任务的fp16结果99.5/32.0/30.4,在3-bit时为99.5/31.3/30.4,而压缩存储约由20%降到9%。4-bit在表7约10%,主文独立成本仪表表3给11.0%,应保留测量口径差别。组合后的footprint不能用 $20\%\times3/16$ 简单估计,因为精确锚点、尾窗和元数据没有同步按该比例缩减;收益也尚未等价为融合内核运行时实测。
A.5–A.9:基线、模型迁移和数据质量
A.5 Additional Baselines: Sanity Checks Behind the Comparisons,p.11。 作者对KIVI重现做检索sanity check;Palu移植到Llama-3.1需要RoPE shim,未压缩路径达到99.5,支持移植基本正确。作者没有直接比较训练型低秩方法;本文结果因此无法回答“为某些训练成本换取性能后,谁更好”。源码包包含论文材料而非完整实验仓库,本次也没有检查作者运行日志。
A.6 The Published Low-Rank Codec: Full Budget Curve and Footprint Validation,pp.11–12,表8。 在20%预算的三任务对照中,VarRate明显优于Palu;较宽预算差距缩小。Palu实测/检查点推算20.41%,VarRate20.22%。但flat也已经大幅优于Palu,所以这一对照不能把全部差值归功于salience分配。作者未在这些GQA模型上复现Palu的融合内核速度:其内核的MHA形状假设不兼容;在Palu原MHA设置上则能复现attention模块加速。应分别解读算法、移植与内核适用范围。
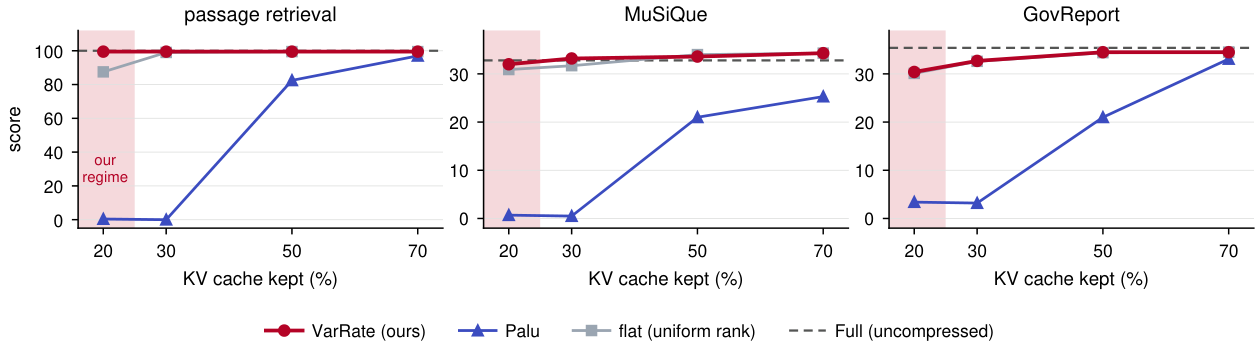
原图3,PDF p.6;完整数值在表8,p.12。横轴是保留缓存百分比,三个面板依次是检索、MuSiQue、GovReport,纵轴得分越高越好。红色VarRate与灰色flat在预算放宽后接近,说明重新分配的额外价值主要发生在有实际资源争夺时。曲线的名义高低不是逐点显著性检验。
A.7 A Third Model at Full Budget Sweep (Mistral-7B),pp.11–13,表9。 在15%预算的检索上,flat29.1,VarRate73.6,Full75.6,方向与主实验一致。该模型本身较弱,且只核查三任务;不能把这个结果当成第三模型完整16任务复现。
A.8 Calibration Robustness Across Three Independently Built Bases,pp.12–13,表10。 更换校准样本、再更换任务来源,已测Llama三任务最大变化1.8分。支持对这几组校准选择不敏感,不证明任意无标签数据都足够。后续负对照使用另一套基,导致GovReport30.0/30.4等小差别;不宜把它们当完全相同运行。
A.9 A Data-Integrity Correction in the 16-Task Breadth Table,p.12。 作者披露曾因跨模型结果文件同名而覆盖18/24个复用单元,已改成按模型显式路径汇总并拒绝重复键。这个披露支持优先使用当前v1的表1,不能作为忽略其他内部不一致的理由。本次未取得原始JSON来独立复算修正结果。
A.10–A.14:预算、实现、步长与统计
A.10 Query-Agnostic Budget Curve, and a Validated Expected-Attention Baseline,pp.12–14,表11。 Llama查询无关三任务中,VarRate在20/25/50%预算的名义均值均不低于KVzip;10%预算默认步长16则骤降至29.92,低于KVzip42.12。步长64能恢复至48.88,是换配置后的消融,不能混作默认值。Expected Attention在它的50%预算query-aware条件能复现接近Full的表现,支持其在本文reuse协议下的下降不只是明显移植错误;但“因为什么下降”仍主要是作者机制解释。
A.11 Where the Prefill Overhead Goes, and How Far It Compresses,pp.13–15,表12–13。 锚点搜索、PCA投影、重建各占compress时间约32.5%、21.8%、19.9%;water-filling约6.4%。作者指出fp32距离矩阵、小kernel启动和逐层搬运基的成本。独立优化测量中,参考+41.7%,GPU缓存基的fp32版本+40.3%,进一步使用bf16的版本+25.1%,对应任务得分最大变化0.07。该40%改善是 $(41.7-25.1)/41.7$ 的附加开销下降,不能说总prefill缩短40%。
附录还记录两个实现陷阱:以bf16距离恒等式算锚点距离会出现消减误差;更换salience数值精度也可能改变秩分配。作者报告FLOPs仅约前向2.61%,但FLOPs比例不能直接当作真实时间可达下界,内存带宽、布局和数值稳定性同样决定成本。(后一句为本次分析)
A.12 The Stride Ablation,pp.13–15,表14;示意图5在p.14。 加大锚点步长把预算从精确token转给低秩系数。它在10%复用三任务上带来+18.96,却在20%全16任务上由45.69降至44.98(−0.71),few-shot和代码受损明显。因此默认保留步长16。图5是带示意salience的教学图,不能视为某个真实needle的完整测量轨迹。
A.13 Statistical Significance, Summarized,pp.15–16,表15。 支持的强结论是显著胜过flat;对选择方法的显著优势主要在Qwen;对KIVI-2未检测到显著差异。未报告多重比较校正,因此不应把大量局部显著性结果当成已控制整体错误率的结论。报告任务级bootstrap也不等于已覆盖训练随机性、所有校准随机性或未来任务分布。
A.14 Real Wall-Clock Latency,pp.15–16,表16。 已在成本部分讨论:短生成承担明显一次性压缩开销,长生成中占比变小。该小节把主表3开销称为accounted estimate,而主表和§4.4称measured;笔记保留“独立仪表开销”和“整次调用wall-clock”两种口径,不合并成一次统一基准。
A.15–A.18:额外任务与信号负对照
A.15 A Second Long-Context Suite (RULER), Limited Scope,pp.15–16,表17。 16K、40例下Full90.0、SnapKV81.7、VarRate82.5,后两者差0.8在噪声内,且都损失约8分。文中给出±区间但该表未充分定义它们的统计含义,不能自行标成标准差。此次仅16K,没有完成RULER的32K–128K扫描;128K主张来自另一套NIAH实验。
A.16 A Powered Re-Gate of the KVzip Comparison,pp.16–17,表18。 3任务上的双侧sign test最小p值为0.25,无法达到常用显著阈值,所以作者转到样本级配对,结果见4.2。合并任务会改变权重,并需要可靠的样本对齐;作者称使用gold-answer指纹核对,但本次未独立审计这种对齐。三个CI跨0不是已经证成严格“等效”,整体合并则是KVzip显著更高。
A.17 Is the Signal Content, or Just Shape?,pp.16–18,表19、图6。 shuffle打乱真实分数与token的对应关系,保留分数集合;position只给近因和attention-sink形状。Qwen检索中,mass99.5、shuffle64.7、position89.0、flat75.0;MuSiQue中分别28.7、7.5、7.7、8.5。由此支持“内容对齐有贡献”,也显示错误的不均匀分配可能比统一分配更差。但position在Qwen检索上高于flat,不能照搬表注“两个控制在Qwen都低于flat”的笼统说法。
A.18 Does the Signal Generalize Past One Heuristic and One Model?,pp.17–18,表20。 作者用attention平方与value区分度构成的二阶敏感度启发式替换mass,报告两模型上与mass未显著区分。Qwen上二元split的GovReport29.4、MuSiQue26.5,渐变分配为31.3、28.7。该证据说明方法不只依赖一种打分启发式,不证明任选打分都行;正文没有完整写出Fisher变体公式,本笔记不伪造其实现。
A.19–A.21:秩下限、低预算失败与长上下文
A.19 Is the Rank Floor a Lever?,pp.17–19,表21、图7。 把 $r_{\min}=16$ 改成0,Llama检索不变,GovReport+0.60,MuSiQue−0.47。作者在约300万–430万coded tokens的日志里报告,两个配置在已查10/15/20%预算下触底占比均显示0.0%。因此,显式下限是保底约束,在这些运行中不是被激活的性能来源。0.0%是报告精度下的统计值;不能据此把每一个token的最低秩严格证明为大于下限。
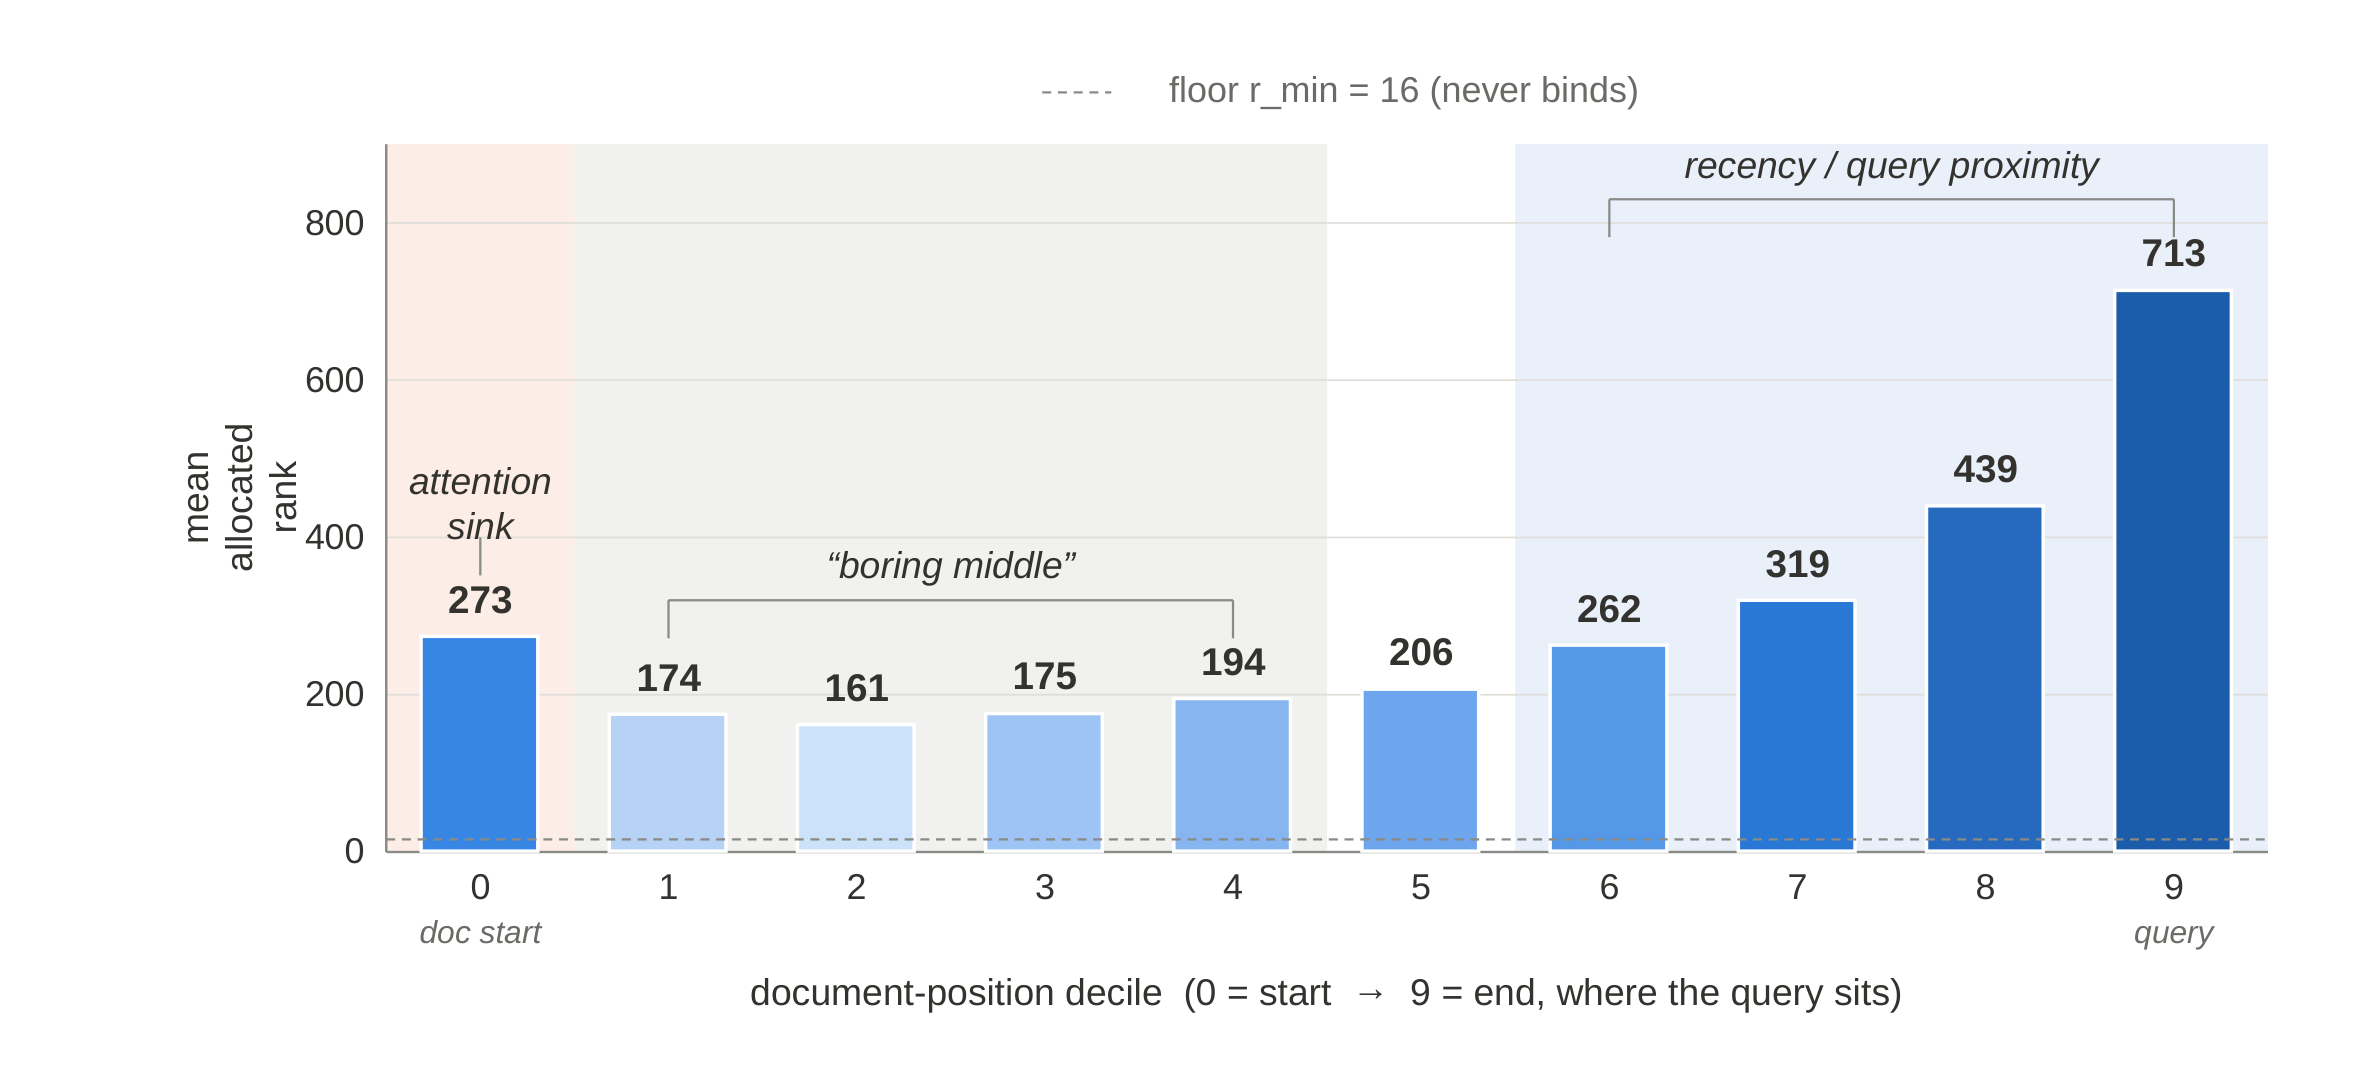
原图7,PDF p.19。横轴是文档十分位(0为开头,9为含query的结尾),纵轴是平均分配秩;300个(layer, example) trace在GovReport、20%预算下汇总。开头有attention-sink抬升,中间低,尾部最高。均值高于下限不等于每个样本都不触底,需结合单token日志解读。
作者还报告跨不同层/样本混合后的原始salience与rank Pearson相关仅约0.05–0.06,并认为尺度混合造成失真。式(5)确实保证单次分配内归一化分数与秩单调,却不保证跨运行原始分数的高线性相关;补做每次分配内的相关和实际任务贡献关联,才更适合检验机制。
A.20 Does the Advantage Grow at Aggressive Budgets?,pp.18–20,表22–23。 “预算越紧越有优势”被实验否定。Qwen在query-aware、8%预算下检索:SnapKV99.5、VarRate29.6、flat27.8;MuSiQue中VarRate和flat均4.2。到12%时VarRate检索恢复99.5,多跳QA25.0,接近SnapKV25.2。更小的总预算让全体低秩表示一起失真,而选择方法仍可能保住少量精确关键token。该结论与复用场景的优势并不矛盾:决定风险的是场景与压缩方式的配合。这里固定约19%的KIVI不能视为8%预算的同内存比较。
A.21 Long-Context Retrieval Beyond the 16K Ceiling,pp.19–20,图8、表24。 查询无关NIAH以相同needle集合横跨16K–128K,Llama、20%预算、每格75例。64K时Full98.7%、VarRate92.0%、SnapKV48.0%;128K时两个压缩方法均回到100%。这个回升在原文被报告为可复现但机制未明,不能只截取64K后声称选择方法会随长度单调崩溃。
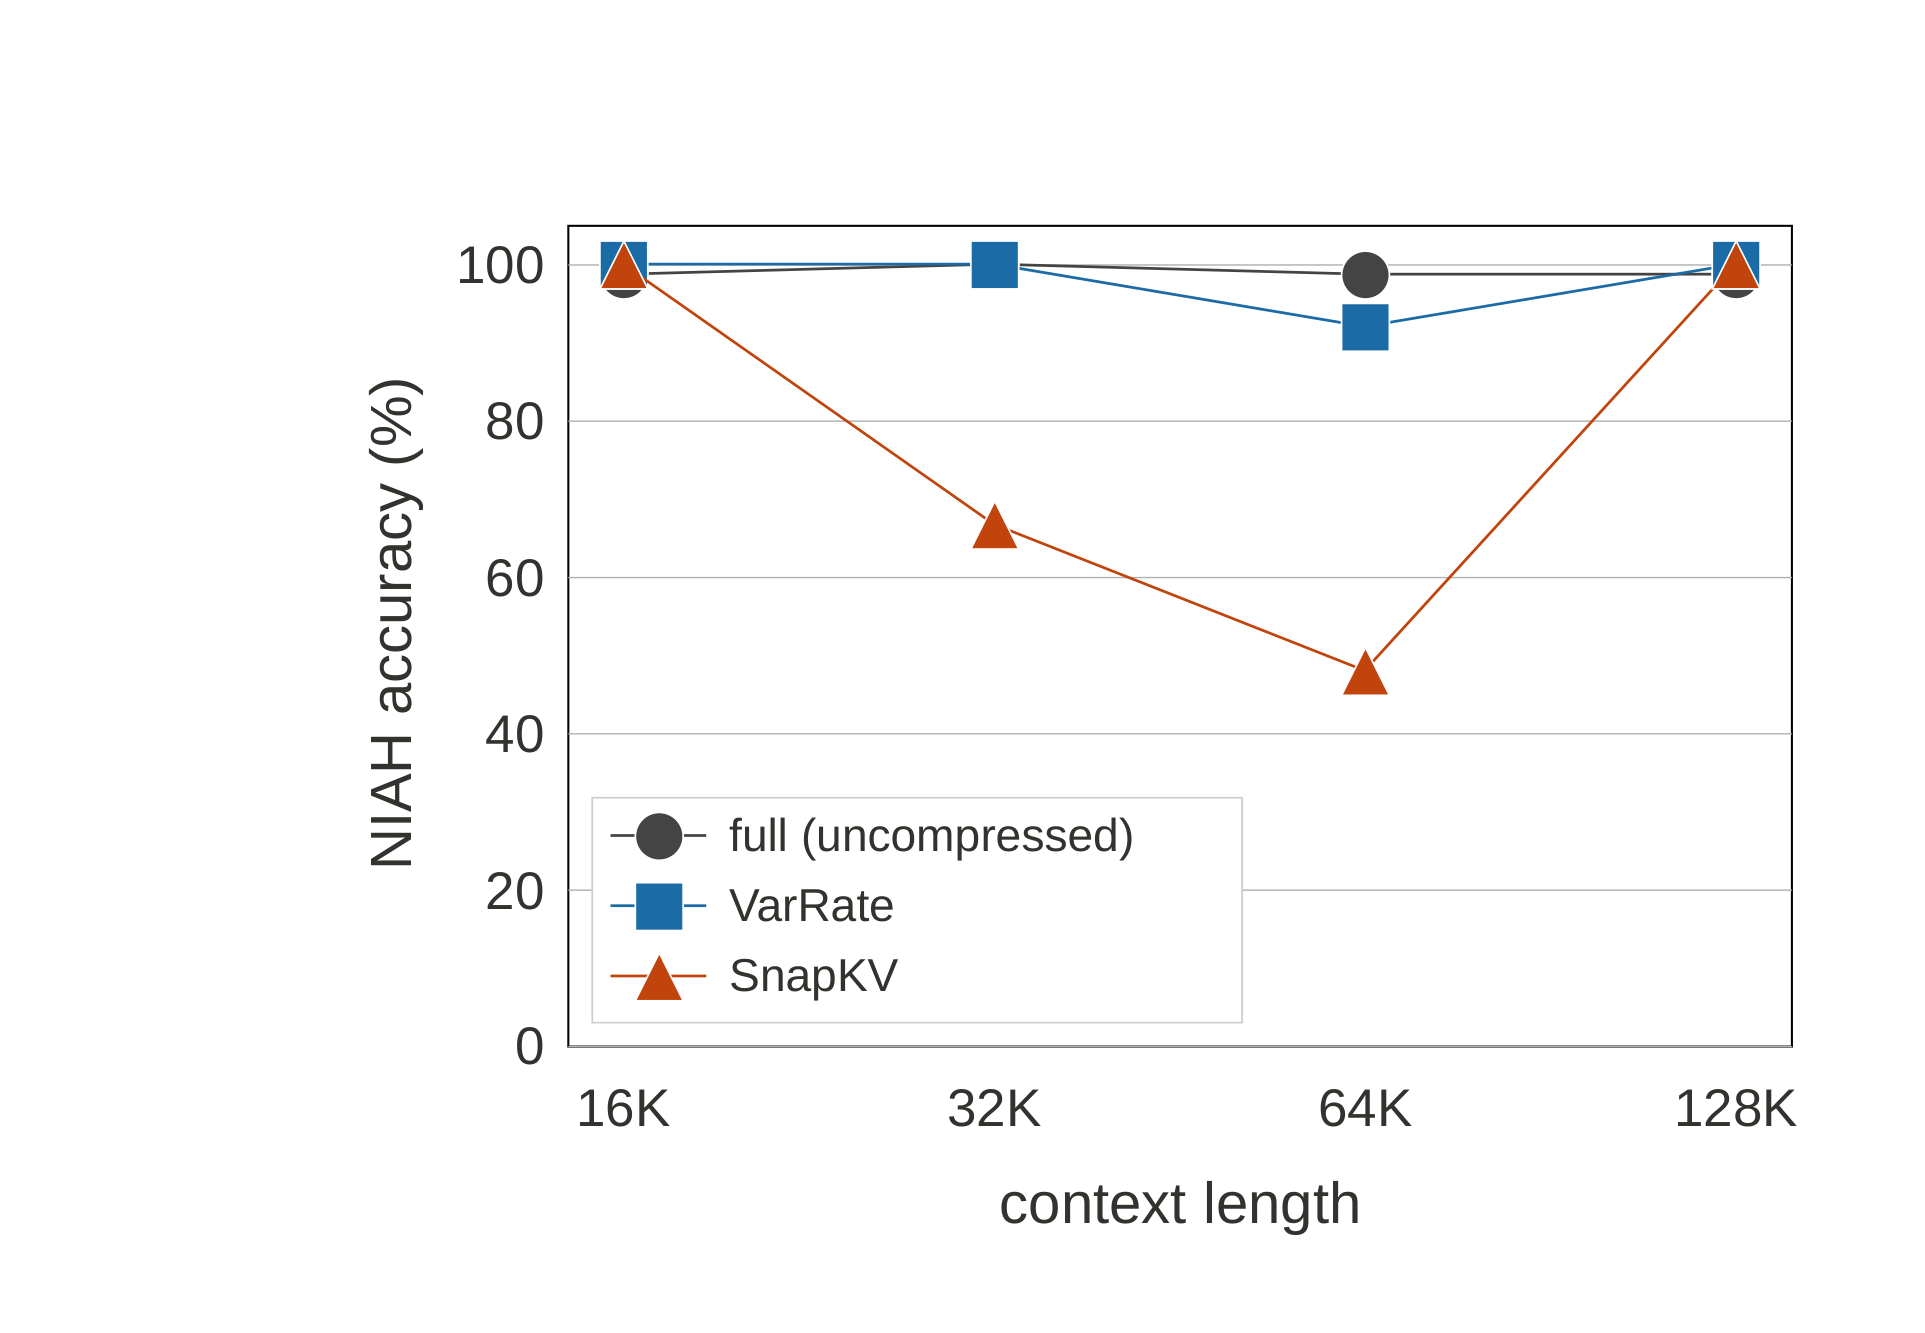
原图8,PDF p.19;表24在p.20。横轴是context length,纵轴是NIAH正确率,所有方法共享各长度的needle集合。128K准确率路径因重建全K/V需要双GPU;作者报告分片在32K/64K复现单GPU结果。本图证明的是特定合成检索任务的质量,不能代替长文摘要、多跳QA或真实多轮服务的128K结论。
五:结论、原文差异与后续问题
5.1 最可靠的贡献
VarRate 提供了一种有用的设计选择:把廉价重要性信号用于调节token表示的精细程度。与相同表示和预算的统一分配相比,自适应分配在已测模型和任务上有明确收益;错误打分后的粗表示保留,也改善了部分查询无关复用结果。这些证据支持继续研究按token分配表示容量。
它仍需要离线校准、选择适当预算与锚点密度,并面对量化在摘要上的强表现、极低预算失效以及运行时工程成本。在没有融合内核、峰值显存和完整服务路径实测前,将其称作“已完成的5倍显存优化”会超出证据。
5.2 v1 中需要保留的口径差别和不一致
| 位置 | 具体问题 | 本笔记的处理 |
|---|---|---|
| 摘要/§4.3 vs. A.16表18 | 四格任务均值落后KVzip0.77;样本合并落后1.18且CI排除0 | 分别报告,不写无条件“整体差不到1分” |
| “accuracy-equivalent”措辞 vs. CI检验 | 未显著不同并不是等效性检验 | 写“未检测到显著差异” |
| §4.4表3 vs. A.14 | 前者称成本measured,后者称accounted estimate | 区分仪表开销与整次调用实测 |
| §4.1 vs. A.12 | 默认写每任务200例,A.12叙述又出现256-example全套rerun | 默认引用200,指出stride重跑样本说明存在歧义 |
| 图6,p.17 vs. 表19,p.18 | 图中flat标“Qwen passage: 87.5”;表19的Qwen flat是75.0,87.5属于Llama | 使用表19;不把图6数值传播到成品图表 |
| 表19表注 vs. 单元格 | 表注称Qwen两个负对照都低于flat,但position检索89.0 > 75.0 | 按任务区分,保留更窄结论 |
| 图5示意 vs. A.19日志 | 图5画低分token贴近floor,日志报告floor基本不绑定 | 示意只解释算法,不当作实测因果证据 |
| 表3 vs. 表7 | 4-bit组合存储分别11.0%和约10% | 保留各自测量口径,不虚构精确统一值 |
表1按展示值相减与表15的部分差值还有0.01级差异,例如Qwen对Ada-KV为1.51而表15写1.52,Llama对KIVI-2为0.87而表15写0.86;可能来自底层未四舍五入值。没有原始分数时应使用作者统计表的差值与CI,不声称独立复算一致。
5.3 值得继续问的技术问题(本次分析)
- 预算的边际收益能否更直接估计? 当前规则只用salience,未显式结合该token每阶残差系数能量。联合二者可能改善分配,但需要证明额外评分成本和泛化代价可接受。
- 收益是否来自跨query的信息保留? 设计真实多问题共享文档、不同问题距离与主题变化的复用实验,比单一去question协议更接近服务负载。
- 如何兑现压缩表示? 需要将变长系数布局、按需重建、RoPE、GQA和attention融合,并计入模型侧基、元数据和临时张量;最后报告峰值显存、TTFT、吞吐和多请求并发。
- 如何处理精确锚点与量化的取舍? 固定步长兼顾不了所有任务;若自适应改变精确预算,应在独立校准集确定规则,而不是逐任务看结果调参。
- “保留所有token”是否足够? 极低预算结果表明非零表示不保证可用信息。应分析重要token的重建误差与最终注意力/答案变化,而不只统计是否被删除。
5.4 建议的组会阅读顺序
先读图2和式(3)–(6),理解预算如何分给残差系数;再看表1、表15,识别最干净的flat消融;接着把表2与表18一起读,避免过度概括KVzip比较;最后看§4.4、A.19–A.21,明确运行时、机制和适用范围。英文幻灯片按约25分钟主讲加备份页组织,所有原图均附最终图号与页码。
本次交付为原文分析,不是全文翻译或实验复现。共享笔记时请同时保留 figures/;每张图的作者源文件、最终图号和来源页码记录在 图件清单。