Looped Latent Attention:跨循环 KV 压缩精读
- 论文:Looped Latent Attention: Cross-Loop KV Compression for Looped Transformers
- 作者:James O’Neill、Fergal Reid(Fin AI Research)
- 版本:arXiv:2607.15456v2,2026-07-24;获取与研读日期:2026-09-20。
- 原始材料:本地 PDF、同版本作者 TeX
main_minimal.tex、其实际调用的results_space_optimized.tex、图件及参考文献main.bbl。阅读覆盖正文 Sec. 1–9、附录 A–J;页码均为 PDF 页码,本版本与印刷页码相同。未执行作者训练程序,以下是原文分析与一致性核验,不是独立复现实验。 - 配套:英文组会幻灯片 · 可编辑 TeX。
论文总览
循环 Transformer 复用模型权重,但历史 token 在每一轮循环仍留下各自的 K/V,因此参数共享不等于缓存共享。LLA 的贡献是把每个 token、层、头的跨循环 K/V 拼接向量编码成低维潜变量(latent),读取时用循环专属投影恢复 K/V。模型主体冻结,压缩器通过教师激活的 SVD 初始化,再用蒸馏调优。应保留的是一段低维轨迹,而不只是最后一个循环状态。
证据最扎实的部分是:循环轴比头轴、层轴更适合压缩;缓存标量数可精确计算;实测能增加单卡可容纳批量。质量结论必须附条件:Huginn 的 32× 近无损主要指教师给定 token 上的保真度;Ouro 的长生成会暴露前缀漂移;最大容量路径当前没有吞吐优势。原文还存在正文、图注与表格不一致,见结果部分的逐项核验。
结构地图
| 原文结构 | 作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 权重共享与循环缓存增长的矛盾 | pp.1–2 |
| 2 Related Work | 区分 MLA、跨层共享、量化、驱逐与 MELT | p.2 |
| 3 Looped Latent Attention | 编解码、压缩率、RoPE、SVD 与蒸馏 | pp.3–4,图1、式(1)–(5) |
| 4 Cross-loop structure in the teacher cache | 光谱、收敛轨迹和跨模型机制 | pp.4–6,图2–4 |
| 5 Experiments | 广泛任务、等缓存轴比较、规模、消融和 Huginn | pp.6–9,图5–6、表1–3 |
| 6 Long-generation stability | on-policy 蒸馏及长上下文检索 | pp.9–11,式(6)–(7)、图7–8、表4 |
| 7 Serving and compute | 存储、批量、延迟与吞吐的区别 | pp.11–12,表5 |
| 8 Discussion / 9 Conclusion | 适用区间、原生 latent 架构方向 | p.12 |
| A Experimental details | 转换训练、样本数、解码器、硬件 | pp.14–15,表6 |
| B Additional figures | 2.6B 性能曲线与容量曲线 | pp.15–16,图9–10 |
| C Compression Across The Broad Suite | 多任务完整表和冷启动 rank 扫描 | pp.16–17,表7–8 |
| D Token-eviction composition table / E On-policy rank Pareto (figure) | 与驱逐组合、额外复评 | p.17,表9、图11 |
| F Design-ablation detail | 初始化、rank 配比、损失 | p.18,表10、图12 |
| G Full 2.6B commonsense and knowledge suite / H Cross-loop stabilization at 2.6B | 全量选择题与结构诊断 | p.19,表11、图13 |
| I Long Context Retrieval Details | 精确检索完整数值 | p.20,表12 |
| J Additional serving and discussion details | 预填充、吸收式 attention、RoPE 误差 | pp.20–21,表13–14 |
一:动机
1. 省下参数之后,缓存仍然按循环次数增长
设共享堆栈有 $D$ 层,执行 $T$ 个循环。每一循环的隐状态不同,同一个投影矩阵也会输出不同 K/V。对每个历史 token,缓存要保存 $T\times D$ 组层状态。Ouro-1.4B 使用 $D=24,T=4$,缓存规模对应 96 个有效层,而权重只对应共享的 24 层(Sec.1,p.1)。
这主要在长上下文、大 batch 场景成为瓶颈;不能把引言“限制推理的是缓存而不是权重”推广到所有短上下文或小 batch 工作负载。
2. 为什么优先选择循环轴
现有压缩分别减少头/通道、层、精度或历史 token。LLA 的假设是:同一组权重反复变换隐状态,让跨循环轨迹比不同头或不同层的表示更冗余。图2中循环轴归一化有效秩约为 0.61–0.63,首方向约承载 60% 能量;头轴和层轴更接近满秩。这里的光谱诊断是实验证据,不是关于所有共享权重网络的定理(Sec.4,p.5)。
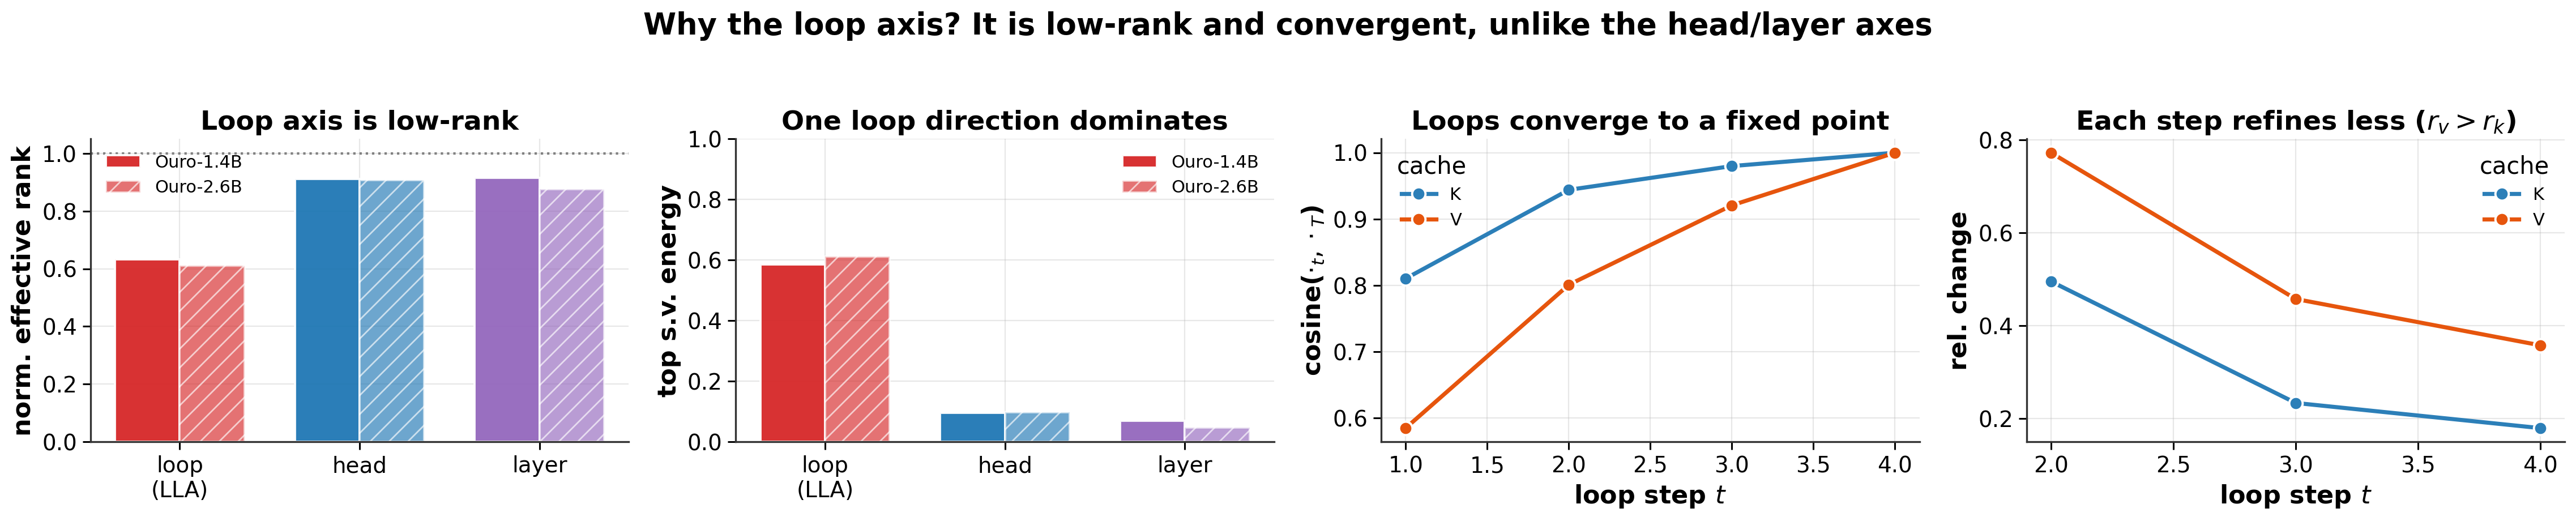
原图2,PDF p.5。前两个面板比较轴的归一化有效秩与第一方向的能量;后两个面板横轴为循环步,纵轴分别表示与最终状态的余弦相似度和相邻步相对变化。两种证据需分开:收敛不蕴含低秩;LLA 需要的是在激活中实际测得的可压缩性。循环数只有 4 的诊断也不意味着整个跨 token 缓存可以被一个标量表示。
3. 为什么不能直接复制最后一轮
若所有循环真的等价,保存最终 K/V 就能免费得到 $T$ 倍压缩。但在表1的 Ouro-1.4B 对照中,最终循环复用的 GSM8K 为 0.000,LLA 4× 为 0.800;该控制的 K/V 相对重建误差分别为 0.35/0.60(p.7)。这支持“不同循环状态仍具有功能差异”。它没有直接否定经过训练的所有单状态方法:MELT 仅在相关工作中讨论,本文没有用同一预算训练并测量 MELT。
二:方法
1. 输入、输出与维度
下表按单个 token、单层、单头定义;K 与 V 分别执行同一种过程。
| 符号 | 意义 / 维度 |
|---|---|
| $T,D,H,d_{\rm head}$ | 循环数、共享层数、头数、头宽度 |
| $x_t$ | 第 $t$ 轮的 pre-RoPE K 或 V,宽度 $d_{\rm head}$ |
| $x=[x_1;\ldots;x_T]$ | 按循环拼接,宽度 $T d_{\rm head}$ |
| $\mu,\mu_t$ | 校准集拼接均值及其第 $t$ 个切片 |
| $W_{\rm down}$ | $(T d_{\rm head})\times r$ 的编码矩阵 |
| $c$ | 宽度 $r$ 的缓存潜变量 |
| $W_{{\rm up},t}$ | $d_{\rm head}\times r$ 的循环专属解码矩阵 |
| $r_k,r_v$ | K、V 潜变量宽度,默认 $r_v>r_k$ |
按原文行向量写法,式(2)–(3)为:
编码器把整个轨迹存成坐标,解码器根据当前循环恢复相应状态。这里不是给整个序列共用一个固定大小记忆:每个历史 token 都有自己的 latent,缓存仍随序列长度线性增长。循环专属均值和投影是跨 token 共享的固定参数。(Sec.3,pp.3–4。)
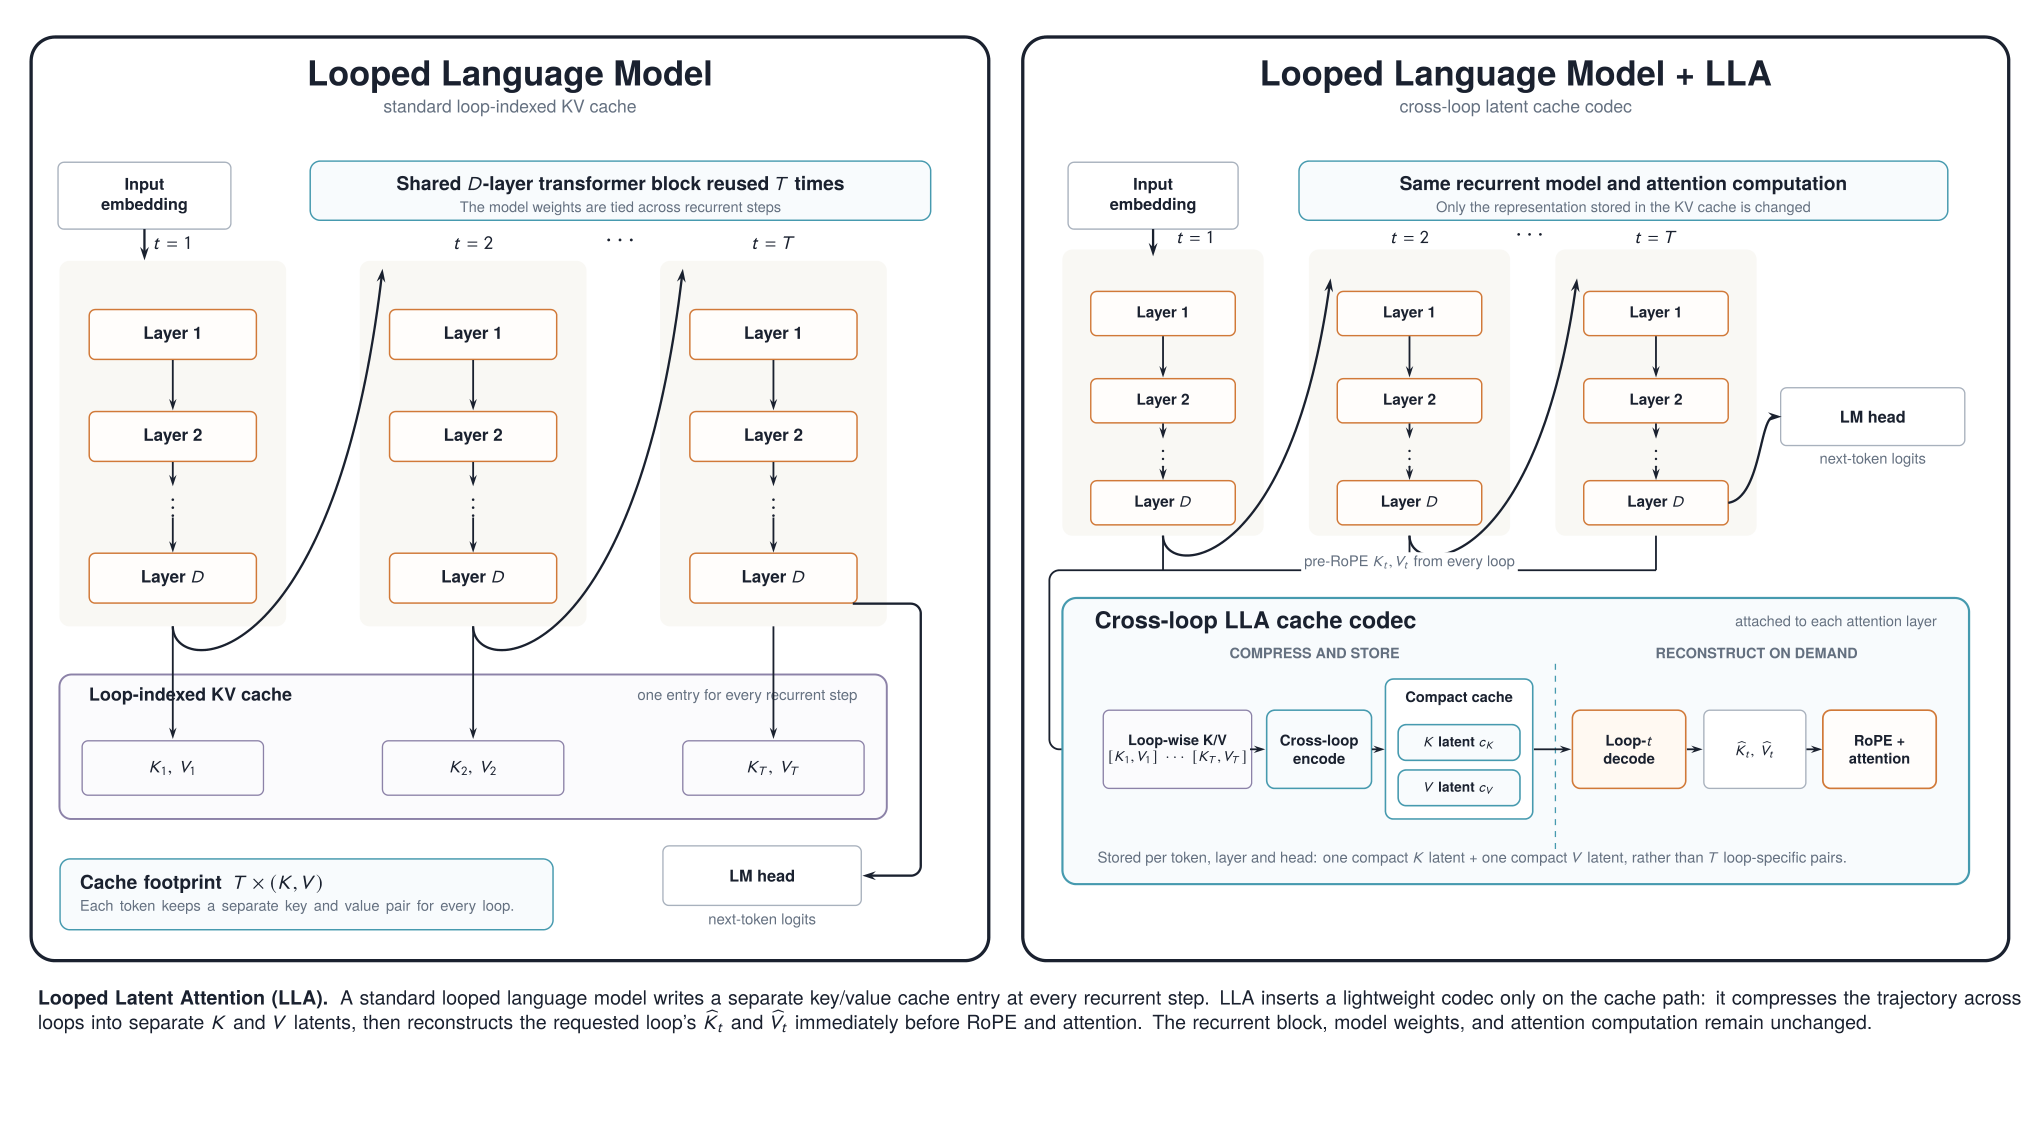
作者原图1,PDF p.3。左侧是循环独立缓存;右侧把跨循环 K/V 编码为两个潜变量,再为指定循环解码。图件来自作者矢量原图,并核对最终 PDF;小字用于查阅,方法以本节公式为准。
2. 精确压缩率算的是什么
原缓存每 token、每层有 $2THd_{\rm head}$ 个标量,LLA 有 $(r_k+r_v)H$ 个,故式(4):
教学代入:Ouro-1.4B 的 $T=4,H=16,D=24,d_{\rm head}=128$,取 $(r_k,r_v)=(96,160)$,每层从 16384 个标量降为 4096 个,恰好 4×。bf16 下,全模型每 token 从 768 KiB 降为 192 KiB,与表5一致。
精确的是相同精度下持久缓存的标量比例,不是质量无损、总显存同比例缩小或时间同比例缩短。固定编码器参数、临时重建张量、模型权重和工作空间不包含在该式内。即便 latent 很小,也不减少原模型循环次数。
3. 为什么 pre-RoPE、为什么 K/V 不同秩
同一 token 在所有循环的位置相同,先压缩内容投影,读取时恢复 K 后再施加该位置的 RoPE,可以沿用原模型的全维旋转。主质量结果走这条完整 RoPE 路径;它不要求把主模型改成原生 MLA。
V 的循环变化收敛更慢,需要更多容量。表10同预算比较 $96/160$ 与 $128/128$,前者 held-out KL 为 0.105,后者 0.129。这是默认非对称分配的依据,不构成所有模型最优分配都是固定 3:5 的结论。
4. SVD 初始化与离线蒸馏
先在校准 prompts 上收集拼接激活,对中心化矩阵做 SVD,取前 $r$ 个右奇异向量作为 $W_{\rm down}$,其循环切片初始化解码矩阵。对单个激活样本来说,编码是投影到从许多样本估计的公共子空间,不是为每个 token 现场重新做 SVD。
随后冻结教师,只训练 codec。式(5):
第一项匹配下一 token 分布,第二项匹配各循环、各层 attention 输出。它优化模型功能保真度,而不只优化 K/V 的欧氏重建误差。SVD 利用几何先验;蒸馏再修正哪些重建误差对模型最重要(Sec.3,p.4)。
5. On-policy:改变用于蒸馏的前缀分布
用 $p_T$ 表示教师、$p_S^\theta$ 表示带 codec 的学生,式(6)–(7)(p.9)可写为:
学生先生成,再让冻结教师对学生访问过的前缀给分布监督。sg 阻止梯度经过采样过程。目标仍是教师分布,没有正确性奖励、答案过滤或强化学习奖励模型。它纠正“训练在教师轨迹,部署在学生轨迹”的分布错位,却不能保证补回已经被极小 latent 删除的信息。
6. LLA-2D 与真实推理流程
LLA-2D 把头轴也拼接进去:每 token、每层存一组 K/V latent,标量数为 $r_k+r_v$。固定 ranks 时比 per-head 少 $H$ 倍;但等缓存比较须相应改变 ranks,不能把这个倍率当成免费的额外收益。其输入宽度为 $THd_{\rm head}$,更大的联合投影和更难压缩的头轴带来参数/质量代价。原文报告 Huginn 的长循环情形下该变体参数不可行,但未给出完整参数内存账单(Sec.3、5;App.J)。
工程上跨循环 $x$ 必须先被获得,不能只写下线性公式就假定是无额外代价的单次前向。附录A明确描述质量评测的两遍解码:先捕获教师 pre-RoPE K/V、编码并重建,再重新前向并注入重建值,由模型执行 RoPE 和缓存。冷启动扫描使用更早的 streaming 解码器。另一个 latent-store 路径只持久保存潜变量,读时重建;长预填充按层重建并释放临时量。这些实现差异是解释实验与成本的必要条件。
三:实验
1. 训练设置与评价对象
主要模型是 Ouro-1.4B,规模实验是 Ouro-2.6B-Thinking(均 4 循环),架构迁移是 Huginn-3.5B(32 循环)。附录A(pp.14–15)报告:255 个校准 prompts;常规转换 3000 steps,消融 300 steps;batch 8、序列长512、AdamW、学习率 $10^{-3}$、warmup100、余弦衰减至5%;每200步在32个 held-out 样本上测 KL,并选最佳 KL checkpoint。训练和评价使用 bf16。容量/延迟在单 H200;生成评测使用 B200,长文本和2.6B运行设每进程内存比例0.99。
校准数据具体来源、on-policy 的完整步数/采样温度等可复现细节在所读正文与附录中未完整报告;不以常用配置补齐。
2. Baseline 与指标
| 对照 / 指标 | 解释与方向 |
|---|---|
| mla_head | 每轮独立压缩头轴,检验预算应花在哪个轴;不是重训一个原生 DeepSeek 模型 |
| cla | 相邻层共享 K/V,检验层轴;附录列共享跨度4、6、12、24 |
| kv_quant | 推理时低位宽 K/V;2、3、4、8 bit,无训练 KL;与 bf16 比最高约8× |
| final-loop reuse | 无可训练参数,只缓存最终循环;用于检验端点是否足够 |
| LLA-2D | 方法族内变体,联合循环和头轴 |
| train-KL ↓ | 名称易误导:附录定义为 held-out、教师强制的 KL,解码器无关 |
| GSM8K EM ↑ | 最终答案 strict exact match,自由生成结果 |
| MC-avg / MMLU ↑ | 给定文本的选择题 loglikelihood 准确率;不是自由长生成 |
| HumanEval / MBPP ↑ | EvalPlus pass@1,base 与 plus 测试分别报告 |
| MATH-500 ↑ / no-ans ↓ | 符号等价最终答案;无可抽取答案不完全等价于严格“不终止” |
| Passkey ↑ | 随机深度的5位数字精确召回,每格15次 |
| max batch ↑ / ms per token ↓ / tokens/s ↑ | 能装下多少请求、单步延迟、吞吐,三者不可互换 |
3. 必须保留的协议差异
| 实验 | 样本与生成设置 | 解释限制 |
|---|---|---|
| 1.4B GSM8K 等缓存对照 | 5-shot、最多256 tokens;教师1319题,codec与对照100题;faithful re-forward | 同表压缩方法用相同题,教师并非同一规模子集 |
| 冷启动 rank 扫描(表8) | codec200题、教师100题;较早 streaming reconstruction | 与表1的 checkpoint 和解码协议不同 |
| 广泛任务(表7) | 附录声称1.4B codec GSM8K100题、faithful;表内 GSM8K数值却与表8逐项相同 | 原文没有充分解释这套数值沿用关系 |
| 2.6B GSM8K(表2) | 2-shot;教师、per-head、head基线1319题;LLA-2D100题 | LLA与head的全量比较更有力;不能假定所有变体样本量相同 |
| MATH-500 | 4-shot、最多2048 tokens、batch1;教师500题,codec200题 | 图7另标 $n=300$ each,应与表4区分 |
| BBH | 3-shot、最多1024 tokens;教师675题、codec135题 | 教师25题/子任务,codec5题/子任务 |
| 代码 / MMLU-Pro / MC suite | 代码164/378题完整集;MMLU-Pro与MC完整集 | MC为0-shot likelihood,不检验前缀漂移 |
| Passkey | 5个key×3个深度,2k–64k,latent-store | 每格15次,0.87约对应13/15 |
四:结果
1. 跨循环结构:低秩与收敛是两个现象
图2–3(p.5)显示:循环表示逐渐接近最终状态,但每个 token-head 的轨迹仍有非首方向成分;作者报告只有约6%的K方差、17%的V方差归因于循环轴,大部分仍是内容变化。图4(p.6)和图13(p.19)分别在 Huginn 与2.6B上复现收敛趋势。不能据此声称整个循环计算可以同样低秩化;本文主要测的是缓存。
2. 广泛任务与冷启动 rank:温和压缩也并非所有任务无损
以下选自表7(p.16),都是准确率/通过率,越高越好;代码取 base:
| 模型 | GSM8K | HumanEval | MBPP | MATH-500 | BBH | MMLU-Pro |
|---|---|---|---|---|---|---|
| Teacher | .794 | .707 | .720 | .74 | .708 | .481 |
| LLA 1.33× | .795 | .756 | .725 | .70 | .705 | .467 |
| LLA 2× | .750 | .744 | .733 | .63 | .677 | .469 |
| LLA 3.20× | .575 | .591 | .646 | .72 | .495 | .399 |
| LLA 4× | .590 | .610 | .616 | .52 | .527 | .416 |
1.33×多数任务接近教师;到2×,MATH-500已经由.74降至.63,不能把所有差异都解释成统计噪声。正文和图5图注声称代码与MMLU-Pro直到4×仍达到/超过教师,但图5实际曲线和表7均不支持此句:4× HumanEval .610 < .707,MBPP .616 < .720,MMLU-Pro .416 < .481。本文以最终 PDF 的具体数字为准。
冷启动表8(p.17)的 GSM8K 在4×、3.2×、2.67×分别为.590、.575、.575,到2×变为.750,到1.33×为.795(教师参考.820)。这是特定协议下的拐点。训练 KL 并未在4×到2×间同步大降(.0160→.0155),说明细小 token 分布差异与最终答对之间并非简单线性关系。作者关于“保住决策 token”的解释有启发性,但没有额外因果干预直接定位这些 token。
3. 等缓存比较:循环轴有优势,不能宣称逐项全胜
表1(p.7),Ouro-1.4B,4×预算:
| 方法 | held-out train-KL ↓ | GSM8K ↑ | MC-avg ↑ | MMLU ↑ |
|---|---|---|---|---|
| Teacher(1×) | — | .794 | .646 | .682 |
| Final-loop reuse | — | .000 | .443 | .537 |
| LLA | .059 | .800 | .640 | .672 |
| mla_head | .122 | .522 | .585 | .657 |
| cla | .267 | .660 | .597 | .666 |
| kv_quant | — | .702 | .645 | .672 |
LLA明显优于头/层压缩的生成质量;量化在4×仍有竞争力,MC-avg略高于LLA,因此不是所有指标都由LLA最佳。到5.33×,LLA GSM8K .752,head .180,quant .122,LLA-2D .760;到21.33×,LLA .740,head .680,LLA-2D .723。高倍率下LLA-2D的KL .097优于per-head .128,但生成更差,再次说明不能只看KL。
这里的4× .800和表7/8的.590不能组成同一条质量曲线;论文明确提示 checkpoint 和评测协议不同,附录又暴露了广泛任务与冷启动表的数值沿用问题。较谨慎的结论是在特定等缓存实验中轴的排序支持LLA,而不是任意4×转换都保证保住80%的GSM8K绝对准确率。
4. 扩大模型:Ouro-2.6B 保留相同排序
表2(p.8)中LLA在4×、5.33×、10.67×的全量GSM8K分别为.834、.817、.821,teacher约.83;head为.585、.772、.775。4×二者差24.9个百分点。表11(p.19)MC均值从teacher .653到LLA .645/.646/.640;head为.599/.606/.601。层共享在4×/6×/12×得到.602/.596/.575,后两个倍率并不与LLA完全对齐。
因此支持跨规模的轴选择,并不能推出压缩率越大质量越好;不同rank的训练、最优checkpoint和评测波动使局部数值非单调。
5. 消融:最大的收益来自 SVD 初始化
表10(p.18),相同4×预算、300步:
| 变更 | held-out KL ↓ |
|---|---|
| SVD + 96/160 + attention matching | .105 |
| 仅 $t=1$ SVD 初始化 | .128 |
| 随机初始化 | .771 |
| 对称 128/128 rank | .129 |
| 只用 KL loss | .110 |
随机/SVD约为7.34倍,原文称“一个数量级”是概括,不应写成精确10倍。非对称rank带来更明显收益,attention匹配只提供较小额外改善;论文未给出这些小差异的多种子显著性检验。
6. Huginn 迁移:32× 的边界是 decoder-independent fidelity
表3(p.9),32循环:
| 压缩 | $r_k/r_v$ | SVD KL ↓ | SVD top-1一致率 ↑ | 蒸馏后KL ↓ | 最佳top-1 ↑ | MC-avg ↑ |
|---|---|---|---|---|---|---|
| Teacher | — | — | — | — | — | .523 |
| 16× | 128/256 | .005 | .970 | — | .970 | .523 |
| 32× | 64/128 | .010 | .954 | — | .954 | .525 |
| 64× | 32/64 | .197 | .799 | .145 | .834 | .486 |
| 128× | 16/32 | .763 | .620 | .177 | .812 | .473 |
SVD alone在16–32×就较好地保留教师分布;蒸馏显著挽回128×保真度,但MC仍低于教师。正文报告等预算头轴SVD重建差20–30倍,但表3没有完整列出头轴数值,不能自行补出各rank的差值。这是不同模型族的有力支持,却没有验证Huginn自由长生成质量或同倍率真实服务吞吐。
7. 长生成:on-policy 修正漂移,但改善终止不等于答对
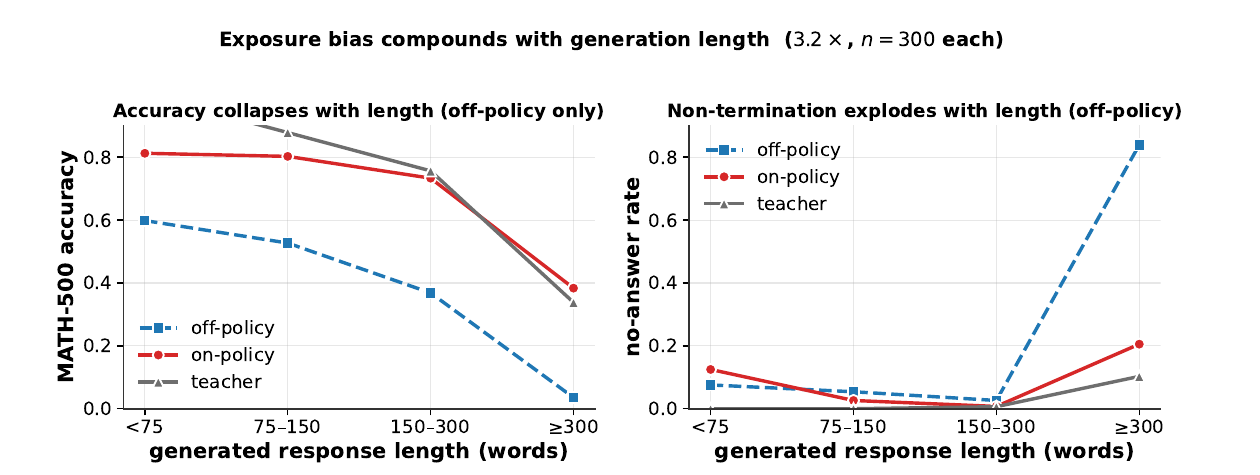
原图7,p.10,3.2×、图内标注每组$n=300$。横轴为生成词数区间;左图准确率,右图无答案率。蓝线off-policy随长度明显恶化,红线on-policy更接近灰色教师。但按生成长度分组本身混入题目难度和不同方法生成长度的变化;图支持漂移解释,不能把分组相关性当作单独控制难度的因果实验。
表4(p.10):
| 压缩 | off准确率 | on准确率 | 绝对变化 | off无答案率 | on无答案率 |
|---|---|---|---|---|---|
| 3.2× | .460 | .700 | +24个百分点 | .21 | .06 |
| 4× | .430 | .660 | +23个百分点 | .15 | .03 |
| 5.33× | .530 | .690 | +16个百分点 | .12 | .03 |
| 10.67× | .650 | .690 | +4个百分点 | .09 | .07 |
| 21.33× | .660 | .620 | −4个百分点 | .11 | .05 |
4×的.43→.66对应23个百分点,约53.5%相对提升。最高压缩点无答案更少却答对更少:on-policy能改变轨迹和结束行为,并不保证修复表达能力不足。表7的MATH-500 4×为.52,不能直接替代这里的off-policy .43;不同实验组需分别引用。图11(p.17)给出额外复评及bootstrap95%区间,不应据此声称所有表格均有同等统计保障。
8. 长上下文:存得下与精确记得住是两个门槛
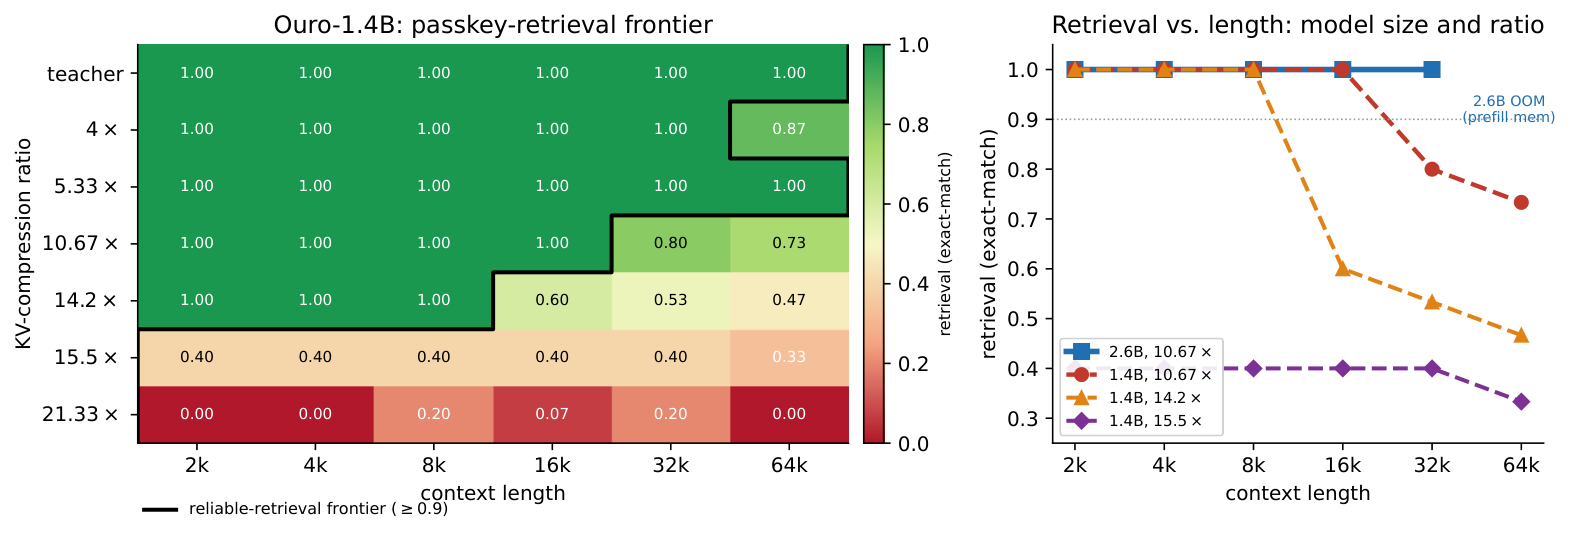
原图8,p.11。热图列是上下文长度,行是压缩率,颜色为精确召回;右图对比模型大小与倍率。每格15次实验,黑阶梯是经验可靠检索边界而非理论阈值。
表12(p.20)显示:teacher在2k–64k为1.00;5.33×在整个区间为1.00;4×在64k为.87,低于正文所称“可靠”阈值.9。所以“≤5.33×均可靠到64k”存在例外。10.67×到16k为1.00,32k .80,64k .73;21.33×大多仅0–.20。图8另给14.2×在8k后下降、15.5×在各长度约.4的区间。2.6B在10.67×可保持1.00到32k,64k为OOM,不是检索准确率0。
作者将“固定latent预算分给更多位置”作为退化解释,但这里每token的latent宽度固定,总缓存仍随长度增长。更准确地说,更长上下文使有损表示下的检索更困难;论文没有证明一个全局固定容量在位置间被摊薄。
9. 服务:容量提升明确,当前吞吐下降
表5(p.11):
| 数量 | Teacher | LLA 4× | LLA 21.3× |
|---|---|---|---|
| 1.4B KV/token | 768 KiB | 192 KiB | 36 KiB |
| 1.4B 4k最大batch | 32 | 128 | 768 |
| 2.6B 4k最大batch | 16 | 64 | 未测 |
| full-memory fast path延迟 | 63.6 ms/token | 74.1 ms/token | 未测 |
| capacity path峰值吞吐 | 748 tokens/s | 未测 | 108 tokens/s |
批量测试是构造decode cache后推到OOM,并验证latent attention与完整重建一致;不是768条真实长推理请求的完整端到端SLA测试。32→768是24倍最大batch,而21.3×是缓存压缩比,两种比例不必严格相同,离散batch搜索和其他显存项也会影响结果。
full-memory fast path保存完整重建K/V,较教师延迟约增加16.5%,没有兑现缓存压缩。latent-store兑现存储收益,但读时重建,作者报告的端点吞吐从748降到108 tokens/s。因此本文应被理解为容量工作,而不是已经部署可用的解码加速方案。
表5把1M上下文缓存写为768/192/36 GiB;该账面数使用约$2^{20}$ tokens的二进制口径。它不表示未经驱逐的1M真实任务已完成质量测试。附录J组合1024-token驱逐后为36 MiB,计算是36 KiB×1024;不是把100万个token的信息全部无损保存在36 MiB里。
10. 驱逐组合与 absorbed attention
表9(p.17)用260-token保留预算(sink4+window256)评估GSM8K:8bit量化基础上的驱逐对照.510,LLA4×+驱逐.520。约1k-token few-shot prompt被驱逐约74%,这两组相比无驱逐约.79都有明显损失。观察支持该配置下叠加LLA没有明显额外代价,不能声称驱逐本身无质量成本或在所有任务上完全正交。
附录J(pp.20–21)利用双线性关系(以下列向量写法)尝试把解码投影吸收到attention里:
这样有希望不显式重建所有历史K/V,但完整RoPE依赖位置,阻碍直接吸收。作者改用NoPE内容路径加显式旋转分支:表13在随机权重、匹配形状的kernel benchmark中,262144上下文absorbed为4.25 ms/token,teacher4.46,较重建后attention快2.30倍。不能与主表63.6/74.1 ms混成同一套端到端数据。
精度代价见表14:full-RoPE KL .059;decoupled无query adapter .55;有adapter .34;延长训练 .30。$d_{\rm rope}=64$,top-1一致率adapter .84、延长训练 .88,完整RoPE约.95;$d_{\rm rope}=32$加adapter KL为1.04。于是主质量与加速路径尚未合一。原生训练让query适应latent cache是作者展望,本文没有完成这一验证。
五:结论
最值得保留的设计启示是:共享权重循环产生的缓存具有可利用的跨循环相关性,但仍需保留循环间差异;为部署压缩时,应联合检验缓存大小、自由生成稳定性和实际内核成本。 SVD+少量codec蒸馏是把结构冗余转为存储收益的直接方法,on-policy蒸馏则针对转换后的前缀分布。
已支持与尚未支持
| 可以据本文支持 | 不能据本文直接推出 |
|---|---|
| 测试的循环模型上循环轴通常比头/层轴好压缩 | 所有Transformer都应先压缩循环轴 |
| 给定rank和相同精度,持久KV标量比例可精确计算 | 总显存、延迟、吞吐也获得相同倍率 |
| 某些中低压缩点的长推理可被on-policy修复 | 极端压缩损失的信息均可通过训练恢复 |
| Huginn32×教师强制保真度较高 | Huginn32×自由长推理近无损 |
| latent-store实测提高batch容量 | 主准确率、最大容量与kernel加速同时实现 |
原文一致性与复现清单
- 广泛任务文字过强:Sec.5/图5图注称代码和MMLU-Pro到4×不降,图5曲线与表7显示下降;以表7为准。
- 跨表协议不可混用:表1与表8有已说明的checkpoint/解码器/样本差异;表7 GSM8K逐项复用表8数字却有不同协议描述,仍待作者澄清。
- 长上下文总括有例外:4×、64k精确检索.87,不能满足≥.9的可靠标准。
- 统计保障有限:多个教师与codec使用不同样本规模;多数表没有多种子方差。轻压缩“drop-in”和“差异仅噪声”应按任务分别判断。
- 系统证据分离:真实省缓存路径、全缓存重建路径、随机权重absorbed微基准是三种条件;尚无同时兼顾质量、容量和速度的端到端证据。
- 实现复现待补:校准分布、on-policy完整训练配方、逐token跨循环编码时序及所有路径的峰值临时显存,需要结合实现进一步核验。本次未运行训练或推理复现。
若继续研究,优先做同一题目集、同一checkpoint、同一latent-store解码器下的rank扫描;再比较任务质量、prefill时间、decode吞吐及峰值显存。其次可检验自适应K/V秩和原生训练的RoPE/latent接口。这些是本次分析提出的后续问题,不是论文已完成的贡献。