SFDA:用相位控制扩展 Delta 记忆,并构造精确分块 WY 表示
论文:Semidirect Fourier Delta Attention: Phase-Controlled Delta Memory with Constructive Chunk-WY Kernels
作者:Tiantian Zhang (Crystal),Columbia University
版本:arXiv:2607.11897v1;研读日期:2026-10-20
原文:arXiv · 本地 PDF
原图许可:CC BY 4.0;原图作者同论文,教学示意图另行标注
配套:英文汇报 PDF · 可编辑 TeX
论文总览
SFDA 的核心改动是:在 Kimi Delta Attention(KDA)的“遗忘—误差修正写入”更新中,让旧记忆既可以缩小,也可以旋转。旋转的角度累计起来能够表示模计数等周期状态;把旋转限制在独立二维块中,则仍然可以利用“结构化矩阵减秩一修正”的形式组织计算。
主更新为
最值得保留的技术结果是构造性分块 WY 定理:对一个含 $C$ 个 token 的块,转移乘积可精确写成
而且作者给出了逐步生成这些因子的递推式、加性写入摘要和块内读出公式。计算时把块摘要作用到边界状态,然后在下一块重新建立因子,因而无需保存随整段序列增长的 WY 因子。
实证结果支持相位对受控计数任务的作用,但也显示学习误差会限制外推。手工构造的模 5 相位计数器在长度 8192 仍为 100%;学得的模 3 计数器从长度 32 的 100% 降到长度 256 的 34.1%,加入重置符号后则在测试长度 32–256 全部为 100%。本文的直接成果是理论构造和小型机制实验;融合内核吞吐、语言模型质量与更高线性层比例的混合架构仍是后续目标。(§§4、7–8,PDF pp.7–10、16–20)
结构地图
下表使用最终 PDF 的章节、附录编号;PDF 页码与印刷页码一致。
| 原文章节 | 作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 从 KDA 出发提出相位控制与分块计算问题 | pp.1–3 |
| 2 Background | 仿射组合、自动机、与 RoPE/SSM 的区别 | pp.3–5;表 1 |
| 3 Semidirect Fourier Delta Attention | 架构、稳定参数化、循环相位记忆 | pp.5–7;式 (13)–(26),表 2 |
| 4 Main Kernel Theorems | WY 闭合与构造、仿射块转移、读出、广义有限状态实现 | pp.7–10;定理 4.1–4.5、4.7 |
| 5 Compact Expressivity of Kernel-Compatible SFDA | 秩预算、循环群、二面体、寄存器与有界栈 | pp.10–14;定理 5.3、5.5、5.7、5.9、5.11 |
| 6 Chunk Algorithm, Cost, and Stability | 算法、复杂度、非扩张性与三角因子条件数 | pp.14–16;算法 1,定理 6.2,命题 6.3–6.4 |
| 7 Basic Experiments | 构造及学习的模 5 计数器 | pp.16–18;图 1,表 3–4 |
| 8 Experiments | 数值恒等式与模 3/重置计数 | pp.18–19;表 5–6;图 2 在 p.20 |
| 9 Related Work | 快权重、SSM、WY、相位与混合注意力背景 | pp.19–21 |
| 10 Limitations and Open Problems | 秩增长、控制族限制与系统实现缺口 | pp.21–22 |
| A Additional Proofs | 复相位、半直积与 WY 归纳证明 | pp.24–25 |
| B Constructive Algorithm Details | 因子递推、乘积顺序与写入摘要伪代码 | pp.25–27 |
| C Kernel Details and Rank-Growth Discipline | 跨块传播、数值与内核实现路径 | pp.27–30 |
| D Finite-State Expressivity and Automata Interpretation | 广义模板下的 one-hot 构造 | pp.30–33 |
| E Experiment Protocol | 尚待执行的大规模实验方案 | pp.33–34;不是结果表 |
| F Tied-Write Compilation over Structured Control Orbits | 写入方向的轨道路由与保护子空间 | pp.34–37;定理 F.2 |
| G Compact Expressivity Proof Details and Review-Driven Additions | 紧凑表示、离散读出和控制族条件 | pp.37–39 |
| H Details for Basic Experiments | 模 5 实验与另一组代数数值检查 | pp.39–41;表 8 |
一:动机——固定状态不仅要记住信息,还要正确演化
线性注意力用固定大小的矩阵状态存储历史,避免逐 token 增长的 KV 缓存。但在计数、栈操作或状态机任务中,关键问题不是“历史能否被压缩”,而是压缩后的状态能否连续执行正确的更新。例如模 5 计数器要求状态经过五次 $+1$ 后回到原点,同时每一步都能被读出。
KDA 把通道衰减与 Delta 规则结合起来:
实对角衰减擅长控制信息寿命,单位模复相位则直接提供周期轨道。SFDA 将二者组合成 $\alpha e^{i\theta}$:$\alpha$ 控制幅度,$\theta$ 控制方向。实验 A 中针对纯实对角控制的周期性限制,应理解为这个受限控制机制的限制;它不构成完整 KDA 在任意宽度、深度下无法学习计数的定理。
作者没有采用任意稠密旋转矩阵,是因为递归计算不仅要求转移可表达,也要求转移乘积可低成本表示。独立二维旋转在复坐标里是对角矩阵,其乘积仍然对角;这给 Delta 修正留下了清晰的低秩计算结构。(§§1–2,PDF pp.2–5)
“Fourier”在这里指用 $e^{i\theta}$ 这样的群特征表示周期状态,计算过程中不需要 FFT。与旋转位置编码(RoPE)相比,SFDA 旋转的是跨时间传递的记忆状态,而不只是 query/key 的位置特征。(§2.3、§3,PDF pp.4–5)
二:方法——相位搬运、Delta 修正和分块摘要
2.1 一个 token 如何更新记忆
以下优先使用论文的复坐标定义;$^*$ 表示共轭转置,在实数域退化为转置。
| 符号 | 维度或范围 | 含义 |
|---|---|---|
| $S_t$ | $\mathbb C^{d\times d_v}$ | 递归关联记忆 |
| $q_t,k_t$ | $\mathbb C^d$ | 读地址、更新地址 |
| $v_t$ | $\mathbb C^{d_v}$ | 当前目标值 |
| $\beta_t$ | 标量,主架构取 $[0,1]$ | Delta 修正强度 |
| $\alpha_t,\theta_t$ | 各 $d$ 个分量 | 幅度衰减和相位增量 |
| $\Lambda_t$ | $d\times d$ 对角矩阵 | 结构化相位—衰减控制 |
| $o_t=S_t^*q_t$ | $\mathbb C^{d_v}$ | 当前状态读出 |
把式 (13) 改写为以下三步,最容易理解其数据流:
这组等价改写是教学解释:先把旧记忆旋转并衰减,再沿当前 key 检查它预测的 value,最后仅写入预测误差。如果旧记忆已经给出目标 value,则 Delta 修正为零。
当 $\|k_t\|_2=1$ 时,沿同一 key 的更新满足
因此 $\beta_t=1$ 是沿该地址的完全替换,较小 $\beta_t$ 是插值修正。这里擦除和写入共享 $k_t$,故称为绑定写入(tied write)。输出随后由 $q_t$ 从更新后的状态读取。(§3,PDF p.5,式 (13)–(19))
2.2 相位如何存储离散状态
在一个相位专用坐标中,取 $z_0=1$、$\alpha_t=1$、$\beta_t=0$,并令
则
计数 $c$ 由圆周上的角度编码。加法变成旋转,模运算由复指数的周期性自动完成。非零初始状态很重要:若同时令 $z_0=0$ 并禁用写入,则任何旋转后仍是零。
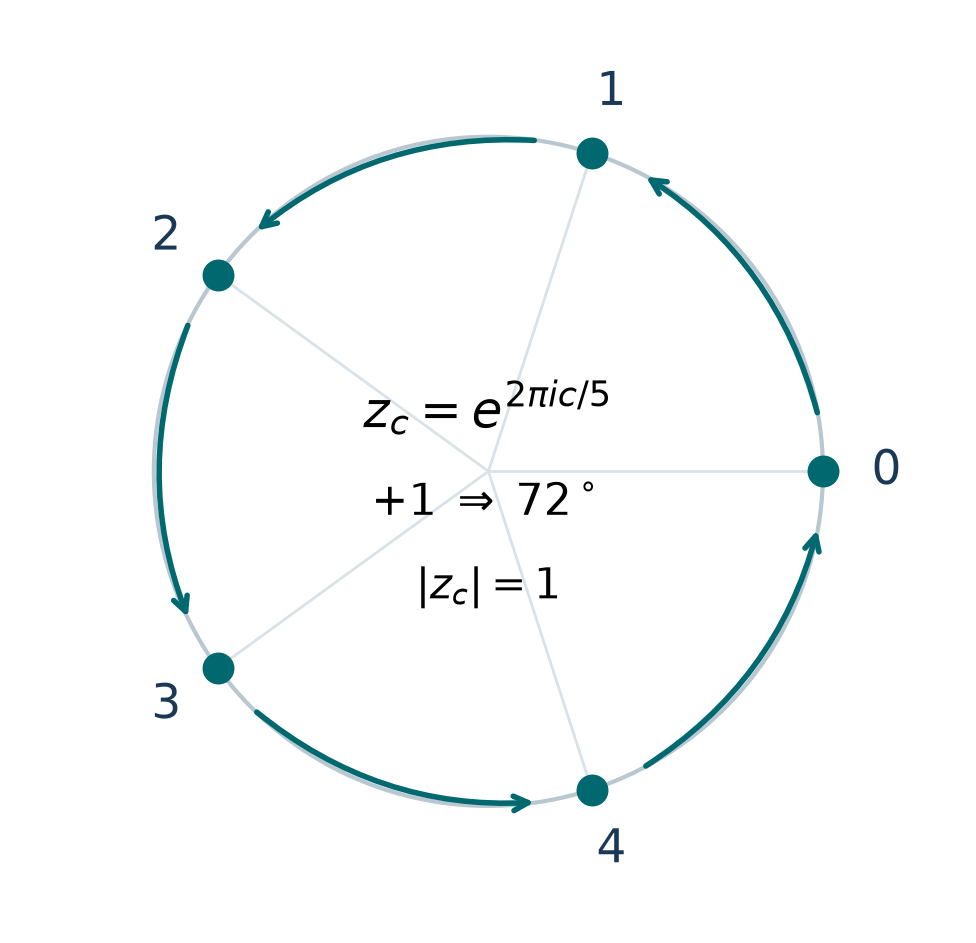
教学示意图,依据命题 3.4 绘制,并非论文实验图。五个点分别对应余数 $0,\ldots,4$;一次 $+1$ 旋转 $72^\circ$,五次后回到起点。离散标签可用最近相位原型分类器读出。(§3,PDF p.7;附录 G.2,PDF p.38)
在实张量中,一次复数乘法对应
这个等价性要求同一实二维块共享幅度衰减。它直接说明相位控制可以用实数运算实现;整个复 Delta 算子的实化还涉及秩和维度,见下文 3.6。(命题 3.3、引理 A.1,PDF pp.6、24)
2.3 主架构、广义控制和证明模板要分开
| 模型层次 | 转移形式 | 结论对应范围 |
|---|---|---|
| 实数 KDA 子族 | $(I-\beta kk^\top)\operatorname{diag}(\alpha)$ | 相位关闭且状态、投影均为实数时恢复 |
| 默认复相位 SFDA | $(I-\beta kk^*)\operatorname{diag}(\alpha e^{i\theta})$ | 相位记忆与绑定 Delta 更新 |
| 内核兼容的广义结构族 | $\Lambda-ur^*$,$\Lambda$ 可含低成本反射或部分置换 | WY 定理及条件化的二面体、栈构造 |
| 广义绑定写入模板 | $(I-\beta kk^*)\widetilde A$,$\widetilde A$ 不受结构限制 | one-hot 有限状态实现 |
WY 代数适用于一般 $\Lambda-ur^*$,不依赖 $u,r$ 必须绑定为 Delta 形式。真正决定内核成本的是 $\Lambda$ 的乘积和作用是否便宜。默认相位族只是其中一个具体选择。(表 2,PDF p.6;定义 5.1–5.2,PDF p.11)
广义有限状态定理的构造很直接:把状态 $q_i$ 编码为 $e_i\in\mathbb R^N$,为每个输入符号 $\sigma$ 设置
再取 $\widetilde A_\sigma=P_\sigma$、$\beta_\sigma=0$,递推就变成 $z_t=P_{\sigma_t}z_{t-1}$。$P_\sigma$ 每列恰有一个 1,但重置可把多列映到同一行,所以它不一定可逆,也不一定是置换矩阵。这里维度等于状态总数 $N$,而不是原始问题的压缩状态维度。(定理 4.7,PDF p.9;附录 D.2,PDF p.31)
2.4 从一个秩一修正到一整个块
定义
这里 $r_t$ 是 WY 右侧向量,不是 value;原文 §3 先用 $w_t$,§4 改用 $r_t$。有
展开两个时间步:
前三项分别是纯控制传播和两次单独修正,最后一项是两次修正的相互作用。WY 中的三角矩阵 $M$ 正是把这些相互作用集中记录下来,避免显式形成稠密的 $d\times d$ 转移乘积。
令 $P_t=A_tA_{t-1}\cdots A_1$。初始化 $\Gamma_0=I$,$Y_0,W_0,M_0$ 为空,按下式递推:
则始终有
$Y_t,W_t\in\mathbb C^{d\times t}$,$M_t\in\mathbb C^{t\times t}$ 为单位下三角矩阵。$M_t$ 最后一行的负号负责正确表示上面展开式中带正号的交叉项;若改变乘积顺序,不能沿用这套因子更新。递推只用乘法、不需要 $\Lambda_t^{-1}$,因此零衰减也不破坏恒等式。(定理 4.2,PDF p.8,式 (34)–(39);附录 A.4、B,PDF pp.25–27)
2.5 加性写入和块内输出都必须保留
仅计算 $P_C$ 还没有完整模拟注意力,因为每个 token 都可能加入新值。令 $B_t=\beta_tk_tv_t^*$,则
最后一步写入对应空乘积 $I$。这个摘要可通过零初始状态递推得到:
完整边界转移是
这里的括号表示实际计算顺序:先投影到 $C$ 维,做三角混合,再映回 $d$ 维,而不是先计算稠密矩阵 $Y_C M_C W_C^*$。(定理 4.4,PDF pp.8–9;算法 1,PDF p.14)
对块内任意前缀 $r\le C$,同样有
因此块摘要不仅能产生块末状态,前缀因子也能生成每个 token 的输出。不过这些恒等式本身还没有给出融合后的完整前向、反向内核;逐前缀物化因子或重复应用公式的开销需要由实现进一步解决。(定理 4.5,PDF p.9)
2.6 “Semidirect”对应仿射组合
两步更新 $S\mapsto A_1S+B_1$、$S\mapsto A_2S+B_2$ 组合后为
第二步的控制会搬运第一步写入的内容,这就是存储部分与控制部分的半直积关系。结合律保证按块重新加括号仍然精确。困难不在“是否可以扫描”,而在每个摘要有多大、组合需要多少计算。(§2.2,PDF p.4,式 (10);引理 A.2,PDF p.24)
三:理论分析——精确性、成本与表达范围
3.1 秩上界是块内预算
由 $P_C-\Gamma_C=-Y_CM_CW_C^*$ 可知
但若连续擦除不同坐标,取 $A_i=I-e_ie_i^*$,则
这个具体例子说明,不能期望保持一个远小于 $d$、且独立于序列长度的通用精确修正秩。因子列数可以随组合次数增长,实际矩阵秩最多饱和于 $d$。
作者推荐在每块内部允许秩增长到 $C$,然后把摘要应用于固定大小的 $S$。跨块顺序传播边界状态,或者在更大的 superchunk 内允许更大秩。将组合摘要重新压缩到小秩的 QR/SVD 路线通常引入近似。(定理 5.3、命题 5.4,PDF pp.11–12;§6,PDF p.15)
这个秩条件是“由至多 $C$ 个原语生成的转移”必须满足的表示性质。论文没有证明所有满足 $\operatorname{rank}(P-\Gamma)\le C$ 的矩阵都能由受限的绑定 SFDA 参数生成;定理中所谓 converse 是对已生成转移进行精确因子化,并非任意低秩扰动的充分可实现性定理。
3.2 参考复杂度保留了 value 宽度
| 每块操作 | 原文参考上界 |
|---|---|
| 保存 $(\Gamma,Y,W,M,B)$ | $O(d+dC+C^2+dd_v)$ |
| 显式构造 $(\Gamma,Y,W,M)$ | $O(dC^2+C^3)$ |
| 零状态写入递推 | $O(Cdd_v)$ |
| 把摘要应用于边界状态 | $O(dd_v+dCd_v+C^2d_v)$ |
若有 $T/C$ 个块,把以上构造、写入与边界应用加总,可以得到
这一参考量级,忽略较小项。此式是按定理 6.2 汇总出的解释,尚未计入投影、全部 token 读出、反向传播和设备访存。固定 $C$ 时它对序列长度 $T$ 为线性;如果 $d_v=d$,状态更新仍含 $O(Td^2)$ 项,不能把“对宽度线性”理解成对共同宽度 $d$ 也是线性。
实际加速依赖批量矩阵乘法、三角求解、相位前缀计算和访存融合。朴素构造里存在 $C^3$ 项,零状态写入仍是递归实现;论文给出了优化方向,没有报告成熟 GPU 内核的速度。(定理 6.2,PDF p.15;附录 B.6、C,PDF pp.27–30)
3.3 稳定性:非扩张转移与有界写入不同
假设
则
证明的关键是 $I-\beta_tk_tk_t^*$ 在 $k_t$ 方向上的特征值为 $1-\beta_t\|k_t\|^2$,在其正交补上为 $1$,因此自身也是非扩张的。再利用谱范数次乘性即可。
若 $\|B_t\|_F\le b_t$,则
这允许写入累计导致状态增长。只有加入一致收缩 $\|\Lambda_t\|_2\le\rho<1$,才得到
当 $b_i\le b$ 时,后项不超过 $b/(1-\rho)$。保留无衰减周期状态与严格收缩是不同的设计取舍。(命题 6.3,PDF pp.15–16,式 (74)–(75))
稳定参数化通过 sigmoid 控制 $\alpha,\beta$,用 tanh 控制 $\theta$,并归一化 key,使更强条件 $\beta\|k\|^2\le1$ 成立。精确自动机构造常使用 $\beta=0$ 或 $1$、$\alpha=1$,这些是允许参数集合中的边界值;普通有限 logit 的 sigmoid 一般只能逼近端点。因此,精确构造与可训练参数化之间还需要端点开关、固定通道或近似误差的说明。(式 (15)–(18),PDF p.5;本段末为实现分析)
对于 WY 因子,若可写 $M=(I+L)^{-1}D_\beta$,并且 $\|L\|_2\le\eta<1$、$\|D_\beta\|_2\le1$,才有 $\|M\|_2\le(1-\eta)^{-1}$。这是条件性界,不由 $\|A_t\|\le1$ 自动推出。实际递推状态稳定,也可能出现中间因子较大、相消或低精度误差。(命题 6.4,PDF p.16)
3.4 紧凑记忆构造及其控制条件
| 记忆系统 | 构造 | 必要的控制或状态条件 |
|---|---|---|
| $C_{m_1}\times\cdots\times C_{m_\ell}$ 循环计数 | 每个计数器一个复相位坐标 | $\ell$ 个复坐标,即 $2\ell$ 个实坐标;$\beta=0,\alpha=1$,非零初始化 |
| 二面体群 $D_m$ | 维护二维旋转/反射的表示矩阵 | 需加入反射或共轭;$S\in\mathbb R^{2\times2}$,共四个实状态量 |
| 寄存器覆盖/重置 | $(I-e_ie_i^*)S+e_i a^*$ | $\Lambda=I,\beta=1,k=e_i,v=a$;KDA 已可实现 |
| 深度 $h$ 的有界栈 | push:$Z_\downarrow S+e_1a^*$;pop:$Z_\uparrow S$ | 需加入零填充移位/部分置换,$h\times d_v$ 状态 |
循环群乘积有 $\prod_j m_j$ 个符号状态,但只需 $2\ell$ 个实坐标存储相位;这个节省针对状态维度,尚未计入读出成本与区分相邻相位所需精度。当 $m$ 增大,最近相位间隔 $2\pi/m$ 也会缩小。
二面体群包含翻转方向的反射,默认复对角相位只包含旋转子群,不能直接套用加入反射后的定理。矩阵状态 $S_t=\rho(g_t)$ 记录整个群表示,避免把一个向量轨道误当成全部方向信息。
有界栈的 push 仍与绑定写入兼容,因为 $e_1^*Z_\downarrow=0$,移位之后第一行本来就是空的,Delta 擦除不再破坏已有数据。满栈继续 push 的式子会丢弃最底层;若任务要求栈溢出报错或单独维护深度,需要额外状态或约定。
(定理 5.5、5.7、5.9、5.11,PDF pp.12–13;附录 G.2–G.4,PDF p.38)
3.5 写入路由为什么需要保护子空间
设希望实现解耦写入
若存在允许的结构化算子 $R_\sigma,\widetilde G_\sigma$,满足
且对所有可达状态 $x$ 有
则
第二个条件是可达方向条件:想写入的方向必须在 $k$ 的控制轨道上。第三个条件是保护条件:擦除不能损坏要保留的旧记忆。只证明 $Rk=w$,还不足以证明整个仿射更新可编译。(定理 F.2,PDF p.35)
固定二维块旋转只能在每个块中搬运质量。例如从 $e_1$ 出发,只能到达第一对坐标的单位圆,无法到达另一个块的 $e_3$。完整正交群可以到达任意单位向量,但成本结构不同;任意坐标对的 Givens 旋转可用至多 $d-1$ 步完成方向路由。路由能力、额外微步和内核成本因此需要一起考虑。(§4.2,PDF p.10;附录 F.5,PDF p.36)
3.6 两处需要补充的数学解读
复相位的实化,不等于把整个复秩一更新替换成实秩一更新。 命题 3.3 和引理 A.1 正确证明了 $\Lambda$ 的实化。对一般复 key,定义
完整复线性算子的实化满足
非零的复秩一算子因此对应实秩二算子。最小例子是 $k=1\in\mathbb C$:$\mathcal R(kk^*)=I_2$,而直接打包后的实 key $a=(1,0)^\top$ 只有 $aa^\top=\operatorname{diag}(1,0)$。
这是本次分析对实现口径的补充:若实现复 SFDA,就应保留复内积或等价的成对实更新;若实现“实秩一 Delta + 实二维旋转”,它本身仍适用实数域 WY 定理,但一般不能直接当作前者的逐元素实化。引言式 (2)–(3) 对整个更新的等价表述需要这一澄清;复秩 $C$ 的修正实化后可达实秩 $2C$。这不影响定理 4.2 分别在实数域和复数域中的代数正确性。
广义无约束模板的连续仿射提升可以比 one-hot 更直接。 原文定理 4.7 用 $N$ 维 one-hot 状态和 $\beta=0$ 实现任意 $N$ 状态自动机,结论成立。但附录 D.1 将一般连续仿射系统的多项式维度提升作为更强问题保留;按该处已经写出的“$\widetilde A_\sigma$ 不受限制”的模型,可以直接使用齐次坐标:
于是
只需 $D=d+1$。这是本次分析,不是作者提出的 SFDA 实现。它说明,真正有研究意义的难题必须把相位结构、稀疏性、稳定性或微步预算等限制加回来;无约束模板本身并不存在这里所述的维度障碍。(对照 PDF pp.30–33 的问题 D.1 与 D.5)
四:实验与结果——三种问题,三种证据
4.1 代数数值检查:两张表不能混成一组精度
§8.1 的表 5 给出相对于暴力参考的算子或状态残差;附录 H.1 的表 8 给出另一组随机测试中的最坏相对误差。二者的精度、归一化和测试集合没有被统一交代,应该分别保留。
| 检查 | 表 5:PDF p.18 | 表 8:PDF p.40 |
|---|---|---|
| Block-WY 闭合 | 未列此独立行 | $6.7\times10^{-16}$ |
| 构造性 chunk-WY | $5.7\times10^{-10}$ | $1.9\times10^{-15}$ |
| 仿射块转移 | $9.5\times10^{-8}$ | $2.4\times10^{-16}$ |
| $\theta=0$ 退化为 KDA | $0$ | $0$ |
| 相位循环检查 | $T=5000$,误差 $5.2\times10^{-13}$ | $T=16384$ 范数漂移 $3.0\times10^{-14}$;模相位误差 $3.0\times10^{-12}$ |
| 转移谱范数 | 2000 个样本满足 $\lVert A_t\rVert_2\le1$ | 最大值 $0.9977$ |
| 广义模板 DFA | $0$ | 未列此独立行 |
表 5 还报告修正秩在所测设置中达到 $C$;附录 H.1 指出 $d_k=d_v=128$、$C\in\{16,32,64,128\}$ 的随机设置中也达到该预算。它支持“修正秩会实际增长”的计算判断。
论文在 p.18 的脚注区分了精确数学与浮点误差:循环相位的 $T=5000$ 双精度检查误差约 $5.2\times10^{-13}$,单精度约积累到 $10^{-4}$。这些检查验证实现与公式的一致性,不提供吞吐测量。
4.2 实验 A:手工构造模 5 周期
问题是:给定精确旋转参数,低维相位表示能否保持长序列计数?使用一个实二维块,按输入增量执行 $R(2\pi a_t/5)$,用最近的五个相位原型分类;解码器在长度 128 校准。对照是在相同低维计数设置下校准的实对角控制模型。指标为模 5 计数准确率,越高越好,机会水平为 $1/5$。
| 序列长度 | SFDA 相位 | 最佳实对角对照 |
|---|---|---|
| 128 | 1.000 | 0.240 |
| 1024 | 1.000 | 0.205 |
| 8192 | 1.000 | 0.201 |
来源:表 3,PDF p.17;协议见 §7 和附录 H.2。
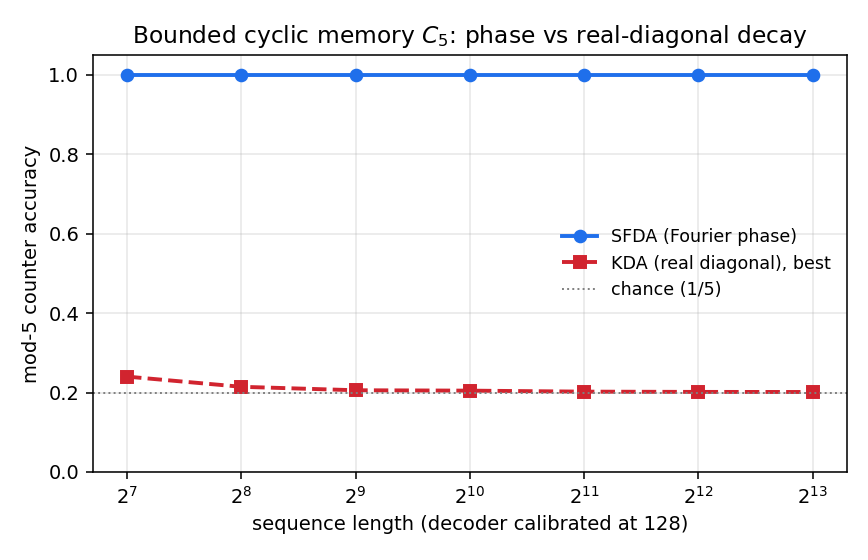
原图 1(a),PDF p.17,复用作者图件。横轴按 $2^7$ 到 $2^{13}$ 排列序列长度,纵轴为计数准确率;蓝线为相位构造,红线为实对角对照,灰线是 20% 机会水平。结果与单位圆上闭合轨道的机制一致。这里精确相位是预先构造的,并非训练所得。
4.3 实验 B:相位能学到,但误差会累计
训练一个最小模 5 计数头,训练长度为 48;对照把相同受控模型的相位固定为零。只改变是否使用相位,旨在隔离相位通道的作用。
| 测试长度 | 相对训练长度 | KDA:$\theta=0$ | SFDA |
|---|---|---|---|
| 48 | $1\times$ | 0.231 | 1.000 |
| 96 | $2\times$ | 0.214 | 1.000 |
| 192 | $4\times$ | 0.203 | 0.951 |
| 384 | $8\times$ | 0.204 | 0.638 |
| 768 | $16\times$ | 0.205 | 0.422 |
来源:表 4,PDF p.18;§7、附录 H.3。该组实验没有充分报告位置平均口径、训练超参数或种子汇总,不能借用下一组模 3 实验的设置补全。
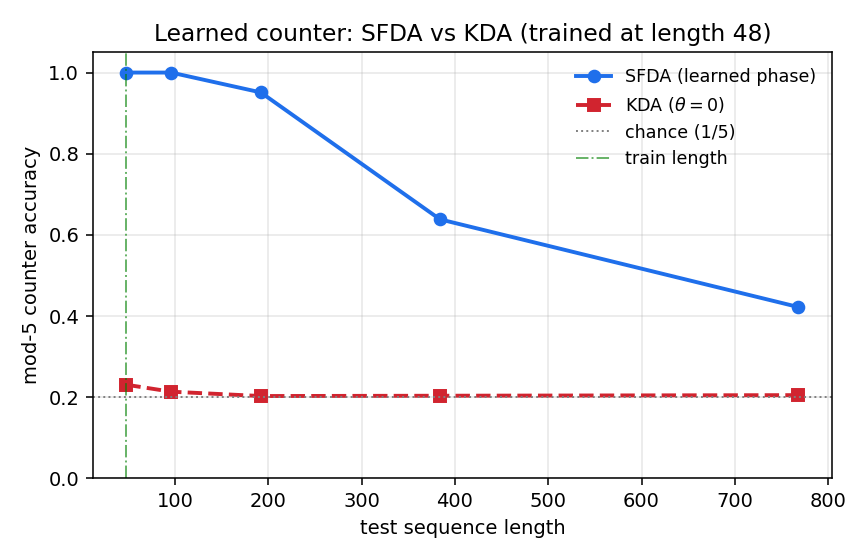
原图 1(b),PDF p.17,复用作者图件。横轴为测试长度,纵轴为准确率;绿色竖线标训练长度 48。SFDA 从长度 192 开始出现可见退化,长到 768 时降至 42.2%。
作者将这一现象解释为相位校准误差的积累。一个教学近似可以说明原因:若每次更新的角误差同向为 $\varepsilon$,$T$ 步后误差约为 $T\varepsilon$;最近原型解码要求误差小于相位间隔的一半 $\pi/m$。因此“存在任意长度精确表示”与“训练找到足够精确的相位”之间存在实际距离。这个误差模型是解释性推导,不是论文对训练轨迹的直接测量。
4.4 §8 的模 3 与重置计数:必须另列协议
这一组使用单层、单头递归模型,状态宽度 $d=16$,线性读出,总参数约 8.3k。作者报告两组模型结构、投影及参数数量一致;KDA 对照通过将相位强制置零得到。训练使用 AdamW 和 cosine schedule,按分布内验证准确率选择 checkpoint。
训练长度为 32,测试长度为 32、64、128、256。指标是在序列最后四分之一位置的准确率,报告两个种子的均值,机会水平为 $1/3$。因此它不是只看末 token 的准确率,也不是实验 B 的模 5 指标。
| 任务 | 模型 | 32 | 64 | 128 | 256 |
|---|---|---|---|---|---|
| 循环 $C_3$ | SFDA | 1.000 | 0.987 | 0.491 | 0.341 |
| 循环 $C_3$ | KDA | 0.344 | 0.330 | 0.337 | 0.335 |
| 重置 $C_3$ | SFDA | 1.000 | 1.000 | 1.000 | 1.000 |
| 重置 $C_3$ | KDA | 0.686 | 0.682 | 0.683 | 0.680 |
来源:§8.2、表 6,PDF pp.18–19。
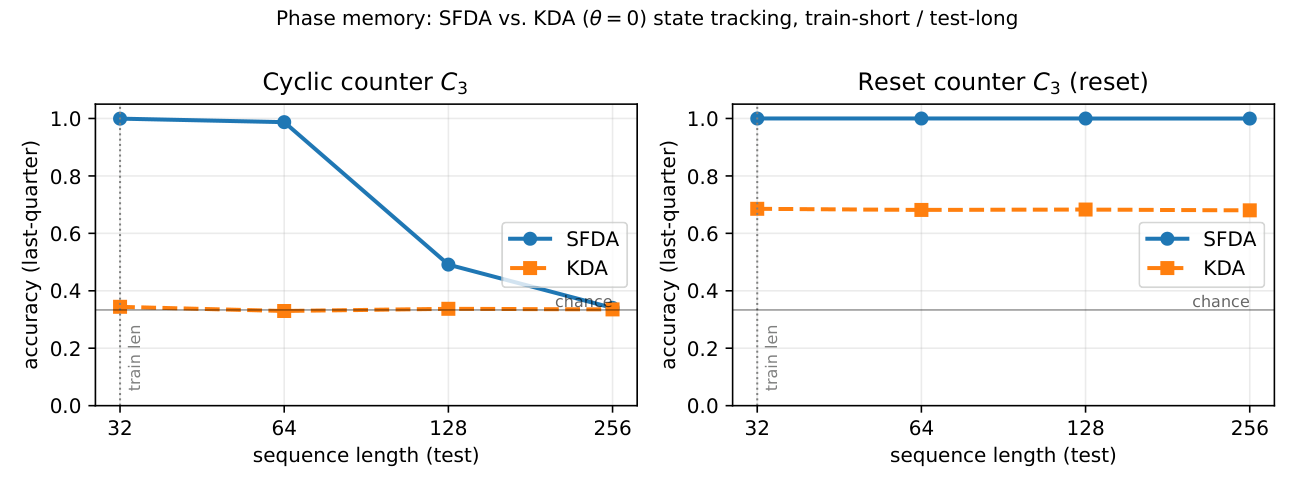
原图 2,PDF p.20,复用作者矢量图并转为 PNG。横轴为测试长度,纵轴为最后四分之一位置准确率;左面板是无重置的循环计数,右面板是带重置计数。实线为 SFDA,虚线为 KDA,训练长度由竖线标记。
左面板显示 SFDA 确实学会了分布内循环更新,但到 $8\times$ 外推时仅比机会水平略高:34.1% 对 KDA 的 33.5%,差 0.6 个百分点。右面板则在长度 256 仍为 100%,相对 KDA 的 68.0% 高 32.0 个百分点。
作者解释重置会限制需要持续跟踪的有效历史,因而抑制相位误差的长期积累。这与实验形态一致。重置符号的频率与间隔分布未被详细给出,所以这一结果不能直接换算成“连续记忆 256 步无误”;它体现的是在所测重置过程中的整段准确率。
4.5 失败案例和后续方案
论文还报告二面体 $D_3$ 的方向翻转任务:SFDA 的分布内准确率约为 0.47,KDA 接近机会水平,但没有给出与表 6 同样完整的长度曲线。作者据此指出方向翻转在当前容量或训练下仍然困难。(§8.2,PDF p.19)
理论的二面体构造依赖显式反射/共轭及适当的矩阵状态。实验段落没有明确说明该扩展控制是否启用,因此这里的失败也不能直接归结为“已实现定理构造却无法训练”。最清楚的后续消融是固定反射控制、可学习反射控制与纯相位控制之间的比较。
附录 E 中的 100M/300M/1B 语言模型、KDA $3{:}1$ 与 SFDA $7{:}1/15{:}1$ 混合比例,以及 RULER、RepoQA 等项目都是实验计划。文中的占位结果不能作为已观察到的质量或效率提升。(PDF pp.33–34)
复现的实际缺口也比较具体:附录 H.4 列出了四个 Python 脚本名,但本次取得的作者源码包没有这些脚本;§8 也未给出学习率、训练步数与种子离散程度。现有材料足以重建递推和数学构造,还不足以无歧义重跑全部学习结果。
五:结论——最有价值的是结构受限的相位记忆
这篇论文提供了一条清楚的设计路线:在状态转移中加入直接匹配任务结构的相位机制,再用构造性的低秩因子维持分块计算。相比单纯声称“某模型能表达某自动机”,WY 因子、写入摘要、前缀输出和秩增长反例把表达方式与计算代价连接了起来。
对方法的评价可以落在三个具体点上:
- 架构启发:相位提供范数有界的周期状态,Delta 规则提供可定址的误差写入。二者解决不同问题,混合使用有明确机制动机。
- 理论贡献:构造性 chunk-WY 恒等式及仿射摘要是最直接可用的结果。紧凑表达能力随控制族变化,应把循环、反射、寄存器和移位分别理解。
- 实证含义:受控计数实验显示相位有用,同时暴露长期角误差和方向翻转的困难。当前证据尚未连接到长上下文检索质量或 GPU 加速。
若继续研究,优先值得回答的是:在统一实/复实现及相同状态字节数下,相位还能带来多少优势;如何校准或约束相位以延长无重置外推;以及完整前向/反向融合内核能否在质量收益之外兑现实际效率。无约束模板的通用实现并不能替代这些结构、精度与系统问题。