线性注意力架构:机制、权衡与跨层路由——中文精读笔记
- 原题:Linear Attention Architectures: Mechanisms, Trade-offs, and Cross-Layer Routing
- 作者:Tommaso Cerruti、Tim Rieder、George Rowlands、Lingfeng Jin、Imanol Schlag;前四位共同贡献。机构为 ETH Zurich D-INFK / ETH AI Center。
- 版本:arXiv:2607.07953v1,arXiv 提交时间为 2026-07-08 22:14:14 UTC;PDF 首页文稿日期为 2026-07-10。两者分别记录,不混作版本日期。
- 获取与研读:2026-09-08 UTC;本次目录创建于 07:56:41 UTC。
- 原文:官方 PDF · 本地 PDF · 同版本 HTML
- 范围:已阅读 20 页 PDF 的正文 Sec. 1–10、全部 6 图与 8 表、附录 A/B;参考文献用于定位,未逐篇阅读。未执行作者代码或复现训练。以下页码均从 PDF 第 1 页起计,正文印刷页码与之相同。
- 性质:分析笔记而非全文翻译。“原文结果”“作者解释”“本次分析/教学推导”分别标明。简称 DN=DeltaNet,GDN=Gated DeltaNet,KDA=Kimi Delta Attention,GDN2=Gated DeltaNet-2。
论文总览
论文有两条相连的主线。第一条把现代线性注意力写成可读写的固定大小关联记忆,比较如何遗忘、如何擦除、如何写入,再在共同训练环境下衡量最终验证损失与训练吞吐。第二条研究记忆内部的信号能否在深度方向复用:直接把低层的写入误差送到高层 value 目标,效果近乎持平或变差;将信号投影到共享残差流,并传递完整写入 value,得到小幅改善。
最有依据的结论是:
- 在论文的 350M 类别 / 15B token 实验中,KDA + Muon + hybrid 的最终验证交叉熵最低,为 2.273;GDN + AdamW + pure 的归一化训练吞吐最高,为 100%,但最终损失为 2.433。这是多个目标之间的权衡。(Table 2,p.12)
- 同架构、同 stack 的表内比较中,Muon 的最终损失均低于 AdamW。不过学习率覆盖不完全均衡,不能把差异全部归因于优化器算法本身。(Sec. 6.2,pp.12–13)
- CLVR 在 Table 7 全部五个匹配实验中降低最终损失;在 350M/1B 时约降低 0.010–0.012,在更长训练或较大 GDN 时仅降低 0.0016–0.0059。全部为单次运行,尚不能给出显著性或普适性结论。(p.16)
- 速度实验测量的是训练吞吐和训练迭代时间;论文没有实测推理吞吐、解码显存或长上下文检索质量。
这里的新贡献主要是统一比较、实现与实验,以及跨层路由研究;四种既有递归注意力并非本文首次提出。
结构地图
| 原章节 | 在论证中的作用 | PDF 页码与主要证据 |
|---|---|---|
| 1 Introduction | 提出效率、记忆干扰和跨层信息传递问题 | pp.1–2 |
| 2 Background: From Softmax Attention to Linear Attention | 从成对检索转为递归记忆 | pp.2–4;Eqs.1–6 |
| 3 Architectures;3.1 Softmax Attention | 统一符号与 softmax 比较对象 | pp.4–5;Eqs.7–13 |
| 3.2 DeltaNet;3.3 Gated DeltaNet | 误差修正与标量遗忘 | p.5;Eqs.14–17 |
| 3.4 Kimi Delta Attention;3.5 Gated DeltaNet-2 | 按通道遗忘、分离擦除与写入 | pp.5–6;Eqs.18–24 |
| 4 Cross-Layer Routing;4.1 Delta-rule write quantities | 定义可复用内部信号 | pp.6–7;Eqs.25–26 |
| 4.2 Cross-Layer Error Residuals (CLER) | 误差注入高层 value 目标 | pp.7–8;Eqs.27–28,Fig.1 |
| 4.3 Cross-Layer Value Routing (CLVR) | 投影到残差流,比较 error/value | pp.7–9;Eq.29,Fig.2 |
| 5 Experimental Setup;5.1 Shared Training Setup | 公共配置与指标口径 | pp.9–10;Table 1 |
| 5.2 Optimizer, Learning-Rate, and Iteration-Time Scaling | 学习率扫描、序列长度计时 | pp.9–10 |
| 5.3 Cross-Layer Routing: Experimental Setup | 匹配基线和数据切片边界 | pp.10–11 |
| 6.1 350M-Parameter, 15B-Token Validation-Loss/Throughput Frontier | 主架构比较 | pp.11–12;Fig.3,Table 2 |
| 6.2 Learning-Rate and Optimizer Effects | 优化器与学习率耦合 | pp.12–13;Figs.4–5 |
| 6.3 Sequence-Length Iteration-Time Scaling | 长序列训练时间 | pp.12、14;Fig.6 |
| 6.4 Larger DeltaNet Runs and Downstream Evaluation | 更大模型及有限下游检查 | pp.14–15;Tables 3–5 |
| 6.5 CLER Validation Loss | 原始路由的负面结果 | p.15;Table 6 |
| 6.6 Cross-Layer Value Routing Results | 精炼路由、尺度变化与控制实验 | pp.16–17;Table 7 |
| 6.7 Reproducibility | 实现与记录要求 | p.17 |
| 7 Discussion: Validation Loss, Throughput, and Architectural Trade-offs | 综合解释与证据局限 | p.17 |
| 8 Future Work;9 Conclusion;10 Acknowledgments | 待验证问题、结论与致谢 | pp.17–18 |
| References | 相关工作出处 | pp.18–19 |
| A Supplementary 1B-Token Baselines | 早期短训练背景 | p.20;Table 8 |
| B Result Inclusion Criteria | 主要结果与探索性结果的边界 | p.20 |
一:动机
1.1 用固定记忆换掉逐 token 检索,会失去什么?
因果 softmax attention 为每个 query 对历史 key 评分,再对对应 value 做归一化加权:
这是 Eq.1(p.3)。序列长度为 $T$ 时,全序列的成对比较计算量随 $T^2$ 增长。论文讨论显式存储注意力矩阵时的二次内存;这一表述有“显式存储”条件,不能直接推广成所有 softmax 实现都必须把完整矩阵常驻显存。
线性注意力改用有限大小矩阵累积历史,使当前 query 只访问一个状态。代价是把越来越多的关联压缩进固定容量,相关 key 会互相干扰。现代 delta-rule 系列试图让记忆能够修正旧关联、忘掉过时内容,而非持续无差别叠加。(Sec.2,pp.3–4)
1.2 为什么还要研究跨层路由?
作者动机:即使单层能形成有效记忆,低层的有用信息沿深层网络传播时仍可能被稀释。能否复用 delta-rule 已经产生的内部量,以较简单的通路提供给后续层,而不额外引入按深度做 softmax 的算子?(Sec.1、4,pp.2、6)
写入误差看起来很自然:它表示当前记忆还未预测出的 value 部分。但“对本层记忆有用的修正”不自动等于“对另一层有用的表征”。这正是后续负面实验和方法调整的逻辑起点。
二:方法
2.1 统一符号与数据流
| 符号 | 维度 | 含义 |
|---|---|---|
| $i$ / $(l,t)$ | 标量索引 | 序列位置 / 层号与序列位置 |
| $q^{(i)},k^{(i)}$ | $\mathbb R^{d_k}$ | 当前 query/key |
| $v^{(i)}$ | $\mathbb R^{d_v}$ | 当前写入目标;是网络内部 value 向量 |
| $\phi,\kappa^{(i)}=\phi(k^{(i)})$ | $\phi:\mathbb R^{d_k}\to\mathbb R^{d_\phi}$ | 特征映射与映射后的 key |
| $W^{(i)}$ | $\mathbb R^{d_v\times d_\phi}$ | 将 key 特征映射为 value 的动态记忆 |
| $\bar v^{(i)},r^{(i)}$ | $\mathbb R^{d_v}$ | 旧记忆对当前 key 的预测、写入误差 |
| $\alpha^{(i)},\beta^{(i)}$ | $(0,1)$ | 标量遗忘因子、标量 delta 更新强度 |
| $\boldsymbol\alpha^{(i)},D_\alpha^{(i)}$ | $\mathbb R^{d_\phi}$、$\mathbb R^{d_\phi\times d_\phi}$ | key 特征维上的遗忘门及其对角矩阵 |
| $\mathbf b^{(i)},\mathbf w^{(i)}$ | $\mathbb R^{d_\phi}$、$\mathbb R^{d_v}$ | GDN2 的擦除门、写入门 |
| $h_{l,t},P_l$ | $\mathbb R^{d_{\rm model}}$、$\mathbb R^{d_{\rm model}\times d_v}$ | 共享残差流、路由投影 |
来源:Sec.3,pp.4–6;Sec.4.3,p.7。$\otimes$ 为外积,即 $a\otimes b=ab^\top$;$\odot$ 为逐元素乘法。这里的 $W$ 是随 token 更新的快速记忆状态,不能与通过训练更新的投影参数混淆。
每个 token 的共同过程:输入表征产生 query/key/value 与门控;对旧记忆进行可选遗忘;用当前 key 读取预测;形成更新并写回;最后用 query 读取更新后的记忆:
这是 Eq.8(p.4)。产生写入误差的是 key 读取旧状态;产生层输出的是 query 读取新状态,两者用途与时刻不同。论文用单头代数省略了输出投影、归一化和 FFN,不能据此声称实际模型没有这些组件。特征映射的逐架构实现细节也不能仅凭抽象 $\phi$ 推定。
2.2 从可分解核到递归累积
若相似度可用 $\phi(q)^\top\phi(k)$ 近似,就能维护:
这是 Eqs.4–5(p.3)。原文这里推导的是未归一化的 numerator/read,不是与 Eq.1 严格相等的归一化 softmax。
本次公式核查:PDF p.3 的 Eq.3 把 $\phi(q)^\top$ 写在 $W$ 左边,与紧接着 Eq.4 的 $W\in\mathbb R^{d_v\times d_\phi}$ 方向不相容;按 Eq.4–5 的列向量约定,正确的乘法顺序应为 $W\phi(q)$。笔记与幻灯片统一采用 Eq.5/8 的方向,保留此处排版/维度问题的记录。
在固定维度下,单 token 读写约需 $O(d_vd_\phi)$,对序列长度是常数;全序列递归算术量为 $O(Td_vd_\phi)$。这是根据公式的分析,不意味着 GPU 训练必须以 Python 逐 token 循环实现,也不意味着完整训练的激活内存不随 $T$ 变化。本文没有给出每种 kernel 的完整并行推导。
2.3 DeltaNet:只写记忆尚未预测出的部分
来源:Eqs.9–10、14,pp.4–5。若当前关联已经预测准确,$r$ 很小,重复出现相同信息不会持续写入同样大小的更新。展开后是:
教学推导:它等价于对局部平方误差 $\frac12\|W\kappa-v\|_2^2$ 作一步梯度更新,但这里是对动态记忆 $W$ 的内层更新,不是语言模型整体交叉熵训练的替代品。
假设一个单位 key 下记忆预测为 2、目标 value 为 5、$\beta=0.5$,则新预测为 $2+0.5(5-2)=3.5$。这是人为构造的教学例子。若 $\|\kappa\|_2=1$,一般地 $W^{(i)}\kappa=(1-\beta)W^{(i-1)}\kappa+\beta v$;其他查询方向 $u$ 的变化则与 $\kappa^\top u$ 成正比。因而修正具有方向选择性,但相关 key 仍可能互相影响。
局限是缺少独立的整体遗忘旋钮。它可以修正某个 key 的关联,却不便直接清空所有过时内容。(Sec.3.2,p.5)
2.4 Gated DeltaNet:先遗忘,再计算误差
来源:Eqs.15–17,p.5。关键顺序是先衰减旧状态,再与目标比较;若误差仍用未衰减状态计算,就不再是这里的 GDN 更新。
标量 $\alpha$ 对整个状态使用相同保留率。它给模型直接遗忘能力,也可能一并弱化本应保留的其他特征。收益是控制简单,代价是遗忘粒度粗。
2.5 Kimi Delta Attention:遗忘细化到 key 特征通道
来源:Eqs.18–20,pp.5–6。$D_\alpha$ 必须乘在 $W$ 右侧,因为它作用于 key-feature 维,而非 value 维。令 $\boldsymbol\alpha=\alpha\mathbf1$ 就回到 GDN。
KDA 可以保留某些特征通道、快速遗忘另一些,但主动擦除和写入仍共同受同一个标量 $\beta$ 控制。它的额外控制自由度在本文获得更低损失,却伴随较低实际训练吞吐;代数表达能力和实现效率需要分别评价。
2.6 Gated DeltaNet-2:把擦除与写入控制分开
来源:Eqs.21–24,p.6。$\mathbf b$ 在 key 侧选择擦除读出的方向,$\mathbf w$ 在 value 侧控制新内容;外积右端仍是原 $\kappa$,不能误写成 $e$。
教学展开为 $\widetilde W(I-e\kappa^\top)+z\kappa^\top$。如果 $\mathbf b=\beta\mathbf1_{d_\phi}$ 且 $\mathbf w=\beta\mathbf1_{d_v}$,就恢复 KDA;再把向量遗忘门变成标量,恢复 GDN。包含更简单更新作为特例,并不保证有限预算下更易优化或更快。
| 机制 | 被动遗忘 | 主动擦除/写入控制 | 核心代价 |
|---|---|---|---|
| DeltaNet | 无独立遗忘门 | 同一个标量 $\beta$ | 过时状态清理受限 |
| GDN | 整体标量 $\alpha$ | 同一个标量 $\beta$ | 遗忘较粗 |
| KDA | key 通道向量 $\boldsymbol\alpha$ | 同一个标量 $\beta$ | 更复杂的门控和实现 |
| GDN2 | key 通道向量 $\boldsymbol\alpha$ | key 擦除 $\mathbf b$ / value 写入 $\mathbf w$ 分开 | 自由度更多,实测未成为最优损失方案 |
2.7 CLER:把写入误差直接加入高层 value 目标
来源:Eqs.27–28,p.7。$p(l)$ 是最近的低层可路由记忆层,不一定是物理相邻层;$\Gamma_l$ 是每层可学习标量,主实验 $\rho$ 为恒等映射。中间 softmax 层传递侧通道,但不生成或消费这类路由信号。
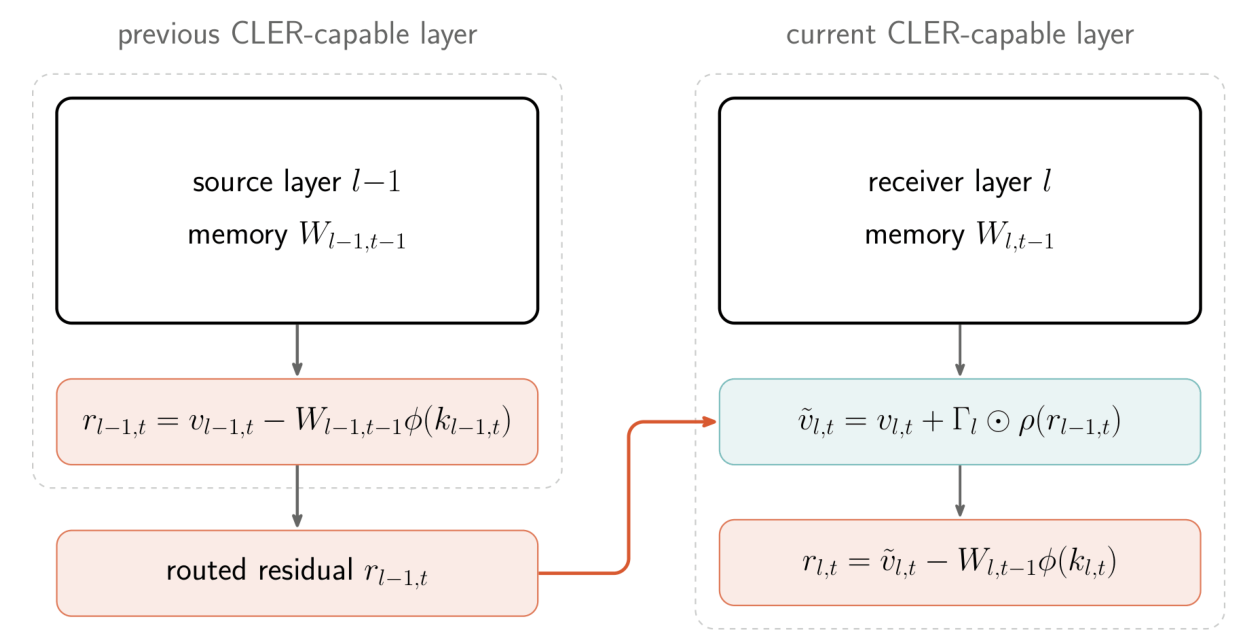
原 Fig.1,PDF p.8,原图裁切。先读左侧低层记忆产生的 $r$,再沿橙色箭头看右侧 $\widetilde v$,最后接收层计算自己的误差。原图用 $l-1$ 简写低层,精确的跨 softmax 定位按正文 $p(l)$ 理解;图中 $\Gamma_l\odot\rho(r)$ 在标量门情况下就是标量缩放。
作者解释:不同层的 value 投影独立学习,相同维度并不意味着同一语义基底。直接相加可能与接收层的写入目标冲突。本次分析:这是与负面结果一致的解释,尚不是“空间错配导致失败”的独立因果证明。
另一个需要注意的符号简化是:Sec.4 的 Eqs.25–28 写的是不带衰减的读取;Sec.3.3 的 GDN 真正写入误差带 $\alpha$。实现 GDN 路由时应明确所取内部量是否为实际带衰减 write residual,不能不加说明地用 Sec.4 简式替换 GDN 更新。本文正文不足以完成这一代码层核查。
2.8 CLER-H 与 CLVR:投影到共享残差流
这是 Eq.29(p.7)。$P_l$ 把 value 空间映射到模型维度,零初始化使初始路由贡献为零。信号通过普通残差路径到达后续层和输出头。
| 变体 | 传递的内容 | 注入位置 | 参数化 |
|---|---|---|---|
| CLER | 写入误差 $r$ | 下一个可路由层的 value 目标 | 标量 $\Gamma_l$ |
| CLER-H | 写入误差 $r$ | 本层后的共享残差流 | 投影 $P_l$ |
| CLVR | 完整写入 value $v$ | 本层后的共享残差流 | 同形状投影 $P_l$ |
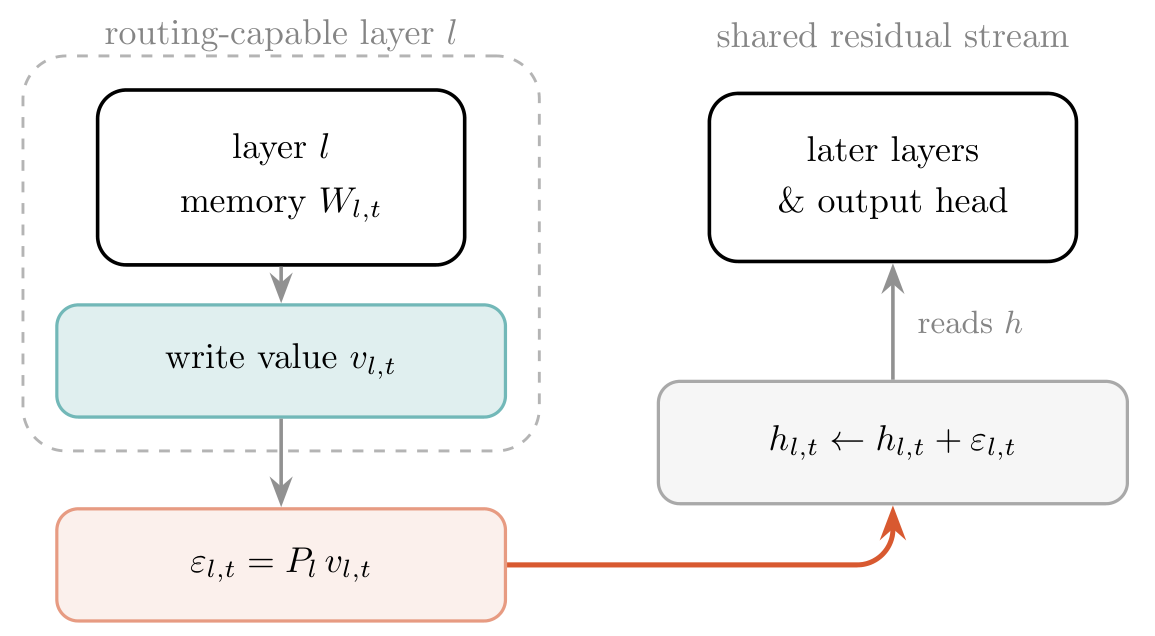
原 Fig.2,PDF p.8,原图裁切。左侧取出的 $v_{l,t}$ 经 $P_l$ 形成模型维向量,在右侧加入 $h$,后续层通过常规残差流读取。它不是把所有历史 value token 拼接起来,也不是新建全局 KV cache。
由于 $v=r+\bar v$,CLVR 比 CLER-H 多保留了该层记忆已预测出的分量。后两者的 $P_l$ 同形状、同秩,故是参数匹配的信号内容比较。CLER 与 CLER-H 则还同时改变了投影参数化;不能声称三者全都严格等参数。
成本与初始化的教学分析:全秩投影每层增加 $d_{\rm model}d_v$ 参数及对应每 token 矩阵乘。可选 $P_l=U_lD_l$、秩 $d_p$ 时,参数量为 $d_p(d_{\rm model}+d_v)$。固定维度下新增计算仍对 $T$ 线性,但论文未报告 CLVR 的完整实测开销表。若实现低秩零初始化,应使乘积为零且保留可学习梯度,例如只把一个因子置零;两个因子同时全零会使普通梯度更新停滞。这是实现推导,非本文已验证配置。
训练与推理:训练仍以语言模型交叉熵优化整个网络;动态记忆沿序列更新,投影与门控通过训练学习。推理时保留记忆状态并按 token 更新,CLVR 加一个即时投影与残差相加,不引入跨未来 token 的访问。若宿主仍含 softmax 层,整体模型依然保有这些层的上下文相关成本。
三:实验
3.1 分清四组训练,才能比较数字
| 实验组 | 规模 / 预算 | 问题与比较对象 | 不能混用的条件 |
|---|---|---|---|
| 主架构扫描 | 350M 类别 / 15B token | 五种机制、AdamW/Muon、hybrid/pure | 20–24 层随架构调整;并非完全同拓扑 |
| 学习率扫描 | 350M hybrid / 2000 step,约 1.05B token | 学习率与优化器是否共同影响排名 | 是短训练曲线,不能直接替代 15B 最终结果 |
| 初始 CLER 与隐藏流路由 | 350M/1B、350M/15B;另有 GDN 1.3B/40B | 每个路由变体与同宿主、优化器、schedule、seed 的 baseline 匹配 | 1B 与长训练使用不同 FineWeb-Edu 切片;不同表的 baseline 也不同 |
| 较大 DeltaNet | 1.3B/40B、3B/60B | DeltaNet 的 stack 和学习率敏感性 | 不是五种注意力的大规模扫描,也不是大规模 DeltaNet CLVR 实验 |
来源:Sec.5,pp.9–11;Tables 1、3、6、7。全文沿用“350M”类别名,但 Table 1 说明已记录的实际模型约 312M、相差约 ±2%,深度 20–24 层;不应写成每个模型恰好 3.5 亿参数。
公共配置为 FineWeb-Edu、LLaMA2 tokenizer、配置内 train/validation/test=99/1/0,序列长度 4096、global batch=128、bf16,在 CSCS Alps 一个含 4 GPU 的 GH200 节点运行。受控路由配置为 20 层、hidden size 1024、FFN 2816、16 attention heads、4 query groups。15B 主实验 micro-batch 为每 GPU 16 个样本,compiled PyTorch 路由实验为 2;不能把它们说成相同 micro-batch。(Table 1,p.10)
默认 DN/GDN/GDN2 hybrid 每第三层为 softmax,20 层时为 14 个线性层、6 个 softmax 层;重复块为 2:1,但总层数比例并非精确 2:1。另有 GDN2 每第四层为 full attention 的 3:1 变体。正文此处没有同样明确地列出 KDA 所有行的具体层型模式,不按其他架构推填。(Sec.5.1 及脚注,p.9)
3.2 优化器与 schedule
主比较包括 AdamW 和 Muon/NorMuon。Table 1 记录 adaptive Muon、NormMuon 二阶矩处理、spectral scaling、Nesterov momentum 0.95;weight decay=0.1、gradient clipping=1.0、Adam betas=0.9/0.95,检查过的配置没有 attention/hidden dropout。
学习率日程为 Warmup-Stable-Decay(WSD),末段使用 minus-square-root decay。表中同时出现 Muon 的 scalar learning rate $1.5\times10^{-3}$ 与部分启动配置的 peak LR $3.6\times10^{-4}$,没有逐参数组映射,不能把它们强行归成一个全局数字。对严格复现,应查看各运行 launcher;本次未执行该代码核查。
3.3 指标怎样读?
- Validation loss:held-out 语言模型交叉熵,越低越好。它衡量平均 next-token 预测,不直接等价于检索能力或所有下游能力。原文主表未单独标注对数底/单位,不另行称为某种精确单位。
- Saturation loss:WSD 高学习率阶段接近结束、最终衰减前的验证损失。
- Final loss:完整 schedule 结束后记录的最终 checkpoint 损失,非训练中最好的单点。
- Relative speed:主 15B 扫描中的归一化训练吞吐,以 GDN/AdamW/pure=100%。低于 100% 是较低吞吐,不是延迟百分比。
- Iteration time:一轮训练迭代秒数,越低越好。Fig.6 的误差条是迭代间波动,不能充当不同随机种子的模型质量方差。
- acc / acc_norm:多选题准确率 / 按候选长度归一化似然得到的准确率,越高越好。表中是 0–1 比例,乘 100 后才是百分数。
- ktok/s/GPU:每 GPU 每秒千个训练 token;Table 8 另给 TFLOP/s/GPU,后者不直接等于任务完成速度。
所有架构与路由比较都是单次运行,没有 seed 平均、标准差、置信区间或显著性检验。匹配同 seed 降低了部分差异来源,却不能估计训练随机性的总体波动。(Sec.6、7、Appendix B,pp.11、17、20)
四:结果
4.1 Sec.6.1:最低损失与最快训练由不同配置取得
以下完整转录 Table 2(PDF p.12),采用简称,数值未重估:
| 架构 | 优化器 | Stack | 相对训练吞吐 ↑ | Saturation loss ↓ | Final loss ↓ |
|---|---|---|---|---|---|
| Softmax | AdamW | dense | 81.7% | 2.587 | 2.413 |
| Softmax | Muon | dense | 79.7% | 2.489 | 2.349 |
| DeltaNet | AdamW | hybrid | 87.0% | 2.517 | 2.348 |
| DeltaNet | AdamW | pure | 91.9% | 2.555 | 2.382 |
| DeltaNet | Muon | hybrid | 83.8% | 2.440 | 2.299 |
| DeltaNet | Muon | pure | 89.2% | 2.476 | 2.334 |
| GDN | AdamW | hybrid | 90.5% | 2.517 | 2.356 |
| GDN | AdamW | pure | 100.0% | 2.601 | 2.433 |
| GDN | Muon | hybrid | 89.5% | 2.464 | 2.321 |
| GDN | Muon | pure | 95.0% | 2.543 | 2.397 |
| KDA | AdamW | hybrid | 74.4% | 2.471 | 2.328 |
| KDA | AdamW | pure | 73.6% | 2.490 | 2.347 |
| KDA | Muon | hybrid | 70.9% | 2.409 | 2.273 |
| KDA | Muon | pure | 68.5% | 2.427 | 2.290 |
| GDN2 | AdamW | hybrid | 83.3% | 2.520 | 2.379 |
| GDN2 | AdamW | pure | 81.9% | 2.601 | 2.452 |
| GDN2 | Muon | hybrid | 81.3% | 2.466 | 2.345 |
| GDN2 | Muon | pure | 80.7% | 2.542 | 2.415 |
检验问题:更细粒度的记忆控制能否获得更好的质量,同时保留线性注意力的实际吞吐?
原文结果:KDA/Muon/hybrid 最低损失为 2.273;GDN/AdamW/pure 最快为 100%。DN/Muon/hybrid 为 2.299/83.8%,GDN/Muon/hybrid 为 2.321/89.5%,呈现中间选择。GDN2/Muon/hybrid 为 2.345/81.3%,其更复杂的控制在这个训练预算下没有带来最低损失。
本次计算:与 softmax/Muon 相比,KDA/Muon/hybrid 的损失降低 $2.349-2.273=0.076$,吞吐降低 $(79.7-70.9)/79.7\approx11.0\%$。归一化吞吐坐标差为 8.8 个百分点;这与相对吞吐下降 11.0% 是两个口径。GDN/AdamW/pure 相对 softmax/AdamW 吞吐约为 $100/81.7=1.224$ 倍,代价是损失高 0.020。
混合层的条件:同架构/优化器下 hybrid 的最终损失在表内都低于 pure,但“hybrid 必然更慢”不成立。例如 KDA/Muon hybrid=70.9% 比 pure=68.5% 更快,GDN2 也有同样方向;替换部分较慢的线性 kernel 可以改善当前实现的吞吐。这不否定 softmax 的长序列成对计算成本,而是说明固定 4k 条件下常数项和实现很重要。
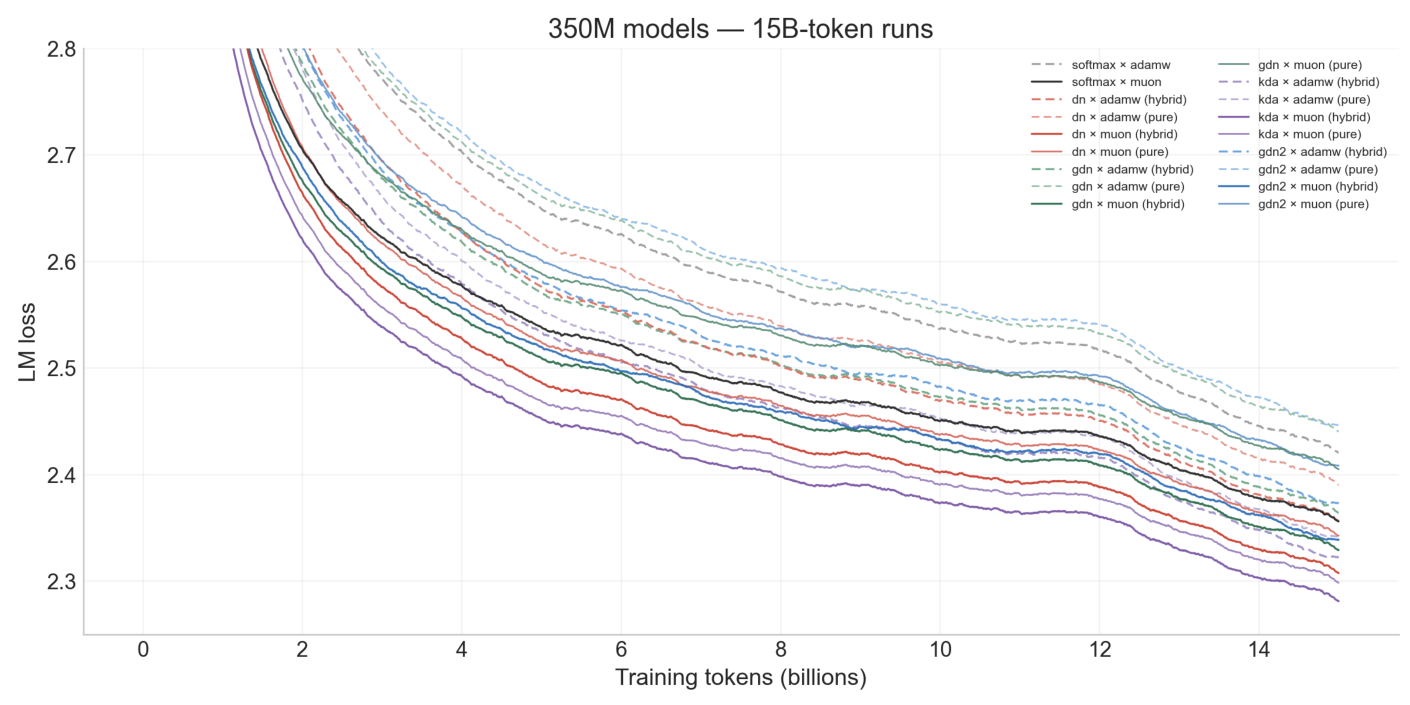
原 Fig.3,PDF p.11。横轴是训练 token 数(十亿),纵轴为 LM loss;图例分别标出架构、优化器和 stack,不能只凭颜色区分全部配置。末段共同下降与 WSD 最终衰减相对应。图能展示训练轨迹与最终相对位置,精确终值以 Table 2 为准;线条没有多 seed 置信带。
4.2 Sec.6.2:学习率调参影响架构比较
原文结果:2000-step hybrid 消融中,Muon 的较优学习率总体在 $3\times10^{-4}$ 附近;AdamW 的线性注意力在 Sec.6.2 被概括为偏好 $10^{-3}$,softmax 偏好 $3\times10^{-4}$。过低学习率收敛不足,过高学习率可使损失变坏甚至轨迹上升。(pp.12–13,Figs.4–5)
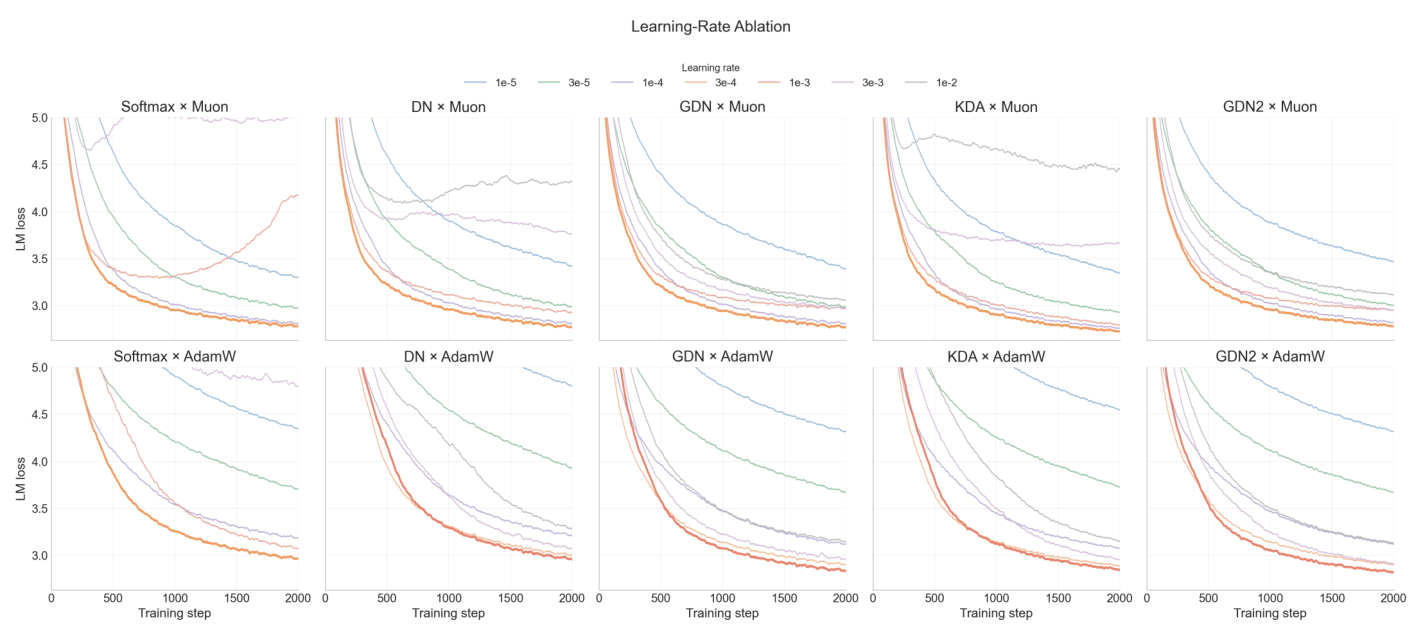
原 Fig.4,PDF p.13。上排 Muon、下排 AdamW;五列依次为 Softmax、DN、GDN、KDA、GDN2。每个面板横轴是训练 step、纵轴为验证 loss,颜色表示学习率。应先比较同一面板不同学习率,再比较对应的上下两排。高学习率下 softmax 更容易明显恶化,但该观察限于这些短训练。
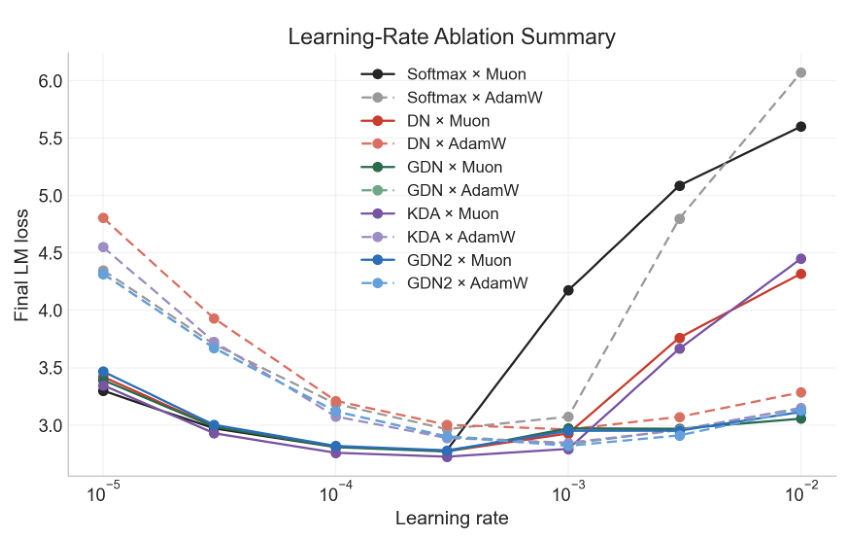
原 Fig.5,PDF p.13。横轴是对数学习率,纵轴为最终 LM loss;实线 Muon、虚线 AdamW,颜色对应架构。它汇总的是同批有限学习率采样点及其连线,不是置信区间,也不是对连续最优学习率的精确求解。
原文描述不完全一致:Sec.5.2(pp.9–10)只将 DN/GDN+AdamW 列为接近 $10^{-3}$,将其余组合归到 $3\times10^{-4}$ 左右;Sec.6.2(p.12)则扩展到所有 AdamW 线性注意力。笔记保留这个差异。可靠的共同结论是学习率应按架构与优化器联合选择,不能由一条笼统陈述替代逐曲线核查。
主表内的精确优化器差:hybrid 时,AdamW→Muon 的最终损失降低量依次为 DN 0.049、GDN 0.035、KDA 0.055、GDN2 0.034;softmax 为 0.064。这些是 Table 2 的差值,非独立调参后的普遍效应量。
4.3 Sec.6.3:长序列训练时间的增长更缓
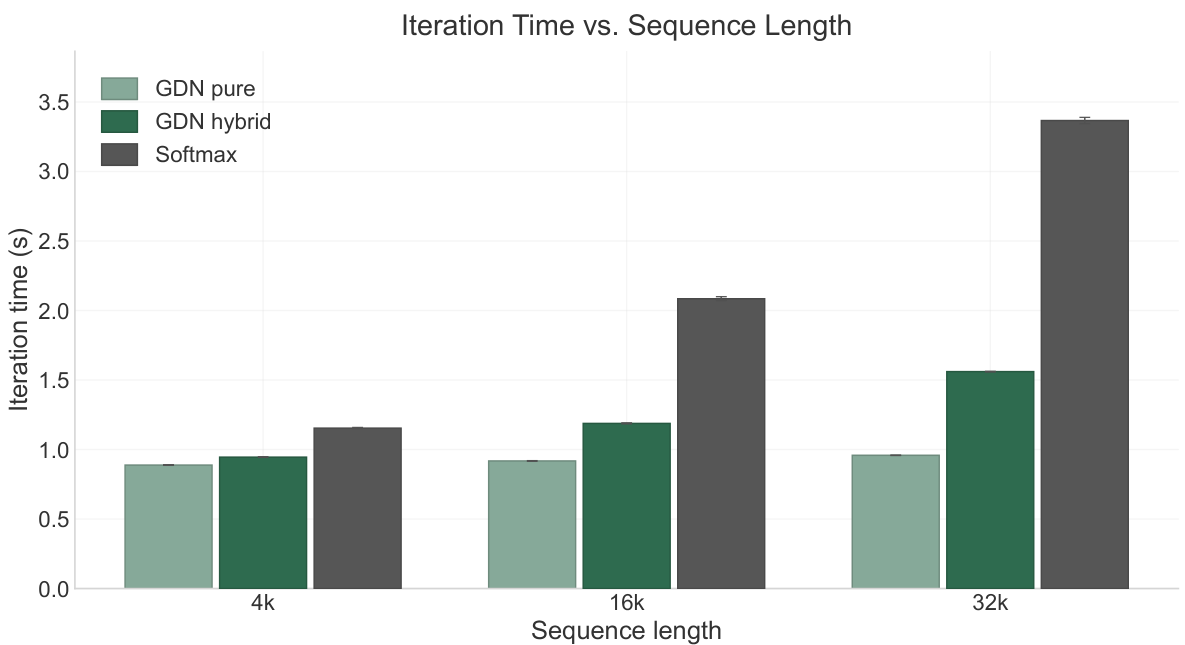
原 Fig.6,PDF p.14。横轴为 4k、16k、32k 序列长度,纵轴为秒/迭代;浅绿是 GDN pure、深绿是 GDN hybrid、灰色是 softmax。误差条为 step-to-step 波动。
| 配置 | 32k 时秒/迭代 ↓ | 原图报告 4k→32k 增幅 |
|---|---|---|
| Softmax | 3.37 | +192% |
| GDN hybrid | 1.56 | +65% |
| GDN pure | 0.96 | +8% |
来源:Sec.6.3 p.12;Fig.6 p.14。本次计算:在 32k 时,softmax/GDN-pure 的迭代时间比为 $3.37/0.96\approx3.51$,softmax/GDN-hybrid 为约 2.16。
证据边界:该测量支持“在论文计时设置中,pure 递归 stack 的迭代时间增长更缓”。正文没有清楚列出 Fig.6 每个长度点的 micro-batch、每步总 token 及是否保持 token 总量固定,因而不能把 +8% 解读为“固定序列条数下处理八倍 token 几乎不增加计算”,也不能凭这三个点证明完整端到端复杂度。尤其不能把 3.51 倍写成推理加速倍数。
4.4 Sec.6.4:大模型结果突出学习率敏感性,下游只做有限检查
较大 DeltaNet(Table 3,p.14):
| 参数 / token | Stack / 变体 | 学习率 | Final loss ↓ |
|---|---|---|---|
| 1.3B / 40B | hybrid | 3.6e-4 | 2.066 |
| 1.3B / 40B | pure | 3.6e-4 | 2.085 |
| 1.3B / 40B | hybrid | 1.5e-4 | 2.109 |
| 1.3B / 40B | pure | 1.5e-4 | 2.063 |
| 1.3B / 40B | pure + CLER | 1.5e-4 | 2.112 |
| 3B / 60B | hybrid | 5e-4 | 2.332 |
| 3B / 60B | hybrid | 3e-4 | 1.955 |
| 3B / 60B | hybrid | 1.5e-4 | 1.955 |
同为 1.3B,hybrid/pure 排序会随学习率切换;3B 中 $5\times10^{-4}$ 明显差于另两个学习率。这组结果不能证明大规模下 KDA/GDN2 的排序,也不能把其中 CLER 当作 CLVR。Table 3 不逐行列优化器;Table 4 的对应较大模型下游检查标为 Muon,不据此把所有 Table 3 运行的细节补成一致。
架构与尺度的下游检查(Table 4,p.15):
350M/15B 的 HellaSwag normalized accuracy 中,DN/Muon/hybrid=0.4305,高于 DN/Muon/pure=0.4133;但 PIQA normalized accuracy 的方向相反,为 0.6779 对 0.6801。GDN/Muon 的 hybrid 在 WinoGrande 为 0.5414,pure 为 0.4870,而 DN/Muon 的 hybrid 在同任务低于 pure(0.5051 对 0.5170)。因此不能把验证损失排序机械转换为每个任务的排序。
更大 DN/Muon/hybrid 的 HellaSwag normalized accuracy 为 1.3B/40B 的 0.5484、3B/60B 的 0.6063;训练预算同时变化,不能将提升全部归因于参数量。1.3B 的 CLER pure 在 $\gamma=0.1$、0.0 两行对三个任务的变化也不一致,不构成稳定的路由收益证据。
匹配路由 checkpoint 的下游检查(Table 5,p.15):
全部为 350M/15B/Muon,zero-shot;scoring-server 使用 full-sequence forward、LLaMA2 tokenizer、batch size 8、maximum length 4096。HS=HellaSwag,WG=WinoGrande:
| 宿主 | 变体 | HS acc | HS acc_norm | PIQA acc | PIQA acc_norm | WG acc |
|---|---|---|---|---|---|---|
| GDN | Baseline | 0.3434 | 0.4131 | 0.6692 | 0.6649 | 0.5146 |
| GDN | CLER-H | 0.3423 | 0.4104 | 0.6670 | 0.6556 | 0.5209 |
| GDN | CLVR | 0.3421 | 0.4113 | 0.6719 | 0.6600 | 0.5328 |
| DeltaNet | Baseline | 0.3410 | 0.4113 | 0.6600 | 0.6605 | 0.5193 |
| DeltaNet | CLER-H | 0.3424 | 0.4069 | 0.6681 | 0.6757 | 0.5264 |
| DeltaNet | CLVR | 0.3437 | 0.4104 | 0.6616 | 0.6551 | 0.5359 |
例如 GDN 的 CLVR 相对 baseline,HS acc_norm 下降 0.0018(0.18 个百分点),PIQA acc 上升 0.0027(0.27 个百分点),WG acc 上升 0.0182(1.82 个百分点)。方向混合且没有统计不确定性估计。作者将其解释为“未见清晰退化的检查”,没有把 WinoGrande 点估计当作独立的广泛改善证据。
比较规则:Table 4 与 Table 5 的同名 baseline 数字不同,必须用各表内部配对;不能拿 Table 4 更高或更低的点估计给 Table 5 路由算 gain。
4.5 Sec.6.5:原始 CLER 没有可靠收益
| 优化器 / 宿主 | Baseline loss | CLER loss | 原表 Δ |
|---|---|---|---|
| Muon / GDN | 2.8319 | 2.8333 | +0.0013 |
| Muon / DN | 2.8511 | 2.8507 | −0.0004 |
| AdamW / GDN | 3.2554 | 3.2562 | +0.0008 |
| AdamW / DN | 3.4068 | 3.4258 | +0.0190 |
来源:Table 6,PDF p.15;350M、约 1B token,同优化器及宿主配对。负数意味着更好。Muon/DN 的 0.0004 改善低于 $10^{-3}$,作者不视为可靠收益;另外三组变差。
数值核查:原表 Muon/GDN 的 Δ 写 +0.0013,但显示出的四位小数相减为 $2.8333-2.8319=0.0014$,可能涉及未展示精度或记载误差。此处保留原表 Δ,并明确显示值的差异,不静默改表。
作者记录到路由残差并非零,但损失曲线几乎重叠。这支持“通路没有完全关闭,仍未观察到可靠收益”,不直接证明到底是幅度不足、基底错配还是信息冗余。
4.6 Sec.6.6:隐藏流路由改善较一致,完整 value 优于 error
以下转录 Table 7(PDF p.16)。最后一列为本次按 baseline+Δ 计算,原表只给 baseline 和两种 Δ:
| 宿主 | 参数 / token | 匹配 baseline | CLER-H Δ | CLVR Δ | CLVR 最终损失(计算) |
|---|---|---|---|---|---|
| GDN | 350M / 1B | 2.8331 | -0.0073 | -0.0103 | 2.8228 |
| GDN | 350M / 15B | 2.3417 | -0.0042 | -0.0059 | 2.3358 |
| GDN | 1.3B / 40B | 2.0635 | -0.0010 | -0.0019 | 2.0616 |
| DeltaNet | 350M / 1B | 2.8469 | -0.0047 | -0.0119 | 2.8350 |
| DeltaNet | 350M / 15B | 2.3347 | -0.0002 | -0.0016 | 2.3331 |
检验问题:改变注入位置是否改善原始 CLER?在同形状投影下,传 error 还是 value 更有用?
原文结果:CLER-H 与 CLVR 在各自匹配组均为负 Δ,且 CLVR 五行都低于 CLER-H。350M/1B 的差异最大,长训练与较大 GDN 的差异更小。大规模隐藏流路由只有 GDN 1.3B/40B;本文没有 DN 1.3B/40B 的 CLER-H/CLVR 配对,也没有 KDA/GDN2 路由结果。
基线不能串表:例如 Table 2 GDN/Muon/hybrid=2.321,Table 7 GDN/350M/15B baseline=2.3417。CLVR 的 −0.0059 必须加在 2.3417 上,不能拼出主架构表没有报告的“2.3151”。Table 6 的 1B baseline 与 Table 7 也不相同,不能当作完全相同的一次运行。
解释与边界:
- CLER-H 与 CLVR 的参数形状匹配,使“value 相较于 error 的内容差异”更容易解释。
- CLER 到 CLER-H 同时改变注入空间与标量/矩阵参数化,且跨表 baseline 不同,对“仅空间变化”的因果识别较弱。
- $v=r+\bar v$ 提示 value 保留了误差中减去的已预测信息。作者将更小模型/更短训练的较大收益解释为额外信息仍有用;这是一种与趋势相容的机制解释。
- 同方向的单次结果值得后续验证,但不等于显著性。不同训练预算的数据切片也不同,“收益随规模递减”应作为当前表内 gain 的现象,而非已拟合出的缩放定律。
- 非零投影范数能说明通路被更新/使用,不能单凭范数证明它对性能的因果贡献。
4.7 Sec.6.6 的额外控制与 Attention Residuals
这些是原文已报告的探索性数字,不能与 Table 7 的主运行不加区分地合并。(p.16;证据级别见 Appendix B,p.20)
| 控制 | 原文结果 | 适当解读 |
|---|---|---|
| 用 $\lVert r\rVert/\lVert v\rVert$ 对 value 路由门控 | final loss=2.8220 | 同 seed 参考 CLVR=2.8152;未见更好 |
| 拼接 $[r;v]$ | final loss=2.8194 | 同一探索组未超过普通 value |
| 路由本层 hidden state | Δ≈−0.0014 | 接近持平;仅单 seed |
| 增加同等数量的 baseline 参数 | Δ=+0.0021 | 该控制没有改善 |
| Attention Residuals:DN,350M/15B | final=2.3246,Δ=−0.0101 | 此宿主收益大于 CLVR 的 −0.0016 |
| Attention Residuals:GDN,350M/15B | Δ=+0.0030 | 收益未转移到另一宿主 |
这里的探索性 CLVR=2.8152 不等于 Table 7 的 GDN/1B 计算值 2.8228,也不等于 DN/1B 的 2.8350;正文没有足够逐运行信息将它们认成同一组,因此分别记录。作者说部分控制差异“在 run-to-run noise 内”,但没有多 seed 方差估计,本次把它理解为谨慎表述,不当作统计检验结果。
Attention Residuals 的机制是对不同深度的子层输出学习 softmax 组合并替代原残差求和;CLVR 是把记忆内部 value 投影后附加到残差流。论文不能据此宣称 CLVR 在所有宿主上胜过深度注意力,也没有给出二者完整的实测成本对照。
4.8 Sec.6.7 与附录:复现信息、早期基线和纳入规则
作者在 Sec.6.7(p.17)给出 Megatron-LM 实现仓库,称包含训练 launcher、数据准备、smoke check 与评分服务。本次仅核对论文中的说明,未验证仓库内容、运行 launcher 或重做训练。严格复现仍需逐运行确认层数、stack、学习率参数组、数据切片、checkpoint 语义,以及路由投影的 rank/附加参数量。
Appendix A 的 Table 8(p.20)为早期约 1B token 基线,不参与主 15B 前沿排名:
| 架构 / 优化器 | Train loss | Val loss ↓ | Val PPL ↓ | ktok/s/GPU ↑ | TFLOP/s/GPU |
|---|---|---|---|---|---|
| Softmax / AdamW | 2.9111 | 2.9019 | 18.2095 | 144.8 | 334.6 |
| Softmax / Muon | 2.7134 | 2.7240 | 15.2410 | 136.7 | 316.0 |
| GDN / AdamW | 2.8587 | 2.8562 | 17.3950 | 159.5 | 298.6 |
| GDN / Muon | 2.6965 | 2.7097 | 15.0254 | 154.8 | 289.6 |
| DN / AdamW | 2.9484 | 2.9391 | 18.8987 | 153.4 | 296.8 |
| DN / Muon | 2.6990 | 2.7137 | 15.0847 | 146.7 | 283.7 |
GDN/Muon 在该早期表取得最低 val loss=2.7097,GDN/AdamW 的吞吐 159.5 ktok/s/GPU 最高。它再次展示质量与吞吐的区别,但不能拿其较低绝对 loss 与其他 1B 路由实验作 gain 比较:同为“1B”不保证实验记录与 checkpoint 相同。
Appendix B 的核心是可审计性不等于统计可靠性。主结果需要记录架构、stack、规模、预算、优化器、学习率、指标和 checkpoint;surprise gating、拼接、output injection、低秩变体只作指示性检查。原文附录把 Attention Residuals 说成在主文“Table 7”报告,但 Table 7 本身只列 baseline、CLER-H、CLVR,Attention Residuals 数字实际在 Sec.6.6 段落。这是引用位置差异,不改变数字的出处。
五:结论
5.1 这篇论文可靠地贡献了什么?
它把几个名称不同的线性注意力放回同一个“遗忘旧状态—读出当前关联—擦除/写入—query 读取”的框架,便于判断新增门控到底作用在哪个维度。实验进一步说明,控制粒度更多不自动保证更快或更低损失;优化器、学习率与 stack 需要一起比较。
CLER 的负面结果也是有用发现:本层 delta-rule 误差是一种局部量,不是天然可跨层复用的语义表示。CLVR 通过投影把完整 value 放进共享残差流,在已报告匹配组中有小幅正向趋势。最清晰的内容消融是同形状投影下 value 优于 error,而不是仅凭 CLER/CLER-H 便证明失败原因只有空间错配。
5.2 哪些结论还不能下?
不能声称 CLVR 已显著改善大模型、能增强长上下文检索、会提高推理吞吐,或已经适用于 KDA/GDN2。不能把非零路由范数当作机制证明,也不能把表内小 loss 差写成百分点准确率提升。主扫描的最低值是该训练条件下的一次结果,缺少重复种子和均衡超参数搜索,不能成为普遍架构排名。
还缺少决定复现解释的重要细节:Fig.6 的逐长度工作量控制、每种路由投影的实际 rank 和参数开销、部分控制实验的完整映射,以及 GDN 内部路由误差的实现定义。以上是本次对原文证据可支持范围的判断,不表示作者代码一定缺少这些信息。
5.3 后续研究如何直接检验其解释?
依据 Sec.8(pp.17–18),优先问题是扩大 token 预算并做多 seed 配对,测量收益是否继续衰减;将路由应用到 KDA/GDN2,并明确选择 raw value、gated write target 或 residual;记录投影前后信号、残差流变化及投影范数,在相同 checkpoint 分析信号影响;在关联检索、passkey、长上下文问答与多干扰 ICL 中评估;补充推理吞吐、解码内存与长上下文质量测量。
本次建议的额外控制:保留相同的投影形状与预算,只改变注入 value/hidden 的位置,能比当前标量 CLER 与矩阵 CLER-H 的跨组比较更直接检验空间假说。应再做训练后关闭路由或扰动信号的干预,以区分“通路在使用”和“通路带来收益”。
5.4 组会可围绕三个问题讨论
- 写入误差对时间方向的记忆修正很合适,为何完整 value 对深度方向的传递更合适?
- 比较架构时,应在固定 token、固定训练时间、固定总参数或固定 FLOPs 中选择哪一种约束?本文主要回答的是哪一种?
- 若平均 next-token loss 只改善 0.002 左右,怎样设计实验判断这是否对应重要的长上下文能力变化?
交付与核验说明
本地成品为本笔记、英文 Beamer PDF 与 可编辑 TeX。图件均从已查看的原 PDF 裁切,保留图例与坐标;图件坐标记录 给出来源页码。facts.json 保存中英文共用的 Table 2、5、7 核验数值,新增计算均在正文注明。
英文幻灯片按约 25–30 分钟主讲加备份材料组织。编译和逐页视觉检查的实际记录见 quality-check.md。本次没有训练复现实验,不把论文单次结果升级为统计结论。