Sparse Delta Memory:中文精读笔记
原题:Sparse Delta Memory: Scaling the State of Linear RNNs through Sparsity
作者:Loïc Cabannes、Pierre-Emmanuel Mazaré、Gergely Szilvasy、Matthijs Douze、Maria Lomeli、Ilze Amanda Auzina、Justin Carpentier、Gabriel Synnaeve、Hervé Jégou。机构为 Meta FAIR、Inria Paris / ENS-PSL University、University of Tübingen。
版本:arXiv:2607.07386v1,2026-07-08 提交;PDF 首页排版日期为 2026-07-09。获取与研读日期:2026-09-08(UTC)。
材料:原文 PDF · 作者 TeX 主文件 · 源码清单 · 英文幻灯片 · 可编辑 TeX。
本次阅读以同版本作者源码 main_arxiv.tex → body.tex / appendix.tex 为主,核查了相关宏、架构图的 TikZ 源文件、参考文献条目与原始 PDF 图件,并用最终 20 页 PDF 核对公式、图表和页码。正文 Sec. 1–7 及附录 A–F 均已覆盖;参考文献用于定位,未逐篇阅读所引论文。源码获取成功。以下页码均为从 1 开始的 PDF 页码,与本论文印刷页码一致。本笔记是分析,不是全文译稿;未执行作者代码、重训模型或复现基准测试。
论文总览
SDM 的核心想法是把线性 RNN 的“小而密集更新的状态”换成“大而稀疏访问的记忆表”:每个 token 只选少量槽位读写,使可存储的信息量大幅增加,而主要读写算术成本由访问槽数控制。地址通过乘积键记忆(Product-Key Memory,PKM)产生,更新沿用门控遗忘与 delta 修正的思路。
最扎实的实验证据是:在论文匹配的 GDN 对照条件下,增大状态明显改善固定状态模型的长上下文能力。8B 档位的 RULER 13 任务平均准确率由 34.2% 提升至 50.2%(+16.0 个百分点),但 FullAttn 仍为 61.2%。默认 SDM 还学习初始状态 $\mathbf M_0$,因此该比较同时包含可学习记忆的作用;去掉可学习初始化后,1.4B SDM 的 RULER 仍为 28.0%,高于 GDN 的 20.0%。[Sec. 5.3、6;Table 2,p. 8;Table 3,p. 9]
理解全文需要带着三个限定:参数匹配排除了 SDM 记忆;isoFLOP 不等于同速度;v1 的逐槽更新公式与架构图/附录存在实质差异。这些限定影响方法复现和结论解释,后文分别展开。
结构地图
| 原文章节 | 论证作用 | 已核查的位置 |
|---|---|---|
| 1 Introduction | 长上下文、固定状态容量瓶颈与贡献 | pp. 1–2;Fig. 1,p. 1 |
| 2 Background | 线性注意力、GDN、PKM 与相关工作 | pp. 2–3;Eq. (1)–(2) |
| 3 Method | 稀疏寻址、写入、读取、初始化与容量控制 | pp. 4–5;Fig. 2 在 p. 3;Eq. (3)–(6) |
| 3.1 Sparse Delta Memory | SDM 单步运算 | p. 4 |
| 3.2 IsoFLOP Design: Matching GDN Parameters and FLOPs | 匹配投影尺寸与访问预算 | pp. 4–5 |
| 3.3 Limiting the State Size Expansion | 用头数控制状态的立方增长 | p. 5 |
| 4 Experimental Setup | 混合架构、训练、规模阶梯与评测 | pp. 5–6;Table 1,p. 6 |
| 5.1 Power-Law Scaling: SDM Outperforms GDN at All Compute Levels | 训练损失随算力扩展 | p. 6;Fig. 3,p. 7 |
| 5.2 Sparse Memory Improves Short-Context Performance | 知识与推理任务 | p. 6;Table 2,p. 8 |
| 5.3 Scaling Memory Improves Long-Context Retrieval | RULER 检索 | pp. 6–7;Table 2,p. 8 |
| 5.4 SDM Reaches Lower Perplexity with More Context | 百万 token 代码文档的困惑度 | p. 7;Fig. 4,p. 9 |
| 6 Ablations: What Makes SDM Work? | 初始记忆、容量、效率和访问分布 | pp. 7–10;Table 3;Fig. 5–7 |
| 7 Conclusion | 贡献与状态占用限制 | p. 10 |
| A Efficient Training of SDM | 分块并行、稀疏内积、节省反向内存 | pp. 14–15;Eq. (7) |
| B SDM Memory Utilization During Training | 训练中的门与槽位覆盖率 | p. 16;Fig. 8 |
| C RULER Per-Task Accuracy by Sequence Length | 全部 13 项任务的长度曲线 | pp. 16–17;Fig. 9–10 |
| D Ablations | 访问分布定义、读写预算对照 | pp. 18–19;Table 4 |
| E Mixed FullAttn + SDM Hybrid | 三类注意力的互补性 | pp. 19–20;Fig. 11;Table 5 |
| F Compute Resources | 实验硬件与总资源 | p. 19 |
一:动机——状态容量为什么值得单独扩展
1.1 两种记忆机制的约束
自回归 Transformer 在 KV cache 中保留过去 token 的键值。对固定模型,每生成一个新 token,访问历史的计算和 KV 占用随上下文长度 $T$ 增长。线性 RNN 则将历史压缩到固定状态;每步读写成本与历史长度无关,但固定容量会造成不同信息之间的干扰。
GDN 的状态是一个稠密矩阵。直接把矩阵增大,每步都要更新更多元素,状态和计算量一起增长。SDM 要解决的具体问题是:能否让总槽数 $N$ 很大,而每步只触碰 $W$ 个写槽与 $R$ 个读槽? 这把容量和访问预算变成两个可以分别控制的量。[Sec. 1–2,pp. 1–3]
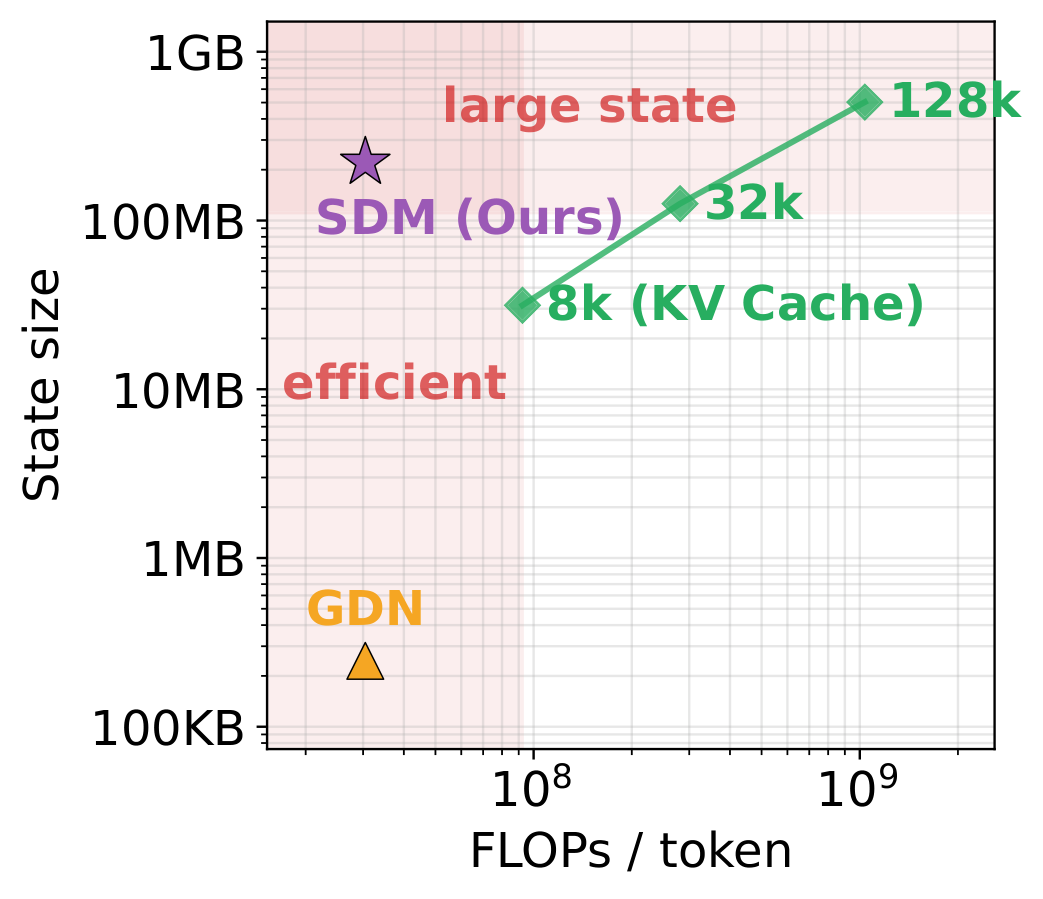
原 Fig. 1,PDF p. 1,作者原图。横轴为每 token FLOPs,纵轴为单个全局层的状态大小,均为对数刻度;绿线上的 8k、32k、128k 对应不同 KV 长度。图表达固定状态模型的容量—计算权衡,不能据此断言 SDM 在任意长度下比 FullAttn 更省显存,也不是实测吞吐图。
1.2 SDM 相对 GDN、PKM 分别增加了什么
- 相对 GDN:以稀疏地址访问更大的表,并且只遗忘被选中写入的槽;移除了 GDN 的 q/k/v 一维卷积。
- 相对传统 PKM:记忆不仅在训练中学得,还会在处理上下文时发生递归写入。
- 学习 $\mathbf M_0$ 后:同一表既承载预训练知识的起点,也承载当前序列产生的动态状态。这里没有声称推理时对整个模型运行优化器。
作者把 Fast-Weight Product Key Memory 视为最接近的工作,并强调其与本论文在更新、混合架构、isoFLOP 对照及规模上的差别;本次未独立复核那篇相关论文,故不将这些比较扩展成新的优先权判断。[Sec. 2,p. 3]
二:方法——从稀疏地址到可更新记忆
2.1 先理解 GDN 的 delta rule
背景中的线性注意力先把键值压到关联记忆中:
这是原 Eq. (1) 及其前面的定义,PDF p. 2。$\phi$ 是键/查询特征映射;$\mathbf z$ 提供归一化,分母须有定义。有限维映射允许保存固定大小的充分计算状态,但压缩会带来容量约束。原文讨论了无限维特征可精确表示 softmax 核的理论联系,并未因此声称 SDM 等价于精确 softmax attention。GDN 则进一步改变写入规则,引入预测残差和遗忘。
原文 Eq. (2) 为:
$\mathbf M\in\mathbb R^{d_{\rm qk}\times d_{\rm v}}$,$\mathbf k\in\mathbb R^{d_{\rm qk}}$,$\mathbf v\in\mathbb R^{d_{\rm v}}$。先以 $\alpha_t$ 遗忘,再以键读取旧预测 $\alpha_t\mathbf M_{t-1}^{\top}\mathbf k_t$;写入“目标值减旧预测”的残差,由 $\beta_t$ 调节强度。外积把同一个残差沿键方向写回。与简单累加键值相比,它显式修正记忆已经能预测的部分。[Sec. 2,pp. 2–3]
这一解释中的“旧预测”是所有键分量对矩阵的加权读取,这正是与后面 v1 Eq. (4) 核对时的关键。
2.2 SDM 符号和输入输出
| 符号 | 含义与维度 |
|---|---|
| $d,\mathbf x_t$ | 模型宽度;输入向量 $\mathbf x_t\in\mathbb R^d$ |
| $H$ | SDM 头数,与 GDN 的头数不必相同 |
| $N,\mathbf M_t$ | 每头槽数;每头状态 $N\times d_{\rm v}$ |
| $W,R$ | 每 token、每头选择的写/读槽数,默认均为 64 |
| $\mathcal I_t^w,\mathcal I_t^r$ | 被选中的写/读槽索引集合,两者可不同 |
| $\mathbf k'_t,\mathbf q'_t$ | PKM 前的分数投影,各长 $2\sqrt N$ |
| $k_t^{(i)},q_t^{(i)}$ | 对选中地址作 softmax 后的写/读权重;其余位置为零 |
| $\alpha_t,\beta_t$ | 每头标量遗忘门和输入门 |
| $\mathbf v_t,\mathbf y_t$ | 写入值、读出值,均为每头 $d_{\rm v}$ 维 |
| $\mathbf g_t,\mathbf o_t$ | 输出门;混合各头后的层输出 $\mathbf o_t\in\mathbb R^d$ |
原文在背景、SDM 投影、附录训练中对 $d_{\rm qk}$、$d$ 有语境依赖;这里明确区分模型总宽度与每头值宽度。投影矩阵的行/列书写依赖向量约定,不改变输入输出维数。
2.3 PKM:用两组短分数寻址大表
将写投影拆成 $\mathbf k'_1,\mathbf k'_2\in\mathbb R^{\sqrt N}$,槽 $(a,b)$ 的分数是
选择得分最高的 $W$ 个槽;读分支独立选最高的 $R$ 个槽,再在选中集合内作 softmax。无须生成全部 $N$ 个组合:全局 top-$k$ 的得分可从两半各自的 top-$k$ 产生的 $k^2$ 个候选中获得,再选一次 top-$k$。并列分数的具体索引选择需要一致的 tie-breaking,论文未展开。
本次教学例子:$\sqrt N=4$、$W=2$,两半分数为 $[4,1,0,-1]$ 与 $[3,2,0,-2]$。只需考虑各自前两名的四个和 $\{7,6,4,3\}$,最终最高两个槽来自和为 7、6 的组合;不必枚举全部 16 个槽。这个例子只解释寻址,不是实验数据。
寻址成本由原文概括为 $O(\sqrt N d+W^2+R^2)$。因此“容量扩大不增加 FLOPs”需要放在 Sec. 3.2 的投影匹配方案下理解:任意独立增大 $N$ 仍可能增大投影成本,top-$k$ 也不是免费操作。[Sec. 2、3.1,pp. 3–4]
2.4 写入、未访问槽的保留、读出
对 $i\in\mathcal I_t^w$,v1 印出的 Eq. (3)–(4) 是:
其中
未选中的槽严格保持 $\mathbf M_t[i]=\mathbf M_{t-1}[i]$,不会在每个 token 上全局衰减。因此某条信息的保留不仅取决于时间跨度,还取决于其槽位后来被写入多少次,以及这些写入的门值。[Sec. 3.1,p. 4;Eq. (3)–(4)]
写入后按 Eq. (5) 读取:
读取可包含当前 token 已写入的内容。随后每头进行 RMS-Norm、逐元素输出门控,再用 $W_o$ 混合各头。图中归一化简写为 LN,正文明确称 RMS-Norm;复现时应核对实现。[Sec. 3.1,p. 4]
2.5 必须保留的 v1 公式歧义
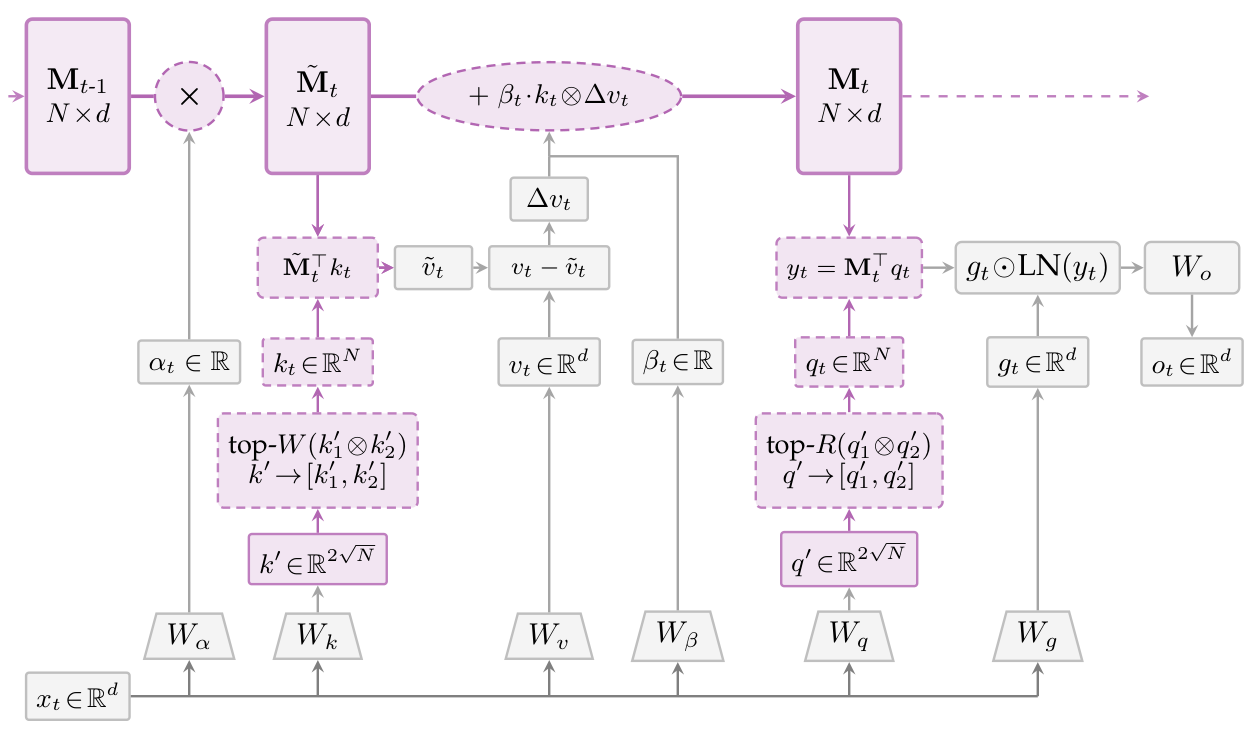
原 Fig. 2,PDF p. 3,来自最终 PDF 的矢量裁切。自下向上读:输入投影产生门、值和地址;紫色虚线表示稀疏操作;上方为状态转移,右侧为读出。图中的 PKM 框用了 $\otimes$,正文的分数运算明确是外和 $\oplus$,本笔记以正文描述解释寻址。
图中写入与逐槽公式并不相同。 图先计算 $\widetilde{\mathbf M}_t^{\top}\mathbf k_t$,再将共同的残差外积写回。按图表达出的更新应为:
Eq. (4) 则对每个槽减掉该槽自身的值。对一般多非零键,这两者不等价。因此 p. 4 的“所有槽都被选择时恰好恢复 GDN”无法由印出的 Eq. (4) 直接推出;图中的共同残差形式才与 Eq. (2) 的结构一致。附录 A 的 write–write 键内积与 WY 三角求解也更吻合后一种形式。
本次教学反例:取 $\alpha=0.8,\beta=0.5$、旧槽值 $[2.5,5]$,故衰减后为 $[2,4]$;令 $k=[0.5,0.5]$、$v=10$。Eq. (4) 给新槽 $[4,5.5]$;图中先得到共同预测 3,再写入,得到 $[3.75,5.75]$。两种状态不同。这不是排版风格差异,不能默默将其中一个替换成另一个。
本次处理:保留原公式,单独解释图/附录支持的共同残差机制;不宣称已确定实际训练内核采用哪种写法。后文训练说明依附录 A 本身展开。这一不一致来自同版本 TeX 与最终 PDF,均已核对,不是文本抽取丢失符号。
2.6 学习初始状态与上下文更新的区别
默认 SDM 将 $\mathbf M_0$ 作为参数,在预训练中学习。测试时它提供一个带预训练信息的初始表,随后 $\mathbf M_t$ 依当前上下文递归变化。普通权重/初始表的梯度学习与序列中的状态更新是两个层次。
作者称学习 $\mathbf M_0$ 相比零初始化不增加推理 FLOPs;这不意味着没有存储、加载或初始化成本。由于初始表本身可以很大,它实质上增加了模型可学习容量。论文也没有证明它存储了哪些具体事实,相关解释由任务成绩与消融间接支持。[Sec. 3.1,p. 4;Sec. 6,pp. 7–9]
2.7 isoFLOP 与“相同参数”的准确含义
GDN 每头使用 $d_{\rm qk}^{\rm GDN}=64,d_{\rm v}^{\rm GDN}=128$;两个模型都保持
主要状态访问计算分别被概括为
设置 $W=R=64$,结合相同线性投影,作者设计近似匹配的 FLOP 预算,并报告 PKM 外和 top-$k$ 的额外操作不到该层 FLOPs 的 1%。仅凭大 O 记号无法证明精确算术次数相等;这些记号省略了常数与若干实现开销。[Sec. 3.2,pp. 4–5]
Table 1 的 Params 包含词嵌入,但排除 SDM 记忆状态;Sec. 5.1 也明确排除 sparse embedding memory。于是默认学习初始化时,“相同参数”应理解为匹配被计入的骨干/投影参数,并非所有可训练标量总数相同。
| 档位 | 表内 Params | SDM 全部全局层状态元素数 | 若初始状态全部可学习,二者相加 |
|---|---|---|---|
| L08,文中简称 1.4B | 1.48B | 553M | 约 2.033B |
| L13,文中简称 8B | 8.14B | 7.963B | 约 16.103B |
最后一列是本次按原表四舍五入值相加的统计解释,不是作者另报的模型规模。不能据默认模型对比单独认定全部收益只来自动态状态容量;零初始化消融更直接支持这一点。[Table 1,p. 6]
2.8 为什么少头能扩大记忆,又为何不能无限少头
每头投影宽度为 $d_{\rm qk}^{\rm total}/H=2\sqrt N$,每头值宽度为 $d_{\rm v}^{\rm total}/H$。总状态元素数为原 Eq. (6):
它计的是元素数,不是字节数;字节占用还取决于精度。固定 $d$ 时,头数加倍使状态降到四分之一,而访问预算的主要 FLOPs 可以保持。固定 $H$ 时,状态随 $d^3$ 增长,比模型参数的平方增长更快,所以作者用 $H$ 限制规模。[Sec. 3.3,p. 5]
本次按配置推导:L08 的 $d=1920,H=2$,每头 $N=57{,}600,d_{\rm v}=960$;每个全局层有 110,592,000 个状态元素,5 层共约 553M,为表内 GDN 状态的约 900 倍。L13 的 $d=3840,H=2$,每头 $N=230{,}400,d_{\rm v}=1920$;9 个全局层共约 7.963B 个元素,按配置约为 GDN 的 3600 倍(作者概称约 4000 倍)。
2.9 附录 A:怎样训练而不保存每一步的大表
分块、再分工。 把长度 $T$ 切成长度 $C$ 的块;块内能预计算的键交互和三角求解批量并行,块间仍按时间顺序传递记忆。它没有消除因果依赖,而是用代数处理块内依赖。[A.1,p. 14]
首先按槽索引累积 log-decay,$\lambda_{t,w}$ 只加上该槽被写入时的 $\log\alpha$。然后构造写–写交互 $\mathbf A$ 与读–写交互 $\mathbf{QK}$;不同 token 的选中集合若没有交集,相关稀疏内积为零。原 Eq. (7) 为:
这里 $i,j$ 是块内 token,$n,m$ 是所选槽的位置,不是上一节的槽行标。指数项修正共同槽上的累计遗忘。构造对角为 1、严格下三角为 $\beta_i\mathbf A[i,j]$ 的 $\mathbf M_{\rm sys}$,求
有了块入口状态后,顺序执行 gather、$\delta\mathbf v=\Delta\mathbf V_{\rm const}+\mathbf B\,\texttt{retrieved}$ 修正、衰减与 scatter 写回,最后组合跨块读出与 $\operatorname{tril}(\mathbf{QK})\delta\mathbf v$。前半段偏计算密集,后一段受 HBM 随机访问限制。
稀疏内积。 先把地址按槽编号排序,以双指针合并找交集。等长写集合的一对比较为 $O(W)$,而不是 $O(W^2)$;所有块内 token 对仍需 $O(C^2W)$ 的工作。读写预算不同的情形还要计入 $R$。附录的整体复杂度概括省略了部分块长/预算依赖,不能解读为整个训练都没有二次块内工作。[A.2,p. 15]
反向内存。 前向原地写入,反向撤销稀疏更新来恢复历史状态,避免每个块保存完整大表;内存量级由 $O((T/C)Nd_{\rm v})$ 降为 $O(Nd_{\rm v}+TWd_{\rm v})$。作者给出的 8B、$T=16384,C=128,W=64$ 示例是每层状态检查点从 226 GB 降至 8 GB。128k 微调还探索 fp8/int4 快照,作者称未观察到效果损失,但未给出完整数值对照和误差条。[A.3,p. 15]
三:实验——哪些条件对齐,哪些口径不同
3.1 共用架构与训练协议
所有主要模型都是混合架构:局部滑动窗口注意力(SWA)与全局层约按 3:1 交错,SWA 窗口为 128。全局层分别换为 FullAttn、GDN、Mamba2 或 SDM。因此表里的 FullAttn 也是 SWA:FullAttn 混合模型,不是所有层都做全注意力。[Sec. 4,p. 5]
- 全注意力采用 GQA,$n_{kv}=n_h/2$,并有 attention output gating;位置编码 RoPE,$\theta=500{,}000$。
- MLP 为 SiLU 门控结构,其隐藏宽度匹配普通 $4d$ MLP 的参数预算。
- SDM 默认 $W=R=64$、softmax 读写权重、学习 $\mathbf M_0$;遗忘参数初始化与 GDN/FLA 约定匹配。
- 预训练长度为 8192;AdamW,$\beta_1=0.9,\beta_2=0.95$,梯度裁剪 1.0,WSD 学习率计划。学习率先在 Transformer 上调优,并用小网格确认 GDN;未报告为 SDM 独立进行同等强度的调参。
- 规模阶梯采用每个非词嵌入参数约 160 token 的预算。L08 为 1.48B 参数、168.4B token、学习率 $0.87\times10^{-3}$;L13 为 8.14B 参数、1.141T token、学习率 $0.50\times10^{-3}$。
- 1.4B/8B 在 128k 序列上分别用 4B/16B token 长上下文微调。Sec. 5.1 用预训练结果,Sec. 5.2–5.4 用长上下文微调后的结果;Fig. 4 另外画出预训练虚线供对照。
共用 H100 80GB,全部预训练、微调、消融和评测合计约 200k GPU 小时。论文未充分列出数据混合比例、所有评测提示与样本数、独立训练种子、速度测试的完整 batch/长度配置;不能用惯例补齐。[Table 1,p. 6;App. F,p. 19]
3.2 指标与评测对象
| 评测 | 回答的问题 | 指标及方向 | 必须区分的条件 |
|---|---|---|---|
| 训练规模曲线 | 算力增加时损失如何变化 | 最后 10 个日志值的平均训练 loss,↓ | 预训练;Fig. 3 |
| 文本/代码建模 | 下一 token 预测质量 | NLL,↓;PPL=$\exp(\mathrm{NLL})$,↓ | 文本 NLL、代码 NLL、分位置 PPL 不是同一数据聚合 |
| 15 项短上下文任务 | 知识、常识、阅读、代码和数学表现 | 论文所列任务分数及其平均,↑ | HumanEval+ 为 pass@1;并非所有任务都只测“推理” |
| Table 2 RULER | 多长度下保留和检索上下文 | 13 任务 exact-match 准确率,↑ | 表注为 4k–131k;图上标为 4k–128k |
| Table 4 读写消融 | 访问预算的作用 | 六任务 RULER、NLL、平均推理分数 | 1.4B、8k 预训练;分数以 0–1 记,长度聚合细节未充分说明 |
| Table 5 混合模型 | 全注意力与 SDM 的互补性 | NLL、平均准确率、六任务 RULER | 1.4B 预训练;RULER 仅 4k–8k |
RULER 包括 single、multikey、multivalue、multiquery 检索,vt 变量追踪,cwe/fwe 词频类聚合,以及 qa 问答。各任务保留原名,避免把这些不同能力统称为同一种检索。正文少数段落仍沿用“6 任务”的说法,与主表 13 任务口径不一致。
四:结果——按原文章节逐组阅读
4.1 Sec. 5.1:扩展算力时,SDM 的训练损失更低
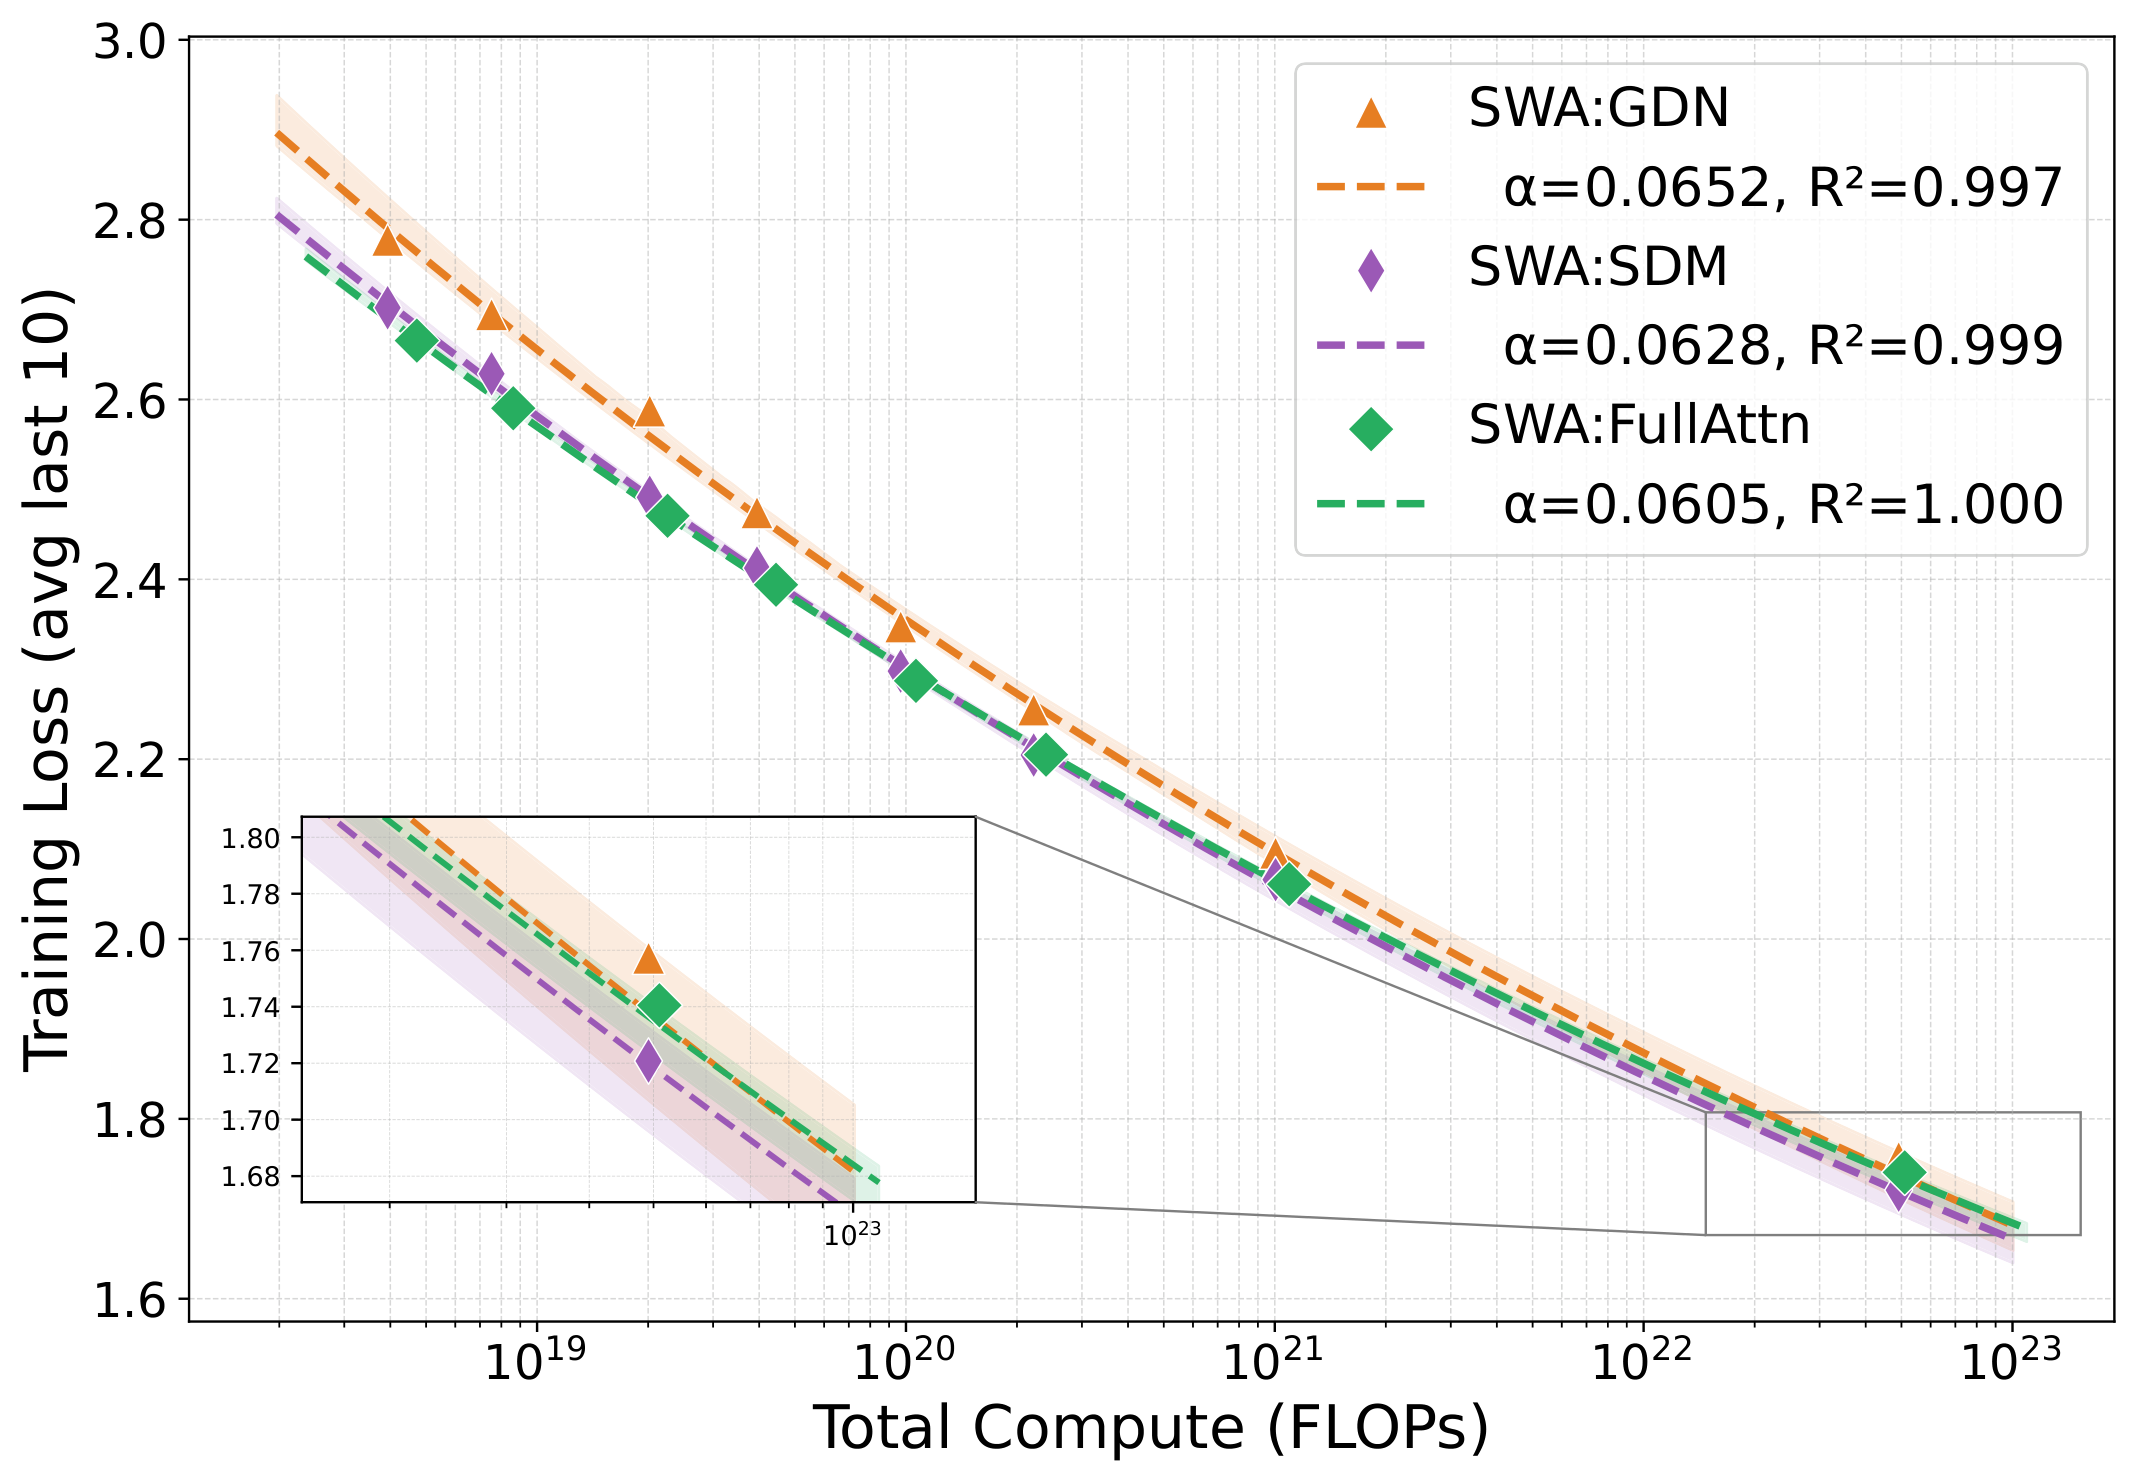
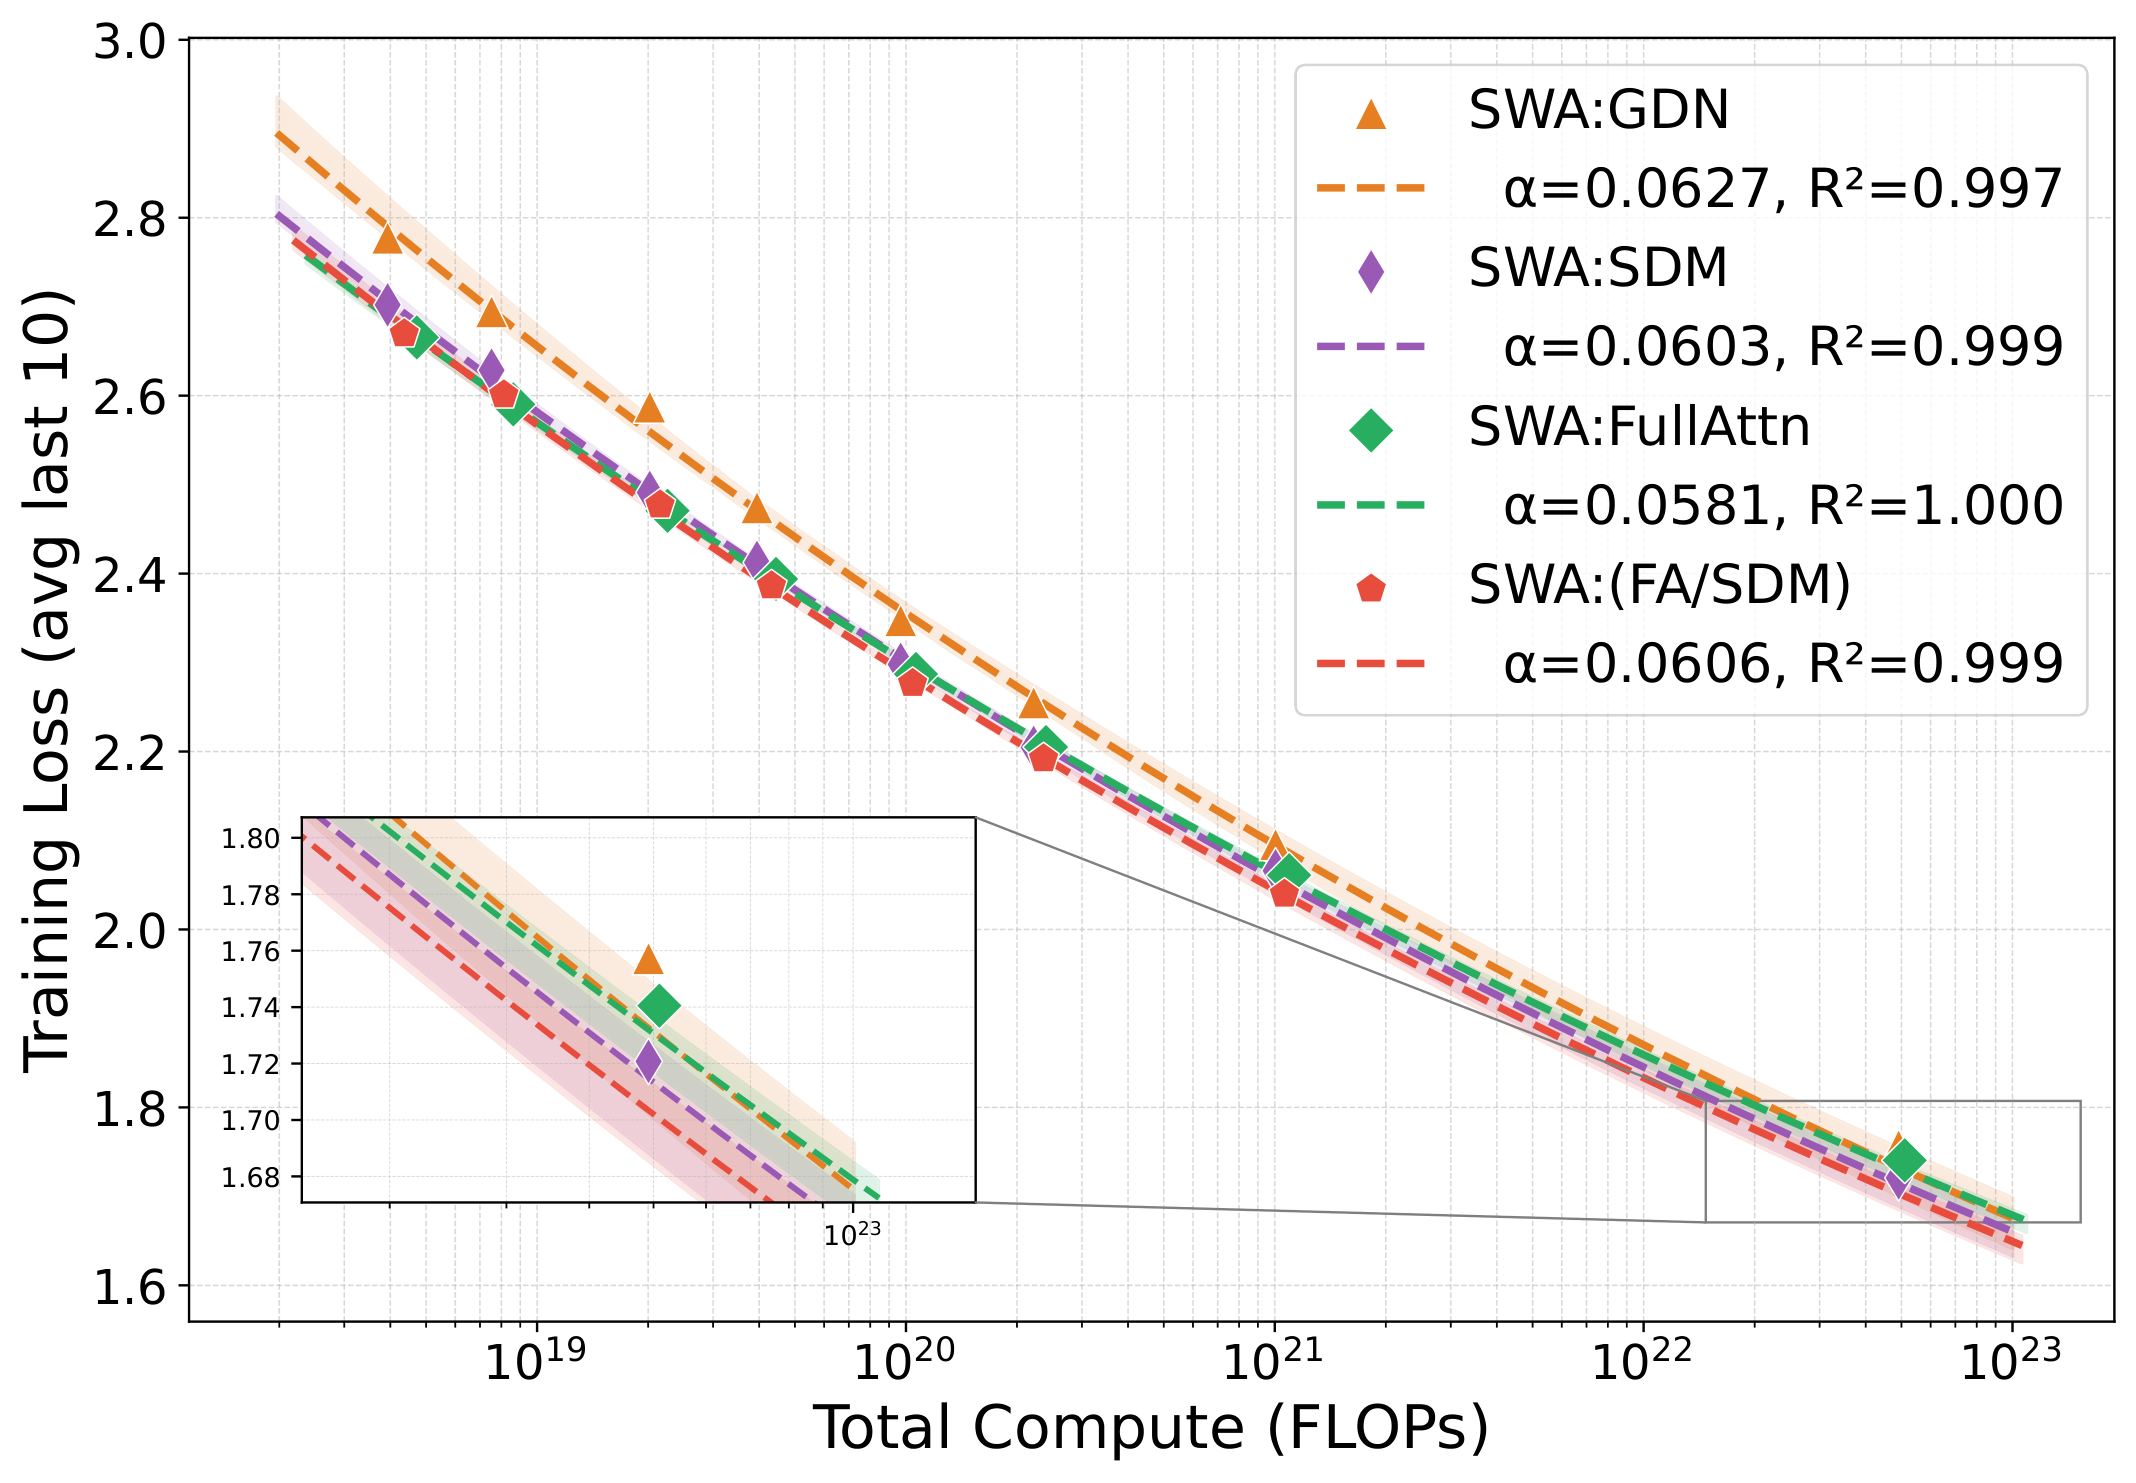
原 Fig. 3,PDF p. 7。横轴为总训练 FLOPs 的对数,纵轴为最后 10 次日志平均 loss;点为模型结果,虚线为拟合,阴影为相关不确定区间,插图放大最大规模。紫色 SDM 在报告的每个阶梯点都优于橙色 GDN,并在 8B 点优于绿色 FullAttn。
作者用 L1–L8 数据拟合,再预测 L13;SDM 拟合 $R^2=0.999$。这支持“在该配方与规模范围中表现平滑、可预测”,不是无限规模有效性的证明。图中的拟合区间也不是 Table 2 每个任务分数的统计显著性证据。[Sec. 5.1,p. 6]
4.2 Sec. 5.2:短上下文平均改善,但任务间有退步
| 指标 | 1.4B FullAttn | 1.4B GDN | 1.4B SDM | 8B FullAttn | 8B GDN | 8B SDM |
|---|---|---|---|---|---|---|
| 文本 NLL ↓ | 2.660 | 2.683 | 2.654 | 2.285 | 2.298 | 2.253 |
| 15 项平均分(%)↑ | 37.98 | 37.93 | 38.51 | 56.65 | 55.70 | 56.84 |
| TriviaQA(%)↑ | 24.24 | 23.68 | 26.61 | 55.23 | 55.36 | 59.11 |
| HumanEval+ pass@1(%)↑ | 8.54 | 8.54 | 9.76 | 24.39 | 18.29 | 24.39 |
| BoolQ(%)↑ | 62.42 | 63.03 | 62.78 | 71.83 | 74.98 | 67.13 |
| GSM8K(%)↑ | 2.81 | 2.96 | 2.73 | 29.34 | 28.81 | 28.66 |
来源:Table 2,PDF p. 8;为保持表宽,只选部分任务。1.4B Mamba2 的文本 NLL 为 2.686、平均分 38.00,亦低于 SDM 的平均表现。
相对 GDN,SDM 的平均分分别增加 0.58、1.14 个百分点;8B 相对 FullAttn 仅增加 0.19 个百分点。8B 的 BoolQ 则下降 7.85 个百分点。全文没有提供这些平均差值的跨种子误差或显著性检验,所以“略高”比“稳定全面胜出”更准确。
原文 Sec. 5.2 称 1.4B 在 13/15 任务改善;按 Table 2 逐行数,SDM 对 GDN 是 11 项提高、4 项下降,下降项为 OpenBookQA、RACE.mid、BoolQ、GSM8K。本笔记按表列数据解读。
另一个数值问题:8B 文本 NLL 的表内差值标为 −0.040,但用表列值重算为 $2.253-2.298=\mathbf{-0.045}$。这明显超出显示三位小数造成的正常舍入差,后续引用应优先给原始两值并注明重算。
4.3 Sec. 5.3:RULER 提升大,FullAttn 仍保有明显优势
| 13 任务平均(%)↑ | FullAttn | Mamba2 | GDN | SDM | SDM−GDN |
|---|---|---|---|---|---|
| 1.4B | 32.5 | 17.9 | 20.0 | 31.2 | +11.2 个百分点 |
| 8B | 61.2 | 未报告 | 34.2 | 50.2 | +16.0 个百分点 |
Table 2,PDF p. 8;13 项、4k–131k 长度平均。8B 的 +16.0 个百分点约相当于相对 GDN 提升 46.8%,这与“+16%”不是同一个量。SDM 与 FullAttn 的差距分别是 −1.3、−11.0 个百分点。
下表完整保留 8B 的任务分解,便于看清增益在哪里:
| RULER 任务,准确率 % ↑ | FullAttn | GDN | SDM |
|---|---|---|---|
| single_1 | 99.3 | 100.0 | 100.0 |
| single_2 | 89.4 | 45.1 | 71.5 |
| single_3 | 70.1 | 32.6 | 74.9 |
| multikey_1 | 75.3 | 32.9 | 59.3 |
| multikey_2 | 58.0 | 1.0 | 4.7 |
| multikey_3 | 29.8 | 0.1 | 1.2 |
| multivalue | 74.3 | 31.1 | 66.1 |
| multiquery | 73.0 | 31.2 | 68.6 |
| vt | 67.2 | 46.2 | 72.3 |
| cwe | 5.5 | 11.4 | 12.8 |
| fwe | 77.8 | 62.7 | 65.0 |
| qa_1 | 39.0 | 23.6 | 27.2 |
| qa_2 | 38.4 | 28.2 | 30.4 |
SDM 在 8B 的 13 项上对 GDN 均改善或持平;但 multikey_2、multikey_3 仍很弱,而 FullAttn 在这些项目明显领先。较大状态改善容量瓶颈,并不自动保证所有类型的关联检索都可靠。
1.4B 的 single_2 从 GDN 20.7 升至 SDM 70.8,提升 50.1 个百分点;但 fwe 从 35.6 降至 12.3,按表列值为 −23.3 个百分点。不能把 8B 的逐项改善泛化到所有规模。
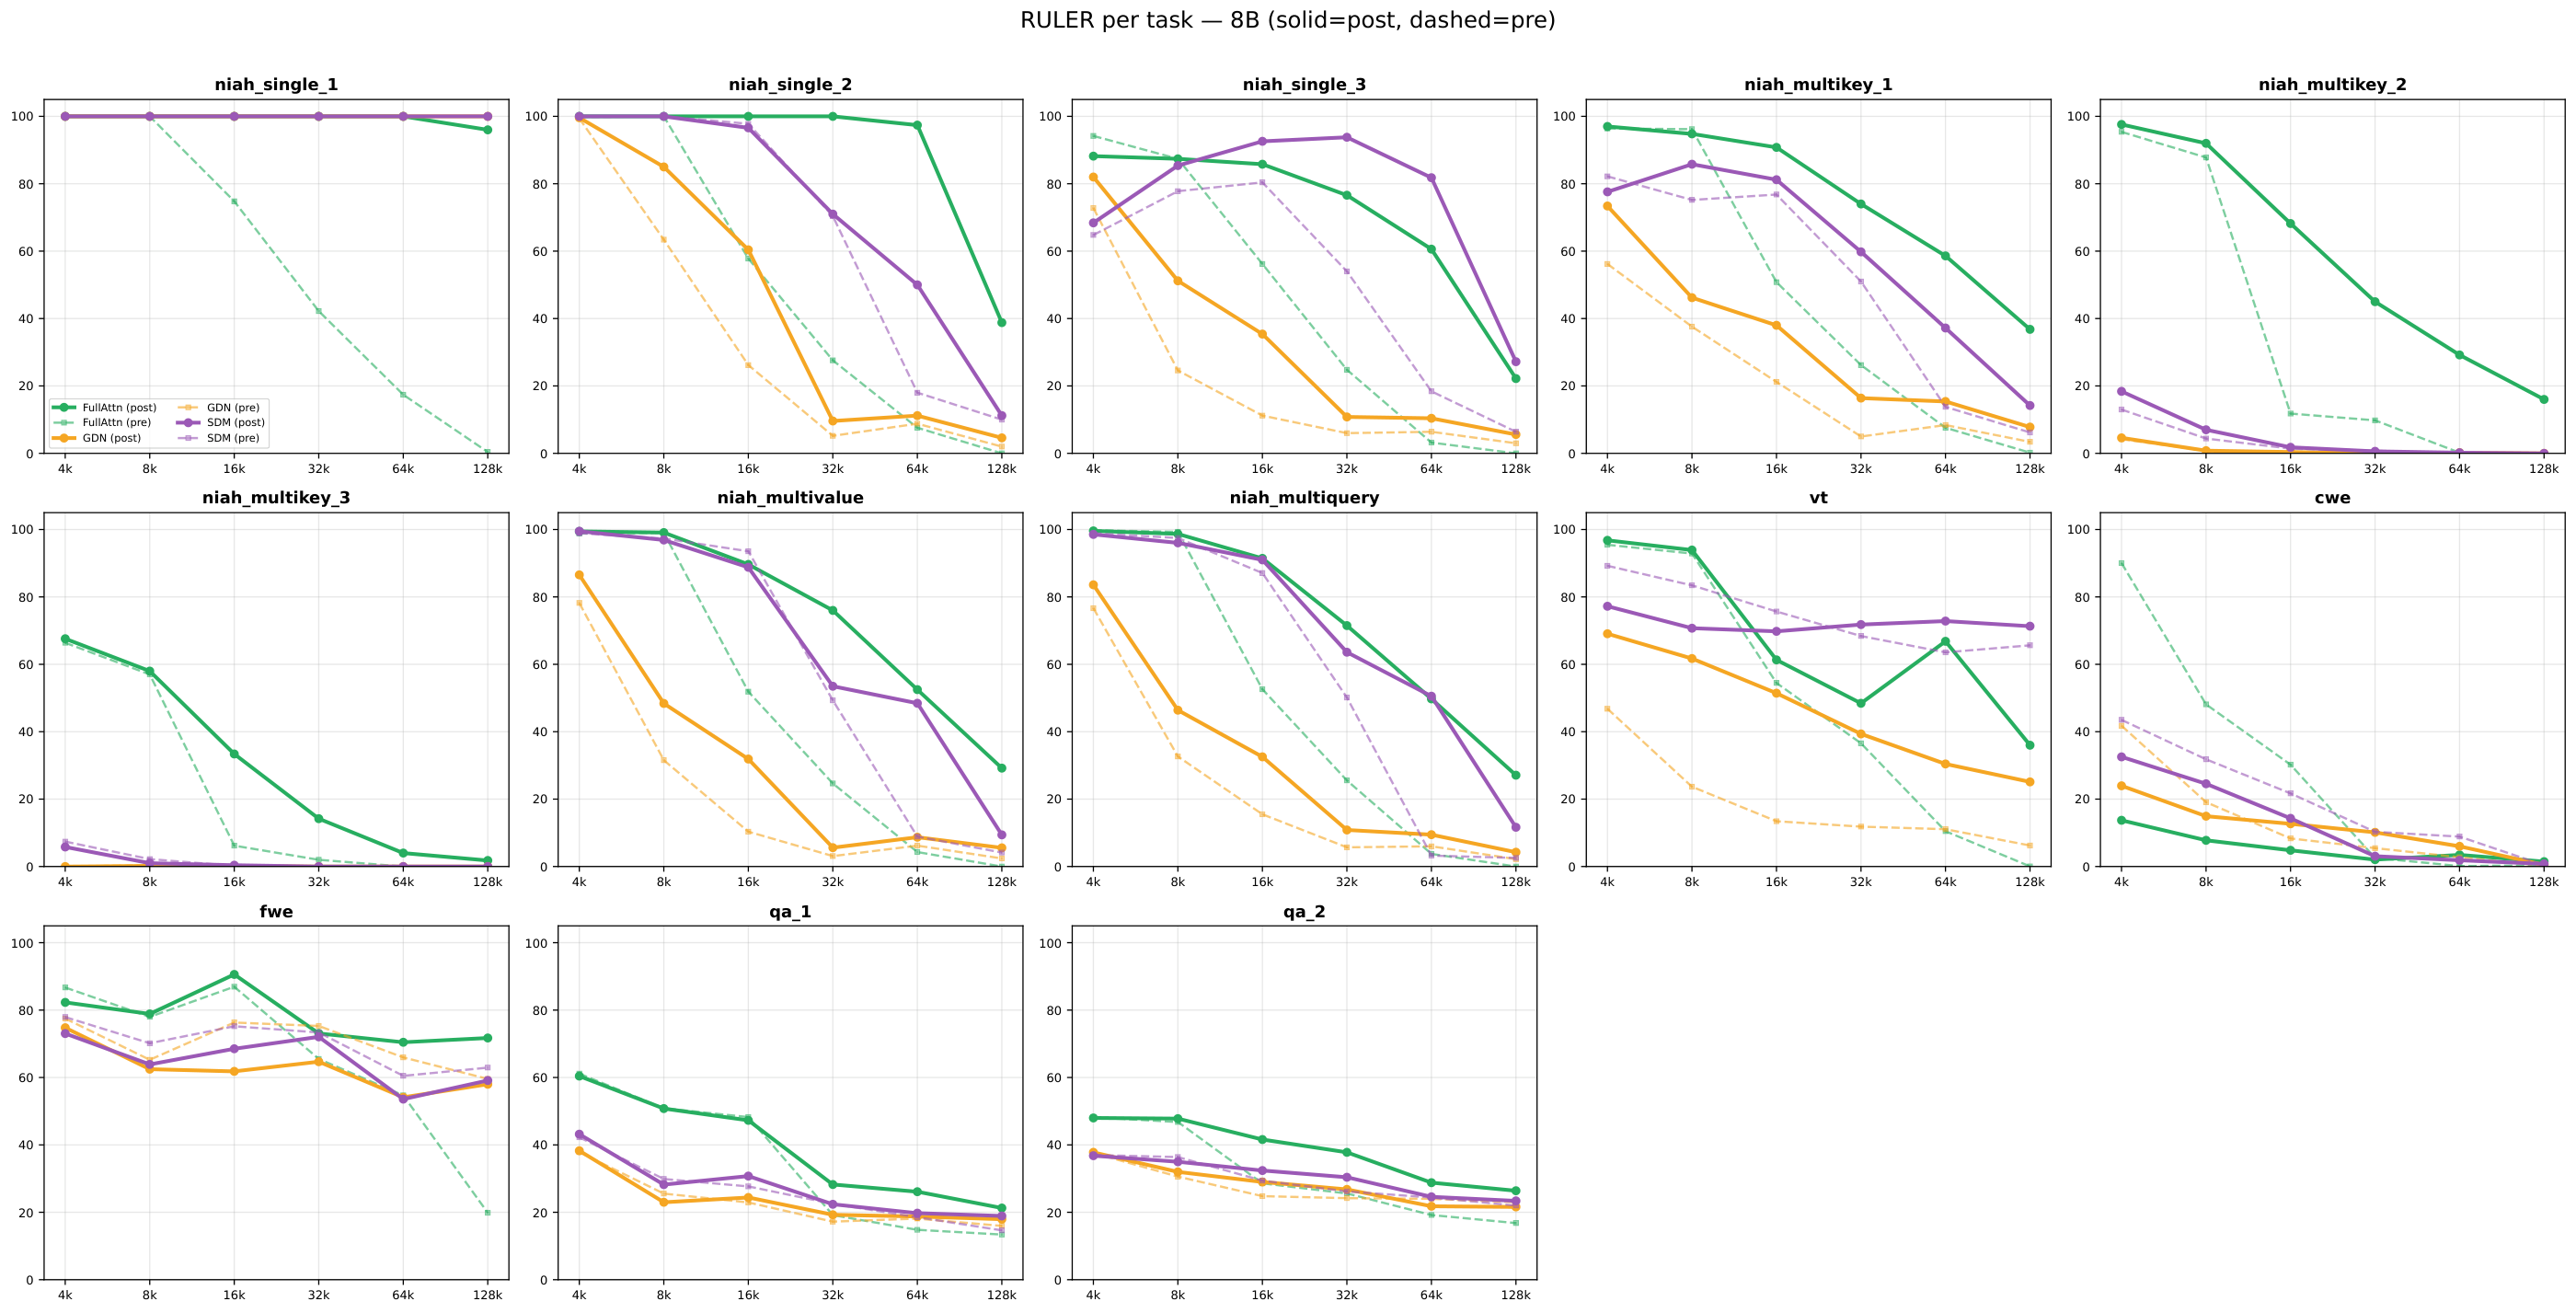
原 Fig. 10,PDF p. 17;查看完整矢量图。每个面板横轴是 4k–128k 序列长度,纵轴为准确率百分比;绿色 FullAttn、橙色 GDN、紫色 SDM,实线为 128k 微调后、虚线为仅预训练。表中的跨长度均值可能掩盖最长端下降,例如 single_2 的 SDM 微调实线到 128k 已明显降低;single_1 保持接近满分不能代表所有任务。
附录 C 对 1.4B 的 vt 随长度改善给出解释:干扰变量偏在序列前部,距离增大可能削弱干扰。那是作者对任务构造的解释,不是模型记忆随长度普遍变强的证据。对应原图见 Fig. 9。
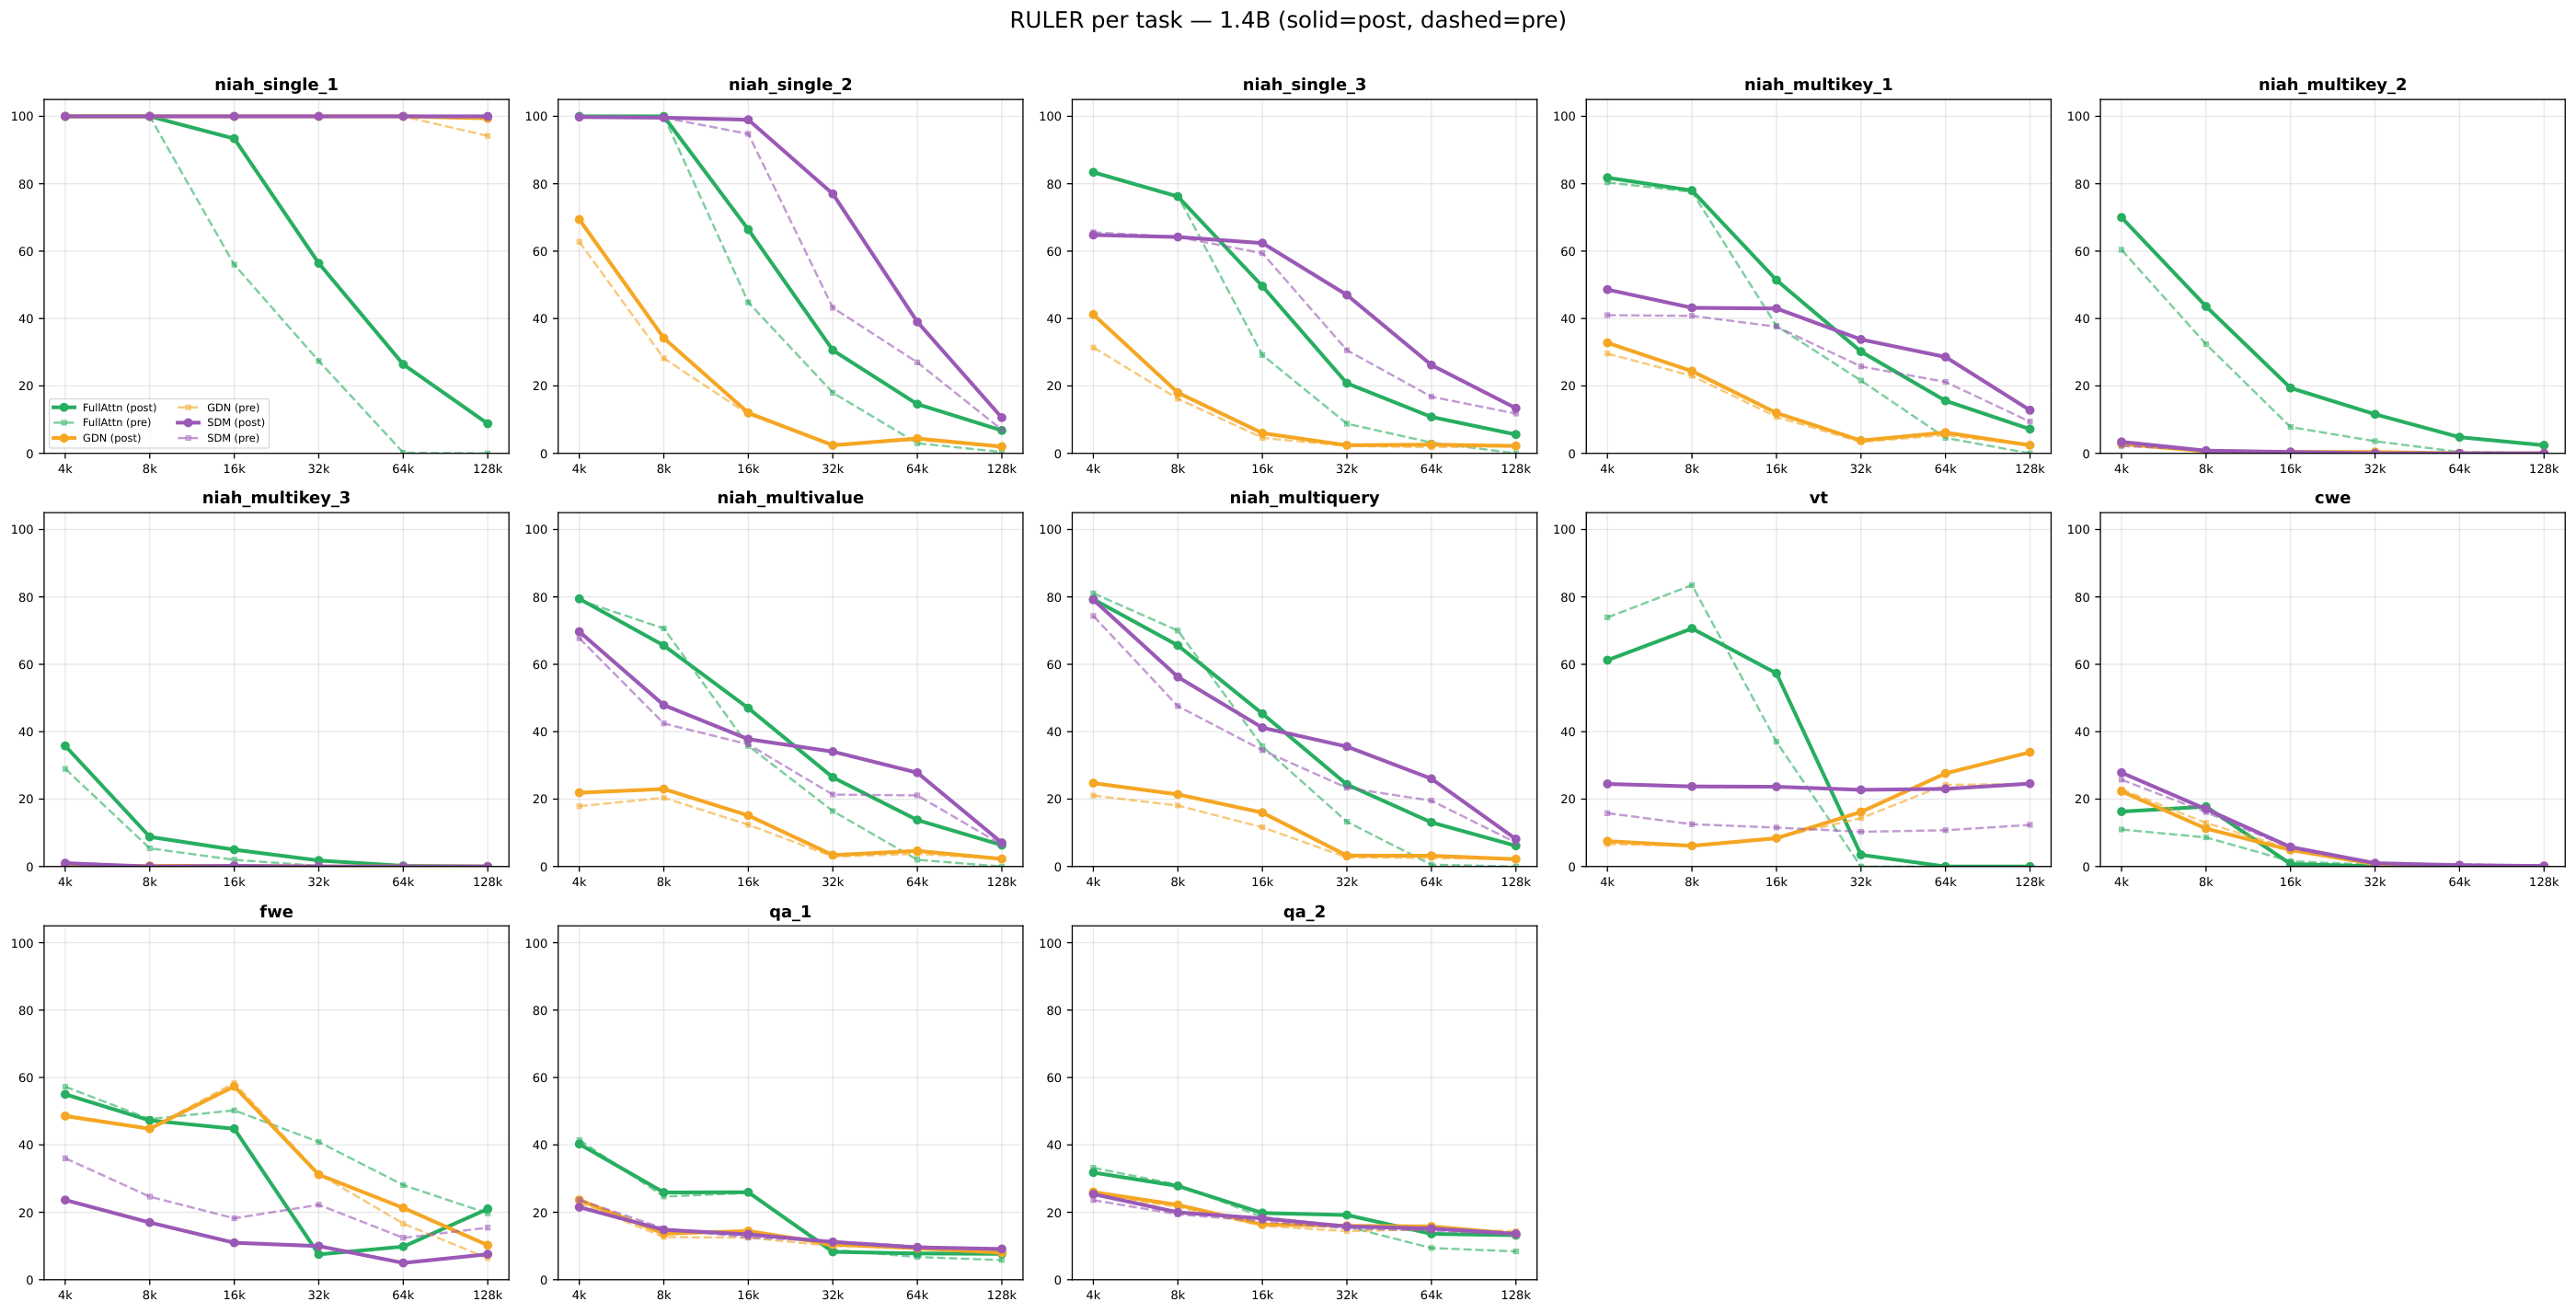
口径冲突:Sec. 5.3 的 p. 7 写 8B FullAttn “overall 76.2”,同时讨论“6 任务”;主表是 13 任务均值 61.2。按该表六个常用子任务重算也不能得到 76.2,因而不能擅自将它解释成一个已核实的六任务均值。本笔记和幻灯片统一采用 Table 2 的 61.2,并保留冲突说明。
4.4 Sec. 5.4:百万 token 的证据是代码建模,不是百万长度检索全胜
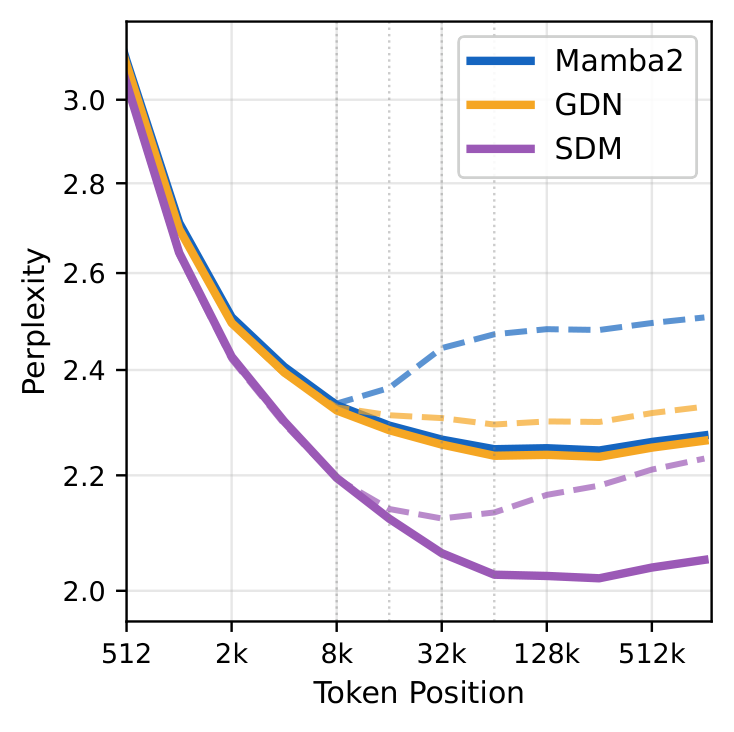
原 Fig. 4,PDF p. 9。对象是 1.4B 模型在 1M-token 代码文档上的预测;横轴 token 位置为对数刻度,纵轴困惑度 PPL,越低越好。实线是 128k 微调后,虚线是仅预训练;三条实线的局部层均为 SWA。
图上 SDM 在长位置的 PPL 接近 2.0,GDN/Mamba2 约 2.2–2.3;这是读图近似值,不应伪装成精确表格数字。128k 微调也使 SDM 比自身预训练虚线更好,表明上下文长度训练与状态设计都有作用。
256k 后原始 PPL 有回升。作者将其归因于这些位置的局部 token 预测更难,并称隔离全局层贡献后,收益持续到 1M;但 Fig. 4 展示的是原始 PPL 曲线,没有单独给出该“全局层净收益”的完整数值曲线。因此可说作者报告了这一分析,不宜说本图直接证明原始 PPL 到百万位置单调下降。[Sec. 5.4,p. 7]
4.5 Sec. 6:容量与可学习初始化各有作用
| 1.4B 变体 | 初始状态 | 原表 State/layer | Code NLL ↓ | 平均分 % ↑ | RULER % ↑ |
|---|---|---|---|---|---|
| GDN | 零 | 0.2 MB | 0.849 | 37.9 | 20.0 |
| GDN | 可学习 | 0.5 MB | 0.850 | 38.0 | 20.6 |
| SDM | 零 | 211 MB | 0.845 | 37.3 | 28.0 |
| SDM | 可学习 | 211 MB | 0.822 | 38.5 | 31.2 |
来源:Table 3 上半,PDF p. 9。容量改大而不学习初始表,RULER 已增加 8.0 个百分点;在 SDM 内学习初始表,再增加 3.2 个百分点,并更明显地改善代码 NLL 和短任务平均分。GDN 学初始状态的变化很小。这里可以说容量对长上下文增益很重要,不能说初始状态无贡献,也不能把 8.0 与 3.2 当作可普遍外推的独立因果比例。
原表对两种 GDN 的 State/layer 分别给出 0.2、0.5 MB,但没有充分解释差别的存储口径;此处保留原值。不要将 Table 3 的每层 MB 与 Table 1 的所有全局层元素数直接相除。
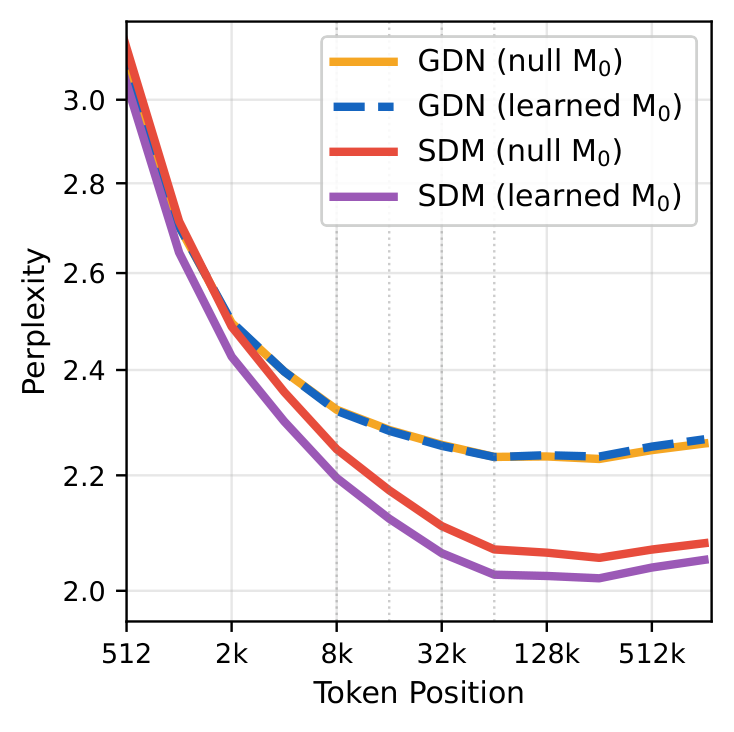
原 Fig. 5,PDF p. 9;1.4B、长上下文微调后、1M-token 代码文档。GDN 两条曲线几乎重合;SDM 零初始化已低于 GDN,学习初始化后进一步下降。图支持上述“两个因素都有作用”的解释。
| 0.8B 容量消融 | 原表每层状态 | Code NLL ↓ | 平均分 % ↑ | RULER % ↑ |
|---|---|---|---|---|
| GDN,零初始 | 0.2 MB | 0.963 | 33.8 | 16.0 |
| SDM,可学习初始 | 27 MB | 0.947 | 33.7 | 20.2 |
| SDM,可学习初始 | 108 MB | 0.937 | 33.6 | 20.7 |
| SDM,可学习初始 | 432 MB | 0.914 | 34.6 | 21.5 |
Table 3 下半,p. 9。NLL 与 RULER 随容量单调改善,短任务平均分并非严格单调。该消融通过改变 PKM 键投影宽度控制 $N$,只明确固定 $W,R,d_{\rm v}$ 与非 SDM 层;地址投影参数/计算也可能随之改变。因此它不是“唯一改变内存字节数”的完全隔离实验。
4.6 Sec. 6:理论 FLOPs 相同,硬件时间仍更贵
GDN 小状态能放在 GPU SRAM,而 SDM 大表放在 HBM,稀疏 gather/scatter 造成带宽与访存瓶颈。作者报告 HBM 带宽比 SRAM 低约一个数量级,当前 SDM 内核的 MFU 也比高度优化的 FLA GDN 内核低约一个数量级。[pp. 8–9]
- 8B 端到端训练作者报告为比 GDN 慢约 1.49 倍;这是时间/速度层面的报告,不能写成性能完全相等。
- 1.4B decode 比 GDN 慢约 10%,比 FullAttn 快约 6 倍;缺少完整长度、batch 等测试条件,不能当作通用速度承诺。
- 8B SDM 的状态占用约等于同档 FullAttn 的 203,400 token KV cache。这是作者特定配置下的状态比较,不是所有系统的统一显存交叉点。[Sec. 7,p. 10]
固定状态意味着随 $T$ 不再无界增长,不意味着绝对值小。多请求并发时,各序列动态状态还会放大总占用;这是本次从递归状态机制推得的部署考量,论文未做并发服务测试。
4.7 Sec. 6 与附录 B/D:读写分布会适应预算
对一个 token 的选中槽权重 $p$,作者统计
其中 $p_{(i)}$ 按权重降序,$k=W$ 或 $R$。$C(m)$ 反映前 $m$ 个槽覆盖多少权重;$u$ 接近 1 表示选中集合内较均匀。更精确地,对固定 $k$,其闭包范围是 $[1/k,1]$,原文用较宽的 $(0,1]$ 表示。[App. D.1,p. 18]
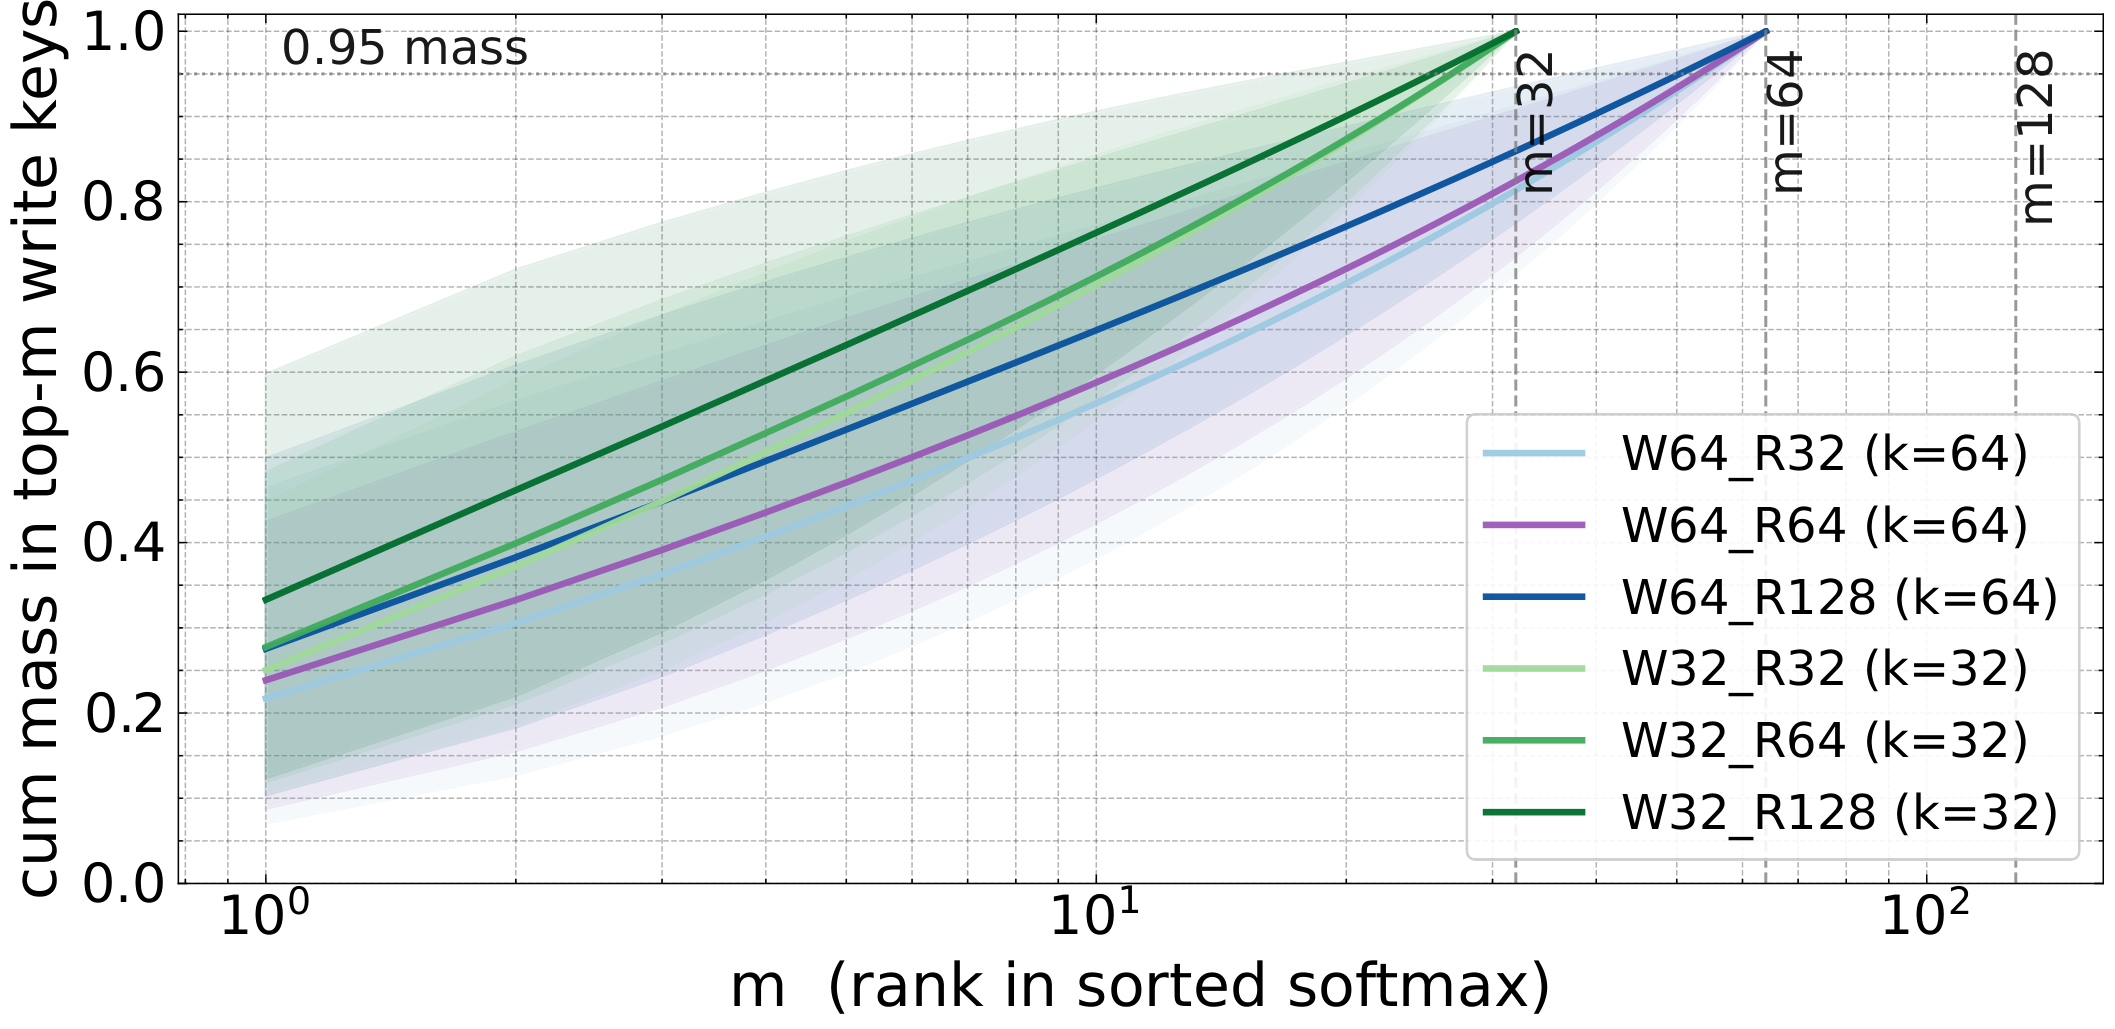
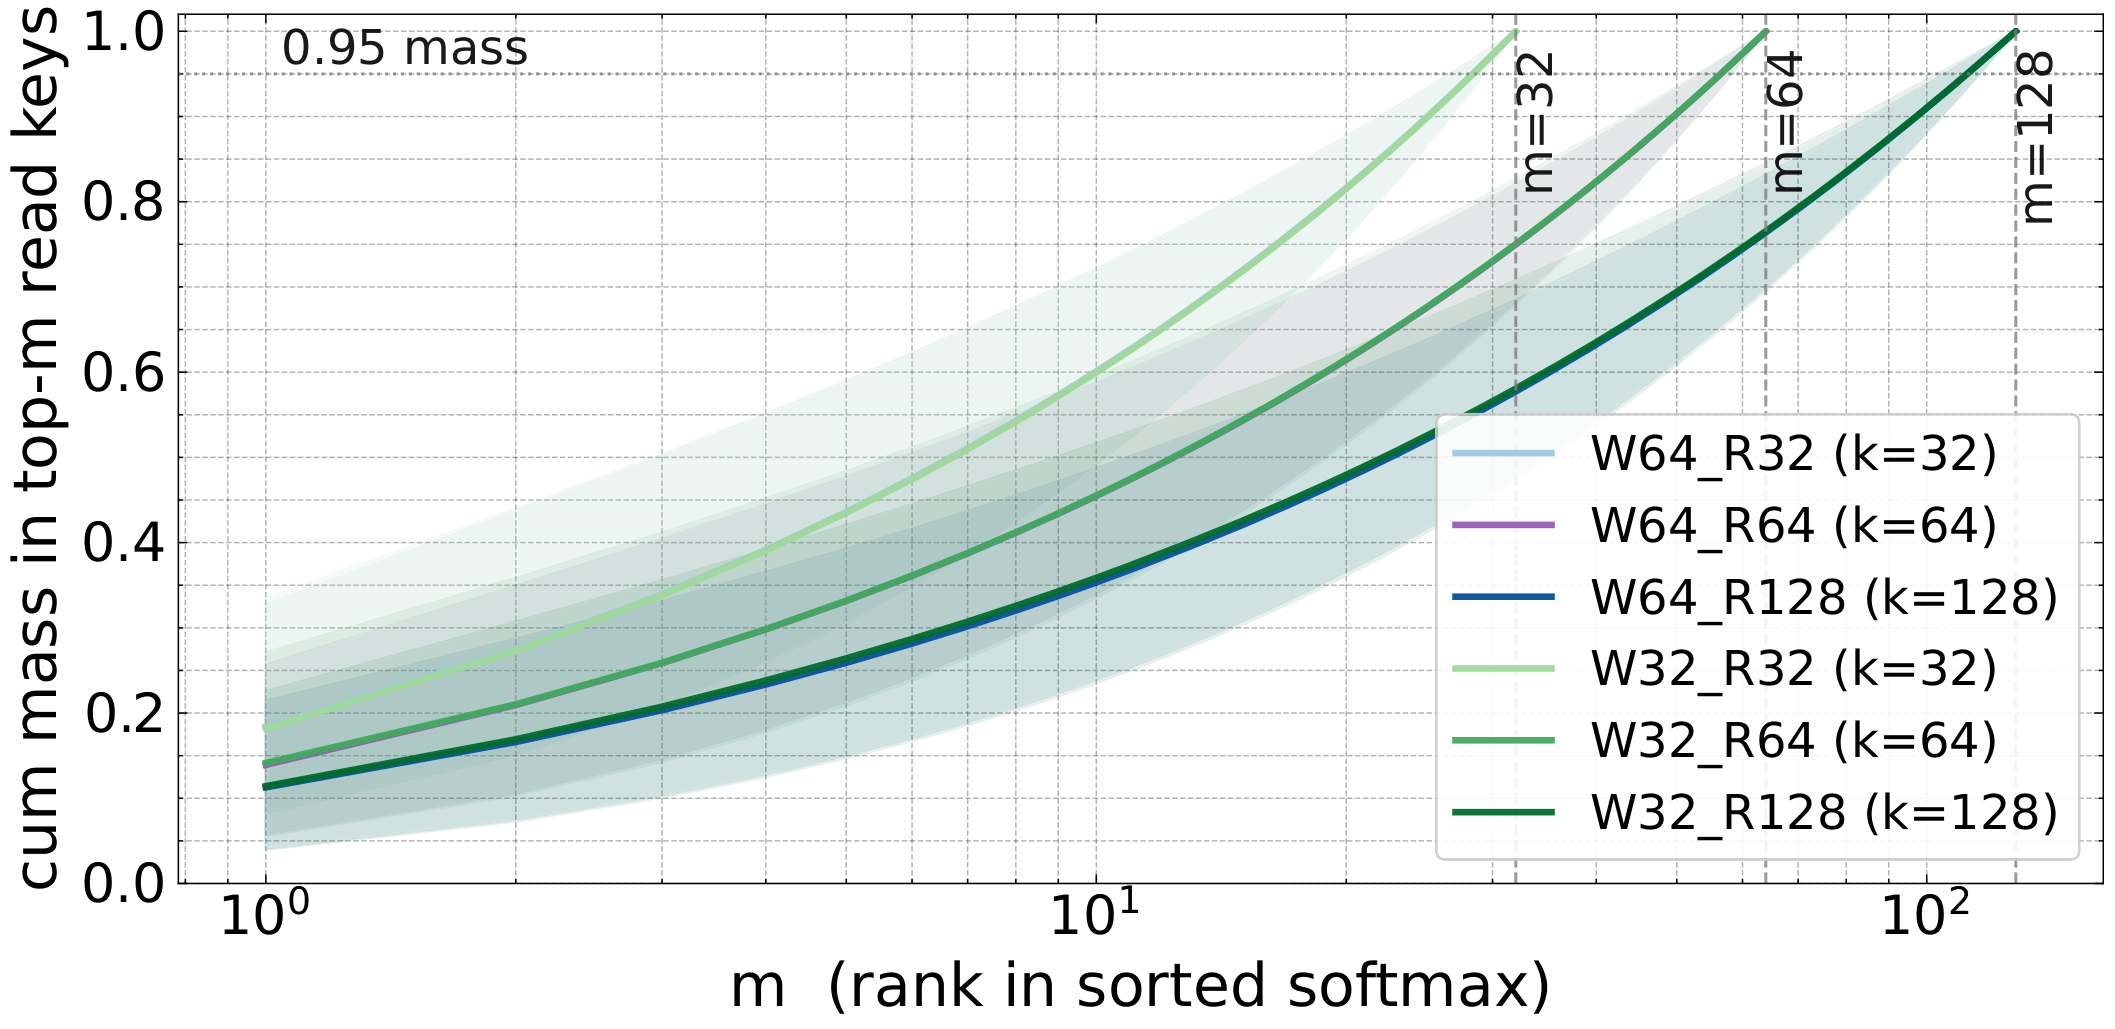
原 Fig. 6 的两个面板,PDF p. 10。横轴是排序后的槽数 $m$(对数),纵轴为累计权重;实线为层平均均值,阴影为 token 级 p10–p90 范围,并非多次训练的置信区间。$W=64$ 时前 32 写槽约占 85%;$R=128$ 时前 64 读槽约占 77%。读取总体更分散,但这些近似量随预算配置变化。
Fig. 7 的小提琴分布表明读权重通常更均匀;增加读取预算到 128 后,归一化利用率会降低,即更有选择性,而不等于绝对有效槽数必然降低。有限读取时写入更分散,充足读取时写入更集中,这是作者对不同模型配置分布的解释。原图见 写利用率、读利用率。
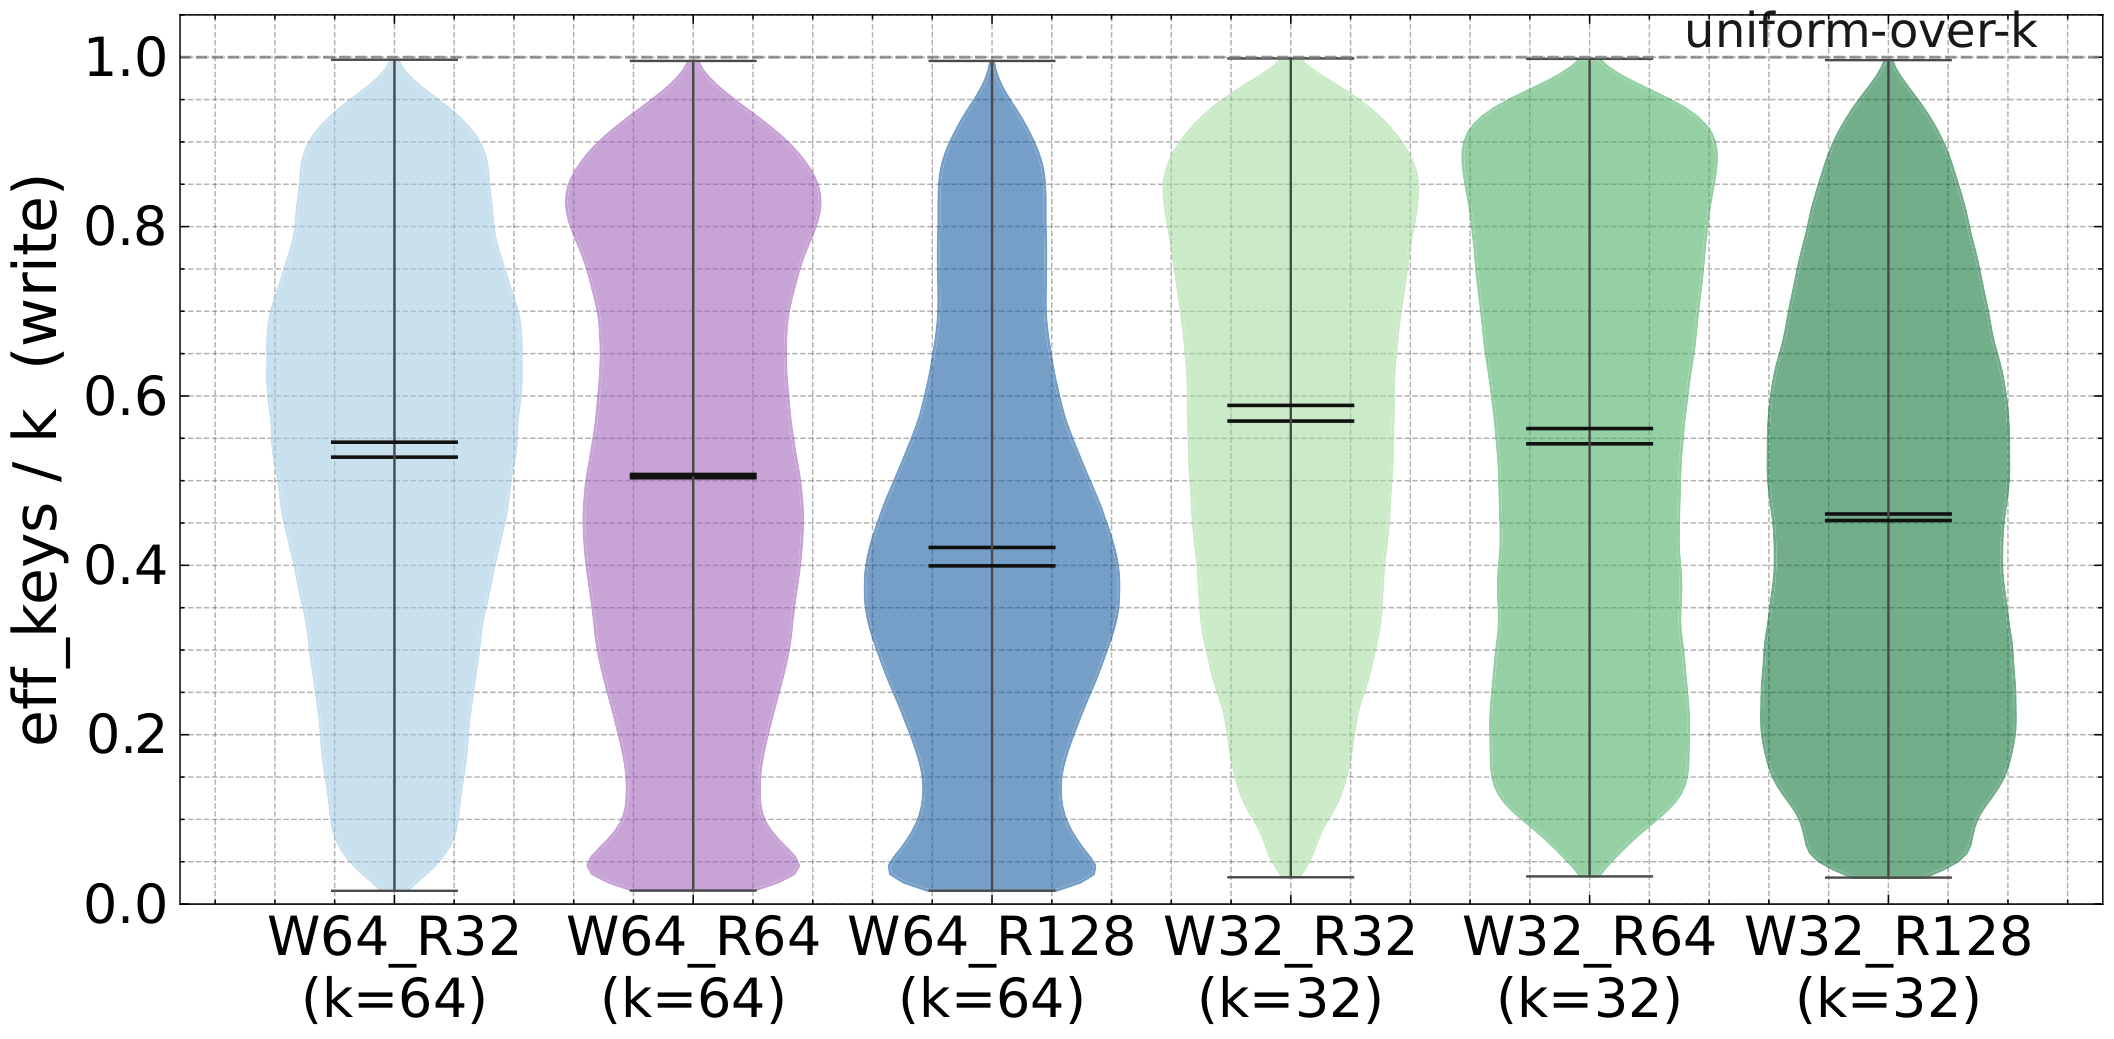
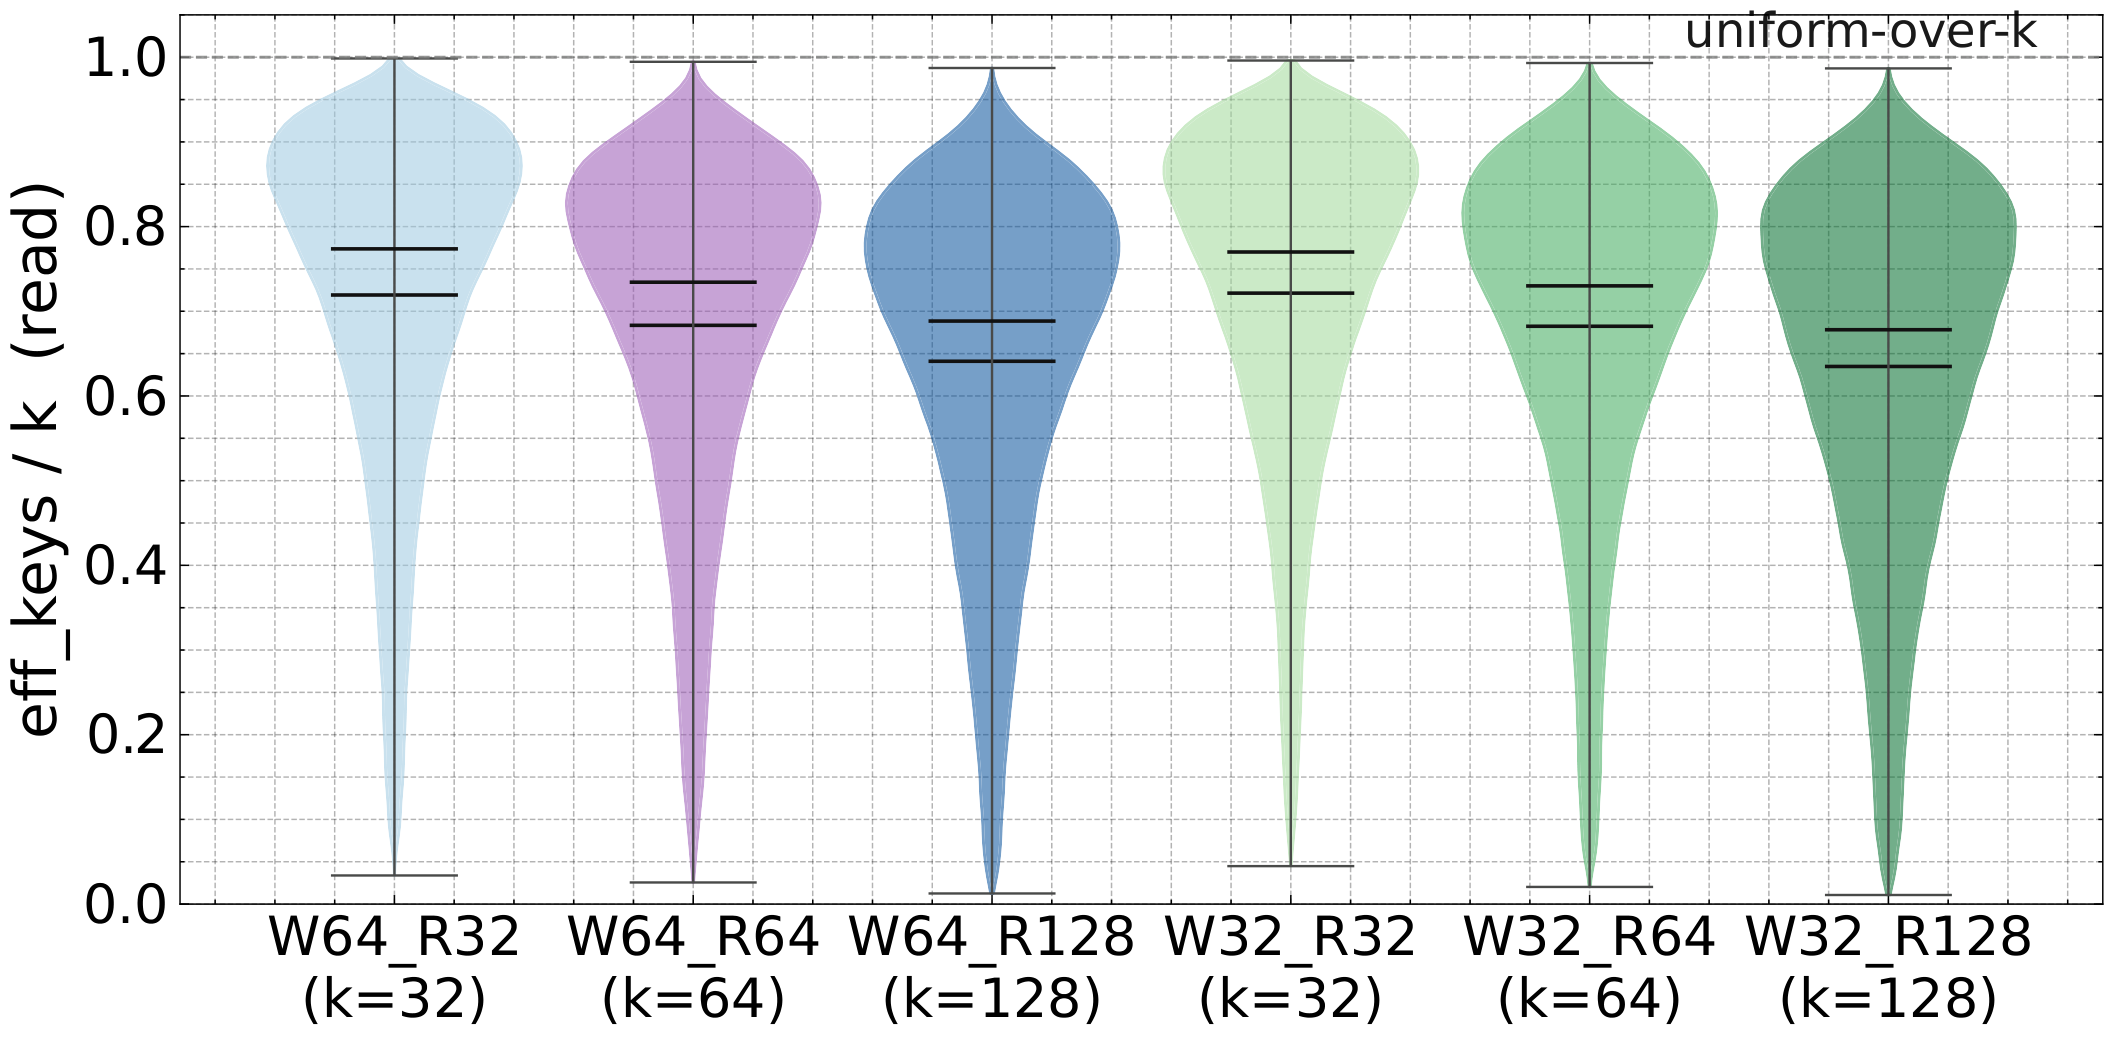
Table 4(p. 19)的预训练读写预算比较如下;为便于理解,RULER 与平均推理分数从原表 0–1 转为百分数:
| 写/读配置 | DCLM NLL ↓ | 六任务 RULER % ↑ | 平均推理分数 % ↑ |
|---|---|---|---|
| W64 / R128 | 2.6703 | 40.11 | 38.42 |
| W64 / R64 | 2.6719 | 41.76 | 38.68 |
| W32 / R64 | 2.6726 | 35.01 | 38.90 |
| SWA:FullAttn | 2.6729 | 34.74 | 38.05 |
| W32 / R128 | 2.6737 | 40.39 | 38.21 |
| W64 / R32 | 2.6746 | 37.64 | 38.87 |
| W32 / R32 | 2.6766 | 36.12 | 38.71 |
更大读取预算没有在每个指标上单调获益;W64/R64 是该表的 RULER 最优,而 R128 的 NLL 更低。该表仅六项任务,不能与主表 31.2 的 13 项长上下文均值直接比较。另有一个原表差值笔误:W32/R128 的 RULER 原始分数与基线之差是 $0.4039-0.4176=-0.0137$,而原 Delta 列为 −0.0136;本表只采用原始分数。
附录 B 的 Fig. 8 跟踪 1.4B 训练,跨 5 个 SDM 层平均,每个点累计约 21M token(10 步):遗忘门均值约 0.95,输入门约 0.50;窗口内独特读槽覆盖率很快接近 100%,写槽由约 28% 增至 42%。这里的“100%”是大批 token 聚合后的覆盖,不是单 token 读完整个表,也不证明每个槽都存储独特、有用的信息。[Fig. 8,p. 16;原图]
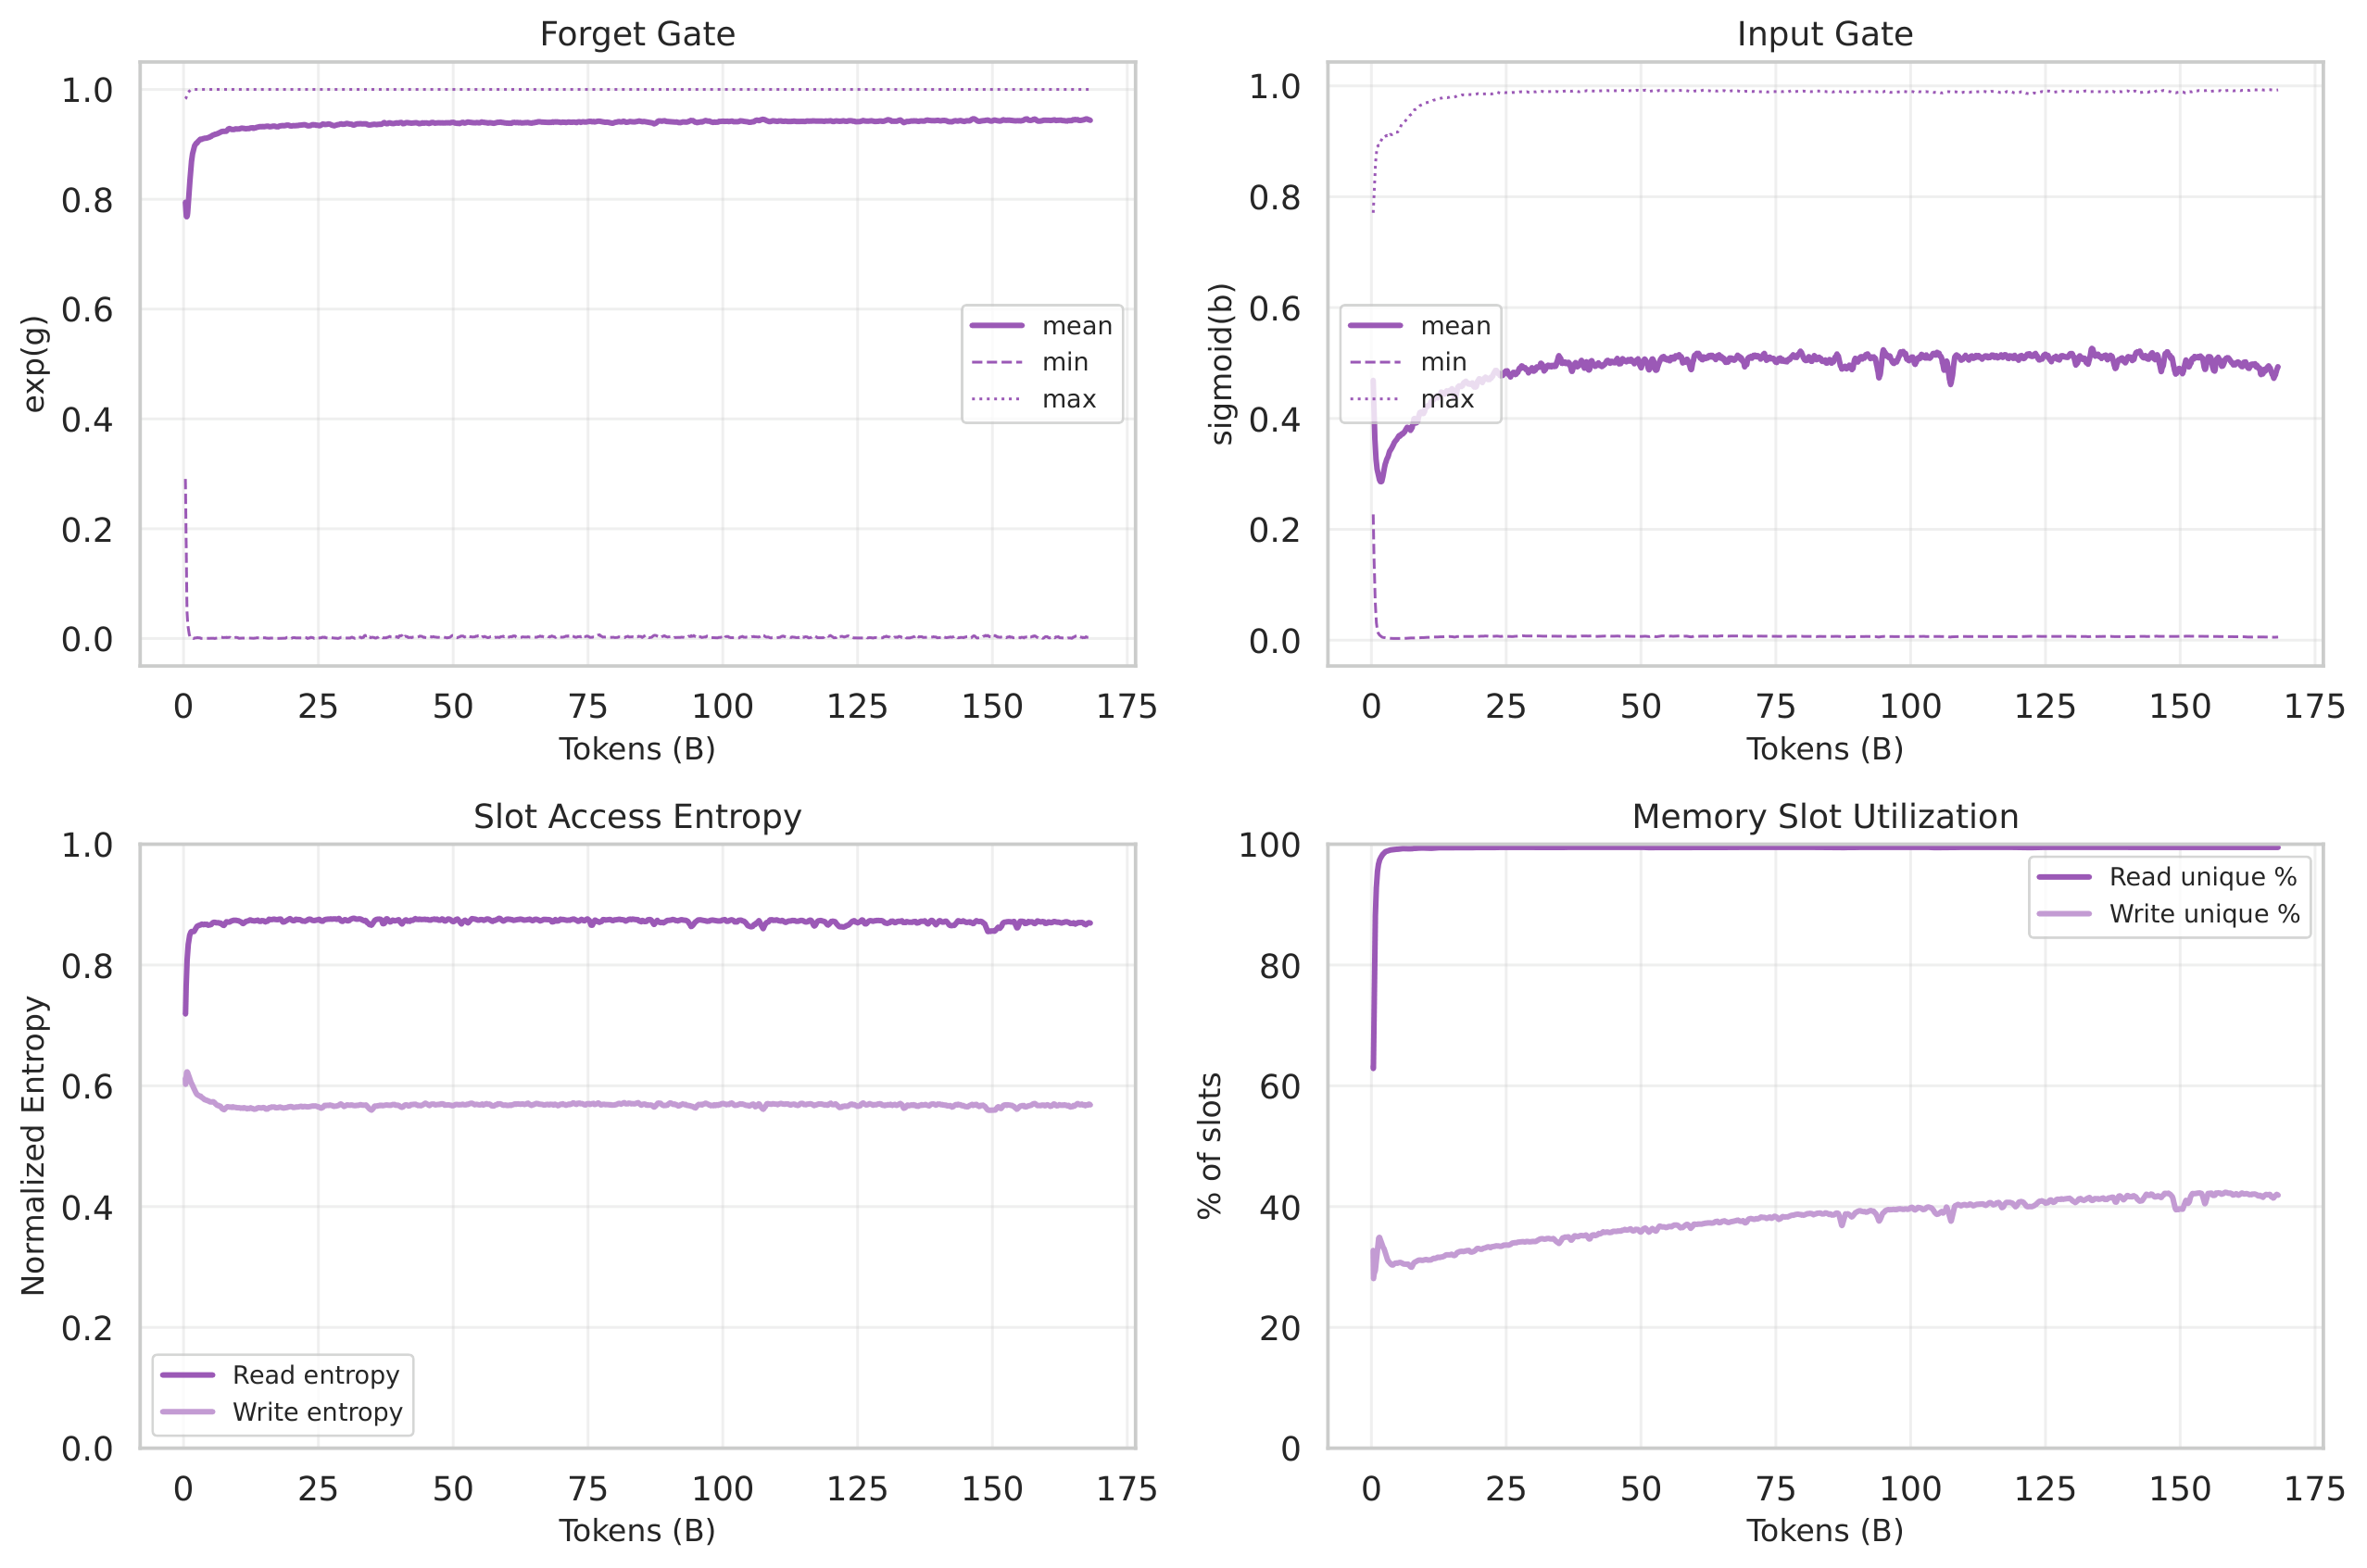
附录 D.1 的探针协议同时写“截断到 2048 token”和“8×8192 batch”,两者冲突。分布趋势可以照图解读,但准确探针长度需要作者代码/说明确认。
4.8 附录 E:加入 FullAttn,显示互补性也保留 KV 成本
作者在全局层位置交替使用 FA、SDM(5 个全局层时为 FA–SDM–FA–SDM–FA),其他层仍为窗口 128 的 SWA。Table 5 是 1.4B、仅预训练、RULER 六任务且只在 4k–8k 的结果:
| 指标 | SWA:FA | SWA:(FA/SDM) | SWA:SDM | SWA:GDN |
|---|---|---|---|---|
| 文本 NLL ↓ | 2.658 | 2.645 | 2.654 | 2.684 |
| 代码 NLL ↓ | 0.798 | 0.797 | 0.821 | 0.849 |
| 平均分 % ↑ | 38.1 | 38.6 | 38.6 | 37.9 |
| 六任务 RULER % ↑ | 80.1 | 64.3 | 56.9 | 32.9 |
来源:Table 5,PDF p. 20。混合模型的 NLL 最好,RULER 位于 FA 与 SDM 之间,支持互补性的方向。它含全局 FullAttn,整体 KV 仍随长度增长,所以不能同时继承纯 SWA:SDM 的固定总状态结论。
Fig. 11(p. 19;原图)给出 L1–L8 拟合与向大算力区间的延伸;不能把大尺度拟合趋势当成已经训练并测得的 8B 三路混合结果。
五:结论、边界与组会讨论
5.1 这篇论文真正支持什么
- 状态大小可以作为有价值的扩展维度。 稀疏寻址使大型可更新表成为可能,报告的模型在匹配主要 FLOPs 的 GDN 对照中表现出更好的长上下文能力。
- 动态容量与预训练记忆是两个不同贡献。 零初始 SDM 的 RULER 改善支持前者;学习初始表对代码 NLL 和短上下文平均分的增益支持后者。
- 系统成本转向状态存储与稀疏访存。 算术匹配后仍有训练/解码时间代价,固定容量是否合算取决于上下文长度、并发和显存预算。
5.2 原文不一致与复现优先事项
| 问题 | 冲突位置 | 本笔记采用的处理 |
|---|---|---|
| 逐槽残差 vs 共同预测残差 | Eq. (4),p. 4;Fig. 2,p. 3;App. A,pp. 14–15 | 两种形式并列,指出一般不等价;未认定实际内核 |
| PKM 外积符号 vs 外和描述 | Fig. 2 与 Sec. 2/3.1 | 寻址按正文外和解释 |
| “相同参数”排除了可学习大表 | 摘要、Sec. 3.2 vs Table 1/5.1 | 显式区分计入参数与初始记忆 |
| 1.4B 的 13/15 提升 | Sec. 5.2,p. 6 vs Table 2,p. 8 | 按逐行原值为 11/15 |
| 8B 文本 NLL 差值 | Table 2,p. 8 | 2.298→2.253,重算 −0.045 |
| 8B FullAttn RULER 76.2 vs 61.2 | Sec. 5.3,p. 7 vs Table 2,p. 8 | 主结论采用 13 任务表值 61.2 |
| 探针长度 2048 vs 8192 | App. D.1,p. 18 | 不臆定长度,分布解释保留限制 |
这些问题削弱了某些具体表述或直接复现的确定性,但并不抹去主表显示的 SDM 相对 GDN 的容量收益。数值误差和主要方向应分别评价。
5.3 适用范围与尚未回答的问题
原文覆盖到约 8B 骨干参数、1.141T 预训练 token、文本和代码、128k 微调及百万位置代码预测。真实智能体长期记忆、多模态视频、更大规模和跨会话持久记忆属于动机/展望,未由本论文直接验证。
后续最值得确认的三件事是:第一,实际内核的 delta 更新与正文哪一种写法一致;第二,在全部可学习参数、显存和真实时间分别匹配时,收益还剩多少;第三,对 multikey_2/3 的失败主要来自地址选择、覆盖写入、容量还是检索组合机制。可以据此设计补充实验,但本文没有提供足够证据替这些问题定论。
组会讲解可按“容量瓶颈 → PKM 与稀疏更新 → 参数/FLOPs 口径 → 主结果 → 初始化与容量消融 → 系统代价和公式歧义”的顺序进行。英文幻灯片保留这些关键限定,附录训练细节与额外消融放在备份页。
归档与图件说明
作者源图复制为本地 PDF,并渲染 PNG 供 Markdown 使用;架构图从最终 PDF p. 3 裁切。图件来源与裁切坐标记录在 figures/manifest.json。实验图均来自原文,没有生成式替代图;教学例子和手算统计已在正文标明。
原文:版本页 · PDF · TeX Source。作者在论文中提供了 代码仓库,本次未审计该仓库,未以未查看的代码消除论文歧义。