DepthWeave-KV:中文精读笔记
题名:DepthWeave-KV: Token-Adaptive Cross-Layer Residual Factorization for Long-Context KV Cache Compression
作者:Anna Córdoba、Adam Puente Tercero、Nerea Angulo Hijo、Mar Linares Tercero、Julia Barrientos、Ainhoa Miranda、Jesús Olivera。
版本:arXiv:2607.06523v1,2026-07-07 提交;2026-09-20 获取并研读,修订 r1。
来源:版本页面 · 本地原文 PDF · 主 TeX · 正文 TeX · 英文幻灯片。
论文总览
DepthWeave-KV 将相邻 Transformer 层的 KV 缓存表示为“共享低秩通道基 + 每个 token 的系数 + 按重要性分配的残差”,再利用注意力输出误差反馈调整残差容量。作者报告:在主表所述的 64K 设置下,平均分 62.9%,比完整 KV 的 63.8% 低 0.9 个百分点;KV 内存压缩倍数 8.3×,解码吞吐 72.8 token/s。这里的压缩倍数只针对 KV,不是整模型显存。
阅读判断:方法提供了一个值得讨论的设计组合,但当前版本不能支持可直接复现的性能结论。基础模型、GPU、batch size、关键超参数及辅助训练协议缺失;第 4 节与表 2 的消融结果不一致;PDF 表格排版损坏。下文所有实验数字均指作者报告,未进行独立复现实验。
材料与覆盖:已读取 main.tex、实际引入的完整 body.tex,检查 refs.bib/main.bbl 中的关键引用及异常条目,结合 9 页 PDF 核对全部正文、3 个公式、2 张图、2 张表和参考文献页。正文为 PDF pp.1–6,参考文献从 p.6 延续到 p.9;所获版本没有附录。两张图来自作者源码中的 PNG。PDF p.5 两表越过单栏并互相覆盖,部分数字甚至落到页面外;本笔记根据同版本 TeX 重排表格,不把源码可读误称为 PDF 所有单元格均可目视核验。
结构地图
| 原章节 | 作用 | PDF 页码与定位 |
|---|---|---|
| Abstract | 提出方法与主要数值 | p.1 |
| 1. Introduction | 深度冗余、token 重要性和四项贡献 | pp.1–2,Fig.1 在 p.2 |
| 2. Related Work | 驱逐、量化/低秩、跨层共享、输出误差 | pp.2–3 |
| 3. Method | 分解、路由、探针、训练及融合执行 | pp.3–4,Eq.(1)–(2) p.3,Eq.(3)/Fig.2 p.4 |
| 4. Experiments | 设置、主结果、任务族、简述消融 | pp.4–5,Table 1 p.5 |
| 5. Ablation Study | 系统消融及组件解释 | pp.5–6,Table 2 p.5 |
| 6. Conclusion | 作者的总结 | p.6 |
| 7. Future Work | 非局部层组、风险路由、服务系统 | p.6 |
| References | 参考文献 | pp.6–9 |
一:动机
长上下文解码需反复读取历史 KV;缓存随 token 数和层数增长。仅从 token 维度删除内容可能丢失后续才显得重要的检索证据;把所有层直接共用一份缓存,又可能抹去层间差异。作者希望同时利用三个不均匀性:相邻层存在冗余,不同 token 的检索价值不同,同一 token 在不同深度需要的保真度不同(Sec.1,pp.1–2)。
相关工作的比较角色如下,限于本文的组织方式,不代表本次重新评测了这些方法:
| 方法/家族 | 在比较中回答的问题 |
|---|---|
| Full KV Cache | 不压缩时的质量与系统开销参照 |
| StreamingLLM、H2O、SnapKV、PyramidKV | 依据位置或重要性分配 token 保留预算是否足够 |
| MiniCache、KVSharer | 利用层间缓存冗余能获得多少收益 |
| ChunkKV、TailorKV | 语义片段保留或混合缓存策略的对照 |
| Eigen Attention | 低秩注意力表示的对照 |
DepthWeave-KV 的区别不只是“使用低秩”:它保留所有 token 的压缩表示,在共享通道子空间上为不同 token 分配不同残差容量,并使用在线注意力输出误差作为反馈(Sec.2,pp.2–3)。这要求重要性特征能够及时识别关键 token;“当前不重要、未来突然重要”的情况依然是风险。
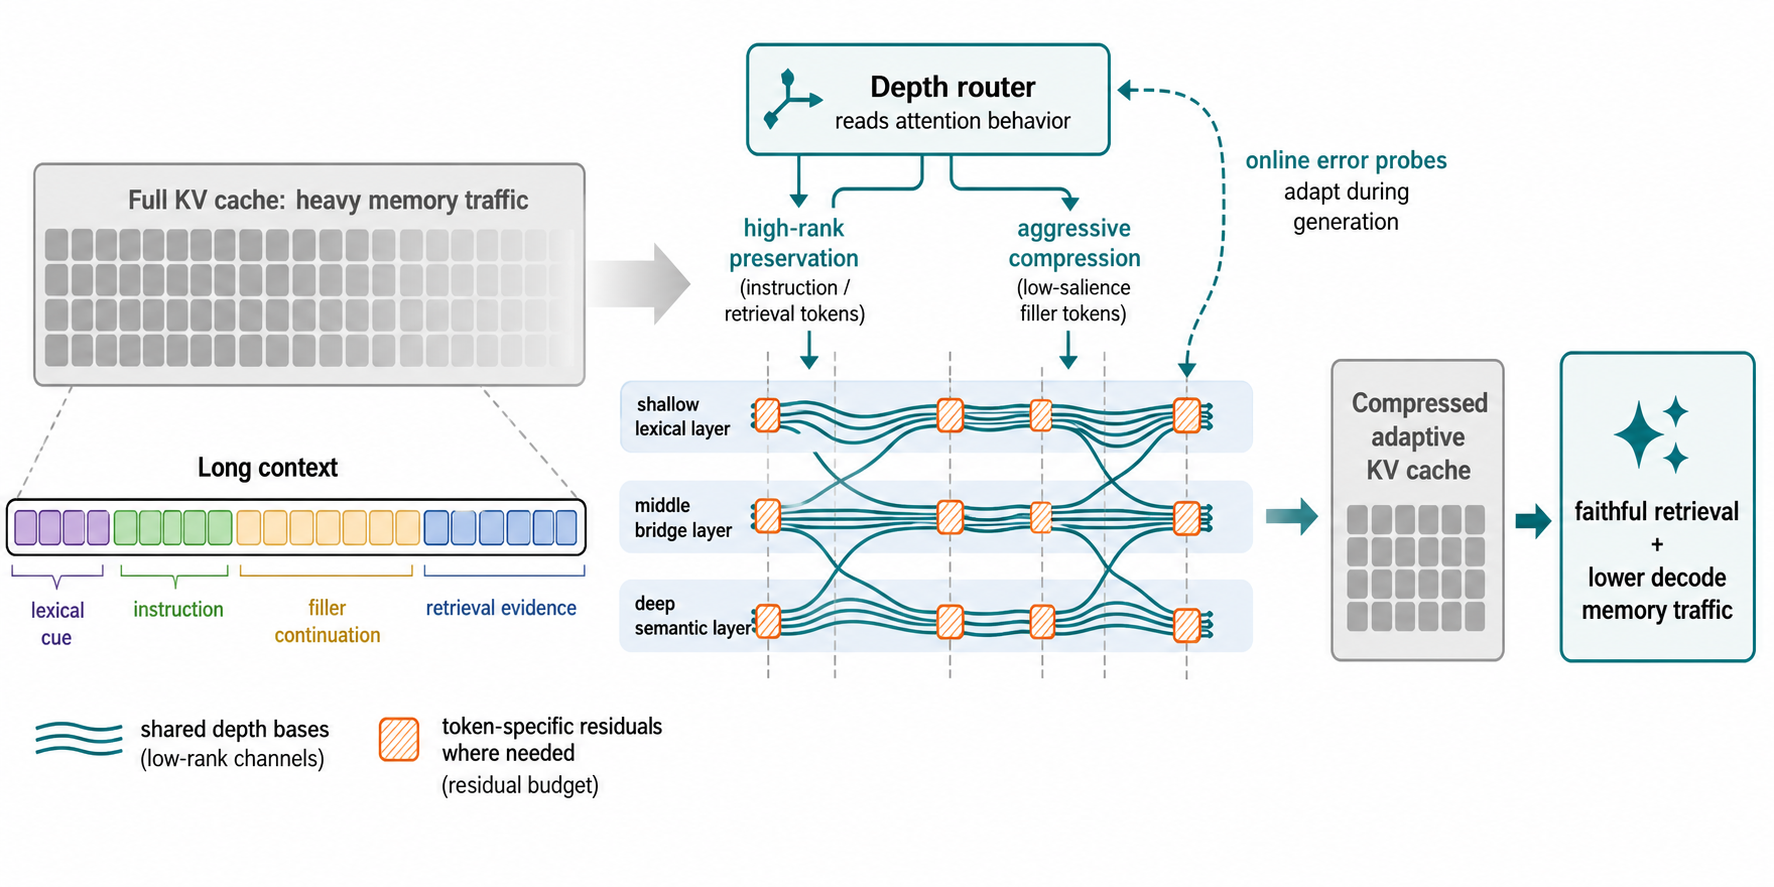
原 Fig.1,PDF p.2,作者原图。由左到右读:长上下文及原始缓存 → 青色共享基与橙色 token 残差 → 压缩缓存;上方路由器和虚线表示误差反馈。图中的浅层词法、中层桥接、深层语义是作者的概念示意,不是逐层测量曲线;图没有统计坐标轴,不能据此量化层间相关性。
二:方法
2.1 输入、表示与输出
输入是模型产生的各层、各头、各 token 的 K/V 向量及注意力统计;输出是压缩缓存以及解码时重建的注意力输入。模型权重保持冻结,但存在需要训练的辅助门控和路由器。
| 符号 | 含义/维度 |
|---|---|
| $\ell,h,t$ | 层、注意力头、token 位置 |
| $\mathcal W_m,w$ | 第 $m$ 个相邻层窗口及窗口大小;窗口可重叠 |
| $Z\in\{K,V\}$ | Key 或 Value,两者分别处理 |
| $d,r_b$ | 每头向量维度、共享基的秩 |
| $B^Z_{m,h}$ | 窗口与头共享的通道基,$r_b\times d$ |
| $A^Z_{\ell,h,t}$ | token/层局部系数,$1\times r_b$ |
| $R^Z_{\ell,h,t}$ | 残差重建向量,$1\times d$ |
| $g^Z_{\ell,h,t}$ | $[0,1]$ 范围内的残差门控 |
| $\rho_{m,h,t}$ | 路由决定的残差容量;原文称 residual rank |
原文 Eq.(1),PDF p.3:
$AB$ 将低维系数映射回 $d$ 维,表达邻层共享成分;$gR$ 补偿层和 token 特有的信息。$B$ 在窗口内跨 token、跨层共享,$A$ 和残差并非所有层共用同一向量,因此不能把该方法等同于直接复用邻层 KV。
定义尚不完整:$R$ 被写成 $1\times d$ 向量,却又称按“秩”存储少量残差通道。原文未给出从 $\rho$ 个数重建 $R$ 的残差基、索引或解码公式。不能据此自行补成完整的低秩分解实现;这里更稳妥地把 $\rho$ 理解为作者意图分配的残差容量。重叠窗口中的层归属/融合规则也未报告。
2.2 基的初始化与量化
作者在 prefill 后,从首个待压缩前缀块的 K/V 构造随机低秩 sketch;按窗口、头以及 K/V 分别初始化共享基。生成时使用指数移动平均更新基。原始 KV 投影得到 $A$,用 8-bit 分块量化存储;残差使用 4-bit 分组量化。$\rho=0$ 时仅保留共享基分量(Sec.3,p.3)。
直觉上,长序列使一次存储的 $B$ 被许多 token 摊薄,而系数维度小于完整 KV 维度。以下只是本次分析的存储项示意,不是论文推导或可重现 8.3× 的公式:
论文未报告 $w,r_b$、平均残差容量、基精度、量化组大小或峰值探针开销,所以不能只按“8-bit+4-bit”推算实际压缩率。还有一个实现问题:当 $B$ 更新后,历史 $A$ 如何保持与其对应?原文未说明重投影、基版本化或等价变换机制。
2.3 Token 条件深度路由
路由输入 $\phi_{m,h,t}$ 包含四类在线特征:累计注意力权重总量、最大注意力峰值、分隔符/指令边界标记、上次探针间隔的注意力输出重建误差。原 Eq.(2),p.3:
$u$ 是学得的参数,$\sigma$ 为 sigmoid,$\tau_m$ 是满足内存预算的自适应阈值。固定特征下,降低阈值会使更多 token 获得高残差容量;升高阈值则增加压缩。
公式是二档分配。正文称实际使用“三个 rank levels”,但又列出 continuation 为 0 或 2、结构 token 为 4、检索关键 span 为 8,共涉及四个数值。可能意指三类 token,但没有给出多档阈值和映射,不能默默把二档公式视作完整四档算法。
教学例子,非实验:假设文档只有一个实体编号是后续回答所需证据。让大多数过渡文字只保留 $AB$,而对编号附近的 token 额外保存残差,可以把容量集中到精确检索。这解释设计意图,但路由器没有答案标签,是否能及时识别该编号仍须验证。
2.4 注意力输出探针与闭环
每隔 $p$ 个解码步骤,选一小部分头和近期 query,分别使用压缩缓存和临时高保真缓存计算注意力输出。原 Eq.(3),p.4:
$Q$ 是采样 query,$\epsilon$ 防止分母接近零;误差无量纲,越低越好。它比较聚合后的输出,而不是直接比较所有 KV 元素,因此更贴近下一层实际接收的信号。超过窗口容差时降低 $\tau_m$;连续若干间隔低于容差时升高阈值。
关键缺口:被有损压缩的历史 KV 如何恢复成“更高保真”参照?提高残差档位时,先前丢失的通道从哪里补回?原文未说明高保真备份、重算或旁路保存机制,也未计量这部分的峰值内存与时间。式子使用无帽 K/V,文字则仅称 higher-fidelity,不能假定参照总是真正完整缓存。头级误差如何映射为 token 级路由特征也不明确。该误差不是任务正确性的理论保证。
2.5 冻结主模型不等于完全无需训练
Sec.3,p.4 明确说:残差 gates 和 router 在无标签长文本上,用冻结 teacher cache 目标训练一次。部署无需任务专用校准数据,基和阈值在线调整。因此应表述为“不重训基础 LLM,部署免任务专用校准”,而不能称“完全 training-free”。论文没有给出辅助训练目标的具体表达式、训练数据/规模、优化器、训练时长或跨模型迁移结果。
2.6 融合执行与完整数据流
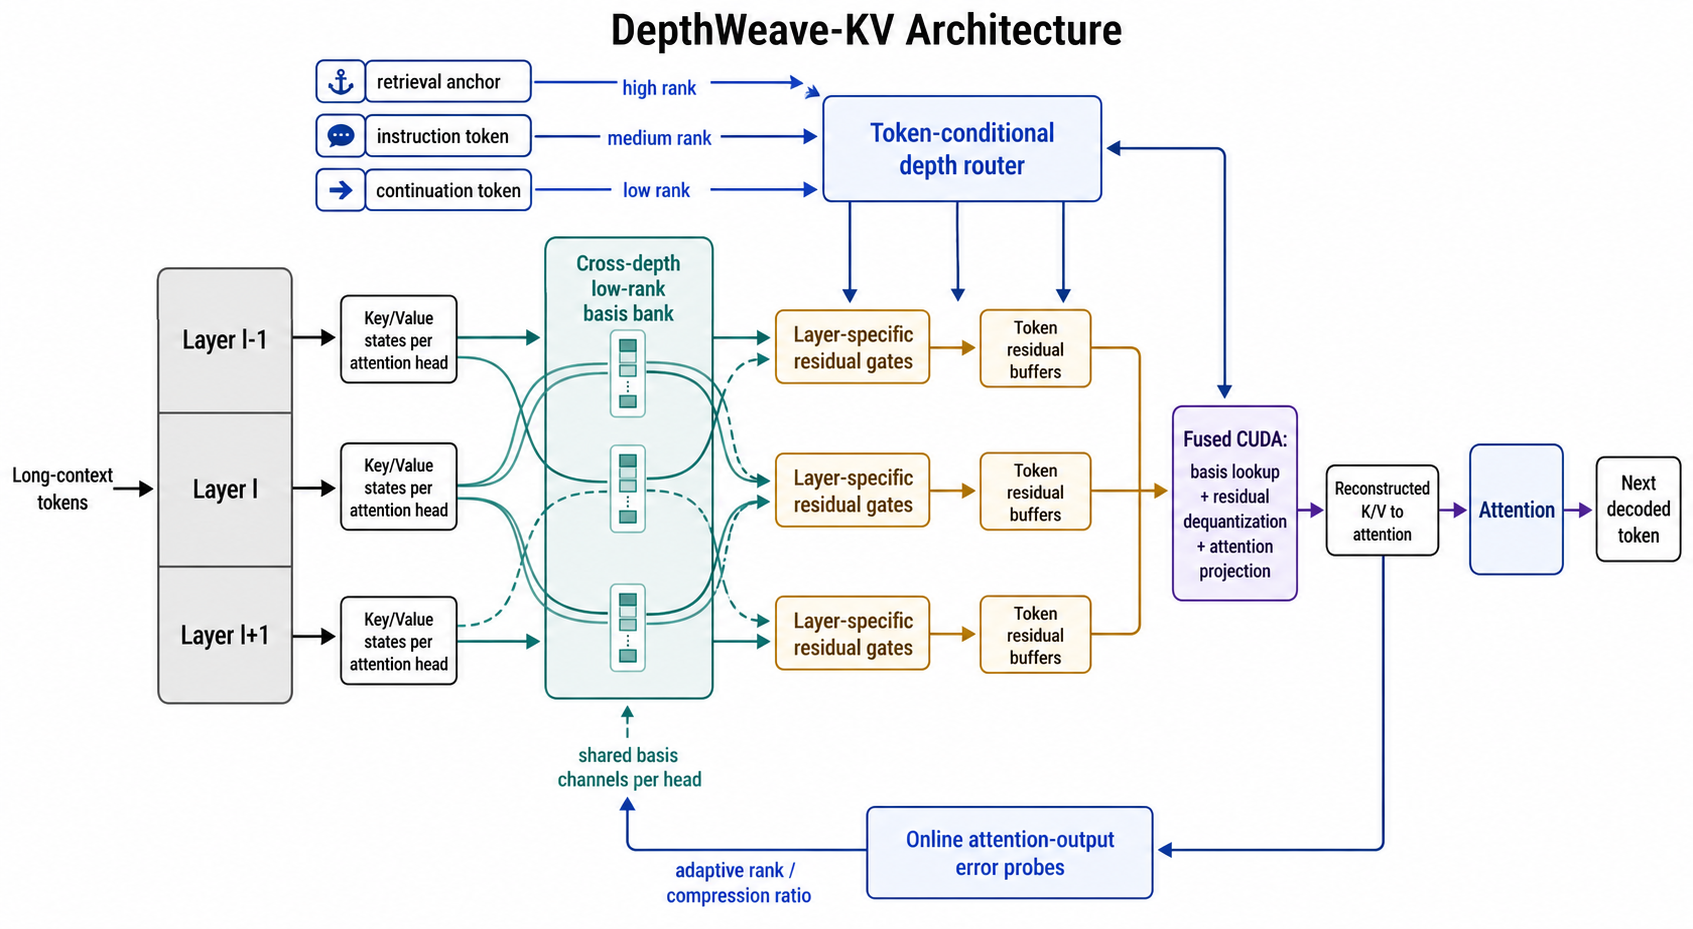
原 Fig.2,PDF p.4,作者原图。左侧邻层产生各头 K/V;中间共享基库配合 layer-specific gates 与 token residual buffers;上方路由控制残差;右侧融合 CUDA 把缓存片段送入注意力;下方探针提供反馈。无坐标轴,箭头表示概念数据流。图未给出线程块、内存布局或可运行内核。
prefill:计算原始 KV → 初始化窗口基 → 投影和量化系数 → 分配残差 → 保存统计。decode:加载共享基与系数 → 仅反量化所需残差 → 局部重建 KV → 立即参与注意力 → 周期性探针更新阈值。融合避免把完整重建 KV 再写回 GPU 全局内存(Sec.3,p.4)。这是额外重建算术换取较少读写的系统设计;若先用普通算子完整重建再调用 attention,不一定获得文中速度。
三:实验
3.1 实验问题与协议
作者要检验:压缩后的任务质量与检索是否保持;内存和速度是否改善;各模块是否对收益必要。
报告的默认条件是 64K token prefill、greedy decoding、生成 512 token;所有方法使用相同模型、tokenizer、prompt 和解码参数。压缩方法在至少 4× KV 缩减约束下选择较强任务分数,而不是在完全相同字节数下比较。原文没有给出基础模型名称/参数量、GPU 类型/数量、batch size、框架版本和具体 baseline 配置(Sec.4,p.4)。
| 指标 | 定义与方向 | 口径限制 |
|---|---|---|
| Avg. Score,% ↑ | 所评估任务子集的平均归一化分数 | 子集、归一化、加权及样本数未给出;不是统一分类准确率 |
| Needle Acc.,% ↑ | 精确检索准确率 | 设置写对 16K–128K、0%–100% 插入深度平均;主表标题写 64K,口径有歧义 |
| KV Mem. Red.,× ↑ | 完整 KV 内存 / 压缩 KV 内存 | 完整精度位宽及临时空间是否计入未报告 |
| Decode Thr.,token/s ↑ | 自回归解码吞吐 | 硬件、batch 和计时边界未知 |
| TTFT,s ↓ | 首 token 延迟 | prefill/探针/初始化计时拆分未知 |
| PPL Δ ↓ | 相对完整缓存的困惑度增量 | 原始 PPL、语料与长度分布未报告 |
| Recon. Err. ↓ | 注意力输出的相对重建误差 | 全局聚合方式与采样数未报告 |
任务涵盖 LongBench、L-Eval、NarrativeQA、Qasper、HotpotQA、MultiFieldQA-en、GovReport、QMSum、TriviaQA 和 Needle-in-a-Haystack。其中套件名称和具体任务可能重叠,不应把这份列表自动理解成互不重叠的十组独立测试。没有逐数据集完整结果、检索长度×深度热力图、误差条或多次运行方差。
四:结果
4.1 主结果:质量和 KV 内存
下表根据 body.tex 中 Table 1 重排;原表位于 PDF p.5 且越栏重叠。
| 方法 | 平均分 % ↑ | Needle % ↑ | KV 缩减 × ↑ |
|---|---|---|---|
| Full KV Cache | 63.8 | 98.7 | 1.0 |
| StreamingLLM | 55.4 | 79.6 | 5.8 |
| H2O | 57.1 | 83.8 | 5.4 |
| SnapKV | 58.3 | 86.5 | 5.7 |
| PyramidKV | 59.0 | 88.1 | 6.1 |
| MiniCache | 59.8 | 89.4 | 6.4 |
| KVSharer | 59.5 | 88.7 | 6.7 |
| ChunkKV | 60.7 | 91.2 | 6.0 |
| TailorKV | 61.4 | 92.6 | 6.5 |
| Eigen Attention | 60.2 | 90.1 | 6.2 |
| DepthWeave-KV | 62.9 | 96.1 | 8.3 |
按报告值,DepthWeave-KV 的平均分距 Full KV 低 0.9 个百分点,Needle 低 2.6 个百分点;比最高平均分的压缩基线 TailorKV 高 1.5 和 3.5 个百分点。8.3× 表示 KV 占原来的约 12.05%,减少约 87.95%(本次计算)。这些是有损缓存结果,不能表述成无损恢复。
这张表在作者选择的配置点上显示较好的质量—内存折中,但未展示统一预算下的整条 Pareto 曲线,也没有方差,因此不支持所有预算、模型和任务上都占优的结论。
4.2 系统指标、困惑度与误差
同一 Table 1,按 TeX 重排:
| 方法 | token/s ↑ | TTFT s ↓ | PPL Δ ↓ | 输出误差 ↓ |
|---|---|---|---|---|
| Full KV Cache | 42.1 | 6.84 | 0.00 | 0.000 |
| StreamingLLM | 58.7 | 5.91 | 0.42 | 0.091 |
| H2O | 56.9 | 5.98 | 0.36 | 0.083 |
| SnapKV | 60.4 | 5.73 | 0.31 | 0.075 |
| PyramidKV | 61.8 | 5.66 | 0.28 | 0.069 |
| MiniCache | 63.2 | 5.48 | 0.24 | 0.061 |
| KVSharer | 64.1 | 5.44 | 0.26 | 0.064 |
| ChunkKV | 62.6 | 5.52 | 0.21 | 0.055 |
| TailorKV | 65.0 | 5.36 | 0.18 | 0.049 |
| Eigen Attention | 63.7 | 5.41 | 0.23 | 0.058 |
| DepthWeave-KV | 72.8 | 4.89 | 0.09 | 0.027 |
本次算术核验:相对 Full KV,吞吐增加约 72.9%,TTFT 减少 1.95 s(28.5%);相对 TailorKV 吞吐增加 12.0%,相对 MiniCache 增加约 15.2%。原文说 PPL 增量 0.09 “less than half” of 0.18,但报告精度下恰好是一半,应改称“为其一半”。
作者将 TTFT 改善解释为缓存物化和准备阶段访存减少,然而未报告时间分解;不能从总 TTFT 直接归因。较低输出误差与较高质量相容,也不能单凭这张汇总表证明该误差是任务质量的可靠预测器。
4.3 任务族拆分
Sec.4,PDF p.5,仅给出文字聚合结果:
- 检索/抽取组含 Qasper、HotpotQA、MultiFieldQA-en、TriviaQA 与 Needle。DepthWeave-KV 比 Full KV 低 1.4 分;MiniCache 和 TailorKV 分别低 5.6、3.2 分。
- 摘要组含 GovReport、QMSum;DepthWeave-KV 比 TailorKV 高 0.8 分、比 ChunkKV 高 1.7 分。
作者解释:精确检索更依赖孤立关键 span,摘要更依赖广泛覆盖。这是机制解释,不是逐任务已证实的因果结论;缺少绝对分数、误差条和细分样本,不能判断收益集中在哪个数据集。
4.4 消融:主模块对质量的影响
以更系统的 Sec.5 / Table 2 作为本节统一口径,同时保留与 Sec.4 的冲突。各变体允许重新调阈值,预算并不完全相同。
| 变体 | 平均分 % | Needle % | KV × | 输出误差 |
|---|---|---|---|---|
| 完整方法 | 62.9 | 96.1 | 8.3 | 0.027 |
| 去跨层基共享 | 61.5 | 93.2 | 5.9 | 0.044 |
| 去 token 路由 | 61.2 | 92.4 | 7.9 | 0.041 |
| 去在线误差跟踪 | 61.7 | 93.5 | 8.5 | 0.038 |
| 去残差门控 | 61.0 | 91.8 | 8.4 | 0.046 |
| 仅共享基、无 token 残差 | 58.9 | 87.6 | 10.2 | 0.071 |
| 去融合 CUDA | 62.8 | 95.9 | 8.3 | 0.028 |
原 Table 2,PDF p.5;数值从同版 TeX 重排,解释见 pp.5–6。
共享基同时改善压缩和质量:去共享后压缩从 8.3× 降到 5.9×、Needle 低 2.9 个百分点。路由使残差分配更有针对性,去路由后 Needle 低 3.7 个百分点。去在线反馈后压缩稍强但 Needle 低 2.6 个百分点,符合用一点容量换质量的设计。去门控低 4.3 个百分点;完全去残差低 8.5 个百分点,说明仅有共享基不能维持同样检索表现。
原文称路由器是检索鲁棒性的最大贡献者,但在表 2 中,“去残差门控”和“无残差”的下降都更大。更准确的结论是路由是重要贡献之一,而非依据该表认定其单独贡献最大。由于阈值允许重调,消融体现整体配置的折中,不是严格固定存储预算的单因素因果估计。
4.5 消融:融合内核和反馈开销
| 变体 | token/s | TTFT s | PPL Δ |
|---|---|---|---|
| 完整方法 | 72.8 | 4.89 | 0.09 |
| 去跨层基共享 | 63.5 | 5.31 | 0.16 |
| 去 token 路由 | 70.1 | 4.96 | 0.15 |
| 去在线误差跟踪 | 73.4 | 4.84 | 0.13 |
| 去残差门控 | 72.1 | 4.91 | 0.18 |
| 仅共享基、无残差 | 76.4 | 4.62 | 0.31 |
| 去融合 CUDA | 61.9 | 5.58 | 0.09 |
去融合保持相近质量和相同 8.3× 压缩,但吞吐从 72.8 降到 61.9,即 降低约 15.0%;反过来“融合带来提升”应以 61.9 为分母,为 约 17.6%。TTFT 增加 0.69 s。不能把两个分母方向混用。
去探针仅快 0.6 token/s,但压缩率同时改变,因此这个差值不等于严格隔离的探针开销。仅共享基的 76.4 token/s 与 10.2× 说明完整方法不是所有消融中最快或最省内存的配置,它选择了较好的报告质量。原表粗体也不能替代数值比较。
4.6 原文不一致记录
| 问题 | 位置与内容 | 本次处理 |
|---|---|---|
| 无路由消融 | Sec.4 p.5:61.1/91.8;Table 2:61.2/92.4 | 保留冲突,主消融使用 Table 2,不平均两者 |
| 无探针消融 | Sec.4 p.5:Needle 进一步降到 89.9;Table 2:独立去 tracking 为 93.5 | 可能前者是累计消融,但原文没有清楚说明,不当成同一实验 |
| 直接层共享替代 | Sec.4:6.9×、误差 0.052;表 2 无此行 | 与“去跨层基共享”5.9×、0.044 分开,不能混用 |
| 路由档位 | Eq.(2) 二档;正文说三档,却列 0/2/4/8 | 多档实现未充分定义 |
| PPL 描述 | 0.09 被称小于 0.18 的一半 | 按数字应为恰好一半 |
| Needle 长度 | 设置对 16K–128K 平均,表题 64K | 数值保留,但不宣称是严格单一 64K 准确率 |
五:结论、边界与后续问题
5.1 能带走的设计启发
可借鉴的思想是把共享表示、token 级差异恢复和行为反馈组合起来,而不是只沿一个维度均匀压缩。式(1)给出概念表示,表 2 的报告结果与“残差保检索、融合换速度”的叙事相容;但证明方法有效所需的可复现实现和实验细节尚不充分。
5.2 复现需要先补齐什么
- 固定对象和测量口径:模型 checkpoint、KV head 数、硬件、batch、完整缓存位宽、峰值显存和统计方法;按同一绝对字节预算绘制质量—速度曲线。
- 实现表示与更新:$w,r_b$、窗口重叠、残差解码、量化尺度、基变化时历史系数处理,以及 RoPE 前后在哪个空间压缩;原文未报告这些细节。
- 证明反馈可执行:高保真参照来源、残差升档的信息恢复、探针间隔/采样/容差和最坏开销。
- 提供辅助训练与系统代码:训练目标、数据和超参数;融合内核及端到端计时,不只提供概念图。
- 更细的检索验证:长度×位置热力图、罕见实体/晚显重要性测试、任务级统计、多次运行与统一消融配置。
以上是本次分析建议,不是论文已完成的实验。
5.3 文档来源本身还需核验
PDF p.1 页脚保留 ICML 2024 会议模板,但 arXiv v1 日期为 2026;不能据模板称其为 ICML 2024 已录用论文。main.tex 的署名附近出现 “Fixed synthetic byline” 注释,且使用 \nocite{*},参考文献含海龟解剖等明显偏离主题条目(例如 PDF p.7)。这些是所获材料中可直接观察的异常,不足以单独证明研究造假或作者身份不实,但使独立核验实现、作者信息及实验来源更有必要。本次没有对全部外部引用逐篇验证,也没有发现所下载源码包中提供可运行 CUDA 实现;不据此声称互联网任何地方都没有代码。
5.4 作者的未来工作
Sec.7,p.6 提议学习非相邻层组或 head-specific sharing graph,改进面向罕见关键 token 的风险路由,并适配 batching、prefix reuse、prefill/decode 分离和多租户缓存池。这些均为展望,当前报告结果没有验证生产服务、多模型泛化或非相邻层共享。
最终判断:把该文作为“跨层低秩 + 自适应残差 + 注意力输出闭环”的设计材料较合适;8.3× 与 72.8 token/s 应带着模型/硬件未报告、统计口径及文档异常的限定引用,不能直接用于工程容量规划。