PartRep:学习哪些 token 值得重复
原题:PARTREP: Learning What to Repeat for Decoder-only LLMs
- 作者:Andikawati P Widjaja、Yongjun Kim、Hyounghun Kim、Jaeho Lee。
- 机构:Bandung Institute of Technology;Pohang University of Science and Technology。
- 原文版本:arXiv:2607.01792v1,2026-07-02 提交;获取与研读日期:2026-09-29。
- 来源:arXiv 版本页 · 原文 PDF · 作者 TeX · 源码清单。
- 配套:英文幻灯片 PDF · 可编辑 TeX。
阅读范围。 已阅读 main.tex 中实际生效的正文、附录 A–E,以及相关 main.bib 条目,并以同版本 15 页 PDF 核对公式、7 幅图与 7 张表。图件取自作者源码;没有执行作者源码或复现实验。以下页码均为 PDF 从 1 开始的页码,与论文印刷页码一致。“原文结果”“作者解释”“本次分析”分开表述。
论文总览
PartRep 研究的是:保留完整原始输入后,追加哪些少量 token,能以较小的增量成本获得接近“再读一遍”的收益? 这与压缩原始输入或删除已有 KV 缓存不同。
方法分两步。离线用目标语言模型计算每个 token 的负对数似然(negative log-likelihood,NLL),以每个样本中 NLL 最高的一部分 token 作为标签,训练一个很小的门控网络。推理时,门控读取原始输入的中间层隐藏状态,选出少量 token,按原顺序接到输入末尾,再完成预填充与生成。原始模型参数保持冻结。
最有直接证据支持的结论来自 Qwen2.5-3B 的七项任务:不重复、完整重复、PartRep 的报告平均准确率依次为 66.9%、68.5%、68.3%;PartRep 的平均缓存 token 数为 280.4,完整重复为 471.1,对应预填充开销为 2.481 T 与 3.140 T FLOPs。这支持“用较低成本接近完整重复的平均效果”,不能解读为每个任务都胜过完整重复。(表 1,p.6)
两个重要限定:
- 节省以完整重复为参照。 PartRep 相对不重复仍增加约 19.1% 的缓存 token 数和 60.2% 的报告预填充 FLOPs;它不是把原始输入的缓存压到更小。
- 长上下文采用另一组设置。 RULER 使用 $\tau=0.3$ 加局部窗口扩展,主表使用 $\tau=0.15$。不能把主表的成本比直接搬到 RULER 上。(表 1、3,pp.6–7)
结构地图
| 原文章节 | 作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 因果注意力的信息不对称,以及重复提示的成本 | pp.1–2;图 1 |
| 2 Related work | 与 prompt repetition、KV eviction、摘要方法的关系 | pp.2–3 |
| 3 Problem formulation;3.1 Comparison with KV cache eviction | 保序子序列选择问题与预算约束 | pp.3–4;式 (1)–(5) |
| 4.1 Token importance scoring | NLL 标签与信息量解释 | pp.4–5;式 (6)–(8) |
| 4.2 Gating mechanism | 中间层特征、MLP 与可学习键值 | p.5;式 (9)–(11) |
| 4.3 Training the gating module | 数据构造、类别加权损失 | pp.5–6;式 (12)–(15) |
| 4.4 Inference | 连接提示、缓存复用、窗口扩展 | p.6;流程图 2 位于 p.4 |
| 5.1–5.2 Experimental setup / Main results | 七项任务、全部基线和成本 | pp.6–7;表 1 |
| 5.3 Other LLM architectures | 三个模型上的 MMLU | p.7;表 2 |
| 5.4 Long-context tasks | 4k、8k、16k RULER | pp.7–8;表 3 |
| 6.1 Ablation studies;6.2 Efficiency comparison | 门控、窗口消融与长度扩展 | p.8;表 4–5、图 3 |
| 7 Conclusion;Limitations | 总结与作者承认的限制 | pp.8–9 |
| References | 引用目录;本次未逐篇阅读被引论文 | pp.9–10 |
| A Implementation Details | 训练和解码设置 | p.11 |
| B.1–B.5 Additional Ablations | 打分、层位置、预算、连接词、键数量 | pp.11–13;图 4–7、表 6–7 |
| C.1–C.8 Qualitative results | 八种策略最终输入的具体形态 | pp.13–14 |
| D Resources;E Artifact Licenses and Intended Use | 硬件与所用材料的许可声明 | pp.14–15 |
一:动机——为早出现的信息提供一次“晚出现”的表示
1.1 为什么原样重复可能有用
在因果注意力中,第 $i$ 个位置只能读取它前面的内容。对于输入 $\mathbf t=(t_1,\ldots,t_L)$,较早的 token 表示缺少后续上下文。把完整输入再接一遍之后,第二份中的对应 token 就能够读取第一份的全部内容。
这里改善的是同一内容在更靠后的位置被重新表示的机会。注意力掩码本身仍然是因果的,第一份输入的早期表示也不会被事后改成双向表示。作者用这种信息路径解释重复收益,但没有通过独立机制干预证明每项提升都由它造成。(§1,pp.1–2;§3,p.3)
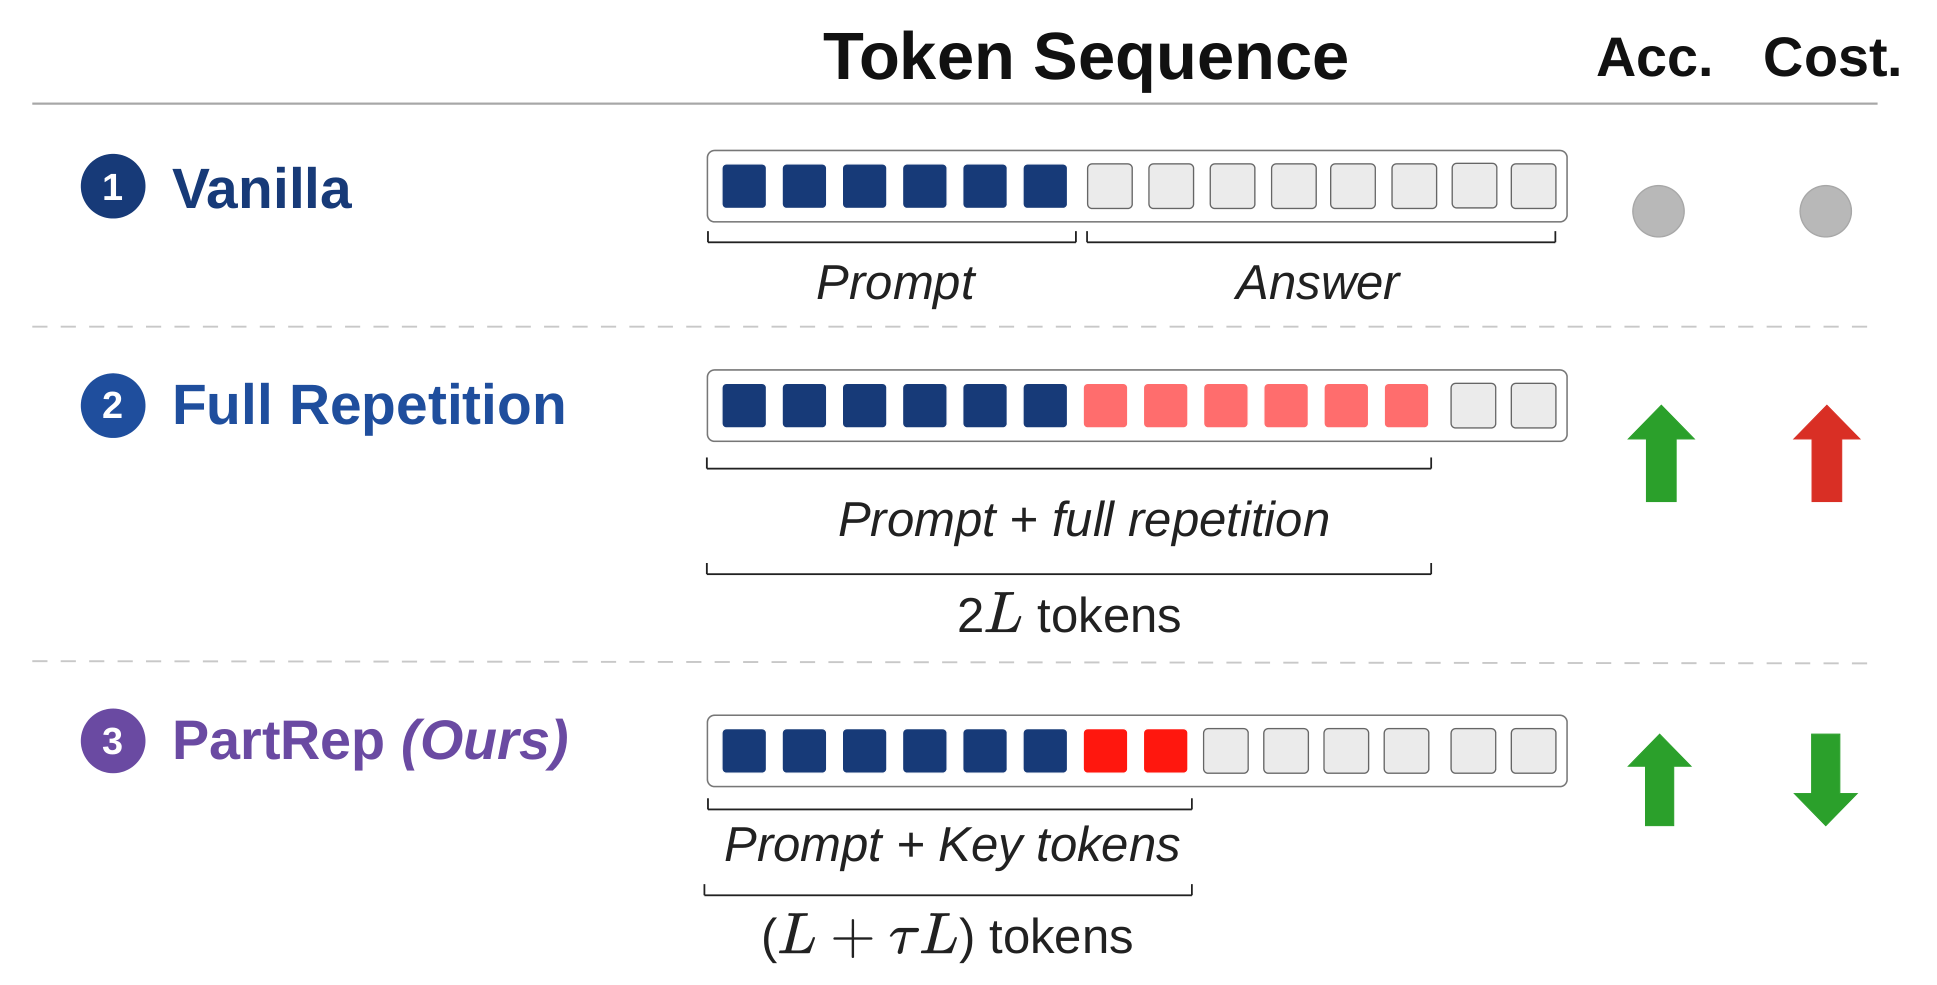
来源:原图 1,p.1。蓝色为原始输入、红色为追加内容。图中的准确率与成本箭头是概念示意,不是所有任务上的实测保证;实际表格存在完整重复使准确率下降的任务。
1.2 PartRep 与相邻方法的区别
| 策略 | 处理对象 | 主要问题 |
|---|---|---|
| 完整重复 | 将原始输入再追加一次 | 所有 token 都承担重复成本 |
| KV 缓存淘汰 | 预填充后保留哪些 KV | 删除什么才不明显损伤后续生成 |
| 输入压缩 | 在模型读取前缩短原文 | 如何用更少输入保存原始信息 |
| PartRep | 保留原文,再追加选中 token | 哪些内容被重新表示最有边际价值 |
先完整重复再淘汰 KV,虽然可减少后续缓存,但已经支付了较长输入的预填充成本。作者还用最后一个 token 举例:它已有完整前文,从“增加可见上下文”的角度看重复收益较小,但它的 KV 对后续生成仍可能很重要。这个例子说明两类选择目标不同,并不构成“末尾 token 在任意任务都不值得重复”的定理。(§2–3.1,pp.2–4)
二:方法——高 NLL 标签、小门控与选择性追加
2.1 问题与符号
作者要求选择器 $f$ 输出一个保序子序列,而不是任意重写的摘要:
来源:式 (2)–(5),p.3。这里的 $\subset$ 表示子序列关系,不能把重复出现的同一个词合并成一个集合元素。$\tau$ 是选择比例,主结果为 0.15;真实输入还要包括连接提示与可能的窗口扩展。
| 符号 | 含义与维度 |
|---|---|
| $L,\tau$ | 原始输入长度、选中 token 比例 |
| $l^\star$ | 提取隐藏状态的层;Qwen 消融选用第 18 层 |
| $\mathbf h_i\in\mathbb R^d$ | 原始输入位置 $i$ 在 $l^\star$ 层的表示 |
| $d_h=64$ | 门控查询向量的维度 |
| $s=64$ | 默认可学习键的个数,与 $d_h$ 是不同超参数 |
| $K\in\mathbb R^{s\times d_h},\mathbf v\in\mathbb R^s$ | 门控内部的可学习键与标量值 |
| $\eta_\tau$ | 每个样本用于保留最高 $\tau$ 比例 NLL 的阈值 |
| $p_i=g(\mathbf h_i)$ | 本笔记对门控输出概率的记号 |
2.2 NLL 是监督信号,不是重复价值的直接测量
来源:式 (6),p.4。概率由目标 LLM 给出。NLL 越大,该 token 在之前的上下文中越难预测;作者据此假设,它携带了值得在末尾重新强调的信息。
式 (7) 按 NLL 阈值选择 token。实现含义是“按分数取前 $\tau L$ 个,再恢复原始位置顺序”。若采用通常的累计分布分位数定义,保留上尾 $\tau$ 比例对应约 $1-\tau$ 分位点;原文将 $\eta_\tau$ 称为 $\tau$-quantile,文字有歧义。本笔记依据明确的 top-$\tau$ 预算解释,取整及并列分数处理没有在论文中说明。
本次分析: 高 NLL 衡量的是目标模型的惊讶程度,不直接等于对当前问题的因果贡献。罕见、拼写异常或与答案无关的 token 也可能高 NLL。另一方面,这个量使用 $t_{ 作者还提出: 来源:式 (8),pp.4–5。p.5 脚注明确承认,这不是通常随机变量意义上的条件熵,因为确定性函数满足 $H(f(X)\mid X)=0$。较稳妥的理解是模型条件下的“信息量/难预测性”动机。论文没有给出 NLL top-$\tau$ 对准确率目标的最优性证明、近似比或性能界。 来源:原图 2,p.4。阅读顺序为原始输入预填充至中间层 → 门控打分 → 选择并追加 → 完成预填充。 精确 NLL 需要得到原始输入的最终词表概率。作者离线支付这个成本,在线用小网络近似“哪些 token 属于最高 NLL 的一组”。它不是在线再次运行一个完整大模型,也不是以 NLL 回归误差为最终训练目标。 对每个隐藏状态,门控先计算查询: 再用查询读取 $s$ 个可学习的键和值: 来源:式 (9)–(11),p.5;$s=64$ 的选择见表 7,p.13。查询与键的乘法沿用原文行向量记法;若全用列向量,应等价写为 $K\mathbf q$。Softmax 对 $s$ 个键归一化,最终得到一个标量概率。 门控里的 attention 是对可学习原型的读取,不是对输入所有 token 再做一次 $L\times L$ 自注意力。 跨 token 的上下文已由主模型隐藏状态提供。忽略偏置,门控参数量按这些式子为 对全部 $L$ 个位置的打分总成本随 $L$ 线性增长;这是依据结构的推导,不是原文报告的额外参数总数。论文没有单独报告在线 top-k 排序及其系统开销。 原文对 $f$ 同时使用“子序列选择器”和“分数向量”的记号。为避免混淆,可把完整选择器理解为:隐藏状态提取 → $g$ 输出每个位置的分数 → top-k → 按位置排序 → 抽取 token。 先保存隐藏状态和连续 NLL: 然后对指定 $\tau$,把每条序列中 NLL 最高的 token 标为 1,其余标为 0。保存连续 NLL 的好处是可以为不同预算重新生成标签;这不等于论文证明了同一个训练好的门控对所有预算都无需调整。 来源:式 (12)–(15),pp.5–6。当 $\tau=0.15$ 时,正例权重约 5.67,用于补偿正例较少的问题。主模型冻结,只训练门控。 来源:§4.3,p.5;附录 A.1,p.11。原文没有明确验证集划分、4096 的批单位、训练随机种子、逐模型门控训练耗时,也没有报告门控与 NLL 标签的 precision/recall。门控需要针对每个目标 LLM 单独训练。 按原文可以整理成以下流程;这是教学伪代码,不是作者发布的实现: 默认连接提示为 “Pay attention to these key tokens:”,前后带换行。(§4.4,p.6;表 6,p.11) 为什么已有前缀可以复用? 在因果掩码及原位置不变时,追加后缀不会改变前缀在各层的计算结果。实际实现还需管理相应层的 KV 和中间状态,并让新追加位置经过所需层。论文声称复用原始隐藏层特征,但没有给出足以复现的跨层缓存调度代码或成本分解。因此不宜将流程口头简化成“两次完整前向”,也不宜认为一个小门控就代表全部额外开销。 窗口扩展解决两个问题:tokenizer 可能把一个词拆开;孤立关键词可能丢掉局部关系。可以把选中片段扩展为完整词,或加入左右邻词。扩展后应重新计数:最终追加长度可能超过 $\tau L$。论文未明确所有设置的去重、重分词、预算回截规则;RULER 的具体窗口宽度也没有报告。 教学例子。 若一个问题同时出现“甲比乙早到”和“乙比丙早到”,只重复人名未必能保留排序关系;连同相邻关系词重复可能更有帮助。这说明选择 token 的信息量与保留局部组合结构是两个互补问题,例子不来自论文实验。 忽略连接提示、窗口扩展和选择器成本,§3 给出: 这里 $M$ 是同一模型、同一缓存精度下与 token 数成正比的 KV 存储,$F_{\rm attn}$ 指随长度二次增长的注意力部分。对 $\tau=0.15$,这两个理想比例分别是 57.5% 和 33.1%;后者不是论文实测/估算的总预填充 FLOPs 比。 若选中 $m$ 个 token,窗口扩展额外增加 $w$ 个,连接与格式提示增加 $c$ 个,则真实长度为 $N=L+m+w+c$。教学上可把完整预填充写成 其中线性项含投影和 FFN 等计算,二次项是注意力,$C_{\rm selection}$ 还取决于实际调度与复用。常数仅用于解释,不是作者提供的成本公式。完整重复把长度翻倍,不代表总 FLOPs 一定变成四倍;表 1 中其总 FLOPs 约为不重复的 2.03 倍。 来源:§5.1–6.1,pp.6–8;附录 B,p.11。作者总共覆盖三个模型家族、八个 benchmark,不是三个模型都跑完八项任务。Gemma 的取特征位置限制在全局注意力层;其具体层号未报告,不能照搬 Qwen 的第 18 层设置。 作者称前七项使用完整测试集;RULER 每个子任务抽 100 道,共 1300 道。没有列出 RULER 每个子任务的得分或各长度的生成种子,也没有统一给出各基准完整提示模板、few-shot 数量、答案抽取规则与采样细节。 来源:§5.1,pp.6–7;附录 C,pp.13–14。两个 LLMLingua 版本不能混为一谈:一个保留原文并追加摘要,一个让目标模型只看到压缩输入。附录 E 指出所用压缩模型为 llmlingua-2-xlm-roberta-large-meetingbank。 这些对照接近预算匹配,但并非全部严格等缓存,例如表 1 中 PartRep 为 280.4 token、H2O 为 270.8、两种追加摘要为 277.4。因此表格给出的是多个工作点的比较,而非严格相同缓存与算力下的完整 Pareto 曲线。 来源:§5.1,p.7;附录 A.2,p.11;D,p.14。没有多随机种子误差条、置信区间或显著性检验。图 5 有层位置与延迟的局部消融,但不构成所有方法的端到端延迟对比;主表 FLOPs 节省也不能直接换算为相同百分比的提速。 下表从表 1(p.6)重排,所有平均分沿用作者报告值。 PartRep 比不重复提高 1.4 个百分点,比完整重复低 0.2 个百分点。用已四舍五入的平均分计算,它保留了完整重复相对不重复增益的约 $(68.3-66.9)/(68.5-66.9)=87.5\%$;这是本次派生量,不是独立统计结果,也不能当成跨任务不变的比例。 与追加 LLMLingua 摘要相比,PartRep 平均准确率高 0.9 个百分点,但 FLOPs 也更高;不能说它在质量与计算上同时支配所有摘要方法。自生成摘要虽然平均分达到 67.9,其摘要生成开销使总 FLOPs 高于完整重复。 LLMLingua Comp. 的 14.9 表明本文特定的压缩和提示设置非常差。附录样例确有片段化内容,但没有充分诊断答案格式、压缩率、tokenizer 等各因素,不能据此否定 LLMLingua 或输入压缩方法的一般有效性。 来源:表 1,p.6;pp 指百分点。按报告精度,PartRep 在六项高于不重复,MMLU-Pro 持平;与完整重复相比,仅 MMLU 和 MMLU-Pro 更高,其余五项更低。完整重复在 MMLU 上下降 2.2 个百分点,在 MMLU-Pro 上下降 0.5 个百分点,因此“重复总能提高质量”不符合这张表。 作者解释: 选择性追加可能避免冗长上下文的不利影响。本次分析: 结果与这种解释相容,但作者没有隔离长度、连接提示和 token 内容三个因素;不能从该表直接证明改善来自缓解 lost-in-the-middle。 由表 1 的显示值重算: 因此相对完整重复,缓存 token 数约减少 40.5%,报告总预填充 FLOPs 约减少 21.0%。原文摘要与结论称“使用 59.4% 的 KV、79.0% 的 FLOPs”;KV 比例与表格重算的约 59.5% 有小差异,原文没有解释。笔记保留原表并明确区分作者表述与重算。 相对不重复则是: 这两组参照不能互换。表 1 是 Qwen2.5-3B 七项任务的结果,不能把这两个汇总比例视作三种模型或所有长度均成立的定律。 来源:§5.3、表 2,p.7。PartRep 在三种模型上都高于不重复,但 Llama 上低于完整重复,Gemma 上低于追加 LLMLingua 摘要;0.2 个百分点的单次差值尤其不应包装成稳健优势。这里也没有门控跨模型零样本迁移实验,每个模型需要自己的训练。 来源:§5.4、表 3,p.7。模型为 Qwen2.5-3B。PartRep 相对不重复分别提高 2.3、3.8、0.9 个百分点,表明这种设置在测试的长上下文任务上仍有效。 三个边界: 门控结构:Qwen2.5-3B,ARC-Challenge。 来源:表 4,p.8。两层 MLP 的报告准确率最高,成本低于更复杂的 Transformer 配置。它并非绝对最省算力,Linear 更便宜;81.4 与 81.3 的差距没有统计检验。正文完整门控还含可学习键值的注意力,不能把表中简称误读成纯 MLP。Gate FLOPs 的逐 token/逐请求归一化口径未明确,不与主表的 T FLOPs 直接相除。 窗口扩展:Llama3.2-3B,ARC-Challenge。 来源:表 5,p.8。最后一项相对不扩展提高 4.5 个百分点,KV 增加约 22.3%。这说明局部语义完整性可以相当重要,也说明质量收益的一部分要用更多追加内容来换,不能只报准确率变化。 B.1 打分信号。 下图横轴是重复比例,纵轴是 ARC 准确率;蓝线为最高 NLL,橙线为最低 NLL,绿线为随机选择,红线为 attention,紫线为 TF–IDF;两条虚线分别是不重复和完整重复。 来源:原图 4,p.11,Qwen2.5-3B。高 NLL 总体优于低 NLL 与随机选择,支持“选择的内容确实重要”。但在 15% 和 90% 附近,attention 曲线高于最高 NLL;90% 时 TF–IDF 也高于它。因此正文“始终匹配或超过”的表述强于图中证据。这里比较的是选择信号,不能把其最高 NLL 曲线直接当成已训练门控的主结果;图 4 在 15% 处约 82.3%,而表 1 的 PartRep 为 81.4%,原文没有完整分解两者差距。 B.2 取特征层。 横轴为层号,左轴蓝线为准确率,右轴红线为延迟(毫秒)。 来源:原图 5,p.12。第 18 层和第 30 层准确率均约 81.4%,但 18 层延迟较低;因此作者选 18 层。曲线并不是越深越准,也没有证明此层号可泛化到其他架构。延迟图没有完整说明 batch、计时范围及对照方法,只支持该局部设置下随提取深度增加的成本趋势。 B.3 重复预算。 来源:原图 6,p.12。横轴为 $\tau$(百分比),左轴为准确率,右轴标注 KV cache(tokens)。图示准确率在 15% 时约 81.4%,60% 时约 80.4%,90% 时约 81.3%,呈非单调变化。作者猜测大预算使“关键 token”这个连接提示的含义变弱;这是解释假设,没有单独验证。 右轴从约 64 增至 69 token,但图注未交代这一数值如何与输入长度、连接词、重分词或主表缓存口径对应。不能仅凭这条轴复现缓存公式,也不能断言增大 $\tau$ 的代价仅为 5 token。 B.4 连接提示。 这项消融十分关键,因为 PartRep 的收益来自“选哪些内容”和“如何提示模型使用它们”共同作用。 来源:图 7 标注值,p.12;模板见表 6,p.11。默认提示优于直接拼接 2.0 个百分点。结构标签较差可能涉及模型对模板或特殊 token 的解释,但论文没有隔离原因,不能推广成“任何 XML/ChatML 提示都差”。这些结果也不支持“随便追加高 NLL token 就够了”。 B.5 可学习键数。 来源:表 7,p.13。64 是本组消融的较好工作点;增加原型容量并不带来单调收益,没有足够证据把它称为跨任务最优值。 来源:原图 3,p.8。两面板横轴均为 4k–16k 的 prompt length;上图纵轴是保存的 KV token 数,下图是 FLOPs(P,$10^{15}$)。完整重复的缓存曲线接近 $2L$;PartRep 低于它,但高于不重复。Echo/H2O 的 FLOPs 曲线接近完整重复,因为先处理了长输入;仅压缩输入的 LLMLingua Comp. 成本低,但须结合其质量损失看待。 §6.2 对 PartRep 缓存增长“越来越可忽略”的文字不应按渐近结论理解:固定 $\tau$ 时仍是 $O(L)$,密集预填充注意力仍是 $O(L^2)$,改进是常数系数。图中较低的系数不代表渐近增长消失,也不是端到端加速测量。 附录 C(pp.13–14)用一道关于农场、猛禽与鼠类数量变化的 ARC 题目展示八种输入形态。PartRep 保留原题,追加若干实体、动作与选项片段,并在末尾保留回答格式要求;输出的关键词串并不是流畅摘要。模型摘要和 LLMLingua 摘要可能遗漏原题的一些关系,而 Echo/H2O 的红字展示被丢弃的 KV 对应位置。 这些样例有助于理解为何保留原文、窗口扩展及最终回答格式都重要,但没有给各方法在这道题上的成对生成结果或错误归因。它们不是独立的定性成功率评估,也不能单凭一个样例判定某条被选 token 必然提高正确率。 PartRep 将“值得再次表示的信息”变成一个可训练的输入侧选择问题。 它用目标模型自己的 NLL 生成弱监督,再让一个小门控从中间层特征预测选择标签,避免在线完整计算词表分布。本文最扎实的贡献是这个流程及其经验性的质量—成本折中。 结果支持:在所测小型指令模型与指定任务上,少量重复可接近完整重复的平均收益;局部窗口和连接提示对效果有实际影响。它没有证明每个 token 的 NLL 是重复收益的因果估计,没有消除自注意力的二次复杂度,也没有展示对所有模型/任务统一最优的配置。 来源:Limitations,p.9。 附录 B 的多个超参数都在 ARC-Challenge 上展示,但未明确是否使用独立开发集调参;宜避免将该基准上的最佳配置看作无偏泛化估计。原始源码包包含论文 TeX 与图件,不包含推理/训练实现;本次没有据此声称作者在其他位置未公开代码。 这些问题不抹去表格中观察到的平均收益,但影响复现、理论表述和部署预期。 以下为本次分析提出的实验,并非论文已完成内容: 英文幻灯片围绕“为什么重复 → 选择与训练 → 主结果 → 长上下文 → 消融与边界”组织,主讲约 20–30 分钟,其余细节在备份页。构建方式: 图件来源和裁切坐标见 figures/provenance.json。所有原图只做格式转换或保留完整坐标、图例的面板裁切;没有生成式重绘实验结果。幻灯片中重排的结果表均注明原表号,所有派生比例均由本文显示值计算。2.3 门控把精确 NLL 的代价移到离线
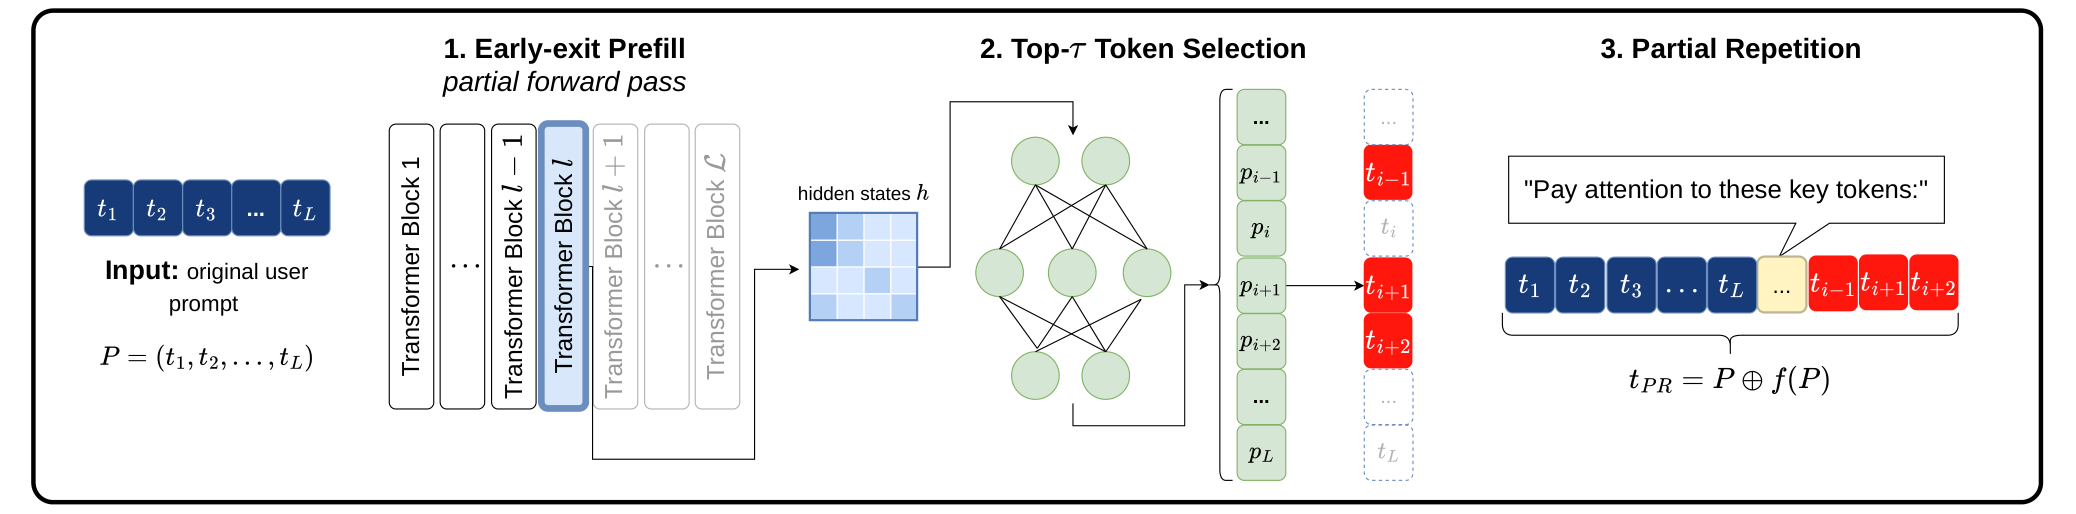
2.4 训练数据与损失
项目 原文报告 数据 FineWeb-Edu 200 万 token + Ultra-FineWeb-Edu 100 万 token 训练片段长度 10–1024 token 优化器 Adam;学习率 $10^{-3}$ 训练轮数与批大小 25 epochs;batch size 4096 调度与早停 CosineAnnealingLR;验证损失早停,patience 5 2.5 推理、复用和窗口扩展
输入:原始 token 序列 t、比例 τ、已训练门控 g
1. 将 t 预填充至 l*,保存可复用的前缀状态。
2. 计算每个位置的分数 p_i = g(h_i)。
3. 选择 top-k 位置,k 约为 τL;按原位置排序。
4. 可选:将所选位置扩展到完整词或局部词窗口,合并重叠。
5. 在原文后追加连接提示与选中内容。
6. 复用原始前缀的已有计算,完成扩展输入的预填充与生成。2.6 成本公式的适用范围
三:实验——实际比较了什么
3.1 任务与模型覆盖
实验 模型 数据与主要设置 检验问题 主结果 Qwen2.5-3B Instruct ARC-Challenge、OpenBookQA、MMLU、MedQA、SciQ、MMLU-Pro、GSM8K;$\tau=0.15$ 能否接近完整重复的质量与成本折中 跨架构 上述 Qwen、Llama3.2-3B Instruct、Gemma4-E4B it MMLU 收益是否局限于一个模型 长上下文 Qwen2.5-3B RULER,4k/8k/16k;$\tau=0.3$,局部窗口扩展 选择性重复在长输入下是否仍有用 门控结构、附录 B 消融 Qwen2.5-3B ARC-Challenge 各设计选择对准确率/成本的影响 窗口消融 Llama3.2-3B ARC-Challenge 完整词与邻词能否修复片段化 3.2 七个基线的比较角色
基线 操作与要检验的替代思路 No Repetition 原文直接生成,衡量追加内容是否值得 + Naïve Summary 原文后追加由目标模型生成的短摘要;同时计入摘要开销 + LLMLingua 原文后追加压缩所得短文本;原始输入仍保留 Full Repetition 追加整份原文,作为重复质量参照 + Echo Eviction 完整重复后移除第一份对应的 KV,只保留第二份 + H2O Eviction 完整重复后按 heavy-hitter 策略淘汰 KV + LLMLingua Comp. 压缩已完整重复的输入,仅把压缩结果交给目标模型 3.3 指标和运行协议
四:结果——质量收益、成本与消融分别说明了什么
4.1 主结果:平均质量接近完整重复
方法 Avg accuracy ↑ KV token ↓ Prefill FLOPs ↓ 不重复 66.9 235.5 1.549 T 追加模型摘要 67.9 277.4 3.676 T 追加 LLMLingua 摘要 67.4 277.4 2.105 T 完整重复 68.5 471.1 3.140 T 完整重复 + Echo 淘汰 64.4 235.5 3.152 T 完整重复 + H2O 淘汰 62.9 270.8 3.162 T LLMLingua 压缩重复输入 14.9 78.6 1.130 T PartRep,$\tau=0.15$ 68.3 280.4 2.481 T 4.2 逐任务分数显示哪些收益被平均值遮住
Benchmark 不重复 完整重复 PartRep PartRep − 不重复 ARC-Challenge 79.8 82.8 81.4 +1.6 pp OpenBookQA 76.6 78.0 77.8 +1.2 pp MMLU 62.5 60.3 63.2 +0.7 pp MedQA 47.5 51.0 50.3 +2.8 pp SciQ 90.3 92.9 92.2 +1.9 pp MMLU-Pro 27.8 27.3 27.8 0.0 pp GSM8K 84.2 87.3 85.5 +1.3 pp 4.3 摘要中的 59.4% 与 79.0% 应怎样读
4.4 跨模型:MMLU 有一致方向的小幅收益,但非全部最优
方法 Qwen2.5-3B Llama3.2-3B Gemma4-E4B 不重复 62.5 54.1 74.0 完整重复 60.3 54.8 72.9 追加 LLMLingua 摘要 61.0 53.5 76.1 PartRep 63.2 54.3 75.8 PartRep − 不重复 +0.7 pp +0.2 pp +1.8 pp 4.5 RULER:更大预算和局部上下文下优于完整重复
方法 4k 8k 16k 不重复 77.7 80.0 72.3 完整重复 79.2 82.3 72.3 LLMLingua(表 3 标注) 69.2 73.1 63.5 PartRep:$\tau=0.3$ + 局部窗口 80.0 83.8 73.2 PartRep − 完整重复 +0.8 pp +1.5 pp +0.9 pp 4.6 门控结构与窗口消融
结构 Accuracy(%) Gate FLOPs(原表口径) 无重复 79.8 0 k Linear 80.7 270.6 k 两层 MLP 配置(本文) 81.4 549.0 k Transformer-based 81.3 654.3 k 扩展方式 Accuracy(%) KV token 不扩展 61.5 90.1 扩到一个完整词 64.6 94.5 完整词再加左、右各一词 66.0 110.2 4.7 附录 B:五项选择依据
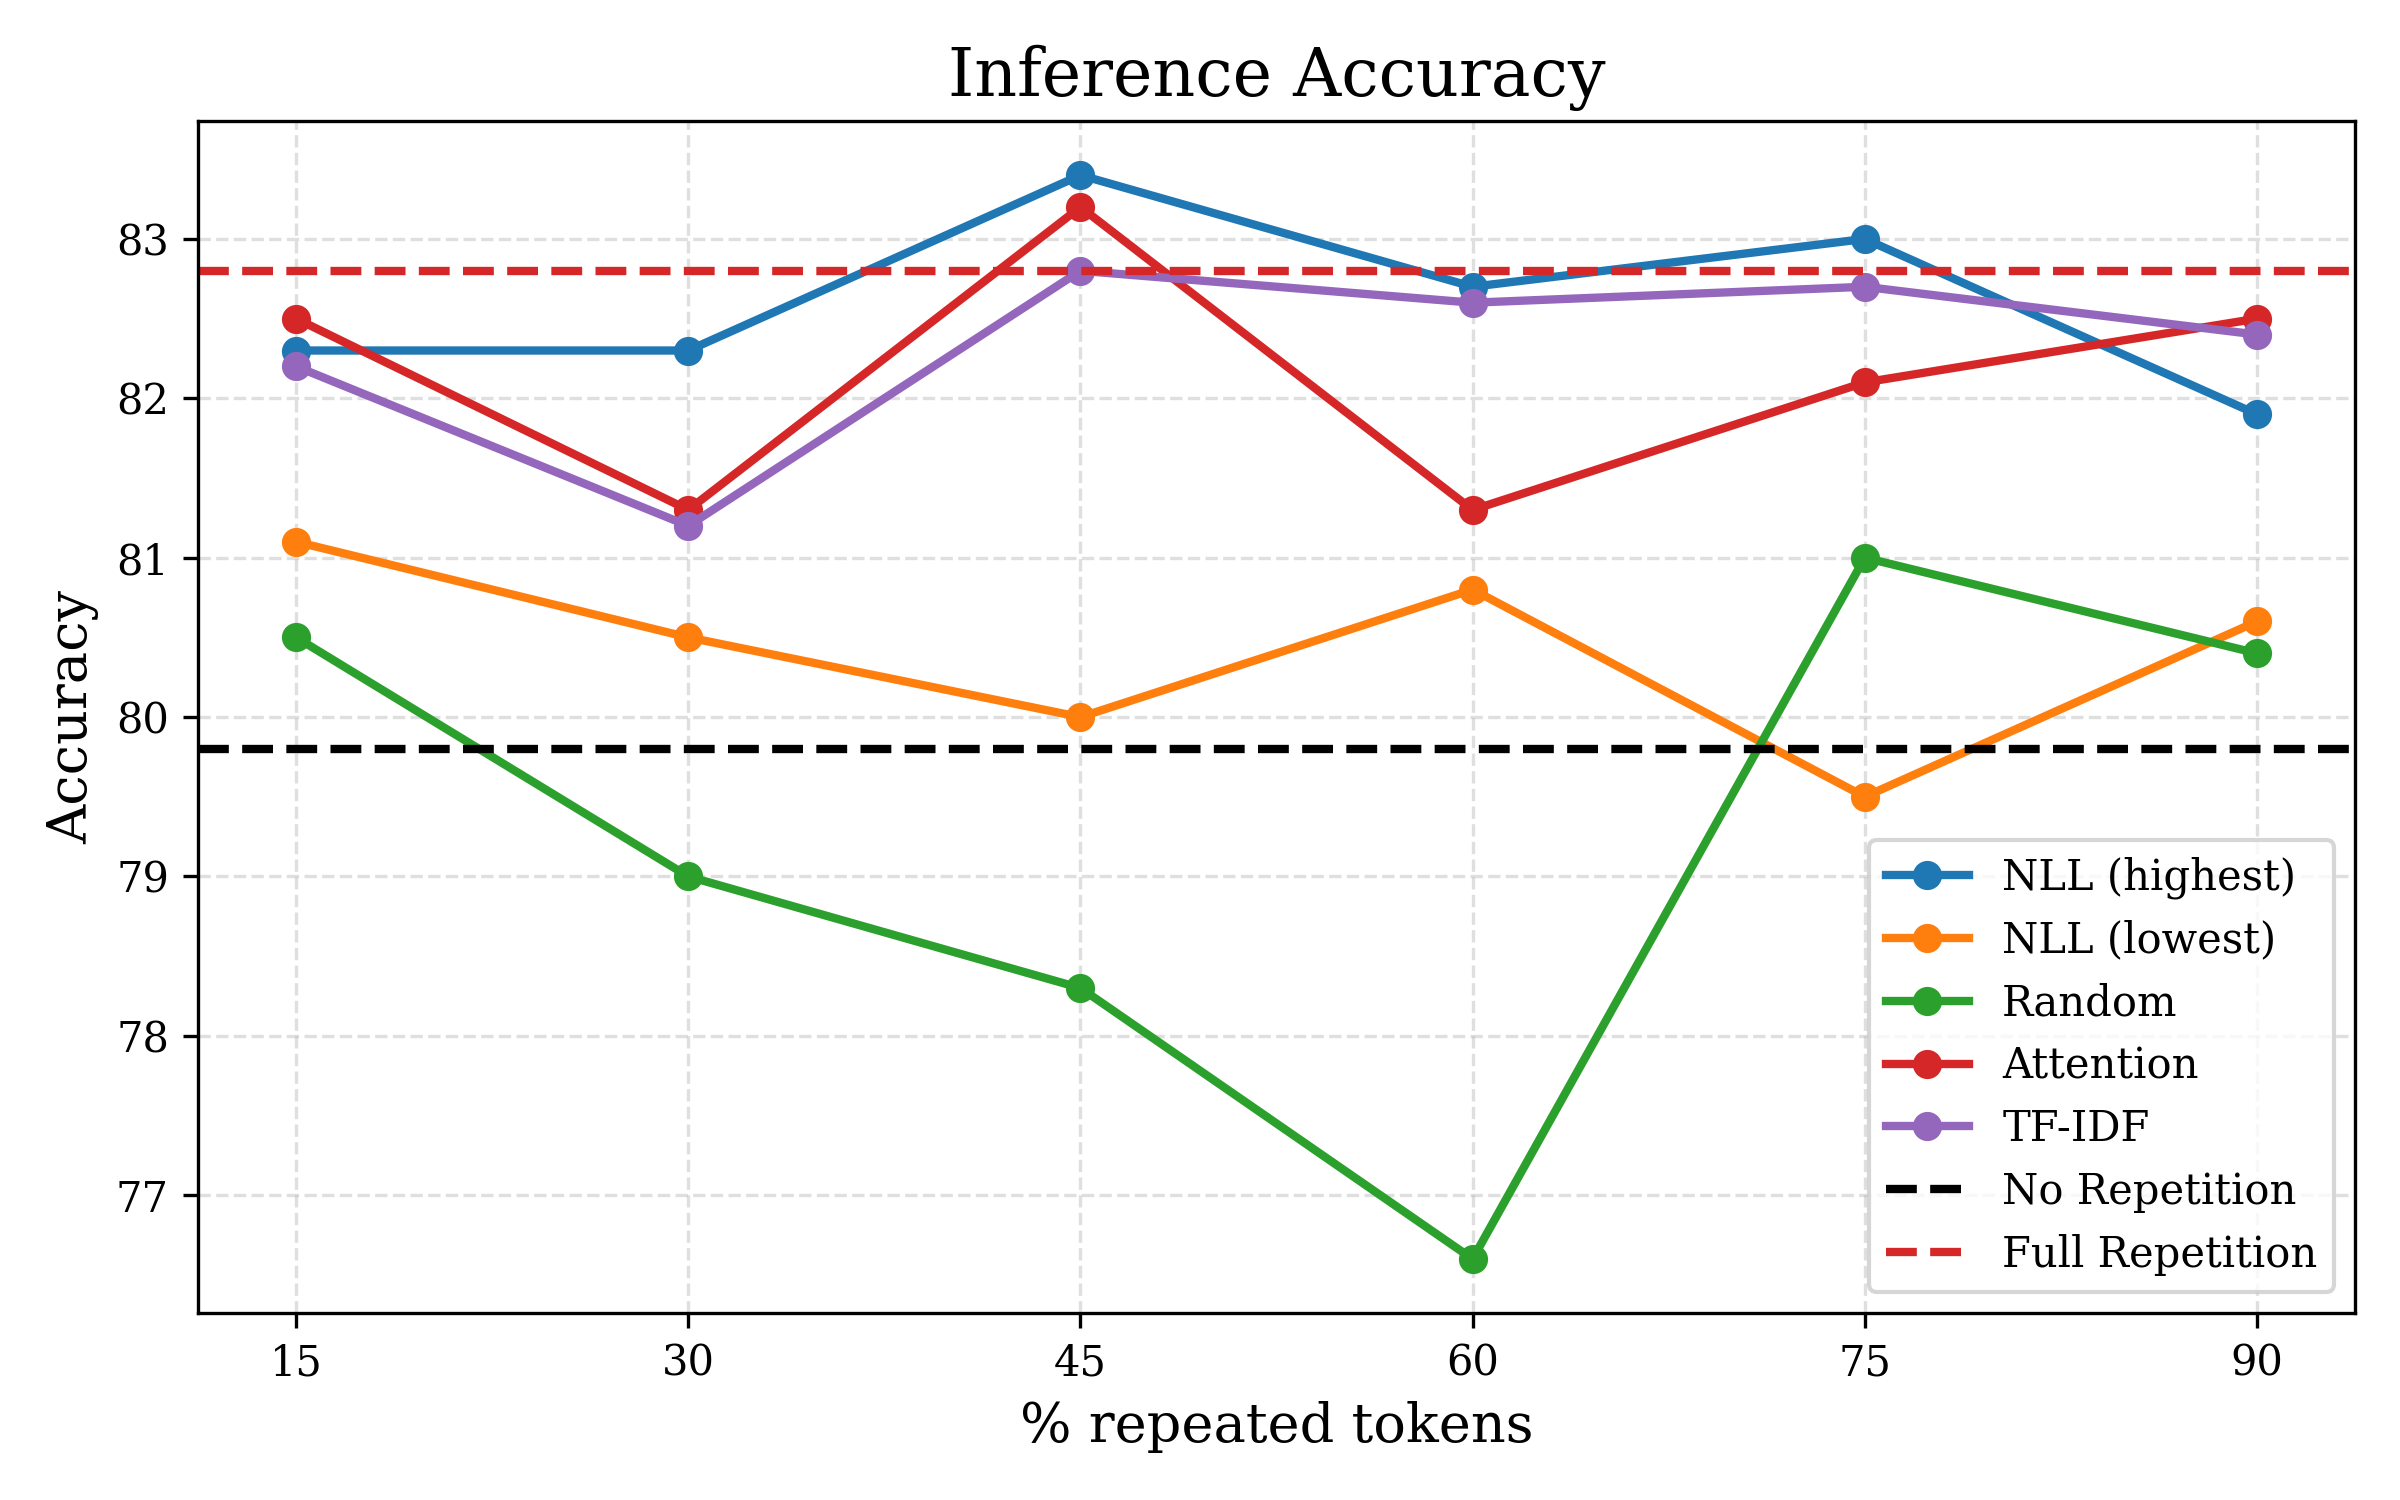
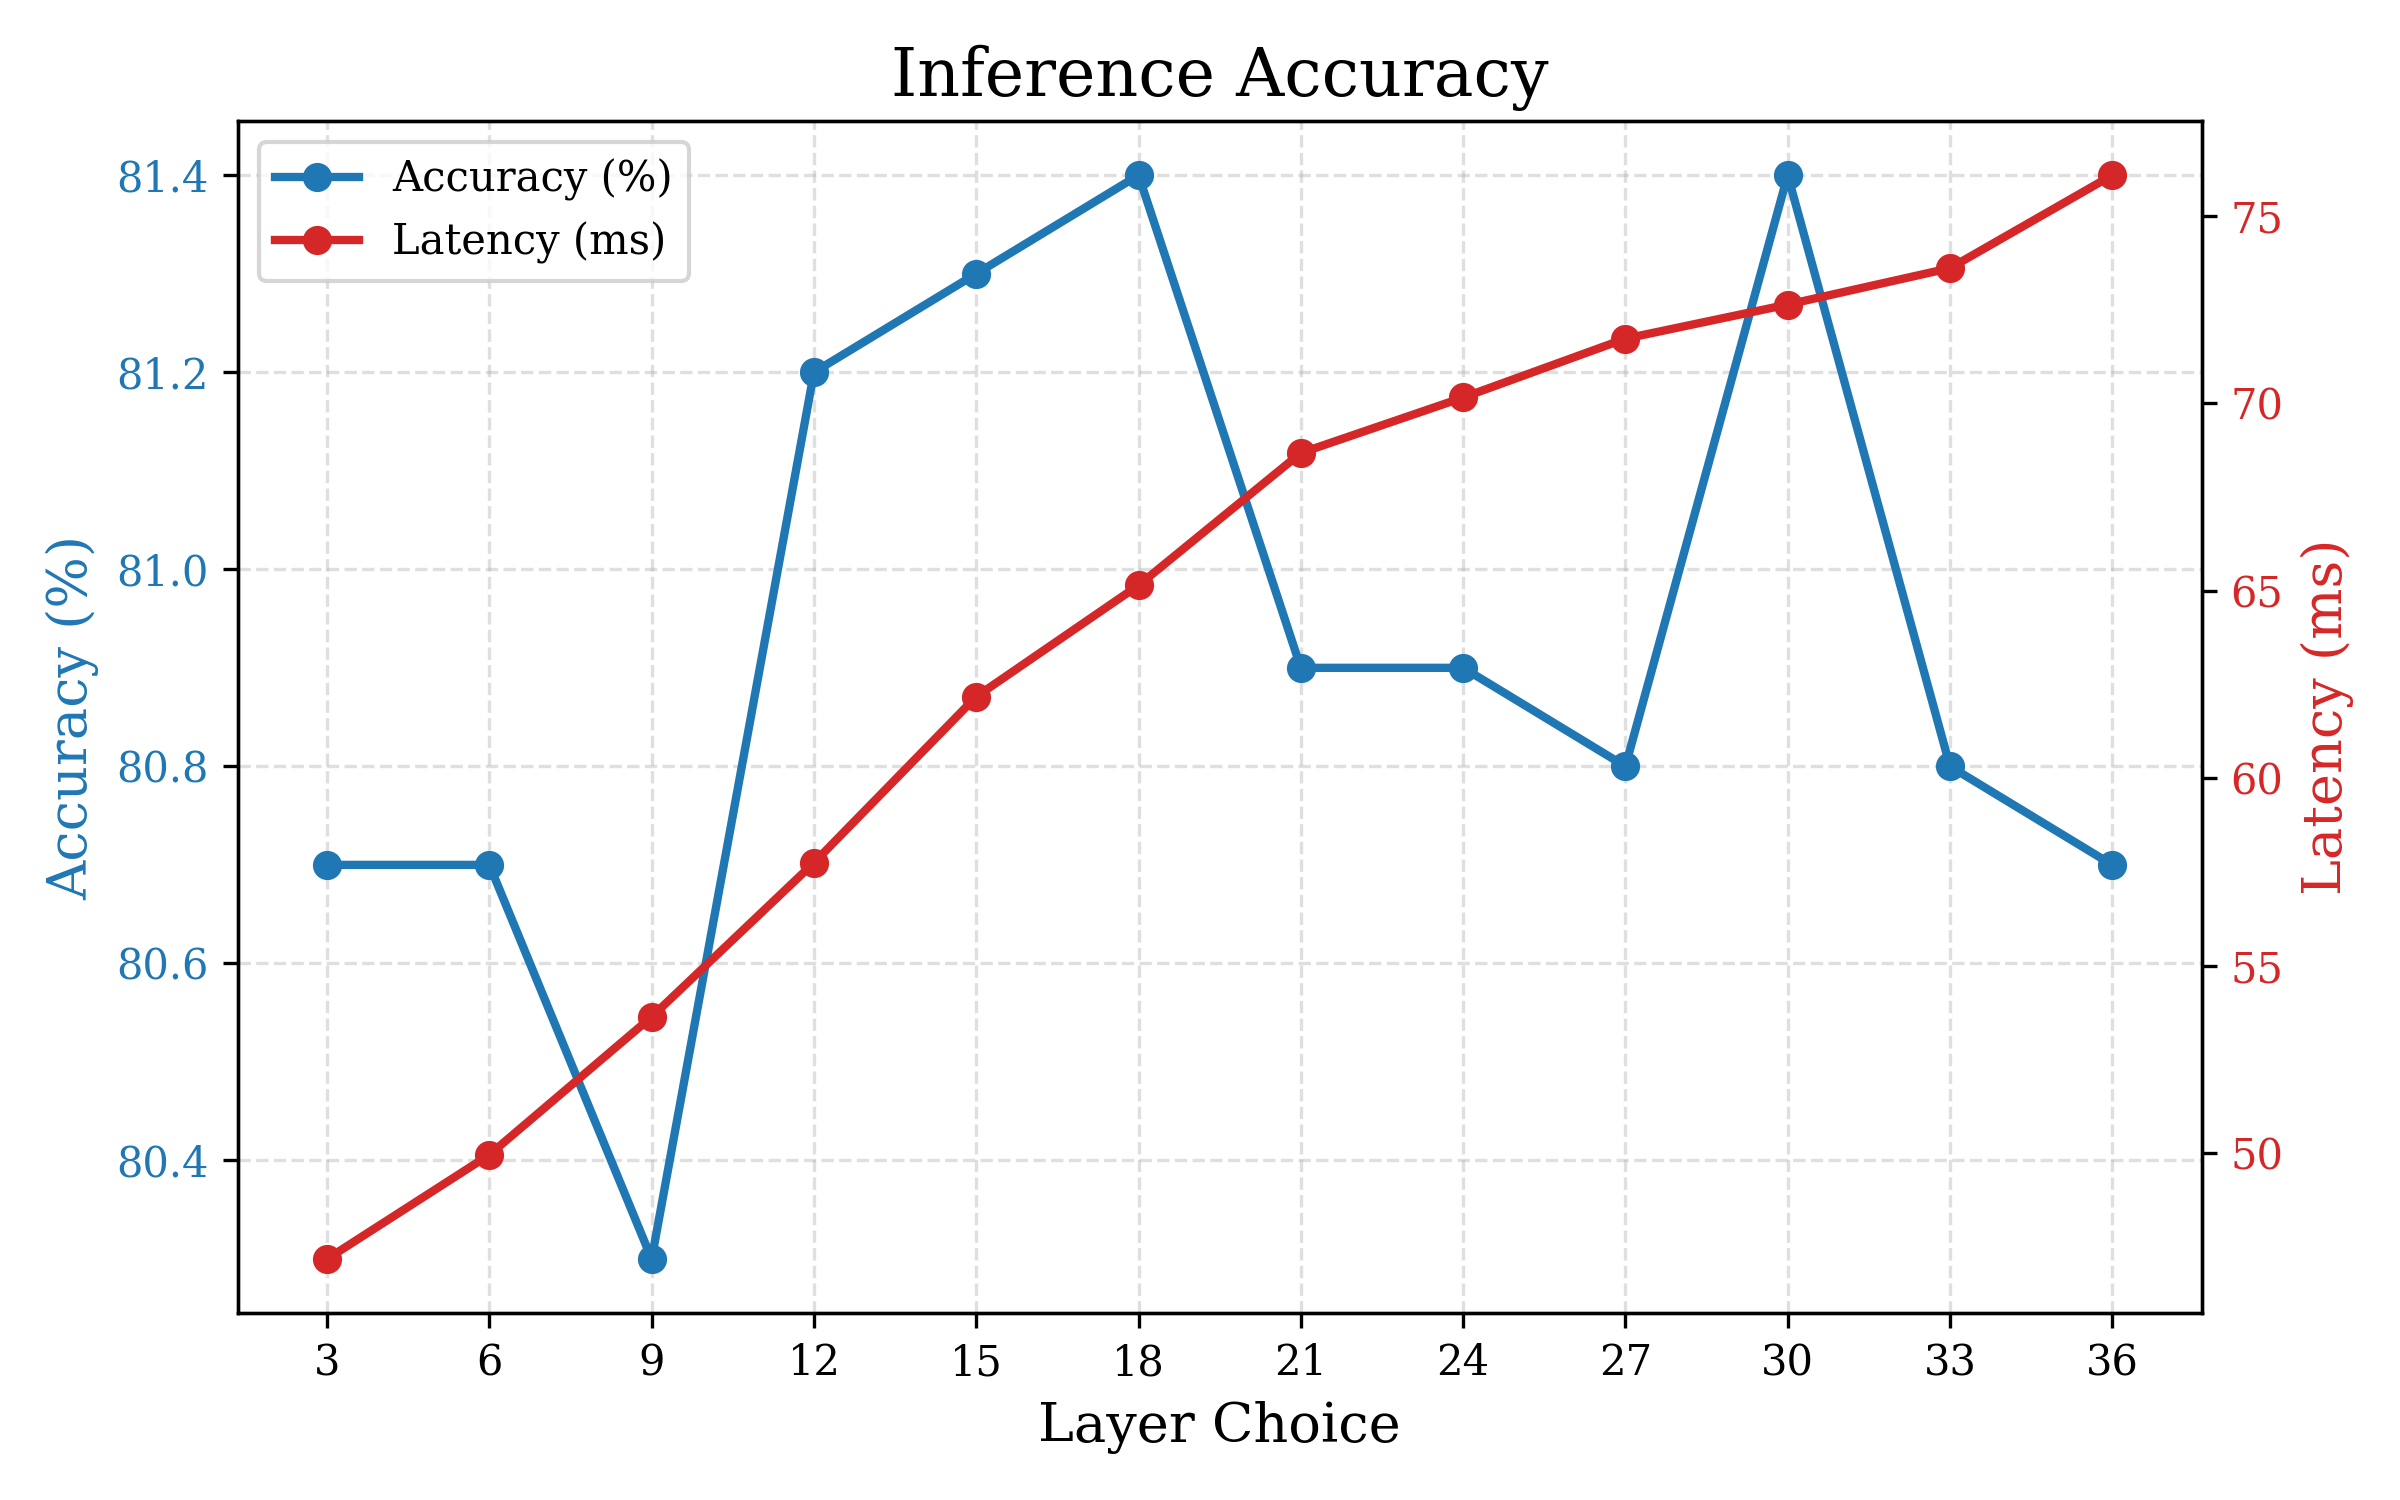
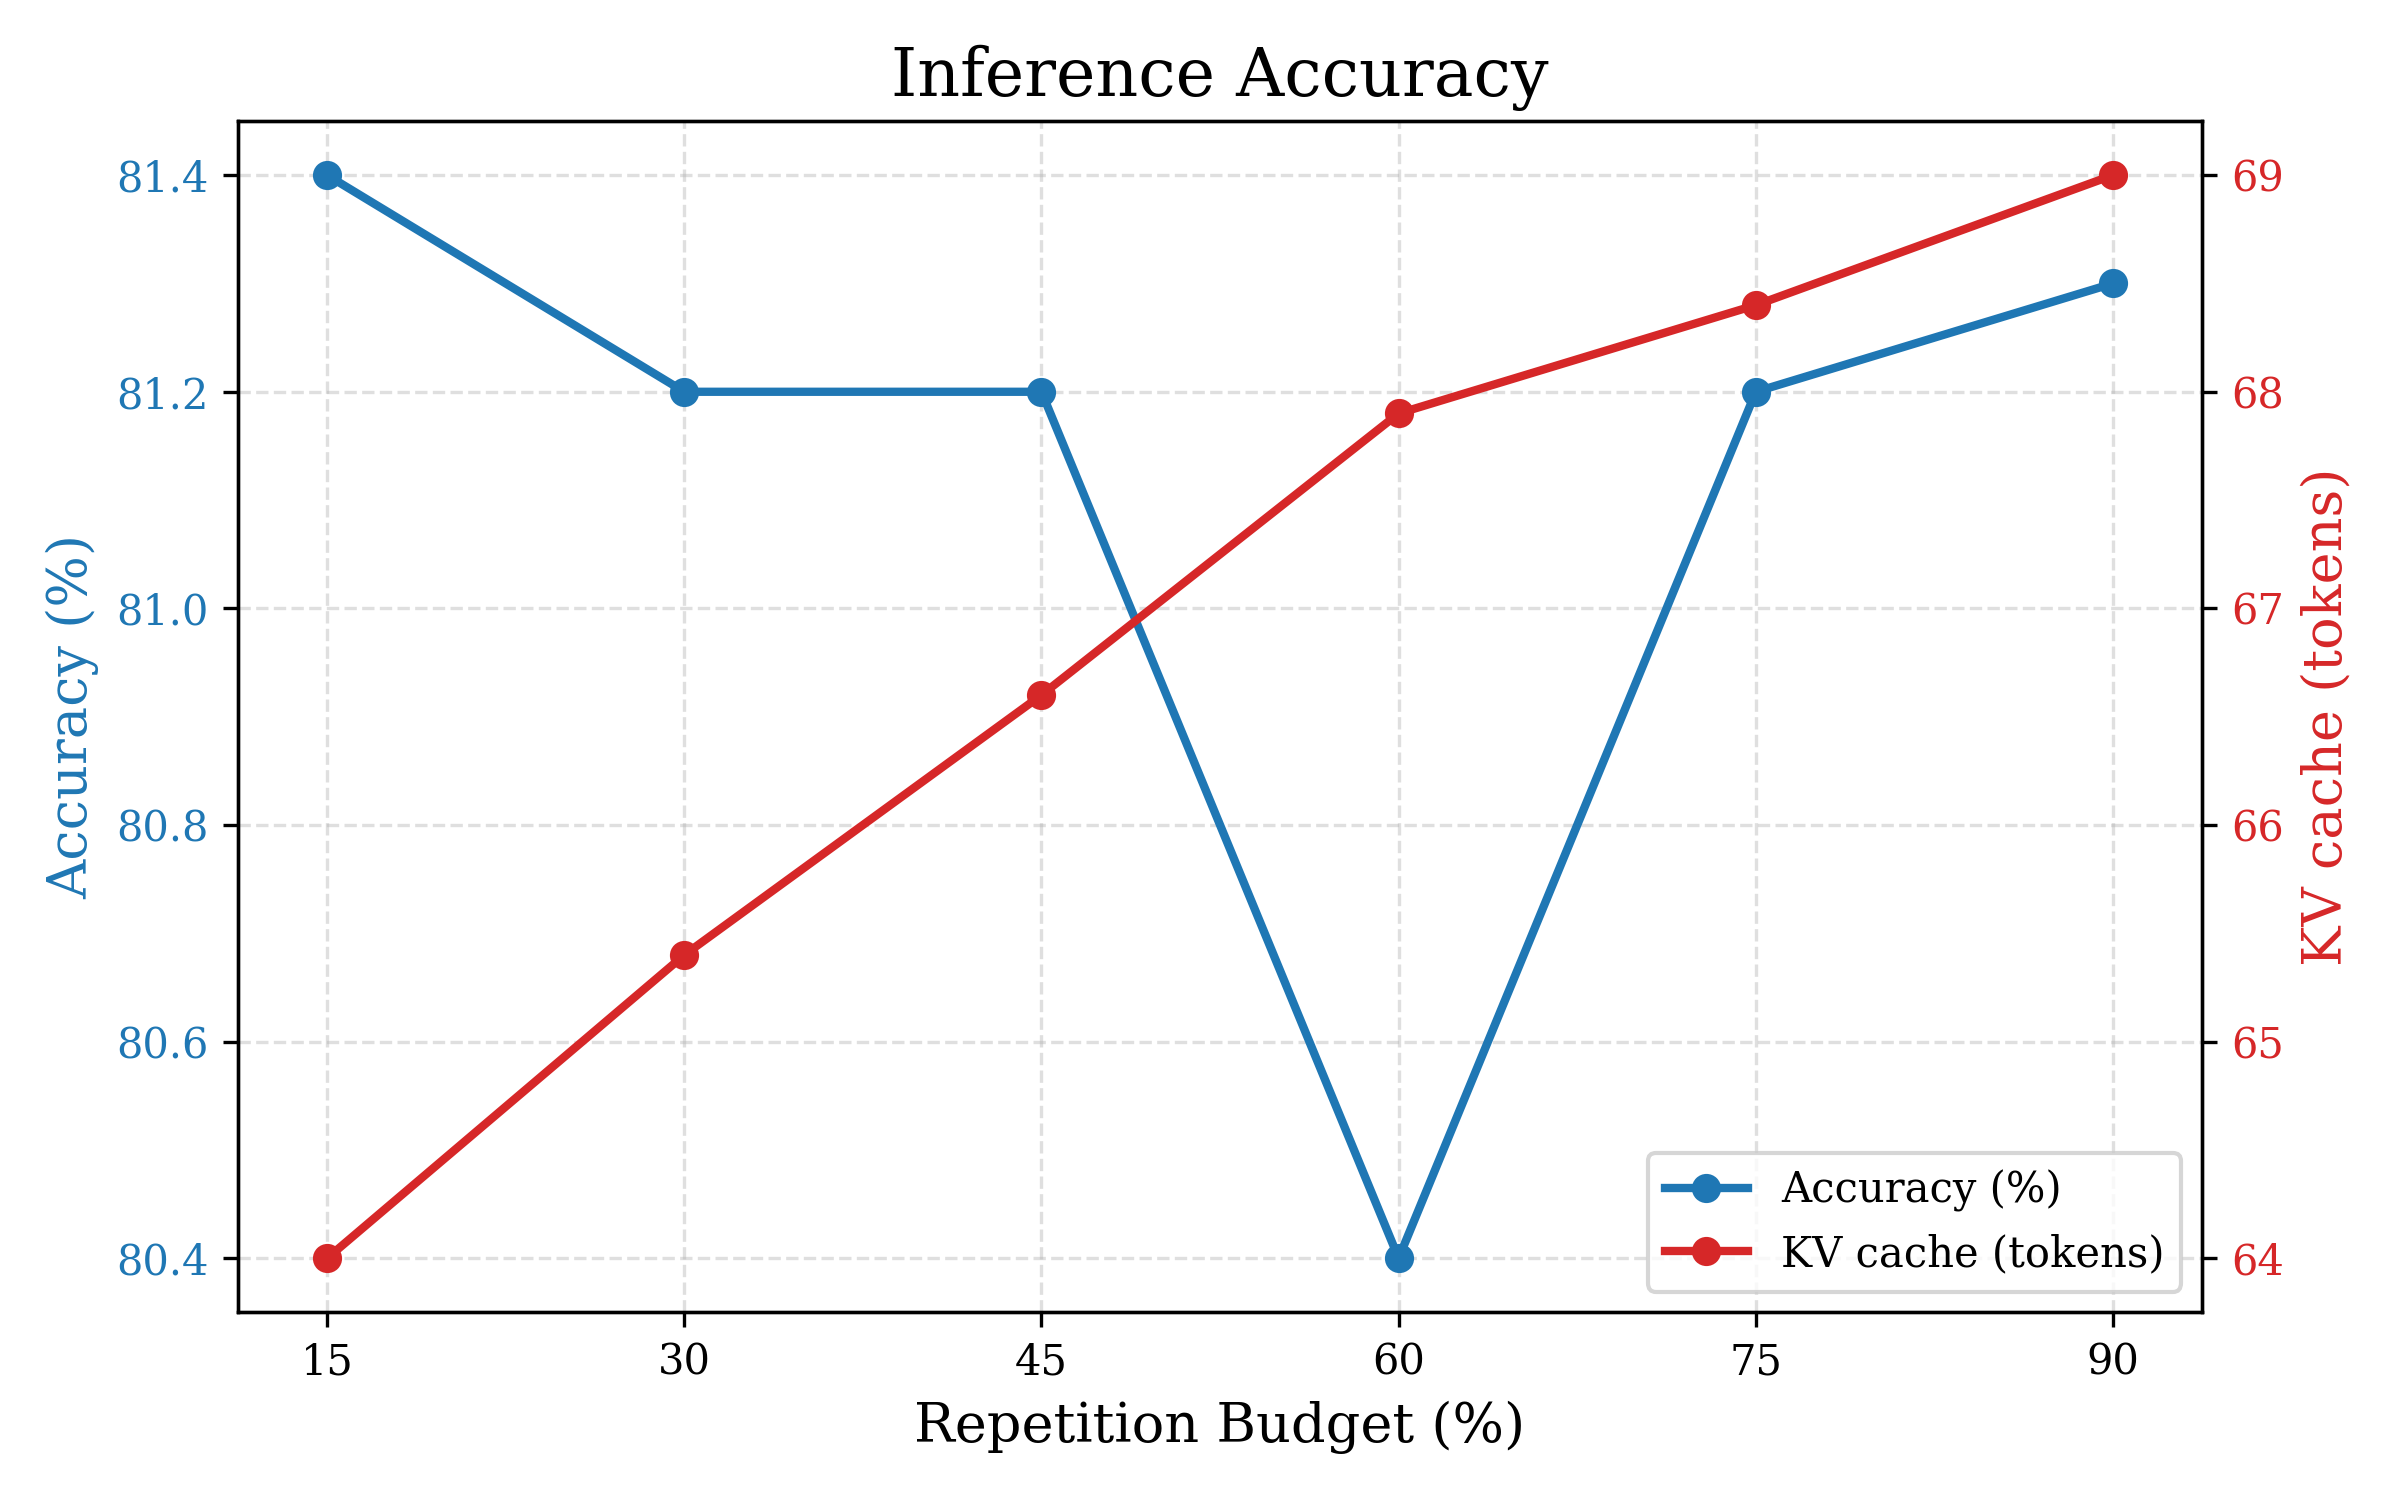
连接方式 ARC accuracy(%) 普通自然语言提示(默认) 81.4 ChatML 包装 70.6 自然语言 + ChatML 79.5 直接拼接 79.4 XML 包装 71.6 技术性自然语言提示 80.9 $s$ ARC accuracy(%) Gate FLOPs(原表口径) 32 80.1 544.8 k 64 81.4 549.0 k 128 80.6 557.3 k 4.8 效率扩展图:降低系数,未改变复杂度阶
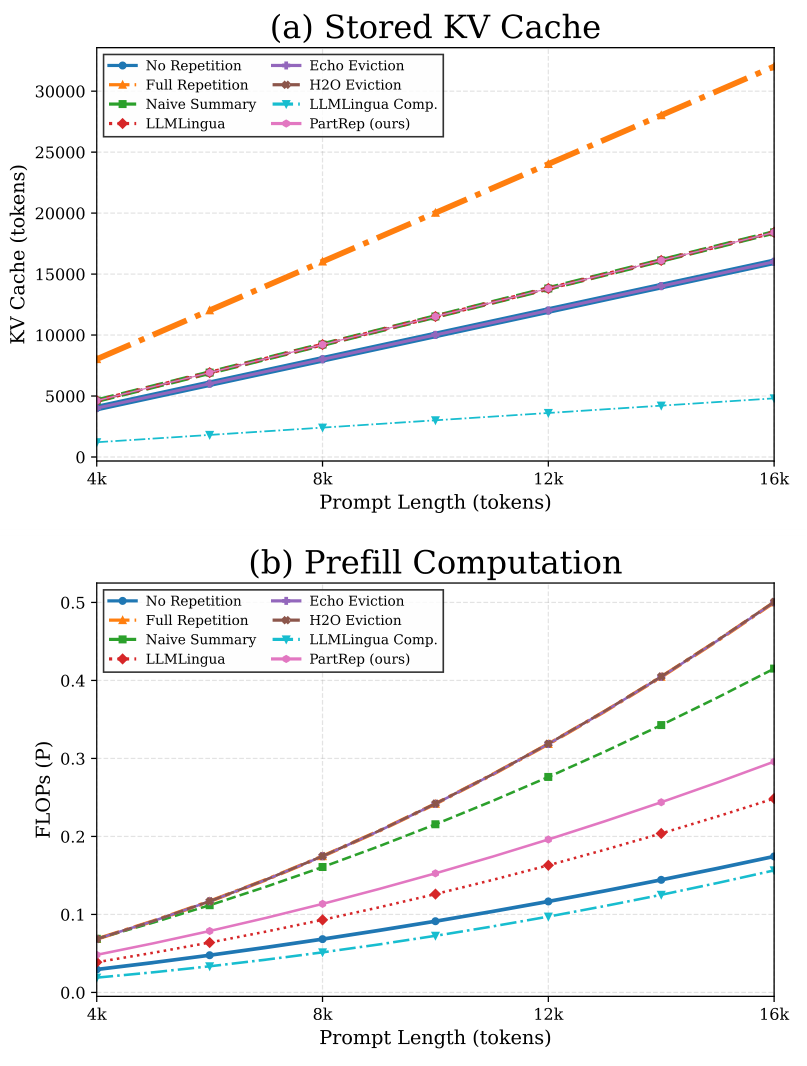
4.9 定性样例提供输入解释,不提供额外准确率证据
五:结论、可信范围与可继续验证的问题
5.1 最值得记住的贡献
5.2 作者明确承认的限制
5.3 阅读时需要保留的证据边界
问题 已有证据 尚缺的证据 平均质量是否接近完整重复 Qwen 七项任务 68.3 vs 68.5 多次训练/运行的不确定性;更大模型和更广任务 是否普遍优于完整重复 MMLU 部分模型、RULER 所测长度更高 主表五项较低,不能作普遍断言 是否降低实际部署时间 估算 FLOPs;取层延迟消融 公平后端下的 TTFT、吞吐、端到端延迟和峰值显存 为何高 NLL 有用 打分消融优于随机/低 NLL 的总体趋势 与重复边际收益的直接测量及因果隔离 是否严格满足预算 选择前比例 $\tau$ 的约束 窗口、连接词、格式后缀后的统一有效预算 长上下文是否可稳定迁移 训练片段至 1024、RULER 测至 16k 更长长度、真实长文任务、逐子任务和分布变化分析 早退是否真正低开销 作者称复用前缀状态 完整调度实现、选择开销、FLOPs 分项账单 5.4 原文中需要特别辨清的记号与口径
5.5 适合组会讨论的三个后续实验
复用材料与汇报建议
python3 build_slides.py slides.en.tex