HYPIC:混合注意力大模型的位置无关缓存——中文精读笔记
原题:HYPIC: Accelerating Hybrid-Attention LLM Serving with Position-Independent Caching
作者:Yifei Liu、Juntong Wu、Yang Liu、Junhao Hu、Minghao Li、Xiaoxu Chen、Weihang Chen。
版本:arXiv:2607.01299v2,2026-07-12 修订;本次获取与研读日期:2026-10-16。
材料:arXiv v2 · 原文 PDF · 英文汇报 PDF · 可编辑 TeX。以下页码均为从 1 开始的 PDF 页码,与本文印刷页码一致。
论文总览
HYPIC 解决的是一个推理服务问题:RAG 和智能体请求不断把已有文档、记忆或工具结果拼成新的长提示词,但同一段内容换了前缀以后,标准前缀缓存就无法复用。位置无关缓存(position-independent caching,PIC)允许独立缓存这些段,再在新请求里拼装;然而,已有 PIC 依赖逐 token 的 KV,无法直接处理混合架构中只保留一个循环状态的线性注意力层。
论文给出的关键答案是:把一段内容缓存为一个作用于历史状态的仿射变换,而不只缓存它从零出发的结束状态。 在线性层保存累计转移算子 $T_C$ 与零初态结束状态 $S_{C\mid0}$,复用时执行 $S\leftarrow T_CS+S_{C\mid0}$;在全注意力层重算每个中间段开头的少量 token,并让这些 token 穿过整个混合堆栈;对尚未缓存的段,则分发到多个实例并行预填充,再汇合。
三个机制对应三种障碍:状态不能直接相加、任意 token 难以跨线性层重算、冷请求仍然很慢。论文贡献主要在于把这三件事接成可运行的服务路径,而非提出新的训练目标或注意力模型。
| 结果 | 原文报告 | 必须一起理解的实验条件 |
|---|---|---|
| 热缓存首 token 延迟 | 相对 Prefix Cache 平均加速 3.25× | 4 个模型 × 4 个公开任务,所有段预热,指标为 p50 TTFT |
| 任务质量 | 相对 Full Recompute 平均低 1.71 分 | 汇总 F1 与 ROUGE-L 的绝对分数差,不能读成相对下降 1.71% |
| 负载下服务容量 | 相对 Prefix Cache 平均 1.66× QPS | Prod-RAG,预热 10 分钟后仍有 miss,以 p50 TTFT=1 秒曲线交点比较 |
| 全冷请求 | 2.83 秒降至 0.49 秒,报告 5.7× | 32k token、8 段,从单个 TP-1 实例扩至 8 个实例 |
来源:Sec. 6.2、6.5,PDF pp. 10–12,Figs. 10、11、15。热缓存加速、生产负载容量和冷请求扩展是不同实验,不能拼成一个同时满足所有条件的结果。
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与关键对象 |
|---|---|---|
| 1 Introduction | 提出混合注意力与 PIC 的兼容性缺口 | pp. 1–2;Fig. 1 |
| 2 Background | 区分前缀/PIC,统一线性注意力递推 | pp. 2–3;Table 1,Eqs. (1)–(2) |
| 3.1 Existing PIC primitives do not transfer to linear-attention states | 推导直接相加的结构误差 | pp. 3–4;Table 2,Eqs. (3)–(5) |
| 3.2 Existing PIC correction does not apply to hybrid stacks | 解释逐 token 修正断路与段首偏差 | pp. 4–5;Figs. 2–3 |
| 3.3 Existing PIC systems do not exploit segment-level self-containment | 从段独立性引出跨实例并行 | p. 5;Fig. 4 |
| 4.1 Overview | Router、Store、Assembler 及请求路径 | p. 6;Fig. 5 |
| 4.2 State composition with cached transitions | 状态组合、成本、卷积和位置处理 | pp. 6–7;Fig. 6,Table 3,Eqs. (6)–(7) |
| 4.3 Full attention alignment with seam windows | 段首重算及跨线性层传播 | pp. 7–8;Figs. 7–8,Eq. (8) |
| 4.4 Cache-miss acceleration with segment parallelism | scatter/combine、LPT、计算传输流水线 | pp. 8–9;Fig. 9,Eq. (9) |
| 5 Implementation | SGLang、NIXL 与两次递推内核调用 | p. 9 |
| 6.1 Setup;6.2 End-to-end performance | 模型、数据、基线、热缓存与负载实验 | pp. 10–11;Figs. 10–11 |
| 6.3 Linear-attention state composition | 扩展性、构建代价与深层漂移 | pp. 11–12;Figs. 12–13,Table 4 |
| 6.4 Sensitivity of seam window width | 窗口宽度与质量/延迟取舍 | p. 12;Fig. 14 |
| 6.5 Segment parallelism for cache-miss prefill | 冷请求扩展与调度消融 | p. 12;Fig. 15 |
| 7 Conclusion | 归纳系统贡献 | pp. 12–13 |
一:动机——缓存对象改变后,复用接口也必须改变
1. 前缀匹配为什么浪费可复用内容
设两个请求分别为“系统提示 + 文档 A + 文档 B + 问题 1”和“系统提示 + 文档 C + 文档 B + 问题 2”。标准前缀缓存可以复用系统提示,但 A/C 处一旦不匹配,后面的 B 也必须重算。原因不仅是 B 的绝对位置可能改变:上游上下文改变后,B 在深层的隐藏状态也会改变。
PIC 把文档 B 独立预填充并缓存,之后调整位置、修正少量受上下文影响较大的 token,从而复用大部分计算。对全注意力模型,基本操作是沿 token 轴拼接 KV,再做位置校正和选择性重算。混合模型则同时含有逐 token KV 与固定大小循环状态,两类缓存的代数结构不同。(Sec. 2.1,PDF pp. 2–3。)
2. 只保存结束状态,丢掉了什么
现代线性注意力可写成:
这里 $S_i\in\mathbb R^{d_k\times d_v}$ 是记忆矩阵,$T_i\in\mathbb R^{d_k\times d_k}$ 负责保留、衰减或定向擦除历史,$u_i\in\mathbb R^{d_k\times d_v}$ 写入当前内容,$q_i\in\mathbb R^{d_k}$ 读出 $o_i\in\mathbb R^{d_v}$。这是原文 Eq. (2),PDF p. 3。
如果 $T_i=I$,零初态结束状态只是各写入项之和,两个段的状态可以相加;原始归一化线性注意力中的归一化状态 $z$ 也需相应累加。现代门控/衰减/Delta 变体一般不满足这个条件。第二段会先改变第一段留下的记忆,再写入自己的内容,因此真实结果是:
若直接相加,按“真实结果减去相加结果”的符号约定,误差为:
常数衰减 $T_i=\gamma I$ 给出 $\|\Delta\|/\|S_{C_1\mid0}\|=1-\gamma^{|C_2|}$。 当 $\gamma=1-2^{-10}$ 时,后段长 256/512/1024 token 的归一化误差分别是 0.221/0.394/0.632。后段越长,遗漏的历史衰减越严重。这是递推语义缺失,不是通过提高浮点精度能消除的误差。(Sec. 3.1,PDF p. 4,Eqs. (4)–(5)、Table 2。)
3. 为什么不能直接移植已有 PIC 的 token 选择器
选择一个待修正 token $i$ 后,要重算它在高层的 KV,必须获得它在所有较低层的输出。全注意力层可以读取前面 token 的 KV;线性层通常只缓存整段或整请求的结束状态,缺少 token $i$ 前面的状态 $S_{i-1}$。
为每个 token 保存完整循环状态的代价是 $d_kd_v$ 个元素,相比一个 KV 对的 $d_k+d_v$ 个元素,在 $d_k=d_v=128$ 时高达 64 倍;从段首递推到任意位置又会吃掉复用收益。HYPIC 于是把可修正区域约束在段首:已有前段结束状态就是一个可用的起点,连续重算少量 token 即可。(Sec. 3.2,PDF pp. 4–5,Fig. 2。)
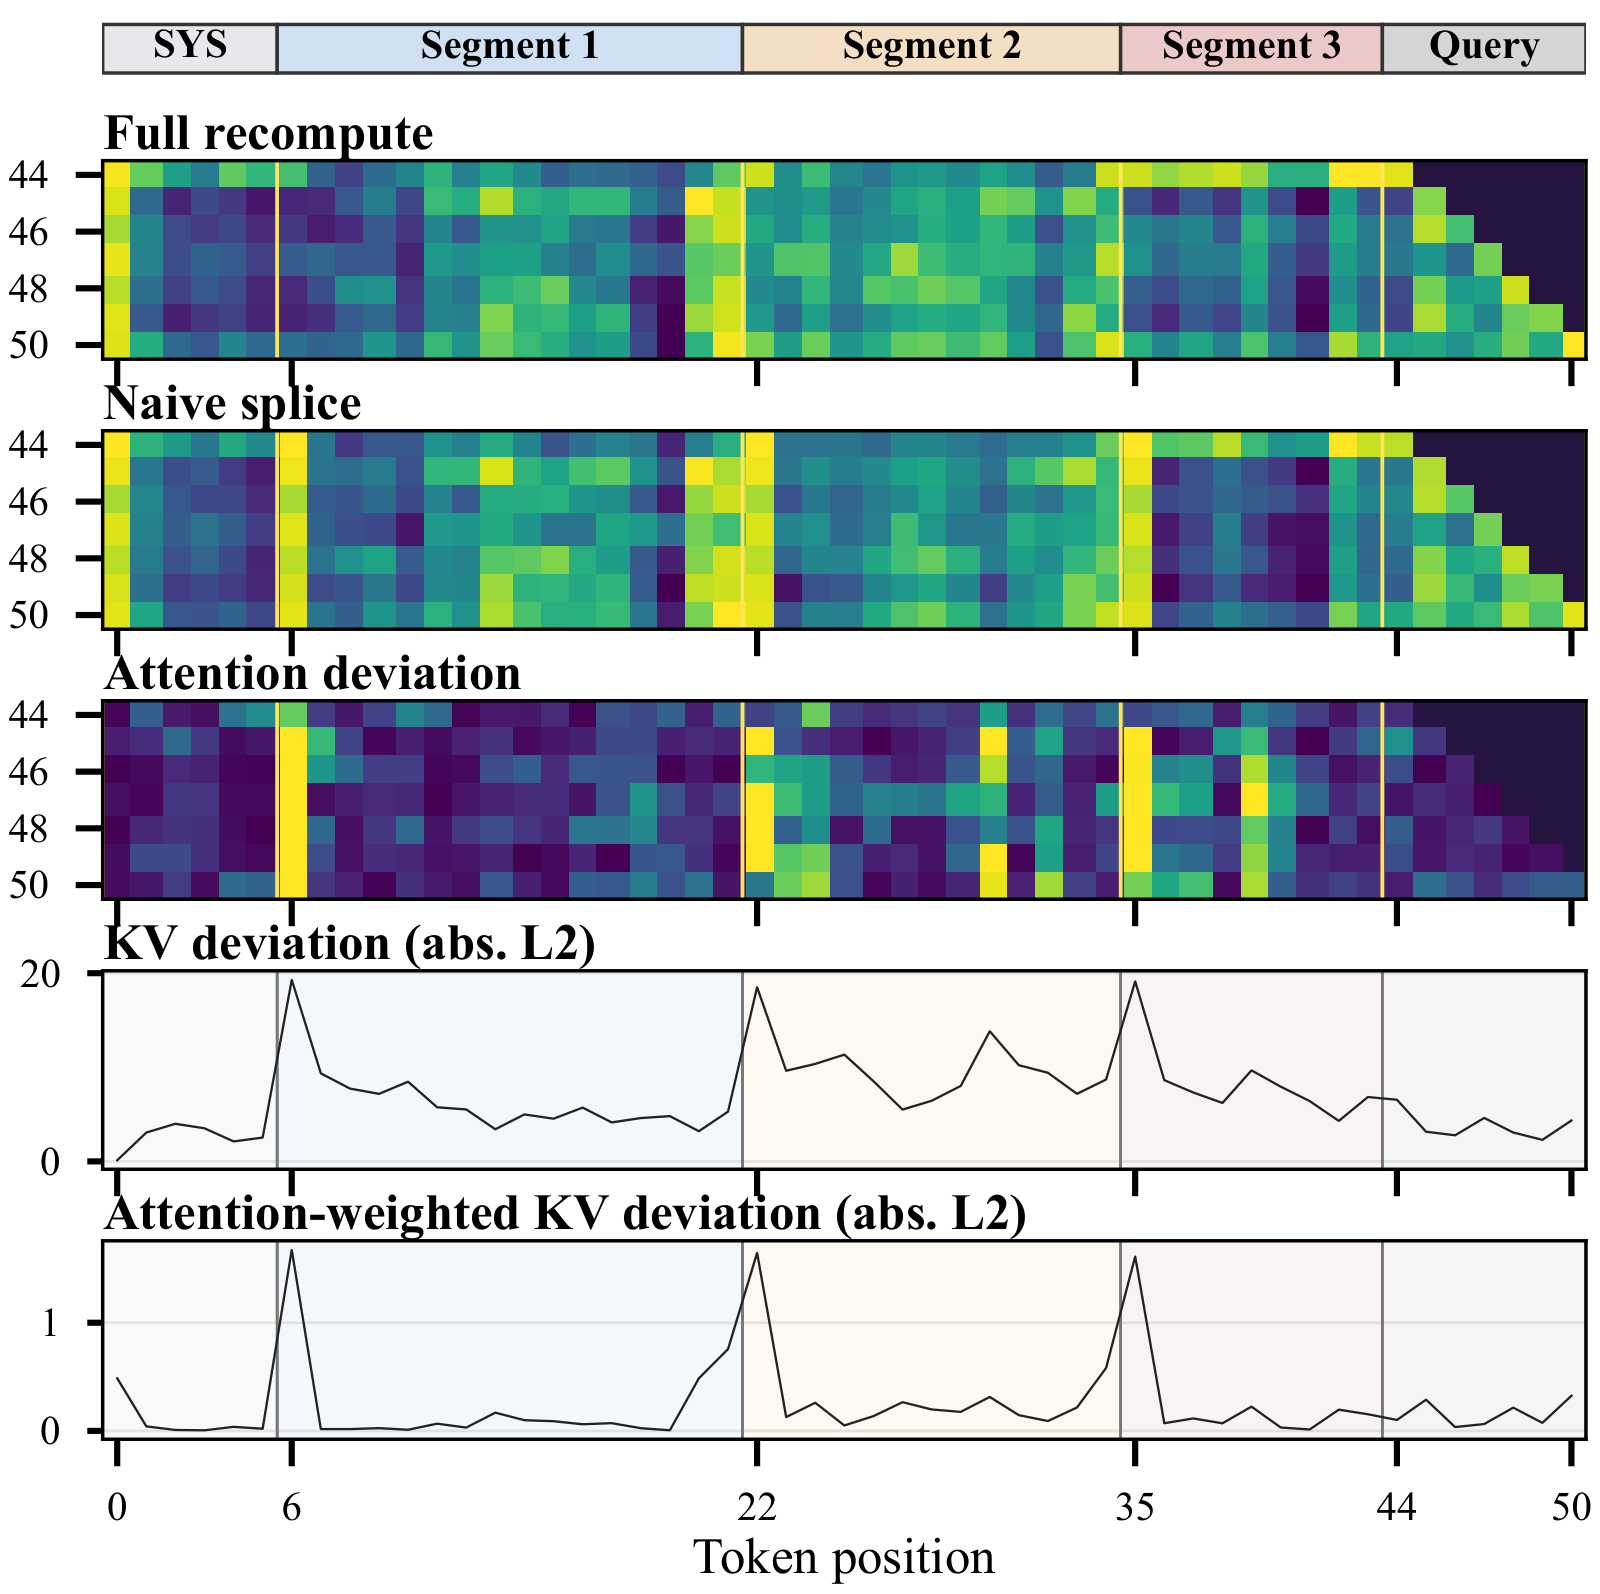
原文 Fig. 3,PDF p. 5。横轴是 token 位置,上方标出系统提示、三个文档段和 query;前三幅热图依次比较完整重算、直接拼接及注意力差异,下面两条曲线给出 KV 差异和注意力加权 KV 差异。峰值集中在文档段开始的位置,支持将有限重算预算投到边界。该图是 Qwen3.5-35B-A3B 第 7 层第 0 头的诊断示例,论文将其解释为独立段产生的局部 attention sink。
二:方法——状态组合、边界修正与冷段并行
1. 请求的数据流
HYPIC 接收由应用明确划分的段序列。Router 先检查缓存命中,再选一个 combine worker,并把未命中的段分发给 scatter workers。每个冷段独立产生线性层缓存二元组与全注意力 KV;Assembler 收齐结果后,在线性层组合状态,在全注意力层拼接 KV 并重算边界,最后按通常的预填充—解码分离路径交给 decode worker。
Store 分为两类:public pool 保存可跨请求复用的段缓存;private pool 保存已经含有当前请求前缀信息的运行状态。二者容量独立、分别采用 LRU。private 状态在生成结束后可以保留,以便同一会话的后续请求继续走前缀缓存。因此,新请求先找 private 前缀命中,再对剩余段找 public PIC 命中。(Sec. 4.1–4.2,PDF pp. 6–7。)
2. 把段表示为仿射变换
固定某一层的输入隐藏状态后,一段 $C=(1,\ldots,m)$ 的展开式为:
第二行空乘积按单位阵处理。$T_C$ 保存“整段如何处理已有记忆”,$S_{C\mid0}$ 保存“整段自己留下什么”。二者合起来,才足以作用于任意输入状态。
教学推导:记 $B_C=S_{C\mid0}$,先处理 A 再处理 B,则
这个操作可结合,但一般不可交换:段可以独立构建缓存,最终组合仍须遵守提示词顺序。例如一维情况下,前缀状态为 10,第二段有两个 token,每步把旧状态乘 0.5、再加 1。那么 $T_C=0.25$、$S_{C\mid0}=1.5$,正确结束状态为 $0.25\times10+1.5=4$;直接相加得到 11.5,会错误保留原本应被衰减的历史。
对 $n$ 个后缀段,原文 Eq. (6) 是:
其中 $S_S$ 是已有前缀的结束状态,乘积顺序为 $T_{C_n}\cdots T_{C_1}$。实现时按段执行 $S\leftarrow T_CS+S_{C\mid0}$ 即可,不需要重新遍历缓存段的所有 token。(Sec. 4.2,PDF p. 6,Fig. 6。)
3. “常数时间”的准确含义与不同变体的成本
下表给出原文 Table 1/3 的关键形式。$g_i$ 在 GDN 中为标量,在 GLA/KDA 中为向量;$k_i,v_i$ 是 key/value 投影,$\beta_i$ 控制写入或擦除强度。
| 变体 | 单步 $T_i$ | 写入 $u_i$ |
|---|---|---|
| RetNet、Lightning-2 | $\gamma I$ | $k_iv_i^\top$ |
| Mamba2 | $a_iI$ | $k_iv_i^\top$ |
| GLA | $\operatorname{diag}(g_i)$ | $k_iv_i^\top$ |
| DeltaNet | $I-\beta_i k_ik_i^\top$ | $\beta_i k_iv_i^\top$ |
| GDN | $g_i(I-\beta_i k_ik_i^\top)$ | $\beta_i k_iv_i^\top$ |
| KDA | $(I-\beta_i k_ik_i^\top)\operatorname{diag}(g_i)$ | $\beta_i k_iv_i^\top$ |
| $T_C$ 家族 | 缓存形式 | 额外存储 | 首次累计成本 | 复用时应用成本 |
|---|---|---|---|---|
| 标量 | 一个标量 | 2 B | $O(\lvert C\rvert)$ | $O(d_kd_v)$ |
| 对角 | $d_k$ 维向量 | 256 B | $O(\lvert C\rvert d_k)$ | $O(d_kd_v)$ |
| 稠密 | $d_k\times d_k$ 矩阵 | 32 KiB | $O(\lvert C\rvert d_k^2)$ | $O(d_k^2d_v)$ |
存储数字按 FP16、$d_k=d_v=128$、每段每头每层 计算,只计额外的 $T_C$;原文把 32 KiB 写作 32 KB。$S_{C\mid0}$ 仍需单独存储。Delta 类每步虽是单位阵加低秩修正,连续相乘后的整体算子一般需要稠密表示;构建时则可利用单步低秩结构,避免逐 token 做稠密矩阵乘法。(PDF pp. 3、7,Tables 1、3。)
所以“常数时间”指的是固定状态维度下,每段组合成本不随该段 token 数增长。段数为 $n$ 时仍有 $O(n)$ 次组合;整个请求还包含 KV 移动、位置重旋转、窗口重算和 query 计算,不能把整个混合模型推理都称为 $O(1)$。
4. 缓存如何构建,精确性在哪里结束
实现使用同一递推内核计算两次:第一次设置 $S_0=0$ 并保留正常写入,得到 $S_{C\mid0}$;第二次设置 $S_0=I$、所有 $u_t=0$,得到 $T_C$。这里第二次运行把状态当作转移算子的累积器;若 key/value 维度不同,数学上需要按 $d_k\times d_k$ 形状构造该累积器。论文在 SGLang 上使用 FLA 内核实现这条路径。(Sec. 5,PDF p. 9。)
组合公式精确依赖一个关键条件:比较两种计算时,这一层的 token 输入相同,从而 $T_i,u_i$ 相同。它们不依赖该层的递归状态 $S_{i-1}$,却可能通过较低层的隐藏状态间接依赖前缀。独立预填充段得到的深层 $T_C,S_{C\mid0}$,因此未必等于完整上下文下重新生成的二元组。
论文在 Qwen3.5-35B-A3B 的 1096-token、4 段例子中,第 0 层组合相对范数误差为 $6\times10^{-5}$,角度误差为 $0.003^\circ$,接近 FP16 数值噪声;深层漂移实验则另有约 9% 的误差,见下文。精确的是给定输入的状态组合恒等式,近似的是跨上下文复用深层缓存。(Sec. 4.2,PDF p. 7。)
5. seam window:既修正 KV,也恢复向上的 token 路径
对每个中间文档段,把前 $w$ 个 token 定义为接缝窗口(seam window),默认 $w=8$。系统提示没有左邻居,完整缓存;末尾用户 query 需要读取整个前缀,端到端计算。
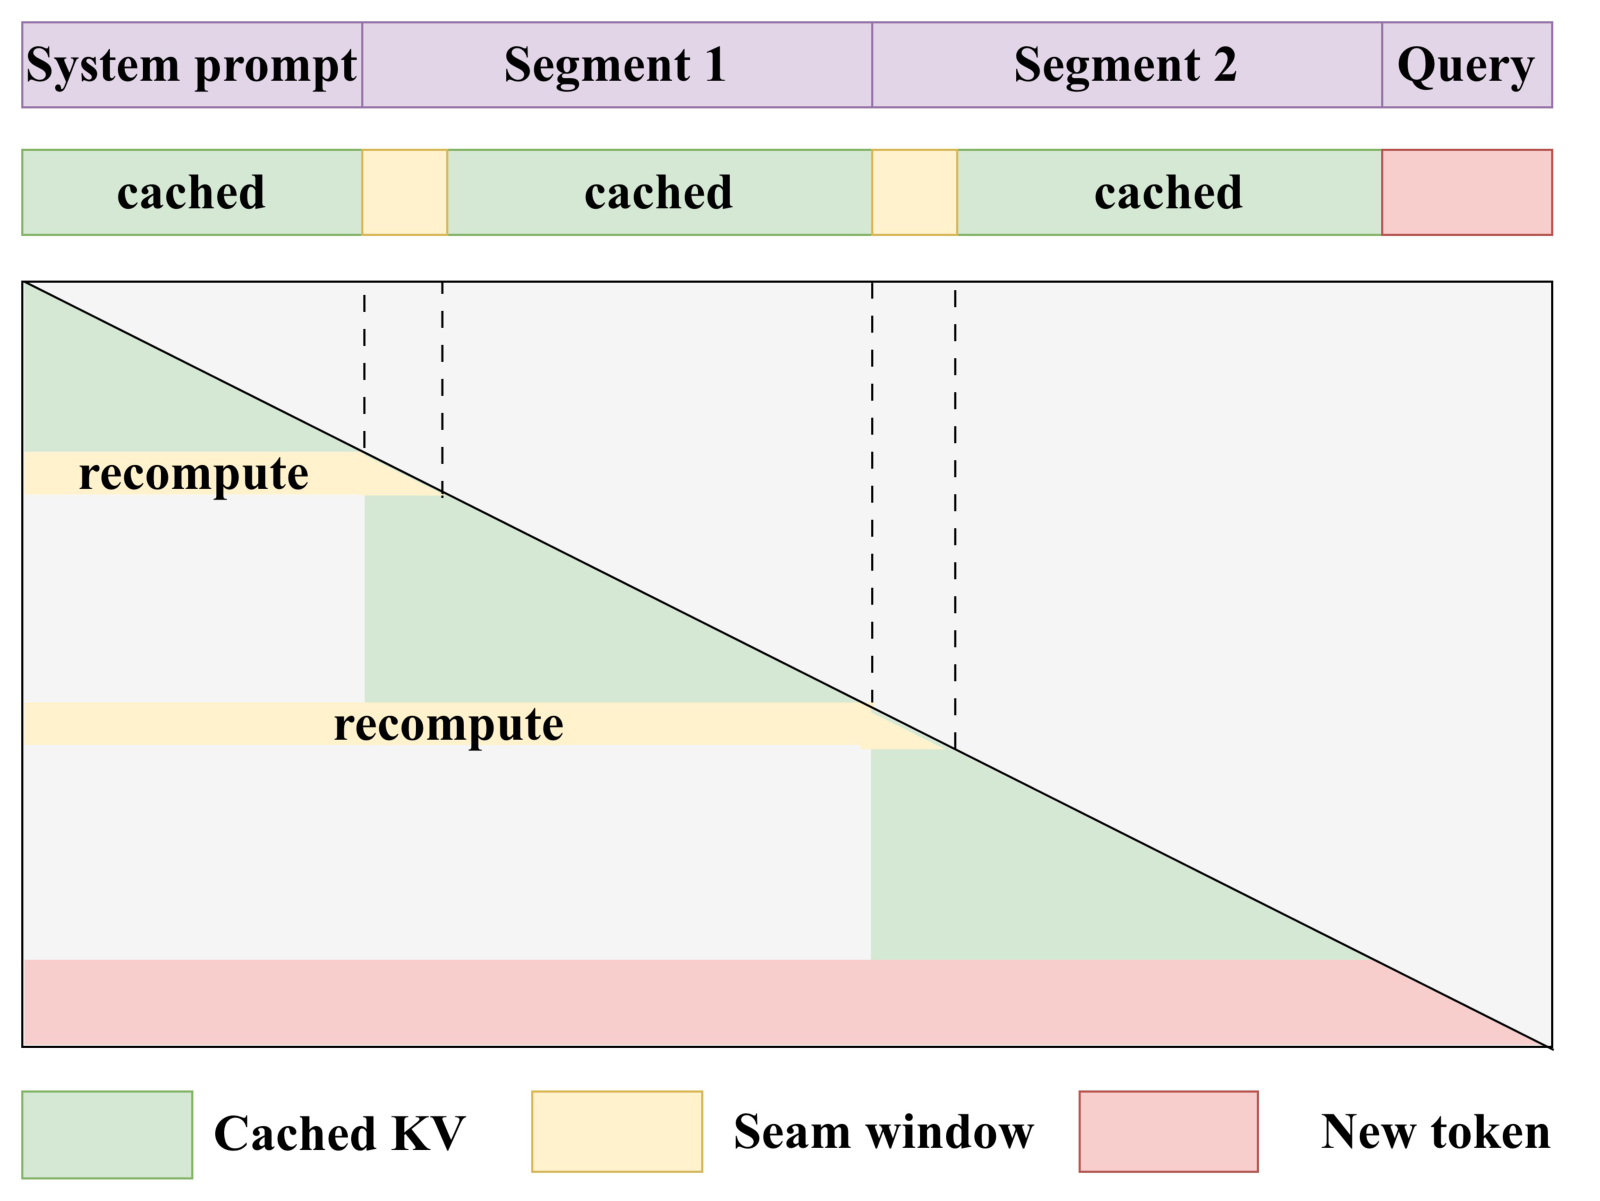
原文 Fig. 7,PDF p. 8。横向排列系统提示、文档段与 query;绿色部分是复用 KV,黄色细条是重算窗口,红色 query 全算。注意力区域的三角形表示因果可见性,窗口 token 在合法的前缀范围内读取缓存,从而重新建立跨段联系。
缓存构建时仍完整计算独立段,以得到各层段内表示;但中间段前 $w$ 个 token 的 KV 不作为可复用 KV 保存,线性层二元组也只累计窗口之后的部分。复用时,每层对窗口 token 从当前前缀状态顺序递推,得到逐 token 输出并传到上一层;随后用缓存的段体二元组一次跳到段尾。
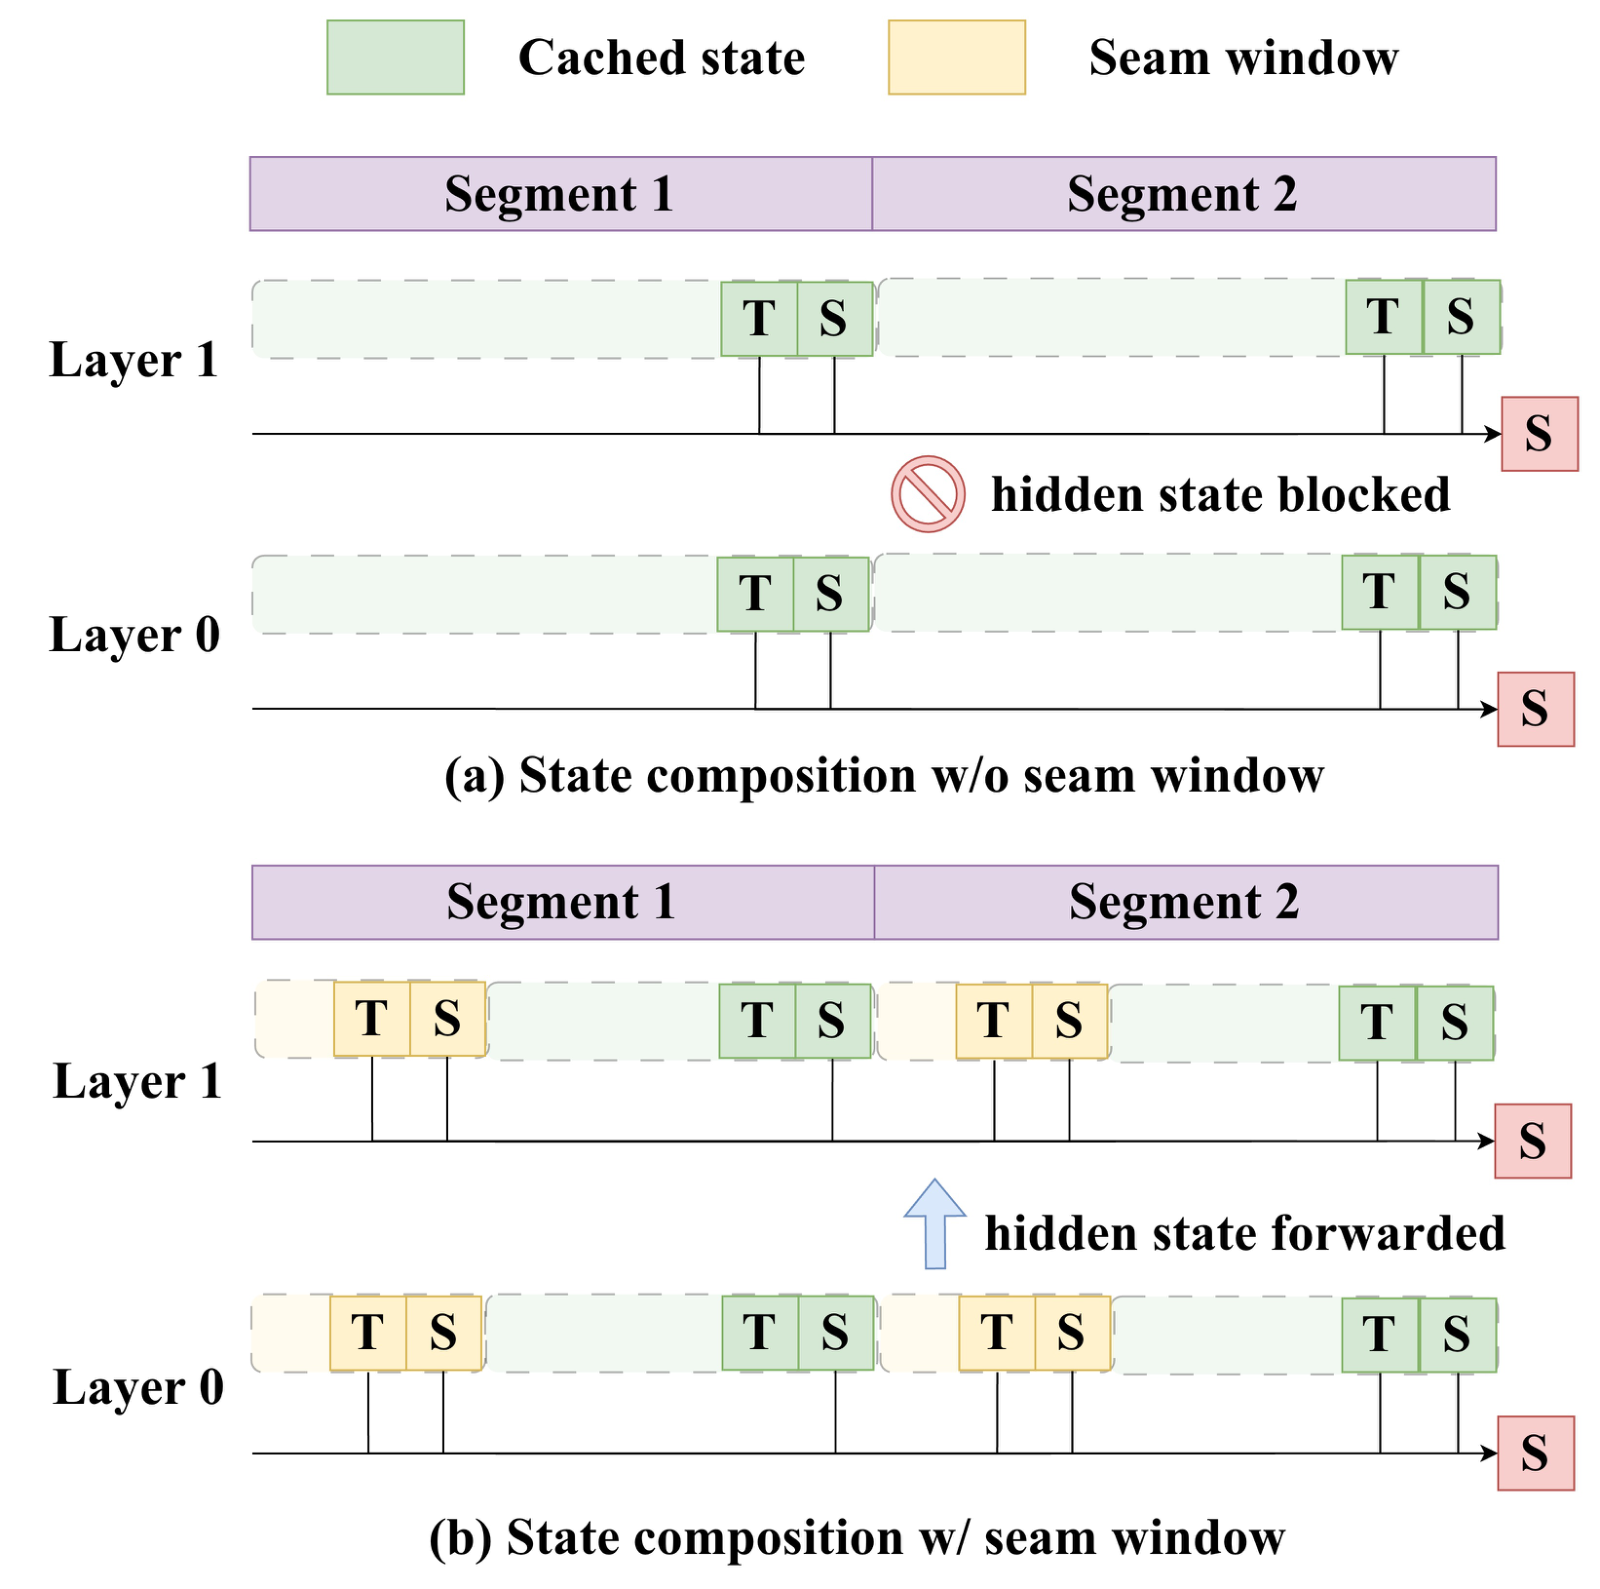
原文 Fig. 8,PDF p. 8。上半图只有段末状态,无法为高层提供待修正 token 的隐藏状态;下半图在线计算黄色窗口,输出可继续向上传递。它同时解决“全注意力要修正哪些 token”和“这些 token 如何通过线性层”两个问题。
这也解释了为何仅给全注意力层增加重算逻辑不够:修正所需的表示路径贯穿整个混合堆栈。seam 之后的段体仍使用独立预填充时的隐藏表示,因而保留前述上下文近似。
6. 因果卷积与 RoPE 必须一起处理
若 QKV 路径含宽度为 $k$ 的因果卷积,当前段开头需要前段最后 $k-1$ 个 token 的输入。HYPIC 缓存段尾卷积状态,并在线重算开头 $k-1$ 个 token;当 $w\ge k-1$ 时,这一步被 seam 重算自然覆盖。只拼主循环状态而忽略卷积边界,仍会引入额外偏差。(Sec. 4.2–4.3,PDF pp. 7–8。)
对于带 RoPE 的全注意力 key,从旧起点 $a$ 移到新起点 $b$,使用
public pool 用段内零起点保存 K,复用时旋转到请求中的全局位置并写入 private slots;V 不需 RoPE 变换,Q 由当前隐藏状态重新生成。不同请求可能把同一段放到不同位置,因而需要各自的旋转后 K 副本。(Eq. (8),PDF p. 8。)
对线性层,论文给出的状态重旋转 $S_{C\mid b}=R(b-a)S_{C\mid a}$ 适用于其讨论的标量转移情形:$\gamma I$ 与旋转矩阵可交换。这里 Eq. (7) 的 $a,b$ 标记段的起始位置,应与 $S_{C\mid0}$ 中“零初态”的语义结合具体上下文区分。不能把这一简式不加条件地推广到任意不与旋转交换的稠密转移。(PDF p. 7。)
7. 冷段并行:把独立缓存构建变成调度单位
没有命中的段也可以独立预填充。因此,一个包含 $n$ 个冷段的请求可以先 scatter,再 combine:各 worker 只读各自段的 token,生成二元组和局部 KV;combine worker 接收新算结果及其他节点上的命中缓存,再做状态组合和 seam 修正。
设各段长度近似为 $|C|$、有 $m$ 个 worker,论文用
描述关键路径,$c$ 表示组合开销。这是面向调度的简化模型;混合堆栈中的全注意力、KV 传输与 seam 读取仍会影响真实时间。它表示段并行可缩短冷请求延迟,而非整个模型对任意长度严格线性。(Sec. 4.4,PDF pp. 8–9。)
段长不均衡时,Router 使用最长处理时间优先(Longest-Processing-Time-first,LPT):将冷段按 token 数降序排列,每次给当前累计 token 最少的 worker。其优化目标为
这是以 token 数近似计算量的贪心调度,不是对任意硬件耗时的精确最优求解。每个 worker 完成一段就立即发起非阻塞传输,再计算下一段,以避免等所有段完成后集中发送。实现通过 NIXL 发起单边 GPUDirect RDMA 写入,combine worker 预先分配目标槽位。论文指出段长至少约 1024 token 时逐段执行仍能保持较好的内核效率。(Eq. (9)、Sec. 5,PDF p. 9。)
段并行在实例之间分工;张量并行(TP)仍可在实例内部工作。二者可以组合,但冷请求扩展使用更多实例,实际部署需要同时考虑其他请求排队、缓存容量和资源占用。
三:实验——每个结果究竟比较什么
1. 模型与硬件
所有实验运行在一台 8×NVIDIA H20-3e 节点上,每卡 141 GB HBM、18-link NVLink,主机配有 120 个物理 CPU 核、2 TB DDR5 及 RDMA 网卡。系统约 14k 行 Python/Triton,构建于 SGLang。(Secs. 5、6.1,PDF pp. 9–10。)
| 模型 | 线性层转移类型 | Figs. 10–11 标注的实例 TP |
|---|---|---|
| Ring-mini-linear-2.0 | 标量衰减 | 1 |
| Ring-flash-linear-2.0 | 标量衰减 | 4 |
| Qwen3.5-35B-A3B | 稠密转移 | 2 |
| Qwen3.5-122B-A10B | 稠密转移 | 4 |
理论表包含 GLA、DeltaNet、KDA 等多种形式;端到端实验实际覆盖上述四个混合模型。冷请求扩展实验另用 TP-1 实例,不应套用这张表的 TP 配置。
2. 数据、指标与缓存状态
| 实验对象 | 测量问题 | 指标与协议 |
|---|---|---|
| HotpotQA、TriviaQA | 问答质量是否保留 | token-level F1,越高越好 |
| MultiNews、GovReport | 摘要质量是否保留 | ROUGE-L,越高越好 |
| 4 个模型 × 上述 4 个任务 | 热缓存的速度—质量取舍 | 所有段预热;p50 TTFT,越低越好 |
| Prod-RAG | 真实请求负载下服务容量 | 预热 10 分钟,缩放到达率;仍有内容更新和淘汰引起的 miss |
| Prod-RAG 特征 | 解释缓存复用机会 | 平均输入约 12k token,含约 2k 系统提示;到达突发、文档热度长尾 |
| 全冷合成设置 | 冷段并行扩展 | 32k token 分成 8 段,所有检索段未命中 |
TTFT 从请求到达到生成首 token,既包含计算,也受排队影响;QPS 是每秒请求数;吞吐是每 GPU 每秒处理 token 数。论文没有在吞吐定义中进一步拆分输入 token 与输出 token,因此不应把图中的 token/s/GPU 简写为“生成速度”。Fig. 11 使用 p50 TTFT,1 秒 SLO 下的 QPS 比较也据此读取。(Sec. 6.1–6.2,PDF pp. 10–11。)
3. 基线的角色
| 方法 | 复用机制 | 用来回答的问题 |
|---|---|---|
| Full Recompute | 整个提示词重新预填充 | 标准完整上下文行为和计算成本参考 |
| Prefix Cache | 仅精确前缀命中 | 与现有混合模型服务方式比较 |
| Naive Addition | 只缓存段末状态并相加;全注意力不重算 | 直接移植段缓存的失败程度 |
| HYPIC | 缓存 $T_C$、组合状态、8-token seam | 完整系统的速度和质量 |
Full Recompute 是参考结果,不是任务分数的严格数学上界:采样/解码及任务评分允许近似方法偶尔得分更高。Naive Addition 同时没有转移算子和 seam,因而它与完整 HYPIC 的差距不能全部单独归因于 $T_C$。状态公式提供了遗漏 $T_C$ 的直接机制解释,但要量化两个模块各自的端到端贡献,仍需分开控制。(Sec. 6.1,PDF p. 10。)
四:结果——收益来自哪里,证据支持到哪里
1. Sec. 6.2:热缓存速度提升稳定,质量差异依模型而变
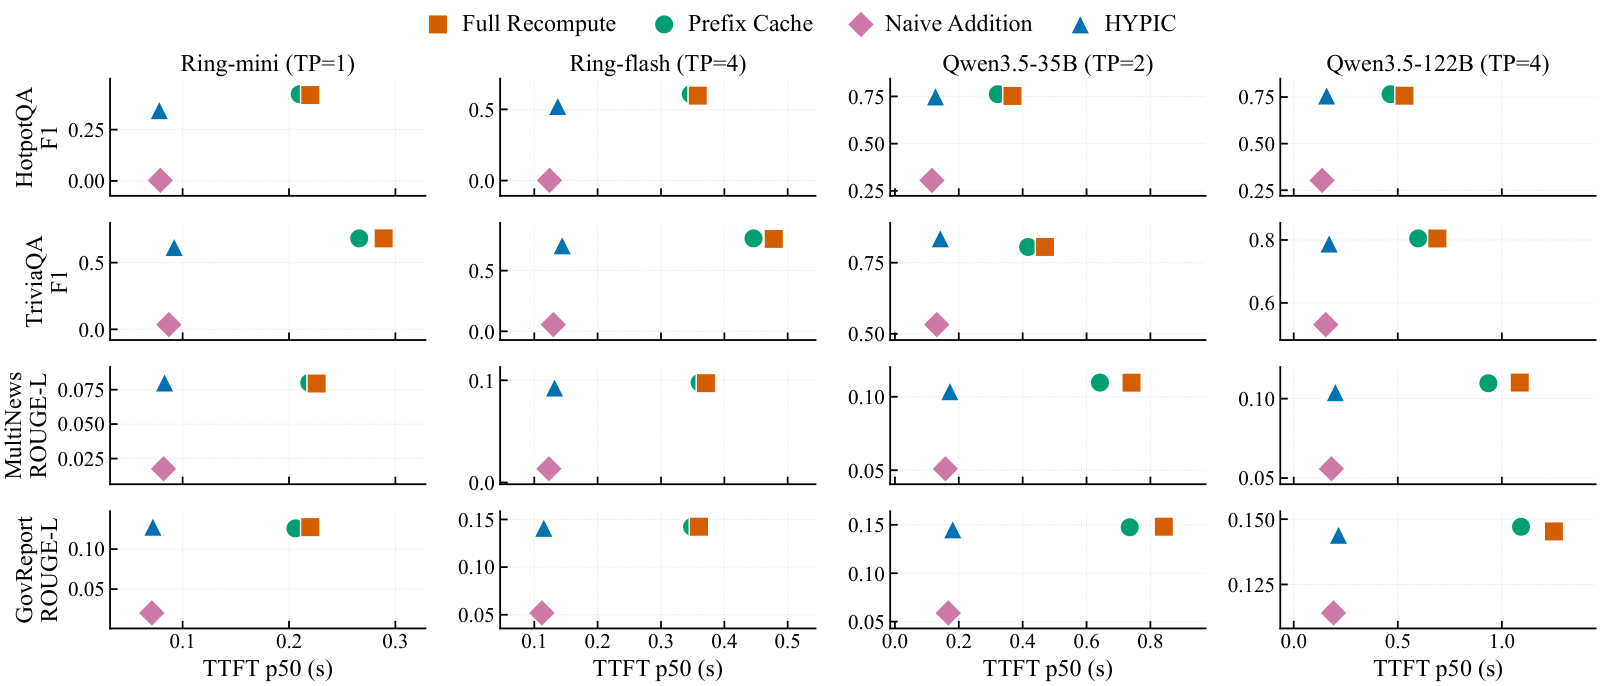
原文 Fig. 10,PDF p. 10。四列对应模型,四行依次为 HotpotQA、TriviaQA、MultiNews、GovReport;横轴是 p50 TTFT,越左越快,纵轴为对应任务得分,越高越好。HYPIC 蓝色三角显著左移,同时比 Naive Addition 更接近完整重算的质量。
| 模型 | TTFT 加速 / Full Recompute | TTFT 加速 / Prefix Cache | HYPIC−Full Recompute 得分差 |
|---|---|---|---|
| Ring-mini | 2.94× | 2.77× | −3.44 分 |
| Ring-flash | 2.97× | 2.85× | −3.29 分 |
| Qwen3.5-35B | 3.79× | 3.32× | +0.47 分 |
| Qwen3.5-122B | 4.67× | 4.05× | −0.56 分 |
来源:Sec. 6.2,PDF pp. 10–11。每模型的数值汇总四个公开任务;四个模型相对 Prefix Cache 的报告加速比平均约为 3.25×。将 16 个模型—任务组合的分数差汇总,平均为 −1.71 分。图上分数按 0–1 绘制,文中的“分”对应乘以 100 后的绝对差,混合了 F1 与 ROUGE-L;这个平均数适合概括整体质量偏差,不能代替每个应用自身的容忍阈值。
Naive Addition 按作者汇总损失了 Full Recompute 分数的 66.9%,这是相对分数损失,与上表的绝对分数差口径不同。两项修正使 PIC 从严重失真变为接近标准模型,但 Ring 系列仍有更明显的质量代价。
2. Sec. 6.2:负载下 QPS 与峰值 token 吞吐都改善
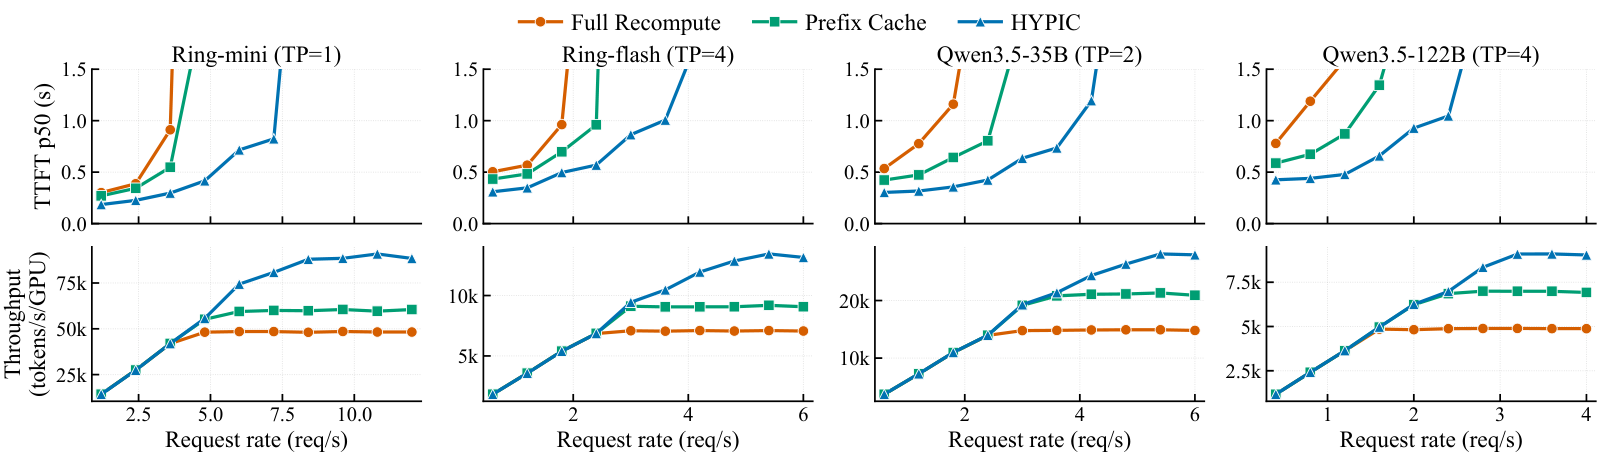
原文 Fig. 11,PDF p. 11。上排横轴是请求率、纵轴是 p50 TTFT;曲线上升加快表示服务逐渐饱和。下排是在相同请求率轴上的每 GPU token 吞吐。比较某个延迟门槛允许的 QPS,与比较整条曲线的峰值吞吐,是两个不同指标。
| 模型 | 1 秒 p50 TTFT 下 QPS / Prefix | QPS / Full | 峰值吞吐 / Prefix | 峰值吞吐 / Full |
|---|---|---|---|---|
| Ring-mini | 1.85× | 2.01× | 1.50× | 1.87× |
| Ring-flash | 1.49× | 1.98× | 1.46× | 1.89× |
| Qwen3.5-35B | 1.58× | 2.55× | 1.32× | 1.88× |
| Qwen3.5-122B | 1.71× | 3.65× | 1.30× | 1.86× |
相对 Prefix Cache 的四个 QPS 比值平均约 1.66×。这些结果说明复用降低了重复预填充压力,并提高负载容量;Fig. 11 没有提供 p95/p99 延迟或满足 1 秒门槛的请求比例,所以不能将其解读为“尾延迟已经被保证在 1 秒以内”。
3. Sec. 6.3:状态复用成本主要随段数变化
固定 4 个段,把每段从 1k 增至 4k token,Full Recompute TTFT 从 0.141 秒增至 0.624 秒,HYPIC 从 0.103 秒增至 0.127 秒,加速由 1.37× 增至 4.91×。固定每段 1k,把段数从 4 增至 16,每新增一段,HYPIC 约增加 2.3 ms,Full Recompute 约增加 40.7 ms;16 段时加速约 4.80×。(Fig. 12,PDF p. 11。)
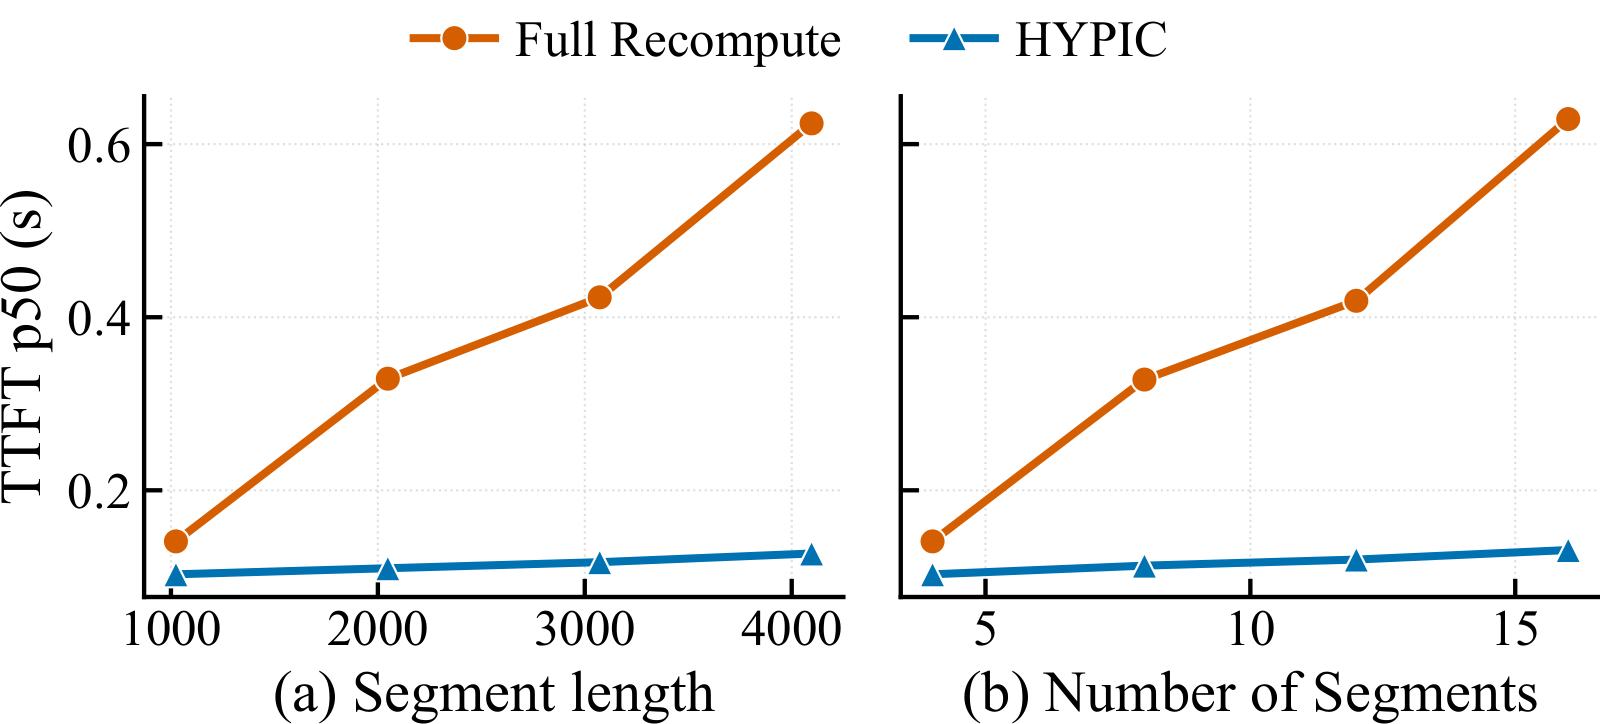
原文 Fig. 12,PDF p. 11。左图改变段长、右图改变段数,两图纵轴均为 p50 TTFT。段长增长对 HYPIC 的影响弱得多,符合缓存段体不再逐 token 递推的机制;段数增长仍带来组合与窗口处理,因此斜率并非零。
缓存构建也有成本。Qwen3.5-35B-A3B 在 256–4096 token 段长上,额外的 transition/state construction 占主前向时间约 5.2%–6.7%;Fig. 13 中五个段长的标注依次为 5.2%、5.4%、5.2%、5.4%、6.7%。这是首次构建付出的额外成本,通过后续重复命中摊销。(PDF p. 11。)
4. Sec. 6.3:深层漂移存在,实验没有给出普遍误差上界
原文用 512-token、两段提示词比较最深线性层的组合状态与完整重算。为隔离线性层误差来源,实验关闭了全部全注意力层。
| 模型 | 最深线性层相对 $L_2$ 误差 | 角度误差 |
|---|---|---|
| Qwen3.5-35B-A3B | 8.92% | $5.11^\circ$ |
| Ring-flash | 8.69% | $4.98^\circ$ |
来源:Table 4、Sec. 6.3,PDF p. 12。它验证了独立段隐藏状态的差异会在深层留下可测漂移,与第 0 层接近浮点噪声的结果形成对照。作者用“在 10% envelope 内”描述这两个测量值;这不是对任意长度、任意前缀的已证明误差界,也不是完整混合堆栈上的全注意力修正实验。
5. Sec. 6.4:8-token seam 是所测两组任务的实用折中
作者在 Qwen3.5-35B/MultiNews 和 Qwen3.5-122B/GovReport 上比较窗口宽度,报告 $w=8$ 的 ROUGE-L 分别为 0.1164 和 0.1418,较大窗口提高 TTFT,却没有稳定增加质量。
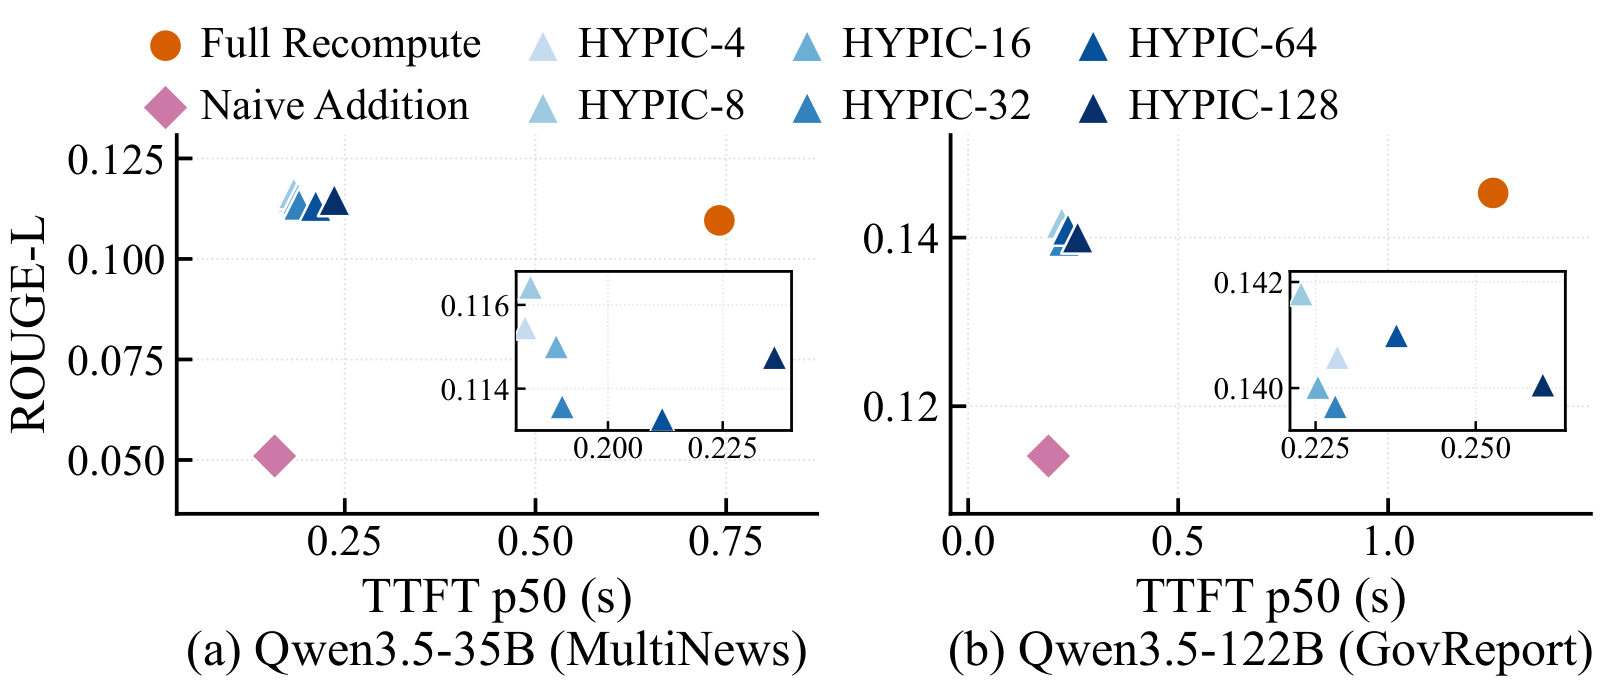
原文 Fig. 14,PDF p. 12。横轴是 p50 TTFT,纵轴为 ROUGE-L,图中插图放大多个 HYPIC 点之间很小的差异。
v2 的实验呈现有一处实质不一致:正文写扫描 $w\in\{0,4,8,16,32\}$,但图例实际列出 HYPIC-4/8/16/32/64/128,没有明确的 HYPIC-0。Naive Addition 同时缺少 $T_C$ 和 seam,不能代替“保留正确转移组合但 $w=0$”的消融。因此,可以据此接受 $w=8$ 在所示两组结果中有较好的速度—质量折中,但无法从该图完整重建正文所述扫描,也不能单独量化从 0 到 8 的纯 seam 收益。
6. Sec. 6.5:冷段并行主要缩短 scatter 关键路径
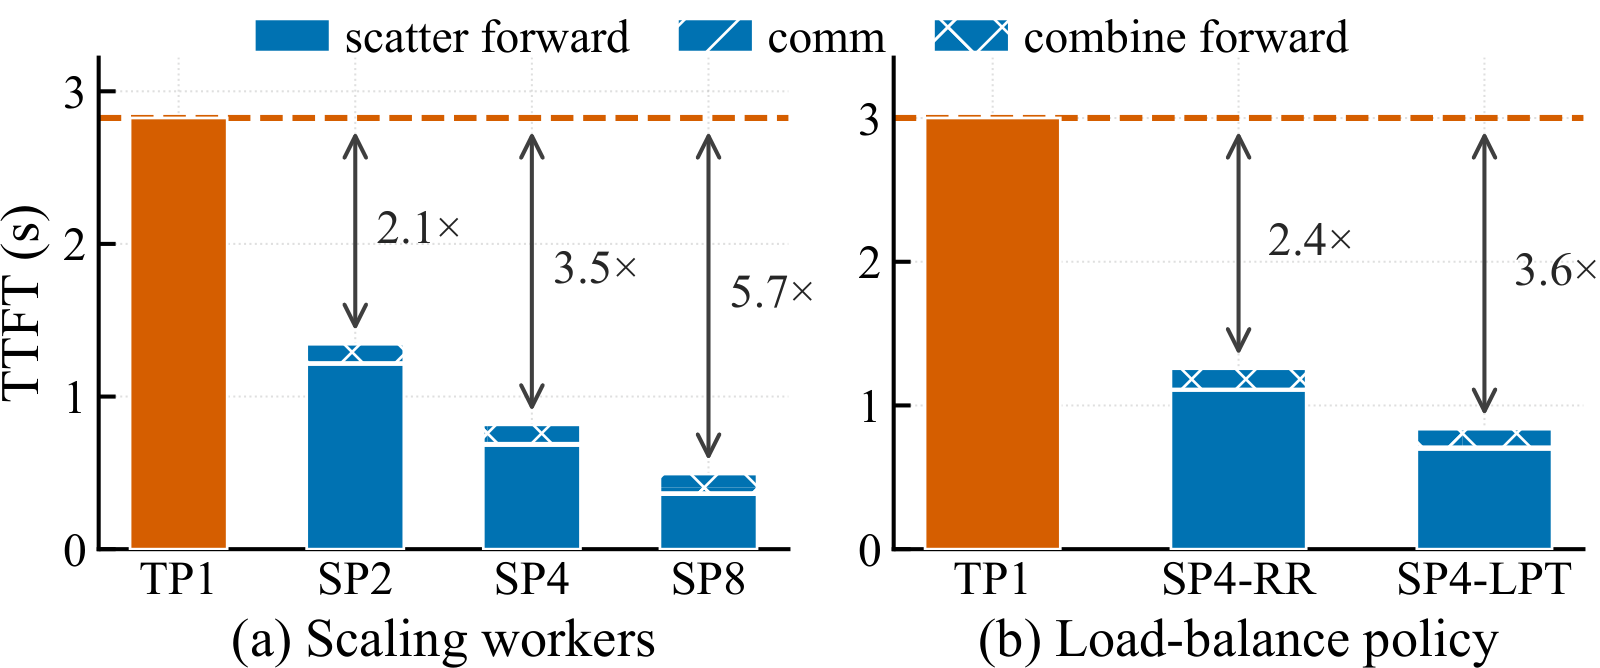
原文 Fig. 15,PDF p. 12。左图改变 worker 数,右图比较 4-worker 的 round-robin 与 LPT;柱子拆成 scatter forward、通信与 combine forward。
| 配置:32k token、8 个等长冷段 | TTFT | 原文报告加速 |
|---|---|---|
| Full Recompute,单 TP-1 实例 | 2.83 s | 1× |
| HYPIC,2 workers | 1.34 s | 2.1× |
| HYPIC,4 workers | 0.82 s | 3.5× |
| HYPIC,8 workers | 0.49 s | 5.7× |
2/4/8 worker 的 scatter 时间分别约为 1.21/0.68/0.36 秒;通信保持约 12–15 ms,combine 约 120 ms。总时间和组件经过各自舍入,不能要求逐项精确相加。使用展示到小数点后两位的 2.83/0.49 会算出约 5.78;5.7× 是作者报告的倍数。
改为 8 个不等长段时,4-worker round-robin 的总 TTFT 为 1.26 秒,LPT 为 0.84 秒;scatter 从 1.10 秒降至 0.69 秒。按这两组展示值,LPT 相对 round-robin 再快约 1.50×,收益主要来自减轻最慢 worker 的负担。
这个结果直接支持“PIC 的独立段可以成为跨实例的并行单元”。它使用更多模型实例降低单请求延迟,并非等资源下的 5.7× 计算效率提升;而且通信测量来自论文的单节点 H20 环境,多节点带宽和共享负载会改变流水线的实际收益。
五:结论——最有价值的是重新定义可复用的计算单元
HYPIC 的核心启发是:压缩记忆系统想复用一段计算,需要同时保存它产生的内容与它对已有记忆的作用。在线性递推中,这恰好对应 $(T_C,S_{C\mid0})$。这个表示让“从不同前缀继续运行”变成明确的代数操作,并消除了直接相加遗漏遗忘与擦除的结构错误。
第二个启发是,缓存修正策略必须适应整条计算路径。混合堆栈里即便只有少数全注意力层,修正这些层的 token 也要通过下面的线性层。边界锚定的 seam 既提供高价值的修正位置,也提供可廉价恢复循环状态的起点。
第三个启发是,允许独立构建缓存以后,缓存单元同时变成可调度的计算单元。由此不仅热命中受益,冷请求也能通过 scatter/combine 缩短关键路径。
在应用上,最适合的是段边界明确、内容会重复出现、文档段足够长的 RAG/多文档任务。部署判断应优先看自身的任务质量、段长分布与缓存命中率,以及额外状态和 private K 副本的内存成本。论文的端到端结果表明这一组合值得采用,但实证中的约 9% 深层状态漂移、Ring 模型较大的分数损失,以及更多实例换取冷请求低延迟,都是实际取舍的一部分。
后续最有信息量的验证是:补齐“正确 $T_C$、无 seam”的独立消融,在更多段数与更长上下文上测量漂移,并在相同集群预算和缓存容量下报告 p95/p99 延迟、SLO 满足率及多节点冷段并行表现。这些实验能进一步区分代数组合、边界修正和调度各自带来的收益。