Self-conditioned Flow Map Language Models via Fixed-point Flows:中文研读笔记
作者:Jaehoon Yoo、Wonjung Kim、Floor Eijkelboom、Chanhyuk Lee、Nicholas M. Boffi、Seunghoon Hong、Jinwoo Kim。机构为 KAIST、University of Amsterdam 和 Carnegie Mellon University。
版本:arXiv:2607.00714v2,2026-10-01 修订;本次获取与研读日期为 2026-10-14。方法记作 FMLM$^\star$,应与论文对照中的原始 FMLM 区分。
arXiv 原文 · 本地论文 PDF · 英文汇报 PDF · 可编辑幻灯片 · 作者代码链接
论文总览
连续流语言模型在连续嵌入空间里生成整段文本:从噪声开始,多次预测干净文本的嵌入,再沿生成时间更新状态。自条件(self-conditioning)把上一次去噪预测送回模型,通常能提高质量,却也让下一步依赖额外的历史状态,使“一次调用跨越多个时间步”的流映射蒸馏不容易直接套用。
本文的核心是把计算拆成两个方向:固定时间和含噪状态,反复修正预测;然后推进生成时间。 前者被解释为不动点迭代。若能用一个网络直接预测迭代终点,便得到不再依赖历史自条件输入的去噪器;再把其生成轨迹蒸馏成流映射,就得到 FMLM$^\star$。文中的“二维”指生成时间与迭代次数两个计算方向,实际文本状态仍位于高维嵌入空间。
主要结果集中在 OpenWebText、长度 1024 的文本生成。在相同步数下,离线 FMLM$^\star$ 的单步 gPPL 为 113.91,原 FMLM 为 168.30;同时平均样本词元熵从 5.17 提高到 5.37 nats,接近数据的 5.44。在线方案用 8 次教师不动点迭代生成训练目标,把论文报告的蒸馏训练时间从 82 小时降至 23 小时,代价是生成质量略逊于离线方案。(Sec. 4.2,PDF p. 9,Table 1;Appendix C.2,PDF p. 23,Table 3。)
这篇论文值得注意的贡献是把“保留历史预测”改写为“为一个局部迭代提供初值”,由此把自条件模型接入流映射蒸馏。理论上的收敛依赖收缩假设;不动点是否带来更好的语言生成,则由实验检验。
结构地图
以下页码均为从 1 开始的 PDF 页码,与本版本印刷页码一致。
| 原文章节 | 作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 问题、贡献与整体路线 | pp. 1–2,Fig. 1 |
| 2 Preliminary | 连续流、去噪器与流映射 | pp. 2–3,Eqs. (1)–(5) |
| 3.1 Self-conditioned flow language models | 自条件训练与采样;Bayes 最优目标 | pp. 3–4,Proposition 3.1 |
| 3.2 Self-conditioning induces a fixed-point iteration | 迭代、收缩与误差界 | pp. 4–5,Proposition 3.3 |
| 3.3 Fixed-point flows | 消去历史状态;冷启动、热启动;第一种蒸馏 | pp. 5–6,Eqs. (13)–(18) |
| 3.4 Fixed-point flow maps | 双时间去噪器与半群蒸馏 | pp. 6–7,Propositions 3.5–3.7 |
| 4.1 Analyzing self-conditioned flow language models | 不动点行为及初始化作用 | p. 8,Figs. 2–3 |
| 4.2 Distilling self-conditioning into fixed-point flow maps | ELF$^\star$、FMLM$^\star$ 与基线比较 | p. 9,Table 1、Figs. 4–5 |
| 5 Related Work;6 Conclusion | 与既有不动点视角、流映射工作的关系 | pp. 9–10 |
| A Proofs and Theoretical Results | 最优性、近似收缩、收敛及半群公式证明 | pp. 13–20 |
| B Experiment Details | 迭代器、蒸馏目标、训练及采样配置 | pp. 21–22 |
| C Additional Results | 迭代次数与在线训练成本的数值结果 | pp. 22–23,Tables 2–3 |
| D Qualitative results | 固定状态下的修正与少步生成样例 | pp. 23–27,Figs. 6–9 |
一:动机——自条件为什么妨碍直接学习流映射
普通流模型的速度可以写成 $b_t(\mathbf x)$:知道当前时间与状态,就能确定如何继续前进。因此它有一个解算子 $X_{s,t}(\mathbf x)$,表示从时间 $s$ 的状态直接移动到 $t$。学习这个解算子,可以把许多小步积分替换成一次大步预测。
自条件采样则还维护一份预测 $\mathbf z$。两个样本即便在相同时间到达相同的 $\mathbf x$,若历史预测不同,下一次去噪结果也可能不同。于是,以 $\mathbf x$ 为唯一状态的普通流映射描述就不再直接适用。
作者选择把 $\mathbf z$ 解释为某个局部求解过程的中间值。充分迭代后,如果 $\mathbf z$ 的极限只由 $(t,\mathbf x)$ 决定,就可以把历史依赖吸收到一个函数 $D_t^\star(\mathbf x)$ 中。实际采样保留上一时刻预测,是为了更快接近这个极限。
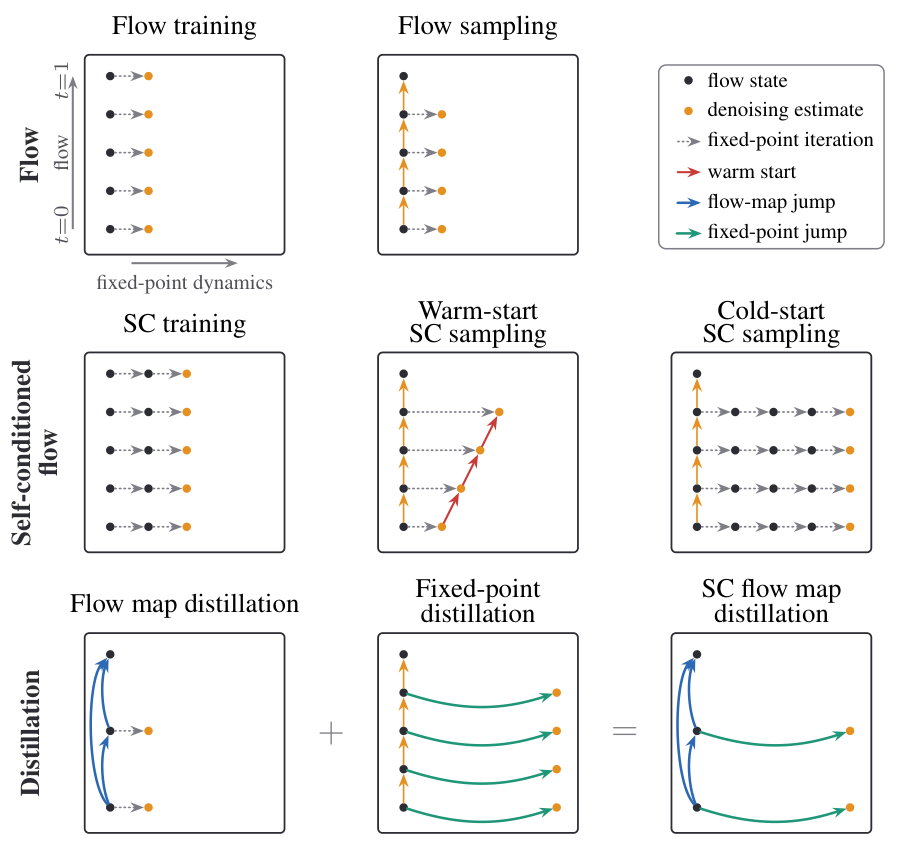
原文 Fig. 1,PDF p. 2。按从上到下的三行阅读:普通流、自条件流、蒸馏。纵向为生成时间,横向为预测修正;红箭头表示热启动,蓝箭头压缩时间方向,绿箭头压缩不动点方向。图中“流映射蒸馏 + 不动点蒸馏”是全文的方法主线。
这一视角有明确的继承关系:Sec. 5 提到 Gulrajani 与 Hashimoto(2023)已经从不动点角度讨论自条件去噪器。本文进一步把它发展成不动点流及其流映射,并给出可实施的双重蒸馏方案。(PDF pp. 9–10。)
二:方法——从自条件迭代到少步生成
2.1 基础对象与输入输出
| 符号 | 含义 |
|---|---|
| $L,d$ | 序列长度、每个 token 的连续嵌入维度 |
| $\mathbf x_0,\mathbf x_1\in\mathbb R^{L\times d}$ | 噪声、干净文本嵌入 |
| $I_t=(1-t)\mathbf x_0+t\mathbf x_1$ | 训练用线性随机插值 |
| $D_t(\mathbf x)$ | 理想的条件均值去噪器 |
| $\hat D_t(\mathbf x,\mathbf z)$ | 学到的自条件去噪器 |
| $\mathbf z^j,\mathbf z^\star$ | 同一 $(t,\mathbf x)$ 下第 $j$ 次预测及其不动点 |
| $D_t^\star(\mathbf x)$ | 学到的去噪器的固定点函数,通常不等于理想 $D_t$ |
| $b_t^\star,X_{s,t}^\star$ | 不动点速度及对应流映射 |
| $\delta_{s,t}(\mathbf x)$ | 以源时间 $s$、目标时间 $t$ 为条件的双时间去噪器 |
理论公式用平方欧氏范数;把 $L\times d$ 数组展平后,也就是相应的 Frobenius 范数。时间变量无量纲,去噪器输出、流状态与自条件状态处于同一连续空间。生成末端通过文本解码器转回离散 token。
理想去噪器与速度的关系为
因为 $\mathbf x_1-I_t=(1-t)(\mathbf x_1-\mathbf x_0)$,对给定 $I_t$ 取条件期望就得到这个速度公式。去噪器预测“干净端在哪里”,除以剩余时间后成为瞬时速度。Euler 采样再执行
训练中的随机插值 $I_t$ 与推理时 ODE 的状态 $\mathbf x_t$ 扮演不同角色;理想流使它们具有同一时刻的边缘分布。(Sec. 2,PDF pp. 2–3,Eqs. (1)–(5)。)
2.2 自条件改变了计算方式,Bayes 目标保持不变
常见训练方式以一半概率不给自条件,以另一半概率喂入模型自己的初次预测:
$\operatorname{sg}$ 表示停止梯度。第二项训练模型在自己的预测基础上继续修正,但内层那次预测不接收该项反传的梯度。(Eq. (7),PDF p. 4。)
Proposition 3.1 的条件是 $\mathbf z\perp\mathbf x_1\mid I_t$ 且二阶矩有限:自条件不能携带当前含噪输入之外的目标信息。于是有平方损失分解
第一项是不可消除的条件方差,第二项是模型偏离最优预测的误差。因此,在不限制函数表达能力的总体优化中,最优输出仍为 $D_t(I_t)$。这个等式是在训练分布的支持上几乎处处成立;它没有把未见过的所有自条件输入都约束住。(Proposition 3.1,PDF p. 4;Appendix A.1,p. 13。)
实际网络容量和优化有限,输出仍依赖 $\mathbf z$。作者的解释是:两种训练输入诱导出“先给初稿,再修正初稿”的计算习惯。自条件的收益来自这类可学习的计算结构。
2.3 不动点迭代:收敛到哪里,依赖什么条件
固定 $t$ 和 $\mathbf x$,只更新预测:
若 $f(\mathbf z)=\hat D_t(\mathbf x,\mathbf z)$ 在非空闭集 $O$ 上满足
Banach 不动点定理给出唯一不动点与几何收敛:
这也解释了初始化的价值:在 $0<\eta<1$ 且初始误差大于容差 $\varepsilon$ 时,达到精度所需次数可由
保证。越好的初值,需要的迭代越少。(Sec. 3.2,PDF pp. 4–5;Appendix A.3,pp. 15–17;A.5,p. 18,Eq. (37)。)
收敛误差与去噪误差要分开理解。 Proposition 3.3 还给出
以及不动点处把系数换成 $\eta/(1-\eta)$ 的界。它控制迭代结果相对 Bayes 目标的偏差,但右侧的追加项随 $j$ 增大,并没有推出“去噪误差逐次下降”。正文的生成质量改善结论依赖后面的实证结果。(Eqs. (11)–(12),PDF p. 5。)
一个教学反例可以看清这个区别:令目标为 0、$f(z)=z/2+1$、$z^0=0$。它是收缩率 $1/2$ 的映射,序列 $1,1.5,1.75,\ldots$ 收敛到 2,却逐渐远离目标 0。这个例子仅说明收缩条件的逻辑范围,不描述论文中的实际网络。
Appendix A.2 进一步说明低自条件损失为何支持一种尺度以上的近似收缩。对简化目标
这里 $X$ 固定,$f$ 连续,$O$ 非空且闭,$Z\sim\mu$ 满足 $\mu(O)=1$,并取 $0
满足 $\mu(A\cap f^{-1}(A))\geq1-\varepsilon$。对其中间距至少为 $w$ 的两点,还能由
得到收缩式不等式。这里有尺度门槛和训练分布下的概率条件;任意小尺度的收缩与整个集合的确定性前向不变仍是更强的要求。因而正文将严格收缩单独作为后续分析假设。(Appendix A.2,PDF pp. 13–15。)
2.4 不动点流:把自条件历史吸收到当前状态函数里
定义
一旦不动点唯一,$D_t^\star$ 就只依赖 $(t,\mathbf x)$。于是 $\dot{\mathbf x}_t=b_t^\star(\mathbf x_t)$ 成为通常的时变 ODE。在理想情况下 $D^\star=D$,它还恢复原始数据流;对于学到的网络,不动点首先代表教师网络的稳定预测。(Proposition 3.4,PDF p. 5,Eqs. (13)–(15)。)
两种采样方式由内层迭代的初值区分:
| 方式 | 每个外层时间步的初值 | 含义 |
|---|---|---|
| 冷启动(cold start) | $\mathbf z^0_{t_i}=\mathbf0$ | 每次重新求该状态的不动点 |
| 热启动(warm start) | $\mathbf z^0_{t_i}=\hat{\mathbf z}^\star_{t_{i-1}}$ | 复用前一时间步的估计,以减少迭代 |
| 常规自条件采样 | 热启动,再仅做一次内层更新 | 把跨步历史用作局部求解器初值 |
热启动节省迭代的直觉依赖相邻流状态的不动点彼此接近;在收缩域内充分迭代,两种初始化会走向相同的不动点。有限迭代时,采样质量仍会受初值影响。(Sec. 3.3,PDF p. 6,Eqs. (16)–(17)。)
以下为依据论文公式整理的教学伪代码,$N$ 为流步数,$K$ 为每步内层迭代次数:
x ← 采样噪声;previous_z ← 0
for i = 0, ..., N-1:
    z ← previous_z(热启动)或 0(冷启动)
    repeat K times:
        z ← D_hat(t_i, x, z)      # 保持 t_i 与 x 不变
    x ← x + (t_{i+1}-t_i) * (z-x)/(1-t_i)
    previous_z ← z
return decode(x)
由这一结构估算,未蒸馏时内层去噪调用数随 $N\times K$ 增长。增加不动点迭代可以换取质量,随后要靠蒸馏把这部分额外计算压缩下来。
2.5 第一种压缩:把内层求解蒸馏成 ELF$^\star$
最直接的目标是学习单次预测不动点的函数:
$\mathbf z^\star$ 可以由教师反复迭代近似。论文实际离线方案采用一致性深度平衡蒸馏(CDEQ),得到 ELF$^\star$。它压缩的是同一个时间点内的多次修正,仍然可以用许多流时间步生成文本。(Eq. (18),PDF p. 6;Appendix B.2,p. 21。)
具体做法是:冻结教师,用 20 次 Anderson 加速迭代生成 $\mathbf z^0,\ldots,\mathbf z^{20}$,把最后一个结果视作目标;给不同迭代位置分配一致性时间 $\tau_j$,使学生从不同中间预测出发都指向同一终点。其参数为
$P_j$ 是两次学生评估的两点 Anderson 组合。训练另以 0.25 的概率直接将 $g_0$ 回归到终点。教师 Anderson 求解器使用 history 3、mixing 0.9、regularization $10^{-4}$;学生两点组合的 mixing 为 1.0。
学生从教师初始化,保留解码头,并在原有时间和 guidance 前缀外增加四个 $\tau$ 前缀 token。推理时固定 $\tau=\tau_0$、自条件输入置零,每个流时间步只评估一次学生。这里训练时两次学生调用的构造与最终单次调用的推理方式应分开。(Appendix B.2,PDF p. 21。)
2.6 第二种压缩:从局部速度学习跨时间的流映射
在 ODE 解唯一的区间,不动点流映射满足
第二式是半群一致性(semigroup consistency):直接从 $s$ 到 $t$,应与先到 $u$ 再到 $t$ 相同。ODE 的唯一解是额外条件;自条件变量方向上的收缩本身没有给出关于流状态的全部正则性。(Proposition 3.5,PDF p. 6;Appendix A.6,p. 18。)
作者通过双时间去噪器参数化它:
$v_{s,t}$ 是整段路径的平均速度。它让同一个网络在短时间跨度上学习局部去噪,在长跨度上学习大步跳跃。解出流映射可得
在对角线上,用瞬时速度定义 $v_{t,t}=b_t^\star$,所以
注意 $s=t$ 时流映射本身是恒等映射,但双时间去噪器仍预测干净端。这使对角线能提供有意义的教师监督。(Eqs. (21)–(24),PDF pp. 6–7。)
半群条件等价于
这两个系数来自将两段流映射代入并整理,不能任意取平均。例如教学设置 $s=0,u=0.5,t=0.75$ 时,权重分别是 $1/3$ 与 $2/3$。(Eq. (25),PDF p. 7;Appendix A.7,pp. 18–20。)
对应训练目标为
第一项把两段跳跃压成一段;第二项把局部行为锚定到教师不动点,避免只让学生与自己保持一致。Proposition 3.7 表明真双时间去噪器具有零损失,零损失解在训练分布上满足这些恒等式。实际实现中,中间状态由当前学生的 $\delta_{s,u}$ 代入恢复式计算,两次构造目标的学生评估都停止梯度;并不在每个样本上求出精确 ODE 解。(Eqs. (26)–(27),PDF p. 7;Appendix B.3,p. 22。)
理论命题把主要关系写在 $t<1$ 的区间内,以避开速度中的 $1/(1-t)$。实现把端点 $(s,t)=(0,1)$ 也纳入训练。在流映射可延拓到终点的理解下,恢复式给出 $X_{0,1}^\star(\mathbf x_0)=\delta_{0,1}(\mathbf x_0)$,这就是一次调用完成整段生成的入口。
2.7 离线与在线:推理目标相同,教师目标的取得方式不同
| 路线 | 如何获得对角线目标 | 训练流程 | 最终推理 |
|---|---|---|---|
| 离线 | 单次调用已经蒸馏的 ELF$^\star$ | ELF → ELF$^\star$ → FMLM$^\star$ | 双时间学生执行少步生成 |
| 在线 | 冻结 ELF 从零初值做 $K$ 次迭代 | 直接训练 FMLM$^\star$,同时压缩两种计算 | 同样使用双时间学生 |
在线的“8 次 FPI”发生在训练时构造教师目标,包含首次以零自条件输入进行的调用。它不要求单步生成时再运行 8 次教师。(Appendix B.3,PDF p. 22。)
双时间网络沿用 ELF 骨干,把原来四个流时间前缀 token 平分给 $s,t$,共享时间嵌入器。离线、在线训练的对角线样本概率分别为 0.4、0.5;非对角线样本中 $1/32$ 固定为 $(0,1)$。其余时间遵循参数 $(\mu,\nu)=(-1.5,0.8)$ 的 logit-normal 边缘分布,中间时刻 $u$ 取 CDF 坐标中的中点。两类 MSE 分别取均值后等权相加,不能简单把抽样概率当作损失权重。
每个样本的 guidance 权重 $w$ 从 $[0.5,5.0]$ 按 log-uniform 采样,供该样本所有教师、学生调用共同使用,推理时跨步固定。文中半群混合系数 $\gamma$ 与实验的 $\gamma$-sampling 参数同名但含义不同,也都不同于 guidance 权重 $w$。
三:实验——四个问题对应四类证据
3.1 数据、指标与比较口径
全部实验使用 OpenWebText,序列长度为 1024。机制分析使用 256 个样本;蒸馏后的生成比较使用 1024 个样本。(Sec. 4,PDF p. 7。)
gPPL 越低越好,但必须结合多样性看。 它使用预训练 GPT-2 Large 评价生成文本的可预测程度,衡量的是外部语言模型对生成结果的评价;它不同于待测生成器在测试集上的似然困惑度。大量重复或简单文本也能得到很低的 gPPL。
熵采用逐样本的 unigram entropy,再对样本平均,单位为 nats。 它概括一段文本中 token 使用的多样性。论文把真实数据的 5.44 当作参照,而非一味追求更大熵。低 gPPL 与接近数据的熵共同构成主要比较标准;熵也不能直接度量长程语义连贯性。
图中的 frontier 通过扫采样参数得到,横轴为熵,纵轴为 gPPL。同一熵附近更低的曲线,代表更好的质量—多样性取舍。机制实验中 ELF 扫 $\gamma\in\{0,0.5,1,1.5,2\}$;LangFlow 扫 softmax temperature $\{0.8,0.9,1,1.1,1.2\}$。(Appendix B.1,PDF p. 21。)
3.2 模型分工与训练配置
| 模型/方法 | 在本文中的角色 |
|---|---|
| ELF、LangFlow | 机制分析对象,分别代表学习到的嵌入与 one-hot 嵌入上的自条件流 |
| 改造后的 ELF-B | 蒸馏教师;将 T5 编码器替换为 GPT-2 Large 最后一层隐状态,使 tokenizer 与基线匹配 |
| ELF$^\star$ | CDEQ 蒸馏得到的无需跨步自条件输入的去噪器 |
| FMLM$^\star$ | 本文最终的少步流映射模型 |
| Duo + DCD / Di4C;MDLM + SDTT / Di4C | 离散扩散模型及其少步蒸馏对照 |
| 原 FMLM;DFM + PSD / ESD | 连续流映射类对照 |
机制分析的 ELF 结果与蒸馏教师的 frontier 属于不同设置:后者更换了文本编码器,不能直接把两者曲线数值拼成一条模型改进链。(Sec. 4.1–4.2,PDF pp. 8–9;Appendix B.2,p. 21。)
ELF$^\star$ 和 FMLM$^\star$ 各训练 5 epochs,全局 batch size 512,使用 8 张 NVIDIA B200;Muon 优化器组合的峰值学习率 0.002,前 0.5 epoch warmup,推理使用 decay 0.9999 的 EMA。主表中的两步、四步结果分别使用 $\gamma$-sampling 参数 0.75、1.0;八步曲线则扫该参数。(Appendix B.3,PDF p. 22。)
四:结果——机制成立到什么程度,压缩带来什么收益
4.1 Q1:同一状态下的预测确实表现出不动点迭代行为
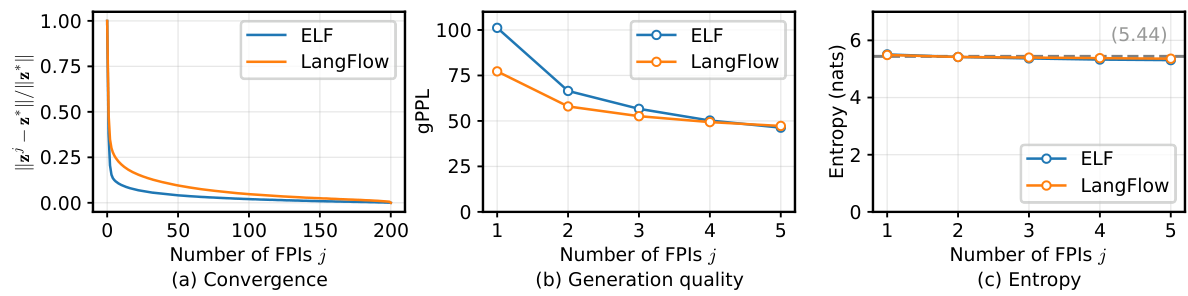
原文 Fig. 2,PDF p. 8。左图横轴为迭代次数,纵轴为相对距离 $\|\mathbf z^j-\mathbf z^\star\|/\|\mathbf z^\star\|$;中、右图分别画生成 gPPL 和熵,灰虚线为数据熵 5.44。ELF 与 LangFlow 均表现出距离逐渐缩小、更多迭代改善生成质量的趋势。
左图使用 256 个训练样本,在 $t=0,0.1,\ldots,0.9$ 共十个时刻构造状态并平均结果;迭代更新为
参照点是同一次迭代的最后结果,所以第 200 次距离为零由定义决定。整条曲线支持向该终点逐渐稳定的解释,不能仅凭终点为零判定严格收缩;这里也没有用未知的 Bayes 最优去噪器作参照。(Appendix B.1,PDF p. 21。)
生成质量实验使用热启动、无阻尼迭代,ELF 为 32 个流步、$\gamma=0$;LangFlow 为 64 个流步、temperature 1.0。附录给出精确值:
| 每个流步的 FPI 次数 | ELF gPPL ↓ | ELF 熵 | LangFlow gPPL ↓ | LangFlow 熵 |
|---|---|---|---|---|
| 1 | 101.19 | 5.51 | 77.26 | 5.49 |
| 2 | 66.50 | 5.42 | 57.99 | 5.42 |
| 3 | 56.67 | 5.37 | 52.63 | 5.40 |
| 4 | 50.25 | 5.33 | 49.37 | 5.38 |
| 5 | 46.31 | 5.31 | 47.27 | 5.36 |
来源:Appendix C.1,PDF p. 22,Table 2。由 1 次增加到 5 次,ELF 的 gPPL 相对下降约 54.2%,LangFlow 约 38.8%;熵也有小幅下降,分别为 0.20 和 0.13 nats。质量改善伴随更多计算:只按内层去噪调用估算,ELF 从 $32\times1$ 增为 $32\times5$,LangFlow 从 $64\times1$ 增为 $64\times5$。这组实验验证修正的价值,为后续蒸馏提供目标。
4.2 Q2:热启动的主要作用是减少达到好预测所需的迭代
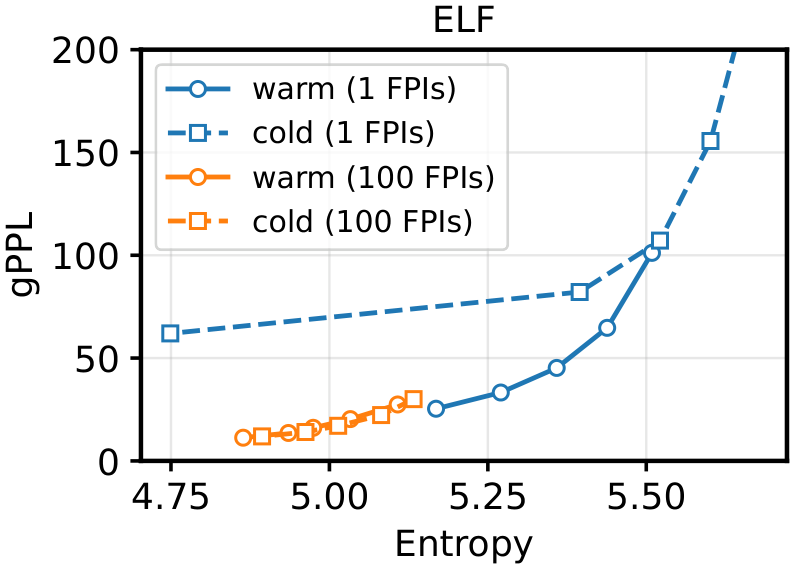
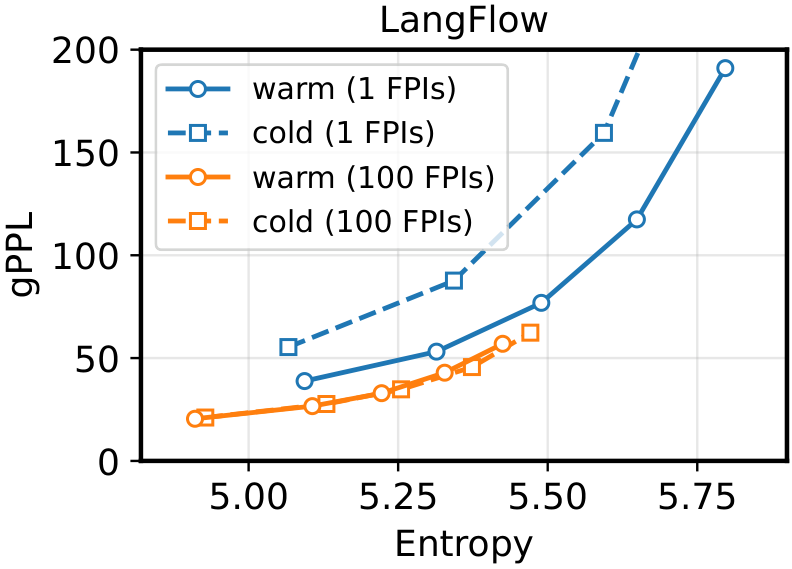
原文 Fig. 3,PDF p. 8,左右面板分别展示。横轴为熵,纵轴为 gPPL;蓝色是每步 1 次迭代,橙色是 100 次;实线为热启动,虚线为冷启动。
1 次迭代时,热启动 frontier 明显优于冷启动;100 次时,两种初始化的 frontier 基本重合。这支持“上一时间步预测提供了好初值”的解释。比较热、冷启动时,外层流步数固定为 ELF 32、LangFlow 64;1 次迭代用 $\alpha=0$,100 次用 $\alpha=0.3$。因此读图应比较同一迭代预算内的两种初始化,区分增加迭代与改变阻尼的因素。(Appendix B.1,PDF p. 21。)
4.3 Q3:不动点蒸馏可以保留教师的质量—多样性取舍
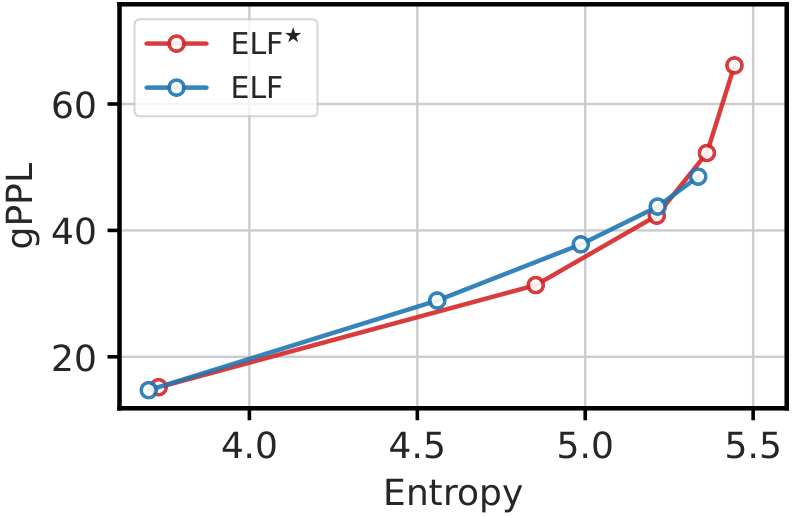
原文 Fig. 4,PDF p. 9。两者均为 32 步生成。ELF$^\star$ 无需保留上一步自条件预测,其 frontier 与教师 ELF 接近,说明教师依赖迭代实现的修正能力可以被压进一次前向预测中。该结果对应“移除自条件状态”这一压缩目标;流时间方向在此仍使用 32 步。
4.4 Q4:再压缩流时间,可以获得有竞争力的单步与少步模型
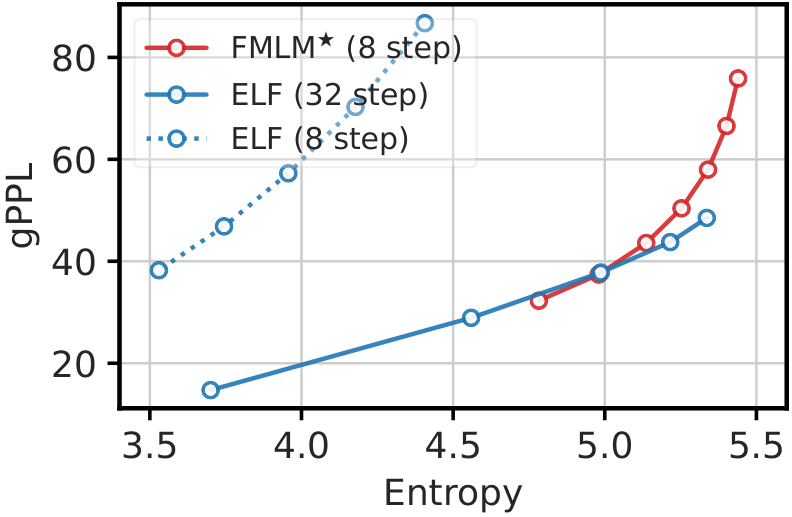
原文 Fig. 5,PDF p. 9。八步 FMLM$^\star$ 的 frontier 接近 32 步 ELF,明显优于八步 ELF;在接近数据熵的高熵端仍能看到与 32 步教师的差距。这里报告的是步数与生成指标,不能把 $32/8=4$ 直接当作实测墙钟加速比。
下表重排原文 Table 1。每格均为 gPPL / 熵(nats),同列采用相同生成步数:
| 模型与蒸馏方案 | 1 步 | 2 步 | 4 步 |
|---|---|---|---|
| Duo + DCD | 5743.29 / 6.02 | 891.16 / 5.41 | 250.86 / 5.37 |
| Duo + Di4C | 370.51 / 3.92 | 210.22 / 4.63 | 154.67 / 4.85 |
| MDLM + SDTT | 1260.86 / 5.26 | 877.22 / 5.34 | 339.73 / 5.38 |
| MDLM + Di4C | 1298.80 / 5.29 | 758.23 / 5.35 | 239.27 / 5.40 |
| 原 FMLM | 168.30 / 5.17 | 133.29 / 5.25 | 111.31 / 5.26 |
| DFM + PSD | 180.29 / 4.91 | 152.83 / 5.03 | 122.32 / 5.10 |
| DFM + ESD | 5.33 / 0.26 | 108.91 / 5.15 | 77.08 / 5.27 |
| FMLM$^\star$ 离线 | 113.91 / 5.37 | 93.66 / 5.46 | 73.86 / 5.35 |
| FMLM$^\star$ 在线,8 FPI | 117.89 / 5.39 | 98.96 / 5.47 | 80.26 / 5.44 |
来源:Sec. 4.2,PDF p. 9,Table 1。三点最能说明这张表:
- 相对原 FMLM,单步、两步、四步的离线 gPPL 分别下降约 32.3%、29.7%、33.6%。 这些是按同列基线计算的相对变化,三种步数的熵也都更接近 5.44。
- DFM + ESD 的单步 gPPL 只有 5.33,但熵仅 0.26。 严重的多样性损失解释了为何不能按 gPPL 一列直接把它判为最佳;原文的最优结论带有保持数据级熵的条件。
- 四步时,离线 FMLM$^\star$ 为 73.86 / 5.35,DFM + ESD 为 77.08 / 5.27。 差距已经小于它与若干离散扩散蒸馏方案的差距。因此本文最有信息量的比较是相近质量范围内的连续流映射模型,以及教师与学生的 frontier。
4.5 在线迭代预算:8 次是本文设置下较好的折中
| 训练目标的取得方式 | 1 步 gPPL / 熵 | 2 步 gPPL / 熵 | 4 步 gPPL / 熵 | 训练时间 |
|---|---|---|---|---|
| 在线,1 FPI | 176.31 / 5.47 | 149.51 / 5.53 | 120.35 / 5.46 | 18 h |
| 在线,2 FPI | 141.97 / 5.42 | 115.25 / 5.50 | 89.32 / 5.44 | 18 h |
| 在线,4 FPI | 123.28 / 5.41 | 101.27 / 5.48 | 81.27 / 5.45 | 20 h |
| 在线,8 FPI | 117.89 / 5.39 | 98.96 / 5.47 | 80.26 / 5.44 | 23 h |
| 在线,16 FPI | 116.63 / 5.37 | 98.61 / 5.46 | 82.50 / 5.44 | 32 h |
| 离线 | 113.91 / 5.37 | 93.66 / 5.46 | 73.86 / 5.35 | 82 h |
来源:Appendix C.2,PDF p. 23,Table 3。由 1 增到 8 次 FPI,单步 gPPL 从 176.31 降到 117.89;由 8 增到 16 次,单步仅再降 1.26,四步反而从 80.26 升到 82.50。训练时间同时由 23 增至 32 小时,边际收益明显减弱。
相对离线,8 FPI 在线方案少用 59 小时,报告的训练时间下降约 72.0%;单步 gPPL 增加 3.98,约 3.5%,四步则增加 6.40,约 8.7%。因此在线方案最直接的价值是简化蒸馏流程并减少训练开销,离线方案保留最佳生成指标。表中时间用于比较这里的蒸馏路线;共同依赖的教师预训练成本没有被分列出来,不能据此得到完整的从零训练成本。
4.6 定性结果:局部修正可见,整段语义仍有缺陷
Appendix D.1 固定 $t=0.25$ 的同一个含噪状态,展示 ELF 三次迭代后的预测。作者标出的变化包括补足语法、使指代和场景中的人物角色更协调。它与“同一状态内反复修正”的方法解释相符。(Fig. 6,PDF p. 23。)
Appendix D.2 的 1、2、4 步文本各展示一个样例,单个样本的 gPPL 分别为 65.54、62.97、49.57,熵为 5.27、5.28、5.25。这些是选出的单例,不能替代主表 1024 个样本的结果。阅读样例可见,即便四步输出也仍有生造词、操作叙述不连贯和主题漂移。因此主表的相对改进应理解为该生成基准上的进步;外部 gPPL 和 unigram entropy 仍不足以概括长文本语义质量。(Figs. 7–9,PDF pp. 25–27。)
五:结论——这项工作提供了什么可迁移的思路
本文把自条件流模型组织成三个对象:自条件去噪器 $\hat D$、固定点函数 $D^\star$、双时间去噪器 $\delta$。它们分别对应一次修正、完成局部修正、完成跨时间跳跃。这样,内层预测计算与外层生成轨迹各自有了明确的蒸馏目标,也解释了常规自条件采样为何可以被看作一次迭代的热启动近似。
从方法设计看,最可借鉴的是:面对带额外递归状态的生成过程,可以先判断该状态能否被解释为当前输入上的一个求解过程,再把求解器蒸馏成直接映射。这为将现成自条件教师改造为少步学生提供了路线。本文在 ELF、LangFlow 的机制分析,以及 ELF 系列的两阶段和在线蒸馏中给出了具体证据。
从实际选择看,追求论文中最佳生成指标时,离线两阶段方案更强;希望压低蒸馏训练成本时,8 FPI 在线方案更有吸引力。直接增加采样时的 FPI 也能提高质量,但会增加去噪调用,因此更适合作为高质量教师目标或计算预算允许时的采样策略。
理论与实验之间还有几个会影响后续研究的问题。严格收缩和 ODE 唯一性分别约束内层与外层动力学,如何让训练显式满足这些条件值得研究;当前 200 次迭代参照与质量曲线给出经验支持,若同时报告固定点残差和局部敏感度,会更直接地连接理论假设。系统层面,本文仍需独立教师,作者提出联合学习自条件、不动点和双时间去噪器的自蒸馏方向。评估则集中在 OpenWebText 长度 1024 的生成,扩展到条件生成、语义质量评价和其他模态,才能检验这种分解在更多任务中的价值。(Sec. 6,PDF p. 10;其余为本次分析提出的延伸。)