DiscoLoop:离散嵌入与连续隐藏状态共同循环的多跳推理
论文:DiscoLoop: Looping Discrete Embeddings and Continuous Hidden States for Multi-hop Reasoning
作者:Hengyu Fu、Tianyu Guo、Zixuan Wang、Hanlin Zhu、Jason D. Lee、Jiantao Jiao、Stuart Russell、Song Mei;前四位为共同第一作者。
版本:arXiv:2607.00341v2,2026-07-27 修订;本次获取与研读日期:2026-10-10。
原文:arXiv v2 · 本地 PDF · 英文汇报 · 可编辑 TeX
论文总览
DiscoLoop 研究一种很具体的推理能力:模型已经把两个事实记在参数里,能否不输出中间推理文字,直接组合它们得到答案?例如,已知 Alice 的儿子是 Bob、Bob 的妻子是 Carol,回答 Alice 儿子的妻子是谁。这里的困难包含两个环节:第二跳要能访问第一跳使用的知识库,也要能正确使用第一跳留下的表示。
循环 Transformer 重复使用同一组参数,缓解了不同深度之间事实存储位置不一致的问题。本文进一步发现:第一轮在中间位置几乎肯定地预测出正确桥接实体,但其隐藏向量与该实体的输入嵌入仍明显不同。将模型自己解码出的实体嵌入混入隐藏状态,就能大幅改善第二轮组合。DiscoLoop 把这一干预推广为可训练结构:每次循环之间,保留连续隐藏状态,并加入由词表概率加权得到的嵌入向量。
证据强度最突出的是受控两跳任务:普通循环模型最终 OOD 准确率为 8.3%,DiscoLoop 接近满分;合成自然语言任务约为 95%。混合两跳/三跳训练中,三跳 OOD 约为 65%,仍有明显缺口。在 440M 参数、20B token 的预训练中,七项零样本任务平均分从普通循环的 49.3 提高到 50.5。前者展示机制,后者提供了向普通语言建模迁移的初步证据。(Sec. 3–5,PDF pp. 4–9;App. A.2,PDF pp. 13–14)
结构地图
下文页码均为从 1 开始的 PDF 页码,本版本与印刷页码一致。
| 原文章节 | 在论证中的作用 | PDF 页码与主要证据 |
|---|---|---|
| 1 Introduction;1.1 Related work | 从深度局部存储引出循环与表示问题 | 1–3;Fig. 1 |
| 2 Task Formulation: Multi-hop Reasoning | 定义参数内两跳推理、实体不相交双图划分 | 3–4;Eq. (1) |
| 3 Looping Fixes Storage, but Not Representation | 普通循环基线、桥接实体探针、无需训练的干预 | 4–6;Table 1、Fig. 2、Eqs. (2)–(3) |
| 4 Architecture Design | 软解码再编码、残差注入、固定/可学习门 | 6–7;Eqs. (4)–(6) |
| 5.1 Symbolic two-graph dataset | 两跳泛化及训练过程中计算方式的变化 | 7–8;Fig. 3 |
| 5.2 Synthetic natural-language dataset | 直接/逆序问法,检验超出专用符号的适用性 | 8–9;Fig. 4 |
| 5.3 Language modeling | 三种循环机制的 440M 预训练比较 | 9;Table 2 |
| 6 Conclusion and Discussion | 总结及跳数外推、规模扩展方向 | 9–10 |
| A.1–A.3 Additional experiments and training details on synthetic datasets | 实现信息、三跳任务、语言任务 Stage-1 诊断 | 13–14;Figs. 5–6 |
| B Language modeling pretraining details | top-128 近似、预训练配置及损失曲线 | 14–16;Fig. 7 |
一:动机——知识可访问之后,还需要可用的中间表示
1. 参数内组合需要解决什么
设知识图谱为 $\mathcal G=(\mathcal E,\mathcal R,\mathcal F)$。原子事实是边 $(a,r_1,b)$;两跳问题输入 $(a,r_1,r_2)$,目标为 $c$,满足
$b$ 是桥接实体(bridge entity)。构造保证给定关系链能确定相应答案。训练时,原子事实与组合问题是分开的样本;组合样本只要求输出最终答案,桥接实体没有作为中间输出给出。测试提示里也不列出两条事实,模型需要调用参数记忆。(Sec. 2,PDF pp. 3–4,Eq. (1))
这里“单次前向中的隐式推理”允许内部反复运行骨干网络。两跳设置使用两次骨干调用,三跳使用三次;节省的是显式推理 token 和相应上下文,计算本身依然存在。
2. 两种瓶颈如何衔接
普通、各层不共享参数的 Transformer 可能形成沿深度展开的电路:较早层取出 $b$,较晚层再检索 $(b,r_2,c)$。如果第二条事实在训练中只作为独立原子事实出现,较晚层未必学会在自己需要的位置存储和调用它。这就是深度局部存储(depth-local storage)问题。
循环结构让两次检索使用同一个 $f_\theta$,但调用接口发生变化:第一轮输入来自 token 嵌入,第二轮输入来自第一轮的隐藏状态。后者可以包含正确实体的信息,同时与模型学会读取的实体嵌入差别很大。本文的新贡献聚焦于这个跨循环接口。(Sec. 1、3,PDF pp. 1–6)
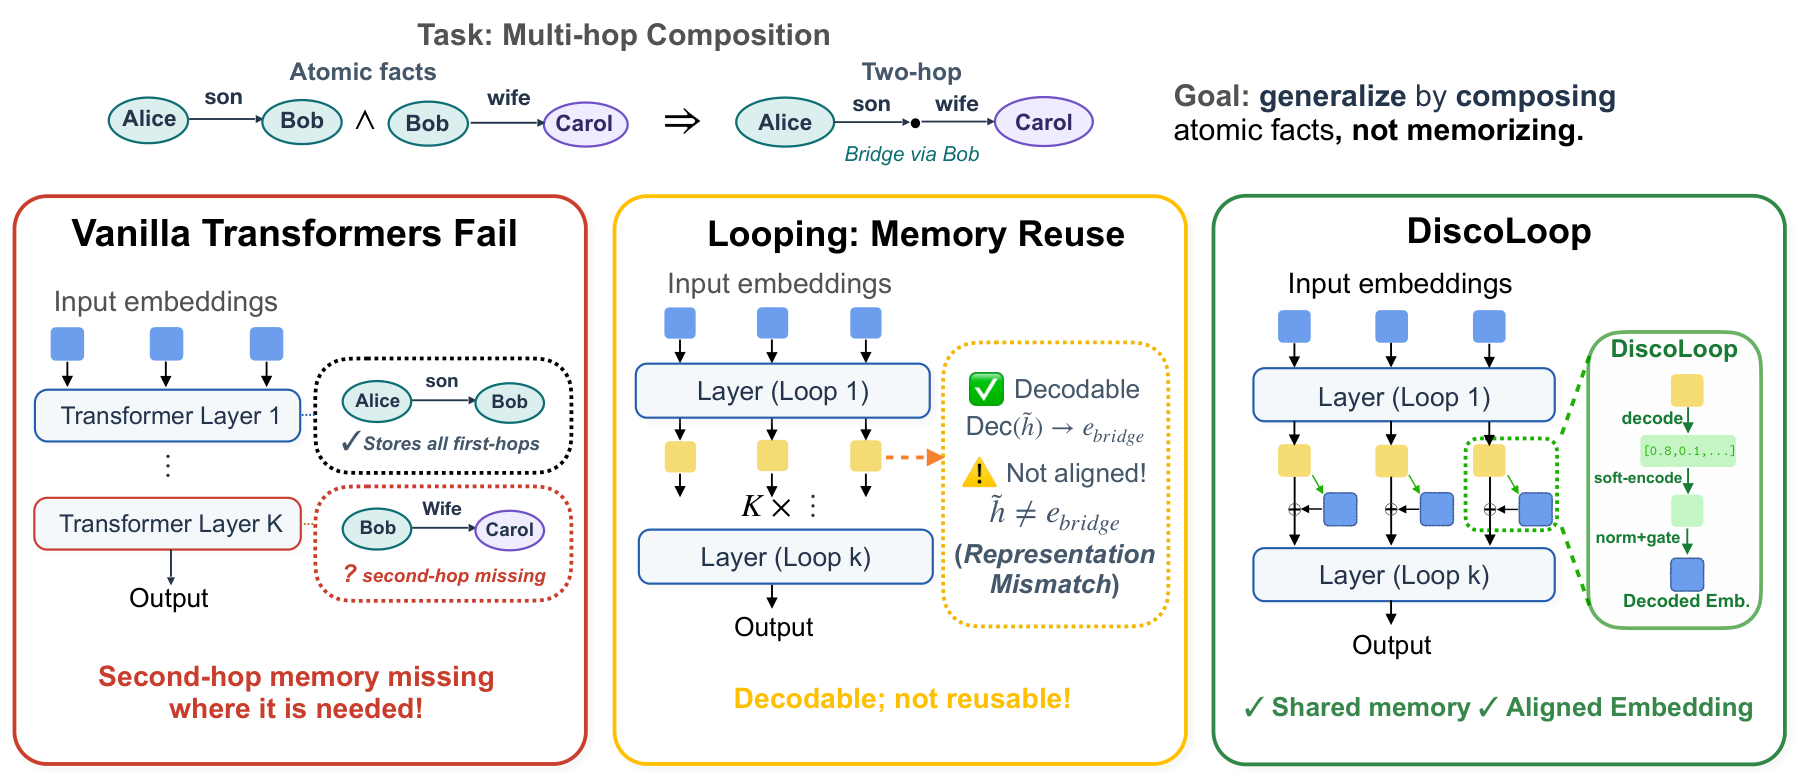
原文 Fig. 1,PDF p. 3。上方是两条边组合成答案;下方从左向右依次展示不共享层的存储位置问题、共享层仍存在的表示不匹配,以及把解码后的嵌入注入残差流的修正。
3. OOD 的含义决定了实验在检验什么
作者构造实体互不重叠、关系词表相同的两张图 $\mathcal G_A$ 和 $\mathcal G_B$。两图的全部原子事实都进入训练,但只有 $\mathcal G_A$ 的部分组合问题进入训练。
| 数据划分 | 模型训练时见过的知识 | 测试要求 |
|---|---|---|
| ID:$\mathcal G_A$ 的留出组合 | 全部原子事实及其他组合问题 | 同一实体集合内组合新的关系链 |
| OOD:$\mathcal G_B$ 的组合 | 全部原子事实,没有该图的任何组合问题 | 将在 A 图学到的组合方式用于 B 图 |
因此 OOD 实体及其事实都已被训练过;分布变化在于它们从“独立事实”变为“组合任务中的成分”。这使 OOD 结果更直接地反映组合规则的迁移,而不会把不知道事实与不会组合事实混在一起。(Sec. 2,PDF pp. 3–4)
二:方法——从干预证据到双通道循环
1. 普通循环基线与读出位置
核心符号如下。
| 符号 | 含义与形状 |
|---|---|
| $T,V,d,K$ | 序列长度、词表大小、隐藏维度、循环次数 |
| $\mathbf W\in\mathbb R^{V\times d}$ | 共享的输入嵌入/输出 LM head 权重 |
| $f_\theta$ | 每轮重复使用的同一组 Transformer blocks |
| $\mathbf H^{(k)}\in\mathbb R^{T\times d}$ | 第 $k$ 轮骨干输出的连续隐藏状态 |
| $\widetilde{\mathbf H}^{(k)}$ | 为下一轮准备的、注入嵌入后的状态 |
| $\Phi(h)\in\mathbb R^d$ | 从隐藏向量软解码、再映射回词嵌入空间的结果 |
| $\alpha_t^{(k)}$ | 位置 $t$、第 $k+1$ 轮骨干之后的注入强度 |
普通循环执行
对于符号输入 $(a,r_1,r_2)$,位置从 0 开始计数。第一轮在位置 1,即 $r_1$ 所在位置,读出桥接实体 $b$;最终在答案预测位置读出 $c$。第一轮的桥接实体读出,与第一轮的最终答案读出,是不同位置、不同目标的两个指标。 因而“桥接实体概率接近 1”和“Stage-1 两跳答案准确率接近 0”可以同时成立。(Sec. 3.1–3.2,PDF pp. 4–6,Eq. (2)、Table 1)
2. 可解码的桥接实体为何还会失效
训练 3,000 epochs 后,普通循环基线得到:
| 读出阶段 | 原子事实训练集 | 两跳训练集 | 两跳 ID 测试 | 两跳 OOD 测试 |
|---|---|---|---|---|
| Stage 1:一次 $f_\theta$ 后 | 100.0% | 8.8% | 0.9% | 0.0% |
| Stage 2:两次 $f_\theta$ 后 | 100.0% | 100.0% | 71.1% | 8.3% |
原文 Table 1a,PDF p. 6;准确率为答案位置 argmax token 与目标一致的比例。第二轮显著提高两跳训练正确率,说明最终解法确实依赖循环,而第一轮已经能够完整召回原子事实。
| 第一轮位置 1 的诊断 | ID | OOD |
|---|---|---|
| 正确桥接实体的 LM-head 概率 $P(b\mid\mathbf H_1^{(1)})$ | 1.000 | 1.000 |
| $\cos(\mathbf H_1^{(1)},\mathbf W[b])$ | 0.327 | 0.266 |
原文 Table 1b,PDF p. 6,按表中精度列出。概率接近 1 只要求正确 token 相对其他 token 获得足够大的 logit;它不要求隐藏向量与该 token 的嵌入共线。因此,输出分类器能读取 $b$,并不意味着整个 $f_\theta$ 会把这个向量当作自己熟悉的 $b$ 输入来处理。这是理解本文的关键区别。
3. 无需训练的干预提供了什么证据
作者只在两轮之间、位置 1 上做替换:
这里使用模型自己的预测 $b_{\max}$,无需提供真实桥接实体,也没有更新模型权重。训练过程中学到的事实保持不变,仅调整进入第二轮的向量,就能把 OOD 准确率从 8.3% 提高到接近 100%。相比单独观察低余弦相似度,这个干预更有力地支持了“跨循环表示接口是重要瓶颈”的解释。(Sec. 3.2,PDF p. 5,Eq. (3)、Fig. 2)
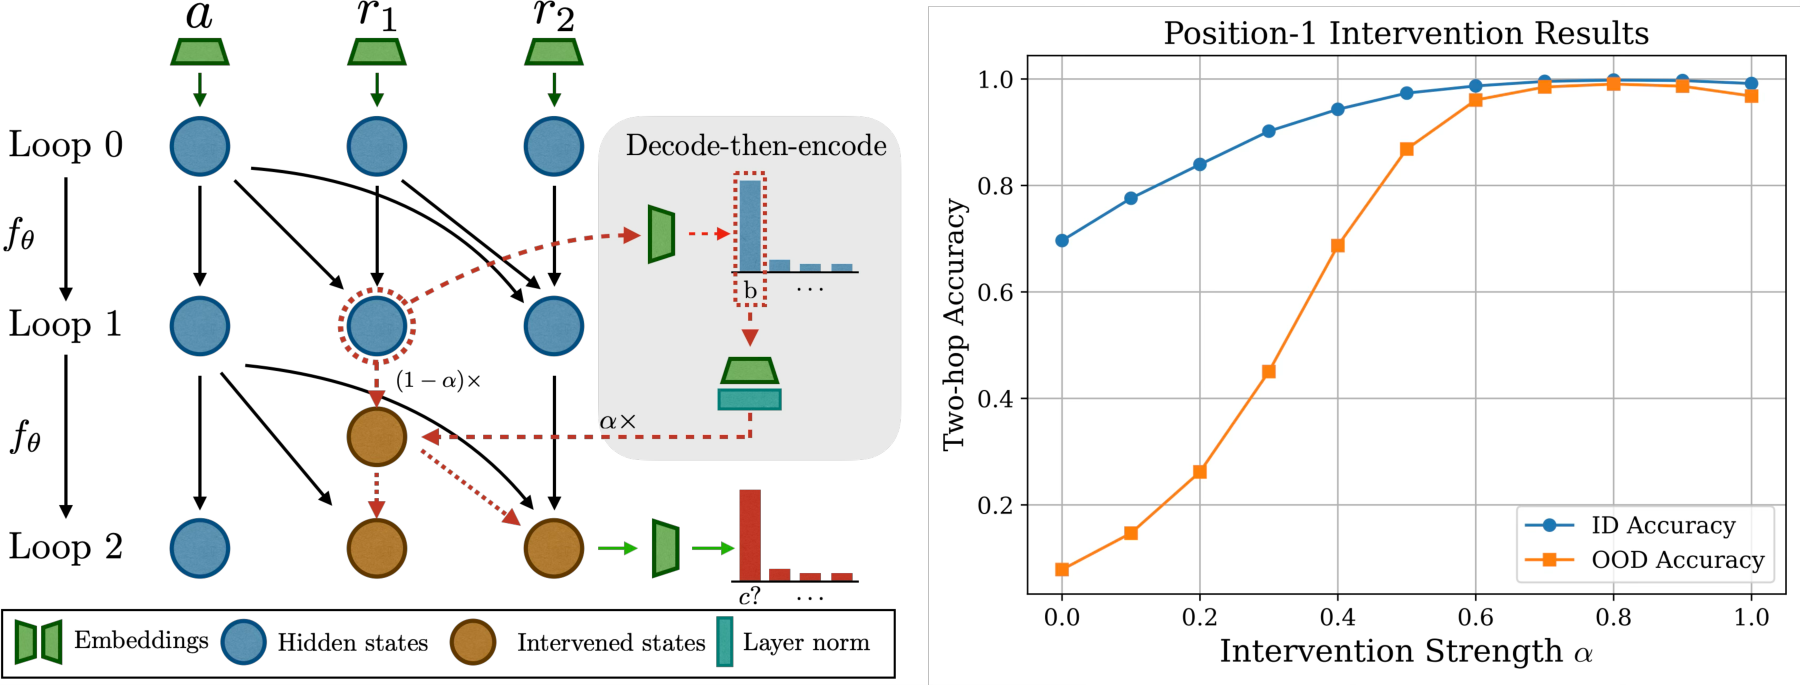
原文 Fig. 2,PDF p. 5。左图标出唯一直接修改的位置;右图横轴是混合强度 $\alpha$,纵轴是两跳准确率,蓝线为 ID,橙线为 OOD。两条曲线都随适量注入大幅上升;保留部分连续状态的中高强度区域表现最好。
原文存在影响数值引用的图文差异。 Sec. 3.2 正文写 $\alpha=0.1$ 时 OOD 为 25.9%,$\alpha\approx0.5$ 时两者接近 100%;图 2 的橙色点则显示:$\alpha=0.1$ 时约 15%,$\alpha=0.2$ 时约 26%,$\alpha=0.5$ 时约 87%,到 $\alpha\approx0.7$–$0.8$ 才接近 99%。这些是按图读取的近似值。两者均支持显著改善这一结论,但不能把正文中的精确强度直接视为已由曲线确认的最佳设置。
4. 软解码再编码:把预测分布变成可再次读取的嵌入
干预使用 hard argmax,且依赖预先知道哪个位置承载桥接实体。DiscoLoop 在所有位置上使用连续可微的算子:
计算分为三步:用共享 LM head 得到词表 logits;以温度 $\tau$ 得到概率分布;用这个分布对输入词嵌入做加权和。批量形式为
这是由原文 Eq. (5) 直接写出的矩阵形式。名称中的“离散通道”指以离散词表为支撑的嵌入通道;实际传递的仍是软加权向量,没有硬采样 token。若分布集中在桥接实体 $b$,$\Phi(h)$ 就接近 $\mathbf W[b]$;若模型尚不确定,它可以保留多个候选的权重。温度控制分布尖锐程度,但本文没有给出系统温度消融。(Sec. 4,PDF p. 6,Eq. (5))
5. 连续信息与嵌入信息如何合并
DiscoLoop 的正式递推是
$\odot$ 表示每个位置用一个标量乘对应行,两个通道加在同一个 $d$ 维残差空间中,并未拼接成 $2d$ 维。RMSNorm 控制注入向量的尺度;门控决定注入强度。原隐藏状态保留上下文中尚未被词表预测表达的信息,嵌入分支则提供与原子事实输入更接近的表示。这是作者的设计动机,也是相对于只在嵌入空间循环的 PonderLM 的主要区别。(Sec. 4、5.3,PDF pp. 6–7、9,Eq. (4))
最后一次骨干调用之后设 $\alpha^{(K-1)}=\mathbf0_T$,最终仍从 $\mathbf H^{(K)}\mathbf W^\top$ 读出答案;实际需要的循环间注入是 $K-1$ 次。
这一式与诊断干预不同:诊断用 $(1-\alpha)h+\alpha e$ 做凸组合;正式架构用 $h+\alpha e$ 做残差加法。二者的 $\alpha$ 不应直接按相同混合比例理解。
6. 门控、训练与推理
固定门使用 $\alpha^{(k)}=\alpha^\star\mathbf1_T$。可学习门为
门读取的是归一化前的软嵌入,所有位置和循环共享一组参数,门控本身只增加 $d+1$ 个参数。符号两跳实验使用固定 $\alpha^\star=1,\tau=1$;合成语言实验使用可学习门。门的结构允许按解码内容调整强度,但论文没有展示门值与置信度之间的定量关系。(Sec. 4,PDF pp. 6–7,Eq. (6))
下面是按公式整理的教学伪代码,省略 batch 维;它描述全词表版本:
X = W[input_tokens]
for k in 0, ..., K-1:
    H = f_theta(X)                    # 每轮共享参数,保留因果掩码
    if k == K-1:
        return H @ W.T                # 读取最终答案/下一 token
    P = softmax(H @ W.T / tau)
    E = P @ W
    gate = alpha_star                 # 或 sigmoid(E @ w_alpha + b_alpha)
    X = H + gate * RMSNorm(E)
合成任务的损失监督最终答案,不要求将桥接实体作为额外生成步骤。全词表软分支允许梯度穿过循环间接口;推理时沿同一递推运行,没有为每个样本执行梯度更新。序列位置保持不变:在 $r_1$ 位置预测出的 $b$ 嵌入,成为下一轮可由后续位置读取的信息。
7. top-128 近似与实际计算开销
预训练词表有 129,280 项,作者用概率最大的 128 个 token 近似嵌入回写:
App. B 报告 top-128 保留了其预训练中几乎全部有意义的概率质量。但其公式沿用原始全词表概率,文字又描述先屏蔽其他 logits 再取平均;这两种写法对是否在 top-k 内重新归一化并不完全明确。复现时需要核实这一点:若之后只有理想的 RMSNorm,整体缩放基本会被消除;若门直接读取归一化前的 $\Phi$,缩放仍可能改变门值。(App. B,PDF pp. 14–15;后半句为本次分析)
从公式估算,全词表解码与回写各包含一个 $O(TVd)$ 量级的乘法。top-k 能将选中后的嵌入聚合降至 $O(Tkd)$,但按通常的精确 top-k 实现,仍须先计算或扫描词表 logits。因此“门参数很少”不能推出“额外计算接近零”。论文控制了骨干调用次数和训练 token,未给出该分支带来的端到端吞吐或显存比较;训练更少 epochs 达到高准确率,应理解为迭代效率改善。
三:实验——各组比较如何组织
1. 符号两跳:隔离共享记忆与表示注入的作用
每图有 500 个实体,共享 50 种关系。每个实体恰有 10 条、关系标签不重复的出边,所以每图有 5,000 条原子事实、50,000 条两跳链。
| 划分 | 实际使用的样本 |
|---|---|
train_atom | A、B 两图全部原子事实,共 10,000 条 |
train_id | A 图的 10,000 条两跳问题 |
test_id | A 图另行留出的 2,000 条两跳问题 |
test_ood | B 图的 2,000 条两跳问题 |
实体和关系各用专用 token;原子序列为 <a> <r1> <b>,组合序列为 <a> <r1> <r2> <c>,目标是最后一个 token。最后的答案是监督目标,不能作为可见输入泄漏给预测位置。(Sec. 3.1,PDF p. 4)
DiscoLoop 与普通循环共享相同骨干、$K=2$ 和训练配置。非循环基线把两份骨干以不共享参数的层串起来,匹配骨干计算深度并拥有更多参数。Sec. 5.1 将其称为 FLOPs 匹配;结合上一节的词表分支,应把骨干预算匹配和整个新增分支的运行成本分开理解。三者训练 3,000 epochs;符号 DiscoLoop 用固定门和温度 1。(Sec. 5.1,PDF p. 7)
2. 合成自然语言:改变表面形式和关系出现顺序
自然语言版本保留双图任务,用英文表达事实和问题。为解释两种格式,可用同一组教学例子:
- 事实:Alice 的老师是 Bob,Bob 的妻子是 Carol。
- Direct:
Alice's teacher's wife is ... - Reverse:
Who is the wife of the teacher of Alice? Answer: ...
两种问法的答案均为 Carol,但 reverse 的关系出现顺序与实际从实体出发的推理顺序相反。这增加了语言解析与信息搬运的要求。所有模型训练 5,000 epochs,循环模型用 $K=2$,DiscoLoop 使用可学习门。(Sec. 5.2,PDF p. 8)
3. 三跳:训练深度增加后的组合迁移
附录沿用两图,每个模型训练 10,000 条原子事实,以及 A 图各 5,000 条两跳和三跳问题。四个测试集分别为两跳 ID/OOD、三跳 ID/OOD,每个 1,000 条。循环数设为 $K=3$,非循环基线串联三份不共享参数的骨干,DiscoLoop 固定门为 1。图 5 显示训练到 5,000 epochs。(App. A.2,PDF pp. 13–14)
训练集中已经存在三跳题。 这组实验检验三跳组合在 B 图上的迁移,并没有检验“只训练两跳,测试三跳”的跳数外推。
4. 语言模型预训练:比较三种循环信号
| 模型 | 跨循环保留的主要信号 | 比较角色 |
|---|---|---|
| Vanilla loop | 连续隐藏状态 | 检验增加嵌入回写是否有收益 |
| PonderLM | 解码后回到嵌入空间的表示 | 检验保留连续残差是否有额外价值 |
| DiscoLoop | 连续隐藏状态加软嵌入 | 本文双通道方案 |
这一实验使用 440M 参数规模,全部模型调用骨干四次。按原文,骨干为 Ouro 风格的 24 层、$d=1024$、16 个注意力头,输入输出嵌入共享;上下文长度 8,192,词表 129,280,使用 DeepSeek-V3-0324 tokenizer。PonderLM 的“四次骨干调用”在其命名惯例下对应三次 ponder 加一次最终调用。(Sec. 5.3、App. B,PDF pp. 9、14–15)
训练数据为 60% FineWeb-Edu、40% FineMath-4plus,总预算 20B tokens。有效 batch 为 128,优化器配置同时启用 AdamW 与 Muon,学习率 $3\times10^{-3}$,warmup 1,000 steps,线性衰减至 $10^{-5}$;梯度裁剪阈值 1.0。原文记录的 Loop launcher 每步处理 1,048,576 tokens,19,074 steps 共 20,000,538,624 tokens。AdamW 的 $\epsilon=10^{-15}$、Muon momentum 为 0.95。(App. B,PDF p. 15)
零样本评估使用 lm-evaluation-harness。ARC-C、ARC-E、HellaSwag、PIQA、SciQ 用长度归一化准确率 acc_norm;LAMBADA、RACE 用 acc,全部越高越好。平均分是七项任务的汇总,不能将其直接解释为统一数据集上的多跳准确率。(Table 2,PDF p. 9)
四:结果——机制证据怎样延伸到不同任务
1. 符号两跳:泛化提升伴随单轮答案捷径消退
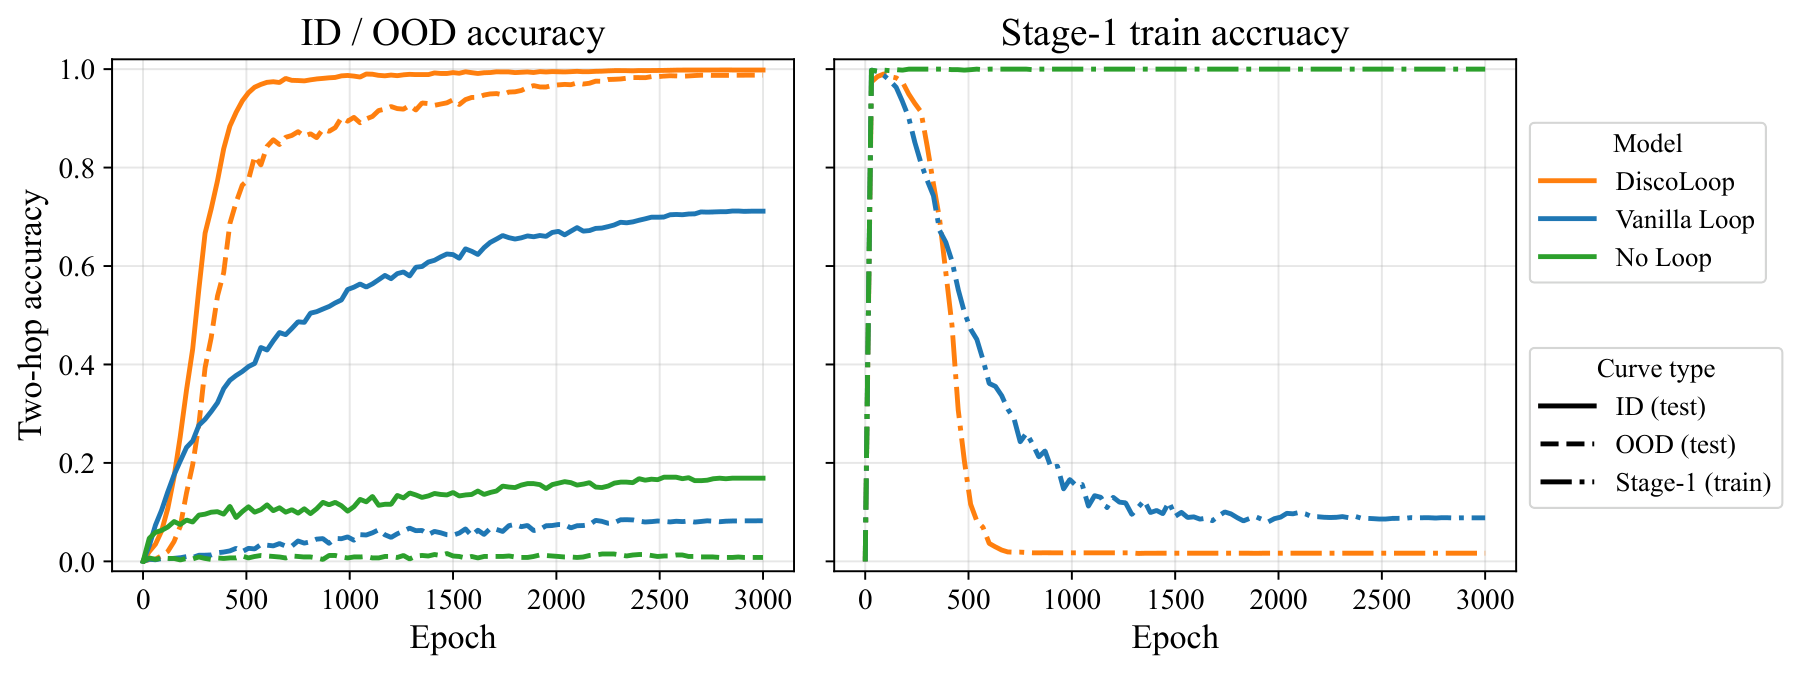
原文 Fig. 3,PDF p. 7。横轴为 epoch。左面板的实线为最终 ID 准确率,虚线为 OOD;右面板是第一轮直接回答两跳训练题的准确率。非循环模型右面板画的是其最终训练准确率,作为参考。
| 模型 | 最终 ID | 最终 OOD | 数值口径 |
|---|---|---|---|
| 非循环 Transformer | 低于 20% | 约 0% | Sec. 5.1 与 Fig. 3 的近似描述 |
| 普通循环 Transformer | 71.1% | 8.3% | Table 1 的精确报告 |
| DiscoLoop | 接近 100% | 接近 100% | Sec. 5.1 与 Fig. 3 的近似描述 |
DiscoLoop 在约 500 epochs 附近出现明显转变,ID 与 OOD 均超过 80%,随后进一步接近满分。与此同时,第一轮对两跳训练题的直接答案准确率从高值迅速下降。作者将此解释为:模型逐步放弃在单次 $f_\theta$ 中记住组合答案,转向利用两轮之间的中间表示完成组合。(Sec. 5.1,PDF pp. 7–8)
这里的“下降”不是最终模型变差,因为最终预测仍使用第二轮。Stage-1 曲线与最终泛化曲线共同支持这种计算分工解释;单看 Stage-1 低准确率,并不能确定完整推理路径。
2. 合成语言:两个问法都受益
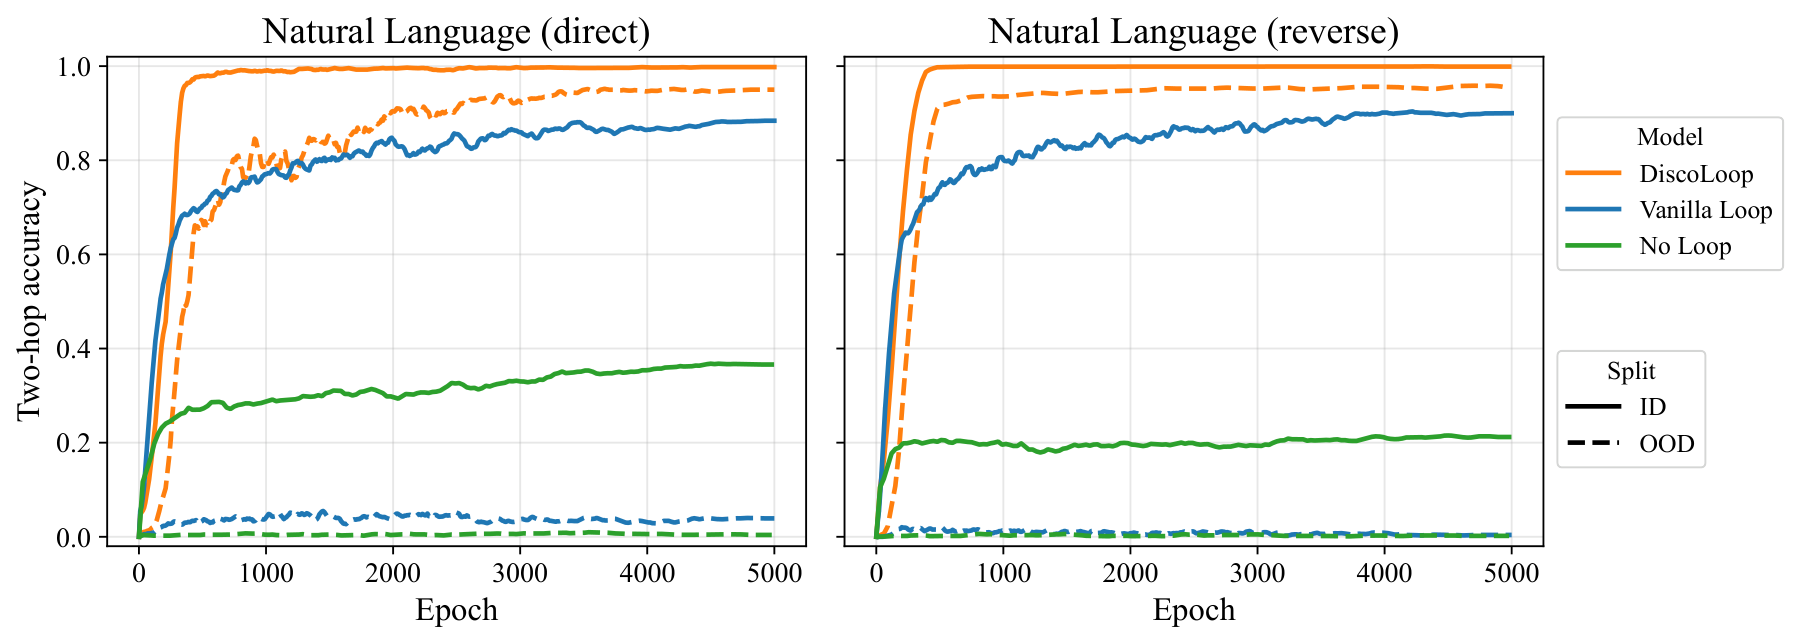
原文 Fig. 4,PDF p. 8。左边 direct、右边 reverse;颜色区分模型,实线为 ID、虚线为 OOD;两面板共用准确率纵轴,横轴为 epoch。
DiscoLoop 在两种问法中都达到接近 100% 的 ID 和约 95% 的 OOD。普通循环的 ID 接近 90%,但 OOD 很低,reverse 尤其接近零。非循环模型的 direct ID 约 40%、reverse ID 约 20%,两者 OOD 均约零。DiscoLoop 约在 500 epochs 已获得很高的 ID 表现。(Sec. 5.2,PDF pp. 8–9;数值为原文近似描述)
这组实验表明,效果可以跨越专用实体/关系 token 的简单布局;它仍然使用由知识图谱生成的英语模板,因此与真实预训练证据分开看更合适。
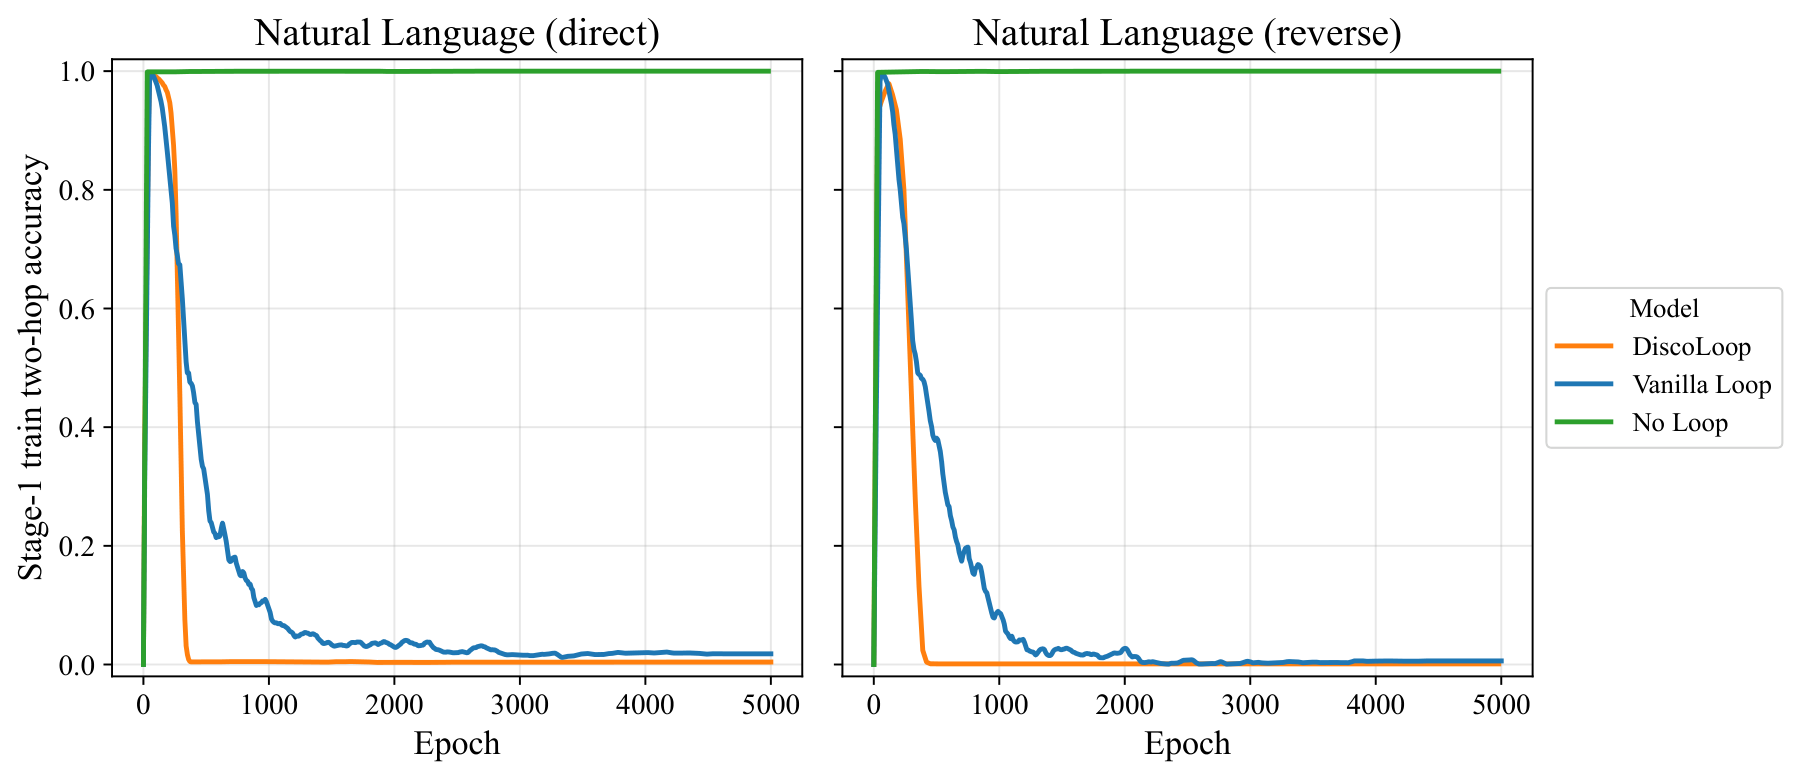
原文 Fig. 6,PDF p. 14。两面板分别为 direct、reverse,纵轴是第一轮直接给出两跳训练答案的准确率。DiscoLoop 约 400 epochs 降至接近零,普通循环需要更长训练,原文概括为超过 2,000 epochs;非循环模型的最终训练准确率一直约为 100%。这一模式复现了符号任务中“较早转向循环组合”的现象。(App. A.3)
3. 三跳:明显改善,但 OOD 尚未接近满分
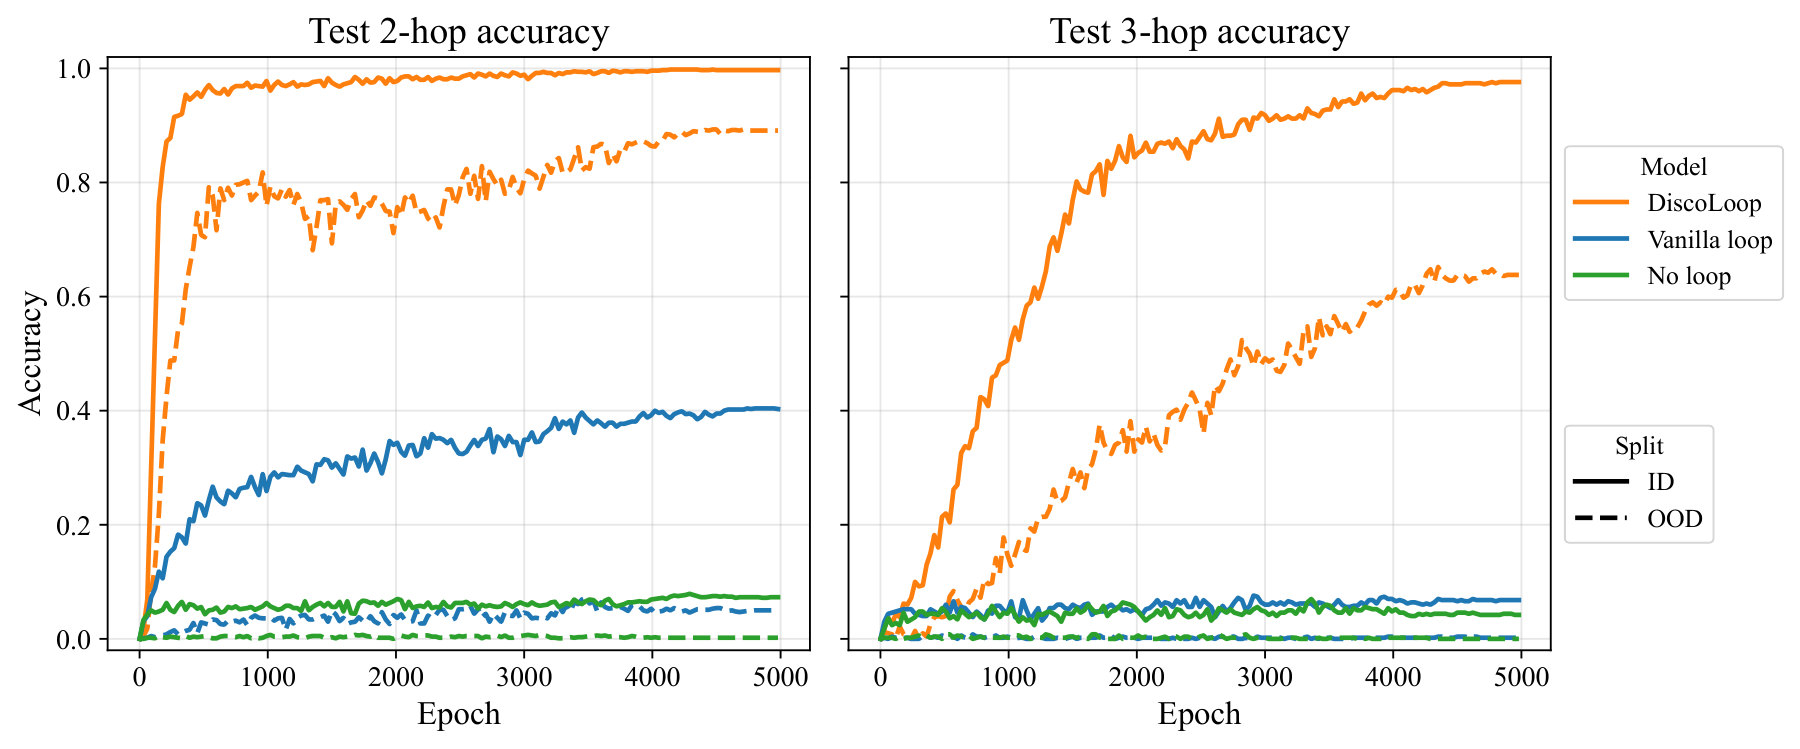
原文 Fig. 5,PDF p. 13。左面板测试两跳,右面板测试三跳,实线为 ID、虚线为 OOD。
| 在 $K=3$ 混合训练下 | DiscoLoop | 普通循环 | 非循环 |
|---|---|---|---|
| 两跳 ID | 接近 100% | 约 40% | 很低 |
| 两跳 OOD | 约 90% | 约 5% | 约 0% |
| 三跳 ID | 接近 100% | 很低 | 很低 |
| 三跳 OOD | 约 65% | 约 0% | 约 0% |
数值来自 App. A.2 的文字与 Fig. 5,均为近似描述。不要把此处普通循环的约 40% ID 与纯两跳任务的 71.1% 混用:训练组成和循环次数已经变化。
三跳涉及两次中间信息传递,双通道依然有效,这与“减少逐跳表示偏差”的机制解释相符。不过约 65% 的 OOD 留下了较大错误空间,不能把两跳的接近满分结论直接扩展为任意深度都能可靠组合。
4. 预训练:平均分改善来自多个任务
以下数值均为 Table 2,PDF p. 9,百分数尺度;最后一列为根据表中值计算的百分点差。
| 任务 | Vanilla loop | PonderLM | DiscoLoop | 相对 Vanilla 的百分点变化 |
|---|---|---|---|---|
| ARC-C | 30.5 | 31.7 | 32.6 | +2.1 |
| ARC-E | 57.2 | 55.6 | 57.6 | +0.4 |
| HellaSwag | 44.2 | 43.9 | 44.2 | 0.0 |
| LAMBADA | 35.1 | 38.0 | 37.6 | +2.5 |
| PIQA | 67.4 | 67.7 | 68.4 | +1.0 |
| RACE | 31.0 | 31.2 | 31.3 | +0.3 |
| SciQ | 79.5 | 80.5 | 81.5 | +2.0 |
| 原文 Avg. | 49.3 | 49.8 | 50.5 | +1.2 |
DiscoLoop 在七项中六项最好或并列最好;LAMBADA 的最佳是 PonderLM。相对 PonderLM,DiscoLoop 平均分提高 0.7 个百分点。相对普通循环的较大单项变化出现在 LAMBADA、ARC-C、SciQ,而非所有任务都有同等幅度提升。
这些任务提供通用语言能力的比较,并没有直接测量第 3 节那种桥接实体接口。因而“预训练迁移有效”有结果支持;“同一个两跳机制在所有基准中产生了收益”仍是解释,需要预训练模型上的对应诊断才能进一步确认。表格未提供多随机种子方差或置信区间,1.2 个百分点应按这组报告结果理解。
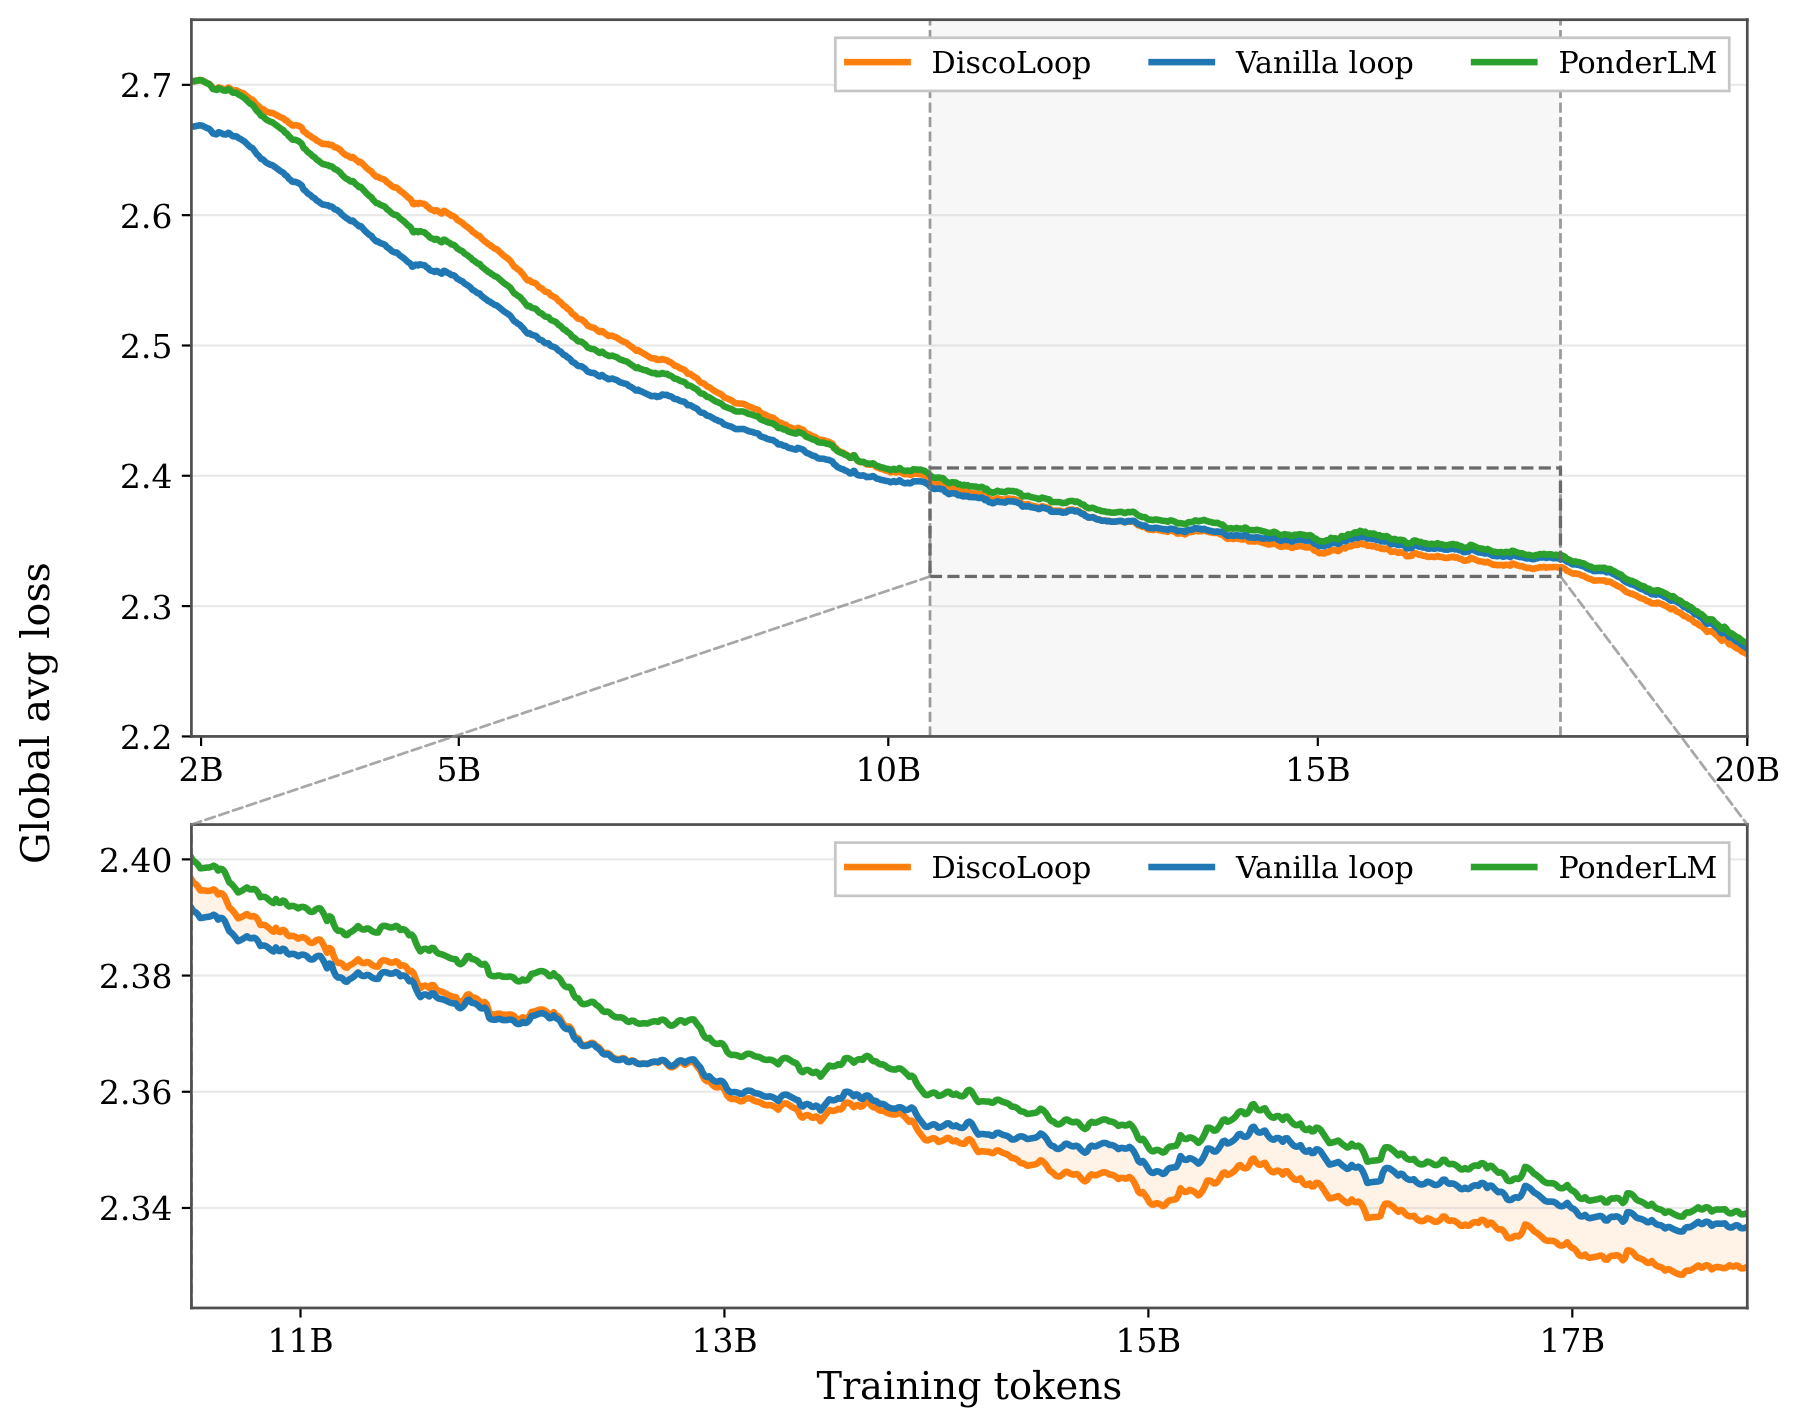
原文 Fig. 7,PDF p. 16。横轴为训练 token 数,纵轴为 global average loss,越低越好。上图给出完整轨迹,下图放大训练中后期;曲线经过指数移动平均平滑。
普通循环在早期损失更低;DiscoLoop 约在 13B tokens 后超过它,后期保持较低损失。放大区间中的最大差距约为 $10^{-2}$ 个 loss 单位,PonderLM 在这段区间也高于 DiscoLoop。这是训练目标上的补充证据,应与独立任务分数一起理解;曲线没有给出可直接引用的“达到同一效果节省多少 GPU 小时”。(Sec. 5.3、App. B,PDF pp. 9、15–16)
五:结论——值得带走的设计原则与下一步
本文最有价值的设计原则是:共享参数解决知识能否再次访问,循环接口决定这些知识能否被当前表示再次调用。 用 LM head 看见一个中间答案,还不足以说明下一段计算能使用它。作者先用模型自身预测进行局部干预,再用软嵌入残差形成普适结构,使机制分析与架构设计紧密衔接。
DiscoLoop 的方案保留了连续状态的信息容量,同时让预测结果经过输入嵌入空间重新表达。固定门就足以在符号任务中获得主要收益,说明受益点不完全依赖复杂门控;PonderLM 的预训练比较则支持保留连续通道的设计价值。实际使用时,新增参数量很小,但中间词表投影与聚合的成本仍需要测量。
有三项后续问题会直接影响对方法的采用判断。
- 跳数外推。 已有三跳实验在训练中包含三跳样本。只训练不超过 $k$ 跳、测试更多跳,才会直接检验是否形成可延长执行的组合程序;作者在 Sec. 6 将此列为未来方向。
- 规模与预算。 当前真实预训练为 440M、20B tokens。更大模型、等总 FLOPs/等训练时间比较,以及把已有非循环模型通过持续预训练改为双通道循环,都是尚待验证的实际路径。(Sec. 6,PDF pp. 9–10)
- 复现接口。 v2 的 Sec. 3.1 与 App. A.1 未列出合成任务骨干大小、学习率和 batch 等具体值;App. B 也没有明确预训练 DiscoLoop 的门类型与温度,且 top-k 归一化存在前述表述差异。复现应先补齐这些配置,而不能套用预训练配置去解释合成任务的曲线。
围绕机制,下一步最有区分度的实验是将等尺度的普通残差投影、打乱词嵌入身份的回写,以及本文的语义嵌入回写放在相同计算预算下比较。这个建议属于本次分析:它能进一步分开“增加了额外变换与计算”和“恢复了可复用的实体输入表示”各自的贡献。