MultiHashFormer: Hash-based Generative Language Models:中文研读笔记
作者:Huiyin Xue、Atsuki Yamaguchi、Nikolaos Aletras。论文:arXiv:2606.28057v2,2026-08-28 修订,EMNLP 2026 录用。本次获取:2026-10-22。原文:本地 PDF。以下页码均为从 1 开始的 PDF 页码。
论文总览
标准自回归语言模型为每个词元存储一个向量,输入嵌入和输出分类器的参数随词表大小 $|\mathcal V|$ 线性增加。单一哈希桶能压缩嵌入,却会让多个词元共享同一个输出 ID,使生成结果无法唯一还原。MultiHashFormer 的关键做法是给每个词元分配唯一的多坐标哈希签名:输入端把多个桶向量合成一个表示;Transformer 处理序列;输出端依次预测签名的各个坐标,并在真实词表上归一化,选出合法词元。(Sec. 1、3,PDF pp. 1–4,Fig. 1)
在论文报告的 1B、3B 规模上,主配置 H4B16K 相对标准模型分别在 9/10、10/10 项主表指标上更高;LAMBADA 准确率分别从 30.41% 提高到 35.34%,从 28.64% 提高到 37.26%。词表由 32,768 扩至 48,122 时,哈希模型无需增加模型参数;标准模型为新词元增加约 31M 嵌入参数。这个优势成立于固定哈希函数数目和桶数、并为新增词元分配未占用签名的设置。(Sec. 5.1、5.3,PDF pp. 6–8,Table 1、Fig. 2)
结构地图
| 原文章节 | 解决的问题 | PDF 定位 |
|---|---|---|
| 1 Introduction;2 Related Work | 词表瓶颈、单桶碰撞、与字节级及压缩嵌入方法的关系 | pp. 1–3;Fig. 1 在 p. 2 |
| 3 MultiHashFormer | 哈希编码器、Transformer 骨干、级联解码器、训练和推理概率 | pp. 3–4 |
| 4 Experimental Setup | 模型和对照、预训练、评测、扩词表协议 | pp. 4–6 |
| 5 Results | 主任务、稀有词、跨语言扩词表 | pp. 6–8;Table 1–2、Fig. 2 |
| 6 Analysis;7 Conclusion | 单/多哈希、$H/B$ 消融、LSH、结论和限制 | pp. 8–9;Table 3–4、Fig. 3 |
| 附录 A–H | softmax 瓶颈、样例、超参数、多种子、T-FREE、推理耗时 | pp. 14–18;Table 5–11 |
一:动机
常规模型的共享输入/输出嵌入矩阵约有 $|\mathcal V|d$ 个参数。扩充词表就要增添参数并为新词初始化权重。已有哈希嵌入把多个词元映到有限桶中,可以节省空间;但生成模型若只预测一个桶,就无法知道桶中究竟是哪一个词元。作者据此把“可唯一解码”作为设计目标:单个坐标允许碰撞,完整签名必须唯一。这保留了词元级序列长度,也让模型参数与可用词表项数脱钩。(Sec. 1–2,PDF pp. 1–3)
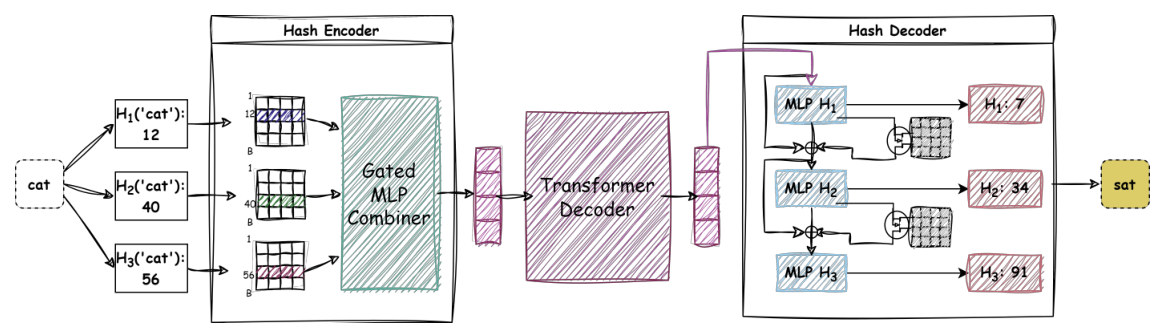
图 1(原文 Fig. 1,PDF p. 2):示例将 cat 映成三个桶 ID,编码器合成向量;骨干产生上下文状态;解码器逐头给出下一词元的签名。图中的三头仅为示意,主实验常用四头。
二:方法
2.1 多哈希签名与输入编码
对词元 $w$,第 $i$ 个哈希函数以独立种子计算
$H$ 是哈希坐标数,$B$ 是每个坐标的桶数,0 留给 padding。签名为 $s(w)=(\mathcal H_1(w),\ldots,\mathcal H_H(w))$。作者遇到完整签名冲突时调整最后一个哈希种子,直至为新增词元找到未用签名。每个坐标仍可与其他词元重合;词元的完整签名在当前实际词表中唯一。(Sec. 3.1,PDF p. 3)
每个哈希头有一个 $E^{(i)}\in\mathbb R^{B\times d}$。门控网络根据所取桶向量给各头分配权重,再求和并作线性适配:
这里 $u_i,e(w)\in\mathbb R^d$,$W_1\in\mathbb R^{d\times d_z}$、$W_2\in\mathbb R^{d_z\times1}$、$W_s\in\mathbb R^{d\times d}$;实验取瓶颈维度 $d_z=64$。门控权重由词元签名的桶向量计算,作用是调整各坐标在当前词元表示中的贡献;它不使用该位置前面的序列上下文。随后普通 decoder-only Transformer 将 $e(w_1),\dots,e(w_t)$ 变为 $h_t\in\mathbb R^d$。(Sec. 3.1–3.2,PDF p. 3)
2.2 级联预测哈希坐标
解码器以 $c^{(1)}=h_t$ 开始,对第 $i$ 个坐标计算桶分布,并将其概率加权的桶向量送入下一头:
输入桶表和输出投影权重共享。对 $i 软检索 $\bar e^{(i)}$ 是按整个桶分布求期望,训练时可微;前一头的预测分布因此会影响后一头。残差保留先前状态。它称为“级联”,但这里的后续头依据的是前一头的软分布,不是已经采样出的离散桶 ID。(Sec. 3.3,PDF pp. 3–4) 一个教学例子:若 cat 与 map 的第二坐标都等于 40,但完整签名分别是 $(12,40,56)$ 与 $(99,40,3)$,单看第二坐标会混淆;三个坐标合起来便可区分它们。图 1 使用了类似示意。(Sec. 1、3,PDF pp. 1–4) 训练把正确词元的坐标概率相乘,最小化对应负对数似然: 各头 softmax 覆盖全部 $B$ 个桶,因此训练目标允许概率落到实际词表没有分配的签名。推理时对真实词表 $\mathcal V_{\rm actl}$ 中每个词元计算签名得分,并作一次词表归一化: 这样输出必然是已注册词元。论文写虚拟空间大小为 $B^H$;由于非 padding 词元的坐标取值为 $1,\dots,B-1$,非 padding 可用组合数更精确地说是 $(B-1)^H$。这些数量是组合容量上界,实际容量还取决于唯一签名分配能否稳定完成。推理重归一化需要扫描真实词表,因而时间随 $|\mathcal V_{\rm actl}|$ 增长;附录 H 在一张 MI300X 上报告 1B H4B16K 的 LAMBADA 推理为 97.38 ms/样本,标准模型为 96.42 ms/样本。(Sec. 3.4,PDF p. 4;App. H,PDF p. 17) 普通 LM 的上下文—词元 logits 矩阵写成 $CW^\top$,其秩至多 $d$。作者在附录 A 将哈希头对真实词表的贡献写成多个 $C_iE_i^\top\Pi_i$ 的和:不同头的状态及词元映射可以让logits 的可达秩上界高于单个 $d$ 维线性输出头。这给 LAMBADA 等任务上的表现提供了一个可能的表达能力解释,并非对实际学得矩阵秩或性能因果关系的直接测量。(App. A,PDF pp. 14–15) 附录 A 印出的 $\min(B,Hd)$ 上界与其紧邻的矩阵分解不完全一致:不同哈希头的映射 $\Pi_i$ 各不相同,简单的求和秩界是 $\min\{|\mathcal C|,|\mathcal V|,H\min(d,B)\}$,不能单凭单头桶数 $B$ 给总和再加一个共同上界。归一化会引入逐行常数项。因而可以接受“多头有机会缓解单头的秩约束”这个方向性解释,不能从文中的公式直接推出所声称的精确秩界或必然获得更高实际秩。(App. A,PDF p. 15) 模型和对照。 三个尺度均用 Qwen3 风格的 decoder-only Transformer 骨干与 Mistral-7B-v0.3 的 32,768 词元 BPE 分词器。Standard 使用常规、输入输出共享的词表矩阵;Standard+$k$L 在 100M/1B 实验增加 Transformer 层数,提供相近参数预算对照。H3B10K 在 1B 主表的嵌入/解码器参数记作 65M/0.9B,与 Standard 相同;H4B16K 为 138M/0.9B,Standard+2L 为 65M/1.0B。3B 只报告 Standard 与 H4B16K,前者 65M/2.8B,后者 138M/2.8B。因此 H4B16K 对 Standard 的比较同时包含更多嵌入参数。(Sec. 4.1,PDF pp. 4–6,Table 1) 训练和指标。 100M 模型用 10B 个 FineWeb-Edu 英文 token;1B/3B 用 100B。全局 batch 为 256,序列长度为 2,048。主评测包括 LAMBADA、5 项常识推理、3 项阅读理解和 ReCoRD,共 10 项。ReCoRD 用 F1;ARC-E、HellaSwag、SIQA、OBQA、SciQ 用归一化准确率;其余用普通准确率。ARC-E、SIQA、OBQA 为 five-shot,其余 zero-shot;不同任务之间的分数不能当作同一种测量直接相加。(Sec. 4.2–4.3,PDF p. 5;App. D,PDF pp. 16–17) 稀有词与扩词表。 Card-660 用词对的人类相似度标注,对比隐藏层词表示余弦相似度的 Pearson $r$ 和 Spearman $\rho$。扩词表实验继续训练 8B token,其中阿拉伯语、中文、印地语各 2B,英语 2B;每种新增语言约 5K 词元,总词表达到 48,122。标准模型给新嵌入做均值初始化并增加参数;MHF 仅注册新签名。两者微调嵌入、输出头以及首尾各两层 Transformer;评估多语言任务和原来的英语任务。(Sec. 4.3–4.4,PDF pp. 5–6) 来源:Table 1,PDF p. 6。1B H4B16K 的 LAMBADA 比 Standard 高 4.93 个百分点,3B 高 8.62 个百分点,这不是相对百分比。逐列检查 Table 1,H4B16K 在 1B 的 10 项中有 9 项高于 Standard,唯一例外是 OBQA(29.80 对 31.60);3B 的 10 项全部高于 Standard。参数相同的 1B H3B10K 对 Standard 在 8/10 项上更高,但 RACE 与 SciQ 略低。(Sec. 5.1,PDF pp. 6–7) 100M 时结论不同:主表中 Standard+4L 在 LAMBADA 取得 19.64,而 H3B10K、H4B16K 分别是 16.40、18.79;COPA、HellaSwag、ReCoRD 也显示加深骨干较有利。附录 F 提供了该规模的三种子均值与标准差;其 LAMBADA 分别是 Standard+4L 19.19±0.6、H4B16K 18.80±0.4。论文将这一现象解释为浅层、窄隐藏状态不易充分消歧共享桶。(Sec. 5.1,PDF pp. 6–7;App. F,PDF pp. 17–18,Table 10) Card-660 的 1B 模型中,倒数第二层 Pearson $r$ 从 Standard 的 0.26 提升为 H3B10K 的 0.32;H4B16K 为 0.30,而 Standard+2L 为 0.29。倒数第二层 Spearman $\rho$ 分别为 0.25、0.29、0.32、0.29。最后一层的优势较小且并非每一列都成立。附录 C 的缩写、别名、拼写变体样例支持共享桶改善部分稀有词表示这一解释;该表报告的是词对相似度相关性,并非生成任务的稀有词正确率。(Sec. 5.2,PDF p. 7,Table 2;App. C,PDF pp. 15–16) 图 2(原文 Fig. 2,PDF p. 7)以颜色区分 Standard/MHF,按阿拉伯语、印地语、中文和英语分组;黑短线是随机基线。22 项比较由前三种语言各 4 项和英语 10 项组成。1B、3B 的 H4B16K 分别在其中 12/22、13/22 项超过 Standard,因此图支持“无新增模型参数时保持竞争力并在部分任务获益”,也显示优势并非覆盖所有语言和任务。标准模型扩展约 15K 新词元需要 约 31M 参数,MHF 为 0M;原词表增幅为 46.9%。英语任务上,作者把“更好或接近”计作 H3B10K 的 6/10 项、H4B16K 的 9/10 项,不能解读为全部严格获胜。(Sec. 5.3,PDF pp. 7–8,Fig. 2) 在 1B、约 20B token 的消融训练中,单 ID(H1)与四 ID(H4)在 B4K/B8K/B16K 下的 LAMBADA 准确率分别是 4.29/8.77/14.30 与 30.27/30.47/30.91。表注说明 H1 把一个值用于四个坐标,以匹配参数量;差别仍然很大。这是完整签名能消除词元级输出歧义的直接实证。(Sec. 6,PDF p. 8,Table 3) 图 3(原文 Fig. 3,PDF p. 8)横轴是 H/B 配置,灰柱为嵌入参数量,彩线为四类任务的平均分,虚线是 Standard。增大桶数/头数显著增加嵌入参数,但分数没有同步陡增;H4B16K 因而是作者选用的折中配置,并非每一指标最高。将 MMH3 哈希头逐步换成字符三元组 LSH 后,LAMBADA 为 30.91、30.60、30.80、31.40、31.36,未出现随 LSH 比例增加的稳定上升。(Sec. 6,PDF p. 8,Table 4) 论文把组合式、可逆的词元签名接入因果语言模型,解决了单哈希桶无法唯一生成词元的问题。主要收益在报告的 1B/3B 模型和扩词表设置中体现;100M 规模更倾向从加深骨干获益。实际取舍是:模型参数可以在固定 $H,B$ 下不随词表项线性增长,但仍需维护词元到唯一签名的映射,并在推理时对真实词表计算与归一化分数。较大模型的主实验每配置只有一个训练种子;100M 有三种子结果,规模外推和小差异比较应据此把握证据强度。(Sec. 5–7、Limitations,PDF pp. 6–9;App. F、H,PDF pp. 17–18) 原文有几处直接影响复述的内部不一致: 值得追问:唯一签名的重哈希在持续扩词表时如何固定旧词元映射,所需映射表占多少内存;真实词表更大时推理重归一化的延迟如何变化;较大模型多种子与更高 token 预算下,主任务优势是否稳定。这些是论文证据尚未覆盖、会影响实际采用的具体问题。2.3 为什么训练与推理使用不同的归一化
2.4 Softmax 秩论证应如何理解
三:实验设置
四:结果与证据
4.1 主任务:优势主要出现在 1B 和 3B
模型 LAMBADA 准确率 ↑ ARC-E 归一化准确率 ↑ COPA 准确率 ↑ ReCoRD F1 ↑ 1B Standard 30.41 59.85 64.00 63.20 1B Standard+2L 30.66 60.23 65.00 63.78 1B MHF H3B10K 35.78 61.95 65.00 64.51 1B MHF H4B16K 35.34 64.35 71.00 64.90 3B Standard 28.64 60.23 65.00 62.26 3B MHF H4B16K 37.26 66.88 68.00 64.13 4.2 稀有词:相关性改善,但依赖观察层
4.3 多语言扩词表:省下参数,任务结果参差
4.4 消融:完整签名比增大单桶更关键
五:结论与读表提示