Erase-then-Delta Attention(EDA):中文精读笔记
论文:Erase-then-Delta Attention: Decoupling Erase and Write Addresses in Delta-Rule Linear Attention
作者:Xiao Li, Chengruidong Zhang, Hao Luo, Xi Lin, Zekun Wang, Zihan Qiu, Yunfei Mao, Langshi Chen, Man Yuan, Minmin Sun, Huiqiang Jiang, Siqi Zhang, Rui Men, Wei Hu, Gong Cheng, Bo Zheng, Dayiheng Liu, Jingren Zhou。机构:Qwen Team、南京大学、浙江大学。
版本:arXiv:2606.26560v1,提交于 2026-06-25;研读/获取日期:2026-09-22。PDF 首页另印有 2026-06-18,应与 arXiv 提交日期区分。
材料:原文 PDF、作者 main.tex 及其实际引用的六个正文章节和 sections/appendix.tex。已覆盖正文全部实质章节、附录 A/B、全部 5 张表和 2 幅图;参考文献用于定位,未另行精读每篇被引论文。下文页码均为 PDF 的 1 起始页码,与正文印刷页码一致。本次没有复现预训练或实测作者内核。
论文总览
EDA 给 delta-rule 线性记忆增加了一个独立的擦除地址 $\mathbf e_t$:先衰减旧状态,再压低 $\mathbf e_t$ 方向的读出,最后仍然沿当前写入键 $\mathbf k_t$ 做标准 delta 修正。新增能力是“一步内在 A 处删除、在 B 处修正写入”,而非仅把已有遗忘门调大。
论文报告的混合架构实验中,EDA 在 Dense 2.5B 和 MoE 25B-A2.8B 的预训练六任务平均分均最高;相对 KDA 分别提高 0.63、1.07 个百分点。80B token 长上下文续训后,MoE 平均领先缩小为 0.14 个百分点。RULER 的六长度平均分最高,但只在 4k、8k、16k 各列领先,不是 4k–128k 每个长度都最好(表 1–3,pp. 8–9)。
最稳妥的理解是:这是一个有语言建模收益的条件性记忆清理通道。它既没有证明历史记忆保真度全面提高,也没有证明每次删除都对应某条过期事实;原文反而指出严格的原写入键回忆探针上 KDA 更好。
结构地图
| 原文章节 | 核心问题 | PDF 定位 |
|---|---|---|
| 1 Introduction | 为什么需要独立擦除地址 | pp. 1–2 |
| 2 Preliminary;2.1–2.3 | 关联记忆、delta rule、GDN/KDA/GDN-2 | pp. 2–3,式 (1)–(6) |
| 3.1 Overview;3.2 Erase-Write Coupling | 定位地址耦合 | pp. 3–4,式 (7) |
| 3.3 Erase-then-Delta | 两步更新、safe gate、交叉项 | pp. 4–6,式 (8)–(16),图 1 |
| 3.4 EDA with Chunk-wise Parallel | 双子步转化与分块计算 | pp. 6–7,式 (17)–(22) |
| 3.5 Efficiency Analysis | 计算与带宽成本解释 | p. 7 |
| 4.1 Experimental Setup | 两种模型规模与共享训练方案 | p. 7 |
| 4.2 Model Results | 400B token 预训练比较 | p. 8,表 1 |
| 4.3 Midtraining Results | 32k 续训后是否保留优势 | p. 8,表 2 |
| 4.4 Long-Context Evaluation | 4k–128k 的 RULER | pp. 8–9,表 3 |
| 4.5 Memory-State Analysis | 清理预算、反事实扰动、地址几何 | pp. 9–10,式 (23)–(24),图 2 |
| 5 Related Work;6 Conclusion | 与已有更新规则的关系及局限 | pp. 10–11 |
| A Model Configurations;B Evaluation Benchmarks | 参数、公平性与指标背景 | pp. 13–14,表 4–5 |
一:动机
固定大小的记忆需要控制干扰
线性注意力把历史压缩为固定大小矩阵,而全注意力保留显式 KV。固定维度时,线性递归层的单 token 状态更新与历史长度无关;不能由此推断本文整个混合模型拥有常数 KV 内存,因为其中仍有全注意力层。
普通加法更新 $\mathbf S_t=\mathbf S_{t-1}+\mathbf k_t\mathbf v_t^\top$ 容易累积相互干扰的关联。Delta rule 通过当前键的读出残差修正状态;KDA 又用对角矩阵按 key 通道调节遗忘。但这两者没有给主动的 rank-1 清理提供另一个独立地址。变量重赋值、事实纠正、上下文切换是论文的动机示例,不是论文单独报告的专项任务实验。
与 GDN-2 的差别
GDN-2 用 key 侧擦除门和值侧写入门分开控制强度,更新仍沿当前键 $\mathbf k_t$ 提交。EDA 分开的是地址:可以沿独立生成的 $\mathbf e_t$ 清理,再沿 $\mathbf k_t$ 写入。GDN-2 的门控读方向可以与 $\mathbf k_t$ 不共线,所以不能简化成“GDN-2 两个方向完全一样”;真正区别是它没有 EDA 这个独立生成、沿自身方向作用的擦除算子(式 (6),p. 3;Sec. 5)。
二:方法
1. 符号与基线
| 符号 | 维度 / 范围 | 含义 |
|---|---|---|
| $\mathbf S_t$ | $d_k\times d_v$ | 单头递归关联记忆 |
| $\mathbf q_t,\mathbf k_t,\mathbf e_t$ | $d_k$,L2 归一化 | 查询、写入、独立擦除地址 |
| $\mathbf v_t$ | $d_v$ | 当前写入内容 |
| $\mathbf D_t=\operatorname{Diag}(\boldsymbol\alpha_t)$ | $d_k\times d_k$ | key 通道保留率 |
| $\beta_t,\gamma_t$ | $(0,1)$ | delta 修正、独立擦除强度 |
| $\mathbf o_t=\mathbf S_t^\top\mathbf q_t$ | $d_v$ | 当前读出 |
基线先衰减,再对重建损失 $\tfrac12\|\mathbf S^\top\mathbf k_t-\mathbf v_t\|_2^2$ 做一步状态梯度更新:
这是原文式 (7),pp. 3–4。梯度步骤是对内部记忆状态的解释,不意味着推理时再运行一次模型参数优化器。
2. 三个有序阶段:衰减、擦除、修正写入
EDA 的核心是式 (8),p. 4:
从右向左理解:
- $\widehat{\mathbf S}_t=\mathbf D_t\mathbf S_{t-1}$:按坐标保留旧内容。
- $\widetilde{\mathbf S}_t=\widehat{\mathbf S}_t-\gamma_t\mathbf e_t(\widehat{\mathbf S}_t^\top\mathbf e_t)^\top$:读出擦除地址的内容,并减去其投影。
- $\mathbf S_t=\widetilde{\mathbf S}_t+\beta_t\mathbf k_t(\mathbf v_t-\widetilde{\mathbf S}_t^\top\mathbf k_t)^\top$:对擦除后的记忆做标准 delta 修正。
第二步对应式 (10) 的状态目标 $\tfrac12\|\widehat{\mathbf S}_t^\top\mathbf e_t\|_2^2$。这里没有人工标注的“过期事实地址”;$\mathbf e_t$ 来自模型学习到的投影。对于任意查询 $\mathbf q$:
因此沿 $\mathbf e_t$ 的读出缩为 $1-\gamma_t$,正交查询在这一步不变(式 (12))。其余非正交查询仍会受影响,不能理解成数据库中无副作用地删除一条记录;之后的 delta 步骤也可能改变这些读出。
3. 一个可手算的教学例子
以下为本次分析,不是论文实验。设 $d_k=2,d_v=1$,旧状态为 $(3,5)^\top$,$\mathbf D=\mathbf I$,擦除地址 $\mathbf e=(1,0)^\top$,写入地址 $\mathbf k=(0,1)^\top$,新值 $v=7$,取门的极限情形 $\gamma=\beta=1$。EDA 先得到 $(0,5)^\top$,再得到 $(0,7)^\top$;无独立擦除的基线得到 $(3,7)^\top$。这个例子展示了额外的表达能力,不证明模型必然学会识别语义上的过期内容。
4. 顺序、交叉项与稳定性的范围
式 (16),pp. 5–6,把两算子的乘积展开为:
最后一项描述地址重叠导致的交互。先 delta 写入再擦除,会让新写入项也受到擦除算子作用;先擦除则使当前新值在最后加入。对角衰减与方向擦除一般也不交换。$\gamma=0$ 恢复基线;$\mathbf e=\mathbf k$ 时,旧状态同方向收缩系数为 $(1-\beta)(1-\gamma)$,但新值的系数仍是 $\beta$,不能把它无条件当成“把 beta 调大”的标准 delta 更新。
本次补充推导:单位向量 $\mathbf e$ 与 $0\leq\gamma\leq1$ 下,擦除算子的特征值为 $1-\gamma$ 和 1;delta 算子同理。若所有衰减率不超过 1,旧状态转移的谱范数不超过 1。这个非扩张结论不要求地址正交,但不是含不断写入项时状态全局有界或训练稳定的完整证明。平均 $|\cos|$ 较小也不代表每个 token 的交叉项都小。
5. 层结构和 safe gate
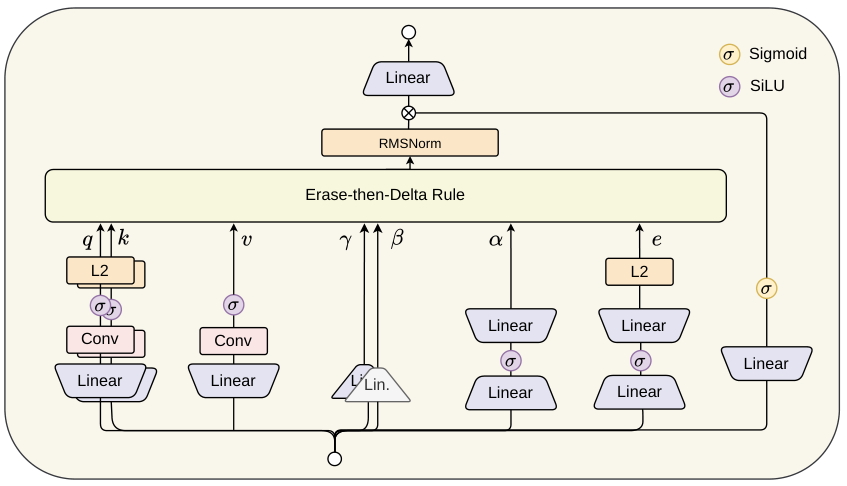
来源:图 1,PDF p. 5,作者原始矢量图转 PNG。由下向上看:输入生成 q/k/v、输出门、两种更新门、衰减参数和独立擦除地址;q/k/v 路径含卷积与激活,q/k/e 做 L2 归一化。内核输出经 RMSNorm、输出门和线性投影。擦除地址使用低秩投影;附录明确 MoE 使用每头 rank-16。
EDA 还改变了衰减门参数化(式 (14)–(15),p. 5):
取 $\ell=-5$ 时,单步 $\alpha_{t,i}>e^{-5}\approx0.00674$;小输入附近 $g\approx-A\Delta$,大输入时饱和,保留幅度与非负开关的解释。作者以此支持半精度分块计算的数值与硬件友好性。单步下界本身不保证任意长连乘都不下溢,实际分块缩放仍需实现核验。
这也是实验归因的边界:EDA 相比 KDA 不仅多一个擦除地址,还有不同 safe gate 和略多参数;论文未提供把这些因素完全拆开的训练消融。
6. 分块并行与实现注意点
式 (17)–(18),p. 6,把每个原 token 变为两个虚拟子步:
| 子步 | q' | k' | v' | beta' | alpha' |
|---|---|---|---|---|---|
| $2t-1$:衰减+擦除 | 0 | $\mathbf e_t$ | 0 | $\gamma_t$ | $\boldsymbol\alpha_t$ |
| $2t$:delta+读出 | $\mathbf q_t$ | $\mathbf k_t$ | $\mathbf v_t$ | $\beta_t$ | 全 1 |
这样可复用 DPLR 递归:奇数步不写值,偶数步才输出。式 (19)–(22) 再用 WY 表示和 UT 变换压缩块内递推、形成矩阵乘法。概念上的序列长度翻倍,增加 prefill 工作量;递归状态大小仍为 $d_kd_v$,每 token 多一次 rank-1 更新。作者认为融合后 HBM 增量不大,decode 主要成本仍是状态读写,但 Sec. 3.5 没有报告硬件、tokens/s 或延迟数值,不能据此宣称已实证“几乎免费”。
原文公式疑点,复现时必须核验:PDF p. 7 和源码式 (21) 都写成 $\mathbf M=\mathbf I+\operatorname{StrictTril}(\cdots)$、$\mathbf W=\mathbf M(\mathbf A\odot\mathbf K')$、$\mathbf U=\mathbf M\mathbf V'$。若按普通未吸收 gate 的 $\mathbf K',\mathbf V'$ 直接解释,单子步时严格下三角为零,$\mathbf M=\mathbf I$,$\mathbf U$ 就缺少式 (20) 所需的 $\beta'$;且递推式通常对应下三角求解。式中 A 的列堆叠方向也与随后逐元素运算的行布局需要澄清。因此这些排版公式不能原样作为已验证内核伪代码。本次不擅自给出“修正后的作者公式”,而以无歧义的式 (8)、(17)–(18) 作为数学主线。
三:实验
1. 比较对象与训练条件
所有线性注意力比较项都是每 3 层线性注意力后接 1 层全注意力的混合模型;Dense 另有纯全注意力 Transformer,MoE 没有对应的纯 Transformer 或 GDN-2 比较项。全注意力层使用 Gated Attention。
| 配置 | Dense 2.5B | MoE 25B-A2.8B |
|---|---|---|
| 总层数(线性/全注意力) | 24(18/6) | 28(21/7) |
| 模型宽度 | 2048 | 2048 |
| 线性 key/value 头数 | 8/16 | 16/32 |
| 每头 key/value 维度 | 128/128 | 128/128 |
| FFN/专家宽度 | 7424–7488 | 512 |
| 路由 | 无 | 256 专家,top-8 + 1 shared |
| 预训练 tokens / 序列 / 全局 batch | 400B / 4096 / 1024 | 相同 |
| 预训练学习率 | $4\times10^{-3}\to3\times10^{-5}$ | $2\times10^{-3}\to3\times10^{-5}$ |
| 额外续训 | 未报告 | 80B tokens,32k 序列 |
共同配置:词表 248,320,BF16,AdamW,SiLU,RMSNorm $\epsilon=10^{-6}$。附录表 5 中 Dense KDA/EDA 为 2.5218B/2.5295B;MoE KDA/EDA 总参数为 24.6324B/24.6558B,激活参数为 2.7885B/2.8119B。并非严格等参数比较,差值分别为 7.7M(Dense)和 23.4M(MoE);相对 KDA 分别约 0.31% 总参数、0.84% 激活参数(本次计算)。
未充分报告的复现信息包括训练语料混合、多个独立训练种子、完整评测提示/解码协议、续训学习率和详细硬件性能。不能把评测重复两次当成独立训练两次。
2. 指标与统计口径
MMLU/MMLU-Pro 侧重知识及更难的多选推理,GSM8K 为小学应用题,MATH 为更高难度数学,BBH 为困难推理任务,EvalPlus 为更严格测试下的代码生成。表 1–2 均是百分数、越高越好,对同一 checkpoint 评测两次取均值;Avg. 是六列等权平均,不是所有样本合并准确率。论文没有给出各均值的标准误或置信区间。
RULER 聚合子任务,重复评测四次,再对六种上下文长度等权求 Avg.;64k/128k 超过 32k 续训长度,是长度外推。通用任务得分和 RULER 平均数不能混成一个统一量表。
四:结果
4.2 预训练:平均领先,但任务之间有取舍
以下均来自表 1,PDF p. 8,单位为百分数,↑。保留原文 Avg. 的四舍五入口径。
| Dense 模型 | MMLU | MMLU-Pro | GSM8K | MATH | BBH | EvalPlus | Avg. |
|---|---|---|---|---|---|---|---|
| Transformer | 50.11 | 18.11 | 20.26 | 12.16 | 35.01 | 30.82 | 27.75 |
| GDN | 49.99 | 15.76 | 20.83 | 12.85 | 34.99 | 31.08 | 27.58 |
| GDN-2 | 49.90 | 15.84 | 21.40 | 13.56 | 35.18 | 32.95 | 28.14 |
| KDA | 50.03 | 16.37 | 21.30 | 13.09 | 35.31 | 30.73 | 27.81 |
| EDA | 49.27 | 16.04 | 23.90 | 13.54 | 35.42 | 32.50 | 28.44 |
EDA 对 KDA 平均 +0.63 个百分点,对 GDN-2 +0.30。GSM8K 对 KDA +2.60,但 MMLU −0.76、MMLU-Pro −0.33。Dense 不能描述成知识、代码和数学所有列均最好。
| MoE 模型 | MMLU | MMLU-Pro | GSM8K | MATH | BBH | EvalPlus | Avg. |
|---|---|---|---|---|---|---|---|
| GDN | 64.75 | 31.46 | 58.89 | 31.87 | 51.88 | 50.09 | 48.16 |
| KDA | 63.84 | 33.14 | 58.61 | 30.78 | 51.87 | 51.60 | 48.31 |
| EDA | 65.31 | 33.61 | 57.71 | 33.57 | 52.72 | 53.37 | 49.38 |
MoE 平均对 KDA +1.07 个百分点;六项中五项最好,例外 GSM8K 比 KDA 低 0.90。这里支持跨两类规模的收益,但仅有两种模型设置,不构成缩放定律。
4.3 长上下文续训:优势保留,差距缩小
表 2,PDF p. 8;MoE 经 400B 预训练 + 80B 续训,百分数,↑。
| 模型 | MMLU | MMLU-Pro | GSM8K | MATH | BBH | EvalPlus | Avg. |
|---|---|---|---|---|---|---|---|
| GDN | 67.43 | 40.55 | 75.93 | 45.94 | 64.25 | 50.09 | 57.37 |
| KDA | 67.32 | 40.60 | 76.21 | 46.87 | 65.04 | 53.82 | 58.31 |
| EDA | 68.12 | 41.71 | 75.99 | 49.28 | 65.81 | 51.78 | 58.45 |
EDA 对 KDA 的 MATH +2.41、EvalPlus −2.04,平均只高 0.14。没有置信区间时应写“报告均值略高”,不能写“显著优于”。相对于预训练时的 1.07 分,领先明显收窄。该设置同时增加 tokens 和训练长度,不能单独识别长度变化的因果作用。
4.4 RULER:短端领先,长端互有胜负
表 3,PDF p. 9;百分数,↑;32k 为续训长度。
| 模型 | 4k | 8k | 16k | 32k | 64k | 128k | Avg. |
|---|---|---|---|---|---|---|---|
| GDN | 92.40 | 90.09 | 87.28 | 82.15 | 67.62 | 45.16 | 77.45 |
| KDA | 93.33 | 89.29 | 85.13 | 79.66 | 72.00 | 42.70 | 77.02 |
| EDA | 93.84 | 90.88 | 87.55 | 81.52 | 71.90 | 44.22 | 78.32 |
EDA 六长度平均领先 KDA 1.30、GDN 0.87 个百分点。EDA 在 4k–16k 最好;32k/128k 最好的是 GDN,64k 最好的是 KDA。三者到 128k 都降至约 43–45 分。摘要中“4k 到 128k 表现最好”的宽泛表述应依据此表解读为聚合平均领先,不是每列最优,也不是已解决超长记忆问题。
4.5 记忆状态:支持独立清理的使用方式,不直接证明任务收益因果
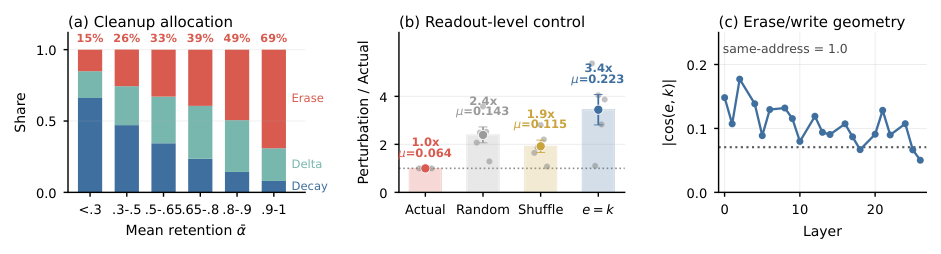
来源:图 2,PDF p. 10,作者原始图转 PNG。三个面板从左向右解释如下。
(a) 门强度分配。 横轴为头内平均保留率 $\bar\alpha$ 的区间;纵轴为归一化门强度份额。以 $b_D=1-\bar\alpha$、$b_\Delta=\bar\alpha\beta$、$b_E=\bar\alpha\gamma$ 定义 $q_m=b_m/\sum b$(式 (23)–(24),p. 9)。蓝、青、红分别代表衰减、delta、独立擦除。全局份额为 35.4%、31.8%、32.8%;当 $\bar\alpha\geq0.9$,擦除占 69.1%,约为同地址修正的 3 倍。它说明弱被动遗忘时更依赖独立清理;不表示删掉 69.1% 的记忆能量,因为未纳入状态投影、各向异性、算子重叠和秩的差异。
(b) 反事实方向的读出扰动。 保留门,替换擦除方向并重放状态序列,观察局部相对扰动 $\|\delta\mathbf o\|_2/\|\mathbf o^-\|_2$。实际、随机、头间打乱、同地址四组原始均值分别为 0.064、0.143、0.115、0.223。图中柱高是各层先相对 Actual 归一化后的倍数,约 1.0、2.4、1.9、3.4;均值比不等于比值均值,不能用 0.143/0.064 覆盖 2.4。学习到的方向在同样门预算下造成更小当前读出扰动,但这不是直接测量下游准确率、删除旧事实的准确率或无害性。
(c) 地址几何。 横轴为层,纵轴为 $|\cos(\mathbf e,\mathbf k)|$;探针输入为 GSM8K few-shot prompts。原文报告平均约 0.105,远低于同地址的 1。128 维独立随机方向参考均值约 0.0707(本次按 $\Gamma(64)/(\sqrt\pi\Gamma(64.5))$ 计算)。这支持“未坍缩成同地址”,但高维随机方向本身就近似正交,不能单靠该图认定语义专门化;0.105 也并非与随机基线完全相同。图的可见纵轴不到 1,“same-address = 1.0”是文字提示,不是 1.0 水平线。
反向证据。 p. 9 和 Sec. 6 明确写 KDA 在原写入键回忆旧 hidden value 的严格探针上更好,但没有展示具体回忆曲线或数值。本次不补造。合理的概念是“为了当前任务更有效地管理有限状态”,不是“任何过去内容都记得更牢”。
五:结论与后续问题
EDA 最清晰的贡献是一个结构简单、可用两次 delta 子步表达的地址级记忆更新规则;报告实验支持在本文 3:1 混合架构和训练设置下提高综合任务均值,探针支持额外地址确实参与条件性清理。相关工作中 GDN-2 的强度解耦与 EDA 的地址解耦可以概念上互补,论文并未验证两者组合收益。
主要边界是:safe gate/参数量未完全隔离;没有独立训练种子的误差统计;续训后的平均差距很小;长端外推并非统一领先;没有清理事件到任务改进的因果追踪;严格历史回忆变差;没有定量吞吐/延迟数据;并行化式 (21) 需要实现级澄清。以上不会否定核心两步递归的意义,但决定了它可被声称的范围。
值得优先做的后续验证(本次建议,非已完成实验):保持 safe gate 和参数量一致,分别去掉擦除、固定同地址、随机地址和反转更新顺序;在多训练种子上检查均值及方差;用带明确失效事件的状态跟踪任务验证删除是否针对过期内容;以式 (8) 的逐步实现作数值基准核对 chunk kernel,再实测 prefill/decode 性能。
组会最值得讨论的问题是:固定大小记忆的目标究竟是保留所有历史,还是保留对后续预测最有用的信息?EDA 的结果支持后一种取向,但尚未完整解释如何把每一次清理与收益对应起来。