Q-Delta:让 query 参与记忆更新
论文:Q-Delta: Beyond Key-Value Associative State Evolution。作者:Sumin Park、Seojin Kim、Noseong Park(KAIST)。arXiv 2606.08804v1,提交于 2026-06-07,arXiv 页面注明 ICML 2026 接收;本次研读与获取日期:2026-10-08。
arXiv · 原文 PDF · 英文汇报 PDF · 可编辑幻灯片 · 论文列出的代码仓库
论文总览
Q-Delta 修改的是线性注意力的记忆更新规则。普通 DeltaNet 先用当前 key 从旧状态中取出一个 value,再根据它与当前 value 的误差更新记忆。Q-Delta 额外读取当前 query 对旧状态的预测,把它加入误差;写入方向仍然是 key。这样,模型最终用来读取记忆的 query,也能影响此后保留下来的记忆内容。(Sec. 3.3.1,PDF p. 5,Eqs. 17–20)
这一改动只增加一个逐 token、逐 head 的反馈强度投影,不增加递归状态。作者将它改写为分块并行算法,并给出混合预测误差的条件收缩与跟踪界。实验证据中,最明显的收益来自 1.3B 模型的合成检索:九个“任务 × 长度”设置的平均准确率为 90.02%,Gated DeltaNet 为 83.51%。语言评测平均分也提高,但真实检索逐项有得有失。(App. B,PDF p. 13;Tables 2–4,PDF p. 8)
理解这篇论文要区分三个对象:用于算误差的方向 $k_t+\lambda_tq_t$、用于写回的方向 $k_t$、用于输出的方向 $q_t$。理论主要分析无遗忘门的混合读出误差;实际模型还包含遗忘门。分块实现则需留意 v1 公式中的转置与衰减因子问题,下面给出统一维度后的推导。
结构地图
下表页码均为从 1 开始的 PDF 页码,与该版本印刷页码一致。
| 原文章节 | 在论证中的作用 | 定位 |
|---|---|---|
| 1. Introduction | 指出 query 只负责读出的结构假设 | pp. 1–2 |
| 2. Backgrounds / 2.1. Linear Transformers | 加性记忆、delta 更新、在线学习与分块计算 | pp. 2–3;Fig. 1、Table 1 |
| 3.1. Query for Value Prediction | 将旧状态 query 读出展开为历史 value 的混合 | pp. 3–4;Eqs. 8–15 |
| 3.2. Complementary Error Signals | 比较 key 与 query 读出的方向和子空间 | pp. 4–5;Fig. 2 |
| 3.3.1. Sequential recurrence | Q-Delta 的无门控及带遗忘门递推 | p. 5;Eqs. 17–19 |
| 3.3.2. Chunkwise parallel form | WY 表示、三角求解与分块输出 | pp. 5–6;Eqs. 20–27 |
| 3.3.3. Stability Analysis of Q-Delta Dynamics | 单步收缩、全局跟踪与经验统计 | pp. 6–7;Lemma 3.1、Theorem 3.2、Fig. 3 |
| 4.1. Experimental Setup | 训练预算、优化设置与吞吐 | p. 7;Fig. 4 |
| 4.2. Evaluation | 语言评测、真实与合成检索、门控消融 | pp. 7–9;Tables 2–5 |
| 5. Conclusion | 将 query 反馈用于状态演化的贡献 | p. 9 |
| A. Datasets / B. Query-Feedback Coefficient | 评测协议、反馈门参数化 | p. 13 |
| C. Theoretical Derivations | value 混合表示与误差界的证明 | pp. 13–16 |
| D. Chunkwise Parallelization of Q-Delta | WY 递推与 UT 变换细节 | pp. 16–18 |
一:动机——记忆写入应怎样利用读出需求
1.1 从累加记忆到误差修正
省略特征映射和归一化后,线性注意力维护一个矩阵状态:
每个 $v_tk_t^\top$ 将 key 与 value 的关联压入固定大小的矩阵。相似 key 会在同一状态里相互干扰;单纯累加没有针对旧关联进行纠正的机制。DeltaNet 把写入值改为预测残差:
这里 $S_{t-1}k_t$ 是“当前记忆认为这个 key 对应什么”。写入的是当前 value 与这份已有预测的差,而不是再次完整累加 value。Gated DeltaNet 进一步先将旧状态乘以遗忘因子 $\alpha_t$,再做残差写入。(Sec. 2.1,PDF p. 2,Eqs. 1–3)
1.2 query 留下的空缺
传统 delta 更新只关心沿 key 的预测,但后续计算实际消费的是沿 query 的读出。作者认为,旧状态沿 query 读出的 $S_{t-1}q_t$ 也包含可用的 value 信息,应当参与决定新状态。
这里的“query-conditioned prediction”是value 表示空间里的预测,不是词表概率,也不是一个单独训练的下一词预测头。它的作用是调整递归层内部的写入残差。当前 token 的 $q_t,k_t,v_t$ 均来自当前隐藏表示,使用 $q_t$ 反馈仍是因果计算。(Sec. 3.1–3.3,PDF pp. 3–5)
二:方法——读误差、写记忆、读输出
2.1 符号与数据流
下面公式先描述单层、单个 head;多 head 分别计算,再经输出映射整合。
| 符号 | 维度或取值 | 含义 |
|---|---|---|
| $q_t,k_t$ | $\mathbb R^{d_k}$ | 输出查询方向、记忆写入地址 |
| $v_t$ | $\mathbb R^{d_v}$ | 当前待写入的 value |
| $S_t$ | $\mathbb R^{d_v\times d_k}$ | 更新后的递归记忆 |
| $\hat v_t=S_{t-1}k_t$ | $\mathbb R^{d_v}$ | 旧状态沿 key 的预测 |
| $\hat o_t=S_{t-1}q_t$ | $\mathbb R^{d_v}$ | 旧状态沿 query 的预测 |
| $o_t=S_tq_t$ | $\mathbb R^{d_v}$ | 更新后的层内读出 |
| $\alpha_t$ | $(0,1)$ | 旧状态保留比例 |
| $\beta_t$ | $[0,1]$;理论中 $(0,1]$ | 残差写入强度 |
| $\lambda_t$ | 实际用 sigmoid,取 $(0,1)$ | query 反馈强度 |
| $x_t=k_t+\lambda_tq_t$ | $\mathbb R^{d_k}$ | 混合预测方向 |
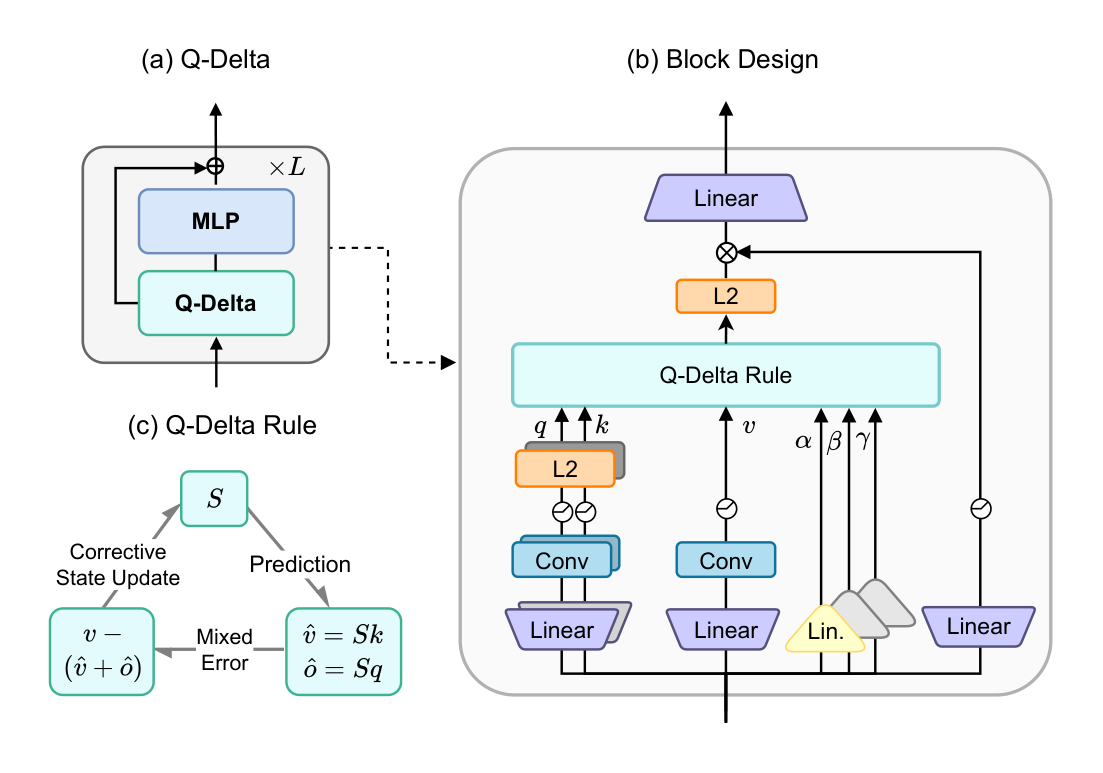
原图 Fig. 1,PDF p. 2。 左侧是 Q-Delta 与 MLP 组成的块,右侧是投影、卷积、归一化与门控路径,下方展示同一状态的两种读出如何组成修正信号。图示中的核心变化集中在 Q-Delta Rule;下面用完整公式明确反馈系数和遗忘因子。
2.2 为什么 query 读出携带历史 value 信息
考虑更一般的线性递推:
每个历史 value $v_\tau$ 只会改变其右侧系数,因此可以归纳得到
为了明确矩阵乘积顺序,可写成
于是
$P_j$ 会持续改变历史 key 的有效方向;当前 query 匹配的是这些经过状态转移后的 key,而不是静态的原始 key。作者称之为“随时间演化的 key”(time-evolved key)。系数 $\gamma_{\tau,t}$ 没有 softmax 归一化,可以为负,所以这是线性混合,不必是凸组合。(Sec. 3.1,PDF pp. 3–4,Eqs. 8–15;App. C.1,pp. 13–14)
这个代数展开对任意探针向量都成立。query 的特殊之处在于,它恰好是模型最终读出状态的方向。这个观察为使用 query 反馈提供动机;它本身没有断言 $S_{t-1}q_t$ 已经是对当前 $v_t$ 的准确估计。
2.3 两种读出为何值得同时考虑
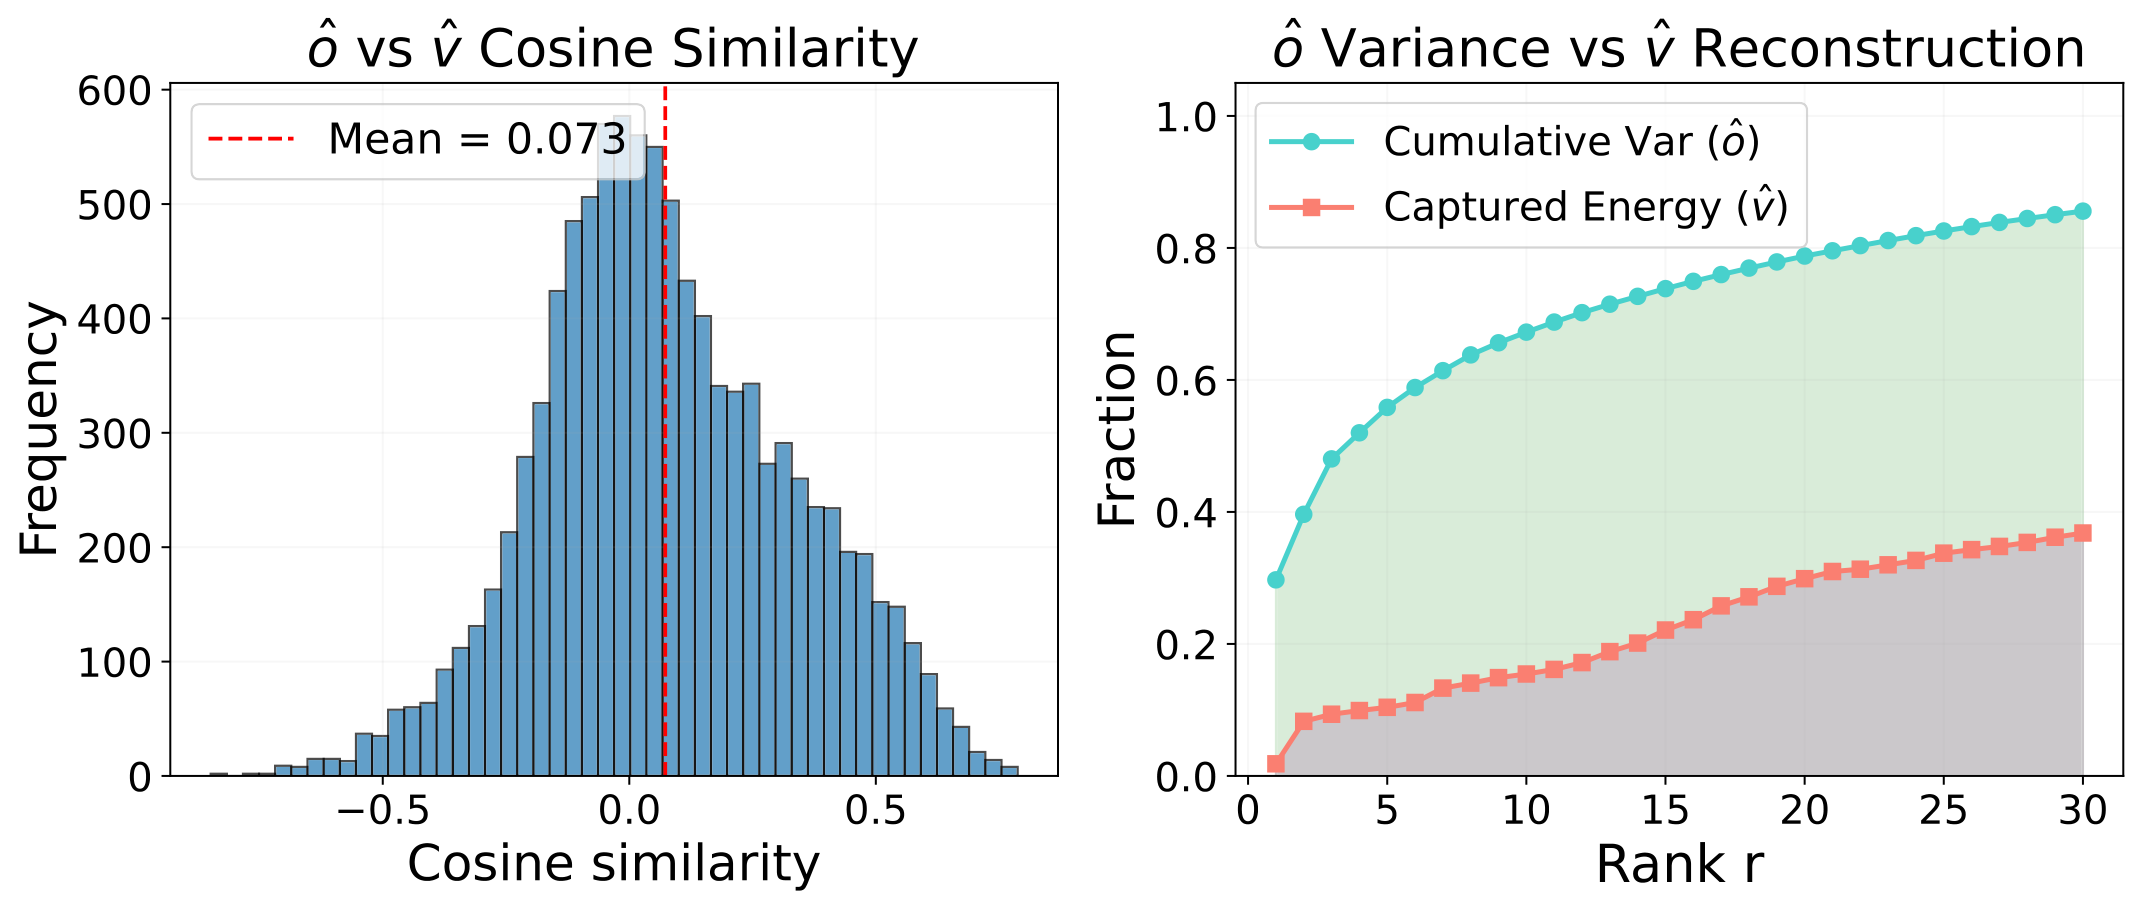
原图 Fig. 2,PDF p. 5;分析文字在 pp. 4–5。 左图横轴为 $\hat o_t$ 与 $\hat v_t$ 的余弦相似度,纵轴为频数。作者在 340M Q-Delta 的第 5、10、15 层收集 10,000 个时间步上的样本;图中均值为 0.073,说明两类读出通常没有高度同向。
右图先对 $\hat o$ 做主成分分析(PCA)。横轴是保留的主成分数 $r$;青色曲线表示这些方向解释的 $\hat o$ 方差,红色曲线表示同一子空间捕获的 $\hat v$ 能量。两条曲线的明显间隔说明,query 读出的主要变化方向并不能充分重构 key 读出。它支持两种读出具有非冗余信息这一解释;具体收益再由消融实验检验。
2.4 Q-Delta 的逐步计算
无遗忘门时,论文提出
令 $x_t=k_t+\lambda_tq_t$,等价形式是
实际模型还包含遗忘门:
这相当于先衰减旧状态,再用衰减后的状态计算混合残差。以下为教学伪代码,对应 Eqs. 19–20(PDF p. 5):
x       = k + lambda * q
S_prior = alpha * S_previous
error   = v - S_prior @ x
S       = S_prior + beta * outer(error, k)
output  = S @ q
因此,带遗忘门时反馈项也要乘 $\alpha_t$,而当前 value 的写入项不乘它。$\lambda_t=0$ 恢复 Gated DeltaNet;$\alpha_t=1,\lambda_t=0$ 恢复 DeltaNet。
这里并不是两个回归误差的凸加权平均:实际残差是 $v_t-S_{t-1}(k_t+\lambda_tq_t)$,没有除以 $1+\lambda_t$,也没有将目标 value 乘 $1+\lambda_t$。
由更新式还可直接推出(本次分析)
query 虽然进入残差,修正仍沿 key 写回。若当前 $k_t^\top q_t=0$,此次写入不改变当前的 query 读出,但改变的状态仍可能被后续 query 使用。
2.5 反馈门、在线目标和计算成本
作者对每个 head 使用
其中 $H$ 是 head 数,$b$ 为初始化到 $-0.8$ 的标量偏置。$\lambda_t$ 随 token 的隐藏状态变化。相较 Gated DeltaNet,新增的是这个投影,递归状态仍为原来的矩阵,不另加 query 记忆。(App. B,PDF p. 13)
论文明确指出,Q-Delta 不是对混合平方损失
做标准梯度下降,因为其负梯度是 $(v_t-Sx_t)x_t^\top$,而 Q-Delta 用 $(v_t-Sx_t)k_t^\top$ 更新。预测方向和写入方向不同,是其稳定性需要单独分析的原因。(Sec. 3.3.3,PDF p. 6)
Table 1(PDF p. 3)给出的在线目标可以理解为另一个每步重新构造的代理目标。固定旧状态,令 $\delta_t=v_t-\alpha_tS_{t-1}x_t$,则
的最小值点恰是 Q-Delta 更新。这个代理目标解释了表格中的在线优化形式,与“不是混合平方损失的梯度步”并不矛盾。
逐 token 递推的主状态运算仍为 $O(d_vd_k)$,整段长度 $L$ 的状态运算为 $O(Ld_vd_k)$;单个 head 的推理状态存储为 $O(d_vd_k)$。这些量描述递归状态部分,不包括训练激活、投影和 MLP。训练时还需要下面的分块并行改写,才能有效使用 GPU。
2.6 分块并行:核心相互作用从 $KK^\top$ 变为 $XK^\top$
将序列切成长度为 $C$ 的块。块间传递一个状态,块内通过矩阵运算求出所有位置的修正。以下统一用行堆叠约定,省略块编号:$Q,K,X\in\mathbb R^{C\times d_k}$,$V\in\mathbb R^{C\times d_v}$,入口状态 $S_{\mathrm{in}}\in\mathbb R^{d_v\times d_k}$。
令
并定义含因果约束的衰减矩阵
这里的 $H$ 为便于讲解新引入,避免与论文中既用于完整比值、又用于严格下三角比值的 $\Gamma$ 记号混淆。
第一步:将连续的秩一更新累积成 WY 表示。 令 $P_i=I-\beta_ix_ik_i^\top$,有
加性 value 项可写成
这两个递推的关键系数都是 $k_i^\top x_r$:此前的写入 key,如何影响当前混合预测。按行堆叠时,它正是 $(XK^\top)_{ri}$。(Sec. 3.3.2,PDF p. 5,Eqs. 21–25;App. D.1,pp. 16–17)
第二步:把这些递推变成下三角线性方程。 记 $\operatorname{sl}$ 为严格下三角部分:
$I+L$ 与 $I+L_\gamma$ 的对角线均为 1,因此可以做三角求解;公式中的逆矩阵不要求实现时显式求一般矩阵逆。这就是原文 UT 变换的计算角色。(主文 Eq. 27,PDF p. 6)
第三步:加入入口状态,得到块输出。 从逐步递推整理可得以下统一写法,属于本次推导:
直观上,$Z$ 是已经消除块内前驱依赖后的有效写入,$H$ 负责把历史写入衰减到当前输出位置。$H$ 包含对角线,所以输出使用的是当前 token 更新后的状态,和 $o_t=S_tq_t$ 一致。固定块长与 head 维度时,计算仍随序列长度线性增长;块内三角求解和矩阵乘法提供硬件并行性。
v1 中会影响照式实现的三处不一致。 App. D.2(PDF p. 18)把 $L_\gamma$ 中的交互矩阵写成 $KX^\top$,但紧接着的分量式要求 $k_i^\top x_r$,与主文 Eq. 27 的 $XK^\top$ 一致。Eq. 26(PDF p. 6)在行堆叠约定下把入口状态项写成 $\overleftarrow W S$,应使用 $S^\top$ 才符合状态维度;同式输出只显式出现因果 mask $M$,按其前一式 Eq. 25 还需要逐位置的 $\gamma_r/\gamma_i$ 衰减。上面的 $Z$ 与 $H$ 形式将这些因素全部写出。这些是原文展示公式的问题,不能据此断言作者的 Triton 内核也有同样问题。
2.7 稳定性:哪个误差收缩,需要什么条件
单步结论
Lemma 3.1 使用无遗忘门的递推,定义
将状态更新式右乘 $x_t$,立刻得到精确恒等式
因此只要 $0<\beta_ta_t<2$,当前样本沿混合方向的误差就在该步缩小。$a_t$ 的含义是预测方向与写入方向的对齐程度:如果写入方向对当前混合输入没有响应,更新就无法纠正这个预测。(PDF p. 6;证明见 App. C.2,p. 14)
一个补充推论:若图 1 中的 L2 归一化使 $q_t,k_t$ 都是单位向量,则
在 $0<\lambda_t<1$、$0<\beta_t\le1$ 时,逐步的 $0<\beta_ta_t<2$ 随之成立。但要有统一收缩率,还要避免 $\beta_ta_t$ 任意接近 0 或 2。
跨时间结论
Theorem 3.2 进一步假设存在统一的 $\rho<1$,满足 $|1-\beta_ta_t|\le\rho$,并定义
前一项是目标漂移,后一项是混合输入变化在旧状态下产生的预测漂移。由于
若 $\|r_t\|\le r$ 对所有时间成立,则
初始误差的贡献几何衰减,持续漂移留下最多为 $\rho r/(1-\rho)$ 的稳态半径。这里控制的是当前混合读出误差,不是整个状态矩阵的范数或语言模型训练损失。(PDF pp. 6–7;证明见 pp. 14–16)
两个条件决定如何解读该结论。第一,逐时刻 $|1-\beta_ta_t|<1$ 不自动推出无限时间上的上确界小于 1;例如 $\beta_ta_t=1/(t+2)$ 始终在区间内,却没有统一的收缩间隔。第二,$r_t$ 包含 $S_{t-1}$,其有界性是定理的额外假设,并非仅由 $\beta_ta_t$ 的条件得出。
实际遗忘门需要额外处理
对于 Eq. 19 的带门控模型,直接计算得到(本次推导)
以及
因此单步修正仍相对于“衰减后的旧状态预测”收缩,但若要沿用同一套跨时间误差定义,需要把遗忘带来的额外项一起约束。原文 Lemma 3.1 与 App. C.2 的证明没有展开这一步;应将其读作无遗忘递推的条件误差界。
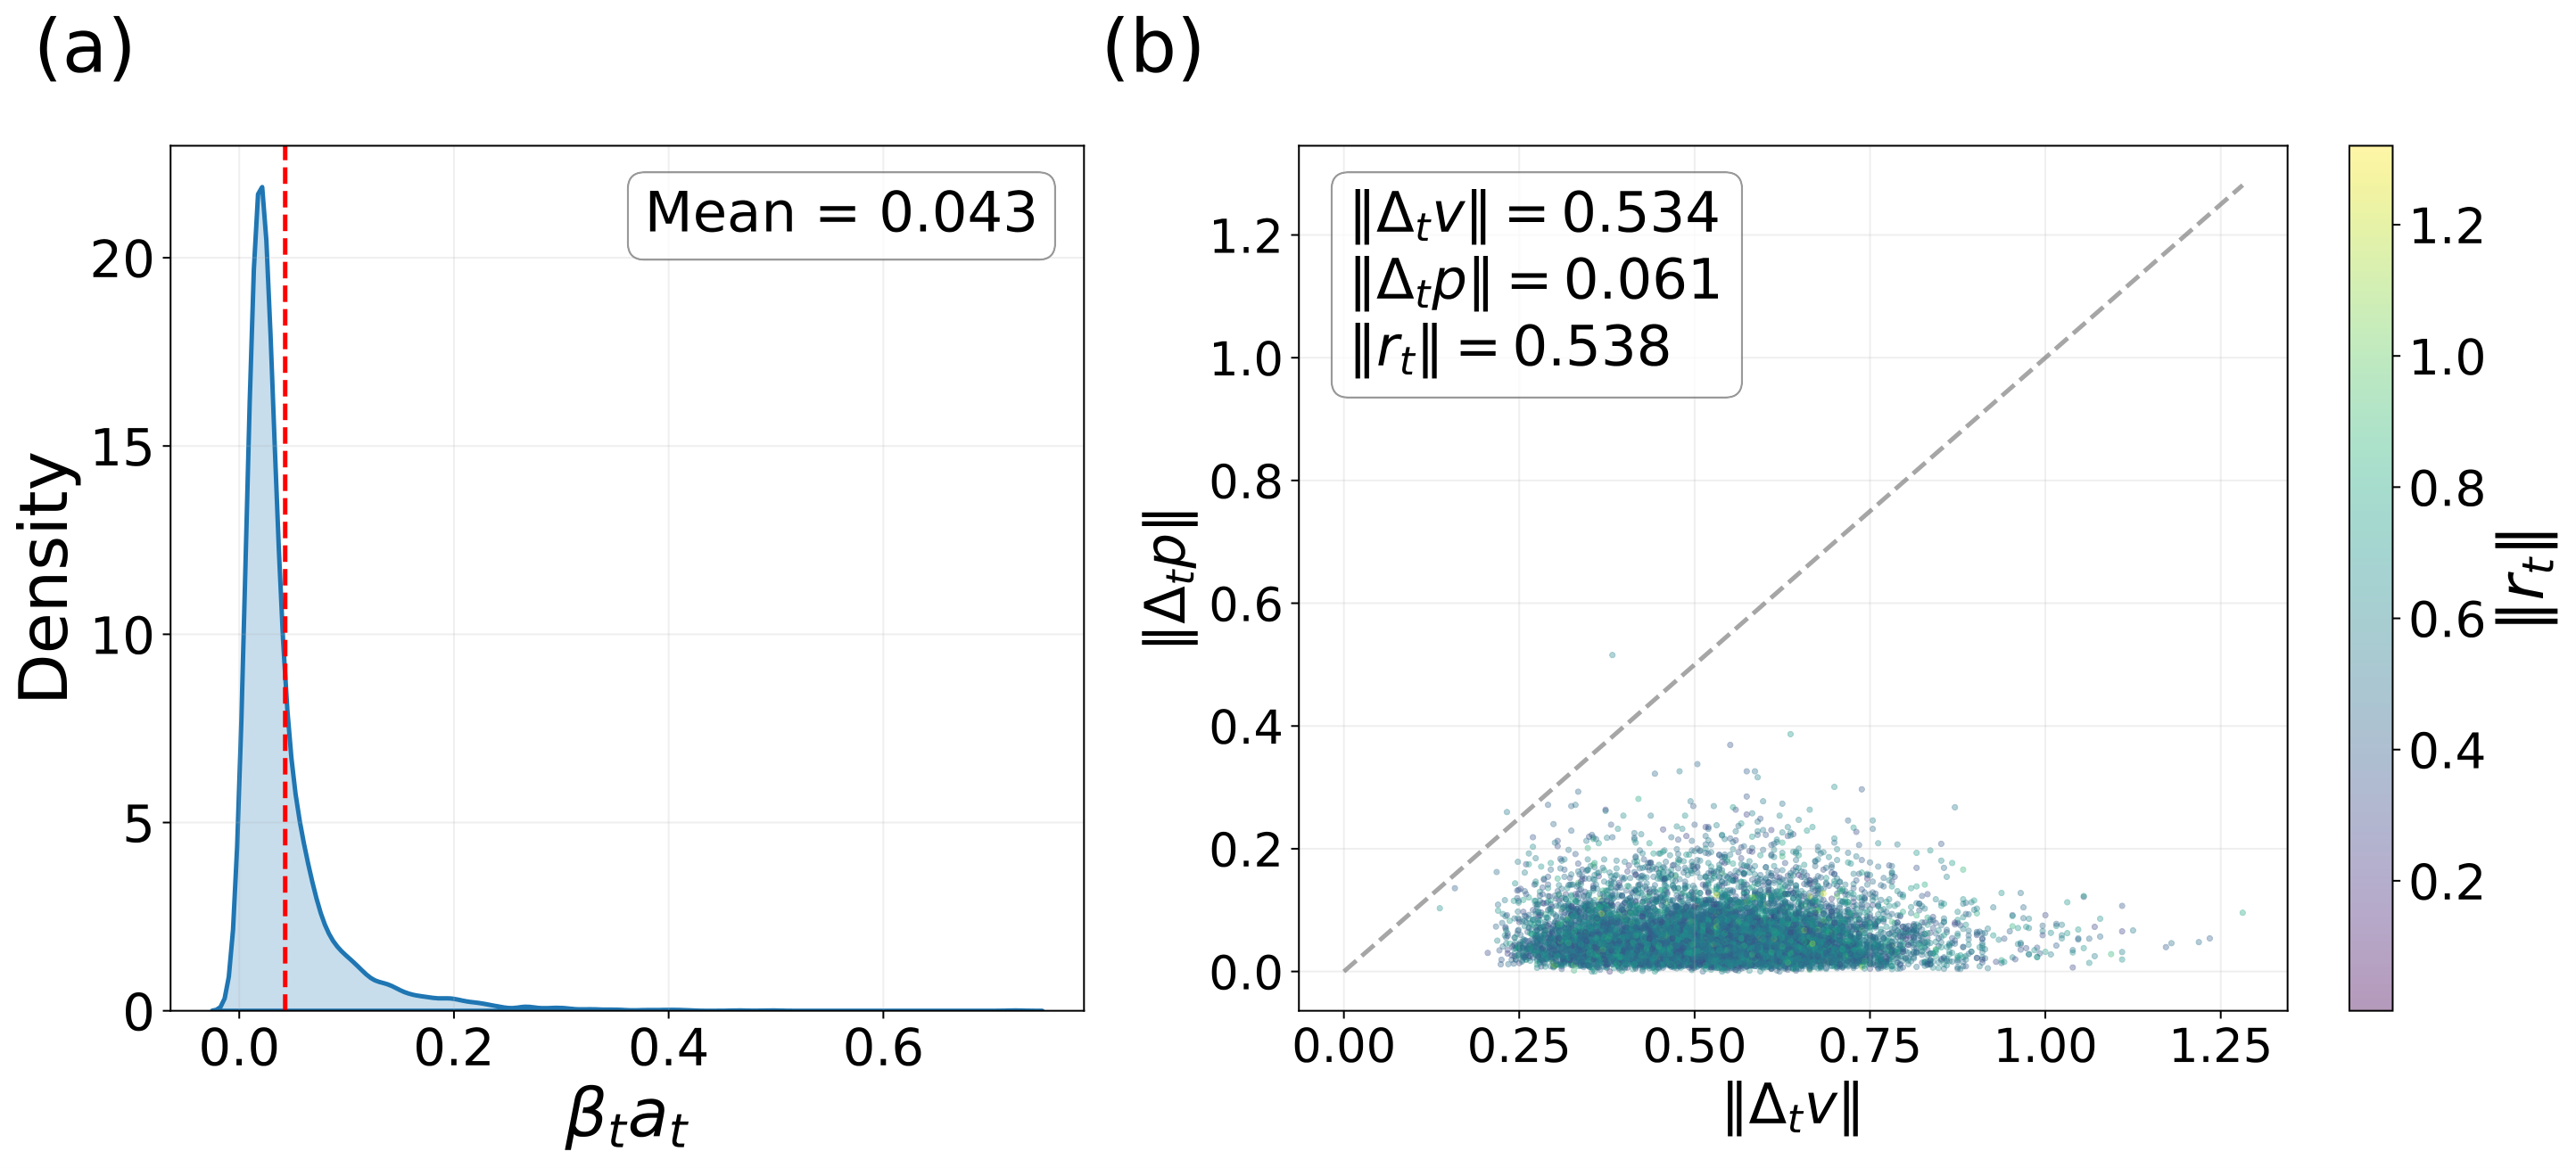
原图 Fig. 3,PDF p. 6;讨论延续至 p. 7。 左图横轴为 $\beta_ta_t$、纵轴为密度,样本位于收缩区间,均值 0.043。右图横轴为目标漂移范数、纵轴为预测漂移范数,颜色表示残余漂移范数;图示均值分别为 0.534、0.061、0.538。预测漂移相对较小,支持该训练轨迹上的误差跟踪较为平稳。分布均值不能直接代入需要最坏情况上界的 $\rho$ 或 $r$,因而图中均值本身没有给出数值上的最坏情况稳态界。
三:实验——各组比较分别检验什么
3.1 模型、训练预算与对照
作者在 flash-linear-attention 框架下重训全部基线,统一使用 FineWeb-Edu、AdamW、余弦学习率调度及梯度裁剪。训练使用 4 张 NVIDIA RTX Pro 6000 Blackwell GPU 和 bfloat16。(Sec. 4.1,PDF p. 7)
| 模型规模 | 预训练 token 数 | 峰值学习率 |
|---|---|---|
| 340M | 15B | $10^{-3}$ |
| 1.3B | 30B | $4\times10^{-4}$ |
RetNet 是带衰减的线性记忆对照;Mamba、Mamba2 是状态空间模型对照;DeltaNet 检验误差修正写入;Gated DeltaNet 是最直接的机制对照,已有遗忘门,主要差异是 Q-Delta 增加 query 反馈及其投影。
3.2 任务、指标和比较口径
| 实验 | 规模与协议 | 指标及其含义 |
|---|---|---|
| 语言建模 | 340M、1.3B;zero-shot | LAMBADA、WikiText 困惑度,越低越好 |
| 通用任务评测 | 同上,LM Evaluation Harness | 八任务准确率算术平均,越高越好 |
| 合成检索 | 1.3B;RULER S-NIAH,1K/2K/4K | 三任务各三个长度的准确率;Avg 为九格平均 |
| 真实检索 | 340M;输入最多 2K;cloze 补全 | 六个 recall-intensive 任务的原表得分,越高越好 |
| 训练效率 | 340M;单 GPU、每设置 50 个训练 step | tokens/s;每步总 token 数保持 32,768 |
| 反馈与遗忘门消融 | 340M | 两种困惑度、八任务平均准确率 |
八任务平均包含 ARC-Easy、ARC-Challenge、HellaSwag、LAMBADA 准确率、PIQA、WinoGrande、BoolQ、OpenBookQA,不包含两列困惑度。LAMBADA 在表中同时有困惑度和准确率,二者不能混用。
真实检索包括 HTML 关系抽取 SWDE、PDF 信息检索 FDA,以及 SQuAD(SQD)、TriviaQA(TQA)、Natural Questions(NQ)、DROP。由于模型没有指令微调,作者使用 cloze 式补全提示。Table 4 没有进一步逐任务标明 EM/F1 等具体评分器,这里沿用“原表得分”,不自行统一改称精确匹配率。(App. A,PDF p. 13;Table 4,p. 8)
合成检索的 S-NIAH-1/2/3 在 Table 3 中分别标为 pass-key、number、UUID;本文按该表使用 UUID 名称,附录 A 将第三项概述为 word-based retrieval。作者把 1K–4K 评测解释为上下文外推,但正文与附录未明确列出预训练的固定上下文长度,因此此处保留确切的测试长度,不补造外推倍数。吞吐测试到 16K,也不能替代 16K 检索质量评测。
四:结果——收益最集中在困难的合成检索
4.1 训练稳定性与吞吐
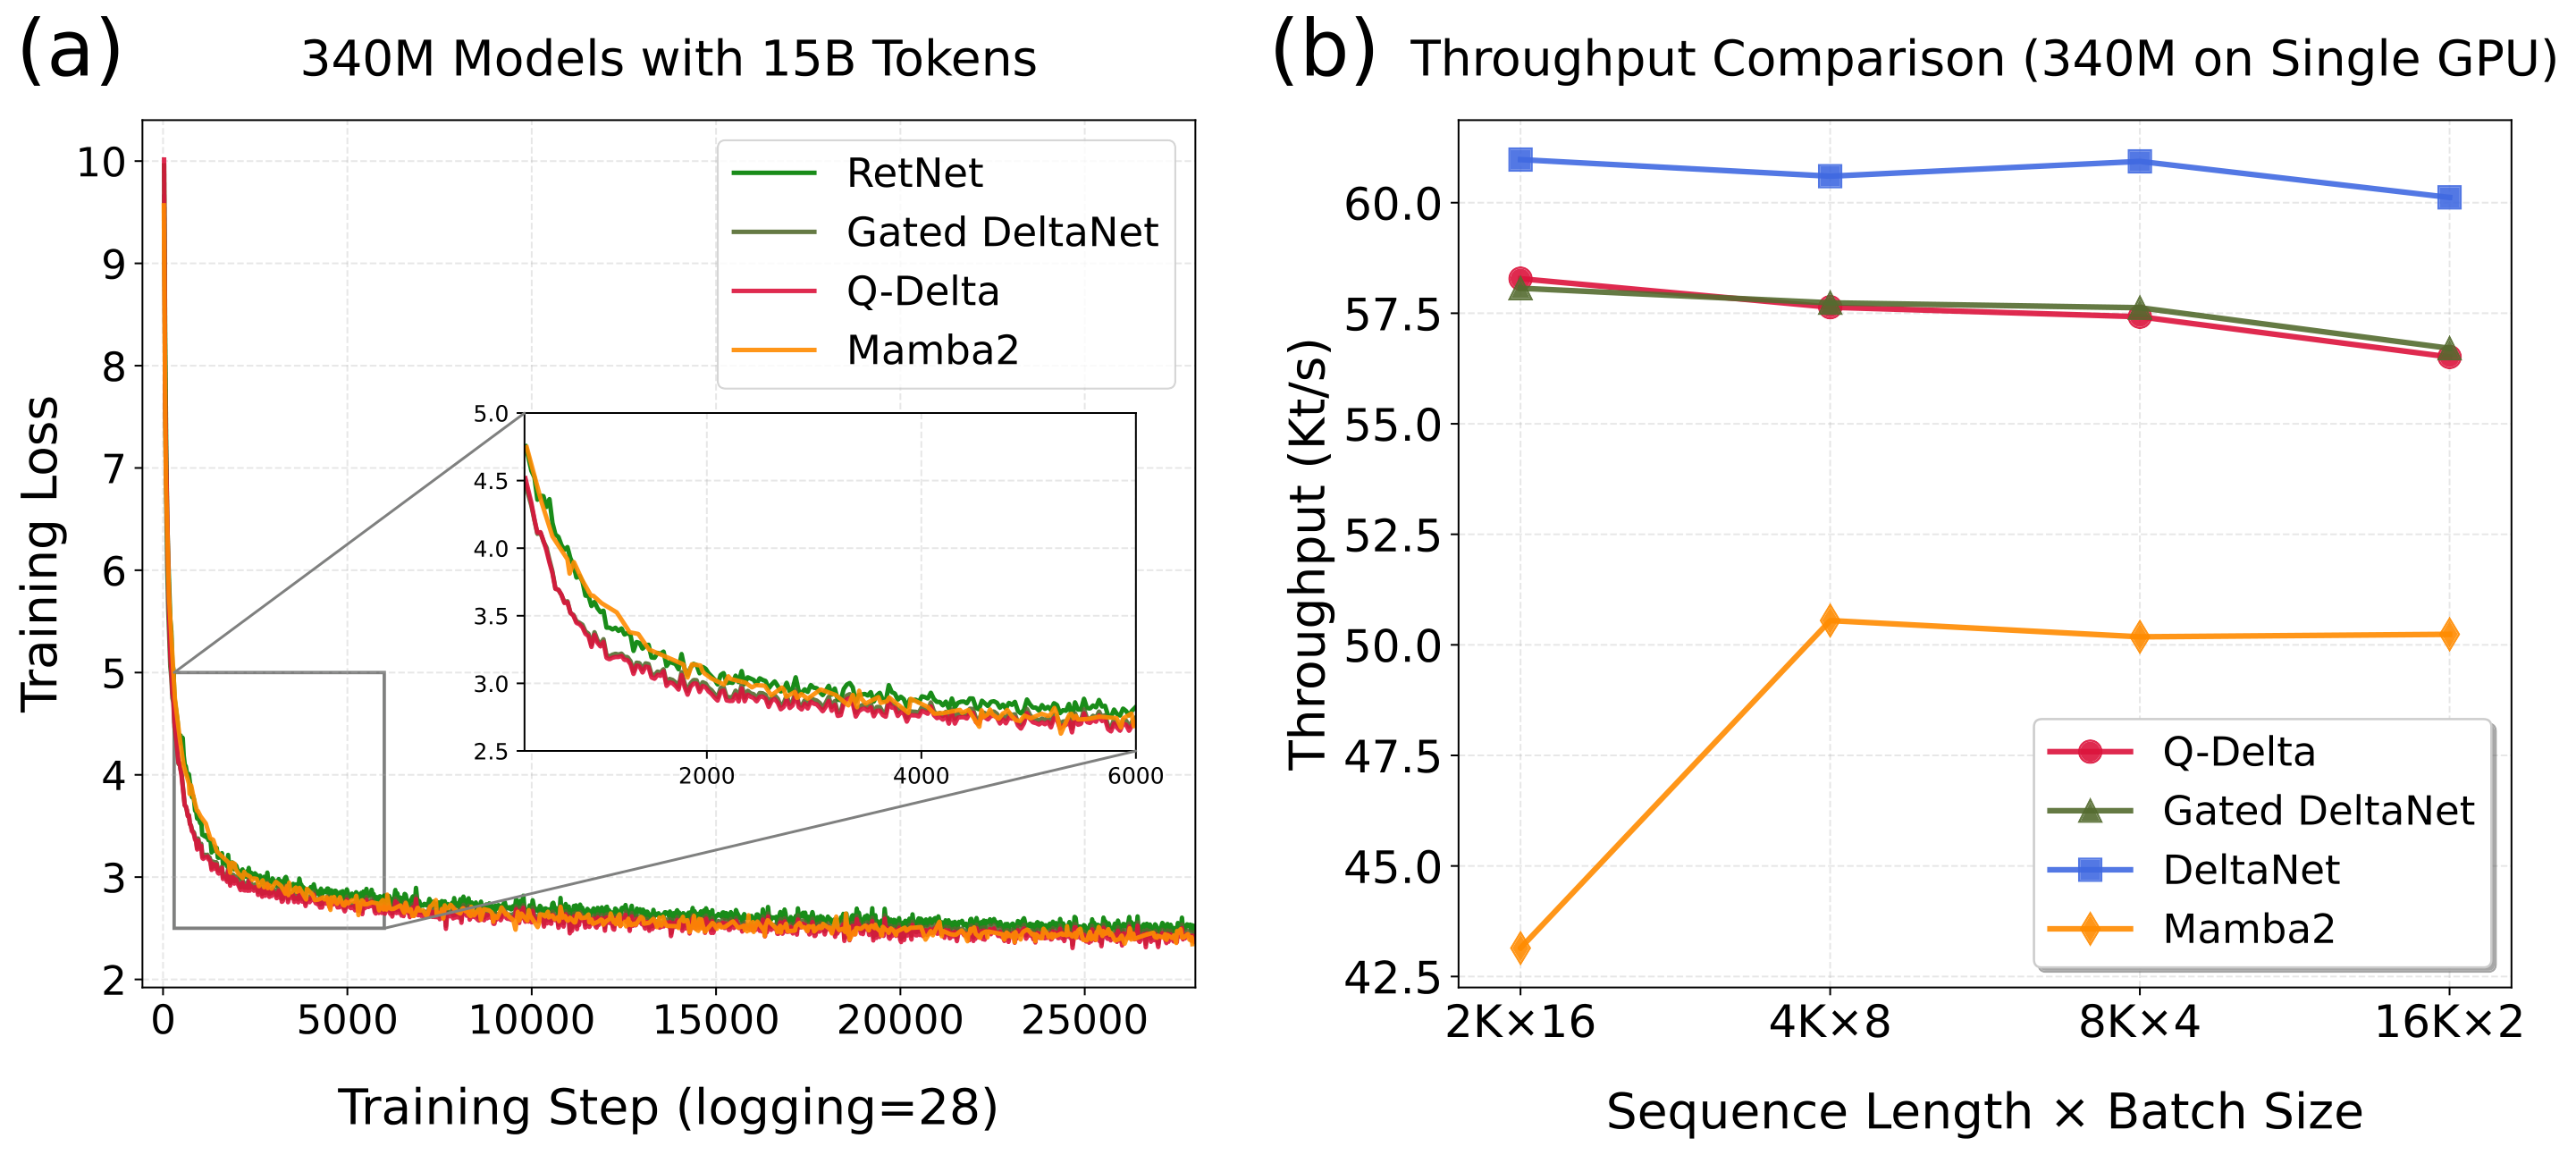
原图 Fig. 4,PDF p. 7。 左图横轴为训练 step,纵轴为训练损失,展示 340M 模型训练 15B tokens 的过程;曲线记录到 28,600 step,每 28 step 记录一次。Q-Delta 的损失平稳下降,放大窗口中没有看到引入 query 反馈造成的明显优化障碍。
右图横轴是“序列长度 × batch size”:$2048\times16$、$4096\times8$、$8192\times4$、$16384\times2$;纵轴单位为千 tokens/s。Q-Delta 与 Gated DeltaNet 曲线基本重合,约在 56–58 千 tokens/s,这是图上近似读数。DeltaNet 的吞吐更高,Mamba2 较低。因此该实验支持的是“反馈改动保留了接近 Gated DeltaNet 的训练效率”。测量对象是训练吞吐,不能换称单 token 解码速度。
4.2 语言建模与 zero-shot 平均分
下表摘取 Table 2(PDF p. 8)中的总体指标;ppl 越低越好,平均准确率越高越好。
| 规模 | 模型 | LAMBADA ppl ↓ | WikiText ppl ↓ | 八任务 Avg. ↑ |
|---|---|---|---|---|
| 340M / 15B | RetNet | 52.29 | 31.36 | 44.55 |
| 340M / 15B | Mamba | 31.20 | 27.50 | 46.64 |
| 340M / 15B | Mamba2 | 30.35 | 26.60 | 46.27 |
| 340M / 15B | DeltaNet | 63.04 | 28.78 | 43.82 |
| 340M / 15B | Gated DeltaNet | 36.27 | 27.82 | 46.01 |
| 340M / 15B | Q-Delta | 32.67 | 26.89 | 47.24 |
| 1.3B / 30B | RetNet | 21.84 | 22.45 | 50.31 |
| 1.3B / 30B | Mamba | 16.98 | 19.89 | 52.39 |
| 1.3B / 30B | Mamba2 | 17.40 | 19.47 | 52.46 |
| 1.3B / 30B | DeltaNet | 16.64 | 19.77 | 52.53 |
| 1.3B / 30B | Gated DeltaNet | 15.32 | 19.61 | 52.77 |
| 1.3B / 30B | Q-Delta | 15.19 | 19.21 | 53.47 |
在 340M 规模,Q-Delta 比 Gated DeltaNet 提高 1.23 个百分点,比其余模型中平均分最高的 Mamba 提高 0.60 个百分点。但两种困惑度均未超过 Mamba2。到 1.3B,Q-Delta 相比 Gated DeltaNet 的平均分增益为 0.70 个百分点,两种困惑度也都是该组最优。
为理解平均值来自哪里,下面列出与直接基线的逐项比较。所有数值均为 Table 2 的百分制准确率。
| 任务 | 340M GDN | 340M Q-Delta | 1.3B GDN | 1.3B Q-Delta |
|---|---|---|---|---|
| ARC-Easy | 60.02 | 59.51 | 68.60 | 68.27 |
| ARC-Challenge | 25.94 | 28.50 | 33.28 | 36.60 |
| HellaSwag | 40.25 | 41.61 | 52.60 | 53.46 |
| LAMBADA accuracy | 31.52 | 33.90 | 43.80 | 43.28 |
| PIQA | 67.30 | 67.63 | 70.84 | 71.44 |
| WinoGrande | 51.54 | 52.88 | 54.78 | 54.93 |
| BoolQ | 57.13 | 59.48 | 59.42 | 61.41 |
| OpenBookQA | 34.40 | 34.40 | 38.80 | 38.40 |
两种规模都在 ARC-Challenge 与 BoolQ 上有较明显增益,但 ARC-Easy 均下降;1.3B 的 LAMBADA 准确率与 OpenBookQA 也下降。平均性能改善说明混合反馈在整体上有效,任务结构仍会影响取舍。
4.3 合成检索:长度增加时拉开差距
Table 3(PDF p. 8)比较 1.3B 模型。下表保留最直接的两类 delta 基线,指标为检索准确率,单位 %。
| 任务 | 长度 | DeltaNet | Gated DeltaNet | Q-Delta |
|---|---|---|---|---|
| Pass-key | 1K | 100.0 | 100.0 | 100.0 |
| Pass-key | 2K | 100.0 | 100.0 | 100.0 |
| Pass-key | 4K | 100.0 | 100.0 | 100.0 |
| Number | 1K | 99.8 | 100.0 | 100.0 |
| Number | 2K | 93.6 | 99.8 | 99.4 |
| Number | 4K | 49.6 | 76.6 | 94.2 |
| UUID | 1K | 87.4 | 83.8 | 94.6 |
| UUID | 2K | 75.8 | 70.0 | 74.0 |
| UUID | 4K | 25.4 | 21.4 | 48.0 |
| 九格平均 | — | 81.29 | 83.51 | 90.02 |
其余基线 RetNet、Mamba、Mamba2 的九格平均依次为 38.09、62.62、76.58。Q-Delta 相比 Gated DeltaNet 的总体增益是 6.51 个百分点,主要差距集中在 4K 的 number 与 UUID,分别提高 17.6 和 26.6 个百分点。Pass-key 已经饱和,区分不了几种 delta 更新。
UUID 随长度增长仍从 1K 的 94.6% 降到 4K 的 48.0%,并且 2K 时 DeltaNet 更好。这组结果显示 query 反馈能缓解困难检索中的遗忘或干扰,但 4K UUID 仍是明显的失败情形。
4.4 真实检索:平均优势很小,任务差异更重要
Table 4(PDF p. 8)使用 340M 模型、最多 2K 输入、cloze 补全。下表的差值为 Q-Delta 减 Gated DeltaNet,单位是原表得分点。
| 任务 | Gated DeltaNet | Q-Delta | 差值 |
|---|---|---|---|
| SWDE | 29.1 | 31.6 | +2.5 |
| SQuAD / SQD | 56.0 | 52.3 | −3.7 |
| FDA | 18.9 | 22.0 | +3.1 |
| TriviaQA / TQA | 48.9 | 48.6 | −0.3 |
| NQ | 18.2 | 18.4 | +0.2 |
| DROP | 34.2 | 33.2 | −1.0 |
Q-Delta 在 SWDE、FDA、NQ 得到全部对照中的最高分;在另三项上低于 Gated DeltaNet。TriviaQA 最优的是 Mamba 的 55.2,比 Q-Delta 高 6.6 分。
原表没有列平均值。按六项等权平均,本次计算得到 Q-Delta 34.35、Gated DeltaNet 34.22(未四舍五入为 34.2167),只差约 0.13 分;Mamba2 为 33.92。原文“平均分最高”的描述在这一算术口径下成立,但“持续匹配或超过各基线”的文字概括比逐项数据更强。对实际任务选择,SWDE/FDA 的增益和 SQuAD 的下降更有信息量。
4.5 消融:反馈本身与自适应反馈的收益要分开
Table 5(PDF p. 9)均为 340M Q-Delta 变体。
| 配置 | WikiText ppl ↓ | LAMBADA ppl ↓ | 八任务平均准确率 ↑ |
|---|---|---|---|
| 可学习 $\lambda_t$ | 26.89 | 32.67 | 47.24 |
| 固定 $\lambda=0.2$ | 26.96 | 35.39 | 46.99 |
| 固定 $\lambda=0.5$ | 26.86 | 33.31 | 47.20 |
| 固定 $\lambda=0.8$ | 26.61 | 33.58 | 46.42 |
| 去除状态衰减,$\alpha_t=1$ | 26.52 | 32.97 | 45.86 |
| 反馈强度固定为 1,$\lambda_t=1$ | 26.55 | 35.21 | 46.36 |
固定反馈已能取得大部分收益。 $\lambda=0.5$ 的平均分 47.20,距可学习门的 47.24 只有 0.04 个百分点。这组数值支持自适应版本取得最佳综合结果,但其额外准确率优势很小;不能把 query 反馈的全部收益都归因于逐 token 门控。
遗忘与 query 反馈提供不同作用。 去掉遗忘门后,平均分从 47.24 降到 45.86;这个无遗忘变体仍比 Table 2 中无 query 反馈的 DeltaNet(43.82)高 2.04 个百分点,支持反馈在没有状态衰减时也有收益。同时,它的 WikiText 困惑度反而是消融表中最好,说明优化取舍不能只用一个指标表示。
原表的 “No gating” 指 $\lambda_t=1$,始终使用完整 query 反馈;它不是 $\lambda=0$ 的关闭反馈实验,也没有移除状态遗忘门。反馈关闭所对应的直接对照是 Gated DeltaNet。
五:结论——可借鉴的设计与尚未解决的问题
这篇论文最有价值的设计是将三种角色拆开:用 $k+\lambda q$ 预测当前 value,用 $k$ 写回修正,用 $q$ 读出结果。它以很小的结构改动让实际读出需求影响记忆更新,并且保留了固定大小状态和分块并行能力。其理论工具也是围绕这个拆分展开:稳定性取决于 $k^\top(k+\lambda q)$ 的对齐,而不是机械套用平方损失梯度下降的解释。
实验最有力地支持的是 340M/1.3B 下平均语言评测改善,以及 1K–4K 合成检索中困难设置的明显收益;训练吞吐接近 Gated DeltaNet。真实检索平均优势只有约 0.13 分,且逐项有下降。可学习反馈门与固定 $\lambda=0.5$ 的差距也很小,因此方法改动的价值比“自适应门一定必要”的论据更充分。
从这里继续研究,最直接的三个问题是:将 $\alpha_t$ 引入完整跟踪证明后,怎样约束新增漂移项;在超过 4K 的实际检索和解码负载上,质量与成本如何变化;在固定反馈与自适应反馈之间,哪些任务确实需要逐 token 调整。这些问题分别接续当前理论、长度评测和消融中尚未闭合的部分。