SparDA:稀疏解耦注意力与长上下文推理
原题:SparDA: Sparse Decoupled Attention for Efficient Long-Context LLM Inference
作者:Yaosheng Fu、Guangxuan Xiao、Xin Dong、Song Han、Oreste Villa
版本:arXiv:2606.04511v1,提交于 2026-06-03;研读与获取日期:2026-10-20。
材料:arXiv · 原文 PDF · 英文汇报 PDF · 可编辑 Beamer。以下页码均为从 1 开始的 PDF 页码。
论文总览
SparDA 的核心,是让模型提前给系统提供下一层的访存需求。普通块稀疏注意力要等本层 Query 产生,才能选块、搬运 KV、计算注意力。SparDA 增加轻量的预测投影 Forecast,在第 $l$ 层生成 $\mathbf F_l$,预测第 $l+1$ 层要读取的历史 KV 块。于是系统可以在当前层计算注意力和 FFN 时,预取下一层的数据。
这次解耦还允许索引器采用更小的头结构:每个分组查询注意力(Grouped-Query Attention,GQA)组只用一个 Forecast 头,而实际注意力继续使用原来的全部 Query 头。它同时降低选块成本、创造传输与计算的重叠窗口。新增参数为 33.5M,约占 8B 模型的 0.41%,只训练 Forecast,冻结骨干。(Sec. 4,pp. 4–6)
在两个已经进行过稀疏训练的 8B 模型上,四类基准的平均分相对 Sparse 提高 0.3 和 2.3 分。H100 上,128K 上下文的 MiniCPM4.1-8B 预填充吞吐为 Sparse 的 1.25 倍;同批量解码最高约 1.69 倍。相对不卸载的 Sparse,扩大可运行批量后吞吐达到 5.28 倍,后一个数字包含显存容量带来的批量收益。(Tables 1、3、4,pp. 7–9)
结构地图
| 原文章节 | 主要作用 | PDF 定位 |
|---|---|---|
| 1. Introduction | 稀疏注意力的选块与 KV 容量瓶颈 | pp. 1–2,Fig. 1 |
| 2. Related Work | 与稀疏选择、压缩及卸载方法的关系 | pp. 2–3 |
| 3. Preliminary / 3.1. InfLLM-V2 | 固定块、局部块、动态块及三级评分 | p. 3,Eqs. (1)–(2) |
| 4.1. SparDA Architecture | Forecast、跨层选块、首尾层处理 | pp. 4–5,Fig. 2,Eqs. (3)–(5) |
| 4.2. Indexer Training | KL 监督、rest bucket、细粒度目标 | pp. 5–6,Eqs. (6)–(7) |
| 4.3. Efficient Implementation | 常驻 UVA 内核与 CTA 配额 | p. 6 |
| 5.1. Experimental Setup | 模型、基准和对照定义 | pp. 6–7 |
| 5.2. Accuracy Results | 聚合分数与长度外推 | p. 7,Tables 1–2 |
| 5.3. Efficiency Results | 选块耗时、预填充和解码吞吐 | pp. 7–9,Fig. 3,Tables 3–4 |
| 6. Limitations / 7. Conclusion | 依赖骨干与扩展方向 | pp. 9–10 |
| A. Algorithm Pseudocode | 预填充与解码调度 | p. 13,Algorithms 1–2 |
| B. Training Details | 数据、优化和训练预算 | p. 13,Table 5 |
| C. Evaluation Details | 注意力预算、位置扩展、评测及硬件 | pp. 13–15 |
| D. Additional Results | 消融、A100、各任务细分 | pp. 15–18,Tables 6–14 |
一:动机——少读 KV,还要足够早地知道读哪里
长上下文推理有三种不同成本:预填充时注意力计算量大;解码时 KV 读取占用带宽;保存整个历史又占用大量显存。块稀疏注意力减少每次真正参加注意力的 token,但未选中的历史仍可能在未来被需要,因此 KV 存储容量仍随上下文增长。
把完整 KV 缓存卸载(offload)到 CPU 可以腾出显存,但随后出现另一条串行依赖:
只减少传输量,不能消除等待。另一方面,选择器仍要扫描历史压缩键:若每个查询都扫描约 $T/s_{C_1}$ 个位置,预填充整体仍有关于长度 $T$ 的二次项。真正稀疏的注意力变便宜后,选择器本身便可能成为主要成本。(Secs. 1、3,pp. 1–3)
作者将已有两类思路结合起来:像 InfiniGen 一样提前一层发起预取,同时像 DSA 的独立索引器一样,让“选哪些位置”和“怎样计算注意力”使用不同表示。SparDA 的区别在于训练跨层 Forecast,并与块稀疏骨干和常驻传输内核配合。其与 InfiniGen 的比较采用了适配到块选择的版本,具体协议见实验部分。(Sec. 2,pp. 2–3)
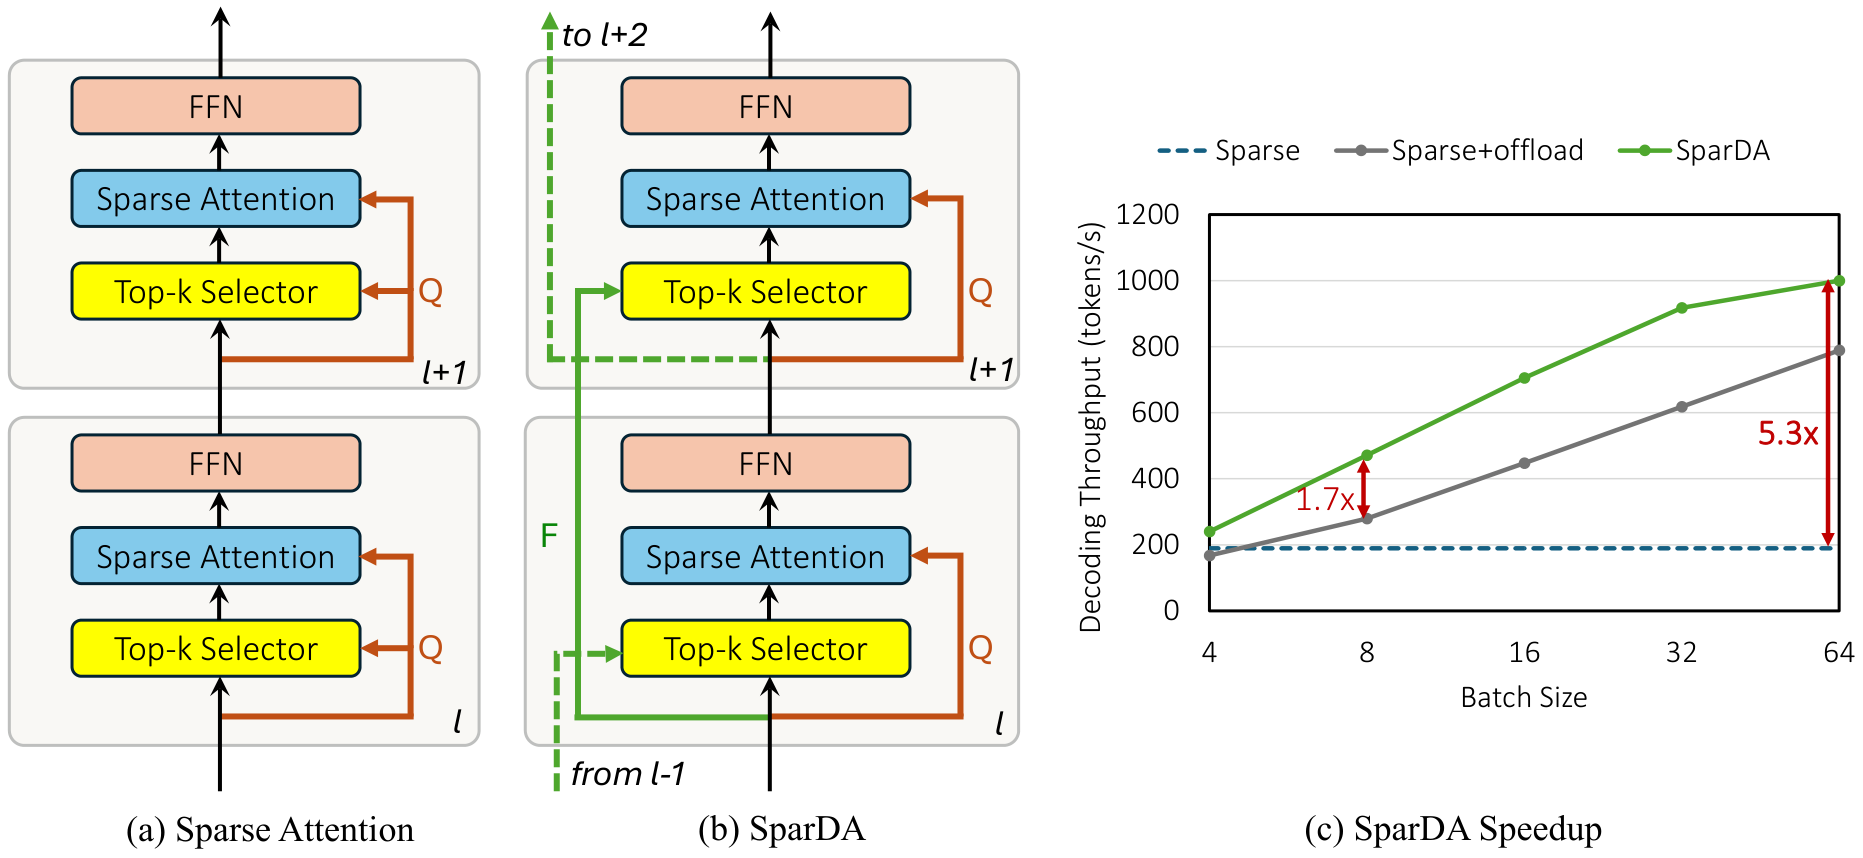
原文 Fig. 1,p. 1。先看左侧:传统 Query 同时驱动选块与注意力;中间的绿色 Forecast 跨到下一层。右侧横轴是 batch size,纵轴是解码吞吐;约 1.7 倍对应同批量卸载比较,约 5.3 倍对应不同可行批量之间的比较。
二:方法——把选块变成可以提前调度的预测
2.1 InfLLM-V2 如何产生稀疏访问集合
对第 $l$ 层、第 $i$ 个查询 token,原文 Eq. (1) 定义:
三项分别保留初始块、附近的滑动窗口、按内容动态选出的远处块。若每块有 $B$ 个 token,则实际注意力每个查询访问约 $|\mathcal B_l(i)|B$ 个 token。(p. 3)
| 符号 | 含义 |
|---|---|
| $T$、$L$ | 上下文长度、层数 |
| $B$ | KV 块大小;实验采用 64 tokens,不是 batch size |
| $H_{\mathrm{kv}}$、$G$ | KV 头数 / GQA 组数;每组包含的 Query 头数 |
| $d_h$ | 为说明维度引入的每头维数 |
| $\widetilde{\mathbf K}_l$ | 从原始 Key 池化得到的压缩键 |
| $l_{C_1},s_{C_1}$ | 压缩窗口大小和步长 |
| $N_b$ | 压缩键网格的位置数,约为 $T/s_{C_1}$ |
| $f_{\mathrm{top}}(\cdot,k)$ | 把压缩网格分数最大池化到块级,再选择 top-$k$ 块 |
| $\tau$ | 原文定义的标准注意力温度 |
原选择器分三步:
压缩键。按重叠窗口做均值池化:
$$ \widetilde{\mathbf K}_{l,j} =\mathrm{Mean}\!\left( \mathbf K_{l,j s_{C_1}:j s_{C_1}+l_{C_1}} \right). $$组内汇总。每个 GQA 组的 $G$ 个 Query 头分别对压缩键打分、做 softmax,再将分数相加。
块级选择。将压缩网格上的共享分数做最大池化,形成最终块分数,选出动态块。
因此,压缩网格位置与最终 KV 块是两级对象。标准压缩窗口为 $(32,16)$,实际搬运的块为 64 tokens;不能把每个压缩键直接当作一个 64-token 块。(Sec. 3.1,p. 3;App. C,pp. 13–14)
2.2 Forecast:用当前层表示预测下一层的访问集合
原文 Eqs. (3)–(5) 给出核心数据流:
$\mathbf F_l$ 决定的是下一层读哪些块,实际注意力的相关性权重仍由 $\mathbf Q_{l+1}$ 计算。略去 batch 维,每个 token 的 Forecast 可理解为 $H_{\mathrm{kv}}\times d_h$,Query 则为 $H_{\mathrm{kv}}G\times d_h$;Forecast 与下一层对应 KV 头的压缩键点积。(Sec. 4.1,pp. 4–5)
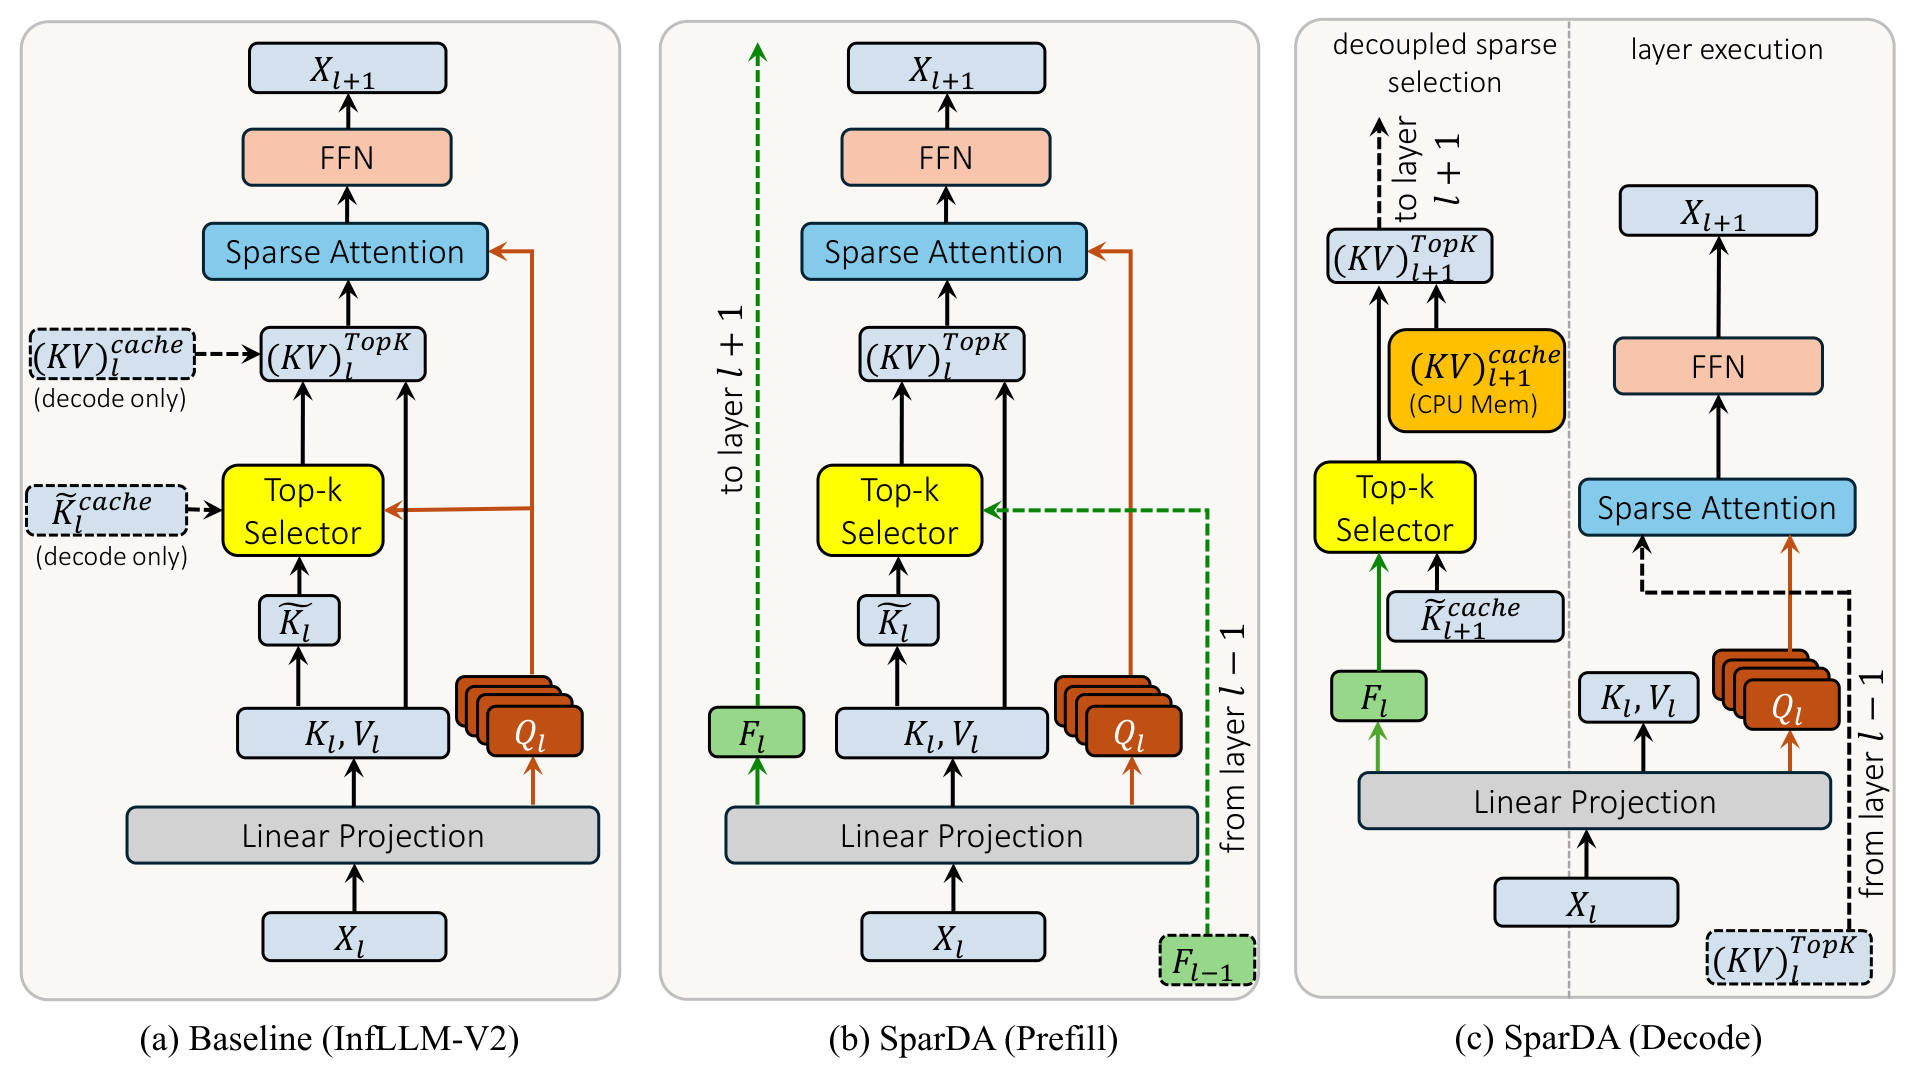
原文 Fig. 2,p. 4。左图是同层依赖;中图在预填充时用上一层的 Forecast 选当前层的块;右图在解码时用当前层 Forecast 选择下一层历史 KV,并将传输安排到独立路径。
提前选块依赖已经缓存的历史 Key。 在自回归解码时,历史 token 在每一层的 KV 都已经缓存。GPU 上保留各层历史 Key 的压缩表示,Forecast 访问的是这个历史索引。初始块和局部块不参与动态候选选择,最新 token 的 KV 位于当前局部区域,因此远处动态块的决策不依赖下一层尚未生成的新 Key。(Sec. 4.1,p. 5)
预填充与解码的获益不同。 预填充仍需先生成当前层整段 Key,随后用保存的上一层 Forecast 评分;这时 KV 已在 GPU,主要收益是简化选择器。解码则能直接利用下一层已有的历史压缩键,真正提前启动 CPU→GPU 预取。
首层没有上一层 Forecast,使用独立的 $\mathbf F_0^{\mathrm{cur}}$ 做同层选择,仍然每个 GQA 组只用一个头。首层 KV 留在 GPU,因此首层不需要等待前一层预取。末层产生的下一层 Forecast 无用途。(Sec. 4.1,p. 5;App. A,p. 13)
2.3 少头、跳过 softmax,改变的是选块成本
多头选择器需要汇总多个头各自归一化后的分数;一个头则可以直接按 logits 排名。对同一个向量,softmax 是保序的;对不相交或重叠候选集合取最大值后,这一单调关系仍保持。因此推理选择路径可以省去 softmax,训练时仍使用它来定义分布,实际注意力内部的归一化也照常进行。(Sec. 4.1,p. 5)
下面是根据机制给出的复杂度解释,忽略池化、top-$k$ 和投影的细节:
$N_b$ 随 $T$ 增长,所以 SparDA 降低了头数等常数开销,未将完整预填充选择变为关于 $T$ 的线性算法。解码只有一个新查询,其评分工作量随历史长度增长;实验中延迟接近水平,是小内核尚未充分占满 GPU 的测量现象。
2.4 用教师选择分布训练 Forecast
目标层 $l$、组 $m$ 的教师与预测分数为原文 Eq. (6):
教师利用目标层真正的多个 Query 头,学生利用上一层 Forecast 的单个头。首层约定 $\mathbf F_{-1,m}=\mathbf F_{0,m}^{\mathrm{cur}}$。因果屏蔽和初始/局部块排除之后,教师确定监督集合 $\mathcal S_l$,两侧最终形成可比较的 $H_{\mathrm{kv}}\times T\times N_b$ 分数。(p. 5)
Eq. (7) 的目标为:
这里横线不是“只留下 top-$k$ 再丢掉其余位置”。它表示 $k+1$ 维分区:教师选中的 $k$ 个位置分别保留,所有其他位置合并为一个 rest bucket,然后重新归一化。教师原始分数是 $G$ 个 softmax 的和,不能直接视作和为 1 的分布;归一化也处理了这一差异。(pp. 5–6)
教学例子:教师分布为 $(0.40,0.30,0.20,0.10)$,选前两个位置;若学生为 $(0.35,0.25,0.15,0.25)$,用于比较的分区分别是 $(0.40,0.30,0.30)$ 与 $(0.35,0.25,0.40)$。学生把过多概率放到集合外,仍会受到惩罚。仅保留前两项再归一化,会丢掉这条约束。
2.5 细粒度教师,粗粒度推理
学生始终用标准 $(l_{C_1},s_{C_1})=(32,16)$ 压缩键;教师改用 $(2,1)$,先在更细的 Key 网格上生成监督分数,再通过最大池化对齐到学生的 $(32,16)$ 网格,之后计算分区 KL。(Sec. 4.2,p. 6)
直觉上,先把 32 个 Key 平均,可能将一个很强的局部匹配稀释。先细粒度评分,再池化分数,更容易保留局部峰值。训练端承担更高分辨率的成本,推理端保留较小的索引。这也解释了为何 Forecast 有机会超过原始参数无关选择器:它接受的监督分辨率更高。
训练用分数网格对齐,与推理中将网格分数池化成最终 KV 块,是不同步骤。文中对监督集合也使用了“blocks”的称呼;实现时需要分别处理压缩位置与实际搬运块,不能仅凭复用的 $k$ 符号将两者混同。
2.6 调度:常驻 UVA 内核与主计算争用资源
按 Algorithm 2,普通中间层的解码顺序可概括为:
- 从 $\mathbf X_l$ 得到 $\mathbf Q_l,\mathbf K_l,\mathbf V_l,\mathbf F_l$,追加当前 KV 并增量更新压缩键。
- 用 $\mathbf F_l$ 读取 GPU 上的下一层历史压缩键,得到 $\mathcal B_{l+1}$。
- 在预取 CUDA stream 发起下一层缺失 KV 块的传输。
- 如有必要,等待上一层已发起的当前层 KV 预取完成。
- 用当前 Query 计算当前层稀疏注意力和 FFN,同时下一层预取继续执行。
GPU 通过统一虚拟寻址(Unified Virtual Addressing,UVA)从 pinned CPU memory 读取 KV。少量常驻线程块(Cooperative Thread Arrays,CTAs)在一次启动中持续处理搬运任务,减少小块拷贝的启动与同步开销。(Sec. 4.3,p. 6;App. A,p. 13)
更多 CTA 有利于传输,却会占用原本用于注意力和 FFN 的 GPU 流多处理器(SM)。随着 batch 增大,传输量近似线性增长,主计算则可能因占用率改善而次线性增长,最佳资源分配随之改变。H100 的启发式为 batch < 32 用 16 CTAs,其余用 32;A100 的阈值为 64。(Table 7,p. 15)
用一个教学近似可以理解重叠窗口:
该式用于解释流水化收益,未计入所有首尾层和资源争用细节,也不是论文给出的性能定理。若传输远长于计算,重叠后仍有等待;若 batch 很小,额外调度成本又可能超过收益。
三:实验——哪些条件决定比较的含义
3.1 模型、预算与对照
| 配置 | 在实验中的角色 |
|---|---|
| Dense | 同一模型的密集注意力配置;效率表中的 Dense$^\dagger$ 全部 KV 常驻 GPU |
| Sparse | 原始块稀疏选择器;效率表中无 $\dagger$ 表示 CPU 卸载 |
| Sparse$^\dagger$ | 原始稀疏选择器,KV 全部留在 GPU,用于分离容量收益 |
| InfiniGen | 无训练的跨层预测对照;适配到块选择,并通过 CPU gather 后传输 |
| SparDA | 训练 Forecast,加上紧凑索引器和异步预取 |
MiniCPM4.1-8B 的骨干为 InfLLM-V2;NOSA-8B 在其上增加与 Query 无关的驱逐头,先减少需要保留/访问的 KV,再使用 Query 相关选择。因此 NOSA 预取流量较少,但也有额外计算成本。(Sec. 5.1,pp. 6–7)
两个模型均采用 64-token 块、1 个初始块和 $(32,16)$ 压缩窗口。App. C 将整体块预算写为 96;MiniCPM 的局部窗口为 2048 tokens(32 块),剩余预算用于 Query 相关选择;NOSA 的局部窗口为 1024 tokens(16 块),Query 相关 top-$k$ 明确分配 24 块。这里应保留各分支配额,不能把“整体 96 块”理解成两个模型都另外选择 96 个远处块。附录没有逐项展开初始块是否计入这个总数。(pp. 13–14)
InfiniGen 原本按 token 选择,本文将其近似分数沿 Key 方向按块大小做 max-pooling,再接相同块选择及稀疏注意力内核。其预填充使用 InfLLM-V2,并额外构造部分 Key 缓存。这一对照同时反映了预测方式和当前系统实现的差异。(App. C,p. 14)
3.2 训练条件
Forecast 训练数据为 ProLong-64K;使用 AdamW,学习率固定 $5\times10^{-4}$,weight decay 0.01,$\beta_1=0.9,\beta_2=0.95,\epsilon=10^{-6}$;有效 batch 为 32,训练 2000 个 optimizer steps,BF16 混合精度,梯度最大范数 0.5。只更新 Forecast 投影,新增 33.5M 参数。(Sec. 4.2,p. 5;Table 5,p. 13)
作者使用 32 张 H100:正文称 MiniCPM 在 64K 下 48 小时以内完成,NOSA 在 32K 下 24 小时以内完成。训练长度有一处原文不一致:同页 Table 5 统一列出 65,536 tokens,而表前文字分别写 64K/32K。复现 NOSA 时需要进一步确认实际训练配置。参数增量很小,但长序列教师分布的计算仍需显著训练资源。
3.3 准确率协议
| 基准 | 检验内容及样本 | 生成与统计 |
|---|---|---|
| HELMET | 7 类:recall、RAG、ICL、rerank、citation、long QA、summarization;每类 100 样本 | 原生最大上下文,贪心生成 50–200 tokens;需要模型裁判的任务用 GPT-5.2 |
| LongBench | 14 个英文任务,涵盖问答、摘要、检索、分类和代码等 | 原生最大上下文,贪心生成,任务上限 32–512 tokens |
| RULER | 13 个合成任务,每任务 50 样本,检查不同形式的检索与聚合 | 贪心生成 30–128 tokens;默认原生长度,另测 32K–128K |
| Reasoning | MATH-500:500 题;AIME 2024/2025:各 30 题 | 采样生成,最终答案由 GPT-5.2 判断;报告三套题的平均准确率 |
原生最大长度分别为 MiniCPM 64K、NOSA 32K。外推时,MiniCPM 使用官方提供的 128K LongRoPE 因子;NOSA 将 rope_theta 从 10,000 改为 40,000,同一模型的所有注意力配置使用相同扩展。(App. C,p. 14)
MiniCPM 仅在 reasoning 打开 thinking,采样 temperature 0.9、top-p 0.95,最多生成 64K tokens;NOSA 不支持 thinking,使用 two-shot 推理示例,temperature 1.0、top-p 1.0,最多 8K tokens。因此应在各自模型内部比较方法,不能把模型间的 reasoning 差值全归因于选择器。
Table 1 的 Avg 是四个基准家族分数的算术平均,并非把所有测试样本合并后算准确率;HELMET、LongBench 包含不同任务评分,宜称“平均分提高多少分”。明确是准确率的 RULER/reasoning 差值,则可用百分点表述。
3.4 效率协议与缓存语义
H100 配置为 80 GB HBM3、CPU–GPU PCIe Gen5×16;A100 为 80 GB HBM2e、PCIe Gen4×16;两套系统均有 2 TB CPU 内存。每个吞吐设置丢弃 1 次 warmup,再平均 2 次测量。预填充固定 batch 4,解码扫描 batch 4–128;吞吐单位是 tokens/s,越高越好。(App. C,pp. 14–15)
所有方法基于 NOSI 推理引擎。引擎默认缓存前一个解码步访问过的块,所以每步主要搬运本次新选中且尚未驻留的块,不能把传输量简单估算为“每层每步把全部选中块重搬一遍”。SparDA 还在 GPU 保存压缩键、首层 KV 和计算所需的缓存/缓冲区;压缩键约为完整 Key 大小的 $1/s_{C_1}$。CPU 承担大部分历史 KV 容量。(pp. 14–15)
四:结果——准确率、选块成本与系统吞吐分别看
4.1 聚合准确率:保持或改善均值,但单任务有取舍
下表取自 Table 1,p. 7;所有分数越高越好。
| 模型 / 方法 | HELMET | LongBench | RULER | Reasoning | Avg |
|---|---|---|---|---|---|
| MiniCPM / Dense | 41.7 | 44.8 | 85.3 | 82.3 | 63.5 |
| MiniCPM / Sparse | 38.9 | 45.0 | 78.2 | 83.6 | 61.4 |
| MiniCPM / InfiniGen | 33.5 | 45.1 | 68.4 | 83.7 | 57.7 |
| MiniCPM / SparDA | 38.3 | 45.1 | 78.7 | 84.7 | 61.7 |
| NOSA / Dense | 39.3 | 42.5 | 86.2 | 41.6 | 52.4 |
| NOSA / Sparse | 32.2 | 42.4 | 72.2 | 50.7 | 49.4 |
| NOSA / InfiniGen | 28.1 | 41.6 | 65.2 | 47.6 | 45.6 |
| NOSA / SparDA | 33.4 | 42.3 | 73.9 | 57.2 | 51.7 |
MiniCPM 的 Avg 为 61.4→61.7,主要由 RULER +0.5、reasoning +1.1 抵消 HELMET −0.6;NOSA 的 Avg 为 49.4→51.7,主要来自 reasoning +6.5、RULER +1.7、HELMET +1.2。LongBench 两者基本持平。
Dense 在两个模型的 HELMET/RULER 上仍明显更好。作者推测这与评测长度长于稀疏预训练长度有关:MiniCPM 的稀疏预训练为 32K、评测为 64K;NOSA 对应 16K/32K。这是作者对差距的解释,表格本身未单独隔离“训练长度”因素。(Sec. 5.2,p. 7)
细分结果说明“总体接近”包含具体能力上的增减:
- HELMET:MiniCPM 的 Recall 67.8→61.5,Rerank 14.7→17.0;NOSA 的 Recall 40.9→45.6,但 LongQA 26.9→26.0。(Table 11,p. 17)
- LongBench:MiniCPM 的 narrativeqa 20.2→22.6,2wikimqa 35.2→34.2;NOSA 的 musique 23.4→24.9,passage retrieval 92.0→90.5。相近均值掩盖了不同任务的方向差异。(Table 12,p. 17)
- RULER:MiniCPM 的
qa_164.0→70.0,但niah_multikey_362.0→56.0;NOSA 对应多键任务 20.0→28.0。难多键检索并未因换索引器而全面解决。(Table 13,p. 17)
Reasoning 的来源更清楚地体现在三个子集:
| 模型 / 数据集 | Sparse | SparDA | 差值,百分点 |
|---|---|---|---|
| MiniCPM / MATH-500 | 97.6 | 97.4 | −0.2 |
| MiniCPM / AIME 2024 | 90.0 | 86.7 | −3.3 |
| MiniCPM / AIME 2025 | 63.3 | 70.0 | +6.7 |
| NOSA / MATH-500 | 72.2 | 71.6 | −0.6 |
| NOSA / AIME 2024 | 40.0 | 46.7 | +6.7 |
| NOSA / AIME 2025 | 40.0 | 53.3 | +13.3 |
来源:Table 14,p. 18。NOSA 的提升主要来自 AIME;每套仅 30 题,+13.3 个百分点约对应多答对 4 题,且这里使用采样生成。三子集等权平均也使 30 题的 AIME 与 500 题的 MATH-500 各占相同权重。
4.2 长度外推:相对优势扩大时,绝对分数仍可能下降
| 模型 / 方法 | 32K | 64K | 96K | 128K |
|---|---|---|---|---|
| MiniCPM / Sparse | 86.1 | 78.2 | 68.7 | 67.7 |
| MiniCPM / SparDA | 87.6 | 78.7 | 70.8 | 68.8 |
| 差值 | +1.5 | +0.5 | +2.1 | +1.1 |
| NOSA / Sparse | 72.2 | 56.6 | 48.8 | 40.7 |
| NOSA / SparDA | 73.9 | 60.5 | 52.9 | 45.0 |
| 差值 | +1.7 | +3.9 | +4.1 | +4.3 |
来源:Table 2,p. 7;RULER 平均准确率,差值单位为百分点。
Forecast 在所有测试长度均高于 Sparse,NOSA 的优势从 1.7 扩大到 4.3 个百分点。不过 SparDA 的 NOSA 自身仍从 73.9 降到 45.0。结果支持“替换选择器后外推表现较好”,同时显示更长上下文的能力损失仍然明显。
4.3 注意力拆分:更便宜的是绿色选块部分
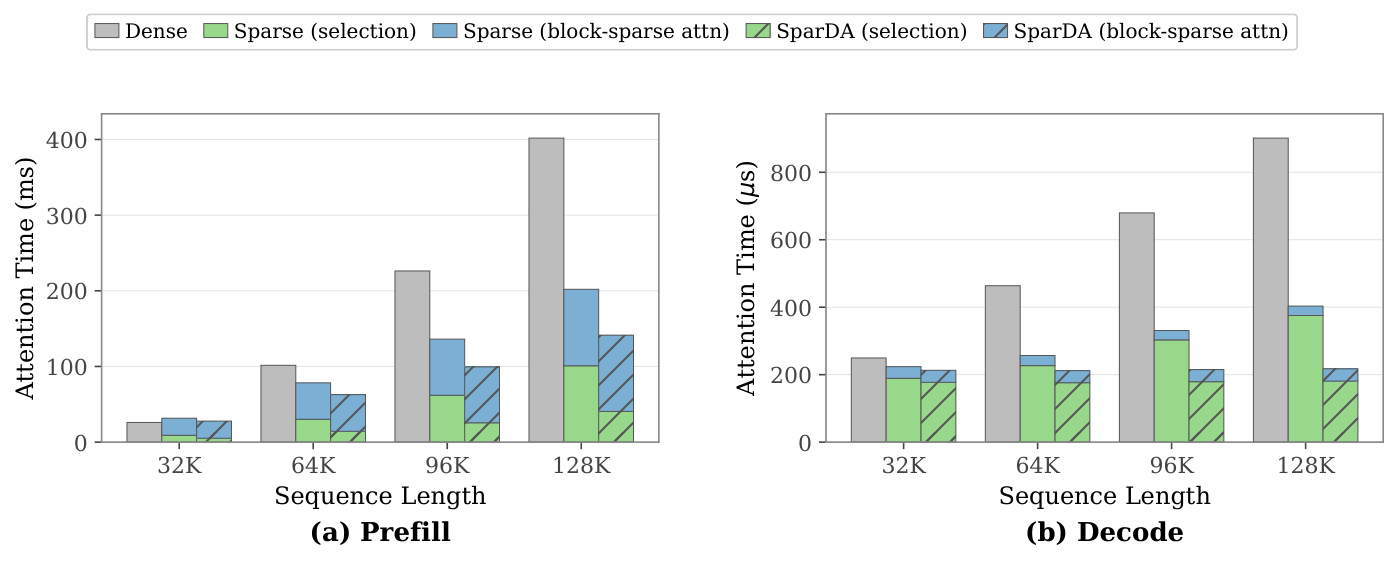
原文 Fig. 3,p. 8;MiniCPM4.1-8B、batch 4。横轴为序列长度;左图纵轴为预填充单层耗时(ms),右图为解码单层耗时(μs)。灰色为 Dense;绿色为选块,蓝色为稀疏注意力;斜线纹理表示 SparDA。
128K 时,作者报告预填充选块部分加速最高 2.50 倍;解码选块成本下降超过 2 倍。相同长度下蓝色部分接近,吻合“主要优化选择路径”的设计。
原文 p. 7 将预填充的稀疏注意力耗时描述为随长度大致不变,但 Fig. 3(a) 的蓝色柱段实际随长度增长。这里按图解释为相同长度下两方法的稀疏注意力成本相近,不将其理解为整段预填充注意力成本与长度无关。右图近乎平坦的 Forecast 选择延迟,则由作者解释为 GPU 尚未充分利用。
4.4 预填充:长上下文的收益来自索引器
H100、batch 4 的关键结果如下,单位 tokens/s。(Table 3,p. 8)
| 模型 / 方法 | 32K | 64K | 128K |
|---|---|---|---|
| MiniCPM / Dense$^\dagger$ | 20388.3 | 13673.7 | 8085.8 |
| MiniCPM / Sparse | 18548.4 | 16254.4 | 13661.8 |
| MiniCPM / SparDA | 19845.6 | 18379.5 | 17087.6 |
| NOSA / Dense$^\dagger$ | 20438.9 | 13701.0 | 8118.0 |
| NOSA / Sparse | 12778.3 | 11359.2 | 9805.2 |
| NOSA / SparDA | 13456.0 | 12386.1 | 11332.7 |
MiniCPM 从 64K 起吞吐领先所有对照,128K 时相对 Sparse 为 $17087.6/13661.8=1.25$ 倍,相对 Dense 为 2.11 倍。NOSA 从 96K 起领先,128K 相对 Sparse 为 1.16 倍。短上下文下 Dense 仍可能更快。
128K 的 MiniCPM 中,Sparse$^\dagger$ 为 13676.1,Sparse 为 13661.8,差别很小。预填充的 KV 使用后可异步回写 CPU,因此此阶段的主要收益是选择器变轻,而非下一层 CPU→GPU 预取。
4.5 解码:同批量加速与容量带来的吞吐增益
下面节选 H100、128K 的 Table 4(p. 9),单位 tokens/s。
| 模型 / 方法 | Batch 4 | Batch 8 | Batch 16 | Batch 64 |
|---|---|---|---|---|
| MiniCPM / Dense$^\dagger$ | 108.6 | OOM | OOM | OOM |
| MiniCPM / Sparse$^\dagger$ | 189.5 | OOM | OOM | OOM |
| MiniCPM / Sparse | 167.8 | 279.5 | 447.9 | 788.9 |
| MiniCPM / InfiniGen | 51.8 | 66.5 | 85.6 | OOM |
| MiniCPM / SparDA | 240.2 | 471.2 | 705.3 | 1000.1 |
| NOSA / Sparse$^\dagger$ | 179.3 | OOM | OOM | OOM |
| NOSA / Sparse | 173.2 | 285.4 | 529.2 | 1298.3 |
| NOSA / InfiniGen | 77.5 | 105.2 | 131.7 | OOM |
| NOSA / SparDA | 219.0 | 399.3 | 735.0 | 1463.3 |
同批量、同为卸载:MiniCPM batch 8 为 $471.2/279.5=1.69$ 倍;NOSA batch 8 为 $399.3/285.4=1.40$ 倍。这最接近“改换索引与调度,在同样并发量下能快多少”的问题。
各方法可行批量下的吞吐:MiniCPM 的 SparDA batch 64 与 Sparse$^\dagger$ batch 4 相比为 $1000.1/189.5=5.28$ 倍;对 Dense$^\dagger$ batch 4 为 9.21 倍。5.28 倍不代表单请求延迟缩短到约五分之一。
容量充足时的取舍:在 32K、MiniCPM batch 16,Sparse$^\dagger$ 为 1073.0,SparDA 为 918.5;无需卸载的 GPU 常驻路径仍有优势。NOSA 在 32K、batch 4 时,SparDA 214.7 也低于 Sparse 244.0,说明小批量的预取调度成本可能抵消收益。
显存仍有长度依赖:96K 时 Sparse 可运行 batch 128,而 SparDA 因首层完整 KV 留在 GPU,在该批量 OOM;SparDA batch 64 的峰值吞吐仍高于 Sparse batch 128。压缩键、首层缓存和工作缓冲意味着这种卸载并未把 GPU 内存需求变成与长度无关。(Sec. 5.3,pp. 8–9)
InfiniGen 的低吞吐,作者主要归因于 CPU gather 后再传输的瓶颈;其准确率下降则归因于相邻层隐藏状态代理不够准确。两种退化对应不同环节,不能只用其中一个解释所有结果。
4.6 消融:准确率改善来自哪里,异步预取何时必要
监督分辨率。 固定学生/推理窗口为 $(32,16)$,只改变教师压缩窗口:
| 模型 / 教师窗口 | RULER | Reasoning | 四家族 Avg |
|---|---|---|---|
| MiniCPM / $(32,16)$ | 75.7 | 82.5 | 60.4 |
| MiniCPM / $(2,1)$ | 78.7 | 84.7 | 61.7 |
| NOSA / $(32,16)$ | 71.4 | 55.4 | 50.1 |
| NOSA / $(2,1)$ | 73.9 | 57.2 | 51.7 |
来源:Table 6,p. 15。MiniCPM 的 RULER +3.0、reasoning +2.2;NOSA 为 +2.5、+1.8 个百分点。尤其是 MiniCPM 粗粒度教师的 Avg 60.4 低于原始 Sparse 的 61.4;因此准确率结果不能只归功于“加一个跨层线性投影”,教师设计是完整方案的关键部分。
选块与预取拆开。 H100、128K 的解码消融如下;“不预取”仍保留 Forecast 选择器,但同步读取 KV。(Table 10,p. 16;tokens/s)
| 模型 / 方法 | Batch 4 | Batch 16 | Batch 64 |
|---|---|---|---|
| MiniCPM / Sparse | 167.8 | 447.9 | 788.9 |
| MiniCPM / SparDA 不预取 | 247.3 | 505.9 | 696.9 |
| MiniCPM / 完整 SparDA | 240.2 | 705.3 | 1000.1 |
| NOSA / Sparse | 173.2 | 529.2 | 1298.3 |
| NOSA / SparDA 不预取 | 226.5 | 653.0 | 1063.8 |
| NOSA / 完整 SparDA | 219.0 | 735.0 | 1463.3 |
batch 4 时,简化索引器已能带来明显收益,异步流水线反而有少量开销。batch 64 时,不预取版本在两个模型上均低于 Sparse;完整 SparDA 相对不预取分别快 43.5% 和 37.6%。这说明在高吞吐区间,仅有便宜索引还不够,必须把通信藏进计算窗口。
CTA 配额。 H100、MiniCPM、32K 的 Table 7 显示,batch 16 时 16 CTAs 为 918.5 tokens/s,64 CTAs 降至 737.3;batch 64 时则 64 CTAs 达到 1380.2,高于 16 CTAs 的 1255.9。启发式在 batch 64 采用 32 CTAs,得到 1328.0,距该列最佳低约 3.8%。它是简单的资源折中,并非每个配置下的精确最优。(p. 15)
4.7 A100:方向一致,通信重叠收益较小
| A100、128K 条件 | Sparse | SparDA | 吞吐倍率 |
|---|---|---|---|
| MiniCPM 预填充,batch 4 | 6299.2 | 7756.8 | 1.23× |
| NOSA 预填充,batch 4 | 4717.1 | 5477.5 | 1.16× |
| MiniCPM 解码,batch 8 | 195.1 | 303.3 | 1.55× |
| NOSA 解码,batch 16 | 395.6 | 526.3 | 1.33× |
来源:Tables 8–9,pp. 15–16;吞吐单位 tokens/s。索引器的预填充收益在 A100 上仍存在;解码最高同批量收益低于 H100 对应的 1.69/1.40 倍。两个硬件配置同时改变 GPU 计算能力、HBM 与 PCIe 代际,因此这些表支持跨硬件有效,不能单独用来量化 PCIe 代际的因果贡献。
五:结论——让稀疏性尽早暴露访存计划
SparDA 最有启发的设计,是将选块结果视为可以提前生成、交给运行时调度的信号。Forecast 用较小的头结构生成这条信号,细粒度教师使其保持可用的选择质量,常驻 UVA 内核再把“早知道”转化成“早搬到”。消融显示这三个部分各有作用。
对于部署,关键判断是上下文长度、可容纳的 batch、实际缺失块流量与可重叠计算窗口是否匹配。当 KV 可以舒适地全部留在 GPU 时,原稀疏路径可能更快;当长上下文限制并发量时,CPU 卸载的容量收益与 Forecast 的调度收益可以叠加。论文最醒目的 5.28 倍,正是后一种设置。
方法仍依托已有的块稀疏骨干。其块结构与注意力计算规则得到保留,但具体选中的动态块会变化,因此任务分数既能提高也能下降。作者将其描述为受骨干稀疏质量限制的增强模块;实验中相对 Dense 的长检索差距仍然存在,这一限制很具体。(Sec. 6,p. 9)
论文也提出扩展到 DSA/CSA 的 token 级选择和更大模型。这是后续方向,本篇直接证据来自两种基于 InfLLM-V2 的 8B 模型。对研究而言,值得继续验证的是:不同骨干能否学到同样可靠的跨层访问预测,以及更多层的提前量能否在预测误差、缓存占用和可隐藏传输时间之间取得更好的折中。
组会讨论
- 固定同样的 GPU 驻留缓存预算,怎样分别量化“选得更好”“选得更早”和“上一步块复用”的贡献?
- 若下一层与当前层相差较大,Forecast 需要更强的非线性表达,还是细粒度教师已足够?
- 真实请求的长度与 batch 动态变化时,CTA 数量、预取深度和缓存保留策略能否共同自适应?
这些问题由本次分析提出,用于进一步理解机制,不是论文已完成的实验。