Language Models Need Sleep:中文精读笔记
论文:Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories
作者:Ali Behrouz、Farnoosh Hashemi、Adel Javanmard、Vahab Mirrokni(Google Research / Cornell University)
版本:arXiv:2606.03979v2,2026-07-10 修订;本次获取与研读:2026-09-29。
材料:arXiv 版本页 · 原文 PDF · 作者 TeX 主文件 · 英文汇报 PDF · 可编辑 TeX
本次使用同版本 PDF 与作者 TeX,阅读 main.tex 实际引入的 MainText/Intro.tex、Background.tex、Methods.tex、Experiments.tex 和完整 Appendix/RelatedWork.tex,并核对关键引用的书目信息。覆盖正文 §1–5、附录 A.1–A.4 与 B.1–B.5;未独立复现训练,也未逐篇核验相关工作。本文 PDF 共 26 页,以下页码均从 PDF 第 1 页起计,与印刷页码一致。原图依作者 CC BY 4.0 许可署名引用,来源和裁切坐标保存在 图件清单。
论文总览
这篇论文研究的问题是:模型能否在持续接触新信息时,把上下文中的临时知识转入更稳定的参数,同时为下一轮学习腾出空间?
作者把模型运行分成接收新信息的 Wake 和集中处理已有信息的 Sleep。Sleep 包含两步:先做记忆巩固(Memory Consolidation),在较慢的记忆层增加低秩专家,将较快层的知识通过自蒸馏迁入其中;再做 Dreaming,生成候选训练材料,挑选能改善任务表现的材料,学习更有效的自我更新策略。
方法的技术主线是 多时间尺度记忆 + 新参数承接知识 + 更新前自蒸馏 + 合成数据适配。其中最值得关注的是教师与学生的状态安排:教师保留更新前的记忆,学生预先模拟快层更新和旧专家重置后的状态,只训练慢层的新专家来弥补将要丢失的知识。
证据较清楚的结果包括:Qwen3-8B 在 AIME-24 的 average@16 从 OPSD 的 76.6 提高到 79.2;四层 Sleep 在 200 篇 SQuAD 段落学习后的无原文问答准确率为 46.2%,SEAL 为 43.2%。这些结果支持所测设置中的增益,但不能据此认定已解决通用、无限期持续学习。ARC、BABILong 的口径,以及若干图文不一致,需要单独说明。
结构地图
| 原文章节 | 论证作用 | PDF 页码与证据 |
|---|---|---|
| §1 Introduction | 静态参数、遗忘与睡眠类比;提出两个阶段 | pp.1–4,Fig.1 |
| §2.1 Notation;§2.2 Continuum Memory System | 多频率参数与更新规则 | pp.5–6,Definition 1,Eqs.(1)–(2) |
| §2.3 Sleep Terminology in the Literature | 与回放、空闲时上下文处理的区别 | p.6 |
| §3.1 Learning Phases in Continual Learning | 区分在线与离线巩固 | pp.6–7 |
| §3.2 Memory Consolidation: Parameter Expansion | 慢层扩展低秩专家 | p.7,Fig.2 |
| §3.3 Memory Consolidation with Knowledge Seeding | 状态切换、GKD、模仿奖励、重置 | pp.7–9,Eqs.(3)–(4);两项目标无编号 |
| §3.4 Dreaming: A Self-Modifying Process | 随机专家、梯度筛选、适配后奖励 | pp.9–10,Eq.(5) |
| §4.1 The Effect of Memory Consolidation | 分类、长上下文、翻译、BABILong、数学;后半节扩展到完整 Sleep 的知识注入和 ARC | pp.11–13;Figs.3–4 位于 p.10,Figs.5–6 位于 p.11,Tables 2–4 位于 p.12 |
| §4.2 Ablations on the Design Choices | 巩固与 Dreaming 组件消融 | p.13;Table 1 位于 p.11,Table 3 位于 p.12 |
| §5 Conclusion | 总结主张 | p.13 |
| References | 书目 | pp.14–21 |
| Appendix A.1–A.4 Related Work | PEFT、自蒸馏、上下文压缩及作者的工作定位 | pp.22–25;Figs.7–8 位于 p.22 |
| Appendix B.1 Datasets | 数据范围与部分架构配置 | p.25 |
| Appendix B.2–B.5 | BABILong 限定、ARC 分母、训练配置、效率 | p.26,Table 5 |
一:动机——记住、巩固、再学习是不同问题
1.1 从暂存知识到参数知识
常规冻结 Transformer 可以利用上下文回答新知识问题,但上下文被移除后,这段新知识不会自动变成长期参数的一部分。持续微调能写入参数,却可能改变旧任务所依赖的计算。论文希望在适应速度与记忆稳定性之间引入多个层次,而非只保留“上下文暂存 / 固定预训练权重”这两个端点。
这里应区分三种操作:
- ICL:通过当前输入和内部状态影响预测;并不自动意味着部署中的投影权重接受了梯度更新。
- 在线巩固:在处理输入时,通过端到端学习逐步更新不同频率的记忆层。
- 离线巩固:暂缓接收新信息,利用已有模型产生的信号,把快层知识迁移到慢层新参数。
作者在 §2.2 用关联记忆视角把 attention 视为高频记忆。把这一视角解释为“普通 Transformer 推理时不断训练其 Q/K/V 投影矩阵”是不正确的;应区分上下文状态与通常意义上的训练权重。(pp.5–6)
1.2 相对已有工作的新增部分
按本文对相关工作的定位,Hope / Nested Learning 已有不同更新频率的记忆模块;Sleep 增加周期性的显式巩固、新专家扩展和快层专家重置。GKD 提供在学生生成轨迹上蒸馏的基础;本文叠加向更大容量的自身蒸馏与 Learning to Imitate。SEAL 提供用适配后的下游效果训练自编辑生成策略的思路;本文加入先巩固、随机专家以及候选材料筛选。(§§2–3;Appendix A)
“Sleep”是算法组织方式的类比,不是神经科学等价性证明。作者主张用 Wake / Sleep 描述生命周期,也不意味着实验无需区分训练与留出评测:本文 ARC 实验本身就使用留出任务。
二:方法——知识迁移到哪里,更新何时生效
2.1 连续记忆系统:把保留期限写进更新日程
关键符号如下。
| 符号 | 意义 |
|---|---|
| $f_\ell$ | 第 $\ell$ 层在一个基准时间单位内的更新次数;越大更新越快 |
| $C^{(\ell)}$ | 该层两次更新的步间隔;越大更新越慢 |
| $\boldsymbol\theta^{(f_\ell)}$ | 该频率层的参数 |
| $\ell^*-1,\ell^*$ | 本轮巩固的发送层、相邻接收层 |
| $d,d_{\mathrm{low}}$ | 隐藏维度与低秩瓶颈维度,$d_{\mathrm{low}}\ll d$ |
| $p_T,p_S$ | 本笔记为简化书写引入的教师、学生分布;对应原文 $\mathrm{LM}_{\boldsymbol\theta}$、$\mathrm{LM}_{\boldsymbol\theta_{\mathrm{exp}}}$ |
输入经过一串 MLP,原文 Eq.(1) 为:
原文定义 $C^{(\ell)}=\max_{\ell'}C^{(\ell')}/f_\ell$,并假设相邻更新周期整除。参数更新为 $\boldsymbol\theta^{(f_\ell)}_{i+1}=\boldsymbol\theta^{(f_\ell)}_i-\boldsymbol e_{i,\ell}$,其中 Eq.(2) 写作:
$\eta$ 是学习率,函数 $f(\cdot)$ 是优化器误差信号,例如梯度;它与更新频率 $f_\ell$ 不是同一个对象。直觉是“积累若干步的学习信号,在该层日程到期时更新”。原式求和上下界均含端点,字面上包含 $C^{(\ell)}+1$ 项;论文没有进一步澄清这一索引细节,复现时不能直接把它当作已经明确的 $C^{(\ell)}$ 项实现。(§2.2,p.5)
频率与周期的记号有混用。 §3.2 把 1K 和 10K 称为频率,但随后说明前者比后者更新快十倍;这实际是在描述更新间隔。Fig.7 也把 1000、5000、10000 标成 $f_W$,图注却称其为窗口。方法解释应使用 $f$ 表示次数、$C$ 表示间隔;Fig.4 的“Lowest Freq = 512 / 2K / 8K”不能不加说明地换算成明确的 token 更新周期。
2.2 在接收层增加低秩专家
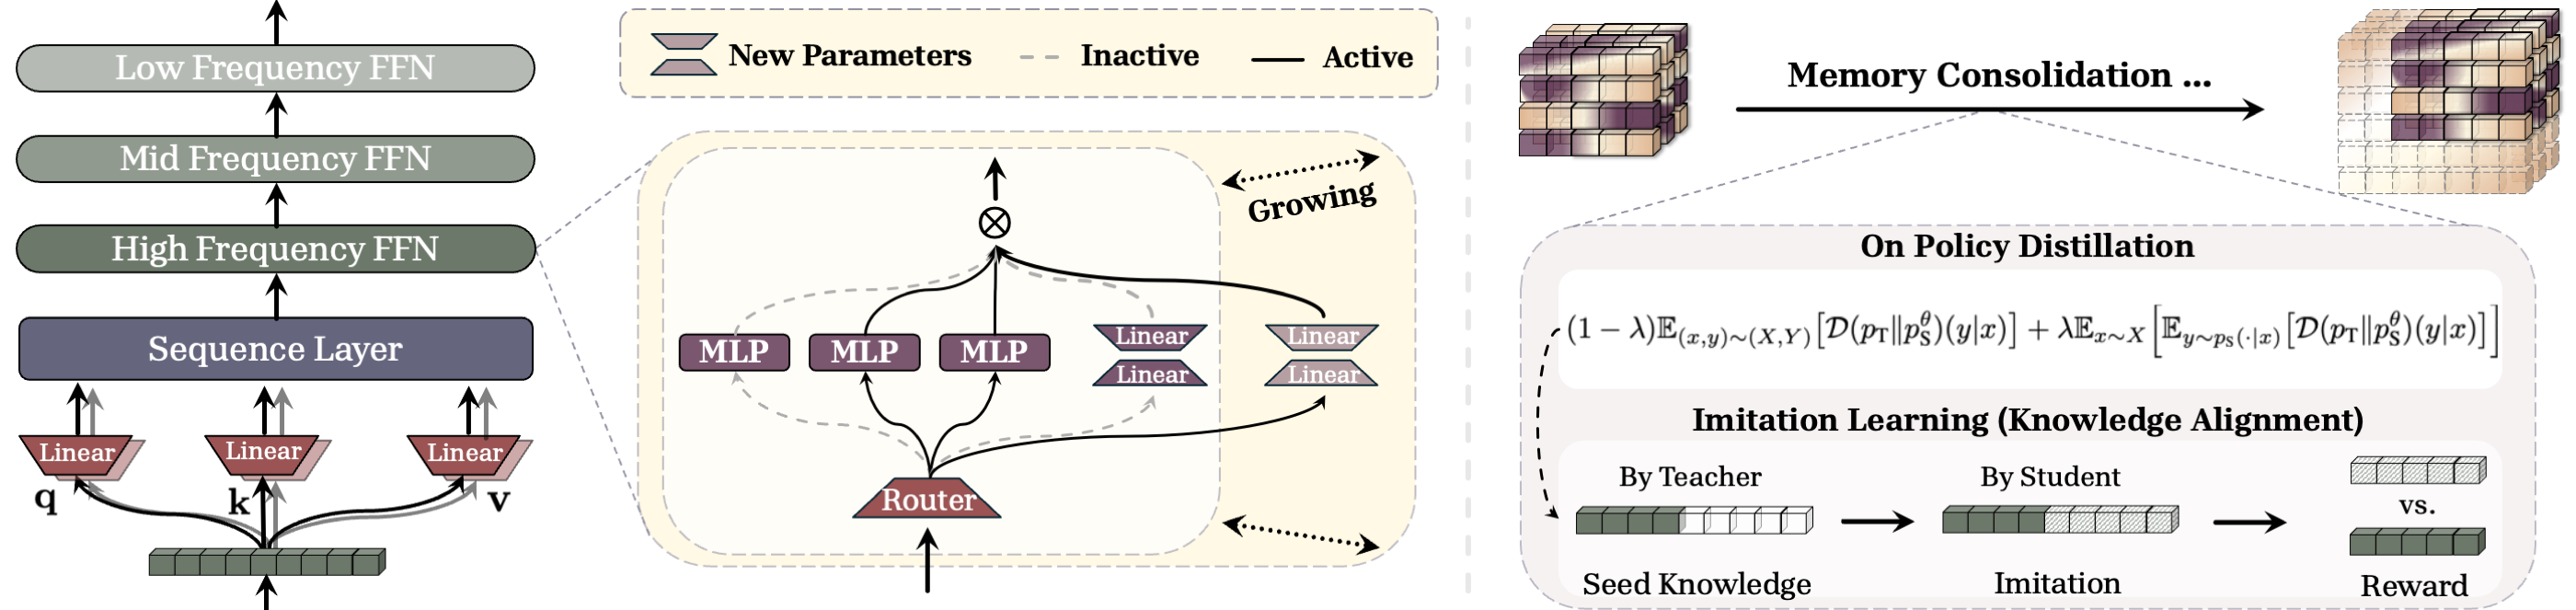
来源:原文 Fig.2,PDF p.7,作者原图。阅读顺序为左侧记忆层级、中部 MoE 扩展、右侧蒸馏及模仿学习。图的重点是知识迁入慢层新参数,而非单纯把整个网络等比例放大。
要将第 $\ell^*-1$ 层的知识转交给第 $\ell^*$ 层,接收层新增专家参数:
只计这两个矩阵,每个新增专家有 $2dd_{\mathrm{low}}$ 个参数。这是由维度直接推得的局部数量,不是论文报告的总模型成本;它不包含路由、偏置、优化器状态与副本开销。
巩固时冻结已有学生参数,只优化新专家。为避免动态改变张量形状,可预先分配专家并通过前向和反向掩码逐步启用。较快层的旧低秩专家在知识向下一个时间尺度迁移后被重置,以便承接新的经验。(§§3.2–3.3,pp.7–9;Figs.7–8,p.22)
冻结旧权重能限制直接覆写,但不能数学上保证旧任务输出不变:新专家改变前向计算,快层后续也会更新和重置。论文没有给出零遗忘定理。
2.3 v2 的关键顺序:compute → consolidate → update
设快层即将执行一次基权重更新。正确理解 §3.3 的协议需要区分“算出候选更新”和“把更新写入当前模型”。
- Compute:用已积累的梯度算出快层候选新权重 $\boldsymbol\theta_{\mathrm{new}}^{(f_{\ell^*-1})}$,暂不覆盖当前模型。
- Consolidate:保留更新前的整模型为教师。学生使用快层候选新权重,模拟快层旧专家已重置,并在慢层添加新专家 $\{A,B\}$。只训练这些新参数,使学生尽量继承教师的知识和生成行为。
- Update:完成巩固后,再正式应用快层基权重更新、重置快层旧专家、启用已训练好的慢层专家。
这相当于在一次可能破坏旧记忆的改写发生之前,先训练好接收知识的参数。若先覆盖教师再生成训练信号,教师就不再代表待保留的旧记忆。(pp.7–8)
原文索引笔误:p.8 教师定义中的 MLP 下标是 $\ell^*$,所配参数却是 $\ell^*-1$;结合前后协议,应把教师理解为更新前整模型,而非把这两个层的索引硬视为相等。
2.4 Knowledge Seeding:向扩展后的自己蒸馏
知识播种(Knowledge Seeding,KS)指小模型向更大模型传递知识;自知识播种(SKS)中,教师与学生是同一系统在扩展前后的两种状态。这里教师的优势来自保留的记忆,而非参数更多。
先从教师生成训练材料 $\mathcal D$。为避免学生只学习教师惯常生成的轨迹,GKD 混合教师数据与学生自己的 rollout。以下是 p.8 无编号公式的等价简写:
- $\mathcal F$ 衡量教师与学生输出分布差异;正文保留了通用散度写法,不能直接断言所有实验都采用同一种 reverse KL。
- $\lambda\in[0,1]$ 控制来自学生自身轨迹的比例;不应与后面的模仿权重 $\alpha$ 混淆。
- 学生在自身会走到的前缀上获得教师逐 token 反馈,可减轻训练轨迹与实际生成轨迹的差异。
- 这一步不对学生采样分布求导,优化的学生参数也限于新增部分;不应把该 stop-gradient 描述直接扩展为后续 RL 奖励也不需要策略梯度。
2.5 Learning to Imitate:既保留分布,也学习如何使用记忆
教师生成序列 $d^{(i)}$,随机截取前缀,要求学生续写为 $\hat d^{(i)}$。原文 Eq.(3) 的奖励为:
$r_{\mathrm{sem}}$ 由冻结的奖励模型判断语义是否相同,取 0 或 1;Eq.(4) 的字面相似性奖励为:
$z$ 是 Levenshtein 距离,$z_0$ 是阈值。语义项允许同义表达,字面项约束生成轨迹与教师接近;两者可能有张力,并非每个任务都应强迫逐字一致。
随后 p.9 的无编号 KS 目标可简写成:
方向必须看符号:原文把它记为 $\mathcal L_{\mathrm{KS}}$,但它是“奖励减散度”,应最大化;若代码只接受最小化 loss,应最小化其负值。本笔记改记 $J$ 以显式表示这个解释,没有声称作者报告了一个编号不同的新公式。该式仅写学生采样期望,前面的混合系数 $\lambda$ 未在这里再次展开。
正文没有给出足以复现各实验的 $\lambda,\alpha,\gamma,z_0$、语义奖励模型标识和所有 RL 优化细节。(§3.3,pp.8–9)
2.6 Dreaming:学习生成真正有用的适配数据
巩固之后,模型处理任务 $(C,\tau)$:$C$ 是相关上下文,$\tau$ 是下游表现的评价函数。流程如下。
- 基于 $C$ 生成 $m$ 份候选 dream。生成时,MoE 路由额外选择随机专家,使不同记忆有机会共同影响生成。
- 对各候选计算 SFT 目标的梯度信号 $g^{(i)}_{\mathrm{DR}}=\nabla_{\boldsymbol\theta}\mathcal L_{\mathrm{SFT}}(\mathrm{DREAM}^{(i)},\boldsymbol\theta)$,按重要性保留 Top-$k$,再加入 $b$ 个随机候选以保留多样性。
- 对每个入选候选建立隔离的模型副本,使用 LoRA 做 SFT,得到 $\boldsymbol\theta'^{(i)}$。
- 若该副本相对适配前在 $\tau$ 上有所改善,则给这个 dream 奖励 1,否则为 0;这就是 Eq.(5)。
- 使用继承自 SEAL 的 ReST$^{\mathrm{EM}}$ 优化生成策略,使模型更常生成有助于后续适配的材料。
外层优化“应该生成什么训练材料”,内层执行“用这份材料更新模型”。这个奖励不是 LTI 中的语义 / 编辑距离奖励,两者服务不同阶段。(§3.4,pp.9–10)
两项重要限制:第一,论文引入重要性分数 $\boldsymbol\omega^{(i)}$,实际只给出梯度向量 $g^{(i)}_{\mathrm{DR}}$;向量如何变成可排序的标量、是否使用范数或与验证梯度对齐,均未说明,不能擅自补成某种具体筛选算法。第二,“无需人类监督”不能理解为不需要任何评估信号:Dreaming 显式依赖任务评价 $\tau$,LTI 也用冻结奖励模型。
2.7 教学例子:一次改写如何保住旧知识
以下例子用于理解协议,不是作者实验或可运行复现代码。快层刚学会两个新实体的关系,下一批输入到来时要更新快层。系统先保留当前模型为教师,让它生成这些关系的问答;学生则模拟“已完成新更新、已清理快层旧专家”的状态。接收层的新专家被训练去恢复这些问答行为。随后真实执行更新,快层可接收下一批信息,而此前关系尽可能由慢层专家支撑。
这个例子也暴露出方法的边界:教师没有生成或正确表达的知识,不能自动保证被巩固;某个旧事实即使仍存在于冻结参数中,也可能因新的前向路径而变得不易访问。
三:实验——先明确每组实验检验什么
3.1 实验矩阵
| 实验 | 对象与数据 | 对照的角色 | 指标与方向 |
|---|---|---|---|
| 类别增量学习 | Llama-3B / Llama3-8B;CLINC150、Banking77、DBpedia 70 类 | ICL:无 Sleep;EWC:参数正则;InCA:外部持续学习器;Hope:无显式巩固蒸馏的多层更新 | 分类 Accuracy,越高越好 |
| 记忆层数 | MK-NIAH、LongHealth、QASPER;该小节未明确独立列出骨干 | ICL、DuoAttention、Cartridges;不同层数和最低频率设置 | 前两者 Accuracy↑;QASPER 图中为 Perplexity↓ |
| 顺序学习语言 | Manchu 与 MTOB 的 Kalamang→English;骨干未在小节单列 | 单语言学习 vs 顺序学习;ICL 与 1/2/3 阶段 Sleep | 两个方向的 ChRF↑ |
| 超长上下文 | BABILong;微调小模型与其他模型 | 图中列 Llama3+RAG、Llama3.1-8B-Instruct、GPT-4;正文还讨论其他小模型 | Accuracy↑ 随上下文长度变化 |
| 数学推理 | Qwen3-1.7B 与 Qwen3-8B;AIME-24/25、HMMT-25 | Base、SFT、GRPO、OPSD | average@16↑,不是 pass@16 |
| 事实知识注入 | SQuAD;1 或 200 段;具体骨干通过引用 SEAL 设置,本文未单列清楚 | Base、无 Dreaming 微调、SEAL、两层/四层 Sleep | 无原文上下文的平均问答准确率↑ |
| 少样本抽象推理 | Llama-3.2-1B;筛选后的 ARC | ICL、TTT + 合成更新、SEAL | 独立 dream 适配尝试的成功比例↑ |
§4.1 开头说先测“仅巩固、无 self-improvement”。到 Knowledge Incorporation 段落才明确转向完整 Sleep,ARC 附录也明确包含先巩固后 Dreaming。因此不能把前面所有收益归给 Dreaming,也不能把后半节当成仅巩固实验。BABILong 的附录解释又提到 self-improvement,具体阶段归属存在表述不一致,应保留这一不确定性。
3.2 数据与配置的可复核范围
附录 B.1 给出:CLINC150 有 150 个域内意图、10 个领域;Banking77 有 77 个意图和 13,083 条样本;DBpedia 使用 70 类二级类别,并抽取 10K 训练、1K 测试样本。LongHealth 使用 20 份虚构病例中的 200 个问题;QASPER 以整篇论文为上下文。它们不是统一的“长文本问答准确率”测试。
附录 B 开头报告新增部分采用 5 个维度为 64 的 MLP block,声称激活参数量保持与 3B / 8B 基座相同。但总参数、专家预分配、各实验路由 Top-$k$ 与实际激活预算的完整对应没有展开;这段一般说明也不能覆盖数学 1.7B 和 ARC 1B 的所有具体配置。
Table 5(p.26)给出的训练设置:
| 配置 | GRPO | SFT | Sleep |
|---|---|---|---|
| 学习率 | $5\times10^{-6}$ | $5\times10^{-6}$ | $5\times10^{-6}$ |
| 有效 batch size | 32 | 32 | 32 |
| 训练步数 | 500 | 100 | 100 |
| LoRA rank | 64 | 64 | 64 |
| LoRA alpha | 128 | 128 | 128 |
该表与数学对照相邻,但没有逐项覆盖每个任务;OPSD 的对应训练配置也未列出。LoRA alpha 与 KS 目标中的 $\alpha$ 含义不同。文中没有为这些关键比较给出足够的重复种子、误差条或置信区间,细小差值不能称为统计显著。
四:结果——哪些结论得到什么程度的支持
4.1 类别增量学习:巩固后的表现高于 Hope
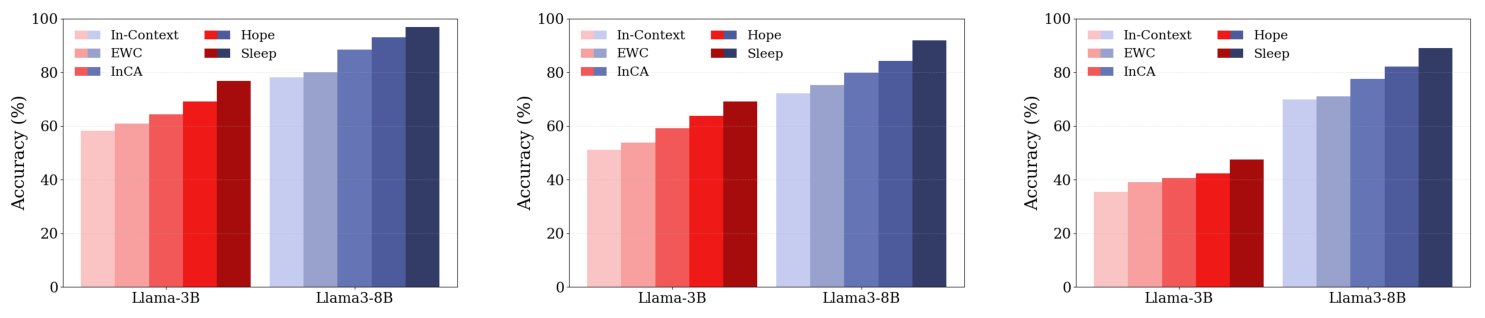
来源:原文 Fig.3,PDF p.10,完整三面板裁切。左、中、右分别是 CLINC、Banking、DBpedia;横轴分 3B / 8B 骨干,纵轴为分类准确率,各组颜色依次对应 ICL、EWC、InCA、Hope、Sleep。
六个“数据集 × 规模”组合中,Sleep 柱均高于 Hope。这支持显式巩固在已有多时间尺度更新之上的增益。原图没有逐柱数字和误差条,因此这里不把目测柱高写成精确结果。仅凭终点柱状图也不能重建每个旧类别随时间的遗忘曲线。(§4.1,p.11)
4.2 记忆层数:整体趋势较好,但不是每条曲线严格单调
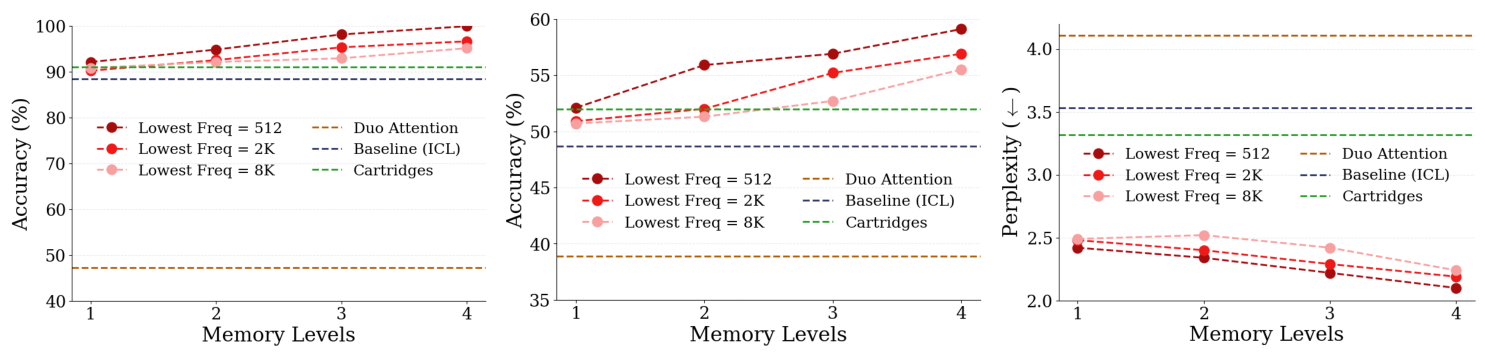
来源:原文 Fig.4,PDF p.10。横轴是 1–4 个 Memory Levels;三条红色曲线按原图标注为 Lowest Freq = 512、2K、8K。左、中纵轴为 Accuracy,右为 Perplexity,方向不同。水平线分别是 ICL、DuoAttention、Cartridges。
从图中可读出的近似值:4 层、标签为 512 的设置,MK-NIAH 接近 100%,LongHealth 约 59%,QASPER 困惑度约 2.1。ICL 水平线分别约 88.5%、48.7%、3.54。这些是读图估计,不是作者附表中的精确数值。
整体上,更多记忆层带来更好结果;但 QASPER 的 8K 曲线从 1 层到 2 层略升,困惑度略变差。LongHealth 的部分低层数配置也低于 Cartridges。因此“所有层数一律更好”“每次加层都严格改善”都比图中证据更强。频率/周期记号混用的问题也使图中的数值设置难以直接还原为明确调度。(§4.1,p.11)
4.3 顺序学两种语言:ICL 丢失较多,Sleep 保留较多
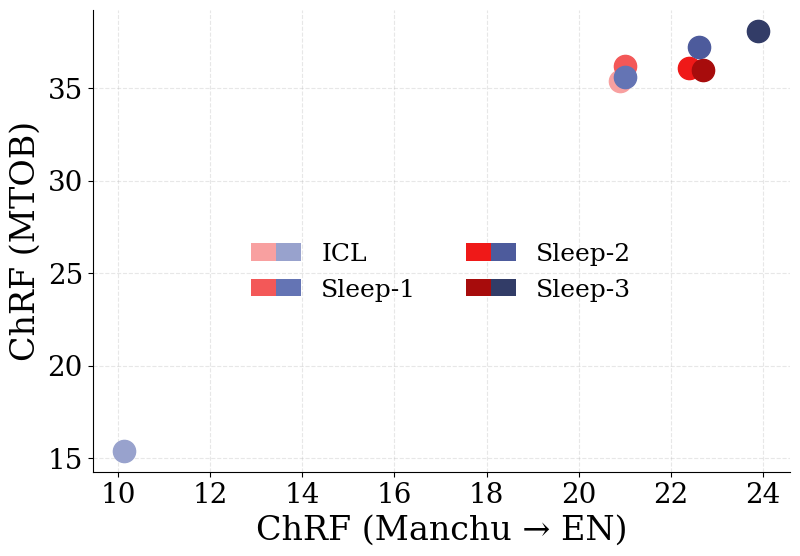
来源:原文 Fig.5,PDF p.11,作者原图。横轴是 Manchu→English 的 ChRF,纵轴是 MTOB / Kalamang→English 的 ChRF;右上更好。按图注,红色是单语言训练,蓝色是顺序学习。
ICL 的蓝点位于左下(约 10、15),Sleep 蓝点集中在右上,支持 Sleep 在这一短任务序列中保存了更多能力。按蓝色 Sleep-1/2/3 点看,多阶段结果更好。
细节上,Sleep-2/3 的蓝点高于相应红点,所以正文“接近恢复单语言表现”的描述较保守;红色点本身也非在两轴严格单调。SFT 与 Cartridges 被正文描述为至少一种语言很差而落在图外,但没有在图中给出完整数值,不宜据此计算其差距。(pp.11–12)
4.4 BABILong:10M 长度仍有较高分,图文对应需谨慎
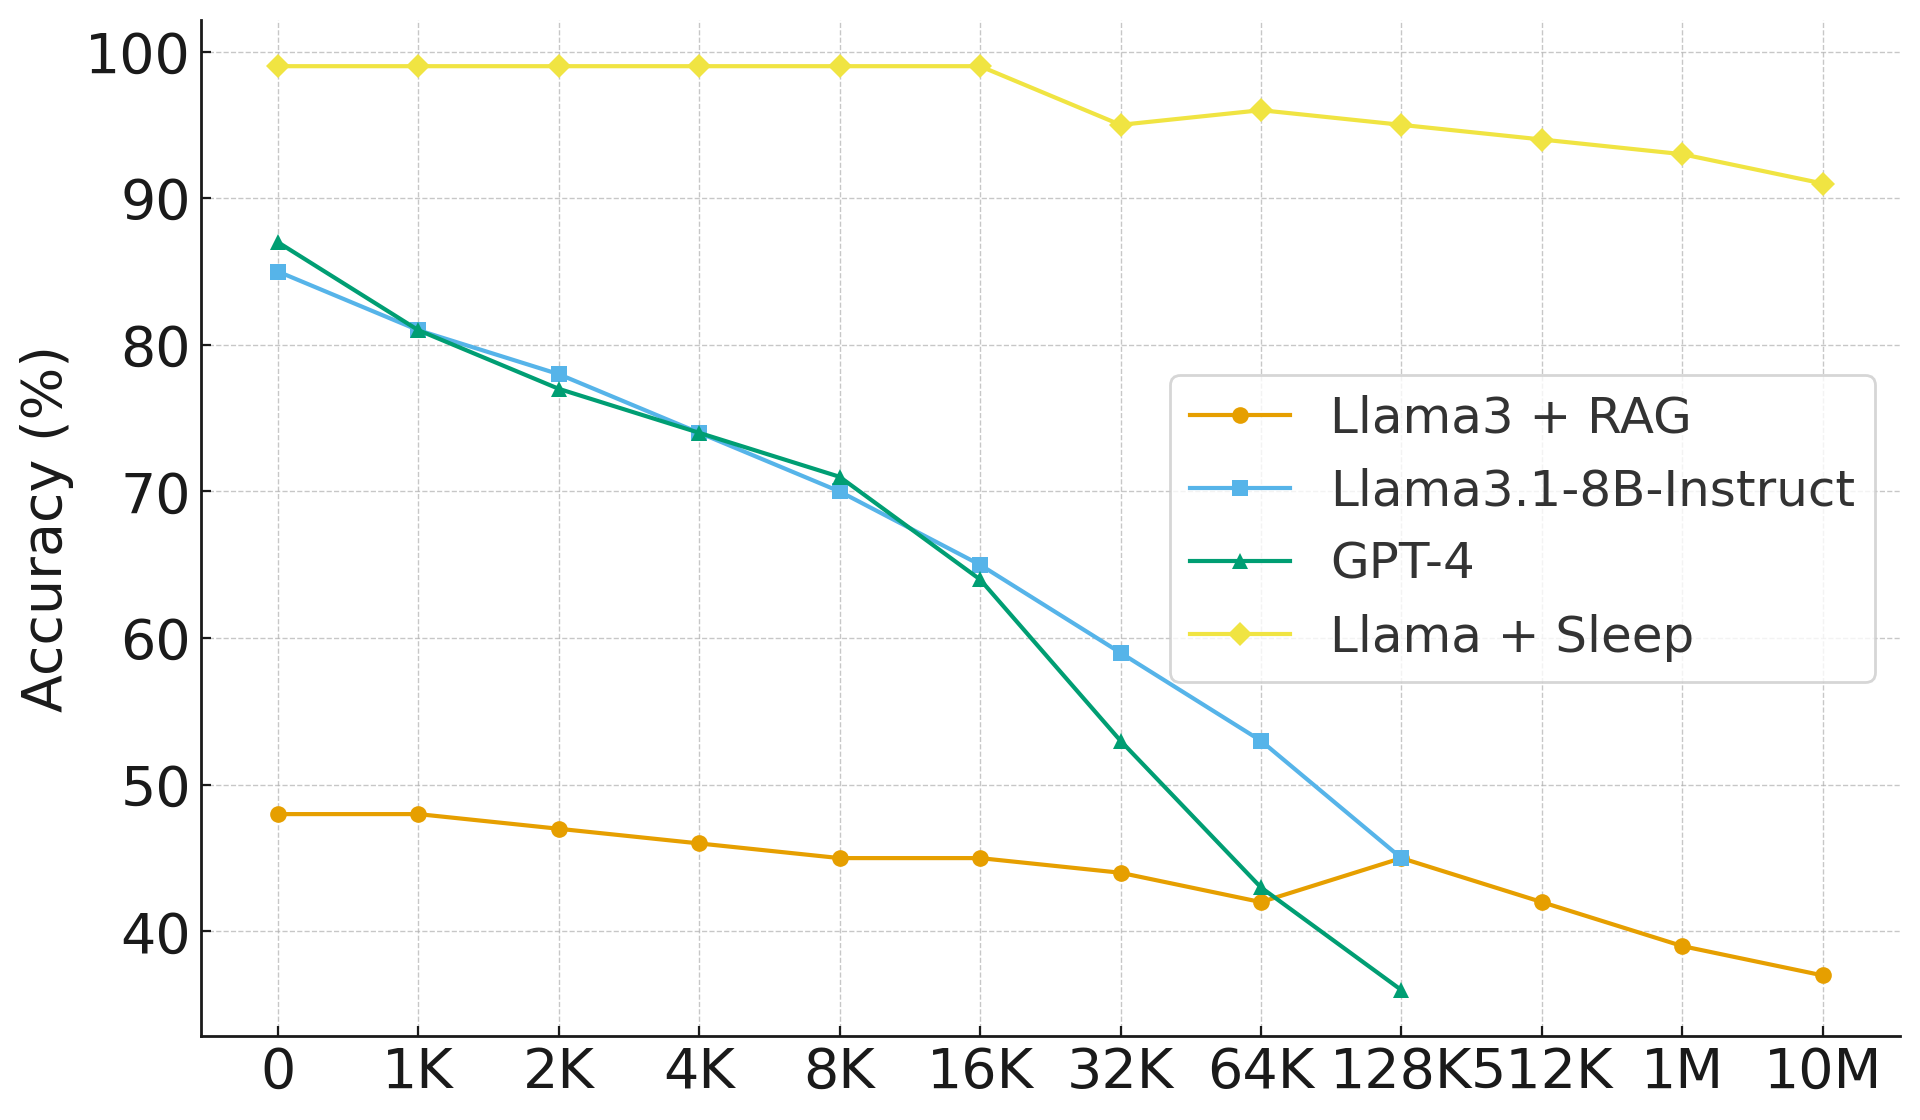
来源:原文 Fig.6,PDF p.11;源码中实际图件名为 babilong.png。横轴是标注的 token 长度档位,且以等间距绘制不等跨度的档位;纵轴是 Accuracy。黄色菱形为 Llama + Sleep,橙色为 Llama3 + RAG,蓝色为 Llama3.1-8B-Instruct,绿色为 GPT-4。
最稳妥的读法是:Sleep 曲线在 10M 处仍约 91%,明显高于同图中 RAG 的约 37%;不能写成 10M 下 100% 或近乎没有下降。数值均为读图估计。
这里存在三项需保留的原文差异:
- 正文 p.12 概括为“几乎满分”,但图上末端约 91%。
- Fig.6 图注描述“红点微调、蓝点零样本”,与实际黄/橙/蓝/绿折线不一致。
- Appendix B.2 讨论 GPT-4o-mini、RMT、ARMT、Titans 及其 1M 之后的衰减,但当前 Fig.6 没有这些曲线,不能从该图复核那些比较。
附录明确说明小模型接受 BABILong 专项微调,未微调时都会大幅退化。这项结果说明特定训练和任务下的长程信息保存潜力,不能推广为任意基础模型的 10M 零样本能力,也不是统一成本下的模型排行榜。(§4.1,p.12;Appendix B.2,p.26)
4.5 数学推理:8B 上相对 OPSD 的提升为 1.0–2.6 分
Table 2,PDF p.12;指标为原文的 average@16,越高越好。应按 16 次采样的平均表现理解,不能解释成“16 次中有一次做对”的 pass@16;论文未在该表附近完整展开采样与聚合细节。
| Qwen3-1.7B 方法 | AIME-24 | AIME-25 | HMMT-25 |
|---|---|---|---|
| Base (Instruct) | 49.8 | 34.5 | 25.7 |
| SFT | 47.3 | 36.1 | 22.9 |
| GRPO | 51.0 | 38.6 | 26.1 |
| OPSD | 51.6 | 40.0 | 28.1 |
| Sleep | 53.2 | 40.2 | 29.3 |
| Qwen3-8B 方法 | AIME-24 | AIME-25 | HMMT-25 |
|---|---|---|---|
| Base (Instruct) | 73.8 | 68.1 | 42.4 |
| SFT | 75.5 | 66.4 | 43.7 |
| GRPO | 76.4 | 68.1 | 44.9 |
| OPSD | 76.6 | 67.4 | 45.1 |
| Sleep | 79.2 | 69.0 | 46.1 |
本次计算:Sleep 相对 OPSD,1.7B 分别增加 1.6 / 0.2 / 1.2 分;8B 增加 2.6 / 1.6 / 1.0 分。这些是绝对分数差,不是相对百分比。1.7B 的 AIME-25 差距只有 0.2 分且没有误差估计,证据力度应与 8B AIME-24 区分。
4.6 事实注入:Dreaming 的贡献大于额外增加层数
Table 3,PDF p.12;mean no-context SQuAD accuracy,越高越好。评测时不再提供原始段落。CPT 设置是在一次继续训练中接触 200 篇段落、回答 974 个相关问题;每篇生成 5 个 dreams 并汇总成训练数据。它不是 200 轮独立、逐轮评测的终身学习序列。(pp.12–13)
| 方法 | 单段 $n=1$ | CPT $n=200$ |
|---|---|---|
| Base | 31.9 | 31.9 |
| 微调,无 Dreaming | 33.4 | 32.0 |
| SEAL | 46.7 | 43.2 |
| Sleep,Transformer 两层记忆 | 48.1 | 44.3 |
| Sleep,Transformer + 四层记忆 | 48.9 | 46.2 |
四层 Sleep 对比 SEAL 是 +2.2 / +3.0 个百分点;对比两层 Sleep 是 +0.8 / +1.9 个百分点。这些对照显示分层记忆的额外作用,但增益大小也依赖是否包含 Dreaming,见后面的移除实验。无上下文问答使“知识写进参数”比仅在提示中保留段落更直接可测,但论文并未同时报告充分的旧知识保留评测。
4.7 ARC:80% 的分母是独立适配尝试
| 方法 | 原文 Success Rate (%) |
|---|---|
| ICL | 0 |
| TTT | 10 |
| SEAL | 72.5 |
| Sleep | 80 |
来源:Table 4,PDF p.12;协议:§4.1 p.13、Appendix B.3 p.26。
模型为 Llama-3.2-1B。作者先过滤掉常规设置仍不可解的任务,留下 11 个训练任务、8 个留出任务。训练时每任务采样 60 个 dreams、拒绝 45 个;测试时每个留出任务采样 5 个 dreams,分别独立适配再预测,报告能得到正确答案的 dream 比例。
因此它不是完整 ARC 数据集的准确率,也不是 8 个任务中有 80% 被最终解出。若按每任务五次等权统计,则共 $8\times5=40$ 次尝试,80% 对应 32 次成功,72.5% 对应 29 次成功;这是根据协议推算,论文没有逐次公布这 40 条结果。差距为 7.5 个百分点,但只相当于这个小评测规模下的三次尝试,不能忽略任务筛选和方差。
4.8 设计消融:支持多个组件,但存在单项反例
Table 1,PDF p.11,Qwen3-8B:
| 巩固设计 | AIME-24 | AIME-25 | HMMT-25 |
|---|---|---|---|
| 完整 Sleep | 79.2 | 69.0 | 46.1 |
| 去除 Imitation Learning | 76.8 | 67.9 | 45.0 |
| 去除 Semantic Reward | 78.9 | 69.2 | 44.5 |
| 不扩展参数 | 78.2 | 67.9 | 44.9 |
| OPSD | 76.6 | 67.4 | 45.1 |
| OPSD + Expansion | 77.9 | 68.2 | 45.9 |
模仿学习和扩展参数在三项指标上都有正向比较。单纯给 OPSD 增加扩展也有收益;完整 Sleep 相对 OPSD + Expansion 的差距缩小到 1.3 / 0.8 / 0.2 分。因此不能把相对 OPSD 的全部优势都归因于新的模仿目标。
作者 §4.2 写“所有组件均正向贡献”,但去掉语义奖励后 AIME-25 从 69.0 升至 69.2。正确结论是总体支持这项设计,不能声称每个组件在每个指标上均严格改善。另,p.13 把消融指向 Figure 1,实际对应的是 p.11 的 Table 1。
Table 3 的 Dreaming 消融:
| 设置 | 单段 | CPT 200 段 |
|---|---|---|
| 四层 Sleep | 48.9 | 46.2 |
| 移除梯度筛选 | 47.1 | 45.2 |
| 移除随机专家 | 48.0 | 44.7 |
| 移除 Dreaming | 35.7 | 36.2 |
以紧邻的四层完整配置作参照,本次计算降幅分别为 1.8 / 1.0、0.9 / 1.5、13.2 / 10.0 个百分点。表格未在每条移除行重申骨干配置,因此这是按其排版与消融语境理解。Dreaming 在这组任务上的作用最大;梯度筛选和随机专家的收益较小,尚缺随机种子和等计算量比较。
4.9 效率:每步贵、达到某个目标可能更快
Appendix B.5(p.26)给出两种不同口径:
- 相同步数:作者称 SFT 比 Sleep 高效约 4 倍。
- 达到匹配性能:作者称 SFT 在 AIME-24、AIME-25、HMMT-25 分别需要 Sleep 的 4.3、3.6、4.8 倍 wall-clock time。
两者不必矛盾:每步成本更高的方法,可能需要更少步骤到达某个目标。但文中没有同时提供绝对耗时、硬件、具体目标分数和完整成本曲线,不能复核这些倍率如何随规模或任务变化。也不能把“推理激活参数不变”当成“训练成本不变”或“总存储不增长”。
五:结论——值得带走的机制与尚未解决的问题
5.1 最有价值的贡献
本次分析认为,最清楚的贡献是把持续学习拆成可设计的机制:快记忆写入、更新前迁移、慢记忆承接、可塑容量回收、用下游收益选择自训练材料。compute–consolidate–update 的状态安排尤其具体,能帮助理解“先保留什么,再改写什么”。
实验显示这套组合在多个任务上有效,其中数学和 SQuAD 表格提供了最易核验的定量证据。类别增量、跨语言和长上下文图提供了补充支持,但报告充分程度不完全相同。
5.2 主要边界
- 容量与长期成本:新增专家或启用预分配参数消耗总容量;最慢层如何长期合并、淘汰和控制预算,尚未形成完整的无限期策略。
- 保留并非保证:冻结旧参数、蒸馏旧行为有助于减少干扰,但缺少对所有旧任务零退化的保证;自生成数据的覆盖范围和教师错误也会影响巩固。
- 自我改进依赖评价条件:需要上下文、奖励模型或可用的任务评价;并没有证明在任意开放环境中都能自行判定改进。
- 收益与计算未充分分离:新容量、额外 rollout、奖励评估、SFT 副本共同变化。消融有帮助,但尚不能完全排除计算和参数预算差异。
- 复现缺口:梯度向量如何标量化、路由训练细节、各任务完整频率日程、KS 超参数、教师数据生成配置等不够明确。
- 证据表达须分层:ARC 是筛选小集上的尝试级指标;BABILong 涉及专项微调且图文不完全对应;数学小差值缺少不确定性估计。
这些限制不否定报告的增益;它们决定了我们能从这些增益推到多远。
5.3 有针对性的后续验证
以下是本次分析提出的实验建议,不是论文已经完成的结果:在固定总参数与固定总训练 FLOPs 下,比较“只扩展”“只 GKD”“GKD + LTI”“完整 Sleep”;报告每个旧任务随 Sleep 周期的表现,而非只看末次平均值;在不给 Dreaming 目标任务答案的条件下严格隔离奖励构造与最终测试;补充未筛选 ARC、更多种子及最慢记忆容量耗尽后的行为。
最终判断:Sleep 为“上下文知识如何变成长久可用的参数记忆”提供了值得研究的组织方式,证据支持部分设置中的改进。它尚未证明通用零遗忘、无限自我提升,或与生物睡眠相同的机制。
核验与复现说明
- 已对照 PDF 核查 Figs.1–8、Tables 1–5、Eqs.(1)–(5) 及无编号蒸馏目标;本文表格数值按最终 PDF 转录。
- 数值相减均明确称为本次计算;原图近似读数不冒充精确附表结果。
- 本地资源使用相对链接,原论文与本次成品分目录保存;未运行作者训练或构建脚本。
- 幻灯片主讲页覆盖机制、七组实验及关键限制,备份页补充目标和配置。构建命令为
python3 build_slides.py slides.en.tex。 - 交付检查:27 页英文幻灯片已用本地
pdflatex两遍编译,逐页查看渲染结果并修正版面;最终日志无溢出、缺字或未定义引用。中文笔记与幻灯片中的 28 行原文实验数值已交叉核对,本地链接可解析。