BoV:深层 Value 真的需要残差流中的上下文吗?
论文:Do Value Vectors in Deep Layers Need Context from the Residual Stream?
作者:Muyu He、Yuchen Liu(共同一作)、Qingya Huang、Li Zhang。
版本:arXiv:2606.02780v5,2026-08-23 修订;本次获取与研读:2026-09-17。
材料:arXiv v5 · 本地原文 PDF · 作者主 TeX · 作者代码链接。
本次读取主 TeX 实际引用的全部正文章节、附录 A/B 和八张表,并用同版本 PDF 核验五张图、关键公式及结果。PDF 实际为 14 页,与摘要页“13 pages”的说明不同;下文一律采用从 1 开始的 PDF 文件页码。未运行作者代码、未复现实验,也未独立阅读全部参考文献。源码获取成功,无下载限制。
论文总览
这篇论文研究的是一个具体的架构问题:Transformer 后部层的 Value 是否必须从已经混合上下文的残差流计算?作者先做消融,发现对于所测试的小型语言模型,深层 Value 使用原始 token 信息就能取得主要收益,再把这种与序列上下文无关的 Value 参数化为逐层词表,提出 Bank of Values(BoV)。
BoV 在最后三分之一层以 token ID 查询该层专属的 Value 表,取代 $\mathbf{x}_i\mathbf{W}_V$。Query、Key、注意力权重、MLP 和残差路径仍处理上下文。这是对 Value 路径的修改,并没有使整个模型成为无上下文模型。
最扎实的结果是:780M 档模型固定训练 100B tokens 后,验证 BPB 从 0.671 降至 0.663,21 项 CORE 聚合分从 0.334 升至 0.351,16 项任务提高、5 项下降。按作者 FLOPs 统计,训练计算量从 $4.78\times10^{20}$ 降为 $4.66\times10^{20}$,约减少 2.51%。这些结果支持特定训练配置中的有效性,尚不构成大模型、长上下文能力或端到端推理提速的验证。(Sec. 5,Table 2,PDF p. 6;Table 6,p. 13)
结构地图
| 原文章节 | 作用 | PDF 页码与证据 |
|---|---|---|
| 1 Introduction | 区分“补充 token 信息”与“深层只用 token 信息” | pp. 1–3;Fig. 1 p. 2 |
| 2 Preliminaries | 定义残差流与 Q/K/V | p. 3;Eqs. (1)–(2) |
| 3 Motivation | 四个设计轴的 135M 消融 | pp. 3–4;Table 1 p. 3,Fig. 2 p. 4 |
| 4 Bank of Values: Persisting Context-Free Value Vectors as Model Parameters | 查表、推理与内存分析 | pp. 4–6;Fig. 3 p. 5,Eqs. (3)–(6) |
| 5 Experiments;5.1 Main Results;5.2 Comparison with Prior Methods;5.3 Component Design | 训练设置、主结果、对比与组件消融 | pp. 6–8;Tables 2–4,Figs. 4–5 |
| 6 Related Work | 与残差、参数记忆、缓存优化的区别 | pp. 8–9 |
| 7 Conclusion;Limitations | 总结与边界 | p. 9 |
| A Additional Results | 完整 21 项结果,揭示平均分隐藏的退步 | pp. 12–13;Tables 5–7 |
| B Additional Experimental Details | 训练配置 | pp. 12、14;Table 8 p. 14 |
一:动机——把“在哪些层替换”与“替换什么”分开
普通注意力让 Q/K/V 都来自残差流。Q/K 决定当前 token 应该关注哪些位置,Value 决定从那些位置搬运什么内容。作者认为深层残差表示可能稀释原始 token 身份信息,因而重新提供 token 信息有价值;“稀释”是作者的动机解释,本文没有给出足以完整证明这一机制的理论或因果分析。
已有方案有两类:一类向当前 Value 加入首层 Value 或 token embedding;另一类把首层 Value 直接复制到后续所有层。后一类效果差,可能来自浅层也被替换、不同层共享同一投影等因素,不能直接推出深层必须保留上下文 Value。因此作者同时考察四个轴:替换/相加、固定/可学习系数、逐层 $\mathbf{x}_0\mathbf{W}_V$ /共享 $\mathbf{V}_1$、最后三分之一/隔层/全部层。(Sec. 3,pp. 3–4)
二:方法——把深层 Value 变成可训练的 token 表
2.1 符号与上下文路径
| 符号 | 含义与维度 |
|---|---|
| $T,d,H,d_h$ | 序列长度、隐藏宽度、头数、每头宽度;$d_h=d/H$ |
| $\mathbf e,\mathbf x_0$ | token embedding 与其 RMSNorm,均为 $T\times d$;单个 token 本身不含序列上下文 |
| $\mathbf x_i$ | 第 $i$ 层注意力输入,包含前层累积的上下文信息 |
| $\mathbf W_Q,\mathbf W_K,\mathbf W_V,\mathbf W_O$ | 本文多头注意力设置下的 $d\times d$ 投影矩阵 |
| $\lvert\mathcal V\rvert,\mathbf E_v$ | 词表大小及某个目标层的 $\lvert\mathcal V\rvert\times d$ Value 参数表 |
| $i_p,\gamma_v$ | 第 $p$ 个位置的 token ID,以及每层独立、无界可学习标量 |
原文 Eqs. (1)–(2),PDF p. 3:
为简洁,公式省略了实际自回归实现中的因果遮罩。BoV 保留 Q/K 的上下文依赖,仅在指定层改变 V。即使两个位置出现同一个 token、查出同一 Value,它们的 Key 仍可不同,被其他位置关注的权重也可不同。
教学例子:假设 token “bank”在金融和河岸语境中使用同一 ID,那么同一个 BoV 层查询到相同 $\mathbf E_v[\text{bank}]$;但两个语境中的 Q/K、注意力输出及残差表示可以不同。这个例子只解释数据流,不是论文的消歧实验。
2.2 从确定性投影到直接学习
原文 Eqs. (3)–(5),PDF p. 5:
第一个表达式只依赖 token ID 和当前模型参数,与此前序列无关,因此可以用表表达。BoV 并非在每一步训练后重新计算一张缓存表,而是把表本身作为独立可训练参数,并移除目标层的 $\mathbf W_V$。12 层模型修改最后 4 层,24 层模型修改最后 8 层,各层的表互不共享。
初始化用初始 $\mathbf x_0\mathbf W_V$ 填表,使初始前向与“由原始 embedding 投影得到 Value”的方案一致;不能理解为初始前向与普通残差流 Value 的 baseline 一致。之后表、embedding 和其余参数独立优化,原始因式分解关系无需继续成立。无界 $\gamma_v$ 可以大于 1、为 0 或负数,它不是限定在 $[0,1]$ 内的概率门。(Sec. 4–5,pp. 5–6)
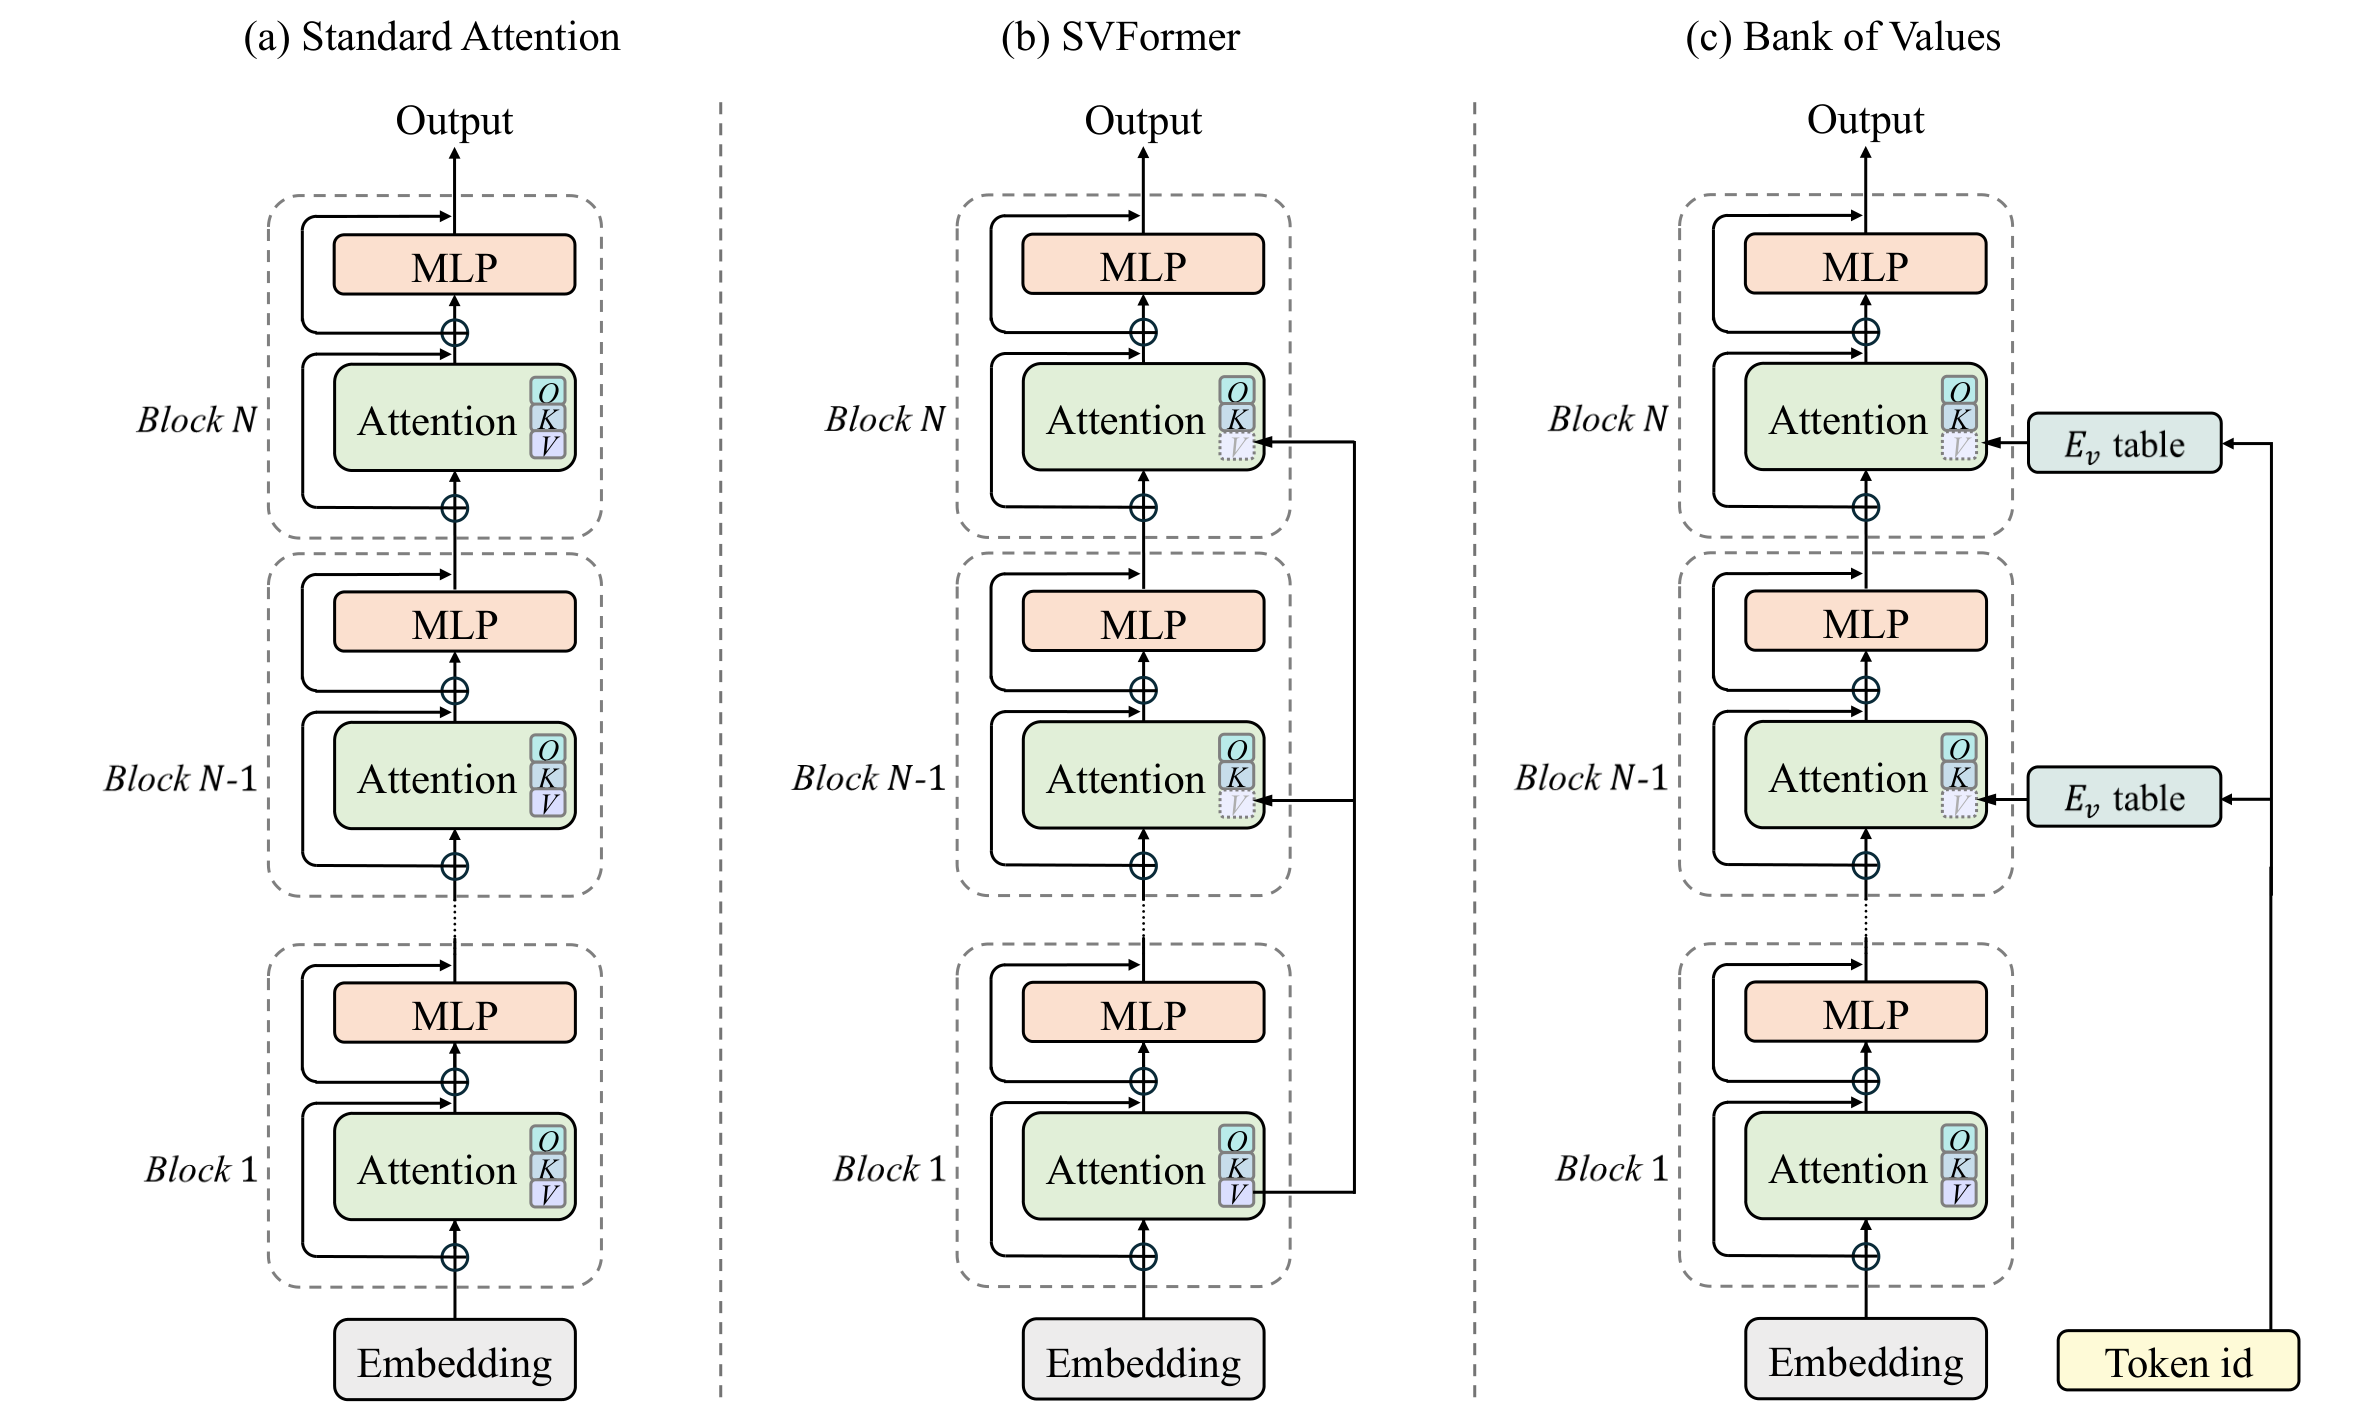
原 Fig. 1,PDF p. 2;复用作者原图。从左到右是标准注意力、全层共享首层 Value 的 SVFormer、逐层查表的 BoV。图中的 Q/K 仍来自各层隐藏状态,是理解“context-free”只约束 Value 的关键。
2.3 训练与推理的数据流
训练/prefill:取得当前序列的 token IDs → 在目标层查询本层表 → 乘 $\gamma_v$ → 与上下文 Q/K 一起计算注意力 → 输出投影并加回残差流。表按访问行参与计算;“稀疏访问”并不意味着表的大部分参数值为零。
逐 token decode:缓存 K 和历史 token IDs;执行目标层时,按历史 IDs gather 出全部历史 V,完成注意力后释放临时 V。前面未修改的层仍使用常规 V 缓存。历史 token ID 不依赖深层计算,因此作者提出可以预取表项,并把表放在主机内存;这是实现可能性,本文没有给出 CPU offload 的吞吐或时延基准。
查找行地址可视为常数时间,但搬运一个 $d$ 维向量仍有 $O(d)$ 数据量;重建长度 $T$ 的历史 Value 是 $O(Td)$。所谓少做 FLOPs,主要来自省掉 Value 的密集投影,不能推成“零带宽”“零注意力计算”或“推理必然更快”。(Fig. 3、Sec. 4,PDF pp. 5–6)
2.4 内存公式的单位、分母与边界
原文 Eq. (6),PDF p. 5:
它按元素个数计:最后 $L/3$ 层原来持久缓存 $Td$ 个 V 元素,现在持久保存 $\lvert\mathcal V\rvert d$ 个表元素。乘每元素字节数才是字节。这个简化口径在单序列、表和缓存同精度、目标层都按长度 $T$ 保留历史的条件下,于 $T=\lvert\mathcal V\rvert$ 打平;nanochat 词表是 32,768,Qwen3 曲线使用 151,936,但并未训练或测试 Qwen3 模型。
本次推导:如果分母取全模型标准 K+V 缓存 $2LTd$,则
极限为 16.7%;若分母仅是全部 V 缓存 $LTd$,极限应是 33.3%。Fig. 5(a) 写“V cache memory saved”,但图中虚线极限约为 16.7%,与前一种分母一致。这是原文的口径歧义,不能引用为“V 缓存最多省 16.7%”而不解释。按 K+V 分母推导,Qwen3 词表在 $T=256\times1024$ 和 $1024^2$ 时约节省 7.0% 与 14.3%;这些是公式估算,不是设备实测。
式 (6) 也没有完整计入目标层临时 $Td$ 张量、token ID 缓存、移除 $\mathbf W_V$ 的权重收益、分配器/内核工作区和优化器状态。多请求可共享参数表,但各有缓存;滑动窗口会改变各层有效历史长度,GQA 会改变 KV 宽度。因此不能直接把图上的百分比用于任意服务负载。表 8 的窗口模式是 SSSL,实际部署尤需按层计算缓存。
本次参数量估算:24 层、$d=1536$、词表 32,768、8 个目标层,新增表共 $8\times32768\times1536=402,653,184$ 个元素,移除投影 $8\times1536^2=18,874,368$ 个元素,净增约 383.8M 参数(忽略少量标量)。bf16 表本身占 768 MiB。论文的“780M 档”不能自动理解为双方都只有 780M 个总存储参数,更不能将 sparse table 当作免费存储。论文未明确单列 BoV 全参数量或训练显存。
三:实验——三种预算不能混在一起
3.1 实验配置与比较角色
| 实验 | 模型与训练预算 | 目的/来源 |
|---|---|---|
| 动机消融与小模型验证 | 12 层、$d=768$、135M 档;$1.50\times10^{18}$ FLOPs;baseline 1.97B tokens | Table 1;Fig. 2;Fig. 4(a) |
| FLOPs 对齐的 780M 对比 | 24 层、$d=1536$;$3.91\times10^{19}$ FLOPs;baseline 8.19B、BoV 8.39B tokens | Tables 3、5;Fig. 4(b) |
| tokens 对齐的主实验 | 780M 档、双方 100B tokens;baseline $4.78\times10^{20}$、BoV $4.66\times10^{20}$ FLOPs | Tables 2、6 |
两个规模均使用 2048 训练序列长度、32,768 词表、bf16、头宽 128;135M 使用 6 个 Q/KV 头,780M 使用 12 个,属于本文等宽 Q/K/V 设置。总 batch 分别是 524,288 与 1,048,576 tokens。矩阵使用 Muon,其余参数使用 AdamW;正文明确 BoV 表的 AdamW 学习率是 0.15。(Sec. 3、5;Table 8)
配置需要保留原文差异:Sec. 5 p. 6 写矩阵 LR 0.02,而 Table 8 p. 14 的 780M 列给 0.0283,并解释 batch/width scaling。表 8 列的是 8.19B 的小预算运行,不是完整的 100B 配置;不能擅自把其迭代数、衰减等全部挪给 100B 运行。源码与 PDF 都保留了这个差异,复现应再核对作者代码配置。本次未执行代码确认。
baseline 是同训练体系的标准注意力。$\mathbf x_0\mathbf W_V$ 用来分离原始 token 信息与直接查表的区别;$\mathbf V_1$ 检验跨层共享;全层 $\mathbf V_1$ 对应 SVFormer 风格;$\mathbf V+\mathbf E_v[i]$ 是保留上下文 Value 的加法方案。最后一种还使用输入相关、有界系数、每隔一层应用,因此 Tables 4/7 并非只改变“加法/替换”一个变量。
3.2 指标及统计口径
验证集来自 ClimbMix 保留集,约 41.9M tokens。BPB(bits per byte)越低越好,衡量按字节归一化的预测编码成本,不能直接当作 token perplexity。
CORE 覆盖 21 项任务:阅读理解、符号问题、世界知识、常识推理和语言理解。正文给出任务中心化分数
其中 $r_j$ 是该任务随机猜测或多数类基线。CORE 越高越好,是等权平均,不能把其 0.017 的提升直接叫作“原始准确率提高 1.7 个百分点”。正文说逐任务报告 centered accuracy,但表中没有逐项列出 $r_j$,原始/中心化单项分数口径不足以独立重算;本笔记保守称为表列任务分数,不自行恢复原始准确率。论文未报告多随机种子误差条、置信区间或显著性检验。
四:结果——按论证顺序读证据
4.1 动机消融:收益来自深层、逐层、可调尺度
Table 1,PDF p. 3;135M 档、等 FLOPs,BPB 越低越好:
| Value 方案 | 目标层/系数 | BPB |
|---|---|---|
| 普通 $\mathbf V$ | baseline | 0.854 |
| 普通 $\mathbf V$ | 最后 4 层、可学习尺度 | 0.858 |
| 共享 $\mathbf V_1$ | 所有层、固定 1 | 0.872 |
| 共享 $\mathbf V_1$ | 最后 4 层、固定 1 | 0.849 |
| 共享 $\mathbf V_1$ | 最后 4 层、可学习尺度 | 0.847 |
| 逐层 $\mathbf x_0\mathbf W_V$ | 隔层、可学习尺度 | 0.849 |
| 逐层 $\mathbf x_0\mathbf W_V$ | 最后 4 层、固定 1 | 0.847 |
| 逐层 $\mathbf x_0\mathbf W_V$ | 最后 4 层、可学习尺度 | 0.845 |
| $\mathbf V+\mathbf x_0\mathbf W_V$ | 最后 4 层、两项固定 0.5 | 0.848 |
| $\mathbf V+\mathbf x_0\mathbf W_V$ | 最后 4 层、分别学习尺度 | 0.845 |
限制目标层非常关键:共享首层 Value 全层替换会退步,只替换后四层则改善。逐层投影与可学习尺度进一步降低损失。加回上下文 Value 后,0.845 与替换式持平;这才是“深层上下文 Value 的额外收益小”的直接证据。它不是对任意层、任意规模或任意任务的普遍证明。
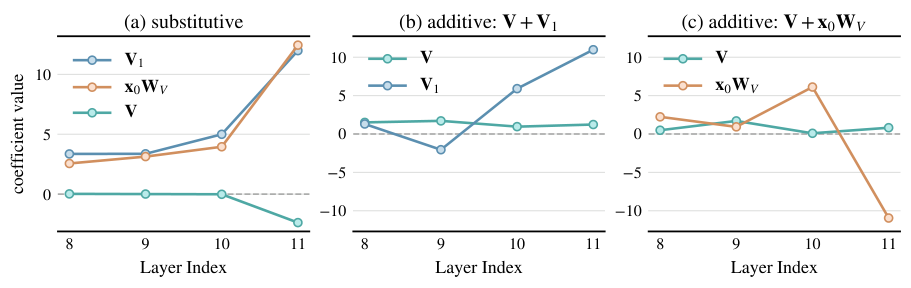
原 Fig. 2,PDF p. 4。横轴是 0-based 层索引 8–11,纵轴为无界系数;(a) 替换式,(b) 与首层 V 相加,(c) 与逐层原始 embedding 投影相加。深层 context-free 分量的系数绝对值通常较大;(c) 最后一层约为负 11,而不是正向概率权重。本次分析:系数大小还依赖向量范数和可重参数化,不能仅凭系数绝对值就当作严格的信息贡献度;应和替换消融一起理解。
4.2 主结果:100B tokens 下平均改善,也有明确退步
Tables 2/6,PDF pp. 6、13:
| 指标 | Baseline | BoV | BoV − Baseline |
|---|---|---|---|
| BPB ↓ | 0.671 | 0.663 | −0.008 |
| CORE ↑ | 0.334 | 0.351 | +0.017 |
| CommonsenseQA ↑ | 0.437 | 0.523 | +0.086 |
| SQuAD ↑ | 0.506 | 0.531 | +0.025 |
| CoQA ↑ | 0.342 | 0.372 | +0.030 |
| Repeat-Copy ↑ | 0.000 | 0.094 | +0.094 |
| Dyck ↑ | 0.087 | 0.154 | +0.067 |
| LSAT-AR ↑ | 0.300 | 0.187 | −0.113 |
| CS Algorithms ↑ | 0.442 | 0.414 | −0.028 |
| Winograd ↑ | 0.766 | 0.740 | −0.026 |
BPB 相对下降约 1.19%;CORE 的绝对提升 0.017,相对基线约 5.09%,是对报告分数的算术比较。16/21 项提高;另外两项退步是 WikiData −0.007、ARC-Challenge −0.003。尤其 LSAT-AR 的下降比多项收益更大,因此不能写成“符号推理全面改善”。
4.3 等 FLOPs 对比:BoV 同时利用了每 token 成本下降
Table 3,PDF p. 7:
| 方案 | BPB ↓ | CORE ↑ |
|---|---|---|
| 标准注意力 | 0.722 | 0.260 |
| BoV,最后三分之一 | 0.714 | 0.272 |
| $\mathbf x_0\mathbf W_V$,最后三分之一 | 0.719 | 0.259 |
| $\mathbf V_1$,最后三分之一 | 0.718 | 0.242 |
| $\mathbf V_1$,所有层、固定尺度 | 0.741 | 0.210 |
BoV 平均分提高 0.012、BPB 降低 0.008;直接投影原始 embedding 虽降低 BPB,却没有提高 CORE。等 FLOPs 下 BoV 看到 8.39B tokens,而 baseline 是 8.19B,约多 2.44%;作者把更多训练数据视作潜在原因之一,并未用独立实验完全分离参数化、优化和 token 数的贡献。
Table 5(p. 12)显示小预算下 13 项改善、8 项下降;COPA、CommonsenseQA、PIQA 此时都略降。不要把 100B 的常识收益搬到 8B 预算。Fig. 4 的横轴是训练 tokens,两条运行在固定 FLOPs 下的终点不必相同;曲线不是等墙钟时间的效率比较。
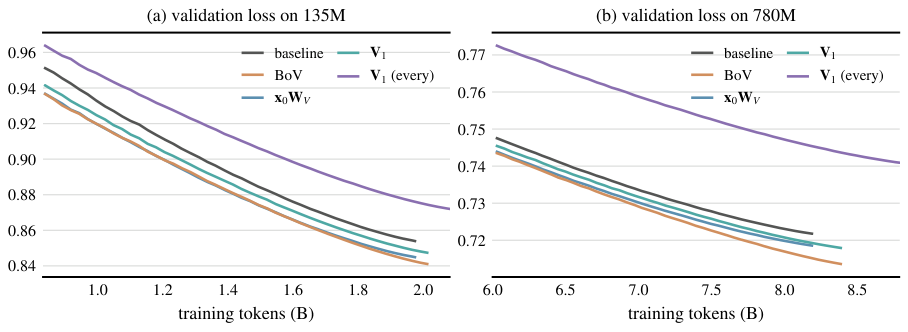
原 Fig. 4,PDF p. 6。左图 135M,右图 780M,纵轴为验证损失、越低越好。BoV 曲线较低;全层共享首层 V 最差。135M 的 BoV 终值在图中约 0.84,本笔记不将图上近似读数当作论文精确报告值,也不将 Table 1 的 0.845 误记为直接查表 BoV 的结果。
4.4 与加法 Value embedding 对比:接近、互有胜负
Table 7,PDF p. 13(Table 4 p. 7 只选了四项):
| 指标 | 加法 $\mathbf V+\mathbf E_v[i]$ | BoV 替换 |
|---|---|---|
| BPB ↓ | 0.712 | 0.714 |
| CORE ↑ | 0.268 | 0.272 |
| SQuAD ↑ | 0.439 | 0.416 |
| BoolQ ↑ | 0.594 | 0.635 |
| CommonsenseQA ↑ | 0.259 | 0.324 |
| Winograd ↑ | 0.692 | 0.645 |
完整表逐项计数是 BoV 10 胜、8 负、3 平,并不是 21 项中严格过半胜出;若排除平局则是 10/18。作者正文“most benchmarks”需要结合这个计数理解。最准确的表述是 aggregate CORE 接近且 BoV 略高,验证损失则略差。无种子统计时不能断言 0.004 CORE 差异显著。
4.5 组件设计:不应丢掉逐层表、尺度和深度限制
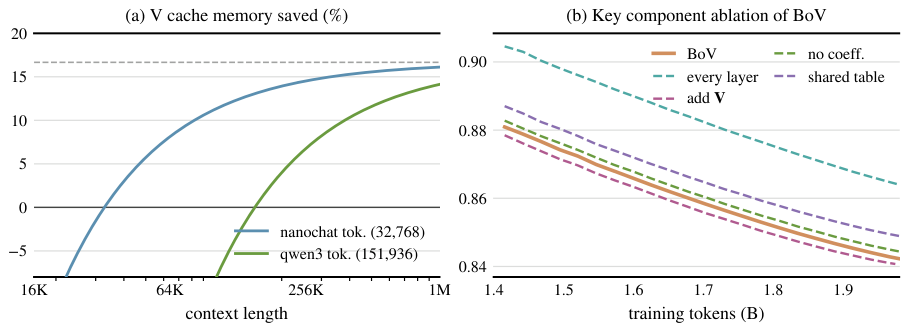
原 Fig. 5,PDF p. 8。左图横轴为上下文长度、纵轴为声明的缓存节省百分比;分母歧义见 2.4。右图横轴为训练 tokens,纵轴验证 BPB;全层查表的损失明显更高,共享表和固定尺度也退步。添加普通 V 的曲线比 BoV 略低,但改善很小。原图没有给这些曲线终值的精确数值表或误差条,因此只作定性比较。左图是存储公式趋势,右图才是训练实验结果,不能混成“实测长上下文加速”。
五:结论、局限与值得追问的实验
可靠贡献:作者把 Value 的来源、目标深度、共享方式和尺度拆开研究,给出小模型实验证据,表明深层可以依赖 token 专属静态 Value。直接训练逐层表进一步减少密集投影成本,并提供不持久缓存深层 V 的实现路线。100B 固定 token 实验也表明收益不全来自固定 FLOPs 下看到更多数据。
证据边界:只验证 135M/780M 档与 2048 训练长度;没有数十亿规模实验、长上下文质量测试、实测 decode 吞吐/时延、CPU offload 基准、多种子显著性或完整训练显存对照。可以消除目标层持久 V 缓存,不等于消除所有 V 存储;大参数表和临时 gather 仍有成本。
原文值得保留的疑点:Fig. 5 缓存百分比分母;正文与 Table 8 学习率/训练预算范围差异;摘要页与实际 PDF 页数差异;逐任务中心化说明与未提供 $r_j$ 的可复算性;没有明确分列 BoV 的总存储参数量。另一个概念问题是 Sec. 5.2 称直接 $\mathbf x_0\mathbf W_V$ 与 BoV 具有相同表达力,但自由表不再被约束为跨层共享 embedding 的乘积;原文没有形式化证明这种“相同表达力”在联合多层参数化中的严格含义。可确认的是初始化等价与 Value 的上下文无关性。
本次分析提出的后续实验:固定 tokens、固定 FLOPs、固定总参数三种预算分别比较;统一加法/替换方案的层位置和门控后重做消融;报告多种子,单独追踪 LSAT-AR 等退步任务;在不同序列长度、batch、窗口和 KV 头数下测峰值显存与端到端吞吐;在训练未覆盖的长上下文任务中检验质量。上述均为建议,非本文已完成结果。
组会可以围绕一个问题展开:当 Q/K 已携带上下文,深层 Value 是否更适合作为由注意力动态组合的 token 内容库? 本文提供了支持这一设计方向的实验证据,机制解释和大规模部署收益仍有待验证。