Memory by Design: Probabilistic Sequence Layers:中文精读笔记
- 作者:Matthew Dowling、Hyungju Jeon、Cristina Savin、Il Memming Park。
- 论文版本:arXiv:2605.31163v3,修订日期 2026-08-18;本次获取与研读日期 2026-09-14,修订 r1。
- 材料:arXiv v3 · 本地原文 PDF · 作者主 TeX · 源码清单。PDF 共 30 页,下文页码均为从 1 开始的 PDF 页码,与本版本印刷页码一致。
- 阅读范围:主文件实际引用的 introduction、method、experiments、discussion、appendix 全部已读,并读取 macros;覆盖正文 §1–5、附录 A–G.1、图 1–8 和表 1–7。参考文献用于识别论文所述相关工作,未另行精读被引论文。源码已成功获取;注释中的旧实验稿不作为结果依据。未执行作者代码或复现训练。
- 配套成品:英文组会幻灯片 PDF · 可编辑 TeX。本笔记是分析,不是全文翻译。
论文总览
核心问题:固定大小的关联记忆遇到相近 key 时,如何既写入新关联,又避免反复破坏已经学会的关联?
作者提出设计模型(design model):先规定关于内部记忆的辅助概率模型,再用它的精确贝叶斯滤波推导递推层。在线性高斯实例 Bayesian Layer(下文 BL)中,状态包含关联内容的均值 $\mathbf M_t$ 和 key 空间的不确定性协方差 $\mathbf P_t$。后者把原始 key 变成 $\bar{\mathbf P}_t\mathbf k_t$,因而能同时改变写入方向和写入强度。这里“Bayesian”指辅助记忆模型中的精确滤波,不表示网络权重有贝叶斯后验,也不表示真实文本遵循高斯生成过程。
最可靠的结论是:稠密协方差提供了有解析解释的抗干扰机制,并在报告的召回任务上带来收益;它没有在语言建模质量与成本上全面胜出。 从头训练的 WikiText-103 实验中,BL 的 AR-hit 困惑度为 18.15,优于 Gated DeltaNet(GDN)的 23.72,但整体困惑度为 20.01,差于 GDN 的 18.75。340M 模型替换四层后,在 8k 上下文的六项 NIAH 平均分为 20.00,GDN-zero 为 16.81,继续训练对照 GDN-FT 为 16.06;与此同时,保留语料困惑度变差,状态还需要额外协方差存储。[表 2,p.9;表 6–7,p.29]
阅读提醒:v3 有图文、指标与附录设置不一致的地方。本笔记把“原文报告”“从原表重算”“本次推导”分开,详见末尾核验说明;不会把这些差异自行补成统一实验设置。
结构地图
| 原文章节 | 论证作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 从代数递推转向显式记忆假设 | pp.1–2 |
| 2 The design-model framework | 写入、读出、确定性输出的分工 | pp.2–5;图 1–2 |
| 2.1 The Bayesian Layer design model | 矩阵高斯信念、转移和伪观测 | pp.3–4;定义 1,式 (4)–(8) |
| 2.2 The Bayesian Layer recurrence | 均值及协方差更新 | p.4;命题 1,式 (9)–(13) |
| 2.3 Anatomy of the update | 写入几何、重复证据及碰撞 | p.5;式 (14)–(16) |
| 3 Specializations of the design model | Delta-rule 重置约化与加性模型 | pp.6–7;表 1,命题 2 |
| 4.1 Controlled collision recall | 确定性机理与学习后的外推 | pp.7–8;图 3,式 (20) |
| 4.2 The Zoology MQAR benchmark | 离散 token 下学习关联 | pp.8–9;图 4 |
| 4.3 From-scratch language modeling and distillation into a pretrained model | 从头训练与预训练模型改造 | pp.9–10;表 2,图 5 |
| 5 Discussion | 与同期方法的区别、限制与总结 | pp.10–11 |
| A Write-Driven Latent-Input Design Model | 加性均值递推的推导 | pp.14–15 |
| B Error-Correction Form and Connection to the Kalman Filter | Kalman 创新形式;与 mLSTM 区分 | p.15 |
| C Kronecker Closure Under the Design Model | 共享列协方差结构闭合 | pp.15–16 |
| D Filtering implementation | 分块计算、复数动态、分组噪声 | pp.16–17;表 3 |
| E Controlled Collision Recall | 定理、平台解析式、任务与消融细节 | pp.17–26;图 6–7,表 4 |
| F Zoology MQAR Benchmark | 训练、状态预算和数据生成 | pp.26–27;表 5 |
| G Distillation and Long-Context Retrieval | 两阶段损失、对照、完整分项结果 | pp.27–29;图 8,表 6–7 |
| G.1 From-scratch WikiText-103 comparison | 分词、AR-hit 定义与种子变异 | pp.29–30 |
一:动机——记忆不仅要知道“存了什么”
线性注意力通常把 $\mathbf k\mathbf v^\top$ 加到状态里;Delta-rule 则写入“新 value 减去旧记忆预测”的残差。后者能抑制同一关联的重复累加,却仍可能沿原始 key 方向修改状态。当 $\mathbf k_A$ 与已存目标 $\mathbf k_B$ 重叠时,即便当前写的是 A,更新也会投影到 B,破坏 B 的读出。
BL 增加的信息是:哪些方向已经被过去证据约束,哪些方向仍未确定。其直觉不是让所有写入都变弱,而是让新写入避开已经确定的分量,把修正放到尚未解释的方向上。过程噪声又让记忆重新获得可塑性,避免永久冻结。
作者的贡献可分为三层:[§1,pp.1–2]
- 框架:把潜在记忆、写入概率模型、读出模型、输出规则分开设计。
- 具体递推:在线性高斯条件下传播稠密 key 空间协方差,得到历史依赖的写入方向和增益。
- 证据:解析碰撞动力学,并测试受控碰撞、学习召回、MQAR 和两类语言建模场景。
这些贡献与“发明一种新的 Kalman 滤波公式”不同;滤波代数本身是标准的,论文的重点是把可学习的 token 映射接入这个架构,并把协方差作为递推记忆的一部分。
二:方法——由辅助概率模型推导一个确定性层
2.1 输入、状态、输出
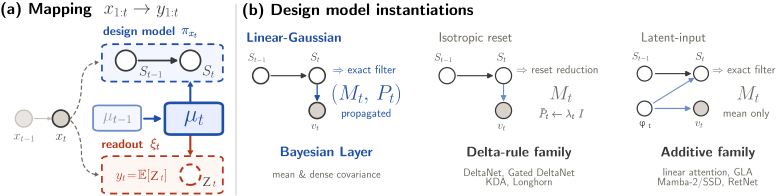
原图 1,PDF p.2。先读左侧:当前输入决定设计模型,滤波更新信念,再经读出得到输出;右侧区分 BL、协方差重置的 Delta-rule 家族和另一潜变量模型的加性家族。箭头表述的是构造关系,不是各完整网络在所有组件上的等价。
| 符号 | 形状/含义 |
|---|---|
| $\mathbf x_t$ | 当前层的输入向量;用于生成下面的 key、value、query、动态及噪声参数 |
| $\mathbf S_t,\mathbf M_t$ | $D\times m$;潜在关联记忆与其后验均值 |
| $\mathbf P_t,\bar{\mathbf P}_t$ | $D\times D$;更新后与预测时的 key 空间协方差 |
| $\mathbf k_t,\mathbf q_t$ | $D$ 维写入 key 和读出 query |
| $\mathbf v_t,\mathbf y_t$ | $m$ 维伪观测 value 和层输出 |
| $\mathbf A_t$ | $D\times D$ 动态;实现中使用结构化矩阵 |
| $\ell_t^2,r_t^2$ | 过程噪声与观测噪声的方差;不是标准差 |
| $\mathbf u_t$ | $D$ 维协方差变换后的 key |
| $\beta_t$ | 标量创新精度;本身不必在 $(0,1)$ 内 |
| $\mathbf K_t=\beta_t\mathbf u_t$ | 向量 Kalman 增益;不要与后文任务的配对数 $K=8$ 混淆 |
这些都是学习到的特征空间量,论文未赋予物理单位。$\mathbf P_t$ 的意义是内部关联的不确定性几何,不是可直接解释为事实可信度的外部校准分数。
2.2 写入模型与读出模型
论文的高斯记号表示
即每一列值记忆有相同的 $D\times D$ 协方差,列间在基础模型中独立。它不是一个任意的 $Dm\times Dm$ 稠密后验。[§2.1,p.3]
给定输入产生的参数,设计模型规定
第一式描述旧记忆如何演化;第二式把当前 value 当作“记忆在 key 方向上应输出什么”的伪观测。$r_t^2$ 大表示这条写入证据可信程度低,$\ell_t^2$ 大表示旧记忆需要更多适应。输入 $\mathbf x_t$ 是条件/控制变量,设计模型没有定义真实文本序列的似然。[定义 1,pp.3–4]
读出单独定义候选输出
$\mathbf Z_t$ 不回流为写入观测,query 不参与当前写入递推。按该模型可推得候选输出协方差为 $(1+\mathbf q_t^\top\mathbf P_t\mathbf q_t)\mathbf I_m$;本次推导,用于说明概率读出的含义。论文实际网络只取均值,没有把这个方差交给下游置信度损失。[式 (7)–(8),p.4;§5,p.11]
2.3 核心递推:五步看清协方差的作用
初始状态为 $\mathbf M_0=\mathbf0$、$\mathbf P_0=p_0\mathbf I$。定义预测均值 $\bar{\mathbf M}_t=\mathbf A_t\mathbf M_{t-1}$,则命题 1 等价于:[式 (9)–(13),p.4;附录 B,p.15]
- 预测:迁移旧记忆并补充不确定性。
- 方向变换:用协方差把 $\mathbf k_t$ 映射成 $\mathbf u_t$。
- 归一化:用观测噪声加预测方差得到创新精度。
- 内容更新:只写入 value 与旧记忆预测之间的残差。
- 信念更新:该方向刚被证据约束,未来的不确定性应减少。
均值更新也可写成带门形式:
$\mathbf F_t$、$\mathbf u_t$、$\beta_t$ 都是滤波导出的量,不是三个互不相关的新增网络模块。尤其 $\mathbf F_t$ 一般不是逐元素 sigmoid 门。标量有效创新权重是
在正观测噪声、半正定协方差下成立。区分 $g_t$ 和 $\beta_t$,可避免把“精度大”误读成“写入比例超过 1”。
为什么只需一块协方差? 向量化后,转移为 $\mathbf I_m\otimes\mathbf A_t$,观测矩阵为 $\mathbf I_m\otimes\mathbf k_t^\top$,噪声也按列重复。预测和 Kalman 更新都保持 $\mathbf I_m\otimes\mathbf P_t$ 形式。附录 C 的证明就在于逐项使用这个 Kronecker 结构;放宽列噪声相同的假设后,要改用多组协方差。[pp.15–17]
2.4 协方差如何保护相近地址
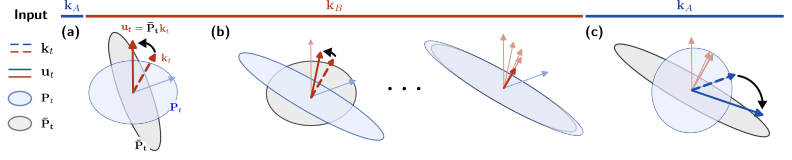
原图 2,PDF p.5。虚线为原 key,实线为有效写入方向;椭圆表示更新前后的不确定性。(a) 展示方向变换,(b) 重复 B 写入使 B 方向收缩,(c) 后续 A 写入偏向未解决的剩余分量。它是机制示意,不是精度实验。
设单位 key 满足
在 B 已充分强化、协方差近似在这组基下对角化时,
A 仍触发写入,但真正收到大幅修改的是正交残余方向。该式是带条件的近似,不能说任意时间点都严格无干扰。[式 (15),p.5]
教学例子(本次构造,不是论文实验):在以 B 为第一轴的坐标系,令 $\mathbf k_B=(1,0)^\top$、$\mathbf k_A=(0.8,0.6)^\top$、$\bar{\mathbf P}=\operatorname{diag}(0.05,2)$。则 $\mathbf u=(0.04,1.2)^\top$。原始 key 的 B 分量很大,有效方向的 B 分量却很小。这个例子为了展示已知主轴下的直觉;在一般固定坐标系,学习到的椭圆会旋转,丢掉非对角项就丢掉了这种方向关系。
2.5 可解析预测及其适用条件
以下结论使用 $\mathbf A_t=\mathbf I$、单位 key、常数 $r,\ell$,并在某时刻以后反复写同一个 A。它们不是对任意门控、任意输入序列的全局保证。[附录 E.1–E.3,pp.17–21]
跨方向收缩与补充。 写 A 后 B 的后验方差变化为
第一项是过程噪声补充,第二项是观测 A 顺带约束 B 的部分。半正定性及 Cauchy–Schwarz 给出收缩项的界。长期重复 A 时,A 与正交子空间的交叉协方差逐渐收缩到零,因此
这表示 B 中未被 A 观测到的部分不断积累不确定性,不是说 B 的内容均值每步损失同样大小。[命题 3、推论 4;正文式 (16)]
写入增益有正的稳态底值。 令 $x_t=\bar\sigma_{A,t}^2$,则
当 $r^2=\ell^2=0.05$,$g_\infty\simeq0.618034$。所以“证据累积让增益衰减”不等于“增益降到零”。同址反复写入时,创新残差也收缩,实际改变量仍趋向零。[式 (42),p.19]
写入方向旋转。 在长时间强化 B、仍有非零正交分量的条件下,下一次 A 写入相对原 key 的极限夹角为 $\arcsin\rho$(这里取实验的 $0\le\rho<1$)。$\rho\to1$ 的极限不能替代 $\rho=1$:完全相同 key 配上冲突 value 时,固定线性读出不能同时精确保留两者。[附录 E.2,p.19]
2.6 与现有递推的关系
| 构造 | 关键选择 | 均值递推的含义 |
|---|---|---|
| BL | 持续传播 $\mathbf P_t$ | 历史依赖的方向与残差写入 |
| DeltaNet | 每步 $\bar{\mathbf P}_t\leftarrow\lambda_t\mathbf I$,$\mathbf A_t=\mathbf I$ | 沿原 key 的 Delta 更新 |
| GDN | 同样重置,$\mathbf A_t=\alpha_t\mathbf I$ | 加上标量遗忘动态 |
| KDA / Kimi Linear | 同样重置,$\mathbf A_t=\operatorname{diag}(\boldsymbol\alpha_t)$ | 各方向不同的遗忘动态 |
| Longhorn 对应形式 | 每列不同的噪声/重置 | 每列具有不同有效更新强度 |
| Linear Attention、RetNet、GLA、Mamba-2/SSD 核心 | 使用另一 latent-input 设计模型 | 精确闭合的加性均值递推 |
来源:表 1、§3,pp.6–7;附录 A、D。这里比较 recurrent core;归一化、卷积、输出门和其他完整网络组件不能自动包含在代数对应中。
重置后
损失的是协方差历史,Delta 的残差校正仍然存在。[命题 2,式 (17),p.6]
加性家族则令每步独立的潜在写入系数 $\boldsymbol\phi_t\sim\mathcal N(0,\lambda_t\mathbf I)$,观测 $\mathbf v_t$ 只测量 $\boldsymbol\phi_t$,并定义 $\mathbf S_t=\mathbf A_t\mathbf S_{t-1}+\mathbf k_t\boldsymbol\phi_t^\top$。于是
这里不能把加性家族说成“把 BL 的协方差设为零”:设零只会使增益消失。准确说法是换了伪观测的对象,均值递推不需要协方差反馈。原文关于“没有后验不确定性”的措辞需收窄,见核验说明。[§3.2,pp.6–7;附录 A,pp.14–15]
2.7 训练、推理与成本
给定一层的输入流,协方差递推不依赖 value 的数值和均值状态;输入生成的噪声和动态参数仍会影响它。先算出增益轨迹后,均值递推是仿射的,可以采用 DeltaNet 类的分块算法。论文按 chunk 顺序推进,chunk 内先做协方差 pass,再用 WY 分解计算均值/读出;这不等于所有时间步的协方差都已经完全并行化。[附录 D,p.16]
基本实例每 token 运算为 $O(D^2+Dm)$,状态为 $O(D^2+Dm)$,前提是 $\mathbf A_t$ 为对角或固定小块结构。若采用任意稠密 $\mathbf A_t$,不能直接套用该成本。分成 $G$ 组观测噪声后,每头存 $\mathbf M$ 和 $G$ 块协方差,总状态 $O(Dm+GD^2)$;包括均值操作的成本也应保留 $Dm$ 项。论文实现描述把协方差主导部分写为 $O(TGD^2)$。[p.4;附录 D,pp.16–17]
实现支持阻尼 $2\times2$ 旋转,等价于复对角动态;读出只看实部时,过程噪声仅注入实部行。此时应使用附录的结构化噪声矩阵,而不能机械照搬基础模型的各向同性噪声。分组噪声会给不同 value 列组独立协方差;论文未给出所有大型实验精确的 $G$、总协方差字节数与吞吐量表。Triton 前反向核使用 fp32 滤波算术,训练外围使用混合精度。[附录 D]
训练学习投影、动态与噪声映射;推理按相同滤波递推更新激活状态,无需每 token 更新网络权重。协方差的额外状态依赖 head 维度的平方,不随序列长度线性累积,因此仍属于固定状态的长序列模型,但“线性于长度”不能推出“与 GDN 等快”。
三:实验——分别回答什么问题
3.1 实验设置与对照角色
| 实验 | 想排除的替代解释 | 对照、预算和重复次数 |
|---|---|---|
| 确定性碰撞 | 差异是否来自训练或地址学习 | 固定 key/value、112 步;BL、reset/Delta、线性注意力、对角协方差;无训练 |
| 学习后的受控碰撞 | 端到端学习是否消除/保留机理差异 | 两层,宽 64,4 头,每头 16 维;2,500 步、batch 256、3 seeds |
| 随机 key 拥挤 | 优势是否只针对人为构造的两地址碰撞 | 独立训练随机 key 任务;相同优化预算;增加 $n/D$ |
| Base / Update / Block MQAR | key/value 都要从离散 token 学习时是否有效 | 两个 mixer 层;作者报告每层 8,192 状态预算;40 epochs;每条曲线仅保留 1 次最终运行 |
| 从头训练 WikiText-103 | 是否只在合成任务有效 | 匹配递推状态预算、约 16–18M 非 embedding 参数、520M 训练 token、每模型 3 seeds |
| 340M 模型蒸馏 | 检索改进是否只是继续训练带来的 | 四层替换、作者按 400M 数据 token 计预算、1 seed;GDN-zero 和 GDN-FT |
来源:表 3(p.17)、附录 E–G.1。各组“匹配”含义不同:受控实验匹配骨干与门参数不代表匹配运行状态字节数;语言模型匹配状态预算也不保证参数量、FLOPs 和实际训练时间完全相同。
3.2 确定性碰撞与学习外推
确定性实验设 $D=16,m=6$,$\mathbf k_A=\mathbf e_1$,$\mathbf k_B=\rho\mathbf e_1+\sqrt{1-\rho^2}\mathbf e_2$,其他四个身份用正交 key;value 为 one-hot。先两轮写入全部身份(1–12 步),再强化 B 40 次(13–52 步),最后写 A 60 次(53–112 步)。取 $\rho=0.92$、$\mathbf P_0=3\mathbf I$、$r^2=\ell^2=0.05$、$\mathbf A=\mathbf I$,重置对照得到固定增益 0.5。[附录 E.4,pp.21–22]
指标要分开:确定性图的 pairwise retrieval 是
$p^{AB}=0.5$ 与 $\Delta=0$ 都表示两类打平。它们不是全词表准确率。单位 one-hot value 使正确类比另一类高 1 时,$p^{AB}=\operatorname{sigmoid}(1)\simeq0.731$,不能把它误读为“最多答对 73.1%”。
学习实验每序列有 8 对目标/干扰地址,值标签每序列重新排列,地址直接送给所有层与头作为 key/query,不允许模型通过学习投影消除指定碰撞。输入包括 WRITE/QUERY 标记、地址、value,33 维;损失只在 query token 上计算。训练 $n_b=4$、$n_f\in\{1,2,4,8\}$、$\rho\in[0.60,0.80]$,AdamW,LR $3\times10^{-4}$,weight decay $10^{-4}$,梯度裁剪 1.0。正文与图 3 把测试写入次数延伸至 256;附录 E.5.1 只列到 64,应视为文档不一致。[pp.23–26]
“-style” baseline 只复制相应递推核,不含原始完整模型所有卷积与门。reset 对照试图单独隔离协方差历史;但学习实验关于 reset 的噪声门是否可学习,正文和附录写法冲突,因此严格的因果归因应保留条件。
随机 key 任务从 64 维标准高斯取单位地址,经所有模型共享、冻结、行正交的 $16\times64$ 投影后重新归一化。先写 $n$ 个关联,再随机问其中 8 个,64 种 value 标签;训练 $n\in\{16,32,48,64\}$,即 $n/D\le4$;测试 $n/D\in\{6,8,12,16\}$。这是独立训练的任务,不能说是在成对碰撞任务上训练后直接迁移。[附录 E.5.4,pp.25–26]
3.3 MQAR:学习角色、更新旧值、跨越间隔
作者修改生成器,让 key 与 value 来自同一词表,试图去掉角色由 token 身份直接决定的捷径。词表大小 8,192;保留训练池分别为 Base 100,000、Update 160,000、Block 120,000 条。统一 AdamW,$\beta=(0.9,0.95)$,weight decay 0.1,batch 256,40 epochs,1,024 步 warmup 后 cosine;按验证 query accuracy 从各任务学习率网格中挑选。曲线未跨种子平均。[表 3、附录 F,pp.17、26–27]
- Base MQAR:图 4(a) 采用长度 $N=512$、64 对关联,横轴模型宽度。BL 在较大宽度接近满分。正文说非 BL 的 Base 曲线引用自前作,因此需要澄清这些基线与“共享词表”改动是否完全同协议;不能默认都在本次生成器下重跑。
- Update-MQAR:例如 A→4、B→5、再 A→4*,最终应返回 A→4* 和 B→5,既要更新同址旧值,也要保护其他关联。训练长度 64/128、关联数 4/16,混合更新量;图 4(b) 固定 $N=128$、16 对关联,横轴更新次数。
- Block-MQAR:例如先 A、B,再 4、5,要求绑定 A→4、B→5。训练 block size 2、长度 128、关联数 2/4/6/8;图 4(c) 将关联数扫到 16。它同时要求跨越 key–value 与 value–query 间隔。
表 5(p.27)的状态公式支持 BL 为均值加协方差、GDN 用扩展 value 维度匹配 8,192,但表头和单元格中 $d_{model}/d_{state}$ 有排版错位;笔记不把错位的“128”直接当作实际 head state dimension。
3.4 两种语言建模实验不能混用数字
从头训练使用 fla-hub/gla-1.3B-100B 的 32k BPE tokenizer。BL/GDN 宽度 512、4 层、4 头、head dimension 128;Mamba-2 使用 8 个 mixer-only blocks。训练四轮 WikiText-103(每轮约 130M BPE token),总计 520M token、7,935 steps,每步 65,536 token、长度 2,048。LR $6\times10^{-4}$ 只在 GDN 上试选后共享;MLP dropout 0.4 对没有 MLP 的 Mamba-2 不起作用。三模型的骨干并非逐组件完全相同。[附录 G.1,pp.29–30]
AR-hit 是一个 token 完成的二元 token 对同时满足:其最近一次先前出现位于同窗口、距离不超过 1,024 token,且该二元组在 130M-token 训练语料中出现不超过 16 次。它度量稀有重复关联的预测能力。距离桶只包含 AR-hit;其他 token 是其补集。评估使用官方验证/测试划分的 packed windows,附录报告 288 个窗口。PPL 是平均 token 交叉熵的指数,越低越好,不能与公开 word-level WikiText PPL 或不同 tokenizer 的 retrofit PPL 直接比较。
预训练模型改造从 linear-moe-hub/Gated-Deltanet-340M 出发:24 层、宽 1,024、4 头、head dimension 256;替换索引 $\{5,11,17,23\}$。Phase A 同时进行各层匹配,每层约 100M token;Phase B 联合训练约 300M token。论文按共享数据曝光计为 400M,不能把四层的 100M 简单相加为“独立新语料 400M”。使用 SlimPajama、训练长度 2,048、一个训练种子。[§4.3,pp.9–10;附录 G,pp.27–28]
Phase A 匹配层输出,损失为方差归一化平方误差加 $0.05(1-\cos)$;Phase B 使用教师到学生的 $\mathrm{KL}(p_{GDN}\Vert p_{BL})$ 和边界输出的归一化 MSE,权重先 $(0.8,0.2)$ 后 $(0.9,0.1)$。训练包括 BL 递推、新旧投影和输出门,并以 0.1 倍 LR 解冻所选层的部分 MLP 权重。GDN-FT 保持相应可训练层范围,继续训练相同 400M token,但用 next-token CE,因此该对照排除了单纯额外优化预算的解释,却没有把“换架构”和“换训练目标”完全独立消融。
RULER 只报告六项 needle-in-a-haystack(NIAH)任务,表 6 注明排除 CWE;“RULER 提升”不能理解为完整 benchmark 的全部任务均提升。PPL 用原 GDN tokenizer,在同样的非重叠窗口和相同 token 位置比较。
四:结果——证据支持什么,不能支持什么
4.1 碰撞动力学:解析结果可复算,但主图有差异
| 量/条件 | BL | reset / Delta | Linear Attention |
|---|---|---|---|
| B 强化结束,$t=52$ 的 $p^{AB}$ | 0.73106 | 0.73106 | 约 1 |
| A 干扰写入结束,$t=112$ 的 $p^{AB}$ | 0.72309 | 0.35138 | 0.00054 |
| 同一时刻概率间隔 $\Delta$ | +0.44619 | −0.29723 | −0.99892 |
| A 写入开始的有效增益,$t=53$ | 0.90708 | 0.5 | 0.5 |
| 长期重复 A 的增益 | 0.61803 | 0.5 | 0.5 |
来源:附录 E.3–E.4,pp.20–22;本次按原递推和配置独立计算,保存在 核验脚本(本地核验附件) 与 计算结果(本地核验附件)。BL 与 Delta 的解析平台与复算一致;线性注意力有限步结果为本次计算。原图 3(a) 蓝线末端视觉上约 0.60,不能用它来声称已在图中验证 0.72309。 原图 6 的 overlap 曲线则与附录约 0.72 的量级一致。没有原始绘图数据来确定主图用了何种不同参数或旧结果。
Delta 的平台可直接解释:令干扰开始前沿 A/B 的读出为 $a_0,b_0$,固定增益 $\gamma$ 给出
BL 则把固定 $\rho\gamma$ 替换为随协方差变化的跨地址增益,附录写成收敛级数;该跨地址影响更小。线性注意力不断累加 A 的 logit,而 B 的目标 logit不增加,所以最终偏向 A。[E.3,pp.20–21]
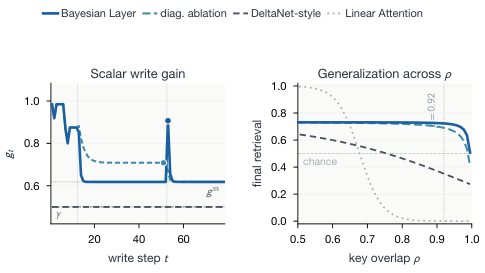
原图 6,PDF p.23。左图横轴写入步数、纵轴标量增益,BL 在切换地址时出现峰值,随后回落到约 0.62;右图横轴 $\rho$、纵轴最终 pairwise retrieval。对角协方差版本位于 dense 与 reset 之间。右侧接近完全重合时 BL 也下降,因此不支持“任意碰撞都不会遗忘”。
固定各向同性先验消融扫 $c\in\{0.01,0.05,0.10,0.50,1,3\}$,增益约 0.17–0.98,末端间隔均为负(约 −0.35 到 −0.19);BL 为 +0.45。这个受控结果说明只调常数增益不能复现 BL 行为,但不排除其他复杂的历史依赖机制。[E.4.2,p.22]
4.2 学习之后:外推收益存在,指标报告需分清
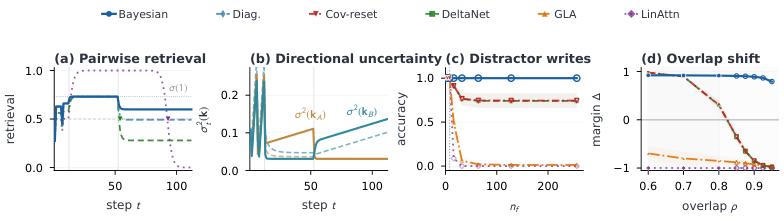
原图 3,PDF p.7;保留全部图例与轴标。(a) 的绝对平台值存在上文所述差异;(c) 轴标是 accuracy,(d) 是 margin $\Delta$。 (b) 区分 A/B 方向不确定性,虚线为丢弃非对角项的消融。
- 写入次数外推,图 3(c):固定 $\rho=0.80$,$n_f$ 延伸到 256,即训练最大值的 32 倍。图示 BL 准确率接近 1,Delta/reset 约在 0.75,线性注意力与 GLA-style 急剧下降。这里只报图读近似,不把正文“margin”的称呼套到这条 accuracy 曲线上。
- 重叠度外推,图 3(d):固定 $n_f=64$,已是训练上限的 8 倍,再将 $\rho$ 推至 0.95。BL 仍为正 margin,Delta/reset 在高重叠度下转负。说明单纯的残差写入并不足以在这个固定地址任务中解决高重叠干扰。
- 统计边界:作者报告 3 seeds、均值 ±1 标准差,但没有单独报告显著性检验;正文和附录的 margin 定义与 reset 设置有冲突。确定性消融对协方差机理的支持比学习实验“唯一变量”的文字声明更干净。
4.3 随机 key:较慢退化不等于无限容量
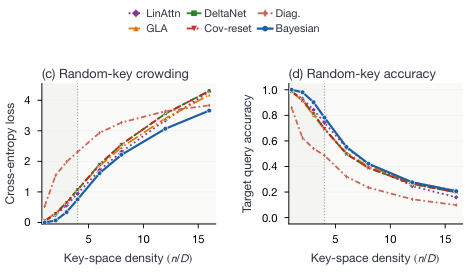
原图 7,PDF p.26。左图交叉熵越低越好,右图全标签 query accuracy 越高越好,横轴都是实际 head 空间的 $n/D$。BL 左图总体最低;右图在高密度下仍优于或接近最强对照,但各模型都大幅退化。对角版本准确率下降尤其明显;它在高密度的交叉熵并非始终最差,不能把“退化最严重”不加区分地套到两个指标上。
附录用线性系统说明单个双线性记忆的精确值重构上限:若 $\mathbf K\in\mathbb R^{D\times n}$、$\mathbf V\in\mathbb R^{n\times m}$,应写
当 $n\le D$ 且 key 满列秩时可解;$n=D$ 是唯一解,$n
4.4 MQAR:BL 有竞争力,但卷积配置决定结论
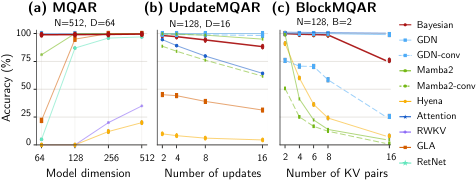
原图 4,PDF p.8。三个面板的纵轴都是准确率百分比;(a) 改宽度,(b) 改更新数,(c) 改关联数量;不同横轴不能合成同一个外推比率。
图 4(b) 在 16 次更新处 BL 约 88%,图例 GDN-conv(有短卷积)和 Mamba2 约 60%;但图例 GDN(无短卷积)的浅蓝方块曲线约 98%,高于 BL。正文/图注笼统说 GDN 降到 60% 会掩盖配置差异,应按图例阅读。
图 4(c) 的无卷积 GDN 保持接近 100%,BL 在关联数 16 时约 75%,有卷积 GDN 更低。这支持“BL 可以不依赖局部卷积跨越 key–value 间隔”,同时也说明这个能力并非 BL 独有。在 Base 任务较大宽度上,BL 接近最强基线;不能把这三张图总结为 BL 在 MQAR 一致优于全部基线。
由于每条曲线仅一次保留运行、Base 基线来自前作、设置说明部分不一致,精度差异应视为所报告实验中的趋势,尚不足以确定小差距具有稳健性。
4.5 从头训练:关联召回收益与整体 PPL 代价并存
| 模型 | 全部 token PPL ↓ | AR-hit PPL ↓ | 其他 token PPL ↓ |
|---|---|---|---|
| BL | 20.01 ± 0.15 | 18.15 ± 1.08 | 20.03 ± 0.15 |
| GDN | 18.75 ± 0.07 | 23.72 ± 1.76 | 18.69 ± 0.08 |
| Mamba-2 | 21.36 ± 0.27 | 424.8 ± 120.4 | 20.58 ± 0.19 |
表 2,PDF p.9,三种子均值 ±标准差。由表重算,BL 相对 GDN 的 AR-hit PPL 下降 23.48%,整体 PPL 却上升 6.72%。这是 PPL 相对变化,既不是准确率百分点,也不是 token 交叉熵下降 23.48%。
| AR-hit 最近重复距离 | BL PPL ↓ | GDN PPL ↓ | Mamba-2 PPL ↓ |
|---|---|---|---|
| 1–64 token | 7.21 ± 0.52 | 10.09 ± 1.07 | 380.6 ± 151.3 |
| 65–256 token | 13.91 ± 1.00 | 19.57 ± 2.07 | 398.9 ± 117.8 |
| 257–1,024 token | 92.1 ± 8.9 | 99.9 ± 0.7 | 544.5 ± 58.3 |
BL 每桶均值最低,但最远桶差距未超过 BL 的种子波动,附录也明确说该差异相对 seed variation 尚未分辨。Mamba-2 在近距离桶也很差,所以该实验中的问题不只是“上下文不够长”。这些结果来自特定小模型、分词与状态预算,不是对所有 Mamba-2 配置的普遍排名。[G.1,p.30]
4.6 蒸馏:长上下文检索分数提高,绝对能力仍有限
| 上下文 token | GDN-zero | GDN-FT | BL | BL−zero(百分点) | BL−FT(百分点) |
|---|---|---|---|---|---|
| 2,048 | 49.52 | 48.46 | 50.81 | +1.29 | +2.35 |
| 4,096 | 31.08 | 31.58 | 34.02 | +2.94 | +2.44 |
| 8,192 | 16.81 | 16.06 | 20.00 | +3.19 | +3.94 |
| 16,384 | 7.85 | 8.36 | 8.81 | +0.96 | +0.45 |
表 6,PDF p.29;六项 NIAH 均分,越高越好。差值由原表两位小数重算。16k 的相对提升不能掩盖 8.81 的低绝对分数;本文没有解决长上下文召回的全部困难。
分任务看也不是一致上涨:2k 的 niah_single_2 从 96.50 降到 89.00(−7.50 个百分点);4k 同一任务从 35.50 升到 51.00(+15.50);8k 的 niah_multivalue 从 1.88 到 6.25(+4.37),niah_multiquery 从 6.00 到 12.25(+6.25)。8k single_1 则从 71.00 降到 67.00。
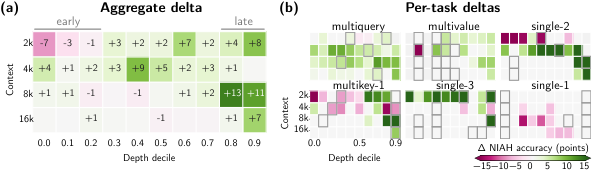
原图 5,PDF p.10。左侧行是 context length,列是 needle 所在深度分位,0.0 最早、0.9 最晚;这不是网络层深度。颜色表示 BL−GDN-zero 的准确率百分点,绿色更好、粉色更差。右侧分六项任务,颜色刻度 −15 到 +15;灰边框表示每格样本数小于 30。
正文报告 4k 的 0.4–0.5 位置有 +8.9,8k 最后两个分位为 +13.0/+11.0;2k 最早位置有 −7.4、最后位置 +8.3。说明替换改变了任务及位置依赖的召回分布,不能据此声称所有早期/中部记忆都受保护。附录称 240 个任务×长度×分位格中有 208 个 BL 样本数少于 30,细粒度热图缺少足够的误差说明。[pp.10、29]
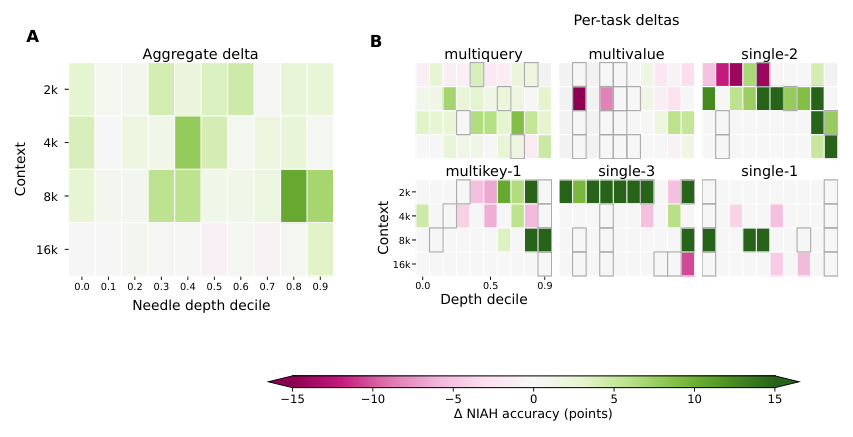
原图 8,PDF p.28。与图 5 类似的模式在 BL−GDN-FT 中保留,削弱“只因多训练了 400M token”这一解释。单种子、目标函数不同、细格样本偏少,仍限制了架构独立因果效应的精确估计。
4.7 保留语料 PPL:应按表 7 计算实际代价
| 语料 | 上下文 | GDN-zero PPL ↓ | GDN-FT PPL ↓ | BL PPL ↓ | BL 相对 zero 上升 |
|---|---|---|---|---|---|
| WikiText-103 | 2k | 15.94 | 15.97 | 16.34 | 2.51% |
| WikiText-103 | 8k | 14.57 | 14.59 | 14.97 | 2.75% |
| WikiText-103 | 16k | 14.44 | 14.47 | 14.83 | 2.70% |
| SlimPajama-heldout | 2k | 12.61 | 12.62 | 12.91 | 2.38% |
| SlimPajama-heldout | 8k | 12.15 | 12.16 | 12.43 | 2.30% |
| SlimPajama-heldout | 16k | 12.06 | 12.07 | 12.34 | 2.32% |
| PG-19 validation | 2k | 20.30 | 20.36 | 20.83 | 2.61% |
| PG-19 validation | 8k | 19.29 | 19.35 | 19.81 | 2.70% |
| PG-19 validation | 16k | 19.14 | 19.19 | 19.65 | 2.66% |
原值来自表 7(p.29),百分比为本次重算。包含 4k 的全表范围:WikiText 约 2.51–2.75%,SlimPajama 约 2.30–2.38%,PG-19 约 2.61–2.70%。摘要/正文将三者统称为 2.5–2.7% 不完全符合表中舍入值,尤其 SlimPajama 低于该范围;笔记和幻灯片采用按语料重算的结果。
GDN-FT 的 PPL 接近原模型,而 BL 的损失在不同长度均存在。数据支持“持续的质量取舍”,没有显示随着上下文增大 BL 在总体 PPL 上反超。对 PG-19 使用验证集前 50 本书、约 3M token;SlimPajama 为约 1M heldout shard;评估使用非重叠窗口。不同语料 token 数与不同长度有效预测位置不同,跨行不应视为同一批预测位置的配对误差。
五:结论、限制与值得追问的问题
5.1 可以带走的认识
BL 的价值是把“记忆确信程度”变成决定下一次写入的状态。Delta-rule 已经有误差校正,BL 进一步让误差沿哪个方向写入、写多少,都取决于过去证据留下的协方差几何。受控的解析模型、复算与消融给这一点较强支持。
设计模型框架还帮助区分两种容易混淆的关系:Delta-rule 是 BL 设计模型的协方差重置形式;加性递推来自观测每步写入系数的另一模型。它统一的是核心更新的推导视角,不保证完整网络、训练目标或计算效率相同。
实际语言建模证据体现为召回指标与平均语言质量的取舍。对稀有重复二元组及部分长上下文检索任务有收益,代价是额外状态、算术与 PPL 损失。论文没有报告能证明 BL 已在通用质量/吞吐量曲线上占优的大规模实验。
5.2 作者明确承认的限制与本次分析
| 类型 | 内容及影响 |
|---|---|
| 作者限制 | 只研究线性高斯设计;非线性、非高斯信念仍是展望 |
| 作者限制 | 340M 改造只替换四层,最大测试 16k;不能外推到更大模型、更多替换层或更长上下文 |
| 作者限制 | 稠密协方差带来 $GD^2$ 状态/计算;低秩、稀疏近似未在本文验证 |
| 作者限制 | 协方差只影响写入,没有用于下游校准或不确定性感知损失 |
| 本次分析 | learned reset 门设置、margin 定义、主图解析平台不一致,限制精确复现与严格归因 |
| 本次分析 | MQAR 只有单次保留曲线;retrofit 一个种子,位置热图多数小样本;不能声称统计显著 |
| 本次分析 | GDN-FT 控制 token 预算与可训练层,但目标函数不同;并非完全分离架构和蒸馏的因子实验 |
| 本次分析 | 没有 throughput、FLOPs、峰值显存、延迟对照表;不能从复杂度认定更快或“匹配计算”已被硬件计量证明 |
同期工作的比较来自论文 §5(pp.10–11),未额外查阅其全文:作者将 Palimpsa 概括为对角 importance 状态,将 Kalman Linear Attention 概括为可扫描的对角信息滤波,将 MesaNet 概括为带稠密统计量、在读出时解静态回归。BL 自身的定位是稠密协方差、演化状态的递归滤波、直接均值读出。附录 B 也强调 mLSTM 的“covariance memory”是存内容的外积状态,不应与这里不存 value 的后验协方差混为一谈。
可进一步研究的问题包括:在匹配真实吞吐量和显存后召回收益是否保留;低秩加对角近似能保留多少方向信息;相同蒸馏目标下 BL 与 GDN 的差距如何;新事实覆盖旧事实与抗干扰保护之间能否更好调节。这些是本次讨论提出的方向,本文没有给出答案。
5.3 v3 核验说明:原文不一致及采用口径
| 位置 | 观察到的问题 | 本笔记采用方式 |
|---|---|---|
| 图 3(a),p.7;E.3–E.4,pp.20–22;图 6,p.23 | BL 主图末端约 0.60;附录给 0.72309,复算支持后者 | 引用附录解析值并明确图文差异;不声称主图已定量验证 |
| §4.1 式 (20),p.8;图 3(c),p.7;E.5.5,p.26 | 正文定义双类 margin;(c) 轴标 accuracy;附录 margin 使用全标签 softmax | (c) 按 accuracy,(d) 按 margin;不混换数值或机会水平 |
| §4.1,p.8;E.5.1,p.24 | 正文/主图外推到 256 次;附录测试集合只列 16/32/64 | 图示最大值用 256,同时注明附录不全/冲突 |
| §4.1,p.8;E.5.5,p.26 | 正文称 reset 与 BL 都有单头可学习标量;附录把 reset 的 $\ell^2$ 固定为 0.05 | 确定性匹配可核验;学习对照是否完全匹配需作者澄清 |
| 图 4,p.8 | “GDN 约60%”对应带卷积曲线;无卷积 GDN 曲线更高 | 严格按图例区分 GDN 与 GDN-conv,不宣称 BL 普遍优于 GDN |
| §4.2,pp.8–9;F,pp.26–27 | Base 基线来自前作,但实验又改共享词表;表 5 维度列错位 | 不默认所有 Base baseline 同协议重跑;按正文及状态公式解释 |
| 表 7,p.29;摘要/§4.3 | 全语料 2.5–2.7% 与 SlimPajama 的表值不符 | 按各语料重算并保留舍入精度 |
| §3.2,pp.6–7;A,pp.14–15 | “无后验状态不确定性”强于模型实际可推出的结论 | 使用“均值不依赖协方差递推”,见下述推导 |
| E.2,p.19 | 大过程噪声展开写为 $1-r^2/(2\ell^2)$ | 使用式 (42) 精确式;其一阶展开应为 $1-r^2/\ell^2+O((r^2/\ell^2)^2)$ |
| E.5.4,p.25 | $\mathbf K^\top\mathbf M=\mathbf V^\top$ 维度不符,且把 $n=D$ 也叫欠定 | 改写为 $\mathbf K^\top\mathbf M=\mathbf V$;满秩方阵情形为唯一解 |
关于 latent-input 的补充推导:在其独立 Gaussian 模型下,$\operatorname{Var}(\boldsymbol\phi_t\mid\mathbf v_t)=c_t\mathbf I$,其中 $c_t=\lambda_t r_t^2/(\lambda_t+r_t^2)>0$。若追踪记忆后验协方差 $\mathbf C_t$,则
所以“给定潜在变量时状态是确定函数”并不使观测条件下的不确定性消失。本次推导支持的是:该协方差无需参与均值更新或线性均值读出,因此可以不作为运行状态维护。这个措辞修正不推翻加性均值递推的构造。
以上是影响理解和复现的具体核验结果,不等同于对论文全部理论或作者实现的全面审计。原始 PDF 和作者 TeX 保持原样;没有把推导修正写回原文。
5.4 阅读与交付记录
- 原文 PDF 与 TeX 身份、v3、题名和作者一致;源码获取状态
available。原始包及逐文件哈希由获取工具记录,PDF SHA-256 为f17e87990df69c5b5fdde1bdf8215423034a2262639b9e793cb86f1727304258。 - 图 1–8 均来自本版本作者的原始 PDF 图件,并与成文 PDF 对照;PNG 用于 Markdown,PDF 用于 Beamer。图件内容与原图号对应,不以生成图替代实验结果。
- 独立复算仅覆盖确定性滤波轨迹、增益极限及原表差值;不代表重新训练、重新运行 MQAR 或重新评估 RULER。运行:
python3 build/verify_equations.py。 - 幻灯片使用本地 pdfLaTeX 编译;编译与逐页视觉核验的实际结果另见 质量核验记录。图件映射见 figures/manifest.json。