Looped Diffusion Language Models:中文研读笔记
作者:Sanghyun Lee、Chunsan Hong、Seungryong Kim、Jonghyun Lee、Jongho Park、Dongmin Park(KAIST、KRAFTON、UC Berkeley)
论文:arXiv:2605.26106v1,2026-05-25 提交;本次获取与研读日期:2026-10-13。
链接:arXiv · 本地原文 PDF · 英文汇报 PDF · 可编辑 TeX
论文总览
LoopMDM(Looped Masked Diffusion Model)研究一个很具体的问题:在参数量和总训练 FLOPs 固定时,把一部分预算用于反复执行少量共享层,能否改善掩码扩散语言模型? 作者的答案是,在所测的 125M–170M 模型上可以,但效果高度依赖循环的位置、范围和次数。
方法把去噪网络分为 head、mid-block、tail,只循环 mid-block。语言建模主配置是 12 层网络中的零基索引 1–2 层,即第 2、3 个 Transformer 层;训练每步从 1–12 次均匀采样循环次数,推理时可以调整次数或提前停止。循环增加单次前向的有效深度,但共享参数不增加模型参数量。
主要证据包括:达到基线最终测试 NLL 所需训练 FLOPs 最多减少到约 $1/3.34$;九项下游任务平均准确率由 40.0% 提高到 41.4%;专门在 TinyGSM 上训练的 125M 模型,在 GSM8K 上最高提高 8.5 个百分点。后者也超过了训练单步计算量近似匹配的 21 层非循环模型。以上均需结合推理循环次数理解,不能将训练效率直接换算为推理加速。(Sec. 4.1–4.2,PDF pp. 4–7)
机制解释是:尚未确定的 token 位置,其连续隐藏状态可以相互交换信息,形成并行计算工作区;共享层在离散化之前反复加工这个工作区。数独实验、注意力分析和不同噪声时刻的收益分布支持这一解释。论文同时给出循环过多导致局部预测变差的例子,并存在若干图文、表格口径差异,下文在对应结果处说明。
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 从参数扩展转向训练计算分配 | pp. 1–2,Fig. 1 |
| 2 Background / 2.1 Masked Diffusion Models | 前向掩码、反向去噪、NELBO | pp. 2–3,Eqs. (1)–(3) |
| 3 Looped Masked Diffusion Models | 三段结构、随机循环次数、训练成本 | pp. 3–4,Eqs. (4)–(6) |
| 4.1 Selective looping matches MDM quality with substantially fewer training FLOPs | 语言建模、迁移表现、架构消融 | pp. 4–6,Fig. 2,Tables 1–4 |
| 4.2 Looping outperforms deeper MDMs at matched per-step training FLOPs in math | 与同参数及更深网络比较数学推理 | p. 7,Fig. 3 |
| 4.3 Where do the gains come from? | 工作区、数独、注意力、动态停止 | pp. 7–9,Example 1,Figs. 4–5,Table 5 |
| 5 Conclusion | 作者归纳 | pp. 9–10 |
| A Related Work | 扩散模型、循环 Transformer、推理计算扩展 | p. 15 |
| B Theoretical Analysis | 有条件的工作区表达能力分离 | pp. 16–18 |
| C Experimental Details | 数据、训练和评测协议 | pp. 18–20 |
| D Omitted Results | 停止阈值、其他循环方案、逐 token 轨迹 | pp. 20–22,Table 6,Figs. 6–8 |
| E Limitations and Future Work | 规模、可学习分配、机制及解码组合 | pp. 22–23 |
| F Dataset Licenses and Usage Terms | 数据使用条款汇总 | p. 23,Table 7 |
以下页码均从 PDF 首页起计,与该版本印刷页码一致。
一:动机——已有去噪迭代为什么还需要层内循环?
掩码扩散模型(Masked Diffusion Model,MDM)从部分或全部被掩码的序列出发,逐步预测并确定 token。与逐个生成下一个 token 的自回归模型相比,每次网络调用都能处理许多尚未确定的位置。问题在于,这些位置在一次前向中形成的连续表示,通常经过输出分布和离散采样后,才影响下一次去噪。
LoopMDM 在一次去噪内部增加计算:先保留所有位置的隐藏状态,反复运行共享层,最后输出 token 分布。这里有两个独立的预算维度:
| 预算 | 改变什么 | 状态如何传递 |
|---|---|---|
| 外部去噪步数 $T$ | 调用去噪网络的次数与每步解除多少掩码 | 当前离散序列 $x_t$ 更新成较少掩码的序列 |
| 内部循环次数 $S$ | 一次网络调用中的有效深度 | 隐藏矩阵 $H_t^{(k)}$ 连续更新 |
因此,即便采样已有多步,单步内部仍可能存在值得投入计算的部分。尤其当多个未知位置彼此依赖时,在确定 token 前增加通信可能减少过早提交不一致预测的风险。
作者进一步追问这种投入是否划算:如果每个训练样本处理得更深,就必须在固定 FLOPs 下减少训练步数及 token 暴露量。论文的核心贡献在于找出一个局部循环配置,在这个取舍中取得收益。(Sec. 1、Sec. 3,PDF pp. 1–4)
二:方法——把少量共享层变成可反复使用的计算算子
2.1 掩码扩散的输入与训练目标
令干净序列为 $x_0=(x_0^1,\ldots,x_0^L)$,词表为 $\mathcal V$,掩码符号为 $\mathrm m$,扩展词表为 $\bar{\mathcal V}=\mathcal V\cup\{\mathrm m\}$。时间 $t\in[0,1]$ 越大,噪声通常越强;$\alpha_t$ 是严格递减的 token 保留概率,$\alpha_0\simeq1$、$\alpha_1\simeq0$。
原文 Eq. (1) 的前向过程逐位置独立进行:
也就是以概率 $\alpha_t$ 保留正确 token,否则替换成掩码。网络读入整个 $x_t$,为每个被掩码位置预测干净 token 分布;反向过程保持已解除掩码的 token 不变,逐步解除剩余掩码。其按位置条件独立的采样形式,允许各位置的预测分布共同依赖全序列隐藏表示。
负证据下界(negative evidence lower bound,NELBO)只在被掩码位置计入损失。循环模型沿用此目标,只把预测器换成循环后的输出。(Sec. 2.1,PDF p. 3)
2.2 三段结构与有效深度
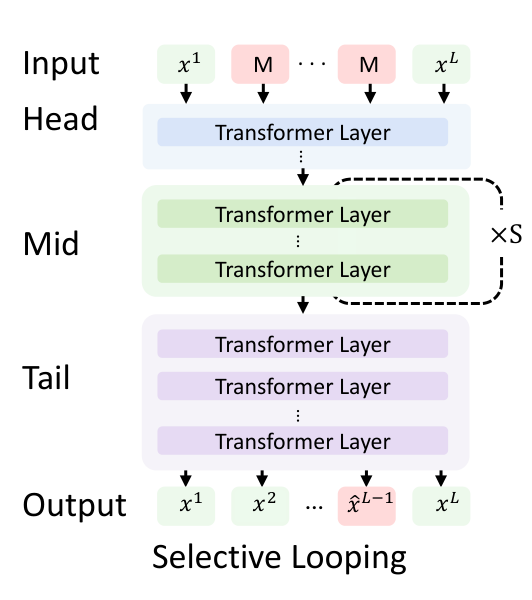
来源:原文 Fig. 1 左侧架构面板,PDF p. 2。head 和 tail 各运行一次,mid-block 使用同一组参数运行 $S$ 次。
| 符号 | 含义 |
|---|---|
| $L,d$ | 序列长度、隐藏维度 |
| $n_h,n_m,n_o$ | head、mid-block、tail 的层数 |
| $H_t^{(k)}\in\mathbb R^{L\times d}$ | 第 $k$ 次 mid-block 执行后的全序列隐藏状态 |
| $S,S_{\max}$ | 本次实际循环次数、训练时循环次数上限 |
| $p_\theta^{S,i}$ | 使用 $S$ 次循环后,第 $i$ 个位置的词表概率向量 |
原文 Eq. (4):
tail 包括从最终隐藏状态映射到词表分布的 LM head。mid-block 的参数在循环间共享,但每次接收的隐藏状态不同。因此,相同参数仍能执行逐步改进的计算。
参数对应的独立层数为 $n_h+n_m+n_o$;有效执行深度为
语言建模主配置的独立 Transformer 层为 12 层,循环索引 1–2 层,故 $n_h=1,n_m=2,n_o=9$,$D_{\mathrm{eff}}=10+2S$。$S=1$ 是 12 层执行,$S=12$ 是 34 层执行,$S=24$ 是 58 层执行。这里数的是 Transformer 层调用,不把词表投影单独算成一层。
这也解释了作者使用“early-middle”的含义:实际选的是非常靠前、但已经经过一个初始层的位置。论文将其解释为输入表示初步形成、又尚未专门用于最终预测的区域;依据来自位置消融。(Sec. 3,PDF p. 3;Table 4,PDF p. 6)
2.3 随机循环训练
每个训练步采样
然后将最终循环输出代入损失:
这里 $x_0^i$ 用 one-hot 向量表示,内积取得正确 token 的概率。由于 $\alpha'_t\le0$,而对数概率非正,这种写法对应非负的加权负对数损失;也可等价写成非负权重 $-\alpha'_t/(1-\alpha_t)$ 乘交叉熵。
随机 $S$ 让同一个算子面对不同展开深度,训练损失施加在当前抽到的最后一次输出上。训练上限为 12 次的语言模型,在测试到 24 次时仍有收益;数学模型则从训练上限 8 次测试到 16 次。外推有效是实验观察,随机训练本身没有给出收敛或逐 token 单调改善保证。(Eq. (5),PDF p. 4;Figs. 2–3,PDF pp. 5、7)
2.4 匹配训练 FLOPs 的含义
共享参数不能消除重复执行的计算成本。原文 Eq. (6):
$F_{\mathrm{base}}$ 是基线一个训练步的 FLOPs,$F_{\mathrm{layer}}$ 是单层相应的计算成本。固定总预算时,LoopMDM 按比例减少训练步数。因而“训练数据匹配”表示使用相同语料来源,不表示累计训练 token 数相同。
教学估算:若只按等成本 Transformer 层计数,忽略嵌入、输出头等开销:
| 设置 | 循环次数 | 有效层调用 |
|---|---|---|
| 12 层非循环基线 | 一次前向 | 12 |
| 语言建模训练平均 | $\mathbb E[S]=6.5$ | 23 |
| 语言建模推理 | $S=6/12/24$ | 22 / 34 / 58 |
| 14 层数学模型训练平均 | $\mathbb E[S]=4.5$ | 21 |
| 14 层数学模型推理 | $S=8/16$ | 28 / 44 |
这解释了为何数学实验选 21 层网络来近似匹配 LoopMDM 的训练单步平均计算量。推理时取 $S=8$ 或 16,实际执行深度已经超过 21 层。因此该对照支持训练预算分配与共享计算的价值,尚未给出固定推理 FLOPs 下的完整比较。(Sec. 3–4.2,PDF pp. 4、7)
2.5 自适应循环:隐藏状态稳定后停止
固定循环次数会在每个去噪时刻付出相同的 mid-block 成本。作者改为监测
当 $r_k<\epsilon$ 或达到循环预算上限时停止,主实验取 $\epsilon=0.1$。这是依据隐藏状态变化的启发式停止规则;其判断对象不是真实答案的误差。论文没有进一步明确范数类型及批内聚合细节。(Sec. 4.3,PDF p. 9)
下面是便于理解数据流的教学伪代码:
H = head(x_t)
for k = 1 ... loop_budget:
    H_new = mid(H)                  # 每轮复用同一组参数
    relative_change = norm(H_new - H) / norm(H_new)
    H = H_new
    if adaptive and relative_change < epsilon:
        break
probabilities = tail(H)
x_s = unmask_using(probabilities, x_t)
外部去噪步之间传递的是更新后的序列;这里的层内循环没有引入跨去噪步保存隐藏状态的新机制。
三:实验——区分三种模型设置和比较目标
3.1 训练与数据
| 实验 | 模型与数据 | 循环与比较 |
|---|---|---|
| 语言建模 | 170M DiT;12 层,$d=768$,12 heads;RoPE、adaptive layer norm;LM1B、OWT、FineWeb-Edu | 索引 1–2 层,$S_{\max}=12$;同参数 MDM;总训练 FLOPs 匹配 |
| 数学推理 | 125M;14 层,$d=512$,8 heads,长度 512;Qwen2 风格注意力;TinyGSM 的 11.8M 道问题与 Python 解答 | 同两层循环,$S_{\max}=8$;14/18/21 层 MDM;总训练 FLOPs 匹配,21 层额外匹配平均单步训练 FLOPs |
| 数独机制实验 | 单层网络,$d=384$,12 heads;100k 训练题,1,000 测试题 | $S_{\max}=6$;固定从左到右解码;100 epochs 内收敛 |
语言建模中,LM1B 用 BERT uncased tokenizer、长度 128;OWT 和 FineWeb-Edu 用 GPT-2 tokenizer、长度 1024,文档间插入 EOS。基线训练 1M steps、batch size 512,LoopMDM 按计算量缩短训练;AdamW,学习率 warmup 2,500 步至 $3\times10^{-4}$,使用 4 张 A100。
数学设置使用 4 张 A100,每卡 batch size 32,学习率 $3\times10^{-4}$,EMA decay 0.9999;GSM8K 使用 EMA checkpoint,结果按 3 个随机种子平均。附录 C.2 写出 900k iterations,但没有逐一列出 14/18/21 层与循环模型的匹配后步数;应依据正文的 FLOPs 横轴理解比较,不能把它改述为所有模型同时等步数、等 FLOPs。
下游选择题使用 FineWeb-Edu 预训练模型,无额外微调,按给定问题下各候选答案的似然选项;每个候选最多评估 128 tokens,输入补齐到 1024。附录 C.3 的“预训练 1M steps”概述与 C.1 明确的循环模型减少步数存在措辞差异;本文采用 Sec. 3、Sec. 4.1 及 C.1 一致的总 FLOPs 匹配描述。(PDF pp. 4、7–8、18–20)
3.2 指标和基线的角色
| 指标 / 对照 | 回答的问题 |
|---|---|
| 测试 NLL,越低越好 | 模型对保留集的建模质量如何;同一 NLL 需要多少训练预算 |
| Zero-shot PPL,越低越好 | 预训练后在七个外部语料上的概率建模迁移 |
| Generative PPL,越低越好 | 无条件生成样本在该困惑度指标下的质量 |
| 九项选择题准确率,越高越好 | 似然排序能否选出正确答案;Avg. 为九任务平均 |
| GSM8K accuracy,越高越好 | TinyGSM 专项训练后的数学任务效果,使用 Top-2 / Top-3 解除掩码 |
| 数独 exact-solve rate,越高越好 | 整个棋盘是否完全解对 |
| 同参数非循环 MDM | 相同参数存储预算下,是否值得将训练计算用于反复执行 |
| 18/21 层非循环 MDM | 更深但不共享参数的网络能否解释循环收益 |
Top-2 / Top-3 指每步按最大 token 概率的置信度选择 2 或 3 个位置解除掩码,不能读成词表采样的 top-k。语言评测表报告 5 个随机种子的均值及“±”值;文中没有充分说明这些误差项是否来自独立预训练、评测随机性以及具体统计定义,因此不据此宣称统计显著性。生成困惑度也没有在正文及附录 C 明确给出打分模型名称,复现这一指标时需要额外补充协议。
四:结果——效率来自选择性循环,收益依赖任务和计算口径
4.1 语言建模与架构消融(Sec. 4.1)
测试 NLL:同一参数量下,较少训练预算可达到基线质量
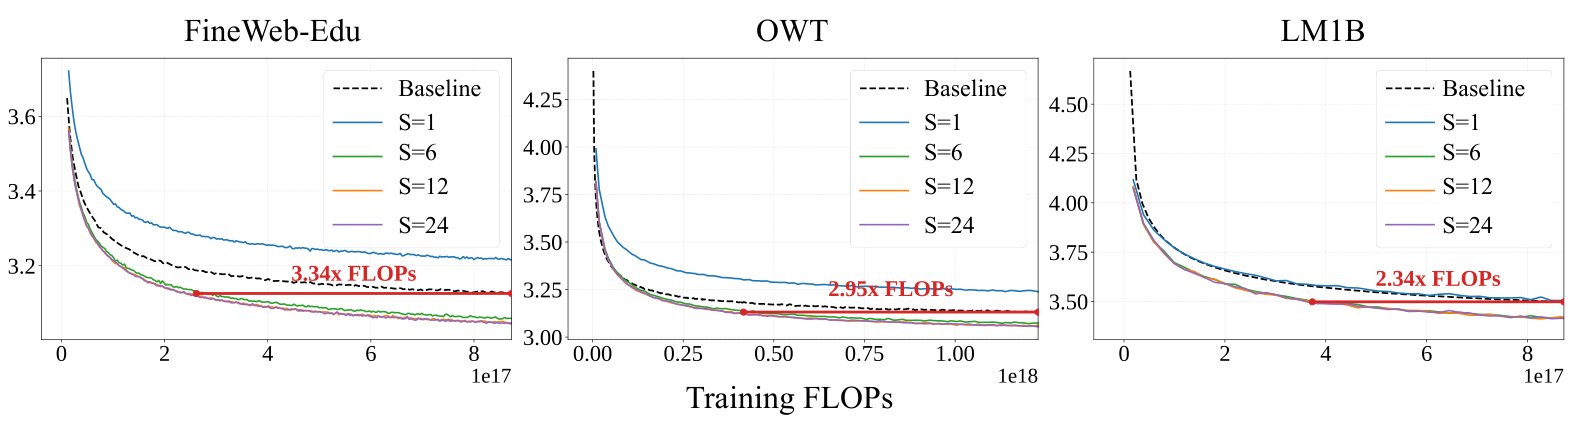
来源:原文 Fig. 2,PDF p. 5。横轴是累计训练 FLOPs,纵轴是测试 NLL;三个面板依次为 FineWeb-Edu、OWT、LM1B。虚线表示非循环 MDM,彩色实线是同一循环架构在不同推理循环次数下的表现。横向红箭头比较到达基线最终 NLL 的训练预算。
从图中可读出,$S=1$ 整体较差;$S\ge6$ 时曲线优于基线;测试到 $S=24$ 仍能进一步降低 NLL。这个结果说明,共享块的能力主要通过重复执行发挥,不能把训练后的 LoopMDM 直接当成一次通过的基线替代品。
该版本的倍率归属存在图文冲突:
| 语料 | Fig. 2 面板标注,PDF p. 5 | Sec. 4.1 正文按列举顺序,PDF p. 4 |
|---|---|---|
| FineWeb-Edu | $3.34\times$ | $2.34\times$ |
| OWT | $2.95\times$ | $2.95\times$ |
| LM1B | $2.34\times$ | $3.34\times$ |
可以可靠引用作者报告的最高倍率 $3.34\times$,而按语料引用时应注明采用图中标注。$3.34\times$ 对应使用约 29.9% 的原训练 FLOPs,约节省 70.1%;这里的效率目标是达到特定质量阈值,而非每步训练或端到端运行时间减少 3.34 倍。
生成困惑度:增加内部循环改善不同去噪预算下的结果
| 外部去噪步数 $T$ | MDM | LoopMDM,$S=6$ | LoopMDM,$S=12$ |
|---|---|---|---|
| 64 | $116.71\pm2.72$ | $105.59\pm3.83$ | $99.06\pm5.91$ |
| 128 | $84.71\pm2.15$ | $76.76\pm1.09$ | $68.22\pm1.58$ |
| 256 | $79.43\pm2.60$ | $64.08\pm1.39$ | $56.45\pm0.50$ |
| 512 | $55.50\pm2.04$ | $49.16\pm2.65$ | $48.16\pm3.17$ |
| 1024 | $42.56\pm1.09$ | $39.23\pm1.31$ | $38.53\pm1.23$ |
来源:Table 1,PDF p. 5;5 个随机种子,保留原表误差项。固定去噪步数时,$S=12$ 均取得最低生成 PPL。增加 $S$ 与增加 $T$ 都能改善质量,但各自成本不同,该表没有固定 $T(10+2S)$ 这样的总推理计算预算。
Zero-shot PPL:七个语料均优于基线,但单任务不总随循环次数单调变化
| 语料 | MDM | $S=6$ | $S=12$ |
|---|---|---|---|
| PTB | 108.5 | 100.2 | 90.2 |
| WikiText | 35.1 | 34.2 | 32.4 |
| LM1B | 68.1 | 68.0 | 67.8 |
| Lambada | 49.6 | 44.6 | 45.8 |
| AG News | 69.3 | 59.2 | 56.6 |
| PubMed | 43.0 | 37.2 | 36.5 |
| Arxiv | 37.8 | 33.1 | 32.7 |
来源:Table 2,PDF p. 5;此处为均值摘录。PTB 改善最大,降低 18.3 个 PPL 单位;LM1B 只降低 0.3。Lambada 在 $S=6$ 时优于 $S=12$,说明总体改善不要求每个任务都随循环次数继续改善。$S=1$ 在该表所有语料上均差于基线。
下游准确率:平均提升主要由部分任务驱动
| 任务 | MDM(%) | $S=12$(%) | 差值(百分点) |
|---|---|---|---|
| ARC-c | 25.5 | 25.3 | −0.2 |
| ARC-e | 47.7 | 47.7 | 0.0 |
| BoolQ | 46.6 | 57.4 | +10.8 |
| HellaSwag | 31.9 | 32.7 | +0.8 |
| OBQA | 30.8 | 28.0 | −2.8 |
| PIQA | 60.6 | 61.1 | +0.5 |
| RACE | 28.5 | 31.7 | +3.2 |
| SIQA | 36.8 | 37.3 | +0.5 |
| WinoGrande | 51.3 | 51.5 | +0.2 |
| 九任务平均 | $40.0\pm0.3$ | $41.4\pm0.6$ | +1.4 |
来源:Table 3,PDF p. 6;各任务列为均值,平均行保留原表误差项。$S=1,6,12$ 的平均值依次为 39.4、40.7、41.4。
正文称九项任务全部持平或提高,但原表显示 ARC-c 与 OBQA 均下降;更准确的结论是六项提高、一项持平、两项下降,平均提高 1.4 个百分点。BoolQ 的 10.8 点增益明显大于多数任务,不能用平均值暗示各类知识能力均匀改善。
架构消融:预算应该投给哪些层?
Table 4 在 LM1B 上使用 170M 模型和 0.1M-step 规模的等训练 FLOPs 设置,基线 NLL 为 3.798。以下摘录主要比较:
| 变化因素 | 设置 → NLL | 解释 |
|---|---|---|
| 循环起始位置,零基索引 | 0 → 3.744;1/2 → 3.729;5 → 3.734;10 → 3.777 | 靠前的中间位置最好,输入端和末端相对较差 |
| 循环层数 $n_m$ | 1 → 3.743;2 → 3.729;3 → 3.734;6 → 3.784;7 → 3.857;12 → 3.933 | 两层已覆盖主要收益,循环超过六层劣于基线 |
| 训练上限 $S_{\max}$ | 4 → 3.741;8 → 3.733;12 → 3.729;16 → 3.740;20 → 3.763;24 → 3.800 | 训练循环过重会挤占 token 暴露预算 |
来源:Table 4,PDF p. 6。位置表中的“1 或 2”是两个候选起始位置,不能与主配置“同时循环索引 1–2 这两层”混为一谈。
这些消融揭示了训练成本的约束:增加层数或训练循环上限会令单步更贵,在固定预算下减少步数,收益可能抵不过数据暴露损失。同时,训练用 $S_{\max}=24$ 较差与训练用 12、推理用 24 较好是两个不同实验,二者并不矛盾。
4.2 数学推理:与更深 MDM 比较(Sec. 4.2)
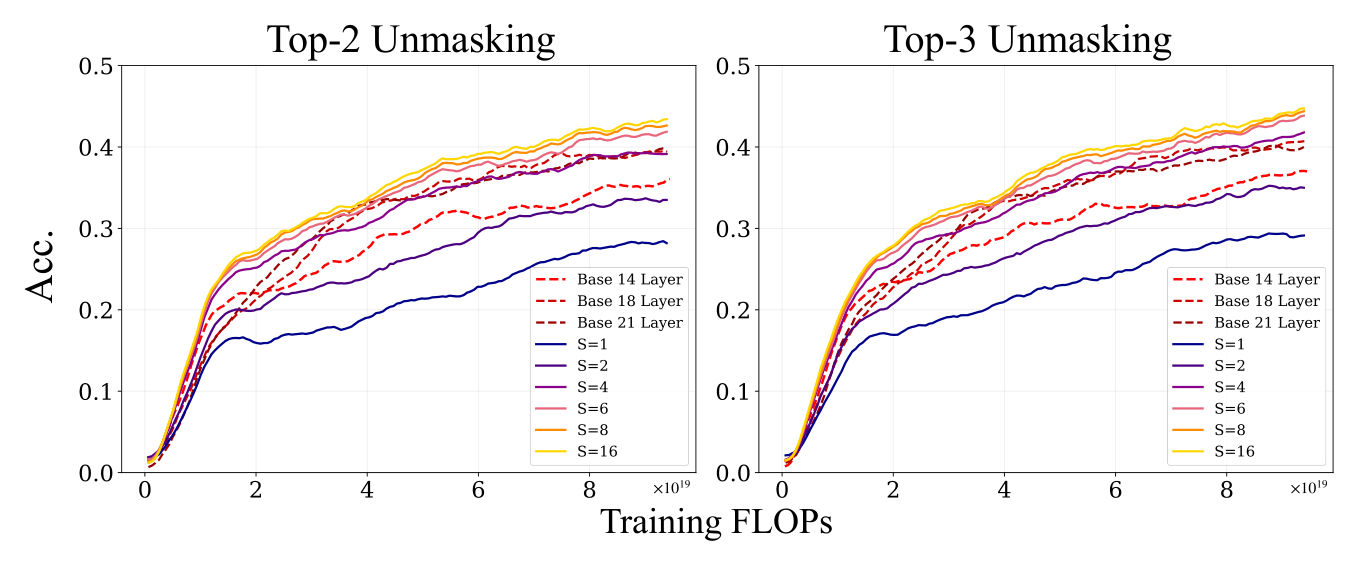
来源:原文 Fig. 3,PDF p. 7。横轴为训练 FLOPs,纵轴为准确率(0–1);左右面板分别为 Top-2、Top-3 解除掩码。虚线是 14/18/21 层基线,实线是同一 14 层循环架构在不同 $S$ 下的表现。
| 比较 | 原文报告结果 |
|---|---|
| $S=16$ 对 14 层基线,Top-2 | +8.5 个百分点 |
| $S=16$ 对 14 层基线,Top-3 | +8.1 个百分点 |
| 达到 14 层基线最终准确率 | 约使用其 43% 的训练 FLOPs,即约节省 57% |
| 对 21 层基线 | $S=8$ 时 +2.7 点,$S=16$ 时 +3.4 点;正文未在这两个差值后进一步注明解码面板 |
模型从头在 TinyGSM 的问题—Python 解答形式上训练,这一结果应理解为特定数学训练设置下的收益,不是普通 FineWeb-Edu 170M 预训练模型直接取得的 GSM8K 提升。
比起独立叠加层,共享两层并反复加工隐藏状态,在这组训练预算下更有效。与此同时,21 层只近似匹配训练时的平均有效深度;评测 $S=8/16$ 时循环模型执行 28/44 层。若目标是部署,需要进一步比较相同推理 FLOPs 或实际延迟下的准确率,而不仅是训练曲线。
4.3 机制:未知位置能承担哪些计算?(Sec. 4.3 与 Appendix B)
工作区分离例子的推导与假设
作者选择固定 $k$ 的 $k$-Clique 问题:输入是 $n$ 个顶点的邻接矩阵 $A$,判断是否存在 $k$ 个互不相同且两两相连的顶点。输入长度 $N=\Theta(n^2)$。
上界构造给每个有序候选 $\mathbf v=(v_1,\ldots,v_k)\in[n]^k$ 分配一个 masked workspace,共 $n^k$ 个位置。每个位置用注意力取回候选顶点间的边,计算
再由答案位置汇总
固定 $k$ 时,每个槽所需的局部资源可以视为常数;候选索引需要 $O(k\log n)$ 位,所以该构造兼容作者讨论的对数宽度设置。
下界额外假设:不添加位置的固定架构,在有限精度、对数宽度和常数循环预算下,可由大小 $O(N^C)$ 的常深度 $\mathrm{AC}^0$ 电路模拟。作者调用其引用的 Clique 电路下界 $\omega(n^{k/4})$;取 $k>8C$,就有
与该下界冲突,从而得到条件性的分离。(Appendix B.2–B.3,PDF pp. 16–18)
这个例子说明增加并行存储位置可以改变可表达计算的范围。决定结论的两个条件必须保留:$\mathrm{AC}^0$ 可模拟性是命题假设,不能仅由“有限精度 Transformer”自动推出;有工作区一侧添加了 $n^k$ 个位置,显著增加序列宽度与计算量。因此,该例子比较的是常数循环深度下的工作区能力,不构成同 FLOPs 下 LoopMDM 优于无掩码模型的定理。正文 proof sketch 的“same compute budget”措辞不能代替附录中的实际资源假设。
数独:固定解码顺序后,层内循环仍可改善一致性
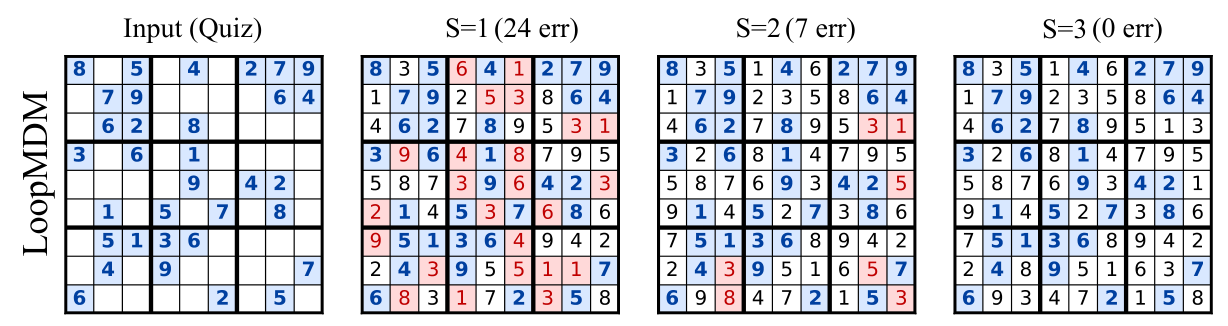
来源:原文 Fig. 4,PDF p. 8。第一面板是输入题目;后三面板分别取 $S=1,2,3$,红色表示错误。该示例错误格数为 24 → 7 → 0。
实验固定从左到右解除掩码,去掉“先解容易格子”的顺序优势。单层非循环 MDM 的完整解对率为 10.9%,循环模型在 $S=1$ 时为 10.6%。图示表明更多内部计算可以在相同固定解码顺序下得到更一致的解。
这里的 24 → 7 → 0 是一题的错误格数,不是 1,000 题测试集上的解对率曲线。正文没有给出更大 $S$ 对应的完整测试集 exact-solve 数值,不应由这个成功示例推断 $S=3$ 的整体解对率为 100%。
注意力与噪声时刻:更多循环加强未知位置之间的交互
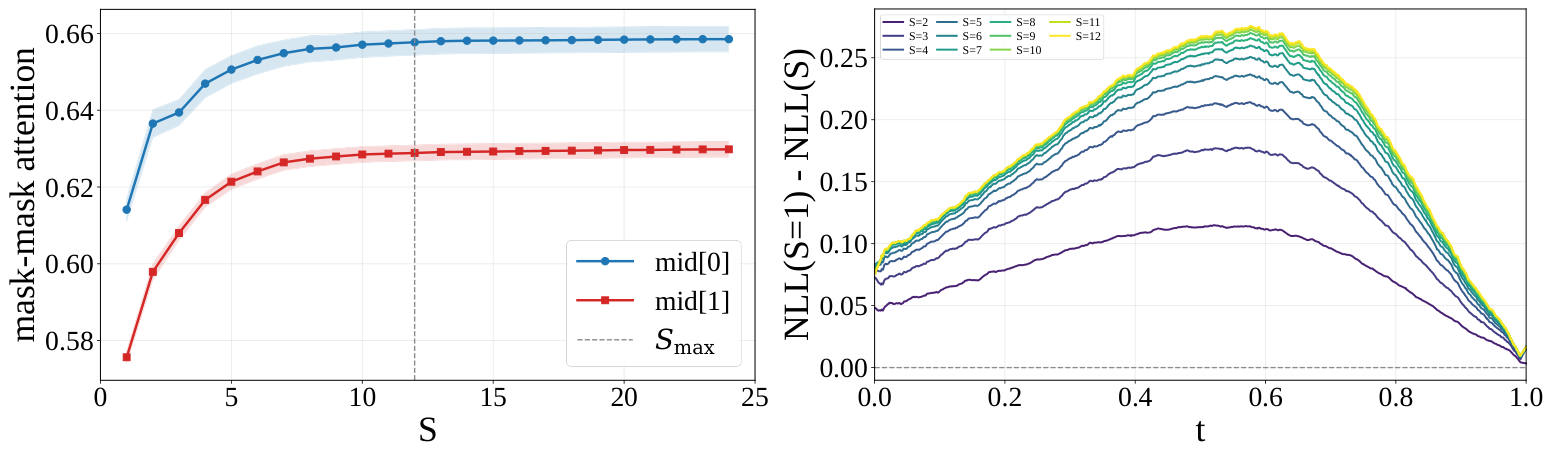
来源:原文 Fig. 5,PDF p. 9。左图固定 $t=0.5$,横轴是循环次数,纵轴是从 masked query 分配给 masked keys 的平均注意力质量,两条线对应两个共享层;右图横轴是扩散时间 $t$,纵轴是 $\mathrm{NLL}_t(1)-\mathrm{NLL}_t(S)$。
左图的 mask-to-mask attention 随循环次数增大,并在训练上限约 12 次附近趋于饱和。右图的收益在中间噪声水平最大:此时既有已知上下文,也有足够多尚未确定的位置,反复通信较有价值;接近全掩码端时上下文不足,接近干净端时剩余问题较少。
这是注意力分配与收益分布的观察,支持工作区解释。数独控制了解码顺序,但两组分析都没有直接通过关闭 mask-to-mask 通路来测量其因果贡献。
4.4 自适应循环与附录补充结果
主表:平均约五次循环保留大部分质量
| 指标 | 固定 $S=12$ | 自适应,$\epsilon=0.1$ | 平均循环次数 |
|---|---|---|---|
| Zero-shot 平均 PPL ↓ | 51.7 | 52.9 | 12 → 5.1 |
| Generative PPL ↓ | 38.53 | 39.11 | 12 → 5.2 |
| 下游平均准确率 ↑ | 41.4% | 41.3% | 12 → 4.9 |
来源:Table 5,PDF p. 9。自适应方案以小幅质量下降换取更少共享块执行。下游准确率降低 0.1 个百分点;生成 PPL 增加 0.58。
整网还需要执行 head 和 tail,因此“12 → 5.2”不能直接解释为整网计算减少 56.7%。沿用前面的等层成本教学估算:
即 Transformer 层调用约减少 40%;真实 FLOPs、批处理效率和墙钟延迟还受输出投影、停止检测和实现方式影响。它依然比非循环模型的 12 层执行更贵。
停止阈值:附录结果应保留独立口径
| 阈值 / 固定循环 | Zero-shot PPL | 对应 $\bar S$ | Generative PPL | 对应 $\bar S$ |
|---|---|---|---|---|
| $S=12$ | 55.58 | 12.00 | 62.44 | 12.00 |
| $\epsilon=0.02$ | 55.57 | 11.73 | 62.66 | 10.73 |
| $\epsilon=0.10$ | 56.68 | 6.20 | 64.39 | 5.45 |
| $\epsilon=0.20$ | 59.45 | 3.74 | 66.03 | 3.41 |
来源:Table 6,PDF p. 20,摘录。更宽松的停止阈值总体减少计算并损害 PPL,生成 PPL 的相邻阈值结果也有局部波动。
Table 6 的固定 $S=12$ 基准、$\epsilon=0.1$ 时的平均循环数,与 Table 5 不同;论文没有充分交代两表差异所需的 checkpoint、数据或采样配置。因此两组表格应分别引用,不能合并成同一条质量—成本曲线。
Table 6 的 Compute 列在数值上基本对应 $\bar S/12$,例如固定 $S=6$ 的一行给出 $6/12=50\%$。它表示共享块循环比例,未计入不循环的部分,不能当成整网 FLOPs 的实测百分比。
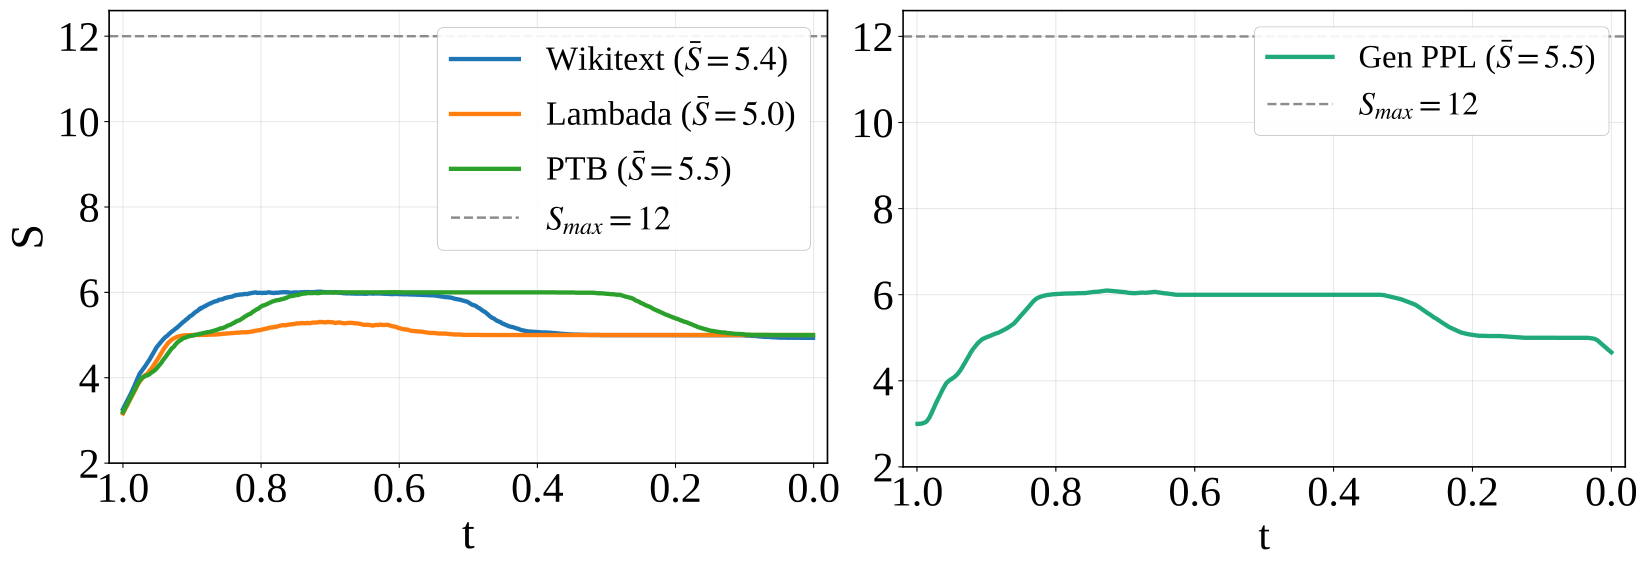
来源:原文 Fig. 6,PDF p. 21;OWT 模型,$\epsilon=0.1$,100 条采样序列。此图横轴按 $t=1\to0$ 排列,与 Fig. 5 右图方向不同。中间阶段通常投入更多循环,接近两端减少循环;Gen PPL 使用 1024 去噪步。
其他循环方式没有优于简单均匀采样
Appendix D.2、Fig. 7(PDF pp. 20–21)比较两个变体:训练时向 mask embedding 注入高斯噪声,以及用 log-normal Poisson 分布采样循环次数。前者 NLL 劣于普通 MDM,后者只小幅改善且弱于 LoopMDM 的均匀采样。
这里所谓 input injection 实际测试的是作者选定的掩码嵌入噪声注入变体;不能由它推断所有将原始输入重复注入循环网络的设计都无效。就本文设置而言,更复杂的循环训练方案没有替代简单均匀采样的必要。
单个 token 的改进与失败轨迹
Appendix D.3、Fig. 8(PDF pp. 21–22)给出四类成功轨迹:局部复制、语义选择、词性调整、结合较远上下文。例如正确 token 为 half 的位置,预测从 a 变为 half,真实 token 的 NLL 从 7.00 降到 0.13。
同时,失败例的正确 token 为 with:$S=1$ 时预测正确、NLL 为 0.75;$S=6$ 时转为 who、NLL 为 2.38;$S=8$ 时转为 whether、NLL 为 5.31;$S=24$ 时仍为 whether、NLL 为 6.69。循环会沿着学到的动力学继续更新,但更多更新并不保证靠近正确答案。这里的 NLL 衡量真实 token 的概率,不能等同于当前错误预测 token 的置信度。
五:结论——如何理解这项工作的价值?
LoopMDM 的实用贡献是一个非常小的架构改动:在 MDM 中将两个靠前的 Transformer 层反复执行,配合随机循环训练,就能在所测规模与固定总训练 FLOPs 下改善质量。它提示,除了增加参数和训练 token,还可以重新分配每个样本得到的计算深度。
最有启发性的机制观点是把未知 token 的隐藏表示当作计算空间。循环次数控制反复加工的深度,掩码位置提供并行交互的槽位,而输出层在这些计算之后才产生离散决策。数独、注意力和时间相关收益形成了一条相互支持的经验链条。
部署价值取决于训练预算与推理预算如何权衡:高循环次数提升质量,却增加单次网络调用成本;自适应停止回收部分成本。当前证据集中在 125M–170M 模型、手工选择的循环层和简单停止准则,尚未建立十亿级模型、长上下文与实际延迟上的扩展规律。数学实验的推理成本差异、理论例子的额外工作区,以及结果表中的口径差异,都应随结论保留。(Appendix E,PDF pp. 22–23)
值得继续讨论的三个问题是:
- 固定总推理 FLOPs 时,增加内部循环 $S$ 与增加外部去噪步数 $T$,怎样组合最好?
- 如果限制或关闭 mask-to-mask 注意力,循环收益减少多少,能否更直接确认工作区机制?
- 能否学习循环位置与停止规则,在保留收益的同时避免 Fig. 8 中的预测漂移?
论文支持的核心判断是:在这一规模的掩码扩散模型中,选择性共享循环是一种有效的训练计算分配方式;其实际推理收益需要与采样预算、循环上限和停止策略一起评估。