Delta Attention Residuals:中文精读笔记
作者: Cheng Luo、Zefan Cai、Junjie Hu。
论文: arXiv:2605.18855v1,2026-05-13 提交。
获取与研读日期: 2026-10-04。
材料: 原文 PDF · 英文汇报幻灯片 · 作者代码。本文页码均指从 1 开始的 PDF 页码。
论文总览
这篇论文研究 Transformer 的深度方向信息混合:一个子层在处理当前残差流时,能否再有选择地读取早期子层的贡献?作者提出 Delta Attention Residuals,把注意力加权得到的历史增量读出加到当前残差流上,再送进下一个 attention 或 MLP 子层。细粒度版本 Delta AttnRes 保存各子层输出;Delta Block 用分块表示降低读出成本。
实验中,细粒度版本在 220M、533M、1044M 三个配置取得最低验证困惑度;Delta Block 接近它的质量,显著降低开销。在从零训练的 7.57B 配置中,Delta Block 将验证 PPL 从 17.43 降到 16.00,相对下降 8.2%,吞吐从 21.4k 降到 14.0k token/s。Qwen3-0.6B 继续训练后,八项下游任务平均分为 55.6%,标准微调为 55.0%。(Sec. 3,Tables 1–5,PDF pp. 5–8)
理解贡献时有一个关键修正:原始 Attention Residuals 已经使用子层输出作路由源。 本文把它概括为“全历史累计隐藏状态”,与原始论文的公式不一致。因此,较可靠的贡献表述是:在本组实验中,保留残差流、额外加入深度注意力读出的设计改善了质量;不能把“首次将累计状态改为子层增量”作为已成立的创新判断。零初始化与分块实现也有实质细节,下面在对应机制处说明。
结构地图
| 原文章节 | 作用 | PDF 页码与主要证据 |
|---|---|---|
| 1 Introduction | 提出路由源冗余与增量路由动机 | pp. 1–2;Fig. 1 |
| 2.1 Preliminaries: Attention Residuals | 深度注意力的打分和加权 | p. 2;Eq. (1) |
| 2.2 The Source Redundancy Problem | 比较累计源和增量源 | pp. 2–3;Fig. 2 |
| 2.3 Delta Attention Residuals | 加性路由、残差流与伪代码 | pp. 3–4;Eq. (2)、Fig. 3 |
| 3.1 Experimental Setup | 模型、训练和对照 | pp. 4–5 |
| 3.2 From-Scratch Training Results | 三个自定义规模的质量和成本 | pp. 5–6;Table 1 |
| 3.3 Scaling From-Scratch Training | 标准 0.6B 架构及 7.57B 扩展 | pp. 6–7;Tables 2–3、Fig. 4 |
| 3.4 Ablation: Effect of Block Size | 分块数量的质量与成本取舍 | p. 7;Table 4 |
| 3.5 Fine-Tuning Pretrained Models into Delta Attention Residuals | 迁移预训练权重、下游任务和学习动态 | pp. 7–8;Table 5、Fig. 5 |
| 4.1 Routing Collapse: Why Cumulative States Fail | 最大路由权重随深度变化 | pp. 8–9 |
| 4.2 Why Additive Routing Preserves Information | 用残差保留解释实验差异 | p. 9 |
| 4.3 Learned Routing Patterns | 查看具体深度路由矩阵 | p. 9;Fig. 6 |
| 5 Conclusion | 汇总结果 | p. 10 |
| A Related Work | 跨层连接、残差分析、差分与路由背景 | p. 12 |
| B Comparison with Original Attention Residuals | 实现对照与 reset 操作 | pp. 12–13;Table 6、Fig. 7 |
| C Delta Block: Block-Level Variant | 分块增量与成本解释 | pp. 13–14;Eq. (3)、Fig. 8 |
一:动机——跨层注意力究竟在选择什么?
1. 标准残差把历史贡献压在同一条流中
以单个 token 为例,标准 Pre-Norm 子层可写成
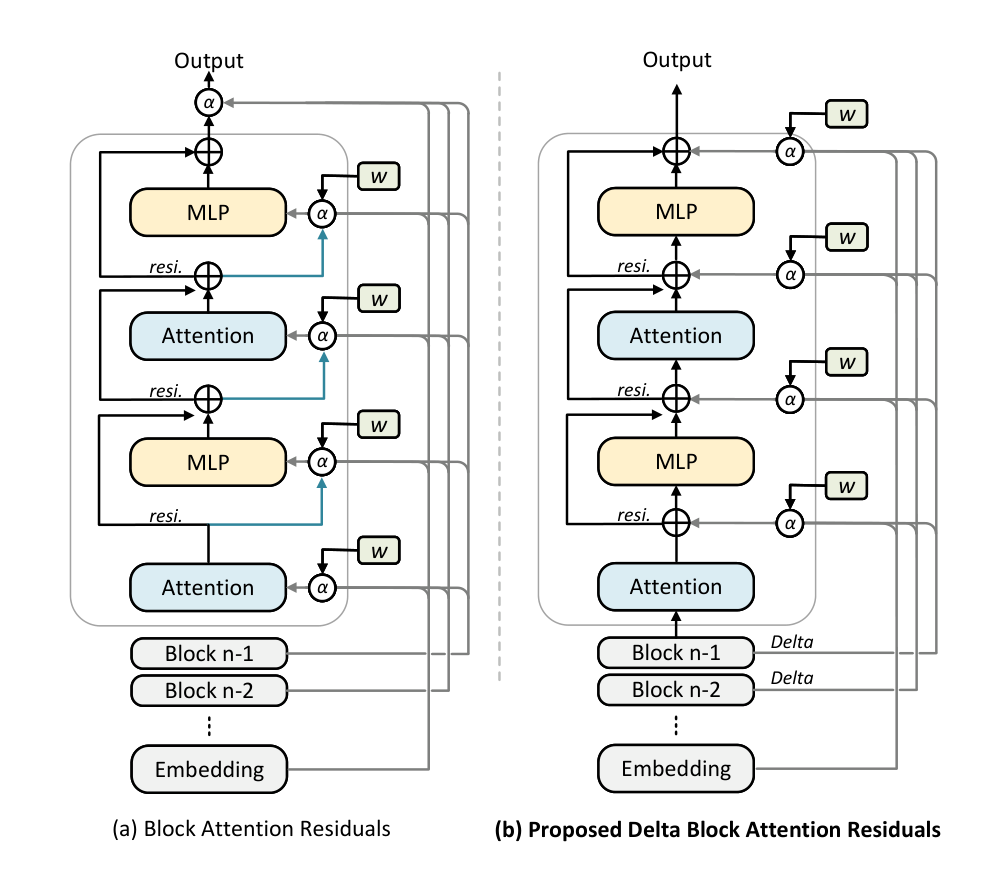
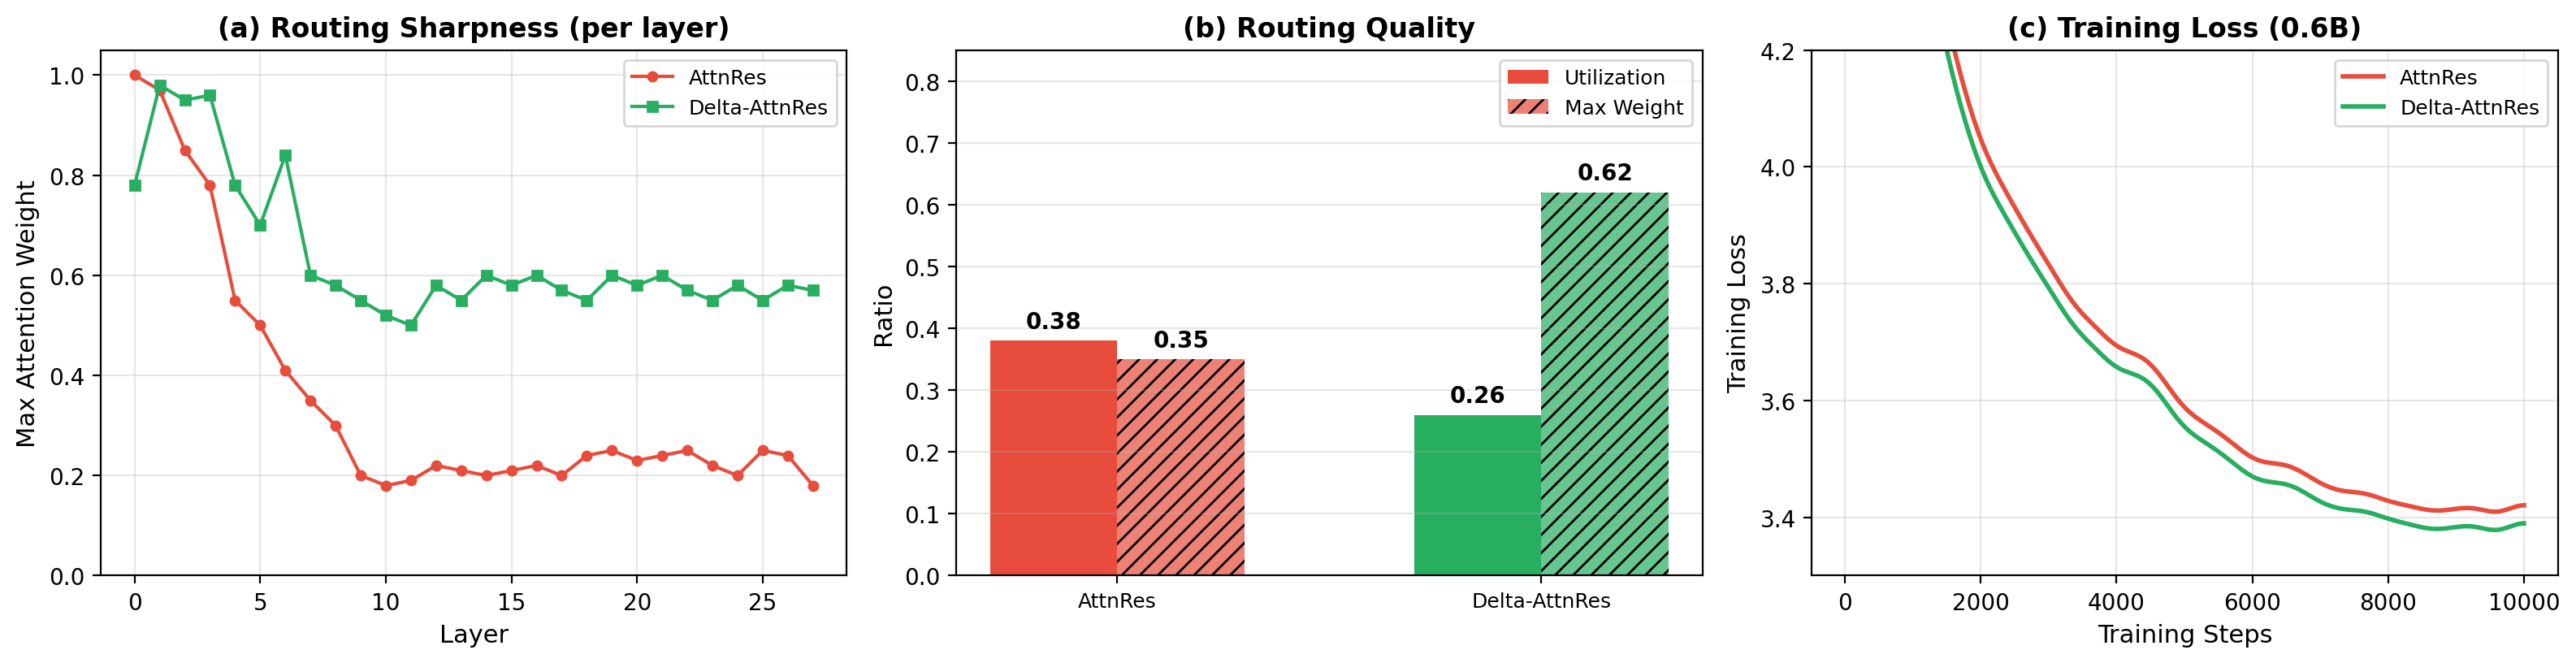
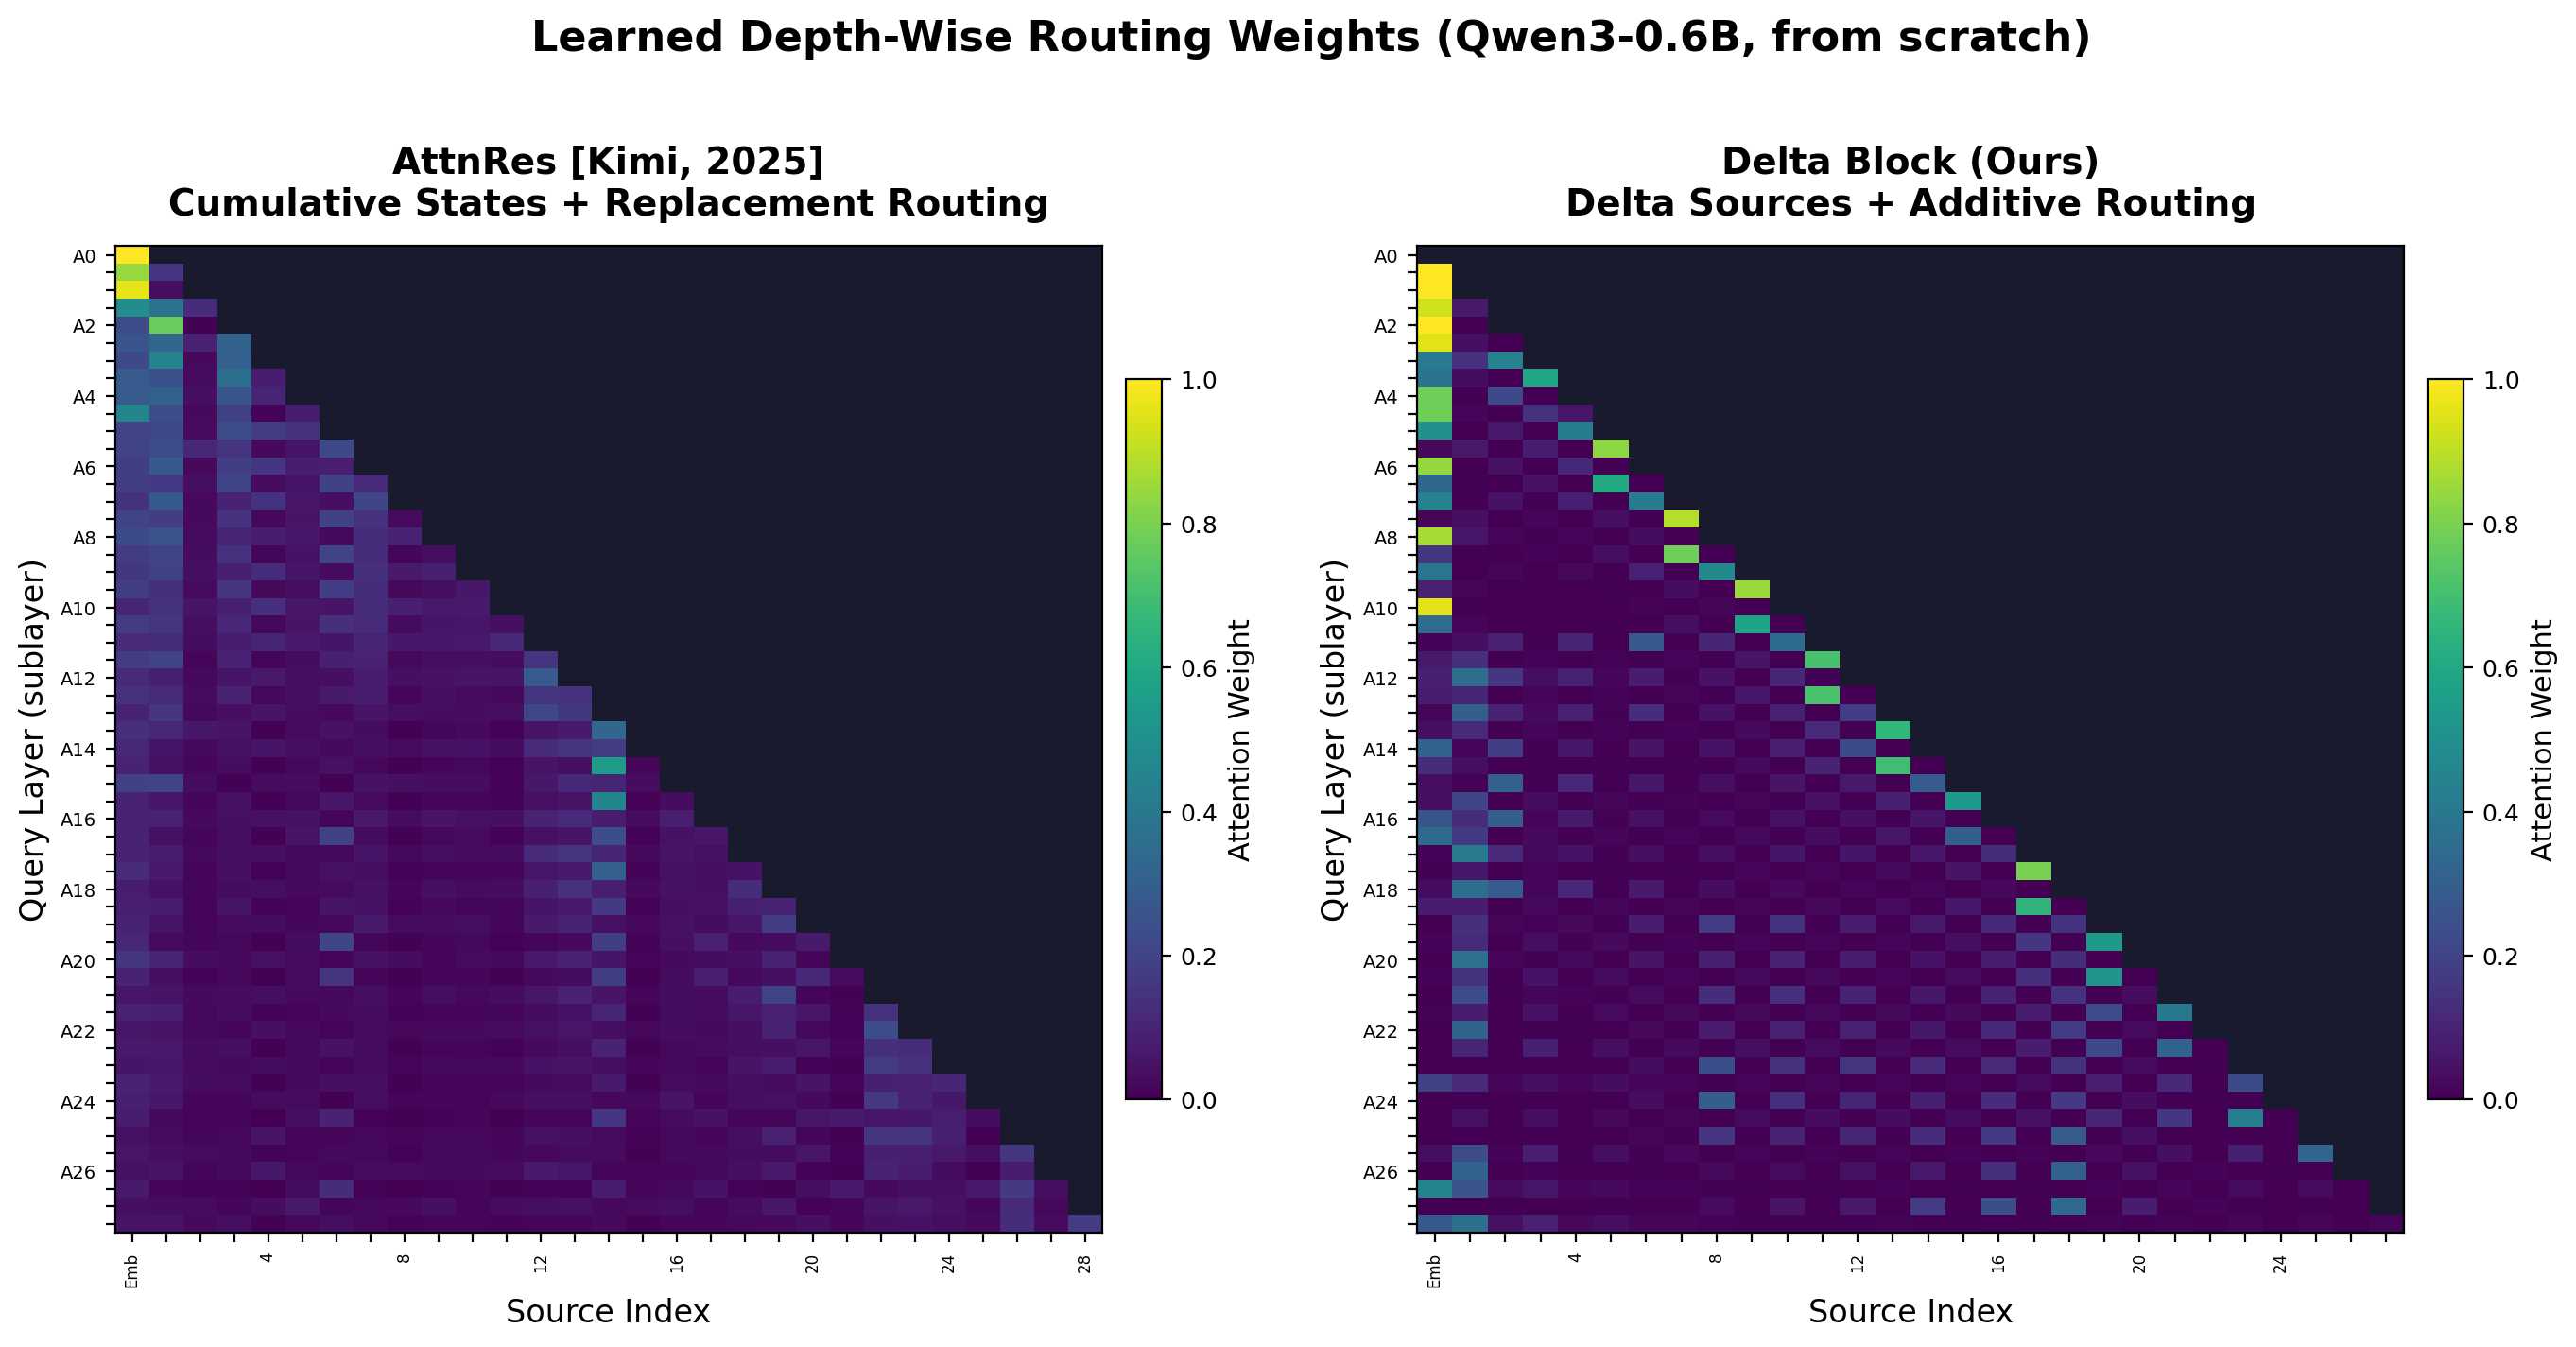
其中 $f_i$ 包含该子层的归一化和 attention/MLP 变换。展开后,$\mathbf h_l=\mathbf h_0+\sum_{i 作者希望提供这样的接口。其直觉是:若候选源都是包含大量共同前缀的累计状态,RMSNorm 后的方向可能相近,深度注意力就难以区分它们。相比之下,不同子层的输出可能更有差异,便于选择。这是对表示几何的动机,不是由“它们是差分”自动推出的正交性或多样性定理。(Sec. 2.1–2.2,PDF pp. 2–3) 原始 Attention Residuals,2603.15031v1 的 Sec. 3.1、Eq. (3)(PDF p. 4)明确令 key/value 等于 embedding 或子层输出 $f_i(\mathbf h_i)$;其 Block 版本 Eq. (5) 保存的是块内子层输出之和。它们并非都形如 $\mathbf h_0+\sum_{j\le i}\mathbf v_j$ 的全历史前缀。本文附录 B 的伪代码也会先保存完成的块,再清空当前块累加器,因此 reset 不等于删除已保存历史。 这改变了动机的解释范围:本文的实验可以比较特定 Qwen 实现中的读出方式与训练行为,但不能仅凭“累计前缀冗余”解释原始 AttnRes 的全部行为。加性读出与替代式读出、残差路径、源构造、初始化都可能影响结果,后文实验没有把这些因素逐一分离。(本文 Sec. 3.1、Appendix B,PDF pp. 5、12–13;原始 AttnRes Sec. 3.1–3.2,PDF p. 4) 给定源 $\mathbf s_i$,本文 Eq. (1) 的打分为 这里 $\mathcal S_l$ 是当前已经可用的历史源集合。查询是每个接收子层自己的参数,不由当前 token 通过一个 $W_Q$ 投影生成;但源依赖输入,因此路由权重仍随 token 改变。源堆叠后为 $[N,\text{batch},T,d]$,softmax 沿 $N$ 个深度源进行,各序列位置分别计算。 RMSNorm 用于构造打分 key,加权求和仍使用未归一化的源作为 value。它减少源范数对打分的直接影响,但保留 value 的幅度信息。这里的深度读出没有替换模型原有的因果序列 attention。(Eq. (1)、Fig. 3,PDF pp. 2、4) Delta AttnRes 的核心是 Eq. (2): 结合 Fig. 3,完整的数据流应理解为 也就是说,历史读出先改变当前子层的工作输入;子层算出新贡献后,再加回原残差流。不要把更新误写为 $\tilde{\mathbf h}_{l+1}=\hat{\mathbf h}_l+\mathbf v_l$,那会把历史读出直接重复写入残差流,与图中伪代码不同。 attention 和 MLP 各有自己的查询与路由归一化。细粒度版本在 attention 结束后追加 attention 输出,在 MLP 结束后追加 MLP 输出,下一子层即可访问这些源。训练与推理使用同样的路由计算;训练额外学习查询、归一化参数及骨干参数。(Sec. 2.3,PDF pp. 3–4) 教学解释: 若已有 $\mathbf v_1=(2,0)$、$\mathbf v_2=(0,1)$,权重为 $(0.8,0.2)$,读出就是 $(1.6,0.2)$。模型保留原残差流,同时让下一个子层更强地感知第一个贡献。softmax 对向量做凸组合,不能任意设定负的选择系数,但向量自身可包含正负分量。 理想的分块定义是将连续子层贡献相加。为避免原文把 $B$ 同时当“块数”和“块宽”,令 $\tau_b$ 表示块边界的子层索引: 然后以 $\Delta_b$ 为源计算加性读出。按原文设想,可另保留 embedding 和当前未完成块。细粒度源的规模为 $O(2L)$,块级源为 $O(K)$,其中 $K\approx L/S$。Table 4 把 $B$ 用作块数,给出 $B+1$ 个源;Appendix C 的 Eq. (3) 又把 $B$ 用作块宽。因此,解释实验时应以表中的实际 Sources 列为准。(Sec. 3.4、Appendix C,PDF pp. 7、13–14) 原图 Fig. 8,PDF p. 14。左侧展示块间替代式读出,右侧展示在保留残差流的基础上注入块级读出;从下往上读,横向分支是可再次访问的深度源。图是作者提出的架构示意。 分块减少可单独选择的贡献数量。保留残差流不意味着块内每个子层仍可独立访问:细粒度版本可以逐个选取,Delta Block 只能选取聚合后的块。因此原文“每个子层贡献都单独可访问”的论点应限于细粒度版本。 原文 Fig. 3 在添加源时计算 作者公开代码固定到提交 原文 Sec. 2.3 声称:查询零初始化使权重均匀,因此路由退化为恒等映射。但直接代入公式,对 $N$ 个非空历史源有 这个附加项一般不为零。再加入一个零向量 null source 后,它只变成 $\frac1{N+1}\sum_i\mathbf v_i$,也不会自动消失。null source 提供了一个“可以选择不读”的选项,但均匀 softmax 不会把全部权重放到它上面。“加权平均有界”也不保证其相对当前残差流足够小。(PDF p. 4 的 Safe initialization、p. 8 的 Initialization matters) 这里有一个值得保留的细节:若源集合恰好完整分解当前残差流,即包括 embedding 且 $\sum_i\mathbf v_i=\tilde{\mathbf h}_l$,均匀读出会令 $\hat{\mathbf h}_l=c\tilde{\mathbf h}_l$,$c>0$。忽略 $\epsilon$ 时 RMSNorm 对正比例缩放不变,后续子层因而可能保持同样输出。这是依赖源覆盖与归一化的条件性解释,不是 本次分析的可验证改法: 在读出前乘一个初值为零的标量门 $g_l$,$\hat{\mathbf h}_l=\tilde{\mathbf h}_l+g_l\mathbf r_l$,即可在初始化时严格保留输入。它是一个机制建议,不是论文主实验已经验证的改动。作者仓库存在可选门控分支,但不能据此把它当成 Table 5 的实际设置。 若每个 attention/MLP 的路由器包含一个长度 $d$ 的查询和一个长度 $d$ 的 RMSNorm 权重,两者合计约 $4Ld$ 参数。取 $L=36,d=4096$,得到 589,824,符合原文报告的 589.8K、约占 7.57B 的 0.008%。 额外成本主要来自跨深度源的保留、读取、归一化和加权。按每层最多 $N$ 个源粗略计,路由算术规模为 $O(LN\,\text{batch}\,T d)$,源缓冲规模为 $O(N\,\text{batch}\,T d)$;细粒度版本令 $N=O(L)$。这是理解额外开销的量级分析,不是总模型显存公式。论文报告的是训练吞吐与训练峰值显存,不能直接当作解码吞吐或 KV cache 节省。(Sec. 3.2–3.3,PDF pp. 6–7) 全部使用 Qwen3 架构和 FineWeb-Edu,从随机初始化训练 10K 步;优化器 AdamW,$\beta=(0.9,0.95)$,weight decay 0.1,500 步 warmup 后 cosine 衰减。硬件为 8 张 H100 80GB,BF16 与 token 数是按“步数 × 有效 batch × 序列长度”推算的输入量,不是作者额外报告的数据量。7.57B 使用 FSDP 和梯度检查点。这里的“8B 实验”是从零训练一个 8B 规模架构,不是继续训练官方 Qwen3-8B 权重,也不是完成常规大模型预训练预算。 同规模各方法匹配数据、步数和超参数,没有匹配墙钟时间或总计算成本。不同规模的 token 预算与上下文不同,所以这些点不构成单一控制条件下的严格 scaling law。 验证 loss 和 PPL 越低越好,PPL 约等于 $\exp(\text{平均 token NLL})$。Tok/s 为所有 GPU 的总吞吐,越高越好;Mem 为单卡训练峰值已分配显存。Table 1 的显存条件是每卡 batch 4、长度 1024;Table 3 的 8B 条件包含梯度检查点,显存数字不宜脱离这些设置横向外推。 微调使用官方 Qwen3-0.6B 权重,在 FineWeb-Edu 继续训练 20K 步,有效 batch 32、4 张 H100、500 步 warmup。Delta Block 加 null source,骨干学习率 $5\times10^{-5}$,路由参数 $5\times10^{-3}$;Baseline FT 和 AttnRes 统一用 $5\times10^{-5}$。因此该结果比较的是架构与相应优化配置的组合;未单独消融 100 倍路由学习率与 null source。这里引用 LoRA 是说明分组学习率思路,论文并未将这项实验定义为 LoRA 微调。(Sec. 3.5,PDF p. 8) 下游使用 lm-evaluation-harness 的 0-shot 测试,八项任务覆盖常识补全、科学问答、物理常识、指代消解、是非问答、学科知识和末词预测。表中的 Avg 是这八个所报百分比分数的等权算术平均。 以下是 Table 1 的验证 PPL,均越低越好。(PDF p. 5) 细粒度 Delta AttnRes 相对 Baseline 的 PPL 降幅依次是 4.86%、2.97%、1.92%;Delta Block 是 4.21%、2.63%、1.72%。三个配置内,Delta 方法均改善,而作者的 AttnRes 复现在 1044M 退化。原文说收益“随深度扩大”,但这三个相对降幅实际上缩小;规模扩展结果应按表理解。 1044M 的成本更能说明取舍: Delta Block 比细粒度版本只高 0.06 PPL,约 0.21%,却有 2.53 倍吞吐、约 36.6% 的显存占用。相对 Baseline,它的吞吐低 20.4%、显存高 26.2%;同 token 预算对应约 25.6% 更长的稳态训练时间。细粒度版本显存约为 Baseline 的 3.45 倍,吞吐低 68.5%。原文将 0.06 PPL 的差距写作“小于 0.2%”,按展示值计算略高于该阈值。(Table 1,Sec. 3.2,PDF pp. 5–6) 来源:Tables 2–3,PDF p. 6。0.6B 标准架构上的 PPL 改善为 2.39%,说明质量收益不限于三个自定义配置。但 $N=28$ 的分块很细,Delta Block 显存比 Baseline 高约 82.6%,不能把“分块”一概等同于很低成本。 7.57B 上,Delta Block 相对 Baseline 的 PPL 改善为 8.20%,相对作者的 AttnRes 复现改善 13.89%。吞吐比 Baseline 低 34.6%,显存高 2.6%;同 token 预算下稳态时间约为 1.53 倍。它比 AttnRes 快 12.0%,但并未超过普通残差的吞吐。7.57B 没有报告两个细粒度版本,不能声称它们也已在该规模完成验证。(Sec. 3.3,PDF pp. 6–7;Checklist limitations,p. 15) Table 4 中 $B$ 表示块数,下表沿用此表的口径。(PDF p. 7) 220M 在 $B=4$–6 附近取得较好的分块结果,进一步细分到 12 块反而退化。533M 的块级 PPL 仅在 31.18–31.27 间变化,增加源数的质量收益很小;显存总体上随源数增加。 这组实验与 Table 1 的同名配置数值不同:例如 220M 的 Delta Block 在 Table 1 为 37.08 PPL / 306k / 5.9GB,Table 4 的 $B=4$ 为 36.98 / 343k / 9.1GB。作者公开运行索引把它们列为不同运行,但论文没有充分说明这些成本差异的具体测量条件。因此这里分别解读各表,不把两表拼成一条精确的性能曲线。Table 4 的吞吐也并非随源数单调变化,不能把偶然的速度排序当作结构复杂度规律。 Table 5,PDF p. 8。数值为原文所报 0-shot 百分比分数;最后一列是 Delta Block 减 Baseline FT 的百分点差。 相对未经该轮继续训练的 checkpoint,Delta Block 八项均提高;相对真正有训练预算匹配意义的 Baseline FT,则是 3 胜、1 平、4 负。ARC-Easy 的 5.0 点提升单独贡献平均值中的 0.625 点,其余七项合计稍有下降。因此这里观察到的是由特定任务推动的小幅平均优势。论文明确是单次训练结果,没有误差条;0.6 点差异应按这一证据强度理解。(Checklist statistical significance,PDF pp. 17–18) 原图 Fig. 5,PDF p. 8。左图横轴为层号,纵轴为最大路由权重;中图的斜线柱给出其平均值,Delta Block 为 0.87、AttnRes 为 0.49;右图为 20K 步内的验证 loss。右图显示 Delta Block 在早期较低,两者后期接近,最终蓝线还略低。它没有画出 Baseline FT 曲线,纵轴范围约 2.66–2.80,也没有显示正文描述的 3.96 初始尖峰。因此“2.8→3.96”应标为正文叙述,不能说已被这张图展示或由它证明严格无扰动初始化。 原图在 PDF p. 2 为 Fig. 1,在 p. 6 重复为 Fig. 4。图内绿色图例写作 Delta-AttnRes,正文与图注将该配置称为 Delta Block,$N=L=28$;这里按正文和 Table 2 解释。 左图显示随着层数增加,红线最大权重降至约 0.2,绿线在深层保持约 0.55–0.60;中间斜线柱的跨层平均最大权重为 0.35 与 0.62,后者约为前者的 1.77 倍;右图中绿色训练 loss 较低。中图另有 Utilization 柱,但正文未充分定义其统计方式,因此不把它当作可直接比较的额外质量指标。 最大权重更高表示选择更集中,却不能单凭最大值 0.2 认定“接近均匀”。若有约 28 个候选,严格均匀的最大权重约为 $1/28=0.036$,0.2 仍高出很多。跨深度候选数还在增加,最好同时查看归一化熵或相对均匀分布的差异。图中第一层若只有一个候选,最大权重为 1 也不代表学出了特殊选择能力。这些是对作者 routing collapse 解释的具体修正。(Sec. 4.1,PDF pp. 8–9) 原图 Fig. 6,PDF p. 9。横轴为源索引,纵轴为接收 attention/MLP 子层,颜色条为 0–1 权重;上三角为空是尚不可访问的未来深度。右图存在更亮的局部峰值和 embedding 列,支持选择更集中的观察。两图色标范围相同,能够比较局部集中程度;但热点与更低 PPL 同时出现,不能单独确定究竟是源表示、加性通路还是优化差异产生了改善。 这篇论文最有用的设计是为自然残差流增加一个按 token 选择历史贡献的读出接口。Delta AttnRes 给出最细的选择粒度,Delta Block 则显示了明显更好的训练成本取舍:1044M 上仅牺牲约 0.21% PPL,相对细粒度版本获得 2.53 倍吞吐。7.57B 的 8.2% PPL 改善是值得进一步验证的结果,但来自约 1.31B token、固定训练步数的实验,并伴随约 1.53 倍稳态训练时间。 机制判断要与实验成绩分开:原始 AttnRes 已使用子层或块内输出,零查询也不一般性地使加性路由成为恒等映射,公开 Delta Block 的源构造与边界差分公式存在差异。它们影响的是创新定位、因果解释和复现定义,而不是可以通过阅读直接否定或重新确认的训练数值。 若沿此方向开展实验,最优先的工作是固定源集合定义,核对每个块源是否等于相邻边界之差,再做“相同源、加性/替代式读出”的对照;微调则测量 step 0 的 logits 差异,并对齐路由学习率和门控设置。对于实际选型,应补充同墙钟预算的 PPL 比较;这些实验能直接回答额外深度读出究竟带来了多少独立收益。2. 必须区分本文的 baseline 描述与原始 AttnRes
二:方法——保留残差流,再读一次历史增量
1. 符号与深度注意力
符号 含义 $L$ 本文中的 Transformer 层数,每层含 attention 和 MLP 两个子层 $d$ 隐藏维度 $\tilde{\mathbf h}_l$ 当前自然累加的残差流,单 token 形状为 $d$ $\mathbf v_i$ 第 $i$ 个子层的输出,也等于残差流在该子层的变化 $\mathbf w_l\in\mathbb R^d$ 接收子层的可学习查询向量 $\alpha_{i\to l}$ 接收子层 $l$ 对历史源 $i$ 的权重 $K$、$S$ 下文为避免原文混用而引入:块数、每块 Transformer 层数,约有 $KS=L$ 2. 加性路由改变子层输入,残差更新仍用原来的流
3. Delta Block 的预期数学含义
4. 分块公式与公开实现没有完全对齐
hidden_states - deltas[-1]。若 deltas[-1] 已经是一个增量,它就不是上一个块边界的隐藏状态,通常不能得到上式的块差分。一个标量教学例子是边界状态依次为 1、3、6:保存 embedding 1 后,第一个增量为 $3-1=2$;再减“最后一个增量”会得到 $6-2=4$,正确的相邻边界差分是 $6-3=3$。fc11c3e 后,delta_block 分支也使用 partial_block - blocks[-1];按 block_start_partial 计算真正边界差分的另一段逻辑被注释。该分支读出已保存源时也没有按 Appendix C 的文字显式加入当前 partial delta。这说明论文中的理想块公式与已公开计算路径存在差异,复现实验必须先明确采用哪一种定义。当前仓库不能独自证明论文各历史训练运行使用的精确代码状态。(Fig. 3、Eq. (3),PDF pp. 4、13;固定版本实现,L559–610、被注释的边界累加,L1104)5. 零查询、零源与“恒等初始化”
depth_route 本身恒等;上述分块实现差异也使这一条件不能直接套用。6. 参数少,运行成本仍可能高
三:实验——比较什么、预算如何对齐?
1. 从零训练协议
torch.compile。(Sec. 3.1,PDF pp. 4–5)配置 $d$ / $L$ 有效 batch / 序列长度 学习率 10K 步名义 token 数 220M 768 / 12 32 / 1024 $6\times10^{-4}$ 0.328B 533M 1024 / 24 32 / 1024 $6\times10^{-4}$ 0.328B 1044M 1280 / 36 32 / 1024 $6\times10^{-4}$ 0.328B Qwen3-0.6B 架构,文中计 508M 1024 / 28 64 / 2048 $6\times10^{-4}$ 1.311B Qwen3-8B 架构,7.57B 4096 / 36 64 / 2048 $3\times10^{-4}$ 1.311B 2. 五类对照与指标
方法 在本论文实验中的角色 Baseline 普通加性残差 AttnRes 作者复现的块级替代式深度注意力 Full AttnRes 作者称为 $N=L$ 的更细粒度复现;其命名和原始 Full 的子层口径需区分 Delta AttnRes 保存 attention/MLP 输出,额外加性读出 Delta Block 更少的分块源,额外加性读出 3. 预训练权重迁移协议
四:结果——质量、成本与机制证据
1. 三个自定义规模:细粒度质量最好,分块更实用
方法 220M 533M 1044M Baseline 38.71 32.00 29.70 AttnRes 37.39 31.75 31.76 Full AttnRes 37.30 31.68 33.36 Delta Block 37.08 31.16 29.19 Delta AttnRes 36.83 31.05 29.13 方法 PPL ↓ 吞吐,k token/s ↑ 单卡峰值显存,GB Baseline 29.70 108 22.5 AttnRes 31.76 71 31.6 Full AttnRes 33.36 49 52.0 Delta Block 29.19 86 28.4 Delta AttnRes 29.13 34 77.7 2. 标准架构与 7.57B:更好的 PPL 伴随吞吐成本
配置 方法 PPL ↓ 吞吐,k token/s ↑ Mem,GB Qwen3-0.6B 架构 Baseline 32.22 173 13.8 同上,$N=28$ AttnRes 32.38 111 28.4 同上,$N=28$ Delta Block 31.45 117 25.2 7.57B Baseline 17.43 21.4 41.6 7.57B AttnRes 18.58 12.5 44.0 7.57B Delta Block 16.00 14.0 42.7 3. 块数消融:源越多并不总是更好
规模 $B$ / 源数 PPL ↓ 吞吐,k token/s ↑ Mem,GB 220M 1 / 2 37.44 396 8.7 220M 2 / 3 37.08 318 8.8 220M 4 / 5 36.98 343 9.1 220M 6 / 7 36.92 315 9.3 220M 12 / 13 37.34 318 10.2 220M 细粒度 / 25 36.75 212 12.4 533M 2 / 3 31.23 217 14.7 533M 4 / 5 31.27 160 15.4 533M 6 / 7 31.19 194 16.1 533M 12 / 13 31.22 171 18.3 533M 24 / 25 31.18 137 23.5 533M 细粒度 / 49 31.05 80 33.6 4. 微调:平均分增加 0.6 个百分点,主要由 ARC-Easy 推动
任务 Pretrained Baseline FT AttnRes Delta Block 相对 Baseline FT HellaSwag 47.3 50.1 49.4 50.0 −0.1 ARC-Easy 56.2 61.5 60.2 66.5 +5.0 ARC-Challenge 33.9 36.7 35.3 37.3 +0.6 PIQA 67.4 69.2 68.8 69.4 +0.2 WinoGrande 55.9 57.0 57.9 56.7 −0.3 BoolQ 63.8 70.3 70.3 70.3 0.0 MMLU 40.3 45.2 42.5 44.8 −0.4 LAMBADA 40.0 50.0 48.4 49.8 −0.2 等权平均 50.6 55.0 54.1 55.6 +0.6 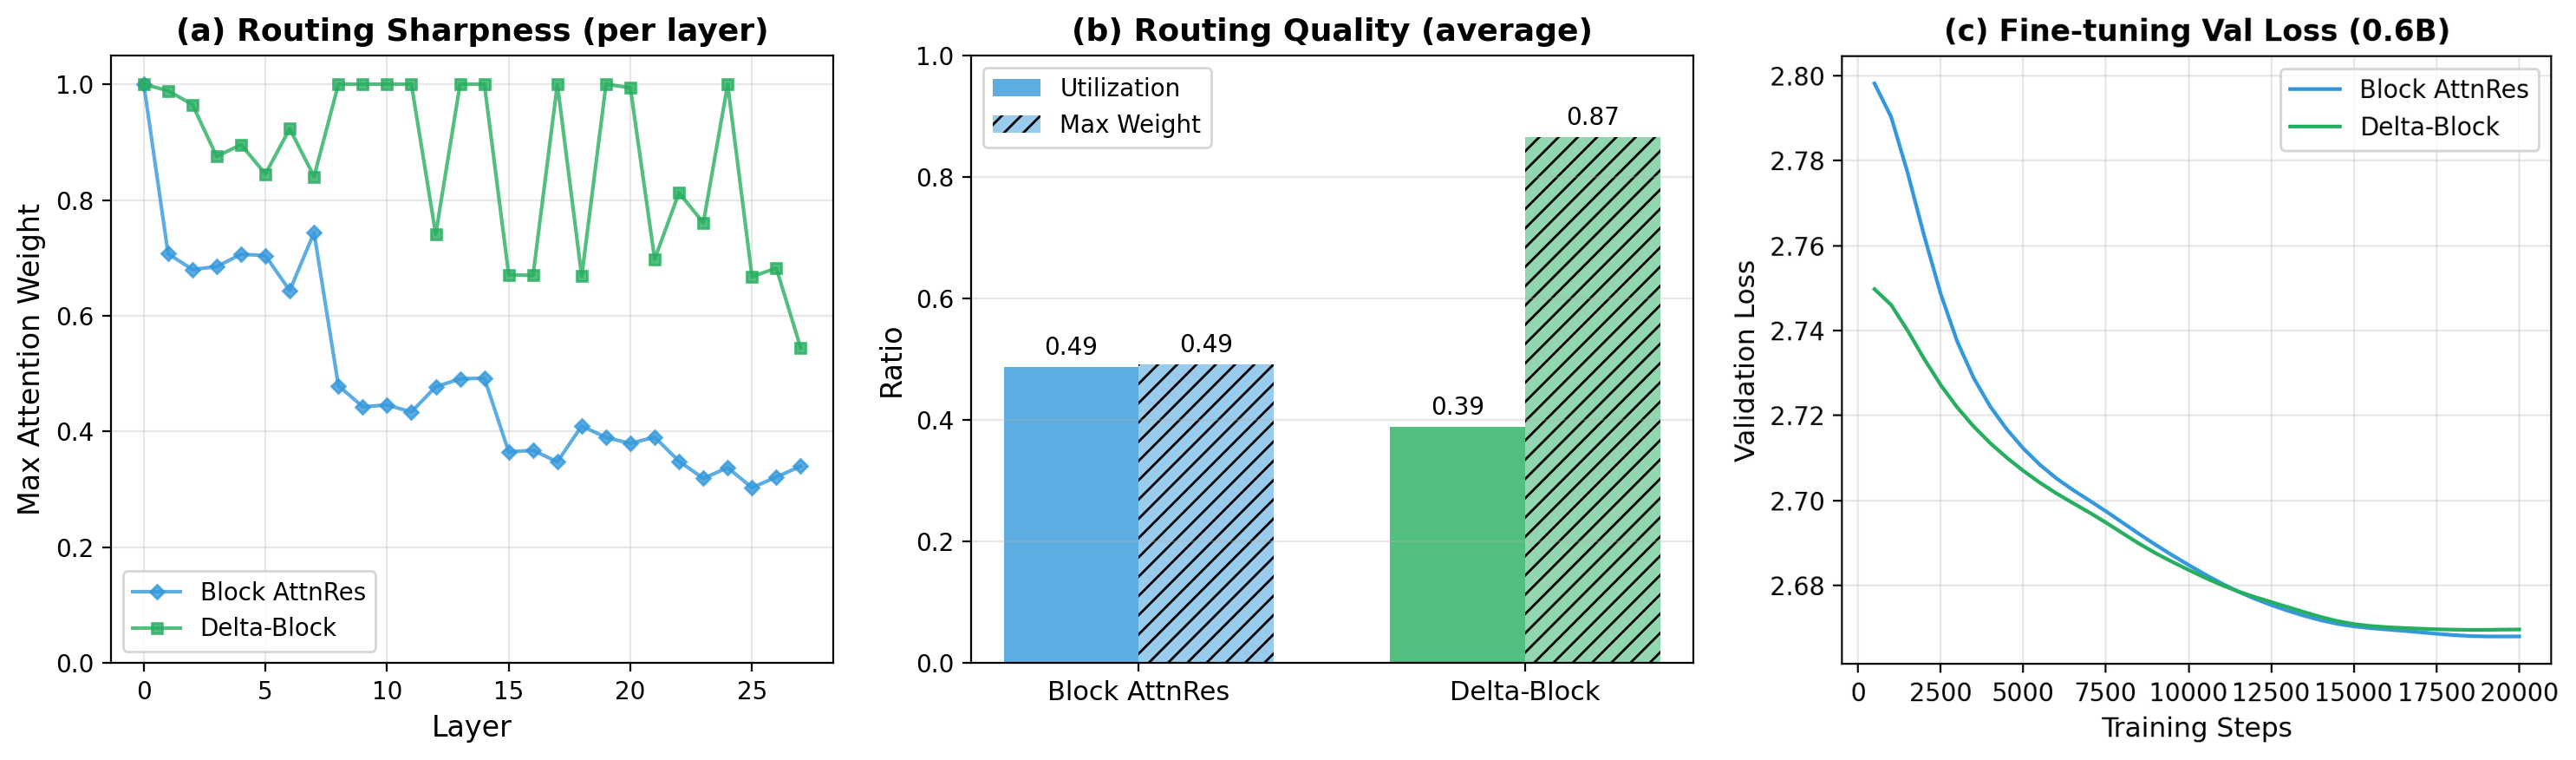
5. 路由机制:分布更集中,但“塌缩”的判据需要更精确
五:结论——值得保留的设计与下一步验证