Attention Sinks and Outliers in Attention Residuals:中文研读笔记
方法:OASIS · arXiv:2605.17887v2 · 论文修订日期:2026-09-24 · 研读日期:2026-10-07。
作者:Haozheng Luo、Haoran Dai、Ching-Yuen Huang、Shaoyang Zhang、Xi Chen、Eric Hanchen Jiang、Yijiang Li、Chenghao Qiu、Chenwei Xu、Zhenyu Pan、Haotian Zhang、Binghui Wang、Yan Chen(按 PDF 署名)。
arXiv 页面 · 本地原文 PDF · 作者代码链接 · 英文汇报 PDF · 可编辑 TeX。以下页码均为从 1 开始的 PDF 页码。
论文总览
Attention Residuals(下文沿用论文写法 AttnResidual)通过注意力学习如何混合不同深度的分支输出。它同时具有 token 维度和深度维度的 Softmax:前者必须把全部概率分给真实 token,后者必须把全部概率分给真实分支。当某一步实际上只需很小的贡献时,这两个约束可能迫使网络寻找“代替不做事”的 token 或分支。
本文先提出 AoS(Activation-only Outlier Suppression):把两个 Softmax 都改成带零值空状态的 $\mathrm{Softmax}_1$,允许部分概率不贡献任何向量。OASIS 在此基础上加入跨层面的反馈:一个分支中各注意力头的平均空概率越高,就相对降低它的深度路由 logit。方法修改路由计算,沿用原训练目标,并通过继续预训练适配。
最有辨识度的实验证据是 Qwen3-0.6B 的组件消融:W4A4 GSM8K 从标准 AttnResidual 的 45.67%,依次提高到仅 token 空路由的 52.36%、双空路由 AoS 的 54.21%,再到带耦合 OASIS 的 58.88%。因此,耦合本身在 AoS 上贡献 4.67 个百分点。(§6.2,p.8;Table 8,p.24)
需要同时抓住两个边界。第一,理论揭示的是特定向量分离条件下的路由集中机制;激活异常值与量化收益主要由实验支撑。第二,12K 长上下文实验中 OASIS 显著修复了改造 AttnResidual 后的性能损失,但仍未达到原始骨干的全部分数。(§5,pp.5–7;Table 3,p.10)
结构地图
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 双归一化问题与 OASIS 主线 | pp.1–2;Fig.1 |
| 2 Related Work | 异常值、门控、空状态背景 | p.2 |
| 3 Failure Modes of Dual Normalization in AttnResidual | sink 与异常值的现象证据 | p.3;Figs.2–3 |
| 4.1 Notation / 4.2 Activation-Only Outlier Suppression | 深度混合与双空路由 | p.4;Eqs.(4.1)–(4.2) |
| 4.3 Token-to-Depth Null Coupling | 统计空概率、中心化、修正 logit | pp.4–5 |
| 5 Theoretical Analysis | 条件集中界与空状态衰减界 | pp.5–7 |
| 6.1 Outlier Efficiency of AoS | 两级空路由及 clipping/gating 组合 | pp.7–8;Table 1 |
| 6.2 Component Ablation of Null Routing and Token-to-Depth Coupling | 三个组件各自贡献 | p.8;Table 8 在 p.24 |
| 6.3 Outlier Efficiency of OASIS | 量化 PPL 与 GSM8K | p.9;Table 2 在 p.8 |
| 6.4 Improvement in Attention Sinks | 注意力图与 12K 长上下文 | pp.9–10;Fig.4、Table 3 |
| 6.5 Ablation Studies | Pile、知识与数学任务泛化 | p.10;Table 4 |
| 7 Discussion and Conclusion | 贡献归纳 | p.10 |
| C Proofs / D Assumptions | 证明细节与几何条件 | pp.17–22 |
| E Implementation / F Limitations | 继续预训练、耦合参数与限制 | pp.22–23 |
| G Additional Numerical Experiments | CPT 对照、稀疏归一化、全局 sink | pp.23–24;Tables 5–8 |
一:动机——为什么跨深度注意力也需要“空选项”
1.1 双重概率预算的约束
标准 token 注意力输出为 $A=\sum_jp_jv_j$,其中 $p_j\geq0$、$\sum_jp_j=1$。这意味着输出位于真实 value 的凸包内。如果所有非空候选在某个方向上都显著偏离零,想让 $A$ 很小,就需要把概率集中到接近零的候选上。早期 token 因为对后续所有位置都可见,容易承担这种固定接收概率的角色,形成注意力汇(attention sink)。
AttnResidual 又把多个历史分支的输出做一次凸组合。于是相同的约束在深度方向再出现一遍:即使所有变换分支都没有必要贡献很多,深度 Softmax 仍要把完整的概率预算分给某个真实来源。作者把它称为双归一化(dual normalization)。这里“双”指两个路由概率归一化,不是 LayerNorm 和 RMSNorm。
1.2 观察到了什么
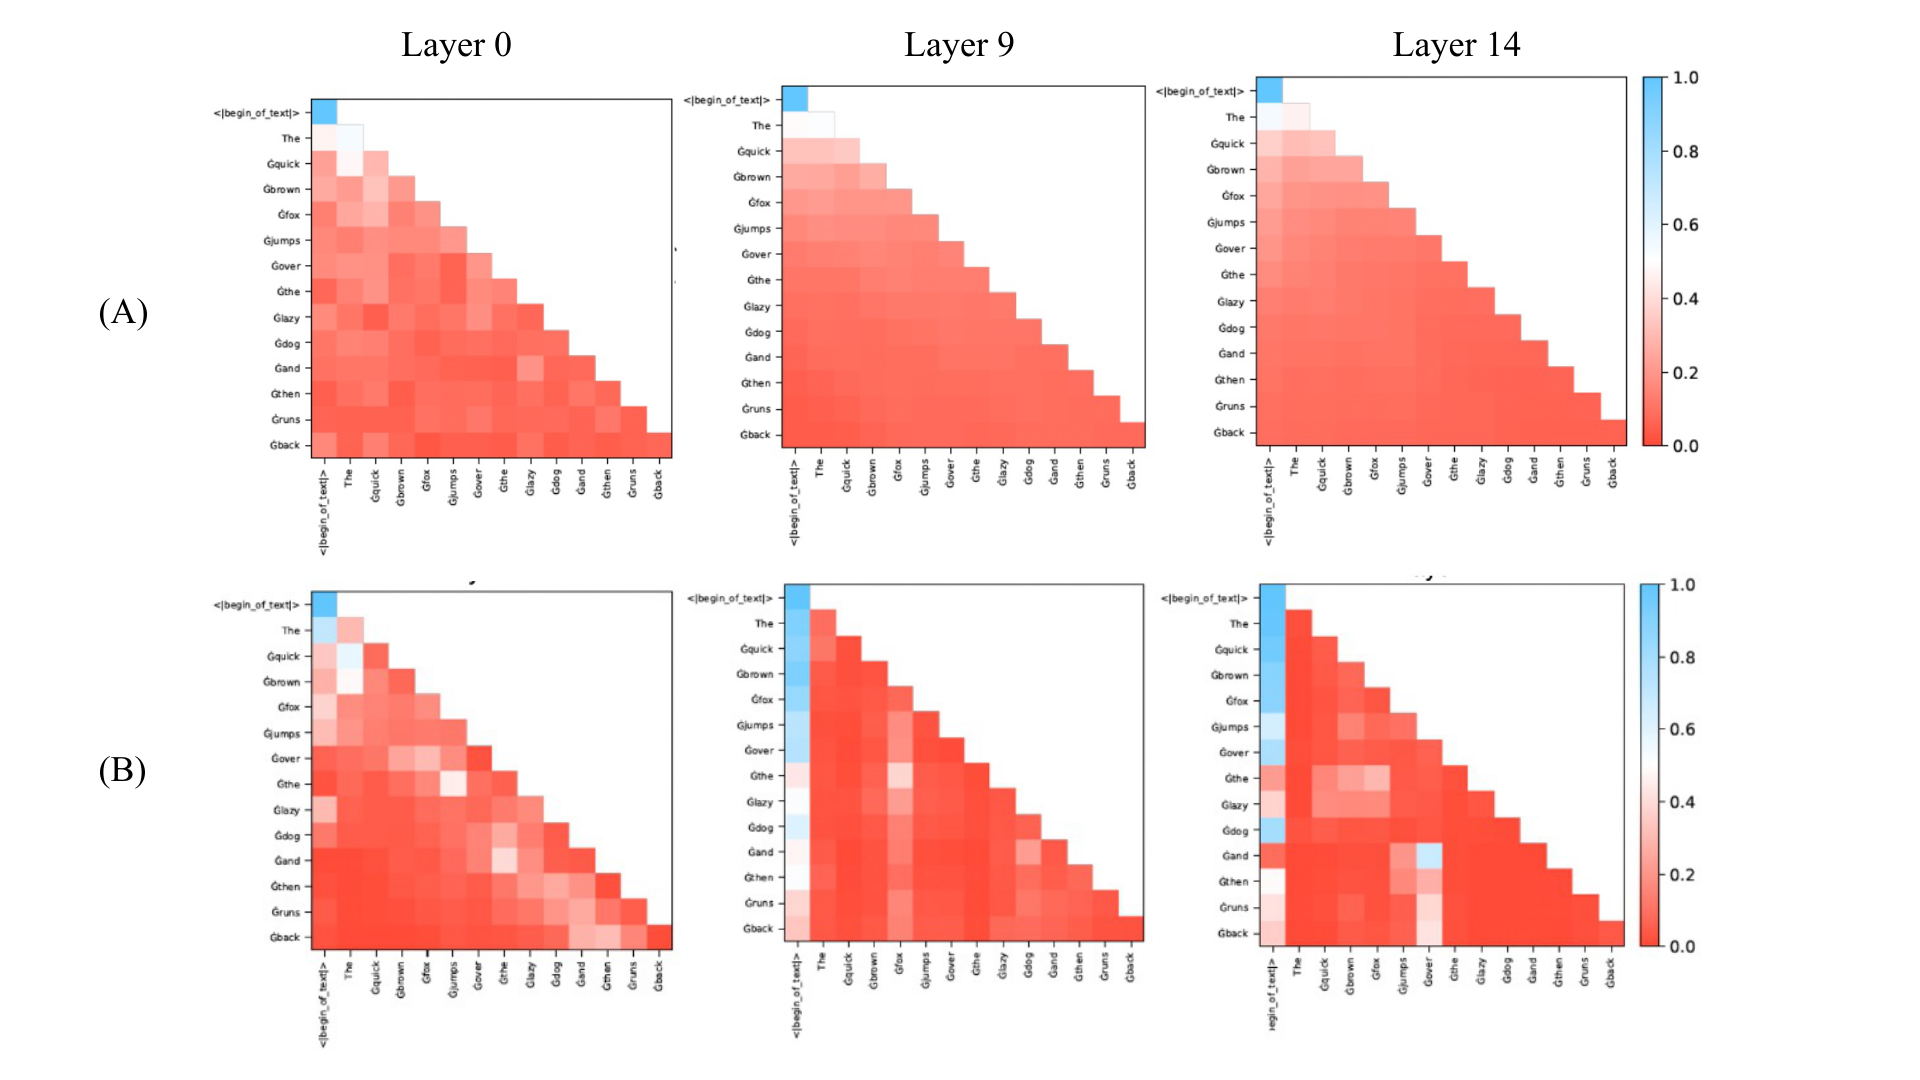
来源:Fig.2,p.3。横轴为被关注的 key token,纵轴为 query token;每列对应 layer 0、9、14,上下两行分别为原始 Transformer 和 AttnResidual。首列对应开头 token,随 query 延伸的竖带表示它被持续关注。因果掩码使有效区域呈下三角。应结合色条阅读:图中的蓝色代表较高权重。
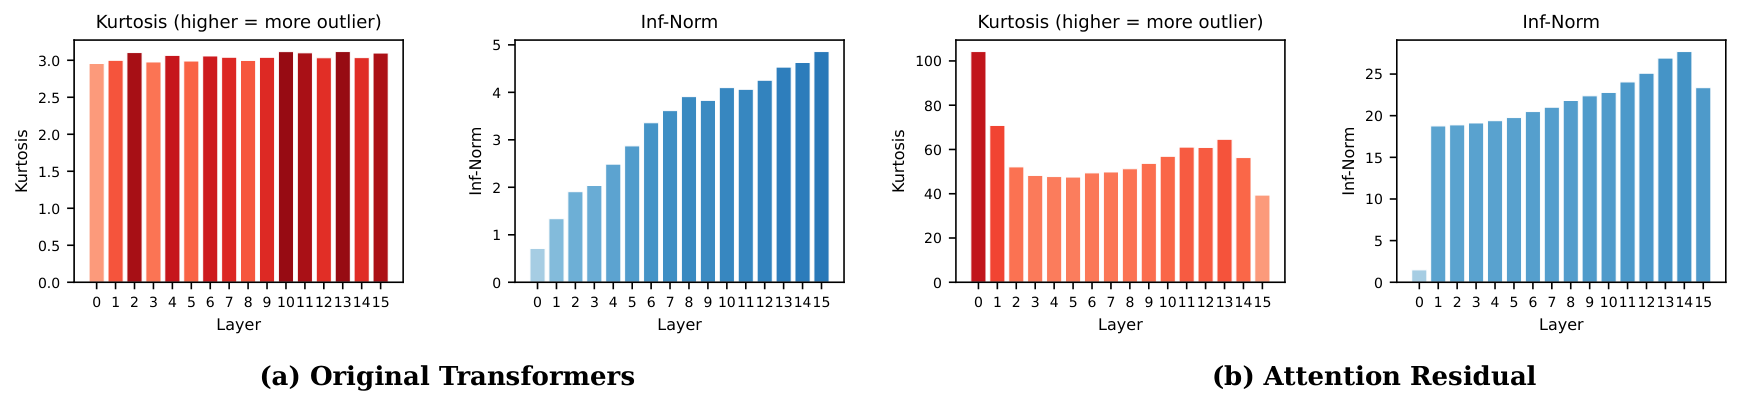
来源:Fig.3,p.3。每组左图是激活峰度、右图是无穷范数,横轴均为层号。原始 Transformer 的峰度约为 3、最大幅值小于 5;AttnResidual 在该图中的首层峰度超过 100,随后约 50–70,幅值可到约 28。两组纵轴范围不同,需要读刻度。后文 Table 1 的最大幅值采用更广的激活统计口径,不能把图中的 28 当作表中的 84.43。
教学解释:异常值为什么伤害量化? 在对称均匀 $b$ 比特量化的简化模型中,若范围由最大幅值 $M$ 决定,量化步长约为 $2M/(2^b-1)$。少数极大值拉宽范围,会让常见小值使用更粗的刻度。实际 OmniQuant 带有学习校准,这个式子用于解释动机,不是本文实验的完整量化器。
二:方法——先允许衰减,再利用空概率选择分支
2.1 数据流与符号
| 符号 | 含义 |
|---|---|
| $t,j,m$ | 当前 query、可见 key 的索引、可见 token 数 |
| $i,\ell,H$ | 来源分支、目标层、注意力头数 |
| $v_j^{(i,h)},z_{t,j}^{(i,h)}$ | 第 $i$ 个分支第 $h$ 个头的 value 向量及 token logit |
| $s_{0,t}=h_t^{(1)}$ | 初始状态分支,与零值空分支不同 |
| $s_{i,t}=f_i(h_t^{(i)})$ | 第 $i\geq1$ 个变换分支的输出,维度与隐藏状态一致 |
| $g_{i\to\ell,t}$ | 分支 $i$ 路由到层 $\ell$、位置 $t$ 的标量分数 |
| $\tilde p_{t,\varnothing}^{(i,h)}$ | token 空状态的概率 |
| $\psi_{i,t},\beta$ | 分支平均空概率、非负耦合强度 |
标准深度混合写成:
这里路由的对象包括初始状态和历史变换输出,并非简单把当前层乘一个标量。token 注意力则在每个变换内部,对上下文 value 做加权求和。(§4.1,p.4)
2.2 AoS:在两个层面加入固定 logit 为零的空状态
token 层面:
深度层面:
分母中的 $1=e^0$ 等价于增加一个 logit 为 0、value 为零向量的类别。因此,包含空状态的概率仍然和为 1;真实候选的概率和可以小于 1。(Eqs.(4.1)–(4.2),p.4)
固定原有 logits 时,有严格恒等式:
这把“选择哪个内容”和“总共贡献多少”分开了:真实 token 之间的相对分配不变,但总输出被缩小。普通 Softmax 对所有 logit 同减常数不敏感;$\mathrm{Softmax}_1$ 的空 logit 固定在零,所以这个共同偏移可以改变真实内容与空状态的竞争。
深度空路由的语义是衰减混合结果。 按本文公式,它把质量分给零向量;它不会自动保留上一个隐藏状态。初始状态 $s_{0,t}$ 是真实分支,有自己的非零值与 logit,必须与 $\varnothing$ 分开理解。(§4.2,p.4;Appendix C.5,pp.21–22)
2.3 OASIS:将 token 的空概率传给深度路由
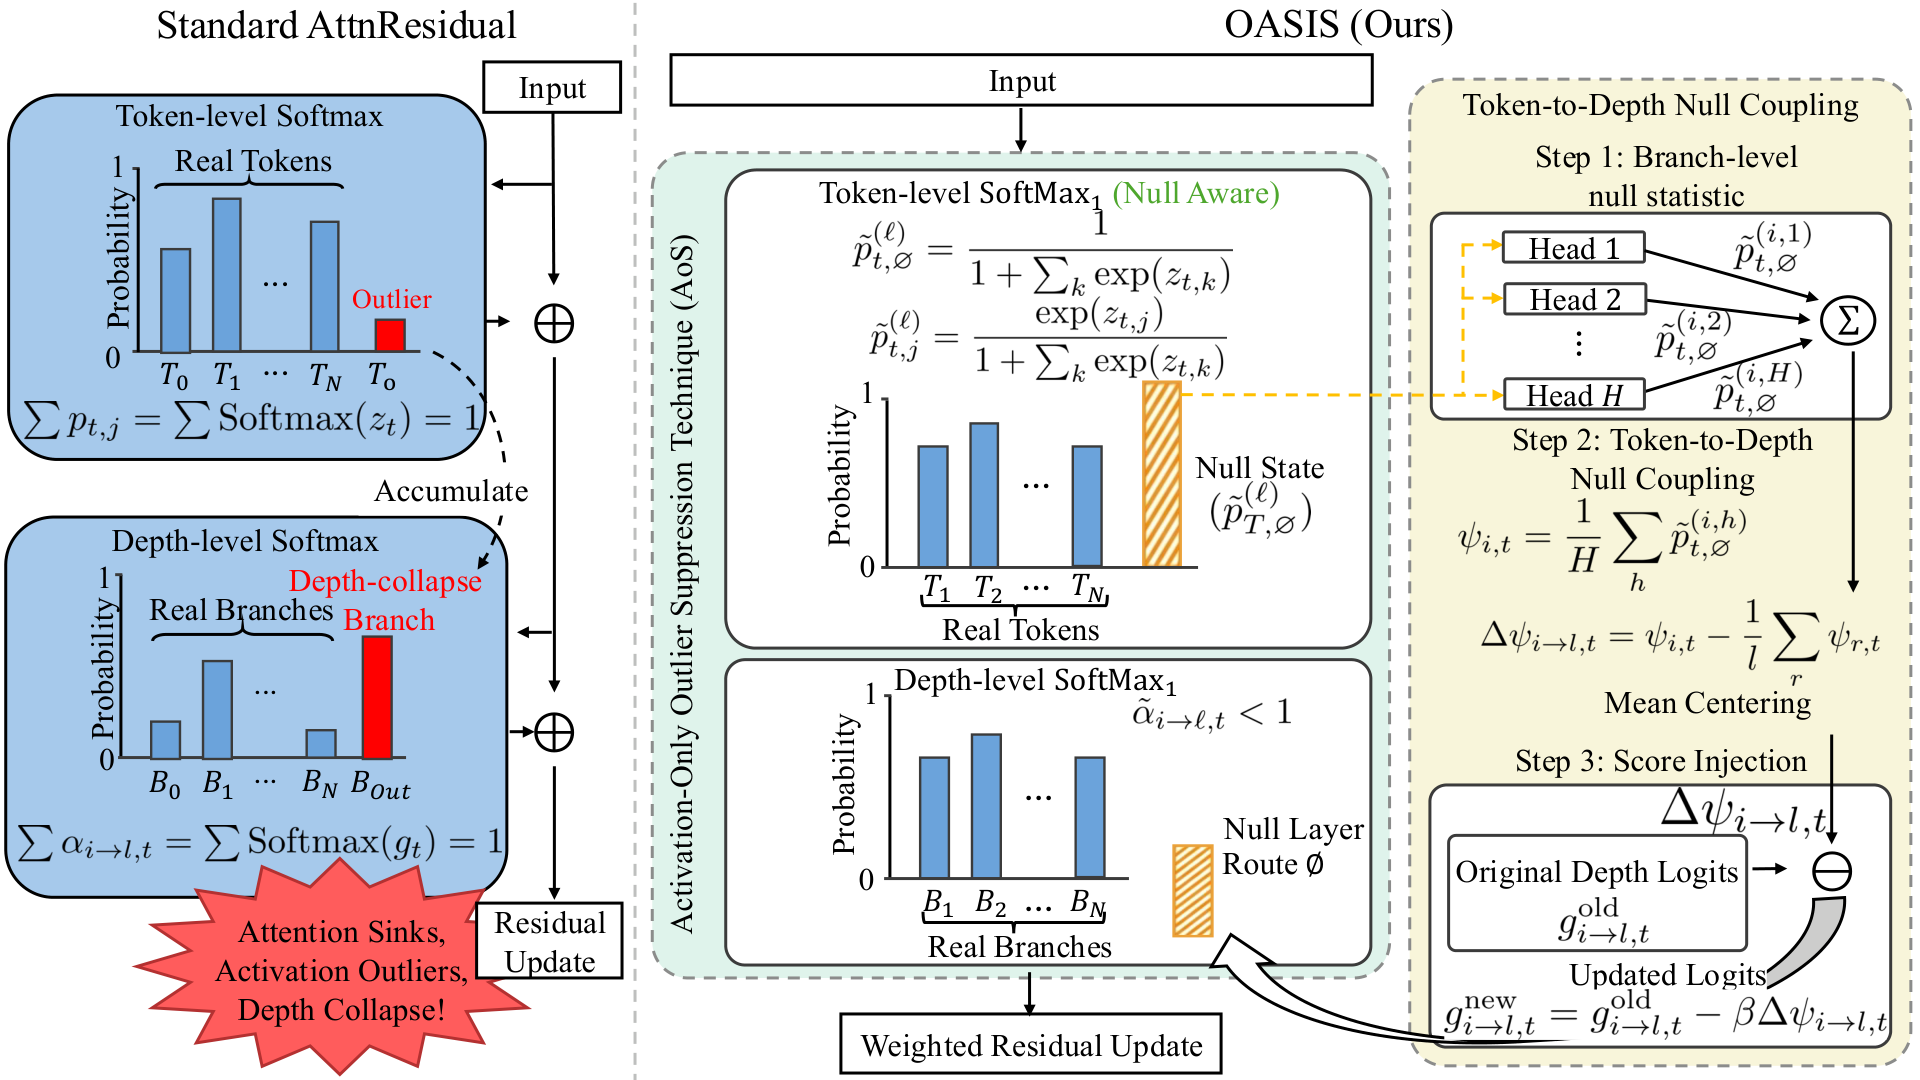
来源:Fig.1,p.2。先看中间两个归一化模块:它们组成 AoS。再看右侧反馈路径:逐头汇总空概率、在变换分支之间中心化、修正深度 logits;这是 OASIS 增加的部分。
对每个变换分支 $i\geq1$,先平均注意力头的空概率:
再对当前可用的变换分支做中心化:
最后把统计量注入路由分数,再做深度 $\mathrm{Softmax}_1$:
高于平均空概率的分支被相对降权,低于平均的分支被相对升权。$i=0$ 没有注意力头,所以其 logit 不变;其最终概率仍会随归一化分母改变。$\ell=1$ 不使用耦合;只有一个变换分支时,中心化统计量也为零。(§4.3,pp.4–5)
本次推导:耦合改变了什么比例? 对任意两个变换分支 $i,k\geq1$:
这精确表达了“较大的空概率带来较小的相对权重”。中心化只消除了变换分支之间的共同偏置;由于零值空状态与初始状态不作同样平移,它还会影响变换分支相对这两个选项的总质量。因此,中心化并非可以随意删除的步骤。
教学例子。 设初始分支和两个变换分支的旧 logits 都为 0,两个分支的 $\psi$ 分别为 0.8、0.2,取 $\beta=1$。AoS 将三个真实分支和空状态各分到 0.25。OASIS 的真实 logits 变成 $[0,-0.3,0.3]$,得到约 $[0.2445,0.1811,0.3300]$,空概率约 0.2445。高空概率分支被降权,但总空概率并未增加;耦合不能简单理解成“制造更多空概率”。
2.4 如何训练和使用
作者对预训练骨干加入路由改造后继续预训练,再做训练后量化(PTQ)。OASIS 没有额外监督损失。$\beta=\mathrm{softplus}(\theta)$,其中未约束参数初始化为 $\theta=-5$,实际 $\beta\approx0.0067$,使初始耦合较弱。这里接近无操作的是 耦合修正,不是说把 Softmax 换成 $\mathrm{Softmax}_1$ 后整个模型完全不变。(Appendix E,p.23)
推理时使用相同的空路由与耦合规则,需要保留每个可用来源分支、当前位置的 $\psi_{i,t}$。它没有定义离散跳层或分支裁剪,所以不能仅凭权重变小推断出推理加速。
以下是忠于公式的教学伪代码,不代表作者代码的具体张量布局:
在每个分支、每个头中:
    用 softmax(concat(token_logits, 0)) 得到真实与空概率
    attention_output = sum(real_prob * value)
    psi[branch, token] = mean_over_heads(null_prob)
在目标层 ell:
    delta = zeros(ell)
    if ell > 1:
        delta[1:ell] = psi[1:ell] - mean(psi[1:ell])
    alpha = softmax(concat(depth_logits - beta * delta, 0))
    hidden = sum(alpha_for_real_branches * source_states)
实际稳定计算时,应把固定空 logit 一起纳入 log-sum-exp;不能只平移真实 logits、却把空 logit 留在零而声称概率不变。
2.5 理论:哪些机制得到严格刻画
低范数 token 的集中界。 Lemma 5.1 假设存在候选 $o$ 满足 $\|v_o\|\leq c_0$,其余所有 value 在同一单位方向 $u$ 上都有 $\langle v_j,u\rangle\geq c_1>c_0$。如果要求 $\|A\|\leq\delta 证明的关键不是所有 value 范数大,而是 非候选 value 的方向不能互相抵消。沿 $u$ 投影,再用三角不等式,得到 与 $\|A\|\leq\delta$ 合并即得结论。当 $c_0/c_1$ 和 $\delta/c_1$ 都很小时,$p_o$ 被迫接近 1。(Lemma 5.1,p.5;证明 C.1,pp.17–18;Assumptions D.1、D.3,p.22) 教学反例:分离假设不可省略。 若只有两个 value,分别为 $u$ 与 $-u$,以 0.5、0.5 加权就能精确输出零,完全无需 sink。它们无法同时满足同一方向上的正投影条件。这说明 no-op 需求本身不足以推出集中。 深度集中界。 定义来源相对参考状态的偏差 $u_{i,t}=s_{i,t}-h_t^{\mathrm{ref}}$。标准深度 Softmax 的和为 1,故 若最小偏差分支 $i_t^*$ 满足 $\|u_{i_t^*,t}\|\leq b_0$,其余分支在同一方向 $w$ 上投影至少为 $b_1>\delta_t$,且混合偏差不超过 $\delta_t$,则 这复用了 token 层面的几何证明。只有在 $b_0/b_1\to0$、$\delta_t/b_1\to0$ 的高分离情形,界才迫使深度权重趋于单分支。(Theorem 5.1,p.6;C.3,pp.18–19) 路由病理分数。 作者定义 $\mathcal S_t=L_t+\lambda_1C_t+\lambda_2E_t$:$L_t$ 为无关 token 的泄漏质量,$C_t=\max_{\ell,j}\alpha_t^{(\ell)}p_{t,j}^{(\ell)}$ 为最大联合路由概率,$E_t=-H(\alpha_t)-\sum_\ell\alpha_t^{(\ell)}H(p_t^{(\ell)})$ 为负联合熵。$E_t$ 越大表示越集中。Proposition 5.1 预先假设三个分量在 AttnResidual 中分别不小于 vanilla attention,再对非负权重求和。其作用是汇总已满足的分量关系,而从架构独立推出这些关系,仍需要额外证据;这个分数也没有直接度量激活峰度。(Definitions 5.1–5.2、Proposition 5.1,pp.5–6;D.4,p.22) sink 聚合界。 令 $\sigma_t^{(\ell)}$ 是每个分支分给 sink 集合的质量,$\Sigma_t=\sum_\ell\alpha_t^{(\ell)}\sigma_t^{(\ell)}$,则 如果路由集中到某个分支,聚合质量就趋近该分支的 sink 质量。因此“聚合”是凸平均,不是把各分支 sink 无界累加;是否加重 sink 还取决于选择了哪个分支以及训练如何改变分支本身。(Lemma 5.2,p.6;C.4,p.20) 空状态提供衰减自由度。 对有界 value 和来源状态,Theorem 5.2 的证明给出 增大空概率便可使真实贡献任意小,无需集中到某个真实候选。这个结果直接支持 AoS 的设计;OASIS 的耦合公式则明确规定相对路由偏好,而最终量化准确率仍须看实验。(Theorem 5.2,p.7;C.5,pp.20–22) 衰减与保留参考状态的区别也能直接写出。令 $a_\varnothing=\tilde\alpha_\varnothing$,有 当参考状态不为零时,最后一项不能省略。这正是不能把深度 $\mathrm{Softmax}_1$ 直接解释成恒等残差捷径的原因。 来源:§6,pp.7–9;Appendix E,pp.22–23。Table 3 是单独的最大训练/评估长度 12K 设置(§6.4),不应套用常规 2048 长度。原文未充分展开这组 12K 训练的预算细节。 Table 7 在所有层、头、query 位置与评估样本上聚合,报告 BOS 概率质量、sink rate、注意力熵、secondary-sink mass 和 null mass。BOS mass 可直接理解为首 token 获得多少注意力;熵越高表示更分散。正文没有清楚给出 sink rate 的判定阈值、次级 sink 的具体选取和空状态参与熵计算的口径,故这些值适合做表内比较,尚不足以照此复刻全套统计。(Appendix G.3,p.24) 以下摘录 Table 1(p.8)的均值。PPL 越低越好;对应主文的 WikiText-2 语言建模实验。 两级空路由在三个骨干上均优于仅 token 空路由,尤其 Phi 的低位宽退化得到大幅修复。可是 W4A4 下 Phi 的 PPL 48.26 仍明显高于其 FP16 的 11.09,量化误差并未消失。 与 clipping、gating 的组合也有效。 LLaMA 的 W4A4 PPL 为 Clipped Softmax 26.81 → Clipped AoS 22.57,Gated Attention 24.27 → Gated AoS 21.45;Qwen 的对应值为 39.89 → 16.95、28.78 → 15.43;Phi 为 112.18 → 37.62、102.45 → 31.89。与此同时,部分 FP16 结果仍由其他方法更好,例如 LLaMA 的 Gated Attention 为 8.26、Gated AoS 为 8.68。AoS 的优势应表述为量化稳健性和异常值抑制,而非每个精度、每个指标都最优。(§6.1,pp.7–8;Table 1) 来源:§6.2,p.8;Table 8,p.24。与 Vanilla 相比,token-only 增加 6.69 个百分点、depth-only 增加 3.23 个百分点。两者合并达到 54.21%;再加耦合增加 4.67 个百分点,相对 AoS 提高约 8.61%。这是本文对 OASIS 新模块最直接的隔离证据。 Table 2(p.8)关键均值与标准差如下。PPL 为 WikiText-2;GSM8K 为百分比。 OASIS 相对 Vanilla 的 GSM8K 绝对收益分别为 0.55、13.21、40.21 个百分点。LLaMA 的准确率变化很小;Qwen 和 Phi 贡献了更大的量化后恢复。FP16 GSM8K 则分别为 13.64 → 13.75、62.58 → 62.68、93.78 → 94.02,远小于后两者的低位宽增益。因此,大幅收益主要体现为保住量化后的能力。 激活统计也同步改善: 摘要的平均数如何读。 四个主要百分比是先算每个模型的相对变化,再等权平均:峰度下降 95.90%、最大幅值下降 81.75%、W8A8 PPL 下降 82.00%、W4A4 GSM8K 相对提升 42.11%。例如最后一项为 它不是准确率增加 42.11 个百分点,也不是先合并模型分数再计算相对增幅。§6.3(p.9)还保留了只针对 LLaMA、Qwen 的另一种口径:先平均分数,再算相对差,得到 GSM8K 提升 23.47%。这两个数字的模型范围和平均顺序均不同,不能混用。 Fig.4(p.9)展示短因果提示上的代表性 head-0 注意力图;§6.4 说明检查的是 layer 14。开头 token 的竖直高权重带和次级竖带是要观察的对象。作者据此认为 OASIS 减弱了首 token 与次级 sink,并使注意力更多回到邻近内容。更有代表性的证据来自 Table 7(p.24)的全局聚合: 与 AttnResidual 相比,BOS mass 在 Qwen、LLaMA 上分别下降约 99.7%、98.2%。同时次级 sink 减少、熵上升,支持集中程度在模型范围内下降。 一个值得追问的机制细节是:Qwen 的平均空质量只有 0.0004,仍出现显著 sink 抑制;LLaMA 的空质量却为 0.2185。 结合“固定 logits 时 Softmax1 仅整体缩放真实概率”的恒等式,这提示最终改善还涉及训练后 logits 与分支选择的改变。把结果全部解释成推理时将原有 BOS 概率直接转移给空状态,无法解释这种跨模型差异。这是本次分析提出的解释方向,论文没有给出隔离其训练因果路径的实验。 下表为 Table 3(p.10)报告的 12K 分数,均为越高越好。S1 的可学习 sink logit、S2 的前缀 sink token 和 StreamingLLM 都没有将吸收质量反馈到深度路由。 这组数据说明 双空路由本身不足以解释全部长上下文收益:AoS 在这四列均落后于 S1,而加入耦合的 OASIS 超过这些 sink 对照。以 LLaMA RULER 为例,恢复比例是 同理,Qwen RULER 恢复 80.3%;LLaMA、Qwen LongBench 分别恢复 89.1%、91.8%。这些百分比的分母是“原始骨干减去 Vanilla AttnResidual 的损失”,不是原始骨干分数。原文表格高亮了 OASIS,但原始骨干仍在四列中更高。实验支持其修复架构改造后的长上下文退化。 Table 4(p.10)将语言建模扩展到 The Pile,将准确率任务扩展到 MMLU、TriviaQA 和 MATH500。以下摘录低位宽均值,准确率列单位为 %。 量化前的改善小得多。例如 Qwen MMLU 从 AttnResidual 的 43.46 提升到 OASIS 的 43.77,而量化后从 33.21 提升到 41.00。这样读更能区分“增强原有能力”和“防止量化损坏”。小幅任务差异还需结合标准差:Qwen FP16 MMLU 为 43.46 ± 0.23 与 43.77 ± 0.21,表中均值排序本身不构成显著性检验。 Appendix G.1 的 Table 5(p.23)使用匹配的 Backbone + CPT: 单独继续预训练后,激活统计仍接近原始骨干;加入 AttnResidual 才出现显著恶化,支持路由改造与不稳定性有关。OASIS 把峰度和任务表现恢复到较好水平,但最大幅值仍大于匹配骨干。这也说明量化可用性不能只按一个最大范数判断。 Table 6(p.23)在 LLaMA 上比较 Softmax、Sparsemax、Entmax15 和 OASIS。W8A8 PPL 分别为 30.189、19.814、19.600、8.162;峰度分别为 91.706、87.322、13.134、3.024。稀疏归一化确实能改善部分指标,但 OASIS 的低位宽恢复更强。 这里的设计启发是:Sparsemax、Entmax 改变真实候选之间的分布稀疏程度,显式零值空状态则改变可输出贡献的总质量。注意力稀疏与贡献衰减是两种不同自由度。 本文最重要的贡献是把空状态从 token 层面的技巧延伸到了 token—深度联合路由:先让两级路由都能降低真实贡献,再利用分支的 token 空概率修正深度选择。AoS 的大量量化收益说明双归一化是一个值得处理的位置;Qwen 组件消融和长上下文对照进一步支持跨层面耦合的增量价值。 理论中最有用的部分是带明确分离假设的集中下界,以及 $\mathrm{Softmax}_1$ 的质量衰减恒等式。它们解释了为何“所有权重必须和为 1”会限制 no-op,但激活异常值、全局 sink 和准确率之间的完整因果链仍主要依赖实证观察。 对于实现或继续研究,以下三个问题会实际影响判断: 若把这篇论文用于组会讨论,最值得抓住的问题是:当跨层路由需要判断一个分支是否值得继续使用时,分支内部“选择不贡献”的概率,能否成为可学习的信息质量信号? OASIS 给出了一个简洁实现,并通过低位宽消融提供了有力的初步证据。三:实验——每组对照分别回答什么
3.1 训练、量化与统计协议
项目 原文设置与理解 骨干 LLaMA-3.2-1B、Qwen3-0.6B、Phi-4;Phi 的脚注链接实际指向 microsoft/Phi-4-reasoning训练方式 在预训练检查点上改造 Attention Residuals,再继续预训练 训练数据 BookCorpus 与 Wiki40B/en 常规继续预训练 500 steps;sequence length 2048;block size 512;batch size 1、梯度累积 64 优化 学习率 $5\times10^{-5}$;线性调度;100 warmup steps;gradient clipping 1.0;weight decay 0.1 耦合强度 $\beta=\mathrm{softplus}(\theta)$,$\theta=-5$ 初始化 环境 4 张 NVIDIA H100 80GB;PyTorch、Hugging Face Transformers、Accelerate 生成参数 温度 0.6、top-p 0.95、最大生成 4096 token;GSM8K 使用思维链提示 量化 FP16 对照;W8A8;W6A6/W4A4 使用 OmniQuant;W、A 分别指权重与激活位宽 统计 作者声明使用三个独立随机种子,主要表格报告均值与标准差;部分长上下文/消融表只列汇总值 3.2 baseline 与指标的角色
对照或指标 用来判断什么 Original backbone 未进行这轮架构改造的预训练模型,给出原始能力参考 Backbone + CPT 相同继续预训练设置、保留骨干结构,区分训练本身与架构改造的影响 Vanilla AttnResidual 两级普通 Softmax;Table 2 的 “Vanilla” 指它,不能误认成原始骨干 OutEffHop / Token only 仅在 token 侧采用空路由,对比增加深度空路由的价值 AoS 两级独立空路由,对比耦合的增量价值 Clipped / Gated 系列 限制极端注意力或用门控实现部分更新,测试 AoS 与已有抑制策略能否组合 Sparsemax / Entmax15 对比稀疏分配与显式空状态的效果 S1 / S2 / StreamingLLM 分别是可学习 sink logit、带学习 value 的前缀 sink、在 KV cache 中保留 sink;测试吸收/保留 sink 与向深度传递空信息的区别 平均峰度、最大 $\ell_\infty$ 范数 ↓ 激活分布尾部厚度和最大幅值;不等同于任务能力 WikiText-2 / Pile PPL ↓ 下一个 token 的预测困惑度,分别比较量化前后表现 GSM8K Pass@1 ↑ 一次生成的答案正确率;表中的 58.88 表示 58.88% MMLU / TriviaQA / MATH500 ↑ 知识、问答、数学任务表现 RULER / LongBench ↑ 12K 长上下文汇总分数;Table 3 按 0–1 数值展示 3.3 全局 sink 指标的解释
四:结果——空路由的收益与耦合的增量
4.1 AoS:仅修正两级归一化就能显著改善量化
骨干 方法 W8A8 PPL W6A6 PPL W4A4 PPL LLaMA-3.2-1B Vanilla AttnResidual 30.19 39.38 74.97 OutEffHop 10.42 13.56 26.18 AoS 9.36 11.28 22.63 Qwen3-0.6B Vanilla AttnResidual 36.64 44.78 50.82 OutEffHop 10.60 13.36 32.36 AoS 9.62 10.48 17.52 Phi-4 Vanilla AttnResidual 1176.73 1611.07 2724.05 OutEffHop 16.98 37.75 160.70 AoS 12.18 16.85 48.26 4.2 组件消融:耦合超出了两级独立空路由
Qwen3-0.6B 配置 token 空路由 深度空路由 耦合 W4A4 GSM8K Pass@1 Vanilla AttnResidual 否 否 否 45.67% Token only / OutEffHop 是 否 否 52.36% Depth only 否 是 否 48.90% AoS 是 是 否 54.21% OASIS 是 是 是 58.88% 4.3 OASIS:三个骨干的任务收益差异很大
骨干 方法 FP16 PPL ↓ W8A8 PPL ↓ W4A4 GSM8K ↑ LLaMA-3.2-1B Vanilla AttnResidual 8.98 ± 0.01 30.19 ± 0.06 12.97 ± 0.24 AoS 9.00 ± 0.01 9.36 ± 0.01 13.34 ± 0.18 OASIS 8.01 ± 0.01 8.16 ± 0.01 13.52 ± 0.17 Qwen3-0.6B Vanilla AttnResidual 10.57 ± 0.01 36.64 ± 0.08 45.67 ± 0.86 AoS 9.35 ± 0.01 9.62 ± 0.01 54.21 ± 0.66 OASIS 9.20 ± 0.01 9.52 ± 0.01 58.88 ± 0.59 Phi-4 Vanilla AttnResidual 11.21 ± 0.00 1176.73 ± 0.01 43.16 ± 0.25 AoS 11.09 ± 0.00 12.18 ± 0.00 76.85 ± 0.21 OASIS 10.94 ± 0.01 11.72 ± 0.00 83.37 ± 0.21 骨干 平均峰度:Vanilla → OASIS 最大幅值:Vanilla → OASIS LLaMA-3.2-1B 91.71 → 3.02 84.43 → 12.25 Qwen3-0.6B 93.04 → 2.95 74.78 → 13.00 Phi-4 38.83 → 2.27 37.96 → 8.68 4.4 sink:局部图像与全局统计共同支持改善
骨干 / 方法 BOS mass ↓ Sink rate ↓ Entropy ↑ Secondary mass ↓ Null mass Qwen / 原始骨干 0.1064 0.0027 3.74 0.013 0 Qwen / AttnResidual 0.4990 0.6642 1.83 0.042 0 Qwen / OASIS 0.0013 0.0001 4.44 0.008 0.0004 LLaMA / 原始骨干 0.1091 0.1846 3.34 0.013 0 LLaMA / AttnResidual 0.5630 0.7861 1.86 0.046 0 LLaMA / OASIS 0.0099 0.0046 4.55 0.010 0.2185 4.5 长上下文:修复损失,但原始骨干仍领先
方法 LLaMA RULER LLaMA LongBench Qwen RULER Qwen LongBench 原始骨干 0.786 0.225 0.891 0.194 Vanilla AttnResidual 0.500 0.115 0.592 0.133 S1:可学习 sink logit 0.597 0.131 0.811 0.184 S2:前缀 sink token 0.586 0.128 0.800 0.181 StreamingLLM 0.578 0.124 0.792 0.177 AoS 0.567 0.121 0.781 0.174 OASIS 0.721 0.213 0.832 0.189 4.6 跨领域与下游任务:主要体现为更小的量化损失
骨干 / 方法 Pile W8A8 PPL ↓ MMLU W4A4 ↑ TriviaQA W4A4 ↑ MATH500 W4A4 ↑ LLaMA / 原始骨干 11.79 29.01 24.40 2.59 LLaMA / AttnResidual 38.24 26.42 19.13 2.81 LLaMA / AoS 11.62 29.27 24.04 3.43 LLaMA / OASIS 10.17 30.19 25.56 3.77 Qwen / 原始骨干 13.61 40.06 15.41 19.59 Qwen / AttnResidual 44.52 33.21 12.09 15.41 Qwen / AoS 11.73 39.37 15.07 19.50 Qwen / OASIS 11.58 41.00 16.14 21.51 4.7 继续预训练对照:异常值增加不只是训练造成的
骨干 / 方法 平均峰度 ↓ 最大幅值 ↓ W8A8 PPL ↓ W4A4 GSM8K ↑ LLaMA / Backbone+CPT 3.07 5.20 9.85 12.76 LLaMA / AttnResidual 91.71 84.43 30.19 12.97 LLaMA / OASIS 3.02 12.25 8.16 13.52 Qwen / Backbone+CPT 3.16 4.77 11.50 55.79 Qwen / AttnResidual 93.04 74.78 36.64 45.67 Qwen / OASIS 2.95 13.00 9.52 58.88 4.8 稀疏化并不能替代空状态
五:结论——贡献、取舍与值得继续研究的问题