OSDN:在线预条件如何改进 Delta Rule
论文:OSDN: Improving Delta Rule with Provable Online Preconditioning in Linear Attention
作者:Chenyu Zhou、Hongpei Li(共同一作)、Yuerou Liu、Jianghao Lin、Dongdong Ge、Yinyu Ye。
版本:arXiv:2605.13473v1,提交于 2026-05-13;获取与研读日期:2026-09-22。
材料:原文 PDF、作者 TeX 主入口、源码清单。
本次以 main_arxiv.tex → main.tex 实际引用的正文和附录 A–M 为阅读范围,结合 44 页 PDF 核对公式、页码和关键图表。阅读了方法推导、三种骨干的实现伪代码、两组证明及全部实验附录;没有运行作者模型、独立复现实验或逐篇核验参考文献。以下页码均指 PDF 页码,与此版本印刷页码一致。作者代码地址见原文;本次没有审计代码仓库。
论文总览
主线:把 DeltaNet 的每 token 标量写入步长扩展为逐特征的在线缩放,同时保留大矩阵更新的分块计算形式。 新增状态是一条每头 $K$ 维向量 $d_t$。二次回归损失使更新 $d_t$ 的反馈消去记忆残差,因此可以先从 key 与 gate 计算预条件器,再执行记忆写入。
最明确的任务结果是:340M / 约 10B-token 设置下,OSDN 的 JRT 总体 contains accuracy 从 0.150 升至 0.198,即 +4.8 个百分点、相对 +32%。1.3B / 100B-token 设置下,OSDN-APF 的局部残差比几何均值从 0.432 降至 0.265(约 −38.7%),但重复召回准确率从 0.227 降至 0.217。因此,“39%”不能读成大模型召回准确率提高 39%。证据支持改进写入机制,尚不支持普遍提升下游能力。[Table 1, p.7;Table 8, p.35;Table 16, p.40]
结构地图
| 原文章节 | 内容与作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 标量写入的局限与两阶段方案 | pp.1–3,Fig.1 |
| 2 Related Work | DeltaNet、门控递归与内层优化的关系 | p.3 |
| 3 Preliminary | 状态维度、Delta rule、OSGM surrogate | pp.3–4,Eq.(1) |
| 4 A Preconditioned Delta Rule | 写 key 等价、超梯度、APF、chunk 实现 | pp.4–6,Eqs.(2)–(7),Alg.1 |
| 5 Theory: Residual Contraction | 总体目标与 token-local 两种条件保证 | pp.6–7,Thms.5.1–5.2 |
| 6 Experiments | 主表、机制诊断、1.3B 扩展 | pp.7–9,Table 1,Fig.2 |
| 7 Discussion | 作者结论及限制 | pp.9–10 |
| A Method Details and Proofs | WY 推导、单步下降、成本 | pp.15–17,Table 2 |
| B Backbone Extensions: Gated DeltaNet and KDA | 门控与转置状态约定 | pp.17–19,Table 3 |
| C Chunkwise Implementation Pseudocode | 三种骨干的两阶段实现 | pp.20–23,Listings 1–3 |
| D Theoretical Analysis: Quadratic Memory-Regression Dynamics | 完整证明、反例、比较器差距 | pp.23–31,Thms.D.5/D.7,Cor.D.8 |
| E Benchmark Suite and Metrics | 各评测的定义与用途 | pp.31–32 |
| F Training and Evaluation Reproduction Details | 训练、随机种子、packing、扩展配置 | pp.32–34,Tables 4–5 |
| G Additional 340M Benchmark Breakdowns | 逐任务和跨骨干结果 | pp.34–37,Tables 6–12,Fig.3 |
| H PG-19 Length Extrapolation Details | 20K 外推与位置桶 | pp.37–38,Fig.4,Table 13 |
| I OSDN Variant Ablations | 初始预条件器及 APF 消融 | pp.38–39,Table 14 |
| J Training-Loss Diagnostic | 匹配 token 预算的 CE 曲线 | p.39,Fig.5 |
| K 1.3B / 100B Scaling Breakdown | 大模型逐任务与缺失评测说明 | pp.39–41,Tables 15–18 |
| L Inference Throughput Protocol and Results | 推理吞吐、状态内存、内核一致性 | pp.41–42,Tables 19–20 |
| M Extended Related Work Taxonomy | 内层优化视角的扩展分类 | pp.42–44,Table 21 |
注:附录 C 与 D 在 p.23 交接(D 标题从 p.23 开始);浮动图表可能先于所属小节出现,例如 Table 14 在 p.38、小节 I 在 p.39。
一:动机
1.1 DeltaNet 已经会“纠错”,为什么还需要预条件?
普通加性线性注意力将 $v_tk_t^\top$ 累加到记忆矩阵,同向写入容易叠加。DeltaNet 先读出 $S_{t-1}k_t$,再只写入当前值与读出值的差。这使它可以覆盖过时关联,但每个 key 坐标仍共享一个标量步长 $\beta_t$。
作者认为,不同坐标受到的写入频率和局部几何不同,共享步长需要折中。OSDN 用 $d_{t,j}$ 调整每个坐标的有效步长 $\beta_td_{t,j}$。这里的“曲率适应”是一种优化解释;实际算法并未维护或求逆完整协方差矩阵。它优化的是后文的 token-local surrogate,不能直接等同于逐渐学到了总体 Hessian 的逆。[Sec.1, pp.1–3;Sec.4, pp.4–6]
1.2 真正的设计约束
预条件方法必须同时满足三点:新增状态足够小;不依赖正在更新的大记忆矩阵;不破坏已有 chunkwise DeltaNet 的矩阵乘结构。直接对总体目标使用稠密 Newton 预条件不符合后两点。本文的关键选择是“对角约束 + 当前 token 的二次损失”,由此得到可以解耦的闭式反馈。
相关工作的比较角色:DeltaNet 是直接宿主与主要 baseline;Gated DeltaNet(GDN)和 KDA 检验能否与其他状态门控组合;OSGM 提供预条件器的在线学习框架;TTT/MesaNet 是优化视角的背景,本文没有与它们开展同预算主实验。[Sec.2;App.M]
二:方法
2.1 符号、输入与输出
| 符号 | 含义与维度 |
|---|---|
| $x_t$ | 当前层 token 表征,维度 $d_m$ |
| $q_t,k_t\in\mathbb R^K$ | query、物理/read key |
| $v_t\in\mathbb R^V$ | value |
| $S_t\in\mathbb R^{V\times K}$ | DeltaNet 每头快速记忆 |
| $u_t=v_t-S_{t-1}k_t$ | 写入前残差,$V$ 维 |
| $\beta_t\in(0,1)$ | 学习得到的标量写门 |
| $d_t\in\mathcal D=[d_{\min},d_{\max}]^K$ | 在线预条件向量 |
| $D_t=\operatorname{Diag}(d_t)$ | 对角右预条件器 |
| $\tilde k_t=d_t\odot k_t$ | 存储/write key,$K$ 维 |
| $\eta$、$r_{t,h}$ | 预条件器内层步长、每 token 每头保留门 |
| $o_t=S_tq_t$ | 层的记忆读出,$V$ 维 |
原文还用 $q_t$ 表示残差比值,与 query 向量重名;下文涉及 $q_{\rm geo}$ 或收缩时,$q_t$ 均指标量比值。序列长度与平滑常数在原文也都可能记作 $L$,应按上下文区分。
2.2 右预条件恰好等于只缩放写 key
对 token 的回归目标为
把 DeltaNet 的梯度步右乘 $D_t$:
所以只需改变写入方向。残差计算仍用原始 $k_t$,query 读出仍用 $q_t$。 同时替换残差里的 key 会得到不同算法。记忆转移变成
秩一结构保留,但原来对称的 $k_tk_t^\top$ 变成不对称的 $k_t\tilde k_t^\top$。[Sec.4.1/4.3,Eqs.(2)/(5),pp.4–5]
2.3 为什么更新 $d_t$ 不必读取 $S_t$?
令 $s_t=k_t\odot k_t$、$n_t=\|k_t\|_2^2$,并令 $a_t=\beta_t\langle d_t,s_t\rangle$。一次写入后,在同一个 key 上回读得到
用梯度平方归一化损失变化,残差模长被消去:
公式只含 key、标量门与当前 $d_t$;不再含 value、记忆或残差。因此第一阶段可以独立运行。这个推导对非零 key 且非零写入前残差直接成立;零残差的定义存在额外细节,见后文边界。[Lemma 4.1/Eq.(3), p.5;App.A.3, pp.15–16]
2.4 在线更新、顺序与单步稳定性
实践中用 $\bar n_t=\max(n_t,\epsilon)$:
先使用 $d_t$ 发出 $\tilde k_t$,再更新到 $d_{t+1}$,不能把两步交换。340M 最终配置给出 $d_1=\mathbf1$、$\eta=0.003$、$\mathcal D=[0.5,2]^K$,代码示例的数值地板为 $10^{-6}$。[Alg.1, p.5;Listing 1, pp.20–22;App.F, p.32]
若 key 单位归一化,则 $\langle d_t,s_t\rangle$ 是坐标缩放的加权平均,落在 $[0.5,2]$。由于 $0<\beta_t<1$,有 $0 这保证当前 token 写入后更接近自身目标,不保证早先 token 的关联不被破坏。此外它是区间给出的稳定性,不等同于在线预条件一定优于 baseline。[Cor.A.2, p.16] 教学例子(非论文实验):$k=(1,0)$、$\beta=0.5$ 时,$d=(1,1)$ 给出 $q=0.25$;若后续在线学习将该方向提高到 $d_1=1.5$,则 $q=0.0625$。这是相同残差的单步损失比改善,不是准确率提高四倍,也不表示一次 $\eta=0.003$ 更新就能达到 $1.5$。 阶段 1 顺序读取 $(k_t,\beta_t)$,输出整段 $\tilde K$,每头常驻状态 $O(K)$、每 token 工作量 $O(K)$。未投影更新可写成 $A_td_t+b_t$,其中 $A_t$ 为单位阵减秩一项;无需构造稠密 $K\times K$ 矩阵。加入 clamp 后是分段仿射。不能因“仿射 scan”就断言整个第一阶段已获得常数深度或对数深度并行;Table 2 明列其顺序深度为序列长度。[pp.5–6、17] 阶段 2 使用既有 WY 分块结构。省略 chunk 下标,$K,\tilde K\in\mathbb R^{C\times K}$、$V\in\mathbb R^{C\times V}$、$B=\operatorname{Diag}(\beta)$,则 三角系统、矩阵形状保留;块内输出的得分因子用 $Q\tilde K^\top$。注意 $W$ 中仍为 $K$。这说明算法结构兼容原来的硬件计算布局,不意味着现有对称 key 的 kernel 不作接口改动即可调用。物化整段 $\tilde K$ 的临时存储也不同于常驻的 $K$ 维状态。[App.A.2, p.15;App.C, pp.20–23] 训练时外层参数仍通过语言模型损失反传:$\tilde k_t=d_t\odot k_t$ 向 $d_t$ 与 $k_t$ 分流梯度,再反向遍历预条件器递推。推理时也继续更新 $S_t,d_t$,这是前向计算内部的在线学习,不是额外对外层模型做一次 AdamW。[Sec.4.5, p.6] APF 为每个 token/head 预测 $r_{t,h}=\sigma(w_{r,h}^\top x_t+b_{r,h})$,并使用 保留门只衰减 $d_t$,不直接衰减 $S_t$。公式也不是重置回 $\mathbf1$;当衰减占主导时会向下移动,受投影下界约束。作者希望它应对话题变化造成的过时校准。它每层增加 $H(d_m+1)$ 个参数;340M 配置作者称不超过 0.3%。无 APF 的 vanilla OSDN 不增加可训练参数,但仍增加运行时状态。[Sec.4.4, p.6;App.A.5, p.16] GDN 先得 $\bar S_{t-1}=\alpha_tS_{t-1}$,再用 $u_t=v_t-\bar S_{t-1}k_t$ 写入。这一“门控后残差”保持相同超梯度结构;用门控前残差会引入额外项。KDA 采用 $K\times V$ 状态,因此存储 key 出现在左侧: 向量记忆门 $\alpha_t$ 和预条件器保留门 $r_t$ 是不同机制。[App.B, pp.17–19] 1.3B 并非逐字沿用主文递推。 App.B/C 指出它使用不含 $\beta_t$ 的 phase-1 更新,在归一化 key 下为 实际记忆写入仍含 $\beta_t$;还采用零初始化的可学习初始 scale 和约 0.999 初始化的数据依赖保留门。应把这些看作作者报告的实现配置;不能假定它直接满足主文 beta-aware surrogate 的理论。[App.B, p.17;App.C, p.20] 定义 $f(S)=\tfrac12\mathbb E\|Sk-v\|^2$、$\Sigma_k=\mathbb E[kk^\top]$、$L=\lambda_{\max}(\Sigma_k)$。Hessian 是常数 $\Sigma_k\otimes I_V$,所以 Hessian-Lipschitz 常数为零。右 Newton 比较器 $D_\star=\Sigma_k^\dagger$ 可以在可辨识子空间内一步到最优。 在总体全梯度更新、损失单调下降、对稠密 $D_\star$ 的累计 regret 不超过 $\mathcal R_T$ 的假设下: 证明路线是:用 Newton 一步最优性表达最优反馈;用 Rayleigh 商得到 $|h_t(D_\star)|^{-1}\le2L$;regret 控制各步误差比例之和;AM–GM 将平均比例转为乘积。$\mathcal R_T=o(T)$ 时括号趋零,得到超几何收敛。[Thm.5.1, p.6;Thm.D.5, pp.26–27] 条件不能省略:实际算法只搜索有界对角类,理论比较器一般稠密;实际训练流提供单 token 梯度而非总体梯度。App.D.3 把差距分解为在线学习 regret、box 约束差距、对角近似差距;第一项小并不自动使三项总和次线性。 对单位 key,$q_t=1+2h_t(d_t)$。定义固定对角比较器误差 若在此 surrogate 上有对固定比较器的 regret 界 $R_T$,则 推导只需 $\prod q_t\le(\frac1T\sum q_t)^T$、$q_t=1+2h_t$ 和 regret 定义。真正的超几何特例还要求同一个可行 $d^\star$ 对所有 token 满足 $\beta_t\langle d^\star,s_t\rangle=1$,使比较器误差为零,并且 $R_T=o(T)$;$R_T=O(\sqrt T)$ 时得到 $(O(1)/\sqrt T)^T$。比较器误差不为零时,不能无条件宣称超几何。[Thm.5.2, p.7;Thm.D.7, pp.28–29] 本次分析:可行性条件相当强。 对 box 上界 2,若某步 $\beta_t<0.5$,即使单位 key、所有坐标取 2,也有 $\beta_t\langle d,s_t\rangle<1$,该步不可能满足精确条件。固定 $\eta=0.003$ 的实际运行也没有获得专门的次线性 regret 证明;通常 OGD 的 $O(\sqrt T)$ 结果需要相应的步长选择。作者在 Discussion 中承认这一限制。APF 还需动态 regret 分析,现有定理不能直接覆盖。[p.9、pp.30–31] 相邻 token 的 $f_t$ 不同,乘积不发生望远镜消去。原文反例是 $K=V=1$、$k_t=1$、$v_t=(-1)^t$:即使每次完全写对,$S_t$ 仍在正负 1 间振荡,不收敛到总体最优 0。[App.D.4, p.29] Cor.D.8 在更强的“类别值固定、key 正交且支撑块互不重叠、预条件器尊重块结构”下,才把 token 比值乘积连接到各类别最终损失比的乘积。自然语言重复上下文并未被证明满足这些条件。它是机制直觉的支持,不是对 JRT 数据结构的已验证描述。[pp.29–30] 零残差还需谨慎:App.D 在 $u_t=0$ 时定义 $h_t=0,q_t=1$,但此时闭式 $(1-a_t)^2$ 一般不等于 1,且不依赖 $u_t$ 的极限也不一般为零。因此“连续扩展”这一表述与后续对所有 token 直接代入闭式的证明存在衔接问题。本笔记的比值推导限定在非退化 token;严格处理零残差应统一约定或分离这些步,不把 $0/0$ 当作普通观测。 340M DeltaNet:24 层、width 1024、8 heads;KDA:23/1024/8;GDN:21/1024/6。因此最干净的是各骨干内部比较,不应把三者视作同一架构。AdamW 外层学习率 $10^{-3}$,cosine + warmup,裁剪 1.0,seed 42,bf16/fp32 reductions;4 GPU×累积2或8 GPU×累积1匹配每步 token 数。warmup 长度及部分其他优化器超参数在此文中未给出。[App.F, pp.32–34] 训练最大连续递归上下文依 App.F 为 4096;单 GPU 的 65,536 长度是 packing 后的张量,各文档边界重置状态,不能解释为 64K 长上下文训练。App.E 却写“训练 2K”,与 App.F 和 Fig.4 图注冲突;本笔记采用更具体的 App.F,并保留差异。 1.3B:24 层、width 2048、16 heads、100B tokens,只比较 DeltaNet 与 OSDN-APF。具体学习率、步数、batch、硬件数量、墙钟成本被指向训练日志,论文没有给出这些数值,不能套用 340M 配置。FW-Edu 使用训练集切片作 pseudo-validation,不能当成独立域外泛化证据。[App.E/F/K] 以下数值来自 Table 1(p.7);LM PPL 为 WikiText/LAMBADA GeoMean,JRT 均是比例值。 OSDN 总体 +0.048 是 +4.8 个百分点、相对 +32%;重复 +0.073 是 +7.3 个百分点、相对约 +50.3%。APF 总体 +0.026,相对约 +17.3%,但单次 0.152 低于 baseline 0.155;所以 APF 没有在所有召回设置中优于 vanilla。 逐任务发现更有解释力:OSDN 的 SWDE-twice 从 0.158 升至 0.227,SQuAD-twice 从 0.231 升至 0.383,FDA-twice 却为 0.045→0.044。平均收益并非三个任务普遍提高。[Table 7, p.34] 扩展到 GDN/KDA 的结果是混合的:OSGDN-APF 重复召回相对 GDN 提高约 59%;OSKDA 无 APF 时单次改善而重复下降,两个 OSKDA 变体的 LM PPL 都比 KDA 差。这支持“可组合的机制”,不足以支持“无代价的通用改进”。 来源:Table 8, p.35。340M 覆盖 48 prompts、24 层×8 头,约 $7.85\times10^6$ token-layer-head 测量;这些测量共享 prompt 和 checkpoint,不能当成数百万个独立实验样本。1.3B 头数变为 16,不能沿用 340M 测量总数。 原图 Fig.2, p.9,来自作者矢量图。左图横轴为 1–63 相对位置桶,纵轴为每桶残差比几何均值;竖虚线分隔第一次和重复上下文。右图为总体几何均值。OSDN/APF 曲线低于 DeltaNet,且在重复段仍有明显优势。不能将左图解释成 OSDN 自己的重复段比第一次段整体更低:重复边界后曲线也有上升。图支持相对 baseline 的优势,不证明每个位置或每个 token 都改善。 APF 的几何均值略优于 vanilla,但算术均值更差(0.573 vs 0.566),说明聚合口径会影响排序。$q_t$ 衡量当步自回读的局部改善;它不直接测量远处 query 最后能否答对。 来源:Tables 15–18, p.40。重复任务分项中 FDA-twice 0.061→0.073,SWDE-twice 0.392→0.360。SQuAD/SQuAD-twice 的 contains accuracy 因 harness 失效被排除;但内部残差诊断仍报告了 SQuAD-twice 的 0.473→0.102。这是两种测量,不能拿后者补齐缺失的答题准确率。 340M 总体召回平均 6 项,1.3B 平均 4 项,不能直接把二者的总体平均差解释成纯 scale 效应。1.3B 也没有完成匹配的 PG-19 20K sweep。作者称重复召回变化“在噪声内”,但没有提供足以检验这一说法的多 seed 置信区间;本笔记仅报告点估计和近似持平的描述,不声称统计等效。 Fig.4/Table 13, p.38。横轴为 20K 测试块中的 2K 位置桶,纵轴为 PPL;颜色对应骨干和变体,红色背景标记后段。Final 是全语料评估输出,不是桶 PPL 的简单平均。漂移量定义为末桶 PPL 减去 2–4K 桶 PPL。 APF 的绝对 Final 最好,但晚段漂移大于 vanilla 和 baseline。不能概括为“APF 在所有长期稳定性指标上最佳”。GDN→OSGDN 的 Final 为 20.11→19.70,OSGDN-APF 为 20.21;KDA→OSKDA 为 18.73→18.53,OSKDA-APF 为 19.00。这些分组也显示 APF 存在权衡。 Table 14(p.38)比较固定初值 OSDN、学习 $D_0$、放松初值投影的 $D_0^\star$ 及 APF。学习 $D_0$ 后,召回为 0.172、PG-19 Final 为 21.57;$D_0^\star$ 为 0.164/21.42;均不如 vanilla 的 0.198/20.02。它们的 Common. 点估计略高,但不足以抵消召回和长度漂移上的代价。原文未报告每种超参数、多 seed 的完整网格,因此不把消融视为所有初始化策略的结论。 Fig.5, p.39。横轴为训练 tokens;全程面板使用对数纵轴,其余三个面板放大最后 25% 训练、使用线性纵轴。曲线是 257 步居中滚动均值,最终 CE 取最后 256 步平均;全部完成配置在 2.421–2.479 nats 内,相差 0.058。DeltaNet/OSDN/APF 分别为 2.475/2.479/2.459。此图不能证明“在线预条件提升训练优化速度”,也不能把语言模型 CE 与定理中的内层回归损失混同。 340M 的 Common. 多数仅在小范围变化;特别是 Table 9 的图注说明,vanilla OSDN 采用各任务已完成 no-APF cell 的最佳值后再平均,不宜把这行当成严格单一 checkpoint 的整套评测。[p.35] 开放域检索在这些未指令微调的 340M 模型上分数很低。Table 12(p.37)中 DeltaNet/OSDN/APF 的 DROP、NQ、TriviaQA 三项平均均四舍五入为 0.016;KDA 是 0.018,两个 OSKDA 变体是 0.014。受控 cloze 的优势没有普遍转化成开放域 QA 收益。FW-Edu screen(Table 11)提供域内拟合对照:OSDN 12.32 vs DeltaNet 12.43,KDA 11.38;该切片来自训练 split,不能把它当成独立测试集。 Tables 19–20, p.41。指标按 $(2048+128)/(t_{prefill}+t_{decode})$ 计算,不能称为纯 decode tokens/s。作者报告 340M OS-* 相对宿主约 −2.2% 至 +5.5%,但没有给出计时误差条,也未覆盖长 prompt、大 batch、训练吞吐等全部场景。 本次复核发现:原文多处“新增状态 ≤0.05%”与表格不符。 340M DeltaNet 的 $(6.047-6.000)/6.000\approx0.783\%$;1.3B 同样约 0.783%;GDN 的 0.031/7.875 约 0.394%。公式 $VK\to VK+K$ 给出相对增量 $1/V$,也支持约 0.4%–0.8% 的量级。作者似乎混淆了很小的 MiB 增量与百分比;不能直接采用原文的 ≤0.05%。这不推翻“增量很小”,但应修正定量表述。此计数排除权重、激活、allocator、短卷积 cache,并按 bf16 元素计量,不等同于整卡实测显存。[App.A.6/L, pp.17、41–42] 内核一致性也是作者报告,非本次复测:OSGDN 在合成输入上与 chunk reference 的输出相对误差 ≤$6.5\times10^{-3}$、最终状态 ≤$6.7\times10^{-3}$、最终 $d$ ≤$2.0\times10^{-3}$;128-token prefill+1-token decode 对照误差 ≤$5.8\times10^{-3}$。[p.42] 本文最有价值的是一个具体的代数与系统结合点:对角右预条件可写成 write-key 缩放,而归一化 token-local 超梯度可消去高维记忆残差。 因而用很小的在线状态就能改变 DeltaNet 写入几何,同时沿用大部分 chunkwise 矩阵结构。340M 的受控召回与多尺度局部残差实验为这一机制提供了正面证据。 理论价值在于区分了理想总体优化和实际 token-local 优化,但其超几何结论有严格前提。实践价值也有明确边界:APF、不同宿主和更大规模有收益与损失并存,没有证明全面超过原骨干,更没有证明最终语言模型交叉熵超几何收敛。 匹配 seed 与数据顺序有利于减少混杂,但单 seed 不消除随机性;已有结果没有 seed bootstrap 置信区间。主文“相同 protocol”也不足以补齐未给出的 1.3B 训练超参数。本笔记指出这些问题是为了读准证据,并未据此声称整篇论文结论无效。2.5 两阶段与 chunkwise 公式
2.6 APF:遗忘预条件器校准
2.7 GDN/KDA 与 1.3B 配置差异
三:理论分析与实验设计
3.1 总体目标定理:理想 Newton 比较器
3.2 token-local 定理:与实现更接近,但对象更窄
3.3 为什么这不是记忆全局收敛定理
3.4 实验设置与指标
实验 协议与目的 指标 340M 匹配训练 FineWeb-Edu;20,480 步;每步 524,288 tokens,实际约 10.74B 控制骨干内架构差异 JRT cloze 2K context;FDA/SWDE/SQuAD 及各自 twice contains accuracy,越高越好;不是严格 EM 机制 replay 每个 twice 任务 16 prompts;fp32 回放每层每头 $q_{\rm geo}=\exp(\operatorname{mean}\log q_t)$,越低越好 LM WikiText/LAMBADA 两者 PPL 几何均值,越低越好 Common. PIQA/HellaSwag/WinoGrande/ARC-E/ARC-C/SIQA/BoolQ/LAMBADA 8 任务零样本准确率平均 LongBench 英文 14 任务 原文平均分,越高越好;逐任务值未报告 PG-19 20K blocks;每 2K 位置桶 Final corpus PPL 与后段漂移分开 检索 LM-eval DROP、NQ-Open、TriviaQA DROP F1;另两者空白归一化 EM 推理效率 单 H100,batch=1,2048 prefill+128 greedy decode;预热2次、测5次中位数 合计 tokens/s 与 decode ms 四:结果与证据解释
4.1 主结果:340M 的收益集中在受控召回
340M 模型 JRT 总体 ↑ 单次 ↑ 重复 ↑ LM PPL ↓ LongBench ↑ DeltaNet 0.150 0.155 0.145 32.00 0.072 OSDN 0.198 0.179 0.218 31.67 0.087 OSDN-APF 0.176 0.152 0.199 30.99 0.073 GDN 0.154 0.169 0.139 30.01 0.073 OSGDN 0.182 0.169 0.195 29.78 0.073 OSGDN-APF 0.203 0.185 0.221 29.50 0.080 KDA 0.168 0.187 0.150 26.75 0.088 OSKDA 0.175 0.218 0.133 27.93 0.090 OSKDA-APF 0.185 0.191 0.179 28.02 0.098 4.2 机制诊断:比值下降确实存在
模型 $q_{\rm geo}$ ↓ $q_{\rm arith}$ ↓ 相对本尺度 baseline 的 $q_{\rm geo}$ 下降 DeltaNet 340M 0.537 0.636 — OSDN 340M 0.433 0.566 19.4% OSDN-APF 340M 0.425 0.573 20.9% DeltaNet 1.3B 0.432 0.546 — OSDN-APF 1.3B 0.265 0.484 38.7% 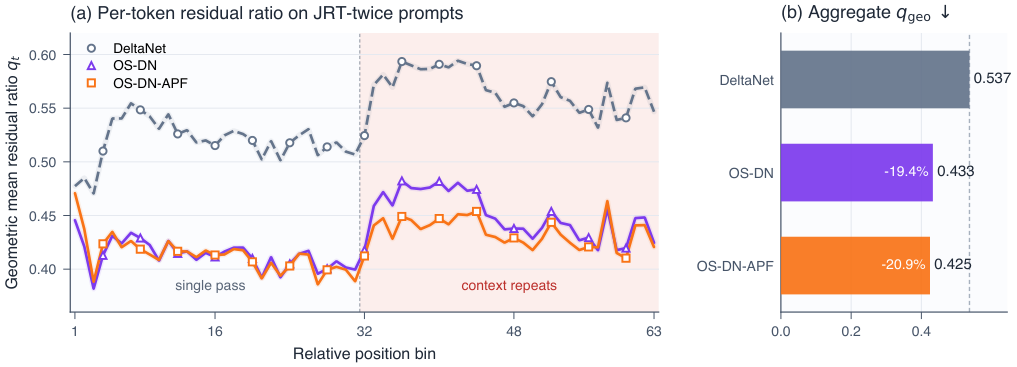
4.3 1.3B:更强的机制信号,接近持平的任务结果
指标 DeltaNet OSDN-APF 解读 WikiText PPL ↓ 17.23 18.42 变差 LAMBADA PPL ↓ 11.84 10.98 改善 两者 GeoMean ↓ 14.28 14.22 数值接近 FW-Edu pseudo-val PPL ↓ 8.71 9.10 变差 FDA/SWDE 单次 ↑ 0.293 0.315 +2.2 个百分点 FDA/SWDE 重复 ↑ 0.227 0.217 −1.0 个百分点 四项总体 ↑ 0.260 0.266 +0.6 个百分点 Common. ↑ 0.560 0.566 小幅差异 LongBench ↑ 0.115 0.116 小幅差异 4.4 PG-19:绝对 PPL 与漂移量必须分开
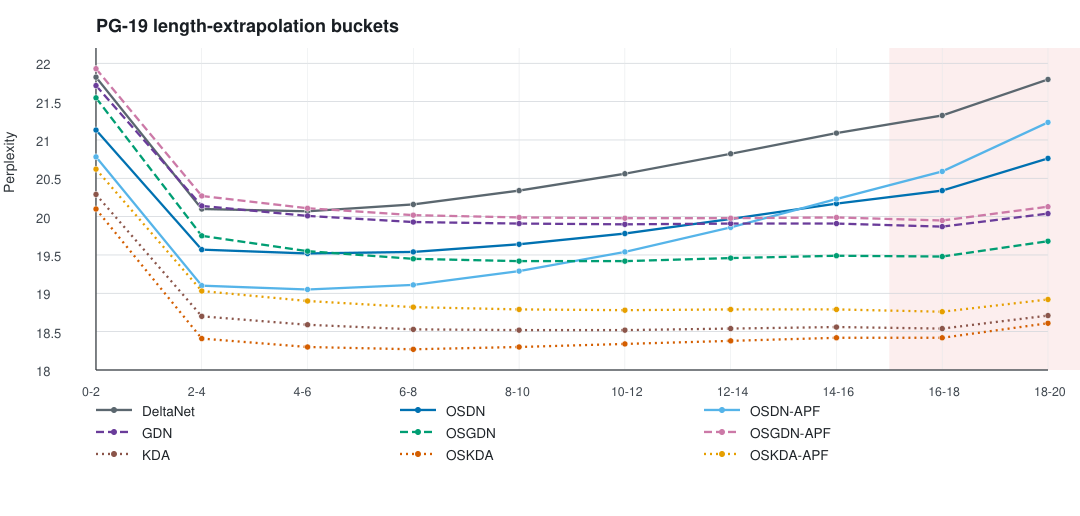
DeltaNet 家族 Final PPL ↓ 2–4K 18–20K 后段漂移 ↓ DeltaNet 20.78 20.10 21.79 +1.69 OSDN 20.02 19.57 20.76 +1.19 OSDN-APF 19.85 19.10 21.23 +2.13 4.5 初值消融与训练 CE
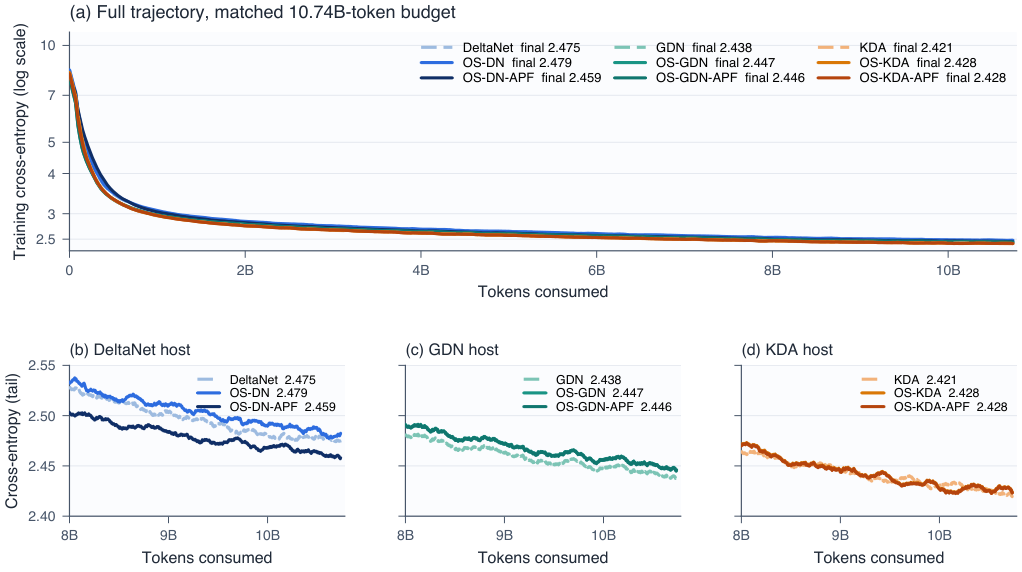
4.6 通用任务与开放域检索
4.7 吞吐与内存:低开销成立,百分比有算术问题
模型 合计 tokens/s ↑ 相对 baseline 常驻状态 MiB(bf16计数) DeltaNet 340M 784.5 — 6.000 OSDN 340M 782.7 −0.2% 6.047 OSDN-APF 340M 767.2 −2.2% 6.047 DeltaNet 1.3B 794.0 — 12.000 OSDN-APF 1.3B 739.9 −6.8% 12.094 五:结论、限制与后续问题
5.1 可以可靠带走什么
5.2 阅读中需保留的原文差异
差异或限制 原文位置 本笔记采用的处理 新增状态“≤0.05%”与 MiB 表格不符 pp.6/9/41–42 采用表格数值及 $1/V$ 推算,约0.4%–0.8% 训练2K与实际至多4K App.E p.32 vs App.F p.32、Fig.4 p.38 采用详细 packing/reset 协议的4K上限 1.3B phase-1 非 beta-aware App.B p.17、App.C p.20 与主文理论实现分开说明 OSKDA 固定保留0.999与最终 no-retention App.C p.23 vs App.F p.32 以明确标注 refreshed final 的 App.F 描述实验,复现需核对配置 OSDN-APF Common. 0.454/0.456 Table 14 p.38 vs Tables 1/9 pp.7/35 主结果采用0.456,消融差异不静默合并 Fig.1写 key使用 $d_{t+1}$,算法先输出 $d_tk_t$ Fig.1 p.2 vs Alg.1 p.5、Listing 1 p.21 实现顺序依据公式与算法;不复制该示意图作为正确伪代码 零残差扩展与闭式/比较器证明不完全衔接 App.D pp.28–29 非退化情形推导明确成立;零残差另行定义 “噪声内/持平”缺少显著性支持 Sec.6.3、App.K 仅作为点估计描述,不宣称统计等效 5.3 适合组会讨论或后续复现的问题
成品与复核记录
pdflatex;编译及逐页视觉检查结果见 quality-check.md。