ELF: Embedded Language Flows:中文精读笔记
作者: Keya Hu、Linlu Qiu(共同第一作者)、Yiyang Lu、Hanhong Zhao、Tianhong Li、Yoon Kim、Jacob Andreas、Kaiming He,MIT。
版本: arXiv:2605.10938v2,2026-06-26 修订;本次获取与研读日期:2026-10-14。
材料: arXiv · 原文 PDF · 作者代码入口 · 英文汇报 PDF。下文页码均为从 1 开始的 PDF 页码。
论文总览
ELF 要回答的问题是:连续扩散语言模型过去落后于离散模型,究竟是语言的离散性造成的,还是连续模型的设计还没有做好?它将整段文本表示成连续的上下文嵌入,用连续时间流匹配(Flow Matching)把高斯噪声逐步变成这些嵌入;直到最后一步,才让同一个 Transformer 切换到解码模式,把嵌入映射为词元。
关键组合包括:直接预测干净嵌入的 $\mathbf{x}$-prediction、共享权重的去噪与解码、利用前一次预测的自条件(self-conditioning)、在训练时学习的自条件无分类器引导(classifier-free guidance,CFG),以及针对少步生成的随机采样。这里的贡献在于连续与离散之间的接口设计及其有效组合,不能概括成首次把扩散或流匹配用于文本。
在 OpenWebText(OWT)上,105M 参数的 ELF-B 无需蒸馏,32 步达到生成困惑度 24.08 ± 0.16、平均 unigram entropy 5.15 ± 0.002;误差是六个评估随机种子的标准误。其估算的任务训练词元量为 45.2B。v2 新增 ELF+PD:固定 64 步教师、五轮渐进蒸馏后,8 步达到 23.18 / 5.07,1 步为 136.10 / 5.26,斜线两侧分别是生成困惑度和熵。条件生成中,ELF-B 的 WMT14 De-En BLEU 为 26.4,XSum ROUGE-1/2/L 为 36.0/12.2/27.8。(Sec. 4,PDF pp. 6–9;App. B,Table 4,p. 20;Table 9,p. 31。)
最有价值的启发是:把词元级监督集中到末端,可以保留连续生成过程的自由度,并复用图像生成中的引导、采样和蒸馏方法。证据主要来自小至中等规模的文本生成实验;质量判断仍需同时考虑多样性、条件忠实度和实际计算成本。
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与主要证据 |
|---|---|---|
| 1 Introduction | 提出连续 DLM 的设计空间问题 | pp. 1–2,Figs. 1–2 |
| 2 Background & Related Work | 区分嵌入、simplex、latent 和离散扩散路线 | pp. 2–3 |
| 3.1 The ELF Framework | 连续路径、预测目标、末端解码 | pp. 3–4,Fig. 3,Eqs. (1)–(2) |
| 3.2 Pseudocode | 两模式训练与迭代推理 | pp. 4–5,Algs. 1–2 |
| 3.3 Conditioning and Guidance | 自条件、训练时 CFG、输入条件 | pp. 5–6 |
| 4.1 Ablations | 表示、解码、引导、采样器、模型规模 | pp. 7–8,Figs. 4–6 |
| 4.2 / 4.3 System-Level Comparison | 无条件生成、翻译、摘要比较 | pp. 8–9,Fig. 7,Table 1 |
| 5 Conclusion | 连续 DLM 的质量与效率取舍 | pp. 9–10 |
| A Continuous Diffusion Language Model Survey | 按状态空间和离散化位置定位方法 | pp. 17–18,Table 2 |
| B Progressive Distillation of ELF | v2 新增的少步蒸馏及失败模式 | pp. 19–21,Eqs. (3)–(4),Fig. 9,Tables 3–5 |
| C Method Details | 两种噪声、自条件 CFG、采样算法 | pp. 21–25,Fig. 10,Eq. (5),Algs. 3–6 |
| D Additional Ablations | 预测目标、瓶颈、训练比例等七组消融 | pp. 25–29,Figs. 11–17 |
| E Experimental Details | 模型、预算、精确数值与条件基线配置 | pp. 29–32,Tables 6–11 |
| F Qualitative Examples | 去噪轨迹、无条件与条件生成、蒸馏样例 | pp. 33–39,Fig. 18 |
一:动机——离散输出是否要求每一步都预测词元?
1.1 过去方法的两类接口成本
离散扩散语言模型直接在词元空间中恢复被破坏的序列。MDLM 以掩码状态为中心,Duo 则使用更一般的词元扰动和修订。连续模型先把词元映射成向量,再去噪,但不少方法仍在中间时间点施加词元交叉熵,或在采样中进行取整、投影,使轨迹始终受离散词表约束。
另一类 latent diffusion 方法允许连续去噪,却依赖独立的文本解码器。这增加了模块和训练阶段,也使连续去噪与最终离散恢复之间多了一道接口。ELF 的选择是同时取消中间词元监督和独立解码网络,把末端解码视作同一网络的另一种工作模式。(Sec. 2,pp. 2–3;App. A,pp. 17–18。)
| 比较对象 | 与 ELF 的关键差别 |
|---|---|
| MDLM、Duo 等离散 DLM | 生成状态直接属于离散词元空间 |
| 许多 embedding / simplex 连续 DLM | 在训练中间步骤进行词元监督,部分方法推理时也离散化 |
| LD4LG 等 latent DLM | 使用独立的 latent-to-text 解码器 |
| FLM、LangFlow 等流模型 | 已采用连续流,但仍在中间轨迹使用词元级目标 |
| ELF | 连续嵌入状态、连续时间;CE 集中于解码模式;去噪与解码共享主干 |
“训练时逐步离散化”和“推理时逐步离散化”是两个维度。例如,有些方法推理全程保持连续,却在训练时让每个噪声水平都预测词元。ELF 同时改变了这两者与词表的关系。原文 Table 2 也列出例外,因此不能把所有既有连续 DLM 归为同一种方案。
1.2 设计背后的假设
本次的机制理解是:连续空间允许模型在确定词元前联合修正整段表示。上下文编码器提供一个已有语言结构的表示空间;直接预测干净向量,便于共享末端解码的参数。原文消融分别支持上下文表示和 $\mathbf{x}$-prediction 的作用,但没有单独对照只移除中间 CE 的影响。
二:方法——把生成路径和末端解码连成一个模型
2.1 数据流与符号
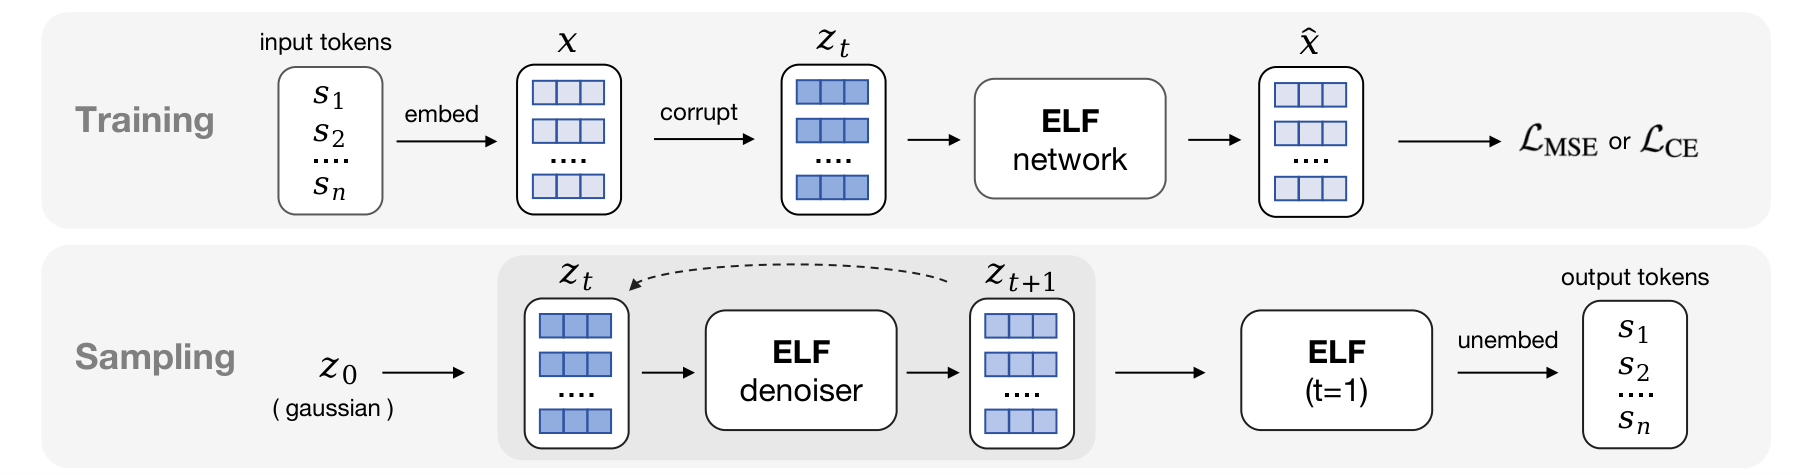
原文 Fig. 3,PDF p. 3。上行是训练:编码、扰动、预测,再按模式计算 MSE 或 CE。下行是推理:噪声经过多次连续更新,最后一次调用网络完成词元恢复。图中相邻状态表示相邻采样时刻,不代表时间变量每次加 1。
| 符号 | 含义与默认维度 |
|---|---|
| $\mathbf{s}\in V^L$ | 长度为 $L$ 的词元序列,$V$ 为词表 |
| $\mathbf{x}\in\mathbb{R}^{L\times d}$ | 编码后的干净上下文嵌入,默认 $d=512$ |
| $\boldsymbol\epsilon$ | 与 $\mathbf{x}$ 同形状的高斯噪声;具体实验另设噪声尺度 |
| $t\in[0,1]$ | 无量纲的连续时间,0 表示噪声端,1 表示数据端 |
| $\mathbf{z}_t$ | 时间 $t$ 的连续状态 |
| $\mathbf{x}_\theta$、$\mathbf{v}_\theta$ | 网络直接预测的干净嵌入,以及由它换算的速度 |
| $W$ | 将每个位置的预测映射到词表 logits 的可学习 unembedding 矩阵 |
| $\omega$ / $w$ | CFG 强度;正文与算法使用两种记号 |
默认编码器是冻结的 T5-small(35M)。ELF-B 主干为 12 层、hidden size 768、12 个注意力头,共 105M 参数;采用 SwiGLU、RMSNorm、RoPE、qk-norm。输入先经过 128 维瓶颈,再投影到主干宽度。512 维连续状态、128 维网络输入瓶颈和 768 维隐藏层是三个不同概念;这里没有把采样状态整体改成 128 维 latent。(Sec. 4,p. 6;App. E,Tables 6–7,p. 30。)
无条件生成从噪声开始,不需要在推理时运行 T5 编码器。条件生成需要取得源文本的干净嵌入,因此 Table 1 单独列出额外的 35M 编码器;“推理不需要编码器”的说法应限于无条件生成。
2.2 连续流与 $\mathbf{x}$-prediction
训练时,把一条真实嵌入和一份噪声用直线路径连接:
网络预测干净终点 $\mathbf{x}_\theta(\mathbf{z}_t,t)$,然后利用
得到速度。原文 Eq. (1) 的训练目标为
这说明 预测量是 $\mathbf{x}$,损失却在速度空间计算,并非普通的等权重嵌入重建。教学推导很直接:将真实速度也写成 $(\mathbf{x}-\mathbf{z}_t)/(1-t)$,相减即可得到右侧。临近 $t=1$ 时,同样大小的嵌入误差对应更大的速度误差;最终 $t=1$ 则切换解码模式,不在该点计算含零分母的速度。(Sec. 3.1,Eq. (1),p. 4。)
训练时每一对数据和噪声使用直线插值,并不意味着推理的完整轨迹是一条直线。模型必须根据当前混合状态估计适合总体分布的方向;不同位置和语义选择仍会在迭代中相互影响。
$\mathbf{x}$-prediction 有两个作用:一是相对容易表达结构化的干净语言嵌入,二是使去噪输出与解码输入的语义相容。App. D.1 的独立解码器控制实验显示,$\mathbf{v}$-prediction 在 512 维尚有竞争力,但在 768/1024 维明显恶化;$\boldsymbol\epsilon$-prediction 在所测配置中退化,$\mathbf{x}$-prediction 最稳定。低维数据流形是作者的解释,图中的实验结果是支持该解释的证据。(Fig. 11,p. 26。)
2.3 两种训练模式共享同一主干
每个样本以 0.8 概率进入去噪模式,以 0.2 概率进入解码模式。两类样本可以混在一个 batch 中,并通过 mode 控制词元区分。
| 模式 | 输入如何构造 | 网络任务 | 损失 |
|---|---|---|---|
| denoise,80% | 每条序列采样一个 $t$,再构造 $\mathbf{z}_t$ | 预测干净嵌入,并换算速度 | 速度 MSE;启用训练时 CFG 后更改目标 |
| decode,20% | 逐词元独立扰动干净嵌入,时间条件固定为 1 | 恢复适于词元分类的表示 | 词元交叉熵 |
解码目标是原文 Eq. (2):
如果训练解码器只看完全干净的编码器输出,它可能无法处理实际去噪留下的残差。ELF 因而在解码分支增加逐词元扰动,使网络利用周围上下文修复局部错误。注意:网络的时间条件仍是 $t=1$,不等于其训练输入完全无噪声。(Sec. 3.1,p. 4;App. C.1,pp. 21–23。)
具体噪声设置如下,均在嵌入归一化之后施加:
| 分支 | 扰动变量分布 | 高斯噪声尺度 |
|---|---|---|
| 去噪 | 每序列 $t=\sigma(u)$,$u\sim\mathcal N(-1.5,0.8^2)$ | 2 |
| 解码 | 每词元 $p_i=\sigma(u_i)$,$u_i\sim\mathcal N(0.8,0.8^2)$;$\tilde z_i=p_i x_i+(1-p_i)\epsilon_i$ | OWT 为 5;条件任务为 1 |
主文的双分支可以共用一次批处理;自条件训练还需要额外预测,不能把“共享主干”理解成整个训练过程完全没有额外前向计算。
2.4 自条件与两种不同的 CFG
自条件把模型对干净文本的当前猜测送回输入。训练时,先得到 $\hat{\mathbf x}'$,停止其梯度后,与噪声状态沿通道拼接;再用线性层将 $2d$ 维投影回 $d$ 维。去噪分支有 50% 概率使用该预测,其余使用零向量。推理时直接复用上一个采样时刻的预测,因此无需为获得自条件再做一次前向。解码分支始终使用零自条件。(Sec. 3.3,pp. 5–6;Algs. 3–5,pp. 22–24。)
普通 CFG 将有条件和无条件速度外推:
$\omega>1$ 时强化条件方向。ELF 的无条件文本生成也能使用 CFG,因为这里的“条件”可以是自条件预测,而不必是外部提示。
为避免每步算两遍,ELF 把自条件 CFG 放进训练。令网络输出的是已经引导的场,训练目标改为
该目标整体停止梯度;没有自条件的样本仍回归原始速度。$\omega=1$ 时修正项消失。训练时在 $[0.5,5]$ 采样引导强度,网络学习按指定强度直接给出引导后的预测。因此推理改变强度只需改变输入控制值。(App. C.1,Eq. (5),p. 23;Alg. 3,p. 22。)
模型前缀包含 4 个时间控制词元、4 个 CFG 控制词元、4 个模式控制词元。相较将异质条件合并进 adaLN-Zero,in-context conditioning 让它们进入双向注意力;该改动把 ELF-B 参数从 148M 降到 105M,消融中的质量也略有改善。
条件生成还存在第二种 CFG:输入条件 CFG。模型把源文本的干净嵌入放在目标序列之前,训练与推理均保留它们;训练时以 10% 概率清空源条件。推理按普通 CFG 组合有源条件与无源条件预测,这部分仍需要两路计算。主实验的自条件 CFG 为 1,输入条件 CFG 为 2,不能将“自条件 CFG 每步单次前向”的优点直接套到全部条件推理上。
2.5 推理:连续更新之后再解码
基本 ODE Euler 更新为
从高斯噪声开始,重复该更新,到达终点后进行一次 decode-mode 前向与 unembedding,逐位置取 argmax。一次去噪调用会联合更新整段序列,所以“32 步”指 32 次整段去噪更新,不是只生成 32 个词元。按 Alg. 5,$N$ 步无条件去噪还要额外加一次末端解码;步数不能直接当作端到端延迟或完全统一的 NFE。
时间网格使用 logit-normal 分布采样并排序,中间点服从与去噪训练相同的 $(-1.5,0.8)$ 参数,再补上 0 和 1。它把更多小步放在噪声较强的早期。
原文另给出一种受 SDE 启发的随机更新。设 $\gamma$ 为重新注入噪声的强度:
先在扰动后的 $(\mathbf z_{\mathrm{back}},t_{\mathrm{back}})$ 上预测 $\hat{\mathbf x}$,再使用原状态 $\mathbf z_t$ 和原时间 $t$ 计算上面的 Euler 更新。$\gamma=0$ 时回到 ODE。论文明确称它为 SDE-inspired 的实用近似,不能当成严格 SDE 离散化公式。作者认为重新扰动有助于修正早期错误;实验直接表明少步时的质量改善。(App. C.2,Alg. 6,pp. 24–25。)
2.6 v2 的 ELF+PD:让一步匹配教师的一段轨迹
若教师在 $[t,r]$ 内经过多个小步,将 $\mathbf z_t$ 推到 $\mathbf z_r$,学生希望用一个 Euler 步完成同一位移。令
直接解得原文 Eq. (3) 的目标:
此处匹配的是教师在一段时间上的位移。新的 $\tilde{\mathbf x}$ 是构造出来的学生目标,不应自动等同于真实文本的编码器输出。蒸馏分支采用上述嵌入 MSE,保留原来的解码 CE。(App. B.1,Eqs. (3)–(4),p. 19。)
| 蒸馏轮次 | 学生目标步数 | 每个学生步匹配的教师子步数 |
|---|---|---|
| 1 | 16 | 4 |
| 2 | 8 | 8 |
| 3 | 4 | 16 |
| 4 | 2 | 32 |
| 5 | 1 | 64 |
五轮一直使用同一个固定的 64 步教师。第一轮学生从教师初始化,后续学生从上一轮学生初始化;变化的是学生初始化与目标步数,而不是每轮更换为上一轮教师。每轮在 OWT 训练一遍,因此任务词元预算从约 45B 增至约 90B;该计数没有按教师前向次数折算总计算。(Table 3,p. 20;App. B.2,p. 19。)
三:实验——把评估协议和比较对象先对齐
3.1 数据与指标
| 任务 | 数据与序列 | 评估指标与含义 |
|---|---|---|
| 无条件生成 | OWT,约 9B 词元,打包到 1024 长度 | 生成 1,000 个样本,用 GPT-2 Large 计算 Gen. PPL,越低越符合该评估器的语言分布;同时报告平均 unigram entropy |
| 德英翻译 | WMT14 De-En,源 64 + 目标 64;约 144M 目标词元 | BLEU 越高越好,衡量与参考译文的重叠 |
| 单句摘要 | XSum,源 1024 + 目标 64;约 6M 目标词元 | ROUGE-1/2/L 越高越好,分别侧重 unigram、bigram、最长公共子序列重叠 |
这里的 Gen. PPL 不是 ELF 对真实验证集的似然困惑度。它评价的是生成文本在另一个语言模型下的分数,容易受到重复、常见表达偏好等影响。unigram entropy 反映词汇多样性,但不能保证语义连贯或事实正确。因此主要图都把 PPL 与熵同时展示;理想前沿是 PPL 更低、熵相当或更高。(Sec. 4,p. 6。)
3.2 不同实验使用不同配置
| 实验 | 关键设置 |
|---|---|
| 默认 ELF-B 训练 | Muon,学习率 0.002,batch 512,OWT 5 epochs,EMA 0.9999 |
| 默认主文消融 | ELF-B,64 步 ODE,扫自条件 CFG;个别采样消融单独说明 |
| 8 / 16 / 32 步无条件系统比较 | SDE-inspired,SC CFG=3;$\gamma=2/2/1.5$ |
| 模型规模比较 | B/M/L 为 105M/342M/652M;OWT 分别训练 5/4/3 epochs;64 步,SDE 时 $\gamma=1$ |
| 翻译与摘要 | 各训练 100 epochs;验证集选择 64 步 ODE,SC CFG=1,输入 CFG=2 |
| ELF+PD 1/2/4/8 步 | $\gamma=1.5$、SC CFG=2.5 |
| ELF+PD 16/32 步 | $\gamma=2$、SC CFG=2 |
这些设置分别来自 Sec. 4、App. B.2 和 E.2;不能把 64 步、$\gamma=1$ 的消融数值与少步系统比较混用。
3.3 baseline 与成本口径
无条件比较同时包含离散模型 MDLM/Duo、连续流模型 FLM/LangFlow,以及经过额外训练的 MDLM+SDTT、Duo+DCD、FMLM。ELF-B 为 105M,所列无条件基线约 170M,属于系统级比较而非统一架构下只改一个损失的实验。
Table 8 以 batch × steps × length 估计有效训练词元:MDLM、Duo、FLM、LangFlow 为 524.3B,ELF 为 5 × 9.04B = 45.2B,比例约 11.6。这是所列生成模型训练阶段的数据处理量,没有纳入 T5 编码器此前的预训练,也不等价于 FLOPs、训练总时长或包括自条件额外前向的计算账单。ELF+PD 的约 90B 还需另外考虑教师采样成本。(Table 8,p. 31;Fig. 9,p. 20。)
条件生成比较混合了文献报告与作者复现结果。WMT14 大多数基线取自既有论文,Duo 为复现;XSum 的 AR/MDLM/E2D2/Duo 为复现,SeqDiffuSeq 来自文献。AR/MDLM/E2D2 的 XSum tokenizer 使用 Qwen3-0.6B,Duo 使用 T5-small;MDLM 采用 block size 32 的两块生成,E2D2 为 8,Duo 调整为带源编码和 CFG 的条件版本。因此 Table 1 能说明这些完整系统的结果,却不能把全部差距单独归因于连续或离散状态。(Table 11,p. 32;App. E.5,p. 31。)
四:结果——连续设计在哪些条件下奏效?
4.1 主文消融:表示和引导共同决定质量前沿
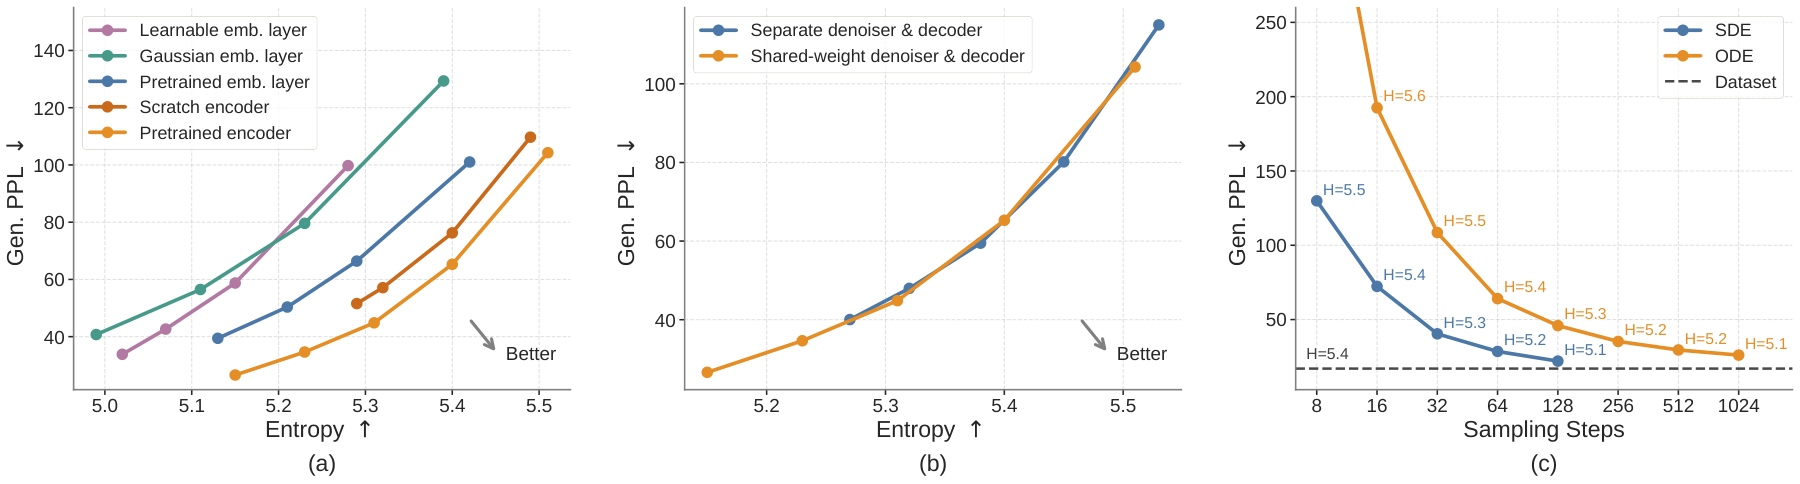
原文 Fig. 5,PDF p. 7。左、中两图横轴是熵、纵轴是 Gen. PPL,向右下方移动更好;每条线通过扫描 CFG 得到。右图横轴改为采样步数,点旁的 H 是对应熵,比较步数时仍须保留该信息。
CFG 强度。 增大引导通常降低 PPL,也降低熵。在 64 步 ODE 的 ELF-B 上,SC CFG 从 0.5 到 1、2、3 时,PPL/熵分别为 104.29/5.51、65.30/5.40、34.65/5.23、26.62/5.15。它是质量与多样性的调节旋钮;并非强度越大越好,Table 10 中 B/M 模型的 SDE 结果在强度超过 3 后反而恶化。(Fig. 4,p. 7;Table 10,p. 32。)
嵌入选择。 冻结的预训练上下文编码器前沿最好;在 OWT 上从头训练的 T5 编码器略逊但仍较强。无上下文的预训练词表优于固定随机高斯词表,联合学习的词表最差。该结果支持“上下文表示有帮助”,也表明并非任意可学习连续空间都会自动变好。由于预训练与从头训练的资源不同,这组实验不能单独排除预训练知识的作用。(Fig. 5a;App. E.3,pp. 29–30。)
共享解码与独立解码。 两者的质量—熵前沿接近,共享版本能进一步进入低 PPL 区域,还减少独立解码阶段与模块。论文的主要支持点是简化接口且不损害整体质量,不是共享版本在所有点上都有大幅领先。(Fig. 5b,pp. 7–8。)
采样器。 SC CFG=1 时,SDE-inspired 在少步区域显著优于 ODE;点旁的熵也随采样器变化。它支持将随机扰动作为少步误差修正手段,机制解释仍是作者提出的假说。(Fig. 5c,p. 7;Sec. 4.1,p. 8。)
模型规模。 应比较扫过 CFG 后的质量前沿,而非同一个 CFG 下的裸 PPL。一个可直接核对的等熵例子是:64 步 SDE 下,ELF-B 在 CFG=0.5 时为 36.77/5.28,ELF-L 在 CFG=3 时为 23.31/5.28;在相同报告熵处,后者 PPL 低约 36.6%(本次按表值计算)。另一方面,同为 CFG=3,B 的 PPL 是 19.72,L 是 23.31,但 L 的熵为 5.28、B 为 5.10,不能据此说小模型更好。(Fig. 6,p. 8;Table 10,p. 32。)
4.2 无条件系统比较:32 步结果强,但要保留熵与预算
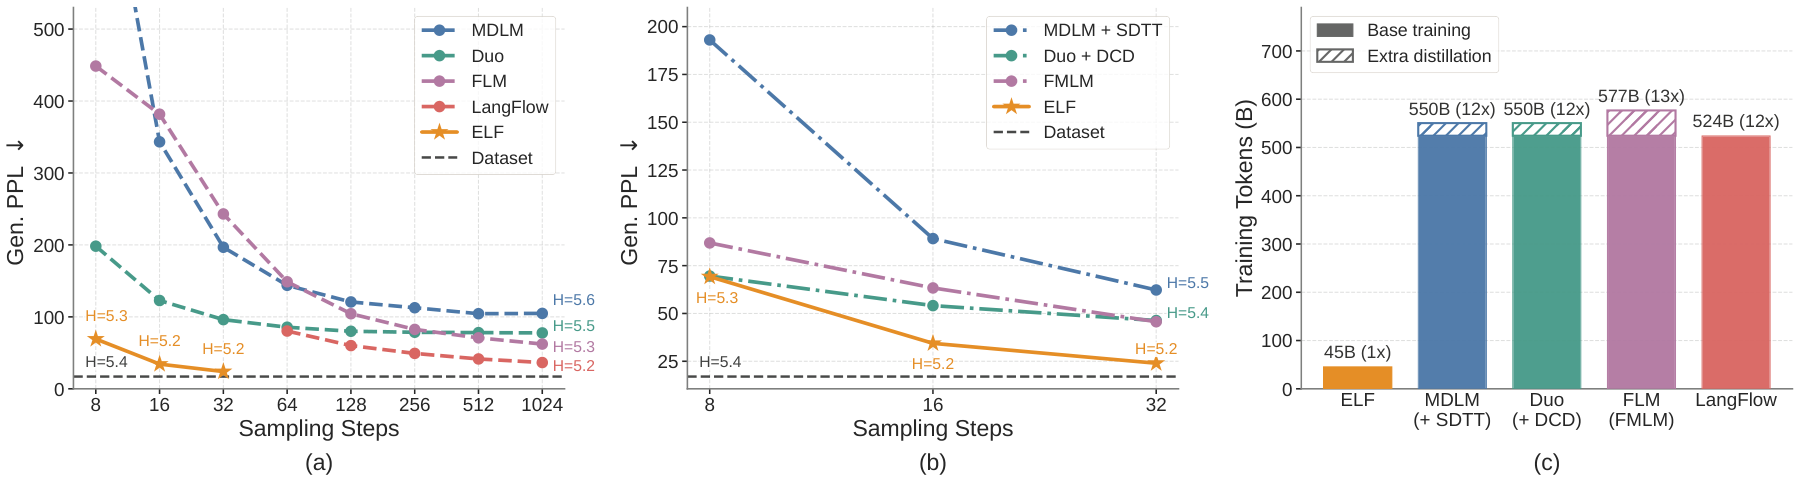
原文 Fig. 7,PDF p. 8。面板 (a) 对比未蒸馏模型;(b) 用未蒸馏 ELF 对比其他方法的蒸馏版本;(c) 展示估算训练词元量。前两图横轴为采样步数、纵轴为 Gen. PPL,末端或点旁标出熵,不能将它们理解为严格匹配熵的延迟测试。
| ELF-B 步数 | SC CFG | $\gamma$ | Gen. PPL ↓ | 平均 unigram entropy |
|---|---|---|---|---|
| 8 | 3 | 2.0 | 67.32 ± 2.25 | 5.14 ± 0.085 |
| 16 | 3 | 2.0 | 33.66 ± 1.09 | 5.16 ± 0.026 |
| 32 | 3 | 1.5 | 24.08 ± 0.16 | 5.15 ± 0.002 |
来源:Table 9,PDF p. 31,六个评估随机种子的均值 ± 标准误,不是六次独立预训练。步数从 8 增至 32 时,PPL 大幅降低,而这三个配置的熵保持在约 5.15。图中的 ELF 也在较少步数下达到比所列离散和连续基线更低的 PPL。
比较的实际意义是:在这套 1024 词元 OWT 生成协议中,ELF 提供了有竞争力的质量、步数和任务训练数据量组合。其优势来自表示、损失、引导、优化器、采样器的完整配置;Fig. 7 不是实测端到端吞吐曲线。
4.3 条件生成:翻译和摘要均领先所列基线
| 模型 | 参数口径 | WMT14 BLEU ↑ | XSum R1 ↑ | XSum R2 ↑ | XSum R-L ↑ |
|---|---|---|---|---|---|
| AR | 99M | 25.2 | 30.5 | 10.2 | 24.4 |
| MDLM | 99M | 18.4 | 33.4 | 11.6 | 25.8 |
| Duo | 170M + 35M | 21.3 | 31.4 | 10.1 | 25.0 |
| E2D2 | 99M | 24.8 | 28.4 | 8.3 | 22.0 |
| SeqDiffuSeq | 未列 | 21.3 | 19.3 | 1.7 | 14.1 |
| CDCD | 未列 | 24.9 | — | — | — |
| ELF-B | 105M + 35M | 26.4 | 36.0 | 12.2 | 27.8 |
来源:Table 1,PDF p. 9;这里为便于比较摘录中心值。ELF 的 XSum 标准误分别为 ±0.13、±0.11、±0.12,原文按评估样本计算,不能解释为训练重复之间的波动。
BLEU 相比所列最强 AR 基线提高 1.2 分;XSum 相比 MDLM 分别提高 2.6、0.6、2.0 个 ROUGE 分。这些是指标的绝对分差,不是相对百分比。条件 CFG 从 1 增至 2 带来明显收益,继续增大则逐步变差。(Sec. 4.3,p. 9;Fig. 17,p. 28。)
原文有一处会影响读数的标注问题:Fig. 17 右图纵轴写作 ROUGE-1,最优值约 27.8;Table 1 则将 27.8 列为 ROUGE-L、36.0 列为 ROUGE-1。这里采用 Table 1 报告具体结果,仅用 Fig. 17 支持“适中输入引导最佳”的趋势,不将其点值当作 ROUGE-1 的再次测量。
4.4 渐进蒸馏:少步质量改善与一步生成的剩余差距
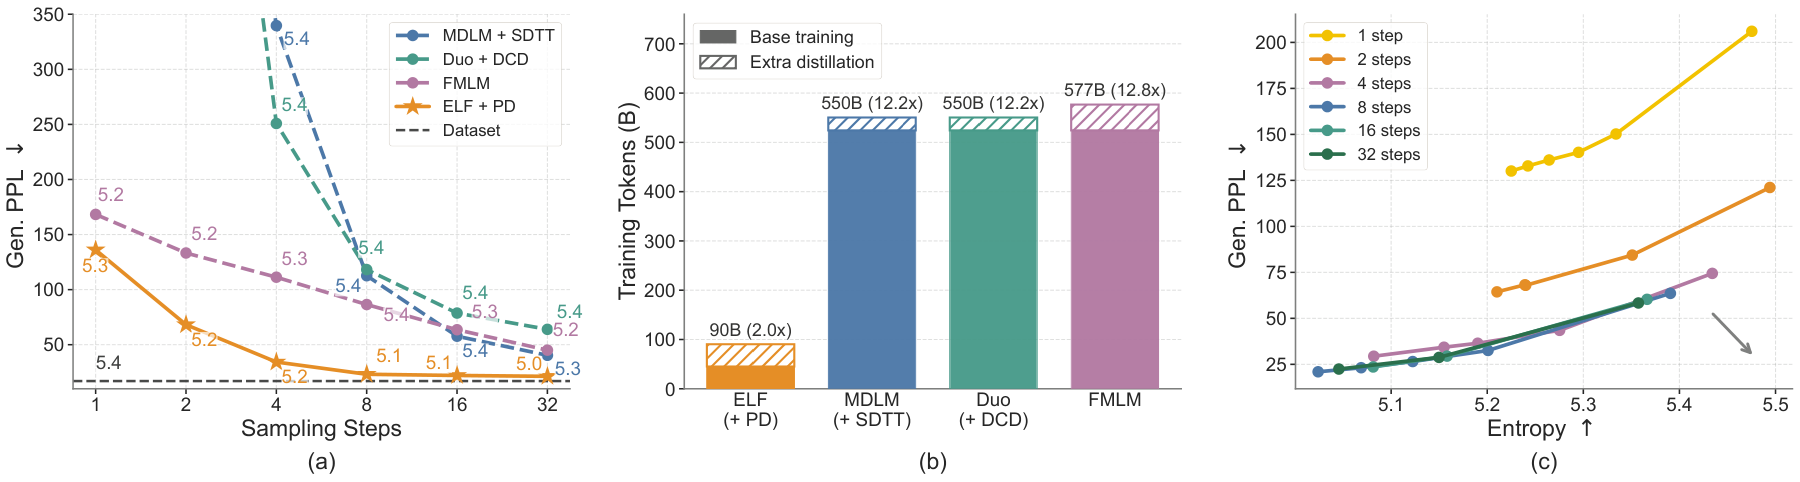
原文 Fig. 9,PDF p. 20。左图比较不同步数下的 PPL 并标注熵,中图是训练词元估算,右图固定噪声配置后扫 CFG。右图只展示熵大于 5 的点;它显示 8–32 步前沿接近,而 1–4 步仍有明显质量损失。
下表每格为 Gen. PPL / entropy,来自 Table 4,PDF p. 20。使用五轮蒸馏后的最终学生,在不同采样步数下评估。
| 步数 | MDLM+SDTT | Duo+DCD | FMLM | ELF+PD |
|---|---|---|---|---|
| 1 | 1260.60 / 5.26 | 5743.90 / 6.02 | 168.30 / 5.17 | 136.10 / 5.26 |
| 2 | 877.22 / 5.34 | 891.16 / 5.41 | 133.29 / 5.25 | 68.25 / 5.24 |
| 4 | 339.73 / 5.38 | 250.86 / 5.37 | 111.31 / 5.26 | 34.33 / 5.16 |
| 8 | 112.66 / 5.41 | 118.21 / 5.41 | 86.50 / 5.36 | 23.18 / 5.07 |
| 16 | 57.74 / 5.39 | 78.74 / 5.43 | 63.63 / 5.29 | 22.12 / 5.06 |
| 32 | 40.41 / 5.34 | 63.98 / 5.40 | 45.09 / 5.25 | 21.32 / 5.04 |
ELF+PD 在表中各步数具有最低 PPL;8 步 PPL 比 FMLM 低约 73.2%(本次由表值计算),但熵也从 5.36 降至 5.07。因此应称为“报告配置下更低 PPL、仍保持一定多样性”,不能把这个百分比说成等多样性下的纯质量提升。1 步相对 FMLM 的 PPL 改善约 19.1%,但 136.10 仍远高于自身 8 步的 23.18。
课程消融提供了最直观的指标陷阱:第二轮学生强行 1 步采样,PPL 低至 1.7,熵却只有 0.64,属于重复退化。最终一轮的 1 步 PPL 是 136.1,熵恢复到 5.26;PPL 数值变高,生成实际上摆脱了塌缩。原文将熵低于 5 的这类点标记为退化。(Table 5,p. 21。)
4.5 补充消融逐项说明了什么?
| 原文小节 | 被检验的问题 | 主要观察与解释 |
|---|---|---|
| D.1 Prediction Targets,Fig. 11,pp. 25–26 | $\mathbf{x}$、$\mathbf{v}$、$\epsilon$ 哪种参数化适合高维嵌入? | 在冻结编码器和独立解码器的控制设置中,$\mathbf{x}$ 随 512→1024 维最稳定;$\mathbf{v}$ 高维退化;$\epsilon$ 产生低熵或高 PPL |
| D.2 Bottleneck,Fig. 12,p. 26 | 瓶颈越小越好吗? | 32 维容易以牺牲熵换低 PPL,512 维 PPL 较高,128 维在 SDE 下最均衡 |
| D.3 Denoising Mode Probability,Fig. 13,pp. 26–27 | 主干的训练容量如何分给两种任务? | 去噪比例过低会伤害前沿,0.8 在所测配置中最好 |
| D.4 Conditioning Strategies,Fig. 14,p. 27 | 用控制词元还是 adaLN-Zero? | 控制词元略改善质量,并将参数从 148M 降至 105M |
| D.5 Optimizers,Fig. 15,pp. 27–28 | 优势是否依赖优化器? | 调参后的 Muon 优于 AdamW,SDE 下更明显;作者报告两种优化器的 ELF 都优于所列基线 |
| D.6 Sampling Methods,Fig. 16,pp. 28–29 | 网格与随机扰动分别有什么作用? | logit-normal 网格少步优势更明显;适中增加 $\gamma$ 降低 PPL,同时稍降熵;默认消融取 $\gamma=1$ |
| D.7 CFG on Conditional Generation,Fig. 17,pp. 28–29 | 源文本引导是否越强越好? | 两任务均在输入 CFG=2 最佳,再增强则退化;指标标注问题见上一节 |
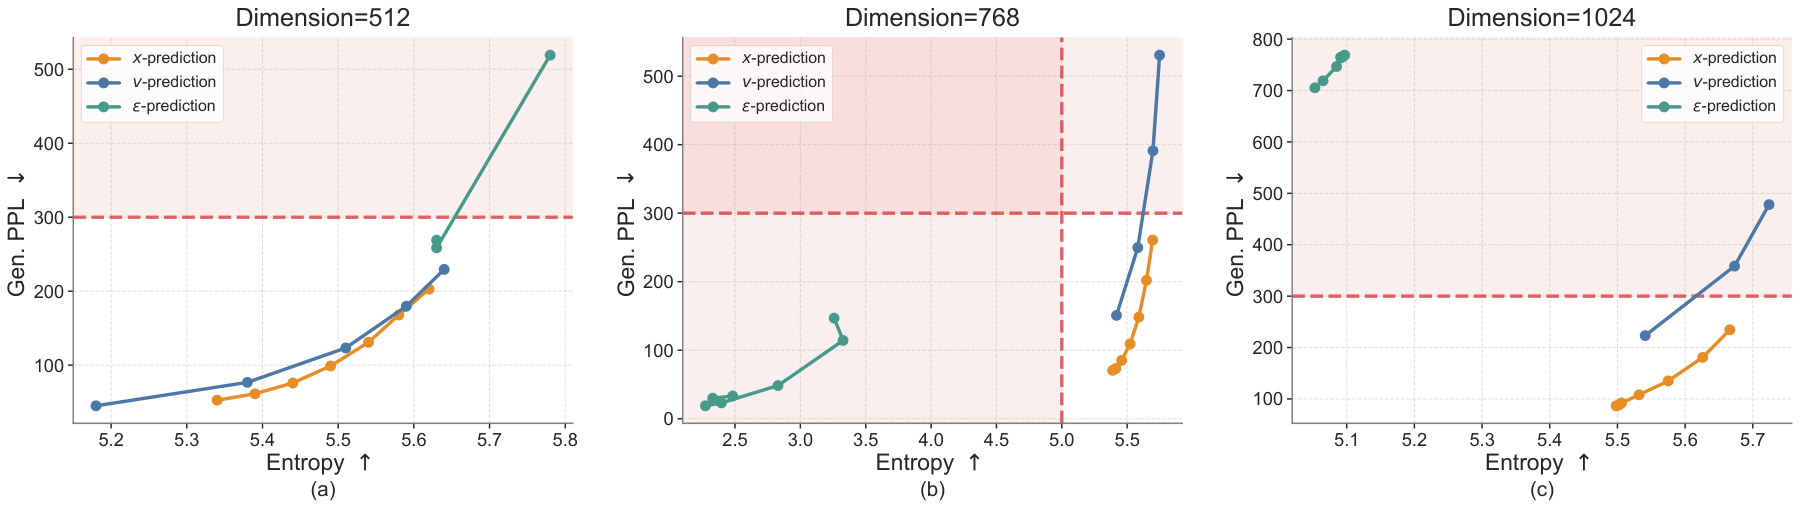
原文 Fig. 11,PDF p. 26。三面板依次为 512、768、1024 维;横轴熵、纵轴 PPL,红色区域表示熵低于 5 或 PPL 高于 300。这组对照使用两阶段独立解码器与 adaLN-Zero,不能将曲线数值直接当作默认共享主干系统的性能。
4.6 定性样例:自动指标没有覆盖的失误
Fig. 18 展示从重复词元到较完整句子的演化;这是一种对中间状态的可视化,实际采样仍在连续空间里进行,不需要每步执行图中的词元读出。(App. F.1,p. 33。)
下面是基于作者附录样例的具体阅读判断:
- 翻译语义偏移: 将美国的“26 个州”译为“26 个国家”,还出现拼写重复;另一例混淆美国、州与各国的关系。(App. F.3,pp. 34–35。)
- 摘要事实错误: Voges 的例子中,参考摘要描述小腿肌肉撕裂、缺席至八月,生成摘要却写成骨伤,并改变了原文对缺席时间的表达;另一个摘要重复人物名并扭曲政治人物的投票建议。(pp. 35–37。)
- 低 PPL 仍可能缺乏连贯内容: ELF-B 的科技样例虽然 Gen. PPL 为 21.04,却混杂公司、产品与虚构功能;蒸馏后的 8 步样例 PPL 为 19.22,仍反复改述“基础教育”和“政治问题”,语义推进有限。(pp. 33–34、38–39。)
- 一步蒸馏的语言质量仍弱: App. F.4 的一步例子包含大量重复与语法损坏,与 Table 4 的相对较高 PPL 一致。(p. 37。)
这些观察不改变 Table 1 的指标优势,但会改变对“流畅、忠实、可直接使用”的判断。BLEU/ROUGE 与 PPL/熵覆盖了文本质量的一部分,还需要语义和事实层面的评估。
五:结论——应保留的贡献与实际取舍
ELF 最重要的贡献是提供了一个有效的连续语言生成接口:以高维上下文嵌入作为状态,让主干直接预测干净数据,并通过末端模式切换完成词元恢复。训练时自条件 CFG 使质量调节不必增加无条件推理的逐步前向次数;SDE-inspired 采样和渐进蒸馏进一步改善了少步结果。
从方法设计看,有三点值得带走。第一,离散输出并不迫使每个中间状态都承担词元分类任务。第二,预测参数化要与表示维度和最终解码任务一起选择;$\mathbf{x}$-prediction 在这里同时服务两者。第三,好的数值指标来自整个系统的协同,噪声日程、优化器、条件注入和训练任务比例都能显著影响结果。
对实际使用最有影响的取舍也很具体:共享主干减少模块,却仍需一次末端解码;条件输入引导仍有两路计算;T5 表示带来已有语言结构,但其预训练资源不在 45.2B 的任务训练账单内;蒸馏的词元预算也没有反映教师轨迹计算。论文给出了步数和任务训练量优势,尚不能据此换算成统一硬件上的延迟倍数。
证据覆盖到 652M 模型和 OWT、翻译、摘要三类设置,其中条件输出长度为 64。最有价值的下一步是,在计入编码器与教师成本的统一预算下,测量端到端延迟,并补充条件忠实度和长文本语义连贯性的评估。尤其应检查少步生成是否能在保持语义质量的同时维持当前的 PPL—熵前沿,而不是仅继续压低 PPL。
一句话判断: ELF 有力支持了连续嵌入流作为语言生成路线的可行性;其最强证据是质量—多样性—采样步数的组合改善,而一步高质量生成和可靠条件语义仍有明显空间。