Key-Value Means:可扩展分块循环压缩记忆的中文精读
论文:Key-Value Means: Transformers with Expandable Block-Recurrent Compressed Memory
作者:Daniel Goldstein、Navneel Singhal、Eugene Cheah;前两位共同一作。
版本:arXiv:2605.09877v5,2026-08-03 修订;本次获取与研读日期:2026-09-22。
原始材料:本地论文 PDF(23 页)、同版本作者 main.tex 和五份所用原图;源码获取成功。已阅读正文全部章节及附录 A–G,并用 PDF 核对身份、公式、图表与页码。参考文献用于核对本文背景,不代表逐篇阅读所引文献。未运行作者训练代码或复现实验。本文页码均为 PDF 页码,与原文印刷页码一致。
配套汇报:英文 Beamer PDF · 可编辑 TeX。
论文总览
KVM 把长上下文记忆做成一个可选容量的在线压缩过程:近期 token 保留精确的分块滑动窗口,较早的 token 退出窗口时,根据 key 相似度追加为新记忆槽或并入已有槽;查询通过同一次 softmax 同时读取两部分。记忆既可固定为 256 个槽,也可按 $16\sqrt{N}$ 增长,从而在状态容量、计算量和检索能力之间连续调节。
最有说服力的证据是增长记忆相对固定记忆的收益具有明确任务条件。350M 模型在 NIAH-S3 的 16K 上,从 KVM-256 的 3.0 提升到 KVM-sqrt 的 77.6;但 32K 时后者也只有 36.6。KVM-sqrt 的全 RULER-4K 平均分 38.6 低于全注意力 GPTA-2 的 47.2。因此,这篇论文支持一种有效的容量—成本折中,而不是“压缩后全面优于全注意力”。(Table 2,p.8)
论文报告 32K 时 KVM-256 的单层序列混合 decode 加速为 29.77 倍,KVM-sqrt 为 7.88 倍;不包括投影、位置编码和其他层计算,不能当作端到端模型加速。(Sec.5,pp.8–9)
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与证据 |
|---|---|---|
| 1 Introduction | 固定状态与完整 KV cache 之间的容量选择 | pp.1–2;Fig.1、Table 1 |
| 2 Background | 压缩、更新时机、度量和位置编码的设计选项 | pp.2–3 |
| 3.1 Overview | 近期窗口与压缩状态的整体流程 | pp.3–4;Fig.2 |
| 3.2 KVM Formulation | 预处理、读出、追加、合并、预算 | pp.4–7;Fig.3、Eqs.(1)–(4),其余关键公式未编号 |
| 4 Language modeling performance | 长位置损失、短任务、检索和综合长任务 | pp.7–8;Fig.4、Table 2 |
| 5 Speed Benchmarks | 单层序列混合计时 | pp.8–9;Fig.5 |
| 6 Ablation studies | sink、温度、value 半径、merge gate | p.9;Table 3 |
| 7 Conclusions | 贡献和未验证的应用方向 | pp.9–10 |
| A Related Work | 与 BRT/FAM/NHA、LRNN/TTT、OVQ 等比较 | pp.16–17 |
| B Pseudocode | 实现顺序与批量 attention 的关系 | pp.17–18 |
| C GPTAlpha-2 Transformer Architecture and Backbone | 实验骨干的 QKV、token shift、value residual、MLP | pp.18–19;Eqs.(5)–(13) |
| D Training details and Hyperparameters | 优化器和缩放规则 | p.19 |
| E Short-context evals | 六项短任务及消融 | pp.19–20;Tables 4–5 |
| F Extrapolation and partial RoPE ablations | 不同外推指标可能相互背离 | pp.19–21;Fig.6、Tables 6–7 |
| G Design choices | 归一化、路由、增长和位置编码的设计理由 | pp.21–23 |
参考文献位于 pp.11–15;AI 使用说明位于 p.10。
一:动机——为什么让记忆缓慢增长
1.1 问题不是单纯减小 KV cache
全注意力对每个历史 token 保留一个 key/value 对。序列越长,缓存越大,每个新查询也需要扫描越多历史位置。固定状态 RNN 将历史写进大小不变的状态,成本稳定,但遇到不断增加且不可压缩的细节时,状态容量成为瓶颈。KVM 允许状态小于原始历史、却仍随历史增长。(Sec.1,pp.1–2)
如果干扰内容高度重复,少量槽可以反复吸收类似信息;如果干扰内容始终新颖,更多槽才可能避免目标信息被混合掉。这是作者解释 NIAH-S1 与 S2/S3 差异的主要思路,但论文并未对信息冗余度做独立控制实验,不能把它当成已经证明的因果机制。(Sec.4,pp.7–8)
1.2 KVM 的位置
| 路线 | 状态与更新方式 | 与本文的主要区别 |
|---|---|---|
| 完整 attention | 逐 token 追加原始 KV | 保留全部历史,但状态线性增长 |
| BSWA | 最近若干块,整块退出 | 没有压缩长期记忆 |
| RWKV-7 等 LRNN | 固定矩阵状态、递归更新 | 容量固定;本文 RWKV-7 还使用不同骨干 |
| BRT / TransformerFAM | 分块更新工作记忆 | 提供分块循环思路,具体状态更新与 KVM 不同 |
| NHA | 同一 softmax 读局部窗口和长期槽 | 长期槽数量固定,更新为平滑的循环机制 |
| OVQ | 最相似槽的在线向量量化 | 本文对照为与 SWA 交替的混合层;需计数,状态有上限 |
| 训练后 KV 合并 | 以少量代表 KV 近似原注意力 | KVM 在训练中学习适应压缩状态,不保证近似原 full-attention 输出 |
依据 Sec.2、Appendix A(pp.2–3、16–17),仅概括本文描述,不构成对这些外部论文的独立复核。KVM 的贡献在于单层读出、可扩展槽、硬路由、归一化与位置处理的组合;不能把“相似 key 合并”本身说成本文首次提出。
二:方法——从输入到压缩记忆再到输出
2.1 符号、状态与块时序
| 符号 | 含义与形状 |
|---|---|
| $T$ 或 $N$ | 序列 token 数;论文不同部分使用不同字母 |
| $\mathbf{x}_t\in\mathbb R^d$ | residual stream 输入 |
| $H,d_h$ | 头数、每头维数 |
| $\mathbf q_t,\mathbf k_t,\mathbf v_t\in\mathbb R^{d_h}$ | 单头查询、键、值 |
| $C$ | chunk 长度;主要实验为 256 |
| $L=\mathtt{n\_bswa\_chunks}C$ | BSWA 最大窗口;主要 KVM 实验为 512 |
| $m$ | 当前压缩状态行数,不包括 BSWA |
| $\mathbf s_i^K,\mathbf s_i^V$ | 槽 $i$ 的持久 key/value 累积和 |
| $\rho_i$ | 槽创建时保存的 value 的二范数;此后不更新 |
| $S=1$ | 前一个状态槽作为 sink,禁止其他 token 合并进入 |
| $\mathcal B(e)$ | 为下一块预设的状态预算 |
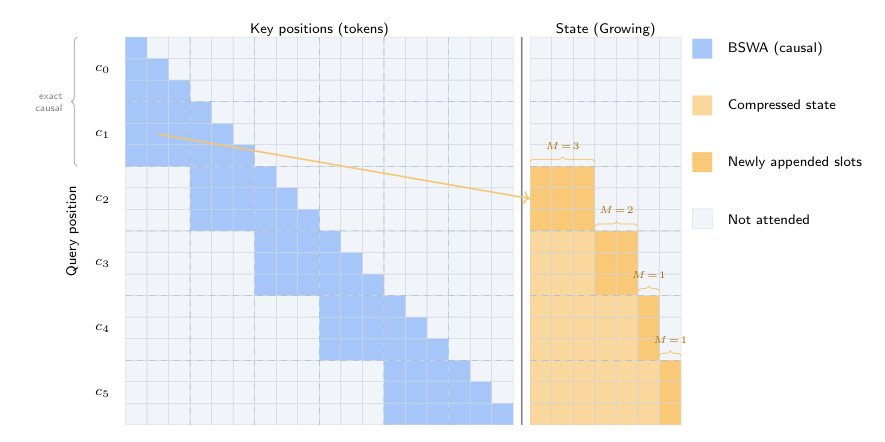
来源:Fig.2,p.4;复用作者矢量原图并转为 PNG。纵轴是查询位置,横轴左侧为原始 key 位置,右侧为压缩状态;蓝色为局部因果注意力,橙色为可读的历史状态,深橙强调新增槽。图中的 $C=3,L=6$ 是示意配置,不能与实验 $C=256,L=512$ 混用。开头两个块使用精确因果注意力;进入循环区后,较早块的信息由状态接替。
对当前查询块 $[s,e)$,窗口起点为 $b=e-L$。查询先读已有状态和窗口 $[b,e)$,随后退出窗口的块 $\Omega_e=[b,b+C)$ 更新状态,供下一块使用。状态初次创建时复制第一个块,该块不能再当 overflow 合并一次。附录 B 伪代码改成“先并入上一轮退出的块、再读当前块”,两者时序等价。(Sec.3.2,pp.4–6;Appendix B,pp.17–18)
窗口内的查询仍必须遵循 causal mask;不能因按块计算就让块内早期 token 看到未来 token。
2.2 key 预处理与门控:位置与写入强度分开
对退出窗口的 token,作者先将已使用 partial RoPE 的 key 的前 $r$ 个旋转通道清零,再使用带偏置的 LayerNorm:
写入门是每头一个、依赖输入的正标量:
对应 Eqs.(1)–(4),p.5。$g_t$ 控制这个 token 对目标槽的影响大小,不是遗忘门:更新公式没有把旧槽乘以衰减系数。理想实数计算下 $g_t>0$,所以它不改变同一 token 对不同槽的 argmax 排序;它影响合并权重。
位置处理的精确含义:局部窗口保留 partial RoPE;压缩 key 丢弃原始旋转子空间的内容。不能将此说成“将 RoPE 逆旋转后保留全部信息”,也不能直接称最终 key 的前 $r$ 维恒为零,因为清零之后还要经过带仿射参数的 LayerNorm。论文没有证明整个压缩注意力严格位置不变;安全的解释是其意图去掉被合并 token 的显式旋转位置信息,同时付出部分表达能力的代价。(Appendix G,pp.22–23;本段后半为公式核读)
2.3 初始状态与 just-in-time 读出
初次状态长度为 $C$:
初始化和后续 append 都使用未乘 merge gate 的 $\bar{\mathbf k}$ 和 $\mathbf v$。只有被合并的 token 使用 $g_t$。(p.5、p.6)
持久状态存累积和,在读出时临时归一化:
这里 $\epsilon_{\mathrm{norm}}>0$ 避免除零;在范数不小于该阈值时,value 读出长度恢复为创建时的 $\rho_i$。更新主要改变读出方向,而非令读出长度随着合并数无限增长。持久状态本身不会被这个临时读出归一化覆盖。(pp.5–7)
这解释了为什么不必保存每个槽的计数:最后要读的是经过归一化的方向,不是未经处理的算术均值。作者把 key 的处理解释成加权均值再映射到平移的超椭球。由于 LayerNorm 的数值稳定项,严格的尺度不变是理想化理解;本文没有给出误差定理。
教学例子(不是原文实验):两个单位 value 为 $(1,0)$ 与 $(0,1)$,等权平均的长度是 $1/\sqrt2$;恢复到半径 1 后变为 $(1/\sqrt2,1/\sqrt2)$。归一化解决长度缩小,却不能从这个方向恢复两个原始 value。若向量完全相消,归一化也不能找回丢失信息。因此“半径保持”不等于“无损压缩”。
2.4 一次 softmax 让近期信息与历史状态竞争
来源:Sec.3.2 Readout,p.6,公式未编号。两种 $\tau$ 都是可学习、每头独立的标量逆温度,通过缩放 key 来调整两区 logits,而不是在输出末端做两个分支的加权平均。所有历史状态可见,窗口中未来位置被 $\mathbf M_u$ 屏蔽。多头输出拼接后经 $W_O\in\mathbb R^{d\times d}$ 投影,并加入 residual stream。
这种设计复用 Q/K/V 投影;参数增量主要来自门、归一化和标量温度。原文没有给每种模型新增参数的精确计数,不应把“很少”具体化为未经报告的百分比。
2.5 Append:预算决定数量,相似度决定内容
当前 $m$ 个槽只能增长,不能缩减;每次最多新增退出块的 $C$ 个 token:
对每个退出 token,计算它与现有状态的最大相似度:
选 $s_j$ 最小的 $n_{\mathrm{append}}$ 个进入 $A_e$:即它与任何旧槽都不够像,更值得获得新容量。追加其 $\bar{\mathbf k}_j,\mathbf v_j,\|\mathbf v_j\|_2$。余下 $R_e=\Omega_e\setminus A_e$ 才进入 merge。(p.6)
重要区别:选谁追加是数据相关的,但追加几个由预设预算决定,论文尚未验证根据内容自动学习容量的策略。这里是相对旧状态的一次批量排序,也没有保证本批新增 token 彼此不相似。原式 append 的最大值没有排除 sink;merge 才明确排除。
2.6 Merge:硬分配、加权累积、保护 sink
先扩容到 $\mathbf s_+$,再将每个剩余 token 指派到最相似的非 sink 槽:
合并目标包括本轮刚追加的槽。批内多个 token 可以指向同一槽,进行求和;这不是逐 token 更新完槽再重新分配下一个 token 的串行算法。sink 保留读取权,但禁止被写入;$\rho_i$ 在合并中不变。(Sec.3.2,p.6)
教学示例:若现有三个槽(含一个 sink),本轮退出四个 token,预算允许增一槽,先把与旧状态最不相似的 token 直接追加,得到四槽;其他三个 token 可以选择原来两个非 sink 槽或新槽。不能先合并完再选追加,否则与论文操作不同。
2.7 复杂度和并行性
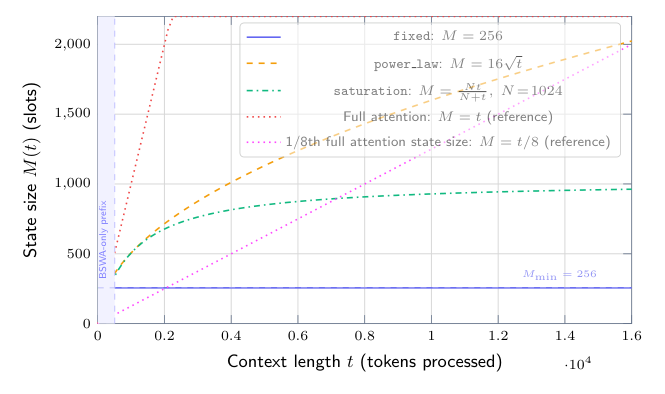
来源:Fig.3,p.5。横轴为处理过的 token 数,纵轴仅为压缩状态槽数。固定 256、$16\sqrt t$、趋于 1024 的饱和曲线展示三种预算;完整 attention 和 1/8 比例缓存是参照线。图中的初始下限和 BSWA-only prefix 提醒读者:预算公式还受初始化与可用 token 限制,不是从 $t=0$ 开始自由取任意槽数。
| 状态策略 | 运行时状态规模 | 整序列 prefill | decode 每 token 的摊销复杂度 |
|---|---|---|---|
| 固定 $m$ | $O(1)$ | $O(N)$ | $O(1)$ |
| $m\propto\sqrt N$ | $O(\sqrt N)$ | $O(N^{1.5})$ | $O(\sqrt N)$ |
| Full attention | $O(N)$ | $O(N^2)$ | $O(N)$ |
前两行以 $C,L,H,d_h$ 固定为前提;依据 Table 1,p.2。分块状态更新使部分解码步比普通步贵,表中把这种代价摊到 token 上。
本次推导:若 $m(t)=\Theta(t^\alpha)$、$0\le\alpha\le1$,一个块的读取及相似度路由约为 $O(Cm(t)d_h)$,固定窗口项另计。对 $N/C$ 个块累加得到主要项 $O(N^{1+\alpha})$。因此只要 $\alpha<1$,渐近 prefill 就是次二次;“状态小八倍但仍线性增长”并不因此变成次线性复杂度。
支持 chunk 内并行,不代表整个状态递推可无依赖地全序列并行。Appendix B(p.18)指出,可先算各块状态,再用一次带掩码 attention 处理对应区域;保存中间状态可能增加训练内存。Table 1 的小状态优势不能直接等同于完整训练峰值显存。
容量估算(本次计算,非实测字节):32,768 token 时 $16\sqrt N\approx2896$ 槽,加上至多 512 个 BSWA token,约为 full cache 行数的 10.4%;KVM-256 加窗口最多 768 行,约为 2.34%。这尚未算 radius、不同数据类型、舍入、临时张量及训练保存的状态,不能宣称等比例的 GPU 显存节省。
2.8 骨干与训练/推理区别
GPTAlpha-2 先线性投影 Q/K/V,value 与第一层 value 做可学习向量混合,再对 Q/K/V 做静态参数 token shift;query/key 经带偏置 LayerNorm 和 partial RoPE。MLP 使用 token shift 后的平方 ReLU channel mixer。(Appendix C,pp.18–19,Eqs.(5)–(13))
KVM 的状态更新在训练、prefill 和 decode 中遵循同一逻辑;门、温度、投影等通过训练学习,运行时无需 SGD/Adam 优化状态。本文训练的是配备 KVM 的模型,不是把任意预训练模型无训练转换成 KVM。离散 argmax 路由的梯度处理细节在论文中未展开,复现时需要检查发布实现,不能自行补写为某种直通估计器。
三:实验——分别测什么
3.1 模型、训练与对照
| 项目 | 已报告设置 |
|---|---|
| 主模型规模 / 训练量 | 120M / 3B tokens;350M / 7.8B tokens |
| 训练数据、长度 | Prolong,8K 上下文 |
| 主要 KVM | $C=256$,两块 BSWA;KVM-256 固定 256 槽;KVM-sqrt 为 $16\sqrt N$ |
| KVM/SWA、OVQ/SWA | 容量趋于 1024 的状态层,与 256-token RoPE SWA 交替 |
| 全注意力对照 | GPTA-2;默认 head 通道一半使用 RoPE |
| GPTA-2/SWA 对照 | full-attention 层分别使用 HalfRoPE 或 NoPE,与 SWA 交替 |
| BSWA 对照 | 三块局部窗口(按 $C=256$ 为 768 token),HalfRoPE |
| RWKV-7 | 固定状态 LRNN 对照,使用自身骨干 |
来源:Sec.4,p.7。不能将速度测量中的 32 个头、batch 8 直接当作这些 120M/350M 训练模型的配置;论文没有完整列出各训练模型的层数和宽度。RWKV-7 的不同骨干、混合层的不同配置,也限制了“差异全部来自一个注意力模块”的解释。
训练细节(Appendix D,p.19):CompleteP,$\alpha=1$;batch 为 524,288 tokens;AdamC,$\beta_1=0.9,\beta_2=0.95,\epsilon=10^{-8}$;基准学习率 $2\times10^{-3}$、weight decay 0.2,先在 120M/3B 调整后迁移。更长训练按 $1/\sqrt{N_{\mathrm{steps}}}$ 缩放学习率与 weight decay;不对标量/向量施加 weight decay。warmup 200 steps,随后线性降至零;RoPE base 10,000。主文未报告多随机种子方差和下游评测显著性检验。
3.2 评测问题与指标
| 实验 | 检验问题 | 口径与方向 |
|---|---|---|
| TextbookChapters | 越过训练长度后,语言建模是否恶化 | 随机选长度至少 32,768 的文档;每连续 1024 token 的平均 loss,越低越好;样本数、误差未报告 |
| 六项短上下文任务 | 压缩记忆是否破坏一般任务能力 | LAMBADA、ARC-C/E、HellaSwag、PIQA、WinoGrande;准确率越高越好,LAMBADA ppl 越低越好;ARC-C、HellaSwag 用 normalized 指标 |
| NIAH-S1/S2/S3 | 不同干扰下能否找回目标 | 4K/8K/16K/32K,表中分数越高越好;16K/32K 为相对训练长度的外推 |
| 全 RULER | 多类长上下文任务整体表现 | 只在 4096 长度汇总,不能解释成 32K RULER |
| LongBench | 更综合的长上下文任务 | 只使用 few-shot 子集平均分,不是完整 LongBench 总分 |
| 速度 | 核心序列混合成本 | 单层 decode 为 ms/token;prefill、backward 为 ms;越低越好 |
下游使用 LM Evaluation Harness。具体任务版本、few-shot 子集的完整配置、生成参数等在论文中未充分列明,本次不假定采用某一默认值。
四:结果——证据支持到哪一步
4.1 位置损失:固定记忆也可以有良好外推
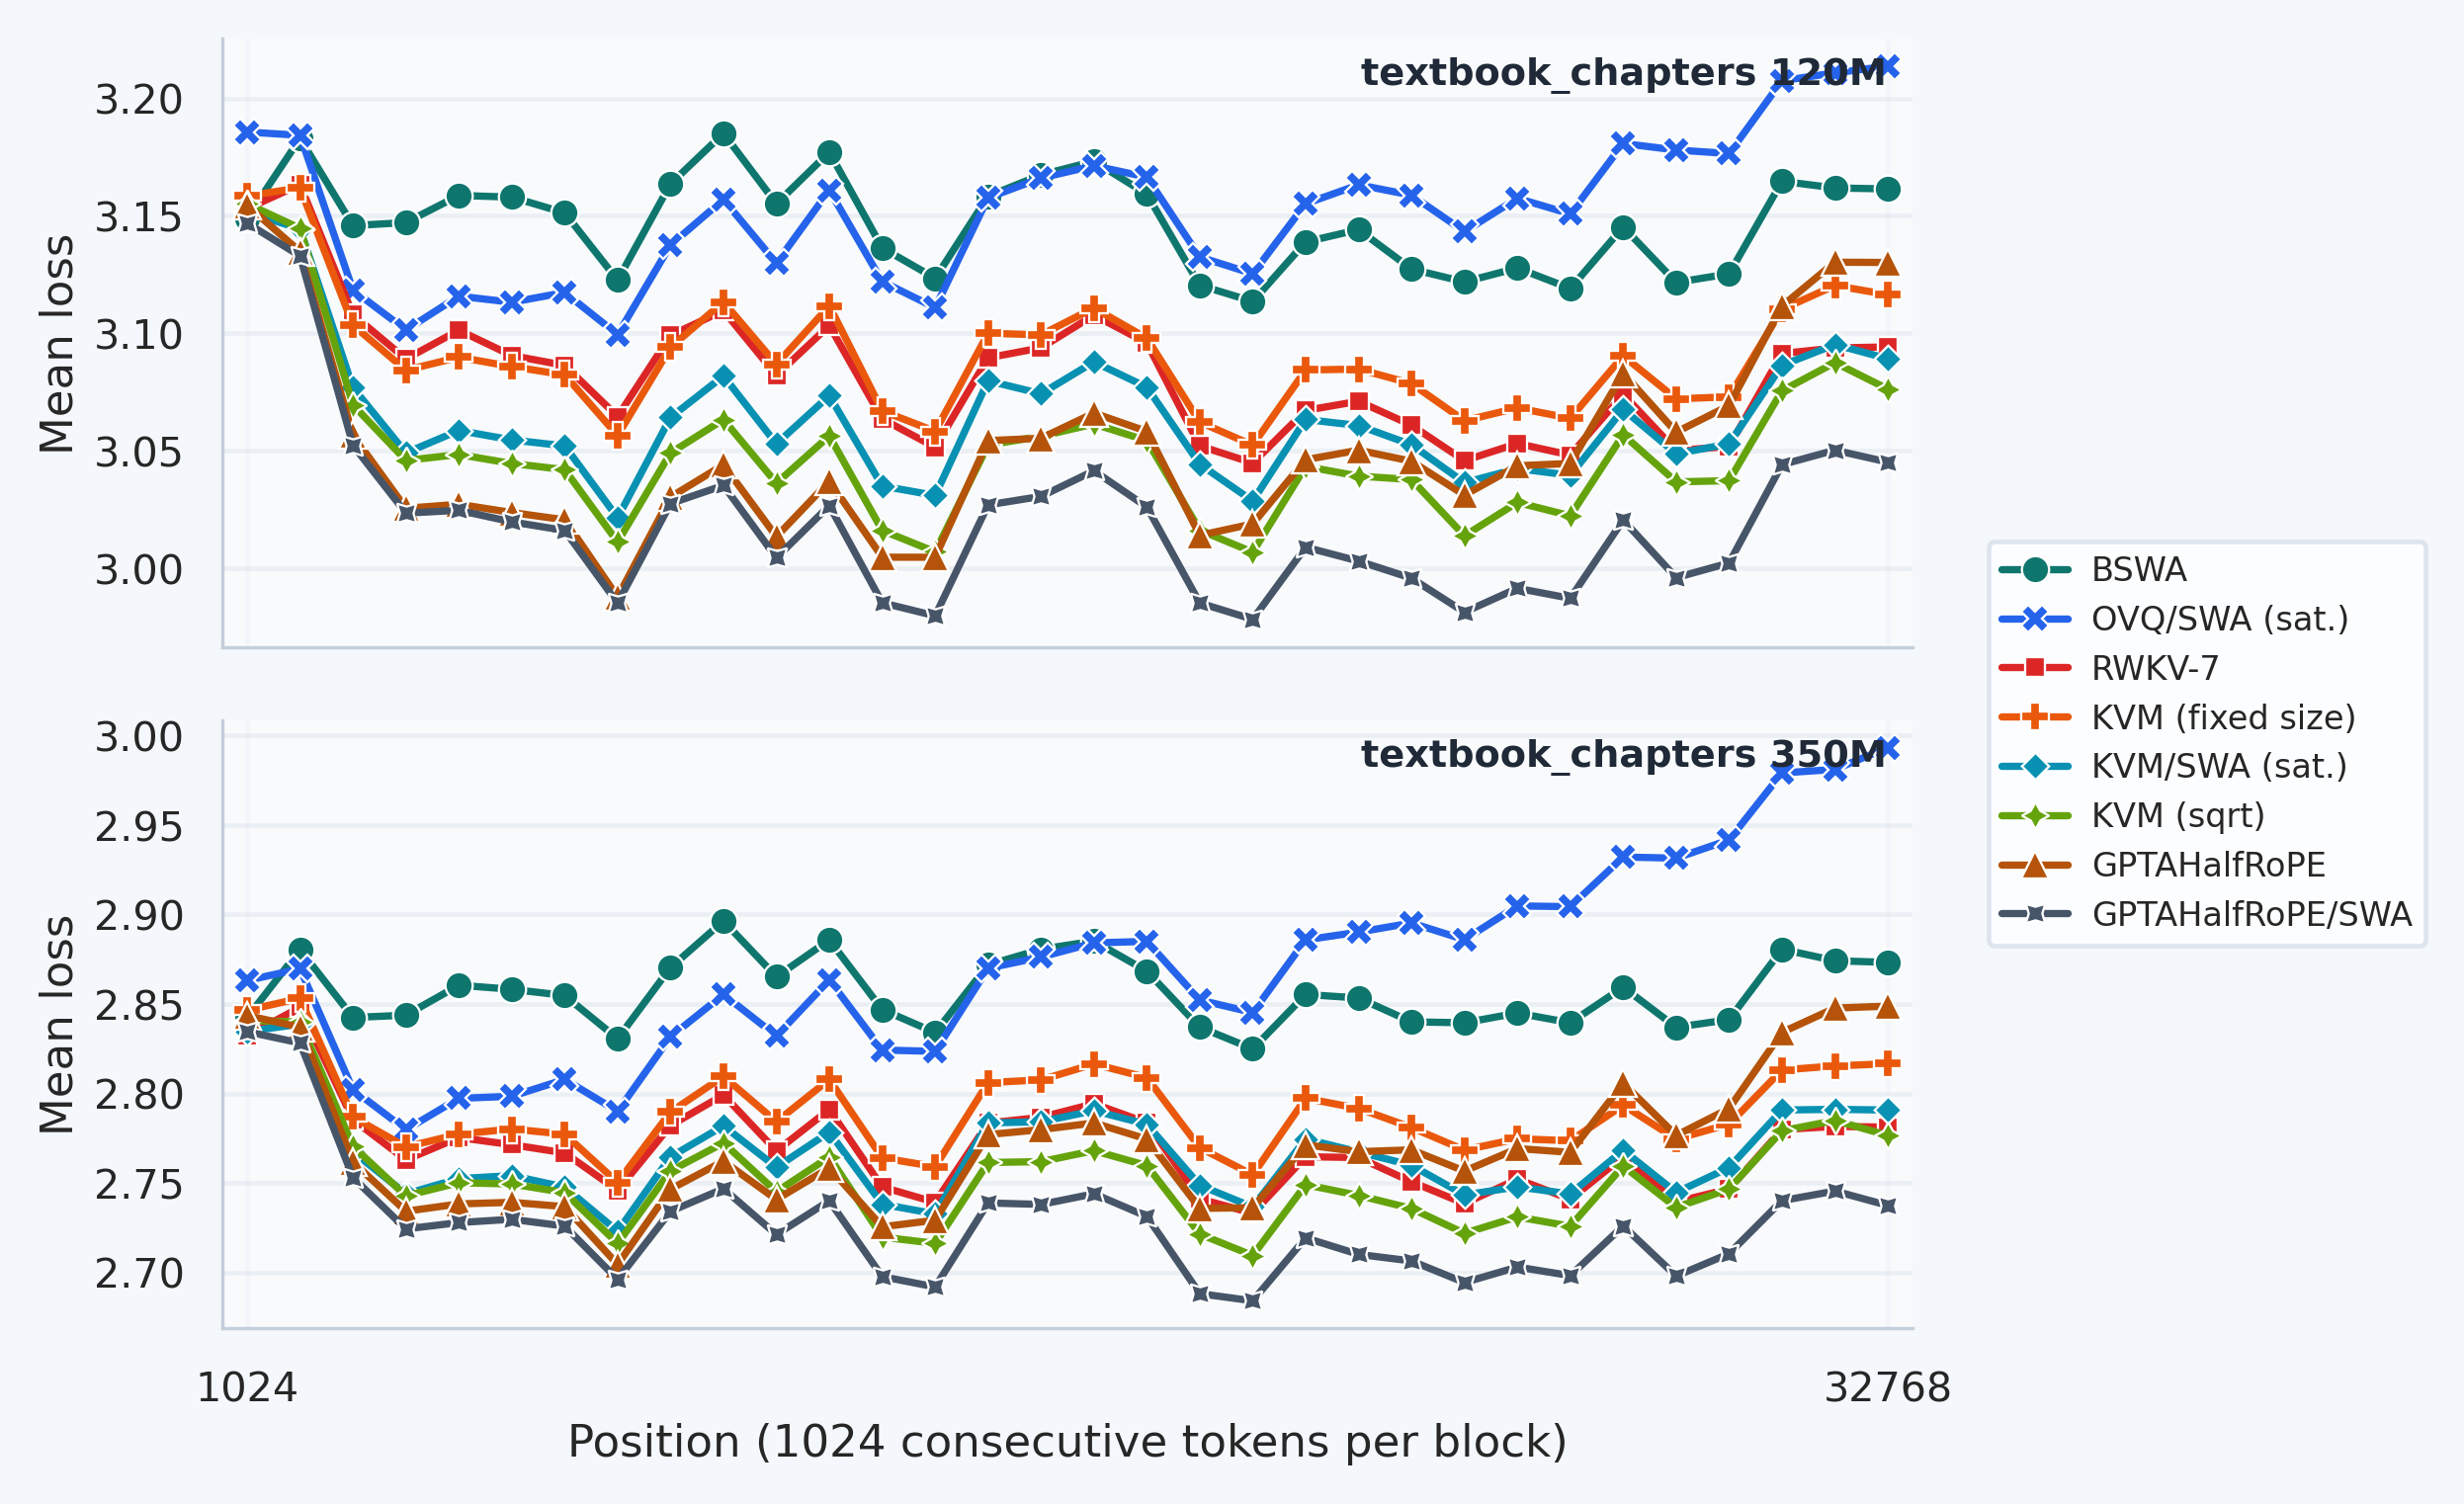
来源:Fig.4,p.8;作者原始 PNG。上、下分别是 120M 和 350M;横轴为连续 1024 token 块的位置,纵轴为平均 loss。颜色/符号对应不同架构。读图应先在同一面板比较同位置的曲线,再看超出训练 8K 后是否持续上升。
KVM 的曲线在长位置仍较稳定;作者报告 KVM-sqrt 是所测非 GPTAlpha 模型中最好的一组,KVM-256 也优于更大状态的 OVQ/SWA。GPTAlpha HalfRoPE/SWA 的曲线仍更低。图没有逐点数值表或置信区间,本笔记不从低分辨率曲线虚构精确 loss 或显著性。
解释边界:平均预测损失良好,可能主要说明常见语义/局部统计保留得不错,不能自动推出稀有目标的精确检索也好。下面 NIAH 正好暴露二者差异。
4.2 短任务:保持接近,未显示全面优势
原文 Table 4(p.20)节选;avg 为六项准确率类分数的汇总,不包含 perplexity。
| 模型 | 120M avg ↑ | 350M avg ↑ | 350M LAMBADA ppl ↓ |
|---|---|---|---|
| BSWA | 42.1 | 47.5 | 22.2 |
| RWKV-7 | 42.7 | 48.2 | 19.9 |
| GPTA-2 | 42.0 | 47.2 | 22.9 |
| KVM-256 | 42.0 | 47.3 | 22.0 |
| KVM-sqrt | 42.7 | 47.7 | 21.7 |
| OVQ/SWA | 41.9 | 46.9 | 23.2 |
| KVM/SWA | 42.3 | 47.3 | 22.0 |
350M KVM-sqrt 相对 GPTA-2 的平均分差为 0.5 分;没有误差范围,不能称为显著改善。更稳妥的结论是这些设置下短任务表现相近。局部窗口覆盖许多短任务是作者解释,但不是所有六项样本都落在窗口内的独立统计证明。
4.3 长检索:固定槽保留重复背景中的针,增长槽帮助复杂背景
Table 2,p.8,350M 模型节选。所有 NIAH 数值为表中百分制分数,越高越好。
| 模型 | S1 32K | S2 16K | S2 32K | S3 16K | S3 32K |
|---|---|---|---|---|---|
| BSWA | 2.6 | 4.8 | 2.4 | 5.6 | 2.4 |
| RWKV-7 | 12.6 | 2.0 | 3.4 | 1.2 | 0.4 |
| GPTA-2 | 22.4 | 45.2 | 20.8 | 37.6 | 5.8 |
| KVM-256 | 98.8 | 3.6 | 2.4 | 3.0 | 2.4 |
| KVM-sqrt | 98.4 | 71.0 | 17.0 | 77.6 | 36.6 |
| OVQ/SWA | 45.2 | 17.6 | 4.2 | 8.6 | 2.6 |
| GPTA-2 HalfRoPE/SWA | 41.2 | 52.0 | 23.6 | 37.2 | 9.6 |
| GPTA-2 NoPE/SWA | 95.0 | 99.0 | 0.0 | 29.2 | 0.0 |
| KVM/SWA | 92.2 | 47.6 | 5.8 | 28.8 | 6.8 |
三点值得分开看:
- KVM-256 的 S1 32K 为 98.8,说明固定状态并不意味着所有长检索都失败;可压缩的背景非常关键。
- S3 16K 时扩大状态从 3.0 到 77.6,即 +74.6 个百分点;32K 从 2.4 到 36.6,即 +34.2 个百分点。仍有明显的随长度退化,不能写成“解决 32K 复杂检索”。
- 不同任务的排序会反转:S2 32K 上 GPTA-2 的 20.8 高于 KVM-sqrt 的 17.0,HalfRoPE/SWA 的 23.6 更高。KVM/SWA 的优势也不是对每个复杂检索长度都成立。
规模边界:120M KVM-sqrt 在 S1 32K 为 99.6,但 S2/S3 32K 仅 4.2/2.6;S3 16K 为 16.4,相比 350M 的 77.6 低得多。两组同时改变了参数量与训练 token 数,不能单独归因为模型参数规模。(Table 2)
4.4 综合长任务:接近某些基线,但全 RULER 仍有差距
同为 Table 2,p.8;LB 为 LongBench few-shot 子集,RULER 为 4K。
| 模型 | 120M LB ↑ | 120M RULER ↑ | 350M LB ↑ | 350M RULER ↑ |
|---|---|---|---|---|
| RWKV-7 | 17.5 | 15.6 | 23.2 | 19.6 |
| GPTA-2 | 16.9 | 34.0 | 25.1 | 47.2 |
| KVM-256 | 12.2 | 25.2 | 23.7 | 33.2 |
| KVM-sqrt | 16.6 | 29.6 | 25.0 | 38.6 |
| OVQ/SWA | 12.0 | 16.5 | 21.0 | 29.0 |
| GPTA-2 HalfRoPE/SWA | 12.2 | 38.7 | 13.6 | 41.6 |
| GPTA-2 NoPE/SWA | 10.0 | 30.9 | 21.0 | 45.1 |
| KVM/SWA | 12.6 | 27.5 | 25.2 | 40.7 |
350M KVM-sqrt 与 GPTA-2 的 LB 平均分几乎相同(25.0 对 25.1),RULER 却相差 8.6 分。KVM/SWA 的 LB 为 25.2,但不能因此得出它在长任务全面最佳。原文 Sec.4 对增长与混合模型“表现良好”的描述,必须结合这些具体任务与长度限制理解。
4.5 速度:必须保留硬件、测量边界和交叉点
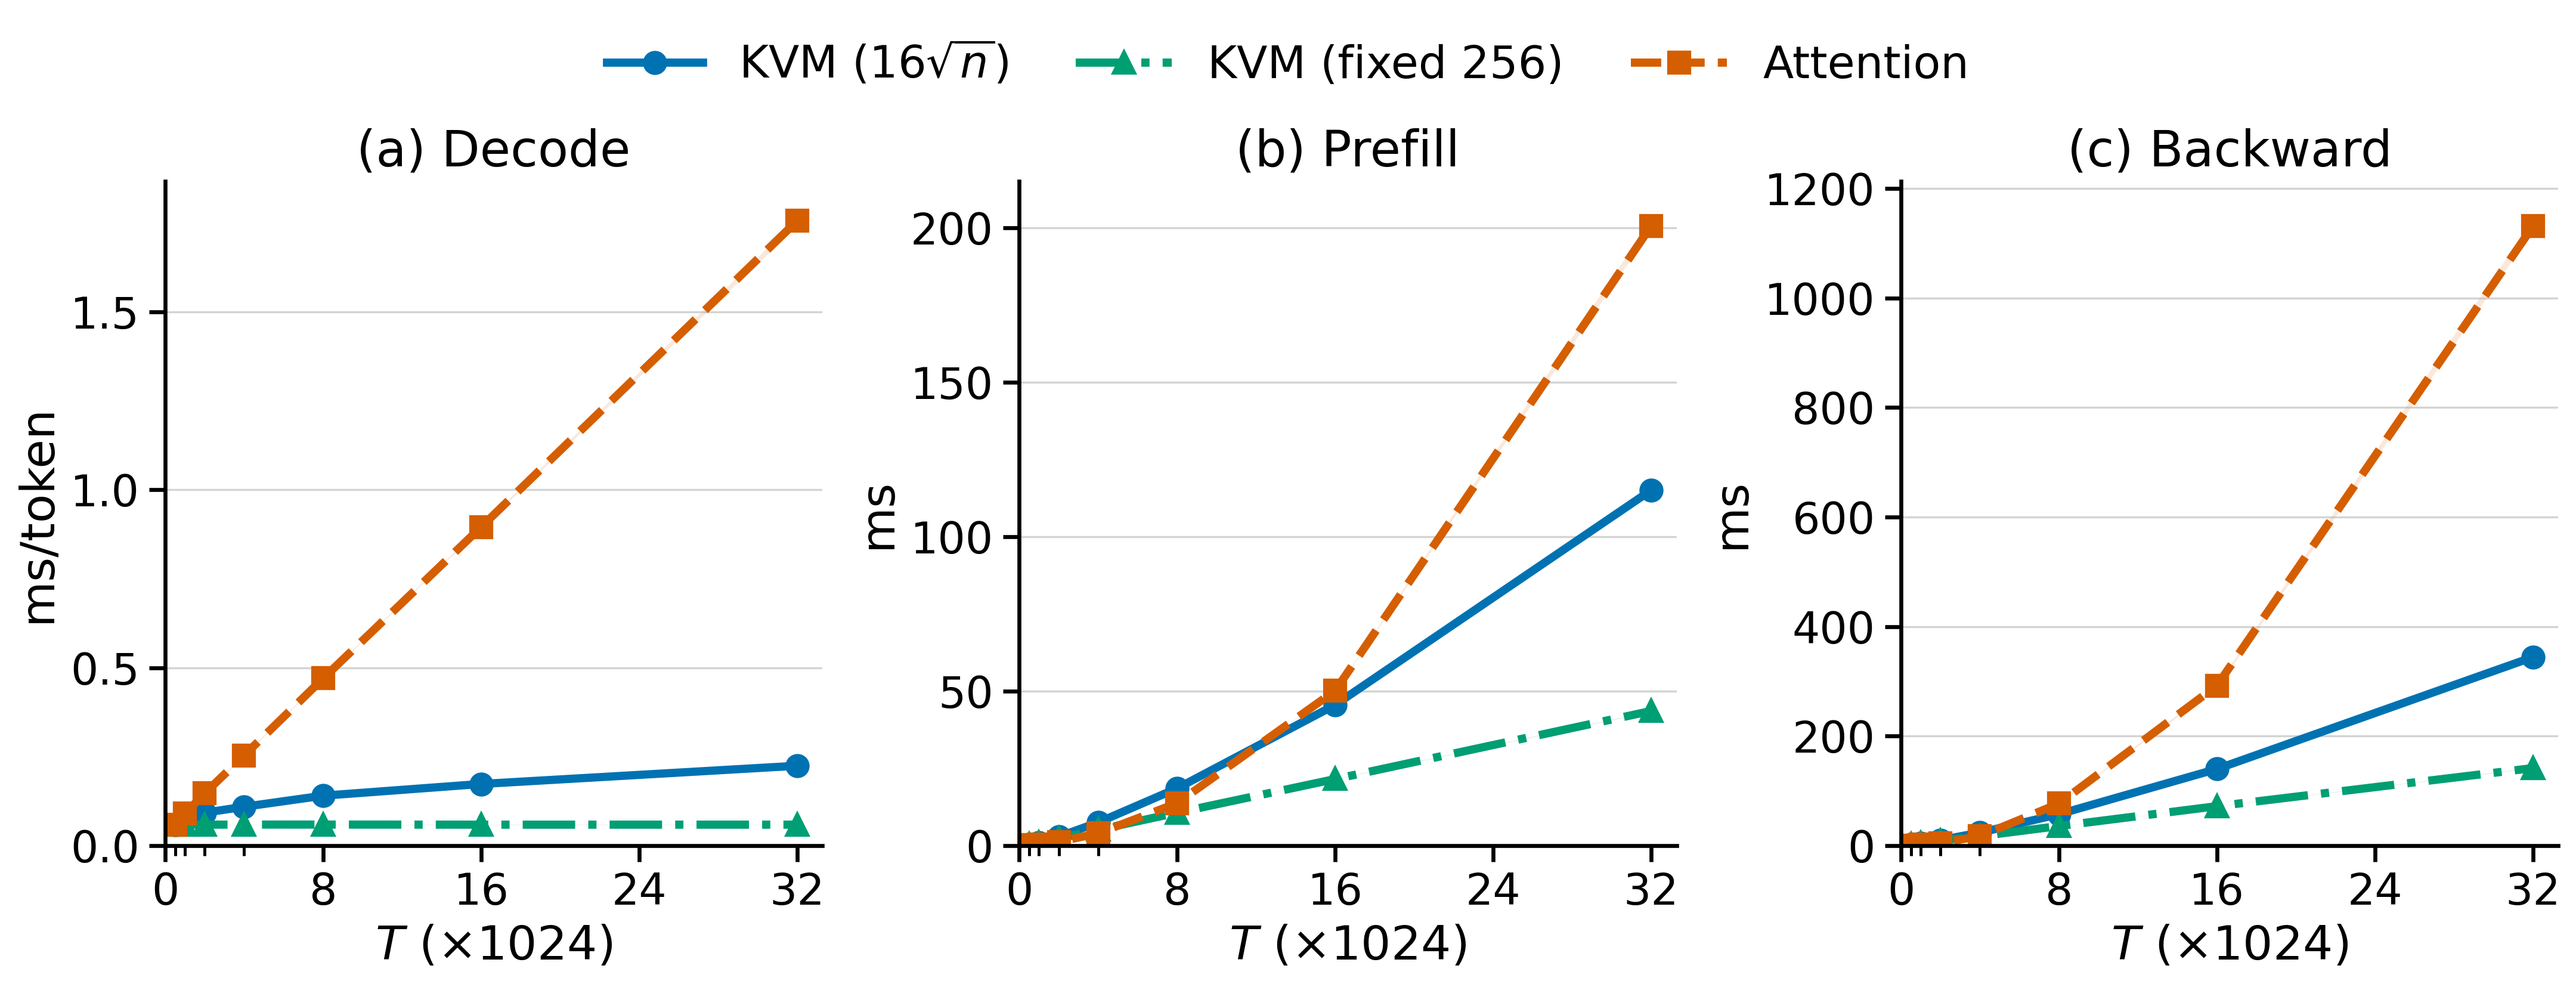
来源:Fig.5,p.9;作者原始 PNG。左图纵轴为 ms/token,另两图为整段操作的 ms;横轴是上下文长度,单位为 1024 tokens。绿线为 KVM-256、蓝线为 KVM-sqrt、橙线为全注意力。曲线是中位数,阴影为各次 run 的中位数最小值与最大值,不是准确率误差条或置信区间。
计时条件:AMD Instinct MI325X,单层 32 heads、head dimension 128、batch 8;输入输出 bfloat16,敏感运算 float32;KVM 用 Triton 实现,对照是 PyTorch Flash SDPA / ROCm AOTriton。从输入投影之后到 head concatenation 之后计时,包含 KVM 路由及状态更新,但不含输入/输出投影、位置编码和 transformer 层其他部分。(Sec.5,pp.8–9)
| 32,768 tokens | Decode 加速 | Prefill 加速 | Backward 加速 |
|---|---|---|---|
| KVM-256 / full attention | 29.77× | 4.59× | 7.99× |
| KVM-sqrt / full attention | 7.88× | 1.76× | 3.30× |
报告开始快于 full attention 的测量长度分别为:KVM-256 的 decode 1K、prefill 8K、backward 4K;KVM-sqrt 则为 1K、16K、8K。短上下文可能尚不能抵消状态路由等额外成本。
摘要的“可用标准操作实现、无需 custom kernel”是可实现性主张,上述速度数字实际使用了定制 Triton kernel。两句话不矛盾,但不能把这些加速归到普通 PyTorch 实现,更不能跨硬件、batch 或模型大小直接外推。
4.6 消融:value 半径非常关键,温度收益不一致
120M KVM-256;Table 3(p.9)与 Table 5(p.20)合并节选。
| 设置 | S1 32K ↑ | S2 4K ↑ | LB ↑ | RULER-4K ↑ | 短任务 avg ↑ |
|---|---|---|---|---|---|
| 完整模型 | 98.4 | 88.8 | 12.2 | 25.2 | 42.0 |
| 无 sink 保护 | 79.6 | 37.6 | 14.0 | 19.1 | 41.9 |
| 无每头区域温度 | 98.8 | 55.0 | 9.4 | 25.5 | 42.2 |
| 无 value 长度归一化 | 3.6 | 14.4 | 5.3 | 13.4 | 42.6 |
| 无 merge gate | 87.8 | 33.8 | 12.1 | 20.3 | 42.5 |
去掉 value 长度归一化使 S1 32K 从 98.4 降至 3.6(−94.8 个百分点),却使短任务平均从 42.0 到 42.6。这说明短任务成绩很难判断长期记忆设计是否有效。sink 保护与 gate 在若干检索任务上很重要,但无 sink 的 LB 反而为 14.0;移除温度后 RULER 25.5 略高于 25.2,不能声称各模块对所有指标都必要。
这里直接消融的是 value 长度归一化;没有独立表格消融 key JIT LayerNorm。附录 G 对多种路由、EMA 等选择给出经验叙述,但未提供完整数值,证据强度低于上述受控表格。
4.7 RoPE 附录:外推是多维性质
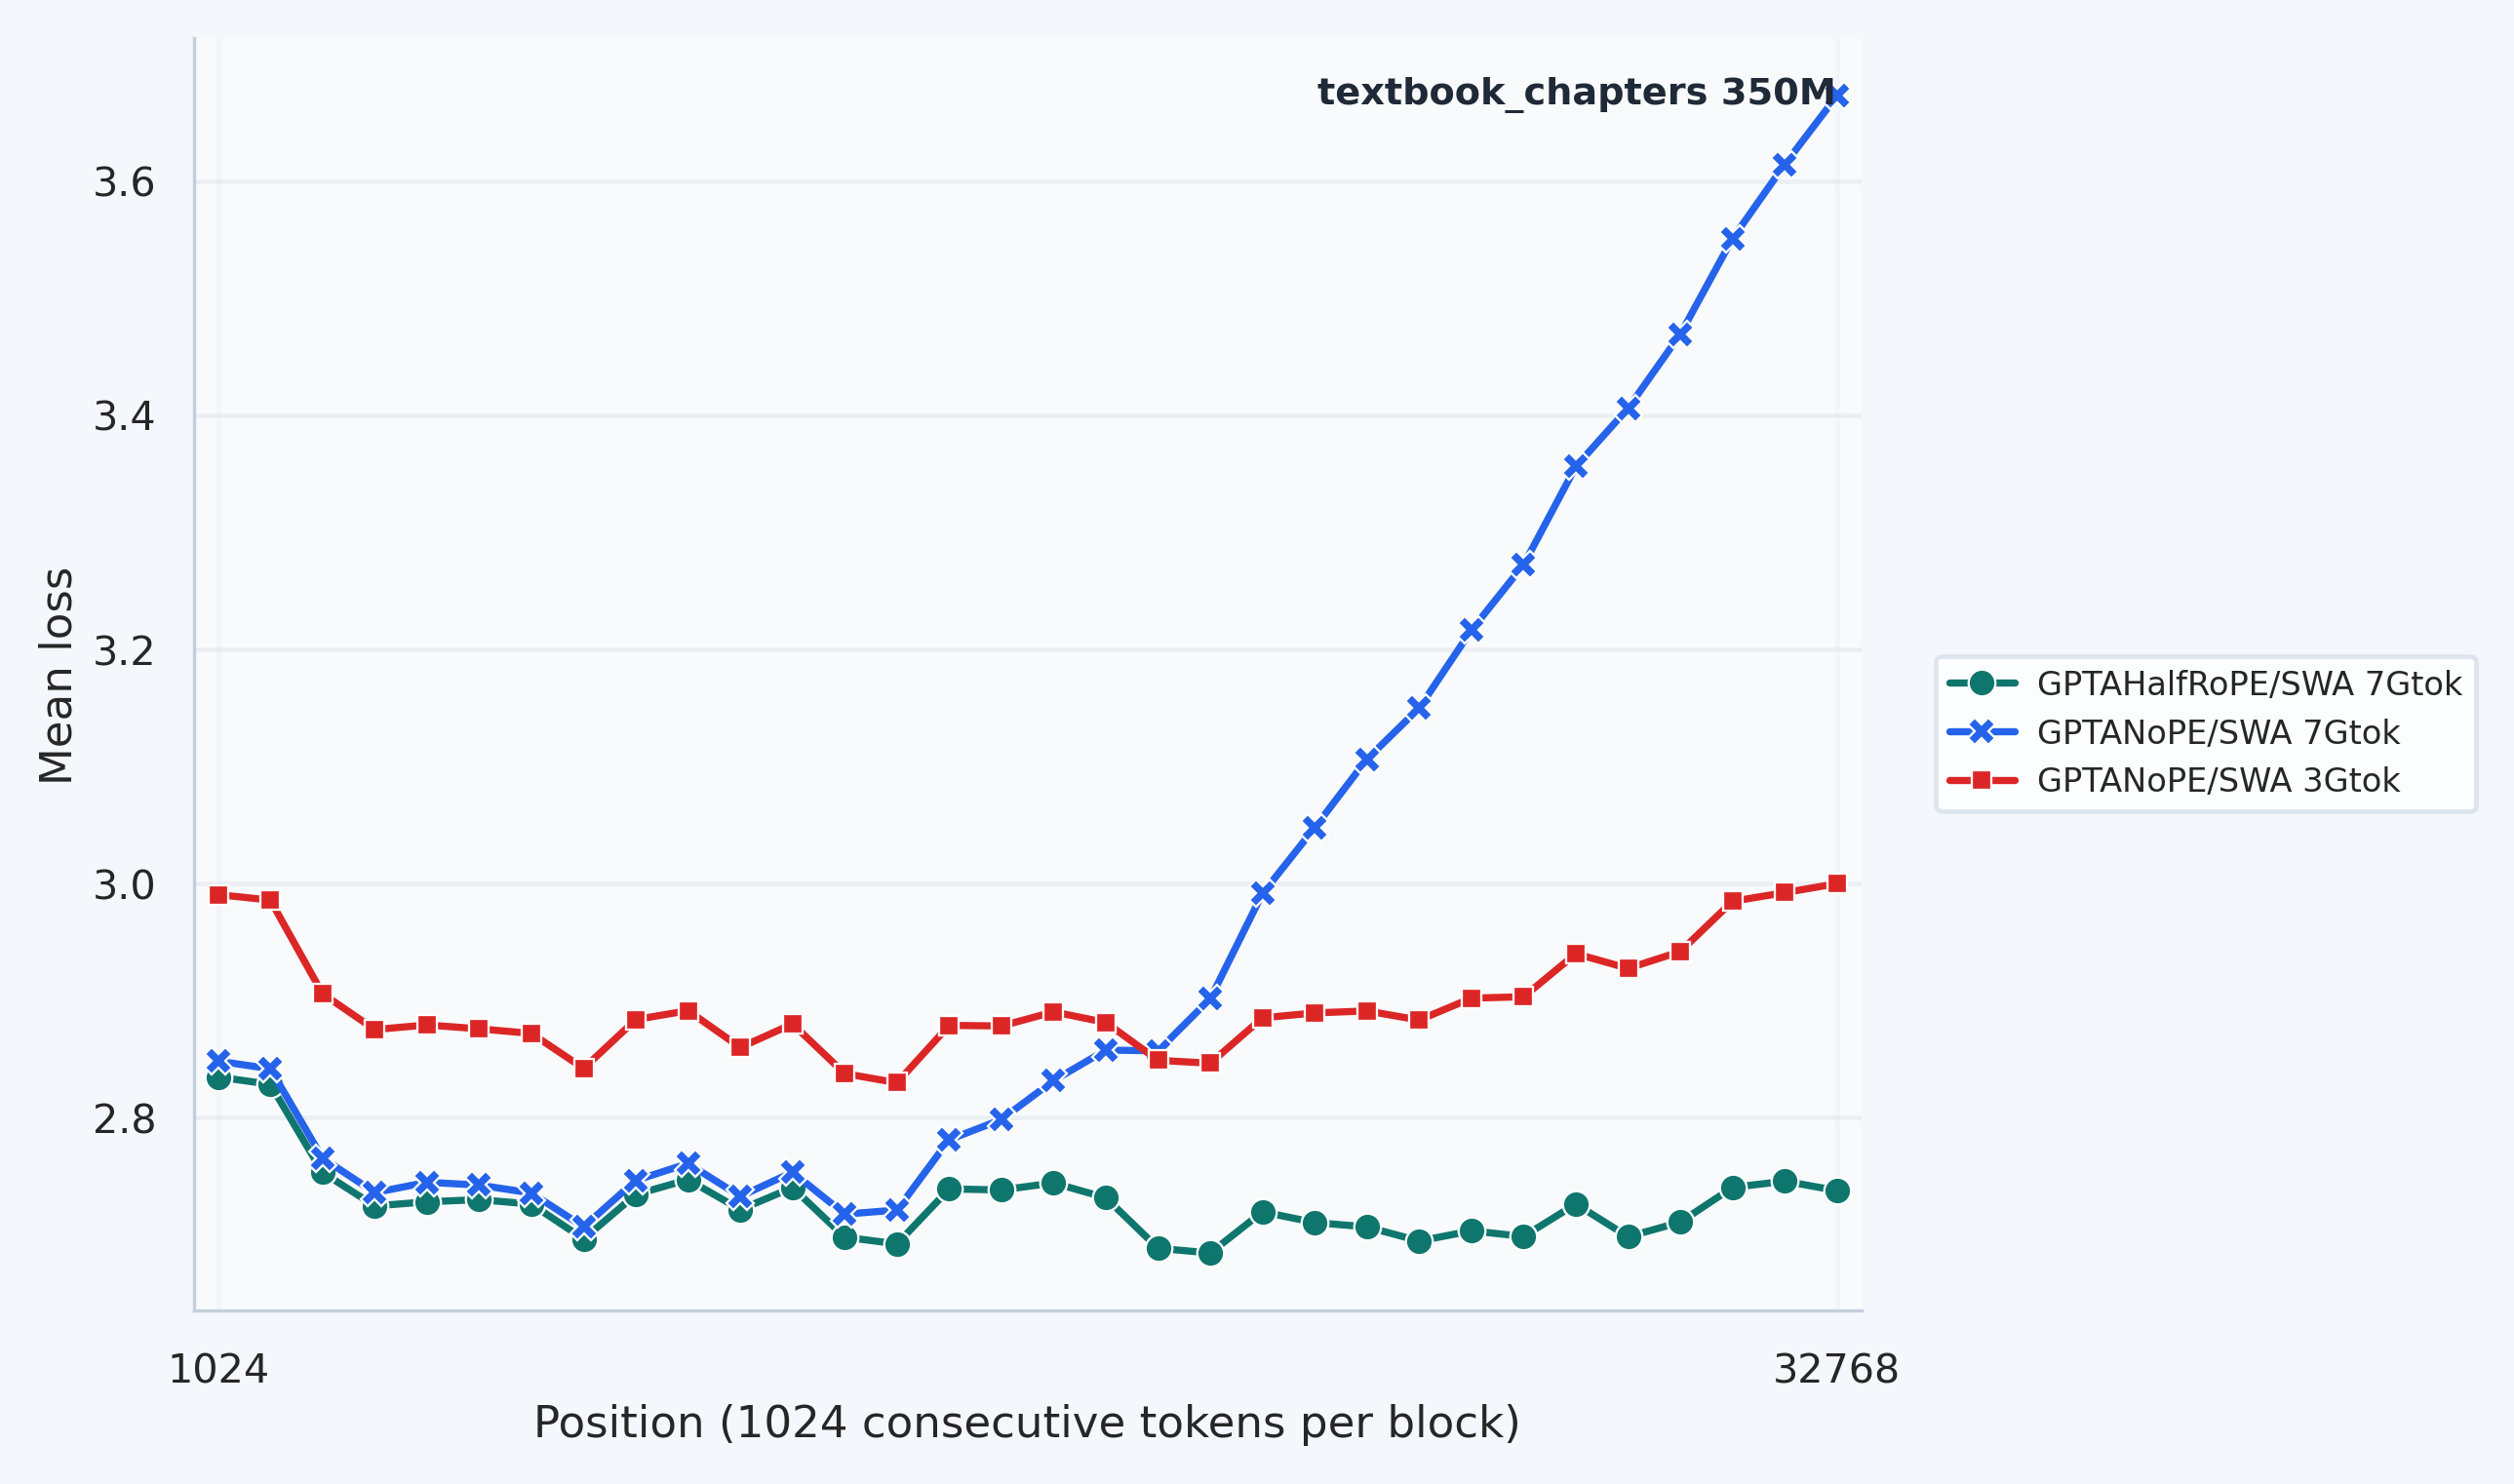
来源:Fig.6,p.21,350M GPTA-2/SWA;横轴位置、纵轴 loss。比较 HalfRoPE 与 NoPE,以及 NoPE 的不同训练量。原图图例将长训练简写为 7Gtok,Tables 6–7 写 7.8Gtok;本笔记和幻灯片统一按表格的 7.8B 标注。
HalfRoPE 的长位置 loss 更稳定,而 NoPE 长训练曲线在外推区明显上升;但 NoPE 的检索不一定更差。Table 6(p.20)中,7.8B NoPE 的 S1 32K 为 95.0,高于 HalfRoPE 的 41.2;S2 16K 为 99.0,高于 52.0;到了 S2/S3 32K,NoPE 又都为 0.0。
训练量也不能概括成“越多外推越差”:NoPE 从 3B 到 7.8B,LB 从 6.0 到 21.0、RULER 从 40.3 到 45.1;但 S1 32K 从 99.4 到 95.0,S2 32K 从 2.4 到 0.0。短任务 Table 7(p.21)中,LAMBADA ppl 从 32.9 降到 22.9,HellaSwag 从 36.9 到 41.7。更多训练提高了不少任务,同时恶化某些长度外推指标。
作者推测 NoPE 会学习绝对位置信号,更长训练强化这种依赖;也推测 HalfRoPE 更利于相邻 token 的相对关系。这些是解释性假说,未在本文被直接验证。尤其这组实验研究 GPTA-2/SWA,不能当作对 KVM 去旋转机制的完全隔离因果实验。
五:结论——贡献、边界与后续问题
5.1 可以相信的贡献
KVM 提供一个相对简洁的训练型记忆架构:把分块局部窗口与可增大的 KV 槽统一到普通 softmax 读取中,退出窗口时做新颖性选择与最相似槽合并,通过读出归一化避免直接读累积和的尺度问题。固定预算与平方根增长的模型在小规模训练中给出了不同的成本—质量工作点。速度实验也证实,在指定硬件和长上下文的单层核心操作上有实际收益。
5.2 不应超出证据的结论
- 不是完整 KV 的无损替代:value 方向混合、硬路由和旋转维丢弃会损失信息;论文没有压缩误差或检索容量定理。
- 不是大型生产模型验证:语言任务主要是 120M/350M、3B/7.8B 训练量与最多 32K 检索;尚不能外推至数十亿参数、百万 token 或复杂工具使用。
- 不是免训练替换方案:原文未尝试把既有 transformer 直接蒸馏/转换为 KVM。
- 不是所有预算都被系统验证:主要比较固定、sqrt 和混合饱和安排;没有密集容量扫描证明完整 Pareto 前沿,也未验证训练/测试切换预算。
- 不是所有长上下文能力同时提高:loss、NIAH 不同子任务、LongBench 和全 RULER 的排序不同。
- 不是完整系统性能报告:缺少端到端吞吐、峰值显存、跨硬件与多 batch 延迟曲线;速度统计带不能替代质量实验多种子误差。
5.3 值得继续研究的问题
作者明确留待未来的方向包括:训练与测试之间切换状态预算、通过微调适配预算、内容相关的容量调度,与 GQA/MLA 的组合,以及从普通 transformer 蒸馏到 KVM。(Sec.7,p.10)
本次阅读进一步提出三项具体检验:固定参数量与训练量,画出密集状态预算下的质量—时间—实际显存曲线;控制干扰文本的新颖度,区分检索收益来自容量还是位置机制;给出 hard routing 的稳定性、归一化数值行为和多种子结果。这些是研究建议,并非论文已完成的实验。
5.4 组会应抓住的主线
先讲为什么固定容量遇到不断新颖的信息会吃紧,再用 Fig.2 讲清局部读出与块退出;接着解释 append/merge 和 value 半径;用 S3 16K 的 3.0→77.6 展示增长状态的价值,同时用 RULER 的 38.6<47.2 和 32K S3 的 36.6 约束结论。最后展示有限测量范围内的速度收益。这样,方法、结果与边界构成同一条论证链。