Nectar:将静态长上下文的注意力编译成可学习函数
论文:Nectar: Neural Estimation of Cached-Token Attention via Regression
作者:João Monteiro、Michal Klein、Pierre Ablin、Marco Cuturi(Apple)
版本:arXiv:2605.09778v2,2026-07-08 修订;研读与获取日期:2026-10-08
原文:arXiv v2 · 本地 PDF · 英文汇报 PDF · 可编辑 TeX
论文总览
Nectar 面向反复查询同一本书、手册或其他固定文档的场景。其核心观察是:一旦文档及基础模型固定,每层、每个 KV 头对文档的注意力就成为 query 的确定函数。 可以离线训练小网络逼近这个函数,用参数保存文档的查询行为,在线不再逐项读取原文档的 KV-cache。
关键设计是一对函数:target 网络预测“从文档读出什么”,score 网络预测“文档应占多少注意力权重”。后者逼近 log-normalizer,使文档贡献能够与新问题、已生成 token 的精确因果注意力共同归一化。基础模型权重冻结,每份文档有自己的 Nectar 模块。(Sec. 3,PDF pp. 4–6)
最有说服力的质量结果来自原生长上下文模型 Qwen2.5-7B-1M:在三份文档的随机测试问题上,容量为原文档 KV-cache 的 10% 时,MLP 的语义评分差为 $-0.14\pm0.34$,接近完整缓存;但与训练问题最不相似的 challenge split 上,同容量差距为 $1.18\pm0.43$。这里分数范围为 1–5,差距越小越好,负数表示 Nectar 的平均得分更高。应把本文理解为依赖查询分布的静态上下文压缩;训练目标、测试问题分布和基础模型的长上下文能力共同决定其效果。(Tables 3、19,PDF pp. 9、27)
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 固定知识源的重复读取成本;直接拟合内部注意力 | pp. 1–3,Fig. 1 |
| 2 Background: Attention, KV-Caching, and Context Distillation | 注意力、位置编码与 Cartridges 基线 | pp. 3–4,Eqs. (2.1)–(2.3) |
| 3 Method: Regressing Attention over Long Contexts | 双网络、回归和蒸馏、推理合并、两类架构 | pp. 4–6,Eqs. (3.1)–(3.6) |
| 4.1 Setup: Base Models, Datasets and Hyperparameter Choices | 模型、容量与实验协议 | pp. 6–7,Table 1 |
| 4.2 Approximation Fidelity vs. Next-Token Agreement on Evaluation Q/As | 内部逼近与单步指标 | pp. 7–8,Figs. 2–5 |
| 4.3 Assessing Generation Quality using LLM as a Judge | 自由生成、基础模型失败与语义评分 | pp. 8–10,Tables 2–6 |
| 5 Conclusion | 静态文档适用域与后续方向 | p. 10 |
| A Additional Experimental Details;B Proofs and Derivations | 数据、训练、存储、log-sum-exp 性质 | pp. 12–16,Tables 7–9 |
| C Additional Results | 容量分配、训练动态、补充指标 | pp. 16–18;图延续至 p. 25,Tables 10–11、Figs. 6–16 |
| D Generation Benchmarks | 时间、吞吐与峰值显存 | pp. 18–19,Table 12 |
| E Sample Quality Breakdown;F Out-of-Distribution Generalization: The Challenge Split | 细分任务、损失消融、分布外问题 | pp. 19–22;图表在 pp. 25–28,Tables 13–23 |
| G Side-by-Side Nectar (MLP) vs. Quadrature Generation Examples at $\rho=10\%$ | 比较三份文档上的具体回答 | p. 22;实例在 pp. 29–31 |
| H Details of Generation Quality Evaluation | 生成设置与评审规则 | pp. 23–24;提示词在 pp. 32–33 |
| I Training Data Generation and Verification Prompts | 自学习任务与一致性过滤 | pp. 24–25;提示词在 pp. 34–36 |
一:动机——把重复读取的对象变成函数
长度为 $n$ 的文档,在 $L$ 层、每层 $H$ 个 KV 头、头维度 $d$ 的模型中需要保存 $2nLHd$ 个数。对每个新 query,标准注意力仍要读取相应的全部文档 keys 和 values。论文举例:约 61K token 的《了不起的盖茨比》在 Qwen3-4B 上产生约 9 GB 的 bfloat16 KV-cache,已经超过约 8 GB 的模型权重。(Sec. 1,PDF p. 1)
对于文档固定、查询反复到来的业务,可以提前支付一次文档专属训练成本,换取之后更小的常驻状态和更便宜的文档读取。Nectar 所拟合的是“该文档在当前模型内部如何响应查询”,因此模块同时绑定文档、基础模型、层、KV 头及位置编码设置。
本文将两条设计轴分开:表示形式可以是少量可学习 KV 对,也可以是一般 MLP;监督信号可以是注意力内部回归,也可以是最终 next-token 分布蒸馏。Cartridges 对应可学习 KV 对加纯蒸馏,Nectar 将内部回归纳入统一框架,并重点研究 MLP 表示。这个区分让实验能够讨论收益来自表示能力还是训练信号。(Sec. 2.2–3.3,PDF pp. 3–6)
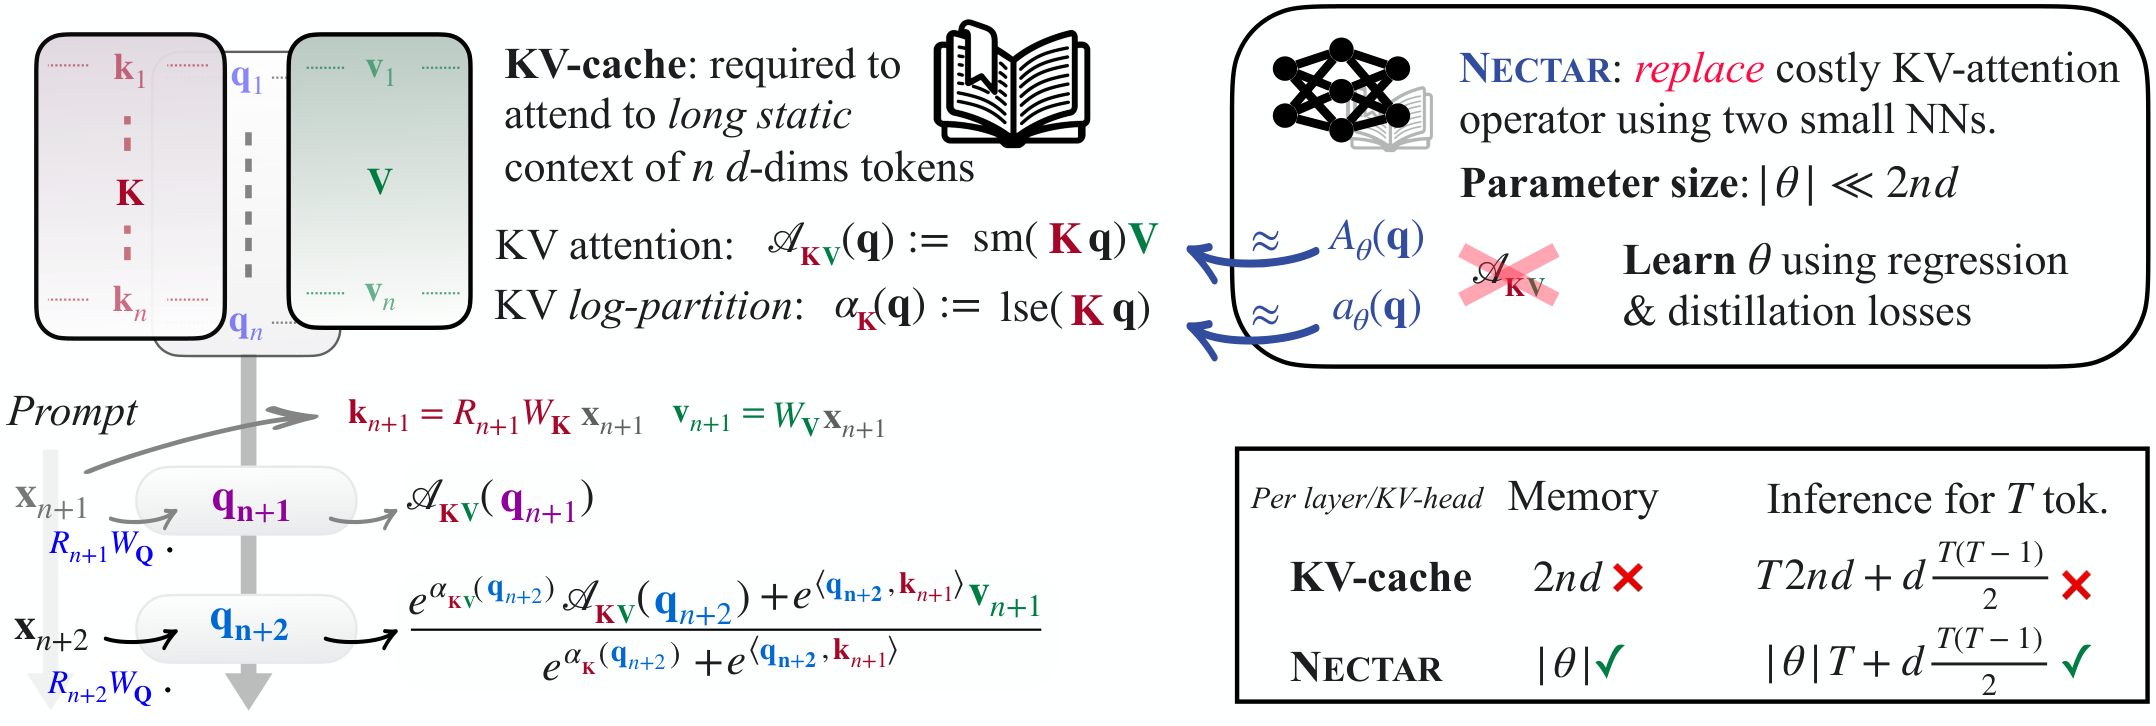
原文 Fig. 1,PDF p. 2。左侧是整份文档的 KV-cache,右侧是预测输出和归一化量的两个网络;下方展示它们如何继续与新 token 的局部注意力结合。图中的复杂度比较保留了生成 token 之间的注意力成本。
二:方法——输出与权重必须同时预测
2.1 固定上下文确定两个 query 函数
以下省略层、头下标时,均指同一个 $(\ell,h)$。
| 符号 | 含义与维度 |
|---|---|
| $\mathbf K,\mathbf V\in\mathbb R^{n\times d}$ | 固定文档的 keys 与 values;keys 已应用 RoPE |
| $\mathbf q\in\mathbb R^d$ | 对应位置和 query 头的 RoPE 后查询 |
| $\alpha(\mathbf q)\in\mathbb R$ | 文档注意力未归一化权重之和的对数 |
| $\mathcal A(\mathbf q)\in\mathbb R^d$ | 单独在文档内部归一化后的注意力输出 |
| $a_\theta,A_\theta$ | 分别逼近 $\alpha,\mathcal A$ 的 score、target 网络 |
| $\rho$ | 模块参数数目占相应原始 KV 存储元素数目的比例 |
令 $s_j=\mathbf q^\top\mathbf k_j/\sqrt d$,则
这是原文 Eq. (3.1),PDF p. 4。网络分别学习 $a_\theta:\mathbb R^d\to\mathbb R$ 和 $A_\theta:\mathbb R^d\to\mathbb R^d$。在分组查询注意力(GQA)中,同一 KV 组内的多个 query 头共享 $\mathbf K,\mathbf V$,因而也共享这对网络;不同 query 头仍分别提供自己的 $\mathbf q$ 并执行网络前向。
2.2 为什么只预测注意力输出还不够
把当前 query 可见的后续 token 集合记作 $\mathcal I_{\mathrm{local}}$,定义
完整注意力可以精确重写为
把 $\alpha,\mathcal A$ 换成学习到的函数,便得到 Nectar:
原文 Eqs. (3.4)–(3.5),PDF p. 5。前一个等式只是把 softmax 的求和分组,没有近似;误差来自之后用网络替代文档的两个函数。实现上,将 $a_\theta$ 作为一个虚拟 logit、$A_\theta$ 作为其 value,与局部 token 共同做 softmax。
当 $Z_{\mathrm{local}}>0$,也可写成以下教学形式:
score 决定文档与当前对话的混合权重,target 决定文档贡献的内容。举一个标量例子:若文档权重和为 9、读出值为 2,局部权重和为 3、读出值为 10,正确输出是 $(9\times2+3\times10)/12=4$。只知道两个读出值,却不知各自权重,便无法确定这个结果。
这里的 local 指文档之后的指令及生成序列,并未规定一个固定大小的滑动窗口。它们的精确 KV-cache 仍然存在,随对话长度增长。原文 Eq. (3.4) 采用 $i\le t$ 的索引;实际实现应使拆分前后使用相同的因果可见集合。
2.3 离线训练:内部回归与输出蒸馏
训练先为文档构造 instruction–response 对,再用完整缓存的基础模型获取 query、文档注意力输出和 log-normalizer。query 来自真实模型激活,而非在 $\mathbb R^d$ 中随意采样;其位置、指令内容及前序 response token 都影响分布。
回归目标为
$h'$ 遍历 KV 头 $h$ 对应的 query 头;score 损失是相应的标量平方误差。$\mathcal L_{\mathrm{KL}}$ 在 teacher forcing 下,让 Nectar 模型的 next-token 分布匹配完整缓存模型;只更新模块参数 $\theta$。(Eqs. (3.2)–(3.3),PDF pp. 4–5)
| 训练方式 | 监督位置 | 作用 |
|---|---|---|
| 纯回归 | 每层、每头的 score 与 target | 直接约束内部算子逼近 |
| 纯蒸馏 | 最终 next-token 分布 | 允许内部表示变化,只要求模型输出分布接近 |
| 混合 | 内部回归与最终分布 | 兼顾局部逼近和误差经多层传播后的影响 |
MLP 通常使用 $(\lambda_\alpha,\lambda_{\mathcal A})=(0.1,1)$。虽然方法允许令 $\lambda_{\mathrm{KL}}=0$,附录实际生成结果显示纯回归会产生退化文本;“可以训练”与“生成可用”必须分别判断。
2.4 两类函数表示
Quadrature:可学习的少量 KV 对。 每层、每个 KV 头保留 $p$ 对参数 $\mathbf W,\mathbf Z\in\mathbb R^{p\times d}$:
参数数为 $2pd$,初始化为原 KV-cache 的前 $p$ 行。score 与 target 共享 keys,因此作者令这类架构的 $\lambda_\alpha=0$。在本文数据构造下,Quadrature 配合纯 KL 蒸馏就是 Cartridges 训练基线。它保留了“对少量可学习槽做注意力”的结构。(Sec. 3.3,PDF p. 5)
MLP:直接预测函数值。 原文采用反复注入输入 query 的网络:
score 输出 1 维,target 输出 $d$ 维;可选共享 backbone,使用 $(D_b,D_s,D_t)$ 表示 backbone、score、target 的深度。宽度按参数预算确定;散点中主要展示 $(0,2,3)$ 与 $(2,1,2)$。相比 Quadrature,MLP 不要求输出由少量固定 value 的 softmax 混合产生,因而有更自由的函数表示。(Eq. (3.6),PDF pp. 5–6;App. A.3,p. 13)
设计灵感来自 log-sum-exp 的凸性和最大内积搜索:低温极限下,$\beta^{-1}\log\sum_j e^{\beta\mathbf q^\top\mathbf k_j}\to\max_j\mathbf q^\top\mathbf k_j$。但本文只是借用输入跳连结构,并未给出保证网络凸性的权重约束;不能将这套 SiLU MLP 直接等同于有凸性保证的网络。另一个容易混淆的地方是:$\nabla\alpha$ 给出加权的 keys,注意力输出则加权 values,一般不能靠 score 的梯度替代 target 网络。(App. B,PDF pp. 15–16)
2.5 压缩率与“固定成本”的准确含义
以一个层、KV 头计,$\rho=|\theta|/(2nd)$。在相同存储精度下,$\rho=2\%$ 对应静态文档状态缩小约 50 倍,$10\%$ 对应约 10 倍。原模型权重、局部 token KV-cache 和运行时工作区均不包含在这个比值里。
对已经训练完成、大小固定的模块,文档读取成本不再显式遍历 $n$ 个 token。生成 $T$ 个后续 token 的粗略成本由 $O(Tnd+dT^2)$ 变为 $O(T|\theta|+dT^2)$,省略固定的模型层数和头数。若在不同文档上始终保持同一个 $\rho$,模块预算 $|\theta|=\rho\,2nd$ 本身仍随文档长度增长;因此固定网络的查询成本与固定压缩比例下的跨长度扩展是两回事。(Fig. 1,PDF p. 2;Sec. 4.1,p. 7)
三:实验——先分清各组实验在测什么
3.1 模型和文档
单步逼近实验覆盖 Qwen3-1.7B、Qwen3-4B、Qwen3-8B 和 Qwen2.5-7B-1M。三个 Qwen3 模型统一使用 4 倍 YaRN 扩展,完整缓存参考模型也采用同样设置;Qwen2.5-7B-1M 原生支持长上下文。开放生成的定量质量比较只使用后者,且只评测 Heart of Darkness、LongHealth、Great Gatsby 三份文档。(Sec. 4,PDF pp. 6–9)
| 文档 | 上下文 token 数 | 合成样本数 |
|---|---|---|
| Time Machine | 40,022 | 117,111 |
| Heart of Darkness | 49,313 | 117,120 |
| LongHealth | 59,031 | 103,592 |
| Great Gatsby | 61,651 | 114,896 |
| IP Intro | 122,466 | 228,193 |
来源:Table 1,PDF p. 7。这里是五个固定知识源上的文档专属训练,模块没有在未见文档上直接复用。
3.2 自学习数据与训练开销
文档分成约 2,000 词且可重叠的块;Qwen3-8B 每块生成约 10 对样本:5 个 QA、1 个摘要、2 个引用、2 个改写。问题必须点名具体实体或事件,能够在全文中独立定位。Qwen2.5-7B-Instruct-1M 再读全文回答,并依据任务相关的一致性标准过滤,置信度低于 0.7 的样本被丢弃。之后随机划分 80% 训练、20% 测试。(App. A.1,PDF pp. 12–13;App. I,pp. 24–25、34–36)
模型缓存每个非文档 token 的注意力 target 和 score,使用 float32 保存监督值。缓存阶段允许最多 512 个 query token,训练阶段则将指令和回答总长度限制为 196 token,过滤更长样本。两者是不同阶段的上限。学习率峰值基准为 $10^{-4}$,采用预热与余弦衰减、全局梯度裁剪;基础模型不更新。(App. A.2–A.5,PDF pp. 13–14)
训练预算也应按实验读取:App. A.4 写通用预算 1M datapoints,而 Table 8 明确列出 Qwen2.5-7B-1M 在 $\rho=5\%,10\%$ 时使用 1.5M 样本。主文称优化器为 AdamW,附录称 Adam;复现实验时需结合实现确认权重衰减设置,不能把两个名字默认为同一配置。
3.3 对照、指标和评审规则
| 指标或对照 | 衡量内容 | 方向与解释 |
|---|---|---|
| 完整 KV-cache 模型 | 同一基础模型读取完整文档的行为 | 是质量参考,也是蒸馏教师 |
| Quadrature + 纯 KL | 本文协议下的 Cartridges 基线 | 与 MLP 比较表示形式 |
| score / target MSE | 内部注意力函数逼近 | 越小越好,受目标尺度影响 |
| Token-accuracy gap | 完整缓存与替换模型的 next-token 准确率差 | 正值表示替换后下降;按百分点理解,不是自由生成答案正确率 |
| LM CE gap、eval KL | token 级分布变化 | 辅助判断输出分布是否接近教师 |
| $\Delta_s=\bar s_{\mathrm{base}}-\bar s_{\mathrm{Nectar}}$ | 自由生成答案对参考答案的语义评分差 | 1–5 分量表;越小越好,负值表示 Nectar 均值更高 |
生成评测对每份文档随机抽取 500 个 held-out 指令。用 nucleus sampling($p=0.8$、温度 $0.7$),QA 最多生成 64 token,其余任务最多 196 token;GPT-5.2 以任务相关 rubric 打 1–5 分。评审依据语义匹配,连 quoting 任务也允许轻微措辞和边界差别。因此这些结果不能当作逐字引用的 exact-match 准确率。(App. F、H,PDF pp. 21、23–24、32–33)
论文另有 Nectar 与 base 输出的成对相似度评审,其规则允许“共享同一个错误”算高度一致;主表 $\Delta_s$ 用的是两者分别对参考答案的评分差。二者不应混用。
聚合方式决定数字含义。 Table 3 在每个固定容量下,为每份文档挑选最好配置,再跨三份文档平均。Table 4 固定蒸馏权重,对各“文档×容量”单元选优并平均。Table 5 先按四任务平均分给每份文档选定一个最佳配置,再展示该配置的任务分数。它们均是搜索后聚合,不代表一个统一超参数在所有文档上的结果;报告的置信区间也不是多次独立训练的种子方差。(Sec. 4.3,PDF p. 9)
四:结果——质量收益依赖训练信号与查询分布
4.1 注意力逼近与 next-token 指标
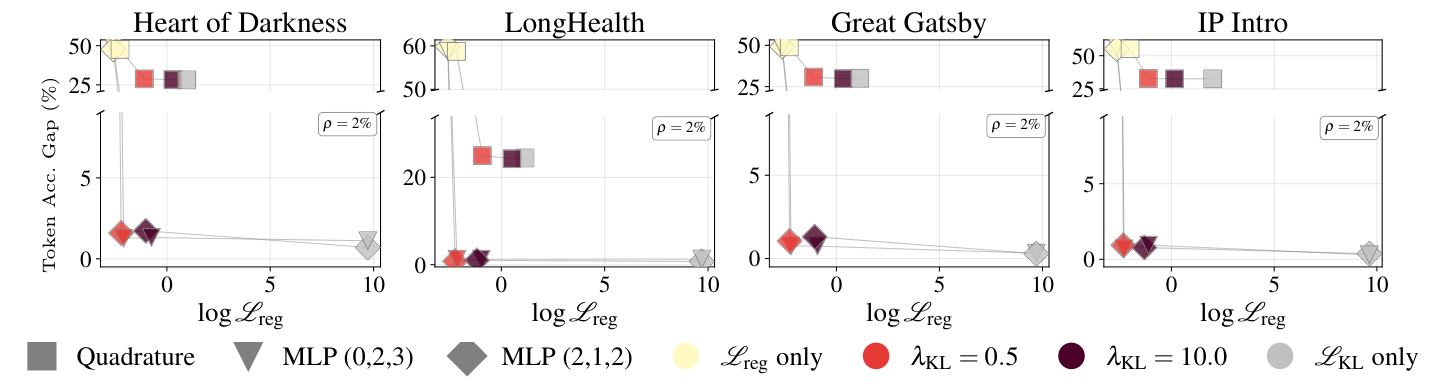
原文 Fig. 4,PDF p. 7,$\rho=2\%$。四个面板依次是 Heart of Darkness、LongHealth、Great Gatsby、IP Intro;横轴为 $\log\mathcal L_{\mathrm{reg}}$,纵轴为 token 准确率差;形状区分架构,颜色区分损失。纵轴有断轴,跨面板观察高度时应同时看刻度。
作者据 Figs. 2–5、10–11 认为低回归误差通常伴随较小的 token 准确率差,且较大模型上 MLP 相对 Quadrature 更有优势。图中确实可以看到 MLP 混合目标到达较好的联合区域,而 Qwen2.5 的 Quadrature 在不少配置中仍有很大准确率损失。
但散点还揭示了更具体的取舍:跨训练目标比较时,两个指标并不单调一致。 纯回归点可处于横轴靠左、准确率差却很高的位置;纯蒸馏的 MLP 则可能保留较大的内部 MSE,同时获得接近零的 token 差距。混合目标的价值是同时改善内部拟合和输出行为,不能将回归误差作为脱离损失配置的通用质量排序器。(Sec. 4.2,PDF pp. 7–8;Fig. 10,p. 22)
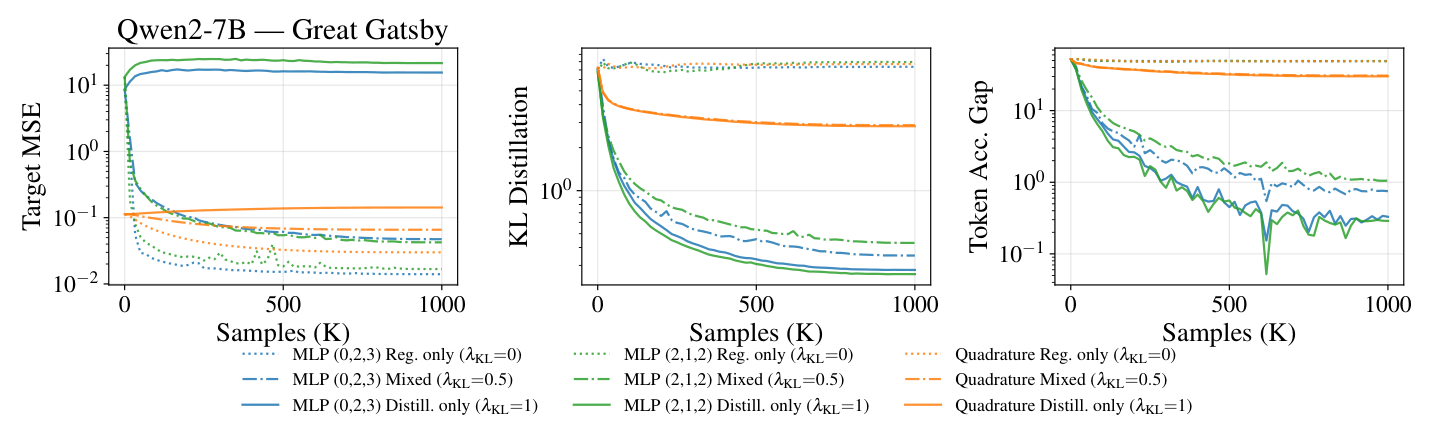
原文 Fig. 9 的 Great Gatsby 行,PDF p. 21;图沿用作者的 Qwen2-7B 简写。横轴为累计训练样本数,三个面板分别是 target MSE、KL 和 token 差距;图例同时区分纯回归、混合与纯蒸馏。纯蒸馏曲线可以在 MSE 上升时改善输出分布,说明内部逼真与输出行为是不同目标。附录概述中的“target MSE 单调下降”不适用于所有损失曲线。
补充指标 RTE 的原文定义为
它以“直接用 query 近似 target”的平方距离作为基准,越低越好。对单个层、头,指数化期望对数可以解释成误差比的几何均值;按 Eq. (C.1) 对层、头求和后,指数化结果是各组几何均值的乘积,需除以组数后再指数化才对应跨组几何平均。论文紧随公式给出的全局几何均值解释省略了这一归一化区别。(App. C.4,PDF p. 17)
Figs. 12–13 将 token gap 与 target RTE 对照,Figs. 14–15 改看 LM 交叉熵差,Fig. 16 则评估教师与学生 top-$K$ 分布的 KL。它们进一步展示损失选择的重要性:在 Qwen3-8B 的 Fig. 16 中,纯回归点的 KL 较高,混合训练降低了 KL;纯蒸馏也可在内部 RTE 较差时维持较小的 KL。输出分布接近与内部函数逼近需要分别观察。(PDF pp. 23–25)
4.2 单步接近教师,仍可能生成失败
在作者采用的 YaRN 设置下,所有三个 Qwen3 模型均出现自由生成失效,包括读取完整缓存的基础模型。作者推测问题与长上下文扩展有关,因此把正式生成质量评测限定在原生支持 1M 上下文的 Qwen2.5-7B-1M。这里的证据支持“这些模型在本文设置下失效”;对 YaRN 的归因是作者假设。(Sec. 4.3,PDF p. 8)
这使模型质量评估形成两层要求:先确认完整缓存教师在目标文档上能正确生成,再判断替代模块是否保留这种能力。对一个已经失效的教师做到低 MSE 或低 token gap,本身不能解决任务。
4.3 随机问题:容量提高后,MLP 接近完整缓存
| 容量 $\rho$ | MLP $\Delta_s\downarrow$ | Quadrature $\Delta_s\downarrow$ |
|---|---|---|
| 2% | $0.28\pm0.26$ | $2.25\pm0.22$ |
| 5% | $-0.02\pm0.39$ | $2.23\pm0.21$ |
| 10% | $-0.14\pm0.34$ | $2.22\pm0.26$ |
来源:Table 3,PDF p. 9;Qwen2.5-7B-1M、三文档、各文档各容量选优;$\pm$ 为跨文档的 95% Student-$t$ 置信区间。
MLP 的跨文档平均差距随容量缩小,Quadrature 在这套数据和训练协议下仍损失约 2.2 分。$\rho=10\%$ 的 MLP 均值虽然为负,但区间为约 $[-0.48,0.20]$,跨过零,因而“接近完整缓存”比“已经确证优于完整缓存”更符合这组证据。这里也不能将 Quadrature 的失败推广成所有 Cartridges 实现的结论。
按文档拆开看,MLP 从 2% 到 5% 再到 10% 的差距分别为:Heart of Darkness $0.18\to-0.14\to-0.05$,LongHealth $0.39\to0.16\to-0.30$,Great Gatsby $0.26\to-0.08\to-0.08$。所以单调改善成立于 Table 3 的跨文档平均,不成立于每一份文档。(Table 13,PDF p. 20)
4.4 蒸馏是自由生成的重要条件
| MLP 训练目标 | 随机测试 $\Delta_s\downarrow$ | 聚合口径 |
|---|---|---|
| 纯 KL | $0.36\pm0.33$ | 固定目标,跨文档与容量 |
| 回归 + $0.01\,\mathrm{KL}$ | $0.25\pm0.13$ | 同上 |
| 回归 + $2\,\mathrm{KL}$ | $0.28\pm0.37$ | 同上 |
| 回归 + $10\,\mathrm{KL}$ | $0.53\pm0.24$ | 同上 |
来源:Table 4,PDF p. 9。小权重混合目标的平均差距最小,但各文档、容量的最优损失并不统一。
更关键的是 Table 14:纯回归 MLP 的 $\Delta_s$ 为 2.22、2.22、2.36(依次对应三份文档),表中各容量列给出的值相同,作者报告生成文本退化。在 $\rho=2\%$ 时,加入 $\lambda_{\mathrm{KL}}=0.01$ 后三者变为 0.18、0.39、0.26,且都优于对应的纯 KL 配置 0.98、1.04、0.62。这组结果说明:内部监督可以改善小容量模块,但自由生成需要输出层面的信号约束误差传播。(App. E.1,PDF pp. 19–20、26)
容量更高时,最优目标有变化:Heart of Darkness 在 5% 和 10%、LongHealth 在 10% 时由纯 KL 取得最小表内差距;Great Gatsby 在 5% 和 10% 时由混合目标 $\lambda_{\mathrm{KL}}=2$ 取得最好结果。论文结论中“混合优于任一单项”的概述需要限定到具体实验和聚合方式。
4.5 任务分解和生成实例
| 任务 | MLP $\Delta_s\downarrow$ | Quadrature $\Delta_s\downarrow$ |
|---|---|---|
| 改写 | $0.19\pm0.59$ | $2.60\pm0.53$ |
| QA | $-0.46\pm0.66$ | $2.01\pm0.82$ |
| 引用 | $-0.10\pm1.01$ | $2.09\pm0.41$ |
| 摘要 | $-0.33\pm1.06$ | $2.16\pm0.27$ |
| Overall | $-0.18\pm0.46$ | $2.22\pm0.42$ |
来源:Table 5,PDF p. 10。每份文档先固定一个四任务平均最好的配置,再做任务分解;宽区间体现了聚合单元少、不同任务和文档差异较大。
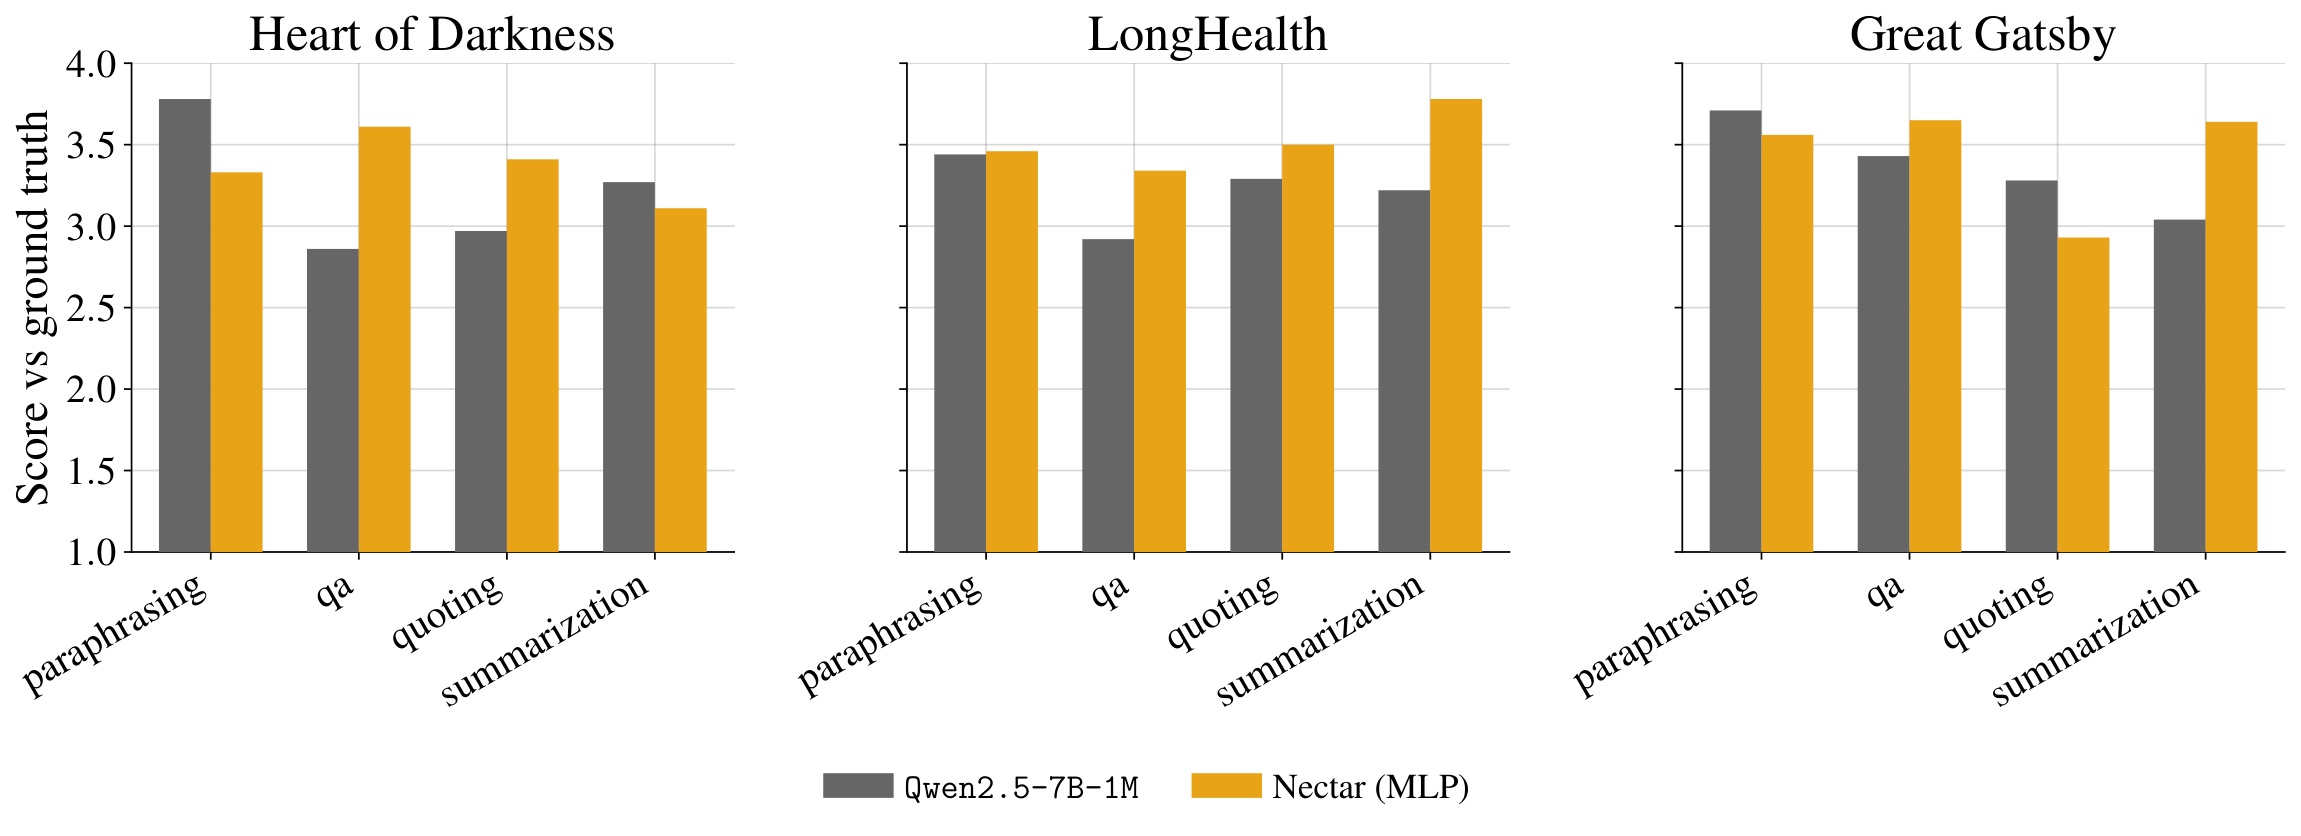
原文 Fig. 17,PDF p. 25。纵轴为绝对语义评分,越高越好;灰色为完整缓存,黄色为 MLP。MLP 在不同文档、任务上有升有降。例如 Heart of Darkness 的改写略差、QA 更高,Great Gatsby 的引用略差、摘要更高。图与 Table 6 不支持附录开头“LongHealth 在所有任务上差距更大”的概括,应以具体图表为准。
QA 专项结果更好:Table 15 给出 2%、5%、10% 容量的 $\Delta_s$ 分别为 $-0.14\pm0.41$、$-0.45\pm0.66$、$-0.44\pm0.36$;但这是 QA 专项选优及聚合,不能代替四任务总体结果。(PDF p. 26)
Tables 24–26 提供了 10% 容量下的配对生成例子:MLP 往往能提取人物、事件或病历中的关键事实,Quadrature 常产生无关片段。不过,Table 2 的 MLP 回答在正确说出 Tom 的橄榄球经历之外,还补充了参考答案未提供的“参加决赛”细节。这说明语义相似度较高并不意味着每个额外事实都得到验证。(PDF pp. 9、29–31)
4.6 Challenge split:同一文档内也存在明显分布外差距
作者用 all-MiniLM-L6-v2 嵌入每条测试指令,计算其与任意训练指令的最大余弦相似度,再为每份文档选出最大相似度最低的 500 条指令。文档没有改变,变化的是提问方式和所覆盖内容与训练问题的接近程度。(App. F,PDF pp. 21–22)
| 容量 $\rho$ | 随机问题 MLP $\Delta_s$ | Challenge MLP $\Delta_s$ | Challenge Quadrature $\Delta_s$ |
|---|---|---|---|
| 2% | $0.28\pm0.26$ | $1.40\pm0.54$ | $2.79\pm0.23$ |
| 5% | $-0.02\pm0.39$ | $1.28\pm0.49$ | $2.78\pm0.23$ |
| 10% | $-0.14\pm0.34$ | $1.18\pm0.43$ | $2.78\pm0.23$ |
来源:Tables 3、19,PDF pp. 9、27。MLP 仍明显好于本文的 Quadrature 基线,但与完整缓存相比,分布外损失已达到约 1.2–1.4 分。10% 容量时,随机与 challenge 的差距相差约 1.32 个评分点;两组指令上的完整缓存分数不同,因此这个差不能直接当作 Nectar 自身绝对得分下降量。
Table 21 的最佳配置任务分解为:改写 0.79、QA 0.95、引用 1.98、摘要 0.78,Overall 1.12。引用在 challenge 上最困难,即使评分规则允许轻微措辞差别,仍接近两分损失。Table 20 也显示混合目标的收益缩小:纯 KL 为 $1.49\pm0.25$,回归加 0.01 KL 为 $1.46\pm0.16$。(PDF p. 27)
这一结果直接检验了方法的关键假设:模块必须在将来 query 实际访问的区域学好函数。随机划分的同文档自学习问题能支持较好的结果,远离训练问题的指令则暴露出泛化不足。它比单纯增加文档长度更直接地解释了为什么“文档固定”仍不足以保证任意问题都能回答。
4.7 容量消融:层间分配和双头分配
层间分配。 在 Qwen3-1.7B、$\rho\approx2\%$、$\lambda_{\mathrm{KL}}=0.01$ 下,作者把 28 层分为 $[0,9)$、$[9,15)$、$[15,27)$、$[27,28)$,使用乘数 $(1,2,5,2)$,并归一化保持总容量不变。对照是均匀分配。(App. C.1、Table 10,PDF p. 16)
| 三文档平均指标 | 均匀分配 | 加权分配 | 变化 |
|---|---|---|---|
| Score MSE | 0.056 | 0.074 | 变差 0.018 |
| Target MSE | 0.256 | 0.224 | 改善 0.032 |
| Token-accuracy gap | 0.76 pp | 0.60 pp | 改善 0.16 个百分点 |
增加中后层容量提高 target 的逼近质量和最终 token 指标,即使 score MSE 略差。这支持按不同层对最终误差的影响来分配预算,而不是追求所有内部指标都同步变小。作为计算说明,这四组分别含 9、6、12、1 层,乘数的层数加权平均为 $83/28$;归一化需要考虑组大小。
score/target 分配。 Table 11 在总容量 10% 下比较 score/target 占原缓存的 $1\%/9\%$ 与 $2.5\%/7.5\%$,层间乘数改为 $(1,2,8,12)$,不能与上一组设置混用。混合训练时平均 token gap 为 0.34 与 0.47 pp,更多容量给 target 更好;纯蒸馏时则是 0.24 与 0.20 pp,方向相反且差距较小。结论应限定为“在这组有 score 回归监督的混合训练中,优先保障 target 容量更有效”。(App. C.2,PDF pp. 16–17;表中模型简写为 Qwen2-7B)
4.8 存储、推理和离线训练成本
Table 9 的解析存储估算以约 62K token、bfloat16 为基准:
| 模型 | 模型权重 | 原文档 KV | 2% 模块 | 5% 模块 | 10% 模块 |
|---|---|---|---|---|---|
| Qwen3-1.7B | 3.44 GB | 7.11 GB | 142 MB | 356 MB | 711 MB |
| Qwen3-4B | 8.04 GB | 9.14 GB | 183 MB | 457 MB | 914 MB |
| Qwen2.5-7B-1M | 14.14 GB | 3.56 GB | 71 MB | 178 MB | 355 MB |
来源:Table 9,PDF p. 15。这里是原文档状态的压缩,不是全进程显存减少 50 倍;例如 Qwen2.5 的模型权重本身仍占约 14 GB。
该表另列 Qwen3-8B 的 KV 为 16.25 GB,但 Sec. 4.1 用了 64 层,而 Qwen 官方 Qwen3-8B 配置 为 36 层、8 个 KV 头、$d=128$。按官方配置及 $n=62,000$ 重算,文档 KV 为约 9.14 GB。这个差异影响该行的存储估算,部署时应依据实际 checkpoint 配置计算,不能直接沿用 16.25 GB。
推理计时选取 Table 12 的短、长两个端点:
| 模型 / 文档长度 | TTFT:Base → Nectar | 解码 tok/s:Base → Nectar | 峰值显存 GB:Base → Nectar |
|---|---|---|---|
| Qwen3-1.7B / 40,022 | 183,000 → 26.4 ms | 9.5 → 44.2 | 24.9 → 7.7 |
| Qwen3-1.7B / 122,466 | 299,900 → 29.3 ms | 4.4 → 37.7 | 60.4 → 8.2 |
| Qwen3-4B / 40,022 | 347,900 → 44.6 ms | 6.3 → 18.4 | 38.6 → 16.7 |
| Qwen3-4B / 122,466 | 557,600 → 50.1 ms | 1.5 → 15.7 | 84.2 → 17.1 |
来源:App. D、Table 12,PDF pp. 18–19。122K 时,解码提升分别为约 8.6 倍和 10.5 倍,峰值显存下降约 7.4 倍和 4.9 倍。
这组计时有两个决定性条件。首先,Base 包括完整文档 prefill,而 Nectar 使用已训练好的模块,离线数据生成、目标缓存及训练时间不进入 TTFT;它没有直接比较“已有可复用 prefix KV 的服务”。其次,计时模型是本文自由生成失败的 YaRN-Qwen3,质量主结果来自 Qwen2.5-7B-1M。因此论文分别提供了速度潜力和生成质量证据,尚未给出同一可用生成配置下的完整质量—速度比较;计时表也未绑定明确的模块容量与架构。
离线成本不可忽略。Table 8 在单个 8-GPU 节点上的平均训练时间,已经统一扣除 1 小时数据加载与编译开销:
| 模型 / 容量 | 训练样本预算 | 纯回归 / 混合 / 纯蒸馏 |
|---|---|---|
| Qwen3-1.7B / 2% | 1M | 13.2 / 12.9 / 11.8 小时 |
| Qwen3-4B / 2% | 1M | 26.2 / 25.0 / 24.8 小时 |
| Qwen2.5-7B-1M / 2% | 1M | 16.4 / 16.3 / 16.5 小时 |
| Qwen2.5-7B-1M / 5% | 1.5M | 23.7 / 23.8 / 24.0 小时 |
| Qwen2.5-7B-1M / 10% | 1.5M | 23.7 / 24.0 / 23.8 小时 |
来源:App. A.6、Table 8,PDF pp. 14–15。不同训练目标耗时接近,但文档专属模块需要大量重复访问才能摊销这笔离线支出;现有结果不足以算出实际服务的盈亏平衡请求数。
五:结论与研究启发
Nectar 最值得保留的设计是将固定上下文拆成 query-dependent content 与 query-dependent mass:前者负责读出,后者保留与新上下文共同归一化的接口。这个接口让通用 MLP 可以接入已有 softmax Transformer,同时保持后续 token 的精确因果注意力。
实验表明,文档专属 MLP 能在很小的静态状态预算下保留相当一部分长上下文能力;小容量时内部回归与少量蒸馏的结合尤其有效。评价这一结果时,应同时看三层证据:内部函数误差、单步输出分布、自由生成任务表现。本文自身提供的纯回归和 YaRN-Qwen3 失败例子,说明前两层不能替代最后一层。
适用场景是长期稳定、被高频访问、查询类型可提前覆盖的知识源。实际采用时最需要补齐的实验,是在生成质量正常的同一基础模型和模块上,比较复用 prefix KV、Nectar 及其他压缩方案的显存、解码速度、训练摊销,并测试真实用户问题和更长的生成过程。本文训练 query 长度及生成上限较短,不能直接推断长对话中的模块误差会保持相同水平。
一个直接的后续方向是针对查询覆盖不足构建训练集,而不只是盲目加宽所有模块;challenge split 的大幅退化和层间容量消融都支持这种有针对性的分配思路。作者还提出跨上下文元学习、由文档直接生成模块、按文档结构组合多个模块等方向。若组合多个上下文,每个模块输出 score 与 target 为再次做 softmax 分组合并提供了形式基础,但重叠内容、不同上下文下的激活及位置编码对齐仍需单独研究。这是由本文接口得到的研究启发,尚不是已验证的系统能力。