MELT:中文精读笔记
论文:Memory-Efficient Looped Transformer: Decoupling Compute from Memory in Looped Language Models
作者:Victor Conchello Vendrell、Arnau Padrés Masdemont、Niccolò Grillo、Jordi Ros-Giralt、Arash Behboodi、Fabio Valerio Massoli(Qualcomm AI Research;前两位共同一作)。
版本:arXiv:2605.07721v2,2026-05-19 修订;本次获取与研读日期:2026-09-20。
材料:原文 PDF、同版本作者 TeX 源码。已沿主文件 neurips/neurips_2026.tex 阅读正文全部章节及实际引用的附录 A–G;排除注释中的旧稿。PDF 共 22 页,下文页码均从 PDF 第 1 页计算,与印刷页码一致。参考文献用于确认论文内部脉络,未逐篇阅读引用文献;未执行作者代码或复现实验。
论文总览
MELT 把循环 Transformer 中“每层、每个 token、每一轮各存一份 KV”改成“每层、每个 token 只保留一份可学习更新的记忆”。因此推理 KV 缓存对循环次数 $T$ 不再线性增长,但仍随 token 数 $L$ 增长。门控更新只解决表示方式;分块训练、渐进插值和注意力输出蒸馏共同解决把预训练 Ouro 改造成 MELT 后的分布变化。
最可靠的结果是一个性能—缓存容量折中:在四轮循环设置下,每 token KV 缓存恰为 Ouro 的四分之一;MATH-500 从 Ouro 的 94.4 降至 93.4,HumanEval 从 76.8 升至 81.7。不能将摘要中的“不牺牲性能”理解为所有任务无损,更不能理解为任意循环深度已验证有效。(表 1–2,PDF pp.6–7)
结构地图
| 原文章节 | 作用与证据 | PDF 页码 |
|---|---|---|
| Abstract / Fig.1 | 概览;图 1 左图标注有误,见后文 | 1 |
| 1 Introduction | 循环推理的缓存瓶颈与三项贡献 | 2 |
| 2 Related work | 循环模型、KV 共享、架构迁移与蒸馏 | 2–3 |
| 3.1 Preliminaries | 层数、循环次数、token 数的区分 | 3 |
| 3.2 Architecture | 共享缓存、门控状态、式 (1)、图 2 | 3–4 |
| 3.3 Training details | 分块、插值、注意力对齐;图 3 | 4–6 |
| 4.1 Experimental setup | 初始化、数据、评测设置 | 6–7 |
| 4.2 Results | 表 1 主结果 | 6–7 |
| 4.3 Exact memory usage | 表 2 显存统计及估算 | 7 |
| 4.4.1 Gate mechanism variants | 表 3 第一阶段门控消融 | 8 |
| 4.4.2 Component removal | 表 4 累积移除训练组件 | 8–9 |
| 5 Limitations and future work / 6 Conclusion | 固定循环、无 GQA、训练并行性 | 9 |
| References | 引用清单 | 10–14 |
| A Extended Related Work | 扩展背景 | 15–16 |
| B Analysis of existing KV-Cache sharing methods on long reasoning | 表 5、图 4:不训练直接共享的失败 | 16–17 |
| C Attention Alignment Loss | 图 5 层级与循环级教师监督 | 17–18 |
| D Hyperparameters | 表 6–7:训练与评测配置 | 18–19 |
| E Theoretical analysis | 饱和门控下的局部 Jacobian 分析 | 19–20 |
| F Notes on reproducibility and inference efficiency in Ouro | 作者的复现与早退观察 | 20–21 |
| G Existing assets | 表 8–11:资源与代码库清单 | 21–22 |
一:动机
循环模型重复使用同一组 Transformer 层,把参数量与有效计算深度分开。但权重共享并不自动带来 KV 共享:Ouro 为不同循环保留对应缓存,后续 token 在相应循环访问这些表示。因此固定层数和上下文长度后,增加循环仍增加推理缓存。
MELT 希望保留完整的 token 轴注意力,却沿循环轴压缩历史。它不是删去旧 token,也不是将整个上下文压缩成一个固定向量;每个历史 token 仍有一个可寻址的状态。相比 head 维共享的 GQA、layer 维共享的方法,本文主要压缩 recurrence 维。(§2–3,pp.2–4)
为什么不直接复用最后一轮?附录 B 在 Ouro-1.4B-Thinking 上测试第一轮/最后一轮共享,各自再分保留/不保留原 prompt 缓存,共四种未经训练的策略,表 5 中 AIME24、AIME25、AMC23、MATH-500 全部为 0。图 4 的长推理文本先连贯、后退化。作者将其解释为缓存不匹配随生成累积,并推测与旧工作 few-shot CoT 协议不同有关;这里是特定设置下的失败证据,不是所有直接共享方法必然失败的证明。(pp.16–17)
二:方法
2.1 输入、输出与三个维度
输入是 token 序列;token 嵌入通过同一 $N$ 层网络 $\mathcal M$ 共 $T$ 次,最后由 lmhead 产生词表 logits。循环发生在连续隐状态中,但实验仍允许最多 32k 的文本 completion;“潜空间循环”不等于没有文本推理链。
| 符号 | 含义 |
|---|---|
| $N,L,T,d$ | 不共享参数的层数、token 数、循环次数、隐维度 |
| $l,t$ | 层与循环索引;不把 $t$ 与 token 序号混为一谈 |
| $x_t^{(l)}$ | 当前 token 在该层该轮的隐藏表示 |
| $h_t^{(l)}$ | 同一 token、同一层跨循环保留的记忆向量 |
| $z_t^{(l)}$ | 逐维 sigmoid 门控,维度为 $d$ |
| $W_z^{(l)},U_z^{(l)},b_z^{(l)}$ | 两个 $d\times d$ 门控矩阵与 $d$ 维偏置 |
2.2 门控记忆如何接入注意力
原文式 (1),§3.2,PDF p.4:
每个特征维自己决定保留多少旧状态。$z\approx1$ 偏向记住,$z\approx0$ 偏向覆盖。随后生成 $k_t^{(l)}=h_t^{(l)}W_K^{(l)}$、$v_t^{(l)}=h_t^{(l)}W_V^{(l)}$;查询仍由当前计算流获得,注意力后接标准残差与 FFN。作者认为先更新 latent 再投影有利于查询—键对齐;这是设计动机,正文并未给出对齐必然保持的证明。
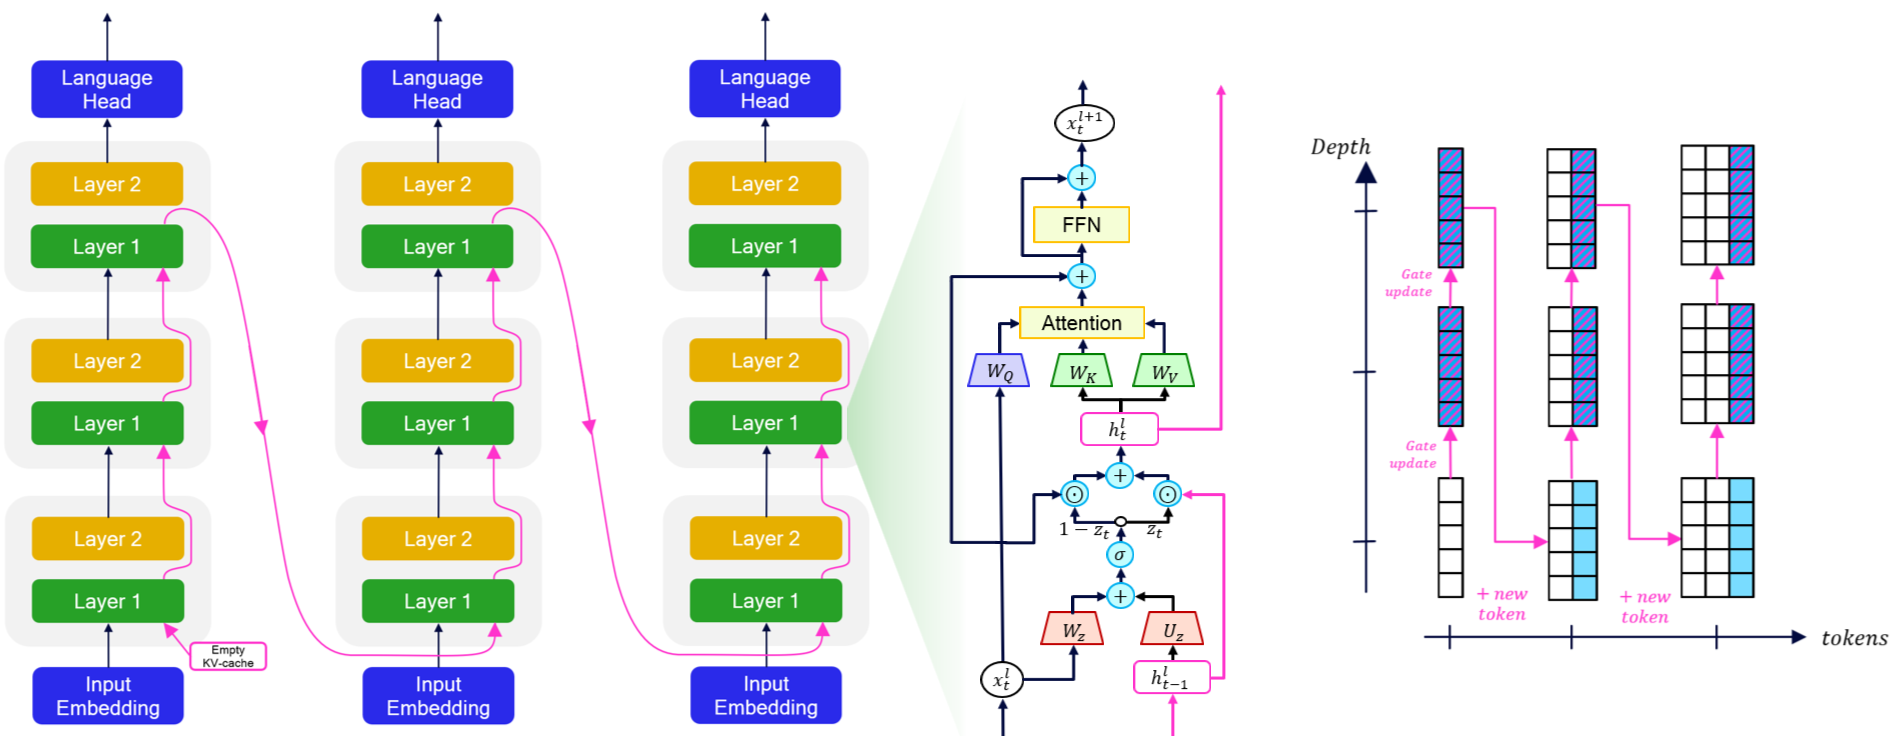
原图 2 的作者图件,PDF p.4。左侧展示两层网络重复三轮;中间展示层内门控与注意力;右侧横轴是 token,纵向表示循环深度。粉色路径追踪第一层缓存。每来一个新 token 新增一行;同一 token 的后续循环覆盖当前行,历史 token 保持最终状态。原文 $[K^{(l)},k_t^{(l)}]$ 中的 $K^{(l)}$ 是之前 token 的缓存,不应实现为每轮都永久追加当前 token。
教学例子(非实验):若某维 $z=0.2$,则 $h_t=0.2h_{t-1}+0.8x_t$。固定该门控并展开三轮,得到 $h_3=0.008h_0+0.032x_1+0.16x_2+0.8x_3$。早期信息被压缩而非逐份保存;实际 MELT 的门控随层、token、轮次与维度变化。
省略固定宽度与精度常数,缓存复杂度由 $O(NLT)$ 变为 $O(NL)$。若显式保留 KV 宽度,可写为 $O(NLTd_{KV})$ 与 $O(NLd_{KV})$。这里的“常数”仅相对于 $T$:上下文增长仍增加缓存,循环增加仍增加计算,训练激活、优化器与教师内存不由这项推理缓存结论涵盖。
2.3 分块训练:接受近似以恢复部分并行
推理时,后一个 token 读取前一个 token 完成所有循环后的最终记忆。全序列同轮并行训练无法严格重现这一依赖。逐 token 顺序训练又过慢。
因此把序列切成 chunk:块间顺序处理并传递最终状态,块内同轮并行计算。块越小越接近自回归推理,块越大吞吐越高、偏差也越大。论文使用 chunk=500、训练长度 10K,即约 20 块;没有报告完整 chunk 大小—性能—吞吐曲线。(§3.3,pp.4–5;表 6,p.18)
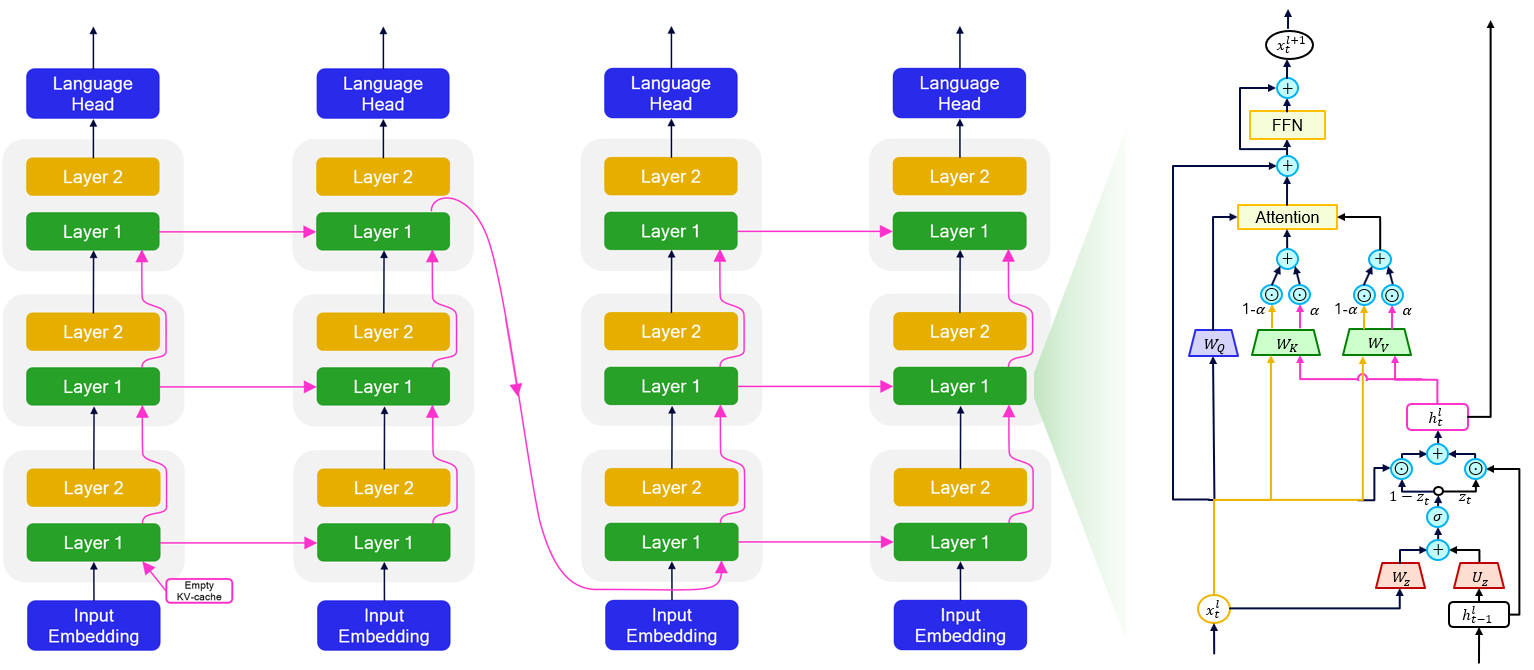
原图 3 的作者图件,PDF p.5。左图是四 token、每块二 token 的教学结构;粉色线强调块间传递。右图橙色是原模型 KV,粉色是 MELT KV,二者经 $\alpha$ 混合。图中示例尺寸并非实际训练 chunk=500。
2.4 两阶段迁移:先平滑改变架构,再约束表示漂移
阶段 1:插值过渡与所有循环蒸馏。 从 Ouro 预训练权重初始化,新增门控随机初始化,全模型微调。使用
$$KV=\alpha KV_{\mathrm{MELT}}+(1-\alpha)KV_{\mathrm{base}},\qquad\alpha:0\rightarrow1.$$混合对应注意力所用的 KV 表示,让模型逐渐适应新缓存语义;这不是把完整的 $T$ 份历史缓存数组与一份数组直接广播相加。原文没有给出完整张量实现。教师在全部循环提供知识蒸馏(KD)监督,而非只监督最终输出。500 步、160M token。
阶段 2:注意力输出对齐。 在纯 MELT 动态下继续训练,冻结原 Ouro 教师:
$o$ 为 post-attention 表示,$\mathrm{sg}$ 阻止梯度流进教师。这里对齐的是注意力输出,不是 attention probability 矩阵。$\beta=0.1$;300 步、96M token。作者报告不约束地继续训练会漂移;这一阶段用于保留教师的内部计算。(§3.3,pp.5–6;附录 C 图 5,p.18)
论文未充分展开 $\mathcal L_{KD}$ 的精确计算、温度及全部归一化方式,也未在正文明确当前 token 初始 $h_0$ 的实现细节;复现时需查代码,不能由上述示意补造配置。
2.5 理论分析能支持什么
附录 E(pp.19–20,式 (2)–(3))对当前 token 的状态写出
$$J_t=\operatorname{diag}(z_t)+\operatorname{diag}(h_{t-1}-x_t)\frac{\partial z_t}{\partial h_{t-1}}+\operatorname{diag}(1-z_t)\frac{\partial x_t}{\partial h_{t-1}}.$$在相关维度 $z_t\to1$ 且其余量和导数受控时,第一项趋近单位矩阵,后两项趋零,形成近似恒等的梯度路径。连续情形的直觉是 $(1-\epsilon)^T$,要使衰减小,需 $\epsilon\ll1/T$。
本次分析:这解释了门控为什么可能保留梯度,但不是全模型任意深度训练稳定的无条件保证。门控落在 $[0,1]$ 不能单独界定后两项;逐步谱半径接近 1 也不自动保证非正规、时变 Jacobian 乘积范数稳定。实验仅训练四轮,EMA 消融选择 0.2 是因为观察到平均门值约 0.2,并不证明网络整体处于接近 1 的饱和区。保留维度可能存在,论文未给出相应分布证据。固定 $\epsilon>0$ 时无限增加 $T$ 仍会衰减。
三:实验
3.1 训练配置
| 配置 | 原文报告 |
|---|---|
| 初始化 / 最终规模 | Ouro-1.4B-Thinking / MELT-1.6B |
| 层数、隐维度、循环 | 24、2048、4 |
| 新增门控 | $24\times2048^2\times2\approx0.2$B 参数 |
| 数据混合 | 50% AceReason-1.1-SFT + 50% OpenThoughts3 |
| chunk / sequence / batch | 500 / 10K / 320K token |
| 学习率 | 主模型 $8\times10^{-6}$;门控 $5\times10^{-4}$ |
| 优化 | Adam,$(\beta_1,\beta_2)=(0.9,0.95)$;cosine + warmup |
| 正则与裁剪 | weight decay $10^{-4}$;梯度范数裁剪 1.0 |
| 两阶段数据量 | 160M + 96M = 256M token |
| 主运行成本 | 8×H100 80GB,130 小时,1,040 GPU-hours |
来源:§4.1、表 6,pp.6、18。约 20,000 GPU-hours 是作者对包含前期探索、消融、评测的项目总量估计,不能与主运行的 1,040 混用。“轻量”是相对于从头训练,而非普通单卡成本。
3.2 对照与指标
Ouro 是权重来源与高缓存容量的教师对照;Qwen3-1.7B、Gemma4-E2B、Qwen3.5-2B、DeepSeek-R1-Distill-Qwen-1.5B 是相近规模非循环模型。参数量、训练数据和计算量并未全部严格配平,因此比较不是纯架构的等 FLOPs 因果实验。
统一用 LightEval v0.8.1,默认 prompts 与答案提取;temperature=1.0、top-p=0.7、最大 completion 32k token。所有分数越高越好。(§4.1,pp.6–7)
| 基准 | 题数 | 每题 completion | 指标 |
|---|---|---|---|
| AIME24 / 25 / 26 | 各 30 | 16 | pass@1、pass@10 |
| AMC23 | 40 | 16 | pass@1、pass@10 |
| MATH-500 | 500 | 1 | accuracy |
| OlympiadBench | 581 | 1 | accuracy |
| GPQA | 448 | 1 | accuracy |
| HLE | 300(子集) | 1 | accuracy |
| MMLU-Red | 5700 | 1 | accuracy |
| HumanEval | 164 | 1 | accuracy |
来源:表 7,p.19。pass@10 衡量多次采样至少一次成功的能力,不是单次生成准确率,也不能作为“循环十次”的结果。表 1 报告 $\pm$ 数值,但文中未明确其统计构造及置信水平;不能据此直接声称差异显著,也不能把同一题的多次生成当完全独立题目。
四:结果
4.1 主结果:接近教师,平均优于所列相近规模模型
下表摘录表 1(p.6),单位为百分数;AIME/AMC 为 pass@1,其余为 accuracy。
| 基准 | Ouro | MELT | Qwen3-1.7B |
|---|---|---|---|
| AIME24 | 50.2 ±1.6 | 46.7 ±1.6 | 43.1 ±1.5 |
| AIME25 | 36.7 ±1.5 | 33.3 ±1.3 | 33.1 ±1.3 |
| AIME26 | 44.0 ±1.5 | 41.0 ±1.6 | 31.7 ±1.4 |
| AMC23 | 81.2 ±1.2 | 80.2 ±1.2 | 79.2 ±1.2 |
| MATH-500 | 94.4 ±1.0 | 93.4 ±1.1 | 90.6 ±1.3 |
| OlympiadBench | 67.5 ±1.9 | 64.7 ±2.0 | 63.5 ±2.0 |
| GPQA | 40.8 ±2.3 | 42.6 ±2.3 | 37.3 ±2.3 |
| HLE | 2.7 ±0.9 | 2.0 ±0.8 | 1.3 ±0.7 |
| MMLU-Red | 74.2 ±0.6 | 74.2 ±0.6 | 73.8 ±0.6 |
| HumanEval | 76.8 ±3.3 | 81.7 ±3.0 | 71.3 ±3.5 |
数学六项的表中平均:Ouro 62.3、MELT 59.9、Qwen3 56.9、Gemma4 56.0、Qwen3.5 40.7、DeepSeek 46.9;非数学四项平均依次为 48.6、50.1、45.9、45.5、37.1、36.1。这些是跨任务简单平均,不是按题数合并准确率。MELT 相对 Ouro 的数学均值低 2.4 个百分点,非数学高 1.5 个百分点。
MATH-500 相对 Ouro 低 1.0 个百分点,相对 Qwen3 高 2.8 个百分点;HumanEval 相对 Ouro 高 4.9 个百分点。HLE 的绝对准确率仍只有 2.0%,不能用整体平均掩盖这一弱项。
| 多样本指标 | Ouro pass@10 | MELT pass@10 |
|---|---|---|
| AIME24 | 81.5 | 79.9 |
| AIME25 | 69.0 | 61.9 |
| AIME26 | 73.2 | 75.5 |
| AMC23 | 96.6 | 97.8 |
MELT 并非逐项超过所有非循环对照:AMC23 pass@1 的 Gemma4 为 82.7,高于 80.2;GPQA 的 Qwen3.5 为 45.1,高于 42.6;MMLU-Red 的 Gemma4 和 Qwen3.5 均为 75.3,高于 74.2。
4.2 显存:4 倍是 KV 比率,整体数字是估算
表 2,p.7 的原报告值如下,保留原单位标注,不擅自修表:
| 模型 | KV MB/token | 权重 GB | 32k KV GB | 合计 GB |
|---|---|---|---|---|
| MELT-1.6B | 0.196608 | 3.272 | 6.29 | 9.49 |
| Ouro-1.4B-Thinking | 0.786432 | 2.869 | 25.17 | 27.97 |
| Qwen3-1.7B | 0.114688 | 3.442 | 3.67 | 7.07 |
每 token 比率 $0.786432/0.196608=4$,即 KV 下降 75%;原表合计比率 $27.97/9.49\approx2.95$,即表列整体估算下降约 66.1%。MELT 表列合计仍比 Qwen3 多 2.42 GB,不是完全相同的显存。
数值核验发现:正文定义 32k=32,768,但按表列 MB/token、十进制 GB 重算,MELT 应为 $32768\times0.196608/1000=6.44245$ GB,Ouro 为 25.76980 GB,Qwen3 为 3.75810 GB。表中 6.29/25.17/3.67 反而接近用 32,000 token 计算的数值。表内直接相加也不符:3.272+6.29=9.562,不等于 9.49;另外两行分别为 28.039、7.112,不等于 27.97、7.07。论文没有解释这些单位/舍入差异。按统一十进制、32,768 token、表列权重自行重算的合计是 9.71445 / 28.63880 / 7.20010 GB;这是本次算术核验,不是新实测。
作者的“Total”是 2 bytes/parameter 权重估算与 KV 统计之和,不是完整运行时峰值测量;不能据此断言某容量 GPU 一定可运行。训练教师、激活、临时工作区、分配器开销也不由该表覆盖。没有端到端延迟、tokens/s 或能耗结果,不能把省显存等同于更快。(§4.3)
4.3 门控消融:逐维可学习更新优于简化聚合
仅训练阶段 1,避免把阶段 2 收益混入门控比较;表 3,p.8:
| 门控/聚合策略 | AIME24 pass@1 | AIME25 pass@1 | AMC23 pass@1 | MATH-500 |
|---|---|---|---|---|
| MELT 逐维门控(P1) | 44.8 | 32.9 | 77.7 | 92.8 |
| Mean | 29.0 | 23.3 | 68.8 | 83.2 |
| EMA-0.2 | 30.2 | 21.5 | 68.6 | 84.6 |
| Last | 33.7 | 24.0 | 69.7 | 84.0 |
| Single-gated(每 token 一个标量) | 34.4 | 23.1 | 66.9 | 85.6 |
逐维门控在表中指标均最好;例如相对 Last,AIME24 高 11.1 个百分点,MATH-500 高 8.8 个百分点。固定平均门值 0.2 不能替代逐维动态选择。作者称无参数策略中 Last 最好,但这不是逐项成立:EMA 的 MATH-500 84.6 高于 Last 的 84.0。逐维门控也增加约 0.2B 参数,因此该实验不能完全排除容量差异的作用。
4.4 训练组件消融:累积移除,不是独立边际贡献
表 4,pp.8–9。每下一行是在上一行基础上继续删除并重新训练。
| 累积移除过程 | AIME24 pass@1 | AIME25 pass@1 | AMC23 pass@1 | MATH-500 |
|---|---|---|---|---|
| 完整两阶段 | 46.7 | 33.3 | 80.2 | 93.4 |
| 去阶段 2 注意力对齐 | 44.8 | 32.9 | 77.7 | 92.8 |
| 再去插值 | 35.4 | 26.9 | 73.0 | 86.6 |
| 再去所有循环 KD | 35.8 | 24.4 | 67.2 | 85.2 |
| 再去分块训练 | 0.0 | 0.0 | 0.0 | 0.0 |
插值对应 AIME24 从 35.4 到 44.8 的大幅变化;分块被完全去掉后的配置失败,支持训练需尊重新的时序依赖。阶段 2 的 pass@1/accuracy 总体提升,但 AIME25 pass@10 从 P1 的 66.1 降到 61.9,AMC23 pass@10 从 99.3 降到 97.8;去 KD 的 AIME24 pass@1 从 35.4 微升至 35.8。因此正文“所有基准一致改善”的措辞过强。
另外,移除阶段 2 同时减少训练量,表 4 没有一个与完整方案等步数但无对齐的明确结果行。不能把全部增益严格归因为对齐 loss,也不能将最后一行的 0 分解释为在其余组件全保留时仅取消分块的独立效果。
4.5 原文内部不一致清单
| 位置 | 需注意的差异 | 本笔记采用的口径 |
|---|---|---|
| 图 1,p.1 | 左面板说明写 MATH-500,实际纵轴是 AIME26 pass@1 | 以轴与表 1 数值核验,不拿它当 MATH-500 图 |
| §4.2,p.7 vs 表 1 | 声称 Qwen3 在 AIME25/AMC23 超过 MELT、Gemma4 在 GPQA 超过 MELT;表格并非如此 | 引用表格具体数值与真实领先模型 |
| §4.2 vs 表 1 | 声称 MELT 在 MMLU 超过对照 | MELT 74.2,两个对照为 75.3 |
| §4.3 vs 表 2 | 32,768 token、单位与合计不自洽 | 保留原数,并单列重新计算 |
| §4.4.2 vs 表 4 | “一致改善”忽略 pass@10 下降与局部反例 | 分指标描述,不声称普遍单调 |
这些问题削弱的是过强的叙述与绝对数值精度,不推翻每 token KV 比率为 4 的核心结果。
五:结论、局限与组会讨论
可靠贡献:保持 token 轴完整注意力的同时,以逐维门控整合循环历史;用分块训练与渐进迁移把已有循环模型转成共享缓存模型。证据最强的是四轮设置下的 KV 减量与可用性能,而不是任意深度能力扩展。
作者承认的边界(§5,p.9):固定推理循环次数;尚未结合 GQA;顺序 KV 更新限制训练并行性。自适应循环、GQA、更大模型和更长循环均为后续方向。v2 说代码与模型“将发布”,本次未额外核验后续发布状态。
本次分析补充:尚缺循环次数扫描、chunk 扫描、实际延迟/吞吐和显存峰值曲线,以及等训练量的注意力对齐对照。单一 Ouro 初始化与 1.6B 规模不足以支持广泛架构结论。MELT 的数学平均仍低于教师,HLE 表现有限,且小数据集误差解释不充分。
附录 F 的 Ouro 复现与 early-exit 描述是作者观察:他们未完全重现 Ouro 论文数字,因而本文统一采用自己的测量;他们观察到所查实现中早退只选 logits,未跳过所有后续循环。不能将这一观察转述为本次已检查当前版本代码,也不能据此断言所有 Ouro 实现均如此。(pp.20–21)
建议组会讨论三个问题:如果固定实际推理 FLOPs 和训练 token,优势还保留多少?记忆门控在哪些层/特征维保留跨轮信息,是否符合附录的饱和区假设?减小 chunk、加入 GQA 或真正的早退,分别如何影响吞吐、峰值显存和准确率?这些是待验证问题,不是本文已经完成的结果。