TIDE: Every Layer Knows the Token Beneath the Context — 中文精读笔记
- 作者:Ajay Jaiswal、Lauren Hannah、Han-Byul Kim、Duc Hoang、Mehrdad Farajtabar、Minsik Cho(Apple)。
- 论文:arXiv:2605.06216v1,提交于 2026-05-07;PDF 首页排版日期为 2026-05-08。
- 获取与研读日期:2026-09-14;修订 r1;本地原文 PDF。本笔记的页码均为 PDF 页码,从 1 起,与原文印刷页码一致。
- 原始材料:已获取同版本 PDF 与作者 TeX 源码包清单,源码状态
available;阅读了main_file.tex、其引用的apple_preamble.tex与数学宏定义,结合最终 PDF 核验正文、公式、图表和附录 A–M。参考文献用于识别本文的比较关系,未逐篇精读被引文献;未执行作者代码,也未复现训练。 - 配套成品:英文汇报 PDF · 可编辑 Beamer TeX · 图件来源登记。本文件是分析笔记,不是全文翻译。
论文总览
TIDE(Token Identity Delivered Everywhere,把 token 身份送到每一层)在标准 Transformer 之外增加多组按 token ID 查表的记忆。每个 token 的记忆向量在一次前向传播中只计算一次,各层根据自己的上下文状态决定混合哪些记忆,再将混合结果加回残差流。这样,深层网络除了读取已经上下文化的表示,也能再次访问直接由词表 ID 决定的信息。
最可靠的实证结论是:在本文的 LLaMA 风格主干和预训练设置下,这条通路降低了语言建模损失,低频 token 的平均绝对收益较大,并提高了若干规模模型的下游平均分。表 2 的 1B 主干组报告八任务平均分 61.4 → 63.7;但模型另外增加了最多约 6.30B 记忆参数,不能将其解读为等总参数或等训练算力比较。
阅读时应将三个层次分开:结构上增加了独立的身份信息入口,实验中观察到了收益,以及作者将收益解释为 K 倍梯度放大、解除上下文坍缩。前两者有直接方法和结果支持;第三者依赖强假设,部分论证或图文表述需要修正。本笔记在相关位置标明“作者解释”和“本次核验”。
结构地图
| 原文章节 | 作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 提出单次身份注入及两个问题 | pp.1–2;Fig.1 |
| 2 When Context is Not Enough: Diagnosing Standard Transformers | 梯度稀疏性、上下文坍缩、FFN 下界 | pp.2–4;Table 1、Fig.2、Eqs.(2.1)–(2.3)、Prop.2.2 |
| 3.1 Preliminaries and Notations | 标准残差块与符号 | p.5;Eqs.(3.1)–(3.2) |
| 3.2 TIDE Architecture Design | 记忆表、共享张量、路由与融合、存储 | pp.5–6;Figs.3–4、Eqs.(3.3)–(3.6) |
| 3.3 TIDE: Theoretical Perspectives and Observations | 三个命题及稀有 token/坍缩实验 | pp.7–9;Props.3.1–3.3、Figs.5–6 |
| 4.1 Performance Benchmarking of TIDE and Standard Transformer | PPL、K 扩展、零样本任务 | pp.10–11;Figs.7–8(Fig.7 在 p.9)、Table 2 |
| 4.2 A Deeper Investigation of MemoryBlocks and the NULL Bank | 记忆差异与路由行为 | pp.11–12;Figs.9–10 |
| 5 Conclusion | 作者总结 | p.12 |
| References | 本文参考文献 | pp.13–15 |
| A Background Work | 记忆模型、FFN 知识与 embedding 背景 | pp.16–17 |
| B Details of Frequency Bins Generated from Vocabulary | 分箱口径 | pp.17–18;Table 3 在 p.17、Eq.(B.1) 在 p.18 |
| C Gradient Starvation Bound;C.1 梯度比值 | 稀疏更新推导及数值例子 | pp.18–19 |
| D Full Proof of Proposition 2.2 | FFN 近似误差下界证明 | pp.19–20 |
| E Full Proof of Proposition 3.1 | null bank 退化证明 | pp.20–21 |
| F Full Proof of Proposition 3.2 | K 路径梯度下界 | p.21 |
| G Additional Details for Proposition 3.3 | token 表可分离性的说明 | p.22 |
| H Understanding Layer-wise Contribution of EmbeddingMemory | 单层记忆消融 | p.23;Fig.11 在 p.22 |
| I Understanding Decoding Cost with MemoryBlocks | 实际解码延迟 | p.23;Table 4 |
| J Investigating Compression Strategies for EmbeddingMemory | 量化与低秩存储 | pp.23–25;Table 5、Fig.12 在 p.24 |
| K K-Nearest Neighbor Study of Base Embedding and MemoryBlocks | 语义近邻与重叠 | p.25;Fig.13、Table 6 在 p.26 |
| L Model Training Implementation Details | 训练曲线和配置 | p.26 起;Fig.14、Table 7 在 p.27 |
| M Limitations and Future Work | 存储与验证范围限制 | p.26 |
一:动机——为什么要重新提供 token ID?
1.1 低频 token 的输入 embedding 更新机会少
标准输入表 $E$ 把词表 ID $v$ 映射为 $E[v]$。如果这个表只用于输入查表,那么本批次没有出现的 token 对应行不会收到来自这条查表路径的梯度。自然语言频率长尾意味着,低频行被直接训练的机会更少。
作者用 $f_v$ 表示随机 token 位置等于 $v$ 的概率,批大小为 $B$、序列长度为 $T$、训练步数为 $\tau$。在各位置独立同分布的简化模型中,某一步至少出现一次 $v$ 的概率为
所以非零梯度可能发生的步数期望为
若出现时该行每步平方梯度范数被 $G^2$ 上界控制,则
这给出一个有用的稀疏访问模型,但它不是完整的 Adam 训练动力学:实际文本位置相关;若输入输出权重绑定,输出 softmax 可以给未出现在输入中的词表行提供梯度;权重衰减也不等同于零梯度下参数完全不变。附录 C 的证明实际需要的是“每步聚合行梯度上界”,不能把未加说明的单次出现梯度上界直接替代它。(Sec.2.1,pp.2–3;Appendix C,pp.18–19。)
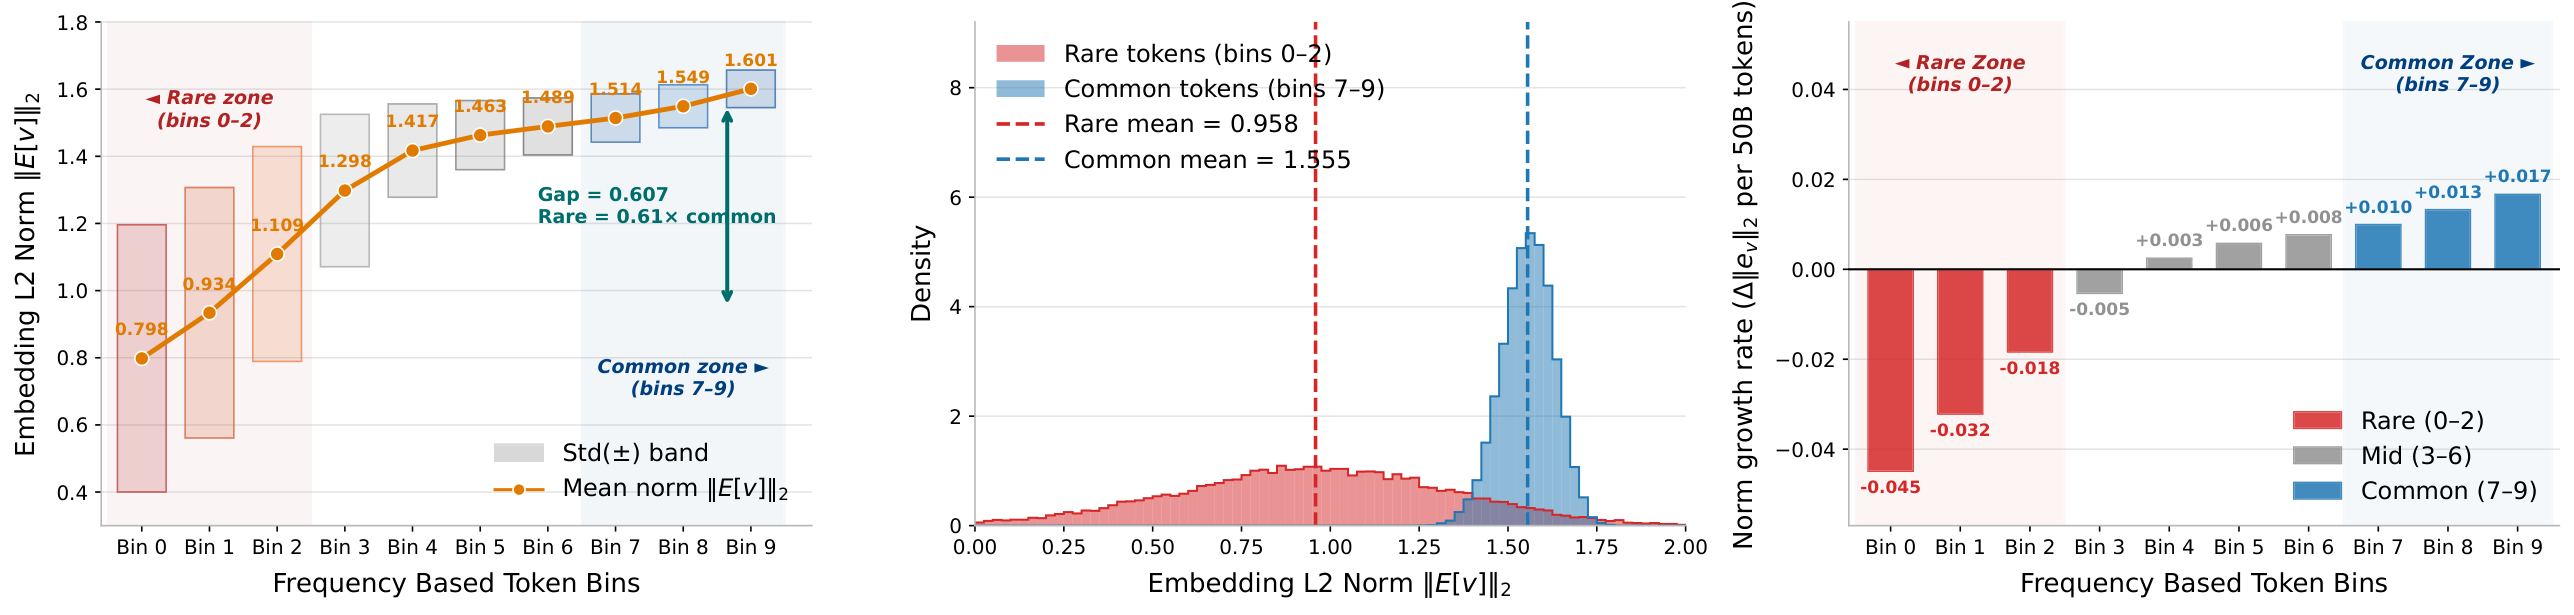
Fig.1,PDF p.2。 左图横轴是频率分箱、纵轴是 embedding 的 L2 范数;中图比较低频/高频范数分布;右图是每额外训练 50B tokens 的范数增长率。低频组范数更小且更分散,增长率为负;高频组相反。这是与训练不足解释相容的诊断,范数小本身不证明语义错误,也不直接测量累计梯度。
1.2 相似上下文可能掩盖不同 token 的身份
作者考虑 their/there、不同数字及领域术语等 token 对,测量匹配模板中逐层隐藏态的距离。其“上下文坍缩”定义是不同 token 的代表性隐藏态满足
固定上游表示后,若 FFN 对输入的 Lipschitz 常数为 $L_{\rm FFN}$,则输出距离不超过 $L_{\rm FFN}\delta$。若任务需要的目标向量距离为 $C=\|g(u)-g(v)\|$,三角不等式给出
直觉:两个几乎相同的输入,经过变化速度有限的同一个函数,不容易得到截然不同的输出。只有 $C>L_{\rm FFN}\delta$ 时,这个界才提供正的误差障碍。(Prop.2.2,p.4;完整证明 Appendix D,pp.19–20。)
边界:$L_{\rm FFN}$ 随权重改变,不能把这一条件界说成“任何宽度、任何权重的 Transformer 都无法区分”。非线性 FFN 对平均隐藏态的输出也不等于逐上下文输出的平均;真实 token 判别能力不能只由平均 L2 距离判断。严格相等与“距离较小”更是不同命题。原文 Fig.2 图注写 250 个模板,正文 p.4 写 150 个,实验样本数存在不一致。
1.3 新思路及其与相关工作的关系
TIDE 保留原 attention 与 FFN,同时增加跨层共享的词表记忆。与文中讨论的外部文本检索相比,它查询的是训练得到的 token 参数行;与把 FFN 整体或部分替换为查表的方法相比,它用加法通路补充 FFN。其特色在于 K 个独立表 + 每层上下文路由 + 跨层复用 + null 选项 的组合。(Sec.1,pp.1–2;Appendix A,pp.16–17。)
这条通路能直接区分不同词表 ID;同一 ID 在不同语境中的含义仍需要上下文计算。多 token 实体也不会自动获得一个独立的“实体记忆行”。
二:方法——静态记忆内容,动态决定注入比例
2.1 符号和数据流
| 符号 | 含义与维度 |
|---|---|
| $\mathcal V$ | 词表,本文 tokenizer 大小 128,256 |
| $x$ | 输入 ID,$\mathbb Z^{B\times T}$ |
| $d,d_b$ | 主干隐藏维度、单个记忆表输出维度 |
| $L,K$ | Transformer 层数、独立记忆块数 |
| $E$ | 原始输入表,$\lvert\mathcal V\rvert\times d$ |
| $E_k$ | 第 $k$ 个记忆表,$\lvert\mathcal V\rvert\times d_b$ |
| $\mathbf M$ | 一次前向的记忆张量,$B\times T\times K\times d_b$ |
| $W_r^\ell$ | 第 $\ell$ 层路由矩阵,$(K+1)\times d$ |
| $\alpha_k^\ell$ | 某个 token 在某层分给第 $k$ 个槽位的权重 |
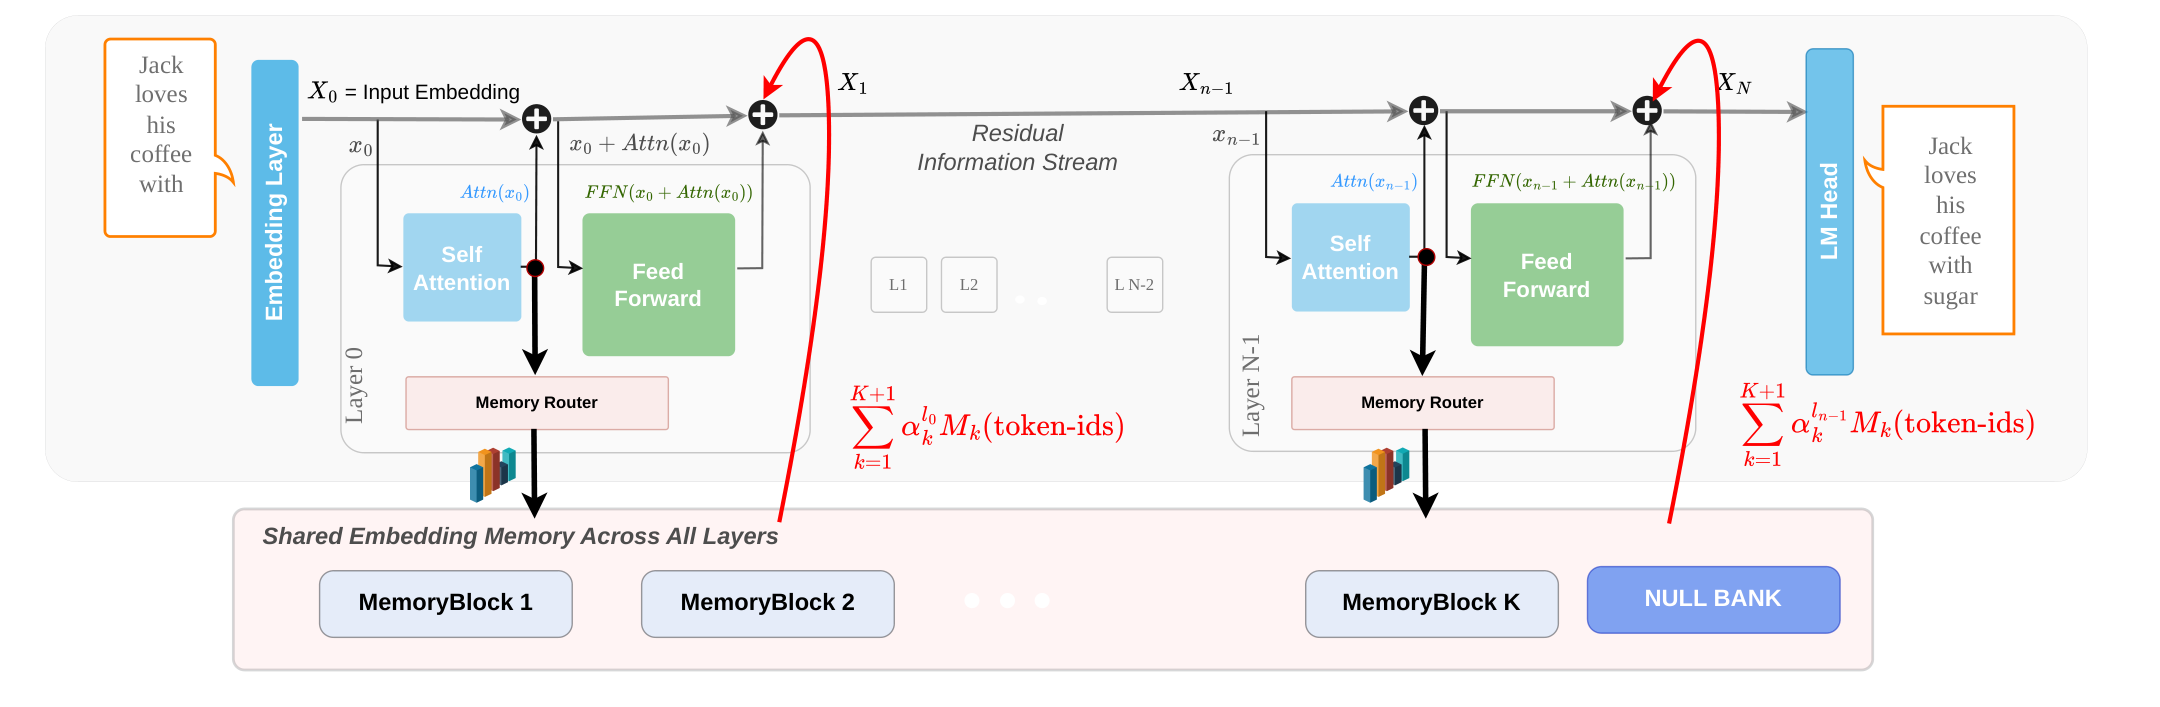
Fig.3,PDF p.5。 从左到右是 Transformer 残差流;底部共享的多个记忆块按原始 ID 取值,再通过每层路由注入。图中共享的是记忆表和本次前向的记忆内容;各层路由参数各自学习。
2.2 MemoryBlock:独立查表并归一化
以下标注的公式编号沿用原文,便于定位。
对每个 $k\in\{1,\ldots,K\}$,
各表不共享参数,也没有显式多样性损失。独立表提供更多可学习的身份表示,但独立参数不等于统计独立、梯度正交或一定学成不同知识。取整批 token 后堆叠:
它每次前向计算一次,供所有层使用。训练中表参数持续更新,因此“静态”指不依赖当前上下文,不能理解为训练时冻结。
2.3 层内路由、null bank 与加法融合
先执行原 attention 残差,再归一化:
路由器根据该层、该位置的状态生成权重:
额外槽位 $M_{K+1}(v)=0$ 是 null bank。它没有专门的非零记忆表,但其 logit 对应的 router 参数需要学习。于是
这里是所有 bank 的 softmax 加权和,没有 top-k 稀疏选择。记忆不先经过 FFN,而与其输出并行相加;两条通路仍通过残差、后续层和共同损失耦合。
关键区别是:$M_k(v)$ 是 context-free,$\alpha_k^\ell$ 和最终 $m^\ell(v)$ 依赖上下文。原文“memory contribution independent of contextual mixing”的措辞应限定为原始 bank 内容和索引,不应扩大到完整融合结果。
维度要求:直接相加需 $d_b=d$,或者另加输出投影。附录 J 明确给出的 1B 配置是 $d_b=d=2048$;原公式没有写 $d_b\ne d$ 时的投影,不能自行补成作者实现。
2.4 教学例子与前向伪代码
以下为教学解释,并非论文实验数据。 设 $K=2$,某层对一个低频术语给出权重 $(0.3,0.2,0.5)$,则注入 $0.3M_1(v)+0.2M_2(v)$。另一个高频 token 的权重为 $(0.05,0.05,0.9)$,其总活跃权重只有 0.1。这个例子说明 null bank 如何控制注入幅度,并不意味着幅度只由权重决定;向量方向仍会相消。
h = E[x]
M[k] = RMSNorm(E_k[x])            # 对每个 bank,前向内只算一次
for layer in transformer_layers:
    h_attn = h + Attention(RMSNorm(h))
    n = RMSNorm(h_attn)
    alpha = softmax(W_router[layer] @ n)   # K+1 个槽位
    memory = sum(alpha[k] * M[k] for k in active_banks)
    h = h_attn + FFN(n) + memory
logits = original_output_head(h)   # 教学示意;最终归一化按主干处理
训练仍以自回归交叉熵为主,附带配置表中的 z-loss;没有额外检索监督或多样性目标。生成时处理的是当前已知 token ID,不需要知道将要预测的下一 token,因此结构上保留因果性。它也没有提供缩减 attention KV cache 的机制。
2.5 计算与参数:少量每层算术,大量词表存储
记忆表主导的新增参数为
后者忽略规范化参数等小项。一次查表和 RMSNorm 后,每层仍需 router 矩阵乘法、softmax 和向量加权和。因而“记忆查表不做矩阵乘法”不能改写成“整个 TIDE 不增加矩阵乘法”。
按 $|\mathcal V|=128256,d_b=2048$ 本次计算:每个 bank 有 262,668,288 个参数;$K=8$ 增加 2.101B,$K=24$ 增加 6.304B。主干图示约 1.03B,所以两者总参数约为 3.13B 和 7.33B,另有小量 router 等参数。名称中的“1B”不是 TIDE 总参数。
FP16 记忆存储为 $2K|\mathcal V|d_b$ 字节,8 个 bank 约 4.20 GB;4-bit 理想数据体积为其四分之一,约 1.05 GB,未计比例因子/元数据。Fig.4(p.6)的主干 8-bit 约 1.028 GB、24 bank 4-bit 约 3.152 GB 是权重存储拆分,不是包含 KV cache、激活、缓存和临时缓冲的实测峰值 VRAM。训练还要承担记忆梯度及优化器状态,论文未提供完整峰值训练显存和等 FLOPs 比较。
三:理论与实验设计——分别检验哪些问题?
3.1 Null bank 能否恢复基线?
作者 Prop.3.1(p.7;Appendix E,pp.20–21)提出 TIDE 可以任意逼近标准 Transformer。若所有活跃 logit 为 0,null logit 为 $s$,并设记忆最大范数为 $C_M$,有
这段代数清楚解释了抑制机制。本次分析:原 Eq.(3.5) 是无 bias 线性 router,证明直接要求它对所有相关隐藏态给出统一大正 null logit,缺少实现条件。例如隐藏态集合同时包含 $n$ 和 $-n$ 时,同一线性行无法在两者上都取得统一正 margin。带独立 null bias 的构造可以做到,但那是对公式的补充。稳妥结论是“在路由能统一偏向 null 的输入域,可接近关闭记忆的行为”,不是已经证明无条件的函数类包含关系。
另外,临界 $s$ 只给 $\le\epsilon$;要严格 $<\epsilon$ 应取更大的 $s$。这是边界符号问题,与上述实现缺口不同。
3.2 K 路径到底“放大”了什么?
Prop.3.2 / Eq.(3.7)(p.7;Appendix F,p.21)研究的是跨 K 张表累计的梯度平方范数总和。假设每次 $v$ 出现时,每一张表的行梯度都满足统一的
即可相加得到
求和过程成立,问题在于这个假设不由结构自动保证。softmax 权重正不代表总梯度非零;上游梯度、归一化 Jacobian、跨层相消都可能削弱它。$G_{\min}$ 也可能随 $K$ 下降。附录为简化还排除了实际存在的 null bank。
教学反例(本次分析):在一层、固定均匀 router、相同局部 Jacobian 与上游梯度 $g$ 的情形,$\alpha_k=1/K$,每个 bank 的梯度为 $g/K$,平方范数和是 $\|g\|^2/K$。它表明“有 K 张表”本身不足以保证梯度总量增加;该例不否定论文的实测收益。
因此不能从该命题推出:实际相对 baseline 恰好 K 倍、K×L 倍、稀有词不出现也能更新,或收敛/样本效率提高 K 倍。它只是强非退化假设下的 K 项下界。低频损失改善提供独立实证支持,但不识别改善的唯一原因。
3.3 离散身份是否保证解除坍缩?
Prop.3.3 / Eq.(3.8)(p.8;Appendix G,p.22)强调 $M_k(u)$ 和 $M_k(v)$ 取决于不同词表行,其距离无须随着上下文隐藏态距离 $\delta$ 一起趋零。这是设计最有说服力的结构直觉,而且 $K=1$ 就有这种能力。
作者进一步声称仅选择表参数就能实现任意目标距离 $C>0$。本次分析:固定增益 $\gamma$ 的 RMSNorm 满足
所以任意距离还需要明确允许调整增益或限制目标到可达范围。bank 内能分离,也不保证多个 bank 加权后不相消,更不保证加入 FFN 和残差后每层始终分离。应保留的结论是:词表 ID 旁路提供了一种不受当前隐藏态近邻约束的表示来源,训练是否有效利用要看实验。
3.4 训练和评估协议
| 项目 | 论文报告的配置 | 证据与限定 |
|---|---|---|
| 主干 | LLaMA 风格 Transformer;主表 750M、1B、3B | Table 2 p.10;这些是主干规模标签 |
| 预训练数据 | mlfoundations/dclm-baseline-1.0 | Table 7 p.27 |
| tokenizer / 词表 | meta-llama/Llama-3.1-8B;128,256 | Table 7 |
| 序列长度 / 激活 | 2048 / SiLU | Table 7 |
| 优化器 | Adam;$\beta_1=0.9,\beta_2=0.95$;weight decay=0.1 | 按表中名称记录,不自行改成 AdamW |
| 损失 | Cross Entropy;z-loss 系数 $10^{-6}$ | Table 7 |
| 学习率 | warmup 初始 $10^{-6}$,10,000 iterations;cosine,最大 $10^{-4}$,最小 $10^{-5}$ | Table 7 |
| token 预算 | Table 7 写 400–500B;Fig.5 指定 200B;Fig.8 曲线延伸到 500B;Appendix M 概括 200–500B | 各项不是同一个 checkpoint 协议,不混用 |
| 诊断分箱 | WikiText-103 训练集,约 120M tokenizer tokens | Appendix B p.17 |
| 语言建模评估 | WikiText-2、PubMed、DCLM held-out;PPL 越低越好 | Fig.8 p.10;并非 PubMed 医学问答准确率 |
| 下游评估 | 八项 zero-shot;BoolQ/LAMBADA 为 accuracy,其余按原表为 normalized accuracy,单位 % | Table 2 p.10;提示模板、harness 版本和细分计分实现未完整报告 |
| 解码评估 | 1×B200;5,120 个生成 token 的平均 ms/token | Appendix I / Table 4 p.23 |
缺失项:没有完整报告每个规模的全部结构细节、各表 checkpoint 对应训练预算、训练全局 batch 与梯度累积、随机种子/重复次数、主结果置信区间,以及等总参数/等 FLOPs 的替代基线。理论示例的 $B=8$ 不能直接当成所有实际训练的全局 batch。附录 J 的 1B 模型写 24 层,但 Figs.6/11 的可见层索引为 0–19,这一点复现时需要作者澄清。
3.5 频率分箱与指标口径
Appendix B 的分箱先去掉 BOS/EOS、纯空白及非字母数字标点,共移除 28 个已观察 token 类型;65,569 个已出现类型剩下 65,541。按频率升序排名,再分成 10 个近似等类型数的箱,每箱约 6,554 个类型。bins 0–2 为 rare,3–6 为 mid,7–9 为 common。未出现在 WikiText-103 中的词表条目不在这些箱内。
等类型数不等于等出现次数,也不等于完整 DCLM 训练语料中的频率标签。每箱交叉熵反映模型对该组评估 token 的预测损失;原文没有完全写明先按出现位置平均还是先按类型平均,不能用未说明的权重把各箱结果还原成整体 PPL。Fig.5 与 Fig.7 的 Base 损失水平也不同,checkpoint 或聚合口径未完全对应,二者数值应分开使用。交叉熵以 nats 计,越低越好;$\mathrm{PPL}=e^{\mathrm{CE}}$,但须同样本、同平均口径。
下游 accuracy 的 +2.3 是百分点。例如 61.4→63.7,原表差是 2.3 个百分点,相对增幅约 3.75%;不能写成相对提升 2.3%。normalized accuracy 通常涉及候选评分的长度归一化;本文只给出指标名称,未充分描述实现细节,跨论文比较应谨慎。
四:结果——哪些发现能由图表支持?
4.1 稀有 token 的降损更明显(Sec.3.3.2)
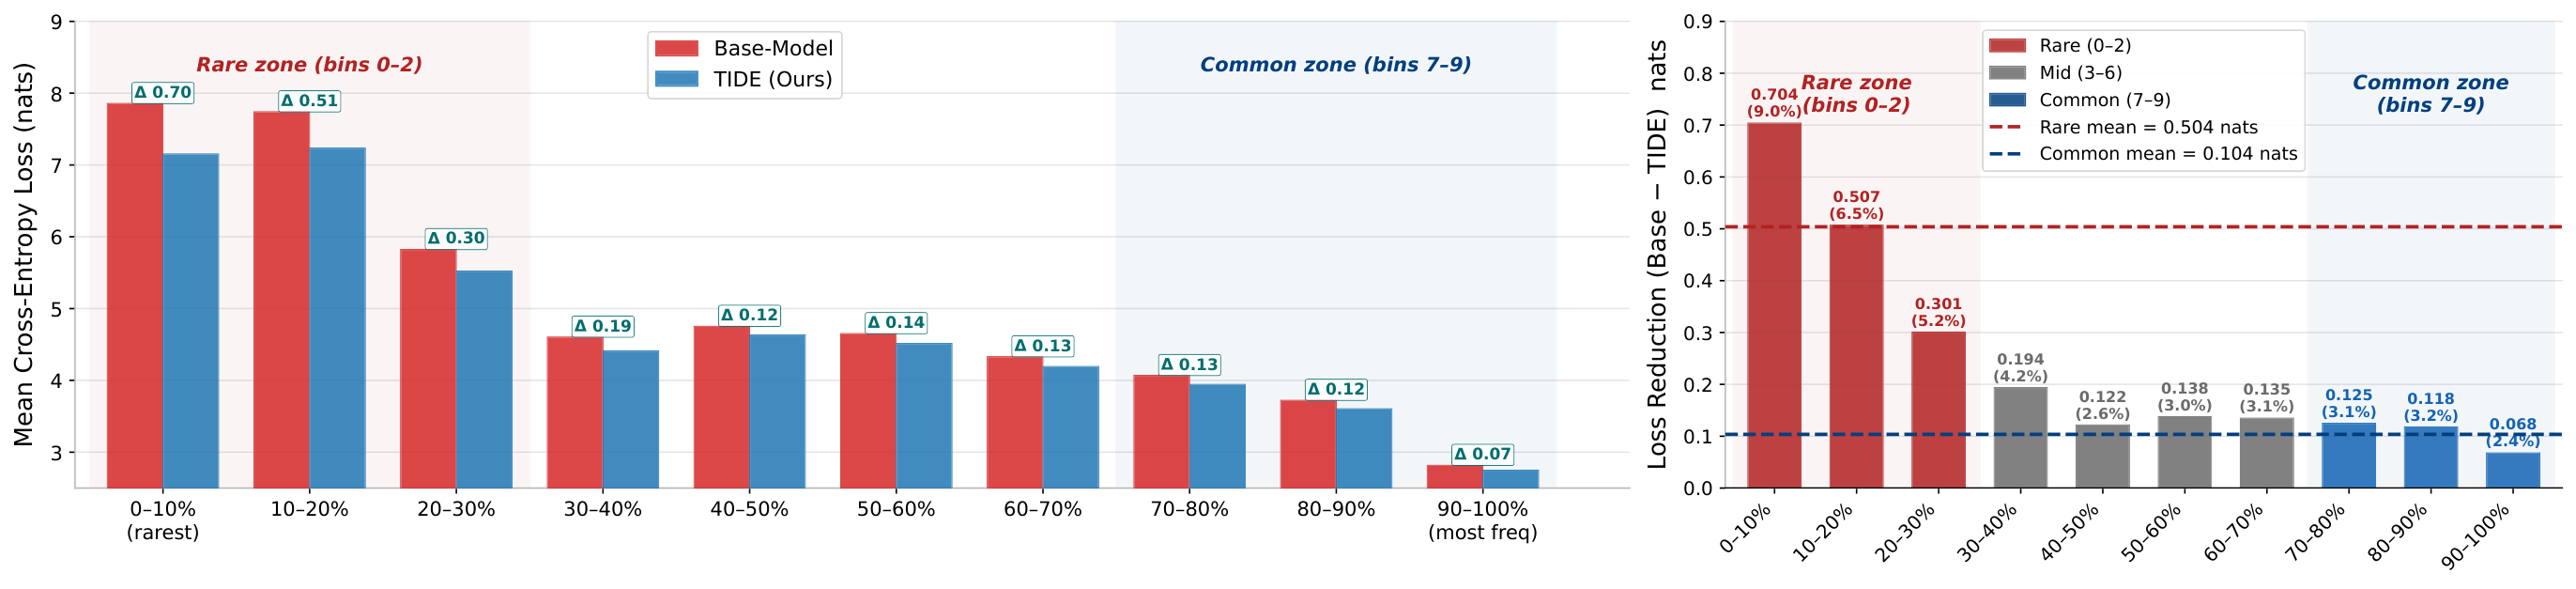
Fig.5,PDF p.8;1B 主干,TIDE-8E,200B 训练 tokens。 左图比较每箱 Base/TIDE 交叉熵,右图是 Base−TIDE 的损失差;正值代表 TIDE 更好。10 个箱的差值均为正。
| 频率组 | 原图/正文给出的降损 | 含义 |
|---|---|---|
| 最稀有 decile | 0.704 nats;约 9.0% 相对降损 | 单个 decile 的差值 |
| 最常见 decile | 0.068 nats;约 2.4% 相对降损 | 单个 decile 的差值 |
| rare 组平均 | 图中标 0.504 nats | bins 0–2 的组均值 |
| common 组平均 | 图中标 0.104 nats | bins 7–9 的组均值 |
按组均值,rare 的绝对降损约是 common 的 4.8 倍;不要将它与端点 $0.704/0.068\approx10.35$ 倍混淆。图上 decile 降损顺序为 0.704、0.507、0.301、0.194、0.122、0.138、0.135、0.125、0.118、0.068,存在小幅反弹,因此只能说总体偏向低频,不能说每个 decile 都严格单调下降。它支持“低频收益更大”,不直接测量梯度放大倍数。
4.2 隐藏态距离增加,但不是完整的身份能力证明(Sec.3.3.3)
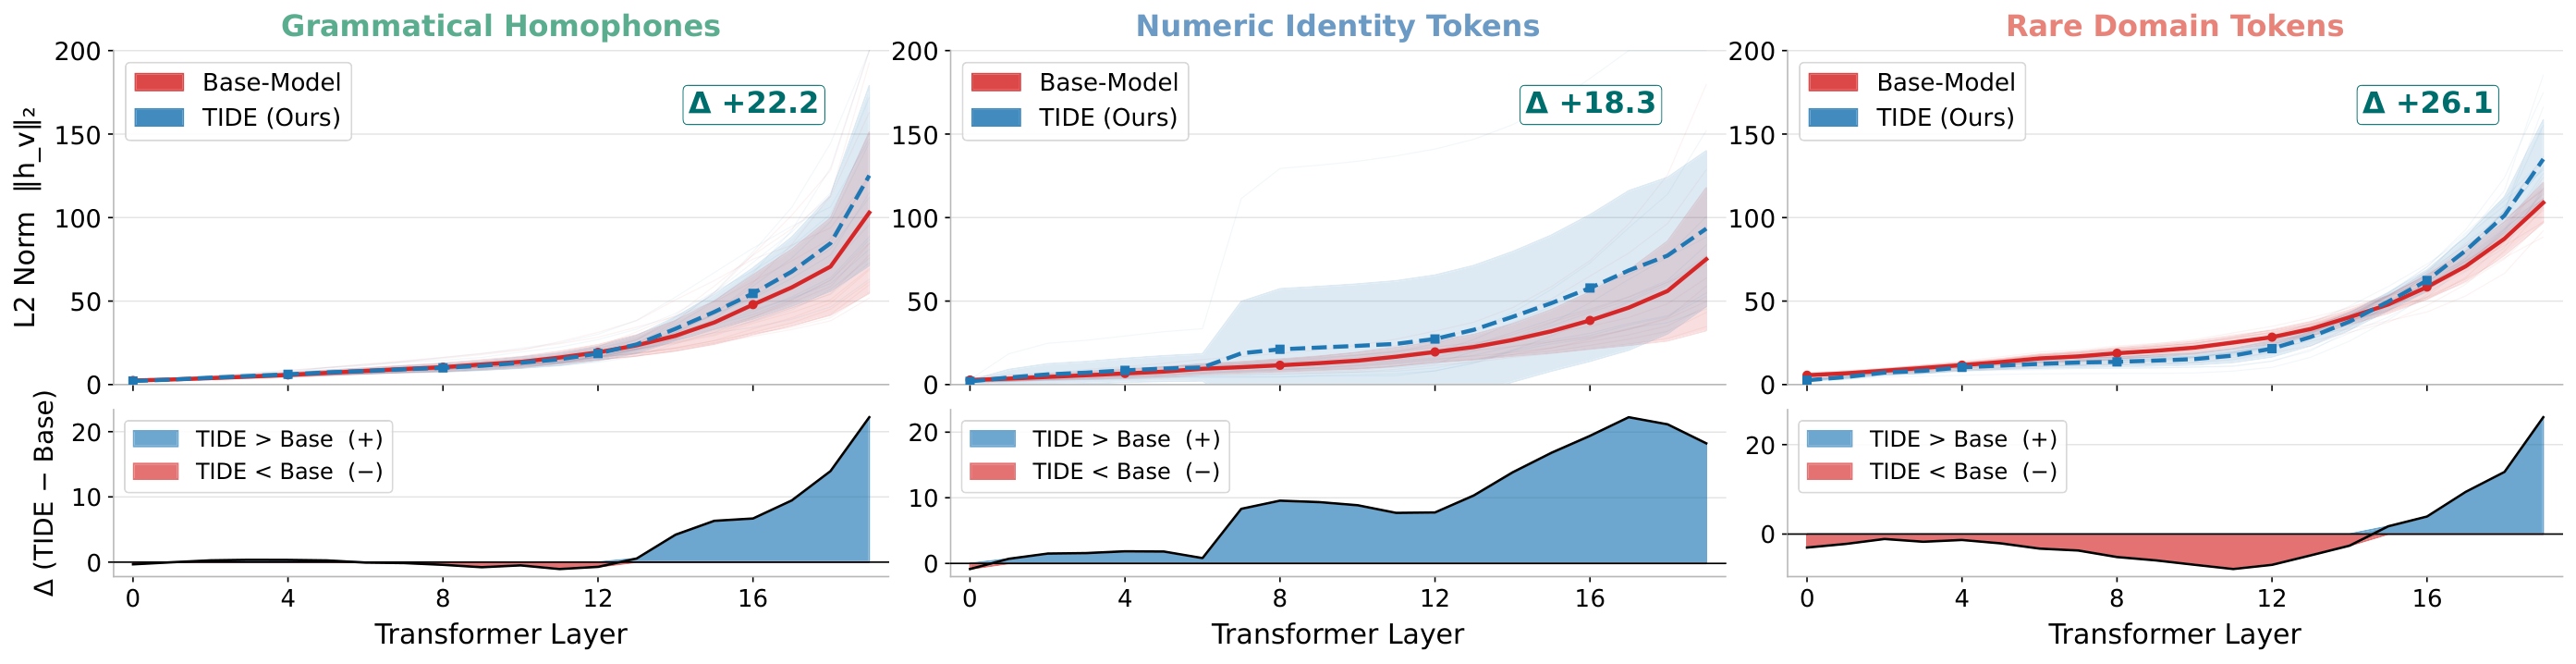
Fig.6,PDF p.9。 三列依次是语法同音相关 token、数字身份 token、稀有领域 token;上排画 Base/TIDE 的平均 L2 距离,下排画两者差值。总体上中后层 TIDE 距离更大,数字类别改善较突出;稀有领域类别在部分中层的差值却为负。
作者据此解释为身份信息得到保留。本次分析将它视为模板上的几何诊断:原始 L2 距离会受表示整体尺度影响,且图中阴影的统计口径未充分交代;没有配套归一化距离、线性探针或严格的 token 身份恢复测试,不能据此宣称所有层、所有 token 都不再坍缩。
4.3 语言建模、训练动态与 K 的边际收益(Sec.4.1)
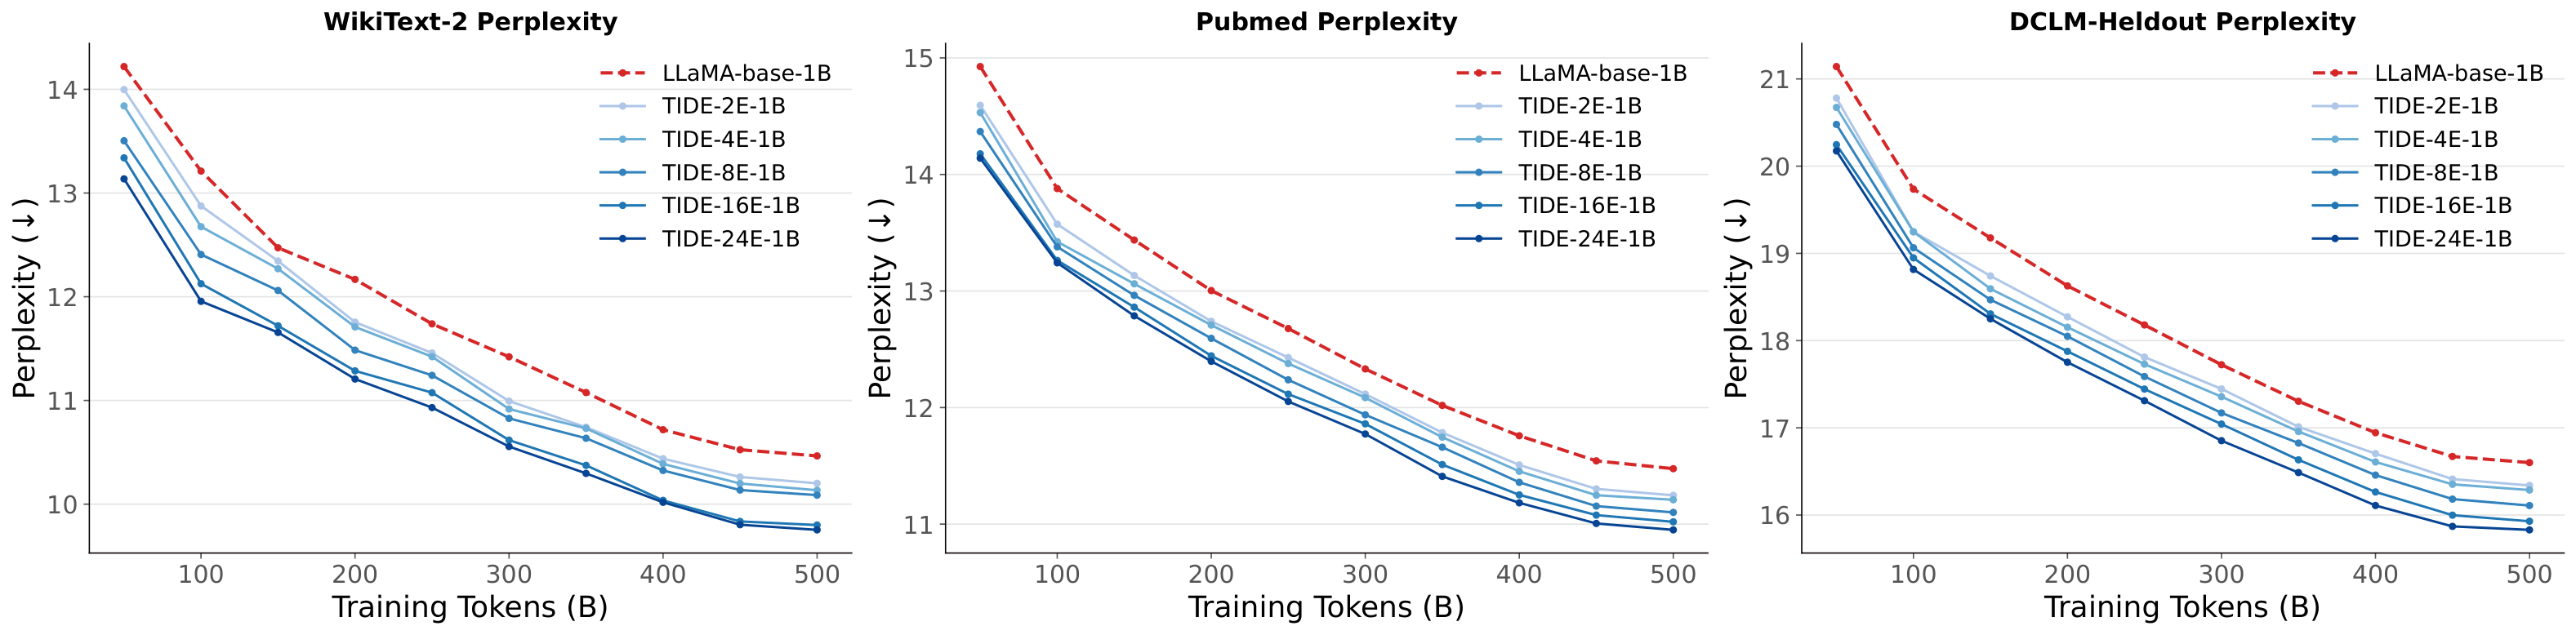
Fig.8,PDF p.10。 横轴是训练 token 数(B),纵轴 PPL;红色虚线为 Base,蓝色为 $K=2,4,8,16,24$。三数据集显示较稳定的整体改善,较大的 K 通常更低。这是相同主干、更多静态参数的质量收益;不同曲线不是等总训练计算量。
正文称 100B tokens 的 K=2–4 已匹配 baseline 200B 的 PPL。图形核验不支持这一普遍断言:例如 WikiText-2 的 100B K=2/4 约为 12.9/12.7,而 200B baseline 约为 12.2(这些是图读近似值,不是原始数表)。因此不采用“训练数据减半/2× 样本效率”的结论。Fig.14(p.26)训练损失曲线也呈较大 K 更低的总体趋势,但未给出训练时间或 FLOPs 收敛曲线。
Fig.7(p.9)进一步比较频率组,图中有断轴,不能按视觉斜率跨组直接比较:
| K | Rare CE ↓ | Mid CE ↓ | Common CE ↓ |
|---|---|---|---|
| 0 / Base | 6.671 | 4.480 | 2.967 |
| 2 | 6.454 | 4.452 | 2.940 |
| 4 | 6.361 | 4.418 | 2.928 |
| 8 | 6.353 | 4.414 | 2.929 |
| 16 | 6.254 | 4.367 | 2.893 |
| 24 | 6.250 | 4.342 | 2.892 |
Rare 的总降损 0.421 nats,common 为 0.075,端点收益比约 5.6。K=2 已得到 rare 总收益的 $(6.671-6.454)/0.421\approx51.5\%$,可概括“约一半”,正文写约 55%。K=16→24 的 rare 增益仅 0.004,显示边际收益变小;common K=4→8 还略变差。原图另标“斜率比 3.7”,但没有定义拟合口径,不作为可重现的独立数值结论。
4.4 下游任务平均收益存在,单任务并非普遍改善(Sec.4.1)
下表摘录原文 Table 2(PDF p.10),保留原表的 PPL 和 Average。PPL 列表注明为 “LAMBDA perplexity”,而旁边任务名是 LAMBADA;可能为拼写错误,但原文未澄清。本笔记称“表 2 PPL 列”,不混同于 Fig.8 的三个验证集。
| 主干规模 | 模型 | 表2 PPL ↓ | 原表八任务平均 ↑ |
|---|---|---|---|
| 750M | Base | 5.63 | 59.7 |
| 750M | TIDE-8E | 5.18 | 60.7 |
| 1B | Base | 5.19 | 61.4 |
| 1B | TIDE-2E | 4.97 | 62.6 |
| 1B | TIDE-8E | 4.89 | 63.0 |
| 1B | TIDE-16E | 4.78 | 63.3 |
| 1B | TIDE-24E | 4.60 | 63.7 |
| 3B | Base | 4.00 | 67.2 |
| 3B | TIDE-8E | 3.86 | 68.3 |
原表三规模的平均增益分别为 +1.0、最多 +2.3、+1.1 个百分点。1B 的表 2 PPL 5.19→4.60,相对下降约 11.37%。
为判断平均分来自哪里,再看 1B 组的两个端点(同一 Table 2):
| 任务 | Base | TIDE-24E | 差值(百分点) |
|---|---|---|---|
| ARC-C | 37.5 | 38.9 | +1.4 |
| ARC-E | 64.4 | 66.3 | +1.9 |
| BoolQ | 61.7 | 69.5 | +7.8 |
| HellaSwag | 63.9 | 66.3 | +2.4 |
| LAMBADA | 64.6 | 66.4 | +1.8 |
| OBQA | 37.6 | 37.2 | −0.4 |
| PIQA | 74.9 | 77.3 | +2.4 |
| SciQ | 86.9 | 87.2 | +0.3 |
BoolQ 对均值提升贡献较大;OBQA 端点反而下降,且其 K=8 的 40.8 优于 K=24 的 37.2。750M 的 BoolQ 63.5→63.0、3B 的 SciQ 93.3→93.2 也有下降。原文“六项下游任务随 K 单调提升”与表内数值不符;1B 序列中只有 HellaSwag、PIQA 全程非递减。
平均口径核验:上述八个已公布分项简单平均为 61.4375 和 63.6375,差为 2.20 个百分点;原文 Average 列和正文报告 61.4→63.7,+2.3 个百分点。可能涉及未公布精度或汇总差异,论文未说明;本笔记保留原表报告,同时给出可重算结果。没有多次运行和置信区间,不能将很小的单项差异直接称为统计显著。
4.5 记忆表学到什么?最后一层何时使用它?(Sec.4.2)
Fig.9(p.11)计算两张表对同一 token 行的平均 cosine distance:
主输入表 $E$ 与 8 张记忆表的距离约为 0.649–0.990,说明其行向量没有直接复制输入 embedding。不同记忆表之间仍有较多重叠。向量余弦差异不是“子空间独立”的证明,也不能仅凭距离远就确认知识更准确。
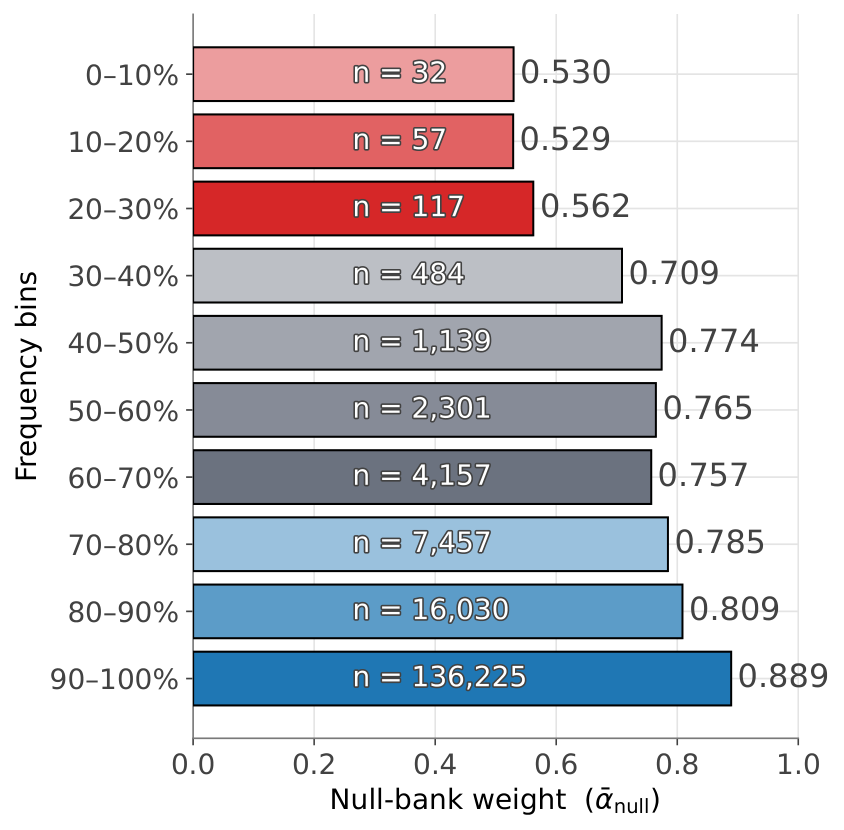
Fig.10 右面板,PDF p.12。 纵轴为频率 decile,横轴为该组最后一层 null bank 平均权重;图内 $n$ 标注各组样本数,最稀有组仅 32,不能把这幅图当成每箱等观测数量的统计。最稀有箱的 null 权重 0.530,最高频箱 0.889,对应活跃记忆总权重 0.470 和 0.111。方向与“低频更需要记忆”相容。
全部权重为 0.530、0.529、0.562、0.709、0.774、0.765、0.757、0.785、0.809、0.889,整体上升但非单调。这是最后一层的相关性观察,不能推广为全部层的固定规律。
左面板显示一些 bank 在低频组或中频组权重更高。这里还有编号问题:图中用 Bank0–Bank7,正文有 $M_1$–$M_8$ 的一基符号,稀有档约 0.31 的条目正文称 $M_5$、图标 Bank5;本笔记不强行将两种编号对应。论文也没有从头训练的 no-null 对照,因此尚不能单独量化 null bank 的因果贡献。
4.6 单层消融揭示不均匀的注入依赖(Appendix H)
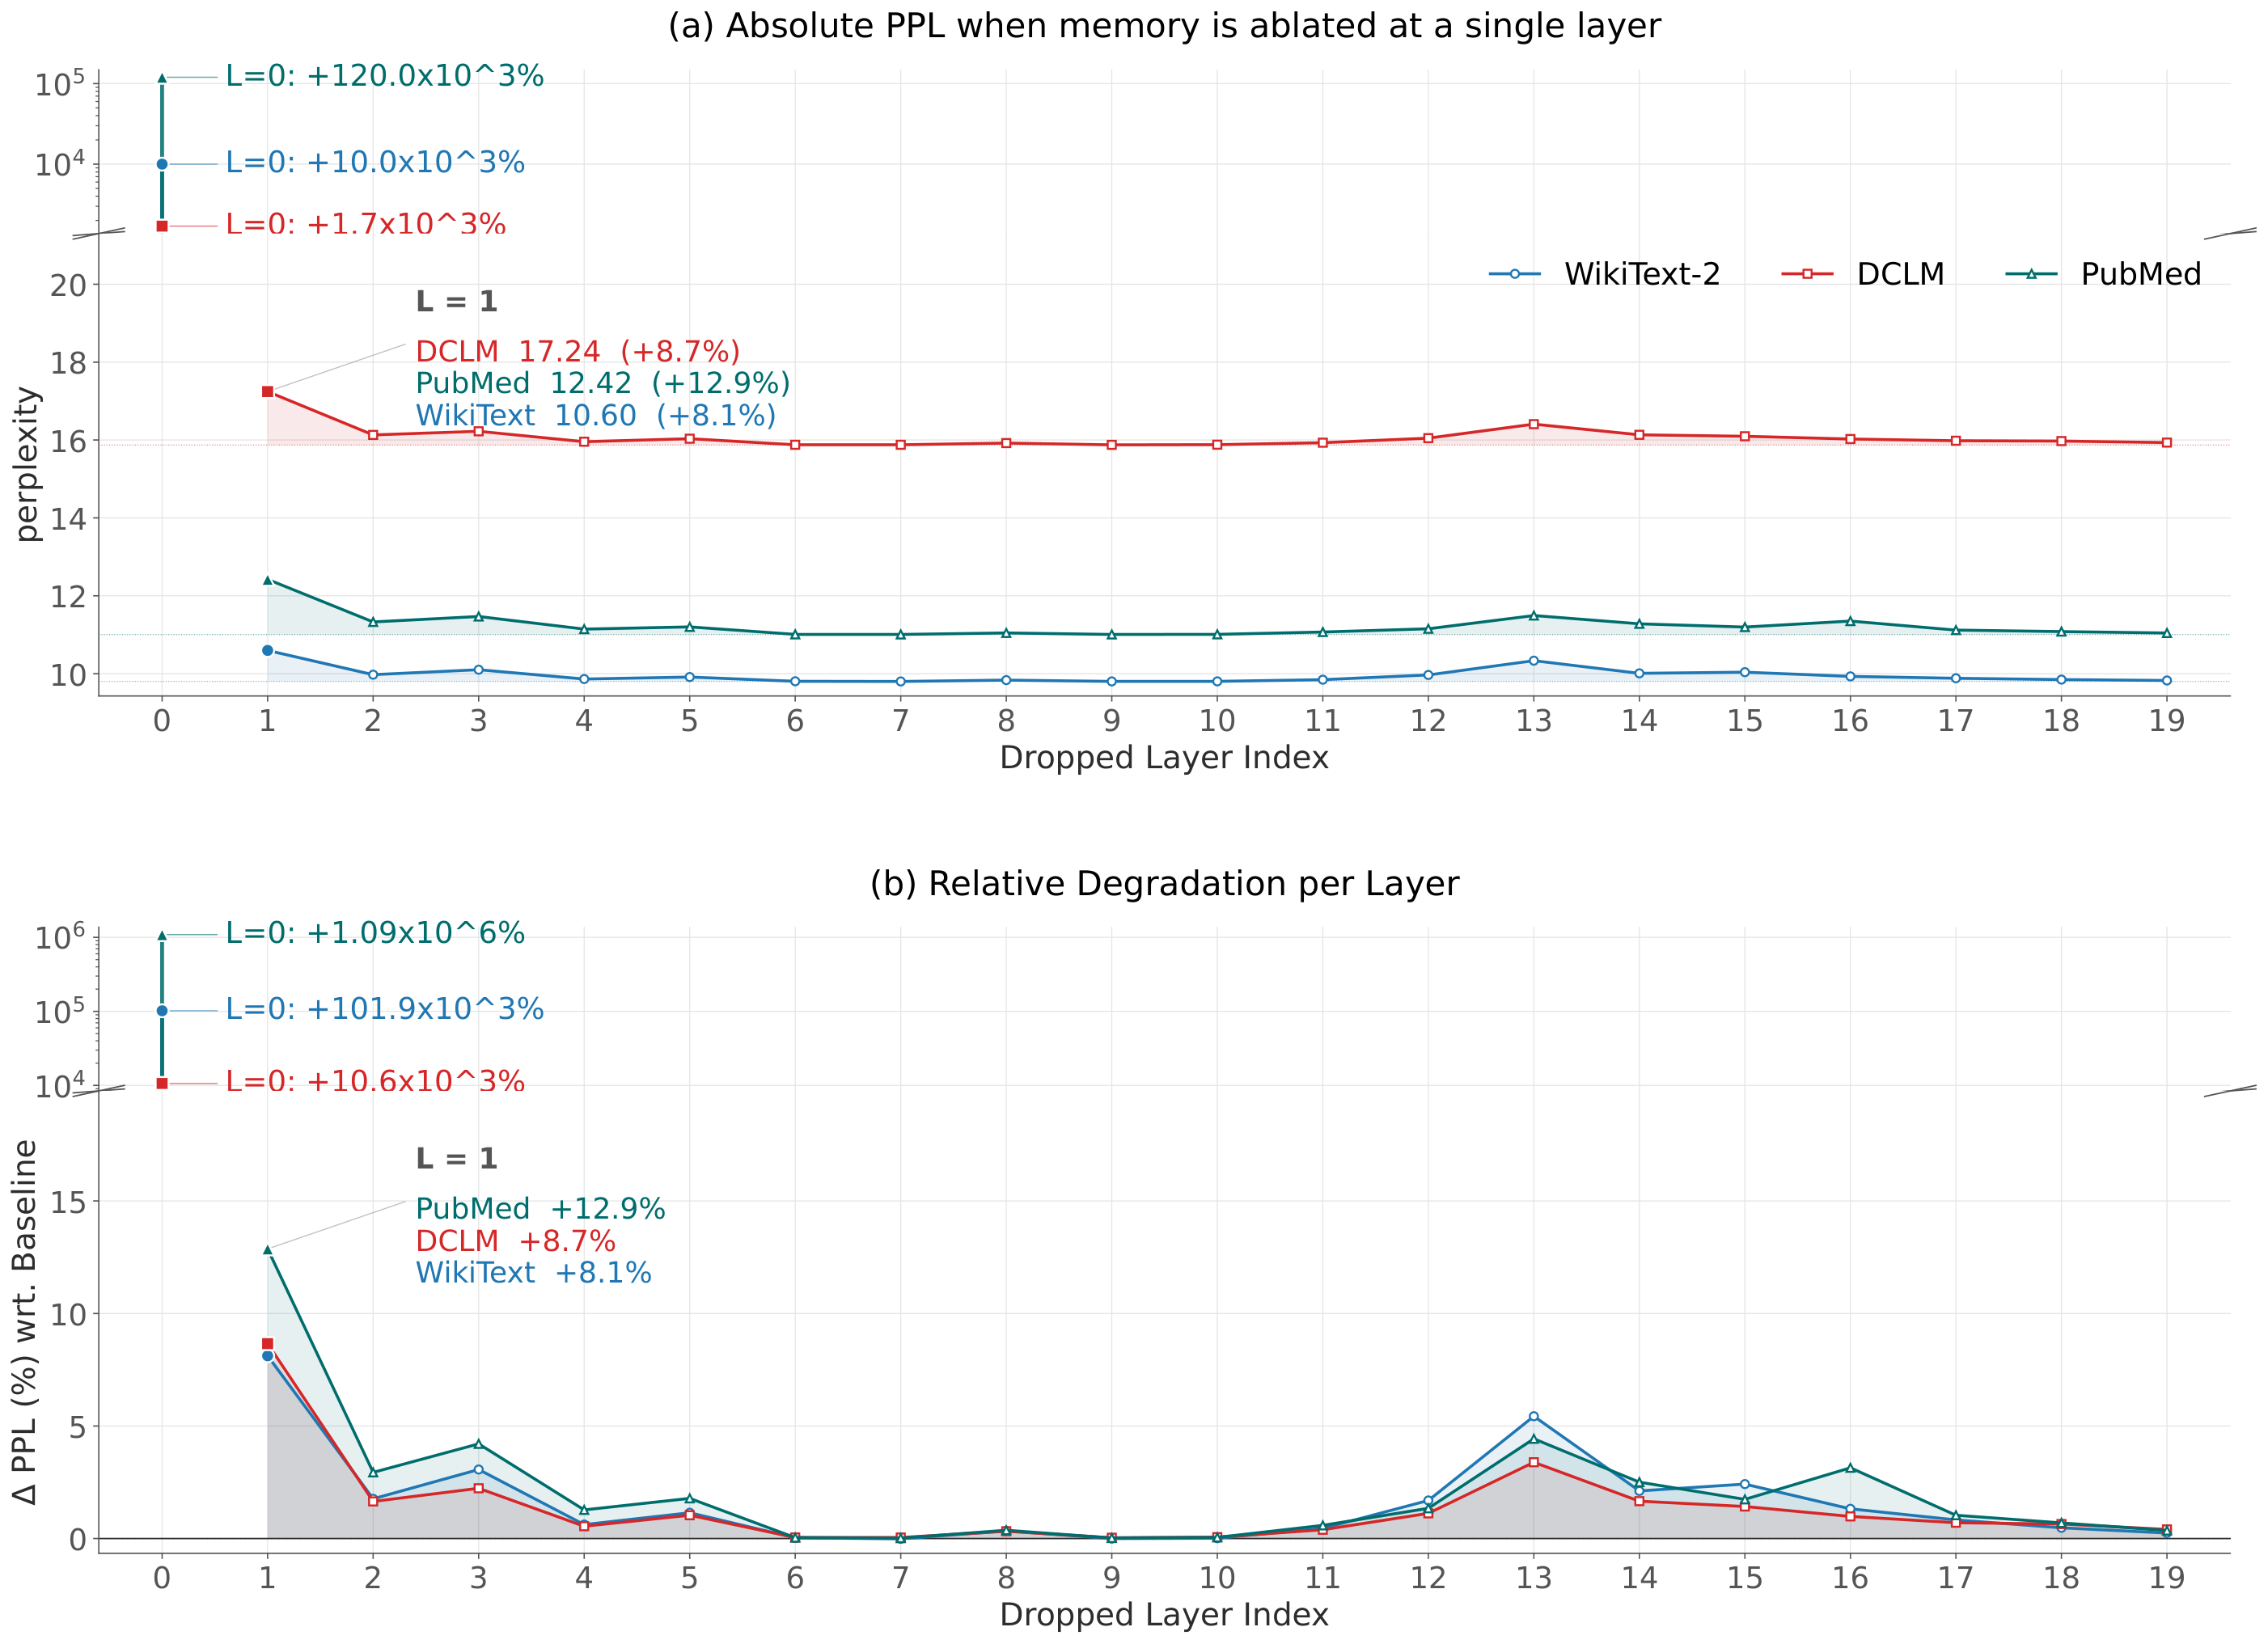
Fig.11,PDF p.22;方法说明 p.23。 在训练好的 K=24 模型中,每次只将一个层的 $m^\ell(v)$ 置零,其他层保留。横轴为被关闭的层;上排是绝对 PPL,下排是相对完整 TIDE checkpoint 的 PPL 增幅。它检验的是既有模型对该层注入的依赖。
- 第 0 层被关闭时,PPL 灾难性上升;下排给 PubMed 约 $1.09\times10^6\%$。这不是一般模型质量变化,也不意味着相同注入安排从头训练一定失败。
- 第 1 层关闭时,WikiText-2、DCLM、PubMed 分别增加 8.1%、8.7%、12.9%。
- 第 4–12 层逐个关闭的代价约小于 2%;第 13 层有第二个峰值,显示各深度作用不均。
作者将其解释为早期注入的信息可保留数层,随后需要再次补充;这是一种机制解释,也可能涉及训练适应或尺度变化,尚非唯一因果说明。不能据此推出所有层都同等必要,或中间层可同时删除而无损。
图中有两处复现注意事项:上排是绝对 PPL,却在 layer 0 标注了与下排不同的“%”,本笔记采用下排的相对口径;可见层索引 0–19 与附录 J 的 24 层描述未一致。
4.7 实测解码并非零开销(Appendix I)
Table 4,PDF p.23,1×B200,跨 5,120 个生成 token 平均:
| K | 延迟(ms/token,↓) | 相对 Base 延迟增加(本次计算) |
|---|---|---|
| 0 / Base | 11.085 | — |
| 2 | 11.236 | 1.36% |
| 4 | 11.854 | 6.94% |
| 8 | 12.688 | 14.46% |
| 16 | 12.901 | 16.38% |
| 24 | 13.422 | 21.08% |
虽然每层额外算术较轻,大 K 仍有可见延迟。论文未完整提供 batch、输入长度、精度、SSD 设备、缓存命中率、预取实现及是否实际 offload,故不能把表 4 宣称为“SSD 卸载后仍只有这些开销”的实测证明。Fig.4 的存储规划、Table 4 的延迟和 Table 5 的量化质量是三类证据,不能自动拼成一个已验证的部署配置。
4.8 量化较温和,强低秩压缩会明显损害质量(Appendix J)
Table 5(PDF p.24)仅压缩 TIDE-8E-1B 的记忆块,三个质量列均为 PPL:
| 记忆精度 | 记忆容量(GB) | WikiText-2 ↓ | PubMed ↓ | DCLM ↓ |
|---|---|---|---|---|
| 16-bit | 4.20 | 10.088 | 11.100 | 16.108 |
| 8-bit | 2.10 | 10.089 | 11.100 | 16.113 |
| 4-bit | 1.05 | 10.263 | 11.277 | 16.343 |
4-bit 相比 16-bit 存储减少 75%,PPL 分别上升 1.73%、1.59%、1.46%;8-bit 几乎持平。原文“negligible”应转成这些具体代价。量化算法、group size、校准/scale 开销与压缩后下游全套任务未完整报告。
低秩实验用每张表的 rank-$r$ SVD 近似 $UV$。保存因子的参数量从 $|\mathcal V|d_b$ 变为 $(|\mathcal V|+d_b)r$,节约存储需
整数可取 $r\le2015$。原 Eq.(J.2) 采用不增存储的 $\le$ 形式。对 2048 维记忆,按 $r=\lceil(1-p)d_b\rceil$,统一扫描 0%–90% 的降秩比例。
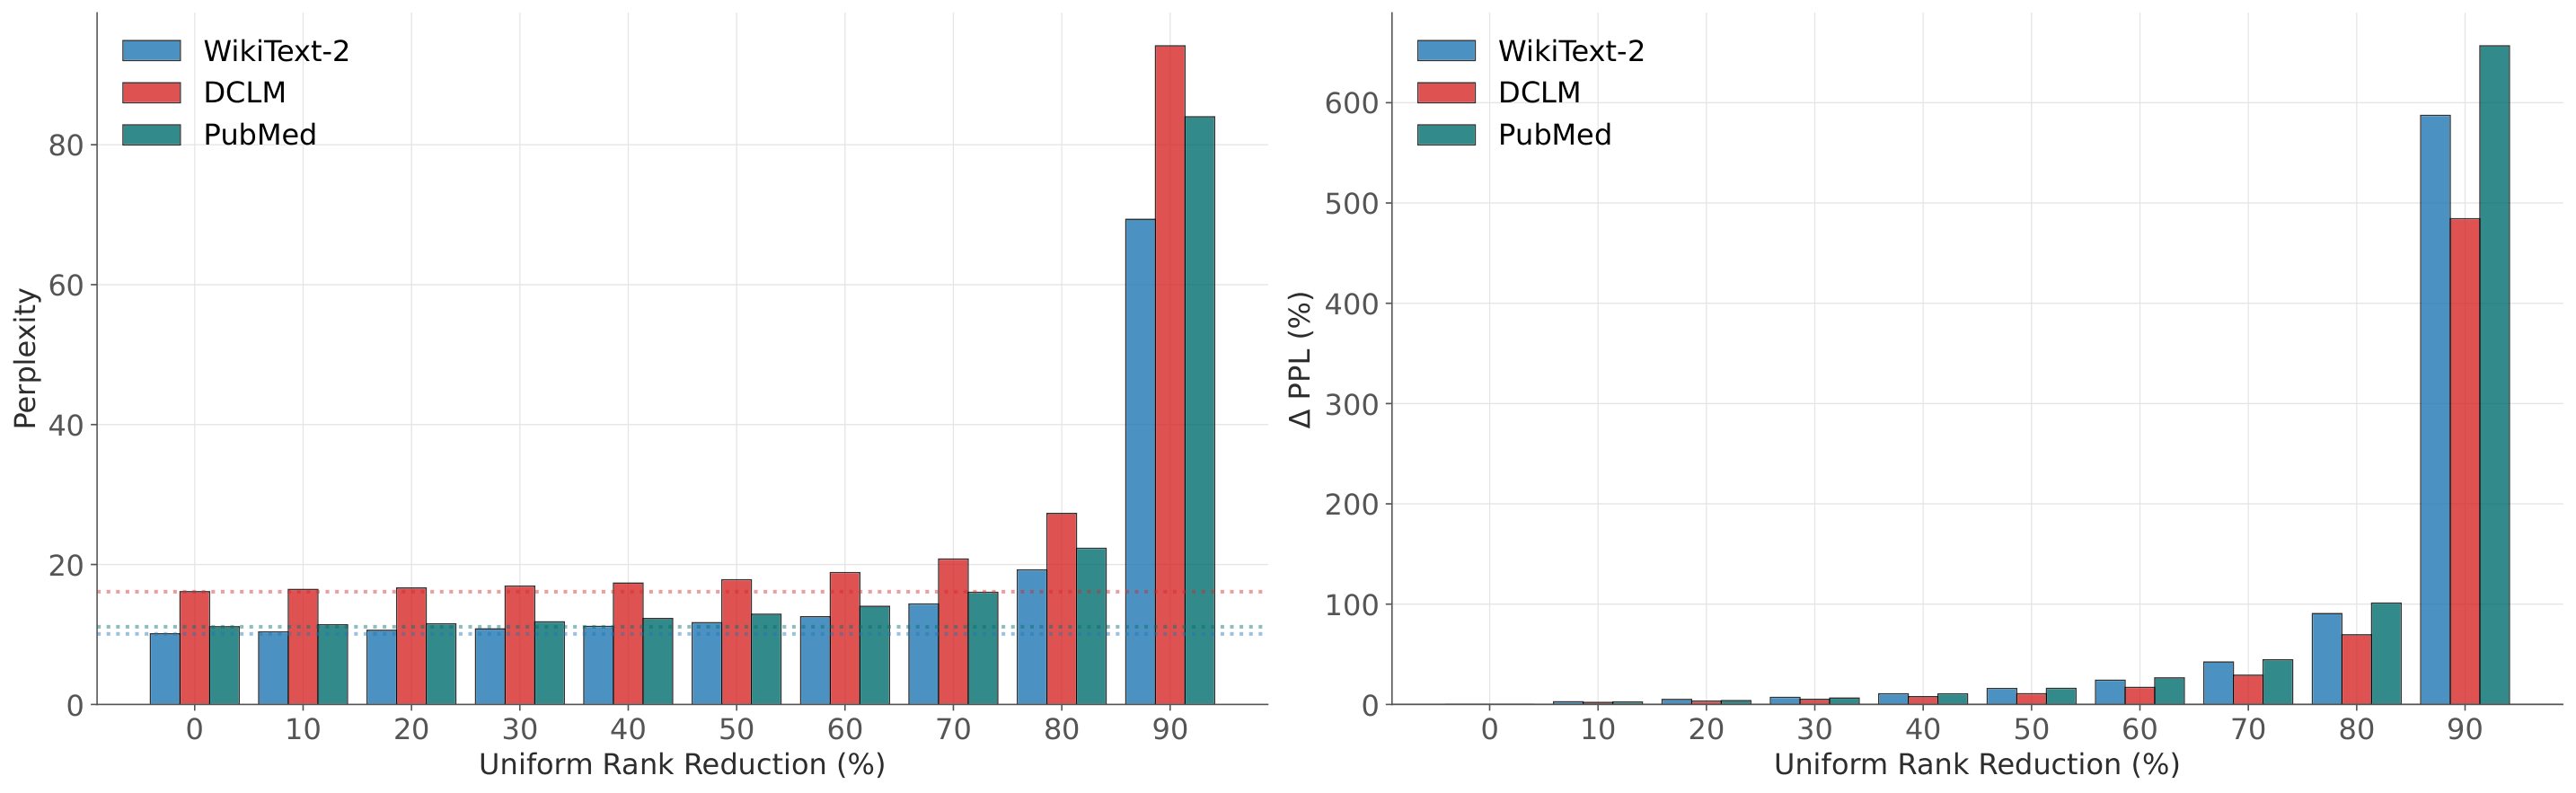
Fig.12,PDF p.24,解释在 p.25。 左图是绝对 PPL,虚线是未压缩基准;右图是相对 PPL 劣化,横轴是减少的秩比例。10%–30% 较温和;40%–60% 劣化逐渐明显;70% 后加速上升。最右的 90% 降秩 对 WikiText-2、DCLM、PubMed 分别达到约 587%、484%、657% 的 PPL 增幅,不能误记为 70% 时的结果。
本次计算:50% 降秩取 $r=1024$,因子参数仍约为原表的 50.8%,省约 49.2%,不是精确减半。该点已可见约 10%–16% 的 PPL 上升(读图近似),不宜笼统称为无损。低秩分解还可能引入在线重构计算,论文未提供压缩后的吞吐验证;量化和低秩是分开的实验,不能假设叠加仍保持各自单独的质量。
4.9 近邻分析展示差异,语义互补还需额外检验(Appendix K)
Fig.13(p.25)比较主输入表和各记忆表的 top-10 cosine 近邻集合,使用 Jaccard
作者提到随机抽取 200 个 rare/common token,但未澄清总计还是每组 200。低频组的 Jaccard 通常更小,说明记忆表为它们组织了不同邻域。
Table 6(p.26)的 asynchronously 例子中,主表多为相近词形和副词,部分记忆块出现 callback、callbacks、caching 等技术相关内容;fred 例子出现姓名变体和相关名字。作者将其解释为语义互补。本次分析:也有语义不明显的近邻,且没有盲评或外部标签证实这些邻居更正确。原表的多词字符串、可见重复字符串和一行不足十项,使仅凭打印文本无法可靠重算 token-ID 层面的 Jaccard;需要原始 ID 与检索代码。
五:结论、证据边界与后续问题
5.1 这篇论文最值得带走的内容
TIDE 提供了一种清楚、容易理解的结构选择:在保留标准上下文计算的同时,让每一层可以再次查询词表身份,并用当前状态控制注入量。 相同主干上的 PPL 和下游平均分改善,以及偏向低频 token 的降损分布,构成了它的实用动机。
收益的代价是额外的大词表参数、训练存储和非零解码开销。4-bit 记忆压缩显示较好的质量—存储折中,但文中的理论不能提供无条件的 K 倍学习效率、全层永不坍缩或完整 SSD 部署保证。
5.2 原文内不一致:哪些会影响解读?
以下是本次原文核验,并不表示已经否定整体实验结果。
| 问题 | 原文定位 | 本笔记采用的处理 |
|---|---|---|
| 常见词非零更新数 1.66×10⁹ 超过总训练步数 | Table 1 / Eq.(2.2),p.3 | 200B/(8×2048)≈1.22×10⁷ 步;常见词不能用稀有近似,表内混入出现次数 |
| 给定参数的梯度比值上界被写为 $10^{-5}$ | Appendix C.1 / Eq.(C.8),p.19 | 代入 $\epsilon=8.3\times10^{-9},BT=16384,\kappa\approx1,G^2/G_{\min}^2=10$ 得约 $1.36\times10^{-3}$,不复述五数量级结论 |
| null bank 退化、任意距离、K 倍梯度存在额外条件 | Props.3.1–3.3,pp.7–8;Apps.E–G | 分开记录已成立代数、参数实现和训练假设 |
| “逐 decile / 多数任务 / NULL 权重单调”强于结果 | Figs.5、7、10,Table 2;pp.8–12 | 采用整体趋势及具体反例 |
| “100B 匹配 200B”与图线位置不符 | Sec.4.1 / Fig.8,p.10 | 不声称 2× 数据效率 |
| Average 列增益与公布分项重算不同 | Table 2,p.10 | 原表 +2.3pp;分项重算 +2.2pp,均注明口径 |
| token 预算、层数与模板数未完全对应 | Fig.5、Table 7、Apps.J/M;Figs.2/6/11 | 逐实验注明预算;列出 24 层 vs 0–19、250 vs 150 的差异 |
| PPL 列写 LAMBDA;bank 编号零/一基混用 | Table 2 p.10;Fig.10 p.12 | 保留表2 PPL 列身份,避免误接图8;不强行纠正 bank 对应 |
两个算术问题的关键是出现次数、更新步数和梯度能量是三个对象。即便 rare token 的机会确实更少,也不能从错误近似获得精确的数量级结论。
5.3 作者承认的局限与本次补充
作者在 Appendix M(p.26)承认:记忆存储随 K 增长;实验仍集中在 750M–3B 主干、200–500B tokens;更长训练、指令微调和 RLHF 后的效果未知;bank 专门化缺少深入机制解释。引言 p.2 的 350M–1B 范围与主表不同,本笔记以实际结果表为准。
本次分析额外关注四点:
- 增加记忆容量与身份反复注入尚未充分分离:缺少等总参数、等 FLOPs、相同输入 embedding 反复注入、单大表、固定/均匀 router 等对照。现有消融主要是训练后干预。
- 几何诊断和理论解释不足以单独确认语义机制:需要匹配表示尺度、身份恢复探针、直接梯度测量或受控实验。
- 复现协议仍有缺口:模型结构、checkpoint 对应、分组聚合口径与评估实现没有完整交代;不应擅自用惯例补齐。
- 部署证据尚未闭合:权重大小、量化精度和单卡延迟分别报告,缺少结合真实 SSD、缓存、长上下文 KV 和 batch 的端到端测量。
5.4 适合组会讨论的后续实验(本次建议,非已完成结果)
- 在相同总参数和训练 FLOPs 下,对比扩大 FFN、单表记忆、重复输入 embedding、K 表路由,识别容量与结构各自贡献。
- 分 token 频率直接测量梯度平方范数及更新方向,并扫描 K/null 权重,检验理论假设是否近似成立。
- 从头训练只在少数层注入的变体,比较质量和耗时;训练后关闭某一层不能代替这一实验。
- 在规范化距离和 token-ID 探针上验证身份保留,并评估同一 token 多义、多 token 实体及未见词组合。
- 固定硬件、batch、上下文长度、量化算法和 SSD/缓存配置,联合报告质量、首 token 延迟、解码延迟、峰值显存和实际存储流量。
建议汇报主线是:单次查表的动机 → 身份记忆与上下文路由 → 低频与下游收益 → 参数/延迟代价 → 条件性理论与尚待验证的问题。这既保留论文的新设计,也让听众知道证据能支持到哪里。