MDN:让 Delta 线性注意力的逐步动量更新能够并行训练
论文:MDN: Parallelizing Stepwise Momentum for Delta Linear Attention
作者:Yulong Huang、Xiang Liu、Hongxiang Huang、Xiaopeng Lin、Zunchang Liu、Xiaowen Chu、Zeke Xie、Bojun Cheng;前两位共同一作。
机构:香港科技大学(广州)。
版本:arXiv:2605.05838v1,提交于 2026-05-07;获取与研读日期:2026-10-20。
链接:arXiv · 原文 PDF · 作者代码 · 英文汇报 PDF · 可编辑 TeX。
论文总览
Momentum DeltaNet(MDN)把线性注意力的快速权重更新看成一个在线优化问题:每个 token 提供一个 key–value 关联,模型根据当前记忆的预测误差更新状态。Gated DeltaNet(GDN)用当前误差做一次梯度下降;MDN 额外保留一个动量矩阵,让历史误差方向继续参与之后的写入。
这篇论文最有价值的地方是把逐 token 动量递推改写成保持因果关系的分块并行计算。作者交换嵌套求和的次序,将历史影响分解成可预计算的标量系数,再用一个下三角系统求出块内残差。训练时因此可以使用矩阵运算,解码时仍然按 token 更新两个固定大小的状态。这里的“分块”是计算调度方式;残差依然基于每一步对应的历史状态。
实验显示,MDN 的优势主要在记忆与检索:400M 和 1.3B 模型的 2K 上下文检索平均分分别为 26.76、36.14,比相同规模最好的其他纯线性模型高 2.29、0.89 个百分点;但 Transformer 仍分别达到 30.42、40.60。1.3B 模型在 16K LongBench 上取得 20.18,超过 GDN 的 19.28。代价是增加动量状态和训练中间量,训练吞吐低于 GDN、Comba,与 Mamba2、KDA 接近。定位:Sec. 4.2–4.3,PDF pp. 7–9,Tables 2–4、Fig. 6。
阅读时需要把三层结论分开:递推与并行形式的代数关系、单步转移矩阵的谱分析、实际训练的稳定性和质量。前两层解释机制,最后一层由实验支撑;v1 在若干系数公式、谱半径表述和动量下界上存在需要辨清的差异,下文在对应位置给出。
结构地图
以下均使用从 1 开始的 PDF 页码,本版本与页脚页码一致。
| 原文章节 | 作用 | PDF 页码与关键对象 |
|---|---|---|
| 1 Introduction | 检索瓶颈、动量动机、逐步更新与训练并行的矛盾 | pp. 1–2;Fig. 1 |
| 2 Notation and Preliminaries | 从注意力到快速权重,介绍 decay、delta、chunkwise | pp. 2–4;Table 1 |
| 3.1 Linear Attention with Stepwise Momentum Rule | 双状态递推、求和换序、系数与块内求解 | pp. 4–5;Eqs. (1)–(18) |
| 3.2 Eigenvalue Analysis and Discussion | 二阶动态和谱约束动机 | pp. 5–6;Fig. 2 |
| 3.3 Neural Architecture | 神经网络模块、归一化、门控参数化 | pp. 6–7;Fig. 3 |
| 4.1 Synthetic Benchmark | MQAR 关联召回 | p. 7;Fig. 4 |
| 4.2 Language Modeling | 预训练、常识任务、检索、LongBench、NIAH | pp. 7–8;Tables 2–3、Fig. 5 |
| 4.3 Efficiency and Ablation Analysis | 吞吐、消融、混合模型、状态变化 | pp. 8–9;Table 4、Figs. 6–7 |
| 5 Conclusion | 方法贡献和后续优化方向 | p. 9 |
| A Notation;B Extended Related Work | 分块记号、相关更新规则 | pp. 15–16;Fig. 8 |
| C Chunkwise Parallel Derivation for Momentum Delta Rule | 完整并行推导 | pp. 17–18;Eqs. (22)–(47) |
| D Coefficients Chunkwise Parallelization | 对数域系数算法 | p. 19;Algorithm 1 |
| E Pytorch-like Pseudo Code for Recurrent and Chunkwise MDN | 递推与分块伪代码 | pp. 20–22 |
| F Stability Condition of Gated Momentum Dynamics | 完整转移矩阵与特征值 | p. 23;Eqs. (55)–(60) |
| G Additional Experiment Details;H Additional Experiments | 训练协议、完整消融 | pp. 23–25;Tables 5–6 |
| I Limitations and Future Work | 规模、内核、混合架构的限制 | p. 24 |
一:动机——压缩记忆如何持续修正
标准自注意力保存历史 key、value;上下文增长时,KV cache 和访问历史的成本也增长。线性注意力把历史压缩进固定大小的矩阵:
这使单步解码的状态大小不随序列长度增长,但不同关联会在同一个矩阵里叠加。衰减机制通过 $\alpha_t\mathbf S_{t-1}$ 遗忘历史;delta rule 则先查询当前 key 对应的预测值,再写入预测误差。以 GDN 为例:
因此 GDN 的一次更新有明确的方向:修正当前 key 的读出误差。MDN 的问题是:能否把过去的误差方向也保留下来,让一次关联的修正影响多个后续时刻,同时维持高效训练? 这是内层记忆更新的动量;外层网络参数仍用 AdamW 训练,两者作用对象不同。定位:Sec. 2–3.1,PDF pp. 2–4。
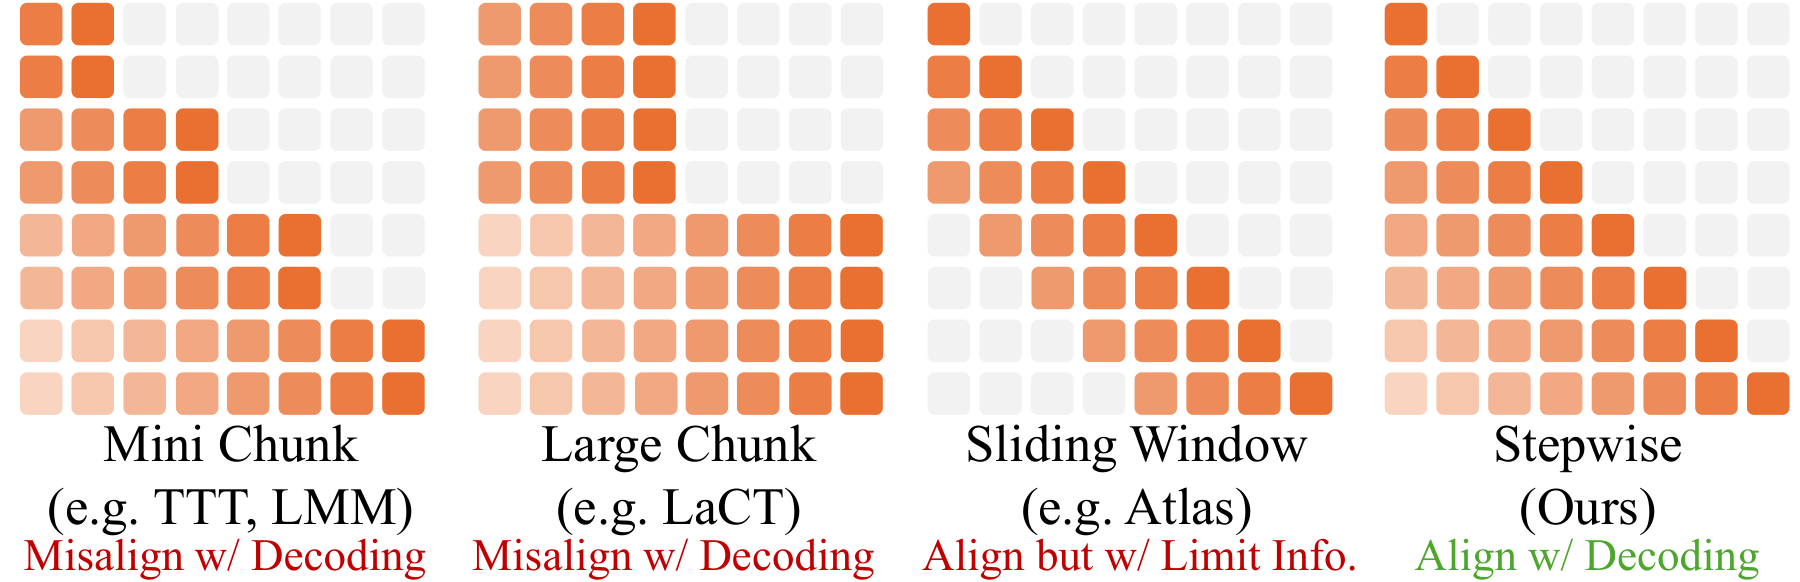
原文 Fig. 1,PDF p. 2。每一行表示一个更新位置,每一列表示它依赖的位置,橙色区域为可见依赖。作者用块状区域说明部分 blockwise 方案相对于逐 token 更新的依赖差异;滑动窗口限制历史范围;最右侧 MDN 保留完整下三角结构。图中“块内非因果”描述的是作者比较的内层更新方案,不能据此认定所有采用 chunk 的模型都会泄漏未来信息。
MDN 要解决的计算障碍来自两层依赖:当前残差依赖 $\mathbf S_{t-1}$,而 $\mathbf S_{t-1}$ 又受过去所有动量更新影响。只并行动量的指数加权求和还不够,必须同时解除残差与历史状态之间的递归关系。
二:方法——从双状态递推到下三角求解
2.1 状态、输入与四个门
下文先讨论一个注意力头。序列长度为 $L$,计算块长为 $C$。
| 符号 | 维度 | 含义 |
|---|---|---|
| $\boldsymbol q_t,\boldsymbol k_t$ | $d_k$ | 查询向量、关联地址 |
| $\boldsymbol v_t,\boldsymbol o_t$ | $d_v$ | 待写入内容、读出结果 |
| $\mathbf S_t$ | $d_k\times d_v$ | 快速权重,即压缩后的关联记忆 |
| $\mathbf M_t$ | $d_k\times d_v$ | 动量,即累计的误差梯度方向 |
| $\alpha_t$ | 标量 | 旧快速权重的保留比例 |
| $\beta_t$ | 标量 | 用动量更新快速权重的步长 |
| $\mu_t$ | 标量 | 旧动量的保留比例 |
| $\eta_t$ | 标量 | 当前误差梯度的缩放 |
| $\boldsymbol p_t=\alpha_t\boldsymbol k_t$ | $d_k$ | 从上一步状态计算残差时的读地址 |
| $\mathbf Q,\mathbf K,\mathbf V,\mathbf P$ | $C\times d_k$ 或 $C\times d_v$ | 一个块内按行堆叠的向量 |
上述门在模型中按 token、按头生成;同一头内共享标量门。推理解码维护 $\mathbf S,\mathbf M$ 两个矩阵,相同头尺寸下这部分状态元素数是单状态更新的两倍,仍与 $L$ 无关。
2.2 在线回归目标怎样产生动量递推
先衰减旧记忆,得到 $\widetilde{\mathbf S}_{t-1}=\alpha_t\mathbf S_{t-1}$,再最小化当前 key 的重构误差:
对这个临时记忆变量求梯度:
将梯度积累进动量,再更新快速权重:
来源:Sec. 3.1,PDF p. 4,Eqs. (3)–(5)。$\widetilde{\boldsymbol v}_t$ 是“希望写入的值减去当前预测”;动量里的负号与状态更新里的负号相消,所以当前误差沿纠正方向写入。令 $\mu_t=0,\eta_t=1$ 就恢复 GDN;再令 $\alpha_t=1$ 得到 DeltaNet。
两步教学例子。 假设两步后的残差已经分别确定,令 $\widehat{\boldsymbol k}_i=\eta_i\boldsymbol k_i$。第 1 步误差对 $\mathbf S_2$ 的贡献为
$\alpha_2\beta_1$ 来自第 1 步写入后留下的记忆;$\beta_2\mu_2$ 来自第 1 步误差仍保存在动量里、第 2 步继续写入。这个新增路径说明历史误差怎样跨步传播。实际模型会重新计算每一步残差,避免把不断重复写入同一个固定值当成算法本身。
2.3 求和换序如何暴露可并行的系数
为避免把 $\eta$ 遗漏,以下显式使用 $\widehat{\boldsymbol k}_t=\eta_t\boldsymbol k_t$;$\boldsymbol p_t$ 仍是 $\alpha_t\boldsymbol k_t$,不随这次记号替换改变。作者在并行推导中把 $\eta$ 吸收进写入 key,这是 Eq. (6) 后脚注的含义。
在一个块内重新从 $1$ 编号,块初始状态记为 $\mathbf S_0,\mathbf M_0$。定义
其中 $\bar\alpha_0=\bar\mu_0=1,c_0=b_0=0$。展开后:
原来 $\mathbf S_i$ 的更新先遍历“动量被使用的时刻”,再遍历“误差产生的时刻”。换序后固定误差产生的时刻 $j$,把它从 $j$ 到 $i$ 的所有影响合并为一个系数:
这与前面的累计积/累计和表达式相同,却更直观:误差先通过动量传播到 $r$,在 $r$ 以 $\beta_r$ 写入,再通过快速权重衰减传播到 $i$。求和区域始终是 $j\le r\le i$;交换遍历顺序不会改变依赖范围。定位:Sec. 3.1,PDF p. 4,Eqs. (7)–(9);Appendix C,PDF p. 17,Eqs. (27)–(31)。
v1 正文 Eq. (8) 将写入项写成了 $\operatorname{Diag}(\gamma_{t,t}/\boldsymbol\gamma_{t,:})$,与前一行展开式不一致。Appendix C 的 Eq. (30) 使用 $\operatorname{Diag}(\boldsymbol\Gamma_{t,:})$,与上式一致。这里采用后者;否则连 $\gamma_{i,i}=\beta_i$ 这一单步关系都无法保持。
2.4 残差尚未给定:用一个因果下三角系统求它
上面的展开只是第一步,因为 $\widetilde{\boldsymbol v}_i$ 仍依赖 $\mathbf S_{i-1}$。代入展开式,有
注意系数是 $\gamma_{i-1,j}$,因为残差读取的是上一步状态。令
因此 $\Gamma^-$ 是 $\Gamma$ 下移一行、首行补零;仅把 $\Gamma$ 的对角线清零会保留错误的时间索引。正文 p. 5 将它简写成“strictly lower triangular part”,但 Appendix E 的 gamma_mask 明确执行了行移位(PDF p. 22,代码第 130–133 行)。
按行堆叠残差,得到
其中 $\bar{\boldsymbol\alpha}^{-}=(1,\bar\alpha_1,\ldots,\bar\alpha_{C-1})^\top$, $\boldsymbol b^{-}=(0,b_1,\ldots,b_{C-1})^\top$。左侧系数矩阵是对角线全为 1 的下三角矩阵,因而可以求解。写作
关键分工由此明确:$\mathbf T,\mathbf U,\mathbf Y,\mathbf Z$ 只依赖块内输入,可以先计算;跨块传来的 $\mathbf S_0,\mathbf M_0$ 进入最后一行。矩阵逆是代数表达,实际计算使用结构化的三角求解/变换,不需要形成整个长度 $L$ 的稠密逆矩阵。定位:Sec. 3.1,PDF p. 5,Eqs. (15)–(18);Appendix C,PDF p. 18;Appendix E,PDF pp. 21–22。
2.5 块输出和跨块状态如何连接
残差已求出后,块内所有位置的输出为
前两项从块入口的历史快速权重和动量读出,第三项处理本块产生的误差写入。把块尾状态传给下一块:
两行必须都用更新前的 $\mathbf S_0,\mathbf M_0$;计算完再替换。训练并行化发生在块内矩阵计算和可提前计算的系数上,跨块仍保留状态传递。Appendix E 的伪代码默认 $C=64$,并在 query 上使用 $d_k^{-1/2}$ 缩放;上式可将该缩放吸收进 $\mathbf Q$。定位:PDF p. 5;Appendix C,PDF p. 18,Eqs. (40)–(42);Appendix E,PDF pp. 20–22。
2.6 数值稳定与反向传播的工程取舍
累计积直接计算时容易下溢,商和累积差也可能产生大中间量。作者因此在每个块内使用对数域:
随后
其中 $\ell_0=-\infty$。正文 Eq. (10) 和 Appendix D 的对应式把 $b$ 的累计 $\log\alpha$ 项写成了 $\log\mu$,与 $b_i=\bar\alpha_i c_i$ 不符;Appendix E p. 21 的 b_t = (log_a_cum + log_ct).exp() 与定义一致。这里按定义及伪代码解释。
Algorithm 1 把对数项广播成 $C\times C$ 的下三角矩阵,逐行减去最大值再做求和,得到稳定的前缀 log-sum-exp。论文将固定小块的这项操作称作 $O(1)$ 时间;从一般复杂度看,它是利用并行归约处理 $O(C^2)$ 个元素,并非对任意 $C$ 都只有常数工作量。固定 $C$、固定头尺寸时,整段序列的计算仍随 $L$ 线性增长;块内还包括三角变换的成本。定位:Sec. 3.1,PDF p. 5;Appendix D,PDF p. 19。
反向传播另有一个取舍。直接重算双状态比重算单个 $\mathbf S$ 更贵,作者选择在前向保存残差 $\widetilde{\mathbf V}$,反向利用残差重建状态,而不保存每个块的完整 $\mathbf S,\mathbf M$。这用额外中间量换取吞吐,Fig. 6 给出了有无残差物化的比较。由此可见,“参数增量很小”“解码状态固定大小”和“训练显存不增加”是三个不同问题。
2.7 二阶动态为什么能够产生复特征值
冻结一个时刻的 key 和门,把输入驱动项暂时分离,状态转移矩阵为
在与 $\boldsymbol k_t$ 正交的方向,特征值分别为 $\alpha_t,\mu_t$;沿 key 方向,剩余两个特征值由一个二次多项式决定。设 $\|\boldsymbol k_t\|_2=1$,用 $r_t$ 表示该二维子系统的迹,以免与后文激活函数的温度 $\tau$ 混淆:
当 $r_t^2<4\alpha_t\mu_t$ 时,特征值是一对共轭复数。写成
可看到振幅衰减与相位变化两个因素:模长控制保留程度,相角控制旋转/振荡。这个解释针对冻结系数的线性系统;实际输入会让 key 和门随时间变化。定位:Sec. 3.2,PDF pp. 5–6;Appendix F,PDF p. 23,Eqs. (58)–(60)。
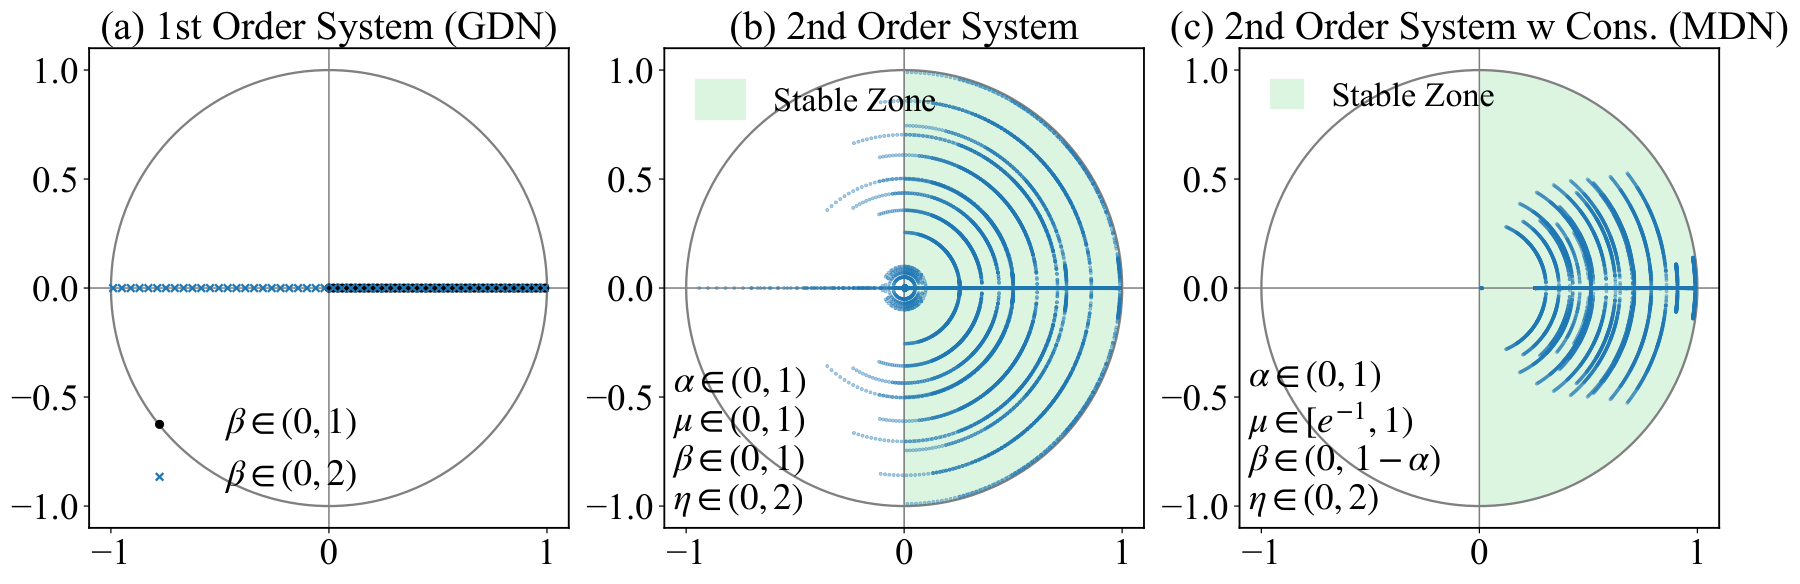
原文 Fig. 2,PDF p. 6。横轴、纵轴分别是特征值实部、虚部,圆周为单位圆。左图展示 GDN 沿 key 方向的实特征值;中图展示动量带来的二维谱区域;右图展示作者约束下的右半平面分布。这里的圆点轨迹来自系数扫描,不能当作训练后各层特征值的实测分布。
正文 p. 5 将 GDN 的谱半径写成 $\alpha_t(1-\beta_t)$,实际这只是沿 key 方向的特征值。若 $d_k>1$,还存在 $d_k-1$ 个 $\alpha_t$,所以在 $0<\beta_t<1$ 下整个矩阵的谱半径是 $\alpha_t$。这个修正不影响“MDN 可以产生复特征值”的对比。
如果消去动量,在 $\beta_{t-1}\ne0$ 时还可得到一个更直观的二阶记忆递推:
这是由 Eqs. (4)–(5) 得到的补充推导。Table 1 的二阶摘要式在 $\boldsymbol k_t\boldsymbol k_t^\top$ 项缺少 $\alpha_t$;Appendix F 的双状态矩阵保留了这个因子。实现时直接使用双状态递推更清楚,也避免除以 $\beta_{t-1}$。
2.8 谱约束如何进入神经网络门控
作者希望保留衰减振荡,同时避开实部为负的谱模式,提出 $\beta_t\le1-\alpha_t$ 和动量下界。实现通过互补上界构造:
$a$ 是正的衰减缩放,$s$ 控制角度范围;论文给出的温度默认值为 $\tau=\sqrt{d_{\mathrm{in}}/h}$。在非正衰减函数下,$\alpha_t\le\alpha_{\max}$、$\beta_t\le\beta_{\max}$,从而 $\alpha_t+\beta_t\le1$。门投影只生成每头少数标量,因此相对网络宽度的参数增量很小。来源:Sec. 3.3,PDF pp. 6–7。
动量下界要按实验表理解。 Fig. 2 和 Sec. 3.3 用 $\log\mu\ge-1$ 说明约束,Sec. 4.3、Tables 4 和 6 则明确把 $-2$ 标为报告结果所用设置;因此不能把主结果解释为使用 $-1$ 下界。
这两个下界并不必然对应不同的谱象限。下面是本次分析补充的一个充分条件:在 $\|\boldsymbol k_t\|=1$、$\eta_t<2$、$\beta_t\le1-\alpha_t$ 下,
所以 $\mu_t>1/8$ 足以使迹为正。又因行列式 $\alpha_t\mu_t>0$,两个 key 方向的特征值实部都为正;报告设置 $e^{-2}\approx0.1353>1/8$ 也满足这一充分条件。
单步谱约束与训练稳定性的关系。 Appendix F 在归一化 key 的设定下给出的单位圆条件是
另有 $|\alpha_t|,|\mu_t|\le1$。它约束冻结时刻的特征值。实际上,当 $\alpha,\mu,\beta\in(0,1),\eta\in(0,2)$ 时,上述单步单位圆条件已经成立;负实部可以造成符号变化,却不自动表示该固定矩阵会发散。
训练中的状态由 $\mathbf A_t\mathbf A_{t-1}\cdots\mathbf A_1$ 决定,而且并行实现还计算累计比值及指数项。逐步特征值在单位圆内,不能直接推出这些变动矩阵乘积和有限精度算法都稳定。论文中移除门约束后出现 NaN,是支持这些工程设计的直接证据;作者将其主要归因于负实部模式,是进一步的机制解释。Appendix F 将部分系数称为固定标量,而 Sec. 3.3 实际按输入生成这些门,因此将附录理解为单步谱分析最合适。
2.9 MDN 如何嵌入语言模型
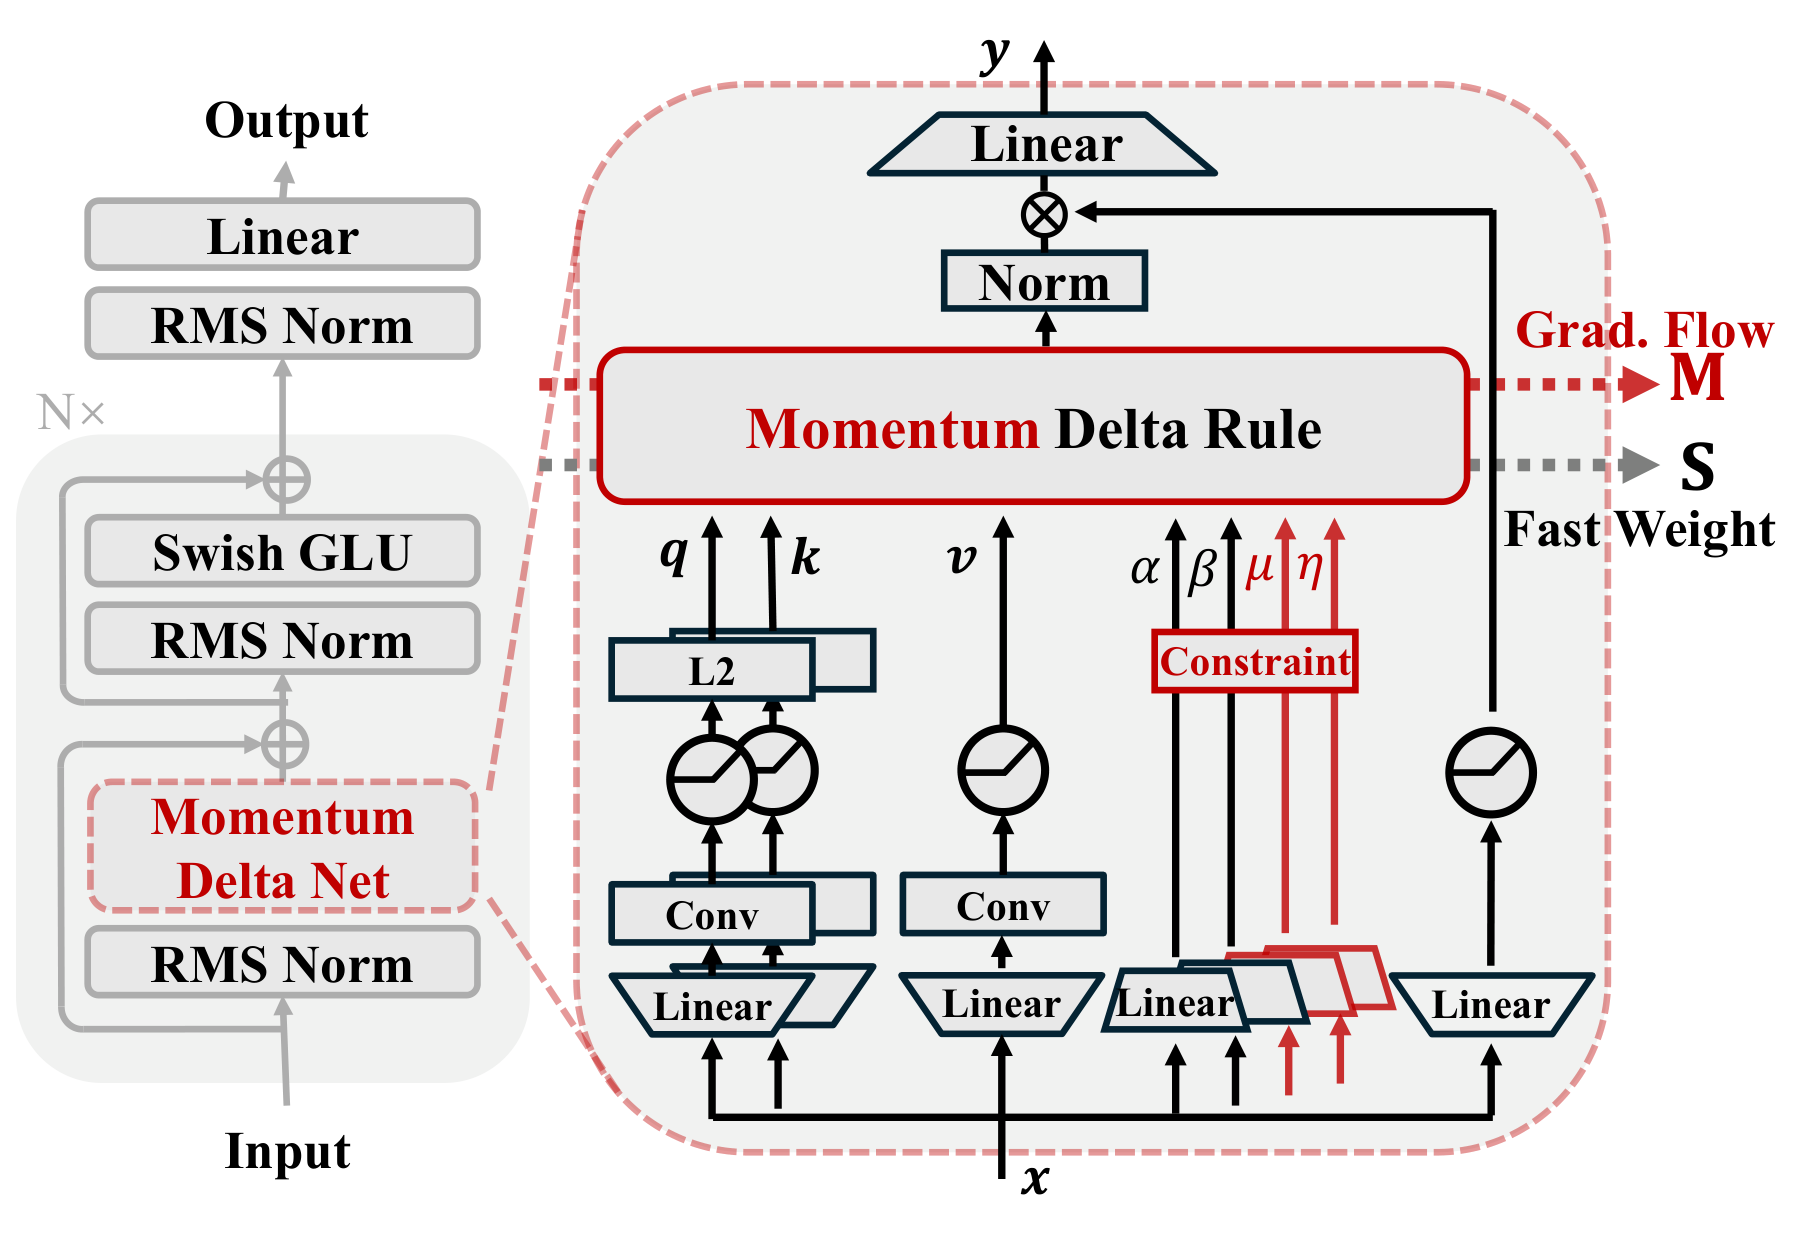
原文 Fig. 3,PDF p. 6。左侧是交替堆叠的注意力模块与前馈模块;右侧从下往上读取:输入投影与短卷积、向量归一化和门控、双状态更新、输出归一化与门控、输出投影。红色部分突出动量及相关门。
每头的 query、key、value 先线性投影,经 ShortConv 与 SiLU;query 和 key 再做 L2 归一化。模型还沿用 Comba 的输出修正,在 query 归一化前使用 $\boldsymbol q_t\leftarrow\boldsymbol q_t-d\boldsymbol k_t$,其中 $d$ 是修正系数,不能与头维度混为一谈。随后执行前述 MDN 核心,最后
训练用分块公式,解码用双状态递推。短卷积、输出修正、归一化和输出门一起构成实际模型,因此“MDN 比 GDN 好”的主表比较是完整架构比较;单独考察动量的贡献需要看消融。定位:Sec. 3.3,PDF pp. 6–7;Table 4,PDF p. 9。
三:实验——分别检验记忆、质量、长度和计算代价
3.1 基线各自回答什么问题
Transformer 使用 LLaMA 风格的 RoPE、SwiGLU、RMSNorm,是保留完整历史访问能力的对照。Mamba2 代表衰减式状态更新;GDN 代表带遗忘的 delta 更新;Comba 提供更强的修正机制对照;KDA 将 delta 注意力的衰减细化到通道。论文提示 KDA 的架构主要为混合模型设计,纯线性版本结果可作为这一具体训练设置下的比较。
所有主表模型在同一数据集上训练相同 token 数,规模分为 400M 和 1.3B。这个协议控制了数据和训练量;它没有将所有模型的递归状态容量或训练显存固定成相同数值。MDN 增加一个动量矩阵的代价应结合效率实验理解。定位:Sec. 4,PDF p. 7;Table 2,PDF p. 8。
3.2 语言模型训练协议
| 项目 | 400M | 1.3B |
|---|---|---|
| 训练 token 数 | 15B | 100B |
| 每批 token 数 | 0.5M | 1M |
| 训练序列长度 | 4K | 4K |
| 学习率预热 token 数 | 0.5B | 1B |
| 学习率 | 峰值 $3\times10^{-4}$,余弦下降至 $3\times10^{-5}$ | 相同 |
| 优化器 | AdamW | AdamW |
| 数据与分词 | SlimPajama 的 100B-token 子集;GPT-2 tokenizer | 相同 |
这里的 15B/100B 是不同规模的训练预算,不能把两组模型当成相同训练量的扩展曲线。来源:Sec. 4.2,PDF p. 7;Appendix G,PDF pp. 23–24。
3.3 各组评测的对象与指标
| 实验 | 检验的问题 | 设置与指标 |
|---|---|---|
| MQAR | 压缩记忆能否保留多个 key–value 关联 | 训练 64–256 tokens、4–64 对;图中测试 512–2048 tokens、32–512 对;准确率越高越好 |
| 语言建模/常识组 | 一般预测与下游表现是否改善 | LAMBADA、WikiText 的 PPL 越低越好;8 项任务准确率的算术平均越高越好 |
| In-context retrieval | 从给定上下文中抽取和使用信息 | FDA、SWDE、SQuAD、NQ、TQA、DROP;2K 输入,6 项得分平均 |
| LongBench | 从 4K 训练长度扩展到 16K 后的任务表现 | 1.3B 模型,14 项任务;任务各自的分数及宏平均,不能统称准确率 |
| RULER NIAH | 不同“针”类型和数量下的检索及长度外推 | 单针、多 key、多 query、多 value;2K、4K、8K、16K 上下文 |
| 效率 | 双状态是否妨碍实际计算 | 单张 H100,1.3B 模型,训练 tokens/s、图示解码时间和显存 |
| 消融与混合模型 | 动量、门约束、输出修正、全注意力比例的作用 | 400M,沿用 15B 训练预算,单项改变配置 |
常识组包括 HellaSwag、LAMBADA、ARC-Easy、ARC-Challenge、PIQA、WinoGrande、BoolQ、SciQ。HellaSwag 与 ARC-Challenge 使用长度归一化准确率 acc_n,其余使用表中标注的 acc;“LM average”是这 8 项的平均,不是 token 级语言建模准确率。附录有 SciQA 字样与不同引文,这里保留 Table 2 实际使用的列名 SciQ。
检索任务使用适合非指令微调模型的轻度转换版本。Appendix H 的协议脚注还说明本文采用 LAMBADA-OpenAI 和 WikiText-4K,而 Comba 原论文采用 LAMBADA-Standard 和 WikiText-2K;比较应使用本论文统一协议下的表内结果,不能直接与外部论文数字拼接。定位:Table 2,PDF p. 8;Appendices G–H,PDF pp. 24–25。
四:结果——改善最明显的地方与付出的成本
4.1 MQAR:高关联密度下更能保留记忆
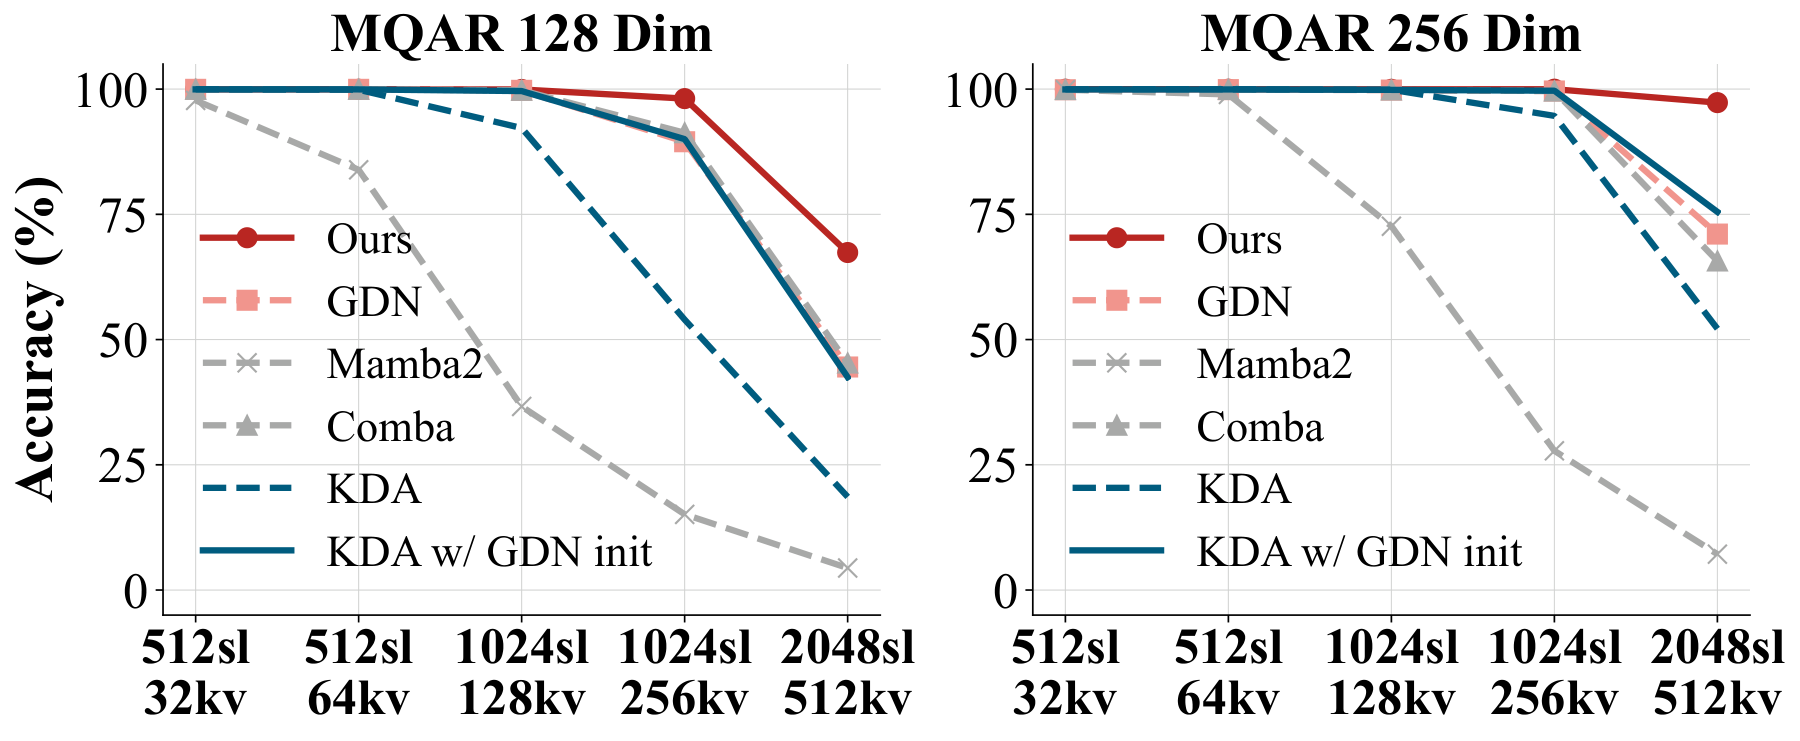
原文 Fig. 4,PDF p. 7。左右面板对应 128、256 的模型嵌入维度;纵轴为准确率,横轴同时改变序列长度 sl 和键值对数 kv,因此不是只控制长度的实验。最右端是 2048 tokens、512 对关联,远超训练中的 256 tokens、64 对。
较容易的配置中多种方法都接近满分,差别在关联数增加后显现:MDN 的红线下降较晚,256 维配置在最难一组仍接近满分。KDA 还分别报告默认初始化和 GDN 初始化两种曲线,初始化明显改变其表现,比较时应辨清图例。该实验支持动量对大量关联召回的帮助,也表明模型宽度和初始化会影响结果。
MQAR 使用两层、两头,key size 为 128,value expansion 为 2;训练 32 epochs、batch size 256,并搜索学习率。这里的 128/256 嵌入维度实验与后面的 400M/1.3B 预训练实验是不同设置。定位:Appendix G,PDF pp. 23–24,Table 5。
4.2 语言建模与常识组:平均增益较小,困惑度更稳定
下表摘自 Table 2(PDF p. 8);PPL 越低越好,常识与检索平均分越高越好。
| 400M / 15B tokens | LAMBADA PPL ↓ | WikiText PPL ↓ | 常识平均 ↑ | 2K 检索平均 ↑ |
|---|---|---|---|---|
| Transformer | 54.36 | 32.80 | 48.06 | 30.42 |
| Mamba2 | 60.42 | 33.45 | 47.85 | 21.12 |
| GDN | 45.63 | 32.10 | 48.51 | 22.93 |
| Comba | 46.19 | 31.73 | 48.91 | 24.01 |
| KDA | 43.44 | 31.96 | 49.06 | 24.47 |
| MDN | 41.62 | 31.51 | 49.42 | 26.76 |
| 1.3B / 100B tokens | LAMBADA PPL ↓ | WikiText PPL ↓ | 常识平均 ↑ | 2K 检索平均 ↑ |
|---|---|---|---|---|
| Transformer | 17.90 | 18.99 | 57.95 | 40.60 |
| Mamba2 | 18.20 | 19.14 | 57.10 | 32.45 |
| GDN | 16.12 | 18.51 | 57.44 | 32.80 |
| Comba | 15.17 | 18.37 | 58.49 | 35.25 |
| KDA | 16.83 | 19.24 | 58.56 | 32.62 |
| MDN | 14.87 | 18.03 | 58.82 | 36.14 |
MDN 在两种规模的两项 PPL 上均为表中最低,常识平均也最高;相对常识平均最好的其他线性模型 KDA,增益为 0.36、0.26 个百分点。这说明收益并非只发生在合成检索任务,但平均差距应按实际数值理解。单项也存在取舍,例如 400M 的 WinoGrande 为 50.28,低于 KDA 的 53.28;1.3B 的 BoolQ 为 59.63,低于 Comba 的 62.02。
4.3 上下文检索:缩小了与完整注意力的差距
相对 GDN,MDN 的平均检索分从 22.93 增至 26.76、从 32.80 增至 36.14,分别提高 3.83、3.34 个百分点。相对最强的其他纯线性基线,增益则是总览中的 2.29、0.89 个百分点。
Transformer 仍然最高:400M 比 MDN 高 3.66 个百分点,1.3B 高 4.46 个百分点。这与固定状态压缩的任务取舍相符:动量改善写入动态,却没有把完整历史 KV 变成可逐项访问的记忆。
收益也不是所有检索子项都改善。1.3B MDN 的 SWDE 为 42.74,高于 Comba 的 38.33;但 DROP 为 20.36,低于 GDN 的 21.27、Comba 的 21.37。论文最直接支持的结论是平均检索能力提高,而非每个检索任务都获益。来源:Table 2,PDF p. 8。
4.4 LongBench:代码与摘要贡献突出
1.3B 模型用 4K 序列训练,在 16K 输入上评估。以下选择能看出整体优势及任务取舍的列;完整表还有其他问答和少样本任务。
| 模型 | 14 项平均 ↑ | LCC 代码 ↑ | RepoBench-P 代码 ↑ | GovReport 摘要 ↑ | QMSum 摘要 ↑ | MultiNews 摘要 ↑ |
|---|---|---|---|---|---|---|
| Transformer | 8.35 | 38.80 | 11.94 | 5.49 | 7.38 | 17.04 |
| Mamba2 | 15.00 | 38.51 | 30.69 | 5.44 | 16.60 | 14.73 |
| GDN | 19.28 | 42.94 | 30.70 | 7.81 | 15.98 | 16.82 |
| Comba | 18.11 | 44.74 | 36.60 | 9.60 | 16.52 | 16.74 |
| KDA | 18.62 | 37.99 | 33.39 | 10.02 | 15.59 | 16.95 |
| MDN | 20.18 | 50.50 | 39.13 | 10.24 | 17.20 | 18.85 |
来源:Table 3,PDF p. 8。MDN 平均高于 GDN 0.90 分,约为 4.67% 的相对提升,这里的 0.90 是综合分差,不是统一准确率的百分点。代码两项和摘要三项均领先,是该组最清楚的优势。
其余任务上优势并不统一:MuSiQue 为 3.63,略高于 GDN 的 3.28;MultiFieldQA 则为 12.21,低于 GDN 的 13.29;少样本分类 SSM 为 15.65,低于 GDN 的 26.27。Transformer 的平均分很低发生在 4K 训练、16K 测试的长度外推设置中;不能用它推断经过长上下文训练或位置扩展后的 Transformer 也有同样差距。
4.5 NIAH:越过训练长度后仍有检索收益,但难任务会衰减
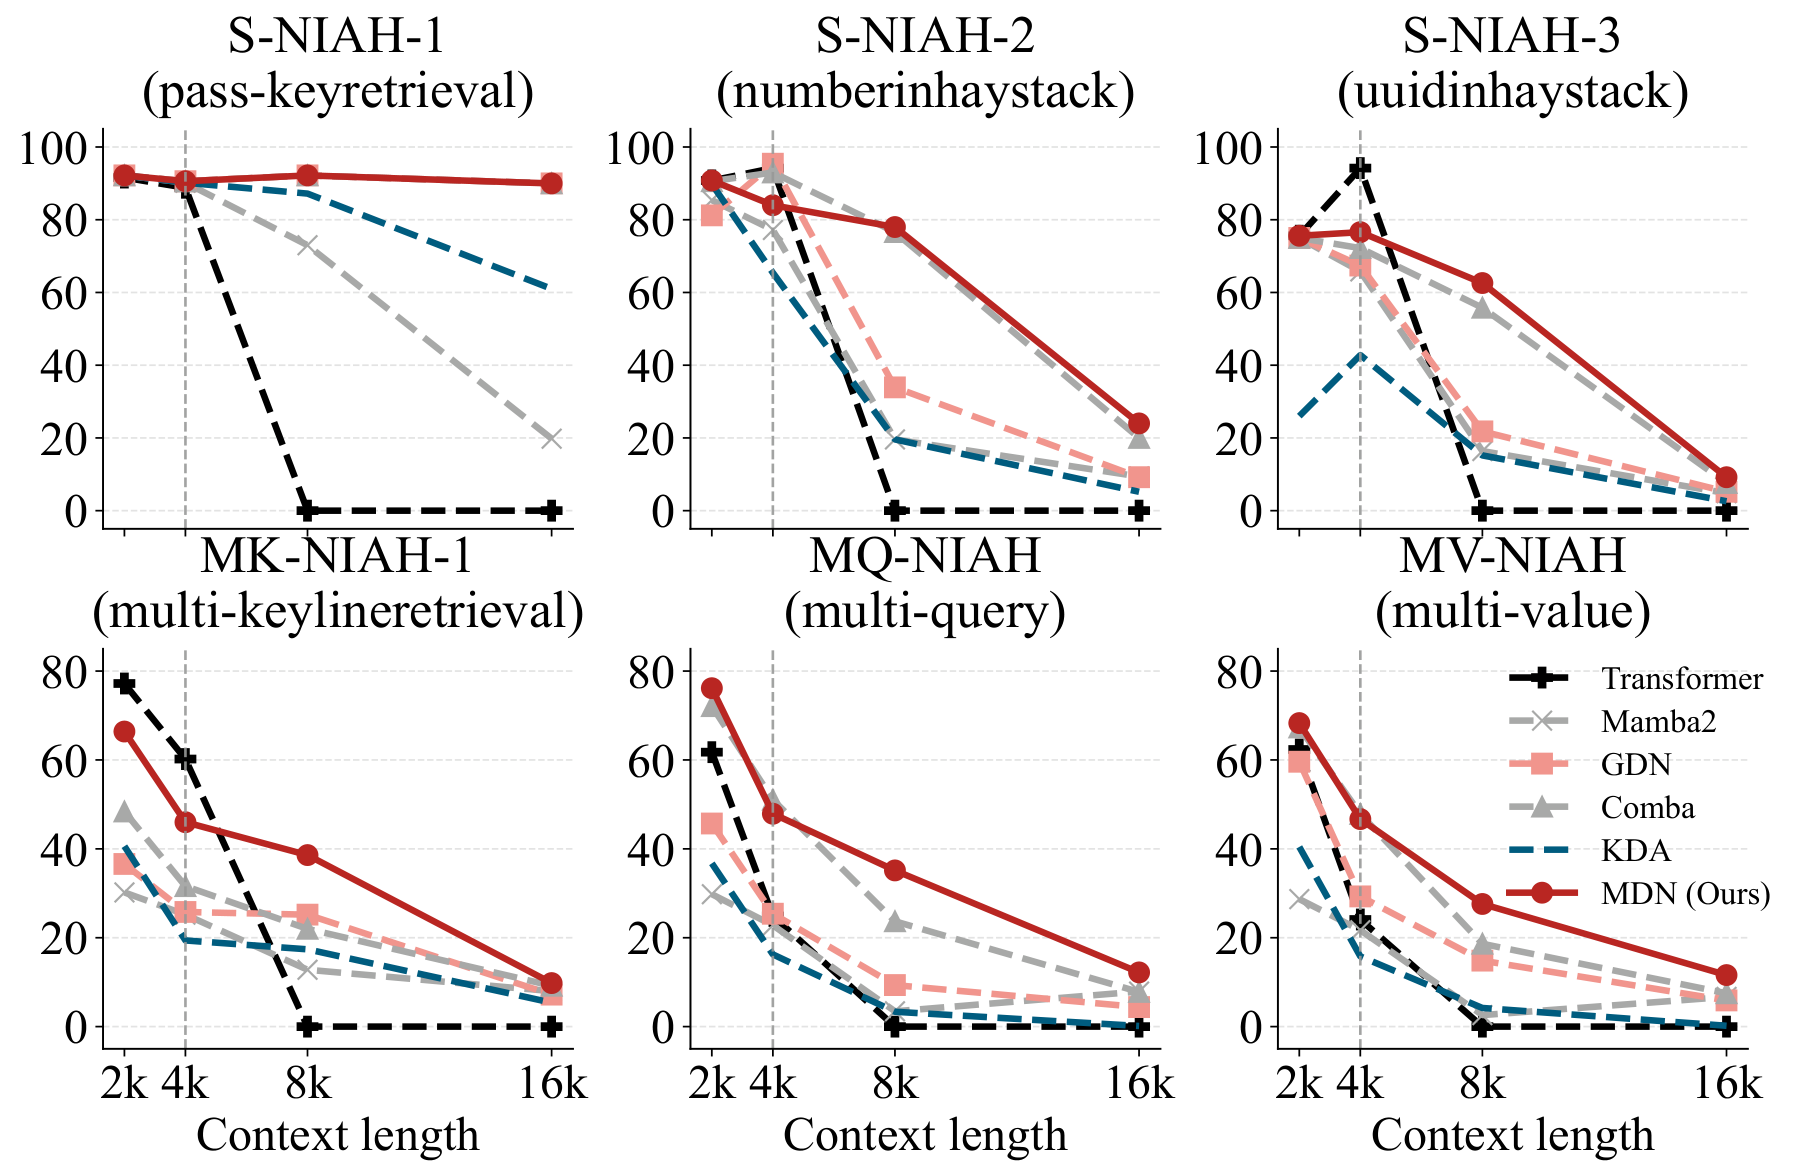
原文 Fig. 5,PDF p. 8。横轴是上下文长度,纵轴为检索得分;灰色虚线标出 4K 训练长度。上排为三个单针任务,下排为多 key、多 query、多 value。应先比较同一面板内的长度变化,再比较各类任务的难度。
正文精确报告了 8K 的多针结果:
| 8K 子任务 | MDN | 相对该任务最强其他基线的增益 |
|---|---|---|
| MK:多 key | 38.60 | +13.40 分 |
| MQ:多 query | 35.15 | +11.45 分 |
| MV:多 value | 27.60 | +8.95 分 |
这些增益支持动量对超出训练长度的检索有帮助。单针 pass-key 曲线尤其稳健,但多针任务在 16K 时仍显著下降。此处反映的是不同检索类型上的长度外推能力,不能只用最容易的 pass-key 面板概括全部长上下文表现。
4.6 效率:解码接近单状态基线,训练要付出额外成本
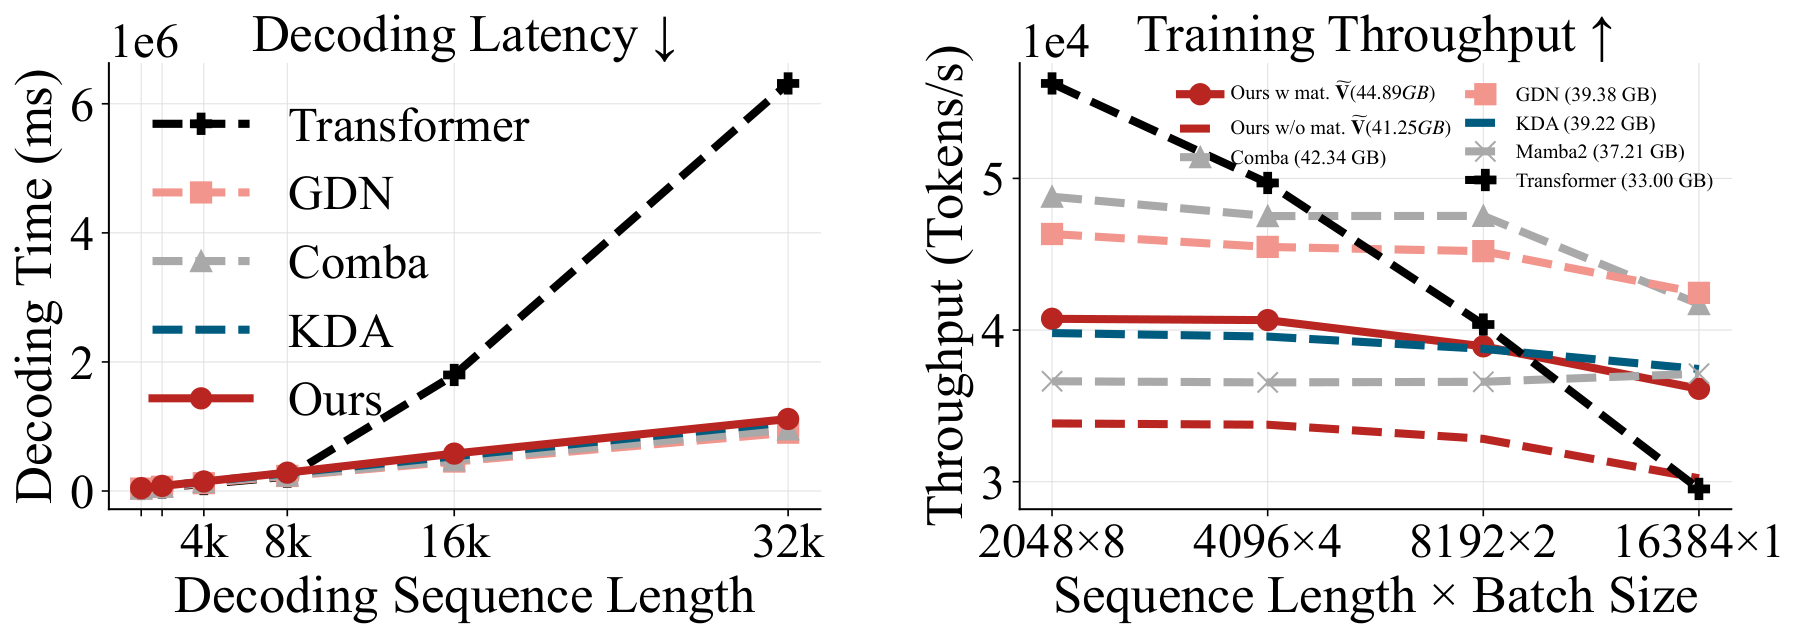
原文 Fig. 6,PDF p. 8,1.3B 模型、单张 H100。左图横轴为解码序列长度,纵轴标注 Decoding Time (ms);曲线随生成长度积累,不应将图中数值直接称作单 token 延迟。MDN 与 GDN、Comba、KDA 接近,Transformer 在长序列下增长明显。
右图横轴从 $2048\times8$ 到 $16384\times1$,每点的序列长度与 batch size 乘积均为 16384 tokens;纵轴为训练 tokens/s。MDN 实线代表保存残差 $\widetilde{\mathbf V}$,红色虚线代表不保存。保存后吞吐提高,与 KDA、Mamba2 处于相近范围,但仍低于 GDN、Comba。Transformer 在短序列点的吞吐反而更高,随长度增加下降更快。
图例报告的显存为:
| 实现 | 图例显存 |
|---|---|
| MDN,保存残差 | 44.89 GB |
| MDN,不保存残差 | 41.25 GB |
| Comba | 42.34 GB |
| GDN | 39.38 GB |
| KDA | 39.22 GB |
| Mamba2 | 37.21 GB |
| Transformer | 33.00 GB |
保存残差增加 3.64 GB。图例没有为每个长度分别列显存,因此这些数值应作为该图报告的实现开销,不能进一步解释为每个配置的精确峰值。效率结论是双状态模型仍具备可用的并行训练和递归解码速度,而非在所有负载下都最快或最省显存。
4.7 组件消融:动量对检索的作用最明显
以下摘自 Table 4(PDF p. 9),完整单项结果及失败说明见 Table 6(PDF p. 25)。
| 400M 变体 | LAMBADA PPL ↓ | WikiText PPL ↓ | 常识平均 ↑ | 检索平均 ↑ |
|---|---|---|---|---|
| MDN | 41.62 | 31.51 | 49.42 | 26.76 |
| 去掉输出修正 | 42.31 | 31.72 | 49.19 | 25.52 |
| 去掉动量的可运行替代版本 | 47.01 | 32.11 | 49.26 | 20.12 |
| 去掉 $\beta_{\max}$ 约束 | 42.72 | 31.52 | 48.93 | 26.40 |
| $\eta=2\sigma(\cdot)$ | 49.10 | 31.89 | 49.41 | 25.54 |
去掉输出修正后,检索下降 1.24 个百分点,但仍高于 GDN、Comba。去掉动量的替代版本则下降 6.64 个百分点,常识平均仅下降 0.16 个百分点,支持动量的主要收益集中在记忆/检索这一解释。
这里的“去掉动量”必须读脚注:直接在并行内核中令 $\mu=0$ 会因除法和对数形式产生首步 NaN,表中可运行版本实际是给 GDN 加上 $\alpha_{\max},\beta_{\max}$ 约束。递推公式在 $\mu=0$ 时有良好定义,失效的是没有专门处理零动量的通用并行系数实现。因此,这一行不能描述为“原 MDN 内核只把动量变量设零”的实验。
另外,去掉 $\log\mu$ 下界后,Table 6 报告第 70 个训练步出现 NaN;固定 $\alpha_{\max}=1$ 则首步失败。这说明下界和门控耦合对作者的实际实现重要,具体失败机制仍应与前文的单步谱条件区分。
4.8 动量下界:检索与常识指标的最优点不同
| $\mu_{\min}^{\log}$ | LAMBADA PPL ↓ | WikiText PPL ↓ | 常识平均 ↑ | 检索平均 ↑ |
|---|---|---|---|---|
| −2:主结果设置 | 41.62 | 31.51 | 49.42 | 26.76 |
| −1.5 | 42.65 | 31.50 | 48.94 | 26.03 |
| −1.357 | 44.90 | 31.44 | 49.50 | 25.31 |
| −1 | 43.53 | 31.39 | 49.88 | 25.85 |
来源:Table 4,PDF p. 9。提高下界意味着禁止动量衰减得太快,但不带来所有指标的单调改善。作者选用 −2 是因为 LAMBADA PPL 与检索表现最好;−1 的 WikiText PPL 和常识平均更好。这是表达范围与稳定门控之间的实际调参取舍。
4.9 混合模型:较少全注意力层有潜力,仍需看同类比较
比例表示线性注意力层数与全注意力层数之比。
| 400M 混合模型 | LAMBADA PPL ↓ | WikiText PPL ↓ | 常识平均 ↑ | 检索平均 ↑ |
|---|---|---|---|---|
| Mamba2-H 3:1 | 61.27 | 33.73 | 48.34 | 22.24 |
| GDN-H 3:1 | 46.07 | 29.96 | 48.53 | 33.35 |
| Comba-H 3:1 | 40.88 | 29.92 | 49.35 | 34.72 |
| KDA-H 3:1 | 41.78 | 29.49 | 48.93 | 34.46 |
| MDN-H 3:1 | 46.71 | 30.09 | 48.61 | 33.84 |
| MDN-H 7:1 | 42.95 | 30.32 | 49.68 | 34.37 |
来源:Table 4,PDF p. 9。MDN-H 从 3:1 改到 7:1 后,常识平均提高 1.07 个百分点、检索提高 0.53 个百分点,LAMBADA PPL 改善,WikiText PPL 略变差。这个结果说明更稀疏的全注意力配置值得探索。
不过,同为 3:1 时 MDN-H 没有全面胜过 Comba-H 或 KDA-H;7:1 的检索分也仍低于 Comba-H 3:1。论文没有为这组比例变化同时提供速度收益,所以“减少全注意力层可能改善成本”的结构直觉与已测得的质量结果应分别理解。
4.10 状态变化统计:支持更活跃的记忆更新
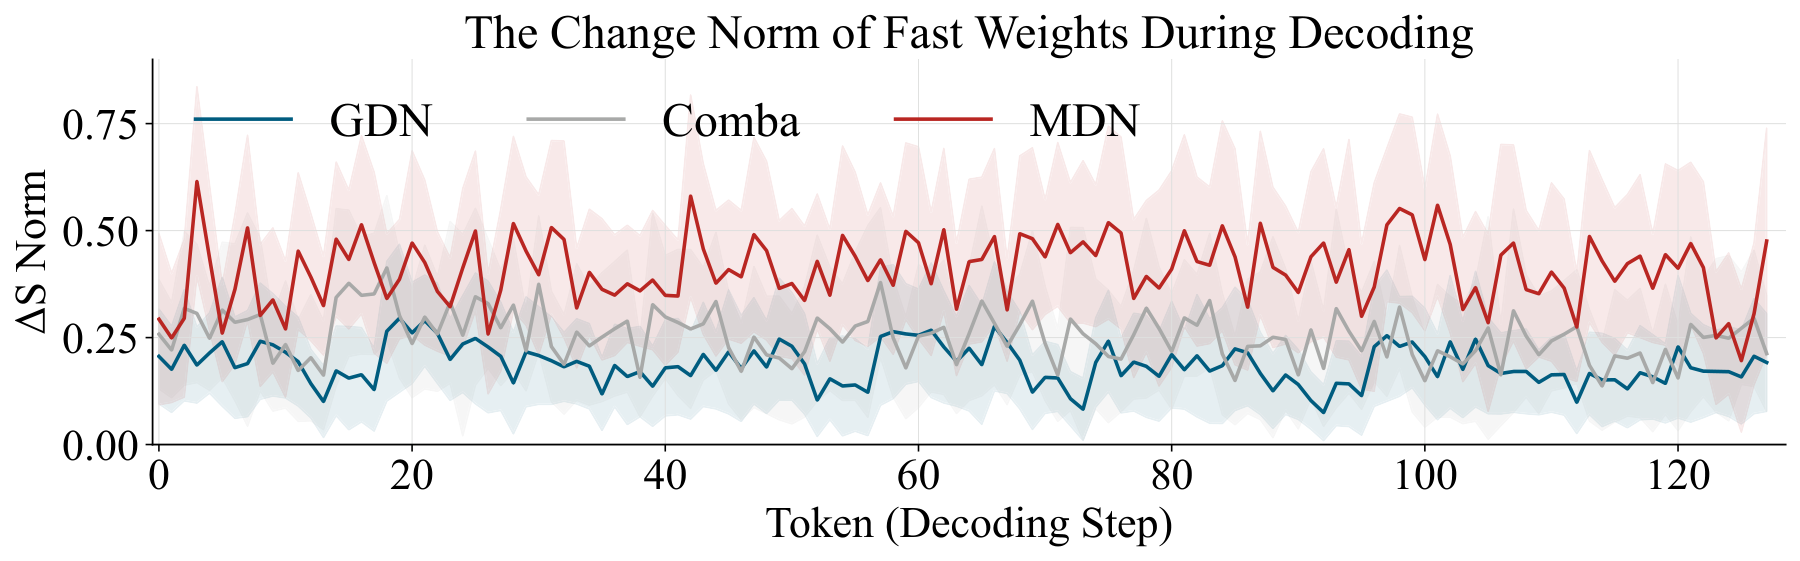
原文 Fig. 7,PDF p. 9。横轴是解码 token 步数,纵轴为论文定义的平均变化范数:
MDN 的红线大多高于 GDN、Comba,说明快速权重更新幅度更大。作者将其与检索改善联系起来,解释为更丰富的记忆动态。图中阴影的具体统计口径没有说明,因此不将其称为置信区间。这个量测的是变化幅度,单独增大范数并不等于存储了更多有效信息;它在这里作为主任务结果的补充解释。
五:结论——最值得保留的方法启发
MDN 提供了一个可复用的思路:从在线优化规则出发设计递归记忆,再利用更新中的线性结构寻找精确的并行算法。关键链条是:逐步动量 → 求和换序 → 系数与误差外积分离 → 块内残差三角求解 → 矩阵运算与跨块双状态传递。
对理解这篇论文,最重要的三点是:
- 动量保存历史误差方向。 它增加了历史关联影响未来写入的路径;合成召回、2K 检索和部分长上下文任务都显示收益。
- 并行化保留了逐步残差的依赖。 不能把求和换序理解成用块入口状态近似整个块;正确的 $\Gamma^-$ 行移位正是维持这一点的关键。
- 质量、状态容量和训练效率一起变化。 MDN 增加双状态动态,在主实验中提升纯线性模型的平均质量,同时付出训练吞吐及显存成本。最好的 2K 检索成绩仍来自 Transformer。
后续最有价值的问题围绕这些具体取舍展开:能否优化双状态反向计算,缩小与 GDN/Comba 的吞吐差;能否给输入相关门和变动 key 的矩阵乘积建立更强的稳定性条件;以及在更大模型和更多混合比例下,动量收益能否覆盖额外状态成本。论文的规模上限是 1.3B、100B 训练 tokens,7B 及以上仍是作者明确保留的研究方向。定位:Appendix I,PDF p. 24。