Consistent Diffusion Language Models:中文研读笔记
作者:Hasan Amin、Yuan Gao、Yaser Souri、Subhojit Som、Ming Yin、Rajiv Khanna、Xia Song。前两位共同第一作者;机构为 Purdue University 与 Microsoft。
版本:arXiv:2605.00161v2,2026-05-30 修订;论文标注 ICML 2026。
研读与获取日期:2026-10-13。
原文:arXiv 页面 · 本地 PDF · 英文汇报幻灯片。下文页码均为从 1 开始的 PDF 页码,与本文印刷页码一致。
论文总览
离散扩散语言模型可以同时更新多个 token,但若生成一段文本仍要运行数百次网络,并行性的收益就会受到限制。CDLM(Consistent Diffusion Language Model,一致扩散语言模型)尝试把“适合大步去噪”直接写进从零训练的目标:给同一条训练文本制造较脏和较干净的两个状态,让它们对原始 token 的预测保持一致。
关键在于如何制造这对状态。作者采用离散扩散已知的精确后验桥 $q(\mathbf x_s\mid\mathbf x_t,\mathbf x_0)$,提出多路径离散一致性(Multi-Path Discrete Consistency,MPDC):从噪声状态直接预测,与先沿真实反向链跳到较干净状态再预测,应当在条件期望上相同。CDLM 将这一原则实现为带目标网络、JSD 损失、跨时间步训练和干净数据锚点的单阶段训练方法。[Sec. 3,pp. 4–6]
在 110M 参数、OpenWebText、1024-token 生成设置中,FP64 采样的 MCDLM–PPLOptimized 在 64 步达到生成 PPL 40.1、熵 5.3,对应 MDLM 为 124.4 / 5.6;AR 基线在 1024 次顺序生成处为 40.2 / 5.6。这是明显的生成质量—调用次数改进,同时存在熵的取舍。实验采用外部 gpt2-large 评价生成文本,每个模型生成 32 条样本;这些数字不是模型自身的测试集似然,也不是实测延迟。[Table 1,p. 7]
理解本文要同时抓住两层:后验桥与条件期望提供数学结构,JSD、数据锚点和调度决定实际训练是否有效。 后面的理论证明与消融结果分别支撑这两层,不能把它们合并成“实际训练已被证明能精确恢复完整文本分布”。
结构地图
| 原文章节 | 主要作用 | PDF 定位 |
|---|---|---|
| 1. Introduction | 少步生成动机;MPDC 的定位 | pp. 1–3;Fig. 1–2 |
| 2. Problem Setup | 离散前向链、后验、连续 PF-ODE 背景 | p. 3 |
| 3.1 Learning a Path-Independent Denoiser | 后验桥、一致性算子、Bayes 不动点、训练与采样 | pp. 4–5;Eq. (2)–(6) |
| 3.2 Design Insights for Stable and Scalable Training | 步长课程、max-step 数据锚点、EMA 与 JSD | p. 5;Eq. (7) |
| 3.3 A Unifying View of Discrete Generative Modeling | 与 MDLM、连续一致性及蒸馏的联系 | pp. 5–6 |
| 4.1 Related Baselines and Model Categorization | 单阶段模型与蒸馏模型;4.1.1 引出无条件生成 | p. 6 |
| 4.2 Experimental Setup | 模型规模、训练预算和变体配置 | pp. 6–7 |
| 4.3 Results and Analysis | 无条件生成及 4.3.1 条件恢复 | pp. 7–8;Table 1–3 |
| 4.4 Ablations and Insights | 调度、数据锚点与散度的作用 | pp. 8–9;Table 4–6 |
| 5. Discussion and Conclusion | 少步而非一步的目标;离散领域扩展 | p. 9 |
| A. Related Work;B. Algorithms | 相关路线与 CD3T / M-CDLM 算法 | pp. 12–14;Algorithm 1–2 |
| C. From Local to Global Consistency | TV 误差累积与 excess-risk 分析 | pp. 12–15 |
| D. Rigorous Unification of Discrete Generative Models | 各种统一关系的推导 | pp. 15–18 |
| E. Additional Proofs | 后验桥与 Bayes 不动点证明 | pp. 18–20 |
| F. Additional Results | 实现、FP32、MAUVE、生成样例 | pp. 20–24;Table 7–8 |
一:动机——把少步能力变成训练目标
自回归模型依次生成 token;扩散模型通过反复去噪更新多个位置,理论上可用较少轮次生成长序列。然而,一个擅长小步修正的去噪器,直接换成大步采样时,质量可能显著下降。因此问题不只在采样器,也在训练是否让模型接触了跨越较大噪声间隔的任务。
连续一致性模型沿概率流常微分方程(probability-flow ODE,PF-ODE)构造确定性轨迹,并要求轨迹上不同点给出一致的干净预测。离散 token 的变化是随机跳转;在原始类别样本空间中,没有相同形式的连续确定性轨迹可直接套用。这里的障碍针对样本空间里的 PF-ODE 路线,不排斥在概率空间写演化方程或引入连续潜变量。[Sec. 2,p. 3]
CDLM 的切入点是:不必先构造一条确定性轨迹,已知扩散过程本身就能提供不同噪声状态之间的条件分布。训练时利用真实文本,能精确采样这些随机连接,从而绕开预训练教师的多步 rollout。
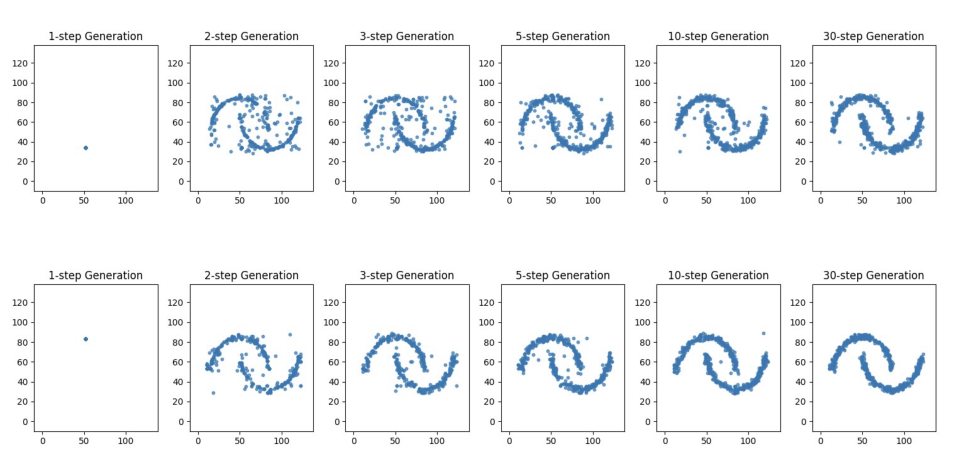
原文 Fig. 1,p. 1。横向六个面板依次为 1、2、3、5、10、30 步,图内横纵轴是量化后的二维坐标。CDLM 在 2–3 步时已呈现较清楚的双月结构;普通 masked diffusion 随更多步数逐渐变清晰。这是离散化玩具数据上的机制示意,文本实验的质量需另看后面的指标与样例。
二:方法——精确连接状态,学习期望一致性
2.1 符号与前向过程
| 符号 | 含义 |
|---|---|
| $\mathbf x_0\in\mathcal V^L$ | 长度为 $L$ 的干净 token 序列,词表为 $\mathcal V$ |
| $\mathbf x_t$、$\mathbf x_s$ | 噪声水平 $t$、$s$ 的序列,$0\le s |
| $Q_t\in\mathbb R^{\lvert\mathcal V\rvert\times\lvert\mathcal V\rvert}$ | 单 token 的行随机转移矩阵 |
| $Q_{a:b}$ | 按时间相乘的转移矩阵,描述一个时间区间 |
| $\delta=t-s$ | 本次训练跨越的噪声间隔 |
| $f_\theta(\mathbf x_t,t)_i$ | 第 $i$ 个位置的干净 token 概率向量 |
| $\mathcal M(\mathbf x_t)$ | 参与损失的位置;masked 扩散为 mask 位置,uniform 扩散为全部位置 |
| $\tilde\theta$、$\mathrm{sg}$ | 目标网络参数与 stop-gradient |
| $\kappa_{\rm ms}$ | 最大步长任务即干净数据锚点的混合权重 |
文中把 token 与其 one-hot 行向量共用记号。前向过程在给定干净文本后逐位置独立:
这一独立性属于腐化过程。真实文本位置之间可以有关联,网络也能读取整条噪声序列;将干净文本边缘化之后,真实反向链一般不会逐位置独立。[Sec. 2,p. 3]
2.2 后验桥怎样计算
给定干净 token $x_0^i$ 与较脏的 $x_t^i$,中间状态 $x_s^i$ 的分布由 Bayes 公式得到:
分子的第一项是“从干净 token 走到各个候选中间 token”的先验概率,第二项是“该中间 token 能产生已观察到的 $x_t^i$”的似然;分母是归一化常数。公式在前向过程有正概率产生的观测上使用。序列级 oracle bridge 是这些位置分布的乘积。[Lemma 3.1,Eq. (2),p. 4;Appendix E.1,pp. 18–19]
对于 $u 这说明直接走 $t\to u$,与先走 $t\to s\to u$ 再边缘化中间状态,得到相同的条件分布。这里相同的是分布,不要求两条随机路径逐样本相同。 后验桥公式继承已有离散扩散结构;本文的新意是利用它定义跨路径训练目标。 对于线性 masked 扩散,时刻 $t$ 以概率 $t$ 将 token 替换为 这里 $\delta_a$ 表示集中在状态 $a$ 上的点质量分布,与步长 $\delta=t-s$ 按上下文区分。即已显露的位置保持不变,仍被遮盖的位置以 $(t-s)/t$ 的概率恢复真实 token。[Algorithm 2,p. 14] 教学例子:取 $t=0.8,s=0.4$,文本为“猫 坐 垫”,当前状态为“ 先将未知的干净文本边缘化,定义真实反向转移: 一致性算子逐位置取较干净预测的条件期望: 理想条件是 $f^*=\mathcal C_{s\leftarrow t}f^*$,并满足干净边界 $f^*(\mathbf x_0,0)_i=\delta_{x_0^i}$。其 Bayes 不动点为 证明的核心是 Markov 条件独立性与全期望公式:经过 $\mathbf x_s$ 对 $x_0^i$ 的预测再取条件平均,仍等于直接给定 $\mathbf x_t$ 的后验。加入正权重的数据边界、并采用前向 KL / 交叉熵这类能识别算术均值的评分规则,支撑论文关于 Bayes 解可识别性的论述。没有数据锚点时,处处输出同一个分布也能满足自一致性。[Definition 3.2–3.3、Proposition 3.4,p. 4;Appendix E.2,pp. 19–20] 这套结论针对 per-token posterior marginal。把这些边缘相乘,一般得不到真实联合后验 $p(\mathbf x_0\mid\mathbf x_t)$。例如,假设真实二 token 序列仅为 训练先抽取 $\mathbf x_0\sim p_{\rm data}$,再生成 $\mathbf x_t$,最后通过 oracle bridge 抽取 $\mathbf x_s$。这样的样本对具有正确的真实联合边缘分布 $p(\mathbf x_t,\mathbf x_s)$,因此训练时不需要显式计算未知的 $p(\mathbf x_0\mid\mathbf x_t)$。 将目标网络加上停止梯度,Eq. (6) 的实际含义为 M-CDLM 使用 Jensen–Shannon 散度(JSD): 目标网络使用 EMA 更新:$\tilde\theta\leftarrow\lambda\tilde\theta+(1-\lambda)\theta$。停止梯度让在线网络追踪相对稳定的目标,避免两边同时改变而过早达成无信息的一致。[Sec. 3.1–3.2,pp. 4–5;Algorithm 2,p. 14] 稳定化设计有三部分: 总目标为 这是 Eq. (7) 按位置展开后的写法。实现可以通过混合抽样 max-step 任务得到相同的期望目标。[p. 5;Appendix B,p. 12] 理想 Eq. (5) 把期望放在散度内部;实际 Eq. (6) 对每次抽到的目标计算散度,再平均。设较脏状态处的在线预测为 $Q$,较干净状态的随机目标为 $P$,两者分别对应 正确抽取 bridge 样本保证 $P$ 的条件平均正确,但不能对任意非线性散度直接交换期望与散度。对于固定的目标分布、且方向为 目标到预测 的前向 KL,有 第一项与 $Q$ 无关,因此最优 $Q$ 是算术均值 $\bar P$;JSD 通常不具备同样的均值识别性质。原文 Appendix C 明确把 excess-risk 推导放在理想化的前向 KL 情形,实际算法则使用 JSD。[pp. 14–15] 一个用于理解差异的自构例子:随机目标以 $0.9$ 概率为 $(1,0)$,以 $0.1$ 概率为 $(0,1)$。前向 KL 的最优预测是 $(0.9,0.1)$;最小化期望 JSD 的最优第一维概率约为 $0.998$。这个简单例子说明,JSD 的训练稳定性不能自动解释为后验概率的无偏估计。 因此应把本文的理论理解为“真实反向链上的理想一致性结构”,把 JSD 配方理解为有消融支持的实用优化选择。类似地,max-step 任务要在前向 KL / 交叉熵和相应时间权重下才严格恢复 MDLM 的 NELBO;仅把 JSD 配方的 $\kappa_{\rm ms}$ 设为 1,并不能据此认定目标与 MDLM 完全相同。[Proposition D.1,pp. 15–16] 以下是按原文整理的教学伪代码,突出数据锚点与桥的作用: 推理时没有真实 $\mathbf x_0$。模型先输出干净 token 概率,再用已有的祖先采样规则构造下一时刻。对于 masked 情形,一个尚被遮盖的位置可写为 已显露 token 保留不变。每次网络读取当前整条序列,下一轮利用新增的上下文继续预测。CDLM 改变的是训练目标,推理兼容既有采样器;训练间隔 $\delta$ 与推理总步数是不同的超参数。[Sec. 3.1 Sampling,p. 5;masked 公式由 Algorithm 2 的桥代入预测边缘得到] 这里的“无教师”准确含义是不需要预先训练好的独立教师模型,训练中仍有作为监督目标的 EMA / 硬更新网络。 附录 C 在真实反向链上考虑网格 $1=\tau_K>\cdots>\tau_0=0$。若每条相邻边对条件期望目标的平均总变差距离(TV)不超过 $\varepsilon$,则 证明使用真实反向链的组合性、TV 的三角不等式与凸性,递推得到 $\mathcal E(k,m)\le\varepsilon+\mathcal E(k-1,m)$。前向 KL 的 excess-risk 分解再给出 这里需要各局部边有相应的统一风险控制。界控制的是真实反向链下预测的跟踪误差;推理使用的是学习出的采样转移,因而还需要额外分析才能把它转化为整个生成联合分布的误差界。[Lemma C.1、Remark C.2,pp. 12–15] 来源:Sec. 3.3,pp. 5–6;Appendix D,pp. 15–18。正文对 DUO-DCD 耦合与低熵的联系使用假设性表述,附录 D.5 的措辞更强。本文将其视为机制解释假说;实验没有单独控制 coupling、散度与 greedy sampler 来识别这条因果链。 主体模型为约 110M 参数的 Transformer,在 OpenWebText 训练 150K 步,全局 batch size 为 2048;附录报告典型训练使用 64–256 张 A100。基线大体统一模型规模、数据和更新步数,蒸馏路线按预训练加蒸馏分配 150K 步。AR 训练 75K 步,作者称这样匹配其统计的已见 token 数。相同更新步数不代表相同 FLOPs:CDLM 有目标前向计算,蒸馏方法还有教师 rollout。[Sec. 4.2,pp. 6–7;Appendix F.1,p. 20] 原文给出了步长范围,但算法伪代码对时间 $t$ 的采样、边界约束等细节较简略;复现时必须保证 $s=t-\delta\ge0$,不能直接把独立抽取的任意 $t,\delta$ 生硬相减。 MDLM 是 masked 扩散的标准单阶段 NELBO 基线;UDLM 是 uniform 扩散基线;DUO 使用连续 Gaussian 与离散类别之间的联系改进 uniform 路线。SDTT 在 MDLM 预训练后进行自蒸馏;DUO-DCD 在 DUO 基础上进行一致性蒸馏,同时报告祖先与 greedy 采样。把单阶段 CDLM 和蒸馏路线分开比较,才能看清“没有独立预训练教师”的意义。[Sec. 4.1,p. 6] 协议与指标来源:Sec. 4.3,pp. 7–8;Appendix F.2–F.3,pp. 20–21。评价样本只有 32 条,表格未配置信区间,因而较小差值不宜作过强排序解释。 下表摘取原文 Table 1,全部使用 FP64 祖先采样;单元格为 PPL↓ / 熵。 Table 1,p. 7。前三行是 150K 步单阶段训练,后两行是 100K + 50K。 基础 MCDLM 已在所有列优于 MDLM;64 步的两者熵均为 5.6,PPL 从 124.4 降到 67.7。这说明改进并不全部依赖 PPL 优化变体降低多样性。PPL 优化变体进一步降低了 PPL,例如 16 步相对 MDLM 从 297.1 到 71.6,降低约 75.9%,但熵也从 5.6 降至 5.3。 单阶段 PPL 优化变体与 SDTT 在少步区间接近或略优,64 步相同;到 1024 步,SDTT 的 PPL 31.2 优于其 33.8。因此“可与蒸馏竞争”成立,“所有预算都胜过蒸馏”不成立。以 MCDLM 作为 SDTT 起点又能继续改进,支持一致性预训练与后续蒸馏互补。[Sec. 4.3,p. 7] 作者报告相对 MDLM 的 64×–128× 加速、相对 AR 的 16×–32× NFE 减少,并明确没有报告 wall-clock latency。用主表中容易定位的具体点来看: 来源:Table 1,p. 7;Table 7,p. 20。主表可直接展示上述 64× 与 16× 对应点,但没有给出一个同样清晰的 128×、同等质量阈值对照。实际服务延迟还取决于每轮全序列计算、AR 的 KV cache、batch 和硬件;报告的 NFE 比例不能直接作为部署吞吐倍数。 下表摘取 Table 2,FP64;“祖先”与“greedy”各按同类采样器比较。 Table 2,p. 8。UCDLM 的祖先采样在所有报告步数都优于 UDLM 和 DUO,但相对 DUO + DCD 并非每列都胜:64 步为 81.0 对 80.2。这与 Sec. 4.3 “无论采样器都严格更优”的概括存在一个表格例外,阅读时应以具体数值为准。 Greedy UCDLM 在表内各步数的 PPL 均低于 greedy DUO-DCD;不过 4 步 UCDLM 的熵也只有 4.8,仍触发作者的低熵提示。DUO-DCD 的 3.9 更低,因此不能只用其 118.4 的低 PPL 判断语言生成质量。 以下摘取 64 步结果,FP64;单元格为 PPL↓ / BLEU2↑。 Table 3,p. 8。CDLM 相对 SDTT 在四个数据集、8/64/512 三种步数下均有更低 PPL 与更高 BLEU2。以 PTB 64 步为例,PPL 降低约 14.3%,BLEU2 增加 0.9 分;这是相对百分比与分数差的两种口径。 DUO-DCD greedy 在该恢复协议下常出现低 BLEU2:例如 PTB 64 步的 PPL 为 45.0,看似很好,BLEU2 却仅 19.3,远低于 CDLM 的 53.3。这说明流畅性与保留输入内容是不同目标。作者将其归因于 uniform 过程允许任意替换 token;实验支持的是当前条件注入和采样设置下的失配,不能据此断言所有 uniform 模型都无法通过固定条件位置等设计完成条件生成。[Sec. 4.3.1,p. 8] 步长调度。 Table 4 的结果如下,单元格为 PPL / 熵: Table 4,p. 9。线性递减相对线性递增在 8、64 步更好,线性递增在 1024 步 PPL 更低但熵降至 4.9。随机调度的 8 步 PPL 仍略好于线性递减,因此结论是调度改变预算偏好,没有一个调度在全部指标上支配其他配置。 数据锚点。 消融清楚展示了仅看 PPL 会得出错误选择: Table 5,p. 9。去掉锚点后 PPL 极低,熵却严重下降;增加干净监督能阻止这种自一致性捷径。过高权重又减少了跨噪声预测匹配的比重,生成 PPL 上升。这既呼应可识别性动机,也说明实际超参数在质量与多样性之间调节。 散度。 Table 6 给出的 64 步结果为: Table 6,p. 9。前向 KL 的均值识别性质没有消除从零训练的优化难度;反向 KL 在 8 步的 PPL 75.3 虽低于 JSD 的 110.6,熵仅 4.6。选择 JSD 的证据来自这类联合比较,不能简化成“理论最优散度”。原文消融页没有明确给出全部独立训练预算和采样精度,不将这些值直接并入 Table 1 的严格同配置排序。 FP32。 Table 7 保持 CDLM 优于 MDLM 的主趋势,但绝对 PPL 与 FP64 可以差很多:MDLM 1024 步由 FP64 的 97.7 变为 FP32 的 42.4,PPL 优化变体由 33.8 变为 17.1。原文没有进一步隔离这一精度差异的来源,因此不可把两种精度拼成一条质量—步数曲线。[Table 1,p. 7;Table 7,p. 20] MAUVE。 OpenWebText、Lambada、WikiText-103 的数值大多在 0.90–0.99,区分度有限;但 PTB 不属于“高分饱和”:8 步时 MDLM / SDTT / CDLM 分别为 0.11 / 0.07 / 0.02,64 步分别为 0.12 / 0.08 / 0.07。因此 PPL、BLEU2 的优势没有在 PTB MAUVE 上转化为领先,分布匹配这一维度应单独保留。[Table 8,p. 21] 定性样例。 附录分别给出 4、64、512 步的单条输出,并截断到 1000 字符。4 步 CDLM 仍有明显断裂、重复和语义不连贯;64 步出现更完整的新闻式段落;512 步仍可能围绕同一主题反复改写、缺少实质信息。这些样例与“更多步数有助于结构形成”相容,也提醒低生成 PPL 并不直接代表事实准确或可用于对话的文本质量。[Appendix F.4,pp. 21–24] CDLM 最有价值的贡献,是把已知随机过程的解析后验变成可直接训练的跨噪声监督。它给离散扩散提供了一种单阶段少步训练路线,而且基础 MCDLM、PPL 优化变体、uniform 扩展和再次蒸馏的结果形成了相互补充的证据。 对方法设计的启发有三点。第一,随机路径上的一致性应从条件期望理解,不能直接照搬连续 ODE 的逐样本不变性。第二,任何自监督一致性都需要有信息的边界或锚点,否则“所有输入都答一样”也会是容易实现的解。第三,统计目标与可优化目标之间有实际张力:前向 KL 的干净理论与 JSD 的稳定训练各有作用,不能相互替代。 最影响结论外推的条件是当前的 110M 模型、32 条生成样本、外部 PPL 评价和 NFE 口径。面向更大模型或实际服务,值得优先回答:在更多样本和训练重复下收益是否稳定;能否设计同时识别正确均值并保持稳定的目标;在匹配文本质量与多样性后,加入 KV cache 的真实延迟和总训练成本怎样变化。对于条件生成,还应在固定条件位置的对齐协议下重新比较 masked 与 uniform 路线。 这篇论文适合被理解为一个有数学结构、也有明确工程取舍的训练框架:解析桥降低了获取跨步监督的成本,而少步文本质量最终由边缘建模能力、稳定化配方、采样方式及评价标准共同决定。[MASK]。后验桥尤其简单:[MASK] 坐 [MASK]”。桥会独立地以 $0.5$ 概率恢复每个被遮盖的位置,可能得到“猫 坐 [MASK]”“[MASK] 坐 垫”等。这些较干净状态都来自同一条真实文本,但模型在较脏输入处需要学习的是对这些随机目标的统计预测。2.3 MPDC 的对象是每个位置的后验边缘
AA 或 BB,各占一半:从全 mask 出发,每个位置的正确边缘都是 $A/B$ 各半;独立一步采样却会给 AB 和 BA 总计一半概率。多轮去噪允许后续预测利用已生成的 token,逐渐建立跨位置关系。这是本文定位少步生成的关键原因。[教学解释;对应 Sec. 3.1,p. 4 与 Sec. 5,p. 9]2.4 实际训练:桥样本、JSD、目标网络与数据锚点
2.5 “目标样本无偏”与“损失无偏”需要分开
2.6 训练与推理怎样衔接
初始化在线网络 θ 与目标网络 θ̃
循环训练:
    从数据集取干净序列 x0
    按调度选择有效时间对 0 ≤ s < t ≤ 1
    以 κ_ms 的权重采用 s = 0 的 max-step 任务
    xt ~ q(xt | x0)
    xs ~ q(xs | xt, x0)
    在线预测 Q = fθ(xt, t)
    目标 P = x0(s=0);否则为 stop_gradient(fθ̃(xs, s))
    在规定位置计算加权散度,更新 θ
按 EMA 或变体规定的硬更新策略更新 θ̃2.7 局部误差如何累积,统一视角有多强
相关路线 与 CDLM 的关系 解读强度 MDLM $s=0$、前向 KL / CE、$-\alpha'_t/(1-\alpha_t)$ 权重;线性 masking 时为 $1/t$ 明确条件下的目标等价 连续一致性模型 把确定性 ODE coupling 换成随机 bridge coupling 训练结构的随机对应;小时间间隔本身不会把类别空间变成连续 ODE Progressive Distillation / Shortcut Models 大步与小步组合相容;CDLM 的已知桥可解析边缘化中间状态 组合约束上的联系,不意味着不同领域的目标逐项相同 SDTT 以教师预测与 rollout 近似真实数据诱导的 coupling 理想教师极限下的联系 DUO-DCD 共享连续潜噪声后投影为离散状态,产生不同的时间 coupling 描述了耦合结构差异,尚不足以单独证明低熵的因果来源 三:实验——预算、比较对象与指标
3.1 基本设置与各变体
变体 调度与训练配置 目的 MCDLM $\delta$ 随机抽取范围 $[1/8,5/8]$;$\kappa_{\rm ms}=0.4$;EMA $\lambda=0.999$ 基础 masked CDLM MCDLM–PPLOptimized 前 100K 步同上;后期将步长上界逐渐缩至 $3/8$,锚点权重降至 0.2;100K 起改为每 10K 步硬更新目标 用一定熵损失换更低生成 PPL UCDLM uniform 腐化;步长从 0.125 线性增加至 0.375,其余配置按文中说明对齐 检验方法能否超出 masked 核 MCDLM + SDTT 100K 步 MCDLM 基础训练 + 50K 步蒸馏 检验 CDLM 能否作为更好的教师起点 3.2 baseline 的比较角色
3.3 评价任务与指标
gpt2-large 计算生成困惑度 PPL,越低越好。它评价外部模型对生成文本的可预测性,重复文本也可能获得很低的值。四:结果——改进在哪里,代价是什么
4.1 Masked 无条件生成:标准模型与 PPL 优化变体均有效
模型 8 步 16 步 64 步 1024 步 MDLM 682.7 / 5.9 297.1 / 5.6 124.4 / 5.6 97.7 / 5.6 MCDLM 246.9 / 5.6 125.6 / 5.4 67.7 / 5.6 53.4 / 5.5 MCDLM–PPLOptimized 132.1 / 5.2 71.6 / 5.3 40.1 / 5.3 33.8 / 5.4 MDLM + SDTT 134.0 / 5.3 76.0 / 5.4 40.1 / 5.3 31.2 / 5.4 MCDLM + SDTT 105.0 / 5.3 57.5 / 5.1 35.3 / 5.3 27.1 / 5.2 4.2 加速结论应怎样读
对照 CDLM 对应点 能直接读出的结论 FP64 MDLM:1024 步,97.7 / 5.6 PPL 优化变体:16 步,71.6 / 5.3 PPL 更低,NFE 为 1/64,熵也较低 FP64 AR:1024 NFE,40.2 / 5.6 PPL 优化变体:64 步,40.1 / 5.3 近似匹配生成 PPL,NFE 为 1/16 FP32 AR:1024 NFE,39.9 / 5.4 PPL 优化变体:32 步,42.4 / 5.3;64 步,35.1 / 5.2 32–64 步区间达到接近或更低 PPL,存在熵差异 4.3 Uniform 扩散:收益并不限于 mask
模型 4 步 PPL / 熵 64 步 PPL / 熵 1024 步 PPL / 熵 UDLM,祖先 516.6 / 5.5 87.6 / 5.6 84.0 / 5.4 DUO,祖先 514.4 / 5.6 85.1 / 5.4 85.4 / 5.6 UCDLM,祖先 377.3 / 5.2 81.0 / 5.5 71.7 / 5.3 DUO + DCD,祖先 408.3 / 5.6 80.2 / 5.5 75.6 / 5.5 UCDLM,greedy 110.4 / 4.8 64.7 / 5.5 57.0 / 5.2 DUO + DCD,greedy 118.4 / 3.9 65.5 / 5.4 58.5 / 5.1 4.4 条件恢复:域内与三个域外数据集
模型 OpenWebText Lambada WikiText-103 PTB MDLM 40.4 / 61.1 62.9 / 57.7 39.6 / 62.2 220.0 / 50.7 SDTT 30.8 / 62.5 46.4 / 59.3 30.5 / 63.7 125.4 / 52.4 MCDLM–PPLOptimized 28.6 / 62.9 38.8 / 60.1 27.3 / 64.4 107.5 / 53.3 4.5 消融:哪些设计决定质量与多样性
调度 8 步 64 步 1024 步 随机 110.6 / 5.3 32.8 / 5.3 19.7 / 5.2 分阶段递增 160.8 / 5.2 45.1 / 5.3 25.3 / 5.2 线性递增 117.6 / 5.5 37.9 / 5.4 17.9 / 4.9 线性递减 112.3 / 5.1 32.1 / 5.2 20.5 / 5.2 $\kappa_{\rm ms}$ 8 步 PPL / 熵 64 步 PPL / 熵 1024 步 PPL / 熵 0 16.7 / 3.2 7.1 / 3.4 5.7 / 2.8 0.4 110.6 / 5.3 32.8 / 5.3 19.7 / 5.2 1.0 274.0 / 5.5 75.1 / 5.5 38.4 / 5.3 散度 PPL↓ 熵 对训练行为的解释 JSD 32.8 5.3 此配置下兼顾稳定与多样性 前向 KL:$\operatorname{KL}(P_{\rm target}\Vert Q_{\rm online})$ 约 80,000 6.9 作者解释为向无信息分布漂移 反向 KL:$\operatorname{KL}(Q_{\rm online}\Vert P_{\rm target})$ 64.0 4.4 寻模倾向强、生成多样性不足 4.6 补充实验:数值精度、MAUVE 与实际文本
五:结论——最值得带走的思想与后续问题