Preconditioned DeltaNet:中文精读笔记
原题:Preconditioned DeltaNet: Curvature-aware Sequence Modeling for Linear Recurrences
作者:Neehal Tumma、Noel Loo(共同一作)、Daniela Rus;MIT / Liquid AI。
版本:arXiv:2604.21100v1,提交于 2026-04-22;本次获取与研读:2026-09-22;研读修订 r1。
材料:arXiv · 本地原文 PDF · 作者 TeX · 英文幻灯片。
阅读依据为同版本的 40 页 PDF 与成功下载的作者 TeX,按 main.tex 实际引用顺序阅读正文 1–6 节、附录 A–G,重点核对理论、并行算法和实验附录。源码文件名的字母与最终附录编号不完全对应,例如 B_theory.tex 实际为附录 C、D_chunkwise_forms.tex 实际为附录 F。下文页码均为从 1 开始的 PDF 页码。原图直接复用作者 PDF 图件并转成 PNG,已与论文排版核对;没有重绘实验数据。未运行作者代码、重新训练模型或逐篇阅读参考文献。
论文总览
核心问题:DeltaNet 用误差驱动的写入更新关联记忆,但通常让读 key 与写 key 相同,没有显式根据历史 key 的各向异性调整更新方向。能否吸收最小二乘问题中的曲率信息,同时保留高效分块计算?
论文先说明:在精确逆 Gram 预条件下,把线性注意力的 query 乘上逆 Gram(ATQ),与把 DeltaNet 的写 key 做特定预条件(ATK),会得到同一个岭回归解。随后放弃昂贵的精确逆,维护 key 平方的逐维衰减统计,并把它转换为有界的写 key 缩放,形成 PDN、PGDN、PKDA。
最可信的实证结论:相对各自匹配的基础递推,所报告的五组模型对的常识任务平均准确率和真实 ICR 平均准确率均上升;代价是作者 profiling 中 PGDN/PKDA 约 10% 的训练效率开销。最强长上下文改善出现在部分 PGDN 配置;不能概括为所有模型、任务、长度都改善。该工作证明了一个有用的结构设计方向,而非证明实用模型精确求解回归或普遍优于其他架构。
结构地图
| 原文章节 | 作用 | PDF 页码与证据 |
|---|---|---|
| 1 Introduction | 动机和贡献 | 1–2 |
| 2 Background and preliminaries;2.1–2.3 | LA、DeltaNet 分块形式与 TTR | 2–3,式 (1)–(2) |
| 3 Preconditioning linear recurrences;3.1 | 精确 ATQ/ATK 等价 | 3,定理 3.1,式 (3)–(5) |
| 3.2 Preconditioned chunkwise parallel forms | 两个 key 的并行更新 | 3–4,式 (6) |
| 3.3 Approximating the key Gram | 对角近似与非等价性 | 4–5,式 (7)–(8),图 1 |
| 3.4 Generalizing to recurrences with decay | PGDN、PKDA、理论比较 | 5,定理 3.2 |
| 3.5 Improving the trainability of the preconditioner | 实际有界参数化 | 5–6,式 (9),图 2 |
| 4 Empirical study;4.1–4.2 | 吞吐与网络结构 | 6–7,图 3–4 |
| 4.3 Experimental results | MQAR、语言建模、ICR、动力学 | 7–8,表 1、图 5–7 |
| 5 The DGPS taxonomy;6 Conclusion | 设计空间和总结 | 8–9,表 2 |
| A Related work;B The DGPS taxonomy continued | 背景、分类框架比较 | 14–17 |
| C Additional theory and discussion | 等价证明、反例、误差比较 | 18–21 |
| D Algorithm and implementation details | 前后向伪代码及 DPLR 交互数 | 21–24,图 8–9、表 3 |
| E Experimental setup and additional results | 配置、完整结果、消融与训练失败 | 25–33,表 4–7、图 10–16 |
| F Deriving the chunkwise parallel forms | 预条件统计与主递推的分块推导 | 33–37 |
| G Deriving recurrences using the preconditioned OCP framework | proximal 目标推导 | 38–40,表 8 |
一:动机——给状态更新加入 key 空间的几何信息
线性注意力维护固定大小记忆,省去随序列长度增长的完整 KV 缓存,但多个 key 共享状态会产生干扰。基础线性注意力直接累加 $v_tk_t^\top$;DeltaNet 改为先预测已有值,再写入残差:
$$S_t=S_{t-1}+\beta_t(v_t-S_{t-1}k_t)k_t^\top.$$这可以解释为对当前样本损失 $L_t(S)=\frac12\|Sk_t-v_t\|_2^2$ 做一步梯度下降。问题在于同一个标量 $\beta_t$ 无法区分 key 各坐标方向的历史尺度。已有 GDN/KDA 增强了状态衰减的控制,本文则改变残差被写入的方向。
作者把设计目标放在两个端点之间:忽略曲率的快速 delta rule,与维护完整二阶信息的回归求解。Mesalayer 的直接逆空间递推有顺序依赖;MesaNet 用共轭梯度近似求解,作者自己的训练配置出现不稳定。这里应把后者理解为论文中的观察及可能解释,而不是对所有 MesaNet 实现的普遍判断。(Sec. 1;App. C.4、E.5,pp. 1–2、19、31。)
二:方法——从精确回归走向可训练递推
2.1 符号、目标和“测试时”含义
| 符号 | 维度/意义 |
|---|---|
| $k_t,q_t$ | $\mathbb R^{d_k}$,读 key 与 query |
| $v_t,o_t$ | $\mathbb R^{d_v}$,value 与输出 |
| $S_t$ | $\mathbb R^{d_v\times d_k}$,从 key 到 value 的记忆映射 |
| $G_t,P_t$ | $d_k\times d_k$,正则化 Gram 及其逆 |
| $C_t$ | $d_v\times d_k$,value–key 交叉统计;不要与块长 $C$ 混淆 |
| $A_t,B_t$ | 实际实现中为 $d_k$ 维向量,分别存储二阶统计与逐维缩放 |
| $\alpha_t,\beta_t$ | 主状态衰减与残差写入强度 |
| $\alpha_t^P,\beta_t^P$ | 预条件统计专用门控,与主递推门控分开学习 |
TTR 的回归发生在模型前向过程中,更新的是序列内状态 $S_t$;外层网络参数仍由语言建模训练优化,不能把两者混为同一个优化器。
原文式 (1)–(2),p. 2:
$$\min_S\frac12\sum_{i=1}^t\|Sk_i-v_i\|_2^2+\frac\lambda2\|S\|_F^2,$$$$G_t=\lambda I+\sum_{i\le t}k_ik_i^\top,\quad C_t=\sum_{i\le t}v_ik_i^\top,\quad S_t^\star=C_tG_t^{-1}.$$取 $\lambda>0$ 可保证这里的逆存在。Gram 衡量 key 在各方向积累的信息以及方向间相关性;预条件针对的是这个回归几何,而非直接计算整个语言模型训练损失的 Hessian。
2.2 精确预条件:ATQ 与 ATK 为什么相等?
ATQ(apply-to-query):先累积 $C_t=C_{t-1}+v_tk_t^\top$,读出时使用 $\tilde q_t=P_tq_t$,于是 $o_t=C_t\tilde q_t=S_t^\star q_t$。
ATK(apply-to-key):保持预测误差里的读 key 为 $k_t$,只替换外积右侧的写 key:
$$\tilde k_t=\frac{P_{t-1}k_t}{1+k_t^\top P_{t-1}k_t},\qquad S_t=S_{t-1}+(v_t-S_{t-1}k_t)\tilde k_t^\top.$$这里是精确回归版本,没有额外任意学习的 $\beta_t$。Sherman–Morrison 给出
$$P_t=P_{t-1}-\frac{P_{t-1}k_tk_t^\top P_{t-1}}{1+k_t^\top P_{t-1}k_t},$$将其代入 $(C_{t-1}+v_tk_t^\top)P_t$,利用归纳假设 $S_{t-1}=C_{t-1}P_{t-1}$,即可得到 ATK 更新。初始化 $S_0=0,P_0=\lambda^{-1}I$,故每一步输出都相等。精确情形还满足 $\tilde k_t=P_tk_t$。(定理 3.1、式 (3)–(5),p. 3;App. C.1,p. 18。)
“offline solve”在此表示利用前缀充分统计进行批式求解,不表示看到了未来 token。两种读出仍然因果。
2.3 对角近似的好处及失去的性质
最简单的统计为
$$A_t=A_{t-1}+k_t\odot k_t.$$它只保留 Gram 的对角,所需附加状态从 $O(d_k^2)$ 减为 $O(d_k)$,更新可以用逐元素前缀和实现;这不改变主状态 $S_t$ 的 $O(d_vd_k)$ 大小。注意 $(\operatorname{diag}G)^{-1}$ 一般不等于 $\operatorname{diag}(G^{-1})$。
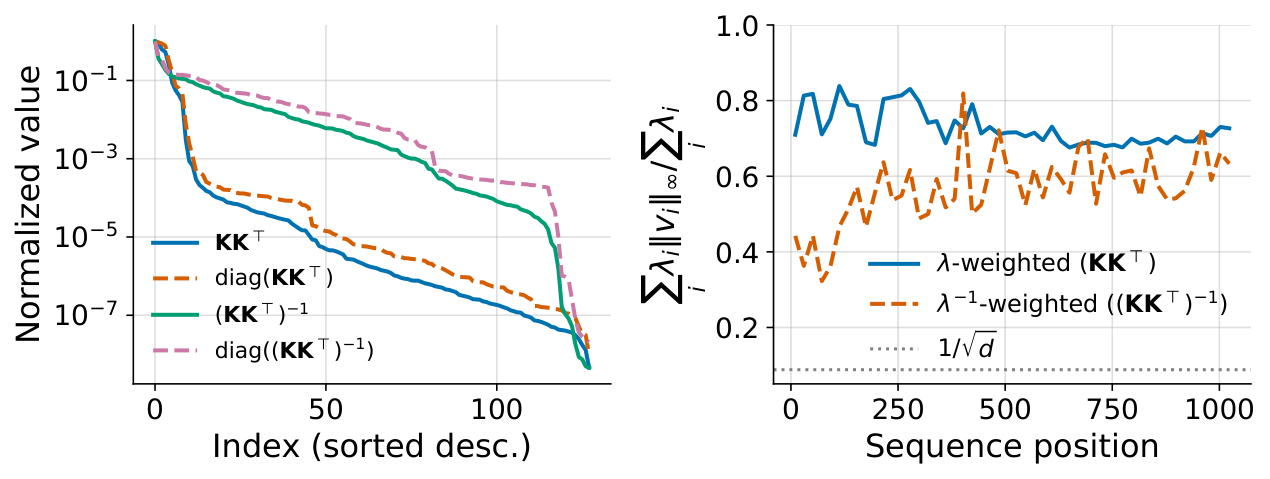
原图 1,p. 4。左图横轴是排序后的谱索引,纵轴采用对数尺度,比较完整与对角化统计的谱形态;右图沿序列位置观察特征值加权的特征向量 $\ell_\infty$ 指标,越接近 1 越偏向坐标轴。作者在一个预训练 DeltaNet-340M 的选定层看到谱相关、相当程度的轴对齐,为对角近似提供经验动机,但没有证明跨模型、跨层都充分准确。
近似后等价定理失效。App. C.2(p. 19)给出的反例:$\lambda=1$,$k_1=v_1=(1,1)^\top$,对角 ATQ 得到 $S_1=\frac12\mathbf1\mathbf1^\top$,使用前一步对角逆及 Sherman–Morrison 归一化的 ATK 得到 $\frac13\mathbf1\mathbf1^\top$。准确说法是“一般不再等价”,并非任意数据下都不相等。
2.4 真正用于训练的式 (9)
简单取倒数仍有尺度、尾部及训练问题,最终模型改为:
$$A_t=\alpha_t^P A_{t-1}+\beta_t^P(k_t\odot k_t),$$$$r_t=\log A_t-\mu,\quad s_t=r_t\oslash(\mathbf1+|r_t|),$$$$B_t=\exp[-\log(x)s_t],\quad \tilde k_t=B_t\odot k_t,$$$$S_t=S_{t-1}+\beta_t(v_t-S_{t-1}k_t)\tilde k_t^\top,\qquad o_t=S_tq_t.$$其中 $\mu>0$ 是每 head 的可学习中心,附录用 $\exp(\text{logAScale})$ 参数化;$x=1.5$,故每个坐标的缩放位于 $[2/3,3/2]$。先在 log 空间居中,softsign 压缩到 $(-1,1)$,再指数映射为正的有界缩放。较大的历史统计对应较小的缩放,保留倒数的单调性。
三个关键改变:使用当前 $A_t$;取消精确公式中的标量归一化;用有界函数代替显式倒数。因此 实际 PDN 是回归理论启发的可训练近似,不能直接调用精确求解保证。正文没有完整规定实现中的 $\log 0$ 防护/数值下限;复现时须核实代码,而非假定式 (9) 就是完整稳定实现。
教学例子(非实验):设 $\mu=\log4,x=1.5,A_t=(16,1)$,则 $r_t=(\log4,-\log4)$,得到约 $B_t=(0.790,1.266)$。同样的残差在第一坐标写得较少、第二坐标写得较多,而残差本身仍通过原 $k_t$ 计算。把两个 key 都替换会改变方法。
2.5 加入遗忘:PGDN 与 PKDA
令 $\bar S_t=S_{t-1}D_t$:PDN 取 $D_t=I$,PGDN 取 $D_t=\alpha_tI$,PKDA 取 $D_t=\operatorname{Diag}(\boldsymbol\alpha_t)$,则统一写为
$$S_t=\bar S_t+\beta_t(v_t-\bar S_tk_t)\tilde k_t^\top.$$这里把正文对向量 decay 的简写按 $S\in\mathbb R^{d_v\times d_k}$ 展开为右乘,避免维度混淆。主状态衰减与统计衰减可以有不同时间尺度;两组门控不绑定,消融支持这个选择。
逐 token 推理保持两个状态 $A_t,S_t$,接收当前 $q,k,v$ 和门控后先算预条件,再写状态、读出输出。训练用代数等价的分块形式及外层反向传播。固定 head 维度下,递推的序列复杂度为线性,本文没有声称记忆容量随序列无限增长。
2.6 为什么两个 key 仍能高效并行?
省略块下标,令 $Q,K,\tilde K\in\mathbb R^{C\times d_k}$、$V\in\mathbb R^{C\times d_v}$,$M$ 为含对角的因果 mask:
$$T=\left[I+\operatorname{tril}(\operatorname{Diag}(\beta)K\tilde K^\top,-1)\right]^{-1}\operatorname{Diag}(\beta),$$$$W=TK,\quad U=TV,\quad R=U-WS_{\mathrm{in}}^\top,$$$$S_{\mathrm{out}}=S_{\mathrm{in}}+R^\top\tilde K,$$$$O=QS_{\mathrm{in}}^\top+[(Q\tilde K^\top)\odot M]R.$$这是无 decay 版本,来自式 (6)、App. F.2.1(pp. 4、35–36)。核心是原 $KK^\top$ 变为非对称 $K\tilde K^\top$;预测残差的 $W=TK$ 仍用读 key,写状态与局部输出用写 key。三角系统编码块内先前写入对当前预测的影响,实际通过三角求解/UT 变换处理,不应理解为调用通用稠密求逆。
统计递推也能分块:$A_{\mathrm{out}}=(\prod\alpha^P)A_{\mathrm{in}}+\sum_j(\prod_{l>j}\alpha_l^P)\beta_j^Pk_j^{\odot2}$。已知块边界后,可构造各 token 的 $A_t$,逐元素 squash 为 $B_t$。标量/对角主 decay 则加入对应累计乘积与因果权重。块内运算适合 GPU 矩阵乘,块边界仍需传播状态;“分块并行”不意味着消灭一切顺序依赖。
App. D 的前向伪代码新增 fused_atk_fwd,改非对称 key 交互,后向分别计算读/写 key 梯度,再通过 $\tilde k=k\odot B(A)$ 反传并合并。泛化 DPLR 通常需要四种块内交互,此处把擦除项右因子与写入项方向绑定,保留两种交互。这里 DPLR 模板的 $k$ 表示写入方向,与正文“读 key $k$”的符号角色不能机械混用。
2.7 两条理论结论应怎样阅读
DeltaNet 与 LA 的误差比较:定理 3.2(p. 5)的正文只突出 key/query 独立、均匀单位球假设。App. C.5(pp. 20–21)的证明进一步使用 $\lambda=0$、无噪声固定线性映射 $v_t=S^\star k_t$,以及 $\beta_t\in[0,1]$。在此条件下:
$$\mathbb E\|o_t^{LA}-o_t^\star\|^2=\frac{\|S^\star\|_F^2}{d}\left(1-\frac td+\frac{t(t-1)}{d^2}\right),$$$$\mathbb E\|o_t^{DN}-o_t^\star\|^2\le\frac{\|S^\star\|_F^2}{d}.$$当 $t\ge d+1$,前式括号至少为 1。这个比较针对未归一化 LA 与标准 DN 的特定回归设置,不能推出实际语言模型中 ATK 对所有 ATQ 方案普遍占优,也不是最终 squash 预条件的理论性能保证。
PGDN 的单步谱界:设 $\|k_t\|_2=1$,$\alpha_t,\beta_t\in[0,1]$。状态转移
$$T_t=\alpha_t(I-\beta_t k_t\tilde k_t^\top)$$的特征值为 $\alpha_t$(重数 $d_k-1$)和 $\alpha_t(1-\beta_t k_t^\top\tilde k_t)$。因为 $k_t^\top\tilde k_t\in[1/x,x]$,$\beta_tx\le2$ 足以令单步特征值模不超过 1;$x=1$ 退化为 GDN。(App. E.3,pp. 29–30。)
本次分析:这是单步特征值结论,不能仅由此推出任意时变、非正规矩阵乘积的范数稳定或全训练梯度稳定;该简单谱公式也不能直接套在 PKDA 的逐维 decay 上。负特征值“可表示”不代表“已学到”:附录 E.4、图 16 表明作者观察的 PGDN 没有学出负特征值。
2.8 DGPS 与 proximal 解释
DGPS 拆成四个设计维度:Decay(遗忘),Gain(写入强度),Preconditioner(key/query 变换),Solve(累积统计式/残差更新式)。TTR 解释回归含义,DPLR 解释高效计算结构,DGPS 试图连接二者。(Sec. 5、表 2,pp. 8–9;App. B。)
App. G(pp. 38–40)将 proximal 范数从 Frobenius 改成 $\|X\|_{P^{-1}}^2=\operatorname{tr}(XP^{-1}X^\top)$。固定 $P\succ0$、$e=v-\alpha S_{t-1}k$,最小化
$$\|S-\alpha S_{t-1}\|_{P^{-1}}^2-2\langle Sk,\beta e\rangle$$的一阶条件给出 $S=\alpha S_{t-1}+\beta e(Pk)^\top$,即 PGDN 形式。若数据项改成完整平方损失,则得到预条件 Longhorn 的归一化增益 $\beta/(1+\beta k^\top Pk)$。这些推导是形式解释;未评测的 P-Longhorn、PGLA 不能当作已验证成果。附录 G.3 的 key-preconditioned Mamba-2 与主文的 query-preconditioned P-Mamba-2 是不同形式。
三:实验——比较协议决定结论范围
3.1 训练与架构
| 项目 | 报告配置 |
|---|---|
| 数据与规模 | SlimPajama;340M 组训练 15B tokens;1B 组训练 50B tokens |
| 长度/批量 | 训练 context 2048;batch 0.5M tokens |
| 优化 | AdamW;峰值 $4\times10^{-4}$;初末 $4\times10^{-5}$;cosine;warmup 0.5B tokens |
| 正则/硬件 | weight decay 0.01,clip 1.0;8 H100 |
| 340M 架构 | 24 层、宽度 1024、8 heads、key/value head dim 128;SwiGLU |
| 配套模块 | 短卷积、SiLU、输出前 headwise RMSNorm;query/key 做 L2 归一化 |
| 参数差异 | KDA/PKDA 有 fused output gate,340M 组实际约 355M |
| 1B 架构差异 | 14 heads;GDN 宽 1792/head 128;KDA 宽 1680/head 120,以匹配参数规模 |
| 实现/评测 | FLA、flame;自定义 Triton;lm-evaluation-harness |
来源:Sec. 4.2–4.3,pp. 6–8;App. E.1,p. 25。1B 不包含 DN/PDN。额外参数来自两个 $DH$ 规模的投影及每 head 一个中心,即每层约 $2DH+H$;按 340M 配置计算 24 层约 393,408 个参数(本次计算,约 0.12%,不含未列出的实现细项),因此参数增加很小但非严格为零。
应在 DN→PDN、GDN→PGDN、KDA→PKDA 内比较。作者配置沿用 GDN 默认设置,跨家族的 gate、head dim、调参都不同,因此不宜据此宣称 GDN 或 KDA 架构本质上更优。
3.2 各实验在回答什么
- MQAR:小型两层 sequence mixer 与两层 channel mixer,改变长度或 KV 数量,检验关联记忆干扰;指标为准确率,越高越好。其余设置沿用 Zoology 默认值,论文没有在本处完整列出所有训练超参数。
- 语言建模/常识:LAMBADA 与 WikiText 的 perplexity 越低越好;八个常识准确率列越高越好,其中 ARC-C、HellaSwag 用 normalized accuracy。Avg 为八项准确率的算术平均,不包含 perplexity。
- 真实 ICR:FDA、SWDE、SQuAD、TQA、DROP,2K 输入;表中统一标作 accuracy,五项平均。没有逐项完整定义答案匹配细则,不应擅自把 SQuAD 列改写为 F1。
- RULER S-NIAH:三个单 needle 变体,长度 512、1K、2K、4K、8K。4K/8K 超过训练长度,检验外推;不代表整个 RULER 或真实长文推理能力。
- 效率:端到端训练吞吐与单算子前后向耗时分开;后者部分曲线明确排除了预条件统计计算,不能当成总成本。
四:结果——平均提升、长程边界与消融
4.1 效率:有开销,但专用结构比通用 DPLR 更合适
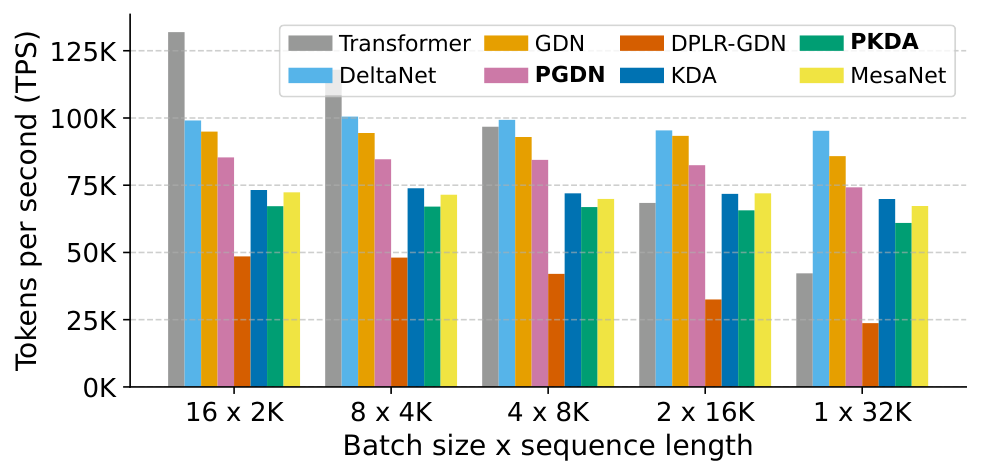
原图 3,p. 6。纵轴为训练 tokens/s,越高越好;横轴为 batch size × sequence length 的组合,使用 8 H100 DDP 和 340M 档模型。正文总结 PGDN/PKDA 相对对应基线有约 10% 开销,PGDN 比 MesaNet 快超过 20%。这是特定配置的 profiling,不能直接换算成任意硬件的解码加速。
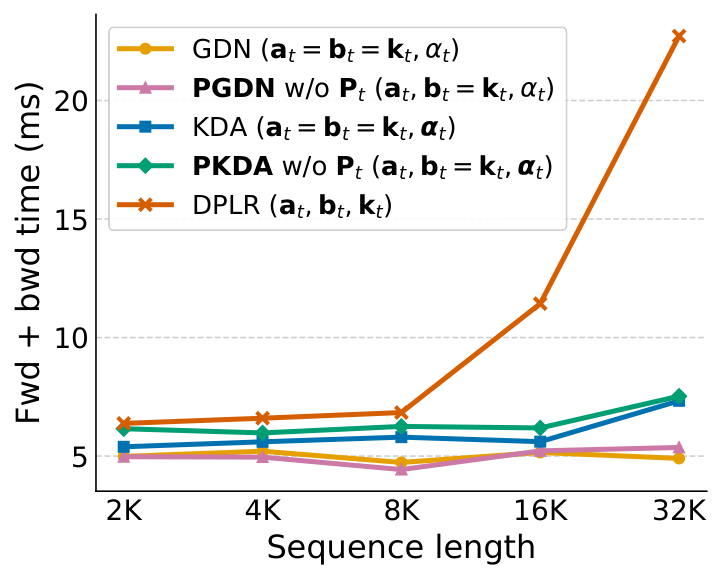
原图 4,p. 6。横轴长度,纵轴前向+反向毫秒数,越低越好;batch=1、8 heads、head dim=128。排除预条件统计后,双 key 专用内核几乎没有新增开销。通用 DPLR 的算子曲线明显更高;正文还报告 DPLR-KDA 在 32K 配置 OOM。应理解为“结构约束换来了实现效率”,不是“整个预条件流程免费”。
4.2 MQAR:预条件总体维持或改善关联召回
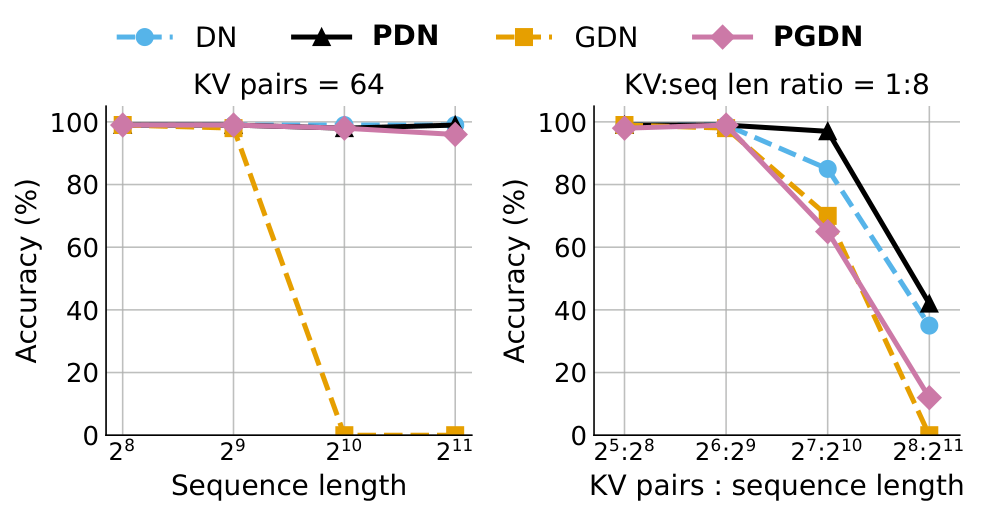
原图 5,p. 7。纵轴 accuracy (%);左图固定 KV=64,右图固定 KV:长度=1:8;比较 DN/PDN 和 GDN/PGDN。长序列、更多干扰时,预条件版本总体不差或更好,但右图负载持续增加后各模型都会退化。附录图 10(p. 26)固定长度 1024、改变 KV 数量,提供第三种切片。图中没有给出重复运行误差带;不从折线像素反推精确表格值。
4.3 主表:五组配对平均数均改善
以下摘录原表 1(p. 7),数值为“基线 → 预条件”;准确率差值以百分点计。
| 配对/规模 | LAMBADA ppl ↓ | WikiText ppl ↓ | 常识 Avg ↑ | ICR Avg ↑ |
|---|---|---|---|---|
| DN→PDN,340M | 45.76→43.05 | 29.04→29.05 | 47.41→47.96(+0.55) | 22.59→23.84(+1.25) |
| GDN→PGDN,340M | 31.39→28.43 | 27.08→26.86 | 48.86→49.96(+1.10) | 24.77→26.17(+1.40) |
| KDA→PKDA,355M | 31.37→25.33 | 26.18→25.98 | 49.12→49.89(+0.77) | 25.88→26.76(+0.88) |
| GDN→PGDN,1B | 13.46→13.09 | 18.05→18.01 | 55.44→56.38(+0.94) | 33.87→34.99(+1.12) |
| KDA→PKDA,1B | 14.52→11.86 | 17.95→17.82 | 55.43→56.64(+1.21) | 34.55→34.88(+0.33) |
例如 340M GDN 的 ICR +1.40 个百分点相当于约 5.65% 相对提升,而不是 +1.40% 相对提升。1B KDA 的 LAMBADA ppl 下降 2.66,约 18.32% 相对下降;这是 perplexity 的变化,不能称为准确率上升。
平均改善并不覆盖每个子项:340M DN 的 WikiText ppl 略差;340M PGDN 的 PIQA 65.83→64.83;1B PGDN 的 FDA 19.69→18.33;1B PKDA 的 FDA 23.23→21.69、SWDE 50.14→48.79。表中没有多训练种子方差或显著性检验,尤其 +0.33 点这类小差异不能自行宣称统计显著。
4.4 长上下文召回:最明显的是 PGDN,且仍有崩落
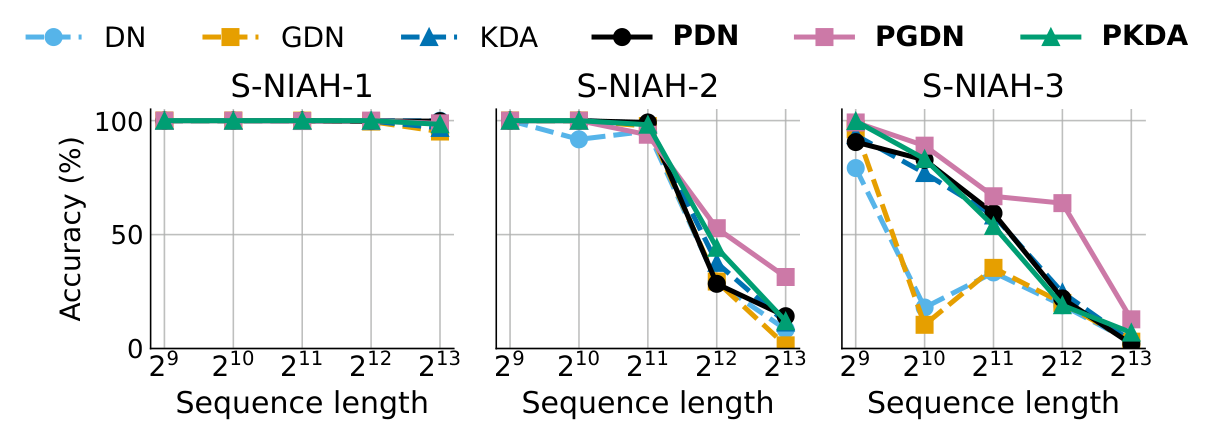
原图 6,p. 8。三个面板从 S-NIAH-1 到 -3,横轴长度、纵轴准确率;模型均在 2K 上训练。S-NIAH-1 基本饱和,不能很好区分方法;较难任务才暴露保持与外推差异。精确数值以表 5(p. 27)为准。
| S-NIAH-3 配置 | 基线 | 预条件 | 差值(百分点) |
|---|---|---|---|
| 340M GDN,1K | 10.4 | 89.0 | +78.6 |
| 340M GDN,2K | 35.4 | 66.8 | +31.4 |
| 340M GDN,4K | 20.0 | 63.8 | +43.8 |
| 340M GDN,8K | 3.0 | 12.8 | +9.8 |
| 355M KDA,2K | 58.4 | 53.8 | −4.6 |
| 355M KDA,4K | 24.6 | 19.0 | −5.6 |
| 1B GDN,2K | 60.4 | 76.8 | +16.4 |
| 1B GDN,4K | 64.2 | 63.8 | −0.4 |
| 1B KDA,1K | 98.0 | 92.4 | −5.6 |
| 1B KDA,8K | 5.4 | 8.8 | +3.4 |
此外,1B PGDN 在 S-NIAH-2 的 8K 从 24.8 降到 11.3。故正文“各设置改善”的宽泛措辞不能按逐模型逐长度理解。8K 的困难召回仍低,不能说解决了任意长上下文检索。对 GDN 的 1K 大幅异常差异,论文没有提供多 seed 排除偶然性,不宜据单点归纳一般规律。
4.5 动力学诊断:多了一个可调整的写方向因子
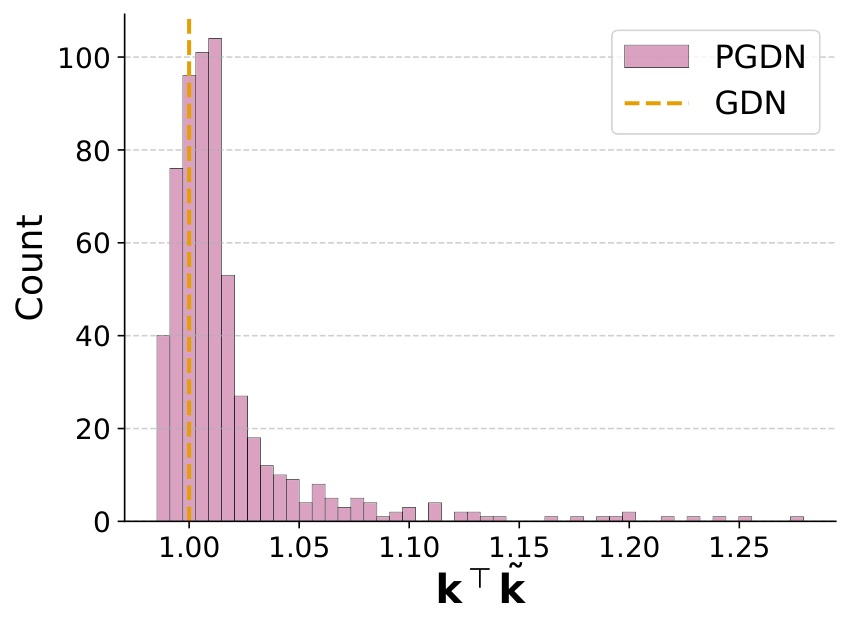
原图 7,p. 8。横轴 $k_t^\top\tilde k_t$,纵轴计数,分布按层聚合;标准归一化 GDN 对应 1,PGDN 偏离 1。它说明预条件确实改变了非平凡写特征值,而不是训练后完全退化为恒等变换。它提供机制线索,但不是“这种谱变化导致全部收益”的独立因果验证。
4.6 消融:有用的不只是近似倒数,而是可训练的参数化
原表 6(p. 27),340M / 15B tokens,training loss 越低越好:
| 方案 | Loss | 能支持的解释 |
|---|---|---|
| PGDN(最终版) | 2.511 | 本组最低 |
| GDN | 2.528 | 无预条件 |
| P-Mamba-2(ATQ) | 2.543 | 该具体 query 方案较差,不代表所有 ATQ |
| PGDN(unstable ATK) | 2.536 | 直接理论形式不自动提高训练效果 |
| PGDN(tied) | 2.518 | 独立统计门控有小幅收益 |
表 6 另列 GDN[-1,1] 为 5.520,源码和 PDF 均如此。该数值与邻列量级及其他评测表现显得异常,但无法确认是否笔误;本笔记不擅改为 2.520,也不把这个单值作为主要结论。
表 7(p. 30)比较最终 $B_t$ 的额外归一化:不归一化 2.511;除以 $k^\top B_tk$ 为 2.517;除以 $1+k^\top B_tk$ 为 2.521;乘 $\beta/(\alpha+\beta k^\top B_tk)$ 的对应设置为 2.524。支持在此参数化下去掉该归一化。图 11–14展示可学习中心、squash 饱和度、缩放分布和门控响应,属于解释性诊断,没有完整给出每种 $x$ 与 squash 选择的数值网格。
原文称 softsign 比 tanh “fast-moving”,但本次数学核对:$r/(1+|r|)$ 向 ±1 的饱和比 tanh 慢,更保守的解释是它让大输入较少过早饱和。不要把作者措辞当成已证明的优化速度优势。
4.7 负特征值对照与 MesaNet 训练失败
App. E.4、表 4–5 用基础 DN/GDN/KDA 的 $\beta\in[0,2]$ 对照,允许负特征值。许多设置获得改善,PGDN 仍在若干检索设置明显更好,但并非所有指标都胜:340M GDN[-1,1] 的真实 ICR Avg 26.22 略高于 PGDN 的 26.17。这个对照说明只扩大特征值可选范围不足以解释所有收益,不足以证明预条件对负谱模型全面占优。
App. E.5(p. 31)报告作者尝试的 MesaNet 340M 在约 5K/30K 训练步出现 NaN,也尝试了原论文配置与 decay 上界。因此本文缺少完成训练的同条件 MesaNet 质量比较;速度比较与质量优劣须分开。其对共轭梯度不充分收敛、隐式梯度可能有误的解释是机制推测,不是本实验中已逐项隔离的原因。
五:结论、边界与进一步思考
这篇论文最有价值的是把读 key 与写 key 解耦,并展示一种低参数开销、仍能利用专用 delta-rule 分块内核的实现。精确最小二乘等价提供了设计动机;对角历史统计和有界 squash 使之成为可以训练的模型;配对实验支持这种设计在所报告预算下改善平均表现。
需要保留的边界:
- 理论与实用形式之间存在距离:最终模型不保留精确回归解,定理 3.2 的证明也有比正文陈述更强的假设。
- 局部谱界并非完整稳定性证明:尤其不能直接推广到全部时变乘积、梯度或逐维 decay。
- 主结果是配对均值提升:任务级退步存在;缺少多 seed 方差;355M 与 340M 以及不同 gate 配置限制横向排名。
- 效率与质量有交换:端到端多约 10% 开销;没有同训练时间/同 FLOPs 的质量前沿,无法据此断言相同算力预算下必然更优。
- 长程外推未解决:2K 训练到 8K 的困难召回仍弱;未验证更大模型、更长训练、任意长推理。
- 源码/正文符号需谨慎:表 2 caption 把 $G_t$ 称作 inverse Gram,与第 2–3 节 $G_t$ 为 Gram、$P_t=G_t^{-1}$ 不一致;理解对角方法应以式 (7)–(9) 为准。附录 E.3 一处说限制 $A_t$,实际被限制的是 $B_t$。这些问题不改变主递推,但影响复现时的直接照抄。
本次分析提出的后续问题(非论文已完成结果):在相同训练墙钟预算下收益是否仍保持?仅学习独立写 key 而不维护二阶统计能否达到同样效果,参数开销如何?适当的块对角/低秩近似能否用可控开销补回坐标相关性?怎样在 PKDA 及时间变化预条件下建立更强的乘积范数保证?这些问题分别对应效率、因果归因、近似精度和理论完整性。
阅读与核验说明
阅读覆盖作者实际引用的正文和附录 A–G;关键论断从 TeX 定义、最终 PDF 表格/图号两侧核对。参考文献用于定位原文论证背景,未额外做相关工作综述。表中差值与比例为本次算术计算,图件为原作者图。有关表 6 的异常值与表 2 的符号冲突均按原文保留,不自行修正文献。